内容参考于:图灵AI大模型全栈
摘要 :本文通过一个完整的 LangChain Agent 中间件实战案例,演示如何利用
before_agent和after_model装饰器实现用户消息预处理与模型输出 JSON 格式的自动修复。文章详细讲解了repair_json_string函数中三个正则表达式的修复逻辑(去除 Markdown 代码块标记、删除多余逗号、为未加引号的 key 补引号),并展示了如何将修复后的 JSON 写回消息状态、为 Agent 注册模型输出后的处理函数,最终实现一个可自动纠错 JSON 的智能体。
效果图:
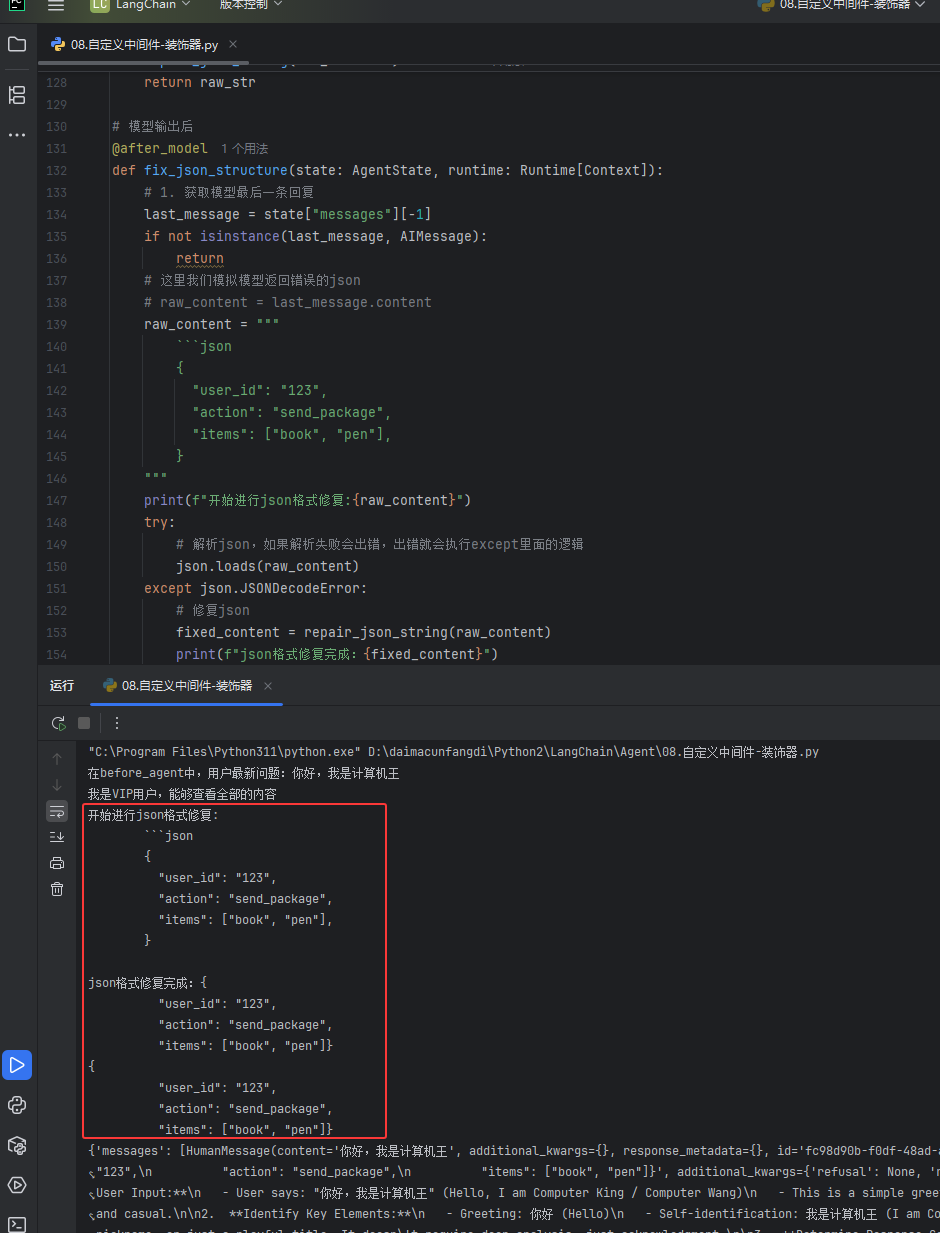
下图红框是输入的错误json,下图蓝框是验证json,下图绿框是修复json
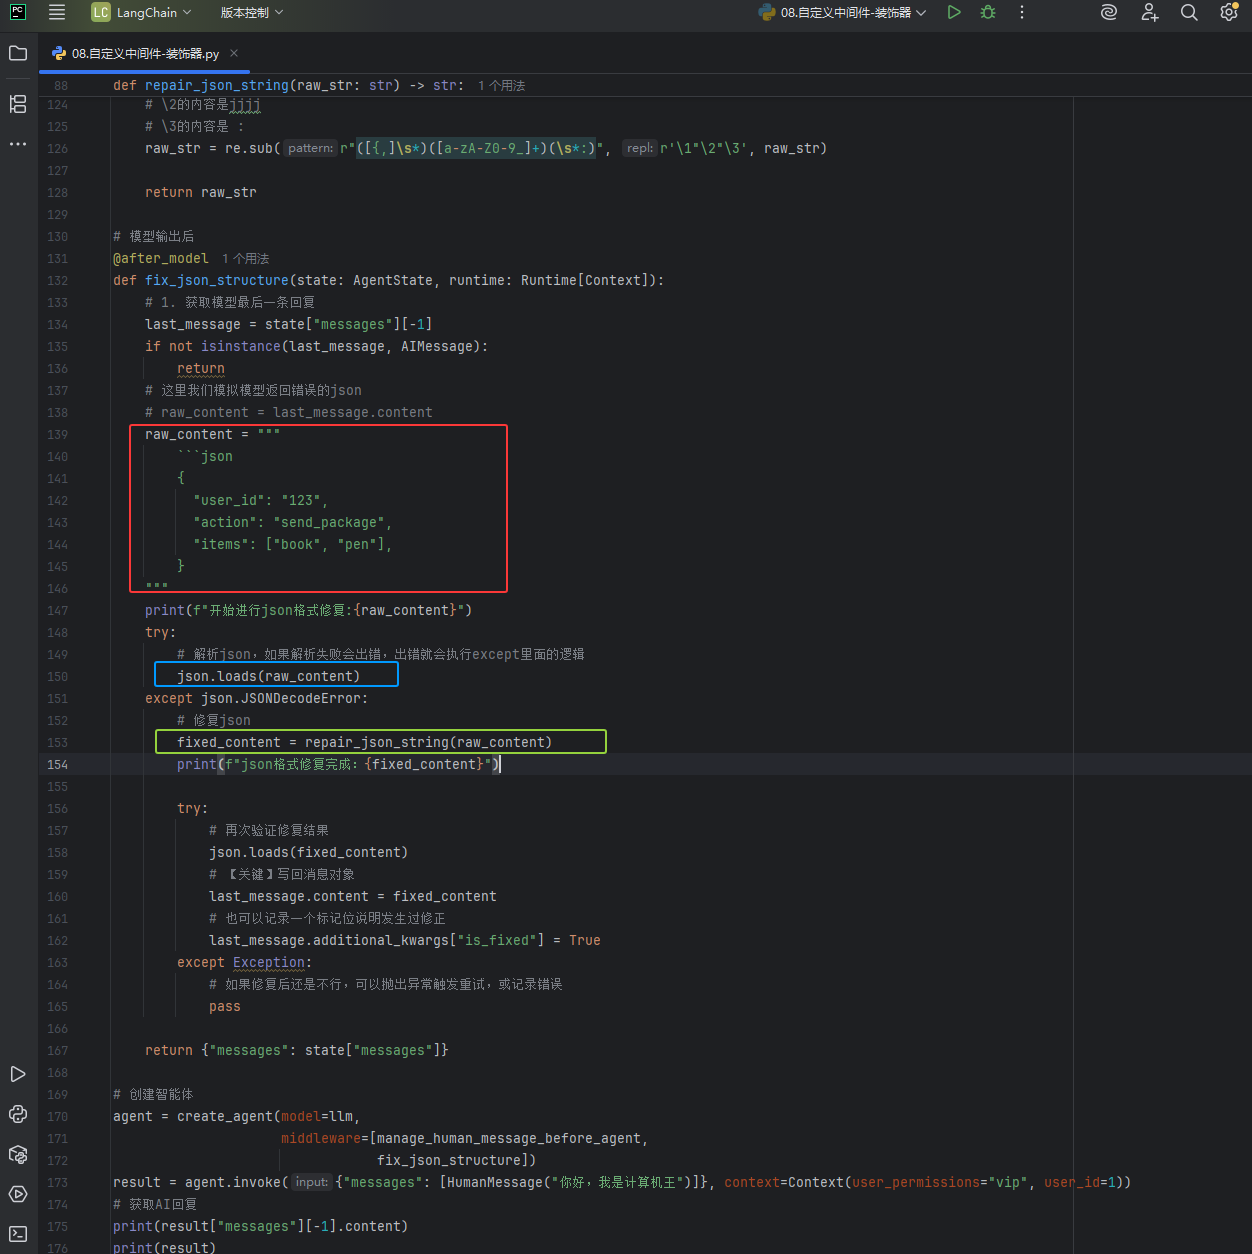
修复逻辑如下图红框的三个正则表达式的处理,这里只是简单的处理,如果是复杂的可以通过大模型来搞
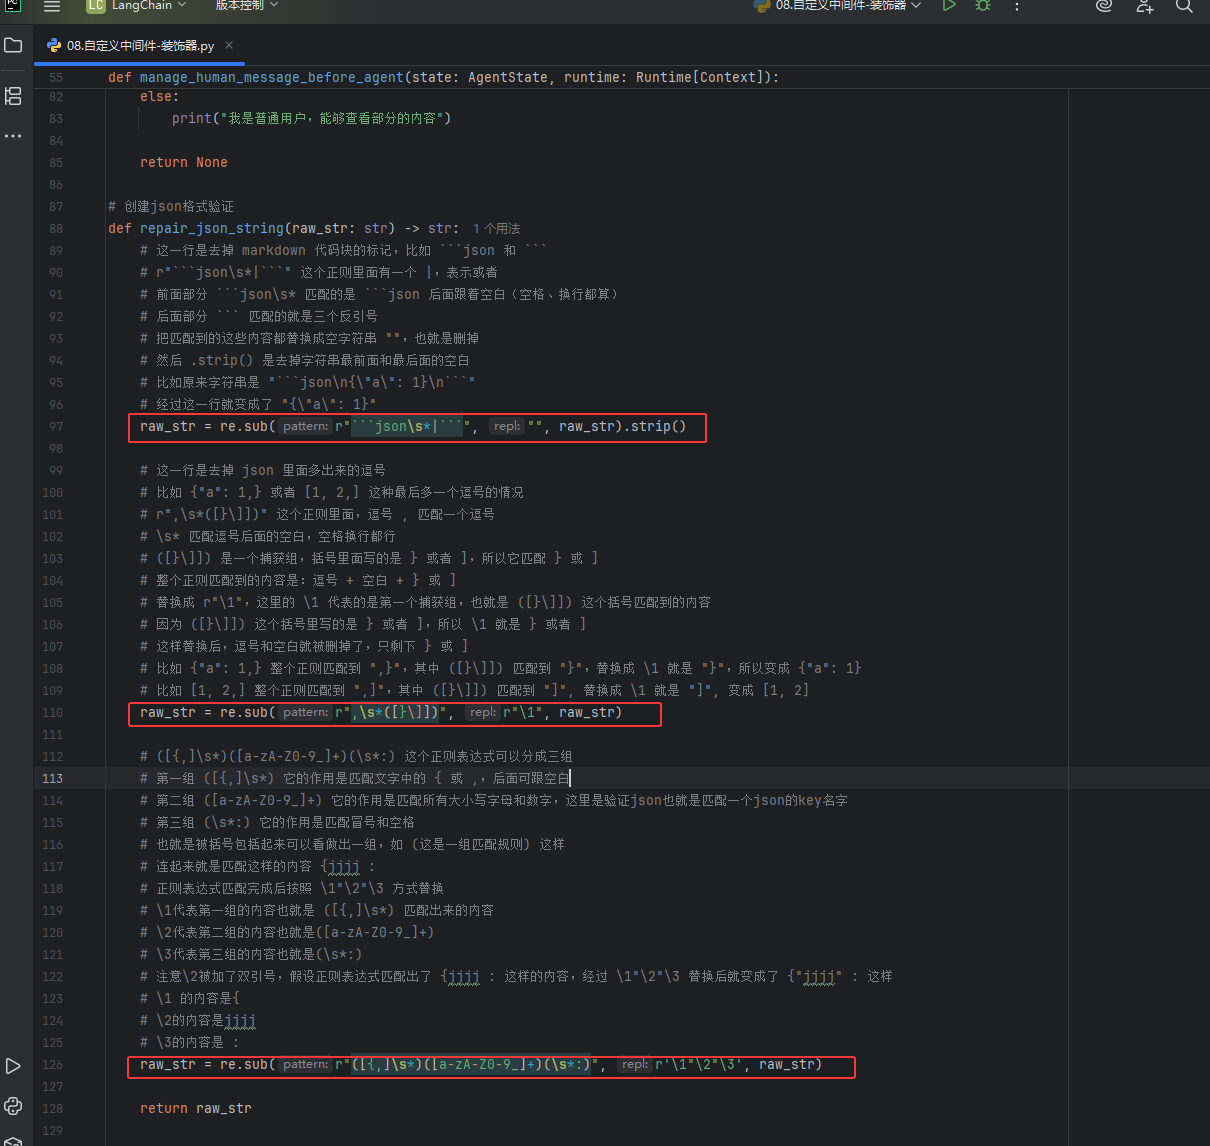
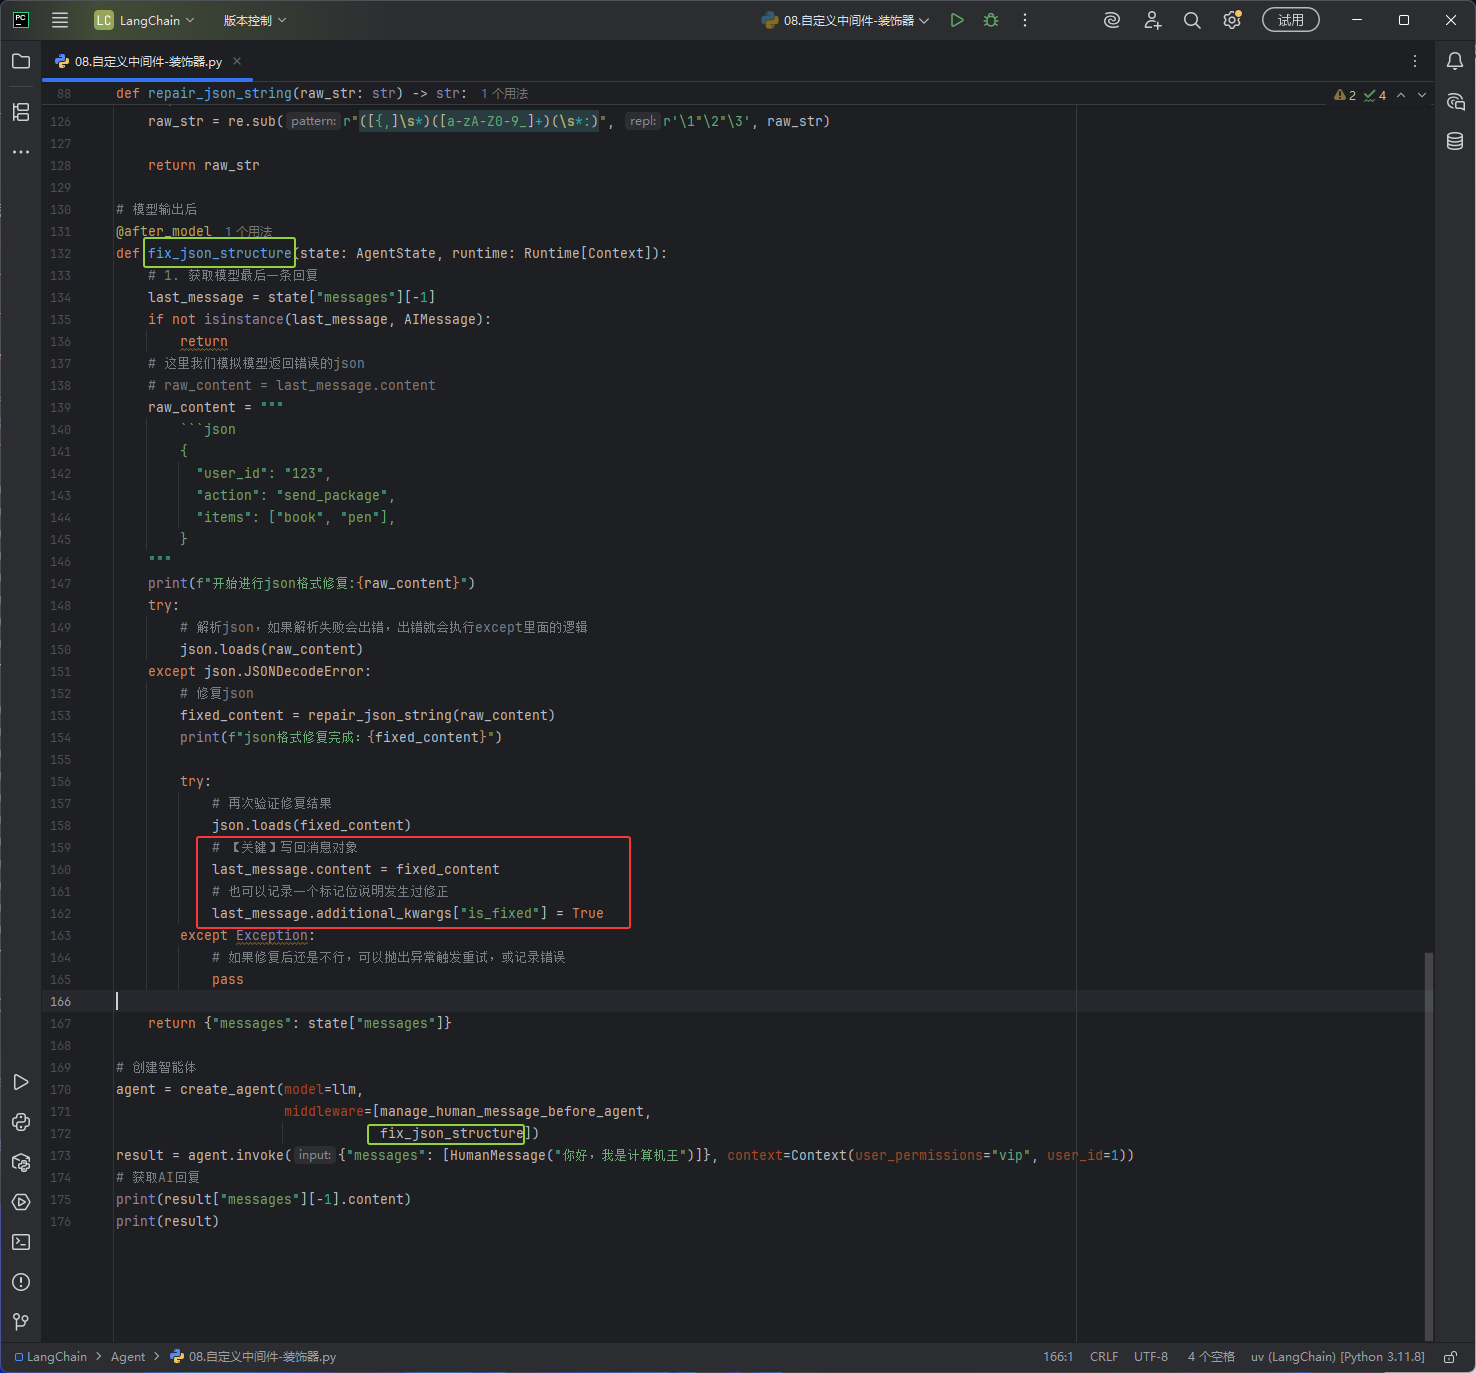
下图红框是把新json写到状态里,下图绿框是给Agent添加模型输出后要执行的函数
代码
python
from dataclasses import dataclass
from langchain.agents import create_agent, AgentState
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage
import re
import json
from langgraph.runtime import Runtime
from typing import Callable
from langchain_qwq import ChatQwen
from dotenv import load_dotenv
import os

# 加载模型
# 加载环境变量
load_dotenv()

# 初始化模型
llm = ChatQwen(
    model="qwen3.7-flash",
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url=os.getenv("DASHSCOPE_BASE_URL")
)

# dataclass会自动创建init、repr、eq方法,frozen能够保证对象初始化之后不能修改
@dataclass(frozen=True)
class Context:
    user_id: int
    user_permissions: str

# 引入装饰器
# 从 LangChain 的 Agent 中间件模块中导入以下组件:

from langchain.agents.middleware import (
    before_agent,      # 装饰器:在 Agent 开始执行前触发一次。适合初始化、权限校验、日志、修改初始状态或强制跳转。
    after_agent,       # 装饰器:在 Agent 执行结束后触发一次。适合资源清理、最终日志、结果后处理等。
    before_model,      # 装饰器:每次调用模型前触发。适合修改消息、动态调整提示词、注入上下文等。
    after_model,       # 装饰器:每次模型返回后触发。适合输出校验、内容过滤、解析结果、记录日志等。
    wrap_model_call,   # 装饰器:包裹模型调用。可在模型调用前后插入逻辑,如重试、缓存、限流、监控、修改请求/响应。
    wrap_tool_call,    # 装饰器:包裹工具调用。可在工具执行前后插入逻辑,如参数校验、权限检查、重试、结果处理。
    ModelRequest,      # 类型:模型请求对象。通常包含 messages、tools、配置等,供 wrap_model_call 中读取或修改。
    ModelResponse,     # 类型:模型响应对象。通常包含生成消息、工具调用等,供 wrap_model_call 中读取或修改。
    AgentMiddleware,   # 基类:用于以类的方式定义中间件,可集中组织多个钩子方法(before/after/wrap 等)。
)

# 通过 before_agent 注解设置进入Agent之前调用的函数
# 它的 can_jump_to 参数表示当前函数可以跳转到什么节点中
# 通过返回 jump_to 这个字段来实现跳转
# can_jump_to是告诉LangChain可以跳转什么节点
# 返回 jump_to 来实现跳转
# 如果 不写 can_jump_to 那么 jump_to 会无效
# can_jump_to 有三个值,如下
# "tools"表示可以跳转到工具节点,进入Agent之前和之后不可以跳转tools
# "model"表示可以跳转到模型节点或进入模型之前的钩子
# "end"表示跳转到Agent末尾 或 第一个进入Agent之后的钩子,也就是用来结束Agent的执行
@before_agent(can_jump_to=[])
def manage_human_message_before_agent(state: AgentState, runtime: Runtime[Context]):
    """
    在Agent启动之前调用
    Runtime:用来传递全局变量(只是用来读取的内容-上下文的常量),还经常用来传递数据库连接池、日志对象一些配置信息
    """

    # 从后往前找第一个类别为 HumanMessage 的消息
    user_content = ""
    for message in reversed(state["messages"]):
        if isinstance(message, HumanMessage):
            user_content = message.content
    # 打印用户最新的问题
    print(f"在before_agent中,用户最新问题:{user_content}")
    # 1.处理用户敏感用词
    sensitive_words = ["TM", "TMD", "CNM", "挂了", "垃圾"]
    if any(word in user_content.upper() for word in sensitive_words):
        # 发现敏感词,直接构造一个 AI 响应,不再交给模型思考
        return {
            "messages": [AIMessage(content="检测到不当言论,请文明交流。")],
            "jump_to": "end"  # 直接结束这次对话
        }
    # 2.vip用户特殊处理
    # 获取用户权限
    user_permissions = runtime.context.user_permissions
    if user_permissions == "vip":
        # vip权限能够进行所有知识库的访问
        print("我是VIP用户,能够查看全部的内容")
    else:
        print("我是普通用户,能够查看部分的内容")

    return None

# 创建json格式验证
def repair_json_string(raw_str: str) -> str:
    # 这一行是去掉 markdown 代码块的标记,比如 ```json 和 ```
    # r"```json\s*|```" 这个正则里面有一个 |,表示或者
    # 前面部分 ```json\s* 匹配的是 ```json 后面跟着空白(空格、换行都算)
    # 后面部分 ```匹配的就是三个反引号
    # 把匹配到的这些内容都替换成空字符串 "",也就是删掉
    # 然后 .strip() 是去掉字符串最前面和最后面的空白
    # 比如原来字符串是 "```json\n{\"a\": 1}\n```"
    # 经过这一行就变成了 "{\"a\": 1}"
    raw_str = re.sub(r"```json\s*|```", "", raw_str).strip()

    # 这一行是去掉 json 里面多出来的逗号
    # 比如 {"a": 1,} 或者 [1, 2,] 这种最后多一个逗号的情况
    # r",\s*([}\]])" 这个正则里面,逗号 , 匹配一个逗号
    # \s* 匹配逗号后面的空白,空格换行都行
    # ([}\]]) 是一个捕获组,括号里面写的是 } 或者 ],所以它匹配 } 或 ]
    # 整个正则匹配到的内容是:逗号 + 空白 + } 或 ]
    # 替换成 r"\1",这里的 \1 代表的是第一个捕获组,也就是 ([}\]]) 这个括号匹配到的内容
    # 因为 ([}\]]) 这个括号里写的是 } 或者 ],所以 \1 就是 } 或者 ]
    # 这样替换后,逗号和空白就被删掉了,只剩下 } 或 ]
    # 比如 {"a": 1,} 整个正则匹配到 ",}",其中 ([}\]]) 匹配到 "}",替换成 \1 就是 "}",所以变成 {"a": 1}
    # 比如 [1, 2,] 整个正则匹配到 ",]",其中 ([}\]]) 匹配到 "]", 替换成 \1 就是 "]", 变成 [1, 2]
    raw_str = re.sub(r",\s*([}\]])", r"\1", raw_str)

    # ([{,]\s*)([a-zA-Z0-9_]+)(\s*:) 这个正则表达式可以分成三组
    # 第一组 ([{,]\s*) 它的作用是匹配文字中的 { 或 ,,后面可跟空白
    # 第二组 ([a-zA-Z0-9_]+) 它的作用是匹配所有大小写字母和数字,这里是验证json也就是匹配一个json的key名字
    # 第三组 (\s*:) 它的作用是匹配冒号和空格
    # 也就是被括号包括起来可以看做出一组,如 (这是一组匹配规则) 这样
    # 连起来就是匹配这样的内容 {jjjj :
    # 正则表达式匹配完成后按照 \1"\2"\3 方式替换
    # \1代表第一组的内容也就是 ([{,]\s*) 匹配出来的内容
    # \2代表第二组的内容也就是([a-zA-Z0-9_]+)
    # \3代表第三组的内容也就是(\s*:)
    # 注意\2被加了双引号,假设正则表达式匹配出了 {jjjj : 这样的内容,经过 \1"\2"\3 替换后就变成了 {"jjjj" : 这样
    # \1 的内容是{
    # \2的内容是jjjj
    # \3的内容是 :
    raw_str = re.sub(r"([{,]\s*)([a-zA-Z0-9_]+)(\s*:)", r'\1"\2"\3', raw_str)

    return raw_str

# 模型输出后
@after_model
def fix_json_structure(state: AgentState, runtime: Runtime[Context]):
    # 1. 获取模型最后一条回复
    last_message = state["messages"][-1]
    if not isinstance(last_message, AIMessage):
        return
    # 这里我们模拟模型返回错误的json
    # raw_content = last_message.content
    raw_content = """
        ```json
        {
          "user_id": "123",
          "action": "send_package",
          "items": ["book", "pen"],
        }
    """
    print(f"开始进行json格式修复:{raw_content}")
    try:
        # 解析json,如果解析失败会出错,出错就会执行except里面的逻辑
        json.loads(raw_content)
    except json.JSONDecodeError:
        # 修复json
        fixed_content = repair_json_string(raw_content)
        print(f"json格式修复完成:{fixed_content}")

        try:
            # 再次验证修复结果
            json.loads(fixed_content)
            # 【关键】写回消息对象
            last_message.content = fixed_content
            # 也可以记录一个标记位说明发生过修正
            last_message.additional_kwargs["is_fixed"] = True
        except Exception:
            # 如果修复后还是不行,可以抛出异常触发重试,或记录错误
            pass

    return {"messages": state["messages"]}

# 创建智能体
agent = create_agent(model=llm,
                     # 设置中间件
                     middleware=[manage_human_message_before_agent,
                                 fix_json_structure])
result = agent.invoke({"messages": [HumanMessage("你好,我是计算机王")]}, context=Context(user_permissions="vip", user_id=1))
# 获取AI回复
print(result["messages"][-1].content)
print(result)