OpenAI 这次的发布帖里,最值得看的地方在三张并排出现的卡片:GPT-6 Astra、GPT-6 Sol 和 GPT-6 Luna。
官方的说法也很直接。Sol 和 Luna 延续了 GPT-6 Astra 的一部分能力,缓存和推理效率进一步优化,API 价格相较 GPT-5.6 的 promotional pricing 降低 50%。同一批发布的两款模型,单价又拉出了 20 倍差距。开发者要先回答的,是同一个模型家族里哪种任务值得用哪一档预算。
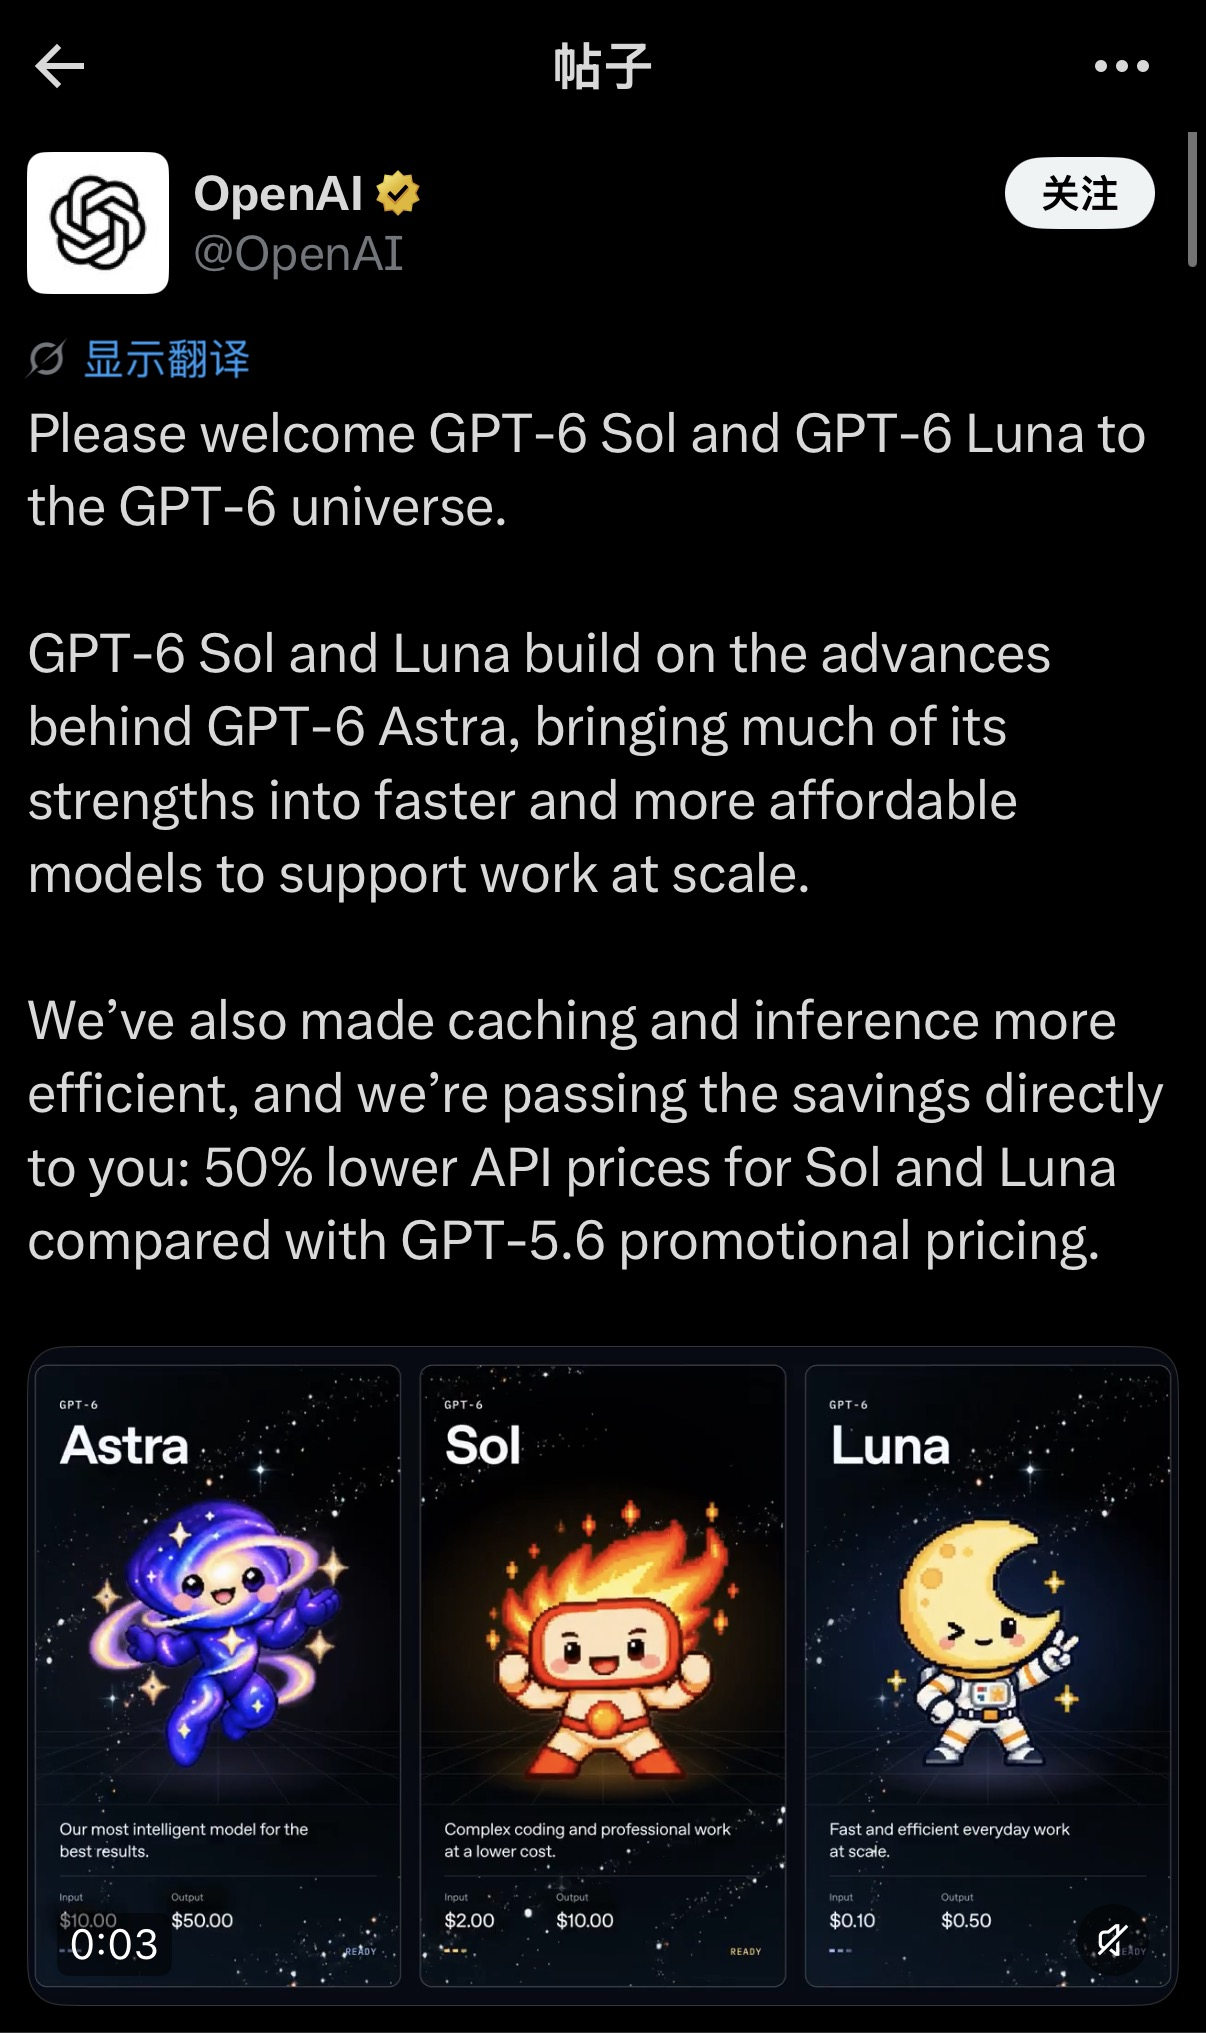
图 1|OpenAI 官方 X 发布说明,展示 Astra、Sol、Luna 的家族关系、任务定位和价格。来源:@OpenAI。
Sol 和 Luna,分别在接什么工作
从官方模型页的描述看,Sol 的重点不在于单纯把参数做大。它的定位是 complex coding and agentic workflows,也就是复杂编程和 Agent 工作流。Luna 的关键词则是 focused, high-volume tasks,强调聚焦、高频和规模化任务。
这两个定位放在一起,分工就很清楚了。一个更适合单次任务链条较长、需要持续推理和工具配合的工作;另一个更适合边界明确、调用次数多、单位成本更敏感的工作。它们接受的输入其实一样,都是文本和图片,输出也都是文本,差异主要落在任务复杂度和调用经济性上。
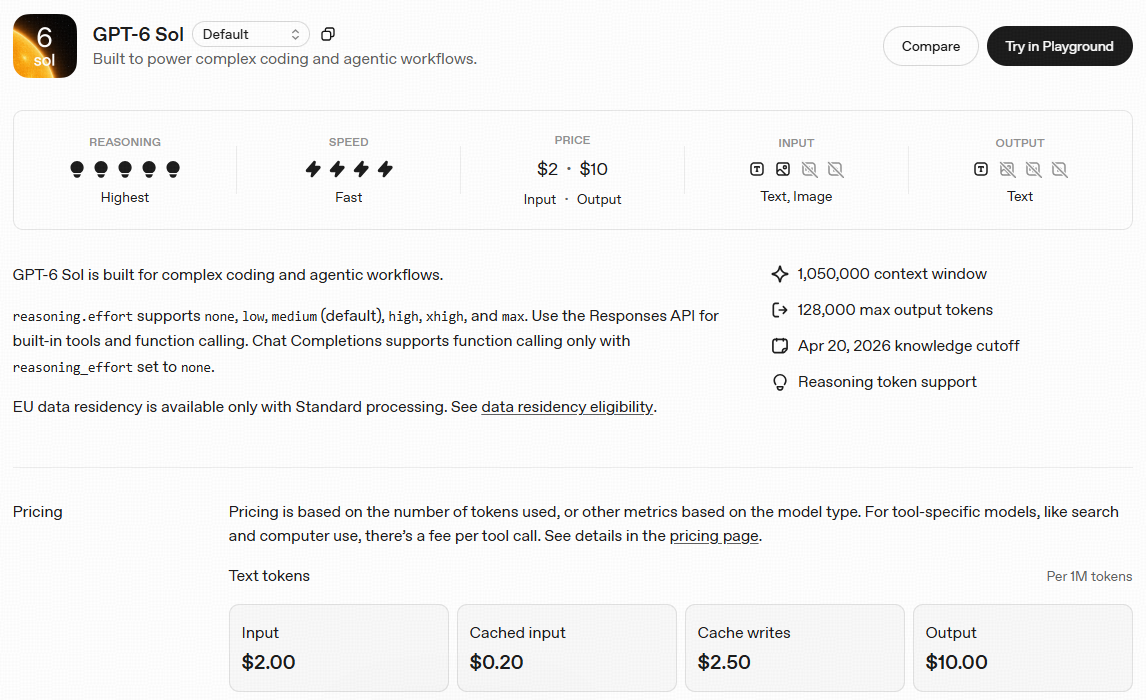
图 2|GPT-6 Sol 的官方定位、价格、输入模态和上下文规格。来源:OpenAI GPT-6 Sol Model。
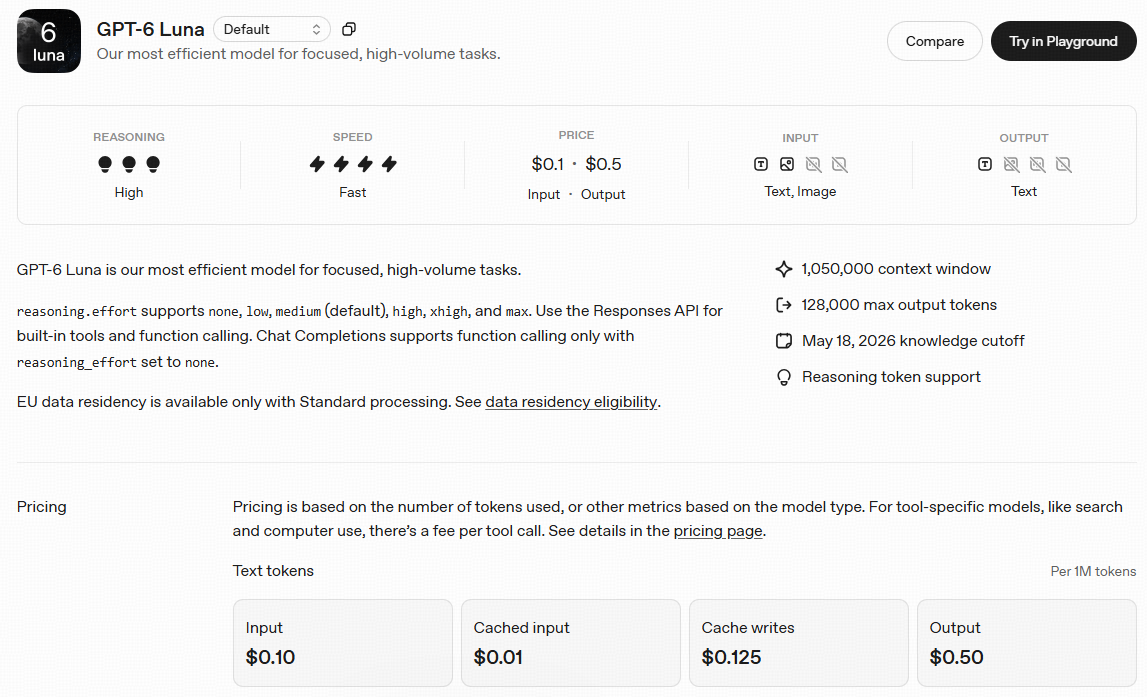
图 3|GPT-6 Luna 的官方定位、价格、输入模态和上下文规格。来源:OpenAI GPT-6 Luna Model。
20 倍价差,模型选择变成了成本决策
API Changelog 给出的标准价格如下:
| 模型 | 输入 | 缓存输入 | 输出 |
|---|---|---|---|
| GPT-6 Sol | $2 / 1M token | $0.20 / 1M token | $10 / 1M token |
| GPT-6 Luna | $0.10 / 1M token | $0.01 / 1M token | $0.50 / 1M token |
三项价格刚好都是 20 倍关系。假设一次任务消耗 1M 输入 token 和 200K 输出 token,暂时不计算缓存,Sol 的费用约为 4 美元,Luna 约为 0.20 美元。任务内容完全相同,模型档位会让成本相差一个数量级以上。
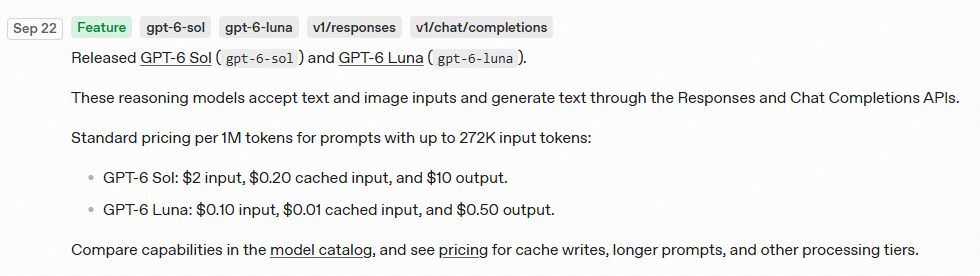
图 4|OpenAI API Changelog 对两款模型的 API、输入模态、272K 价格条件和标准价格说明。来源:OpenAI API Changelog。
这还不是全部变化。OpenAI 发布页同时列出了 GPT-5.6 Sol/Luna 到 GPT-6 Sol/Luna 的价格对照,同档位价格下降 50%。于是这次更新有两层价格变化:新一代模型整体变便宜了,GPT-6 家族内部又把复杂任务和高频任务分成了两档。
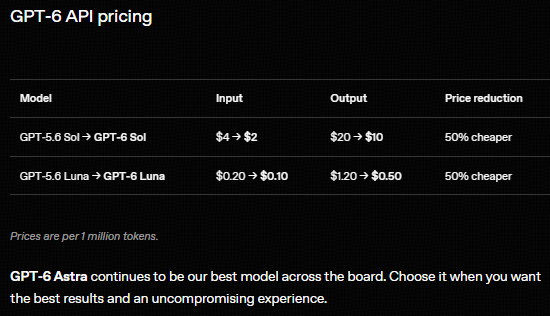
图 5|OpenAI 发布页列出的 GPT-5.6 到 GPT-6 同档位价格变化。来源:Introducing GPT-6 Sol and Luna。
272K 不是上下文上限
这次更新里有一个很容易被读错的数字。Changelog 写的是,标准价格适用于最多 272K 输入 token 的 prompt。它描述的是计价条件,不是模型只能处理 272K token。
在 Sol 和 Luna 的模型页上,OpenAI 还列出了 1,050,000 的 context window、922,000 的 maximum input,以及 128,000 的最大输出 token。超过 272K 输入 token 后,价格会按更高的长 prompt 规则计算;上下文窗口和最大输入字段仍然是另一组规格。预算规划时把这几个数字分开,才不会把一次价格跳档误读成能力上限。
API 入口相同,调用条件仍要重看
Sol 和 Luna 都支持 Responses API 与 Chat Completions API,也都能接受图片输入。不过,模型页对工具调用写得很具体:Responses API 用于内置工具和 function calling;Chat Completions 只有在 reasoning_effort=none 时支持 function calling。
已有应用接入时,不能只把 model 字段替换成新 ID。原来依赖工具调用的代码,要重新检查 endpoint、reasoning effort、函数参数和图片输入格式。两款模型的调用入口没有变化,参数组合却可能影响原有工作流能不能照常运行。
官方基准也在把成本放进比较里
OpenAI 发布页还放出了一张 AutomationBench 1.0.6 图,把端到端 Agent 工作流的得分和单任务成本放在同一张坐标图上。它提供了一个比"谁的分数更高"更接近实际使用的观察角度:模型完成任务的能力和完成一次任务的价格,需要一起看。
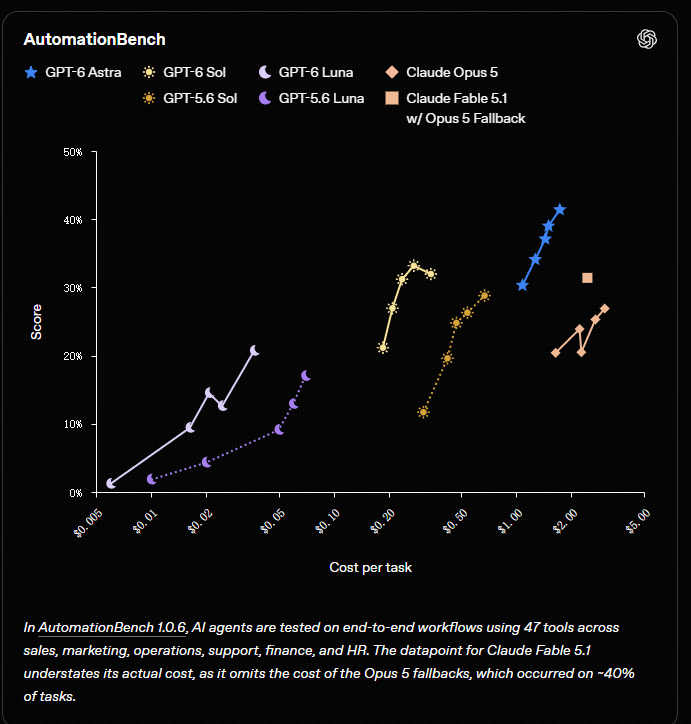
图 6|OpenAI 官方 AutomationBench 1.0.6 成本---得分图。来源:Introducing GPT-6 Sol and Luna。
这张图不能直接告诉你所有业务都该选哪款模型。代码 Agent、客服批处理、知识库整理和工具编排,对推理深度、调用频率和失败重试的敏感点都不同。但它至少把模型选择从单一的能力榜,拉回了成本和任务结果的共同判断。
最后要判断的,是任务值不值得用这一档预算
如果任务需要持续修改代码、调用多个工具、处理长链路决策,Sol 的官方定位更贴近这类工作。若任务边界清楚、调用量很大,或者每次请求都要精打细算,Luna 的价格优势会更直接。
模型发布只是选择的起点。真正准备接入时,还可以在 OkenAI 这类平台看同一个模型在不同 API 服务上的输入、输出和缓存价格,Token 消耗是否稳定,响应时间和成功率能不能撑住实际工作流。
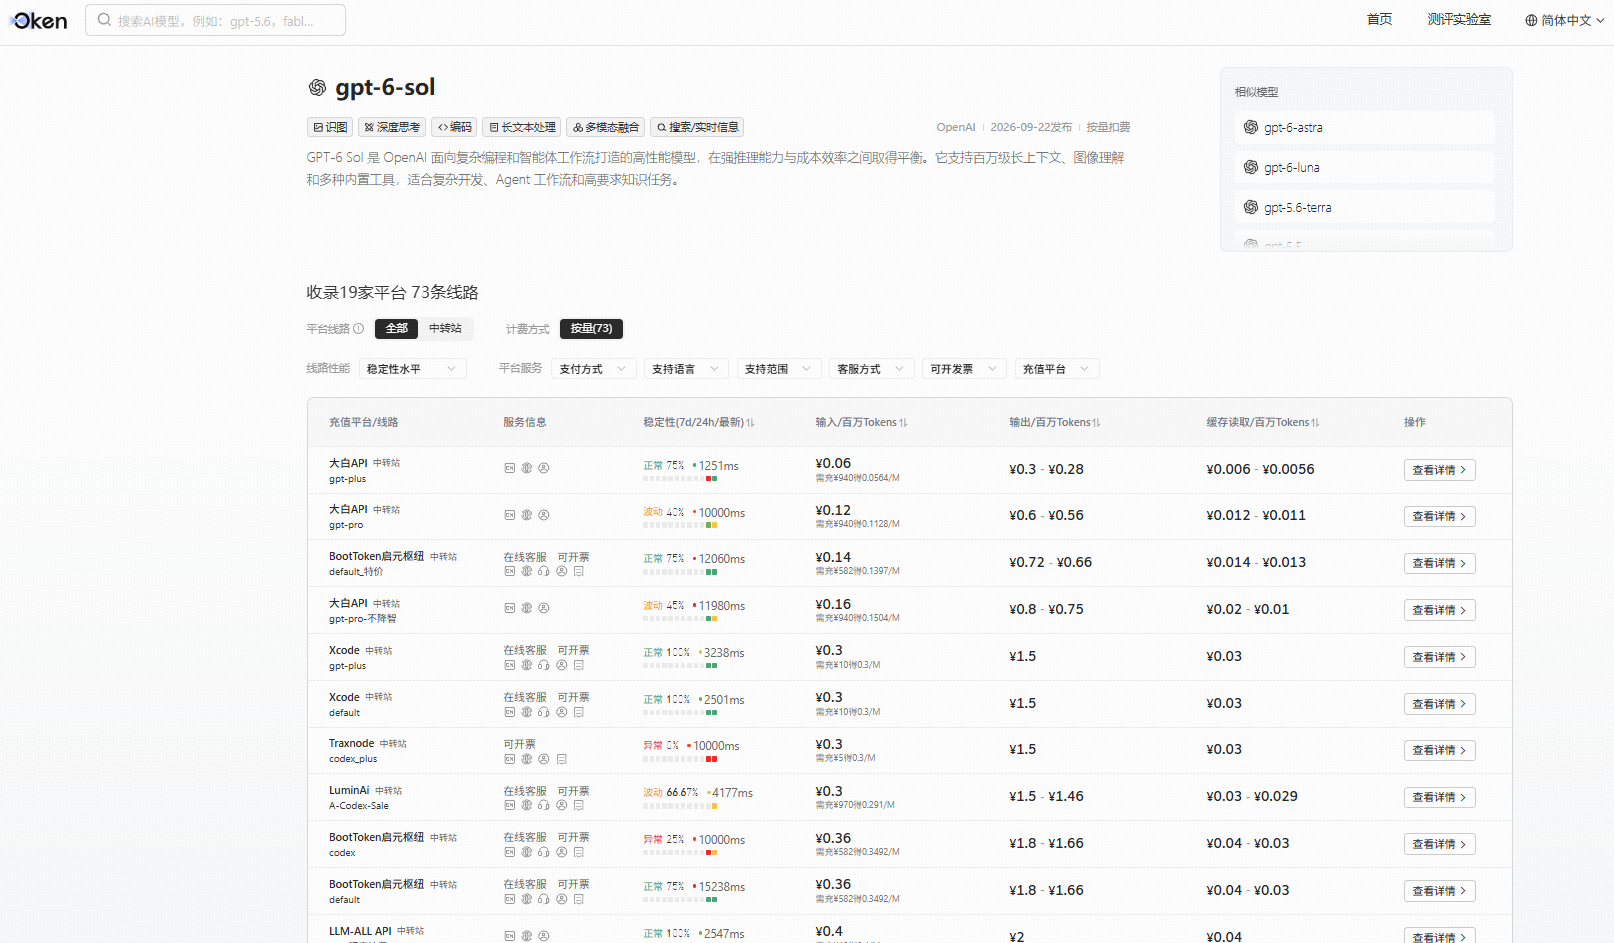
图 7|OkenAI 的 GPT-6 Sol 模型详情页,集中展示 API 服务数量、线路状态、输入/输出/缓存字段和响应表现。来源:OkenAI
这也是模型发布之后最容易被忽略的一步:模型规格解决"它能做什么",服务数据才帮助你判断"这条 API 服务是否值得继续接入和比较"。