视频处理任务里最危险的误判是:目录里出现了 MP4,就认为导出成功。GPU 编码器可能不可用、显存可能不足、进程可能中途退出但留下半成品;即使退出码为 0,成片也可能没有音轨、时长异常或编码格式不适合目标播放器。
第 05 篇已经解决了确认字幕怎样进入成片;本文只讨论成片导出。固定案例是一条 93.2 秒的 1080P 带字幕预览视频:Worker 优先尝试 NVENC,以缩短批量任务耗时;GPU 不可用或编码失败时,再使用 libx264 重新导出。系统必须记录每次尝试、每种编码策略和最终验收结果,不能让失败文件进入交付目录。
示例环境为 Python 3 Worker、FFmpeg/ffprobe、Java 17/Spring Boot 风格服务层和 MySQL 8.x。编码参数与阈值为教学示例,生产环境应按目标平台、机器资源和素材特征调整。
目录
- 编码选择先看交付目标
- 固定案例和可交付标准
- GPU首选、CPU降级的导出链路
- 数据模型:尝试记录与最终成片分开保存
- Python实现:有条件地降级,而不是盲目重试
- Java实现:媒体验收通过才提交
- 预期输出和自动测试
- SQL验证:怎样发现异常交付物
- 异常边界和上线验收
- 小结和延伸阅读
一、编码选择先看交付目标
h264_nvenc 和 libx264 不是简单的"快"和"慢"。前者依赖 NVIDIA 驱动、编码器支持和可用显存;后者主要使用 CPU,耗时更长,但在没有 NVIDIA GPU 的机器上仍可工作。对需要广泛播放的 MP4,视频使用 H.264、音频使用 AAC 通常是保守的交付选择。
| 场景 | 首选策略 | 降级策略 | 为什么 |
|---|---|---|---|
| GPU 工作节点批量导出 | H.264 + NVENC | H.264 + libx264 | 优先吞吐,失败后仍保证交付 |
| 无 GPU 的普通服务器 | H.264 + libx264 | 排队或转交 GPU 节点 | 不把不存在的硬件能力写进流程 |
| 高质量归档母版 | 保留高质量源文件 | 单独归档任务 | 不与面向播放的压缩规则混用 |
| 移动端或平台上传 | H.264 + AAC + faststart | 平台专用转码 | 优先兼容与首屏播放 |
这里的关键是"策略有顺序,结果有证据"。不能因为 NVENC 失败就无限重试,也不能在未记录原因的情况下悄悄换成 CPU,导致后续无法解释任务为什么突然变慢。
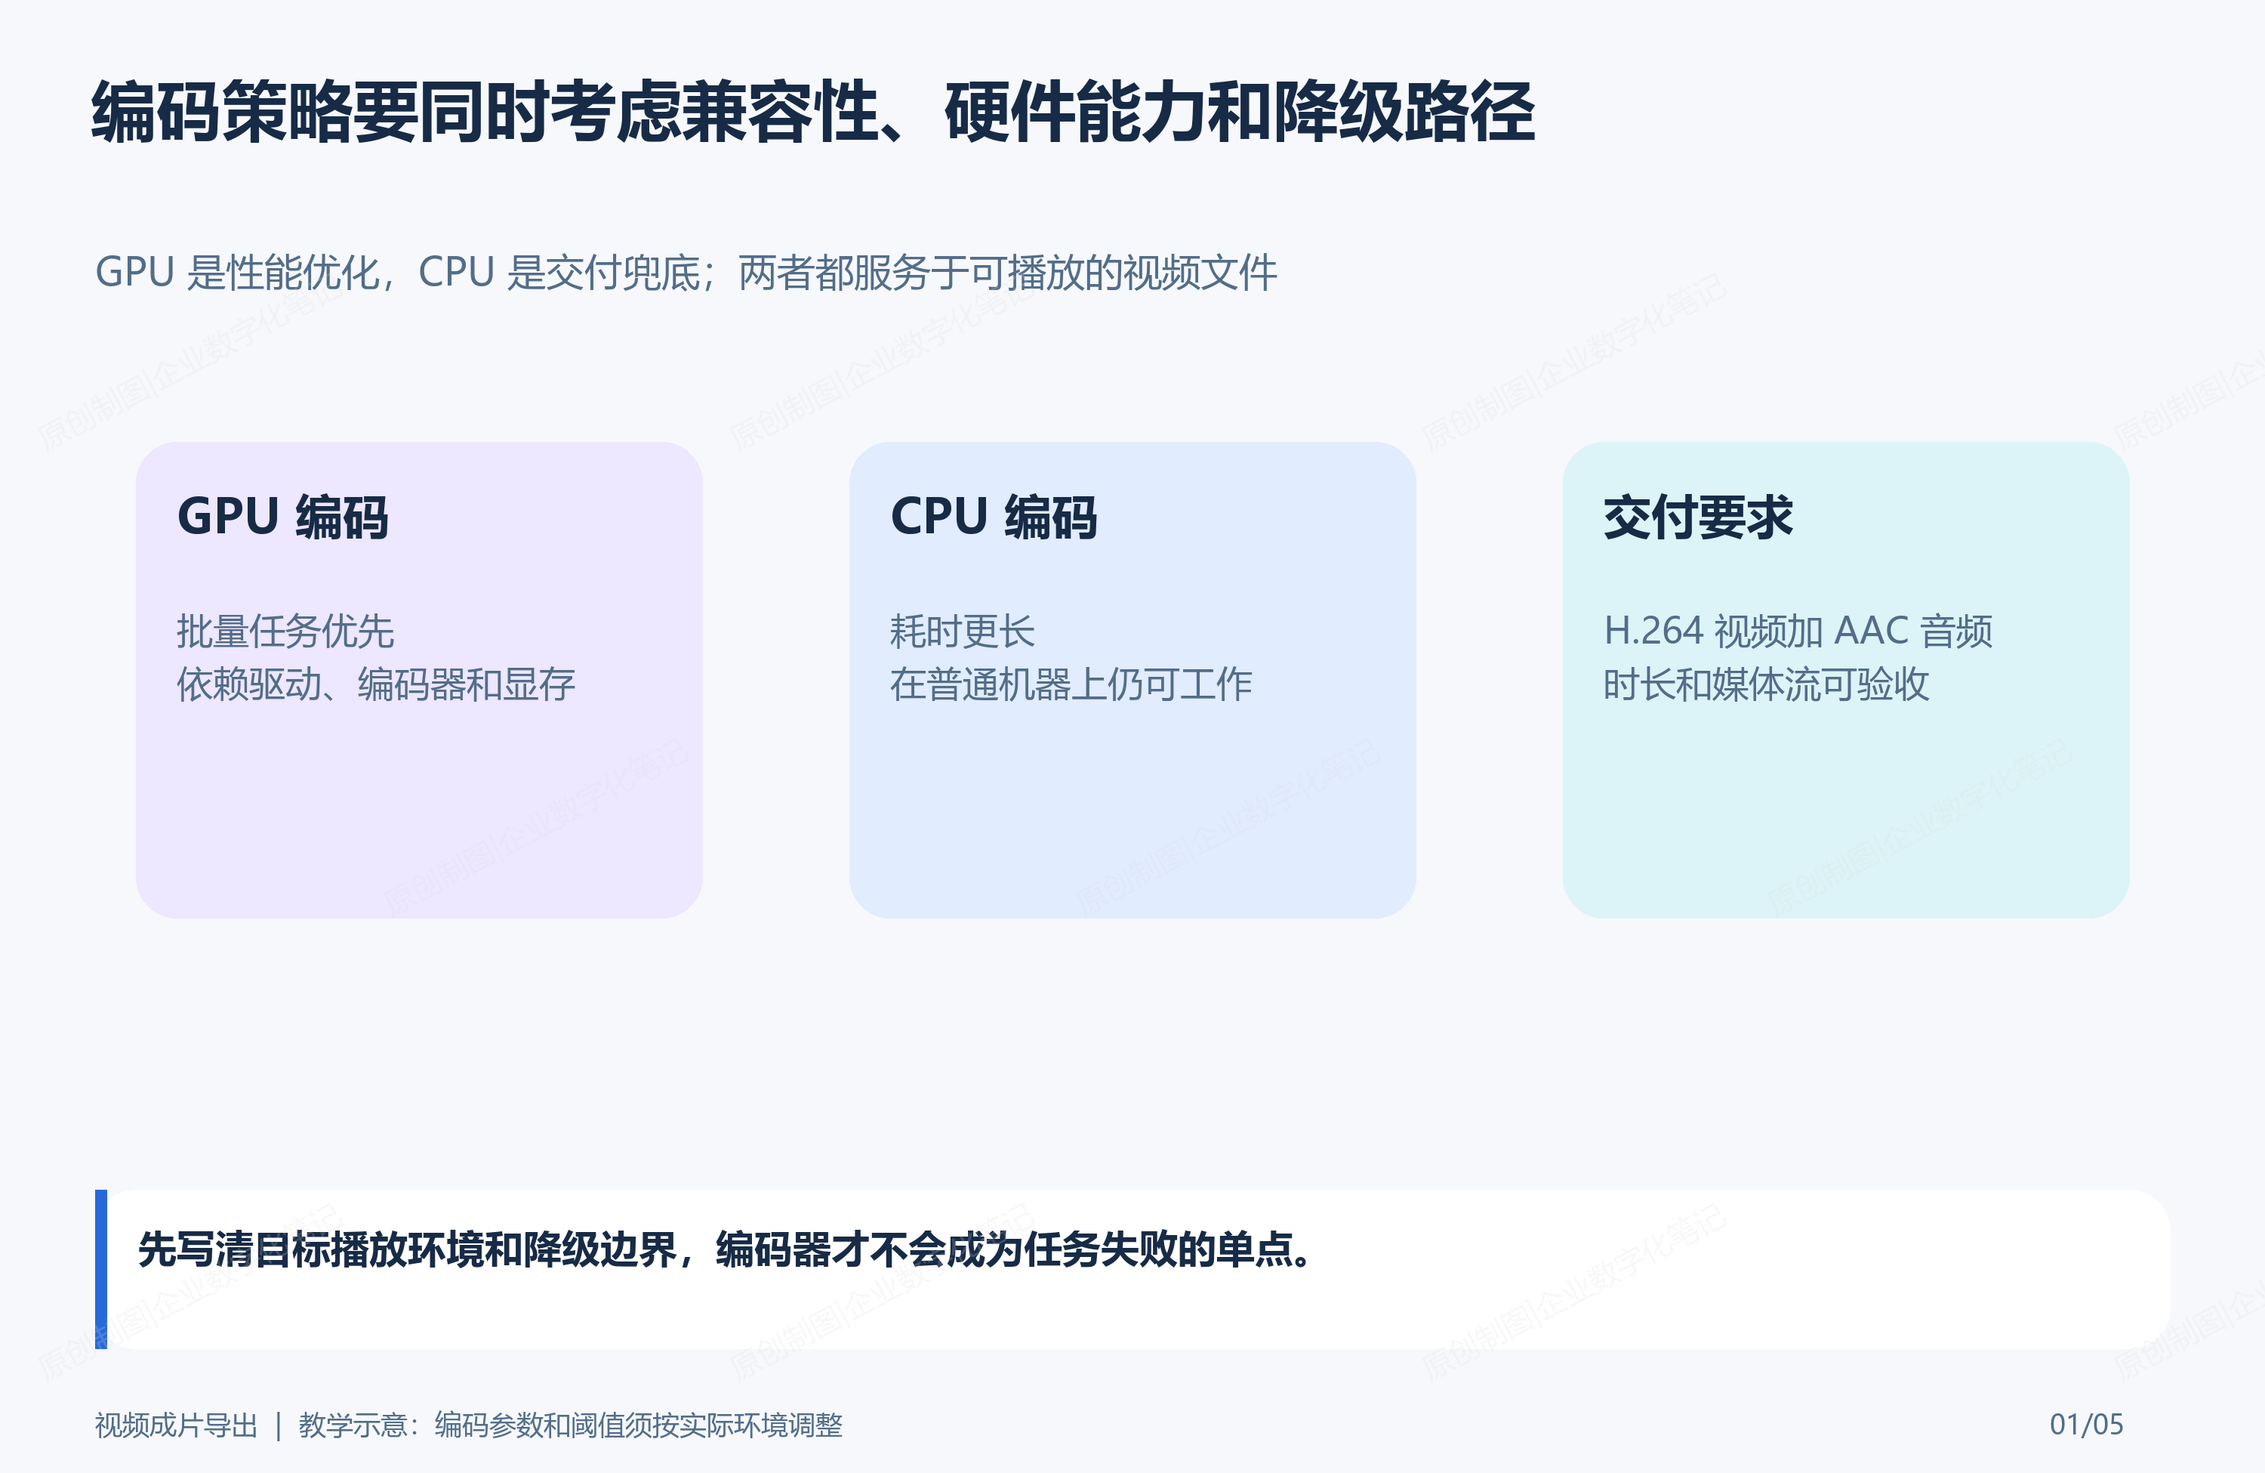
图1:GPU 编码是优化路径,不是交付前提;CPU 降级保证任务在受控条件下完成。
二、固定案例和可交付标准
text
任务编号:VW-20261001-006
输入视频:outputs/preview/lesson-burned.mp4
目标交付:outputs/delivery/lesson-final.mp4
源视频:1920x1080,93.2 秒,含视频和音频流
首选编码:h264_nvenc / AAC
降级编码:libx264 / AAC
最大时长偏差:1.5 秒
最低文件大小:1 MB
请求编号:REQ-RENDER-006
本次故障中,任务第一次调用 NVENC 返回"找不到可用编码器";如果程序只报失败,用户只能手工重新选择机器。如果程序无条件重复调用同一命令,则会制造大量相同失败日志。正确做法是识别"可降级"的编码环境错误,创建第二次 CPU 尝试;第二次成功后,仍要探测最终视频的时长、分辨率、流信息和文件大小。
三、GPU首选、CPU降级的导出链路
导出服务把"编码尝试"和"最终交付"分成两层。前者记录每次命令的策略、耗时和错误,后者只引用验收通过的那一次:
| 步骤 | 处理 | 失败时怎样做 |
|---|---|---|
| 读取输入 | 只读取 READY 的预览视频 |
输入不可用,直接阻断 |
| 创建 GPU 尝试 | 写入 .writing 临时文件 |
记录 stderr 摘要和错误分类 |
| 判断能否降级 | 仅对编码器不可用、设备不可用等环境错误降级 | 内容损坏、路径错误不应换 CPU 重跑 |
| 创建 CPU 尝试 | 使用新临时文件和独立 attempt_no | 保留 GPU 失败记录 |
| ffprobe 验收 | 检查流、时长、分辨率、大小 | 失败文件不进入正式目录 |
| 原子提交 | 移动为正式交付文件并登记 READY |
只有一个最终版本可供下游读取 |
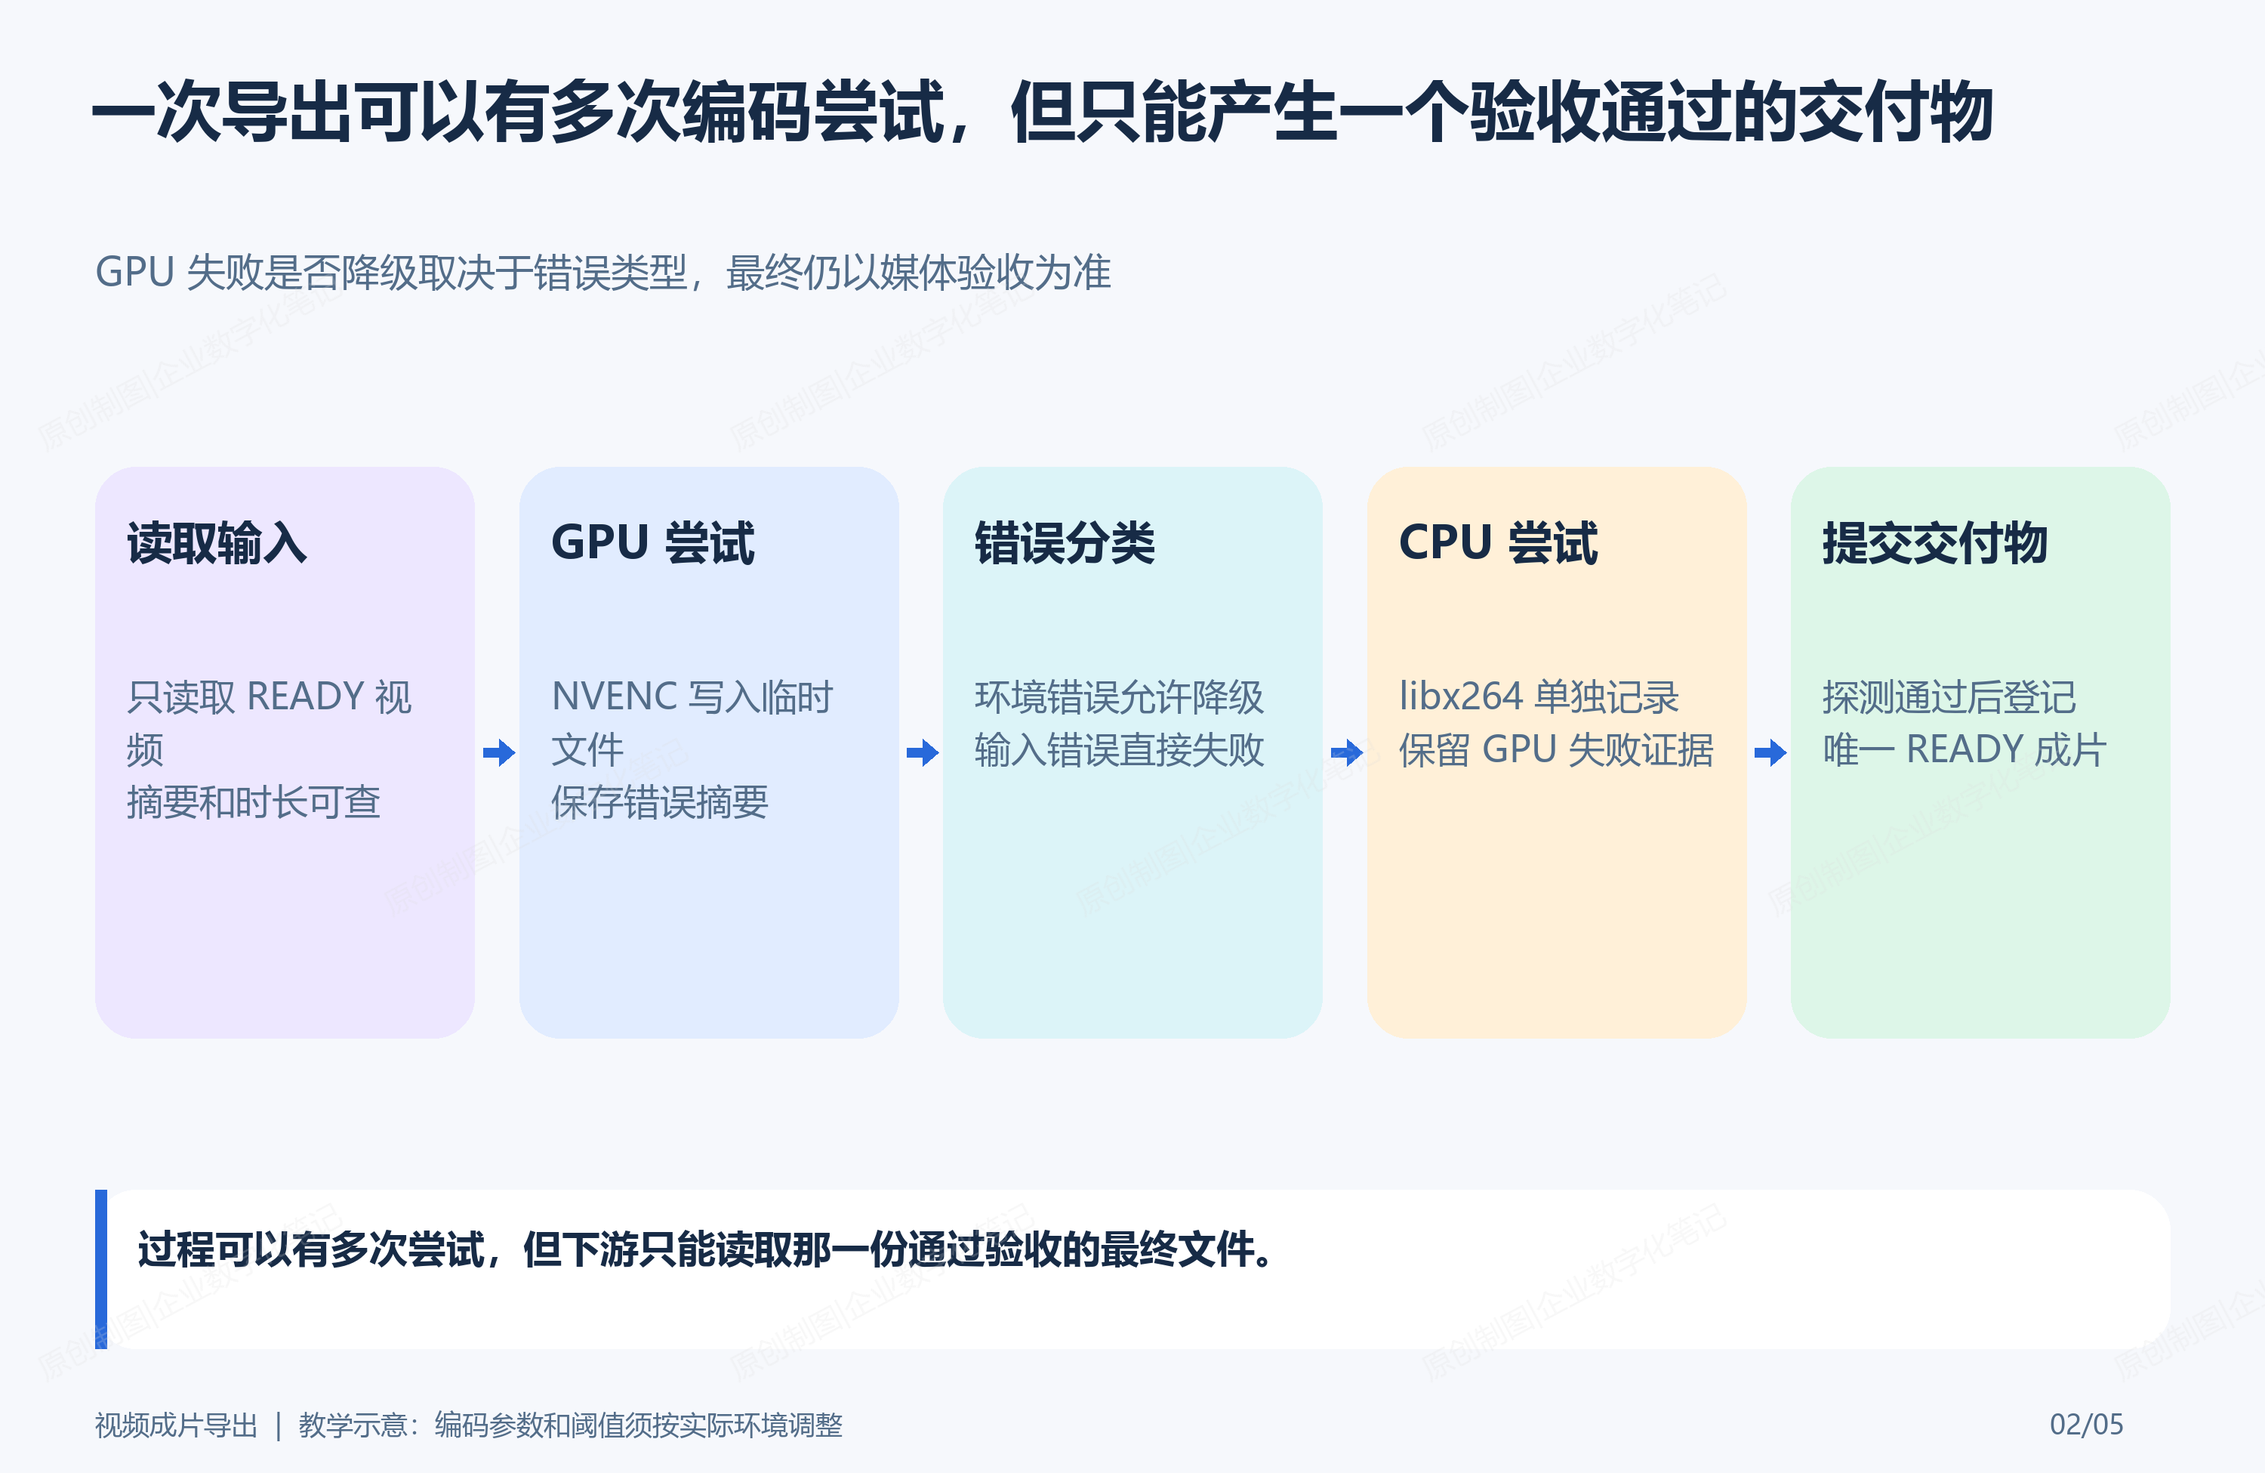
图2:GPU 失败并不等于任务失败;是否降级取决于错误类型,最终仍以媒体验收为准。
把编码速度、预设参数、显卡型号等细节都塞进"最终文件"表会混淆事实。最终成片回答"交付了什么",尝试记录回答"过程发生了什么"。
四、数据模型:尝试记录与最终成片分开保存
sql
CREATE TABLE video_export_attempt (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  export_job_id BIGINT NOT NULL,
  attempt_no INT NOT NULL,
  encoder VARCHAR(32) NOT NULL,
  preset_name VARCHAR(32) NULL,
  attempt_status VARCHAR(24) NOT NULL,
  temporary_path VARCHAR(500) NULL,
  duration_ms BIGINT NULL,
  exit_code INT NULL,
  error_code VARCHAR(64) NULL,
  error_summary VARCHAR(1200) NULL,
  started_at DATETIME NOT NULL,
  finished_at DATETIME NULL,
  UNIQUE KEY uk_export_attempt (export_job_id, attempt_no),
  CHECK (attempt_status IN ('RUNNING', 'SUCCEEDED', 'FAILED'))
);

CREATE TABLE video_export_job (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  job_no VARCHAR(64) NOT NULL,
  source_file_id BIGINT NOT NULL,
  selected_attempt_id BIGINT NULL,
  export_status VARCHAR(24) NOT NULL,
  output_path VARCHAR(500) NULL,
  output_sha256 CHAR(64) NULL,
  output_duration_ms BIGINT NULL,
  output_width INT NULL,
  output_height INT NULL,
  output_size BIGINT NULL,
  request_id VARCHAR(64) NOT NULL,
  create_time DATETIME NOT NULL,
  update_time DATETIME NULL,
  UNIQUE KEY uk_export_request (request_id),
  CHECK (export_status IN ('PENDING', 'RUNNING', 'READY', 'FAILED'))
);
selected_attempt_id 只指向通过媒体探测的一次尝试。这样既能保留 GPU 失败和 CPU 成功的完整上下文,也能保证下游只读取一个 READY 成片。
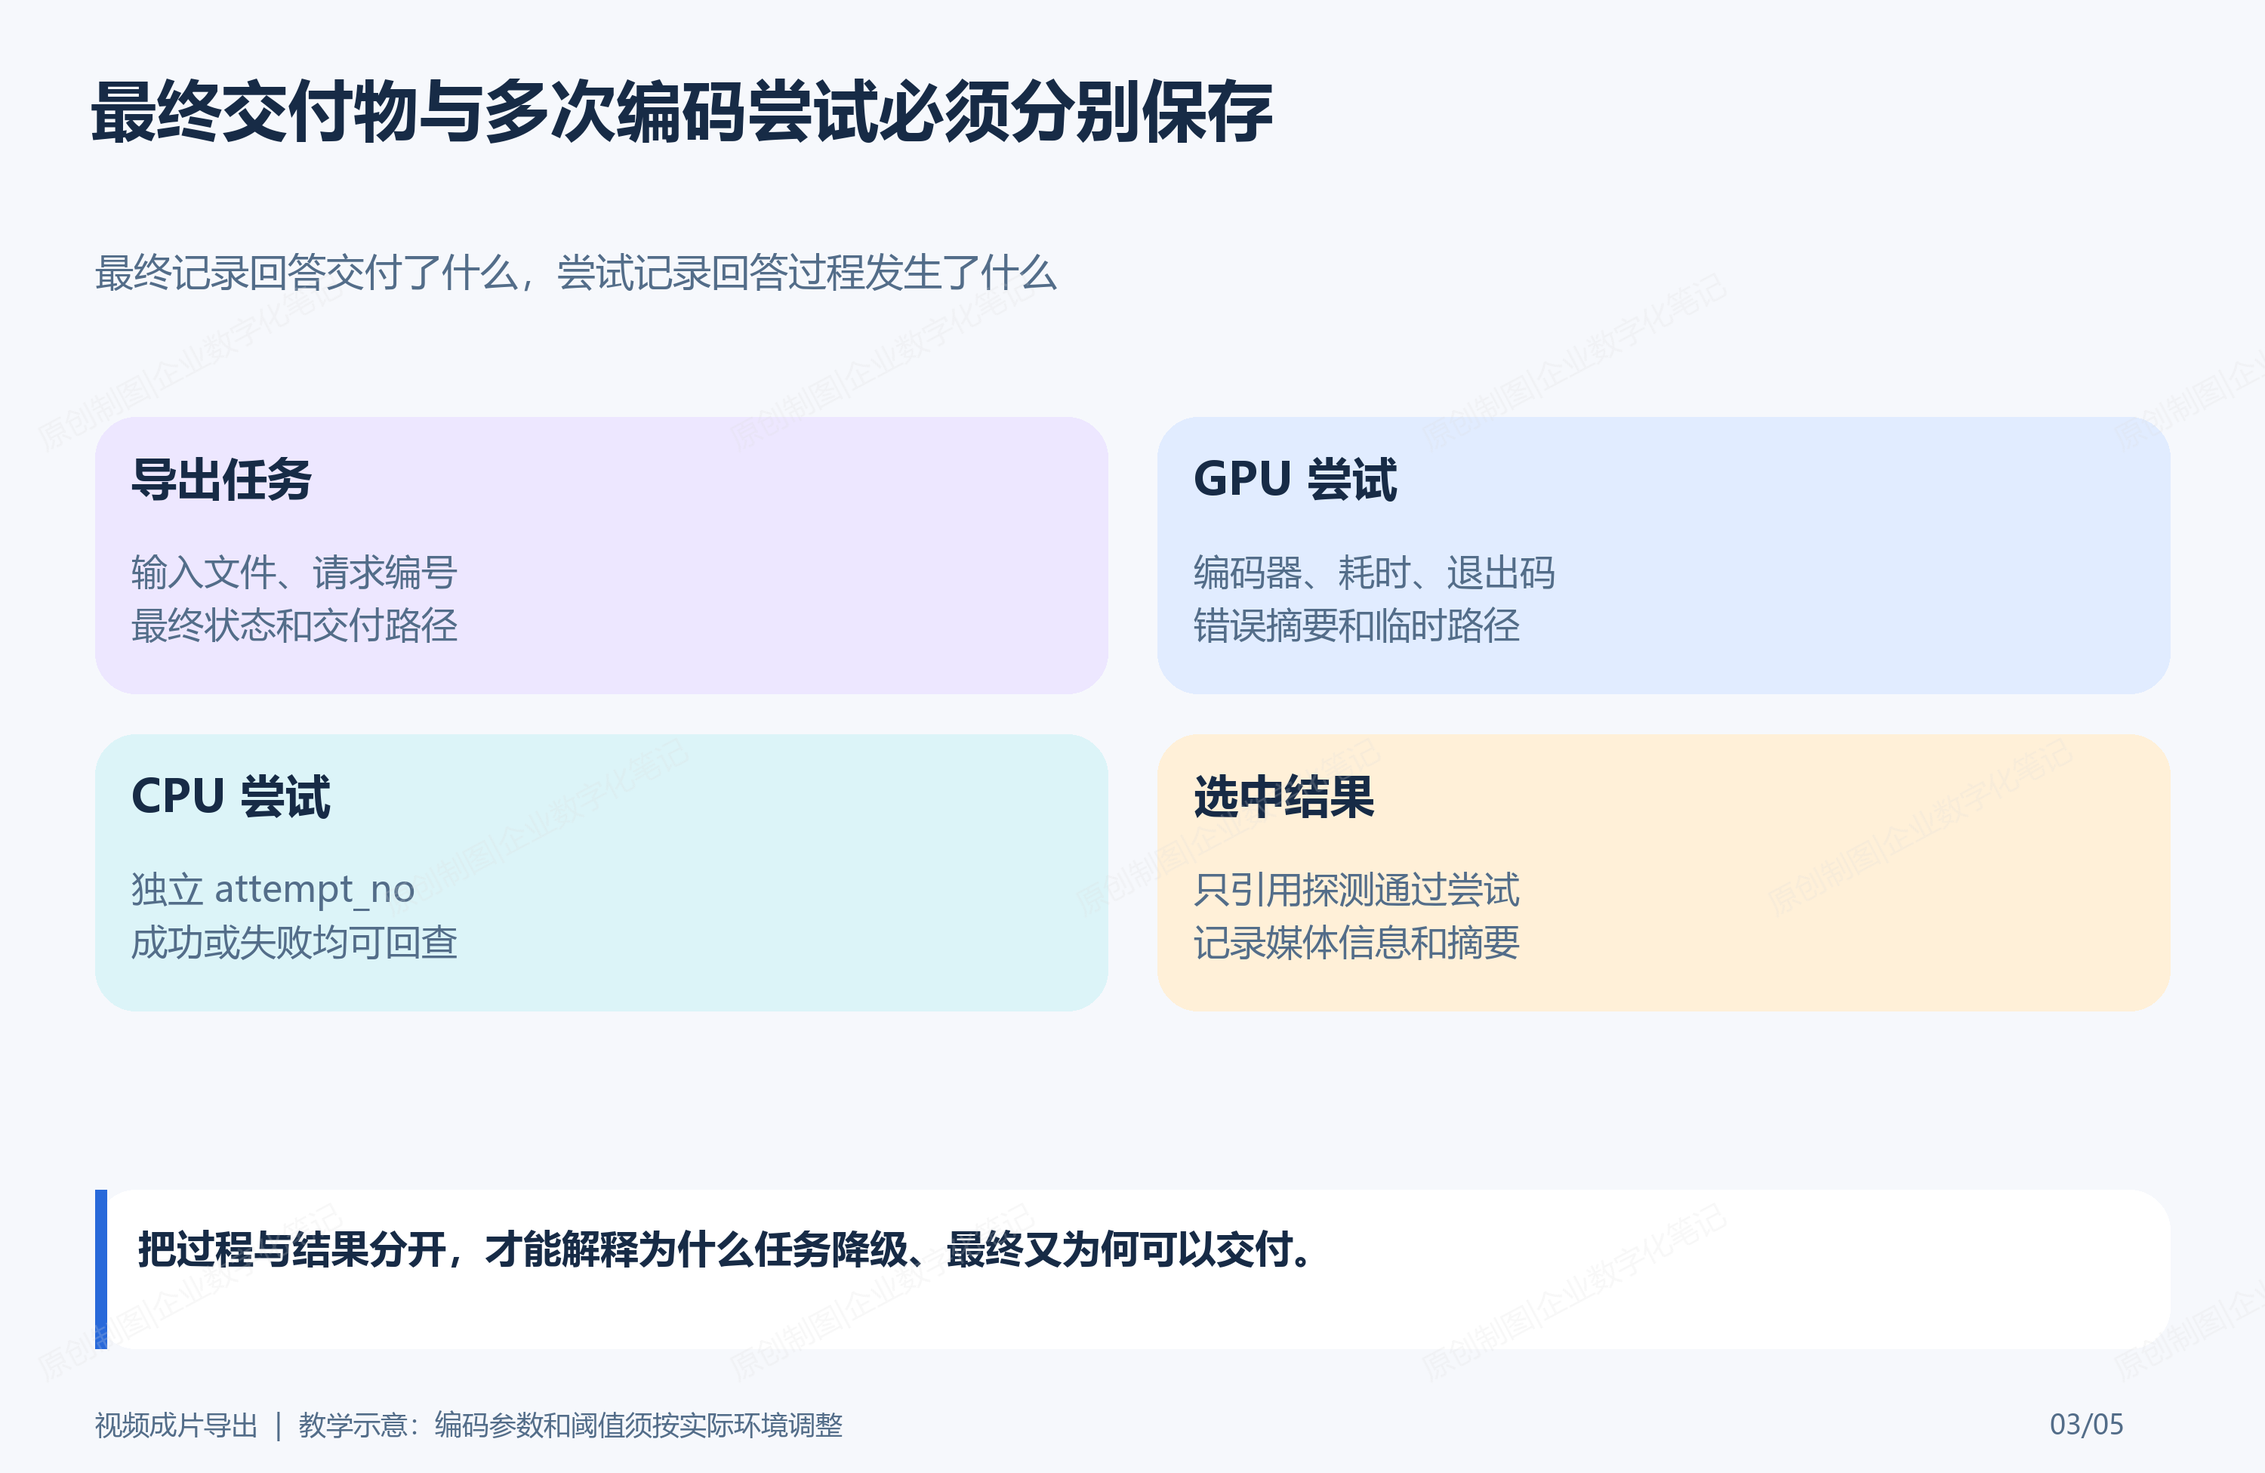
图3:最终交付记录只引用验收通过的一次尝试,所有失败仍可回查。
五、Python实现:有条件地降级,而不是盲目重试
Worker 将 FFmpeg 输出转换成有限的错误类型,再决定是否使用 CPU。下面示例只把明确的 GPU 环境错误列为可降级;输入文件不存在、滤镜参数错误等问题必须直接失败。
python
from dataclasses import dataclass
from pathlib import Path
import subprocess

FALLBACK_MARKERS = ("No NVENC capable devices found", "Cannot load libcuda", "Unknown encoder 'h264_nvenc'")

@dataclass(frozen=True)
class EncodeProfile:
    encoder: str
    extra: list[str]

GPU = EncodeProfile("h264_nvenc", ["-preset", "p4", "-cq", "23"])
CPU = EncodeProfile("libx264", ["-preset", "medium", "-crf", "20"])

def run_encode(input_path: Path, output_path: Path, profile: EncodeProfile) -> tuple[bool, str]:
    temporary = output_path.with_suffix(output_path.suffix + f".{profile.encoder}.writing")
    command = ["ffmpeg", "-y", "-i", str(input_path), "-c:v", profile.encoder,
               *profile.extra, "-c:a", "aac", "-movflags", "+faststart", str(temporary)]
    result = subprocess.run(command, capture_output=True, text=True, timeout=1800)
    return result.returncode == 0, result.stderr[-1600:]

def export_with_fallback(input_path: Path, output_path: Path):
    ok, detail = run_encode(input_path, output_path, GPU)
    if ok:
        return "h264_nvenc", detail
    if not any(marker in detail for marker in FALLBACK_MARKERS):
        raise RuntimeError(f"GPU 编码失败且不允许降级:{detail}")
    ok, detail = run_encode(input_path, output_path, CPU)
    if not ok:
        raise RuntimeError(f"CPU 编码也失败:{detail}")
    return "libx264", detail
实际 Worker 还需要在每次尝试后执行 ffprobe,把时长、分辨率、流数量和文件大小作为结构化结果返回。临时文件直到验收通过前都不移动为 lesson-final.mp4。
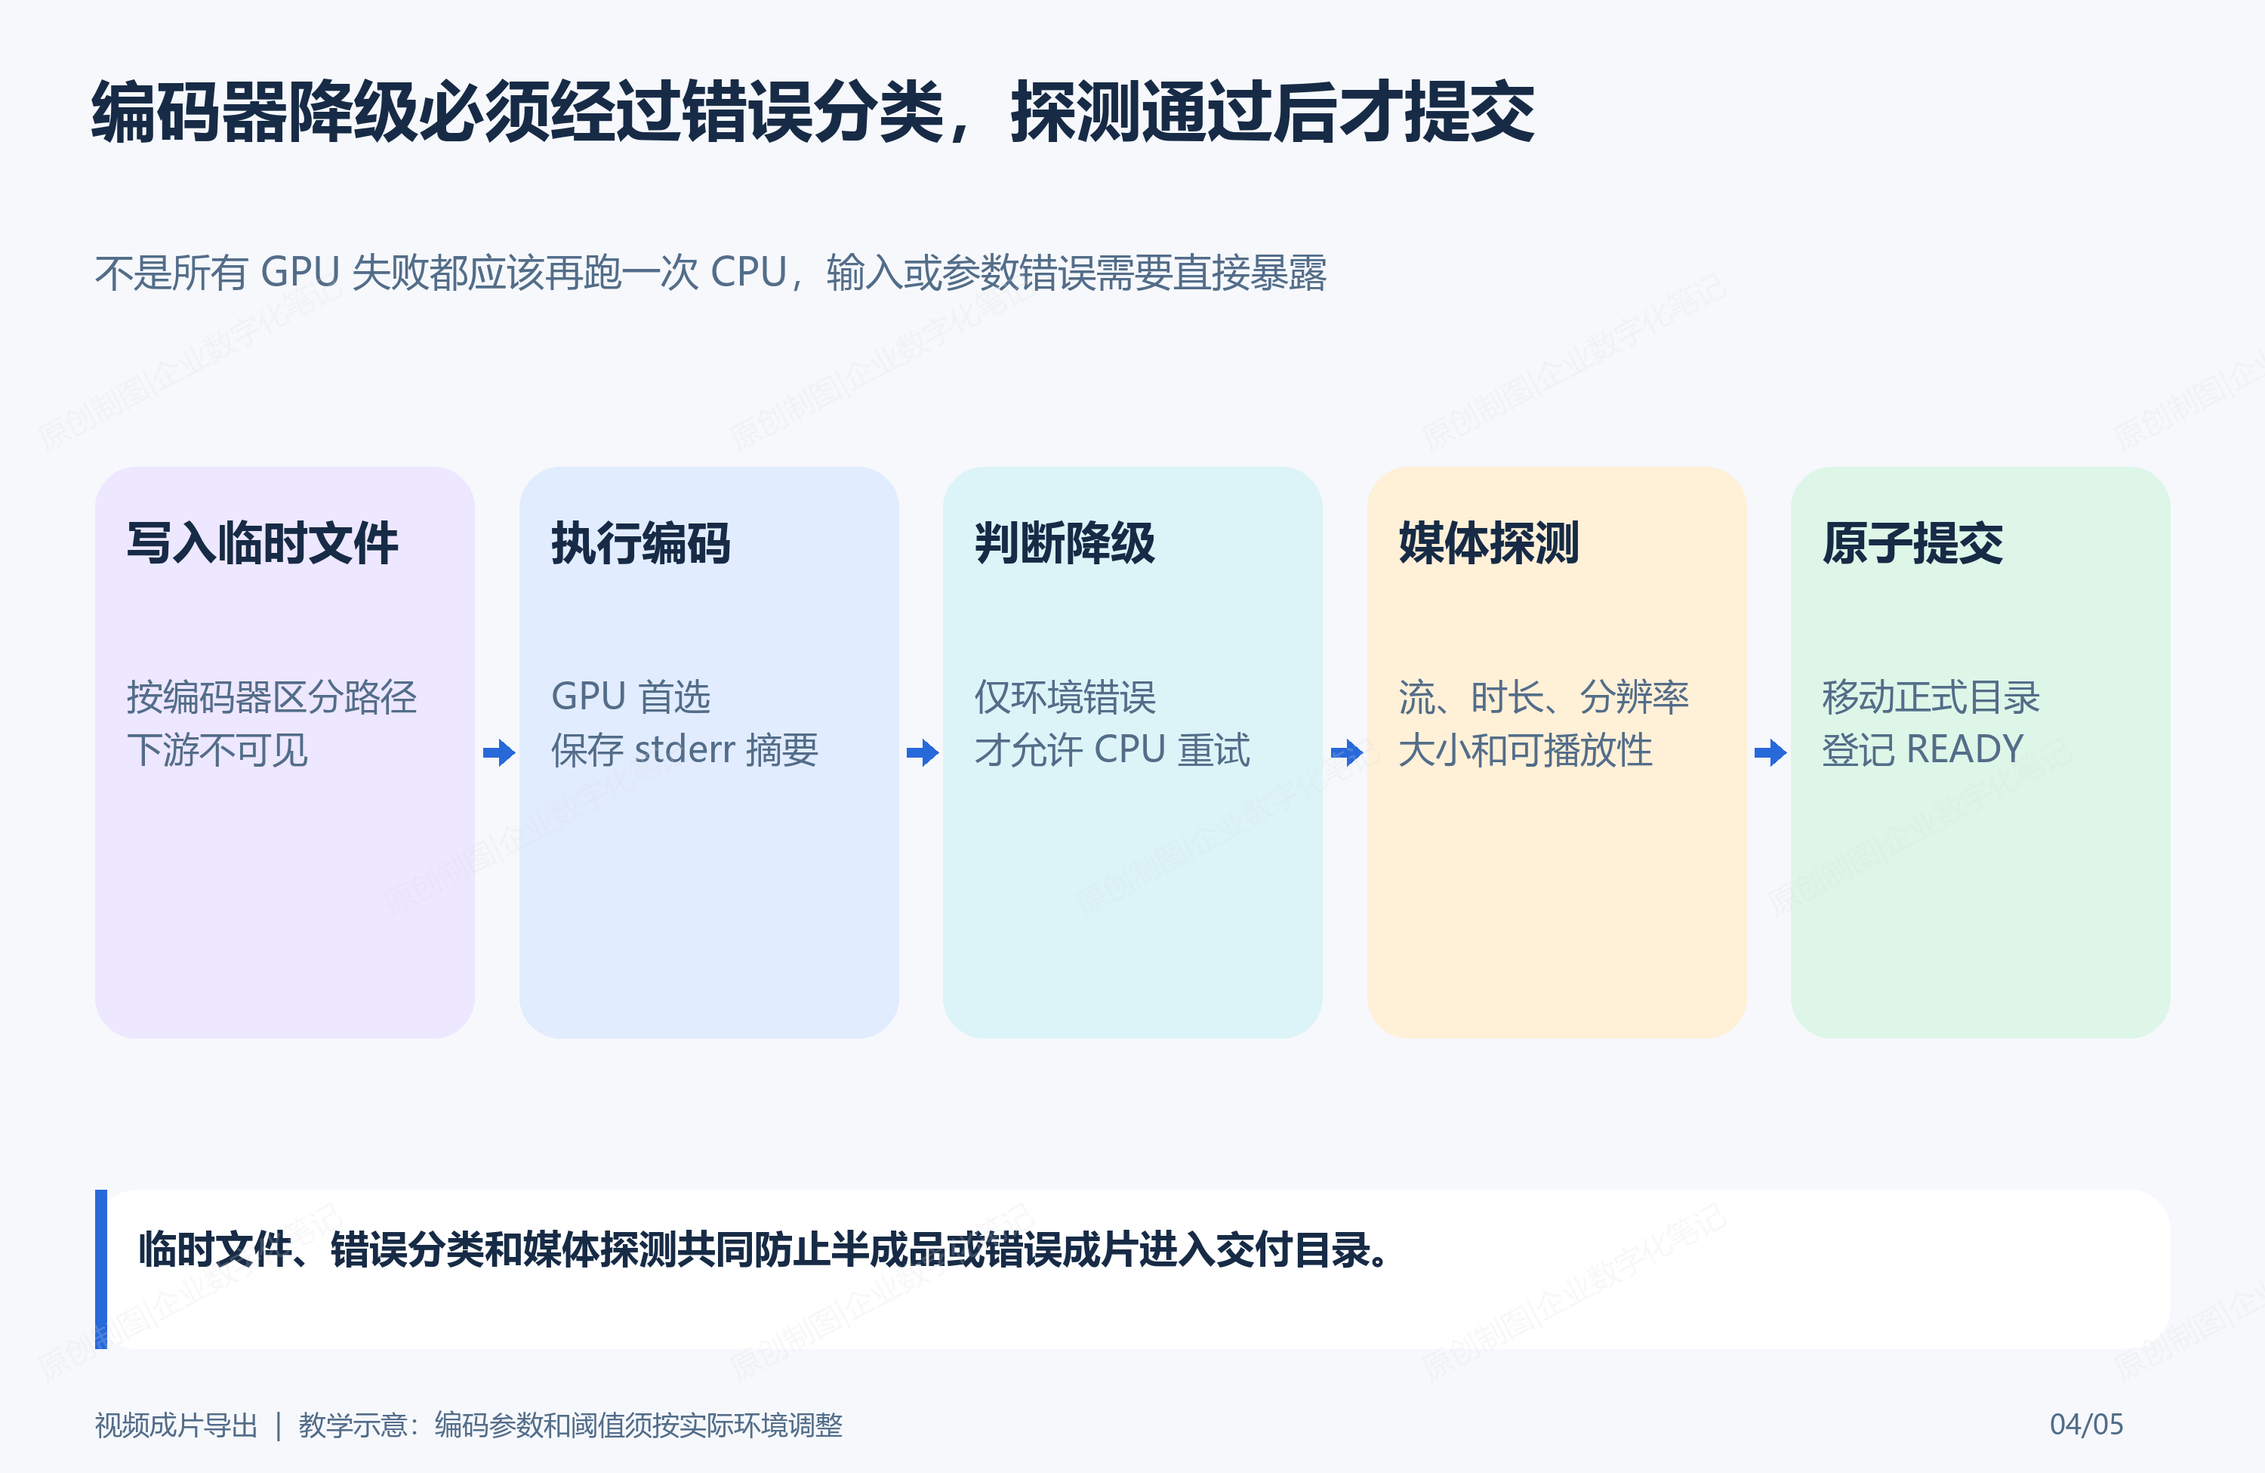
图4:降级是受控策略,不是对任何失败都再跑一次 CPU;临时文件必须先通过媒体探测。
六、Java实现:媒体验收通过才提交
Java 服务层负责幂等、输入状态和最终提交。Worker 只报告编码尝试与探测结果,不能自行把文件登记为可交付:
java
@Transactional(rollbackFor = Exception.class)
public ExportResult export(ExportCommand command) {
    VideoExportJob job = exportRepository.lockByRequestId(command.requestId())
            .orElseGet(() -> exportRepository.createPending(command));
    if ("READY".equals(job.status())) return ExportResult.reused(job.outputPath());

    WorkflowFile input = fileRepository.findReady(command.sourceFileId())
            .orElseThrow(() -> new BizException("预览视频不可用"));
    exportRepository.markRunning(job.id());

    WorkerExportResult workerResult = exportWorker.export(input.path(), command.requestId());
    workerResult.attempts().forEach(item -> attemptRepository.save(job.id(), item));
    if (!workerResult.success()) {
        exportRepository.markFailed(job.id(), workerResult.errorCode());
        return ExportResult.failed(workerResult.errorCode());
    }
    MediaInfo media = workerResult.mediaInfo();
    if (!media.playable() || media.videoStreams() != 1 || media.audioStreams() < 1
            || Math.abs(media.durationMs() - input.durationMs()) > 1500 || media.fileSize() < 1_000_000) {
        exportRepository.markFailed(job.id(), "MEDIA_VALIDATION_FAILED");
        return ExportResult.failed("MEDIA_VALIDATION_FAILED");
    }
    String outputPath = fileRepository.commitTemporary(workerResult.temporaryPath(), "DELIVERY_VIDEO");
    exportRepository.markReady(job.id(), workerResult.selectedAttemptId(), outputPath, media);
    return ExportResult.ready(outputPath, workerResult.encoder());
}
这个服务方法刻意没有"GPU 失败就自己改参数"的逻辑:编码策略属于 Worker 的媒体领域,服务层只验证输入、保存证据和决定是否提交。职责分开后,错误排查不会变成一团命令字符串。
七、预期输出和自动测试
text
第一次尝试:h264_nvenc,FAILED,error_code = GPU_ENCODER_UNAVAILABLE
第二次尝试:libx264,SUCCEEDED
最终成片:lesson-final.mp4,1920x1080,时长 93.2 秒左右,H.264 视频 + AAC 音频
交付状态:READY,selected_attempt_id 指向第二次尝试
python
def test_only_gpu_environment_errors_allow_cpu_fallback():
    assert any(marker in "Cannot load libcuda" for marker in FALLBACK_MARKERS)
    assert not any(marker in "No such file or directory" for marker in FALLBACK_MARKERS)

def test_temporary_path_contains_encoder_name(tmp_path):
    target = tmp_path / "lesson-final.mp4"
    assert target.with_suffix(".mp4.h264_nvenc.writing").name.endswith(".writing")
java
@Test
void shouldCommitCpuOutputAfterGpuUnavailable() {
    fixture.readyVideo(100L, 93_200L);
    worker.stubGpuUnavailableThenCpuSuccess(93_180L, 1920, 1080, 2_400_000L);

    ExportResult result = service.export(new ExportCommand("REQ-006", 100L));

    assertTrue(result.success());
    assertEquals("libx264", result.encoder());
    assertEquals(2, attemptRepository.countFor(result.jobId()));
}

@Test
void shouldRejectPlayableFileWithWrongDuration() {
    fixture.readyVideo(100L, 93_200L);
    worker.stubSuccess(89_000L, 1920, 1080, 2_400_000L);

    ExportResult result = service.export(new ExportCommand("REQ-007", 100L));

    assertEquals("MEDIA_VALIDATION_FAILED", result.errorCode());
}
八、SQL验证:怎样发现异常交付物
sql
-- READY 成片必须关联一条成功尝试,预期结果为空
SELECT j.job_no, j.output_path
FROM video_export_job j
LEFT JOIN video_export_attempt a ON a.id = j.selected_attempt_id
WHERE j.export_status = 'READY'
  AND (a.id IS NULL OR a.attempt_status <> 'SUCCEEDED');

-- 查超过 30 分钟仍未结束的导出任务
SELECT job_no, update_time
FROM video_export_job
WHERE export_status = 'RUNNING'
  AND update_time < DATE_SUB(NOW(), INTERVAL 30 MINUTE);

-- 查 GPU 失败后又重复 GPU 尝试、却没有 CPU 尝试的任务
SELECT export_job_id
FROM video_export_attempt
GROUP BY export_job_id
HAVING SUM(encoder = 'h264_nvenc' AND attempt_status = 'FAILED') > 1
   AND SUM(encoder = 'libx264') = 0;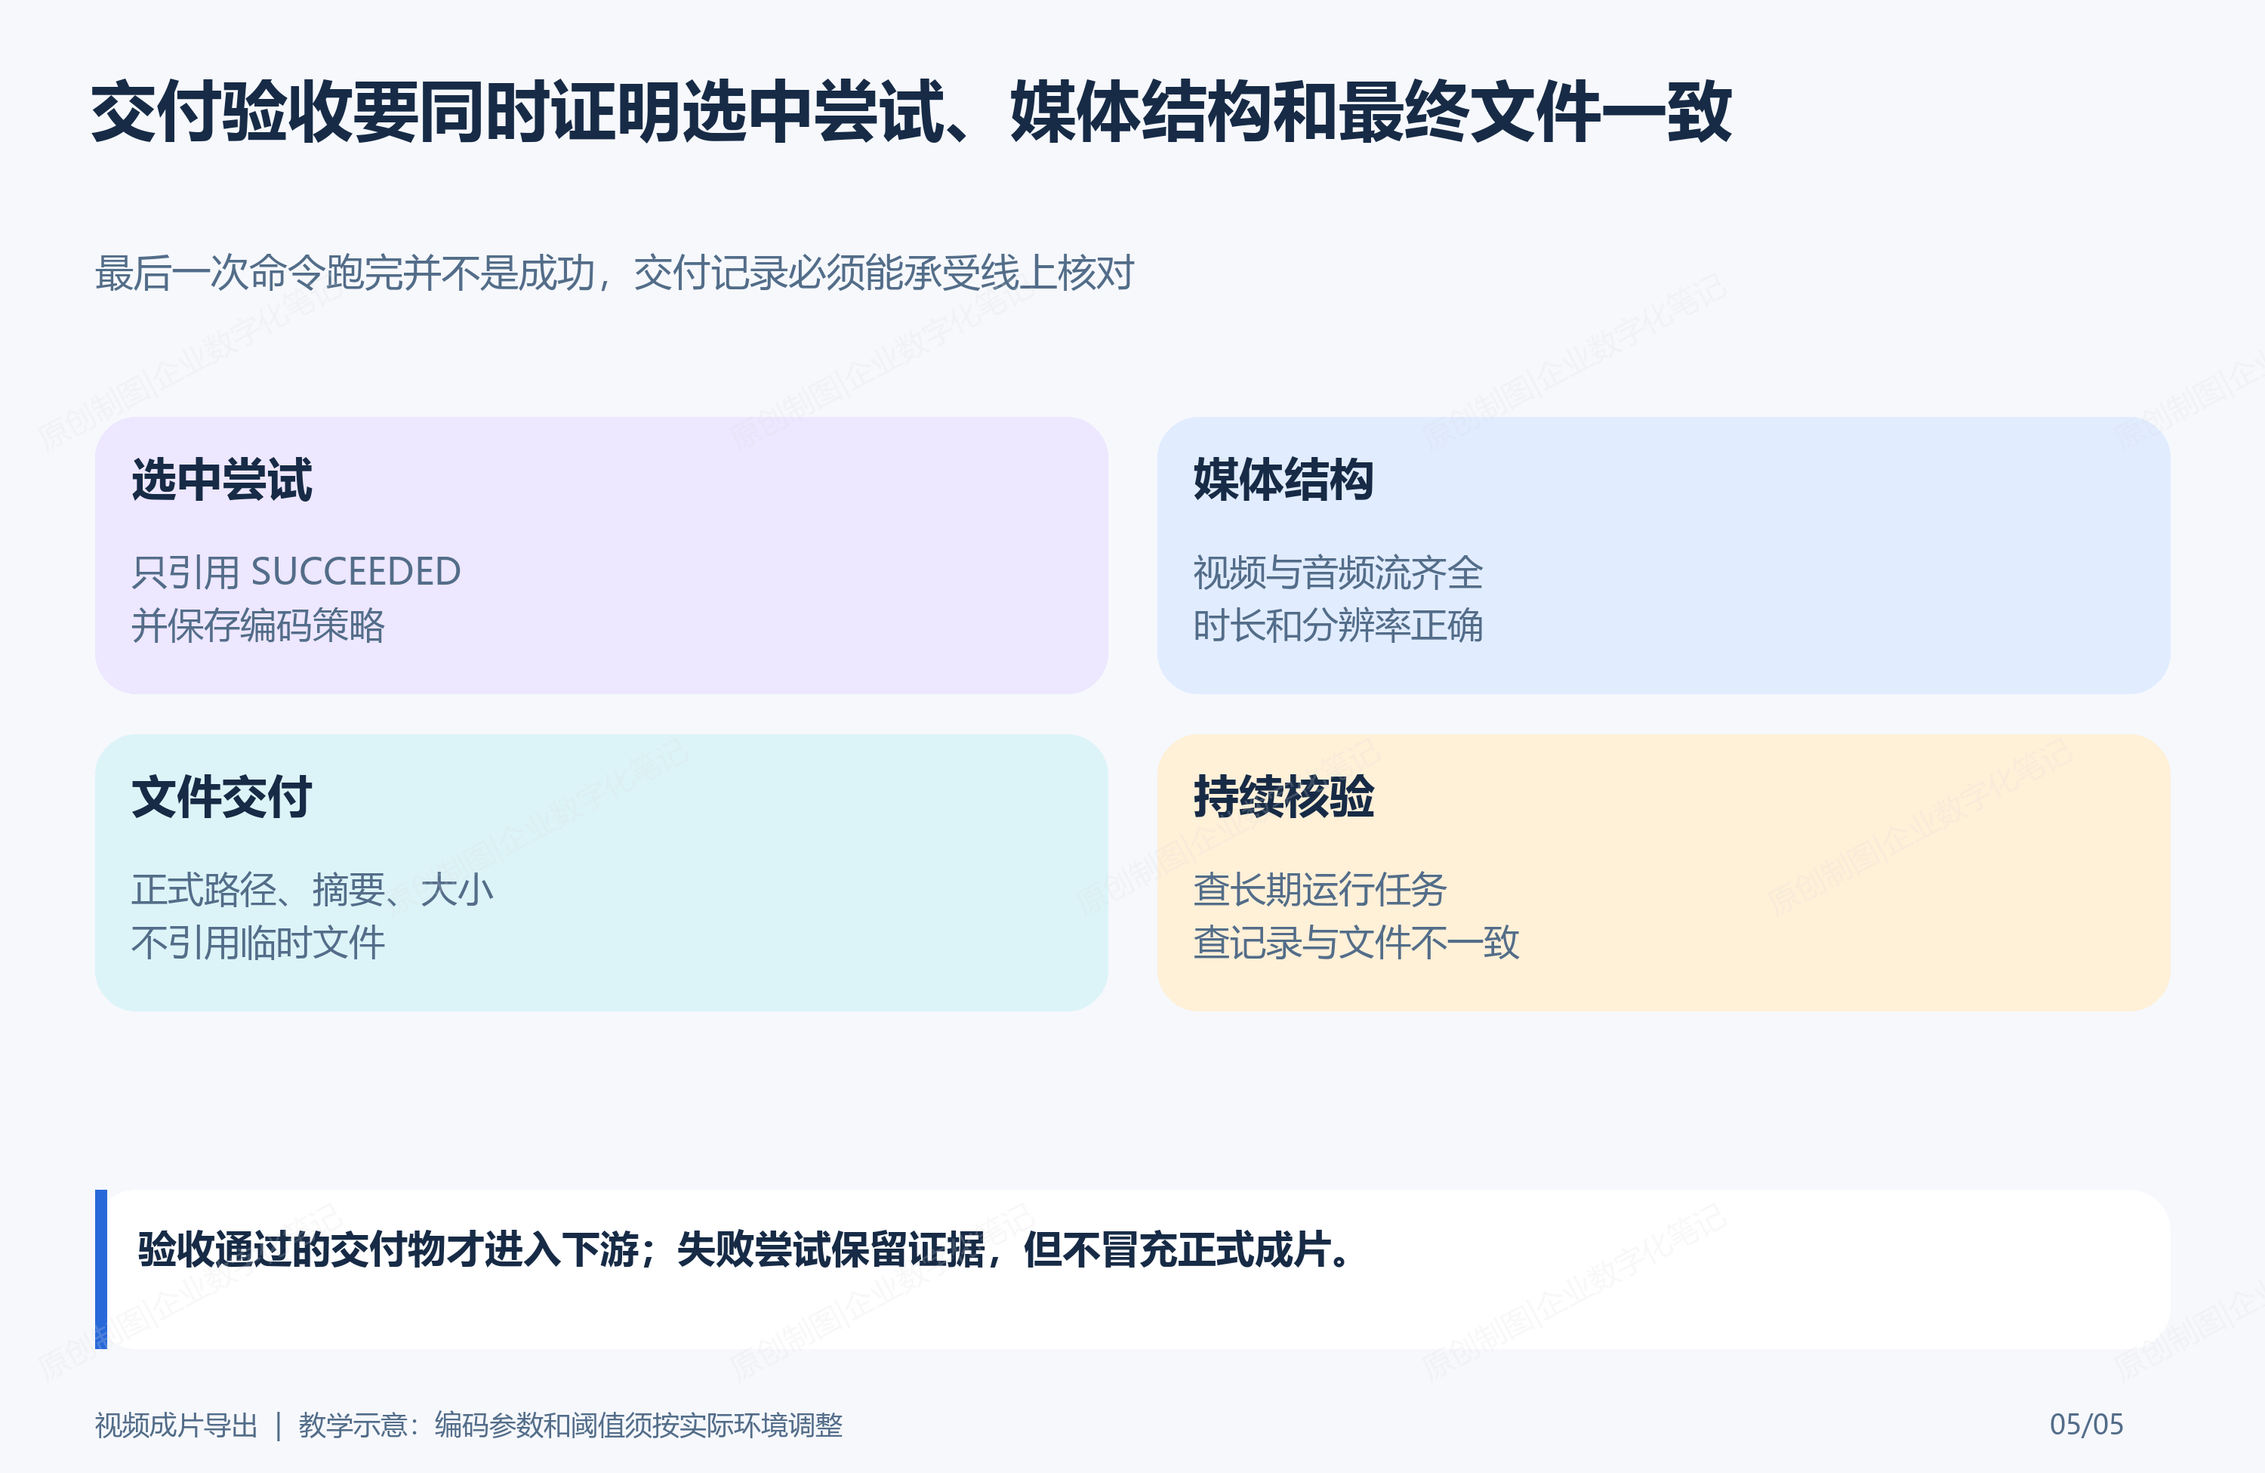
图5:最终交付不是"最后一次命令跑完",而是成功尝试、媒体探测和正式文件三者一致。
九、异常边界和上线验收
| 异常 | 应对方式 |
|---|---|
| GPU 不可用或编码器未安装 | 记录环境错误,允许一次 CPU 降级 |
| 输入文件损坏、路径不存在 | 直接失败,不进行 CPU 降级 |
| CPU 导出超时 | 标记超时,保留尝试摘要,允许从输入重新发起 |
| 半成品文件遗留 | 只写入临时目录;定时清理未被任务引用的旧临时文件 |
| 只含视频或只含音频 | 媒体探测失败,不进入交付目录 |
| 时长、分辨率、大小异常 | 标记验收失败,保留证据供定位 |
| 重复请求 | 按 request_id 复用 READY 结果或返回正在执行状态 |
上线前至少验证:GPU 可用时能选中 GPU 尝试;GPU 不可用时仅降级一次 CPU;输入问题不会触发无意义降级;失败文件不会成为 DELIVERY_VIDEO;SQL 能查出卡住任务和不一致的最终记录。
十、小结和延伸阅读
稳定导出视频的关键不在于永远使用最快的编码器,而在于把编码选择、失败分类、CPU 降级、临时文件和媒体探测放进同一条证据链。GPU 是性能优化,CPU 是受控兜底;只有验收通过的 MP4 才是交付物。