做视觉智能体时,最容易出现的两个极端是:看到视频就想上大模型,或者一开始就把所有需求塞进一个 YOLO 推理循环。前者成本高且不可控,后者又会把"识别出一个框""计算一次越线""替换一块画面"混成同一件事,后续很难解释误差从哪里来。
视觉智能体不是某一个模型,它是一条把图像或视频变成可交付结果的链路。本文用三个脱敏需求做技术选型:道路视频统计车辆通行次数、固定机位视频替换指定颜色区域、导出可播放的标注或合成视频。它们都读视频,却需要不同的核心能力。
示例环境为 Python 3、OpenCV、YOLO 类检测器、可替换的跟踪器和 FFmpeg。文章只讨论技术职责、最小实现和验收边界,不公开真实道路、内部模型配置、客户素材或产品编排。
目录
- 先把视觉智能体拆成五类职责
- 固定案例:三个视频需求怎么选技术
- 选型不是模型对比,而是任务约束对齐
- 数据模型:任务类型、配置与产物分开保存
- Python实现:用任务约束生成执行计划
- 服务层实现:验证计划而不是硬编码流程
- 预期输出和自动测试
- SQL验证:配置和产物有没有对错任务
- 边界、误差和上线验收
- 小结和延伸阅读
一、先把视觉智能体拆成五类职责
一条视频任务通常同时包含文件读取、画面理解、时序关联、像素处理和视频交付,但它们不应由同一个组件"包打天下":
| 职责 | 要回答的问题 | 常用技术 | 不应承担的事 |
|---|---|---|---|
| 媒体输入输出 | 视频能否读取、结果能否播放 | FFmpeg、OpenCV VideoCapture/VideoWriter | 判断画面里有什么 |
| 目标检测 | 单帧中有哪些目标、在哪里 | YOLO 等检测模型 | 统计同一对象经过几次 |
| 目标跟踪 | 相邻帧是否为同一对象 | 跟踪器、运动关联 | 精确抠出头发或布料边缘 |
| 像素分割与合成 | 哪些像素需要保留、替换或修复 | HSV、形态学、掩膜、图像混合 | 推断车辆方向或身份 |
| 规则与验收 | 什么结果算业务完成 | 几何规则、唯一约束、媒体探测、人工抽检 | 替模型伪造准确率 |
例如,车流统计使用"检测 + 跟踪 + 越线规则";指定颜色区域替换通常先用 HSV 阈值和形态学处理;最终视频无论来自哪条算法链,都要经过媒体探测和文件交付。模型只是视觉智能体的一部分。
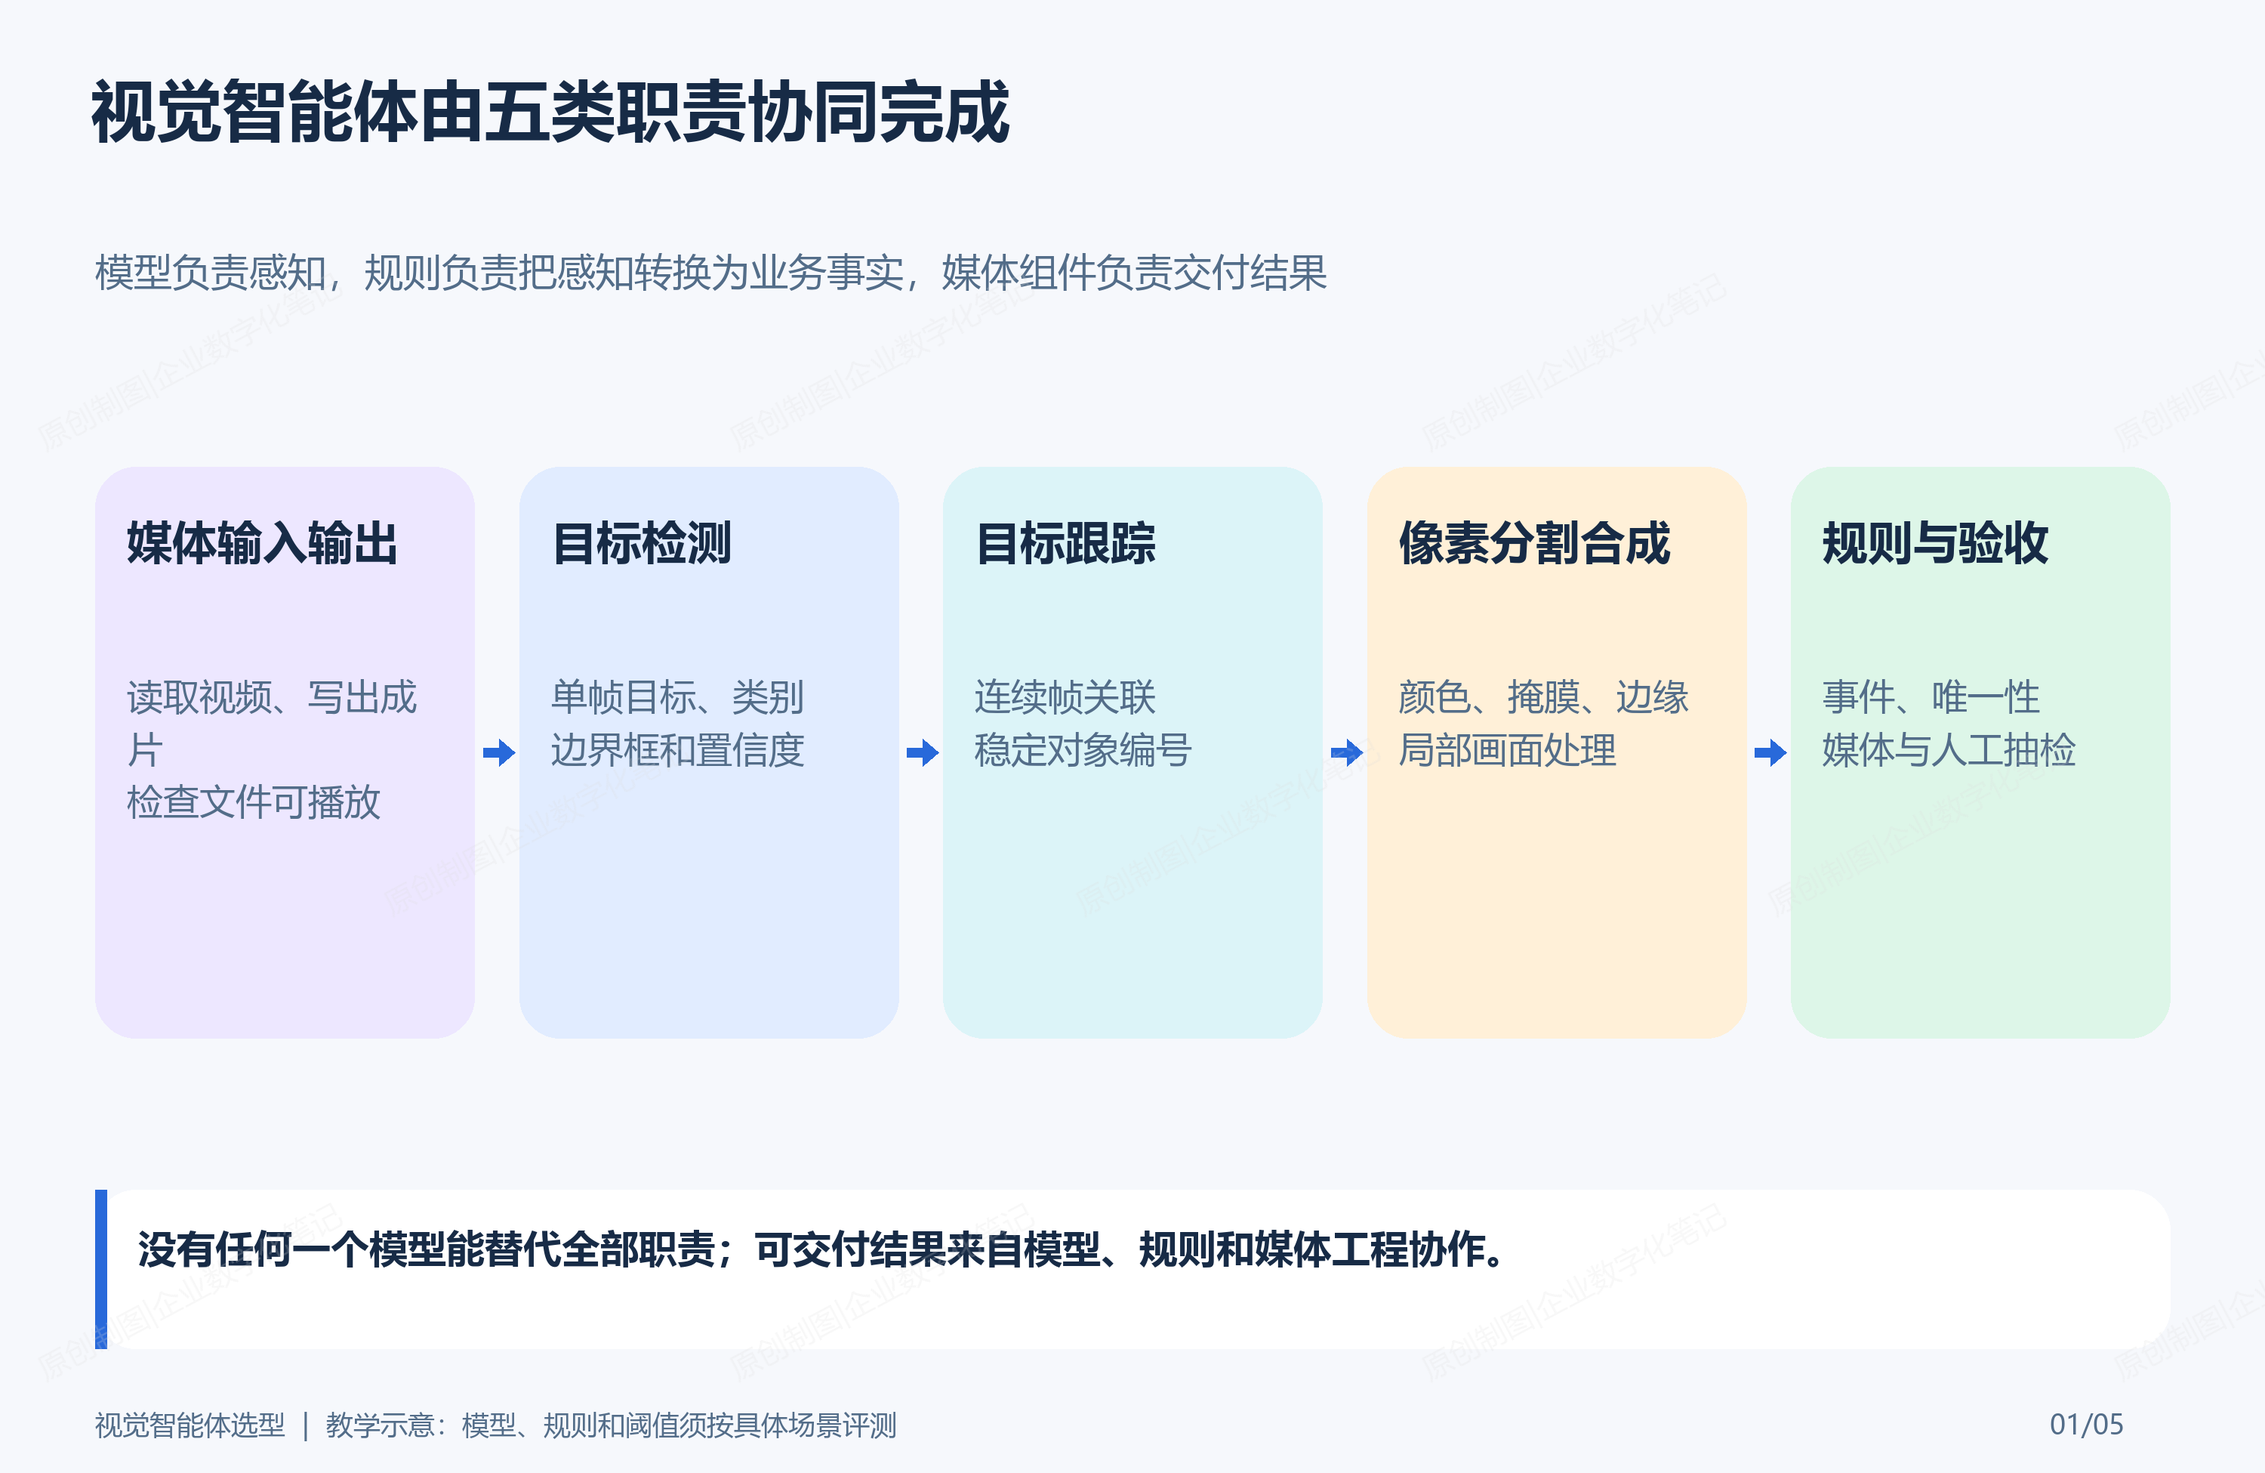
图1:模型负责感知,规则负责把感知转换为业务事实,媒体组件负责让输入与结果可交付。
二、固定案例:三个视频需求怎么选技术
为了避免"先选模型,再找问题",先固定三个真实而脱敏的需求:
text
案例 A:固定机位道路视频,统计 CAR、MOTO、BUS、BIKE 的双向越线次数。
案例 B:固定机位演示视频,用空背景替换某一种颜色布料区域。
案例 C:把 A 或 B 的处理结果导出为 MP4,供浏览器和普通播放器检查。| 案例 | 关键输入 | 核心算法 | 为什么不是另一种算法 |
|---|---|---|---|
| A 车流统计 | 连续帧、计数线、目标类别 | 检测 + 跟踪 + 几何越线 | 单帧检测无法知道是不是同一辆车 |
| B 颜色区域替换 | 空背景、颜色范围、固定机位 | HSV 分割 + 掩膜修复 + 合成 | 目标检测框不能给出细粒度像素边界 |
| C 视频交付 | 临时结果、目标格式、播放环境 | FFmpeg 编码 + ffprobe 验收 | 模型不负责编码兼容性和流信息 |
这三个案例共享任务状态、文件管理、日志和验收,但核心计算不同。技术选型的第一步不是比较"哪个模型最强",而是确认结果需要框、轨迹、像素掩膜,还是一个可以播放的媒体文件。
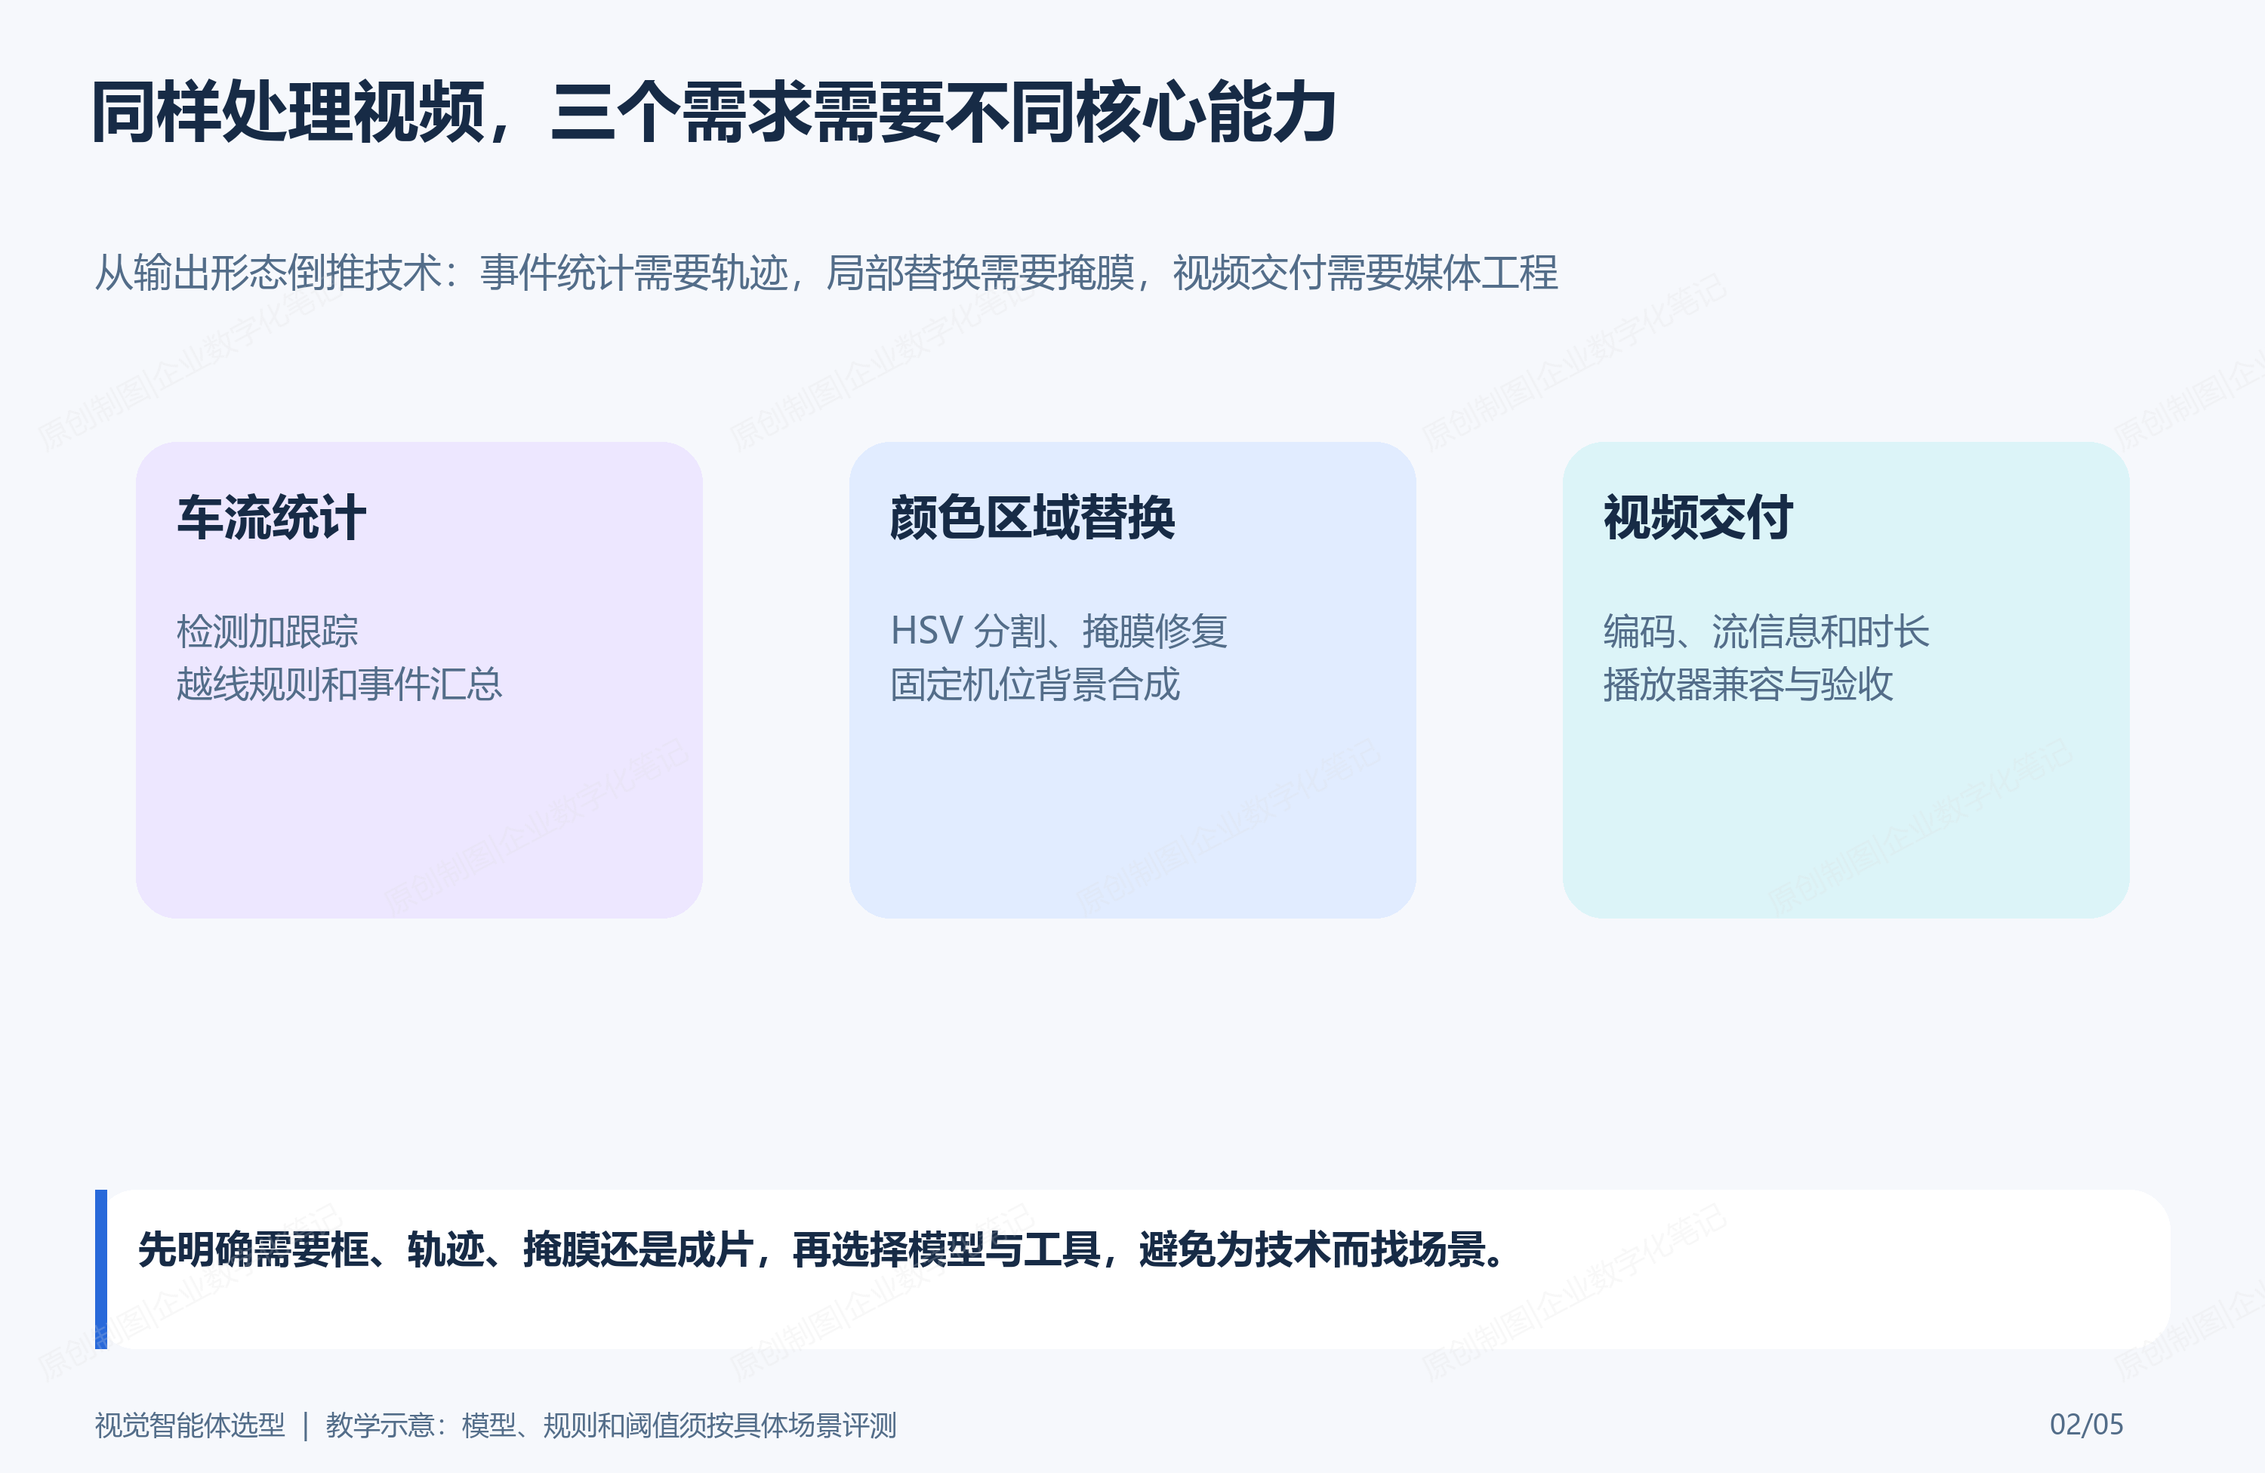
图2:选择技术要从输出形态倒推:事件统计需要轨迹,局部替换需要掩膜,视频交付需要媒体工程。
三、选型不是模型对比,而是任务约束对齐
选型前可先回答四个问题:对象是否需要跨帧保持身份?输出是否需要像素级边界?机位是否固定?结果由谁消费?答案会直接限制技术路径:
| 任务约束 | 推荐路径 | 原因 | 需要额外验收 |
|---|---|---|---|
| 需要按对象计数或判断方向 | 检测 + 跟踪 + 规则 | 需要稳定编号和前后位置 | 同一轨迹不重复计数 |
| 需要替换不规则区域 | 颜色或语义分割 + 掩膜 | 需要逐像素判断 | 边缘残留、孔洞和颜色泄漏 |
| 固定机位、颜色稳定 | 规则优先,模型兜底 | 规则更快、更可解释 | 不同光照下的阈值有效性 |
| 镜头移动、背景复杂 | 检测或分割模型 + 重新标定 | 固定坐标和背景假设失效 | 抽样人工复核 |
| 必须广泛播放 | 编码与媒体探测 | 视觉结果需要变成可靠文件 | 时长、流、分辨率和大小 |
这张表也解释了为什么视觉智能体不必处处用大模型。对于固定机位的单一颜色区域,HSV 规则往往比通用模型更快、更稳定、更容易调整;对于道路车辆跨线计数,仅有颜色规则又无法应对类别、遮挡和方向,需要检测、跟踪和几何规则协作。
四、数据模型:任务类型、配置与产物分开保存
产品不需要把每种视觉算法的内部参数暴露给所有调用者,但需要保存足够的任务事实,让一次运行可重现、可解释:
sql
CREATE TABLE visual_agent_job (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  job_no VARCHAR(64) NOT NULL,
  task_type VARCHAR(32) NOT NULL,
  source_file_key VARCHAR(500) NOT NULL,
  config_version VARCHAR(64) NOT NULL,
  job_status VARCHAR(24) NOT NULL,
  output_file_key VARCHAR(500) NULL,
  output_sha256 CHAR(64) NULL,
  error_code VARCHAR(64) NULL,
  create_time DATETIME NOT NULL,
  update_time DATETIME NULL,
  UNIQUE KEY uk_visual_job_no (job_no),
  CHECK (task_type IN ('TRAFFIC_COUNT', 'COLOR_COMPOSITE', 'ANNOTATED_EXPORT')),
  CHECK (job_status IN ('PENDING', 'RUNNING', 'READY', 'FAILED'))
);

CREATE TABLE visual_agent_job_config (
  id BIGINT PRIMARY KEY AUTO_INCREMENT,
  visual_job_id BIGINT NOT NULL,
  config_kind VARCHAR(32) NOT NULL,
  config_json JSON NOT NULL,
  create_time DATETIME NOT NULL,
  UNIQUE KEY uk_visual_job_config (visual_job_id, config_kind)
);
TRAFFIC_COUNT 可以保存计数线、目标类别和置信度范围;COLOR_COMPOSITE 保存颜色阈值、背景版本和边缘扩张参数;ANNOTATED_EXPORT 保存编码与交付规则。表中保存配置版本和摘要,而不是把核心产品策略或敏感素材直接写入日志。
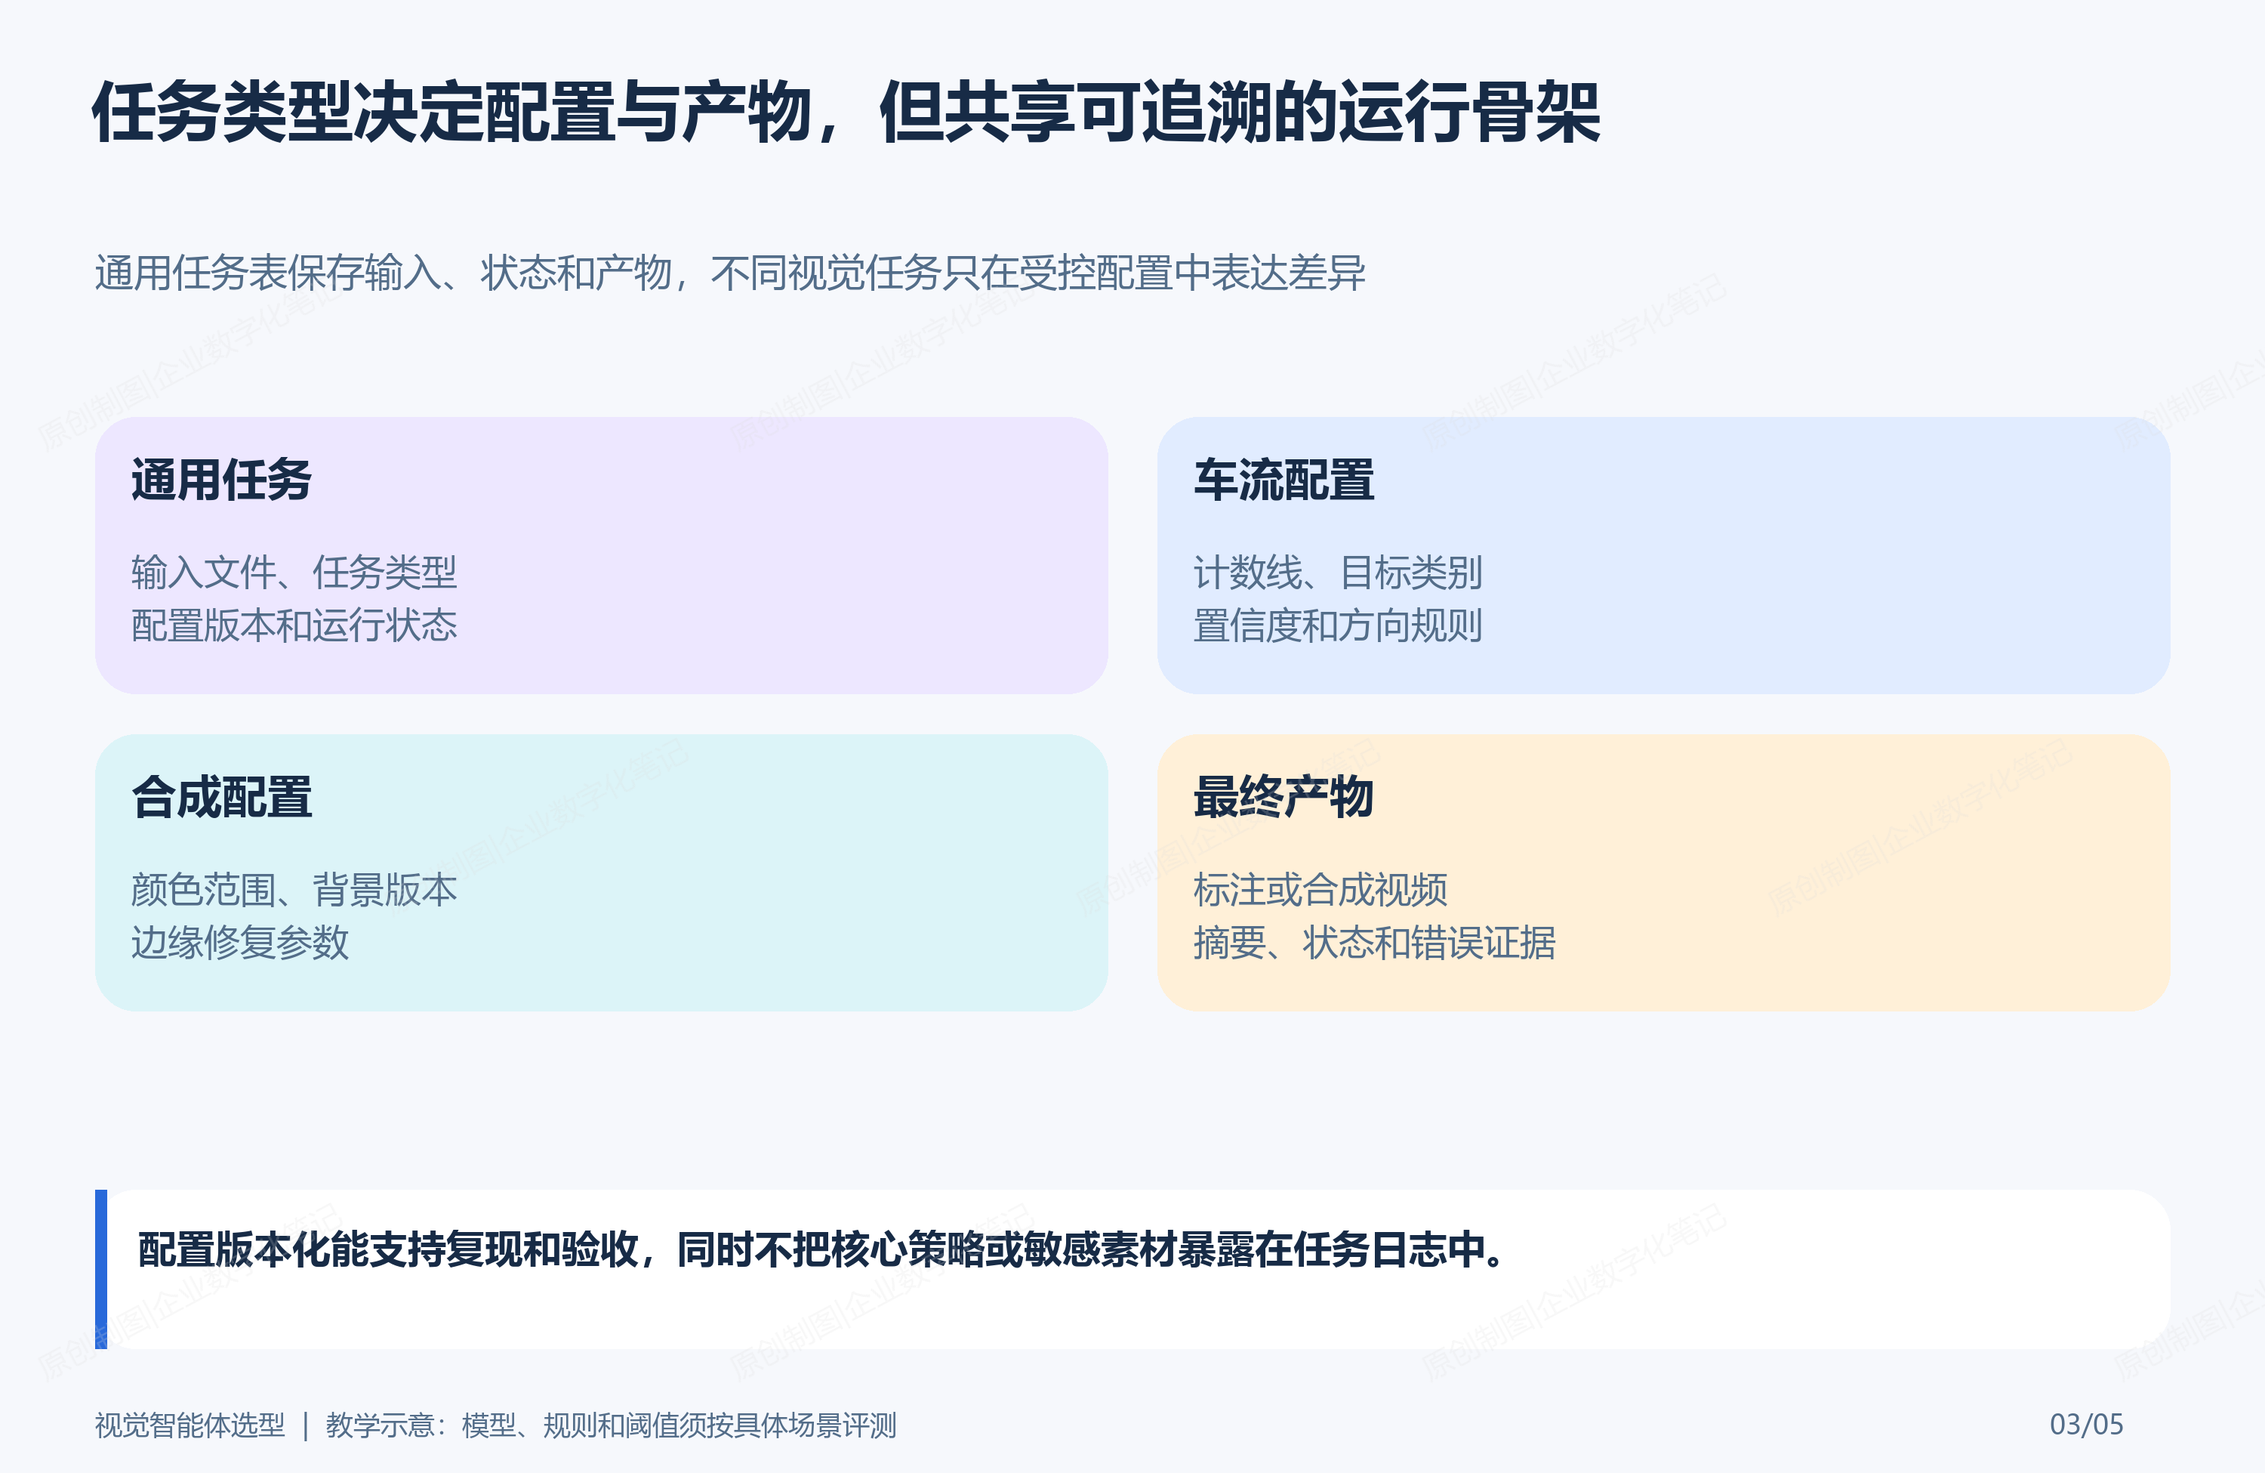
图3:通用任务表保存输入、状态和产物;不同视觉任务只在受控配置中表达差异。
五、Python实现:用任务约束生成执行计划
下面的示例没有绑定某个具体模型,只把需求转换为可审查的执行计划。这样服务层知道需要哪些能力,Worker 再按计划选择已注册的检测、跟踪、分割或编码组件:
python
from dataclasses import dataclass
from enum import Enum

class TaskType(str, Enum):
    TRAFFIC_COUNT = "TRAFFIC_COUNT"
    COLOR_COMPOSITE = "COLOR_COMPOSITE"
    ANNOTATED_EXPORT = "ANNOTATED_EXPORT"

@dataclass(frozen=True)
class VisualPlan:
    read_video: bool
    detector: bool
    tracker: bool
    pixel_mask: bool
    media_export: bool
    acceptance: tuple[str, ...]

def build_plan(task_type: TaskType, fixed_camera: bool) -> VisualPlan:
    if task_type is TaskType.TRAFFIC_COUNT:
        return VisualPlan(True, True, True, False, True,
                          ("event_unique", "summary_matches_events", "annotated_video_playable"))
    if task_type is TaskType.COLOR_COMPOSITE:
        if not fixed_camera:
            raise ValueError("颜色背景替换需要固定机位或额外的画面配准能力")
        return VisualPlan(True, False, False, True, True,
                          ("mask_non_empty", "edge_preview", "output_playable"))
    if task_type is TaskType.ANNOTATED_EXPORT:
        return VisualPlan(True, False, False, False, True,
                          ("media_playable", "duration_matches_source"))
    raise ValueError(f"不支持的视觉任务:{task_type}")
这段代码的价值不在于枚举本身,而在于把选型规则写成能测试的约束:车流统计没有跟踪就不能启动;颜色替换在机位不固定时不能假装使用同一套背景;所有对外视频都必须进入媒体导出和验收。
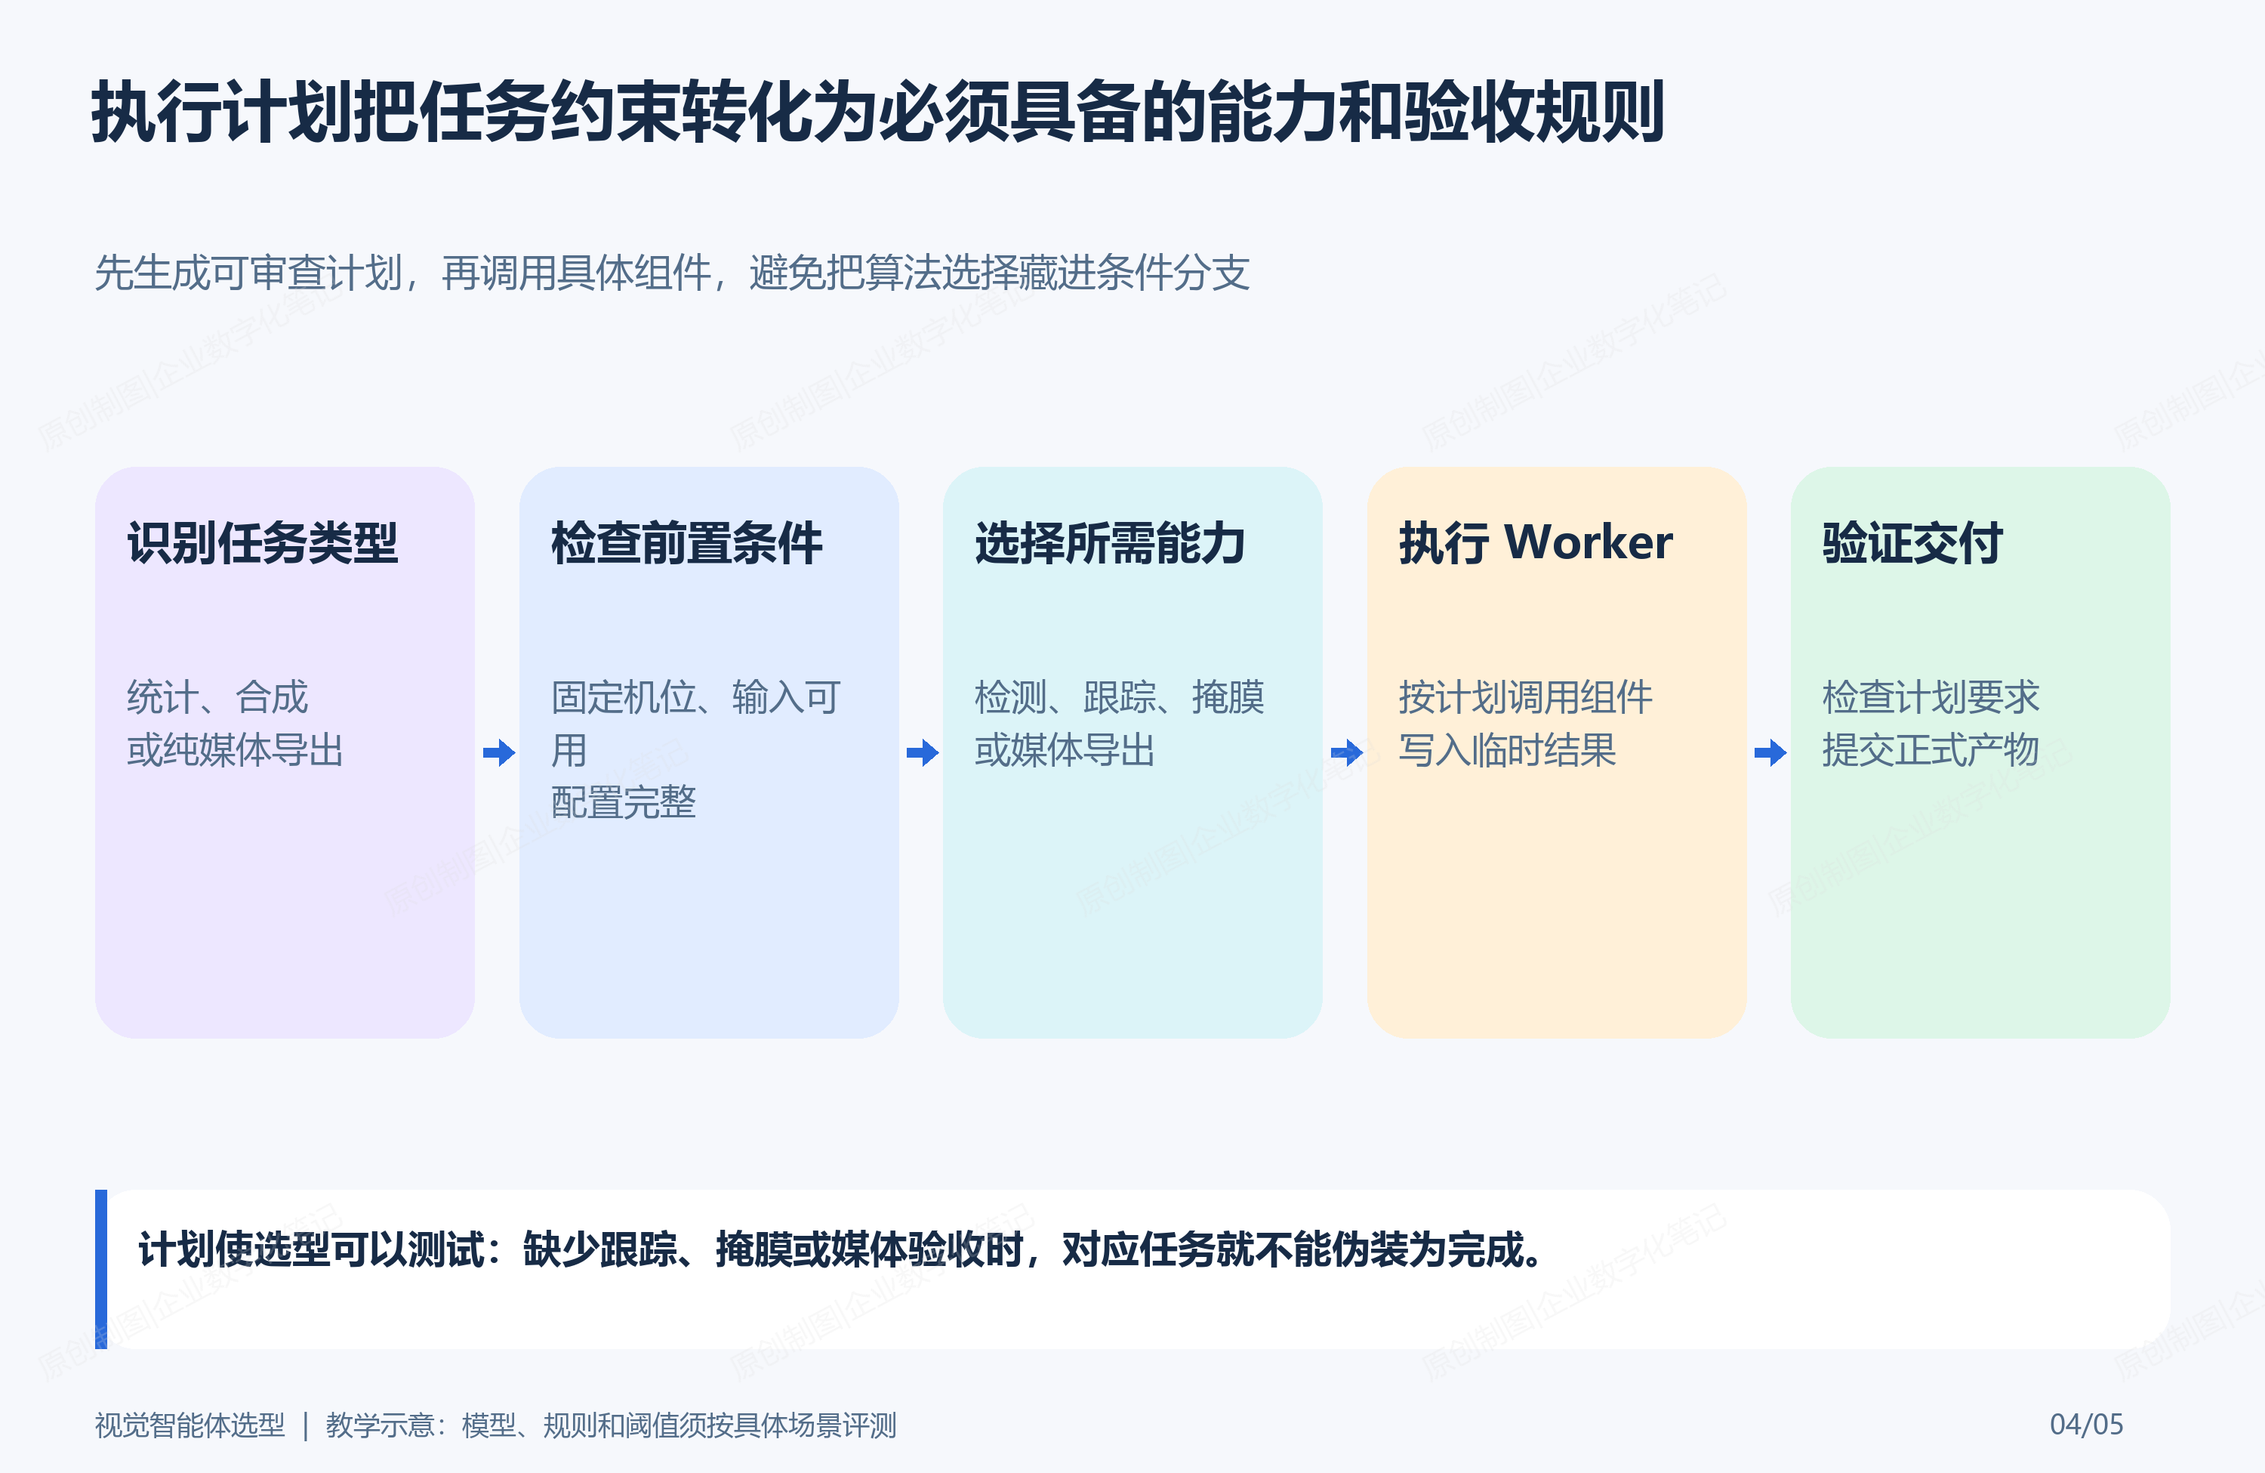
图4:先生成可审查的能力计划,再调用具体组件,避免把算法选择藏进杂乱的条件分支。
六、服务层实现:验证计划而不是硬编码流程
服务层不需要知道检测器或掩膜算法的内部细节,但它必须校验输入与计划匹配、保存配置版本、并拒绝不完整的 Worker 结果:
java
@Transactional(rollbackFor = Exception.class)
public VisualJobResult run(VisualJobCommand command) {
    VisualAgentJob job = jobRepository.lock(command.jobNo())
            .orElseGet(() -> jobRepository.createPending(command));
    if ("READY".equals(job.status())) return VisualJobResult.reused(job.outputFileKey());

    WorkflowFile source = fileRepository.findReady(command.sourceFileKey())
            .orElseThrow(() -> new BizException("输入视频不可用"));
    VisualPlan plan = planFactory.build(command.taskType(), command.fixedCamera());
    configRepository.save(job.id(), command.configVersion(), command.safeConfig());
    jobRepository.markRunning(job.id());

    WorkerVisualResult result = visualWorker.execute(source.path(), plan, command.safeConfig());
    if (!result.success() || !result.acceptance().containsAll(plan.acceptance())) {
        jobRepository.markFailed(job.id(), result.errorCode());
        return VisualJobResult.failed(result.errorCode());
    }
    String outputKey = fileRepository.commitTemporary(result.temporaryOutput(), "VISUAL_OUTPUT");
    jobRepository.markReady(job.id(), outputKey, result.sha256());
    return VisualJobResult.ready(outputKey);
}
这层的作用是保护任务边界:Worker 可以替换模型或优化算法,但不能跳过计划要求的验收;调用者可以提交任务类型和脱敏配置,但不能借由任意参数绕过固定机位、媒体输入或交付规则。
七、预期输出和自动测试
text
TRAFFIC_COUNT:计划包含 detector、tracker、media_export;输出事件统计和标注视频。
COLOR_COMPOSITE:计划包含 pixel_mask、media_export;输出合成视频与边缘预览。
ANNOTATED_EXPORT:计划只要求媒体导出与时长验收;不启动模型推理。
python
def test_traffic_count_requires_tracking():
    plan = build_plan(TaskType.TRAFFIC_COUNT, fixed_camera=True)
    assert plan.detector and plan.tracker
    assert not plan.pixel_mask

def test_color_composite_rejects_moving_camera():
    with pytest.raises(ValueError, match="固定机位"):
        build_plan(TaskType.COLOR_COMPOSITE, fixed_camera=False)

def test_export_does_not_start_visual_model():
    plan = build_plan(TaskType.ANNOTATED_EXPORT, fixed_camera=False)
    assert not plan.detector and not plan.tracker and not plan.pixel_mask
java
@Test
void shouldRejectWorkerResultMissingRequiredAcceptance() {
    fixture.readyVideo("demo.mp4");
    worker.stubSuccessWithout("summary_matches_events");

    VisualJobResult result = service.run(new VisualJobCommand("V-001", "TRAFFIC_COUNT", true));

    assertFalse(result.success());
    assertEquals("ACCEPTANCE_MISSING", result.errorCode());
}
八、SQL验证:配置和产物有没有对错任务
sql
-- 车流统计任务应保存计数配置,预期结果为空
SELECT j.job_no
FROM visual_agent_job j
LEFT JOIN visual_agent_job_config c
  ON c.visual_job_id = j.id AND c.config_kind = 'COUNTING_RULE'
WHERE j.task_type = 'TRAFFIC_COUNT' AND c.id IS NULL;

-- 已完成任务必须有正式产物,预期结果为空
SELECT job_no
FROM visual_agent_job
WHERE job_status = 'READY'
  AND (output_file_key IS NULL OR output_sha256 IS NULL);

-- 颜色合成任务不应使用道路计数配置,预期结果为空
SELECT j.job_no, c.config_kind
FROM visual_agent_job j
JOIN visual_agent_job_config c ON c.visual_job_id = j.id
WHERE j.task_type = 'COLOR_COMPOSITE'
  AND c.config_kind = 'COUNTING_RULE';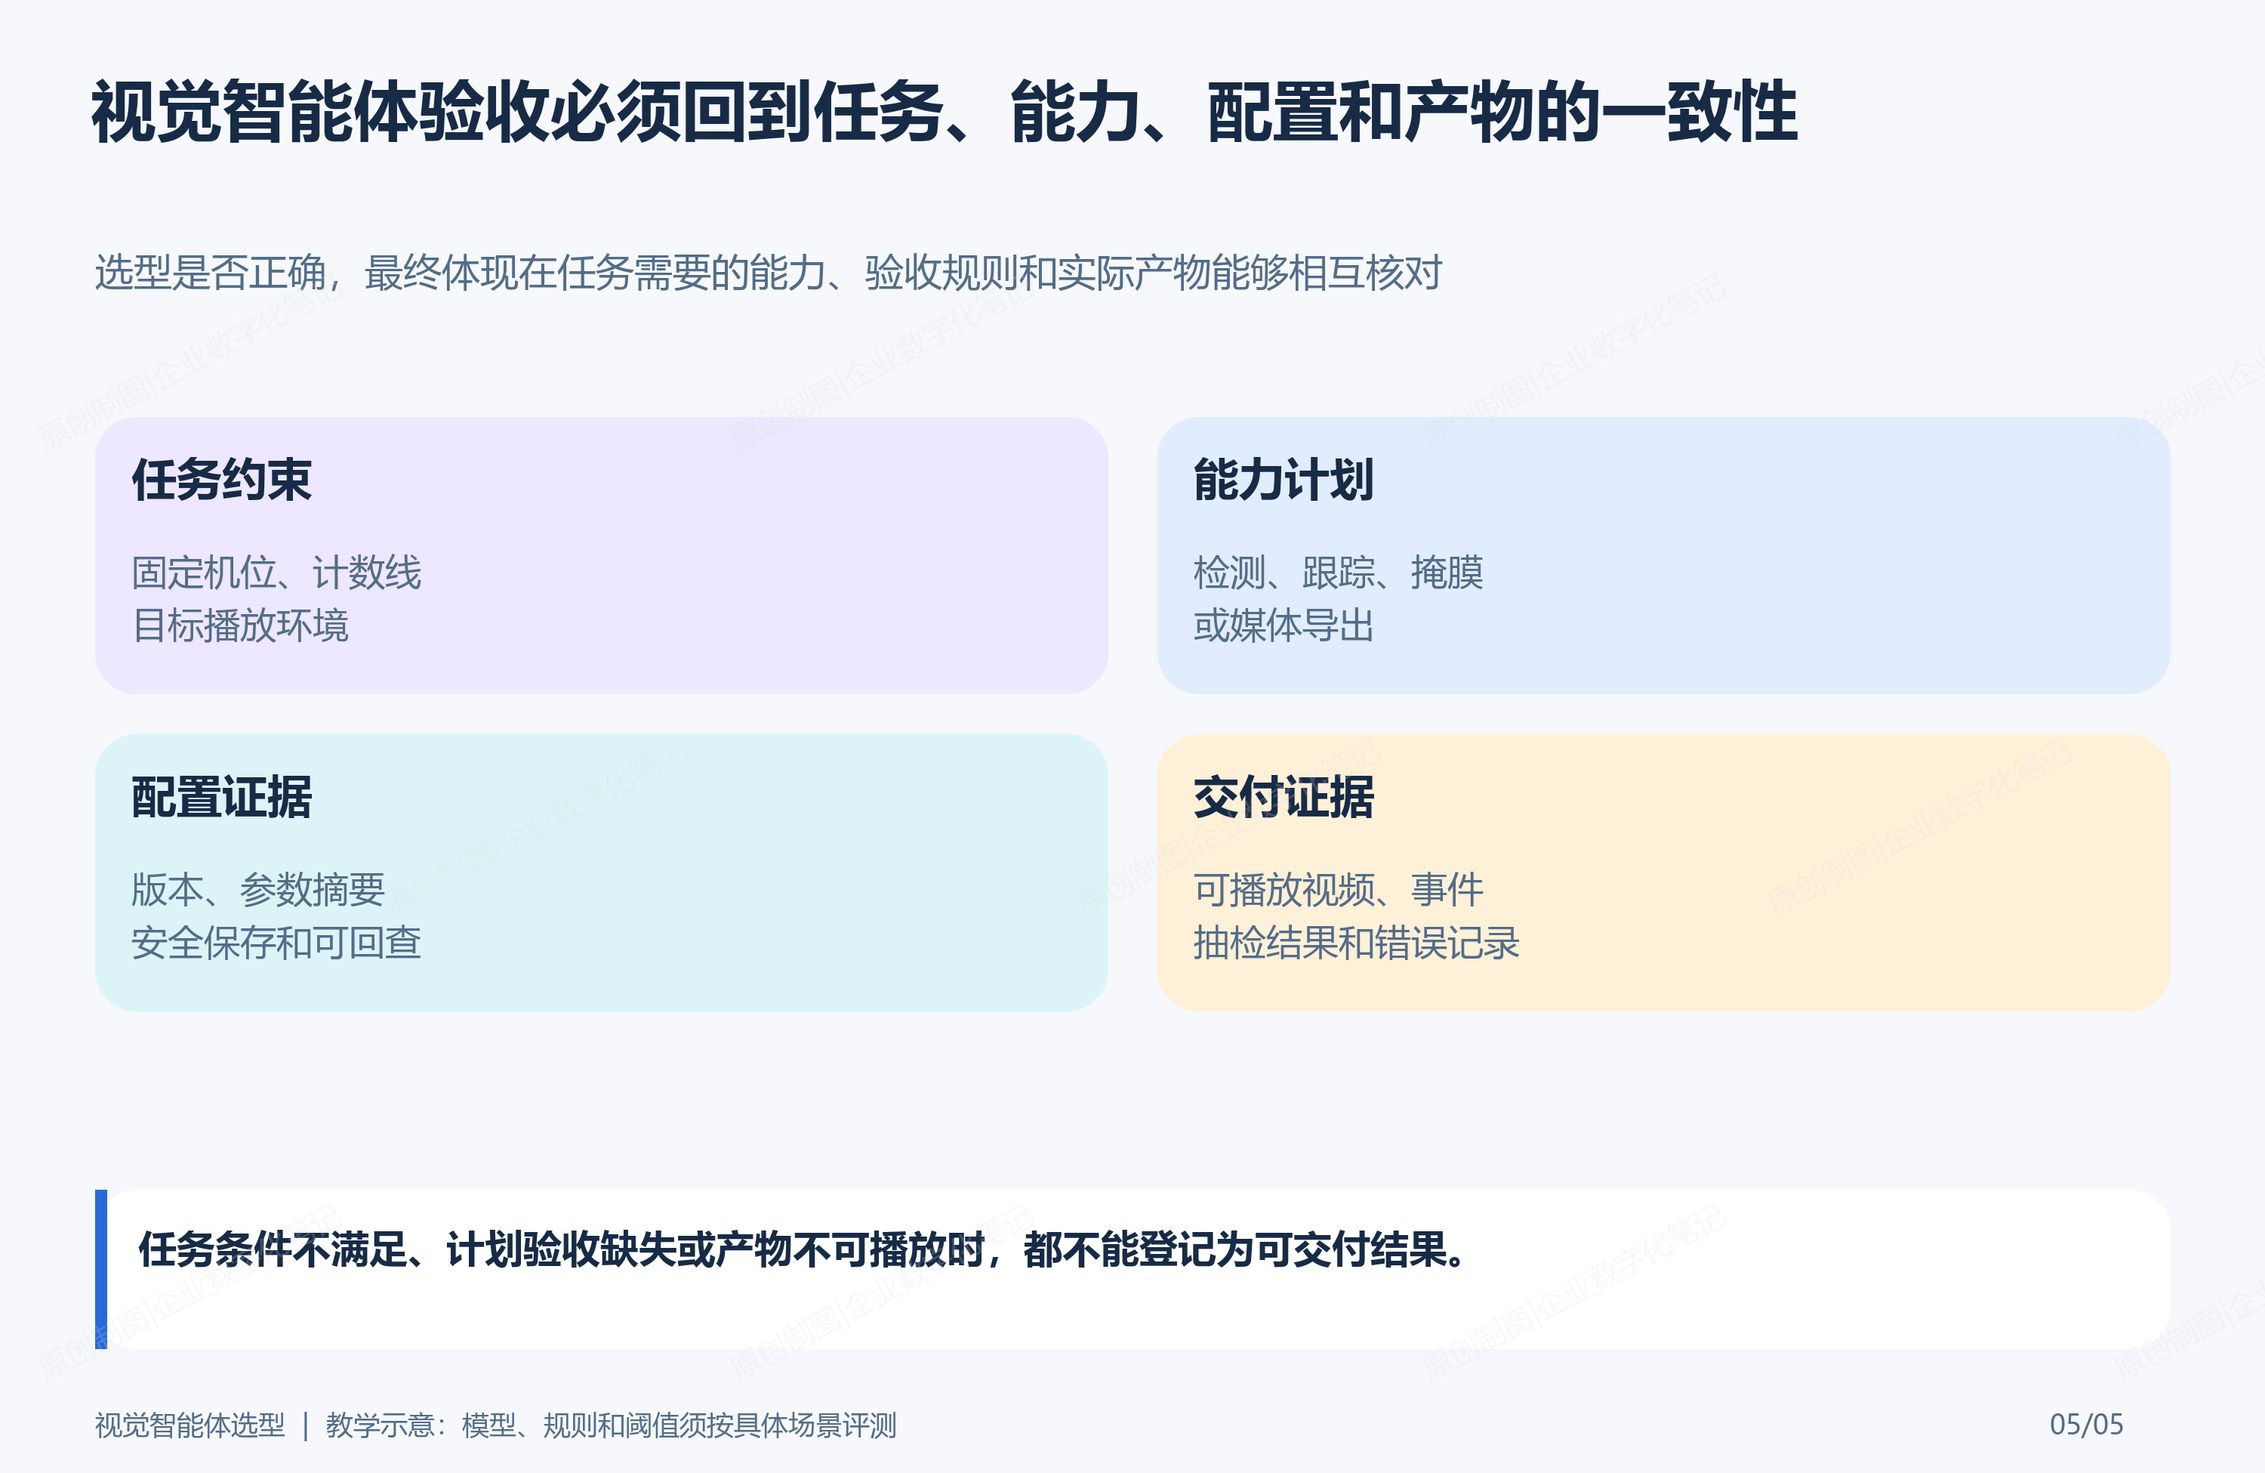
图5:选型是否正确,最终要体现在任务需要的能力、验收规则和实际产物能够相互核对。
九、边界、误差和上线验收
| 边界 | 不能怎么做 | 应该怎么做 |
|---|---|---|
| 固定机位假设 | 镜头移动后继续复用空背景 | 阻断任务或增加画面配准能力 |
| 模型能力 | 把检测框数量当作车流数量 | 使用跟踪和越线规则生成事件 |
| 颜色分割 | 用固定阈值适配所有光照 | 按素材校准并保留预览抽检 |
| 视频导出 | 文件存在即视为成功 | 检查流、时长、分辨率和播放结果 |
| 配置管理 | 把参数散落在代码和页面 | 保存版本化配置和安全摘要 |
上线前至少验证:每种任务能生成正确计划;计划要求的验收不能被 Worker 跳过;不满足固定机位等前置条件时任务会被拒绝;输出视频可播放且可追溯到输入和配置;抽检可以说明模型误检、规则边界或像素残留属于哪一层问题。
十、小结和延伸阅读
视觉智能体的技术选型不是在模型名称之间投票,而是先确定要交付框、轨迹、像素掩膜、事件还是视频文件,再把检测、跟踪、分割、OpenCV、FFmpeg 和规则放到各自合适的位置。选型正确,后面的道路统计和视频合成才有清晰边界;选型错误,再强的模型也只会把问题藏进结果里。