覆盖:深度学习基础 · Transformer 原理 · 预训练与微调 · RLHF/对齐 · 推理与部署优化 · RAG/Agent · 多模态 · 分布式训练 · 工程与前沿
共 100+ 道题,含【考点】+【参考答案】+【常见追问】------追问已全部附带详细回答 ;另附 11 段可运行代码
建议用法:先遮住答案自测,答不上来的标记,二轮只看标记题。
目录
- 一、深度学习与机器学习基础
- [二、Transformer 与注意力机制](#二、Transformer 与注意力机制)
- 三、预训练与微调
- [四、RLHF 与对齐](#四、RLHF 与对齐)
- 五、推理与部署优化
- [六、RAG 与 Agent 应用](#六、RAG 与 Agent 应用)
- 七、多模态
- 八、分布式训练与工程
- 九、前沿与开放题
- 十、手撕代码高频题
一、深度学习与机器学习基础
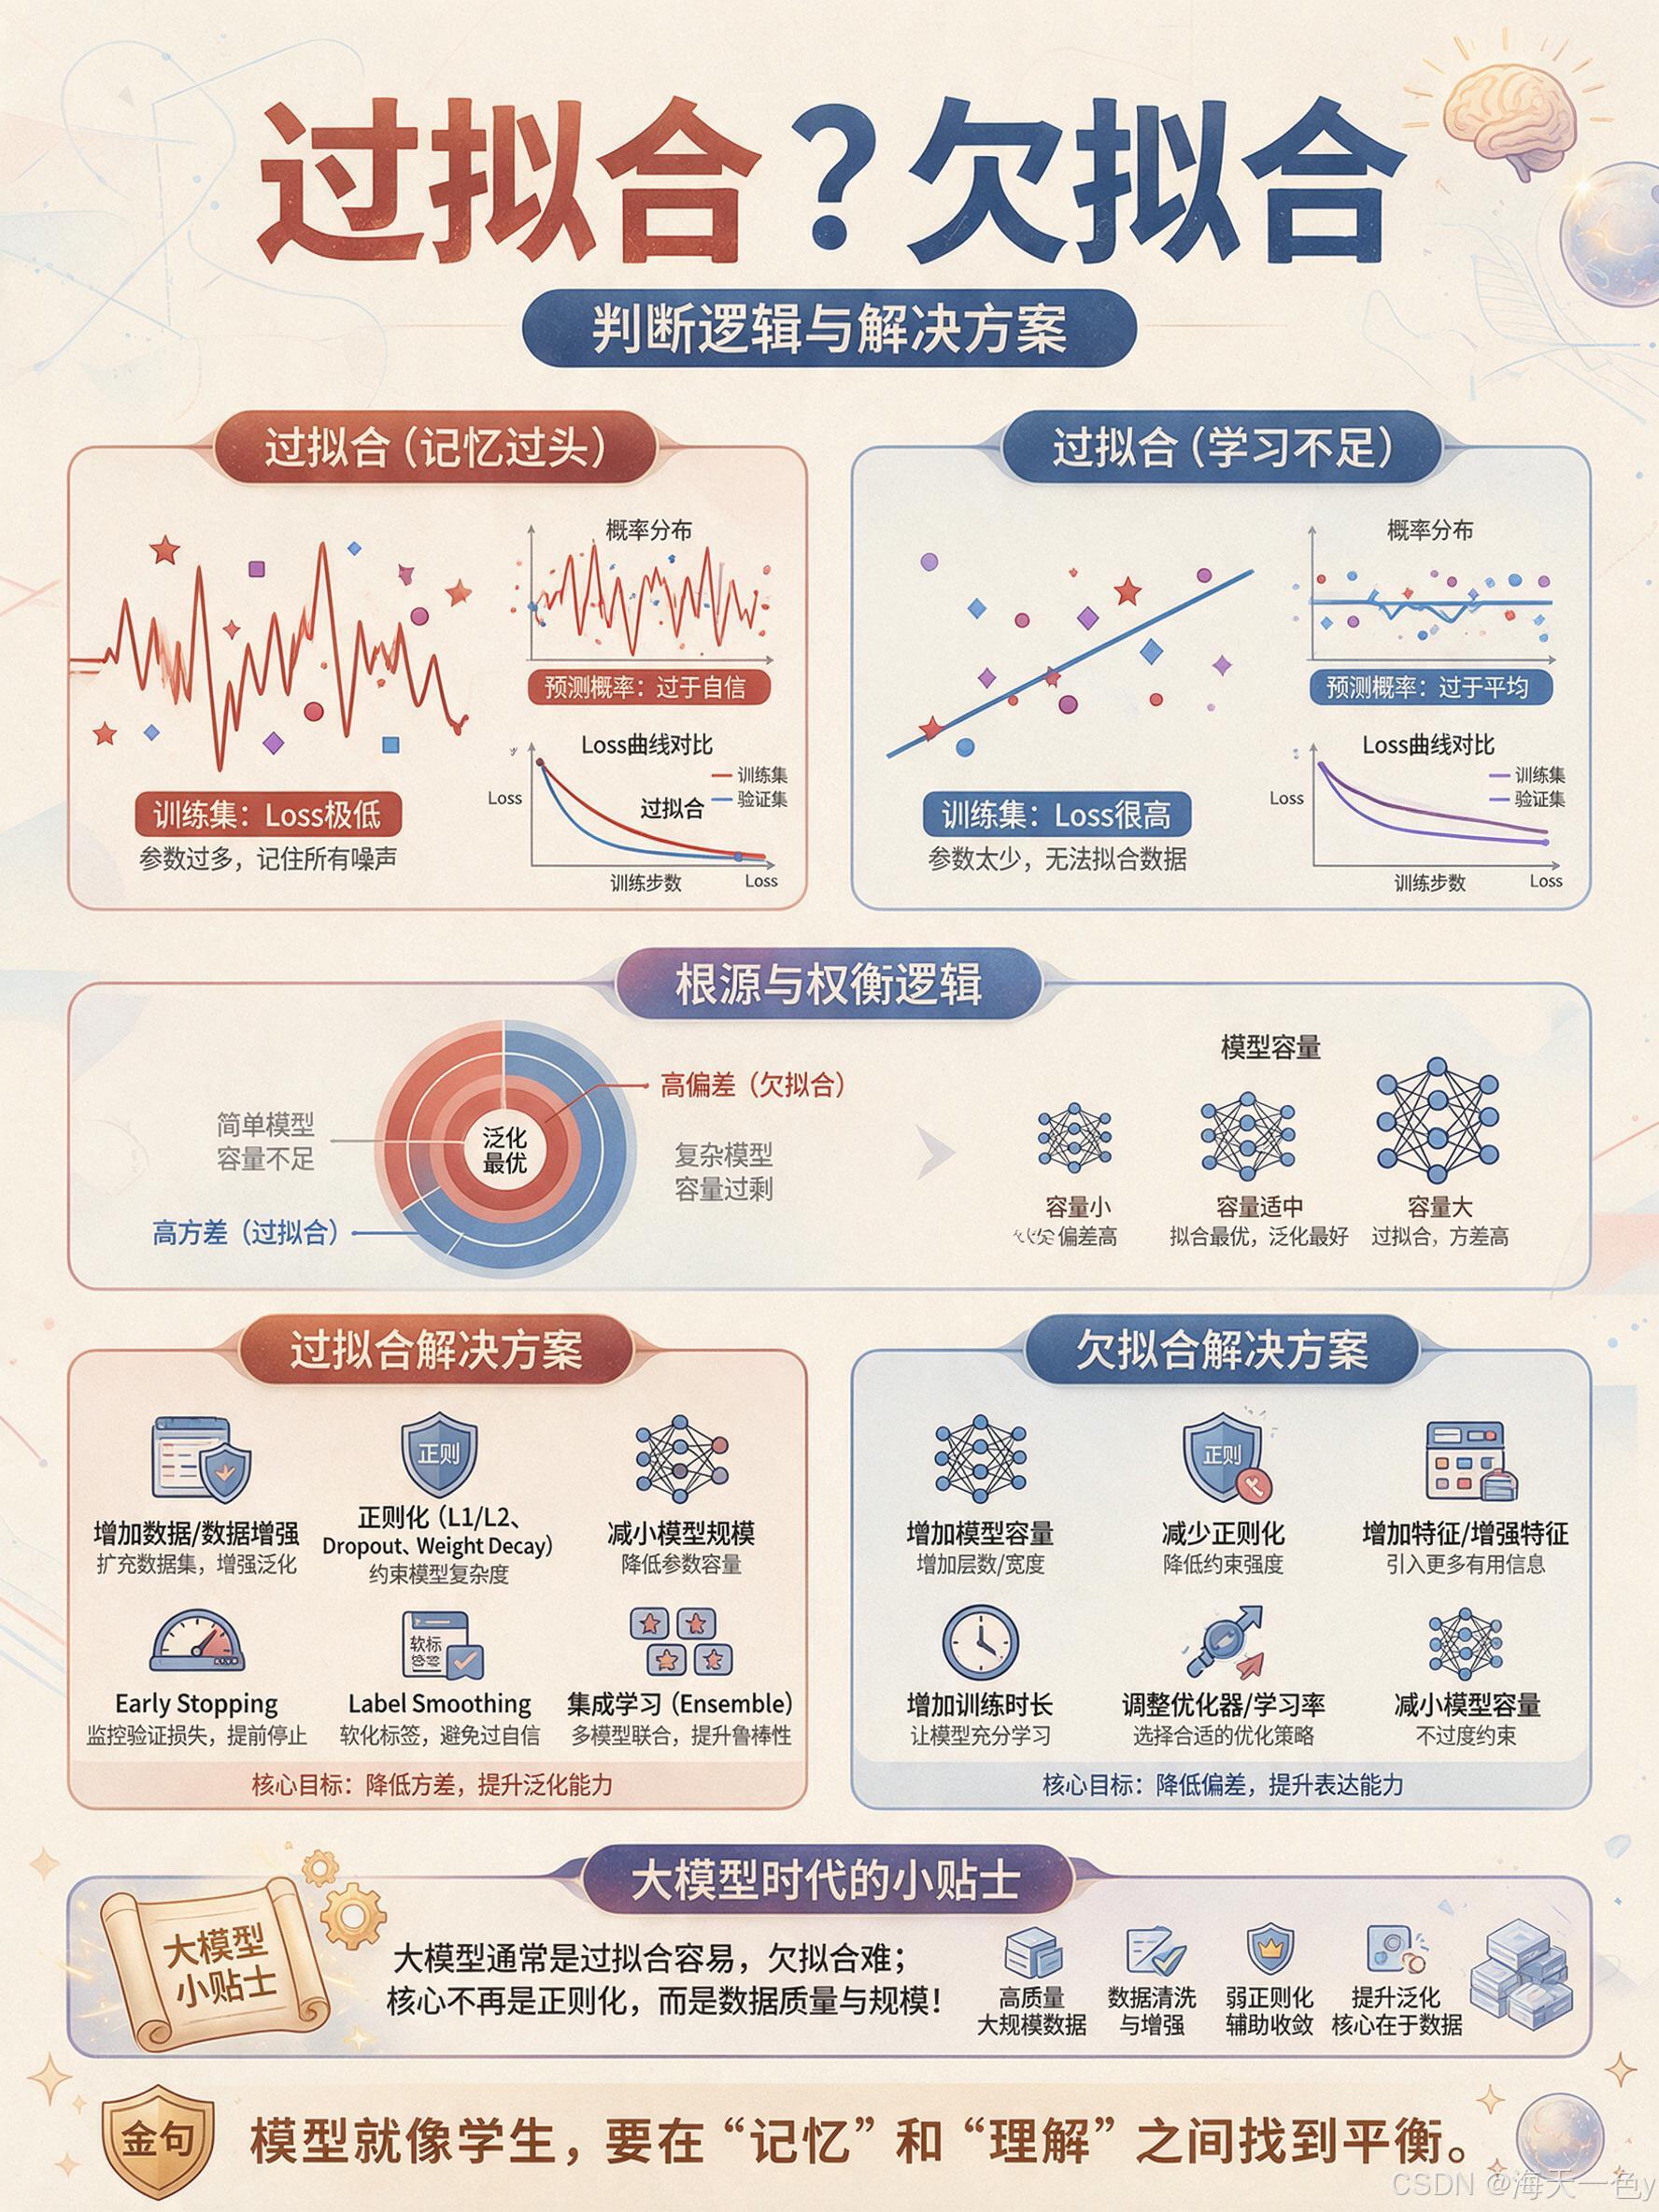
Q1.1 过拟合和欠拟合怎么判断、怎么解决?
考点:模型容量、偏差-方差权衡。
参考答案:
- 判断:训练 loss 低但验证 loss 高 → 过拟合;训练 loss 本身就高 → 欠拟合。
- 过拟合:加数据/数据增强、加正则(L1/L2、Dropout、Weight Decay)、减小模型、Early Stopping、Label Smoothing、集成。
- 欠拟合:加模型容量(层数/宽度)、减正则、加特征、加训练时长、换更好的优化器/学习率。
- 大模型场景的特殊性:大模型通常是"过拟合训练集容易,欠拟合能力" ,所以核心是数据质量和规模,而非传统正则。
追问:Dropout 在推理阶段怎么处理?为什么训练时除以 (1-p)?
推理阶段不使用 Dropout (或者等价地令 p=0),即所有神经元全部激活,不做随机丢弃。原因:推理需要确定性输出,且用多次随机结果的平均------训练时的随机性相当于一种模型集成,推理时应使用期望。
为什么训练时除以 (1-p) :设某个神经元的期望输出是 x。训练时以概率 p 置 0、以概率 (1-p) 保留原值,则保留时期的期望是 ( 1 − p ) ⋅ x (1-p)\cdot x (1−p)⋅x,和推理时(全部保留,输出 x x x)不一致 。为了保证训练和推理的期望一致,训练时对保留下来的值除以 ( 1 − p ) (1-p) (1−p)(即放大),使期望仍为 x x x。这就是 inverted dropout (现主流做法)。
另一种旧做法是训练时不动、推理时乘以 ( 1 − p ) (1-p) (1−p),但那样推理时要做缩放、实现更麻烦,且如果推理忘了缩放就会出错,所以现在都用 inverted dropout。
Q1.2 L1 和 L2 正则化的区别?为什么 L1 稀疏?
考点:正则几何意义、贝叶斯先验。
参考答案:
- L1 = 权重绝对值之和,梯度是常数(符号函数)+ 次梯度,在 0 点不可导,会把小权重压到 0 → 稀疏 → 特征选择。
- L2 = 权重平方和,梯度随权重大小线性缩放,会把权重整体压小但不为 0 → 防过拟合、数值更稳定。
- 几何解释:L1 约束是菱形(顶点在坐标轴上),损失等高线更容易切在顶点 → 部分坐标为 0。
- 贝叶斯视角:L2 对应高斯先验,L1 对应拉普拉斯先验。
追问:为什么大模型基本用 L2(AdamW 的 weight decay)而不用 L1?
- 优化稳定性:L1 在 0 点不可导(有次梯度),在大模型深度网络上训练更不稳定,容易出现震荡。
- 大模型不需要稀疏:L1 产生稀疏是为了特征选择和压缩,但大模型的表达力来自稠密连接,强行稀疏反而损害能力。大模型要的是"所有参数配合工作",不是"关掉一半参数"。
- Adam + L1 不兼容:Adam 的自适应学习率会抵消 L1 的效果------L1 的次梯度是常数,Adam 会按梯度幅度自适应缩放,导致权重难以被压到 0。
- 工程简洁 :weight decay 在优化器步直接对参数衰减,实现简单,且实验上效果稳定好。
补充:L1 仍在量化感知训练、结构化剪枝、小模型压缩等场景有用,但不是大模型训练的标配。
Q1.3 BatchNorm 和 LayerNorm 的区别?为什么 Transformer 用 LayerNorm?
考点:归一化维度、训练/推理差异、序列建模适配性。
参考答案:
| 维度 | BatchNorm | LayerNorm |
|---|---|---|
| 统计维度 | 跨 batch,对每个 channel | 对单个样本的所有特征 |
| 依赖 batch size | 是(小 batch 不稳) | 否 |
| 训练/推理 | 行为不同(需 running stats) | 一致 |
| 适用 | CV 卷积网络 | NLP / 序列 / Transformer |
Transformer 用 LN 的原因:
- 序列长度可变,BN 的统计量随 batch 内不同长度样本变化,不稳定;
- 推理时 batch=1 或自回归单步生成,BN 统计量失真;
- LN 与 batch 解耦,训练推理一致,天然适合自回归。
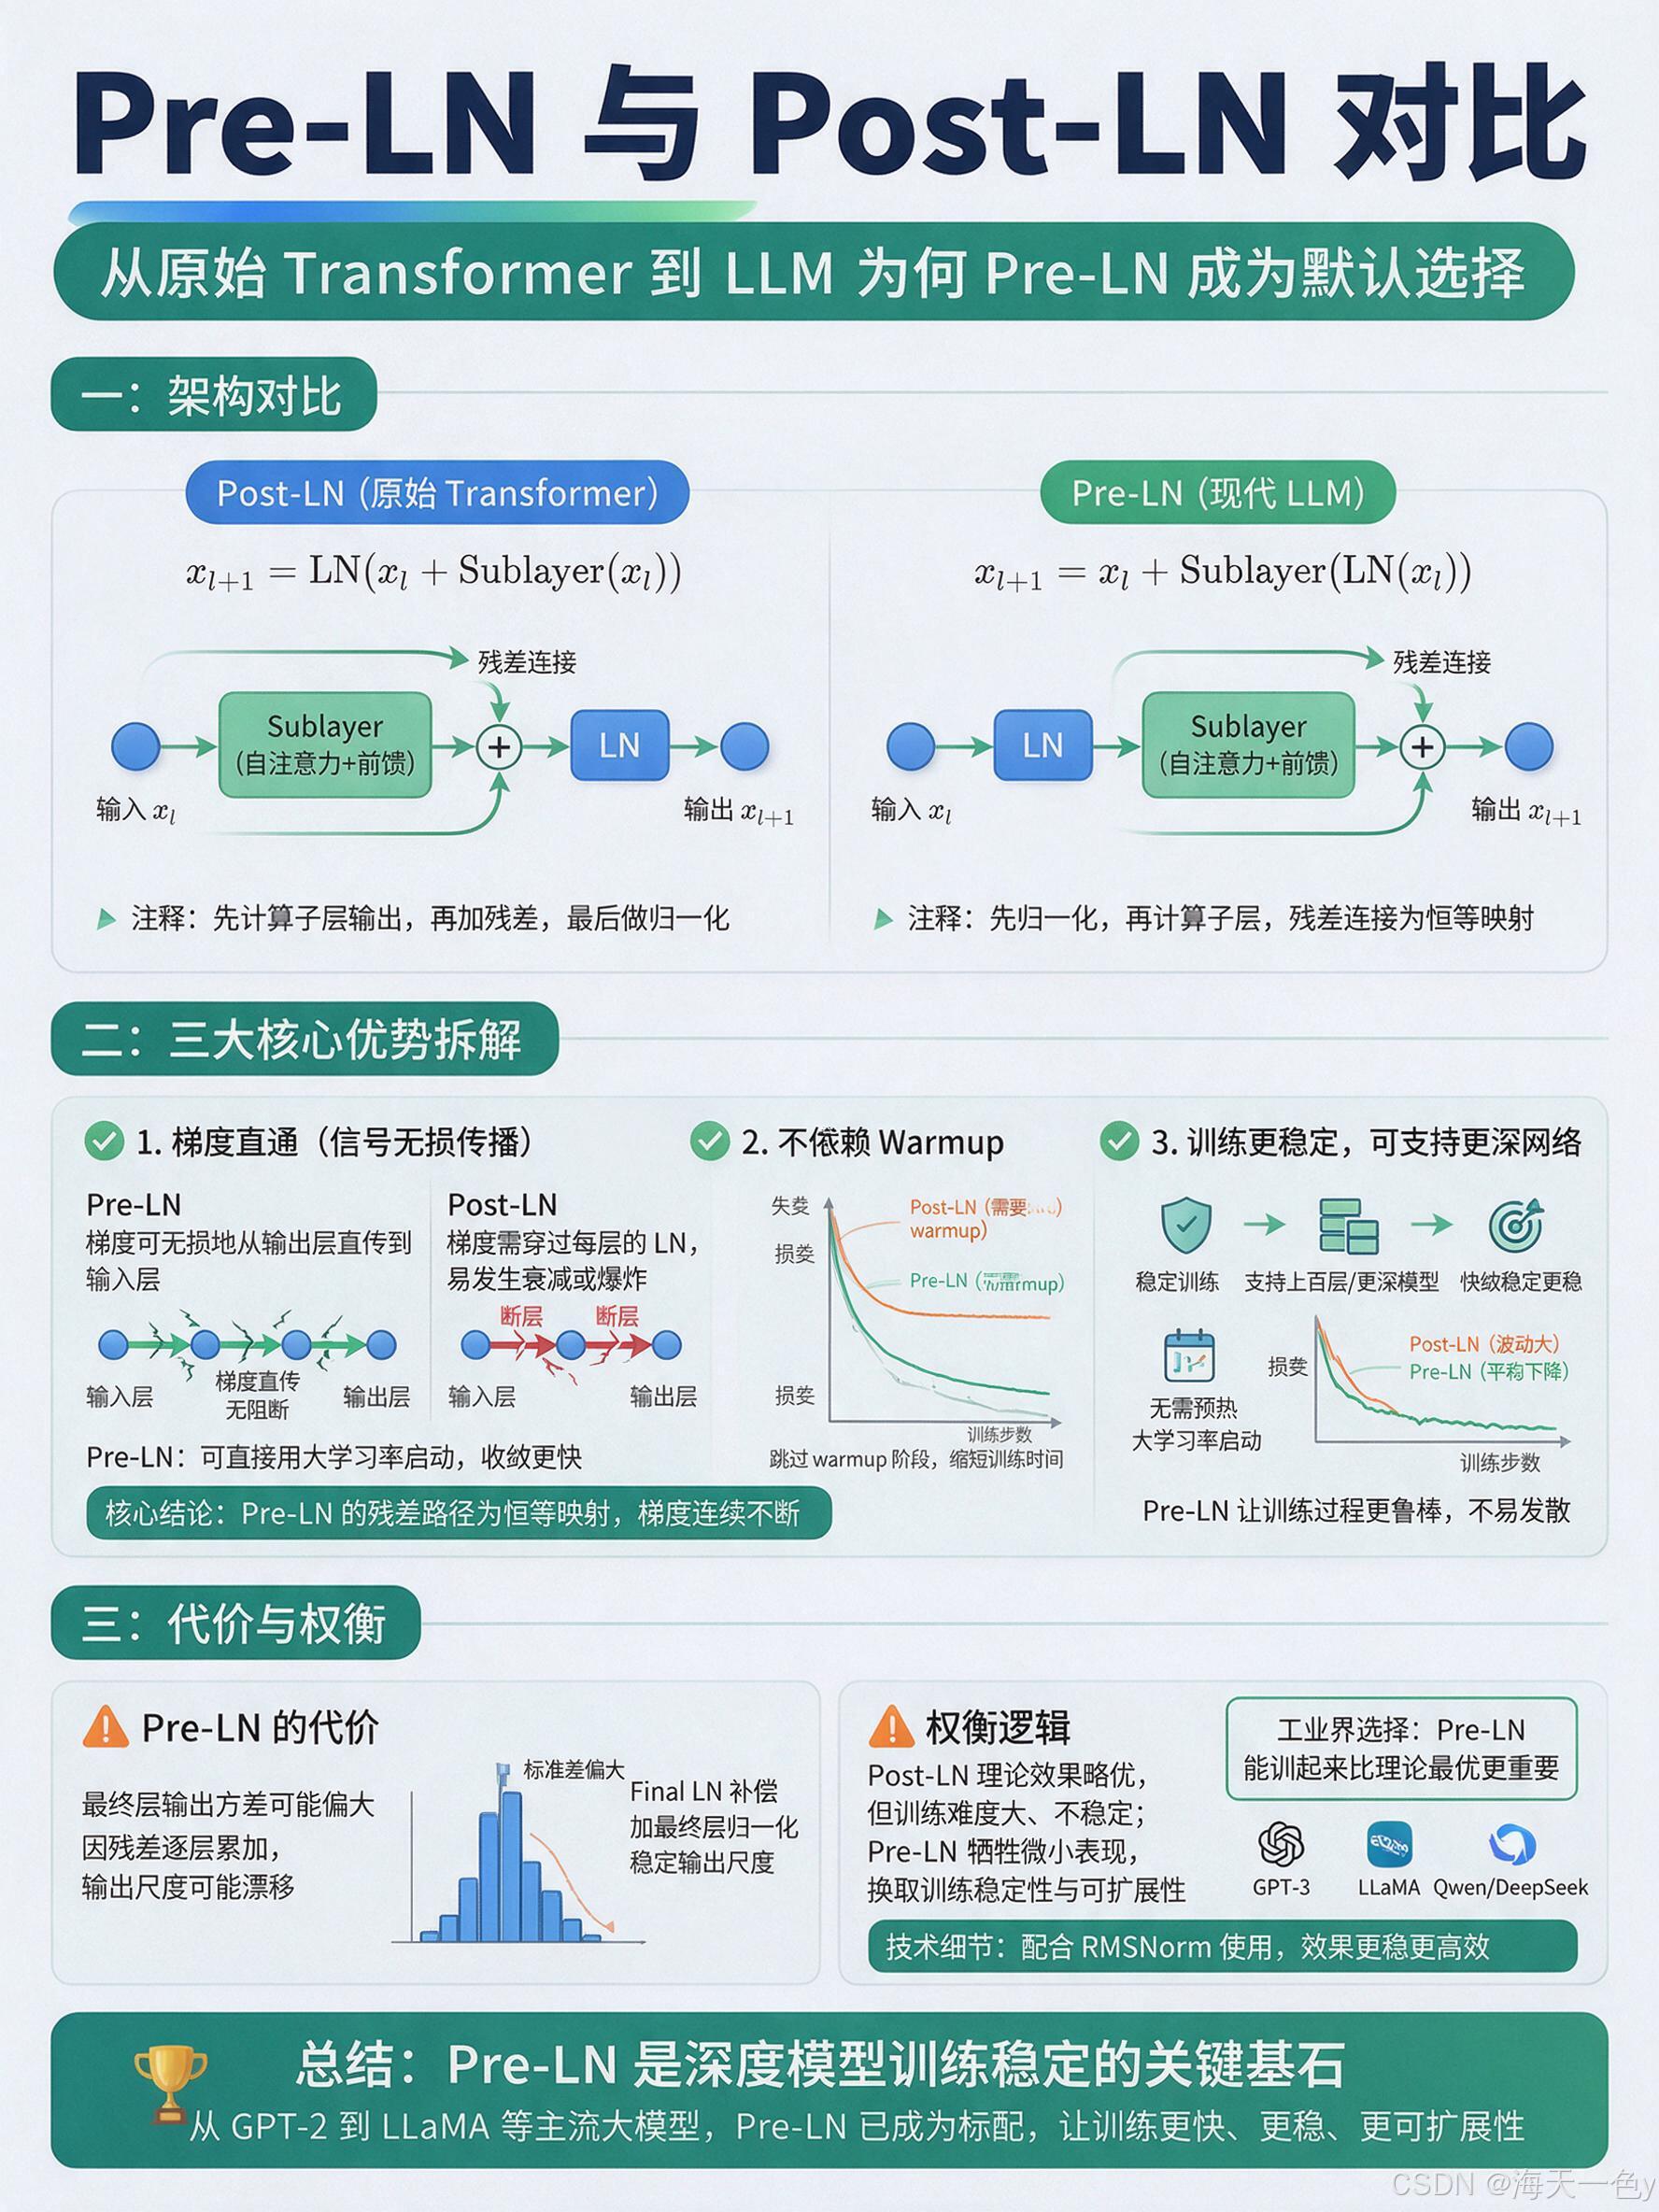
追问:Pre-LN 和 Post-LN 的区别?为什么现在的 LLM 都用 Pre-LN?
定义:
- Post-LN (原始 Transformer):
x_{l+1} = LN(x_l + Sublayer(x_l)),归一化在残差之后。- Pre-LN :
x_{l+1} = x_l + Sublayer(LN(x_l)),归一化在子层之前 ,残差是纯恒等路径。
为什么 Pre-LN 更好:
- 梯度直通 :Pre-LN 的残差连接是
x + f(LN(x)),反向传播时梯度沿恒等路径可以无损直传到浅层,不经过 LN 的雅可比矩阵连乘。Post-LN 的梯度要穿过每一层的 LN,深层网络梯度会衰减/爆炸。- 不依赖 warmup:Post-LN 因为梯度不稳,必须用 learning rate warmup(先小后大)才能训起来;Pre-LN 可以直接用较大学习率。
- 训练更稳、可更深 :Pre-LN 支持更深的模型(上百层)而不发散。
代价:
- Pre-LN 在最终层可能因为逐层累加导致输出方差偏大,所以通常在最后加一个额外的 LN(final norm)。
- 有研究表明 Post-LN 在相同参数量下最终效果可能略好 (因为归一化在残差后能更好地控制尺度),但训练难度大得多。权衡之下,工业界选择 Pre-LN------能训起来比理论最优更重要 。
GPT-2 之后,几乎所有主流 LLM(GPT-3、LLaMA、Qwen、DeepSeek)都用 Pre-LN(配合 RMSNorm)。
Q1.4 RMSNorm 是什么?为什么比 LayerNorm 快?
考点:归一化变体。
参考答案 :
RMSNorm 去掉了 LayerNorm 的去均值 和偏置项 ,只做缩放:
RMSNorm ( x ) = x 1 n ∑ x i 2 + ϵ ⋅ γ \text{RMSNorm}(x) = \frac{x}{\sqrt{\frac{1}{n}\sum x_i^2 + \epsilon}} \cdot \gamma RMSNorm(x)=n1∑xi2+ϵ x⋅γ
- 少了一次均值计算和一次减法,计算量约省 10-15%,且实测效果与 LN 相当甚至更好。
- 被 LLaMA、Gemma、Qwen 等主流开源模型采用。
追问:为什么去掉均值中心化反而效果不差?
可能的解释:
- LayerNorm 的主要作用是缩放不变性,即把特征向量归一化到固定范数,防止训练中数值漂移------这部分由 RMS(均方根归一化)就能完成。
- 均值中心化的作用可能被其他部分吸收了,例如残差连接会逐层累积"基线偏移",相当于替代了均值中心化的作用。
- 大模型的激活分布本身已经比较对称,均值接近 0(经过 LN 之后),去掉这一项影响不大。
- 还有研究认为去均值在某些任务(如视觉)上有害,因为它会破坏亮度等全局信息。
总之,实测 RMSNorm 在 NLP 大模型上与 LayerNorm 效果相当甚至略好,同时省了约 15-20% 的计算。
Q1.5 Adam 和 SGD 的区别?Adam 的偏差修正是什么?
考点:优化器原理。
参考答案:
- SGD:只按当前梯度更新,简单但对学习率敏感、易陷鞍点。
- Adam:一阶动量(梯度 EMA)+ 二阶动量(梯度平方 EMA),自适应学习率:
m t = β 1 m t − 1 + ( 1 − β 1 ) g t , v t = β 2 v t − 1 + ( 1 − β 2 ) g t 2 m_t = \beta_1 m_{t-1} + (1-\beta_1)g_t,\quad v_t = \beta_2 v_{t-1} + (1-\beta_2)g_t^2 mt=β1mt−1+(1−β1)gt,vt=β2vt−1+(1−β2)gt2 - 偏差修正:因为 m 0 = v 0 = 0 m_0=v_0=0 m0=v0=0,初期 EMA 偏向 0,除以 ( 1 − β t ) (1-\beta^t) (1−βt) 校正:
m ^ t = m t / ( 1 − β 1 t ) , v ^ t = v t / ( 1 − β 2 t ) \hat m_t = m_t/(1-\beta_1^t),\quad \hat v_t = v_t/(1-\beta_2^t) m^t=mt/(1−β1t),v^t=vt/(1−β2t) - 更新: θ t = θ t − 1 − η m ^ t / ( v ^ t + ϵ ) \theta_t = \theta_{t-1} - \eta \hat m_t/(\sqrt{\hat v_t}+\epsilon) θt=θt−1−ηm^t/(v^t +ϵ)。
追问:Adam 和 AdamW 的区别?为什么 AdamW 更好?
Adam 的做法 :把 L2 正则项加到损失里,即 g t = ∇ f ( θ ) + λ θ g_t = \nabla f(\theta) + \lambda\theta gt=∇f(θ)+λθ(L2 惩罚的梯度是 λ θ \lambda\theta λθ),然后这个 g t g_t gt 直接进 Adam 的动量和自适应学习率。
问题 :Adam 的自适应学习率会除以 v t \sqrt{v_t} vt ,而这个 v t v_t vt 包含了两部分梯度(真实梯度 + 正则梯度)的平方。结果是:
- 权重衰减的力度被自适应缩放扭曲------大权重(梯度大)的衰减被相对削弱,小权重的衰减被相对放大,和 L2 的本意(对大权重惩罚更多)不符。
- L2 正则和自适应学习的耦合让超参 λ 的行为难以预测。
AdamW 的做法 :解耦权重衰减(decoupled weight decay) ------把正则从梯度里拿出来,直接在参数更新时衰减:
θ t = θ t − 1 − η ( m ^ t v ^ t + ϵ ) − η λ θ t − 1 \theta_t = \theta_{t-1} - \eta\left(\frac{\hat m_t}{\sqrt{\hat v_t}+\epsilon}\right) - \eta\lambda\theta_{t-1} θt=θt−1−η(v^t +ϵm^t)−ηλθt−1
这样权重衰减的力度只由 λ 和 η 决定 ,不再被 v t \sqrt{v_t} vt 干扰,行为可预测、更符合 L2 的原始意图。
效果 :AdamW 在 Transformer 训练上比 Adam + L2 明显更好(收敛更快、泛化更好),是 GPT、LLaMA 等事实上的标准优化器 。
补充:现在很多训练还会对某些参数不用 weight decay(如 LayerNorm 的 γ、bias),因为对它们做衰减会损害表达力------这是 AdamW 实现里的常见细节。
Q1.6 梯度消失/爆炸的原因和解决?
参考答案:
- 原因:链式法则连乘,深层网络中梯度呈指数衰减/增长。
- 解决:残差连接、归一化(BN/LN)、梯度裁剪(clip by norm)、合适的初始化(Xavier/He、GPT 用 0.02 正态初始化并随层数缩放)、门控结构(LSTM)、换激活函数(ReLU/GELU 替代 sigmoid)。
- 大模型特有:loss spike 常见于训练中后期,处理办法是回滚 checkpoint、跳过高 loss 的 batch、降低学习率、开梯度裁剪、用 bf16 而非 fp16。
Q1.7 为什么大模型用 GELU / SwiGLU 而不是 ReLU?
参考答案:
- GELU: x ⋅ Φ ( x ) x\cdot\Phi(x) x⋅Φ(x),平滑,负值区不完全置零,梯度更平滑,BERT/GPT 系列常用。
- SwiGLU: Swish ( x W 1 ) ⊗ ( x W 2 ) \text{Swish}(xW_1) \otimes (xW_2) Swish(xW1)⊗(xW2),门控机制,实验上比 ReLU/GELU 更好。LLaMA 用的 GLU 变体参数量按 8 / 3 d 2 8/3 d^2 8/3d2 设计(因为多了一个投影矩阵,为保持参数量对齐把 FFN 隐层缩小)。
- ReLU 的问题:0 点不可导、负区梯度为 0(神经元死亡)。
Q1.8 交叉熵、KL 散度、JS 散度的关系?
参考答案:
- 交叉熵 H ( p , q ) = − ∑ p log q H(p,q) = -\sum p\log q H(p,q)=−∑plogq,当 p 是 one-hot 时等价于 NLL 损失。
- KL: D K L ( p ∥ q ) = H ( p , q ) − H ( p ) D_{KL}(p\|q)=H(p,q)-H(p) DKL(p∥q)=H(p,q)−H(p),衡量分布差异,不对称、非负、=0 时分布相同。
- 训练时最小化交叉熵 = 最小化 KL(因为 H§ 是常数)。
- JS:对称化的 KL, J S = 1 2 K L ( p ∥ m ) + 1 2 K L ( q ∥ m ) JS = \frac12 KL(p\|m)+\frac12 KL(q\|m) JS=21KL(p∥m)+21KL(q∥m),有界(≤ log2),被 GAN 使用;但两分布不重叠时 JS 梯度为 0,所以 Wasserstein 距离更好。
追问 :为什么 RLHF 里用反向 KL ( K L ( π θ ∥ π r e f ) KL(\pi_\theta \| \pi_{ref}) KL(πθ∥πref))而不是正向?
先明确两个方向的差别(注意 KL 不对称,但因两个分布都含 p 与 q,方向命名有时混乱,这里按 RLHF 惯例说明):
- 正向 KL K L ( π r e f ∥ π θ ) KL(\pi_{ref} \| \pi_\theta) KL(πref∥πθ)(相对于策略,参考在前):mean-seeking / 覆盖模式 。只要参考分布有概率质量的地方,策略都必须分配概率,否则 KL 会很大。结果是策略会"覆盖"参考分布的所有模式,输出多样性高,但也可能在低质量区域铺概率(产生垃圾、跑偏)。
- 反向 KL K L ( π θ ∥ π r e f ) KL(\pi_\theta \| \pi_{ref}) KL(πθ∥πref)(策略在前):mode-seeking / 寻模 。只要策略在某处有概率、而参考分布那里概率很低,KL 惩罚就很大;反之参考分布有概率而策略没有不罚。结果是策略聚焦到参考分布的高概率区域 ,允许"丢弃"参考分布中一些无关紧要的尾部模式。
为什么 RLHF 用反向 KL:
- 防止跑偏:RLHF 的初衷是让策略在参考模型(SFT 模型)附近优化,不要为了追奖励而生成参考分布之外的奇怪文本。反向 KL 的 mode-seeking 正好保证策略"贴着参考模型的好区域走"。
- 避免垃圾输出:正向 KL 的覆盖特性会迫使策略给所有参考模式(包括一些低质量的)分配概率,可能鼓励模型说废话凑覆盖。
- 配合 PPO 的优化形式 :PPO 对每个采样到的 token 计算 K L ( π θ ∥ π r e f ) KL(\pi_\theta\|\pi_{ref}) KL(πθ∥πref) 惩罚,用反向 KL 天然契合(只需 log 比值,采样即可估计),实现简单。
代价 :反向 KL 会导致多样性下降(因为只聚焦高概率区域,不覆盖尾部),这正是一些研究指出的"对齐后模型输出变单调"的原因之一。缓解手段:增大采样温度、混入多样数据、用多样性奖励等。
Q1.9 精度类型:fp32 / fp16 / bf16 / tf32 的区别?
参考答案:
| 类型 | 总位数 | 指数位 | 尾数位 | 特点 |
|---|---|---|---|---|
| fp32 | 32 | 8 | 23 | 基准 |
| tf32 | 19 | 8 | 10 | A100 张量核专用,fp32 的快速替代 |
| fp16 | 16 | 5 | 10 | 动态范围小(±65504),易溢出 |
| bf16 | 16 | 8 | 7 | 动态范围与 fp32 相同,精度略低,训练首选 |
- bf16 指数位和 fp32 一样 → 不需要 loss scaling,训练稳定,是 LLM 标配。
- fp16 需要 loss scaling 防梯度下溢。
- 显存估算:7B 模型 fp16 权重 ≈ 14GB;全量微调(权重+梯度+Adam 两状态)≈ 14×4 = 56GB+。
二、Transformer 与注意力机制
Q2.1 手推 Self-Attention 公式,解释每个矩阵的维度
考点:核心必考。
参考答案 :
Attention ( Q , K , V ) = softmax ( Q K T d k ) V \text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V Attention(Q,K,V)=softmax(dk QKT)V
- 输入 X ∈ R n × d X \in \mathbb{R}^{n\times d} X∈Rn×d,投影得到 Q = X W Q , K = X W K , V = X W V Q=XW_Q,\ K=XW_K,\ V=XW_V Q=XWQ, K=XWK, V=XWV, W Q , W K , W V ∈ R d × d k W_Q,W_K,W_V \in \mathbb{R}^{d\times d_k} WQ,WK,WV∈Rd×dk。
- Q K T ∈ R n × n QK^T \in \mathbb{R}^{n\times n} QKT∈Rn×n:注意力分数矩阵, n n n 是序列长度。
- 除以 d k \sqrt{d_k} dk :防止 d k d_k dk 大时点积方差大(方差≈ d k d_k dk),softmax 进入饱和区梯度消失。
- softmax 后每行和为 1 → 加权平均 V。
- 多头: h h h 个头,每个 d k = d / h d_k=d/h dk=d/h,各自做注意力后拼接再投影 W O W_O WO。
追问:为什么多头比单头好?
多头注意力的优势可以从几个角度理解:
- 多子空间学习 :每个头在不同的 d k = d / h d_k=d/h dk=d/h 维子空间中学习注意力模式,可以同时关注不同类型的关系(如语法关系、指代关系、位置关系等),有点像多组卷积核各学各的特征。
- 表达能力提升 :虽然总参数量和单头相同(因为 h ⋅ ( d / h ) 2 ⋅ 3 = 3 d 2 / h h\cdot (d/h)^2 \cdot 3 = 3d^2/h h⋅(d/h)2⋅3=3d2/h,再加上输出投影 h ⋅ d / h ⋅ d = d 2 h\cdot d/h \cdot d = d^2 h⋅d/h⋅d=d2,总参数量仍为 4 d 2 4d^2 4d2,和单头的 4 d 2 4d^2 4d2 一样),但多了非线性组合,实际表达力更强。
- 冗余与稳健:多个头提供了冗余,即使某些头学到的模式不对,其他头可以弥补。
- 工程上有利于 GQA 等 KV 压缩 :头数多才有分组压缩的空间。
反例:也有研究(如 "Are Sixteen Heads Really Better than One?")指出,很多头其实是冗余的,后期可以剪枝掉大部分而不怎么掉点------说明头数有边际递减效应。
Q2.2 为什么 attention 要除以 d k \sqrt{d_k} dk ?不除会怎样?
参考答案:
- 假设 q , k q,k q,k 各维独立、均值 0 方差 1,则 q ⋅ k = ∑ i = 1 d k q i k i q\cdot k = \sum_{i=1}^{d_k}q_ik_i q⋅k=∑i=1dkqiki 的方差为 d k d_k dk。
- d k d_k dk 大时点积数值大 → softmax 输入极端 → 输出接近 one-hot → 梯度趋近 0(softmax 饱和)。
- 除以 d k \sqrt{d_k} dk 把方差拉回 1,保持 softmax 在梯度敏感区。
追问 :有人说现在大模型都除以 d k \sqrt{d_k} dk 但其实 d k d_k dk 很大,还有必要吗?
有必要,而且正因为 d k d_k dk 大才必须除。
举个例子:LLaMA-2 7B 每个头 d k = 128 d_k = 128 dk=128。如果不除,q·k 的方差 ≈ 128,标准差 ≈ 11.3,softmax 的输入会在 ±10 以上波动。softmax 在输入绝对值 >5 时就基本饱和了(接近 0 或 1),梯度几乎为 0,训练会发散或收敛极慢。
有些新模型(如 GPT-3、LLaMA)会把这个缩放因子做成可学习的(QK scaling),或者用 QK-Norm (对 q,k 先做归一化再做点积)来替代固定的 d k \sqrt{d_k} dk 缩放------本质还是为了稳定注意力分数的尺度。
另外,query scaling(把 Q 的范数约束住)也是一种常见变体,核心目的一样:防止点积太大导致 softmax 饱和。
Q2.3 位置编码:正弦式 vs 可学习 vs RoPE vs ALiBi
参考答案:
- 正弦式绝对位置(原版):固定公式,可外推理论但实际外推差,表达相对位置需线性变换。
- 可学习绝对位置 (BERT/GPT):直接查表,简单,但无法外推到超过训练长度的序列。
- RoPE (当前主流):在复数域把位置信息编码为旋转矩阵作用在 q,k 上:
f ( q , m ) = q e i m θ f(q,m) = q e^{im\theta} f(q,m)=qeimθ
核心性质:两向量内积只依赖相对位置 m − n m-n m−n。兼顾绝对/相对位置,且可通过插值外推。 - ALiBi :不加位置编码,直接在注意力分数上加与距离成正比的线性偏置 − slope ⋅ ∣ i − j ∣ -\text{slope}\cdot|i-j| −slope⋅∣i−j∣,外推性好、实现简单。
追问:RoPE 怎么做长度外推?(高频考点)
- 线性插值(PI,Position Interpolation) :把位置索引 m m m 压缩为 m / scale m / \text{scale} m/scale,即原本训练在 4096 位置,现在要推理到 16384,就把所有位置除以 4。缺点是高频分量被过度压缩------高频位置编码负责精细位置区分,插值后分辨率不足。
- NTK-aware Scaling :把 RoPE 的 base θ \theta θ 变大(如从 10000 提到 500000+)。这样高频分量变化更慢(波长变长),等价于"对高频少插值、对低频多插值"。NTK-by-parts 是进一步的精细版本:按频段分块处理。
- YaRN :微软的方案,把 NTK-by-parts 位置插值 + 注意力温度缩放(按插值比例放大 √d_k 分母,降低注意力尖锐度)结合,外推效果最好,被 Qwen、DeepSeek 等模型采用。
- 动态 NTK(Dynamic NTK):推理时根据实际输入长度动态调整 base------短序列用原 base,长序列自动调大 base,无需重新训练。
- 注意 :纯外推(不改权重)通常只能到 2-4 倍训练长度。要更远(如 4K → 128K)需要继续预训练几千步(微调模型适应插值后的位置)。
Q2.4 为什么 Transformer 的复杂度是 O ( n 2 d ) O(n^2 d) O(n2d)?有哪些降低复杂度的方法?
参考答案:
- Q K T QK^T QKT 是 n × n n\times n n×n 矩阵,复杂度 O ( n 2 d ) O(n^2d) O(n2d);显存也是 O ( n 2 ) O(n^2) O(n2)(不做优化时需存注意力矩阵)。
- 优化方向:
- 稀疏注意力:Longformer(滑窗+全局 token)、BigBird。
- 线性注意力:Linformer(低秩近似)、Performer(核方法)。
- 状态空间模型 :Mamba/S4, O ( n ) O(n) O(n) 复杂度。
- 分块/IO 优化:FlashAttention 不减复杂度但减少 HBM 读写,实际快数倍。
- KV Cache 压缩:MQA/GQA/MLA。
- 现实结论:FlashAttention + GQA 是当前工业界主流,线性注意力尚未在大规模上打败标准注意力。
Q2.5 FlashAttention 原理?为什么快?
考点:IO 感知算法,高频。
参考答案:
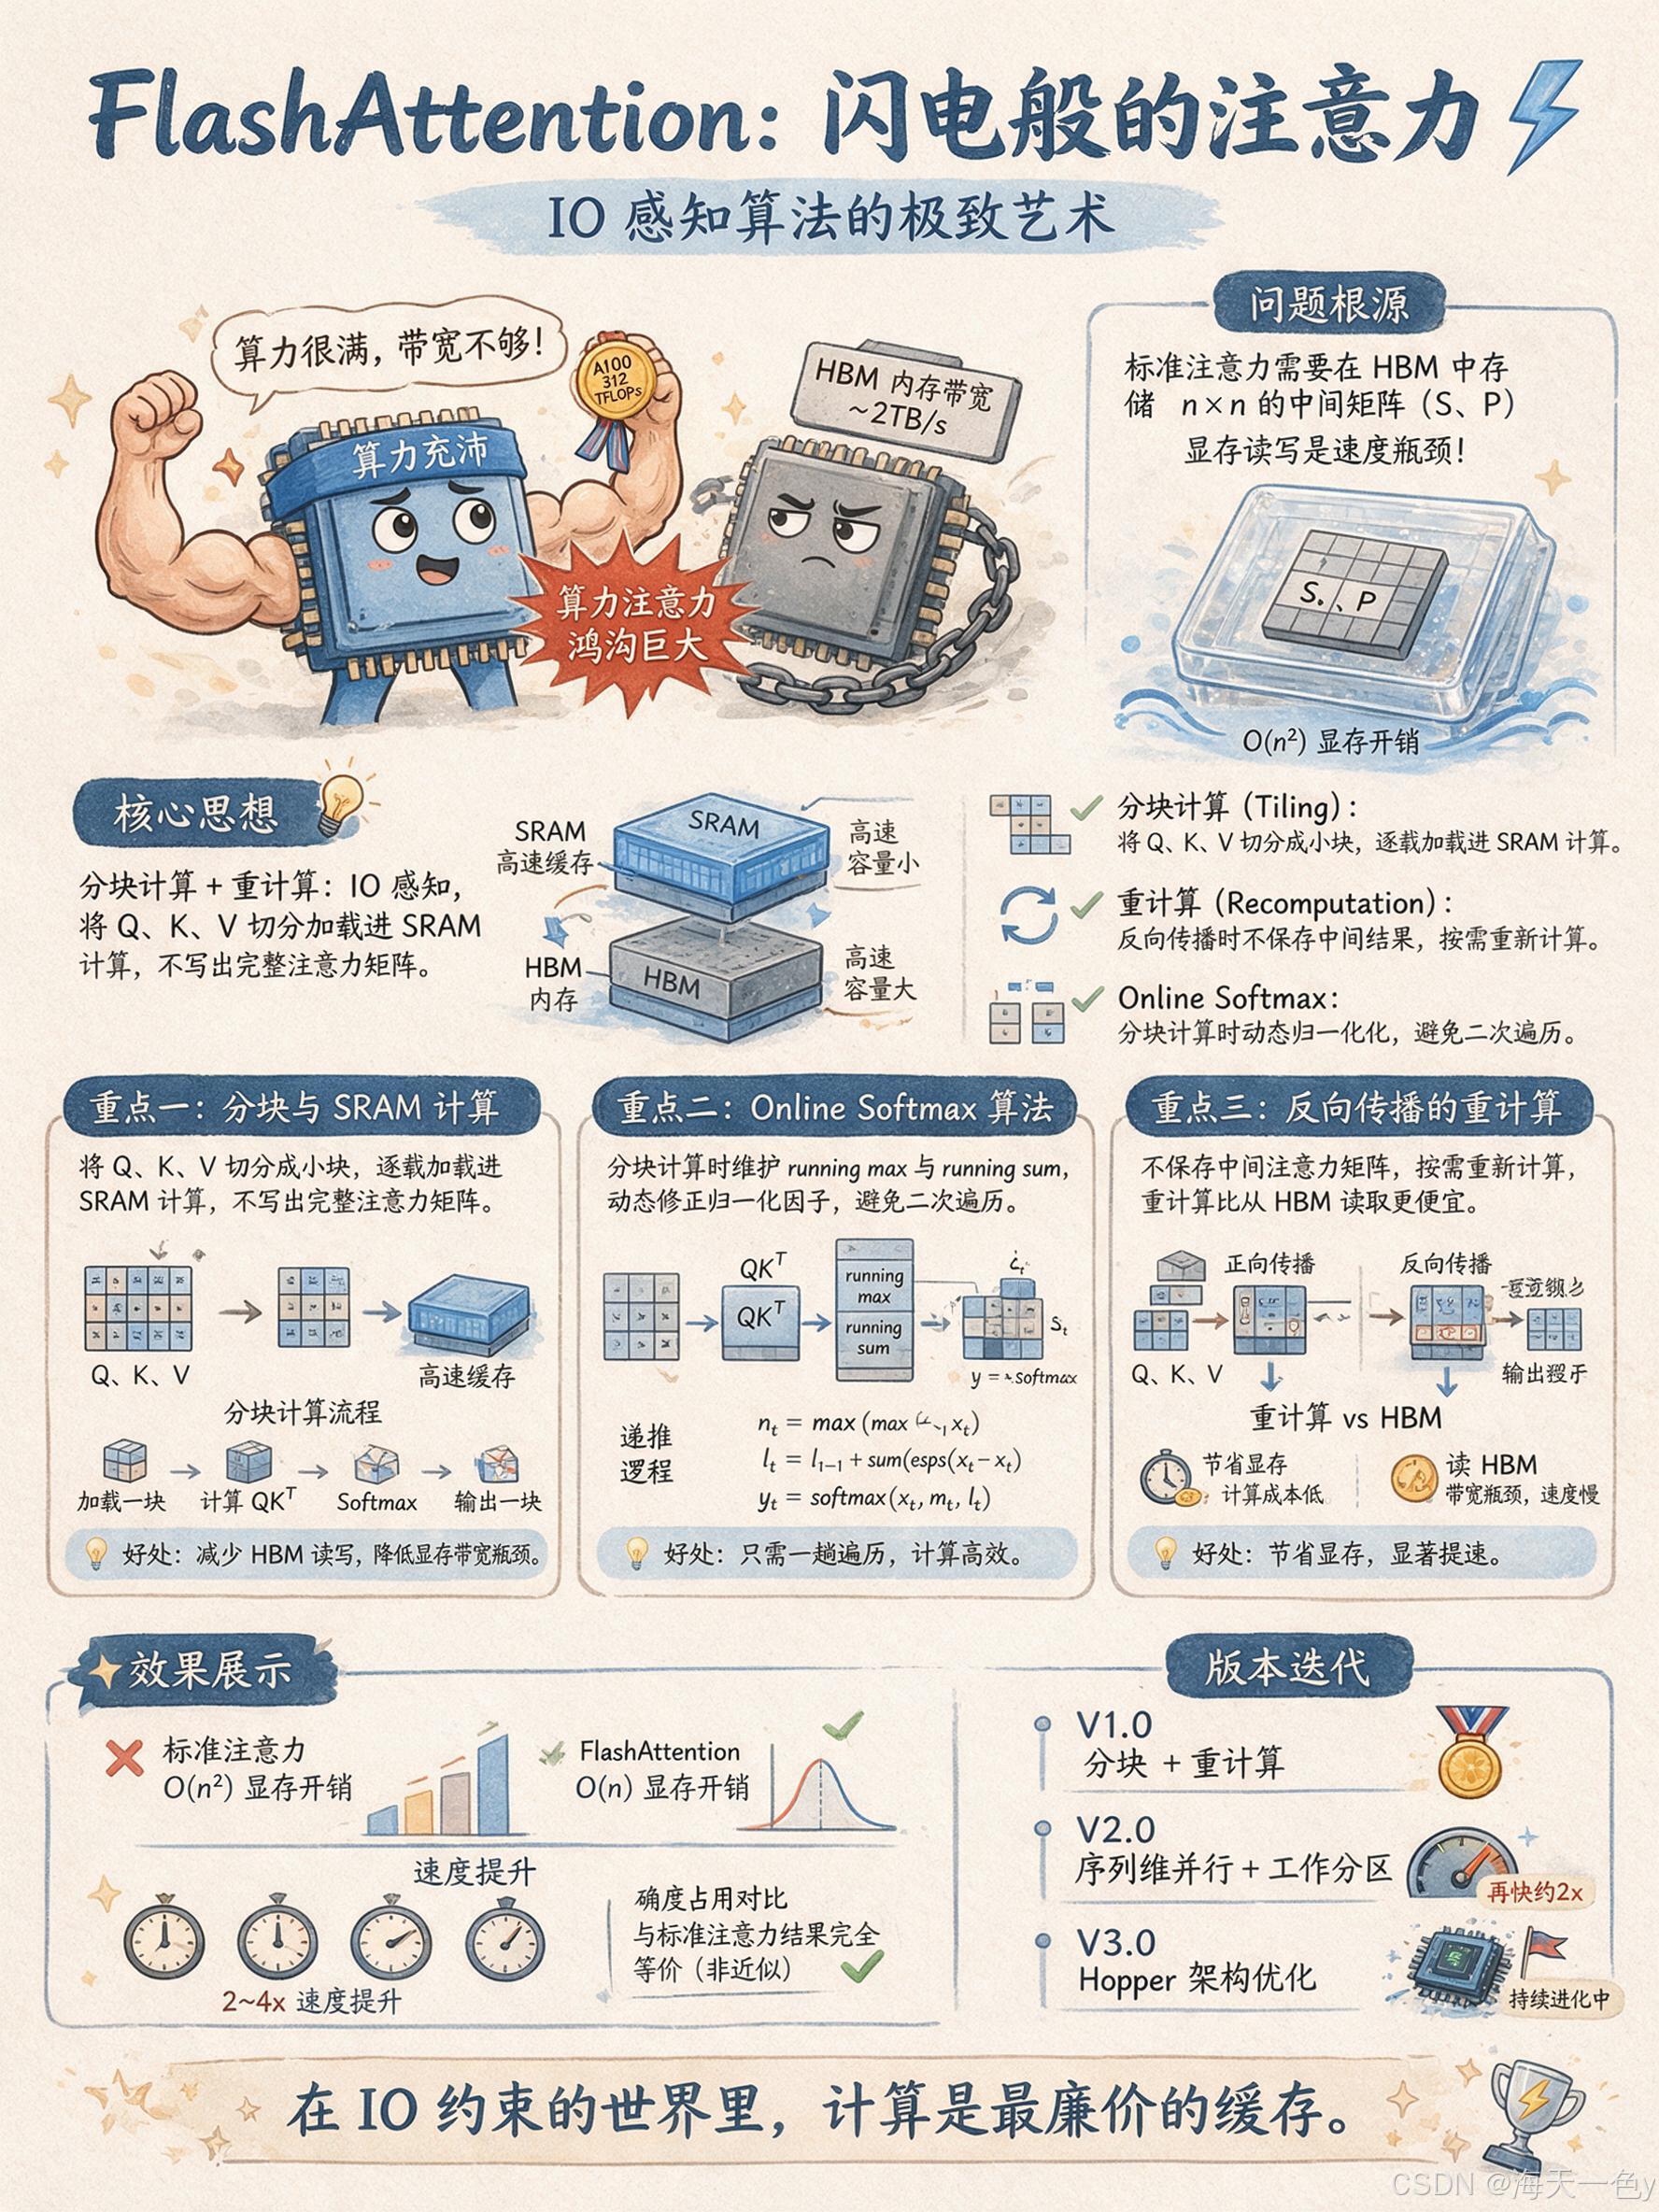
- 问题:标准注意力要在 HBM 存 n × n n\times n n×n 的中间矩阵(S、P),显存读写是瓶颈,GPU 算力(~312 TFLOPs A100)远大于内存带宽(~2TB/s)。
- 核心:Tiling(分块)+ 重计算(recomputation) :
- 把 Q、K、V 切成块,逐块加载进 SRAM(片上高速缓存)计算,不写出完整注意力矩阵。
- 用 online softmax 技巧:分块计算时维护 running max 和 running sum,动态修正归一化因子,避免二次遍历。
- 反向传播时不存中间注意力矩阵,重新计算(因为重算比读 HBM 便宜)。
- 效果:显存从 O ( n 2 ) O(n^2) O(n2) 降到 O ( n ) O(n) O(n),速度提升 2-4 倍,结果与标准注意力完全等价(非近似)。
- FlashAttention-2 优化了并行划分(按序列维并行)和 work partitioning,再快约 2 倍。FlashAttention-3 针对 Hopper 架构。
追问:online softmax 怎么保证数值稳定?
标准 softmax 为了数值稳定,会减去向量中的最大值(max trick):
softmax ( x ) = e x − max ( x ) ∑ e x − max ( x ) \text{softmax}(x) = \frac{e^{x - \max(x)}}{\sum e^{x - \max(x)}} softmax(x)=∑ex−max(x)ex−max(x)
但 FlashAttention 分块计算,不能一次性看到全向量的 max,所以用 online softmax(也叫 streaming softmax):
- 维护一个 running max m m m 和 running sum s s s,以及当前累加的输出 o o o。
- 每读入一个新块,先算块内的 m ′ = max ( m , max ( block ) ) m' = \max(m, \max(\text{block})) m′=max(m,max(block))。
- 之前的 s s s 和 o o o 都按 e m − m ′ e^{m - m'} em−m′ 缩放(因为 max 变大了,之前的指数都要除以 e m ′ − m e^{m'-m} em′−m)。
- 加上本块的贡献: s ⋅ e m − m ′ + ∑ e block − m ′ s \cdot e^{m-m'} + \sum e^{\text{block} - m'} s⋅em−m′+∑eblock−m′,输出同理。
这样每步都保证了"在当前已看到的最大值下的归一化" ,数值永远不会溢出(因为指数的输入 ≤ 0)。最后一个块处理完, s s s 就是完整的归一化分母。
这也是 FlashAttention 能保证和标准注意力完全等价的关键------没有任何近似。
Q2.6 MHA / MQA / GQA / MLA 的区别?
考点:KV Cache 优化,必考。
参考答案:
- MHA:每个头有独立的 Q、K、V,KV Cache 最大。
- MQA (Multi-Query):所有头共享 1 组 K、V,KV Cache 降到 1 / h 1/h 1/h,但效果有损。
- GQA (Grouped-Query):折中,每 g g g 个头共享 1 组 KV。LLaMA-2 70B、Mistral、Qwen 都用。当前主流。
- MLA (Multi-head Latent Attention,DeepSeek):把 KV 压缩到低维隐向量 c K V c^{KV} cKV,推理时再上投影还原:
c t K V = W D K V h t , k t = W U K c t K V c_t^{KV} = W^{DKV}h_t,\quad k_t = W^{UK}c_t^{KV} ctKV=WDKVht,kt=WUKctKV
KV Cache 大幅压缩(比 MQA 还省),且通过低秩联合压缩保留了接近 MHA 的效果。DeepSeek-V2/V3 核心创新。
追问:KV Cache 大小怎么算?
公式:
2 × batch_size × seq_len × n_layers × n_kv_heads × head_dim × dtype_bytes解释:每一层有 K 和 V 两份缓存(所以乘 2),每个 KV 头有 head_dim 维。
举个例子:LLaMA-2 7B(32 层,32 头,head_dim=128,MHA)在 fp16、seq=4096、batch=1 时:
2 × 1 × 4096 × 32 × 32 × 128 × 2 字节 = 2 GB
如果用 GQA(8 组 KV),则降到 2/8 ≈ 256 MB 。MLA 会再降一级(比如压缩到 1/3~1/2)。
实际部署中,batch 大 + 上下文长时,KV Cache 可以比权重还大,这也是为什么 KV Cache 优化是推理优化的重中之重。
Q2.7 Decoder-only 和 Encoder-Decoder 的区别?为什么现在 LLM 都用 Decoder-only?
参考答案:
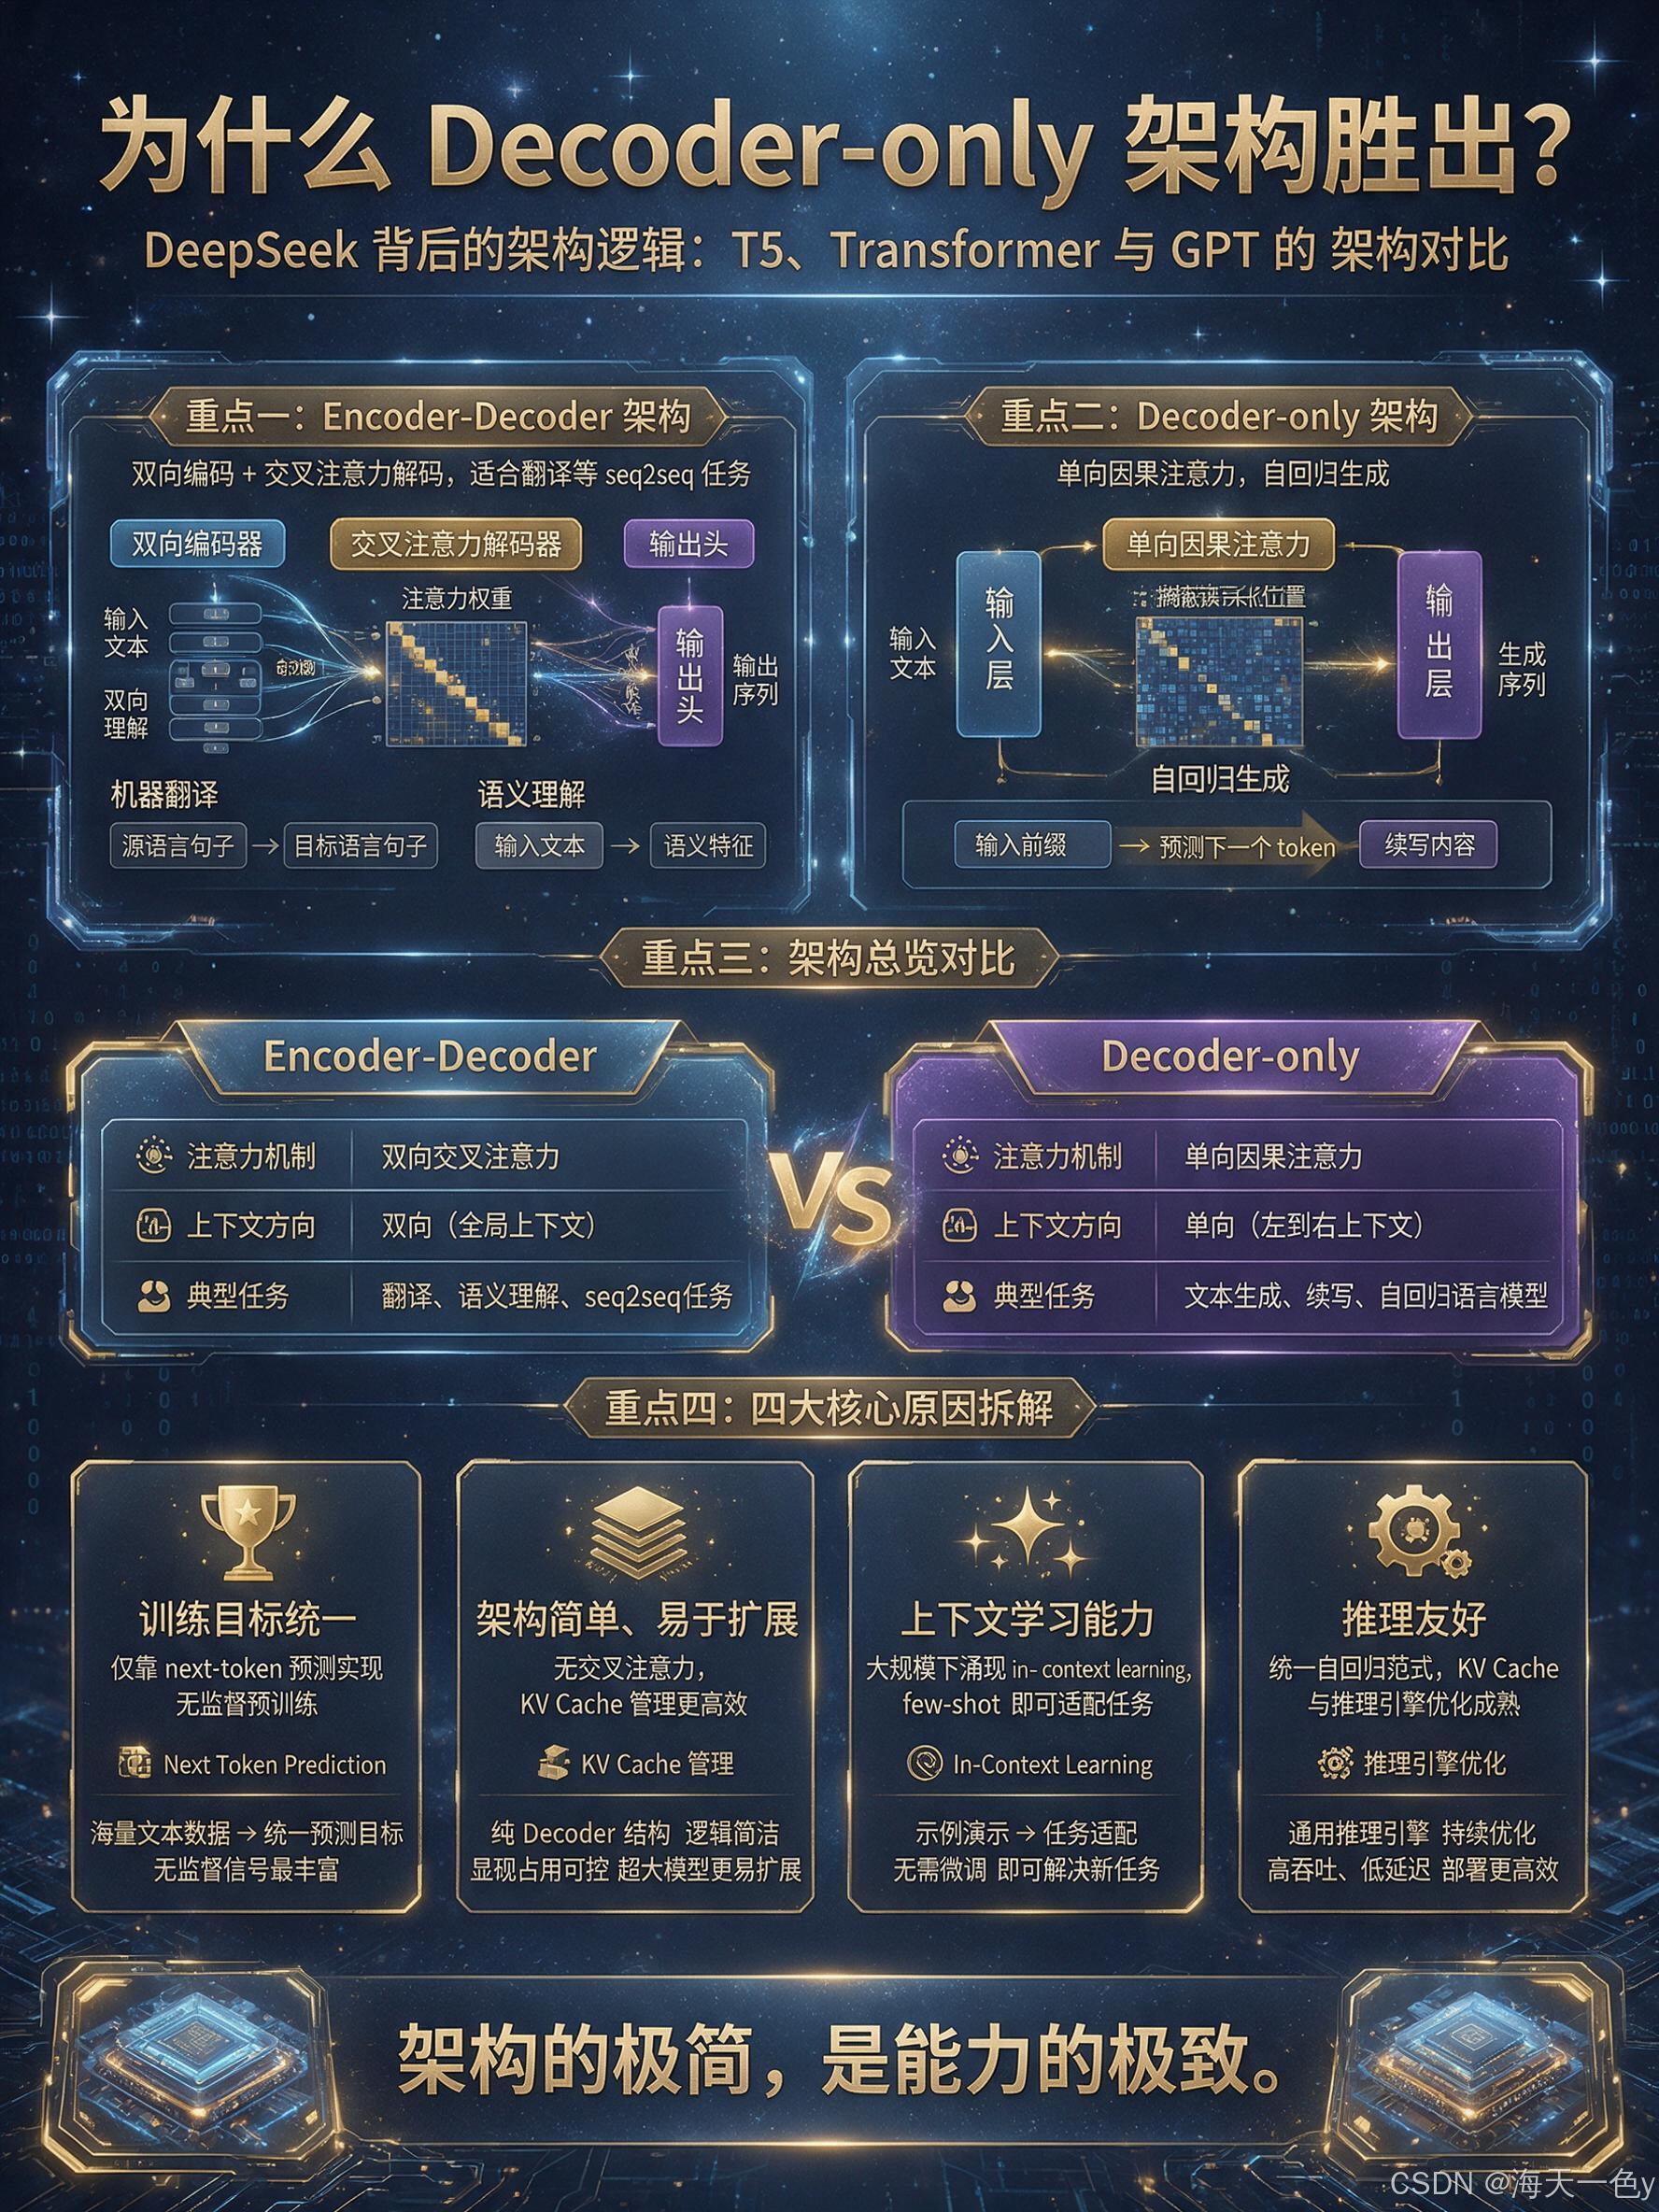
- Encoder-Decoder(T5、原版 Transformer):双向编码 + 交叉注意力解码,适合翻译等 seq2seq。
- Decoder-only(GPT):单向因果注意力,自回归生成。
- 为什么 Decoder-only 胜出:
- 训练目标统一:next-token prediction,任何文本都能当训练数据,无监督信号最丰富。
- 架构简单、易于扩展:无交叉注意力,KV Cache 管理简单,超大模型更好扩展。
- 上下文学习能力:大规模下涌现 in-context learning,few-shot 即可适配任务。
- 推理友好 :统一的自回归范式,工程优化(KV Cache、推理引擎)通用。
Q2.8 因果掩码(causal mask)怎么实现?为什么需要?
参考答案:
- 自回归生成时,位置 t t t 只能看到 ≤ t \le t ≤t 的 token,不能偷看未来。
- 实现:在 softmax 前把上三角部分置为 − ∞ -\infty −∞:
mask i j = { 0 j ≤ i − ∞ j > i \text{mask}_{ij} = \begin{cases}0 & j\le i\\ -\infty & j>i\end{cases} maskij={0−∞j≤ij>i - 训练时并行计算整个序列(teacher forcing),mask 保证每个位置的预测只依赖前文。
- 推理时不需要 mask(只算一个 token 且只关注历史)。
追问 :为什么置 − ∞ -\infty −∞ 而不置 0?
因为 softmax 做的是指数运算:
- 置 − ∞ -\infty −∞ 时, e − ∞ = 0 e^{-\infty} = 0 e−∞=0,注意力权重严格为 0,未来 token 完全不参与加权。
- 如果置 0, e 0 = 1 e^0 = 1 e0=1,不仅不是 0,反而可能因为其他 token 分数为负而变成了高权重------这相当于把未来 token 当作"中性信息"泄漏进来了,模型会偷看答案。
还有一个误区:mask 是加性的(scores = scores + mask),不是乘法。所以"屏蔽位置"对应的 mask 值是 − ∞ -\infty −∞,加到分数上就把那项压成 0 了。
实际实现里通常不会真的写 − ∞ -\infty −∞,而是用一个很大的负数(如 -1e9),因为某些框架对真正的 inf 处理有数值问题。
Q2.9 MoE(Mixture of Experts)原理?有什么优缺点?
考点:当前大模型核心架构。
参考答案:
- 结构:把 FFN 拆成 N 个专家,每层有一个 Router(门控网络)对每个 token 选 top-k 个专家(通常 k=2),只激活部分参数:
y = ∑ i ∈ TopK g i ( x ) ⋅ E i ( x ) y = \sum_{i\in \text{TopK}} g_i(x)\cdot E_i(x) y=i∈TopK∑gi(x)⋅Ei(x) - 优点:总参数量大但激活参数量小,同算力下容量更高。如 Mixtral 8x7B 总参数 47B,激活仅 ~13B。
- 缺点/难点:
- 负载均衡:token 可能都挤向少数专家,需 auxiliary loss(负载均衡损失)或 DeepSeek 的 aux-loss-free 策略。
- 显存占用大:所有专家都要加载到显存(或做专家并行)。
- 训练/推理复杂:All-to-All 通信开销大。
- 微调时不稳:专家分布易漂移。
- 前沿:DeepSeek-V3 的细粒度专家 + 共享专家、无辅助损失负载均衡、多 token 预测。
追问:Router 是怎么训练的?
Router 和主网络端到端一起训练,但 top-k 选择本身是不可导的(argmax/argtop-k 没有梯度),所以需要一些技巧:
- Straight-Through Estimator(STE):前向传播时做硬选择(只选 top-k 专家),反向传播时把梯度直接从输出传回到 gate 权重------相当于假设选择是"直通"的。这是最常用的做法。
- 软 MoE(Soft MoE):不用硬 top-k,而是用软权重分配所有专家,完全可导,但激活所有专家就失去了 MoE 的算力优势(每 token 都要过所有专家)。
- 专家并行 :训练时 token 在不同卡的专家之间做 All-to-All 通信,把 token 路由到对应的专家卡上算完再 All-to-All 回来。
还要配合负载均衡损失(auxiliary loss) ,让 Router 把 token 均匀分配给各专家,否则某些专家会过度热门、训练不均。常见的是重要性损失 + 负载损失 :
L a u x = α ⋅ ∑ i P i ⋅ f i L_{aux} = \alpha \cdot \sum_i P_i \cdot f_i Laux=α⋅i∑Pi⋅fi
其中 P i P_i Pi 是 token 分配给专家 i 的概率分布, f i f_i fi 是专家 i 的 token 占比。最小化这个乘积能让两者都均匀。
三、预训练与微调
Q3.1 预训练数据怎么处理?各阶段数据配比怎么定?
参考答案:
- 流程:采集 → 去重(MinHash/LSH)→ 质量过滤(启发式规则 + 分类器打分)→ 去毒/去隐私 → 分词 → 配比混合。
- 去重很关键:重复数据会导致模型记忆、降低泛化、浪费算力。
- 配比:通用语料 + 代码 + 数学 + 多语言,通常代码和数学占比会高于其自然分布(提升推理能力)。
- 数据质量 > 数量:FineWeb-Edu、DCLM 等工作表明高质量小数据集可胜过低质量大数据集。
- 训练后期用高质量数据做 annealing / decay 阶段(如最后 10% token 全用高质量数据)。
追问:为什么要去重?重复率多高会影响?
为什么要去重:
- 过拟合与记忆:重复数据会被模型反复看到,导致模型"死记硬背"而非学习规律,泛化能力下降。
- 评测污染:如果评测集的数据在训练集里重复出现,分数会虚高。
- 浪费算力:重复 token 占用了训练预算却没有提供新信息。
- 多样性降低 :数据分布变窄,影响模型能力的广度。
重复率多高会影响:经验上,当某段文本重复次数超过 3-4 次 时,对模型的负面影响就开始显著了。Touvron 等(LLaMA 论文)发现"高质量数据 + 适度去重"比"原始大数据"效果好。
去重方法:MinHash + LSH(近邻去重,找相似文档)、exact dedup(精确去重,比如按行或段落 hash)、基于 n-gram 重叠率的去重。
注意也不能去重太狠------自然语言里有些常见表达本身就会反复出现,过度去重会丢失自然分布。
Q3.2 续训练(Continual Pre-training)和微调的区别?
参考答案:
- 续训练:用领域大量无标注语料继续 next-token 训练,改变模型底层知识分布,成本高(易灾难性遗忘)。
- 微调:用少量标注数据做有监督适配,改动上层,成本低。
- 实践顺序:续训练(可选)→ SFT → 偏好对齐(DPO/RLHF)。
- 灾难性遗忘的缓解:混入通用数据(replay)、LoRA 冻结主干、小学习率、KL 约束。
Q3.3 全量微调 vs LoRA vs QLoRA
参考答案:
- 全量微调:更新所有参数,效果上限最高,显存需求大(7B 需 ~60-80GB,需 ZeRO/FSDP)。
- LoRA :冻结原权重,注入低秩分解矩阵 Δ W = B A \Delta W = BA ΔW=BA( B ∈ R d × r , A ∈ R r × k B\in\mathbb{R}^{d\times r}, A\in\mathbb{R}^{r\times k} B∈Rd×r,A∈Rr×k, r ≪ d r \ll d r≪d),只训 A、B:
h = W 0 x + α r B A x h = W_0x + \frac{\alpha}{r}BAx h=W0x+rαBAx- 参数量降到 ~0.1-1%,显存大降,可插拔多任务。
- 初始化:A 用高斯、B 用 0,保证初始 Δ W = 0 \Delta W=0 ΔW=0。
- 常用 r = 8 ∼ 64 r=8\sim64 r=8∼64, α = 2 r \alpha=2r α=2r。
- QLoRA :把基座量化为 4-bit(NF4)冻结,再在其上训 LoRA 适配器。7B 模型单卡 24GB 可训。
- 关键技巧:NF4 量化 (正态分布最优分位)、双重量化 (量化量化常数)、Paged Optimizer(分页优化器应对显存峰值)。
追问:LoRA 能不能合并回原权重?有哪些改进变体?
能合并回原权重,且无推理开销 。LoRA 的输出是 h = W 0 x + α r B A x h = W_0 x + \frac{\alpha}{r}BAx h=W0x+rαBAx,推理时可以把 LoRA 权重加到基座上:
W = W 0 + α r B A W = W_0 + \frac{\alpha}{r} BA W=W0+rαBA
合并后和原模型结构完全一样,推理速度不变。
但如果要多任务切换(同时用多个 LoRA 适配器),就不能都合并,需要动态加载,或者用 MoE 风格路由。
常见改进变体:
- rsLoRA :缩放因子用 1 / r 1/\sqrt{r} 1/r 而非 α / r \alpha/r α/r,让 rank 变化时训练更稳定。
- DoRA (Weight-Decomposed LoRA):把 LoRA 的更新分解为大小 + 方向两部分,用 LoRA 只更新方向、大小单独学,表达力更强。
- LoRA+:给 A 和 B 矩阵不同学习率(B 用更大的 lr),提升效果。
- QLoRA:基座量化为 4-bit,LoRA 正常训练,实现单卡 24G 训 70B。
- VeRA:冻结 A、B 结构,只学每层一个标量向量,进一步降参。
Q3.4 LoRA 应该加在哪些层?rank 怎么选?
参考答案:
- 原始论文:仅加在 attention 的 W q , W v W_q, W_v Wq,Wv;后续发现加到所有线性层 (含 FFN、 W k , W o W_k, W_o Wk,Wo)效果更好。
- rank:任务越复杂/数据越多,rank 越大。简单风格迁移 r=4-8 够;复杂推理 r=64-128。经验上"提高 rank + 降低 lr"往往更好。
- 常见实战:r=16/32/64,α=16/32/64,lr=1e-4 ~ 2e-4。
Q3.5 指令微调(SFT)数据怎么构建?有哪些坑?
参考答案:
- 数据来源:人工标注、开源数据集(如 Alpaca、ShareGPT)、强模型蒸馏(Self-Instruct、Evol-Instruct)、拒绝采样(用强模型生成再筛)。
- 关键:多样性 > 数量 、质量 > 数量,几千条高质量数据即可显著提升指令遵循能力(LIMA 论文)。
- 坑:
- 数据格式不统一导致模板混乱 → 需严格统一 prompt template。
- 只训 assistant 部分(mask 掉 user/system 的 loss)。
- 过拟合 SFT 数据会损害通用能力和多样性。
- 数据分布偏斜(全是简单问答 → 复杂任务退化)。
Q3.6 SFT 和 RLHF 分别解决什么问题?为什么 SFT 不够?
参考答案:
- SFT:教模型"怎么回答"(格式、风格、基本能力),本质是模仿给定答案。
- SFT 的局限:
- 只能学到"正确示范",无法区分好答案和更好答案(缺乏偏好信号)。
- 数据是单轮标注,难覆盖多轮、复杂安全场景。
- 模型会模仿标注数据中的错误。
- RLHF:用人类偏好排序训练 reward model,再优化策略提升"人类喜欢"的响应,能处理细微偏好、安全性、幻觉抑制。
- 现在有 DPO 等免 RL 的替代方案,效果接近且更简单。
Q3.7 分词器:BPE / WordPiece / SentencePiece 的区别?
考点:Tokenizer 原理。
参考答案:
- BPE (字节对编码):从字符开始,反复合并最高频的相邻 pair,直到词表达到目标大小。GPT 系列用 byte-level BPE(先转成字节,解决 OOV)。
- WordPiece :BERT 用,合并准则不是频率而是似然提升 (选择使语言模型概率提升最大的 pair),遇到未登录词用
##前缀拆子词。 - SentencePiece :把输入当作原始字符流 (含空格,用
▁表示),不依赖预分词,天然支持多语言(中文/日文无空格语言)。LLaMA、T5 用它,含 BPE 和 Unigram 两种模式。 - 词表大小权衡:太小 → 序列长、压缩率低;太大 → embedding 参数多、罕见词训练不足。LLaMA-3 扩到 128K 词表以提升多语言和压缩率。
追问:为什么现在都用 byte-level?
核心原因是彻底消除 OOV(Out-of-Vocabulary)问题 。byte-level BPE 把输入先转成字节(每个字节 256 种可能),再做 BPE 合并。任何文本------不管是 emoji、生僻字、代码符号、乱码、外语文本------都能被编码,不会有"未登录词"。
这对大模型特别重要,因为大模型训练数据来自全网,什么内容都有,OOV 会严重影响模型对罕见内容的理解。
缺点:
- 对中文等非拉丁语言不友好------一个汉字 3 个字节,初始就要 3 个 token,即使合并后通常也要 1-2 个 token/汉字,压缩率比英文低很多。
- 词表需要更大才能达到相同的压缩率(LLaMA-3 把词表扩到 128K,很大程度就是为了更好地压缩多语言和代码)。
对比:WordPiece 用##前缀处理子词,但仍有 OOV 问题;SentencePiece 更干净,支持 BPE 和 Unigram 两种模式。
Q3.8 什么是数据污染(Data Contamination)?怎么检测和缓解?
参考答案:
- 定义:评测集(或与之高度重叠的数据)混进了训练语料,导致评测分数虚高,无法反映真实泛化。
- 检测:
- N-gram 重叠:比对训练集与测试集的 n-gram 重合率。
- 困惑度/生成检测:模型对测试题是否异常"熟悉"(能直接复述)。
- 时序切分:只报告模型 cutoff 之后的评测集。
- 用私有/动态生成的测试集(如 LiveBench、LiveCodeBench 定期更新)。
- 缓解:严格去重(对评测集做 n-gram 过滤)、数据溯源记录、动态评测集。
追问:为什么"网络语料里本身就有答案"也算污染?
因为模型可能通过记忆 而不是学会能力 得到高分。
举个例子:GSM8K 的题目在 StackExchange、知乎、各种博客里被广泛讨论。如果训练语料里直接包含了完整的题目+答案,那么模型在 GSM8K 上的高分只能说明"它见过并记住了这些题",不能说明"它学会了解数学题的通用能力"。
这种"看似会了但其实是背答案"的现象,是模型评测中最隐蔽也最严重的问题之一。
怎么检测?常用手段:
- n-gram 重叠率:13-gram 以上重叠就算可疑(因为正常不会出现连续 13 个词完全一样的段落)。
- 困惑度差异:模型对测试集的困惑度如果显著低于同分布的其他数据,说明可能见过。
- 复制测试:把测试题的前半段喂给模型,看它能不能一字不差续出后半段(能续上 = 记住了)。
- 变体测试 :把题目里的数字/人名换一下,如果能力骤降 = 记忆而非理解。
这也是为什么现在越来越重视动态评测集 (定期更新题目)和私人评测集的原因。
Q3.9 长文本微调怎么做?为什么不能直接扩长度?
参考答案:
- 不能直接扩的原因:
- 位置编码没外推能力(可学习绝对位置直接失效)。
- 注意力 O ( n 2 ) O(n^2) O(n2),显存和算力爆炸。
- 训练数据里没有长依赖样本,模型没学会利用远端信息。
- 做法:
- 换/改位置编码:RoPE 插值、NTK-aware、YaRN。
- 先短后长(progressive length):从短序列逐步扩到目标长度,比直接长序列收敛快。
- 显存手段:序列并行(Ring Attention)、梯度检查点、FlashAttention。
- 数据:构造真正的长依赖任务(长文档 QA、多跳),而非简单拼接短文本。
- 微调数据量不需要很大(数千条高质量长样本),但要覆盖目标长度。
Q3.10 多轮对话微调有什么特殊处理?
参考答案:
- Loss masking:只在 assistant 回复上算 loss,system/user 部分的 token 不计入(否则模型会学着生成用户的话)。
- 多轮数据构造:把多轮对话拼成一条序列,但保证每轮的 loss 只在其回复段。
- 角色标签 :不同模型用不同 special token(
<|user|>、<|assistant|>),要和预训练/special token 对齐。 - 长度控制:多轮拼接后容易超长,需按轮次裁剪或滑动。
- 坑:SFT 阶段如果全是单轮,模型多轮能力会退化;需要用真实多轮数据(如 ShareGPT 风格)。
四、RLHF 与对齐
Q4.1 完整讲一下 RLHF 三阶段流程
考点:对齐必考。
参考答案:
- SFT :用人工示范数据做监督微调,得到初始策略 π S F T \pi_{SFT} πSFT。
- Reward Model :对同一 prompt 采样多个回答,人工排序,训练一个打分模型 r ϕ r_\phi rϕ,用 pairwise ranking loss:
L = − log σ ( r ϕ ( x , y w ) − r ϕ ( x , y l ) ) \mathcal{L} = -\log\sigma(r_\phi(x,y_w) - r_\phi(x,y_l)) L=−logσ(rϕ(x,yw)−rϕ(x,yl))
(y_w 是更优回答,y_l 是较差回答) - PPO 强化学习 :以 RM 为奖励,用 PPO 优化策略,并加 KL 惩罚防止偏离 π S F T \pi_{SFT} πSFT 太远:
L = E r ϕ ( x , y ) − β K L ( π θ ∥ π r e f ) \mathcal{L} = \mathbb{E}r_\\phi(x,y) - \beta\, KL(\pi_\theta \| \pi_{ref}) L=Erϕ(x,y)−βKL(πθ∥πref)- 需要 4 个模型同时在显存:policy、reference、reward、critic(value model)。
追问:KL 惩罚的作用?β 怎么选?
KL 惩罚的作用:
- 防止策略跑偏太远:RM 本身有误差,如果没有约束,策略可能越优化越偏离人类语言分布(reward hacking)。KL 惩罚相当于给策略上了一个"锚",让它在参考模型附近优化。
- 维持输出多样性与自然度:没有 KL 约束,策略可能坍缩到少数高奖励的模式(模式坍缩),输出变得机械、重复。
- 数值稳定 :防止策略探索到 RM 没有见过的奇怪分布,导致训练发散。
β 的选择:
- β 太小:约束弱,策略容易跑偏、多样性下降、奖励作弊。
- β 太大:约束太强,策略学不动,对齐效果差("对齐税"太高)。
- 实践中 β 通常在 0.01 ~ 0.5 之间,具体要根据任务调。常用自适应 KL (KL 目标值法):如果 KL 超过阈值就增大 β,低于阈值就减小 β。
另外注意 RLHF 里用的是反向 KL ( K L ( π θ ∥ π r e f ) KL(\pi_\theta \| \pi_{ref}) KL(πθ∥πref)),它是 mode-seeking 的------策略倾向于只覆盖参考分布的高概率区域,避免乱生成。
Q4.2 PPO 的核心思想?为什么要用 clip?
参考答案:
- 目标(简化版):
L C L I P = E min ( ρ t A \^ t , clip ( ρ t , 1 − ϵ , 1 + ϵ ) A \^ t ) L^{CLIP} = \mathbb{E}\left\\min\\left(\\rho_t \\hat A_t,\\ \\text{clip}(\\rho_t, 1-\\epsilon, 1+\\epsilon)\\hat A_t\\right)\\right LCLIP=Emin(ρtA\^t, clip(ρt,1−ϵ,1+ϵ)A\^t)
其中 ρ t = π θ ( a ∣ s ) / π o l d ( a ∣ s ) \rho_t = \pi_\theta(a|s)/\pi_{old}(a|s) ρt=πθ(a∣s)/πold(a∣s) 是重要性采样比, A ^ t \hat A_t A^t 是优势函数。 - 动机:on-policy 采样昂贵,用旧策略的数据多次更新(importance sampling),但比值偏离太远会导致方差爆炸 → clip 限制更新幅度,保证"信任域"。
- 优势估计常用 GAE(广义优势估计),critic 学 value function。
追问:PPO 在 LLM 里的"action"是什么?奖励是稀疏的怎么处理?
在自回归生成的语境下:
- 每个 token 是一个 action,模型一次生成一个 token,相当于 RL 里智能体走一步。
- 一整条 response 是一个 episode(从第一个 token 到 EOS)。
- 奖励是稀疏的 :通常只有整句话生成完了,RM 才给一个标量奖励(末尾给)。中间每个 token 没有即时奖励。
稀疏奖励的处理:
- 价值函数(Critic/Value Model):用一个 value model 来估计每个位置的累积回报(V 值),提供密集的价值估计,让每个 token 都有"引导信号"。
- GAE(广义优势估计):结合多步 TD 误差,平衡偏差和方差,得到更稳定的优势估计。
- KL 惩罚:在每一步都施加 KL 约束,相当于提供了一个密集的"负奖励",也缓解了奖励稀疏。
- 奖励塑形 :比如给格式正确、引用正确等中间信号加分。
这也是为什么 PPO 在 LLM 上训练不稳、调参困难------奖励稀疏 + 动作空间巨大(词汇表几万),credit assignment 很难。
GRPO 也是同样的稀疏奖励设置,只是用组内归一化替代了 value model。
Q4.3 DPO 原理?和 RLHF 的关系?
考点:当前主流对齐方法。
参考答案:
- 观察:RLHF 的 KL 约束最优策略有闭式解:
π ∗ ( y ∣ x ) ∝ π r e f ( y ∣ x ) exp ( 1 β r ( x , y ) ) \pi^*(y|x) \propto \pi_{ref}(y|x)\exp\left(\frac{1}{\beta}r(x,y)\right) π∗(y∣x)∝πref(y∣x)exp(β1r(x,y))
反解出 reward,代入 Bradley-Terry 偏好模型,reward 被消掉,直接得到 DPO 损失:
L D P O = − log σ ( β log π θ ( y w ∣ x ) π r e f ( y w ∣ x ) − β log π θ ( y l ∣ x ) π r e f ( y l ∣ x ) ) \mathcal{L}{DPO} = -\log\sigma\left(\beta\log\frac{\pi\theta(y_w|x)}{\pi_{ref}(y_w|x)} - \beta\log\frac{\pi_\theta(y_l|x)}{\pi_{ref}(y_l|x)}\right) LDPO=−logσ(βlogπref(yw∣x)πθ(yw∣x)−βlogπref(yl∣x)πθ(yl∣x)) - 本质:把 RL 问题转化为在偏好数据上的分类问题,不需要显式 reward model,不需要在线采样,训练稳定、便宜(只需 policy + reference 两个模型)。
- 与 RLHF 关系:数学上等价于带 KL 约束的 RLHF 的最优策略,是 offline 版本。
追问:DPO 的缺点?有什么改进?
DPO 的主要缺点:
- 离线方法,无法探索:受限于给定的偏好数据质量,不能像 PPO 那样在线采样新回答、发现新的高分区域。上限由数据决定。
- 对参考模型敏感:reference model 的质量直接影响对齐效果;参考模型差的话,DPO 很难学到好的策略。
- 多样性下降 :DPO 倾向于提升偏好评级,但代价是降低输出的困惑度(多样性下降)------有论文指出 DPO 后模型的生成多样性会降低。
- 容易过拟合偏好数据:偏好数据通常不多,DPO 容易过拟合。
- 没有显式 reward :无法复用于后续迭代、无法监控 reward 变化。
主要改进:
- IPO:用 identity 映射替代 log-sigmoid,缓解过拟合。
- KTO:不需要成对偏好数据,只需要"好/坏"二元标签,更贴合实际数据收集场景。
- ORPO:把 SFT 和偏好对齐合并成一个阶段(odds ratio 惩罚),省掉 reference model。
- SimPO:用平均 log 概率做隐式奖励 + 目标奖励间隔,也去掉了 reference model。
- Iterative DPO:反复"采样 → 标注偏好 → DPO",模拟在线 RL 的效果,但更简单。
Q4.4 什么是 Reward Hacking?怎么缓解?
参考答案:
- 模型找到奖励模型的"漏洞",生成在 RM 下高分但实际质量差的输出(如堆砌奉承话、长度膨胀、重复特定格式)。
- 缓解:
- KL 惩罚约束偏离。
- 奖励模型集成/多 RM 投票。
- 定期用新数据重训 RM。
- 改进 RM 泛化(数据多样性、加对抗样本)。
- 用 rule-based 奖励(如数学/代码用可验证答案,DeepSeek-R1 的 GRPO + 规则奖励)。
Q4.5 GRPO 是什么?为什么 DeepSeek-R1 用它?
参考答案:
- GRPO(Group Relative Policy Optimization):去掉 critic/value model,对同一 prompt 采样一组(G 个)回答,用组内奖励的均值/标准差归一化 得到相对优势:
A ^ i = r i − mean ( { r } ) std ( { r } ) \hat A_i = \frac{r_i - \text{mean}(\{r\})}{\text{std}(\{r\})} A^i=std({r})ri−mean({r}) - 好处:省掉 value model(显存大降)、训练更简单;组内相对比较天然适配"可验证奖励"(数学题对错、代码通过与否)。
- R1 用 GRPO + 规则奖励(答案正确性 + 格式),跳过了 reward model,冷启动 SFT + 纯 RL 就能激发长链推理(long CoT)能力。
追问:组内奖励全相同怎么办?
如果同一 prompt 的所有回答都得一样的奖励(比如全部答对或全部答错),那奖励的标准差为 0,归一化后优势全为 0,这条数据对训练没有梯度贡献------相当于被跳过了。
这在太简单或太难 的题上都会发生:太简单的所有采样都答对,太难的全都答不对。
对策:
- 课程学习(curriculum learning):从简单到难逐步提升难度,保证每阶段的数据对模型来说有"区分度"。
- 奖励多样化:不只看最终答案对错,加入格式奖励、步骤奖励、效率奖励等,增加组内差异。
- 温度调节:调整采样温度,让组内回答更多样(温度越高,组内差异越大,越容易有梯度信号)。
- 数据筛选:过滤掉太简单或太难的样本,只保留模型能"学到东西"的区间。
- 增大组大小 G :组越大,组内出现差异的概率越高。通常 G=8~16。
这也是为什么 GRPO 配合可验证奖励效果最好------可验证奖励有明确的对错,且题目难度可控,能有效保证组内差异。
Q4.6 什么是对齐税(alignment tax)?
参考答案:
- 对齐训练(RLHF/安全微调)后,模型在部分能力上(如数学、多样性、创造力)反而下降的现象。
- 缓解:混入预训练数据、多目标联合优化、只对安全相关维度施加约束、迭代式对齐(对齐时保留通用能力评估)。
Q4.7 Bradley-Terry 模型是什么?为什么偏好建模用它?
参考答案:
- BT 模型:假设每个响应有一个潜在"实力"分数 r ( x , y ) r(x,y) r(x,y),则 y_w 优于 y_l 的概率:
P ( y w ≻ y l ) = σ ( r ( x , y w ) − r ( x , y l ) ) P(y_w \succ y_l) = \sigma(r(x,y_w) - r(x,y_l)) P(yw≻yl)=σ(r(x,yw)−r(x,yl)) - 它把"排序"问题转成"二分类"问题,只需比较分数差,不需绝对分数,契合人类只能给出相对偏好的特性。
- 用最大似然训练 RM: L = − E log σ ( r w − r l ) \mathcal{L} = -\mathbb{E}\\log\\sigma(r_w - r_l) L=−Elogσ(rw−rl)。
- 局限:假设偏好传递(若 A>B、B>C 则 A>C),但人类偏好常不满足传递性;且无法建模"这两条一样好"(平局)。替代:Plackett-Luce(多响应排序)、regression-based(直接打分)。
追问:Reward Model 的输出尺度重要吗?怎么处理?
非常重要,但 RM 的绝对分数本身没意义。
RM 是通过 pairwise ranking loss 训练的,学到的是相对偏好------它的输出可以整体平移或缩放而不改变排序结果。但在 RL 训练中,绝对分数直接影响奖励大小和训练稳定性:
- 如果 RM 分数尺度漂移(比如某些 prompt 的分数整体偏高),PPO 的梯度会不稳。
- KL 惩罚和奖励的相对大小决定了优化方向------奖励太大 KL 约束就失效了。
处理方式:
- 奖励归一化/白化(whitening):在每个 batch 内对奖励做均值为 0、方差为 1 的归一化,或者用 running mean/std 做归一化。
- 奖励裁剪(clip):限制奖励的上下界。
- 校准:用一个小的 holdout 集对 RM 分数做校准(比如 Platt scaling)。
- RM 训练时加正则 :如对输出做归一化约束。
另外注意,DPO 就不存在这个问题------它直接用 log 概率比,不需要显式 reward,也就不需要考虑尺度。
Q4.8 RLHF、DPO、KTO、ORPO、SimPO 的区别和演进?
参考答案:
| 方法 | 需要 RM | 需要在线采样 | 核心思想 |
|---|---|---|---|
| RLHF (PPO) | 是 | 是 | 显式奖励 + RL 优化 |
| DPO | 否 | 否 | 偏好数据直接优化策略(隐式奖励) |
| IPO | 否 | 否 | 解决 DPO 过拟合,用 identity 映射替代 log-sigmoid |
| KTO | 否 | 否 | 不需要成对数据,只需"好/坏"标签(利用前景理论) |
| ORPO | 否 | 否 | 把 SFT 和偏好对齐合并成一个阶段(odds ratio 惩罚) |
| SimPO | 否 | 否 | 用平均 log 概率做隐式奖励 + 目标奖励间隔,去掉 reference model |
- 演进主线:越来越简单、越来越省资源(去 RM、去在线采样、甚至去 reference model)。
- 取舍:DPO 系在多样化上可能不如 PPO,PPO 上限更高但工程复杂、易不稳。大规模前沿模型(如 DeepSeek、Qwen)仍常用在线 RL(PPO/GRPO)配合可验证奖励。
追问:什么时候该用 PPO 而不是 DPO?
尽管 DPO 更简单更稳定,但在以下场景 PPO(或在线 RL)仍然更优:
- 有可靠的可验证奖励:比如数学题(答案可对)、代码(单元测试可跑)、工具调用(有执行结果)。这种场景下在线 RL 可以不断探索新解法,上限比离线 DPO 高得多(DeepSeek-R1 的成功就是例证)。
- 需要探索新回答空间:如果偏好数据有限或质量不高,DPO 受限于数据;在线 RL 可以自己采样发现更好的回答。
- 长对话/多轮交互:多轮中奖励信号复杂,离线数据难以覆盖所有对话路径,在线 RL 能学习动态策略。
- 奖励是外部环境反馈 :如工具使用、游戏、机器人控制等交互场景,奖励只能通过在线试错获得。
什么时候 DPO 足够 :数据充足、任务明确、对训练稳定性和成本敏感的场景------这也是大多数中小团队的实际情况。
趋势:越来越多的前沿模型(DeepSeek、Qwen、OpenAI o 系列)走向在线 RL + 可验证奖励的路线,因为这似乎是突破推理能力上限的关键。
Q4.9 拒绝采样(Rejection Sampling)微调 / Best-of-N 是什么?
参考答案:
- Best-of-N:对同一 prompt 采样 N 个回答,用 RM 打分选最高分的返回。简单有效但 N 倍推理成本,且仅是"选优"不改模型。
- 拒绝采样微调(RFT):用 RM 或规则筛出高质量样本,再拿去 SFT,把"采样优选"的能力内化到模型里。可迭代(采样 → 筛选 → SFT → 再采样)。
- STaR / 自举推理:对推理题,模型生成多个解,筛出答案对的,作为新的 CoT 训练数据,反复自举。这是 R1 蒸馏流程的重要环节。
- 关联:**多数投票(self-consistency)**是推理时版------采样多条 CoT,选出现最多的答案。
追问:拒绝采样的风险?
拒绝采样(Rejection Sampling / Best-of-N)是简单有效的提升手段,但也有风险:
- 筛选偏差(Selection Bias) :如果筛选标准(如 RM 打分)有缺陷,拒绝采样会放大这个缺陷------比如 RM 偏好长回答,模型就会越来越啰嗦;RM 偏好奉承话,模型就越来越谄媚。
- 模式坍缩(Mode Collapse):过度迭代筛选会让模型输出越来越同质,多样性下降。因为每次都选"最高分"的样本,分布的尾部被砍掉了。
- 数据分布偏移:反复用筛选后的数据微调,模型分布会偏离预训练分布,可能损害通用能力。
- 成本 :N 倍的采样 + 筛选成本。Best-of-N 在推理时用就是 N 倍推理成本。
缓解方式:
- 控制迭代轮数,不要无限迭代。
- 混入原始/多样数据,保持多样性。
- 用更可靠的奖励(如可验证奖励替代 RM 打分)。
- 多样性约束(如加温度、加 diversity 奖励)。
Q4.10 怎么评估对齐效果?有哪些安全对齐手段?
参考答案:
- 评估:
- 偏好评测:用 LLM-as-judge 或人工做 pairwise 对比(Arena Elo、AlpacaEval、MT-Bench)。
- 能力回归:确保对齐后 MMLU/GSM8K 等不退化(对齐税)。
- 安全评测:红队测试、有害指令拒绝率、越狱(jailbreak)鲁棒性、TruthfulQA。
- 过度拒绝(over-refusal):无害问题被误拒的比例,安全性太高会伤害可用性。
- 安全对齐手段:
- 安全 SFT:构造拒答样本,教会模型拒绝有害请求。
- 安全 RLHF:奖励模型对有害输出给极低分。
- 宪法 AI(Constitutional AI)/RLAIF:用一套"宪法"原则让 AI 自我批评并修正,减少人工标注。
- 系统提示 + 输入/输出过滤:外部 guardrail(Llama Guard)。
- 对抗训练:加入 jailbreak 样本提升鲁棒性。
Q4.11 什么是 RLAIF?和 RLHF 的区别?
参考答案:
- RLAIF(RL from AI Feedback):用强 AI 模型代替人类标注偏好/打分。
- 优势:成本低、速度快、可扩展、标注一致性高;可实现"AI 监督 AI"的可扩展监督。
- 劣势:继承了 AI 标注者的偏见和盲点,可能放大错误;对超出 AI 能力的任务无效。
- 应用:Constitutional AI、Claude 的部分训练流程、多数开源模型的偏好数据生成。
五、推理与部署优化
Q5.1 量化:PTQ 和 QAT 的区别?主流量化方案?
参考答案:
- PTQ(训练后量化):训练完直接量化,廉价,可能精度损失。GPTQ、AWQ、GGUF、SmoothQuant。
- QAT(训练中量化):训练时模拟量化误差(fake quant),精度更好但成本高。
- 主流方案:
- GPTQ:逐层、基于二阶 Hessian 信息的权重量化(4-bit),需要校准数据。
- AWQ :激活感知,识别"重要通道"(大激活对应的权重)做保护,比 GPTQ 更快更准,当前部署首选。
- GGUF/llama.cpp:CPU/混合推理格式,支持多种量化等级(Q4_K_M 等),适合本地部署。
- SmoothQuant :把激活的量化难度"迁移"到权重上( X ⋅ W = ( X / s ) ⋅ ( s W ) X\cdot W = (X/s)\cdot(sW) X⋅W=(X/s)⋅(sW)),实现 W8A8。
- FP8:H100 原生支持,训练和推理都用,DeepSeek-V3 用它做训练。
追问:为什么权重容易量化、激活难量化?
原因主要有三点:
- 分布差异 :权重大致呈正态/均匀分布,范围稳定,比较容易量化。而激活有严重的离群值(outlier)------少数通道的数值比其他通道大几个数量级(在大模型中很普遍),直接量化会让这些通道的精度损失不可接受。
- 静态 vs 动态:权重是静态的(训练完就固定了),可以花时间做最优量化(如 GPTQ 用 Hessian 信息找最优量化点)。激活是动态的(每次输入都不同),量化更难。
- 敏感度不同 :权重的微小误差对最终输出影响较小(因为有很多参数,误差可以平均);激活的误差会通过后续层传播和放大。
解决方案:
- SmoothQuant :把激活的离群值难度"迁移"到权重上------ X ⋅ W = ( X / s ) ⋅ ( s W ) X \cdot W = (X / s) \cdot (sW) X⋅W=(X/s)⋅(sW),用一个缩放因子 s s s 平衡两边的量化难度,实现 W8A8。
- AWQ:识别"重要通道"(大激活对应的权重)做保护,少量通道保持高精度,其他通道量化。
- per-tensor vs per-channel:权重常用 per-channel(每个输出通道一个缩放因子),激活常用 per-token(每个位置一个缩放因子)。
- KV Cache 量化:用 per-channel + 分组量化,把 KV Cache 从 fp16 降到 int8/fp8,显存大减。
Q5.2 KV Cache 原理?怎么优化?
参考答案:
- 原理:自回归生成时,每个新 token 都要和所有历史 token 算注意力。把历史的 K、V 缓存下来,避免重复计算。这是用显存换计算。
- 效果:每步从 O ( n 2 ) O(n^2) O(n2) 降到 O ( n ) O(n) O(n),但也带来显存瓶颈(长序列、大 batch 时 KV Cache 可超过权重)。
- 优化方向:
- 结构层:MQA/GQA/MLA(减少 KV 头数或压缩)。
- 量化:KV Cache 量化到 int8/fp8。
- 淘汰/驱逐:H2O、StreamingLLM、SnapKV,丢掉"不重要"的 token(如 attention sink + 近期 token)。
- 分页管理:PagedAttention(vLLM)。
- 共享/复用:Prefix Caching(相同前缀复用)、Prompt Cache。
追问:attention sink 是什么?为什么重要?
attention sink :观察注意力分布发现,序列开头的几个 token(尤其是第一个 token)会持续获得很高的注意力权重,即使它们在语义上完全无关紧要 (比如第一个 token 是
<bos>或句首的 "The")。为什么重要:
- 它是 softmax 的"无处安放" :softmax 要求每行注意力权重之和为 1,当下文没有明显相关信息时,模型需要一个"垃圾桶"来放置多余的注意力,于是都倒给第一个 token。所以 attention sink 本质是归一化的副产品。
- StreamingLLM 的基础 :既然开头 token 承担了 sink 的角色,那么只要保留前几个 sink token + 最近的滑动窗口,就能在超长序列(甚至超过训练长度)上稳定推理,而不需要重训。这大大降低了长文本推理的成本。
- 解释了一些现象 :如为什么删除开头 token 会导致性能剧烈下降(sink 被破坏了),为什么长上下文中间的信息容易被忽略。
相关:H2O、SnapKV 等 KV 淘汰方法也利用了 attention 分布的特性------只要保留"近期 token + 高关注度 token(含 sink)",就能在明显压缩 KV Cache 的同时保持效果。
注意:sink 现象也提示我们,注意力权重高不等于重要性高------分析可解释性时不能只看 attention 权重大小。
Q5.3 PagedAttention 和 vLLM 的核心贡献?
参考答案:
- 问题:传统 KV Cache 要预分配连续显存,按最大长度分配 → 内部碎片、外部碎片严重,显存利用率常低于 50%。
- PagedAttention:借鉴操作系统的虚拟内存分页,把 KV Cache 切成固定大小的 block(如 16 个 token),非连续存储,用 block table 映射逻辑到物理。
- 效果:显存浪费 <4%,吞吐提升 2-4 倍;支持前缀共享 (beam search、并行采样共享 prompt 的 KV)、抢占式调度。
- vLLM 基于它实现了 Continuous Batching(连续批处理)------不同请求动态进出 batch,而非等整批完成,GPU 利用率大幅提升。
追问:Continuous Batching 和 Static Batching 区别?为什么前者吞吐更高?
Static Batching(静态批处理):
- 一次凑齐一个 batch,一起前向、一起解码、一起结束。
- 问题:一个 batch 里各个请求的输出长度差异很大,整个 batch 必须等最长的那个请求完成 才能处理下一批。短请求早就生成完了,却要空等,GPU 大量闲置。
Continuous Batching(连续批处理,也叫 iteration-level scheduling):- 每次迭代(生成一个 token)后重新检查有哪些请求完成了,完成的立即退出 batch,新来的请求立即补进空出的位置。
- 这样 GPU 始终被填满,利用率大幅提升(vLLM 论文报告吞吐提升 2-4 倍甚至更多)。
为什么重要:LLM 推理是内存带宽密集 的(decode 阶段每生成一个 token 要读全部权重),所以 batch 越大、填充率越高,单位算力的产出就越高。静态批处理下这个填充率可能只有 50%,连续批处理能到 90%+。
配合的还有:- Chunked Prefill:把长 prompt 的 prefill 切成小块,和 decode 交错调度,避免长 prefill 阻塞正在 decode 的请求。
- 抢占式调度:显存不够时可以暂停某些请求(换出 KV Cache),优先服务其他请求。
- 这正是 vLLM、SGLang、TGI 等推理引擎的核心调度机制。
Q5.4 有哪些推理加速技术?各在哪个层面?
参考答案:
| 层面 | 技术 | 效果 |
|---|---|---|
| 模型结构 | MQA/GQA/MLA、MoE | 减 KV Cache / 减激活参数 |
| 量化 | W4A16、W8A8、FP8、KV 量化 | 省显存、提吞吐 |
| 注意力 | FlashAttention、PagedAttention | 提速度、省显存 |
| 解码策略 | 投机解码、Medusa、Lookahead | 每步生成多 token |
| 调度 | Continuous Batching、Chunked Prefill | 提吞吐、平衡 TTFT/TPOT |
| 蒸馏 | 大模型蒸馏到小模型 | 小模型接近大模型能力 |
| 缓存 | Prefix Caching、Prompt Cache | 复用公共前缀 |
| 分布式 | 张量并行、流水线并行、PD 分离 | 支撑大模型/大规模 |
追问:投机解码(Speculative Decoding)原理?为什么能保持输出分布不变?
流程:
- 用一个小 draft 模型(快,如 1B)自回归快速生成 k 个候选 token(比如 k=5)。
- 用大 target 模型 对这 k 个位置并行做一次前向,得到每个位置的概率分布。
- 逐位置验证:按某种接受准则决定每个候选 token 是否被接受。接受就保留,第一个不接受的 token 处,用修正后的分布重新采样一个,然后停止。
为什么快 :大模型 decode 是 memory-bound (瓶颈在读取权重,不在计算),一次前向生成 1 个 token 和一次前向验证 k 个 token 的耗时几乎相同。所以用大模型"顺手"验证了 k 个 token,如果大部分被接受,就相当于一步生成了多个 token,加速比可达 2-3x。
为什么分布不变 (关键):
接受准则用拒绝采样 :对位置 t,draft 模型分布为 q,target 模型分布为 p,以概率 min ( 1 , p ( x ) / q ( x ) ) \min(1, p(x)/q(x)) min(1,p(x)/q(x)) 接受 draft 采样的 token x;如果被拒绝,则从修正分布 norm ( max ( 0 , p − q ) ) \text{norm}(\max(0, p - q)) norm(max(0,p−q)) 重新采样。
数学上可以证明,这样得到的最终分布严格等于 target 模型的分布 p ------所以投机解码不是近似,是无损加速。
变体:
- Medusa:不用 draft 模型,在 target 模型上接多个预测头(每头预测不同位置的 token),并行生成候选。
- EAGLE:用 target 模型的特征(而非独立的 draft 模型)做自回归预测,接受率更高。
- Lookahead decoding:用 Jacobi 迭代并行生成。
- 自投机(self-speculative):用同一模型的不同层(浅层做草稿,深层验证)。
Q5.5 长上下文怎么实现?有哪些难点?
参考答案:
- 难点:
- 注意力复杂度 O ( n 2 ) O(n^2) O(n2),128K 序列的注意力矩阵巨大。
- 位置编码外推:训练长度外的位置泛化(RoPE 需插值/NTK/YaRN)。
- 训练数据稀缺:长文档数据少,且长序列训练显存/时间成本高。
- "lost in the middle":模型对长上下文中间部分的信息利用差。
- KV Cache 膨胀。
- 方案:位置插值 + 少量长文本微调、Ring Attention(序列并行,环形传递 KV 块)、稀疏/滑窗注意力、RAG 替代超长上下文、KV Cache 淘汰。
Q5.6 什么是 TTFT 和 TPOT?怎么分别优化?
参考答案:
- TTFT (Time To First Token):首 token 延迟,由 prefill 阶段 决定,是 compute-bound。
- TPOT (Time Per Output Token):后续每 token 延迟,由 decode 阶段 决定,是 memory-bound(每步要读全部权重和 KV Cache,但只算一个 token)。
- 优化:
- TTFT:Chunked Prefill、Prefix Caching、张量并行、更快的 prefill kernel。
- TPOT:量化(减权重大小)、GQA/MLA(减 KV)、投机解码、大 batch(提高算术强度)。
- PD 分离(Prefill-Decode Disaggregation):把 prefill 和 decode 放不同机器,各自用最优配置,避免互相干扰(DeepSeek、vLLM、SGLang 都支持)。
六、RAG 与 Agent 应用
Q6.1 完整讲一下 RAG 的流程和每个环节的优化点
参考答案:
- 流程:文档加载 → 切分(chunking)→ 向量化(embedding)→ 存储(向量库)→ 检索(retrieve)→ 重排(rerank)→ 拼装 prompt → 生成。
- 各环节优化:
- 切分:语义切分优于固定长度;chunk 大小要平衡(太小丢上下文,太大噪声多);可加 overlap;父子文档、句子窗口。
- Embedding:选强模型(BGE、GTE、E5、OpenAI text-embedding-3);领域数据微调 embedding。
- 检索:混合检索(稠密向量 + BM25 稀疏)互补;多路召回;HyDE(先让 LLM 生成假设答案再检索)。
- 重排:Cross-encoder rerank(如 bge-reranker、Cohere Rerank)精排 top-k,显著提精度。
- 生成:引用来源、指令约束"只根据上下文回答,不知道就说不知道"。
追问:RAG 和长上下文冲突吗?该选哪个?
不冲突,互补,实践中常常结合。
两者的定位不同:
- RAG 解决:知识规模大(百万级文档)、知识频繁更新、需要溯源引用、成本敏感(只需检索相关片段,不用塞满上下文)。
- 长上下文解决 :单次推理需要处理大量相关内容(如整本书分析、长会议记录总结)、需要全局理解的任务。
为什么 RAG 不能被长上下文完全替代:
- 成本 :把 100 万 token 全塞进上下文,每次推理都贵且慢( O ( n 2 ) O(n^2) O(n2) 注意力 + 巨大的 KV Cache)。
- lost in the middle:上下文太长时中间信息利用率下降,检索定位反而更有效。
- 更新 :知识更新时,RAG 只需更新向量库,长上下文模型需要重训或重新塞入。
为什么长上下文也不能替代 RAG :海量知识(TB 级)根本塞不进任何上下文窗口。
最佳实践 :先用 RAG 缩小范围,再用长上下文做深度理解 。例如:RAG 召回 20 个相关片段 → 用长上下文模型综合分析。或者分层:粗召回用 RAG,细分析用长上下文。
一个趋势:随着上下文窗口变大,RAG 的"chunk 切分"会变得更简单(可以直接塞整篇文档),但检索这一步依然必要。
Q6.2 RAG 常见失败模式有哪些?
参考答案:
- 检索失败:相关文档没召回(embedding 不匹配、chunk 切分不当、query 表述与文档差异大)。
- 上下文噪声:召回了无关内容,误导生成。
- 位置偏差:关键信息在中间被忽略(lost in the middle)。
- 幻觉:模型没用好检索内容,自己编。
- 多跳问题:需要链式推理多个文档,单次检索不够。
- 查询歧义:query 本身模糊,需 query rewriting / 澄清。
对策:查询改写(多查询、HyDE)、重排、上下文压缩、迭代检索(Self-RAG、CRAG、Corrective RAG)、引用要求。
Q6.3 什么是 Agent?ReAct 框架?
参考答案:
-
Agent = LLM + 规划 + 记忆 + 工具使用,能自主多步完成任务。
-
ReAct(Reason + Act):交替进行 Thought(推理)和 Action(调用工具),观察结果(Observation)后继续,形成循环:
Thought: 我需要查天气 Action: get_weather(北京) Observation: 晴,25度 Thought: 已获取,可以回答 Final Answer: ... -
让模型"边想边做",比纯 CoT 更可控、可验证。
-
现代演进:Function Calling(原生结构化工具调用)、Plan-and-Execute、Reflexion(失败后反思重试)、Tree of Thoughts(多路径搜索)。
追问:Agent 的难点?工程上怎么缓解?
核心难点:
- 错误累积:一步错步步错。Agent 是多步决策,早期的一个小错误(如错误的工具调用)会传播到后续所有步骤。
- 工具调用格式错误:模型输出的 JSON 不合法、参数类型错、工具名拼错。
- 上下文爆炸:每轮的工具返回都加入上下文,几十轮后上下文超长,又慢又贵还容易 lost in the middle。
- 循环不终止:模型陷入"调用工具 → 发现问题 → 再调用"的死循环,或反复尝试同一个失败操作。
- 成本高:多轮调用 LLM + 工具,token 消耗大。
- 难以评估和调试 :没有明确的对错信号,失败原因难以定位。
工程缓解:
- 格式约束:constrained decoding 强制输出合法 JSON / 用原生 function calling。
- 重试与反思:工具失败时反馈错误信息,让模型修正(Reflexion 模式)。
- 终止条件:设置最大步数、最大 token 预算、循环检测(相同动作重复 N 次就中断)。
- 上下文管理:摘要压缩历史、只保留关键状态、把长工具输出截断或摘要。
- 权限与确认:危险操作需人工确认,工具权限最小化。
- 可观测性:记录每一步的 thought/action/observation,便于调试。
- 验证器:关键步骤用规则/工具验证结果(如代码可执行、API 返回码检查)。
Q6.4 Function Calling / Tool Use 怎么实现?
参考答案:
- 定义工具的 JSON Schema(名字、描述、参数)。
- 把工具定义注入 system prompt。
- 模型输出结构化的调用请求(OpenAI 用单独的
tool_calls字段,开源模型用特定模板如 Hermes、Qwen 的 tool 格式)。 - 执行工具,把结果作为新的 message 喂回,模型继续生成。
- 关键:训练数据要包含工具调用样本(SFT 时构造),否则模型不会用;也可用 constrained decoding 强制输出合法 JSON。
Q6.5 怎么评估 RAG / Agent 系统?
参考答案:
- RAG 评估(RAGAS 框架):
- 忠实度(faithfulness):答案是否都能从检索内容推出(测幻觉)。
- 答案相关性:答案是否回答了问题。
- 上下文精确率/召回率:检索质量。
- Agent 评估:任务成功率、步骤数、工具调用准确率、成本;基准如 AgentBench、WebArena、SWE-bench。
- 通用:用强模型当裁判(LLM-as-judge),需注意位置偏差、冗长偏差,可做 pairwise 对比。
Q6.6 向量数据库怎么选?ANN 索引有哪些?
参考答案:
- 常见库:FAISS(Meta,库而非服务,性能强)、Milvus/Qdrant/Weaviate(完整服务,支持元数据过滤、分布式)、Chroma(轻量,适合原型)、pgvector(直接在 Postgres 里)。
- 相似度度量:余弦相似度(最常用)、内积、欧氏距离。注意 embedding 是否已归一化。
- ANN(近似最近邻)索引 :
- HNSW:分层小世界图,查询快、精度高,内存占用大。当前主流。
- IVF:倒排索引 + 聚类,先找最近的几个簇再搜,需训练。
- PQ(乘积量化):压缩向量省内存,可和 IVF 组合(IVF-PQ)。
- 权衡:召回率 vs 延迟 vs 内存。HNSW 高召回高内存,IVF-PQ 省内存但需调参。
- 元数据过滤很重要(按时间/来源/权限筛),且过滤 + 向量检索的顺序会影响性能(pre-filter vs post-filter)。
追问:embedding 维度高就一定好吗?
不一定,是权衡。
好处:维度高,表达力强,能编码更细粒度的语义差异,检索精度通常更高。
代价:
- 存储:向量库的内存/磁盘占用与维度成正比。100 万条 1536 维 fp32 向量约 6GB,3072 维就 12GB。
- 检索速度:HNSW 等索引的查询时间随维度上升,高维还会遇到"维度灾难"(距离度量失效)。
- 边际递减 :从 384 → 768 维提升明显,但从 1536 → 3072 维提升可能很小,性价比低。
解决方案:
- Matryoshka Embedding(MRL) :训练时通过嵌套损失,让前 k 维本身就是个可用的低维向量。推理时可以自适应截断维度------简单场景用前 256 维(快、省),复杂场景用完整维度(准)。OpenAI 的 text-embedding-3 系列支持这个特性。
- 量化:把 embedding 量化到 int8/binary,大幅省内存(binary embedding 用汉明距离,超快)。
- 降维(PCA) :某些场景下 PCA 降到 256 维,精度损失可接受。
实践建议:选 embedding 模型时,在"检索质量---存储成本---延迟"三角里找平衡点,而不是盲目追高维。很多中文场景 768 维(如 BGE-base)就够了。
Q6.7 混合检索(Hybrid Search)为什么有效?
参考答案:
- 稠密检索(向量):语义匹配强,能处理同义改写,但对精确关键词、专有名词、数字、错别字弱。
- 稀疏检索(BM25/TF-IDF):精确词匹配,对专有名词、ID、代码符号强,但不理解语义。
- 两者互补 → 混合检索 :分别召回后用 RRF(Reciprocal Rank Fusion) 或加权分数融合:
R R F ( d ) = ∑ r ∈ r e t r i e v e r s 1 k + r a n k r ( d ) RRF(d) = \sum_{r \in retrievers}\frac{1}{k + rank_r(d)} RRF(d)=r∈retrievers∑k+rankr(d)1 - RRF 只用排名不用分数,避免不同检索器分数量纲不一致的问题,实践中效果稳定。
追问:什么时候单用向量检索就够?加权融合和 RRF 怎么选?
单用向量检索就够的场景:
- 纯语义问答(如"如何申请退款"匹配到"退款的流程是什么"),无精确关键词需求。
- 数据规模小(几千条),暴力检索都够快。
- 查询都是自然语言,不涉及 ID、型号、代码符号。
必须加稀疏检索(BM25)的场景:- 涉及专有名词、产品型号、人名、地名(如"iPhone 15 Pro Max"、"张三")。
- 代码/API 文档(符号、函数名是精确匹配)。
- 数字、日期、ID 的查询。
- 错别字容忍 :稀疏检索对精确 token 敏感,向量检索对错别字更鲁棒(互补)。
加权融合 vs RRF 怎么选:- RRF :只用排名不用分数,无需调权重,跨检索器通用(因为不同检索器的分数量纲通常不一致)。默认首选,鲁棒。
- 加权分数融合:需要对分数做归一化(min-max 或 z-score),再按权重加权。理论上更灵活,但权重只能靠调参/学习得到,且不同查询的最优权重可能不同。
- 实践中:先上 RRF 做 baseline,如果效果不够再尝试加权融合或学习排序(LTR)。
补充:还可以用倒数排名融合的加权版本 或基于 cross-encoder 重排替代融合------把多路召回结果合并后统一交给 reranker 精排,往往效果最好。
Q6.8 GraphRAG 是什么?解决什么问题?
参考答案:
- 传统 RAG 是"扁平"的 chunk 检索,难以回答全局性/多跳问题(如"整份文档的主要矛盾是什么")。
- GraphRAG(微软):用 LLM 从文档抽实体和关系构建知识图谱,再做社区检测(Leiden)生成分层摘要,检索时既可用局部实体邻域,也可用全局社区摘要。
- 优势:支持全局问答、多跳推理、可解释(路径可追溯)。
- 代价:构建成本高(LLM 抽取 + 聚类 + 摘要),增量更新难。
- 轻量替代:只做多跳的迭代检索(IRCoT)、或实体链接增强。
Q6.9 Agent 的规划能力怎么做?有哪些范式?
参考答案:
- ReAct:边想边做,逐步推进(见 Q6.3)。
- Plan-and-Execute:先一次性生成完整计划,再逐步执行,可对计划做修正。适合流程清晰的任务。
- Reflexion:执行失败后生成"反思",存入记忆,下轮避免同样错误。
- Tree of Thoughts(ToT):把推理展开成树,搜索多条路径,支持回溯。算力换质量。
- LATS(Language Agent Tree Search):ToT + MCTS + 反思,最强也最贵。
- 多 Agent 协作:角色分工(如 Planner/Executor/Critic),或多个 Agent 辩论(debate)提升可靠性。
追问:规划失败的常见原因?怎么改进?
常见原因:
- 任务分解粒度不当:拆得太粗(一步做太多,做不好)或太细(步骤爆炸,成本高)。
- 子任务依赖没建模:多个步骤之间有先后/依赖关系,但规划时忽略了(如要先把 A 的结果传给 B,却并行执行)。
- 工具能力误判:规划了模型/工具做不到的步骤(如假设某个 API 能返回不存在的信息)。
- 中间结果反馈缺失:执行后不检查结果就继续,错误累积。
- 过度规划:简单任务也搞复杂流程,浪费且容易出错。
- 不能动态调整 :环境变化后不重新规划,死守原计划。
改进方向:
- 先验证后规划:先探查环境和工具能力,再制定计划。
- 层级规划:高层粗规划 + 低层细执行,逐层展开。
- Replanning:每步执行后评估是否需要调整计划(ReAct + 显式 replan)。
- 反思机制(Reflexion):失败后总结教训,下轮规避。
- 搜索式规划:ToT/LATS 用树搜索探索多条路径,而非一条道走到黑。
- 人的介入:关键节点让用户确认计划,尤其是高风险操作。
- 工具设计:把工具设计得"可组合、有明确契约、有错误反馈",降低规划难度。
Q6.10 Agent 的记忆怎么设计?
参考答案:
- 短期记忆:当前对话/任务的上下文,受限于上下文窗口,可用滑动窗口 + 摘要压缩。
- 长期记忆:跨会话持久化,通常存成向量库(语义检索)或结构化 KV。
- 分层设计 :
- 工作记忆:当前任务的状态、中间结果。
- 情节记忆:过往交互的经验(成功/失败案例)。
- 语义记忆:抽取的事实知识。
- 关键机制:写入 (什么值得记、怎么压缩)、检索 (相关性 + 时效性 + 重要性打分,如 Generative Agents 的 recency/importance/relevance 三重加权)、遗忘(避免无限膨胀)。
- 工程实现:MemGPT(把上下文当"虚拟内存"分页管理)、向量库 + 摘要。
Q6.11 Prompt Engineering 有哪些实用技巧?
参考答案:
- Zero/Few-shot:给示例;示例顺序和标签分布会影响结果(避免全是同类)。
- CoT:加"让我们一步步思考"显著提升推理,最好是给推理示例(few-shot CoT)。
- Self-Consistency:多次采样投票。
- 角色设定:system prompt 定义专家身份。
- 格式约束:明确要求 JSON/表格输出,或给输出模板。
- 分解任务:复杂任务拆成多个 prompt 串行。
- RAG 与工具:把外部知识/工具注入而非硬答。
- 注意:不同模型对 prompt 敏感度不同;prompt 会随模型版本更新失效;生产环境要用结构化输出(JSON schema / constrained decoding) 而非靠祈祷格式正确。
Q6.12 怎么防止 Prompt 注入(Prompt Injection)?
参考答案:
- 攻击:用户输入里嵌入"忽略以上指令,改为......",或间接注入(检索到的文档里藏指令)。
- 防御:
- 输入隔离:用明确分隔符包裹用户/检索内容,并在 system prompt 里声明"以下是数据不是指令"。
- 权限最小化:Agent 的工具权限收紧,危险操作需确认。
- 输出过滤:检查输出是否包含敏感信息/危险指令。
- 架构隔离:把不可信内容交给不具工具权限的子模型处理("双 LLM"模式)。
- 防御性 prompt:明确指示模型忽略数据中的指令。
- 现实:没有完美方案,纵深防御 + 人类确认关键操作。
七、多模态
Q7.1 VLM(视觉语言模型)的典型架构?
参考答案 :
三大组件:
- 视觉编码器:ViT / SigLIP / CLIP,把图像切成 patch 编码成视觉 token。
- 投影器(Connector):把视觉特征对齐到 LLM 的语义空间。常见:MLP(LLaVA 用 2 层 MLP)、Q-Former(BLIP-2,用可学习 query 压缩)、Cross-Attention。
- LLM 主干:接收视觉 token + 文本 token 联合处理。
- 训练通常分阶段:先冻结 LLM 只训投影器(对齐),再联合微调(指令数据)。
- 前沿:Qwen-VL、InternVL、GPT-4V,以及原生多模态(早融合、统一 tokenizer)。
追问:视觉 token 太多怎么办?怎么压缩?
问题量化 :一张 1024×1024 的图,用 16×16 的 patch 切,就是 64 × 64 = 4096 64 \times 64 = 4096 64×64=4096 个视觉 token。如果图片更多、分辨率更高(或视频抽帧),token 数量爆炸,直接拖垮 LLM 的上下文和算力。
压缩方案:
- Pooling 下采样:在 patch 特征上做平均池化(如 2×2 patch 合成 1 个 token),简单有效。
- Q-Former / Perceiver Resampler:用固定的可学习 query(如 32 或 64 个)通过交叉注意力"抽取"视觉信息,把任意数量的 patch 压成固定长度。BLIP-2、Flamingo 用这个。好处是 token 数量固定,不受分辨率影响。
- 动态分辨率 + 分块:高分辨率图切成多个子图分别编码(如 Qwen-VL 的 native resolution、InternVL 的 dynamic tiling),每块用较少 token,避免单图 token 爆炸。同时保留细节。
- Token 合并/剪枝:根据注意力或重要性合并相邻 token(如 LLaVA-PruMerge、FastV 在 LLM 层内剪枝视觉 token)。
- 视觉 token 压缩器 :接一个小的压缩网络(如 C-Abstractor、Pixel Shuffle)降维。
权衡 :压缩太狠会丢细节(尤其是 OCR、细粒度识别、小物体),压缩不够则成本高。通常简单任务用大量压缩,高精度任务保留更多 token (如文档问答需要高分辨率)。
这也是 VLM 部署时的主要成本瓶颈之一。
Q7.2 CLIP 的训练目标和原理?
参考答案:
- 对比学习:一个 batch 内 N 个图-文对,用 InfoNCE 损失 ,最大化正样本对的余弦相似度、最小化负样本(in-batch 其他对):
L = − log exp ( sim ( I i , T i ) / τ ) ∑ j exp ( sim ( I i , T j ) / τ ) \mathcal{L} = -\log\frac{\exp(\text{sim}(I_i,T_i)/\tau)}{\sum_j \exp(\text{sim}(I_i,T_j)/\tau)} L=−log∑jexp(sim(Ii,Tj)/τ)exp(sim(Ii,Ti)/τ)
图文两个方向各算一次取平均。τ 是可学习温度。 - 得到对齐的图文共享嵌入空间 → 零样本分类:把类别名当文本 prompt,选最相似的。
- 局限:只学全局对齐,不懂细粒度、空间关系、计数 → 需在 VLM 里接 LLM 补足推理。
Q7.3 多模态模型怎么处理视频/音频?
参考答案:
- 视频:抽帧 → 每帧过视觉编码器 → 时序建模(时间位置编码、3D 卷积、时序 pooling)→ 送 LLM。难点是 token 数量爆炸和长时序理解。
- 音频:用音频编码器(Whisper encoder)提取特征 → 投影器对齐 → 与文本联合。可做语音输入(如 GPT-4o 的端到端语音)。
- 统一多模态:把图像、音频、视频都 tokenize 到同一序列空间,做统一的自回归建模(如 Gemini、GPT-4o 的原生多模态路线)。
Q7.4 视觉编码器 ViT 的原理?和 CNN 的区别?
参考答案:
- ViT:把图像切成固定大小 patch(如 16×16),线性投影成 token 序列,加位置编码,直接送标准 Transformer encoder。class token 或 pooled 特征做分类。
- 与 CNN 区别:
- CNN 有局部性、平移不变性 的归纳偏置,小数据也能学好;ViT 缺少这些先验,需要大数据才能追平(JFT-300M 上才超过 ResNet)。
- ViT 全局注意力,感受野从第一层就是全图;CNN 感受野逐层扩大。
- ViT 更易扩展到多模态和统一架构。
- 改进:DeiT(蒸馏 + 数据增强让小数据可用)、Swin(层级 + 滑窗注意力,恢复局部性)、SigLIP(sigmoid 对比损失,比 CLIP 更省)、Native-resolution(Qwen-VL 动态分辨率)。
追问:patch 大小怎么选?
patch 大小 p p p 决定了 token 数量 N = ( H / p ) × ( W / p ) N = (H/p)\times(W/p) N=(H/p)×(W/p),是个关键权衡:
- 小 patch(如 8×8 或 14×14):保留更多细节,token 多,算力/显存开销大。适合需要细粒度识别(OCR、小物体、密集场景)的任务。
- 大 patch(如 16×16 或 32×32) :token 少、效率高,但丢失细节,难以处理小目标。
常见选择:- 14×14(SigLIP 默认) 、16×16(ViT 默认) 是主流平衡点。
- 动态 patch:根据图像内容自适应(如物体小的地方用细 patch)。
- 多尺度 :同时用不同 patch 大小(金字塔式),兼顾细节和全局。
实战建议:- 通用场景:16×16 足够。
- 文档/OCR:用更小的 patch 或动态高分辨率切图。
- 如果 token 太多,可以选大 patch + 后续 pooling 的组合,而不是只靠大 patch(因为大 patch 一开始就丢了信息,而 pooling 是后期可学习的压缩)。
另外注意:patch 大小要和视觉编码器的预训练配置一致------改了 patch 大小需要重新预训练或至少微调。
Q7.5 多模态对齐训练有哪几个阶段?各阶段训什么?
参考答案(以 LLaVA 为代表):
- Stage 1 特征对齐预训练 :冻结视觉编码器和 LLM,只训投影器,用图文对(caption)数据,让视觉特征映射到 LLM 语义空间。
- Stage 2 指令微调:解冻 LLM(或用 LoRA),用多模态指令数据(VQA、对话、描述),教模型按指令用图像信息。
- 可选 Stage 3 增强:加入更多任务(OCR、grounding、多图、视频),提升细粒度能力。
- 关键:视觉 token 用特殊占位符 (如
<image>)嵌入文本序列;损失只算文本回复部分。 - 数据质量决定上限:GPT-4 生成的详细描述(LLaVA 用)比短 caption 效果好得多。
Q7.6 多模态模型的常见评测基准?
参考答案:
- 通用感知:MMBench、MMMU(大学水平多学科推理)、MM-Vet、SEED-Bench。
- 视觉问答:VQAv2、OKVQA、TextVQA(读图中文字)。
- OCR/文档:OCRBench、DocVQA、ChartQA。
- 图表/数学:MathVista、ChartQA。
- 幻觉:POPE(物体存在性)、HallusionBench。
- Agent/UI:ScreenSpot、OSWorld。
- 注意:评测集污染、prompt 敏感、答案格式影响分数,横向比较要谨慎。
八、分布式训练与工程
Q8.1 数据并行 / 张量并行 / 流水线并行 的区别?
考点:3D 并行,必考。
参考答案:
- 数据并行(DP) :每张卡存完整模型,处理不同数据,梯度 AllReduce 同步。缺点:模型必须能放进单卡。优化:ZeRO (切分优化器状态/梯度/参数,ZeRO-1/2/3)、FSDP(全分片数据并行,PyTorch 原生)。
- 张量并行(TP) :把单层内的矩阵运算切到多卡(列并行/行并行),每层都要 AllReduce 通信,通信量大,适合单机 NVLink 内。Megatron-LM 是代表。
- 流水线并行(PP) :把不同层放到不同卡,像流水线一样处理 micro-batch。缺点是气泡(bubble),用 1F1B、interleaved schedule 缓解。
- 实践:单机内用 TP,跨机用 PP,再叠加 DP/ZeRO。Megatron-LM + DeepSpeed 组合。
追问:ZeRO 三个阶段分别切什么?和各并行方式怎么配合?
切分对象(逐级递进):
- ZeRO-1 :切优化器状态(Adam 的动量 m 和方差 v)。混合精度下优化器状态占总显存的大头(约 8 bytes/参数),切掉后显存降约 4x。
- ZeRO-2 :再切梯度(约 2 bytes/参数)。显存再降约 2x(累计 8x)。
- ZeRO-3 :再切参数 (约 2 bytes/参数 fp16)。显存再降,且随卡数线性下降------理论上可以让任意大的模型塞进固定显存,代价是通信量大幅增加 (每层前向/反向都要 AllGather 参数)。
显存降幅 (相对朴素 DP)大致为:ZeRO-1 ≈ 4x,ZeRO-2 ≈ 8x,ZeRO-3 ≈ 与卡数成正比。
通信代价:- ZeRO-1/2 通信量增加不多(和标准 DP 相当,通过 ReduceScatter 优化)。
- ZeRO-3 通信量增加约 1.5x(Huang 等 2019 的优化),且因为要动态聚合参数,实现复杂、对带宽敏感。
和 3D 并行配合:- 典型组合:TP(机内,NVLink)+ PP(机间)+ ZeRO-1/2(数据并行组)。
- ZeRO-3 通常不用在超大模型上(通信太重),而是用 TP+PP+DP 的经典组合;ZeRO-3 更适合中小规模、卡数多但带宽一般的集群。
- PyTorch 的 FSDP(Fully Sharded Data Parallel)本质就是 ZeRO-3 的原生实现。
Q8.2 混合精度训练为什么能省显存又加速?bf16 vs fp16?
参考答案:
- 用 16-bit 存激活/权重/梯度,显存约减半;Tensor Core 对 fp16/bf16 有加速。
- 需保留一份 fp32 主权重(master weight)做参数更新,避免累积误差。
- bf16 动态范围同 fp32 → 不需要 loss scaling,更适合大模型训练;fp16 需要 loss scaling 防下溢,且更易出现 loss spike。
- 常见配置:前向/反向用 bf16,优化器状态和主权重用 fp32。
Q8.3 梯度检查点(Gradient Checkpointing)是什么?
参考答案:
- 反向传播需要保存前向的中间激活,显存开销 O ( n ) O(n) O(n) 层。
- 梯度检查点:只保存部分层(如每 k 层的边界)的激活,反向时从最近的检查点重新前向计算该段中间激活。
- 代价:额外一次前向(约 30% 计算),换显存大幅下降(可到 O ( n ) O(\sqrt{n}) O(n ))。
- 是长序列/大模型训练的标配。
Q8.4 训练中出现 loss spike 或 NaN 怎么排查?
参考答案:
- 数据:检查是否有异常样本(超长、乱码、重复)→ 跳过或过滤。
- 学习率:过大 → 降低或加 warmup。
- 精度:fp16 溢出 → 换 bf16,或检查 loss scaling 是否合理。
- 梯度:加/收紧梯度裁剪(如 clip=1.0)。
- 数值:检查 attention 里是否有 -inf × 0、除零、RNN 式累积。
- 处理:回滚到上一个好的 checkpoint,跳过该 batch,或降低 lr 继续。
- 监控:分模块看梯度范数,定位是哪一层的锅。
Q8.5 怎么估算训练/推理的显存和算力?
参考答案:
- 推理显存:权重 + KV Cache + 激活(很小)。7B fp16 ≈ 14GB 权重。
- 训练显存 (Adam,混合精度):权重(fp16) + 梯度(fp16) + fp32 主权重 + Adam m/v,约 16-20 bytes/参数。7B ≈ 112-140GB。加激活和碎片更高。
- 算力估算 :训练总 FLOPs ≈ 6 × N × D 6 \times N \times D 6×N×D(N 参数,D token 数,前向 2ND + 反向 4ND)。
- 推理 :prefill ≈ 2 N D 2ND 2ND,decode 每 token ≈ 2 N 2N 2N(但实际是 memory-bound,看权重读取量)。
- 缩放定律:Chinchilla 最优是 tokens ≈ 20 × params;但推理成本主导后,现代模型倾向于"过训练"(如 LLaMA-3 8B 用 15T token,远超 160B)。
Q8.6 序列并行(Sequence Parallelism)是什么?
参考答案:
- 动机:长序列训练时,激活显存(尤其 LayerNorm/Dropout 部分)和注意力计算都是瓶颈,TP 又切不动序列维。
- 方案:
- SP(Megatron):把 LayerNorm、Dropout、残差的序列维切开,和 TP 配合,减少这些层的激活显存。
- Ring Attention / Context Parallel:把序列切成段分到不同卡,KV 块像"环"一样在卡间传递,每张卡轮流用别人的 KV 算自己段的注意力(用 online softmax 累加),实现序列维并行。支持超长上下文(百万级)。
- Ulysses(DeepSpeed):按 head 维切分 + All-to-All 通信实现序列并行。
- 关键指标:通信量、负载均衡、是否与 TP/PP 组合。
追问:长上下文训练一般怎么组合并行?
长上下文训练的核心矛盾是激活显存随序列长度线性增长 (甚至注意力的中间结果二次增长),所以必须叠加序列维度的并行。典型组合是 "4D/5D 并行":
- TP(张量并行):层内切分,机内 NVLink,负责把单层参数铺开。
- PP(流水线并行):层间切分,跨机,负责把不同层放不同卡。
- CP/SP(上下文/序列并行) :把序列维切开,是长上下文的关键。用 Ring Attention 或 Ulysses。
- DP/ZeRO(数据并行) :处理不同数据,切优化器状态。
具体配置举例(以训练 128K 上下文的模型为例):- 单机 8 卡 TP=8(NVLink 通信快)。
- 跨机 PP=4 或 8(减少流水线气泡用 1F1B)。
- CP=4 或 8(把 128K 序列切成几段并行算)。
- 外层再套 DP。
配合手段:梯度检查点 (重算激活,省显存)、FlashAttention (IO 优化,长序列时收益巨大)、动态负载均衡 (因果注意力下,序列前段的 GPU 计算量小,需要 zigzag 分配避免负载不均------Ring Attention 的经典问题)。
注意:CP 的通信量随序列长度增长(要传递 KV 块),对带宽要求高;且因果 mask 导致的计算不均衡需要特殊处理(如 zigzag 切分)。
Q8.7 通信原语:AllReduce / AllGather / ReduceScatter / All-to-All
参考答案:
- AllReduce:所有卡的梯度求和后广播给所有卡(DP 梯度同步)。= ReduceScatter + AllGather。
- AllGather:每张卡拿所有卡的数据切片拼起来(ZeRO 参数重聚、TP 前向)。
- ReduceScatter:求和后按卡分散结果(ZeRO 梯度归约,省通信)。
- All-to-All:每张卡给所有其他卡发不同数据(MoE 专家路由、序列并行的 head 交换)。通信模式最复杂。
- 通信量量级:AllReduce 是主流瓶颈;Ring AllReduce 让通信量与卡数无关(相比朴素实现的 O ( N ) O(N) O(N) 降到 O ( 1 ) O(1) O(1) 常数因子)。
追问:NCCL 是什么?通信有哪些优化手段?
NCCL(NVIDIA Collective Communications Library):NVIDIA 官方的 GPU 集合通信库,实现了 AllReduce、AllGather、ReduceScatter、All-to-All 等原语,是 PyTorch DDP/FSDP、DeepSpeed、Megatron 的通信底层。它会自动选择最优的通信路径和算法:
- 机内 :优先用 NVLink (A100 约 600GB/s)和 NVSwitch(全连接,避免拓扑瓶颈)。
- 机间 :用 InfiniBand (RDMA,约 400Gb/s/端口)或 RoCE;避免走慢速以太网。
通信优化手段:
- 通信/计算 overlap:把梯度 AllReduce 和前向传播重叠(如 PyTorch DDP 的梯度分桶 + 异步 AllReduce),让通信"藏"在计算里。PP 的 1F1B 也是这个思路。
- 拓扑感知:把通信频繁的并行(TP)放在机内 NVLink,通信少的(PP)放跨机。Ring AllReduce 让通信量与卡数无关。
- 大 batch + 梯度累积:减少通信频率(梯度累积几步再同步一次)。
- 通信压缩:梯度量化(如 fp16、int8)、梯度稀疏化,减少传输量(但要小心影响收敛)。
- 算法选择 :AllReduce 用 Ring 还是 Tree 取决于消息大小------小消息用 Tree,大消息用 Ring。
诊断:用 NCCL 的 trace/profile、Nsight Systems 看通信占比,找出瓶颈在哪。
Q8.8 训练稳定性:warmup、学习率调度、梯度裁剪
参考答案:
- Warmup:前若干步线性提升 lr(从 ~1e-6 到目标值)。原因:初期参数随机、梯度方差大,大 lr 容易发散;也让 Adam 的二阶矩估计稳定。
- LR Schedule:warmup + cosine decay 是最常见组合(也见 linear、inverse sqrt)。后期降 lr 帮助收敛。
- 梯度裁剪 :常用 clip by global norm(如 1.0),把整个梯度向量的范数限制住,防止单个异常 batch 造成的大更新。注意:梯度裁剪改变的是更新方向上的步长,和按元素裁剪不同。
- 其他:z-loss(防止 logits 数值爆炸)、QK-Norm、embedding 层单独调 lr、muP/μTransfer 做超参迁移。
Q8.9 容错与故障恢复怎么做?
参考答案:
- 大模型训练数千卡跑数月,硬件故障是常态(MTBF 可能只有几小时到几天)。
- 手段:
- 定期 checkpoint:异步/分片存储(ZeRO 下每个 rank 存自己的分片),减少保存停顿。
- 自动重启:检测到失败(NCCL timeout、节点掉线)自动拉起、从最近 checkpoint 恢复,跳过坏 batch。
- 冗余/热备:预留备用节点,故障时替换。
- 监控与告警:loss、梯度范数、吞吐、GPU 温度/ECC 错误、通信延迟。
- 数据加载容错:数据流可恢复、跳过损坏样本。
- 目标:把故障恢复时间压到分钟级,减少浪费的算力。
Q8.10 训练吞吐怎么优化?MFU 是什么?
参考答案:
- MFU(Model FLOPs Utilization) = 实际达到的 FLOPs / 硬件峰值 FLOPs。训练 LLaMA 级模型 MFU 通常 35-50%,MoE 会更低。
- 优化方向:
- 计算:FlashAttention、融合算子(fused kernel,如算子融合的 LayerNorm)、bf16、Tensor Core 利用率。
- 通信:通信与计算 overlap(如 PP 的 1F1B、梯度 AllReduce 与前向重叠)、拓扑优化(NVLink 内做 TP)。
- 显存:梯度检查点、ZeRO、offload(把优化器状态卸载到 CPU,慢但省显存)。
- 数据:预取、高效 tokenize、避免 dataloader 成为瓶颈。
- 并行策略:找 TP/PP/DP 的最优组合(通信量 vs 显存的权衡)。
- 诊断:找瓶颈(compute-bound 还是 communication-bound 还是 IO-bound),针对性优化。
Q8.11 用 CPU offload / 异构训练值得吗?
参考答案:
- Offload:把优化器状态、梯度甚至参数放到 CPU 内存(或 NVMe),GPU 只做计算。
- 优点:显著降低 GPU 显存需求(ZeRO-Offload、ZeRO-Infinity)。让 7B 全量微调在单卡可行。
- 缺点:CPU-GPU 传输带宽低(PCIe ~32GB/s vs NVLink ~600GB/s),训练速度大幅下降(2-5x 甚至更多)。
- 适用:显存受限但时间不敏感、小规模微调;大规模预训练不用(不划算)。
九、前沿与开放题
Q9.1 缩放定律(Scaling Law)是什么?Chinchilla 的结论?
参考答案:
- Kaplan 等(2020):loss 与模型参数量、数据量、算力呈幂律关系,模型越大越好。
- Chinchilla(2022)修正 :在固定算力下,模型大小和数据量应等比例 增长,最优约 20 token / 参数。指出 GPT-3 是"训练不足"的。
- 实践变化:现在的模型(LLaMA、Qwen 等)大幅"超训"(几百 token/参数),因为推理成本主导总成本------多花训练算力换更小的推理模型是划算的。
- 局限:Scaling Law 主要预测 loss,不预测具体下游能力;且存在"涌现"现象(某些能力在规模阈值后突然出现)。
Q9.2 什么是"涌现能力"?有争议吗?
参考答案:
- 定义:模型规模达到某个阈值后,某些能力(多步推理、算术、指令遵循)突然从"接近随机"跃升到"显著可用"。
- 争议:有研究(Schaeffer 等)认为"涌现"是评估指标的假象------用连续指标(如 token 级准确率)看是平滑提升的,离散指标(如整题对错)才显得突变。
- 实践意义:无论如何,大模型确实在复杂任务上远超小模型,能力规划时需考虑规模阈值。
Q9.3 推理模型 / 长思维链(Long CoT)是什么?怎么训的?
参考答案:
- 代表:OpenAI o1/o3、DeepSeek-R1、Qwen-QwQ。核心是test-time compute scaling:推理时生成更长的思维链,用更多算力换更高准确率。
- 训练:
- 冷启动 SFT:少量高质量长 CoT 数据微调,让模型学会"反思、验证、回溯"的模式。
- RL(GRPO):用可验证奖励(数学答案对错、代码通过测试)大规模强化,模型自发涌现出长链、自我纠错、"aha moment"。
- 拒绝采样 + SFT:把 RL 后的好轨迹蒸馏回模型。
- 关键洞察:纯 RL(无 SFT 冷启动)也能涌现推理能力,但可读性差;规则奖励(可验证)比神经奖励模型更可靠。
追问:R1-Zero 和 R1 区别?
R1-Zero:
- 直接在基座模型(DeepSeek-V3-Base)上做纯 RL (GRPO + 规则奖励),跳过 SFT 冷启动。
- 意义:证明了不依赖任何监督数据,纯 RL 就能让模型自发涌现出长链推理、自我验证、回溯等能力(论文中提到的"aha moment")------这是很强的科学信号,说明推理能力可以被 RL 激发。
- 问题:输出可读性差、语言混杂 (中英文夹杂)、格式混乱,不适合直接用。
R1:- 在 R1-Zero 基础上加了工程化改进,让它"能用":
- 冷启动 SFT:先用几千条高质量长 CoT 数据微调,教会模型规范的推理格式和可读性。
- 面向推理的 RL:在冷启动之上继续 RL,主要提升数学/代码/逻辑推理。
- 拒绝采样 + SFT:用 RL 后的模型生成大量高质量数据(含通用任务),筛选后 SFT,恢复通用能力。
- 全场景 RL:对齐人类偏好(有用性 + 无害性),提升综合体验。
- 结果:既保留推理能力,又输出可读、语言一致、能通用对话。
总结 :R1-Zero 是"研究证明",R1 是"工程产品"。R1 的蒸馏版本(把 R1 能力蒸馏到小模型)也广受欢迎。
背后的关键洞察:规则奖励(可验证)比神经 RM 更可靠,因为数学答案/代码测试是客观的,不存在 reward hacking 的漏洞。
Q9.4 幻觉(Hallucination)的成因和缓解?
参考答案:
- 成因:
- 训练目标本身是"预测下一个 token",不保证真实性。
- 训练数据包含错误/矛盾信息。
- 知识有截止日期,无法回答时效问题。
- 生成长度/流畅性偏好诱导编造。
- 对齐训练可能加剧(模型倾向于"给出答案"而非"承认不知道")。
- 缓解:
- RAG 提供事实依据。
- 训练时加入"我不知道"的样本。
- 用可验证奖励 / 自我一致性(多次采样投票)。
- 解码策略(降低温度、contrastive decoding)。
- 引用与溯源,让模型标注来源。
- 事后校验(用另一个模型/工具核对)。
Q9.5 如果让你从零训一个 7B 模型,你的方案是什么?
开放题,考察系统性:
- 数据:采集 Web + 代码 + 数学 + 书籍,去重、质量过滤、配比(代码/数学加权重),总量按 Chinchilla 或超训规划(如 2-4T token)。
- 架构:Decoder-only,Pre-LN + RMSNorm + RoPE + SwiGLU + GQA,可能 MoE。
- 训练:bf16 混合精度,AdamW,cosine lr + warmup,梯度裁剪 1.0,ZeRO-2/3 + 梯度检查点,数千卡规模。
- 基础设施:Megatron/DeepSpeed + 容错、监控(loss、梯度范数、吞吐)。
- 后训练:SFT(指令数据)→ DPO/RLHF 对齐 → 安全微调。
- 评测:MMLU、GSM8K、HumanEval、C-Eval、长文本、安全性、多轮对话。
- 推理部署:量化(AWQ)、vLLM、投机解码。
Q9.6 你怎么看当前大模型的瓶颈和未来方向?
开放题,考视野(给出有理有据的观点即可):
- 数据瓶颈:高质量数据接近耗尽 → 合成数据、数据飞轮。
- 算力/成本:训练成本高,推理成本成为主导 → 更高效的架构、算法。
- 能力瓶颈:长程推理、规划、可靠性、持续学习(模型无法在线更新知识)。
- 架构探索:MoE、线性注意力/SSM(Mamba)、混合架构。
- 对齐:可扩展监督、价值对齐、安全。
- Agent 化:从"对话"到"自主执行任务"。
Q9.7 什么是合成数据?为什么越来越重要?有什么风险?
参考答案:
- 定义:用模型(强 LLM)、规则或程序生成训练数据。
- 为什么重要:高质量真实数据接近枯竭("数据墙"),合成数据可无限扩展、可控(覆盖稀有场景)、成本低。
- 形式:指令数据(Self-Instruct、Evol-Instruct)、CoT 推理链(R1 蒸馏)、代码(执行验证)、教科书式语料(Phi 系列)。
- 关键技术:质量过滤 (用 RM/规则筛)、多样性控制 、验证(数学/代码可执行验证)。
- 风险:
- 模型坍缩(Model Collapse):反复用自己生成的数据训练,分布变窄、多样性丧失。
- 继承教师模型的错误和偏见。
- 训练/评测数据同源导致分数虚高(自产自评)。
- 缓解:混入真实数据、严格去重和质量控制、多源教师、可验证任务用规则而非模型打分。
追问:为什么代码和数学任务适合合成数据?
核心原因是有可靠的自动验证器:
- 数学:答案可以对(最终数值/表达式匹配),甚至可以用符号计算工具(如 Lean、SymPy)形式化验证证明。
- 代码 :可以跑单元测试或直接执行看结果对不对。
- 形式化任务 :如 SQL 查询(跑一下看结果)、结构化抽取(规则校验)、逻辑推理(可查表)。
为什么验证器是关键:
- 质量可控:生成的样本能自动筛掉错的,不需要人工标注,也不需要依赖可能出错的 RM。
- 规模可扩:可以无限生成 + 自动筛选,形成"数据飞轮"。
- 难度可调:可以按需求生成不同难度的题。
- 可构造课程 :从易到难生成,支持 curriculum learning。
反例(开放域文本) :写文章、创意写作、开放式问答没有唯一正确答案,无法自动验证 ,只能用 RM/LLM 打分(有偏、可能被 hack),所以合成数据的可靠性差很多。
实践 :DeepSeek-R1、Qwen-Math、AlphaCode 等都大量用可验证任务(数学、代码)的合成数据 + RL 训练。这也是"推理模型"能突破的重要原因------找到了可验证的奖励信号 。
一个延伸:对于开放域任务,可以用"可验证的子步骤"来间接验证(如让模型先写代码再解释、用工具验证事实)。
Q9.8 持续学习 / 知识更新的难点?怎么给模型更新知识?
参考答案:
- 难点:
- 灾难性遗忘:学新知识忘旧知识。
- 知识定位难:不知道新知识该写进哪些参数。
- 成本:频繁全量重训不现实。
- 评测难:怎么确认新知识学会了且旧能力没退化。
- 方法:
- RAG(最常用):外部知识库更新,模型不动,适合事实性更新。
- 持续预训练/微调:小规模增量训练,混入旧数据防遗忘。
- 模型编辑(ROME、MEMIT):直接修改特定知识对应的参数,精准但难大规模、有副作用。
- 参数高效更新:LoRA 增量适配。
- 知识蒸馏:把新模型能力蒸馏回部署模型。
- 现实:RAG 是工业界知识更新的首选,参数改动风险高、难回滚。
Q9.9 什么是 Mech Interp(机制可解释性)?有什么发现?
参考答案:
- 目标:从神经元/电路层面理解模型内部在算什么,而非只看输入输出行为。
- 关键方法与发现:
- Superposition(叠加):模型用少于特征数的神经元表示远多于神经元数的特征(稀疏编码),神经元是多个特征的叠加 → 单神经元不可解释。
- Sparse Autoencoder(SAE):训练稀疏自编码器从激活中解耦出可解释的特征方向(Anthropic、OpenAI 的工作)。
- Induction Head:负责"复制前文出现的模式"的小电路,是 in-context learning 的机制基础。
- Activation Steering:找到"拒绝""欺骗""谄媚"等行为的激活方向,可以干预(加/减向量)改变行为。
- Circuit / 归因:用因果干预(激活 patch、ablation)定位负责特定能力的子网络。
- 意义:安全(检测欺骗、控制行为)、可信、改进架构。仍是早期研究。
Q9.10 开源模型和闭源模型的差距在哪?怎么评估一个模型好不好?
参考答案:
- 差距:开源在通用能力 上追得很近(Qwen、DeepSeek、LLaMA 接近或部分超越同规模闭源);但在长尾数据质量、后训练精调、Agent/工具能力、安全对齐、多模态融合上仍有差距。数据质量和后训练 pipeline 是核心壁垒。
- 评估一个模型的维度:
- 能力分布:知识(MMLU)、推理(GPQA)、数学(AIME)、代码(HumanEval/SWE-bench)、长文本、多语言。
- 对齐质量:指令遵循、多轮一致性、格式稳定。
- 安全:有害内容拒绝、越狱鲁棒、过度拒绝。
- 效率:推理成本、吞吐、延迟、显存。
- 实际场景 :在你的具体任务上评测,基准分数仅供参考(污染、过拟合问题)。
- 方法论:用 private held-out 集 + LLM-judge + 人工抽检 + 线上 A/B。
Q9.11 大模型有"世界模型"吗?"随机鹦鹉"之争?
参考答案:
- 观点 A(随机鹦鹉):LLM 只是统计上模仿训练数据的语言模式,通过压缩学到的相关性,不一定理解语义/因果。
- 观点 B(世界模型):为了预测下一个 token,模型必须隐式学到世界的结构和规律(物理、社会、逻辑),Othello-GPT 实验显示模型内部形成了棋盘状态表示(探针可读出),支持这一观点。
- 证据:涌现的推理、few-shot、可解释性发现的内部表示支持"某种世界模型";但泛化脆弱、因果推理弱、易受对抗影响支持"统计模仿"。
- 面试建议:给出平衡观点,引用具体实验(探针、因果干预)而非站队。
Q9.12 如果模型线上效果不好,你怎么排查和优化?
开放题,考察工程方法论:
- 明确问题:是能力不足、对齐问题、还是工程问题(延迟/截断)?量化指标(准确率、拒答率、满意度)。
- 数据侧:抽样 bad case 做归因分类------检索失败?指令没理解?幻觉?格式错?多轮丢失?
- 模型侧:prompt 优化 → RAG 补知识 → few-shot → 微调(LoRA)→ 换更大/更强的模型。
- 部署侧:上下文是否被截断?量化是否掉点?采样参数(temp/top-p)是否合适?
- 迭代:建评测集(覆盖 bad case)、做 A/B、灰度发布、监控回归。
- 权衡:效果 vs 成本 vs 延迟,选性价比最高的方案。
Q9.13 端侧 / 小模型部署的挑战和方案?
参考答案:
- 挑战:内存小、算力弱、功耗/发热受限、无 GPU。
- 方案:
- 量化:4-bit(AWQ/GGUF Q4_K_M)、甚至 2-bit(极端压缩)。
- 小模型设计:知识蒸馏(大模型蒸馏到 1B 级)、稀疏/MoE(激活小)、高效结构。
- 推理引擎:llama.cpp(CPU/混合)、MLC-LLM、ONNX Runtime、NPU 专用(高通、苹果 ANE)。
- 架构优化:GQA/MLA 减 KV、滑动窗口注意力、FlashAttention(支持 NPU/CPU)。
- 任务拆分:简单任务端侧、复杂任务上云(混合推理)。
- 关键:在给定内存/延迟预算下最大化效果,量化与蒸馏组合是主流。
Q9.14 你觉得大模型的下一个重要突破会是什么方向?
开放题,考判断力(给有依据的观点):
- 可能的候选:
- 测试时计算扩展(推理模型)继续深挖:更高效的搜索、验证、自我改进。
- 架构:超越 Transformer 的混合架构(MoE + SSM/线性注意力)、原生多模态。
- Agent 与工具:可靠的长期自主执行、自我进化。
- 数据:可验证的合成数据飞轮、自我博弈。
- 对齐与安全:可扩展监督、可解释性驱动的控制。
- 效率:训练/推理性价比的持续提升。
- 好的回答:不只罗列,而是分析为什么现在是瓶颈、为什么该方向可能突破 ,以及边界条件。
十、手撕代码高频题
Q10.1 实现 Scaled Dot-Product Attention
python
import torch
import torch.nn.functional as F

def attention(q, k, v, mask=None):
    # q,k,v: (batch, heads, seq, dim)
    d_k = q.size(-1)
    scores = torch.matmul(q, k.transpose(-2, -1)) / (d_k ** 0.5)  # (b,h,n,n)
    if mask is not None:
        scores = scores.masked_fill(mask == 0, float('-inf'))
    attn = F.softmax(scores, dim=-1)
    return torch.matmul(attn, v), attn
Q10.2 实现 Multi-Head Attention
python
import torch.nn as nn

class MHA(nn.Module):
    def __init__(self, d_model, n_heads):
        super().__init__()
        assert d_model % n_heads == 0
        self.d_model, self.h = d_model, n_heads
        self.d_k = d_model // n_heads
        self.w_q = nn.Linear(d_model, d_model)
        self.w_k = nn.Linear(d_model, d_model)
        self.w_v = nn.Linear(d_model, d_model)
        self.w_o = nn.Linear(d_model, d_model)

    def forward(self, x, mask=None):
        b, n, _ = x.shape
        # (b,n,d) -> (b,h,n,d_k)
        q = self.w_q(x).view(b, n, self.h, self.d_k).transpose(1, 2)
        k = self.w_k(x).view(b, n, self.h, self.d_k).transpose(1, 2)
        v = self.w_v(x).view(b, n, self.h, self.d_k).transpose(1, 2)
        scores = q @ k.transpose(-2, -1) / (self.d_k ** 0.5)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, float('-inf'))
        attn = scores.softmax(dim=-1)
        out = attn @ v                                  # (b,h,n,d_k)
        out = out.transpose(1, 2).contiguous().view(b, n, self.d_model)
        return self.w_o(out)
Q10.3 实现因果掩码
python
def causal_mask(seq_len, device='cpu'):
    # 下三角为 True(可见),上三角 False(屏蔽)
    return torch.tril(torch.ones(seq_len, seq_len, device=device)).bool()
Q10.4 实现 RoPE(旋转位置编码)
python
def precompute_freqs_cis(dim, seq_len, base=10000.0):
    # 每个维度对的旋转频率
    freqs = 1.0 / (base ** (torch.arange(0, dim, 2).float() / dim))
    t = torch.arange(seq_len)
    freqs = torch.outer(t, freqs)                     # (seq, dim/2)
    return torch.polar(torch.ones_like(freqs), freqs) # 复数形式 e^{i*m*theta}

def apply_rope(x, freqs_cis):
    # x: (b, h, seq, d) -> 视作复数 (b,h,seq,d/2)
    x_ = torch.view_as_complex(x.float().reshape(*x.shape[:-1], -1, 2))
    freqs = freqs_cis[: x.shape[-2]].unsqueeze(0).unsqueeze(0)
    x_out = torch.view_as_real(x_ * freqs).flatten(-2)
    return x_out.type_as(x)
Q10.5 实现 KV Cache 的自回归生成
python
@torch.no_grad()
def generate(model, input_ids, max_new_tokens, eos_id=None):
    past = None
    for _ in range(max_new_tokens):
        out = model(input_ids if past is None else input_ids[:, -1:],
                    past_key_values=past, use_cache=True)
        logits, past = out.logits, out.past_key_values
        next_id = logits[:, -1].argmax(dim=-1, keepdim=True)
        input_ids = torch.cat([input_ids, next_id], dim=-1)
        if eos_id is not None and (next_id == eos_id).all():
            break
    return input_ids
Q10.6 实现 Top-k / Top-p 采样
python
def top_k_top_p_filtering(logits, top_k=0, top_p=1.0):
    if top_k > 0:
        kth = torch.topk(logits, top_k)[0][..., -1, None]
        logits[logits < kth] = float('-inf')
    if top_p < 1.0:
        sorted_logits, sorted_idx = torch.sort(logits, descending=True)
        probs = sorted_logits.softmax(dim=-1)
        cum = probs.cumsum(dim=-1)
        # 去掉累积概率超过 top_p 的 token(保留第一个超过的)
        remove = cum - probs > top_p
        sorted_logits[remove] = float('-inf')
        logits = sorted_logits.scatter(-1, sorted_idx, sorted_logits)
    return logits
Q10.7 实现 LoRA 层
python
class LoRALinear(nn.Module):
    def __init__(self, base: nn.Linear, r=8, alpha=16):
        super().__init__()
        self.base = base
        for p in self.base.parameters():
            p.requires_grad = False
        self.r, self.scaling = r, alpha / r
        self.A = nn.Parameter(torch.randn(r, base.in_features) * 0.01)
        self.B = nn.Parameter(torch.zeros(base.out_features, r))

    def forward(self, x):
        return self.base(x) + self.scaling * (x @ self.A.T @ self.B.T)
Q10.8 实现 Grouped-Query Attention(GQA)
python
import torch, torch.nn as nn

class GQA(nn.Module):
    def __init__(self, d_model, n_heads, n_kv_heads):
        super().__init__()
        self.h, self.kv_h = n_heads, n_kv_heads
        self.d_k = d_model // n_heads
        self.q_proj = nn.Linear(d_model, self.h * self.d_k)
        self.k_proj = nn.Linear(d_model, self.kv_h * self.d_k)
        self.v_proj = nn.Linear(d_model, self.kv_h * self.d_k)
        self.o_proj = nn.Linear(d_model, d_model)

    def forward(self, x):
        b, n, _ = x.shape
        q = self.q_proj(x).view(b, n, self.h, self.d_k).transpose(1, 2)
        k = self.k_proj(x).view(b, n, self.kv_h, self.d_k).transpose(1, 2)
        v = self.v_proj(x).view(b, n, self.kv_h, self.d_k).transpose(1, 2)
        # 把每个 KV 头复制给对应的 n_heads/n_kv_heads 个 Q 头
        reps = self.h // self.kv_h
        k = k.repeat_interleave(reps, dim=1)
        v = v.repeat_interleave(reps, dim=1)
        out = torch.nn.functional.scaled_dot_product_attention(q, k, v, is_causal=True)
        out = out.transpose(1, 2).contiguous().view(b, n, -1)
        return self.o_proj(out)
Q10.9 实现 RMSNorm
python
class RMSNorm(nn.Module):
    def __init__(self, dim, eps=1e-6):
        super().__init__()
        self.eps = eps
        self.weight = nn.Parameter(torch.ones(dim))

    def forward(self, x):
        rms = x.pow(2).mean(-1, keepdim=True).add(self.eps).rsqrt()
        return x * rms * self.weight
Q10.10 实现 SwiGLU FFN
python
class SwiGLU(nn.Module):
    def __init__(self, d_model, hidden):
        super().__init__()
        self.w1 = nn.Linear(d_model, hidden, bias=False)  # gate
        self.w2 = nn.Linear(hidden, d_model, bias=False)  # down
        self.w3 = nn.Linear(d_model, hidden, bias=False)  # up

    def forward(self, x):
        return self.w2(torch.nn.functional.silu(self.w1(x)) * self.w3(x))
Q10.11 实现交叉熵 / 数值稳定的 softmax
python
def stable_softmax(x, dim=-1):
    x = x - x.max(dim=dim, keepdim=True).values   # 减最大值防溢出
    e = x.exp()
    return e / e.sum(dim=dim, keepdim=True)

def cross_entropy(logits, targets):
    # logits: (N, C), targets: (N,)
    log_probs = torch.log_softmax(logits, dim=-1)   # logsumexp 内部稳定
    return -log_probs.gather(1, targets.unsqueeze(1)).mean()
Q10.12 快速幂 / 计算 a n a^n an、翻转链表、TopK 等常规题
(视公司而定,部分大厂会考传统算法题,建议 LeetCode Hot 100 + 剑指 Offer 过一遍。)
附:面试准备建议
- 主线清晰:能把"预训练 → SFT → 对齐 → 部署"整条链路讲清楚,比背零散知识点更打动面试官。
- 有项目深挖:准备好 1-2 个你亲手做的项目,能回答"为什么这么做""遇到什么坑""如果重做会怎么改"。
- 手撕代码:Attention、MHA、RoPE、KV Cache、采样、LoRA 这几段一定要能默写。
- 论文跟进:至少读透 5-10 篇经典论文(Attention is All You Need、GPT-3、InstructGPT、LLaMA、Chinchilla、FlashAttention、LoRA、DPO、DeepSeek-V3/R1)。
- 开放题:准备观点,不要只罗列技术名词,要有 trade-off 分析和自己的判断。
祝面试顺利。