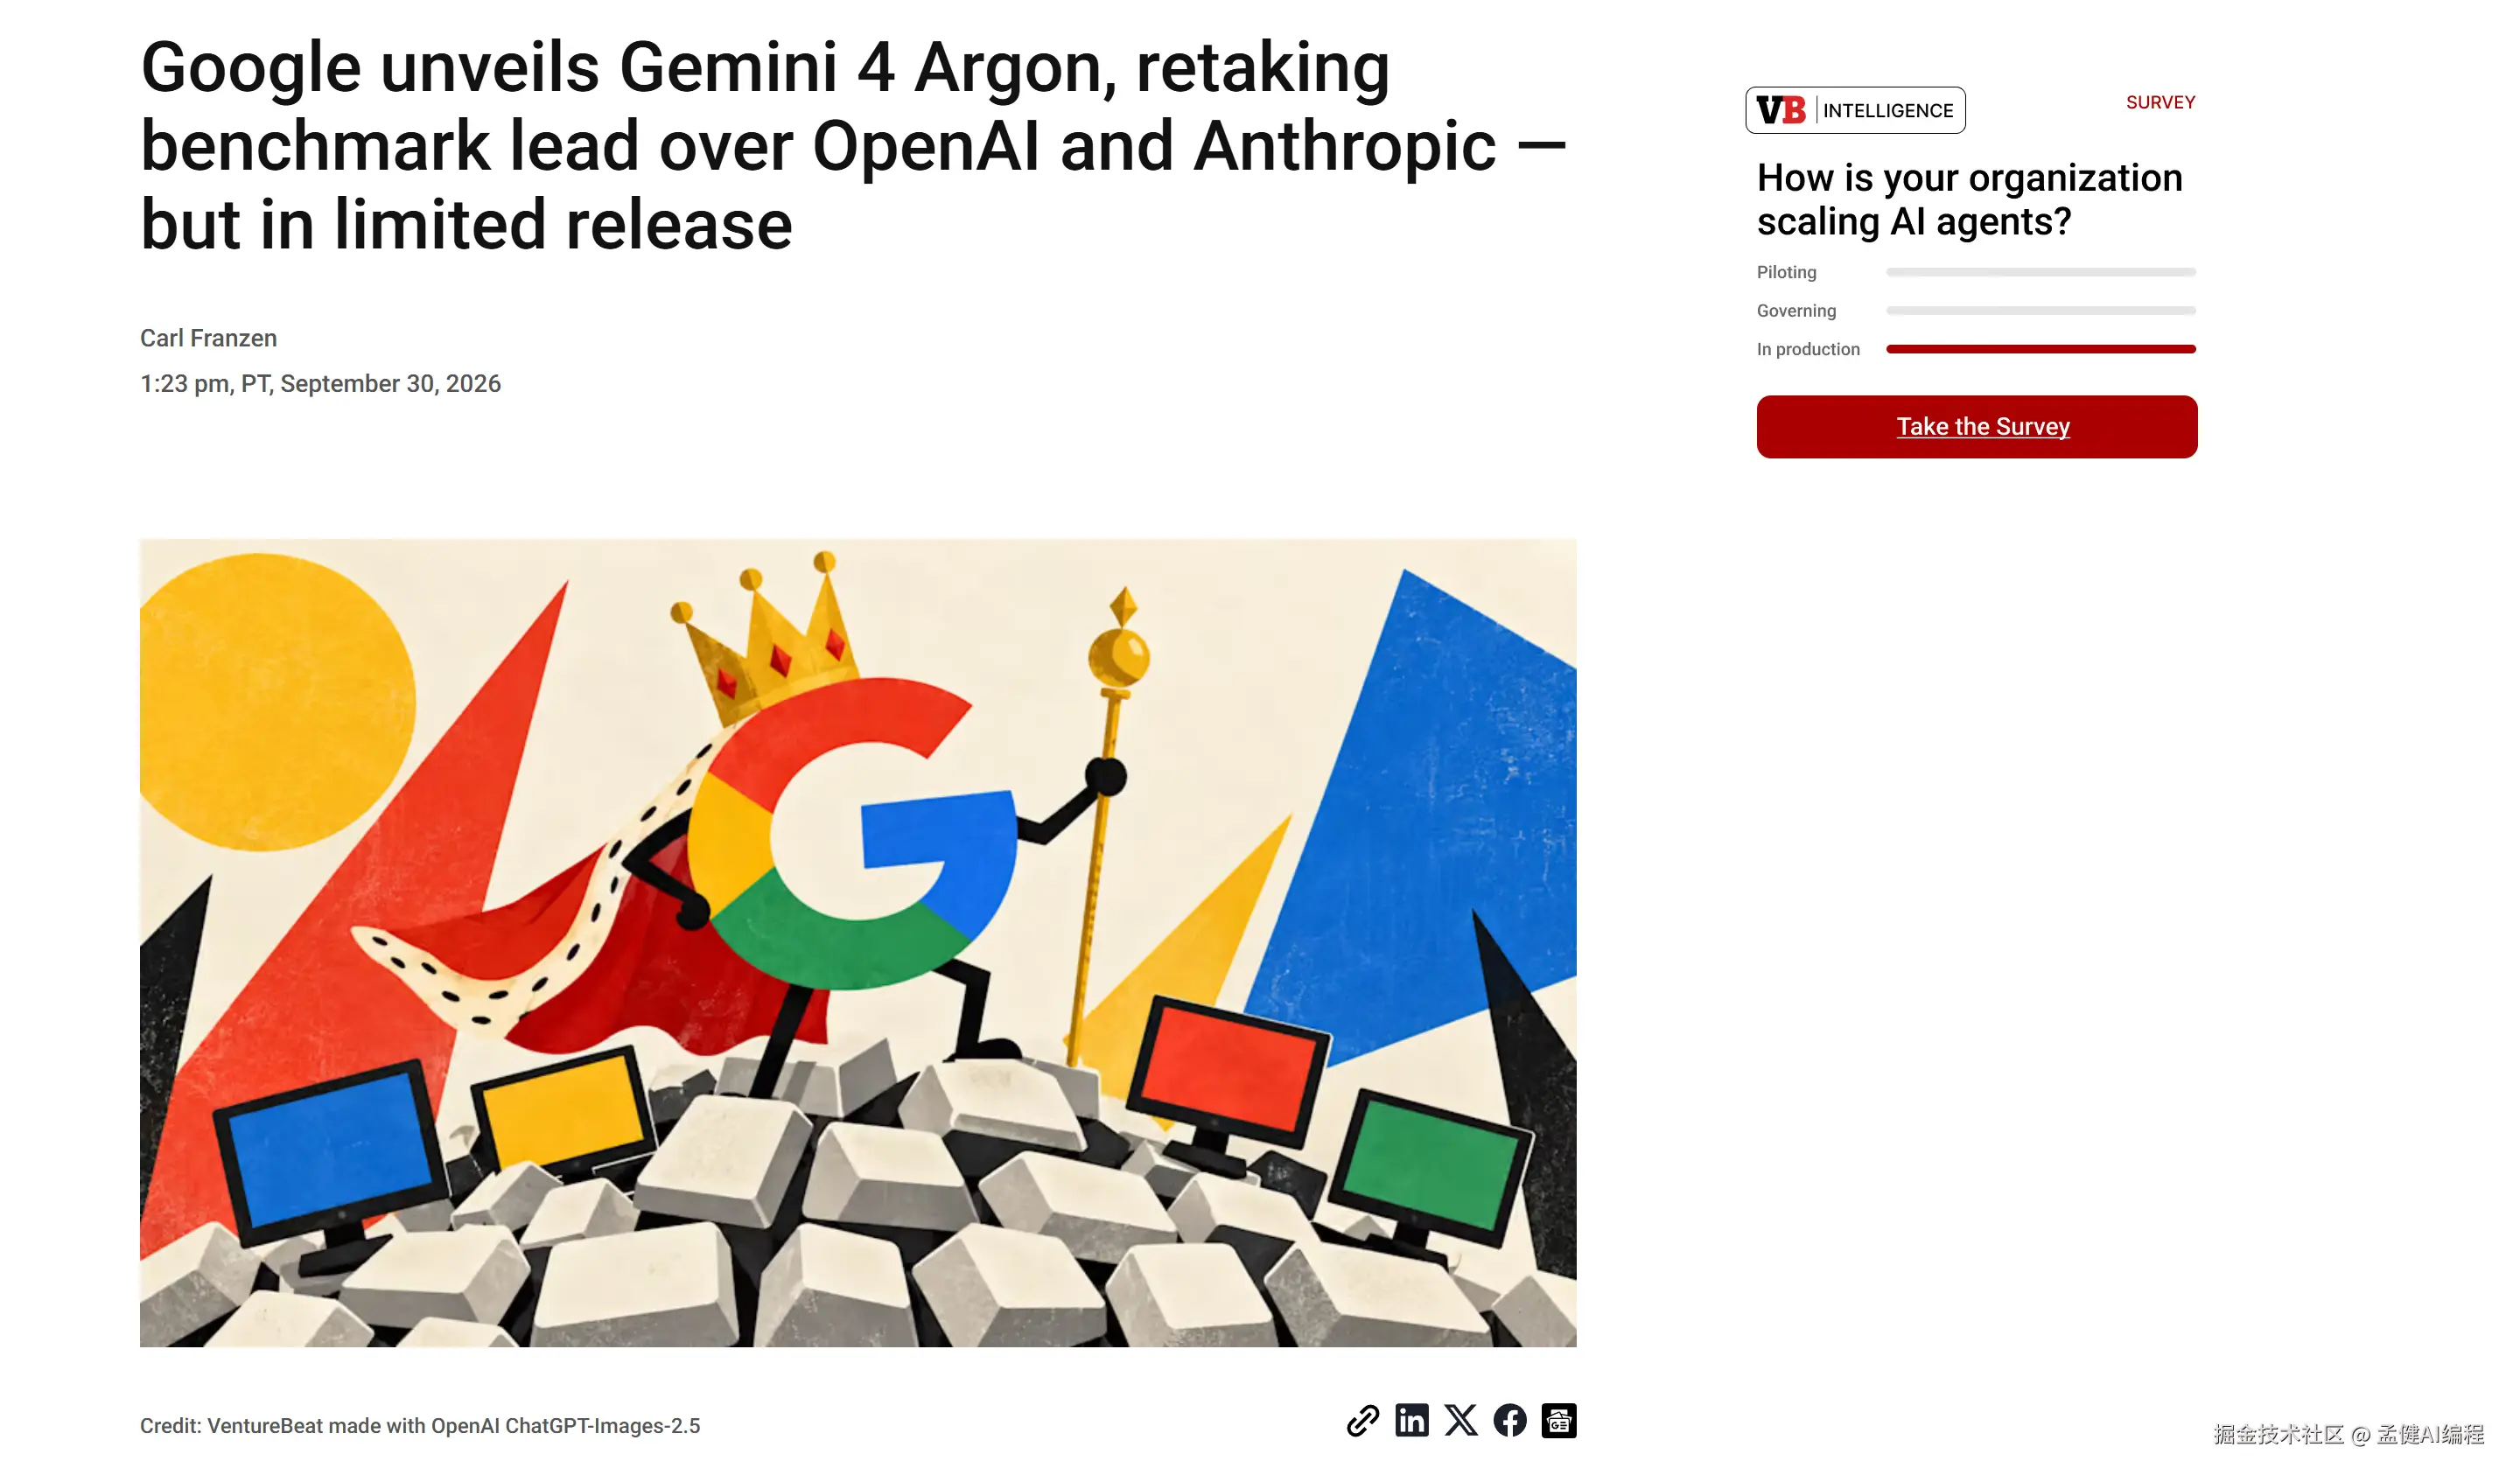
大家好,我是孟健。今天一早在工位坐下,几个技术群和社区里全在刷谷歌 2026 年 9 月 30 日发布的 Gemini 4 Argon。
单次输出上限直接拔到 100 万 Token,首发 API 价格腰斩,很多做独立开发和一人公司的同行跑来问我:孟哥,要不要把主力 Agent 和写代码的基座切到 Argon?
这篇文章就是为每天依赖 AI 辅助写代码、交付软件的独立开发者和中小团队写的。做技术我们习惯盯紧参数突破与架构演进,但做生意必须首先面对真实交付与经营结果。跑完公开数据和基准细节后,我的结论非常明确:现阶段无需迁移,而且短期内你也根本迁不过去。
01、账面数字惊艳,但参数突破不等于落地交付
谷歌这次在工程架构上的动作确实很大。据官方发布信息,Gemini 4 Argon 将单次生成的输出 Token 上限由上一代的 6.4 万一口气推升到了 100 万 Token。作为对比,目前大家主力使用的 GPT-6 Astra 单次输出上限约为 12.8 万 Token。
输出百万级 Token,意味着理论上可以让模型一口气生成一个完整子模块的数十个文件,或者一次性输出极长周期的端到端审计日志。在官方公布的基准测试中,Google 列出的 18 项对比评测里 Argon 拿下了 12 项单独领先、1 项并列第一。
在软件工程领域,Argon 在 DeepSWE v1.1 拿下了 77.9%,超过了 GPT-6 Astra 的 74.1%;CWE-bench v1 漏洞修复以 68% 并列首位;Zapier AutomationBench 达到 51.3%,明显压过 Claude Opus 5.5 的 42.5% 与 Astra 的 41.4%。
做技术时我们习惯盯紧代码产出与系统实现,但做生意必须首先面对真实用户与经营结果。
很多技术人看到这里就开始兴奋,但跑分领先不等于工程可用。做日常研发不仅要看模型能否解出理想单测题,更要看它在复杂目录树与终端交互里的确定性。

02、拆解开发短板:终端与复杂工程依然承压
如果我们把评测颗粒度细化到一线开发者每天都要面对的真实场景,数据展现出的完全是另一幅图景。
在更加逼近真实长程软件工程的 FrontierSWE v2 基准上,Argon 落后 GPT-6 Astra 达 10.5 个百分点;在考验命令行与环境感知的 Terminal-Bench Science 0.1 测试中,同样落后 Astra 10.5 个百分点。而在纯终端交互的 Terminal-Bench 4.0 上,Argon 则落后 Claude Opus 5.5 达 9 个百分点。
bash
# 开发者在日常 Agent 编程中依赖的典型终端回环链路
# 一旦模型在 Terminal-Bench 类任务中失真,整个自动执行链条就会直接卡死
$ pnpm test:e2e --filter=@core/agent
$ git diff --name-only origin/main
# 模型需要精准解析 diff、日志报错并自主修正上下文
# 终端执行鲁棒性差 10%,意味着人工介入排错的频次呈指数级上升
这正切中了 AI 辅助编程最大的痛点:终端执行精度。当你的 Coding Agent 需要在终端里自动装依赖、跑容器、分析报错、回滚代码时,10 个百分点的差距意味着你在日常开发中会频繁遭遇"幻觉卡壳"。
据彭博社 2026 年 9 月 30 日报道,知情人士透露,谷歌内部对 Argon 在编码等关键任务中的实际表现同样存疑,模型在基准榜单上表现突出,但内部员工在日常使用时,部分编码任务依然难以稳定完成。
能跑通 Benchmark,不代表能稳定帮你写代码。 面对不确定的工程稳定性,坚守已被充分验证的工作流,才是一人公司必须死守的安全边际。
03、算清成本账:早期折扣与长期开销的陷阱
再来看大家最关心的成本账。作为前大厂 Leader,我现在做一人公司,每月第一件事就是核算各家 API 的账单流水。算账必须算全周期,不能只看第一天的促销牌。
Argon 首发给出了非常诱人的早期 API 定价:
- 每百万输入 Token:2 美元
- 每百万输出 Token:10 美元
- 缓存输入享有 95% 折扣
依据 Artificial Analysis 测算,在早期折扣下,Argon 每任务平均成本为 1.99 美元,比 GPT-6 Astra 降低了约 40%,相当于只需 Astra 60% 的成本。
但这里存在一个关键变量:这只是促销期价格。促销期结束后,Argon 的标准价将调升至输入 4 美元、输出 20 美元(与 Claude Opus 5.5 持平)。届时根据同样的测算逻辑,其每任务成本将升至 Astra 的 1.2 倍左右。
json
{
  "model_cost_comparison": {
    "gemini_4_argon_promo": {
      "input_per_m": "$2.00",
      "output_per_m": "$10.00",
      "cost_vs_astra": "-40%"
    },
    "gemini_4_argon_standard": {
      "input_per_m": "$4.00",
      "output_per_m": "$20.00",
      "cost_vs_astra": "+20%"
    },
    "gpt_6_astra": {
      "input_per_m": "$10.00",
      "output_per_m": "$50.00",
      "availability": "Public API"
    }
  }
}
做商业基础设施决策,最忌讳因为短暂的补贴窗口而打乱底层栈。一旦你耗费数周时间针对 Argon 调优了 Prompts、上下文分块和工作流适配器,促销期一过,你的成本优势不仅荡然无存,反而承受了迁移重构的技术负债。
04、最现实的壁垒:你现在根本用不到它
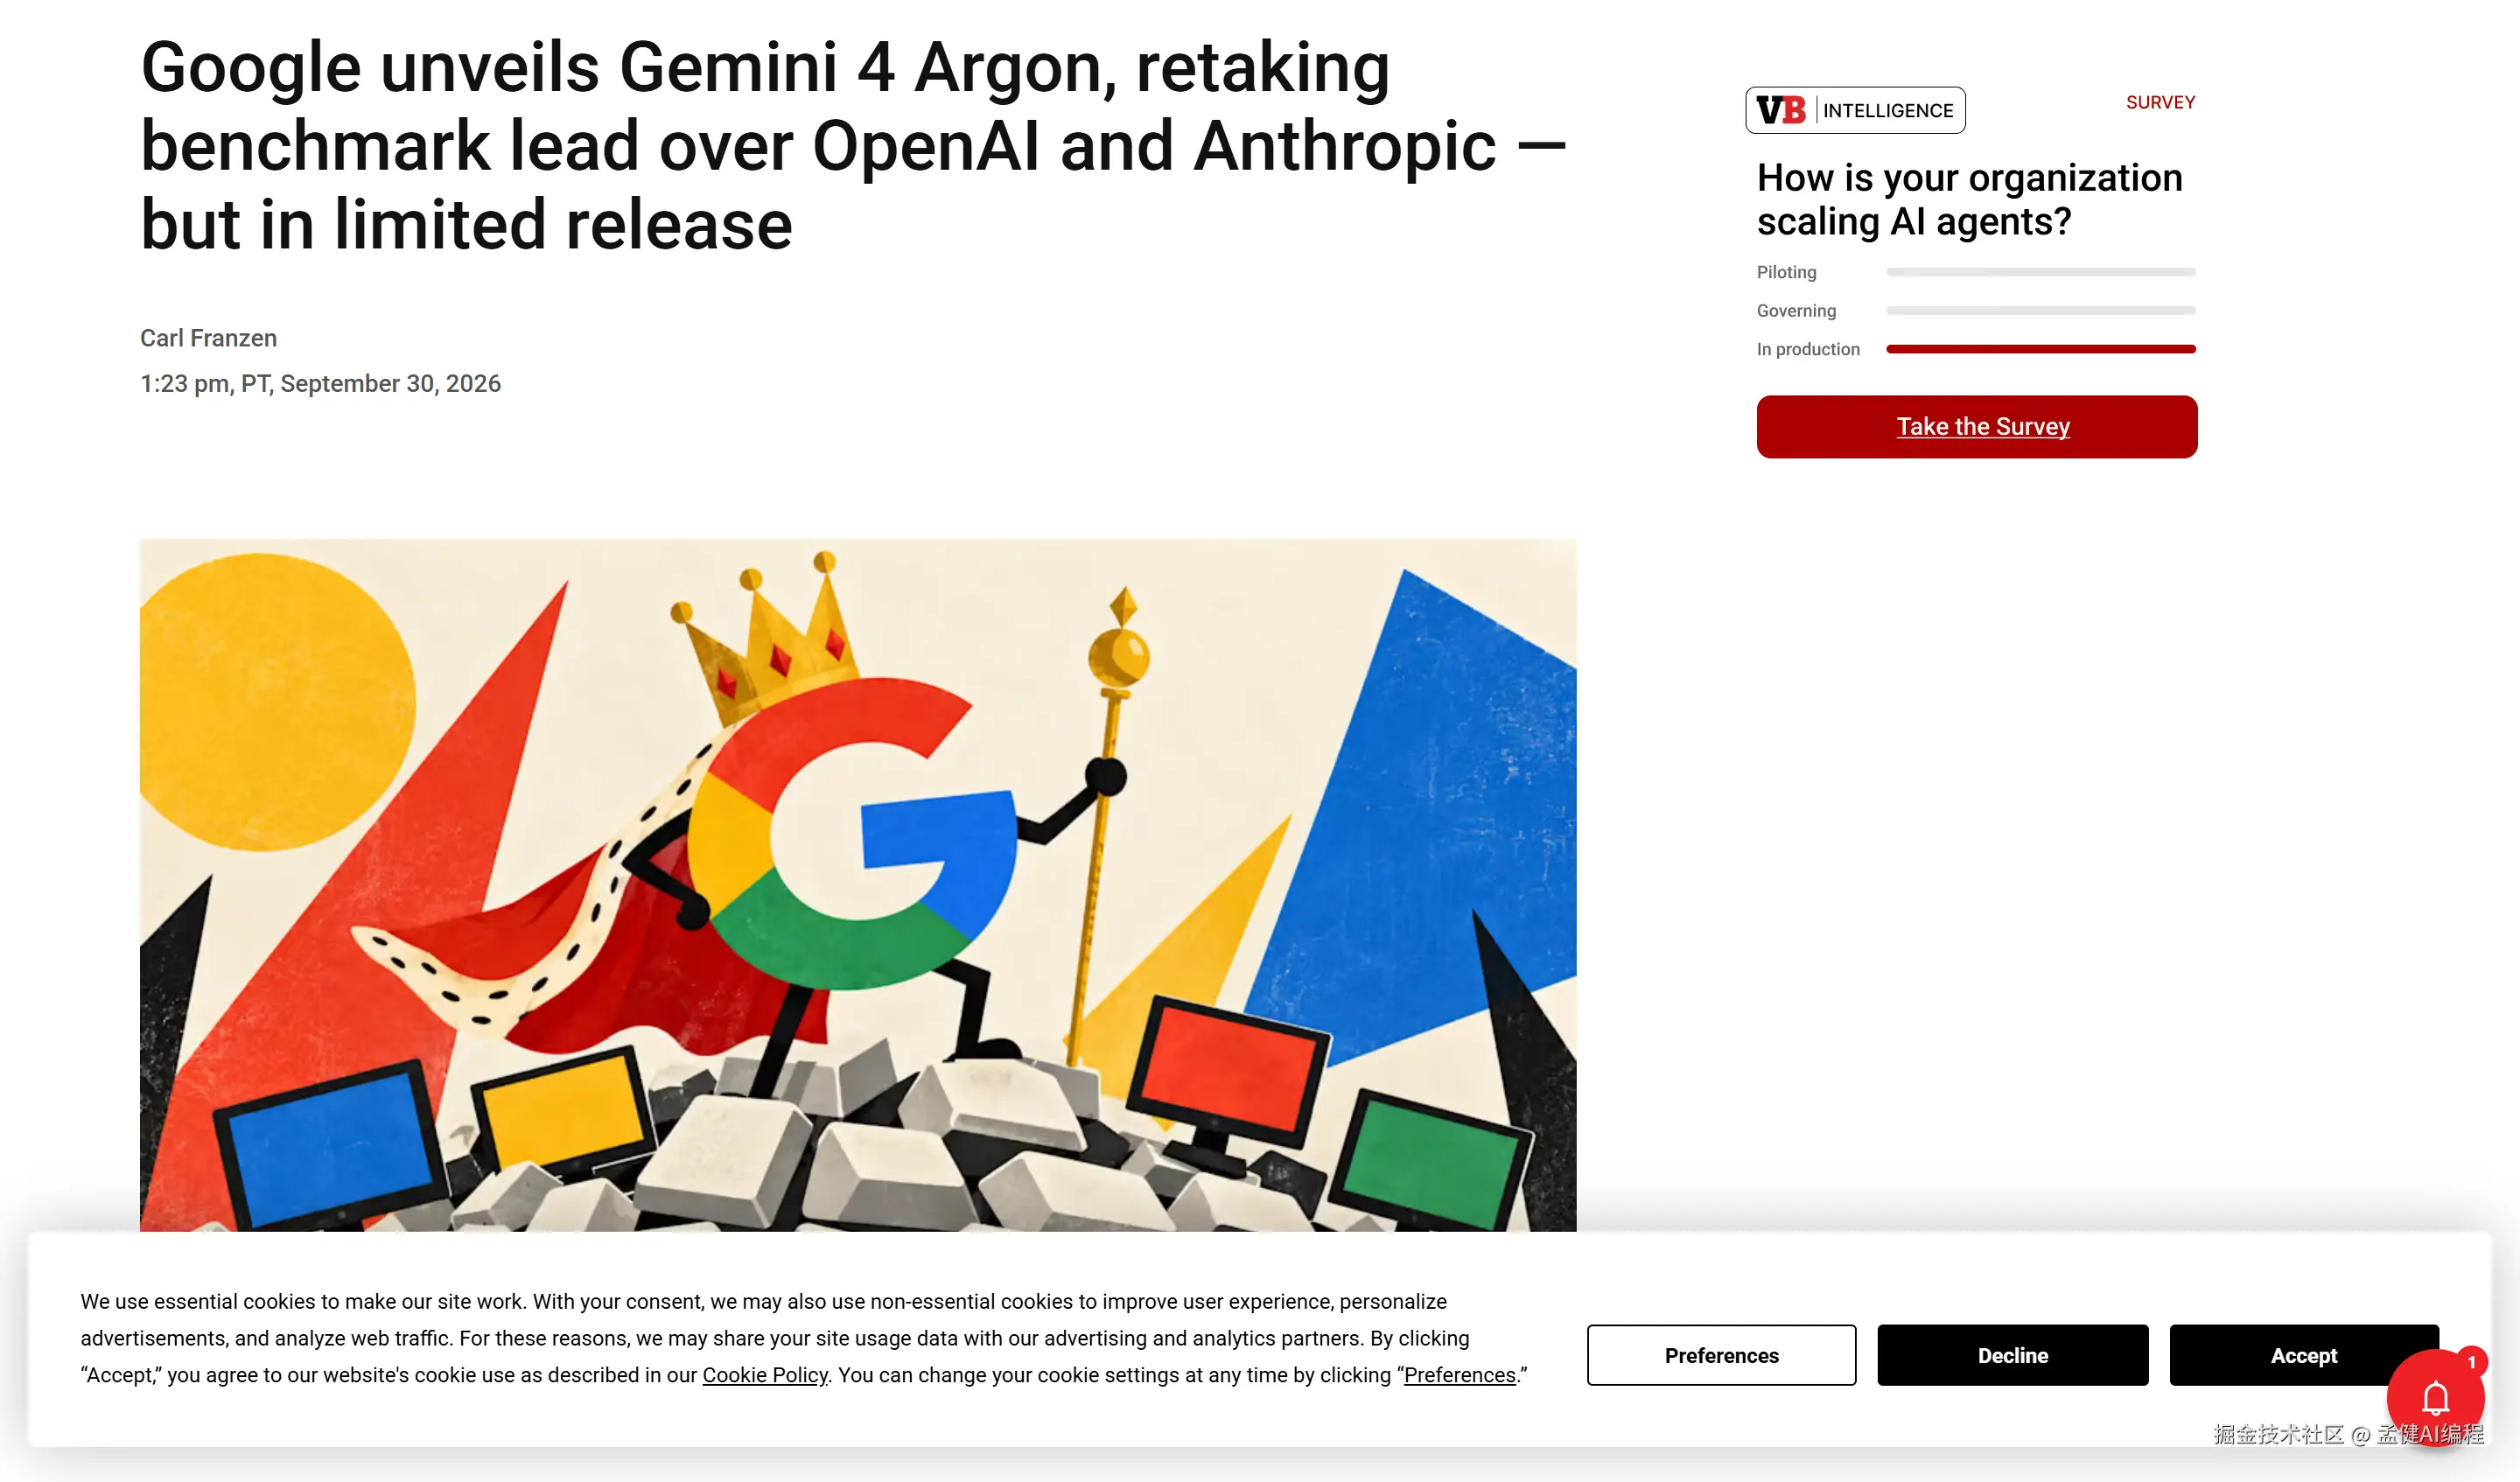
把前面的技术短板与成本波动都抛开,还有一个最核心、最硬性的物理事实:普通开发者根本拿不到调用权限。
与 GPT-6 Astra 早在 2026 年 9 月 3 日就全面向 ChatGPT 与 API 客户开放不同,谷歌对 Gemini 4 Argon 采取了极为严格的受控早期访问策略(Fairwind Program)。目前首批接入资格仅对受信任的网络安全防御机构开放,企业级通用通道和独立开发者个人账户尚未放行。
很多技术人在社群里热烈讨论如何迁移系统、如何替换 Claude Code 或 Cursor 的基座,但在平台连 API 都没向你开放的阶段,这种讨论除了增加信息焦虑,没有实际生产力价值。
克制自己的技术尝鲜冲动,把精力收敛在当前能产生确定性交付的事物上,是独立开发者最基本的生存法则。
05、一人公司的基座选择:现阶段到底怎么选
面对乱花渐欲迷人眼的行业发布会,一人公司的打法永远是做减法,永远看重现货与稳定性。
结合当前各家模型的硬指标与可用性,我给同行们的选型建议非常明确:
- 终端交互与深度 Agent 编排:现阶段继续锁死 GPT-6 Astra 与 Claude 体系。Astra 已经全量可用,在 FrontierSWE v2 和终端科学基准上领先 Argon 10.5 个百分点,是复杂工程调用的基石。
- 日常代码补全与常规任务交付:利用 Claude Opus 5.5 或现有成熟生态,享受成熟社区工具链的红利,不轻易折腾基座适配。
- 对 Gemini 4 Argon 保持观察即可:等 Fairwind 计划逐步外溢、面向公众 API 开放、且有经过第三方真实生产环境的工程评测沉淀后,再做灰度测试也不迟。
做技术产品,公开宣讲的参数再亮眼,也只是初次亮相;真实业务场景中日复一日的交付能力,才决定一个工具能否留在你的终端里。
下一阶段我依然会聚焦于一人公司在真实生产环境下的自动化编程链路降本方案,持续验证更稳妥的工程解法。
大家目前主力写代码用的是哪套基座?在终端场景下更信任哪家模型?欢迎点赞、收藏,有更好的方案我们在评论区深入交流。
👋 我是孟健,前腾讯 T11、前字节技术 Leader,现在全职做 AI 编程。
🔥 更多 AI 编程实战:
- GitHub:@mengjian-github
- 专栏:AI编程实战
觉得有用?点赞+收藏 就是最大支持 🙏
本文由作者借助 AI 辅助整理,内容经作者实测与审校。