(一).为什么会有可靠性传输问题
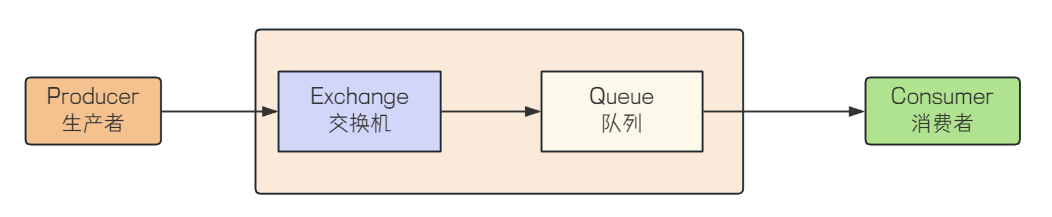
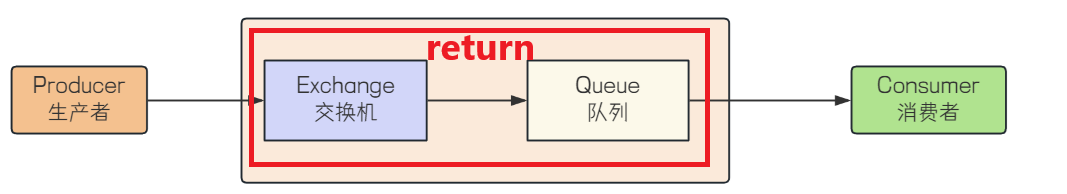
上图是RabbitMQ的消息传递图。从生产者发送消息到消费者消费消息,这个过程中,消息是可能会丢失的。那么我们就来看一下具体有哪几个场景会出现消息丢失的问题。
①.生产者将消息发送到RabbitMQ可能会失败。如果是因为些网络问题,那么就会导致RabbitMQ无法收到生产者发来的消息。
②.消息在交换机中,无法路由到指定的队列。当我们的代码或配置信息写错没导致交换机和队列之间无法正确的绑定,此时就会导致消息路由失败,那么队列就无法获取到交换机发来的消息。
③.消息队列自身原因导致消息丢失。当消息到达RabbitMQ后,RabbitMQ Server 挂了,那么就会导致刚刚到的消息就丢失了
④.消费者消费消息异常,导致消息丢失。当消息到达消费者之后,消费者由于自身问题导致挂了,还没来得及消费,此时消息就会丢失。
下面,就分别来介绍一下,RabbitMQ对于"消息可靠性"问题,做出的措施。
(二).发送方确认
"发送方确认",主要是用来解决,当生产者发送消息之后,消息到底有没有正确地到达服务器的问题的。事实上,针对这个问题,有两种解决方案,一种是通过事务,一种是通过"发送方确认"。事务后面再进行介绍,这里先介绍发送方确认。
关于"发送方确认",RabbitMQ提供了两个方式来控制消息的可靠性投递,一种是confirm确认模式,一种是return退回模式。下面进行具体介绍。
1.confirm确认模式
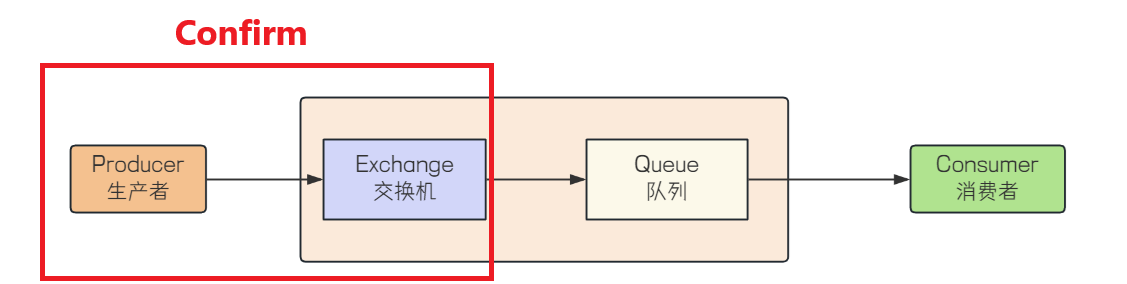
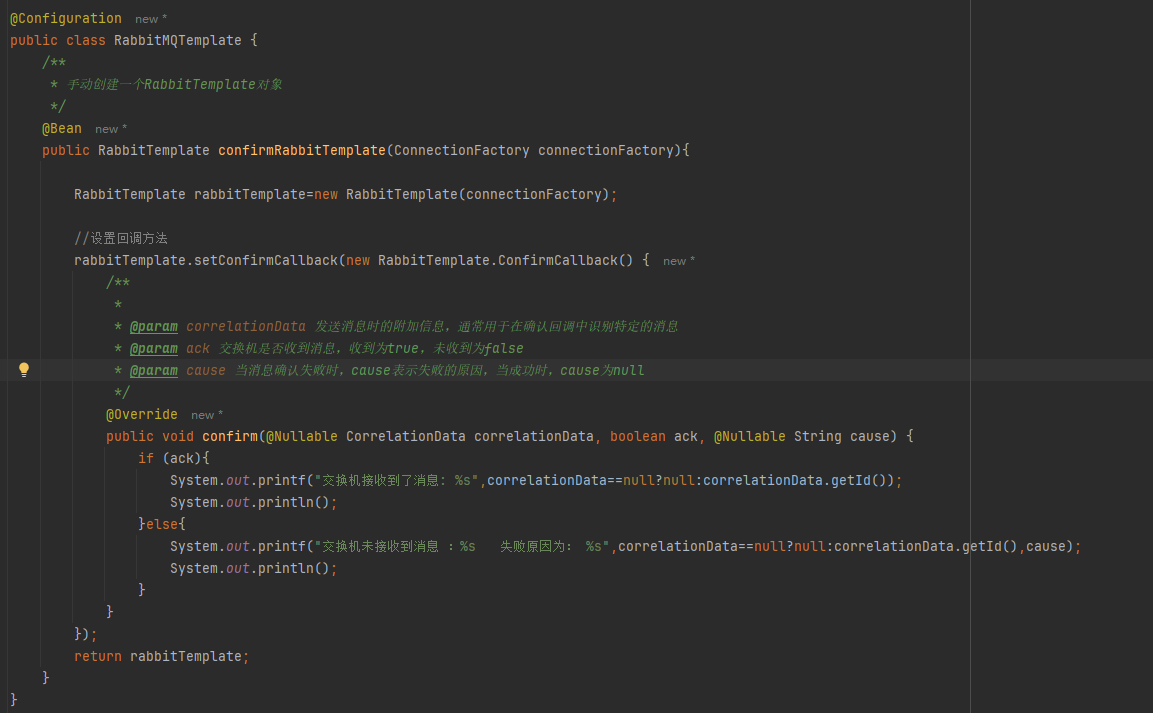
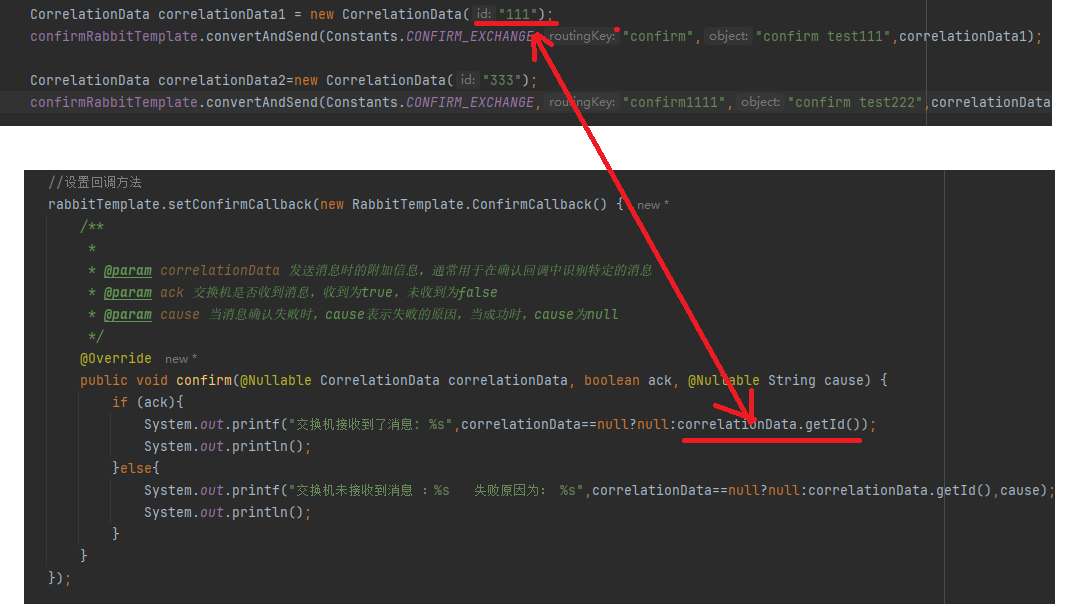
confirm确认模式,指的是,当生产者在发送消息的时候,针对于生产者设置一个ConfirmCallBack的监听,无论消息是否到达交换机,这个监听都会被执行,如果交换机能够成功接收,则ACK设置为True,如果没有收到消息,ACK设置为False
也就是说,confirm确认模式,针对的是从生产者到交换机这一阶段的消息可靠性传输。
下面,进行具体的实现
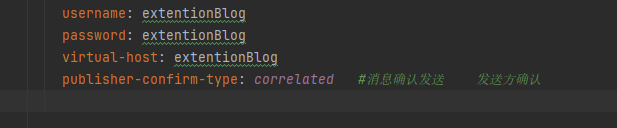
(1).配置相关信息
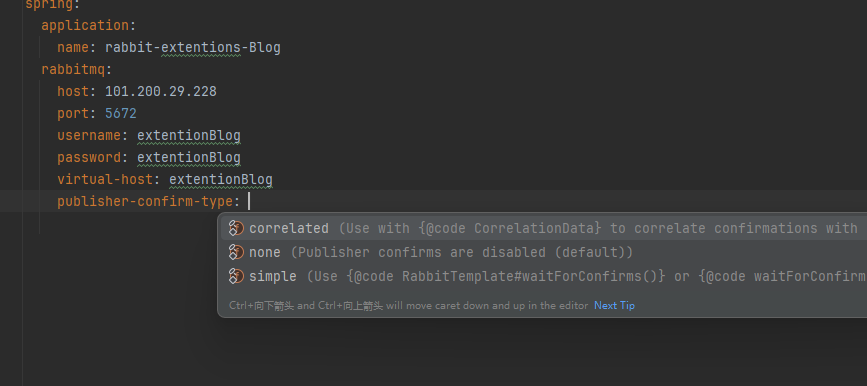
correlated表示的是异步回调确认,当消息发送完成后,异步回调ConfirmCallback,消息发送不会阻塞主线程。
none表示关闭生产者确认机制。
simple表示的同步等待确认,发送消息后,阻塞等待MQ返回确认结果,发送一条,阻塞等回执,再发送下一条。
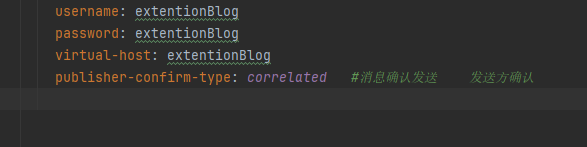
这里,我们设置成correlated。
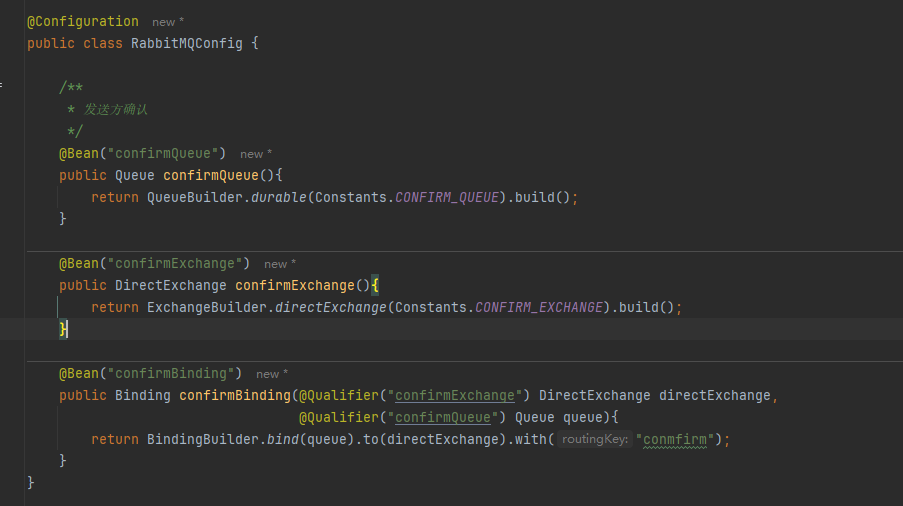
(2).设置确认回调并发送消息
(3).进行测试
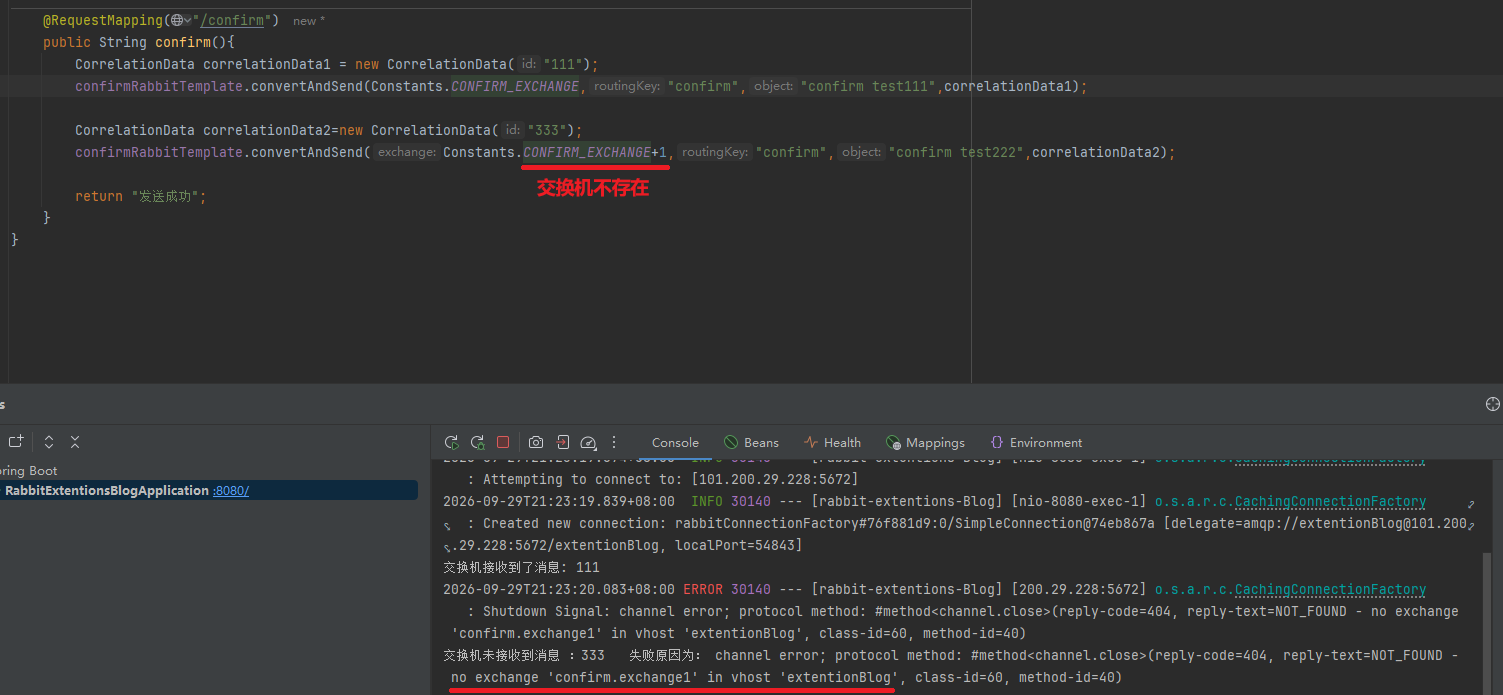
当进行测试的时候,可以发现所有的结果都是符合预期的
2.return退回模式
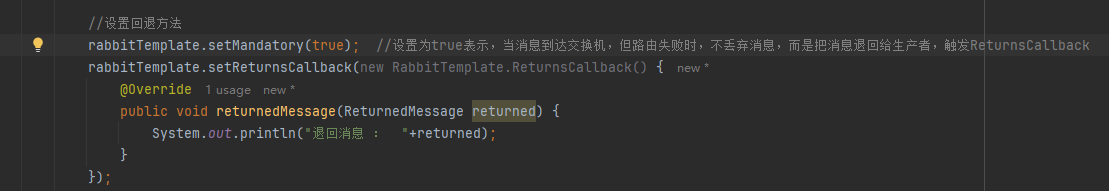
return退回模式,指的是,当消息到达交换机之后,根据路由规则,把消息放入到队列中。在交换机到队列的过程中,如果消息没有被任何队列消费,可以选择把消息回退给生产者。当消息回退给发送方的时候,我们可以设置一个返回回调方法,对消息进行处理。
也就是说,return退回模式,针对的是从交换机到消息队列这一阶段的消息可靠性传输。
(1).配置相关信息
(2).设置返回回调并发送消息
(3).进行测试
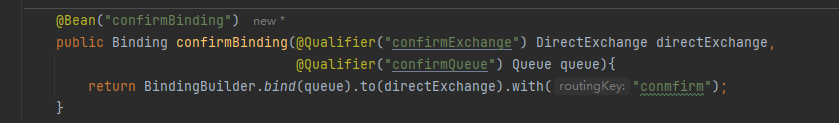
routingKey为"confirm"
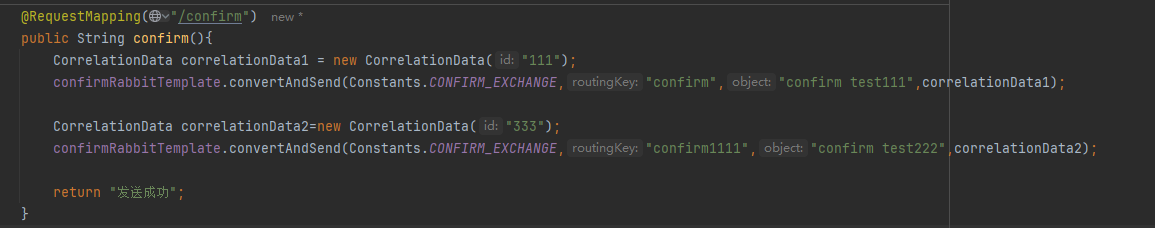
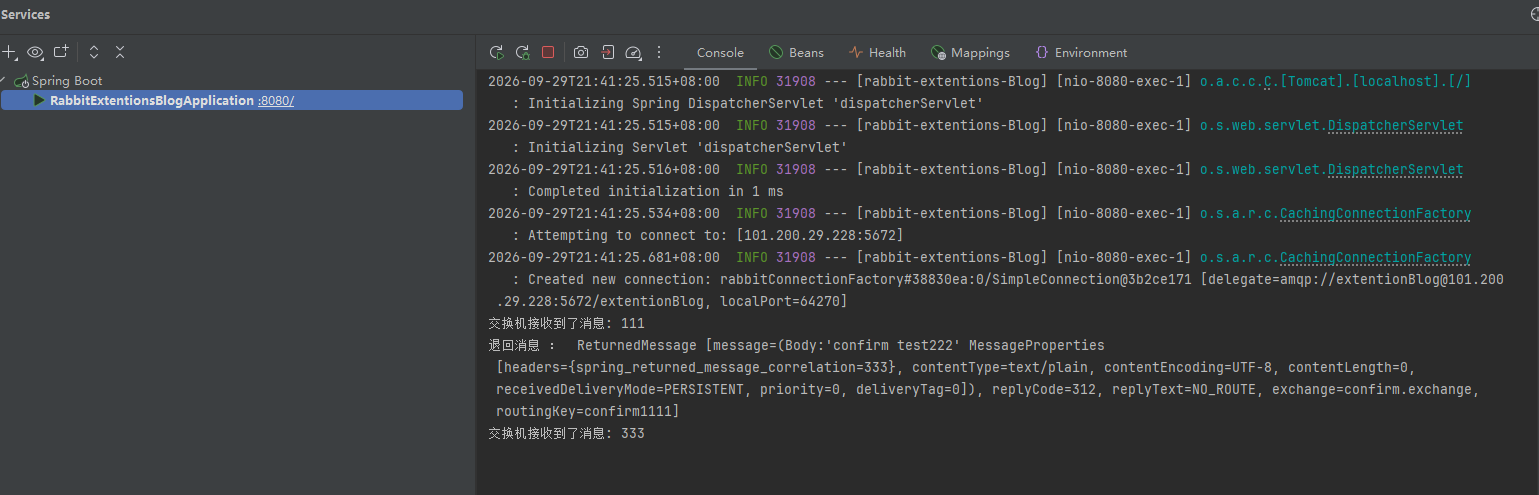
由于第二个消息的routingKey为"confirm111",所以无法让队列接收到消息,所以只能退回
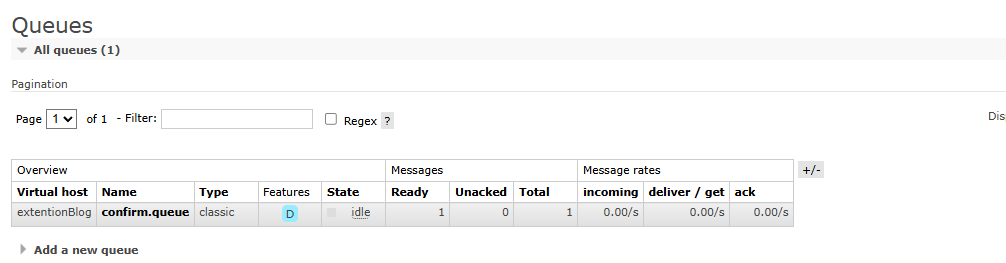
可以看到,队列中只有一条消息
(三).持久化
持久化,解决的是,当RabbitMQ服务停掉以后,生产者发来的消息不丢失问题。
RabbitMQ的持久化,分为三个部分:交换机的持久化,队列的持久化和消息的持久化
1.交换机的持久化
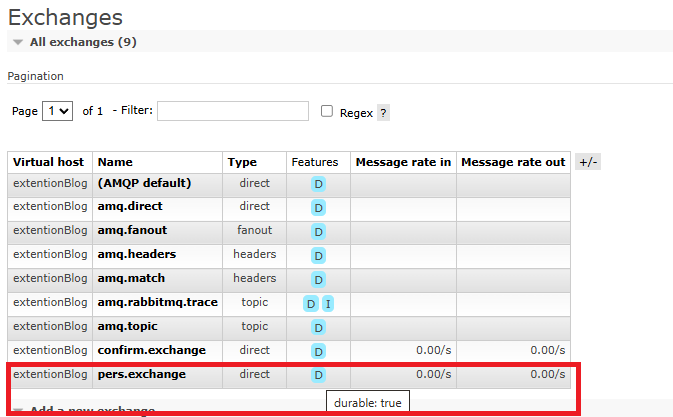
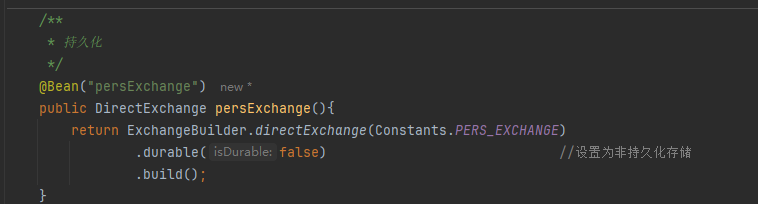
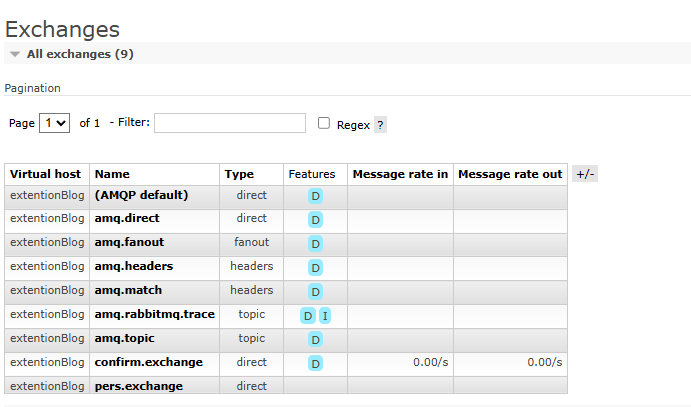
在声明交换机的时候,我们通过durable()方法,然后将参数设置为true,就可以将交换机设置为持久化的了。在默认情况下,交换机就是持久化的,即使我们不设置,也是持久化的,如果需要设置为非持久化,那么就将durable参数设置为false。
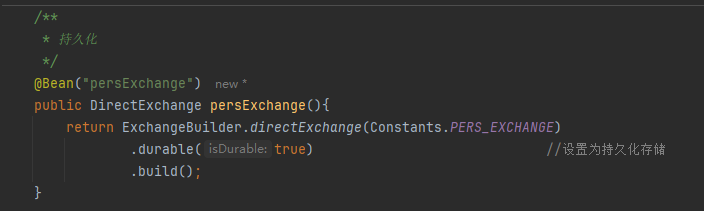
2.队列的持久化
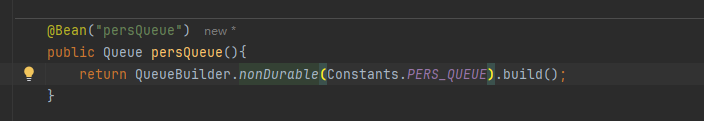
队列的持久化,我们通过声明durable参数来设置的。如果队列不进行持久化,则当RabbitMQ服务重启之后,队列则会被删除,此时数据就会丢失。
事实上,之前创建的队列都是持久化的
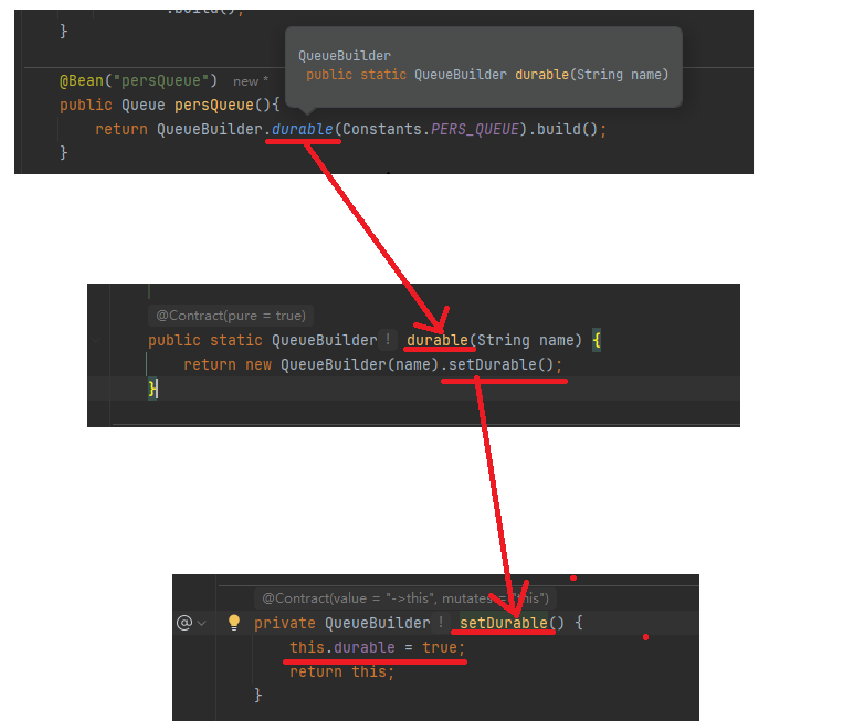
通过源码可以看到,声明队列的时候,默认就是持久化的。如果想要设置为非持久化,则可以通过nonDurable()方法进行设置
3.消息的持久化
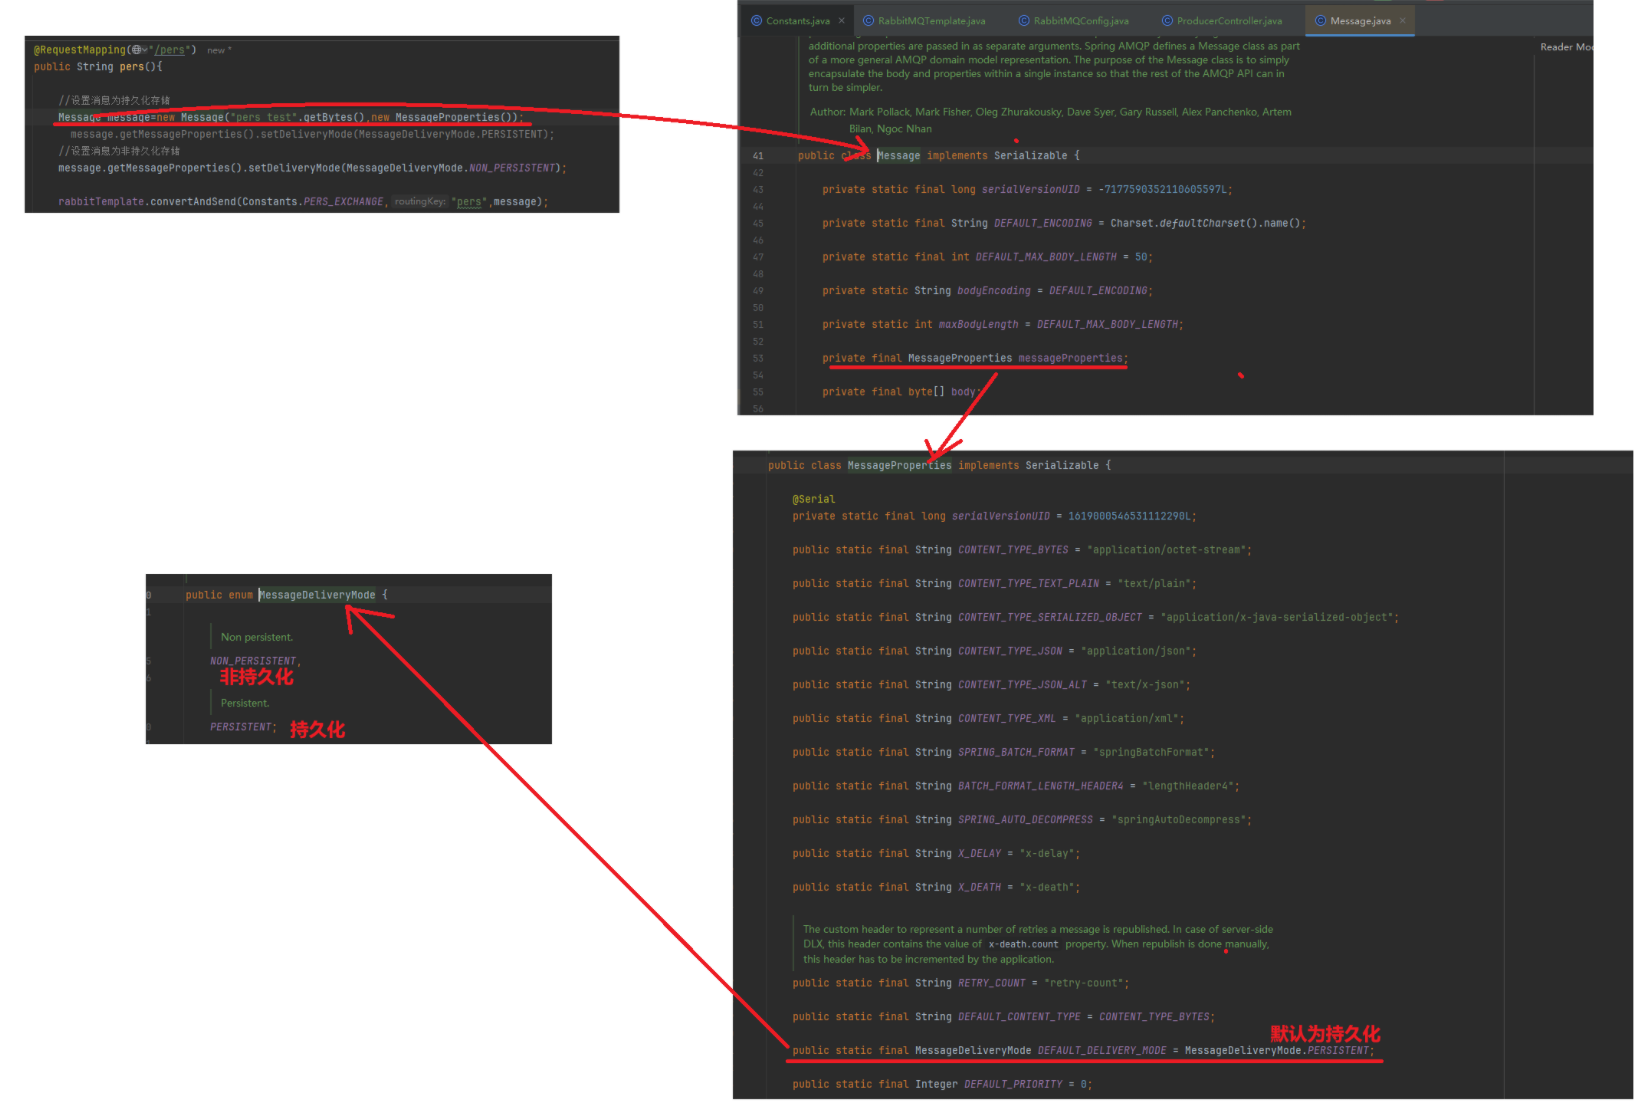
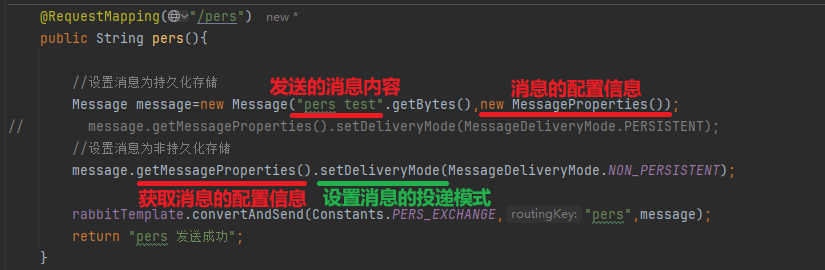
消息的持久化,需要把消息的投递模式设置为PERSISTENT。
在进行设置的时候,我们可以传一个Message对象
4.综合测试
(1).交换机设置为持久化和非持久化,消息是否丢失
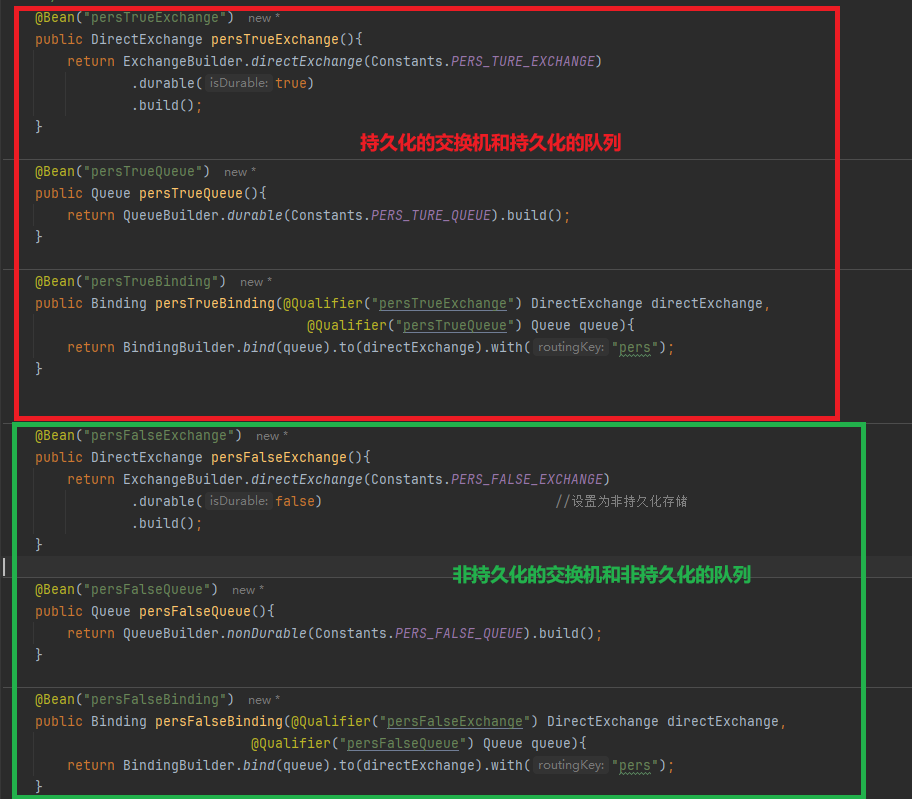
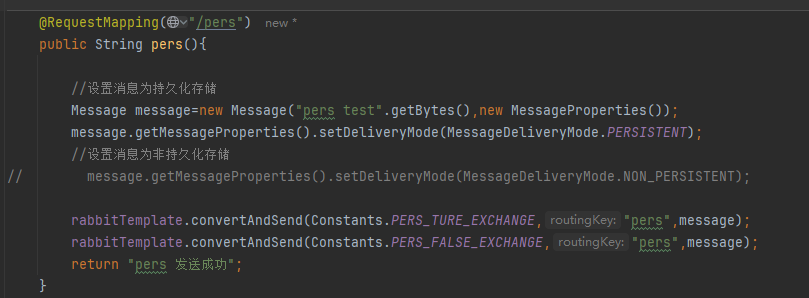
当我发送消息的时候
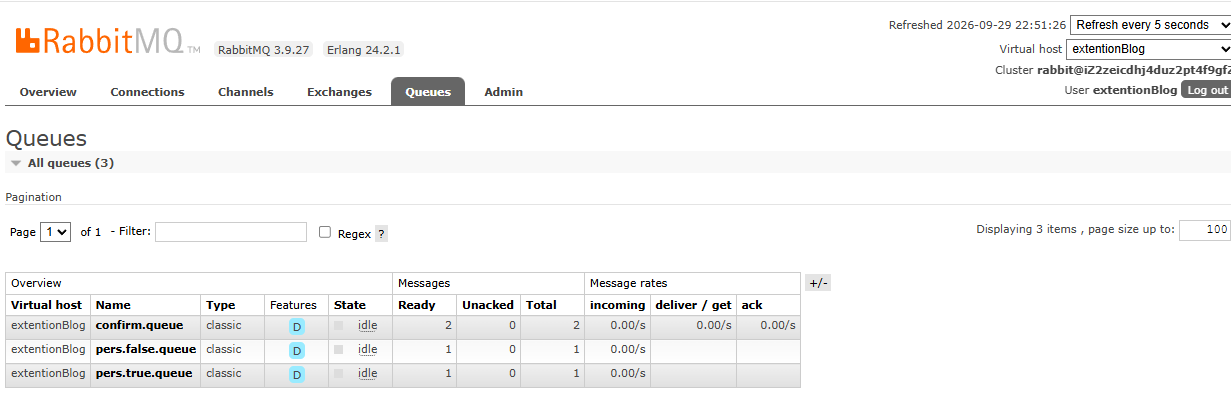
可以发现,两个队列都收到了消息,下面重启RabbitMQ
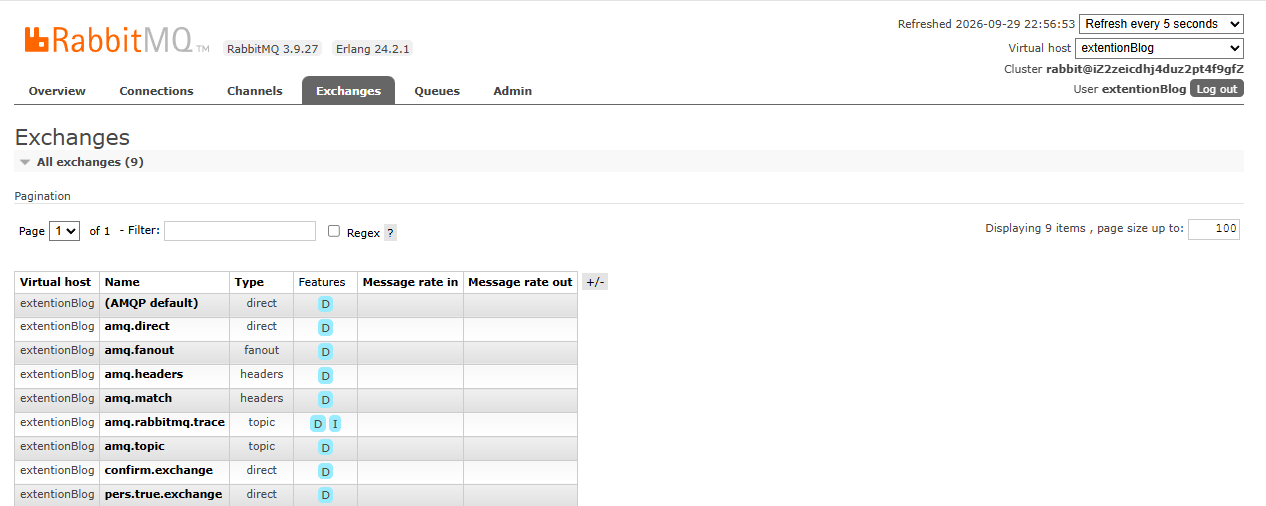
当我重启之后,交换机没有了,那么消息也就不存在了。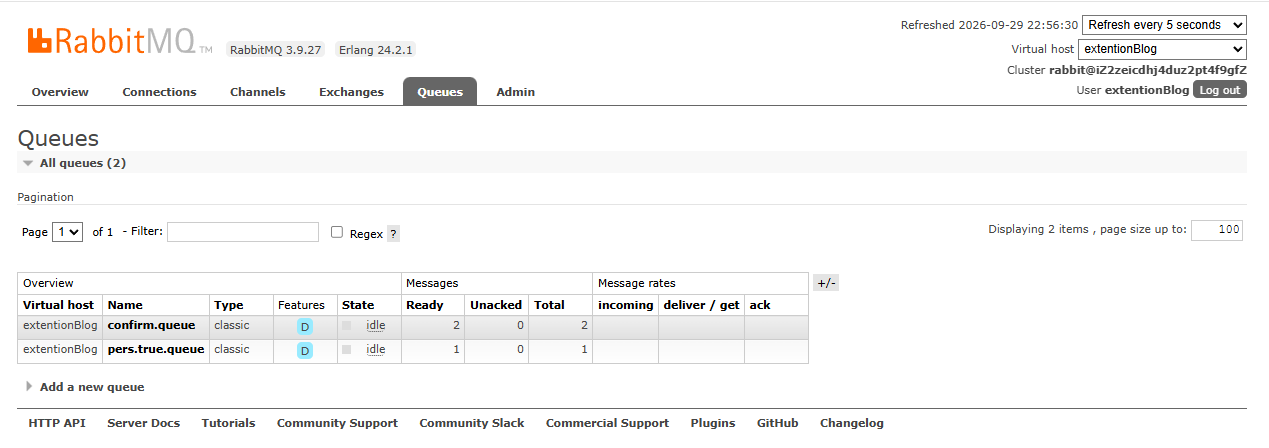
队列也没有了,消息也就没有了,是因为我们设置的队列是非持久化的
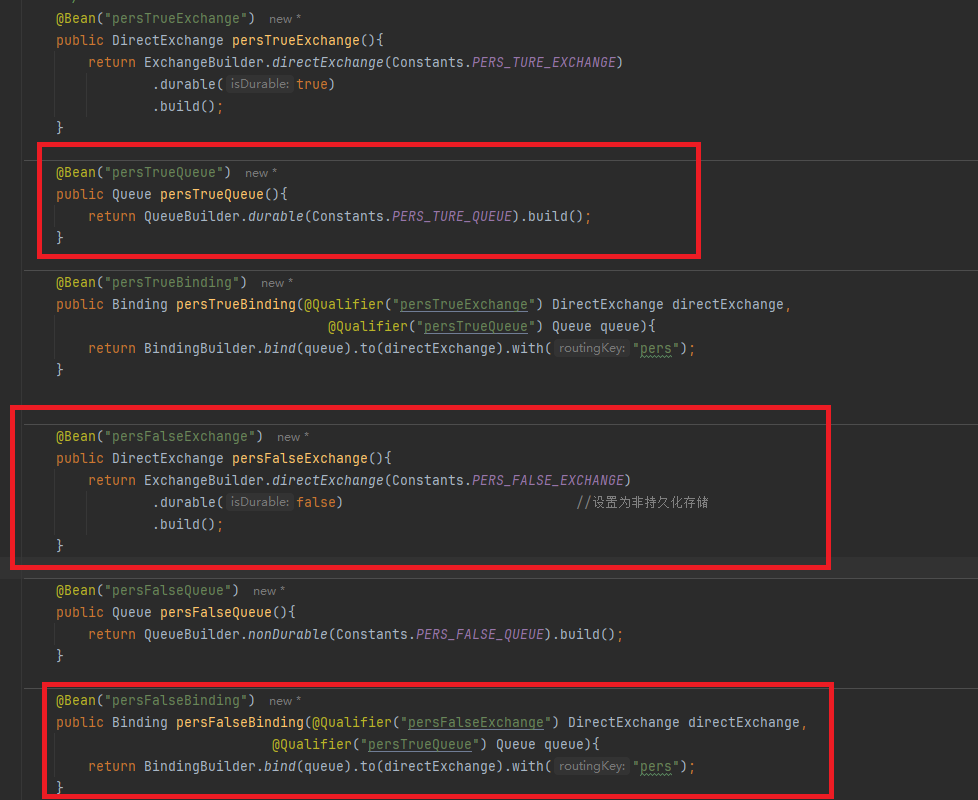
当我将交换机设置为非持久化,队列设置为持久化,再进行测试
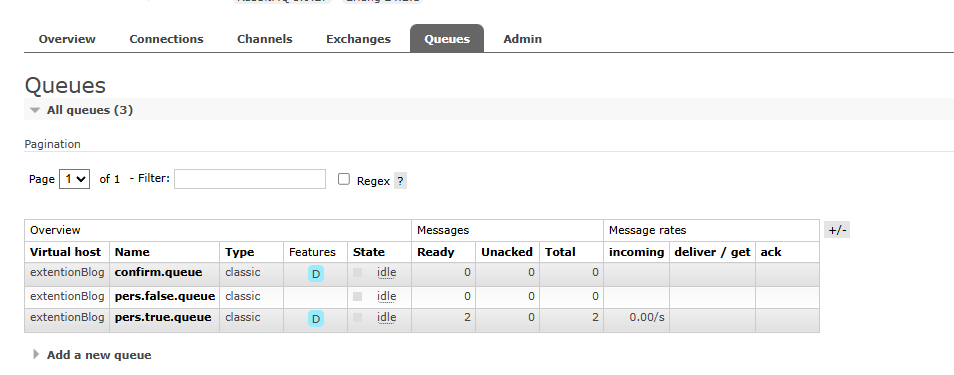
没重启化RabbitMQ之前,有两条数据
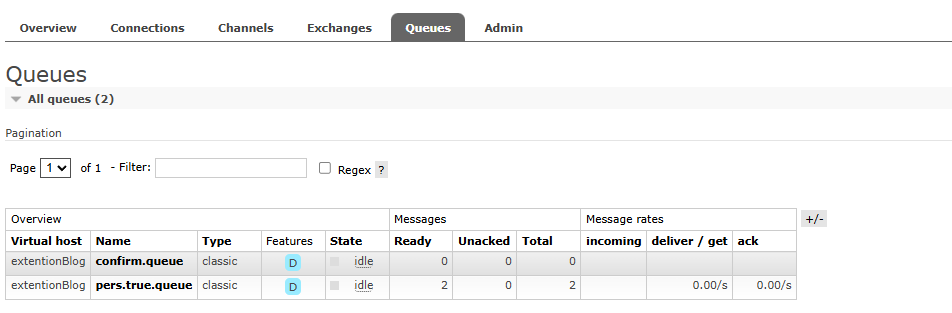
虽然重启之后还是两条数据
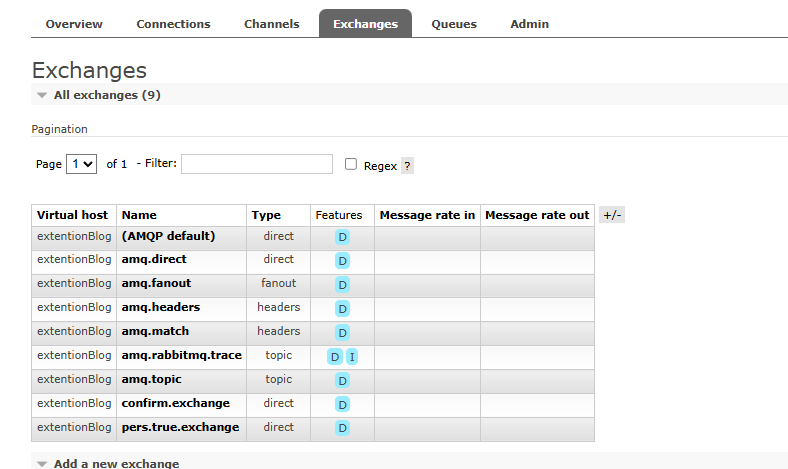
但是交换机不存在了
所以说:交换机持久化存储,消息不丢失;交换机非持久化存储,消息也不会丢失
(3).队列设置为持久化,消息设置为持久化,消息是否丢失
在进行上面的测试的时候,针对于"pers.true.queue"这个队列,队列是持久化存储的,消息也是持久化存储的,并且通过查看测试结果可以看到,消息也存储下来了,所以说,队列设置为持久化,消息设置为持久化,消息不会丢失
(4).队列设置为持久化,消息设置为非持久化,消息是否丢失
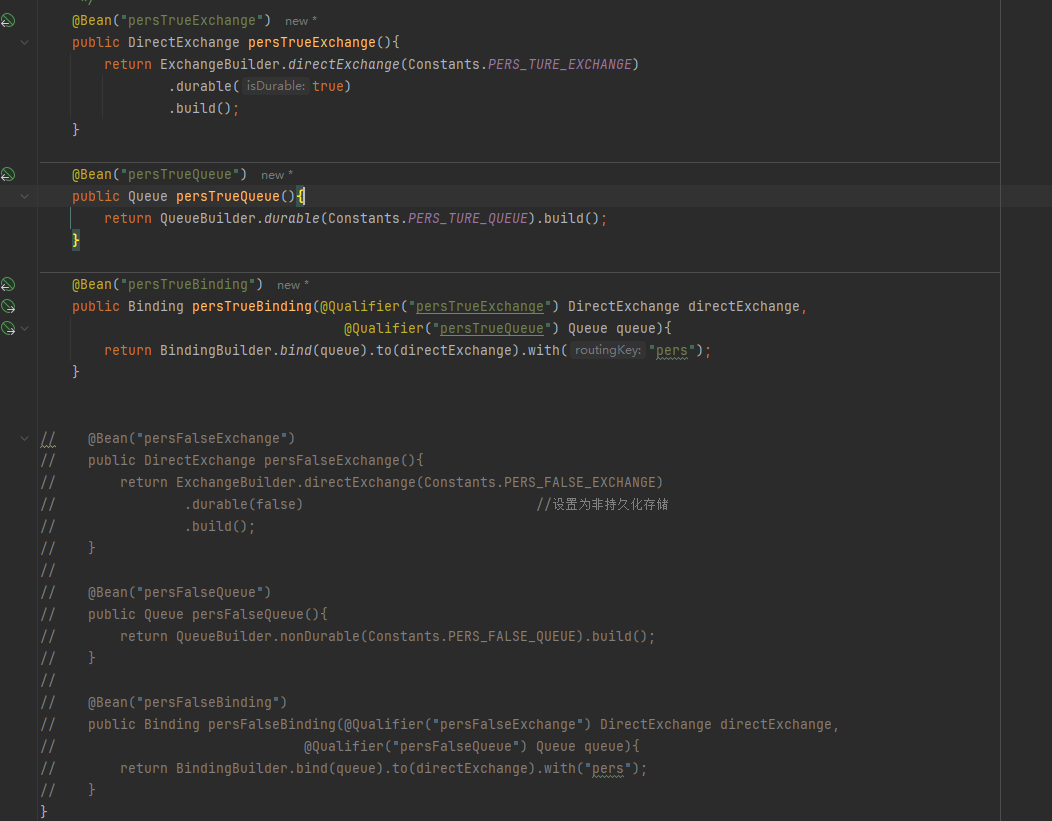
保留一个持久化的队列
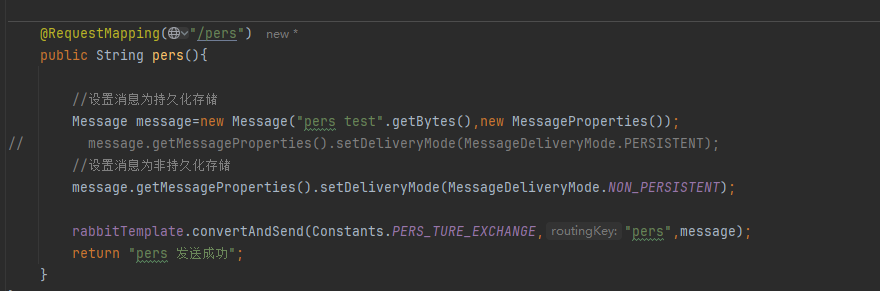
发送非持久化的消息
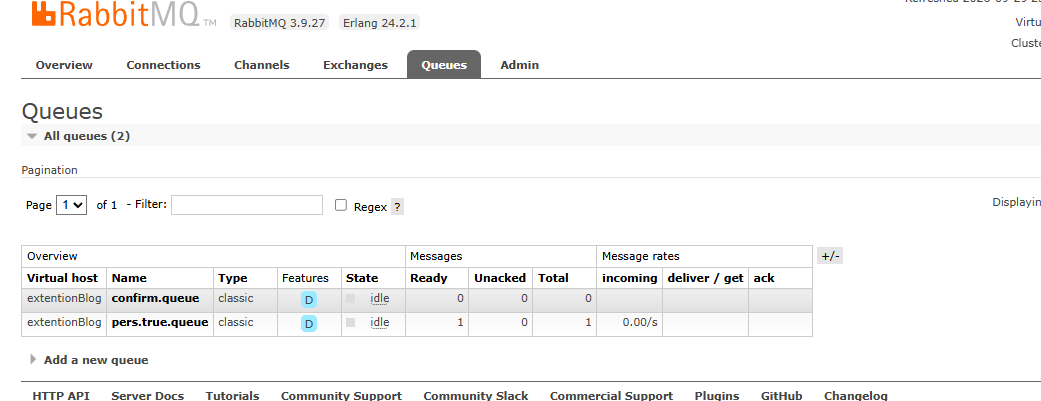
可以发现,已经有一条数据了
下面重启RabbitMQ服务
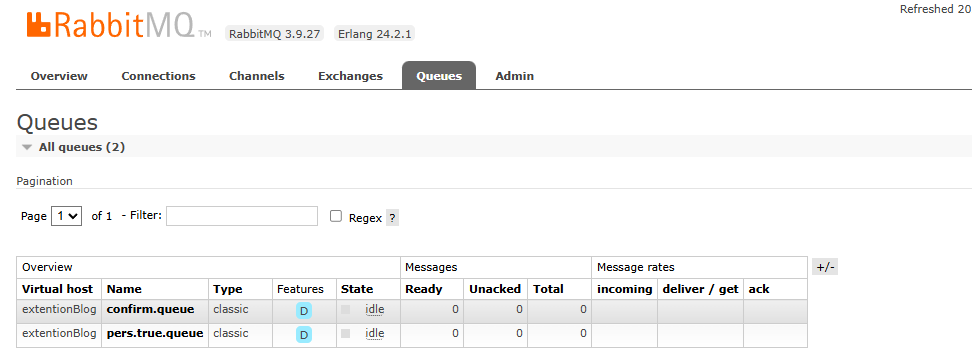
可以发现,消息已经丢失了
所以说:队列持久化,消息持久化,消息不丢失;队列持久化,消息非持久化,消息丢失
(5).队列设置为非持久化,消息设置为持久化和非持久化,消息是否丢失
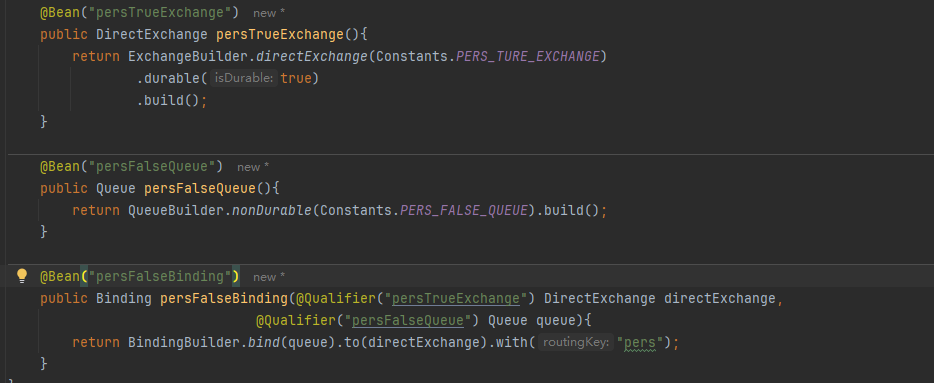
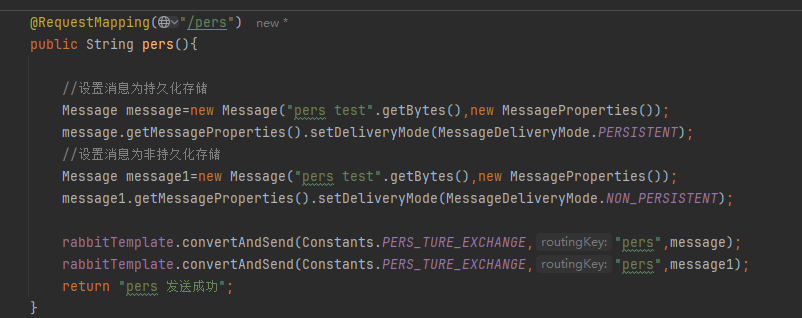
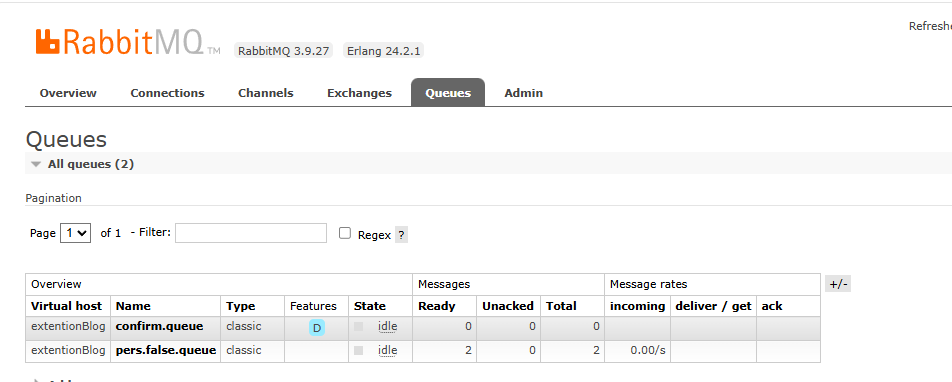
重启之前,可以发现,是两条消息
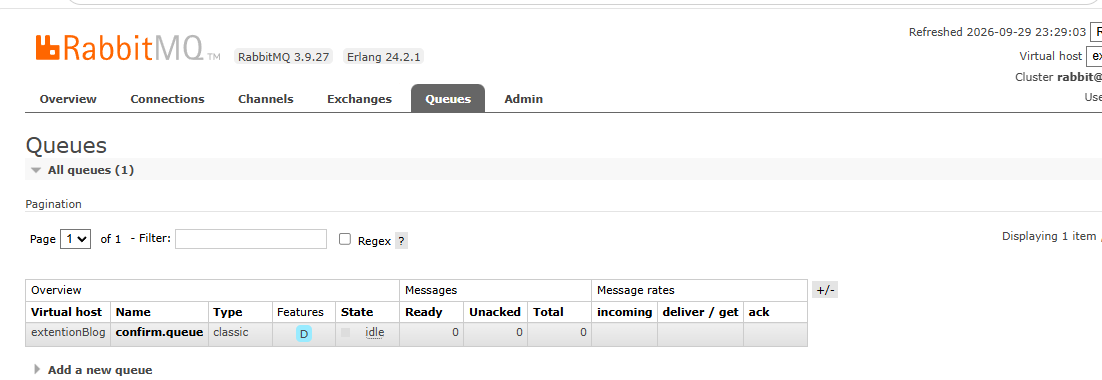
重启之后,发现队列没有了,那么对应的消息也就没有了
所以说:队列非持久化,消息持久化,消息丢失;队列非持久化,消息非持久化,消息丢失
(四).消息确认
1.消息确认机制
消息确认机制,指的是,当消息到达消费者之后,RabbitMQ就会把这条消息删除,但是消费者不一定能够正常处理消息,如果消费者没有正常处理消息,例如消费者挂了,同时,RabbitMQ已经把这条数据删除了,此时就会造成数据的丢失,消息确认机制就是用来解决上述问题的。
也就是说,消息确认机制,针对的是从队列到消费者这一阶段的消息可靠性传输。
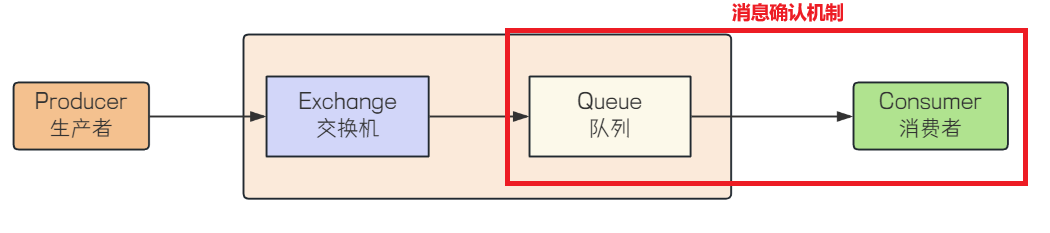
消息确认机制有两种:
一种是自动确认。当autoAck为true的时候,RabbitMQ会自动把发送出去的消息设置为确认,然后从内存中删除,不管消费者是否真正的消费到了消息。
一种是手动确认。当autoAck为false的时候,RabbitMQ会等待消费者显式地调用Basic.Ack命令,回复确认信号后才从内存中移除消息 。
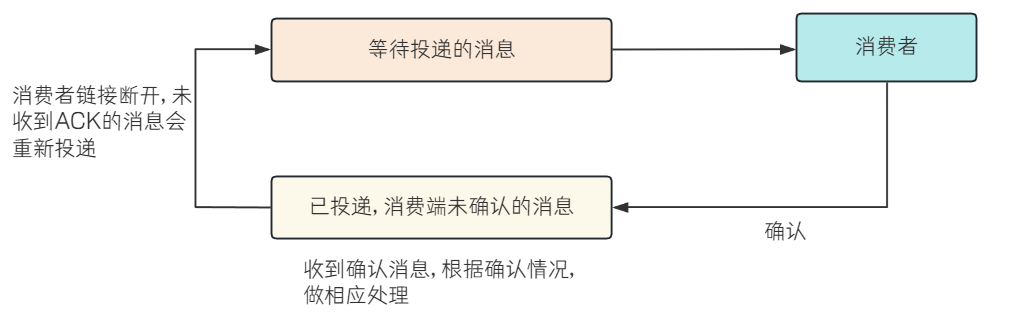
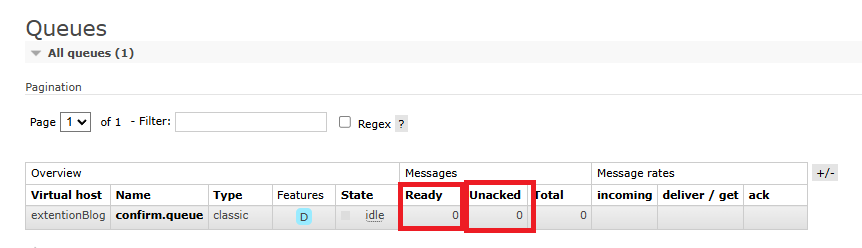
从Web管理平台上,也可以看到当前队列中Ready状态和Unacked状态的消息数
2.手动确认方法
RabbitMQ提供了不同的确认应答方式。消费者客户端可以调用与其对应的channel的相关方法。一共有三种
①.肯定确认:Channel.basicAck(long deliveryTag,boolean multiple)
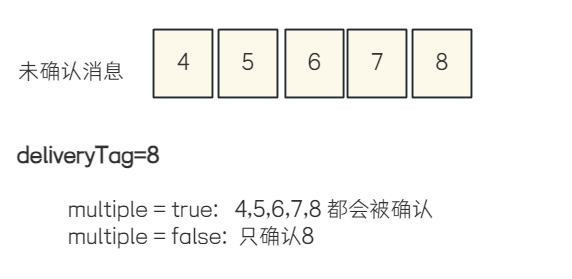
deliveryTag表示的是消息的唯一标识,他是一个单调递增的64位长整型。每个通道上的delivery是唯一的,当消费者确认一条消息时,必须使用对应的通道上进行确认。
multiple表示是否批量确认。
②.否定确认:Channel.basicReject(long deliveryTag , boolean requeue)
requeue表示的是,当消费者拒绝后,如果设置为true,则RabbitMQ会将这条消息重新入队;如果设置为false,则RabbitMQ会将消息从队列中移除。
③.否定确认:Channel.basicNack(long deliveryTag , boolean multiple , boolean requeue)
3.示例
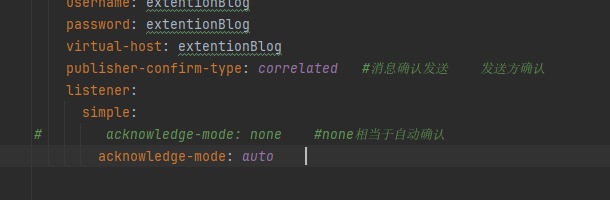
Spring AMQP对消息确认机制提供了三种策略:NONE MANUAL AUTO
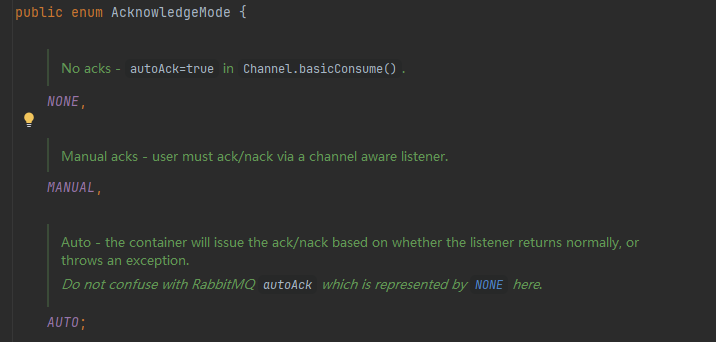
NONE:消息一旦发送给了消费者,无论消费者是否收到,RabbitMQ都会自动确认消息,乳沟消费者处理消息失败,则消息可能会丢失。
AUTO:是Spring AMQP的默认方式。消费者在消息处理成功后会自动确认消息,如果处理过程中出现了异常,则不会确认消息
MANUAL:手动确认模式下,必须成功处理消息后显示调用basicAck()方法来确认消息。如果消息未被确认,RabbitMQ会认为消息尚未被成功处理,并且会在消费者可用时重新投递该消息。
(1).NONE
Ⅰ.配置确认机制
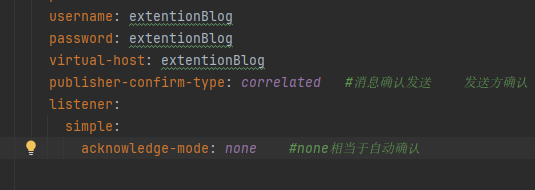
Ⅱ.生产者发送消息
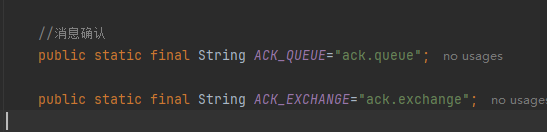
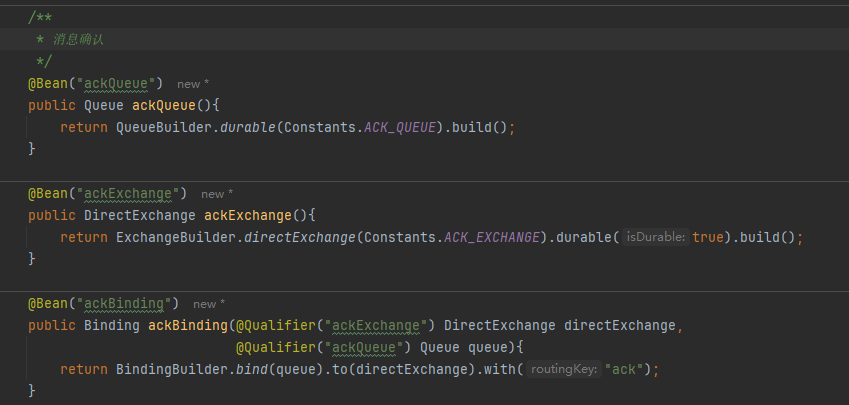
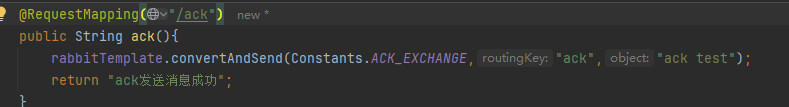
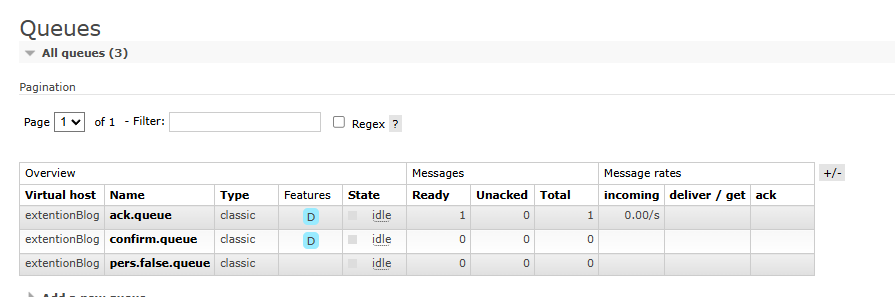
可以看到,能够正常发送消息
Ⅲ.消费者消费消息
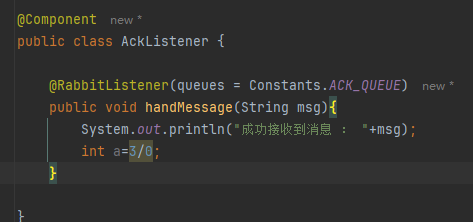
Ⅳ.测试代码
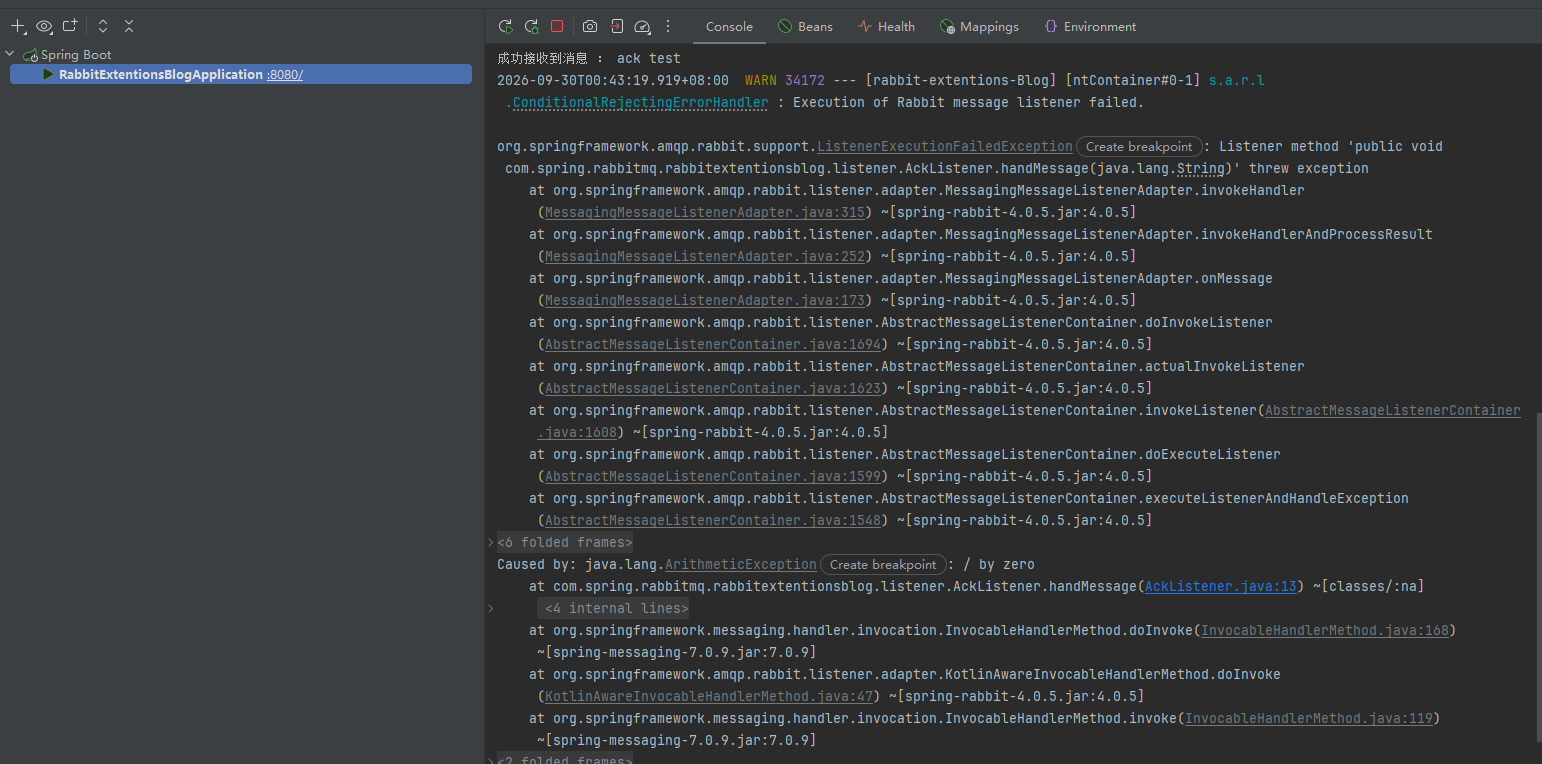
当运行起来的时候,发现,程序报错了
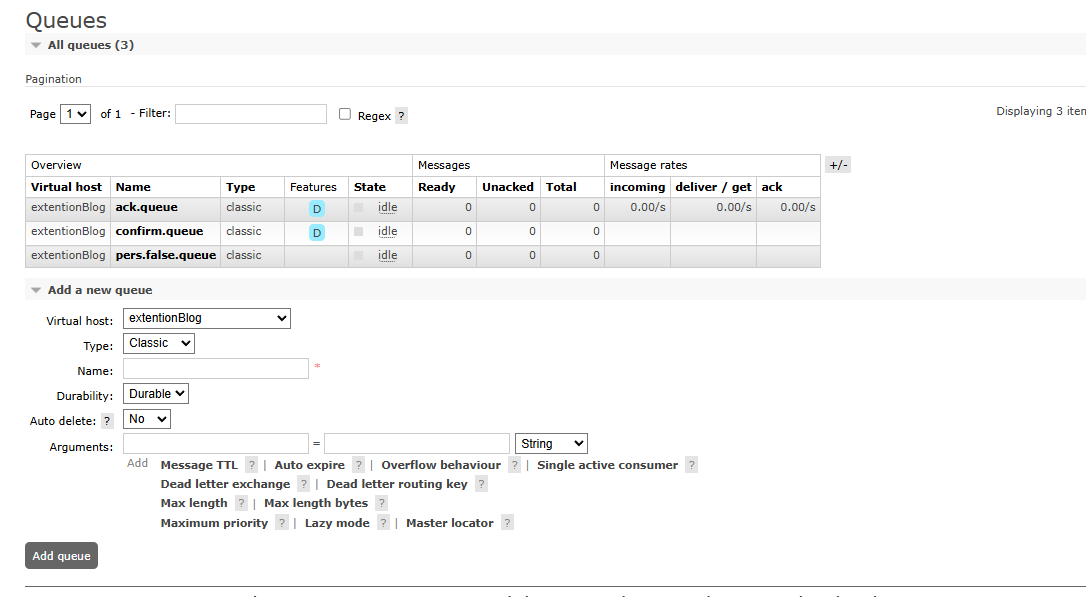
同时,消息已经被丢弃了
(2).AUTO
Ⅰ.配置确认机制
Ⅱ.生产者发送消息
可以看到,能够正常发送消息
Ⅲ.消费者消费消息
Ⅳ.测试代码
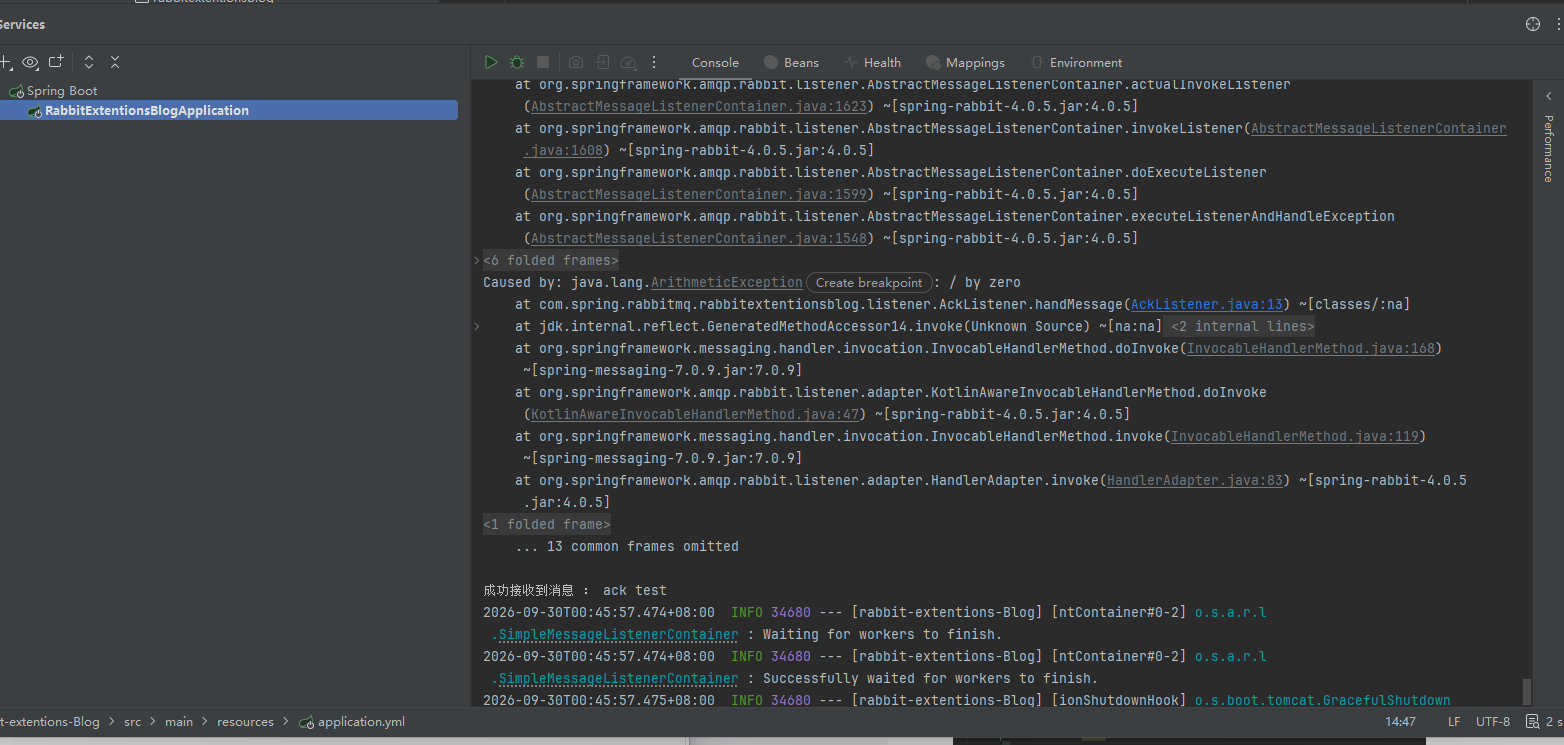
当我进行测试的时候,后端不断地打日志。这是因为,消费者没有确认消息
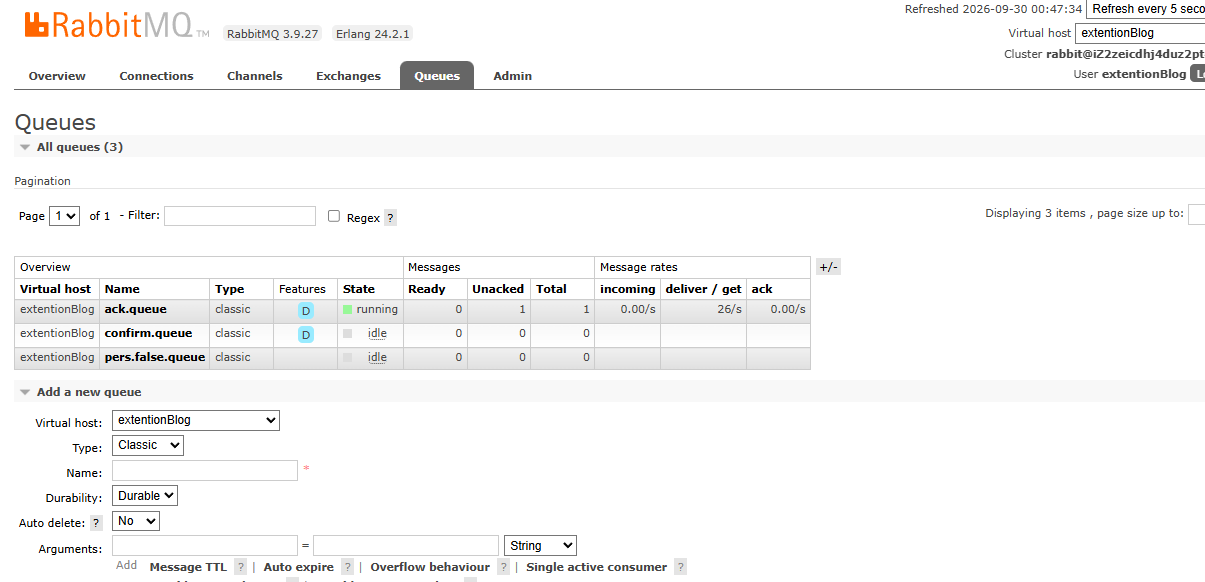
同时,可以看到,在队列中有一条Unacked的消息。
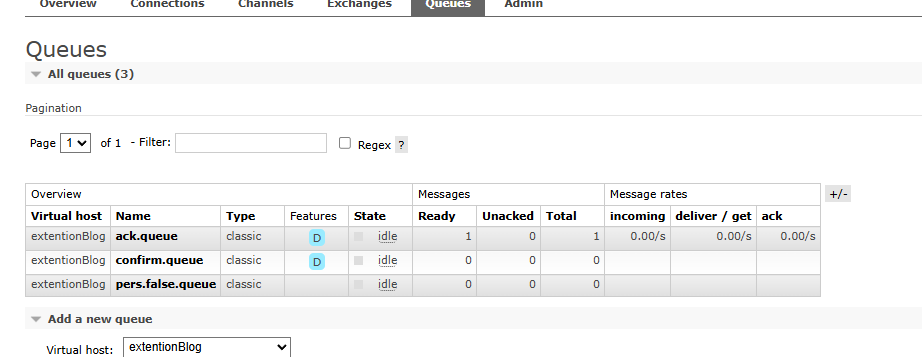
当我将后端日志停掉之后,发现这条消息又变成了Ready状态
(3).MANUAL
Ⅰ.配置确认机制
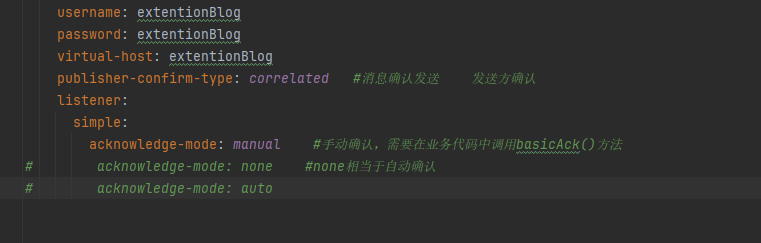
Ⅱ.生产者发送消息
可以看到,能够正常发送消息
Ⅲ.消费者消费消息
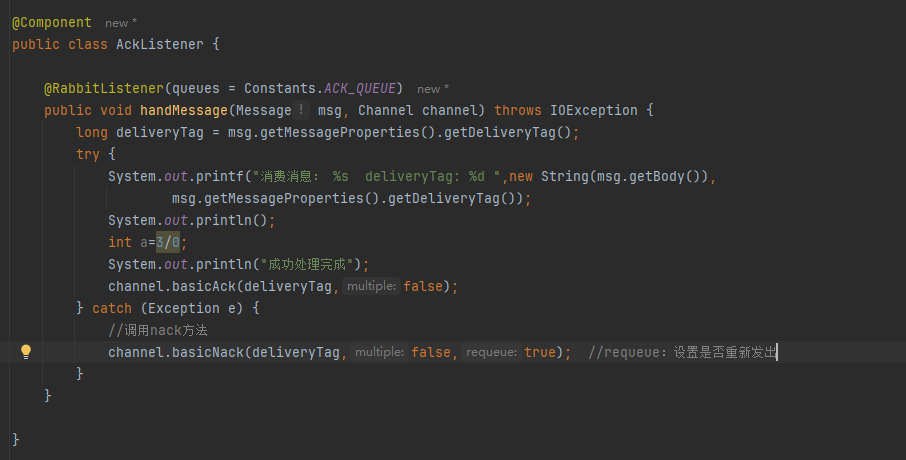
Ⅳ.代码测试
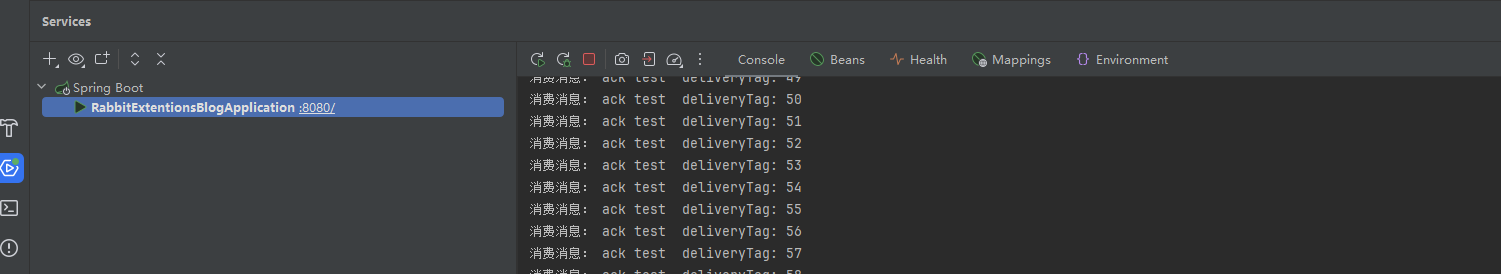
由于原本在队列中有一条消息,并且在处理消息的时候,代码中存在异常。所以,就会调用basicNack()方法,然后重新发出消息,所以后端一直在打日志
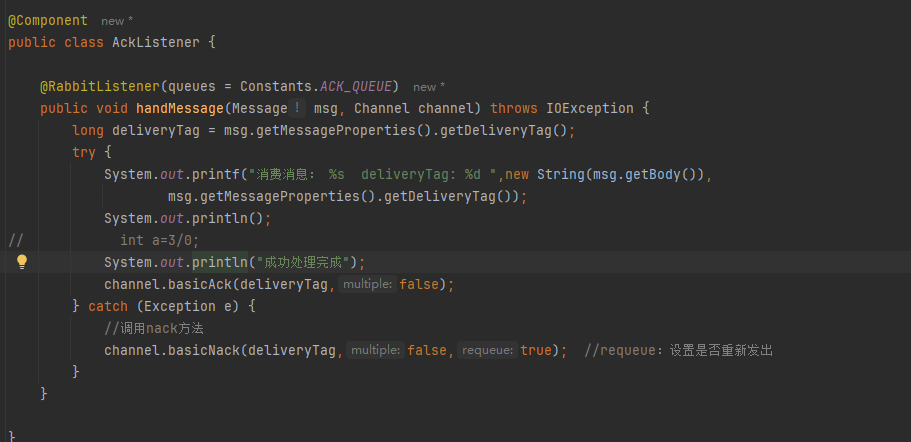
当我们将异常注释掉之后
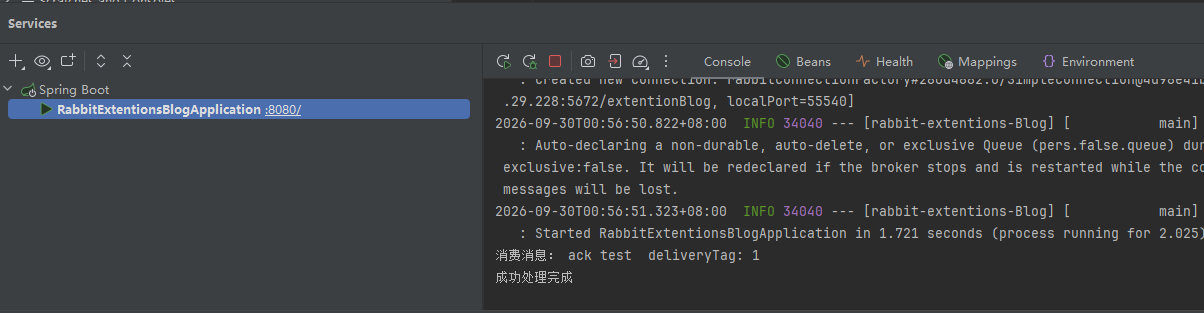
发现,已经成功处理完成了
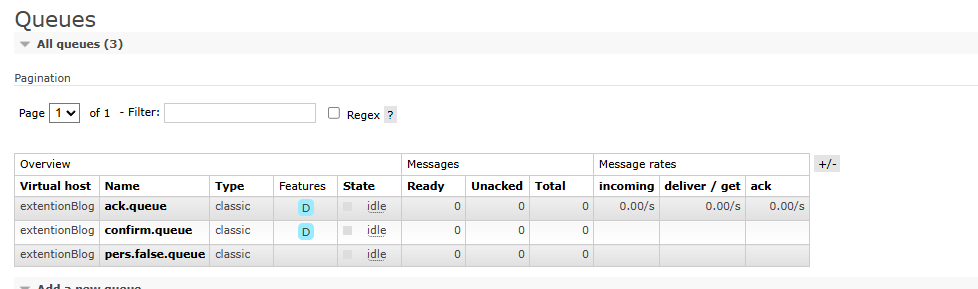
队列中也已经空了
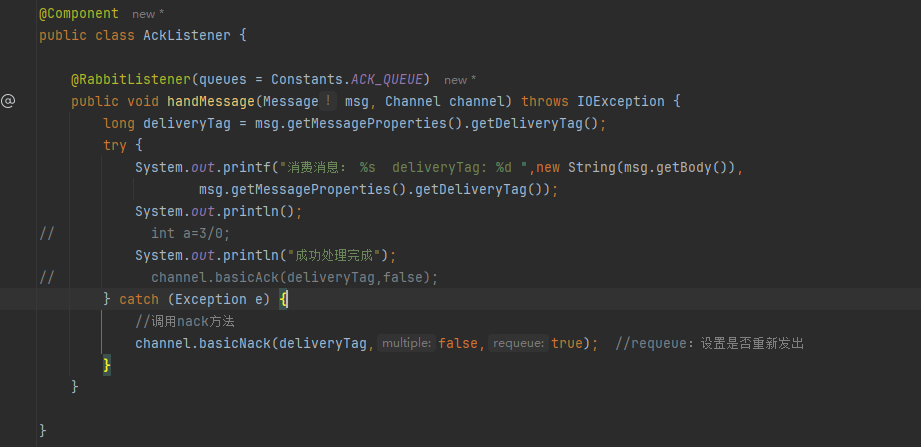
当我们将basicAck()方法注释掉之后,再重新发送消息
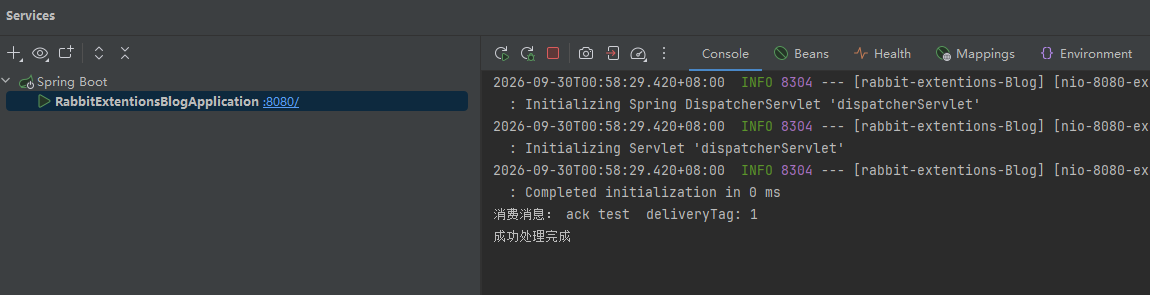
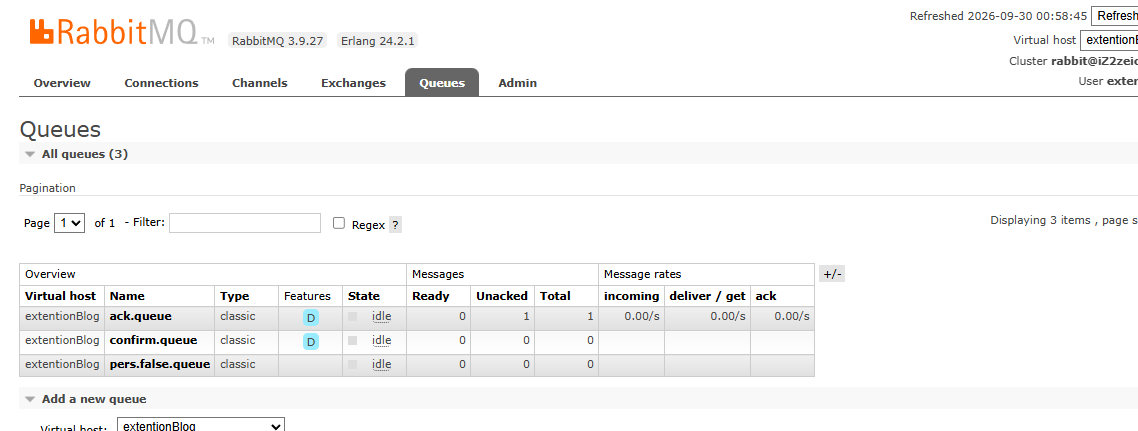
可以发现,这条消息也是一直没有被处理
(五).如何保证RabbitMQ消息的可靠性
1.如果是生产者将消息发送到RabbitMQ失败的话,我们可以采取"发送方确认的confirm模式",当MQ成功收到后会回调ack,如果失败则回调nack
2.如果是消息无法从交换机路由到指定队列,我们可以采取"发送方确认的return回调机制"
3.如果指定队列自身原因导致数据丢失,我们可以采取"持久化"的方式,开启队列持久化和消息持久化。如果消息过期,队列满,消息被拒绝,消息会变成死信转发到死信队列。
4.如果是消费者的原因导致消息丢失,我们可以采取"消息确认"的方式,默认情况下是自动应答的,我们可以开启"手动确认",当业务处理成功后,调用basicAck()方法,通知MQ删除消息。当异常的时候,可以调用basicNack()方法,让消息重返队列重试。重试的时候,我们可以限制重试次数,如果次数达到上限,则投递到死信队列。