摘要
国庆前社团让我做一张活动海报,正式文案还没定下来。我就先用代码画了一张练习图。上半截是红底黄字,下半截是一张白卡红字。我用自己写的网页小工具把它导出成 JPEG,放大一看红字边上裹着一圈发脏的粉边。质量从 0.80 调到 0.99 以后文件涨到了 2.25 倍。字边却几乎没变干净。这篇记下我一路查下去的过程。先弄清 RGB 怎么被拆成亮度和色度,再看 4:2:0 到底丢了什么。然后我用几十行 Python 自己复现了一遍,还读了 JPEG 文件头里的采样因子。后面几章讲黑字为什么没事,还有三个浏览器内核在质量填多少时才不抽样。最后讲这类海报该存成什么格式。
结论先放在这里。红字发糊的主因是色度抽样,质量参数只是次要的因素。Chromium 149 导出 JPEG 时质量要取整到 100 才会换成 4:4:4。Firefox 151 从 90 起就是 4:4:4。红字海报这种「几种纯色加文字」的图用 PNG 减色和 WebP 无损存最合适。它们的字边最干净,文件也比任何一档 JPEG 都小。这一条只对纯色平面图成立。换成网上带渐变插画的真实模板时,无损格式反倒比 JPEG 大 2.5 倍。非交 JPEG 不可的话就去服务端关掉色度抽样。质量 75 的 4:4:4 比浏览器 0.99 的 4:2:0 字边更干净,文件还小 37%。
版本声明
主体实测是 2026-09-29 跑的,四段代码和网上模板那组旁证是 2026-09-30 补跑的。机器是一台 16 GB 内存的 Apple M4 Mac,系统是 macOS 26.5.2。浏览器用了三个内核,分别是 Chromium 149(149.0.7827.55)、Firefox 151.0 和 WebKit 26.5。三个都是开源构建,不等于日常装的 Chrome、正式版 Firefox 和 Safari。文中凡是说到浏览器的结论都只对这三个构建成立。浏览器里导出一律走 canvas.toBlob。对照编码用的 Pillow 11.3 底下是可以指定抽样方式的 libjpeg-turbo。另外还用了 cwebp 1.6.0 和 macOS 自带的 sips,算误差用的是 numpy 2.0.2。文中的 KB 都按 1024 字节算,要紧的地方我会直接写字节数。
适用边界
样本只有两张,都是我用代码画的平面图。一张是 1600×900 的国庆促销风海报,另一张是 960×640 的颜色对照板。主体数据都出自这两张图。后来我又从网上找了一张现成的国庆放假通知模板做旁证,它的数字在文中单独写明。这篇的格式结论只管「纯色块加文字」这一类图。照片会不会一样我没测。浏览器的结论只管上面那三个开源构建,没在正式版 Safari 上验过。海报发到群里或者传到别的平台以后会不会被再压一遍也不在这篇里。我能确认的只是我自己导出的那个文件本身就已经糊了。
文章目录
一、红字压成JPEG为什么会发糊
- 1.1 社团海报的红字边上起了一圈毛
- 1.2 质量调到0.99红字还是糊
- 1.3 质量填到1.00字边变干净了
二、JPEG是怎么存颜色的
- 2.1 每个像素先拆成亮度和色度
- 2.2 大红色的亮度只有66
- 2.3 色度抽样让四个像素共用一份颜色
三、字边糊了多少该怎么量
- 3.1 色差只在字边那一圈算
- 3.2 色差大小用ΔE来表示
- 3.3 抽样方式要从文件头里读
四、怎么自己复现色度抽样
- 4.1 不压缩只砍色度红字也会花
- 4.2 浏览器导出的文件头就写着抽样方式
- 4.3 换抽样比调质量管用得多
五、为什么黑字没事红字糊
- 5.1 黑字白底只差亮度
- 5.2 亮度接近的颜色组合最糊
六、换个浏览器导出结果一样吗
- 6.1 Firefox从质量90起就不抽样
- 6.2 同样填0.9文件大小差出一半
七、红字海报最后该存成什么格式
- 7.1 纯色海报用无损格式更小
- 7.2 必须交JPEG时去服务端关掉抽样
- 7.3 我最后交给社团的是PNG
八、适用边界与风险
九、测量方法的坑
十、还没解决的
参考资料
一、红字压成JPEG为什么会发糊
1.1 社团海报的红字边上起了一圈毛
我在武汉读大四,平时在社团帮忙做宣传。去年做课设时我顺手写过一个网页小工具。填好标题和说明以后它就用 canvas 拼出一张海报再导出成 JPEG 发到群里。社团的海报一向发 JPG,大家转发也习惯了这个格式。今年国庆活动的海报又落到了我头上。正式文案还没定,我就先用 Python 的 Pillow 画了一张 1600×900 的练习图。版式是照着商场国庆促销海报排的。上半截是 120 px 的红底黄字大标题,下面跟着 40 px 和 24 px 的两行小字。下半截是一张白色圆角卡片,卡片上的红字从 72 px 到 32 px 再到 22 px 分了三档。红是 (215, 0, 15) 的大红,黄是 (255, 215, 0)。字体用的是系统自带的华文黑体。我还在每行红字下面放了一行同样内容、同样字号的黑字,本意是想比一比哪个颜色更醒目。没想到它后来成了整篇里最好用的对照组。文案是随手编的满减活动,和社团没关系。这张图存成 PNG 是 126 373 字节(123 KB),因为字边有抗锯齿一共数出来 746 种颜色。
我用小工具把它导出成 JPEG 发到群里。宣传部的学姐很快回了一句「红字边上怎么脏脏的」。我一开始以为是手机屏幕的问题,回宿舍在电脑上把图放大到六倍才看清楚是真的脏。每个红字的笔画外面都裹着一圈淡粉色的毛边。笔画本身也比原图暗了一点,像是红色里掺了一层灰。那行黑字放大看却和原图差不多,这一点我当时没在意。
1.2 质量调到0.99红字还是糊
小工具导出时调用的是 canvas.toBlob(callback, 'image/jpeg', 0.8)。我第一反应就是质量给低了,于是把 0.8 依次改成 0.9、0.95 和 0.99 各导出一张存下来。文件确实一次比一次大,从 120 501 字节涨到了 270 978 字节,是原来的 2.25 倍。可红字边上的那圈粉色毛边一直都在,肉眼看只是淡了一点点。后来我学会了怎么量(第三章讲),又回头补测了一遍。字边的平均色差在 0.80 时是 8.11,到 0.99 时只降到 6.35。花了两倍多的体积换回来的改善还不到四分之一。
练习图是我自己画的。我怕它太理想,又从网上找了一张现成的 2026 年国庆放假通知模板来试。那是稿定设计的一张 1242×2688 的模板图。上面有红底白字的标题、米白卡片上的红字和一排红字日历,还带渐变和插画。我在同一个 Chromium 里把它也从 0.80 导到 0.99。文件从 626 136 字节涨到 2 004 878 字节,是 3.2 倍。「假期安排」那几个红字的字边 ΔE 只从 6.56 降到 4.48。它和练习图是同一个方向。
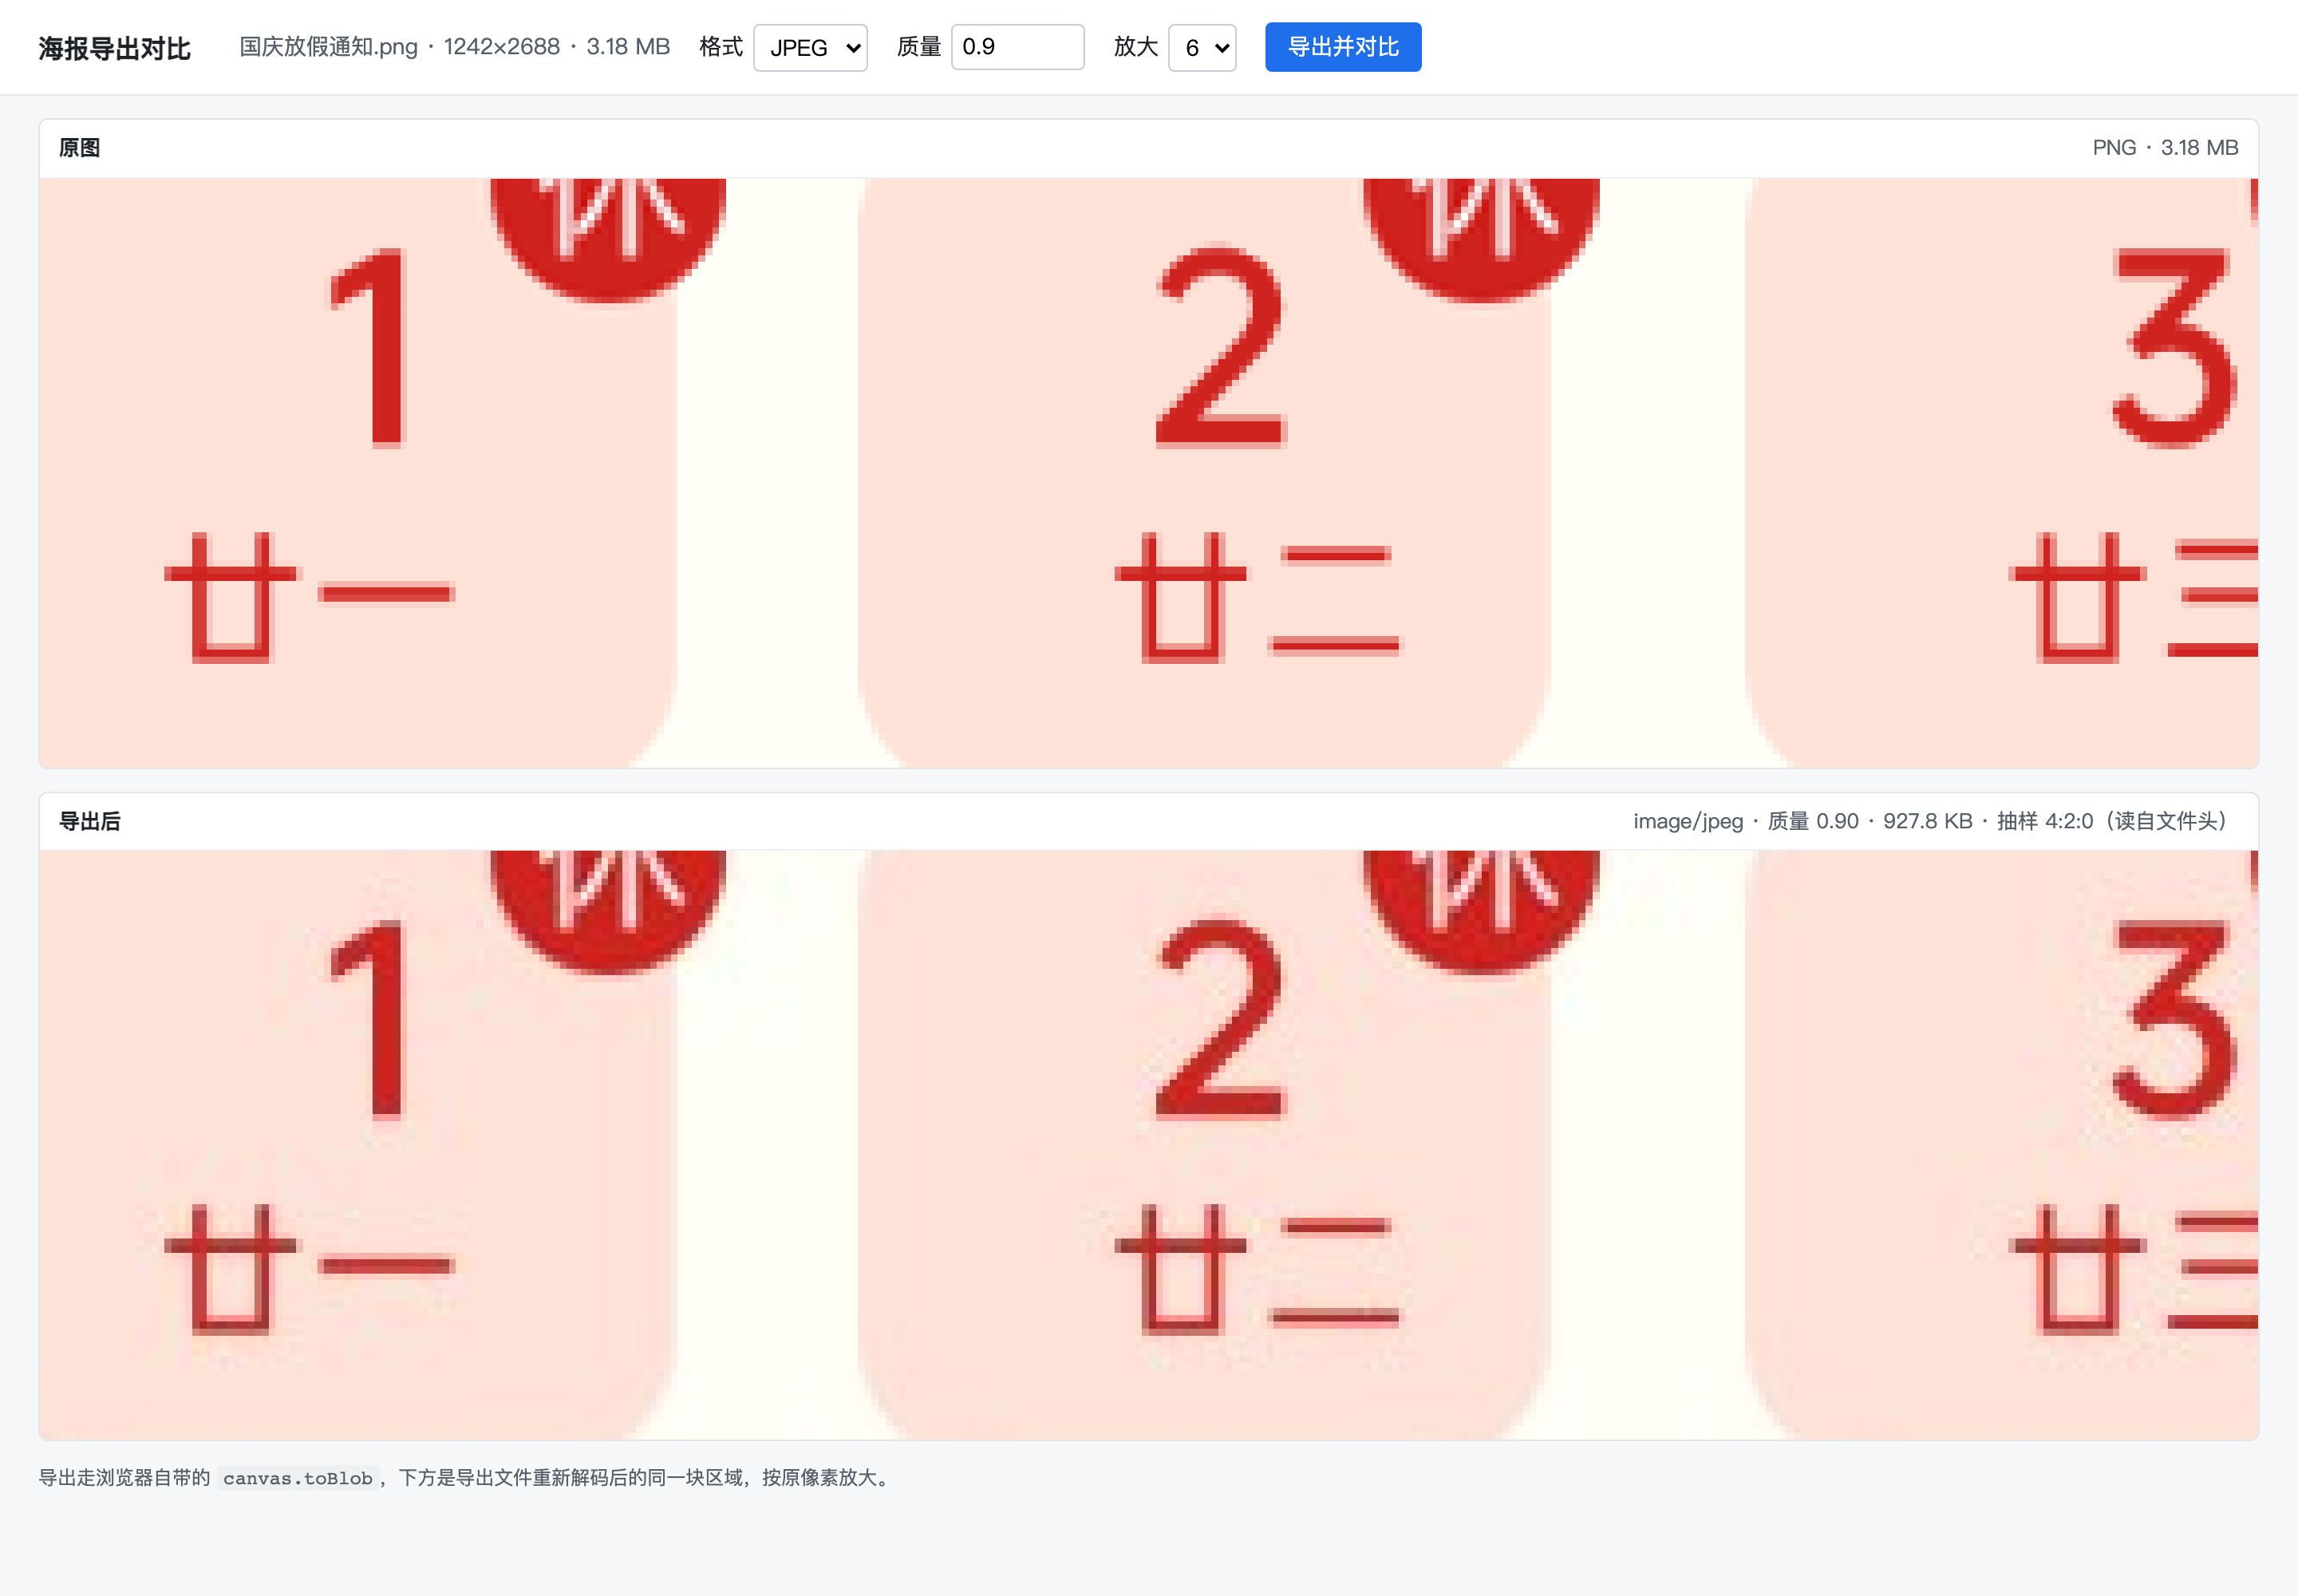
这是我写的一个导出对比小页面的整屏截图,喂进去的就是那张模板。页面上半是原图。下半是导出文件重新解码后的同一块区域。两块都按原像素放大了 6 倍,截的是日历里「1 廿一」「2 廿二」「3 廿三」那几格。下半右上角那行是页面自己从文件头里读出来的,写着 JPEG、质量 0.90、927.8 KB、抽样 4:2:0。要看的是下半那几个「廿一」「廿二」小字。它们的红色发暗发褐,笔画边上裹着一圈粉晕。上半原图里的同一批字是干净的正红。「1」「2」这种大数字差别就小得多,要细看才看得出边上有点毛。
1.3 质量填到1.00字边变干净了
最后我死马当活马医,把质量直接填成了 1.0。这回字边干净了,放大看和原图几乎没差。色差一下掉到了 0.19。代价是文件变成了 438 482 字节(428 KB)。这是原始 PNG 的 3.5 倍。一张本来 123 KB 的海报存成 JPEG 反倒大了两倍多,显然不是正常解法。那张网上的模板也是到 1.00 才一下掉到 0.22。那时文件是 3 643 511 字节,比它的原 PNG 还大。
真正让我起疑的是 0.99 和 1.00 之间那个断崖。从 0.80 调到 0.99 的过程中色差是慢慢往下降的,到了 1.00 它却一下从 6.35 掉到 0.19。质量参数要是连续起作用的就不该出现这种跳变,更像是到了某个点以后编码器换了一种完全不同的存法。我拿「JPEG 红色 边缘 模糊」去搜了好几页结果,最后是在一篇讲视频编码的博客里第一次看到「色度抽样」这个词。那篇写得很硬,我读了两遍也只看懂了一半。我干脆决定从头把 JPEG 怎么存颜色弄明白。
二、JPEG是怎么存颜色的
2.1 每个像素先拆成亮度和色度
平时我们说一个像素是红、绿、蓝各一个的 RGB 三个数。JPEG 存图之前会先换一种说法,把这三个数改写成一个亮度 Y 和两个色度 Cb、Cr。Y 表示这个点有多亮。Cb 大致表示它偏蓝还是偏黄,Cr 大致表示它偏红还是偏青。换算公式是 JFIF 规范里写死的。亮度那一条是 Y = 0.299R + 0.587G + 0.114B。另外两条算的是蓝色和红色分别比亮度多出多少,再加 128 挪到 0 到 255 的范围里。三个数换成另外三个数的过程中信息一点没少,它只是换了个角度描述同一个颜色。
换这个角度的理由在人眼上。我们的眼睛对明暗的细节很敏感,对颜色的细节要迟钝得多。一张图把颜色的分辨率降一半的话大多数人根本看不出来。要是把亮度降一半,马上就会觉得图糊了。亮度和色度分开存以后编码器就可以区别对待它们。亮度一个像素都不动,色度偷偷少存一些。这个思路据说最早来自彩色电视。当年为了兼容黑白电视机就把黑白信号单独拿出来,颜色另外叠上去。这段历史我没细查,只是觉得挺有意思。
2.2 大红色的亮度只有66
知道了这个拆法以后我第一件事就是看看海报里那几种颜色拆完是什么样。我把对照板上用到的 8 组字色和底色都按 JFIF 的公式算了一遍,顺便还算了字和底之间的亮度差和色度差。色度差就是把 Cb、Cr 两个差值当成直角三角形的两条直角边去算斜边长度。下面是代码一。
python
# 把对照板里 8 组颜色拆成亮度 Y 和两路色度 Cb/Cr(JPEG 用的 BT.601 全范围公式)
pairs = {
    '黑字白底': ((20, 20, 20), (255, 255, 255)),
    '红字白底': ((215, 0, 15), (255, 255, 255)),
    '黄字红底': ((255, 215, 0), (215, 0, 15)),
    '白字红底': ((255, 255, 255), (215, 0, 15)),
    '红字黑底': ((215, 0, 15), (20, 20, 20)),
    '蓝字白底': ((0, 70, 200), (255, 255, 255)),
    '红字深蓝底': ((215, 0, 15), (10, 30, 90)),
    '绿字红底': ((0, 150, 70), (215, 0, 15)),
}

def to_ycc(rgb):
    r, g, b = rgb
    y = 0.299 * r + 0.587 * g + 0.114 * b
    cb = 128 - 0.168736 * r - 0.331264 * g + 0.5 * b
    cr = 128 + 0.5 * r - 0.418688 * g - 0.081312 * b
    return y, cb, cr

for name, (fg, bg) in pairs.items():
    y1, cb1, cr1 = to_ycc(fg)
    y2, cb2, cr2 = to_ycc(bg)
    gap_y = abs(y1 - y2)
    gap_c = ((cb1 - cb2) ** 2 + (cr1 - cr2) ** 2) ** 0.5
print(f'{name:6} 字Y={y1:5.1f} 底Y={y2:5.1f} 亮度差={gap_y:5.1f} 色度差={gap_c:5.1f}')黑字白底 字Y= 20.0 底Y=255.0 亮度差=235.0 色度差= 0.0
红字白底 字Y= 66.0 底Y=255.0 亮度差=189.0 色度差=110.1
黄字红底 字Y=202.4 底Y= 66.0 亮度差=136.5 色度差=109.7
白字红底 字Y=255.0 底Y= 66.0 亮度差=189.0 色度差=110.1
红字黑底 字Y= 66.0 底Y= 20.0 亮度差= 46.0 色度差=110.1
蓝字白底 字Y= 63.9 底Y=255.0 亮度差=191.1 色度差= 89.3
红字深蓝底 字Y= 66.0 底Y= 30.9 亮度差= 35.1 色度差=136.2
绿字红底 字Y= 96.0 底Y= 66.0 亮度差= 30.0 色度差=175.3代码说明。这段没用任何库,就是把 JFIF 规范里的三组系数照抄了一遍。输出里最让我意外的是第二行。看上去那么扎眼的大红色亮度只有 66.0(满分 255)。在亮度这个通道里它其实比中灰还暗不少,红色显得醒目几乎全靠色度撑着。第一行里我用的黑 (20, 20, 20) 和白色的色度差是 0.0。灰阶颜色的 Cb、Cr 都正好是 128,黑字和白底的差别全都落在亮度上。最后三行是亮度差最小的三组,红字黑底、红字深蓝底、绿字红底分别只有 46.0、35.1 和 30.0。它们的色度差却都在 110 以上。这张表第五章还要再用一次。
2.3 色度抽样让四个像素共用一份颜色
拆成 Y、Cb、Cr 之后编码器对色度动的手就叫色度抽样,常见的写法有 4:4:4、4:2:2、4:2:0 三种。这串数字我第一次看完全不懂,后来画了个格子才弄明白。想象一块宽 4 个像素、高 2 行的小方格,第一个 4 是说每行有 4 个像素。第二个数是第一行里存了几份色度,第三个数是第二行又额外存了几份新的色度。4:4:4 就是每个像素都有自己的色度。4:2:2 是每行只存 2 份,横着每两个像素共用一份颜色。4:2:0 是第一行存 2 份、第二行不再存新的,这等于每个 2×2 的小方块只留一份 Cb 和一份 Cr。
算一下就知道它省在哪。4:4:4 每个像素要存 3 个数。4:2:0 的亮度照旧每个像素一个,两路色度都只剩四分之一。合起来是 1 + 0.25 + 0.25 = 1.5 个数,比原来少了一半。这一半在压缩之前就先扔掉了,后面怎么调质量都拿不回来。解码时解码器再把这一份色度摊回那四个像素上。
问题就出在字的边缘。我们假设一个 2×2 小方块正好骑在红色笔画和白色背景的交界上。左边两个像素是红,右边两个是白。4:2:0 只给这四个像素留一份色度。这份色度只能是红和白平均出来的淡粉红。解码时四个像素都拿到这份粉红的色度再和各自原本的亮度拼回去。原本是白的那两个像素多了一点粉,原本是红的那两个像素色度被冲淡了。再配上只有 66 的亮度,看起来就成了暗红偏灰。这正好对上我在放大图里看到的样子。笔画外面一圈淡粉,笔画本身发暗。黑字不会这样是因为黑和白的色度本来就一样,平均完还是一样的,丢了也等于没丢。
到这里我大概猜到了那个断崖是什么。只要是 4:2:0,这圈晕在编码最开始就注定了。质量调多高也只是把后面的量化误差压小。到了 1.00,编码器可能换成了 4:4:4,晕才一下消失。这还只是猜测。要验证它得有两样东西。一是能把「糊了多少」量成一个数,二是能从文件里看出它到底用了哪种抽样。
三、字边糊了多少该怎么量
3.1 色差只在字边那一圈算
我一开始用的是整张图只算一个数的 PSNR,结果发现它很不灵敏。海报大部分面积是纯红底和纯白卡。这些地方怎么压都几乎不出错。整图一平均字边那点问题就被稀释了,人眼看着很扎眼的毛边在整图平均里占不了多少分量。
后来我换成只看字边附近。做法是先在原图上找出「边」。相邻两个像素的 RGB 三个差值加起来超过 30 就算这里有一条边。再把这些位置向外扩 2 个像素,就得到一条围着每个字的窄带。后面所有误差都只在这条窄带里算。对照板上的格子挨得很近。为了不把两格之间的交界算进去,我让每一格往里缩了 3 个像素再取窄带。这样量出来的数才和眼睛看到的对得上。质量 0.80 时字边窄带里的 PSNR 是 23.52,到 1.00 时是 54.20。
3.2 色差大小用ΔE来表示
PSNR 是按 RGB 数值差算的。可同样差 10 的数值落在不同颜色上人眼的感受差别很大。我又加了一个更贴近人眼的指标,叫色差 ΔE。做法是把原图和解码后的图都从 sRGB 转到 Lab 颜色空间,再对每个像素算两个 Lab 点之间的直线距离。这个版本叫 CIE76。Lab 空间的设计初衷就是让数值距离尽量接近看上去差多少。
ΔE 多大算能看出来并没有硬标准。一般认为 1 以下肉眼很难分辨,2 到 3 是凑近细看能看出来,5 以上就是一眼可见的色边。这是业内常用的经验分档,不是我实测出来的。海报在质量 0.80 时字边 ΔE 均值是 8.11,到 0.99 还有 6.35。两个都在一眼可见那一档,和学姐一眼就看出来对得上。平均值之外我还看了最差那 5% 像素的 P95。0.80 和 0.99 分别是 27.42 和 24.60,几乎没动。字边最脏的那一小撮像素调质量基本管不到。
3.3 抽样方式要从文件头里读
光看色差还不能断定用的是哪种抽样,还得去文件里找证据。JPEG 文件是一段一段组织的。每段以一个 0xFF 字节开头,后面再跟一个字节标明这是什么段。其中 SOF 段(Start Of Frame,基线编码是 0xFFC0)写着图片的宽高和每个颜色分量的参数。每个分量占 3 个字节。第一个是分量编号。第二个字节的高 4 位和低 4 位分别是水平和垂直的采样因子。第三个是它用哪张量化表。
采样因子是相对的。比如 Y 写 2×2、Cb 和 Cr 都写 1×1 的意思是每 2×2 个亮度样本才对应一个色度样本,也就是 4:2:0。三个分量都是 1×1 就是 4:4:4。Y 是 2×1、色度是 1×1 则是 4:2:2。我后来养成了一个习惯。凡是看到「这张 JPEG 是 4:2:0」这类说法,我都先读文件头确认,不靠文件大小或画质去猜。第九章会讲到看画质猜是会猜错的。
四、怎么自己复现色度抽样
4.1 不压缩只砍色度红字也会花
我想先排除一个干扰。JPEG 除了抽样还有 DCT 和量化,那圈晕会不会其实是量化造成的?最直接的办法是绕开 JPEG 只做抽样这一步。我把对照板转成 Y、Cb、Cr,两路色度每 2×2 取个平均再原样铺回去,然后转回 RGB。整个过程既不做量化也不存成任何文件。要是红字还是花了,那就只能怪抽样本身。这就是代码二。
python
# 不做任何量化,只把色度横竖各砍一半再放回去,看字边会差多少
import json
import numpy as np
from PIL import Image

board = np.asarray(Image.open('pairs_960x640.png').convert('RGB')).astype(np.float64)
cells = json.load(open('pairs_boxes.json'))['pairs']

def rgb2ycc(a):
    r, g, b = a[..., 0], a[..., 1], a[..., 2]
    y = 0.299 * r + 0.587 * g + 0.114 * b
    cb = 128 - 0.168736 * r - 0.331264 * g + 0.5 * b
    cr = 128 + 0.5 * r - 0.418688 * g - 0.081312 * b
    return y, cb, cr

def ycc2rgb(y, cb, cr):
    r = y + 1.402 * (cr - 128)
    g = y - 0.344136 * (cb - 128) - 0.714136 * (cr - 128)
    b = y + 1.772 * (cb - 128)
    return np.clip(np.stack([r, g, b], -1).round(), 0, 255)

def squeeze_chroma(c):
    h, w = c.shape
    small = c.reshape(h // 2, 2, w // 2, 2).mean(axis=(1, 3))   # 每 2×2 只留一个平均值
    return small.repeat(2, axis=0).repeat(2, axis=1)            # 再原样铺回 2×2

def to_lab(a):
    c = a / 255.0
    c = np.where(c <= 0.04045, c / 12.92, ((c + 0.055) / 1.055) ** 2.4)
    m = np.array([[0.4124, 0.3576, 0.1805], [0.2126, 0.7152, 0.0722], [0.0193, 0.1192, 0.9505]])
    xyz = np.einsum("...k,jk->...j", c, m) / np.array([0.95047, 1.0, 1.08883])
    f = np.where(xyz > 0.008856, np.cbrt(xyz), 7.787 * xyz + 16 / 116)
    return np.stack([116 * f[..., 1] - 16, 500 * (f[..., 0] - f[..., 1]), 200 * (f[..., 1] - f[..., 2])], -1)

def near_edge(a, grow=2):
    hit = np.zeros(a.shape[:2], bool)
    hit[:, 1:] |= np.abs(a[:, 1:] - a[:, :-1]).sum(-1) > 30
    hit[1:, :] |= np.abs(a[1:, :] - a[:-1, :]).sum(-1) > 30
    band = hit.copy()
    for dy in range(-grow, grow + 1):
        for dx in range(-grow, grow + 1):
            band |= np.roll(np.roll(hit, dy, 0), dx, 1)
    return band

if __name__ == '__main__':
    y, cb, cr = rgb2ycc(board)
    only_444 = ycc2rgb(y, cb, cr)                                   # 只转一圈颜色空间
    fake_420 = ycc2rgb(y, squeeze_chroma(cb), squeeze_chroma(cr))   # 转一圈 + 砍色度
    band = near_edge(board)
    lab0 = to_lab(board)
    for label, out in (('只转换', only_444), ('砍色度', fake_420)):
        de = np.sqrt(((to_lab(out) - lab0) ** 2).sum(-1))
        row = []
        for name, (x0, y0, x1, y1) in cells.items():
            m = np.zeros_like(band); m[y0 + 3:y1 - 3, x0 + 3:x1 - 3] = band[y0 + 3:y1 - 3, x0 + 3:x1 - 3]
            row.append(f'{name} {de[m].mean():.2f}')
print(label, ' | '.join(row))只转换 黑字白底 0.00 | 红字白底 0.00 | 黄字红底 0.00 | 白字红底 0.00 | 红字黑底 0.00 | 蓝字白底 0.00 | 红字深蓝底 0.00 | 绿字红底 0.00
砍色度 黑字白底 0.00 | 红字白底 7.47 | 黄字红底 7.45 | 白字红底 7.50 | 红字黑底 11.49 | 蓝字白底 6.41 | 红字深蓝底 13.57 | 绿字红底 16.12代码说明 。整段的核心是只有两行的 squeeze_chroma。第一行用 reshape 把图切成一个个 2×2 小块取平均,第二行用 repeat 把每个平均值原样复制回四个位置。真正的编码器缩放色度的方法更讲究。我这里用的是最粗暴的办法,好处是一眼就能看懂。to_lab 和 near_edge 就是第三章说的 Lab 转换和字边窄带,第七章的代码还会接着用它们。输出第一行是只把颜色空间来回转一圈的对照组。8 格的字边色差全是 0.00,说明转换本身不丢东西。第二行只多了砍色度这一步。黑字白底仍然是 0.00,其余 7 格全花了。红字白底 7.47、绿字红底 16.12。
这个结果让我确定了一件事。那圈晕在量化之前就已经注定了。浏览器质量 0.9 导出的真 JPEG 里,红字白底是 10.23。比我这里的 7.47 多出来的那一截才归量化和编码器细节管,大头在抽样。
4.2 浏览器导出的文件头就写着抽样方式
接下来要验证「浏览器导出的 JPEG 就是 4:2:0」。我按第三章的格式写了一个读 SOF 段的小函数去读两类文件。一类是我用 Pillow 指定抽样方式存的文件,当作已知答案。另一类是浏览器在 0.99 和 1.00 两档导出的海报。这段是代码三。
python
# 读 JPEG 文件头 SOF 段里每个分量的采样因子,不靠猜
import os, struct
from PIL import Image

def sampling_of(path):
    data = open(path, 'rb').read()
    pos = 2                                   # 跳过开头的 FFD8
    while pos < len(data) - 4:
        if data[pos] != 0xFF:
            pos += 1
            continue
        marker = data[pos + 1]
        seg_len = struct.unpack('>H', data[pos + 2:pos + 4])[0]
        if marker in (0xC0, 0xC1, 0xC2):      # 基线 / 扩展 / 渐进三种 SOF
            count = data[pos + 9]
            factors = []
            for k in range(count):
                hv = data[pos + 11 + 3 * k]
                factors.append(f'{hv >> 4}x{hv & 0x0F}')
            return factors
        pos += 2 + seg_len
    return None

poster = Image.open('poster_1600x900.png').convert('RGB')
for tag, sub in (('420', 2), ('444', 0)):
    dst = f'poster_q90_{tag}.jpg'
    poster.save(dst, 'JPEG', quality=90, subsampling=sub)
    print(dst, os.path.getsize(dst), 'B', sampling_of(dst))

for q in ('0.99', '1.00'):
    src = f'browser_q{q}.jpg'
print('浏览器', q, os.path.getsize(src), 'B', sampling_of(src))poster_q90_420.jpg 173026 B ['2x2', '1x1', '1x1']
poster_q90_444.jpg 246096 B ['1x1', '1x1', '1x1']
浏览器 0.99 270978 B ['2x2', '1x1', '1x1']
浏览器 1.00 438482 B ['1x1', '1x1', '1x1']代码说明 。sampling_of 从第 3 个字节开始一段一段往后跳。每段开头两字节是标记,接着两字节是段长。碰到 SOF 就停下来读分量信息,分量个数在段首往后第 9 个字节。每个分量的采样因子在分量编号后面那个字节里。高 4 位是水平,低 4 位是垂直。Pillow 的 subsampling 参数填 2 是 4:2:0,填 0 是 4:4:4。这两个文件读出来分别是 2x2 和 1x1,说明函数读对了。后两行里浏览器 0.99 导出的海报写着 Y 是 2x2,就是 4:2:0。到了 1.00,三个分量全是 1x1,换成了 4:4:4。第一章那个断崖就是这么来的。0.99 到 1.00 之间编码器换了抽样方式。
写代码二时我还踩过一个和抽样无关的小坑。Lab 转换那一步我一开始用的是矩阵乘法 c @ m.T。在这台机器上跑的时候 numpy 报了一串除零和溢出的警告,算出来的数却是对的。我没查明白是哪一层出的问题,就换成了 einsum,之后警告没了、数字一位也没变。
4.3 换抽样比调质量管用得多
既然 Pillow 能指定抽样方式,我就把质量和抽样拆开来测。同一张海报在三个质量档各存三种抽样,一共 9 个文件。我逐个量了字边色差。
| 质量 | 4:2:0 字节 / ΔE | 4:2:2 字节 / ΔE | 4:4:4 字节 / ΔE |
|---|---|---|---|
| 75 | 120 513 / 8.64 | 137 543 / 6.27 | 169 640 / 4.47 |
| 90 | 173 026 / 7.11 | 198 266 / 4.46 | 246 096 / 2.31 |
| 95 | 221 333 / 6.66 | 253 455 / 3.80 | 315 356 / 1.31 |
这张表横着读和竖着读是两种感觉。竖着读是调质量,4:2:0 那一列从 75 到 95 时 ΔE 只从 8.64 降到 6.66。横着读是换抽样,同样是质量 90 的时候 4:2:0 是 7.11,4:4:4 就到了 2.31。换抽样的效果比调质量大得多。代价也很清楚,同样质量下 4:4:4 比 4:2:0 大 41% 到 42%。质量 75 时是 41%、90 和 95 都是 42%。
最让我觉得这一路没白查的是质量 75 那一行。质量 75 的 4:4:4 是 169 640 字节,字边 ΔE 4.47。浏览器质量 0.99 的 4:2:0 是 270 978 字节,ΔE 6.35。前者字边更干净,文件还小了 37%。换成那张网上的模板也一样。质量 75 的 4:4:4 是 680 616 字节、ΔE 4.29。浏览器 0.99 的 4:2:0 是 2 004 878 字节、ΔE 4.48。前者更干净,体积大约只有后者的三分之一。我之前拼命往上调质量的方向就是错的。
五、为什么黑字没事红字糊
5.1 黑字白底只差亮度
海报上那行黑字放大后和原图差不多,这件事现在可以解释了。为了看得更清楚我又画了一块对照板。它是 960×640 的,分成 8 格,每格 480×160。每格都写同一行 40 px 的字和一行 22 px 的小字,只换字色和底色。我用浏览器质量 0.9 导出以后逐格量了字边色差。黑字白底只有 0.77。代码一已经算过,(20, 20, 20) 的黑和白色色度差是 0.0。两者的差别全在亮度上,亮度通道从来不抽样。每个像素的亮度都保留着,字的轮廓就一点没损失。这 0.77 是量化带来的,代码二里只砍色度时它是 0.00。同一块板上的红字白底是 10.23,是黑字白底的 13 倍。
5.2 亮度接近的颜色组合最糊
对照板上最糊的其实不是红字白底,排在最前面的三格是绿字红底 18.96、红字深蓝底 17.41、红字黑底 16.12。这三组有个共同点。回去看代码一的输出,它们的亮度差是 8 组里最小的三个,分别只有 30.0、35.1 和 46.0。它们的色度差却都很大。
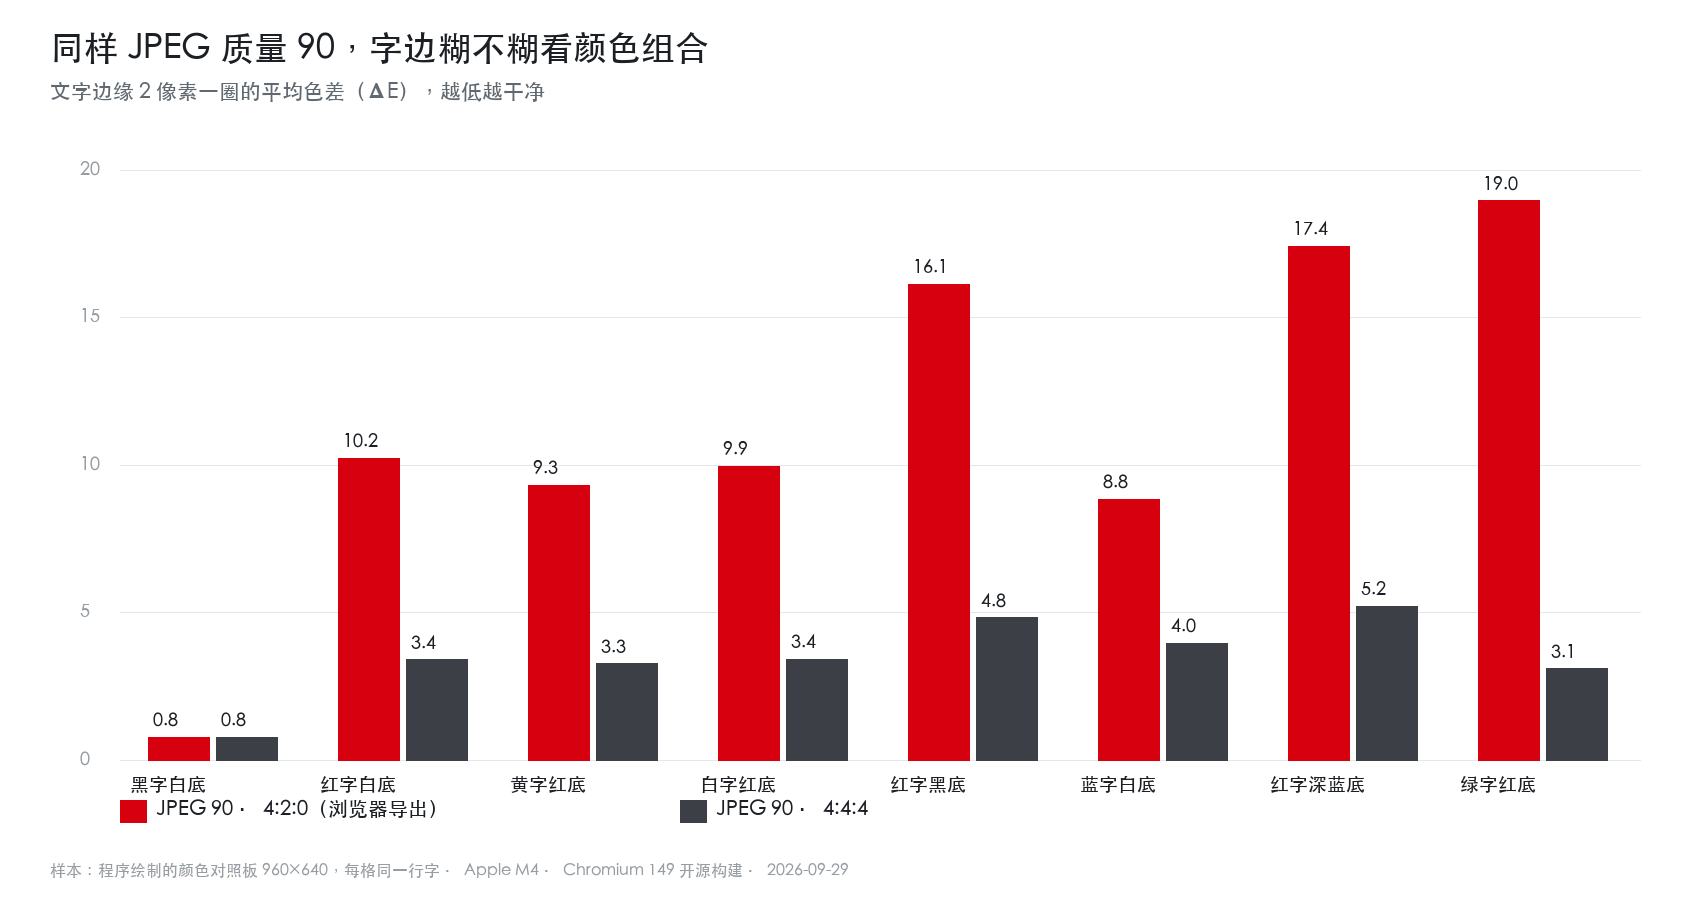
这张图要看红柱和灰柱的高度差怎么随颜色组合变化。红柱是浏览器默认导出的质量 90 的 4:2:0。灰柱是同样质量的 4:4:4。最左边黑字白底的两根柱子一样高,都是 0.8,抽不抽样对它没影响。往右看红柱的高度起伏很大,最高的绿字红底到了 19.0。灰柱却一直趴在 3 到 5 之间,最高的红字深蓝底也只有 5.2。4:4:4 把每种颜色组合都拉回了差不多的水平,高低差异几乎全是 4:2:0 带出来的。图上的数字四舍五入到了一位小数,正文里我引用的是两位小数的原值。
亮度差小的组合为什么最糊,我自己是这么理解的。一个字能被看清主要靠字和底之间的明暗差撑着轮廓。红字白底的亮度差有 189。就算色度被抹成一团,亮度通道也还能把笔画勾出来。我们看到的是清楚的字加一圈粉边。绿字红底的亮度差只有 30,轮廓几乎全靠颜色区分。偏偏颜色只剩四分之一的分辨率,于是连笔画的形状都跟着化开了。红色本身的亮度只有 66,它和黑、深蓝、深绿站在一起时最容易出现这种情况。这也解释了为什么大家总把「红」单独拎出来说。红色亮度低、色度高,不管和谁搭配,差别都主要落在色度上。蓝字白底是个旁证。它的亮度差是 191.1,和红字白底差不多。它的色度差 89.3 比红字小一些,色差也就低一些(8.84)。
六、换个浏览器导出结果一样吗
6.1 Firefox从质量90起就不抽样
社团里用什么浏览器的都有,我就好奇换个浏览器会不会不一样。手边能跑的是 Chromium 149、Firefox 151 和 WebKit 26.5 三个开源构建。我在每个内核里把质量从 0.80 一路试到 1.00,再逐个读文件的采样因子。表里空着的格子是没测的。0.80、0.90、0.99 和 1.00 这几档用的是海报,其余几档用的是对照板。
| 内核 | 0.80 | 0.85 | 0.88 | 0.89 | 0.895 | 0.90 | 0.91 | 0.99 | 0.995 | 0.999 | 1.00 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| Chromium 149 | 4:2:0 | 4:2:0 | 4:2:0 | 4:4:4 | 4:4:4 | 4:4:4 | |||||
| Firefox 151 | 4:2:0 | 4:2:0 | 4:2:0 | 4:2:0 | 4:4:4 | 4:4:4 | 4:4:4 | 4:4:4 | 4:4:4 | ||
| WebKit 26.5 | 4:2:0 | 4:2:0 | 4:2:0 | 4:4:4 | 4:4:4 | 4:4:4 |
三个内核的门槛差得很远。Firefox 从 0.895 开始就是 4:4:4,0.895 乘 100 取整正好是 90。Chromium 和 WebKit 都要到 0.995 才换成 4:4:4,这个数取整后是 100。在 Chromium 和 WebKit 里只要质量没填到 0.995 以上,导出的 JPEG 就一定是 4:2:0。我第一章调到 0.99 还不管用的原因就在这里,差了一点点没跨过门槛。
WebKit 26.5 是开源构建。我没在正式版 Safari 上验过,不敢说 Safari 也是这个门槛。Chrome 正式版和 Chromium 同源,我也没单独验。各家为什么把门槛设在这里,我没去翻源码,只能说测出来是这样。
6.2 同样填0.9文件大小差出一半
门槛不同还带来了文件大小上的差别。同一张海报同样填 0.9,Chromium 导出的是 157 626 字节的 4:2:0。Firefox 导出的是 246 096 字节的 4:4:4。WebKit 导出的是 226 166 字节的 4:2:0。Firefox 的文件比 Chromium 大了一半多,字边却干净得多。三个内核在 0.9 这一档的字边 ΔE 分别是 7.11、2.31 和 6.64。
| 内核 | 0.80 | 0.90 | 0.99 | 1.00 |
|---|---|---|---|---|
| Chromium 149 | 8.11 | 7.11 | 6.35 | 0.19 |
| Firefox 151 | 8.11 | 2.31 | 0.33 | 0.19 |
| WebKit 26.5 | 6.82 | 6.64 | 6.57 | 0.27 |
一开始我差点得出「Firefox 的 JPEG 编码器更好」的结论,后来才发现不对。Firefox 0.9 导出的文件和我用 Pillow 存的「质量 90、4:4:4」都是 246 096 字节,解码出来的像素也逐字节一样。它俩底下很可能是同一套编码逻辑,差别只在抽样这个开关上。这张表竖着看也能说明问题。Firefox 从 0.90 跨进 4:4:4 以后,ΔE 就从 8.11 掉到了 2.31。另外两个内核要一直等到 1.00 才掉下来。
这件事对我那个小工具的意义很直接。同一段导出代码配同一个质量参数,换个浏览器出来的文件体积可能差一半,字边色差可能差好几倍。我之前以为「质量 0.9」是个固定的东西,其实它背后藏着一个我看不见也改不了的抽样开关。canvas.toBlob 的参数里没有抽样方式这一项,前端能填的只有一个质量数。
七、红字海报最后该存成什么格式
弄清原因以后,我先排除了两个看起来能救的办法。第一个是改用 WebP,可它的有损模式建立在 VP8 视频编码上,格式规定就只有 4:2:0。浏览器导出 WebP 质量 0.8、0.9、0.99 时,海报的字边 ΔE 分别是 6.93、6.56 和 6.29。这和 JPEG 的 4:2:0 在同一个水平。cwebp 有个 -sharp_yuv 选项。它换了一种 RGB 转 YUV 的算法,抽样仍是 4:2:0。我测了质量 90 的海报,ΔE 从 6.56 改善到 4.77。体积只多 8%(87 554 到 94 840 字节)。可惜浏览器的 toBlob 没有这个开关。第二个是 AVIF,我手边能编 AVIF 的是 macOS 自带的 sips,它编出来的文件头读出来也是 4:2:0。质量 60 和 80 的字边 ΔE 是 7.88 和 7.49,最差那 5% 像素的色差比 JPEG 还高。AVIF 格式本身支持 4:4:4,是 sips 没打开这个选项。
7.1 纯色海报用无损格式更小
真正的出路在我一开始没考虑的方向上。只有几种纯色加文字的图,本来就不该用 JPEG 存。我用 Pillow 试了三条路,都写在代码四里。一条是把颜色减到 128 色存 PNG,一条是 WebP 无损。第三条放到下一节讲。
python
# 海报的三条出路:PNG 减色、WebP 无损、非要 JPEG 就关掉色度抽样
import os
import numpy as np
from PIL import Image
from s2_fake_420 import to_lab, near_edge   # 复用代码二里的两个函数

poster = Image.open('poster_1600x900.png').convert('RGB')
ref = np.asarray(poster).astype(np.float64)
band, lab_ref = near_edge(ref), to_lab(ref)

jobs = {
    'png_128色.png': lambda p: poster.quantize(colors=128).save(p, optimize=True),
    'webp_无损.webp': lambda p: poster.save(p, 'WEBP', lossless=True, quality=100, method=6),
    'jpg_q75_444.jpg': lambda p: poster.save(p, 'JPEG', quality=75, subsampling=0),
}
for name, write in jobs.items():
    path = name
    write(path)
    back = np.asarray(Image.open(path).convert('RGB')).astype(np.float64)
    de = np.sqrt(((to_lab(back) - lab_ref) ** 2).sum(-1))[band].mean()
print(f'{name:16} {os.path.getsize(path):7d} B 字边ΔE {de:.2f}')png_128色.png 48654 B 字边ΔE 0.14
webp_无损.webp 49350 B 字边ΔE 0.00
jpg_q75_444.jpg 169640 B 字边ΔE 4.47代码说明 。代码二我把主流程包进了 if __name__ == '__main__'。这样这里才能直接 import 它的两个函数,不会顺带把代码二整个跑一遍。quantize(colors=128) 是 Pillow 自带的减色。它默认用中位切分,存出来是带调色板的 PNG。WebP 无损里的 quality=100 管的不是画质。无损模式下它控制的是压缩花多大力气。method=6 是最慢也最省的那一档。输出前两行是这一节要看的。128 色 PNG 是 48 654 字节,字边 ΔE 0.14。WebP 无损是 49 350 字节,ΔE 0.00。这两个都不到原图 126 373 字节的一半,字边也基本和原图一样。
cwebp 做的 WebP 无损也差不多,49 432 字节(48 KB)且误差为 0。它比 cwebp 有损质量 80 的 67 870 字节还小。浏览器也能出 WebP 无损,toBlob 填 1.0 就是。可海报出来是 384 000 字节,相当于 cwebp 无损的 7.8 倍。我猜是浏览器为了速度用了比较快的无损参数,这点没拆开验证。
我把所有编码结果按体积和字边色差放在一起看。最干净的两个是 PNG 减色和 WebP 无损,它们的体积排第二和第三。比它们更小的只有 sips 编的质量 60 的 AVIF,是 46 832 字节。可它的字边 ΔE 是 7.88、P95 是 34.09,是全场最脏的之一。PNG 减色和 WebP 无损比任何一档 JPEG 都小,JPEG 最小的一档也有 120 501 字节。JPEG 4:2:0 那条线越往右越平。从 0.80 到 0.99 多花了 150 KB,只换来 1.76 的 ΔE 改善。
这个排序只对几种纯色加字的图成立,我拿网上那张国庆放假通知模板验过。它有渐变、插画和灯笼,原图数出来有 169 747 种颜色。它本身就是 3 339 216 字节的真彩 PNG。WebP 无损存它是 2 359 014 字节,比浏览器 JPEG 0.9 的 950 062 字节大了 2.5 倍。在这种图上 PNG 和无损反倒是最大的,上面的排序不能照搬。能照搬的只有抽样那一条。同样质量 90 时 4:2:0 的字边 ΔE 是 5.52,换成 4:4:4 是 2.62,体积多了 25%。
7.2 必须交JPEG时去服务端关掉抽样
总有些场合非交 JPEG 不可,比如有的报名系统只收 JPG。这时候前端就很被动,toBlob 没法指定抽样方式。Chromium 和 WebKit 要填到 1.0 才给 4:4:4,文件会到 428 KB。我能想到的办法是把导出这一步挪到服务端去,用能指定抽样的库来编。代码四的第三行就是这个做法,subsampling=0 就是 4:4:4。质量 75 出来是 169 640 字节,字边 ΔE 是 4.47。它比浏览器 0.99 的 270 978 字节、ΔE 6.35 更小也更干净。libjpeg-turbo 自带的 cjpeg 命令行也能用参数指定抽样,这个我没去试。
这么做的代价是同样质量下体积大 41% 到 42%,质量 75 够用的话这点代价是划算的。另一个代价是得有个服务端。我那个小工具是纯前端的,为这个专门加一个后端对社团来说有点重。这条路我只记了下来,没有真做。
7.3 我最后交给社团的是PNG
查到这里我原本打算自己写一段减色代码塞进小工具,后来想先看看现成的在线工具会怎么处理这张图。我用的是图映 ImgIng(https://imging.cn/)2026-09-29 晚上的线上版,入口选「压缩 + 转换」、参数全用默认。浏览器还是那个 Chromium 149 开源构建。我把练习图拖进去以后它没让我选格式。下面直接出了一行提示「自动 检测到图标/线稿 · 已默认 PNG-8 · 256 色(无损又小)」。点转换以后结果卡片上写着 124 色索引 PNG,旁边标着「省 62%」。我把文件拿回来看是 48 481 字节,界面上显示的是 47.3 KB。整个过程我在开发者工具的网络面板里没看到上传请求。
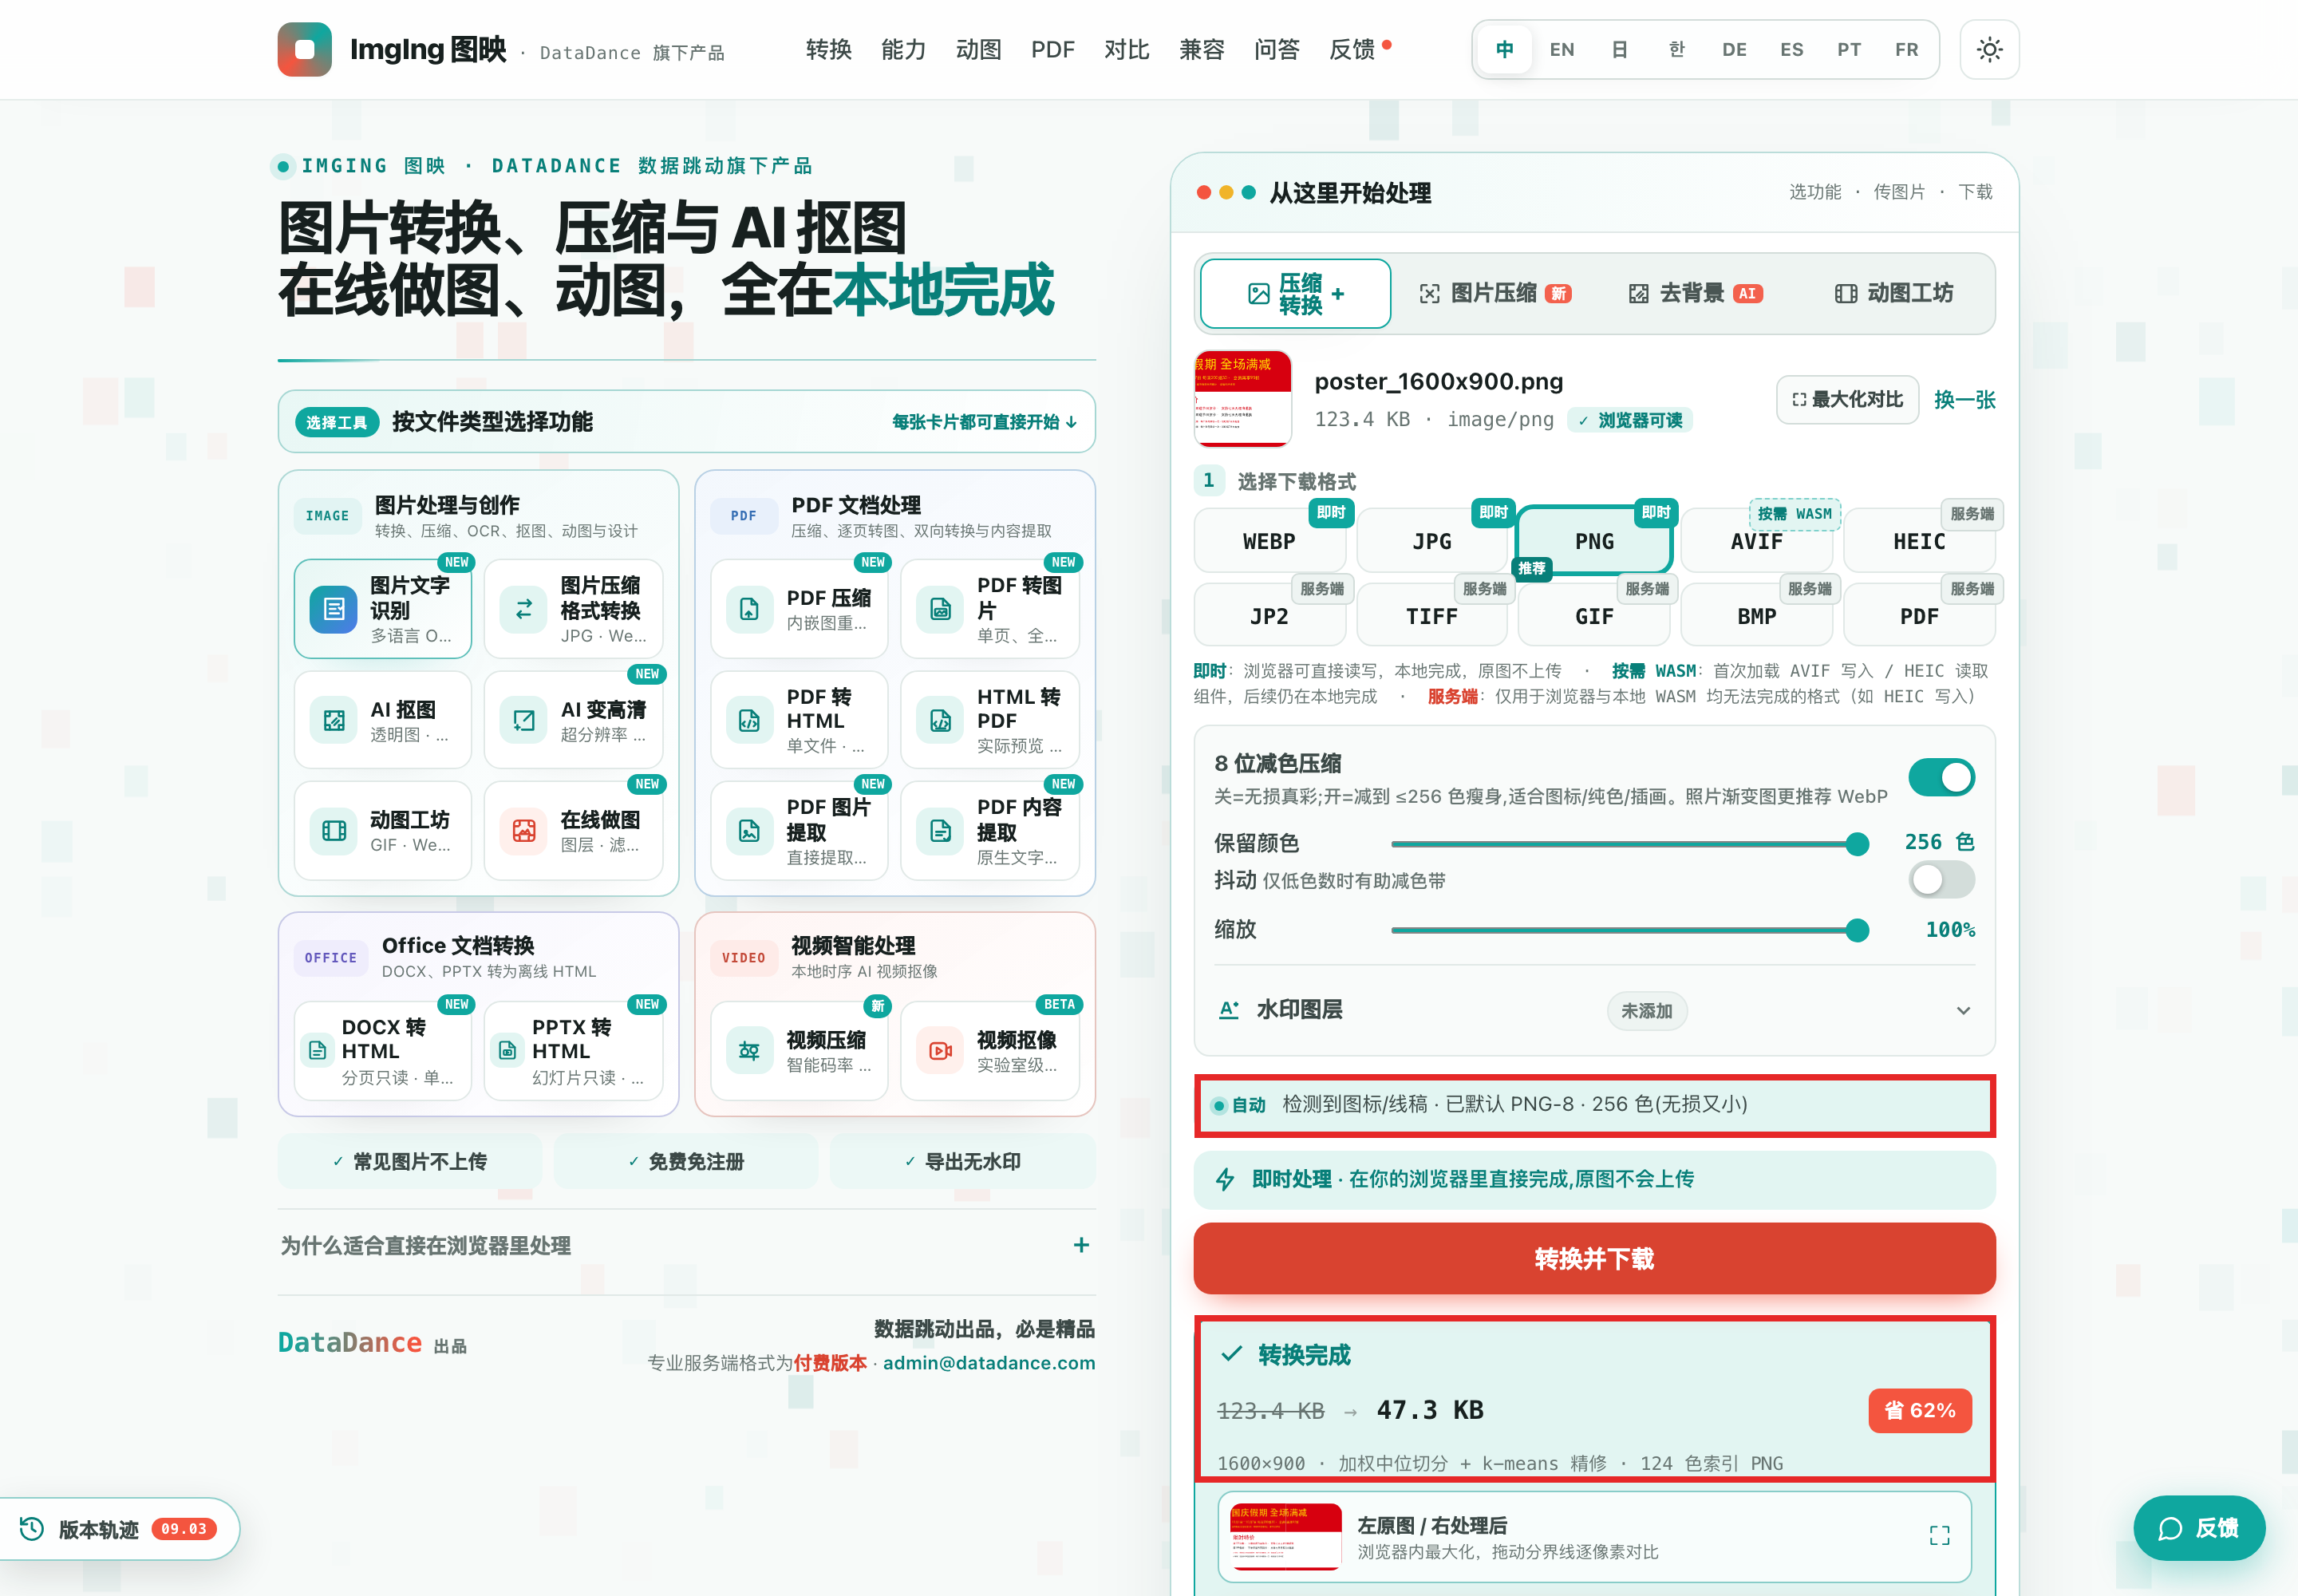
这张图要看两个红框。上面那个框是它拿到图以后自动给出的判断。它把海报识别成图标或线稿,默认走 PNG-8。下面那个框是结果,123.4 KB 变成了 47.3 KB(省 62%)。框里最下面一行小字写着 124 色索引 PNG。中间那块「8 位减色压缩」的设置可以顺带看一眼。保留颜色的滑杆默认在 256 色,抖动开关默认是关的。这张海报用不满 256 色,最后只留下了 124 色。
「无损又小」这四个字我去验了一下。和原图逐像素比有 2.03% 的像素不一样,差得最多的一个通道差 6。严格说它不是逐像素无损。减色本来就会合并掉一些抗锯齿产生的过渡色。不过它的字边 ΔE 是 0.13,和我自己用 Pillow 减到 128 色的 0.14 差不多,放大六倍也看不出区别。一张要发到群里的海报,有这个误差我能接受。
我顺便也试了它的转 JPG。推荐质量 88 出来的文件是 147 563 字节。界面上直接警告「比原图大 17%」,还建议想更小就换 WebP。我又把滑杆拉到 100 导了一次,得到 270 978 字节。这个文件和 Chromium 里 toBlob 质量 0.99 导出的那个逐字节相同,文件头读出来也是 4:2:0。在 Chromium 里它导出的 JPG 就算滑杆拉满也还是 4:2:0,红字的毛边一样在。这和第六章的门槛对得上,界面上的 100 实际传给编码器的是 0.99。
那张网上的模板我也拖进去试了,它给的判断就不一样了。图映把它认成截图或界面,默认走 WebP 画质 84。结果是 3.18 MB 变成 587.9 KB,省了 82%。这时字边 ΔE 是 5.12,和 WebP 有损在同一个水平。这谈不上保住了红字。转 JPG 把滑杆拉到 100 是 2 004 610 字节。它解码出来和 toBlob 0.99 逐像素相同,文件头也是 4:2:0。省 62% 和 PNG-8 那条路只对我那张练习图这种纯色平面图成立。
社团的海报基本都是纯色块加字,最后我给社团的方案是这类海报一律发 PNG。我把小工具的导出格式从 JPEG 改成了 PNG,并在导出前加了一步减色。学姐看了放大图,说这回红字边干净了。
八、适用边界与风险
海报和对照板都是我用程序画的,只有少数几种纯色。字边的抗锯齿产生了几百到一千多种过渡色(海报 746 种、对照板 1674 种)。PNG 减色和 WebP 无损在这类图上效果好,是因为颜色本来就少。照片和渐变多的插画完全是另一回事。减到 128 色会出现明显的色带。那种图我只拿网上一张国庆放假通知模板试过。WebP 无损在它上面比 JPEG 0.9 大 2.5 倍,这篇的格式建议对它们不适用。字号我只测了海报上最小到 22 px 的几档。更小的字会不会更糊、大到多少以后就不明显了,我都没系统地测过。
浏览器的结论只对三个开源构建成立。Chromium 149、Firefox 151 和 WebKit 26.5 的门槛值和文件大小都只代表这三个版本。我没在正式版 Safari 上验过,Chrome 正式版也没单独验。浏览器升级可能换掉内置的编码库,门槛也可能跟着变。想把这个结论用在自己的项目里,最稳的办法是在目标浏览器里导出一张,再用代码三读一下文件头。
服务端 4:4:4 有体积代价,同样质量下要大 41% 到 42%。有些场合对体积卡得很死,比如只允许 200 KB 的上传框。那时候可能宁可降质量也要保住 4:2:0。字边和体积之间怎么取舍并没有通用的答案。
减色也不是逐像素无损。图映的 PNG-8 结果有 2.03% 的像素和原图不同,我自己用 Pillow 减到 128 色同样会改动像素。海报上看不出来。可要是图要拿去做逐像素比对(比如图像识别的标注图)就不能这么用。另一个风险在上传以后,那部分我不知道。我只确认了自己导出的文件是什么样。海报发到聊天软件、公众号或者别的平台,对方会不会再压一遍、用什么抽样,我都没测。就算我交的是 PNG,也不能保证读者最后看到的就是这张 PNG。
九、测量方法的坑
第一个坑是整图平均会把问题稀释掉。海报大部分面积是纯色,整图 PSNR 看上去还不错,字边的问题几乎被淹没了。改成只在字边窄带里算以后,数字才和眼睛对得上。换一张字更少的图,这种稀释会更严重。第二个坑是同一个「质量 90」在不同工具里不是一回事。Chromium 质量 0.9 导出的 JPEG 和 Pillow 质量 90、4:2:0 解码出来的像素逐字节相同,最大差是 0。可 Chromium 的文件小了 15 400 字节(157 626 对 173 026)。我猜是两边的 Huffman 表优化方式不一样,这个没拆开验证。Firefox 0.9 又和 Pillow 90、4:4:4 的字节完全相同。拿「质量」横向比较不同工具的体积之前得先弄清它们的抽样方式,不然比的根本不是同一件事。
第三个坑是看画质猜抽样。质量 0.80 时 WebKit 和 Chromium 的字边 ΔE 分别是 6.82 和 8.11,两个都是 4:2:0。只看色差会以为它们存法不同,文件头读出来却是一样的。我后来都是先读文件头再看色差。第四个坑是放大看图的方式。我第一次放大是直接在看图软件里拉。软件放大时会做平滑,看到的糊有一部分是放大本身带来的。后来改成按整数倍把每个像素放成一个方块再看,边上的色块才清楚了。文中那张导出对比页里的放大就是这么做的。
第五个坑在我自己的模拟里。代码二用的是最简单的 2×2 取平均再原样复制。真编码器缩小色度时可能用别的滤波,解码器放大色度时也常用插值。7.47 和浏览器实测的 10.23 不能直接相减得出「量化占了多少」。它只能说明抽样本身就足以让红字发花。第六个坑是 ΔE 用的是最老的 CIE76。它在饱和的红色附近会比人眼的感受偏大一些,后来的 CIEDE2000 修正了这类问题。我只拿它比较同一张图的不同编码。排序大体可信,绝对数值别太当真。「5 以上一眼可见」那个分档也只是经验说法。
最后是 KB 的口径。文中的 KB 都按 1024 字节算。图映界面上的 47.3 KB 就是 48 481 除以 1024,按 1000 算会是 48.5 KB。对照别人的数据时要先对一下口径。
十、还没解决的
有几件事我到现在也没弄明白。第一件是黄字红底和白字红底。它们的亮度差分别是 136.5 和 189.0,色度差都在 110 左右。浏览器 0.9 下的色差却是 9.32 和 9.95,亮度差更大的那组反而更糊一点。我那套「亮度差大就不容易糊」的解释在这里不太灵。我猜这和 Lab 空间里黄色、白色附近的尺度有关,还没验证。
第二件是解码器,我所有的色差都是用 Pillow 解码后算的。不同解码器把色度放大回去的方法不一样,有的插值有的直接复制。同一个 JPEG 在不同软件里看到的毛边可能不完全相同,这一点我没换解码器对比过。第三件是图映的 AVIF 用什么抽样。它的 AVIF 用的是 libavif 的 WASM 版本,格式本身支持 4:4:4。实际用了哪种我没测,只能留到以后再看。
如果你手上也有一张红字海报导出后发糊,可以先用代码三读一下文件头看看 Y 的采样因子是不是 2x2。是的话别急着往上调质量,先想想这张图是不是只有几种纯色。只有几种纯色就存 PNG 减色或者 WebP 无损,非交 JPEG 不可就去服务端关掉抽样。
写完这篇正好到了十月一号,祝祖国生日快乐。
参考资料
- ITU-T T.81(ISO/IEC 10918-1):JPEG 标准,SOF 段结构与采样因子定义
- JFIF 1.02 规范:JPEG 文件的 YCbCr 与 RGB 换算公式
- RFC 6386:VP8 数据格式与解码指南(WebP 有损模式的 4:2:0 色度格式)
- AV1 Codec ISOBMFF Binding:
av1C配置盒中的 chroma_subsampling 字段 - HTML Living Standard:
HTMLCanvasElement.toBlob()的定义 - CIE 15 色度学:CIE 1976 L*a*b* 颜色空间与 ΔE*ab 色差
- Pillow 文档:JPEG 保存参数
quality、subsampling,Image.quantize() - libwebp 文档:cwebp 的
-lossless、-sharp_yuv选项 - 本文实测数据:2026-09-29 与 2026-09-30 两轮本机运行记录,环境见「版本声明」