Extensive variation between chromosomes of North American and European hop
北美与欧洲啤酒花染色体间存在广泛变异
摘要
啤酒花是酿造行业的核心原料,赋予啤酒特有的苦味与香气。目前绝大多数现代啤酒花品种均为欧洲啤酒花与北美啤酒花谱系的杂交后代,但这两种祖先谱系如何影响啤酒花最重要育种性状 ------ 苦味酸含量,尚不明确。本研究报道了杂交啤酒花品种 Apollo 的染色体水平、单倍型分辨基因组组装结果;在全基因组范围内区分欧洲来源与北美来源的祖先片段,并发现两种来源染色体之间存在不同程度的重组抑制。依托该参考基因组,本研究解析了欧洲与北美啤酒花核心苦味合成通路的遗传多样性与化学多样性。研究进一步证实,来自欧洲和北美的优良等位基因对苦味酸含量存在加性效应,为啤酒花的基因组辅助育种奠定基础。
引言
大麻科啤酒花属(Humulus spp. L.)与大麻属为姊妹类群,其雌株的球果(啤酒花)用于栽培利用的历史至少可追溯至公元 859 年,彼时中世纪中欧开始将啤酒花添加到啤酒中\(^{1}\)。啤酒花含有 α酸,赋予啤酒独特的苦味;更为重要的是,它使啤酒成为耐储存的食品,便于运输与贸易。14 世纪中叶以后,啤酒需求量上涨。由于饮用水普遍受到污染,人们更倾向于饮用啤酒。酿造发展成为专门行业,随后巴伐利亚啤酒纯净法(1516 年)等市政法规规定啤酒原料仅能使用大麦、水和啤酒花\(^{2}\)。这塑造了人们对啤酒的传统认知,推动啤酒成为全球最受欢迎的酒精饮品\(^{3}\),其为全球国内生产总值带来的总增加值达 5550 亿美元\(^{4}\)。
但啤酒花的价值远不止作为苦味添加剂,它含有大量功能多样的高价值代谢物。其中包括赋予风味与香气的萜类、天然防腐剂(β酸),同时含有具有抗炎、抗癌活性的异戊烯基黄酮类物质黄腐酚\(^{5,6}\),以及其衍生物 8异戊烯基柚皮素 ------ 目前已知活性最强的植物雌激素\(^{7}\)。尽管现有成熟的组分分离技术拓展啤酒花应用具备可观潜力,但尚缺乏代谢组分改良的粮药兼用品种,导致啤酒花的利用仍局限于啤酒生产。育种上的这一现实缺口表明,亟需完善遗传资源,支撑啤酒花遗传改良。
传统酿造所用啤酒花为H. lupulus (忽布,啤酒花),原产于欧洲及亚洲部分地区。啤酒花属除啤酒花外,还包含 5 种多年生物种:葎草(H. cordifolius ,日本)、新墨西哥啤酒花(H. neomexicanus ,北美西南部)、北美啤酒花(H. lupuloides ,北美中东部)、柔毛啤酒花(H. pubescens ,北美中西部)、云南啤酒花(H. yunnanensis ,中国中南部);以及一年生植物葎草(H. scandens ,异名H. japonicus,东亚)\(^{8}\)。亚洲北美谱系与欧洲啤酒花谱系的分化发生在一百万年前以上,分化地点很可能位于中国\(^{9}\)。
17 世纪欧洲啤酒花传入北美,欧洲啤酒花与北美本土啤酒花自然杂交产生的后代被称为 "Cluster",其苦味物质含量优于欧洲地方品种。Cluster 系列品种得到广泛种植,并于 20 世纪初引种回欧洲\(^{10}\)。1904 年英国启动首个啤酒花科学育种项目,育种家开始将引进的北美啤酒花种质与欧洲种质开展杂交;首批杂交品种分别于 1934、1939 和 1944 年推出\(^{10}\)。近年研究表明,野生北美啤酒花 α酸含量高于欧洲啤酒花;而北美欧洲杂交品种的 α酸含量远高于二者任一野生亲本\(^{11}\)。因此,虽然欧洲传统地方品种因其独特的经典香气仍具备价值,但当前绝大多数栽培品种均为欧洲与北美啤酒花的杂交单倍体或其后代。然而,现有的啤酒花基因组草图\(^{1214}\)很难反映这种种间育种策略对基因组结构造成的影响;这些组装缺少分相与单倍型水平解析,丢失了优良性状关联区域的物种祖先来源信息。
对于高度杂合的雌雄异株啤酒花基因组(单倍基因组大小约 2.5 Gb;雌株 2n = 18+XX,雄株 2n = 18+XY)这类复杂植物基因组,构建参考级、分相、单倍型分辨的基因组组装,通常需要结合长读长测序与高通量染色质构象捕获(HiC)技术\(^{1517}\)。种间杂交个体中,可以利用**triobinning(三亲本分箱)**依据亲本来源区分单倍型,该方法利用亲本特异 kmer 对染色体或 scaffold 进行分组,现已应用于植物基因组组装\(^{1821}\)。但 triobinning 需要额外的亲本测序数据,并且仅可确定 F₁代的物种来源,不适用于现代啤酒花这类经过多代互交的杂交品种。
本研究获得啤酒花品种 Apollo 两套单倍型的染色体水平基因组组装。Apollo 为高 α酸品种,由欧洲啤酒花与北美啤酒花多代互交选育而来\(^{22,23}\)。本研究利用 Apollo 基因组内部物种特异性重复序列家族的 kmer,完成单倍型上欧洲(Eu)与北美(NAm)祖先片段的归属;鉴定两种祖先来源染色体之间不同程度的重组抑制;进一步证实,欧洲与北美的优良单倍型对啤酒花最重要农艺性状 ------α酸含量存在加性效应。
结果
Apollo 品种基因组中欧、北美祖先来源溯源
本研究不依赖分箱策略,采用 hifiasm\(^{24}\)、ALLHiC\(^{25}\)与 TRITEX\(^{26,27}\)流程,基于总计 120 Gb 的环形一致序列(CCS)读段(二倍体基因组覆盖度 24 倍)完成啤酒花 Apollo 二倍体基因组组装(补充图 1,补充表 1)。首先使用 hifiasm 结合 TRITEX 流程,辅以人工编辑剔除等位 contig,得到单倍体组装(补充表 1,补充图 1)。为统一大麻科染色体命名体系,方便属内、属间基因组比较\(^{28}\),本研究参照大麻(Cannabis sativa)染色体共线性关系对假分子重新编号\(^{29}\)(补充图 1)。与禾本科基因组特征类似\(^{30}\),除 01 号染色体外,其余所有假分子基因密度均向着染色体远端逐步升高;01 号染色体携带 45S rDNA,为 Apollo 基因组中长度排名第六的染色体(图 1)。01 号染色体为近中着丝粒染色体,其短臂不存在啤酒花亚端粒重复序列(HSR)串联重复阵列,这很可能是该染色体基因密度模式异于其他染色体的原因。
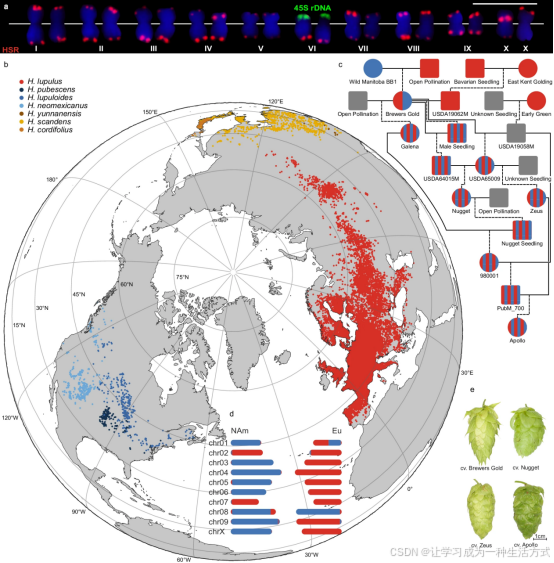
a Apollo 核型图,依据染色体长度排序;图中标注有丝分裂中期染色体上 HSR 亚端粒串联重复序列(红色)与 45S rDNA(绿色)的定位。45S rDNA 信号位点直接标注在对应信号旁。染色体经 DAPI 复染(蓝色)。六号染色体(VI)的长臂带有 HSR 亚端粒重复序列,短臂分布 45S rDNA,与前人报道结果一致\(^{179}\)。同一雌株细胞内两条 X 染色体上 HSR 串联重复的定位存在差异:一条 X 染色体短臂着丝粒周边存在预期的 HSR 信号\(^{180}\);另一条 X 染色体长臂的着丝粒周边 HSR 信号更弱。比例尺 = 10 µm。 b 啤酒花(Humulus lupulus )、北美啤酒花(Humulus lupuloides )、新墨西哥啤酒花(Humulus neomexicanus )、柔毛啤酒花(Humulus pubescens )与葎草(Humulus cordifolius)的地理分布;这 5 个类群过去被划分为啤酒花的植物学变种(引自英国皇家植物园 POWO 数据库)。图中每个点代表全球生物多样性信息机构(GBIF)收录的物种分布记录。红点代表欧洲类群,蓝点代表北美类群,黄、橙点代表亚洲啤酒花物种。 c 啤酒花品种 Apollo 已知系谱图。方块代表雄株,圆圈代表雌株;蓝色符号代表北美(NAm)种质,红色符号代表欧洲(Eu)种质;灰色符号代表祖先来源未知;红蓝条纹符号代表欧美混合基因型;半红半蓝符号代表欧美杂交 F₁代。 d Apollo 单倍型分辨、分相染色体水平基因组组装概览图,蓝色区域代表基因组北美祖先片段,红色区域代表欧洲祖先片段。 e Brewers Gold、Nugget、Zeus 与 Apollo 这几个啤酒花栽培品种的成熟球果。原始数据见补充文件 22。
本研究利用 hifiasm 联合 ALLHiC、TRITEX 流程,完成 Apollo 基因组的分相组装;以 Hi-C 数据与单倍体组装得到的基因模型作为引导,将 contig 划分至不同单倍型,最终得到分相染色体水平基因组(补充表 1,补充图 1)。相位切换误差分析显示,在 5886045 个 SNP 中仅 2.085%(122753 个)存在相位切换,说明最终组装的分相效果良好(补充表 1)。Hi-C 互作矩阵中相邻 contig 之间存在强互作信号(补充图 1);两套单倍型的 BUSCO 完整度均约 98%(补充表 1),证明该分相组装具备高连续性与高完整性。
此时组装得到的单倍型归属仍是随机分配。因此本研究开发了一种方法,利用重复序列区域的细微分化,在分相组装中区分不同亲本来源的基因组。依据部分低拷贝重复家族在染色体上的差异分布特征,筛选得到两个谱系差异化富集的高拷贝 kmer 标记(补充图 1),用于最终的单倍型划分(补充图 1)。将筛选的欧洲、北美野生 / 半野生啤酒花材料的 GBS(简化基因组测序)读段比对至最终组装基因组,结果证实通过 kmer 策略区分出的两个谱系分别对应欧洲祖先与北美祖先。Apollo 基因组中,chr01、chr03、chr04、chr05、chr06、chr09 以及 X 染色体,每对同源染色体各含一条欧洲来源、一条北美来源的单倍型;chr02、chr07 两条同源染色体均为欧洲来源;chr08 两条同源染色体全部为北美来源。此外,chr01 与 chr08 各有一条染色体携带大片段另一谱系的渐渗片段。Apollo 这套单倍型分辨的分相组装可视化见图 1。欧洲、北美来源的同源假分子之间序列分化程度很高(一致性中位数 75%--78%),与引言所述欧、美谱系达到物种级分化的结论吻合。与之对比,同源染色体均为北美来源或均为欧洲来源的染色体对,序列几乎完全一致(>98.5%)(补充图 1)。约 60% 的相位切换误差来自两条同源染色体属于同一祖先来源(全部北美或全部欧洲)的染色体(补充表 1)。
啤酒花种间杂交个体的重组抑制
亲本特异性高拷贝 kmer 分析结果(补充图 1)显示:尽管 Apollo 系谱历经 6 代种间多代杂交\(^{22,23}\),但其基因组内原始欧洲、北美单倍型依然保持清晰分离,单倍型 1 以北美来源为主,单倍型 2 以欧洲来源为主。这与 F₂代及以后多倍体杂交种预期的亲本连锁片段相互嵌合的马赛克基因组模式完全不同\(^{3133}\)。因此本研究构建 3 个双亲本作图群体(Apollo × PubM_740、Zenith × USDA21058M、Cascade × HL-19-060-002M),探究欧美杂交啤酒花中欧洲染色体与北美染色体之间是否存在重组抑制(补充数据 4,补充表 1)。Apollo、Cascade、USDA21058M 同时含有欧洲和北美来源染色体;PubM_740、Zenith、HL-19-060-002M 为欧洲啤酒花H. lupulus(补充图 1)。
采用拟测交策略,使用杂交亲本杂合、且呈 1:1 分离的标记构建连锁图谱;结果发现 Apollo × PubM_740 与 Zenith × USDA21058M 群体中,重组几乎完全被抑制,无法构建连锁图谱(补充图 1)。
减数分裂过程中交换对于同源染色体配对与染色体正常分离至关重要,本研究观察到重组显著降低甚至完全消失,这一现象十分值得关注。一项涵盖 57 个物种、665 张染色体图谱的被子植物重组研究表明,仅有 2% 的染色体每条染色体交换少于 1 次\(^{34}\);绝大多数物种都需要保证交换发生,才能实现减数分裂时染色体正常分离\(^{35}\)。然而补充图 1 显示,Apollo × PubM_740 作图群体的全部 10 对染色体重组率均极低甚至检测不到。部分区域(例如 chr08.1 上的欧洲渐渗片段)重组率看似升高,大概率是单倍型高度异质性与标记稀疏造成的假象,并非真实发生的减数交换。Apollo 的基因密度向染色体末端逐渐升高(补充图 1),而转座子在染色体大部分区域保持高密度(补充图 1),说明其存在大片段着丝粒周边重复区域,与 Akagi 等人报道一致\(^{36}\)。但 Akagi 等人研究的欧洲地方品种 Saaz,观察到重组向染色体末端升高;本研究并未观察到此现象。该差异的原因在于本研究材料是欧美杂交种,两套祖先单倍型分化程度很高,估算分化时间约 105 万年前\(^{9}\)。交换的遗传决定因子、组蛋白分布改变以及各类染色质修饰标记,都可能进一步限制染色体臂上交换的形成;不过整体交换数量仍处于真核生物常见范围\(^{37}\)。但在全基因组核苷酸多样性(π)与单倍型分化(dXY)分析中,重组抑制程度和染色体臂局部序列分化之间没有稳定相关关系(补充图 1)。
需要注意:重组抑制并非啤酒花减数分裂唯一异常特征。已有遗传研究发现,啤酒花性状分离严重偏离孟德尔遗传规律\(^{38,39}\)。细胞学研究进一步证实,从减数第一次分裂联会阶段开始就存在严重异常,并且持续至减数第二次分裂\(^{40,41}\);不同基因型的减数异常程度存在差异。近期研究发现,部分基因型会出现二价体无法排列至赤道板,造成染色体不均衡分离;即使是欧洲地方品种,也存在这类影响减数分裂正常进行的异常\(^{42}\)。Zhang 等人\(^{41}\)在两个野生型与两个杂交组合的终变期细胞核观察发现,能形成 10 个二价体、20 条染色体正常配对的细胞核占比不足 5%。
如上所述,减数异常不只出现在杂交种,野生型杂交组合同样存在,说明欧、美谱系分化并非造成重组抑制的唯一原因。Horáková 等人\(^{42}\)研究支持这一推论:欧洲啤酒花着丝粒结构存在很高的种内多样性与复杂性,Apollo 品种同样具备该特征(补充图 1);染色体异常分离与特殊的着丝粒结构相关。作者认为,啤酒花独特的着丝粒结构是造成非孟德尔分离的重要原因。
虽然减数异常严重,但不同材料间程度存在差异。有意思的是,采用相同策略,在 Cascade × HL-19-060-002M 群体中使用 8751 个 Cascade 杂合标记构建连锁图谱,结果与前面两个群体完全不同:得到总长度 2864.69 厘摩(cM)的遗传图谱,平均标记密度为 4.23 个标记 /cM(补充表 1)。对分离标记进行可视化,同时对比遗传图谱与物理图谱,未发现重组抑制现象(补充图 1);每条染色体平均检测到 1~2 个重组断点(补充图 1)。
尽管本研究部分群体中几乎检测不到重组,且部分杂交组合在减数 Ⅰ、Ⅱ 期存在严重的染色体分离缺陷\(^{40}\),但绝大多数现代啤酒花栽培品种依旧是欧洲啤酒花与北美啤酒花杂交选育得到。原因在于这类杂交材料相比传统地方品种与野生啤酒花,总产量更高,α酸含量更高\(^{11}\)。虽然重组抑制的机制仍有待最终阐明,但本研究结果提示:啤酒花种间育种获得的优良性状,很大程度来自染色体的重新组合,而不是性状位点之间发生重组交换。因此我们进一步探究啤酒花育种中是否偏好特定的欧美染色体组合。为此,本研究利用 GBS 技术对 243 份材料进行基因型鉴定(补充数据 5、6),材料包含育种株系、北美啤酒花、新墨西哥啤酒花、商业栽培品种与欧洲啤酒花。结果发现欧洲同源染色体对占比偏高,这很可能是多代育种持续使用欧洲啤酒花雄株造成(补充图 1);但并未发现对特定欧美染色体组合的选择偏好,说明现代啤酒花品种的优良表现,更可能来自杂种优势效应,而非定向选择。
一项针对欧洲啤酒花生产气候敏感性的研究预测,到 2050 年,啤酒花产量将下降 4%~18%,α酸含量下降 20%~31%\(^{43}\),亟需培育新品种等适应性应对措施。现代植物育种高度依赖优良品种间杂交;但重组受限会制约育种改良效率\(^{44}\),同时也限制精细定位与分子标记开发,分子标记至今仍未在啤酒花育种中常规应用。本研究在 Apollo × PubM_740 群体开展全基因组关联分析(GWAS)定位霜霉病抗性(DMR)位点,在 Zenith × USDA21058M 群体定位白粉病抗性(PMR)位点(补充数据 7)。在 chr02 鉴定到一个 1.8 Mb 的霜霉病抗性关联区域(补充图 1);chr03 整条染色体以及 chr05 上一个 1.56 Mb 区域与白粉病抗性显著关联(补充图 1)。chr03 上的关联区域与前人报道 QTL 吻合\(^{45}\)。chr03 整条染色体均与白粉病抗性关联,正是前面提到的重组抑制导致;这也凸显啤酒花在性状定位与分子标记开发层面存在根本性难题。
欧洲与北美啤酒花的群体基因组学分析
我们基于 33178 个高质量 SNP,继续对上述 243 份啤酒花材料的遗传多样性进行评估(补充数据 6,补充表 1)。比较雌雄个体间 Fst 值,在 X 染色体鉴定出假常染色体区域(补充图 1)。主成分分析(PCA)结果可依据地理来源将材料分组(图 2),与前人研究结论一致:北美啤酒花谱系为单系类群,与欧洲啤酒花分化显著,亲缘关系更接近亚洲啤酒花\(^{9}\)。栽培品种与育种株系聚集在欧洲种质附近,这大概率是多代育种持续使用欧洲啤酒花雄株造成。
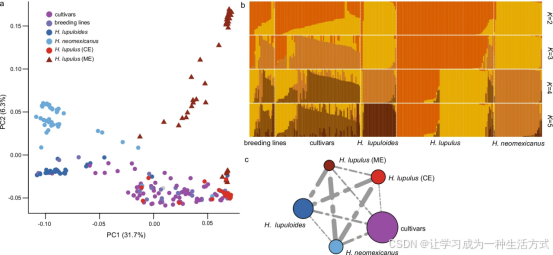
a 主成分分析(PCA)展示 243 份啤酒花材料的遗传多样性,样本依据地理来源聚类。啤酒花(H. lupulus)内部形成两个类群:一类由中欧(CE)材料构成,另一类由中东(ME)材料构成。 b 群体结构分析 K=25 时祖先成分分布柱状图。每一条竖柱代表 1 个个体,不同颜色代表推断得到的遗传类群,柱内各段长度代表该个体归属各类群的祖先成分占比。K=5 时,绝大多数纯合欧洲、北美材料几乎不存在基因渐渗,说明二者为分化显著的谱系。K=5 条件下啤酒花内部识别出两个类群,证明欧洲啤酒花内部已经演化出一个独特谱系。 c 核苷酸多样性与群体分化指数 Fst 分析,用于解析群体内部及群体间遗传多样性。圆圈代表群体内部核苷酸多样性;虚线代表 PCA 划分的各群体之间的 Fst 值。圆圈大小、线条粗细分别与核苷酸多样性、Fst 数值成正比。栽培品种群体的核苷酸多样性最高。啤酒花内部两个亚类群之间的 Fst 高于两个北美啤酒花物种之间的 Fst。颜色对应图 (a) 图例。原始数据见补充文件 22。
本研究的欧洲啤酒花材料可划分为两个亚类群:第一个亚类群包含中欧地方品种与野生逸生材料;第二个亚类群的样本主要采集自中东。两个亚类群的个体均未检测到基因混合,说明二者之间没有发生杂交(图 2)。Fst 分析显示,啤酒花谱系内部这两个亚类群的分化程度,高于北美啤酒花(H. lupuloides )与新墨西哥啤酒花(H. neomexicanus)之间的分化,提示啤酒花内部演化形成了一个独立谱系(图 2,补充表 1)。已有报道认为啤酒花种内遗传分化水平较低\(^{9}\),此前仅在高加索地区发现过遗传上相互隔离的野生啤酒花居群\(^{46,47}\)。结合本研究结果,有必要对欧洲与中东的啤酒花材料开展详尽的分类学修订,探究欧亚大陆是否还存在尚未被描述的啤酒花独立谱系。充分挖掘啤酒花属全部基因资源,将为培育气候适应性更强、代谢物组分改良的新品种提供更多育种素材。
啤酒花属的基因组扩张与大规模结构重排
为比较啤酒花与大麻(C. sativa)的基因组成,本研究采用成熟注释流程,对 Apollo 单倍型分辨分相组装基因组进行基因注释;整合从头预测、蛋白同源比对,以及多个基因型不同组织的 RNASeq、IsoSeq 数据(补充数据 8)\(^{48}\)。经过校正单倍型间基因遗漏的整合步骤后,流程得到两套高可信度基因集:单倍型 1 共 30 920 个高可信度基因模型,单倍型 2 共 30 398 个高可信度基因模型;两套基因集完整度高、冗余重复少(补充表 1)。两套单倍型之间 BUSCO 重复基因数量、基因总数的差异,很大程度来源于顺反式易位,说明小规模染色体易位对基因组成塑造具有重要影响(补充图 1)。
Apollo 两套单倍型、啤酒花栽培品种 Cascade\(^{13}\)与 Saaz\(^{36}\)的单倍体基因组,以及大麻品种 Pink Pepper\(^{49}\)基因组之间,基因顺序整体共线性良好(图 3)。但也检测到大麻 chr04、chr08、chrX 染色体分别与啤酒花 chr08、chr09、chr04 染色体之间存在大规模易位。对比 Apollo 两套单倍型,发现 chr03 与 chr05 之间存在染色体间易位。将 Apollo 基因组与公开的欧洲啤酒花单倍体组装基因组(NCBI 登录号 GCA_963169125.1)进行比对,二者基因顺序也高度共线性,进一步佐证本研究 Apollo 参考基因组组装具备高质量与高连续性(补充图 1)。
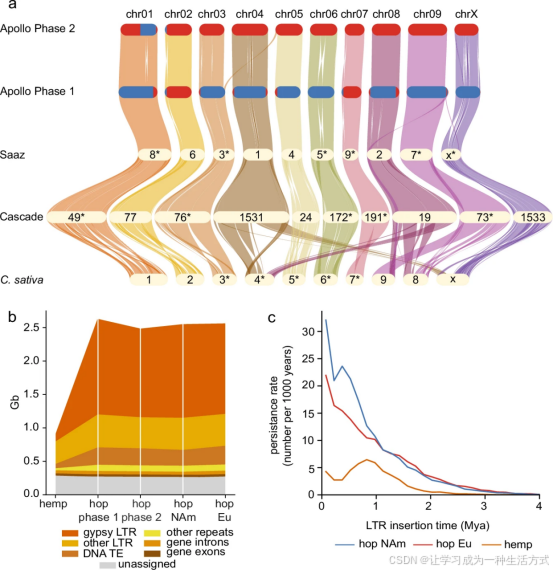
a 大麻(Cannabis sativa )、啤酒花 Apollo 的单倍型分辨分相组装基因组,以及啤酒花 Cascade、Saaz 品种之间基于基因的共线性与直系同源关系。红色、蓝色分别代表 Apollo 基因组中欧洲(Eu)、北美(NAm)来源的基因组区域。染色体标注沿用已发表的原始编号;部分 contig 已做序列反转(*),以减少图中连线交叉。染色体使用不同颜色仅用于可视化区分,不代表其他变量。 b 啤酒花转座子含量是大麻的 4.4 倍;而啤酒花不同单倍型、不同祖先来源之间转座子含量差异很小,该微小差异与组装序列长度差异相关。从大麻演化到啤酒花,基因组扩张主要由gypsy 型 LTR 反转录转座子扩张驱动。 c LTR反转录转座子存续速率比较:约 300 万年前起,啤酒花的转座子存续速率相比大麻显著升高。啤酒花中转座子活性更高且至今仍在发生,造成其基因组扩张。北美与欧洲谱系的转座子速率分化始于约 100 万年前,反映两大洲地理隔离,以及此后二者转座子演化历程出现分化。原始数据见补充文件 22。
啤酒花染色体近着丝粒区域基因密度更低(图 3),本研究未检测到全基因组复制(WGD)事件的证据(补充图 1)。转座子(TE)在大基因组植物中占比很高:大麻基因组中转座子总占比 56%(0.49 Gbp);而 Apollo 基因组单倍型 1、单倍型 2 的转座子序列分别达到 2.19 Gbp、2.05 Gbp,约为大麻的 4.4 倍。其中占比最高的 gypsy 型 LTR 反转录转座子扩张,贡献了大麻与啤酒花之间约 3 倍基因组扩张(扩张总量 1.74 Gbp)中的 77%(图 3,补充表 1)。因此,本研究结果表明,啤酒花属基因组大于大麻属的原因是转座子大量增殖,而非早期研究所提出的全基因组复制事件\(^{14}\)。转座子插入时间分析显示,啤酒花北美谱系与欧洲谱系分化时间约为 100 万年前(图 3),该分化时间也与前人报道一致\(^{9}\)。Apollo 单倍型 1 比单倍型 2 基因组略大 155 Mb,这一差异对应欧、美啤酒花谱系分化之后 gypsy 型 LTR 反转录转座子的含量增加(补充表 1)。对比组装长度与基因组成发现:Apollo 这套源于种间杂交的单倍型分辨分相基因组存在双向渐渗,单倍型 1 含有约 10% 欧洲祖先片段,单倍型 2 含有约 10% 北美祖先片段(补充表 1)。
分析 Apollo 单倍型 1 与单倍型 2 之间的结构变异(SV)(图 4),以单倍型 1 为参照,在单倍型 2 中共鉴定 52 593 个存在缺失变异(PAV)、41 990 个易位、4438 个倒位;这些结构变异涉及序列在单倍型 1、单倍型 2 中分别占 1.8 Gb、1.67 Gb(补充表 1)。绝大多数结构变异发生在祖先来源不同的两套单倍型之间;chr02 染色体检测到的结构变异数量最少,这与该染色体两条单倍型拥有共同祖先、序列分化程度低的特征相吻合。
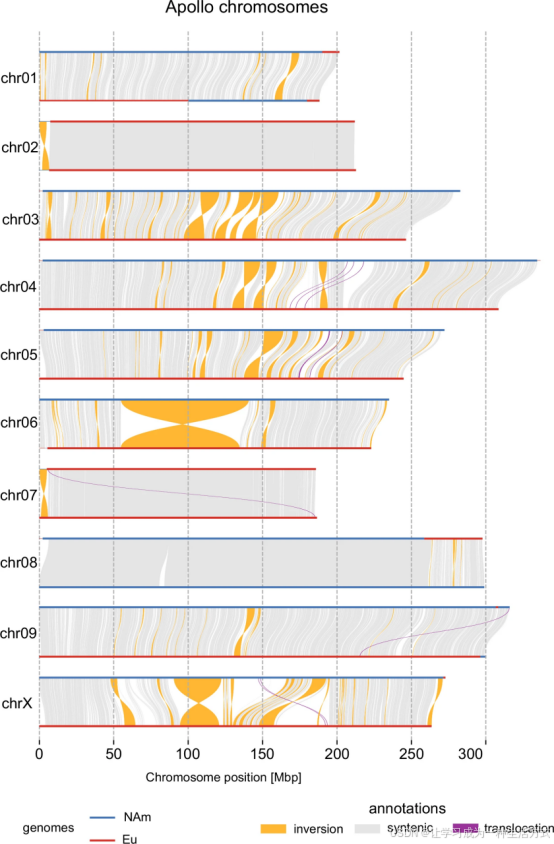
Apollo 品种两套单倍型之间的组装组装共线性图,展示二者的结构变异。基于全基因组比对识别结构变异,以单倍型 1 为参照,将变异划分为存在缺失变异。在 06 号染色体两套单倍型之间鉴定出一段约 85 Mb 的倒位。缩写:NAm 北美;Eu 欧洲。原始数据见补充文件 22。
检测到的最大结构变异为 06 号染色体上一段约 85 Mb 的倒位,该倒位包含约 500 个基因(补充图 1)。将 Apollo 与 Cascade 的 HiC 读段比对至单倍型分辨分相基因组,完成计算机模拟验证;同时通过 PCR 实验完成实验验证(补充图 1)。该倒位存在于 Apollo 单倍型 1 中,但 Cascade 不存在该倒位;其起源可追溯至 Brewer's Gold 品种。Brewer's Gold 是杂交品种,由欧洲啤酒花雄株与 1916 年采集自加拿大马尼托巴省(处于北美啤酒花原生分布区)的北美野生雌株(BB1)杂交获得\(^{50}\)(补充图 1)。Brewer's Gold 于 1934 年推出,因 α酸含量高被选育。现代诸多高 α酸啤酒花品种均源自 Brewer's Gold\(^{51}\)(补充图 1)。该倒位在诸多品种中广泛存在,反映现代啤酒花育种所用遗传基础较为狭窄(补充表 1,补充图 1)。
单倍型间生物合成通路的广泛变异
上文所述 Apollo 品种欧洲、北美来源染色体之间存在大量结构变异与序列分化,促使我们在基因层面进一步解析两套单倍型的分化。欧美啤酒花杂交育种的目标是获得更高的苦味物质与香气物质,因此本研究重点关注参与特化代谢通路的基因家族;这类通路生成赋予香气风味的萜类、异戊烯基聚酮类物质,包括酿酒相关的苦味酸,以及具备药用价值的黄腐酚、8异戊烯基柚皮素,涉及的基因家族包括萜类合酶、异戊烯基转移酶、聚酮合酶\(^{5256}\)。本研究的分谱系组装基因组,为解析上述核心代谢通路在欧洲、北美单倍型之间的序列差异、基因拷贝数差异以及表达动态差异提供了研究基础。
对蔷薇目(补充图 1,补充数据 9)与大麻科(补充图 1,补充数据 911)开展基因本体(GO)富集分析,结果显示大麻科特有的基因家族扩张,主要集中在上述具备商业价值的代谢物生物合成通路。该富集结果表明,大麻科内部特化代谢过程发生显著分化,造就了啤酒花复杂的生化代谢特征。
图 5 展示蔷薇目中萜类合酶(TPS) (补充数据 12)、芳香族异戊烯基转移酶(PT) (补充数据 13)、聚酮合酶(PKS) (补充数据 14)基因家族的系统发育树。异戊烯基转移酶分析表明,该基因家族在大麻科内部发生显著分化。Apollo 基因组单倍型 1 编码 10 个 PT 基因位点,单倍型 2 编码 8 个 PT 基因位点;苦味酸合成关键酶编码基因hlpt1 、hlpt2 定位于 X 染色体。分析发现,质体醌相关亚家族在大麻科发生扩张,其中形成一个支持度很高的分支,包含啤酒花与大麻中参与苦味酸、大麻素生物合成的酶。在 III 型聚酮合酶(PKS)\(^{52}\)中,于单倍型 2(欧洲来源)的 09 号染色体上鉴定到此前未报道的查尔酮合酶(chs )基因重复事件,同时还存在另外 4 个chs 同源基因(hlchs25)\(^{52}\),其中 3 个基因在腺毛中表达。
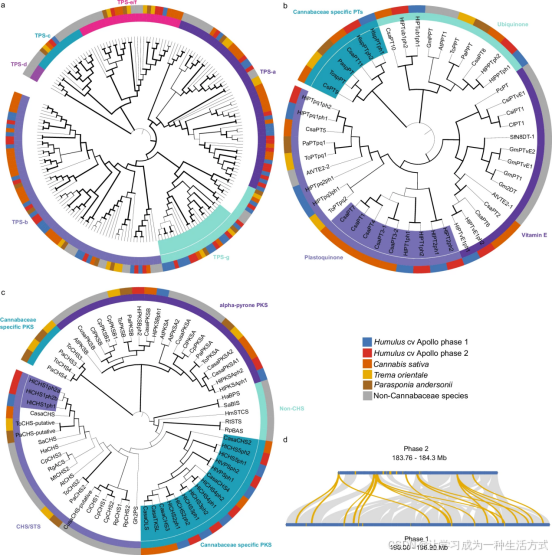
a 基于氨基酸序列构建的萜类合酶(TPS)系统发育树,显示 Apollo 组装单倍型 1 中 TPSg 亚家族一个亚分支发生扩张。对应蛋白序列在内圈旁以青绿色高亮标记。 b 基于氨基酸序列构建的异戊烯基转移酶(PT)系统发育树。参与 α酸、β酸以及大麻素生物合成的 PT 在内圈旁以紫色高亮;大麻科特有分支的 PT 在内圈旁以蓝绿色高亮。 c 基于氨基酸序列构建的植物 III 型聚酮合酶系统发育树。负责合成黄腐酚骨架结构的真正查尔酮合酶(CHS),在 Apollo 单倍型 2(欧洲来源)中发生基因复制,在内圈旁以浅紫色高亮。参与 α酸、β酸与大麻素生物合成的酶归聚于大麻科特有分支,该分支在内圈旁以蓝绿色高亮。 ac 图说明:内圈配色对应系统发育树旁标注的基因家族;外圈颜色代表物种,详见图例。 d 对 01 号染色体两套单倍型上的 TPSg 亚家族(黄色)开展共线性分析,结果表明单倍型 1 中 TPSg 亚家族成员的扩张包含串联基因复制与染色体重排事件。原始数据见补充文件 22。
萜类合酶(TPS)基因家族中,TPSa、TPSb、TPSg亚家族参与啤酒花挥发性风味、香气萜类物质的生物合成\(^{57}\)。Apollo 基因组中 TPSb 与 TPSg 亚家族发生扩张。TPSg 亚家族负责合成构成啤酒花树脂香气的链状单萜与倍半萜,该亚家族在单倍型 1 中拷贝数增多(图 5),并且在 01 号染色体上存在多处串联复制证据(图 5)。补充数据 15 汇总了图 5 系统发育分析涉及的 Apollo 全部基因及其表达量信息。
为在基因组分析基础上补充转录组层面信息,本研究进一步探究:在发育中的啤酒花球果内,两套基因组单倍型是否存在表达显性。跨染色体对,比较各个发育时期每套单倍型的基因表达占比;结果未观察到全基因组水平一致的表达显性效应,两套单倍型整体表达水平基本平衡。仅 chr03、chr05 和 X 染色体表现出统计学显著的表达偏向,偏向单倍型 1(北美来源);但该差异幅度很小,上述染色体中平均仅有 51.3% 的表达基因来自单倍型 1(补充图 1)。
在基因组与单倍型层面分析的基础上,本研究进一步探究球果发育过程中基因调控如何塑造代谢物积累。对球果 5 个发育时期开展共表达分析,得到 4 组具有不同时间表达模式的差异表达基因集(DEG)(图 6,补充注释 1)。将基因集与同批样品非靶向代谢组的代谢物丰度数据做关联分析(图 6,补充注释 1)。得到的关联网络揭示了球果发育过程中动态的 "代谢转录" 调控格局:来自第 2、4 基因簇的差异表达基因与多种挥发性化合物(VC)、非挥发性化合物(NVC)家族的相关性逐步升高。这种关联可追溯至具体基因:生成风味香气萜类与苦味酸的生物合成通路关键步骤,随球果发育进程基因表达持续上调,在开花后 23 周达到表达峰值(图 6)。基因转录激活之后,对应代谢物丰度随之上升,说明啤酒花特化代谢物的合成受转录水平调控。部分萜类合酶的表达在开花后 23 周达到峰值而后下降,但对应的萜类物质含量却持续升高至发育后期;与之不同,苦味酸中的葎草酮与蛇麻酮,会随基因表达下调而含量趋于稳定。
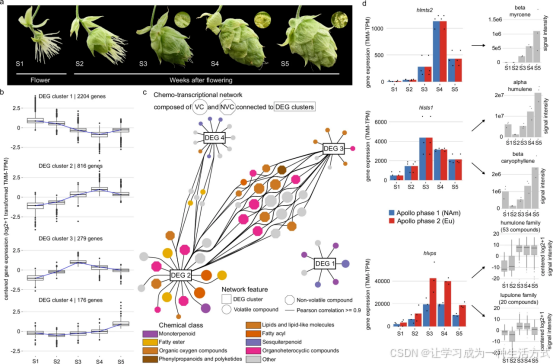
a 啤酒花球果的 5 个发育时期:S1 为开花期,S2~S5 分别为开花后 1~4 周(WAF)。插图展示腺毛(蛇麻腺),是特化代谢物合成与储存的主要场所。转录组分析时,将球果组织拆分为腺毛与苞片 / 小苞片两类样本。 b 球果发育过程中具有相似时间表达模式的差异表达基因(DEG)簇。基因表达量采用中心化 log₂(x+1) 转换、TMM 校正后的 TPM 值(TMMTPM);每个图上方标注基因数目(n=3 个生物学重复)。 c 代谢转录关联网络:4 个差异基因簇(矩形节点,DEG1--4)与挥发性化合物(VC,圆形节点)、非挥发性化合物(NVC,八边形节点)化学类别的相关性。连线代表≥5% 的差异基因与对应代谢物呈显著正相关(Pearson 相关系数≥0.9)。 d 球果发育过程代谢物与基因转录的关联(n=3 生物学重复),示例为参与主要挥发性物质合成的基因:hlmts2 (啤酒花月桂烯合酶 2)、hlsts1 (啤酒花葎草烯合酶 1);以及非挥发性物质合成基因hlvps1 (啤酒花戊二烯酮合酶 1)。hlmts2 与hlsts1 为纯合基因,两个等位基因表达量一致,无法区分等位基因特异性表达;而hlvps为杂合基因,可以观测到等位基因间的表达差异。 b、d 箱线图说明:中线代表中位数,箱体上下边界为第 25、75 百分位数(四分位距 IQR);须线延伸至上下四分位 ±1.5 倍 IQR 范围内的最大、最小观测值;超出须线的数据点单独标记为离群值。缩写:NAm 北美;Eu 欧洲。原始数据见补充文件 22。
基因表达水平和代谢物丰度未必存在相关性:因为同一通路的转录本常协同调控,且代谢物往往会发生转化与转运以行使生物学功能\(^{58}\)。但本数据集里一条与初级代谢相关的发现,可为后续研究提供重要线索:我们分析了甲羟戊酸(MVA)途径与 2C甲基D赤藓醇4磷酸(MEP)途径的基因表达(补充数据 16)。这两条途径生成异戊烯焦磷酸(IPP)与二甲基烯丙基焦磷酸(DMAPP),二者是啤酒花中所有萜类和苦味酸合成必需的 C5 骨架单元\(^{56,59}\)。 定位于质体的 MEP 途径与单萜合成、苦味酸异戊烯基化过程共定位;该途径基因在球果发育阶段存在差异表达,多数呈现 DEG3 那种先升后降的瞬时变化模式。与之相反,位于细胞质、参与倍半萜合成的 MVA 途径基因表达稳定。这种表达分化,可通过持续供给前体物质,支撑 α葎草烯、β石竹烯等倍半萜在球果发育后期持续积累(图 6)。代谢转录关联网络(图 6)进一步印证该规律:各类倍半萜的丰度变化,匹配 DEG1、DEG4 基因表达缓慢上升或逐步下降的模式;而其他化合物(尤其是氧化萜、苦味酸衍生物这类非挥发性脂类物质)的含量波动更大。
北美与欧洲单倍型对 α-酸含量的影响
上述单倍型之间的显著分化,不仅反映二者迥异的演化历史,也提示它们对重要农艺性状的贡献可能存在差异。然而,以往基于群体的 α酸含量研究,无法追溯优良等位基因源自哪一类祖先谱系\(^{60,61}\)。针对该问题,本研究利用 Apollo 单倍型分辨基因组开展全基因组关联分析(GWAS),定位与 α酸含量升高相关的基因组区域,并追溯其属于欧洲还是北美祖先来源。
GWAS 分析理论上优先选用单一单倍型参考基因组,减少变异检出的冗余与不一致。但 Apollo 分相组装得到的两套单倍型,均无法单独作为关联分析的最优参考:Apollo × PubM_740 分离群体的染色体祖先比例约为北美∶欧洲 = 1∶3(图 1,补充图 1),因此使用以欧洲来源为主的单倍型 2 作为参考,更贴合该群体遗传背景。但群体中频度本身偏低的北美特有变异,比对到单倍型 2 时效率较差(补充图 1),会进一步降低关联分析的统计效力。因此本研究分别采用两套单倍型作为参考,独立开展两次 GWAS。
以单倍型 2 为参考的 GWAS 结果显示:在 08 号染色体上鉴定出一段约 30 Mb 的显著关联区域;该区域位于北美来源的 chr08.1 染色体上,包含一段 26 Mb 的欧洲渐渗片段,关联雌性个体的 α酸含量升高(图 7),为唯一主效关联位点;该渐渗片段内部未检测到重组事件。以单倍型 1 为参考的 GWAS,同样检出该区域,还在 05 号、09 号染色体发现额外显著关联信号(图 7),证明两套单倍型参考基因组能够提供互补信息。依次使用两套单倍型作为参考,挖掘与 β酸含量相关的基因组区域,同样得到互补的结果(补充图 1)。以上结果印证我们最初的设想:必须同时使用两套参考基因组,才能完整解析优良性状关联的基因组区域。
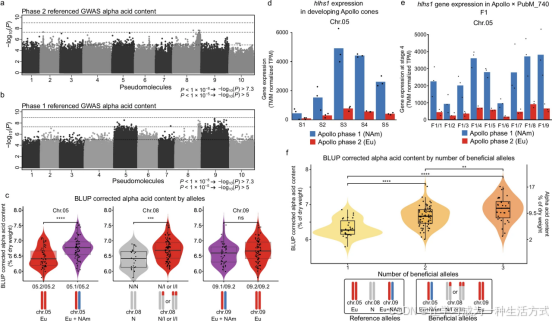
a 以单倍型 2 为参考开展 α酸含量全基因组关联分析(GWAS)(n=131);b 以单倍型 1 为参考开展 α酸含量 GWAS(n=126)。采用线性混合模型(双侧检验),Bonferroni 校正阈值 α=0.05(虚线)。 c 采用双侧 Wilcoxon 秩和检验,并经 BenjaminiHochberg 错误发现率(BHFDR)校正,比较各组 α酸最佳线性无偏预测值(BLUP)差异(chr05:n=55 vs 73,P=1.3×10⁻⁵;chr08:n=26 vs 102,P=7×10⁻⁴;chr09:n=45 vs 83,P=0.114)。 d 球果发育阶段(S1--S5)hlhs1(啤酒花葎草酮合酶 1)的等位基因特异性表达:北美来源等位基因表达量高于欧洲来源等位基因(n=3 生物学重复)。 e 该表达模式在 Apollo × PubM_740 的 F₁代雌性个体中同样存在(n=3 生物学重复)。 f 按携带优良等位基因数量(1、2 或 3 个)分组,性状存在显著差异(Kruskal--Wallis 检验 P=3.6×10⁻⁸);组间两两比较采用双侧 Wilcoxon 秩和检验并 BHFDR 校正(1 个 vs 2 个:n=27 vs 66,P=4.2×10⁻⁶;1 个 vs 3 个:n=27 vs 33,P=1.2×10⁻⁷;2 个 vs 3 个:n=66 vs 33,P=0.006)。 c、f 小提琴图展示数据分布,散点代表单个样本;箱线图中线为中位数,箱体边界为 25%~75% 分位数,须线延伸至 1.5 倍四分位距;本图所有组须线恰好对应最大值与最小值。小提琴图使用不同颜色便于区分。 c--f 基因型缩写:Eu 欧洲;NAm 北美;N 无渐渗;I 存在渐渗。原始数据见补充文件 22。
本研究进一步精细解析这些关联区域,阐明其调控 α酸含量的机制。针对 08 号染色体上鉴定到的欧洲渐渗片段,对 Apollo × Pub_M740 群体个体开展基于 kmer 的分析,划分出 3 个基因型类群,分别对应携带 0、1、2 份欧洲渐渗片段的个体,符合 1:2:1 分离模式。携带 1 份或 2 份渐渗片段的个体 α酸含量显著更高,说明该性状为显性遗传(补充表 1,补充图 1,图 7)。补充数据 17 列出 chr08.1 渐渗区域内全部基因信息:该区域共预测 514 个基因;其中 73.5% 在两套单倍型间为直系同源基因,25.5% 为旁系同源或分化位点,说明该区域整体进化保守,同时存在近期或正在发生的分化信号。 该渐渗片段内未发现已知直接参与 α酸生物合成的结构基因,但包含多个调控基因,其中基因为 HUMLU.APOL.r2.08P1G2339100,编码转录因子 HlWRKY1。HlWRKY1 可与 HlWDR1 形成二元复合物,激活异戊烯基黄酮与苦味酸生物合成下游步骤相关基因;该二元复合物还可进一步组装形成三元 MBW 转录因子复合物,调控同一通路中更上游基因的表达\(^{62,63}\)。
由于 chr08.1 的欧洲渐渗片段在两套单倍型参考的 GWAS 中均稳定呈现主效关联,且该区域含有苦味酸、异戊烯基黄酮合成通路关键调控因子,本研究结果表明该区域是决定 α酸含量的核心位点。早期连锁定位研究同样在 Magnum 品种中定位到该区域,其与稳定升高的 α酸含量相关;报道的标记序列(AY588355.1、AF515719.1)恰好落在 chr08 的欧洲渐渗区域内。Magnum 品种源自 Galena 品种\(^{23}\),而 Galena 正是 Apollo 谱系的亲本之一(图 1),证明 chr08.1 欧洲渐渗片段在现代高 α酸啤酒花品种育种中发挥核心作用。
在 05 号与 09 号染色体上还发现另外两个与 α酸含量相关的基因组区域,关联信号覆盖整条染色体。Apollo × PubM_740 群体中 chr05 为北美欧洲杂合基因型个体,其 α酸含量高于欧洲欧洲纯合个体(图 7)。由于该关联区间跨度大,仍需进一步研究锁定高置信度靶基因;但该染色体上存在编码单加氧酶的HlHS1 与HlHS2 基因(补充图 1)。近期实验证据证实\(^{64}\),HlHS1 负责催化脱氧葎草酮氧化生成葎草酮,是 α酸合成的最后一步。本研究发现hlhs1 存在北美等位基因表达显性(图 7);对 9 株hlhs1位点为欧美杂合基因型的 Apollo × PubM_740 F₁个体发育球果开展 RNAseq,再次验证北美等位基因优先表达(图 7)。
chr09 为北美欧洲杂合基因型个体相比欧洲欧洲纯合个体,α酸含量同样存在差异(图 7),但该直接比较差异不显著。原因可能是群体中缺少北美北美纯合基因型个体(Apollo 亲本为欧美杂合,PubM_740 为欧欧纯合),也可能是对照组个体携带其他优良等位基因。chr09 的关联信号与前人报道的 Nugget 品种中提升 α酸含量的 SRR 标记 3a88219(AY382854.1)以及 AFLP 标记结果一致\(^{39}\)。chr09 携带编码 VPS1 酶的基因,VPS1 催化苦味酸生物合成通路第一个不可逆关键步骤\(^{56}\)。
基于上述结果,本研究进一步探究两套 GWAS 检出的基因组区域是否对 Apollo × PubM_740 群体 α酸含量存在加性效应。结果证实存在显著加性效应:个体携带 1、2 或 3 个优良等位基因时,α酸含量随优良等位基因数量增加而显著上升(图 7)。该结果证明,北美与欧洲来源优良等位基因的组合直接决定 α酸含量,而 α酸是啤酒花育种中最具商业价值的性状。此外,研究结果强调,解析单倍型的物种祖先来源十分关键,有助于理解种间杂交如何影响育种中的核心农艺性状。
讨论
啤酒花 Apollo 品种的单倍型分辨分相组装基因组,是现代基因组技术应用于啤酒花研究的重要突破,也证明单倍型水平组装在植物基因组研究中的巨大价值。以往研究多为单倍体草图组装\(^{13,14}\),与之相比,本研究的单倍型分辨体系,能够将单个染色体或基因组片段的欧洲、北美祖先来源,和高 α酸这一啤酒花核心农艺性状关联起来。本研究证实,种间育种主要通过整条染色体重组实现性状重塑;同时鉴定出 chr08、chr05 上特定的欧洲、北美单倍型,二者可加性提升 α酸含量。这表明,定向选择特定谱系基因组片段,可用于啤酒花农艺性状改良。 另外,现代啤酒花品种遗传基础狭窄,且欧洲与中东啤酒花类群之间分化显著,提示需要充分挖掘啤酒花属基因资源,培育气候适应性更强、产量更高的新品种。因此,Apollo 基因组不仅为基于单倍型选择(而非单纯开发分子标记)设计啤酒花育种策略提供理论依据,也提供了实践基础。
借助 Apollo 基因组的单倍型分辨组装,本研究进一步解析啤酒花复杂基因组的精细结构与遗传架构,有助于加深农艺性状的遗传机制理解,最终支撑等位基因变异、拷贝数变异、基因存在缺失变异以及等位基因特异性表达等方向的研究。本研究解析了不同啤酒花材料之间,各类高价值代谢物合成基因与通路的遗传多样性差异 ------ 这些代谢物正是啤酒花最重要的品质基础。Apollo 基因组中两个啤酒花谱系基因集的完整注释,将推动后续泛基因组、泛转录组与泛代谢组的整合研究,助力挖掘和解析上述代谢通路\(^{65}\),最终指导育种获得黄腐酚、8异戊烯基柚皮素等高价值代谢物含量优化的啤酒花品种。定向挖掘啤酒花属遗传多样性以改良农艺与生化性状,有望推动啤酒花的应用突破传统酿酒行业。
材料与方法
植物材料
本研究构建了啤酒花Humulus cv. Apollo 的染色体水平、单倍型分辨分相基因组组装\(^{22}\)。测序所用植株种植养护于美国华盛顿州亚基马市 S.S. Steiner 公司金门牧场实验苗圃,遵循常规农艺栽培条件(北纬 46.30211°,西经 120.076365°)。
核型分析
有丝分裂染色体制备
从长势旺盛的 Apollo 植株采集 25 mm 幼嫩叶片。叶片使用 0.002 M 8羟基喹啉预处理 4 h(室温 2 h,4 ℃避光条件下 2 h);随后置于克拉克固定液(乙醇∶冰乙酸 = 3∶1,体积比)中 4 ℃过夜固定,之后用于染色体制片。 固定后的叶片依次用蒸馏水洗涤 1 次,每次 5 min;45% 乙酸洗涤 1 次,每次 5 min;0.001 M 柠檬酸缓冲液洗涤 2 次,每次 5 min。置于用 0.001 M 柠檬酸缓冲液配制的 1% 复合酶解液(1% 果胶裂解酶 P3026,SigmaAldrich;0.75% 离析酶 R10,DuchefaBiochemie;0.75% 纤维素酶 219466,SigmaAldrich;1% 细胞裂解酶 C8274,SigmaAldrich)中,37 ℃酶解 50 min。酶解完成后置于 60% 乙酸中压片。 挑选分裂相保存完好的中期制片液氮冷冻,镊子揭去盖玻片。制片使用新鲜配制的克拉克固定液处理 1 次,5 min;可直接用于荧光原位杂交(FISH),或浸泡于 96% 乙醇20 ℃保存备用。
以 Apollo 基因组 DNA 为模板,使用特异性引物扩增啤酒花亚端粒重复序列 HSR(GU831574.1)与 45S rDNA 序列(AF223066.1)\(^{66}\)。
HSR 引物:HSR_F TAAGGCTCCGTTTCGACTCC + HSR_R AACTTTTGTGCCCATGACCC 45S rDNA 引物:45S_rDNA_F TGCCCGTTGCTCTGATGATT + 45S_rDNA_R TCCACCAACTAAGAACGGCC
PCR 产物采用 QIAquick(Qiagen)PCR 纯化试剂盒纯化。参照德国耶拿生物的荧光缺口平移标记试剂盒说明书对纯化 DNA 进行探针标记:HSR 探针标记 Cy3 荧光染料,45S rDNA 探针标记荧光素染料。
参照已发表方法,采用 77% 严谨度条件开展有丝分裂中期染色体 FISH 杂交\(^{67}\)。DAPI 对染色体复染,Vectashield 抗荧光淬灭封片剂封片。使用配置制冷相机的 Olympus AX70 落射荧光显微镜采集图像;Adobe Photoshop 2023 处理图片。
啤酒花属物种地理分布
从全球生物多样性信息平台 GBIF 下载 6 套物种分布数据集(对应 6 个 DOI 链接),基于坐标信息过滤得到衍生数据集。过滤合并后的数据集存放于 Zenodo\(^{68}\),同时注册为 GBIF 衍生数据集\(^{69}\)。 仅保留与《世界植物在线》(POWO) 记载的各物种原生分布区相匹配的分布记录点\(^{8}\)。为避免点位重叠、降低图面复杂度,经纬度坐标四舍五入至 0.25°,删除坐标完全重复的点位。使用 Python 的 Cartopy(v0.25.0)绘制地理分布图\(^{70}\),底图素材来源于 Natural Earth。
基因组大小评估
取自 Apollo 的 450 bp 无 PCR 文库测序得到 250 bp 双端读段(见双亲本群体部分),基于 kmer 策略估算基因组大小。使用 KMC(v3.2.1)软件从原始读段提取 101 bp kmer 序列,kmc_tools 生成 kmer 频数直方图\(^{71}\)。在 R 语言环境中使用 findGSE 包,拟合杂合度模型,依据直方图估算基因组大小\(^{72}\)。
PacBio HiFi 文库构建与测序
DNA 提取:采集同一株 Apollo 幼叶,液氮快速冷冻,寄送至合作服务商(美国博伊斯・汤普森研究所 Polar Genomics 平台)。 参照已发表方法从植物细胞核提取高分子量基因组 DNA\(^{73}\):取约 20 g 冷冻叶片,置于预冷的裂解缓冲液(10 mM 三羟甲基氨基甲烷碱,80 mM 氯化钾,10 mM EDTA,1 mM 亚精胺,1 mM 精胺;pH 9.49.5;添加 0.5% Triton X100、0.15% β巯基乙醇)中匀浆;经过滤、差速离心、多次洗涤获得纯化细胞核。将细胞核包埋于 1% 低熔点琼脂糖块;置于 0.5 M EDTA(pH 9.09.3)、1% 十二烷基肌氨酸钠、0.1 mg/mL 蛋白酶 K 体系,50 ℃裂解 24 h。琼脂糖包埋的 DNA 经 EDTA 洗涤后 4 ℃保存待用。
分别采用分光光度计(ND1000,NanoDrop)与 Qubit 2.0 荧光定量仪检测 DNA 浓度与质量;260/280 比值 1.821.84,230/260 比值 1.72.16。
在英国诺里奇厄勒姆研究所,使用 SMRTbell Express Template Prep Kit 2.0 试剂盒构建 PacBio HiFi(CCS,环形一致序列)文库。简要流程:取 26 μg 基因组 DNA,Megaruptor 3 仪器按照说明书手动片段化;每份片段化 DNA 经 AMPure PB 磁珠纯化浓缩,再进行文库构建。文库严格按照 PacBio HiFiprotocol version 03 流程制备;使用 SageELF 片段分选系统搭配 0.75% 胶盒进行片段筛选。Qubit™3.0 荧光仪定量文库;FEMTO Pulse 检测片段分布。
使用 PacBio SMRTLink Binding Calculator v9.0.0.92017 计算上样参数;测序引物 v2 退火结合 HiFi 文库接头;Sequel II Binding Kit v2.0 将聚合酶结合文库;引物、聚合酶结合比例使用该文库类型默认参数。测序前向每个文库中加入标准浓度 Sequel II DNA 内参。测序试剂为 Sequel II Sequencing Plate 2.0,仪器软件版本 v9.0.0.92233。
文库上机 5 个 Sequel II SMRT 8 M 芯片;测序参数:扩散上样模式,单芯片采集时长 30 h,固定时间 2 h,预延伸时间 4 h,芯片上样浓度 3080 pM。使用 PacBio CCS 软件输出 CCS 一致读段(开源地址见原文链接)。
Hi-C 文库构建
染色质构象捕获测序(HiC)文库按照已发表方法制备\(^{74}\),仅在细胞核分离以及 HiC 文库最终片段筛选步骤做了修改。采集 1.5 g 叶片,采用甲醛进行交联处理\(^{74}\)。细胞核分离:将交联后的叶片置于预冷(−80 ℃)研钵中充分研磨成细粉;粉末转入 50 mL 离心管,加入 30 mL 匀浆缓冲液(10 mM EDTA、10 mM TrisCl、80 mM KCl、0.5 M 蔗糖、0.1 mM PMSF、0.1%(体积分数)β巯基乙醇、1 μg/mL 抑肽酶、1 μg/mL 亮抑酶肽、1 μg/mL 胃蛋白酶抑制剂,pH 9.4)。悬液置于冰上,用 5 mL 移液管吹打混匀;再加入 2 mL 缓冲液(10 mM EDTA、10 mM TrisCl、80 mM KCl、0.5 M 蔗糖、20%(体积分数)Triton X100,pH 9.4),5 mL 移液管吹打混匀,冰上静置 20 min。 4 ℃冷室条件下,样品通过漏斗内的 Miracloth 滤膜与 Sefar Nitex 滤膜过滤以分离细胞核\(^{74}\);3000 g、4 ℃离心 15 min 收集细胞核,弃上清,使用宽口吸头加入 350 μL 预冷 NIBPD 缓冲液重悬沉淀\(^{74}\);若 350 μL 缓冲液不足以完全重悬沉淀,则补加 350 μL 预冷 NIBPD 缓冲液。取 2 mL 离心管,加入 1 mL 预冷 NIBPD 缓冲液作为底层垫液,缓慢铺入 350 μL 细胞核悬液;16000 g、4 ℃离心 1 h 纯化细胞核;宽口吸头吸取 500 μL RE 缓冲液重悬沉淀\(^{74}\)。1900 g、4 ℃离心 5 min 收集细胞核,宽口吸头加入 150 μL 0.5% SDS 进行重悬。用宽口吸头分装为 50 μL 体系,分装至 3 支 2 mL 离心管,62 ℃孵育 7 min。每管加入 145 μL 水与 25 μL 10% Triton X100,37 ℃、350 rpm 振荡孵育 15 min。 采用 DpnII 限制性内切酶酶切,后续操作参照已发表文献。HiC 文库片段筛选使用 AMPure XP 磁珠。简要流程:合并所有 PCR 产物,加入等体积 AMPure XP 磁珠,按照厂家(美国贝克曼库尔特)标准方案沉淀 DNA;使用 27 μL EB 缓冲液从磁珠上洗脱 HiC 文库。文库定量后,使用 Illumina HiSeq 2500 平台按照 Illumina 标准方案进行双端测序(2×100 bp)\(^{74}\)。本部分实验在德国加特斯莱本莱布尼茨植物遗传与作物研究所(IPK)完成。
单倍型基因组组装与共线性分析
使用 hifiasm(v0.15.1)默认参数对 CCS 读段进行组装\(^{24}\),采用主 contig 序列构建单倍型基因组。啤酒花属于高杂合物种,主 contig 组装时,大部分纯合、完全一致的序列会被合并;而杂合区域分化程度高的 contig(等位 contig)无法合并,直观表现为组装总长度大于预期单倍型基因组大小。构建单倍型基因组的目的就是剔除这类等位 contig,将剩余 contig 组装成假染色体。 假染色体构建采用 TRITEX 流程\(^{26,27}\)。首先利用 minimap2(v2.17)将啤酒花遗传图谱标记比对至主 contig 组装结果,构建指导图谱\(^{75}\);再利用 HiC 数据识别等位 contig、拆分嵌合序列、对 contig 进行排序,生成单倍型假染色体。Contig 排序包含人工校正:使用 HiCinspector 可视化 HiC 互作矩阵,依据 HiC 互作信号调整 contig 顺序\(^{76}\)。采用 BUSCO(v5.1.2),基于陆生植物数据库 embryophyta_odb10 的单拷贝直系同源基因评估组装完整性\(^{77,78}\)。将 HiC 读段比对至最终组装基因组,使用 HiCPlotter 绘制 HiC 互作热图,评估基因组连续性\(^{79}\)。 单倍型组装的假染色体命名参照大麻基因组 cs10 版本:使用 gmap(20190912 下载)将大麻 cs10 转录本序列比对至啤酒花单倍型基因组\(^{29,80}\);统计大麻每条染色体上基因模型比对到啤酒花某条假染色体的最高占比,将对应编号赋予啤酒花该假染色体。 通过基因组间比对评估 Apollo(本研究)与 Cascade 啤酒花单倍型基因组之间的共线性。使用 minimap2(v2.24)将 Cascade 组装的假染色体比对到 Apollo 单倍型染色体;提取长度≥2000 bp 的主比对结果,在 R 语言环境绘制点图可视化共线性关系\(^{81}\)。
啤酒花分相基因组构建
本研究使用 hifiasm(v0.16)\(^{24}\)、ALLHiC\(^{25}\)以及 TRITEX\(^{26,27}\)流程构建 Apollo 啤酒花的分相基因组。为降低低质量读段带来的假阳性重复序列,使用 ccs(v6.0.0)软件,采用更严格参数(--min-rq 0.99,--min-passes 3)从 PacBio 亚读段提取 CCS 读段。将 HiFi 读段与双端 HiC 数据输入 hifiasm(v0.16)默认参数,得到分相 contig 组装结果\(^{24}\)。已有文献报道,分相 contig 组装的两套 contig 经常混杂在一起,构建假染色体前必须按照相位进行分离\(^{24}\)。因此采用 ALLHiC 流程完成分相 contig 拆分。 首先合并 hifiasm 输出的两套相位 contig;将啤酒花单倍型基因组的基因模型(见基因组注释部分)通过 gmap 比对到合并后的分相 contig 集,提取每个基因模型比对得分最高的两条 contig,认定为该基因的等位 contig。结合等位 contig 信息与 HiC 数据,使用 ALLHiC 流程将 contig 划分至每条染色体的两个相位。采用 3DDNA 流程的run-assembly-visualizer.sh脚本绘制两套相位 contig 的 HiC 互作矩阵\(^{82}\),使用 Juicebox 可视化\(^{83}\);基于 HiC 互作热图人工拆分两套相位,在 Juicebox 中调整 contig 顺序,保证互作信号沿对角线连续。最后分别提取两套相位的全部 contig,使用 TRITEX 流程,参照前述方法分别构建两套相位的假染色体\(^{26,27}\)。
分相组装相位切换错误评估
相位切换错误定义:单个碱基被错误分配至另一套相位。使用 calc_SwitchErr 流程计算分相基因组中发生相位切换的碱基占比\(^{25}\)。简要流程:使用 minimap2(v2.17)将 Apollo 450 bp 无 PCR 文库双端读段比对至相位 1 组装结果,使用 bcftools(v1.11)流程变异检测\(^{84}\);同时使用 minimap2(v2.17,参数 --secondary=no,保留每条读段最优比对)将 PacBio HiFi 读段比对相位 1,得到 BAM 文件;使用 WhatsHap 基于双端读段检出的 SNP 进行相位分型\(^{84}\),提取带有 PS 标记的分相 SNP 作为真实参考分型 SNP。 使用 minimap2(v2.17)比对两套相位基因组;通过 RagTag 的 paf2delta 函数将 PAF 比对文件转换为 delta 文件\(^{85}\),再用 MUMmer(v4.0)delta-filter 过滤(参数 - i 90,-l 1000)\(^{86}\);使用 MUMmer(v4.0)show-snps(参数 - Clr)基于过滤后的 delta 文件检测 SNP。对比组装得到的分型 SNP 与真实参考分型 SNP,计算不一致 SNP 的占比。
串联重复注释与家族聚类
使用 TandemRepeatFinder(v4.09.1)默认参数识别串联重复序列\(^{87}\)。软件输出结果存在重叠注释:当长重复单元得分更高时,同一区域会同时输出多种不同单元长度的重复(如 20 bp、40 bp、80 bp)。本研究优先保留更长区间注释,截断后续短区间注释,去除重叠条目。从 TandemRepeatFinder 输出的每条一致序列提取代表单元序列;原因是即使序列几乎完全相同,串联重复区域的起始位置会发生偏移。举例:三碱基单元 TGC-TGC-TGC-...,偏移 1 bp 会产生 TGC、GCT、CTG 三种单元;其反向互补序列 GCA-GCA-GCA-... 得到 GCA、CAG、AGC。本研究将所有可能单元按字母排序,取第一条作为代表单元(本例为 AGC)。 使用 vmatch dbcluster(v2.3.0)对代表单元序列聚类。挑选规模最大的 200 个重复家族,在染色体上以 500 kb 窗口绘制其成员位置。大部分家族的成员在两套相位基因组间均匀分布;部分重复家族定位于着丝粒;少数家族表现出显著的亲本偏好,只富集于其中一套亲本来源的相位。
基于 k-mer 的亲本溯源
利用上述亲本特异性串联重复簇的染色体位置,对基因组组装序列进行粗略的亲本来源划分。为获得高密度亲本特异性标记,以这些序列窗口作为输入,鉴定在某一个亲本中高拷贝富集的 k-mer 序列。使用 tallymer 统计 20、30、40、50 长度 k-mer 的丰度\(^{88}\);筛选标准:亲本 1 来源窗口 k-mer 丰度≥400,亲本 2 来源窗口 k-mer 丰度≥250;同时 k-mer 的 log2 倍数变化绝对值≥4.25。通过三步流程将染色体区域分配至对应的亲本:(1) 将 a1、a2 两套 k-mer 文库比对至组装基因组,标记 a1、a2 特异性位点;(2) 每条染色体划分为 500 kb 窗口,计算窗口内 a1/a2 碱基覆盖的 log2 倍数比值;(3) 基于 log2 倍数变化的过零点,标注亲本来源的大致坐标(精度约等于窗口大小)。 第 (1) 步使用 vmatch 分别比对两套相位基因组,仅保留 k-mer 完全匹配;为提高比对效率,使用 vmatch 将非目标碱基屏蔽为虚拟碱基 Z,从 Z 标记位置提取注释坐标。第 (2) 步将每条染色体切分为近似等长窗口以消除边界效应。原始 log2 比值分为:正值(a1 碱基 > a2 碱基)、负值(a1 碱基 < a2 碱基)、无穷大(a2 碱基 = 0)、负无穷(a1 碱基 = 0)、0(a1 碱基 = a2 碱基);窗口≥500 kb 时不会出现 a1、a2 碱基均为 0 的情况。可视化时,正负无穷值分别替换为略大于全局最大值、略小于全局最小值的值(int (max log2 fold +0.5)+0.1;int (min log2 fold −0.5)−0.1)。第 (3) 步筛选亲本来源大片连续区域:仅当窗口内至少包含 50 bp a1 或 a2 标记序列时,才判定为 log2 比值的有效过零点。该生物信息学方法无需额外亲本测序数据(传统 trio binning 需要),即可对 Apollo 基因组染色体区段完成亲本溯源。
两套相位同源序列一致性计算
参照已发表方法计算分相基因组同源染色体间的序列一致性\(^{89}\)。简要流程:使用 minimap2(v2.22)将相位 2 假染色体比对至相位 1 假染色体;提取长度≥10 kb 的主比对结果,计算序列一致性百分比(公式 1)。在 R(v4.3.1)环境,以 500 kb 窗口的序列一致性中位数沿染色体绘制分布图。
Apollo 两套相位的亲本来源判定
采用覆盖度分析判定 Apollo 两套相位的亲本起源\(^{90}\)。收集啤酒花(H. lupulus )、H. lupuloides 、H. neomexicanus以及现代栽培品种代表性材料,开展 GBS 简化基因组测序。使用 cutadapt(v3.5,Python3.9)去除接头与低质量碱基,保留≥30 bp 的读段\(^{91}\)。研究发现 chr02、chr07、chr08 这三条染色体在两套相位间相似度很高;因此构建一个合并参考基因组:全部采用相位 1 染色体,相位 2 仅保留 chr02、chr07、chr08 以外的染色体。使用 minimap2(v2.24)将每个材料高质量读段比对到该合并参考基因组\(^{75}\);minimap2 输出管道送入 samtools(v1.15)转为 BAM 文件,再使用 NovoSort(v3.01.06)排序\(^{92}\)。从每个材料 BAM 文件中统计 5 Mb 窗口内的读段数目;窗口读计数先对测序深度归一化,再对 Apollo 自身同一窗口的读计数归一化。归一化计数值取对数,在 R(v4.0.2)绘制全基因组覆盖度图。补充图上方:分别计算 4 份北美材料(Neomex、14、15、US wild15、16)与 2 份欧洲材料(Eu feral、13、14)窗口归一化计数均值,绘制北美 / 欧洲 log2 倍数差异。
啤酒花属与大麻属的共线性与直系同源框架
为构建 Apollo 基因组的共线性、直系同源分析框架,下载公开的两个啤酒花品种 Cascade\(^{13}\)、Saaz\(^{36}\)以及大麻(Cannabis sativa)基因组\(^{49}\)。提取每个基因位点最长蛋白异构体作为代表序列,记录基因组坐标。使用 GENESPACE v1.3.1,调用 10 个 CPU,其余默认参数完成直系同源推断、共线性检测与可视化;按照 GENESPACE 绘图教程调整图面布局。全部输入文件与结果(含 R 工作空间文件)均已上传,保证分析可重复、便于复用\(^{93}\)。
结构变异(SV)鉴定与验证
以 Apollo 相位 1 假染色体为参考,鉴定基因组结构变异,方法参照文献\(^{94}\)。首先使用 minimap2(v2.24)将相位 2 假染色体比对至相位 1 染色体;使用 RagTag 脚本ragtag_paf2delta.py将 PAF 文件转为 delta 文件\(^{85}\),MUMmer(v3.23)delta-filter 过滤短片段、低质量比对\(^{95}\);MUMmer show-coords将 delta 转为 tsv,再用 SyRI 流程鉴定结构变异\(^{96}\)。 将 CPL、DEL、DUP/INVDP(缺失型)以及 NOTAL、TDM 内相位 1 序列归为缺失型 SV;CPG、INS、DUP/INVDP(获得型)以及 NOTAL、TDM 内查询序列归为获得型 SV;INV 为倒位;TRANS、INVTR 均归为易位 SV。使用 plotsr 包可视化结构变异\(^{97}\)。 采用 PCR 验证两套相位 chr06 染色体之间一段 85 Mb 的倒位。提取倒位两端断点上下游各 5 kb 序列;相位 1 断点坐标:54,872,166 bp 与 140,780,292 bp;相位 2 断点坐标:54,764,504 bp 与 134,556,775 bp。对提取的 4 段序列互相做 blastn 比对\(^{98}\),设计引物特异性扩增相位 1 上包含倒位断点的 2.107 kb 片段(Phase1-ini06-F3137:TTTATGGCAAGGAAGCAGTCGTTT;Phase1-ini06-R5243:TGGAGGGAAAGTATTGCAAATGAGA)。 使用丹麦 VWR UNO PCR 仪,Promega GoTaq G2 DNA 聚合酶试剂盒,按照说明书配制 PCR 体系;模板为系谱中各材料干燥叶片或球果,使用 Qiagen DNeasy 植物小提试剂盒提取基因组 DNA。扩增程序:95 ℃预变性 3 min;30 个循环:95 ℃ 1 min,55 ℃ 1 min,72 ℃ 1 min 30 s;72 ℃终延伸 5 min。PCR 产物使用 2% 琼脂糖凝胶电泳(美国 Invitrogen)检测。Apollo 扩增产物使用 Merck GenElute™ PCR 纯化试剂盒纯化,交由欧洲 Macrogen 公司 Sanger 测序验证序列。每个材料设置阳性对照,使用 contig18 引物对(F: TCATCAGCAGGTGGGTCAGGCA;R: TCCGCACTTCTCTCACAGGCGA)验证 DNA 完整性\(^{99}\)。
单倍型组装蛋白编码基因注释
第一步,将转录组数据的证据以及近缘物种同源信息整合至植物基因组与系统生物学(PGSB)基因注释流程。基于同源性的基因注释:将 UniProt 蛋白库(包含 21802 个蔷薇类物种蛋白,外加森林草莓、八倍体草莓、桃、月季、大麻、拟南芥 TAIR10 版本蛋白)合并构建参考蛋白库 AnnoDB;使用可变剪接感知比对软件 GenomeThreader(v1.7.1)将蛋白序列比对至单倍型组装参考基因组,参数:-startcodon -finalstopcodon -species rice -gcmincoverage 70 -prseedlength 7 -prhdist 4\(^{100}\)。
证据支持注释部分:使用多套 RNA-seq 数据集(补充数据\(^{8}\))开展基因组导向的基因结构(外显子内含子)预测。RNA-seq 读段采用 Trimmomatic(v0.39.2)进行修剪\(^{101}\);修剪前后均用 FASTQC(v0.11.9)做质控\(^{102}\)。全部 RNA-seq 读段使用 STAR(v2.7.8a,参数alignIntronMax=50000)比对参考基因组\(^{103}\),再用 Stringtie2(v2.1.5,参数-m 150 -t -f 0.3)组装转录本\(^{104}\)。采用 Transdecoder(v3.0.0)识别潜在开放阅读框(ORF)并预测蛋白序列。将预测蛋白序列与 UniProt 木兰亚纲已审库(Swiss-Prot)做 BLASTP(v2.13.0,-max_target_seqs 1 -evalue 1e-05)比对\(^{105}\);使用 hmmscan(v3.3.2)对全部蛋白识别保守蛋白结构域\(^{106}\)。BLAST 与 hmmscan 结果交由 Transdecoder-predict 处理,为每条转录本挑选最优翻译产物。最后合并两套基因预测结果,去除冗余蛋白序列。
使用 gffread(v0.12.1)与 Biopython 从注释结果中提取带开放阅读框的蛋白序列\(^{107,108}\)。采用 BLASTP(v2.13.0,e 值 1e-5)将蛋白序列比对 AnnoDB、2017-02-20 下载自 UniProt 的经过验证的木兰亚纲蛋白库 UniMag 以及 PTREP(release 19)数据库\(^{105,108}\)。PTREP 数据库包含推导氨基酸序列的假想蛋白,用于识别 DNA 水平无显著同源的分化型转座元件。前两个数据库仅保留同时含起始密码子与终止密码子的序列。筛选条件:目标序列与查询序列覆盖度均大于 80%;优先选择 UniMag 库中完整、覆盖度达标的蛋白;若 UniMag 无匹配但 AnnoDB 有匹配、且不在 PTREP 库中,同样保留。
采用 AUGUSTUS 软件做蛋白编码基因从头注释\(^{109}\):首先利用已有的啤酒花短读长基因组数据(以色列 NRGENE)训练啤酒花专属模型。使用训练好的啤酒花模型运行 AUGUSTUS(v3.4.0)预测,参数--UTR=on --alternatives-from-evidence=true --allow_hinted_splicesites=atac。为避免过度预测,利用转录组数据和高可信度(HC)预测蛋白生成提示信息(hints)。
分相组装的蛋白编码基因注释
对单倍型分辨分相组装的两套相位,分别按照上述流程完成蛋白编码基因注释。之后使用 EVidenceModeler(EVM,git 提交号 73350ce,分段参数--segmentSize 900000 --overlapSize 50000)整合基于同源信息的非冗余注释与 AUGUSTUS 预测结果\(^{110}\)。所有输入作为基因预测结果输入 EVM;除 AUGUSTUS 外,其余输入同时作为蛋白比对证据提交 EVM。使用 BUSCO(v5.3.2,双子叶植物库 eudicots_odb10 蛋白模式)评估不同权重组合效果\(^{110}\),以 BUSCO 统计指标作为确定 EVM 权重的主要依据。 采用 PASApipeline(v2.4.1)对 EVM 输出注释进行更新,添加 UTR 区域与可变剪接变体信息\(^{111}\)。按照前述方法对 PASA 最终输出做可信度分级。基于 BUSCO(v5.3.2 蛋白模式)以及 Iso-Seq 转录本的 blastn(v2.9.0+,-max_target_seqs 1 -evalue 1e-10)比对结果评估多套覆盖度阈值;三套数据库统一设置查询与目标序列覆盖度阈值为 65%。按照已有文献方法对预测蛋白划分可信度等级\(^{48}\)。对存在多个异构体 / 可变剪接变体的基因,使用 BLASTP 对 AnnoDB 做全部序列两两比对,挑选代表转录本:优先选择覆盖度与一致性最优的转录本;若无数据库匹配,则选取最长转录本。使用 Mercator 工具对转录本开展功能注释,分配 GO 条目、Pfam 与 InterPro 结构域\(^{112}\)。
基因模型整合
为识别并整合两套相位证据注释中可能遗漏的基因,采用与 Jayakodi 等人报道类似的比对策略\(^{113}\)。简要流程:使用 BLAST(v34)、exonerate(v2.4)、gmap(2021-08-25 版本)将基因模型比对至基因组\(^{114,115,80}\);每次比对结果通过蛋白全局比对与源基因模型打分。使用 Biopython 的 AlignIO 模块进行全局比对,BLOSUM62 矩阵,空位打开罚分 10.0,空位延伸罚分 0.5\(^{108}\)。仅保留拥有连续 ORF、同时含起始与终止密码子的完整匹配。此外,基因模型的跨相位转移仅限等位基因匹配,用于互补两套相位同源区域的注释。两套相位间的等位基因区块来自初始证据注释,通过全部对全部 BLASTP 与默认参数 McScanX 获得\(^{116}\)。从得分最高的匹配区块开始,逐步向区块内补全缺失的等位基因模型,前提是其编码区不与已注释 CDS 重叠。
最后使用 Mikado 流程校正整合后的基因模型,去除嵌合基因与可变剪接变体的错误注释\(^{117}\)。按照软件手册使用标准参数运行;所用 SwissProt 蛋白 BLAST 数据库筛选为绿色植物子集;Mikado pick 命令采用参考更新模式。
转座子注释
使用 EDTA 默认参数对 Apollo 与大麻 cs10(GCA_900626175.2)基因组组装序列开展转座子注释\(^{118}\)。为计算每一条完整 LTR 反转录转座子的插入时间,利用其 5' 端与 3' 端长末端重复序列间的分化度(EDTA 输出 gff 文件中的 1-ltr_identity),采用公式 (2) 计算;所用随机突变速率为\(1.3\times10^{-8}\)\(^{119}\)。
基因家族扩张分析
选用以下物种开展基因序列演化、基因家族收缩与扩张分析:啤酒花 Apollo(相位 1)、大麻 cs10(GCA_900626175.2)、山黄麻(GCA_002914845.1)、川桑(GCA_000414095.2)、枣(GCA_000826755.1)、桃(GCA_000346465.2)、葡萄(GCA_000003745.2)。首先依据 GFF 注释坐标提取各物种编码序列;使用 RepeatModeler2 与 RepeatMasker 预测转座子\(^{120,121}\);若编码序列与重复序列重叠度≥90% 则判定为转座子,剔除后续分析。提取每个基因最长转录本,使用 OrthoFinder 默认参数识别啤酒花相位 1 与其余 6 个物种间的直系同源基因\(^{122}\)。 使用 CAFE5 软件在两组直系同源基因集中检测显著扩张 / 收缩基因家族\(^{123}\):第一组为所有研究物种均至少含 1 个拷贝的直系同源家族;第二组为大麻科 3 个物种(啤酒花、大麻、山黄麻)均至少含 1 个拷贝的直系同源家族。CAFE5 输入的两组有根进化树从 Timetree 网站获取\(^{124}\)。
除啤酒花外,用于家族扩张收缩分析的其余物种基因,使用 eggNOG v2.1.12 注释 GO 条目\(^{125}\)。合并每个显著扩张家族的全部基因,基于 GO 注释开展富集分析,解析扩张家族的生物学功能;使用 R 包 topGO(v2.44.0)\(^{126}\)。topGO 基于 GO 层级拓扑结构计算显著性。采用weight01算法与 Fisher 精确检验,对细胞组分(CC)、分子功能(MF)、生物学过程(BP)三大 GO 分类做富集;基因背景集设置为全部物种基因;nodeSize参数设为 5,过滤注释基因少于 5 个的 GO 条目。分析完成后筛选显著富集 GO 条目(P<0.05)。
系统发育分析
萜类合酶(TPS)、聚酮合酶(PKS)与芳香异戊烯基转移酶(aPT)序列的登录号与数据库信息见补充数据\(^{12--14}\)。使用 BLASTp 从基因组数据库调取序列,筛选与其他蔷薇类功能验证的 TPS/PKS/aPT 覆盖度 > 50%、一致性 > 30% 的序列。仅保留含有对应 Pfam 结构域的序列用于分析:TPS 含 PF01397、PF03936;PKS 含 PF08392;aPT 含 PF01040。 分别基于蛋白序列采用最大似然法推断各基因家族演化历史,模型选用 JTT 矩阵模型\(^{127}\)。在 MEGA X 中使用 ClustalW 默认参数做多序列比对;构建 PKS 进化树时仅使用每个基因第二外显子编码的氨基酸序列。选取对数似然值最高的树(TPS:−69400.37;PKS:−12299.76;aPT:−19508.47)。启发式搜索初始树采用邻接法,基于 JTT 模型的两两距离矩阵构建。 TPS、PKS、aPT 数据集分别包含 198、66、48 条氨基酸序列;位点覆盖度低于 80% 的位置全部删除(部分删除模式);最终数据集分别保留 462、327、366 个位点。采用自举检验评估节点置信度,TPS 树 1000 次重复,PKS 树 10000 次重复,aPT 树 1000 次重复。全部演化分析在 MEGA X 完成\(^{128}\);进化树使用交互式在线工具 iTOL 可视化\(^{129}\)。
为研究两套相位之间 TPS 家族扩张情况,提取两套相位 chr01 上的 TPS 区域,以 20 kb 窗口拆分,联合 TPS 基因模型做共线性分析;共线性分析与可视化参照 MCScan(jcvi 工具包)流程\(^{130}\)。
PKS 基因家族系统发育
以 Apollo 基因组 PKS 蛋白序列(HlCHS、HlVPS 家族)作为查询序列,在大麻 cs10、Parasponia andersonii、山黄麻基因组中查找直系同源序列。采用 tBLASTn,默认参数,e 值阈值\(1\times10^{-50}\)比对各基因组数据库;对显著命中结果提取蛋白 ID 与对应氨基酸序列。使用 MAFFT 对蛋白序列做多序列比对;采用 BMGE(默认参数)去除比对模糊区域;使用 NGPhylogeny.fr 平台的 FastTree 构建最大似然进化树,100 次自举评估分支支持度。该分析解析 4 个物种 PKS 家族成员的演化关系。
作图群体构建与测序
构建 3 套 F1 代双亲作图群体用于遗传图谱构建:
- Apollo × PubM_740 群体:共 184 个子代,2012 年以 Apollo(母本)×PubM_740(父本)杂交获得。每个子代采集约 50 mg 新鲜叶片,硅胶干燥后送至德国 LGC Genomics,提取 DNA 并开展全基因组重测序(WGRS),Illumina 150 bp 双端测序,二倍体啤酒花基因组(2n=5 Gb)测序深度约 5×。亲本 Apollo 构建无 PCR 文库,平均插入片段 470 bp,由美国 NRGene 完成 250 bp 双端 WGRS 测序。
- Zenith × USDA21058M 群体:共 128 个子代,Zenith(母本)×USDA21058M(父本)杂交获得,采用简化基因组 GBS 测序\(^{45}\)。基因型数据下载自 NCBI(生物项目 PRJNA906612);白粉病抗性(PMR)表型 BLUP 估计值取自 Havill 等人文献\(^{45}\)。
- Cascade × HL-19-060-002M 群体:共 182 个子代,Cascade(母本)× 啤酒花 HL-19-060-002M(父本)杂交。种子萌发后,取两周龄幼苗叶圆片送至德国 LGC Genomics,提取 DNA 并开展标准化 GBS(n-GBS)测序。
多样性群体
243 份材料构成的多样性群体用于群体基因组分析。每份材料取幼叶提取 DNA,基于 ApeKI 酶切的 GBS 测序由德国 LGC Genomics 完成。GBS 文库在 Illumina 平台进行 100 bp 单端测序。
变异检测
使用 cutadapt(v4.2,Python3.9)修剪读段接头与低质量碱基,保留≥30 bp 读长\(^{91}\)。各材料高质量读段使用 minimap2(v2.24)比对 Apollo 基因组相位 2\(^{75}\);minimap2 输出管道送入 samtools(v1.15)转为 BAM 文件,NovoSort(v3.01.06)排序,再用 samtools 转为 CRAM 文件\(^{92}\)。全基因组重测序数据使用 NovoSort -md标记重复读段。每个群体单独做变异检测:bcftools(v1.15)mpileup 设置最低读质量 - q=20,call 开启-mv参数\(^{131}\)。使用 vcftools(v0.1.13)过滤变异,删除插入缺失(InDel),保留双等位 SNP,质量 Q>25,测序深度≥4,缺失率 < 20%\(^{132}\)。
多样性群体:使用 FASTX-Toolkit 的fastx_barcode_splitter.pl拆分带条形码 GBS 读段,允许 1 个错配;变异检测流程同上。多样性群体 SNP 过滤:删除 InDel,保留双等位 SNP,Q>25,深度≥2,缺失率 < 20%。
遗传图谱构建
采用拟测交策略,分别使用 Apollo × PubM_740(186 子代)、Zenith × USDA21058M(130 子代)、Cascade × HL19-060-002M(184 子代)群体构建遗传图谱\(^{133}\)。拟测交利用 "一个亲本杂合、另一亲本纯合,子代 1:1 分离" 的标记构建图谱;理论上可分别构建双亲图谱。但 6 个亲本中 Apollo、USDA21058M、Cascade 为种间杂种,PubM_740、Zenith、HL-19-060-002M 为欧洲品系(补充图\(^{1}\));欧洲纯合品系缺少足够标记,因此每个群体仅构建一张遗传图谱。
Apollo × PubM_740 群体使用缺失率≤5% 的 SNP;Zenith × USDA21058M 与 Cascade × HL19-060-002M 群体使用缺失率≤20% 的 SNP,阈值由各群体测序策略决定。使用 VcfHunter 流程的vcf2popNew.1.0.py,阈值\(P=1\times10^{-5}\)筛选 F1 子代中符合 1:1 分离、亲本之一杂合的 SNP 标记\(^{134}\)。每条染色体随机选取最多 1000 个分离标记,使用 Rqtl 分染色体构建遗传图谱\(^{135}\);分别为群体双亲构建连锁图谱。使用read.cross导入标记数据,类型设置为bc;剔除偏分离标记(\(P=1\times10^{-4}\));重组率上限 0.35,LOD 最低阈值 10。绘制标记的基因型可视化图,用于分析各群体重组模式。
霜霉病抗性(DMR)表型鉴定
Apollo × PubM_740 群体的雌、雄单株种植于德国哈勒陶产区,接种与评估方法参照已有报道\(^{136}\)。病害严重度采用德国联邦品种局(Bundessortenamt, 2000)的标准化分级体系,依据叶片感染面积百分比打分,共 5 级: 1 级:高耐病,无孢子产生; 3 级:耐病,叶片感染面积 1--20%; 5 级:中度感病,21--50%; 7 级:感病,51--80%; 9 级:高感病,81--100%。
α- 酸与 β- 苦味酸绝对定量
在哈勒陶产区种植的 Apollo × PubM_740 群体中,采集 137 株雌性单株新鲜花序(啤酒花球果),采样横跨两个种植季(2018 年、2021 年)。每年设置两个采样时间点:2018 年 09 月 06 日、09 月 19 日(每个时间点 2 个生物学重复);2021 年 09 月 09 日、09 月 23 日(每个时间点 2 个生物学重复)。所有样品置于干冰上收集,−80 ℃保存待后续处理。各样品冷冻啤酒花球果使用瑞士 Stöeckli 公司 Dörrex 干燥机 55 ℃单独干燥 12 h,随后采用德国 IKA 公司 Tube Mill 100 control 研磨。研磨后的球果粉末装入 50 mL 离心管,4 ℃保存待化学分析。
测定干燥后含水量:取约 2 g 样品置于玻璃烧杯,纱布覆盖,德国 Binder 干燥烘箱 105 ℃过夜充分烘干;由失重计算样品干燥后的残留水分。 化学检测:称取 50 ± 2 mg 样品置于 1.5 mL 玻璃进样瓶,加入 1 mL 50% 乙腈;采用美国 Branson CPXH 系列超声清洗器超声 30 min,提取啤酒花球果代谢物。提取液 1500 g 离心 3 min;取 50 μL 上清液加入预先在 96 孔微滤板(美国安捷伦,0.2 μm 聚偏氟乙烯膜)孔中配制好的 150 μL 50% 乙腈,1500 g 离心 3 min。过滤后的提取液转移至带有玻璃内插管的全新 1.5 mL 玻璃进样瓶,立即开展 HPLC - 紫外 / 可见光检测。
进样:取 10 μL 样品注入安捷伦 1260 Infinity II 液相系统,配备光电二极管阵列检测器(检测波长 360 nm);色谱柱为美国 Phenomenex Kinetex(2.1 × 100 mm,1.7 μm,XB-C18)。流动相 A:超纯水 + 1% 乙酸;流动相 B:乙腈 + 0.1% 正磷酸。洗脱梯度:前 4 min,20% 流动相 A+80% 流动相 B;随后流动相 B 比例依次提升至 85%(维持 2 min)、90%(维持 2 min)、95%(维持 1 min);最后流动相 B 回落至 80%,运行 2 min;总运行时长 11 min。柱温恒定 25 ℃;样品仓温度 15 ℃。采用安捷伦 OpenLab CDS ChemStation v2.3.54 软件采集数据。 所有样品分多批次上机,每批次最多 32 个样品,避免苦味酸随时间发生信号衰减。使用 R(v4.2.1)包 TIGERr v1.0.0,基于每 10 针样品以及每批次首尾进样的混合质控样品,对目标化合物(共葎草酮、正葎草酮、阿葎草酮与蛇麻酮类似物)信号强度做批次校正。采用瑞士苏黎世 LaborVeritas 的 ICE-3 标准品为外标,为每批次建立标准曲线,完成 α、β 苦味酸绝对定量。代谢物浓度以每毫克干重的百分比表示,计算公式见式 (3)。
利用重复表型数据,在 R(v4.0.2)环境下通过 lmer 包构建模型,计算最佳线性无偏预测值(BLUP,公式 4),将 BLUP 值作为后续全基因组关联分析(GWAS)的表型输入。
全基因组关联分析(GWAS)
采用 GEMMA(v0.98.5)的线性混合模型(LMM)开展 GWAS(抗病性状、α- 酸含量,以 phase2 基因组为参考);β- 酸与 α- 酸的另一组分析采用 GAPIT3 的 BLINK 模型,SNP 筛选标准:缺失率<10%,最小等位基因频率 MAF>1%。在 R 中调用 SNPRelate 包的 snpgdsIBSNum 函数,基于个体间同源一致性(IBS)构建各群体亲缘关系矩阵。使用 R 包 qqman 绘制曼哈顿图可视化各性状 GWAS 结果。采用 Bonferroni 校正(显著性水平 0.05)筛选显著标记 - 性状关联位点(MTA)。
基于 k-mer 的渗入片段鉴定
苦味酸含量 GWAS 结果在 08 号染色体上定位到一处渗入片段。本研究采用 k-mer(长度为 k 的独特 DNA 序列)策略鉴定渗入区域,并解析该区域在 Apollo × PubM_740 群体中的分离模式。利用 KMC(v3.2.1)在 Apollo 分相基因组中鉴定该渗入区域特有的 31 bp k-mer。在每个个体质控后的测序读段中检索特征 k-mer,统计携带该 k-mer 的读段数量。绘制携带 k-mer 的读段占总读段的比例分布图,解析渗入区域的分离规律。
群体基因组分析
采用 R 包 SNPRelate(v1.24.0)内置 FastPCA 算法(snpgdsPCA 函数)开展主成分分析(PCA)。群体结构分析使用 ADMIXTURE(v1.3.0),K 值范围设置 2~10;每组 K 值设置 10 折交叉验证、500 次自举重复。利用 vcftools(v0.1.13)与 SNPRelate 分别计算核苷酸多样性与群体分化系数 Fst,评估群体内、群体间遗传多样性。
利用上述品种与育种系的 GBS 数据开展染色体水平覆盖度分析(详见 Apollo 基因组相位来源鉴定部分)。根据覆盖度信息判定样品中各染色体不同相位的存在 / 缺失;进一步统计本研究所用全部育种材料与品种中各类染色体组合的占比。
Apollo 啤酒花球果发育的代谢 - 转录联合分析
材料制备:Apollo 植株置于人工气候室水培培养,光照时长 16 h,培养 8 周完成营养生长;8 周后光照时长调整为 13 h 诱导开花。在 5 个发育时期(开花期、开花后 1 周、2 周、3 周、4 周,WAF)收获球果,每个时期设置 3 个生物学重复,分期方案参照 Wang 等人报道。采集的球果立即液氮速冻,−80 ℃保存。
为富集腺毛用于后续分析,将球果置于液氮中用刮刀搅拌破碎,经双层金属筛(孔径 500 μm)多次筛分,分离得到腺毛富集组分与残留苞片 / 小苞片组分(苞片组分)。
MALDI 质谱成像(MALDI-MSI)
MALDI-MSI 切片制备:采集开花后 2 周新鲜球果,沿中心轴(穗轴)对半切开,随即包埋于 2% CMC 水溶液(美国 Sigma-Aldrich);方法参照已有文献并针对植物材料做少量修改。简述:日本 SECTION-LAB 包埋盒规格 3.5 cm × 2.5 cm,加入 1/3 体积 CMC 溶液;将包埋盒部分浸入正己烷 / 干冰混合体系使底层 CMC 冻结;将对半切开的球果放入,切面朝上,完全覆盖 CMC。CMC 黏度较高,使用注射器在紧密堆叠的苞片、小苞片缝隙间补加 CMC。随后将包埋盒完全浸入正己烷 / 干冰混合体系直至完全凝固。包埋块−80 ℃保存待切片。
包埋球果使用 Leica CM3050S 冷冻切片机,−30 ℃条件下采用 Kawamoto 膜法冷冻切片;冷冻 CMC 包埋块使用 OCT 包埋剂固定在预冷样品台,切取 10 μm 薄片,转移至 3C(16UF)型冷冻黏结膜(日本 SECTION-LAB);再通过双面碳胶将膜固定于载玻片。切片冷冻干燥,置于真空干燥器中等待基质喷涂。基质选用 1,5 - 二氨基萘(DAN,Sigma-Aldrich),采用自制玻璃腔室升华法,150 ℃升华 5 min。包被基质后的样品真空保存,当天完成质谱成像采集。
MALDI-MSI 检测平台:Thermo QExactive Orbitrap 质谱仪,搭配 AP-SMALDI5 离子源;负离子模式,扫描范围 m/z 60--900,像素大小 65 μm。所有样品设置技术重复。化合物鉴定依据去质子化分子离子 M-H⁻精确质量,允许偏差 ±10 ppm,使用 MSiReader(v1.01)处理(补充图)。信号强度以总离子流(TIC)归一化。
挥发性组分分析
取上述 5 个发育时期冷冻苞片与腺毛样品约 25 mg(±9 mg),置于 1 mL 含 10 ppm 1 - 己醇(内标)的 50% 乙腈溶液,室温超声 30 min(Branson CPXH 超声清洗器)。提取液 1500 g 离心 3 min;取 25 μL 上清转移至 20 mL 玻璃顶空瓶。为减少样品接触空气、避免化合物氧化,进样前所有样品瓶通入氩气置换空气。
采用动态顶空吸附萃取(DHS)结合热脱附单元(TDU),搭配气相色谱 - 质谱联用并脉冲火焰光度检测器(DHS-GC-MS/PFPD)分离复杂混合物中的芳香物质。DHS-GC-MS/PFPD 系统配备热脱附单元 TDU、带珀尔帖制冷样品台的多功能自动进样器;安捷伦 7890B 气相色谱搭配 GERSTEL 冷进样系统 CIS4(程序升温汽化 PTV 进样口,低温制冷模块),检测器为 5977 单四极杆质谱与 Xylem OI-Analytical 脉冲火焰光度检测器 PFPD。系统配备安捷伦毛细管分流器 CFT 两路分流(辅助压力控制模块 PCM 控制,带补偿气路)。
DHS 萃取:55 ℃条件下 300 mL 载气吹扫样品,挥发性组分吸附于 21 ℃的 Tenax-TA 吸附管;随后 TDU 热脱附,升温程序 15 ℃→230 ℃(保持 3 min),升温速率 7.2 ℃/min,脱附气流 48 mL/min。脱附组分在低温 PTV 进样口内 Tenax-GR 衬管上 2 ℃冷捕集,完成富集。脱附结束后 PTV 进样口升温:2 ℃→240 ℃(保持 7 min),升温速率 12 ℃/s,将捕获组分导入色谱柱。进样口分流模式,分流比 1:10;双检测器分流:80% 样品进入质谱检测器 MSD,20% 进入 PFPD。
色谱柱:安捷伦 DB-WAX(122-7032UI,30 m × 0.25 mm,膜厚 0.25 μm),载气为氦气。柱温程序:40 ℃保持 4 min;6 ℃/min 升至 165 ℃;30 ℃/min 升至 230 ℃,保持 5 min。质谱采用电子轰击电离(EI),离子源电压 70 eV,离子源温度 300 ℃;设置 3 min 溶剂延迟,规避溶剂出峰阶段质谱采集。
原始谱图使用 MSConvert v3.0.2 转换为 mzML 格式;MZmine2(v2.5.3)预处理:质谱检测时信号强度阈值 1000;ADAP 色谱峰构建器,要求至少 3 个连续扫描点信号≥1000,质量偏差 0.1 Da(或 5 ppm)。采用局部最小值搜索算法对色谱峰解卷积,最小峰高 5000,色谱阈值 95%;基于层次聚类与峰型模型提取伪二级谱图,要求至少 2 个离子。ADAP 峰对齐,保留时间偏差 0.1 min,质量偏差 0.1 Da(或 10 ppm)。
将特征峰与自建谱库比对:库内包含 17 种商用标准挥发性物质(德国默克),均在相同仪器条件下采集;余弦相似度>0.7 判定为阳性匹配。剔除空白瓶样品检出峰以及内标峰,导出峰表为 csv 与 msp 格式;msp 文件使用 MSPepSearch v0.9.4.9 检索 NIST20 质谱库。详细预处理参数见补充表。谱图后处理使用 R 脚本,将信号归一化至样品中位重量与内标峰强度;脚本存放于代码可用性章节。
非挥发性代谢物分析
取上述 5 个发育时期苞片与腺毛组分样品 14 mg(±11 mg)置于 1.5 mL 玻璃进样瓶,加入 1 mL 含 4 ppm 福司可林(内标)的 50% 乙腈,超声 30 min 提取(Branson CPXH 超声清洗器)。乙腈提取液经安捷伦 96 孔 0.2 μm 滤板过滤,采用 LC-qToF-MS/MS 在正负离子模式下检测。
仪器平台:Dionex Ultimate 3000 超高效液相系统搭配 Bruker Compact ESI-QTOF 质谱。色谱柱 Phenomenex Kinetex XB-C18(100 × 2.1 mm,1.7 μm,100 Å 孔径),柱温 40 ℃,流速 0.3 mL/min。流动相 A:0.05%(体积分数)甲酸水溶液;流动相 B:0.05% 甲酸乙腈。梯度程序:0--1 min,10% B;1--23 min 线性升至 100% B;23--25 min 维持 100% B;25--25.5 min 降至 20% B;25.5--30.5 min 重新平衡至 10% B。
质谱采集正负离子模式,m/z 范围 50--1200。质谱参数:毛细管电压 4000 V,端板偏移 500 V;干燥气温度 220 ℃,干燥气流速 8 L/min;雾化气压力 2 bar;源内 CID 能量 0 eV;六极杆射频电压 50 Vpp,四极杆离子能量 4 eV,碰撞池能量 7 eV。MS/MS 采用非靶向采集,碰撞能 27 eV。质控:每 10 针样品、每批次首尾进混合质控样与溶剂空白。
原始数据使用 MZmine2 v2.5.3 预处理(流程微调)。一级鉴定(1 级):精确质量、保留时间匹配,二级谱图余弦相似度>0.7;自建库包含 24 种商用标准品(默克),同一平台采集(补充数据)。该谱库同时用于基于特征分子网络(FBMN)分析,支撑二级鉴定(2 级,二级谱余弦>0.7);标准谱图上传至 GNPS 公共平台,CCMSLIB 编号见补充数据。本研究使用的 FBMN 流程托管于 GNPS 平台,附带化学分类工具包;采用网络注释增强工具 NAP 解析球果发育代谢组化学空间。
同时使用啤酒花专属自建虚拟碎裂数据库 ISDB,包含 265 个啤酒花及近缘物种已解析代谢物结构。基于虚拟碎裂的去重鉴定结果按可信度分级:Fusion、Consensus、MetFrag 算法输出的 SMILES 分别对应 3a、3b、3c 等级。FBMN 与 NAP 结果通过 MolNetEnhancer v22 整合;正负离子网络采用 GNPS "merge networks polarity" 工具 v22.1 合并。所有分子网络使用 Cytoscape 3.8.2 可视化,详细参数见补充表。
为缩减特征数量用于后续关联分析,筛选节点数≥5 的子网络,共 45 个子网络,合计 583 个特征(全部特征 987 个)。对每个子网络,取同一发育时期所有节点信号强度的中位数,代表该子网络代谢物在球果发育过程中的丰度变化(补充图)。
RNA 提取与测序
发育球果的苞片与腺毛富集组分使用 Geno/Grinder 研磨;改良 CTAB 法提取 RNA。每份研磨样品加入 1 mL ES 提取缓冲液,涡旋混匀,孵育 15 min;14000 g 离心 10 min。上清转移至新离心管,加入 500 μL 预冷异丙醇,−20 ℃过夜;4 ℃、14000 g 离心 10 min 沉淀核酸。弃上清,沉淀用无 RNase 水重悬;Zymo RNA Clean & Concentrator 试剂盒纯化,配套 DNase 处理去除 DNA。纯化 RNA −80 ℃保存。
Apollo 球果发育转录组:由华大基因(香港)构建非链特异性 polyA 富集 RNA 文库,DNBSEQ 平台 PE100(2×101 bp)测序;每个样品产出 8 Gb 干净读段。Apollo × PubM_740 群体挑选 10 株雌性单株,取腺毛组织,由韩国 Macrogen 提取 mRNA 构建 TruSeq 链特异性 mRNA 文库,Illumina HiSeq 2500 平台 150 bp 双端测序。
差异基因(DEG)分析
原始 RNA-seq 读段参照已有流程处理:Rcorrector(v1.0.4)校正 Illumina 双端读段的错误 k-mer,丢弃至少一条读段无法校正的序列;TrimGalore!(v0.6.6)去除接头与 Phred 低于 5 的低质量碱基。为完全去除核糖体 RNA 读段,使用 bowtie2(v2.4.4)将读段比对 SILVA 数据库的古质体 SSUParc、LSUParc 合并 rRNA 参考序列,过滤比对上的 rRNA 读段。质控使用 FastQC(v0.11.9)(补充图)。
差异基因分析基于 Trinity/Trinotate 流程。采用 Salmon(v1.9.0)做转录本定量;构建带诱饵序列的转录本索引,诱饵序列采用分相组装的假分子,索引参数--keepDuplicates。R 包 DESeq2(v1.36.0)DESeqDatasetFromMatrix函数处理基因计数矩阵,设计矩阵~stage;筛选标准:任意两两比较中,log2 倍数变化≥2(≥4 倍差异),Benjamini-Hochberg 校正 FDR≤0.001,同时校正生物学重复间表达离散度。
提取球果发育过程表达模式相近的基因:TPM 归一化计数再采用 edgeR 包(v3.42.4)TMM 跨样本归一化,校正样品组成偏差。3612 个差异基因的 TPM-TMM 归一化表达量做层次聚类:表达量做 log2 (TPM+1) 转换,每行基因减去自身均值;采用中心化 Pearson 相关系数(1−相关系数)构建距离矩阵(amap 包),优先捕捉时间序列上表达谱的相关性而非单点差异。R 基础包 stats 的 hclust 函数,Ward.D2 聚类方法。动态树切割使用 R 包 dynamicTreeCut,cutreeDynamic,最小基因数 100,deepSplit=2,最终得到 4 个差异基因簇。采用轮廓系数法评估聚类效果,利用 R 包 cluster 计算最大平均轮廓系数确定最优簇数;factoextra、cluster、ggplot2 绘制轮廓图与聚类图。聚类结果展示啤酒花球果发育中表达模式相似的差异基因集合。
基于直系同源基因信息,对差异基因簇内纯合、杂合基因开展全面的等位基因特异性表达(ASE)分析。每个差异基因簇的 ASE 分为三类:杂合基因仅存在于一个相位(het category1);两个相位均存在同源杂合基因(het category2);两个相位同源杂合基因间存在显著表达差异(p<0.05),且至少一个发育时期表达量高于 1 TPM(het category3)。
将差异基因簇与代谢谱关联:基因表达采用 log2 (TPM+1)(层次聚类质控后),代谢数据包含 45 个非挥发性代谢子网络、49 个挥发性组分。判定正相关:某代谢特征与该簇≥5% 差异基因的 Pearson 相关系数≥0.9;R 基础包 stats 的 cor 函数计算相关系数。基于差异基因簇与代谢物的显著正相关基因计数,使用 Cytoscape 3.8.2 绘制关联网络图。
全基因组等位基因特异性表达分析
基于 Apollo 基因组两套相位鉴定得到的同源基因对开展等位基因特异性表达(ASE)分析。序列一致性与覆盖度均为 100% 的基因对判定为纯合;杂合同源基因对允许 5% 的序列分化,同时依据每对基因 log₂转换后的基因长度比值,基因长度容忍上限为 0.05。
全基因组范围内,已确定的同源基因对中共计包含 38913 个基因,另有 537 个同源串联重复事件,最终合计得到19725 对同源基因 。提取每对同源基因来自啤酒花球果发育的生物学重复、经跨样本归一化的 TPM 表达矩阵,利用 R 包 DESeq2 v1.36.0 开展差异表达分析(实验设计矩阵:~stage+phase),筛选球果发育过程中表达存在显著差异的基因对(校正后P<0.05)。
基于 38913 个基因的球果发育各重复平均表达量设定 TPM 阈值:提取每个基因在球果发育阶段的最大 TPM 值,取第一分位数作为 TPM 阈值(1.05 TPM)。过滤后数据集保留 24172 个基因(去除同源串联重复冗余,优先保留杂合同源基因对;包含 6740 个纯合基因、17432 个杂合基因),用于全基因组水平 ASE 分析。
为统计每条染色体上发生 ASE 的表达基因占比,采用如下计数规则:表达量高于 TPM 阈值的纯合基因各计 1 分;存在显著 ASE 的杂合基因,优势表达相位计 1 分;表达高于 TPM 阈值但无显著 ASE 的杂合基因,按照纯合基因同等方式处理。最后分别除以每条染色体各相位上同源基因的总数,得到占比。
调用 R 基础包stats的prop.test()函数,对每条染色体、每个相位内代表 ASE 发生的二分类计数执行双比例 Z 检验\(^{81}\)。在 Yates 连续性校正条件下,分别计算同一发育时期两套相位之间、全部时期合并后的双比例 Z 检验P值(补充表 1)。
为解析不同发育时期的 ASE 动态,使用上述 19725 对同源基因,在 DESeq2 中对每个发育时期分别做相位间差异表达检验(实验设计矩阵:~phase)。利用 R 包UpSetR绘制 UpSet 图,可视化所有时期组合下显著 ASE(校正后P<0.05)基因对的交集情况(补充图 1)\(^{178}\)。
Data availability
The sequencing data generated in this study have been deposited in the European Nucleotide Archive (ENA) database under accession codes PRJEB64593 (scaffold sequence used for training AUGUSTUS gene annotations), PRJEB64169 (contig sequences and AGP file of the haploid cv Apollo assembly), PRJEB63995 (CCS, RNA-Seq, iso-seq and Hi-C reads used for the generation and annotation of the phased cv. Apollo assembly), PRJEB64122 (RNA-Seq data from the developing Apollo cone), PRJNA1082089 (phased assembly of hop cv Apollo), PRJEB63565 (linkage mapping Apollo × PubM_740 population), PRJEB63534 (linkage mapping Cascade × HL-19-060-002M population), PRJEB63136 (GBS data used for population genomic study). The annotation of the phased cv. Apollo assembly has been deposited to Zenodo [https://doi.org/10.5281/zenodo.18787309](https://doi.org/10.5281/zenodo.18787309 "https://doi.org/10.5281/zenodo.18787309"). All input and results for the syntenic and orthologous framework for Humulus and Cannabis were deposited to Zenodo [https://doi.org/10.5281/zenodo.18802928](https://doi.org/10.5281/zenodo.18802928 "https://doi.org/10.5281/zenodo.18802928"). The Raw DHS-GC − MS and LC-qTof-MS/MS spectral data generated on Apollo hop cone development, control and blank samples are available at the MassIVE repository database under ID MSV000095961. All derived molecular networking jobs can be publicly accessed at following links: FBMN job for positive ionization [https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=0f83c7cfad91444e855c1987f161e854](https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=0f83c7cfad91444e855c1987f161e854 "https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=0f83c7cfad91444e855c1987f161e854"), FBMN job for negative ionization [https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=19aa55bc1f564681b104ddd1b4858a82](https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=19aa55bc1f564681b104ddd1b4858a82 "https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=19aa55bc1f564681b104ddd1b4858a82"), NAP job for positive ionization [https://proteomics2.ucsd.edu/ProteoSAFe/status.jsp?task=025a463a22c54b2da226cf9ebe5c031a](https://proteomics2.ucsd.edu/ProteoSAFe/status.jsp?task=025a463a22c54b2da226cf9ebe5c031a "https://proteomics2.ucsd.edu/ProteoSAFe/status.jsp?task=025a463a22c54b2da226cf9ebe5c031a"), NAP job for negative ionization [https://proteomics2.ucsd.edu/ProteoSAFe/status.jsp?task=7ff6e3f7657240c88bfc11f8e3b360fd](https://proteomics2.ucsd.edu/ProteoSAFe/status.jsp?task=7ff6e3f7657240c88bfc11f8e3b360fd "https://proteomics2.ucsd.edu/ProteoSAFe/status.jsp?task=7ff6e3f7657240c88bfc11f8e3b360fd"), MolNetEnhancer job for positive ionization [https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=48dd84680d3c4e04b6f6b82e407157cd](https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=48dd84680d3c4e04b6f6b82e407157cd "https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=48dd84680d3c4e04b6f6b82e407157cd"), MolNetEnhancer job for negative ionization [https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=bf995243b6e94a49ab702541dc26e1ce](https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=bf995243b6e94a49ab702541dc26e1ce "https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=bf995243b6e94a49ab702541dc26e1ce"), Merged ionization network [https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=ed53ff8a61af457f8c9bf4de87153d89](https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=ed53ff8a61af457f8c9bf4de87153d89 "https://gnps.ucsd.edu/ProteoSAFe/status.jsp?task=ed53ff8a61af457f8c9bf4de87153d89"). The following previously published data sets were used in the current study: occurrence datasets from the Global Biodiversity Information Facility (GBIF) for generation of Fig. 1b (https://doi.org/10.15468/dl.w53rkc, https://doi.org/10.15468/dl.cr37wu, https://doi.org/10.15468/dl.6ye7ug, https://doi.org/10.15468/dl.8jnu9g, https://doi.org/10.15468/dl.mn7b6d, and https://doi.org/10.15468/dl.rzwt9h); genome assemblies for Humulus cv. Cascade (Supplementary Fig. 4, https://hopbase.org) and for Cannabis sativa cv. Cs10 (Figs. 3b and 3c, https://www.ncbi.nlm.nih.gov/search/all/?term=GCA_900626175.2); gene annotation files for Humulus cvs. Saaz (Fig. 3a, Hop_Saaz_haploid_v3.0 | Humulus lupulus | Assembly), Cascade (Fig. 3a and Supplementary Fig. 20d, https://hopbase.org), and drHumLupu1.1 (Supplementary Fig. 21Humulus lupulus genome assembly drHumLupu1.1 - NCBI - NLM) and Cannabis sativa cvs. Pink Pepper (Fig. 3a, Search: GCA_029168945.1 - NLM) and Cs10 (Supplementary Fig. 4b, 5, 20d, and 23, Index of /genomes/all/GCF/900/626/175/GCF_900626175.2_cs10), Parasponia andersonii (Fig. 5, Trema andersonii genome assembly PanWU01x14_asm01 - NCBI - NLM), Malus domestica (Supplementary Fig. 20d and 23, Index of /genomes/all/GCF/002/114/115/GCF_002114115.1_ASM211411v1), Prunus persica (Supplementary Fig. 20d and 23, Index of /genomes/all/GCA/000/346/465/GCA_000346465.2_Prunus_persica_NCBIv2), Vitis vinifera (Supplementary Fig. 20d and 23, Index of /genomes/all/GCA/000/003/745/GCA_000003745.2_12X), Trema orientale (Fig. 5 and Supplementary Fig. 23, Index of /genomes/all/GCA/002/914/845/GCA_002914845.1_TorRG33x02_asm01), Morus notabilis (Supplementary Fig. 23, Index of /genomes/all/GCF/000/414/095/GCF_000414095.1_ASM41409v2) and Ziziphus jujuba (Supplementary Fig. 20d and 23, Index of /genomes/all/GCF/000/826/755/GCF_000826755.1_ZizJuj_1.1).
Raw sequence data for the Zenith × USDA21058M biparental population (Supplementary Fig. 12b, https://www.ncbi.nlm.nih.gov/bioproject/?term=PRJNA906612). Source data are provided with this paper.
Code availability
Code used for metabolomics data processing and analysis is available at GitHub (GitHub - carlsberglaboratorium-publications/apollo-cone-development-metabolomics: Code used in metabolomic study of Apollo hop cone development. Submitted publication: Extensive variation between chromosomes of North American and European hop · GitHub) and archived at Zenodo (https://doi.org/10.5281/zenodo.19134880).