说明:本文以「高远-全球法规管理平台」为例,介绍车企出海合规数字化的人机协同思路。该平台由北京高远华信科技自主研发与交付,并非飞书项目、钉钉等协同工具的原生功能,而是通过标准 OpenAPI 与飞书、钉钉、企业微信协同,并原生对接车企 PLM、ERP 系统。
车企滚动出海,每进一个市场就要面对一套新法规:欧盟 ECE、国内 GB 国标、各目标国认证,加起来成百上千份文件,动辄几百页。传统工作流里,工程师靠人工翻 PDF、逐条对照、手动拆解,把法律条文翻译成技术参数。一份文件拆完要好几天,还难免主观疏漏;一旦限值看漏,车型可能在海外被重罚、召回甚至延期;更隐蔽的是法规升版和零部件 BOM 对不上------老零件还按旧标准采购,新规一生效就是百万级呆滞物料报废。
平台的定位是人机协同的智能合规平台 :把合规拆成四步(外部法规主动捕捉、内部法规数字化治理、知识库智能消费、整车零部件级合规管理),AI 承接 90% 的基础粗活,工程师只做 10% 的确认。下面用代码串一遍这条链路。
一、第一步:让几百页 PDF 自己"开口说话"
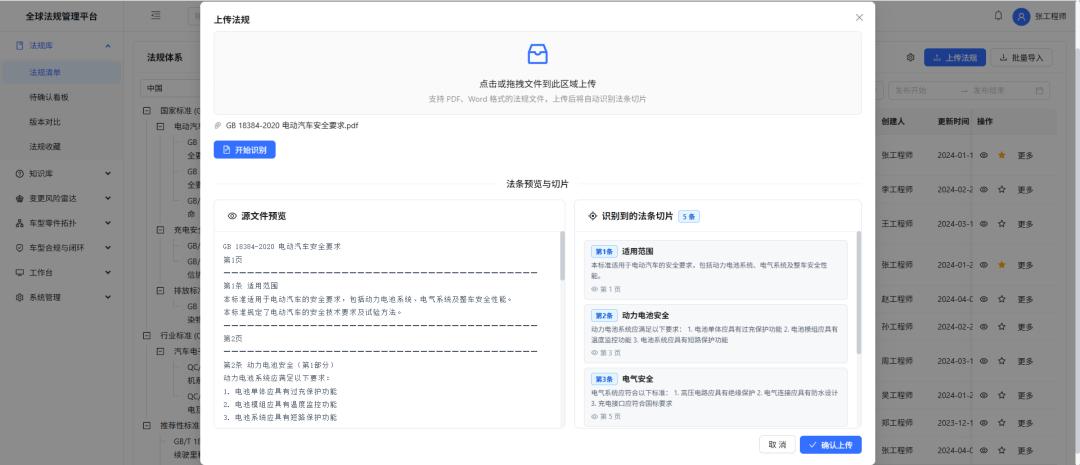
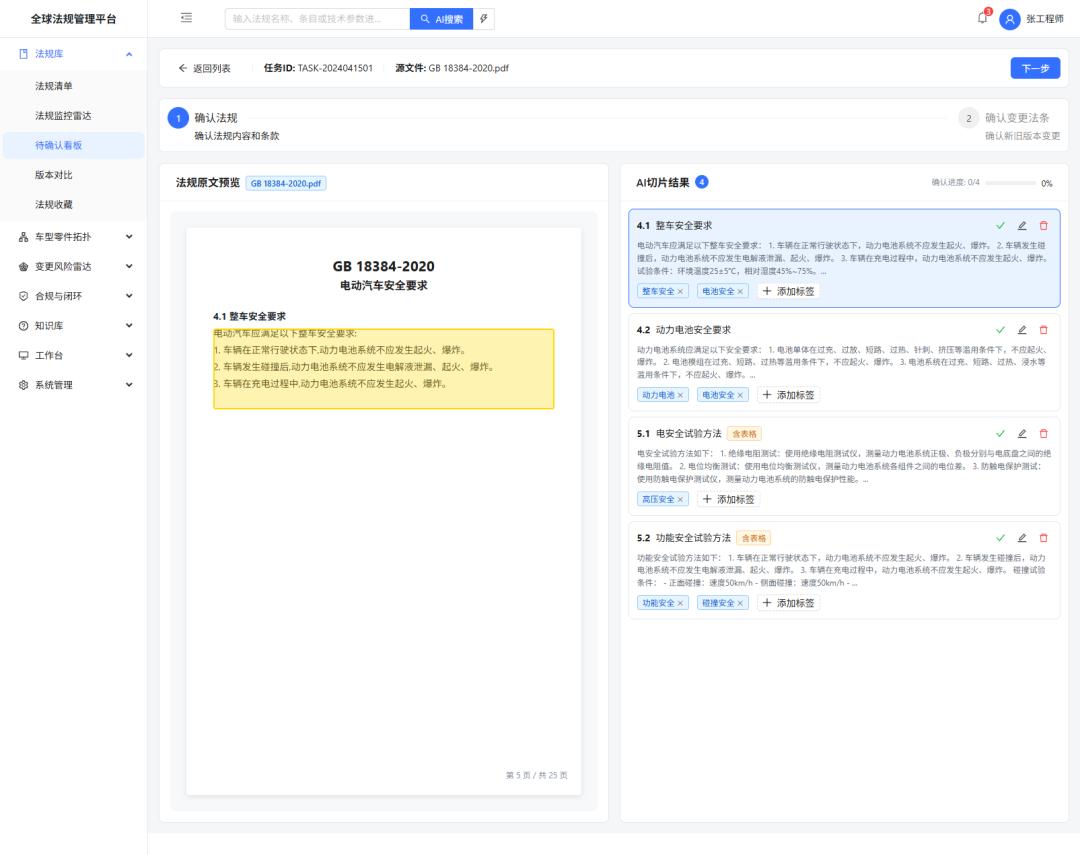 过去最耗时的,是把法规从"纸面文字"变成"可用数据"。平台上传官方源文件 PDF 后,AI 按法律层级降维拆成独立条款切片,并结合同义词字典打技术标签。
```python
from dataclasses import dataclass
from enum import Enum

class LawLevel(str, Enum):
    ARTICLE = "article"      # 章
    CLAUSE = "clause"        # 条
    ITEM = "item"            # 款

@dataclass
class RegulationSlice:
    law_id: str              # 法规编号,如 ECE-R79
    level: LawLevel
    text: str                # 条款原文
    tech_tags: list[str]     # 同义词字典打出的技术标签
    kv_pairs: dict           # 提取的键值对:参数名/试验条件/阈值限值

def parse_regulation(pdf_path: str) -> list[RegulationSlice]:
    """几百页 PDF → 按层级拆成条款切片,并抽取标准键值对"""
    pages = extract_pages(pdf_path)          # 保留跨页/嵌套大表格排版
    slices = []
    for p in pages:
        for node in hierarchy_split(p):      # 按法律层级降维拆解
            kv = extract_kv(node.text,        # 【参数名, 试验条件, 阈值限值】
                            keys=["参数名", "试验条件", "阈值限值"])
            slices.append(RegulationSlice(
                law_id=detect_law_id(node),
                level=node.level,
                text=node.text,
                tech_tags=tag_with_synonym_dict(node.text),
                kv_pairs=kv,
            ))
    return slices
```
parse_regulation 解决"查什么":拆完的切片是后续所有检索、比对、绑定的最小单元,跨页大表格的【参数名/试验条件/阈值限值】键值对也一并落库,给多国准入矩阵对比打底。
二、待确认看板:看得见依据
 光拆不够,工程师要能核对到原文物理位置。平台首创待确认看板------点右侧切片,左侧 PDF 浏览器自动滚动到对应页码并黄色高亮。
```python
def locate_source(slice_id: str) -> dict:
    """点击条款切片 → 返回源文件页码与物理坐标,用于左侧高亮"""
    s = get_slice(slice_id)
    page = s.source_page
    box = s.bbox                       # (x1, y1, x2, y2) 物理坐标
    return {
        "pdf_url": s.pdf_url,
        "page": page,
        "bbox": box,
        "highlight": f"page={page}&rect={box}",  # 前端据此黄色高亮
    }
```
locate_source 把"我确认过"这件事变成可点击、可回溯的动作------工程师不用在页码堆里翻找,点发布即可,每条结论都能回到 PDF 原件。
三、第二步:变更风险雷达,从"人找漏洞"到"漏洞找人"
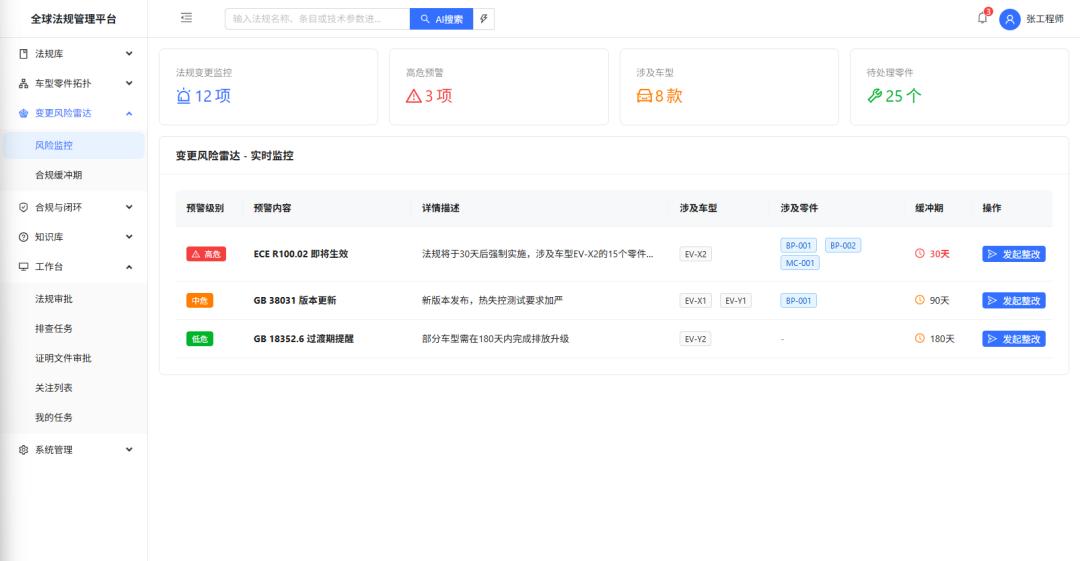
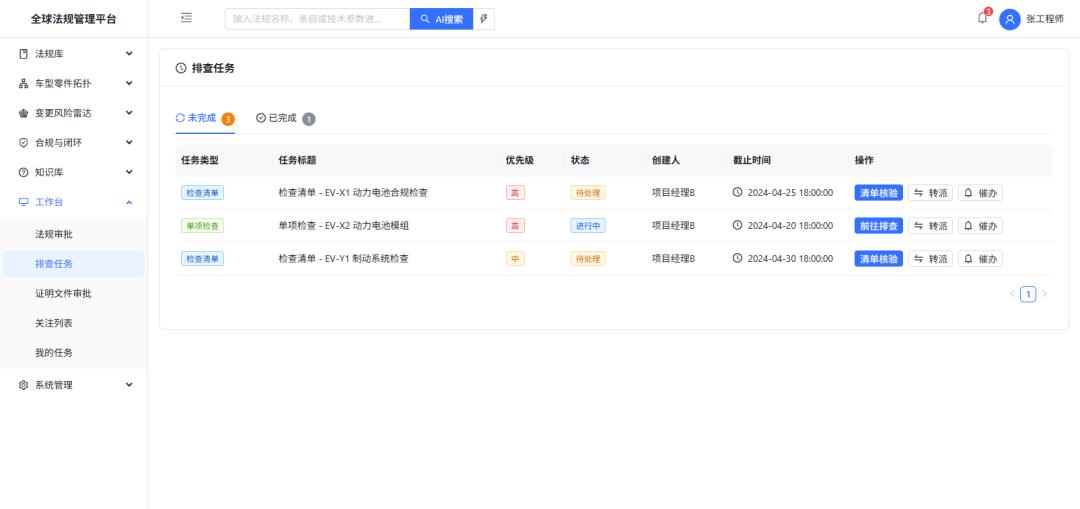 法规会升版、废止。雷达在后台扫描外部变动,沿"变动条款 → 波及零件 → 受影响车型"逆向追踪,自动下发整改工单。
```python
def risk_radar(changed_clause: str) -> list[dict]:
    """外部法规一变动,逆向追踪波及零件与车型,下发工单"""
    bindings = query_bindings(clause=changed_clause)   # 多对多强绑定关系
    tickets = []
    for b in bindings:
        parts = b.affected_parts            # 波及零件
        models = b.affected_models          # 受影响车型
        level = "red" if b.severity >= 3 else "yellow"
        tickets.append(create_ticket(
            clause=changed_clause,
            parts=parts, models=models,
            level=level,                    # 红黄灯
            action="整改并核实最新限值",
        ))
    return tickets
```
risk_radar 把被动合规变主动:异常件在大盘亮红黄灯,整改工单自动派发,不再靠人逐条比对几百页。
四、第三步:零件与法条多对多强绑定
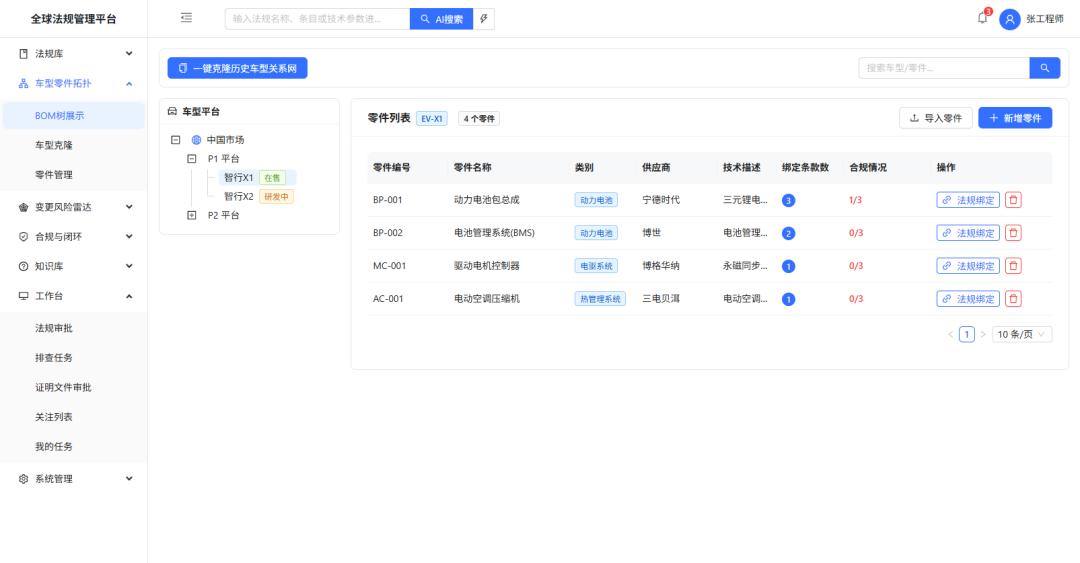
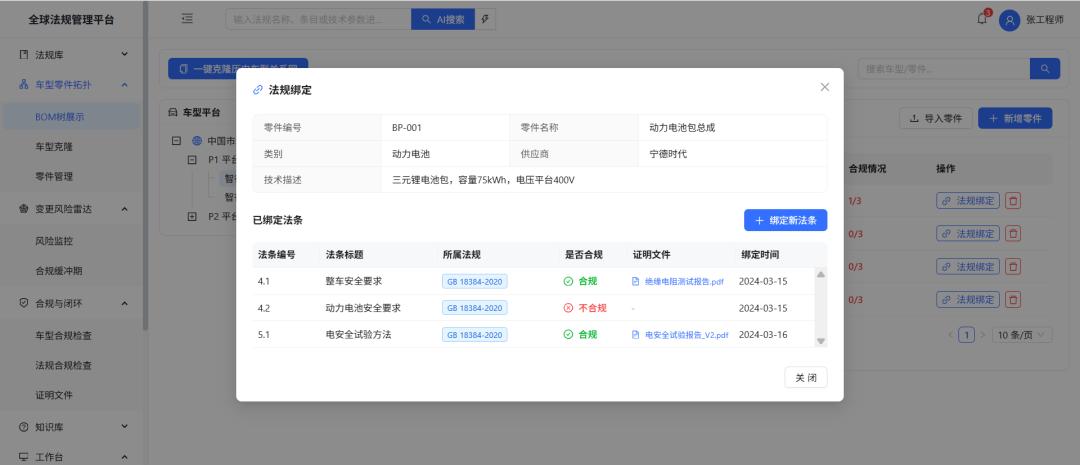 法规和"我的车"对不上,等于白管。平台对接 PLM/ERP 拉真实车型零件拓扑,把零件和多条法条做强绑定,绑完法条一变就触发雷达。
```python
def bind_law_part(part_id: str, law_ids: list[str], model_id: str) -> None:
    """零件与法条多对多强绑定,并克隆成熟车型的既有绑定网络"""
    for law in law_ids:
        upsert_binding(part_id=part_id, law_id=law, model_id=model_id)
    # 新车型研发初期:一键克隆成熟车型全量绑定网络
    if is_new_model(model_id):
        clone_bindings(from_model=mature_model(model_id),
                       to_model=model_id)
```
bind_law_part 解决"法规和车怎么对上":绑定即建立责任链,任一法条变动立刻沿链告警;新车型还能克隆成熟车型的合规底账,大幅压缩前期梳理周期。
五、第四步:知识库问答 + 7×24 情报推送
法规进知识库后,工程师自然语言提问,AI 每句结论末尾带超链接,点开即拉开 PDF 并高亮;冷门问题触发人工工单,专家解答结单瞬间向量化入库。平台另做全天候监控,把外部增量分类后通过飞书精准推送。
```python
def ask_knowledge(question: str) -> dict:
    """自然语言提问 → 结论 + 可点击溯源超链接"""
    ans = llm_answer(question, retrieval="law_vector_store")
    if ans.confidence < 0.6:               # AI 没把握 → 转人工
        return trigger_expert_ticket(question)
    return {
        "answer": ans.text,
        "sources": [                       # 每条结论带溯源链接
            {"pdf_url": s.pdf_url, "page": s.page, "bbox": s.bbox}
            for s in ans.citations
        ],
    }
```
ask_knowledge 从根上消除大模型胡编------结论与 PDF 原件强绑定。冷门问题 AI 没把握时触发人工工单,专家解答结单瞬间向量化入库,知识库越用越准。
```python
def monitor_push() -> None:
    """7×24 扫描官方源站,增量按草案/征求意见稿/正式版分类,飞书推送"""
    for inc in crawl_official_sources():
        stage = classify_stage(inc)        # 草案 / 征求意见稿 / 正式版
        feishu_push(text=f"[{stage}] {inc.title}", url=inc.source_url)
```
monitor_push 让合规情报主动上门,不再等人去翻官网。外部增量自动归类为草案、征求意见稿或正式版,附带源站链接精准推送。
六、能力矩阵与系统对接
平台把四步能力收敛成一张可落地的清单:
|----------|-----------|----------------------|
| 能力 | 解决什么 | 关键技术 |
| PDF 降维拆解 | 纸面文字→可用数据 | 层级拆分 + 同义词字典 + 键值对抽取 |
| 变更风险雷达 | 法规升版漏跟踪 | 变动条款→零件→车型 逆向追踪 |
| 零件-法条绑定 | 法规和车对不上 | PLM/ERP 拓扑 + 多对多强绑定 |
| 知识库问答 | 查证慢、易胡编 | 向量检索 + 结论溯源超链接 |
| 7×24 监控 | 情报靠人翻 | 官方源站扫描 + 飞书精准推送 |
平台通过标准接口对接企业既有系统,部署上支持私有化:
|-----------|------------------------|---------------|
| 对接方向 | 支持系统 | 协同方式 |
| PLM | Teamcenter / Windchill | OpenAPI 开箱同步 |
| ERP / MES | SAP 等 | OpenAPI 开箱同步 |
| 协同工具 | 飞书 / 钉钉 / 企业微信 | 标准接口推送 |
| 大模型部署 | DeepSeek-R1 + 向量库 | 本地私有化,核心数据不出域 |
数据安全方面,底层关键写操作强制写独立审计日志,且系统不提供该日志的删改接口,形成不可篡改的证据链。
|------|-------------|-----------------|
| 工作环节 | 传统方式 | 平台方式 |
| 拆解法规 | 人工翻 PDF、逐条抄 | AI 自动切片 + 键值对抽取 |
| 跟踪变更 | 靠人留意升版 | 雷达逆向追踪、红黄灯工单 |
| 关联车型 | 文档里手动记 | 零件-法条多对多强绑定 |
| 查证条款 | 翻页码找原文 | 自然语言提问 + 一键溯源 |
| 获取情报 | 人去官网刷 | 7×24 监控 + 飞书推送 |
七、常见问题
Q1:我们已在用 Teamcenter / SAP,平台能接上吗?要开发很久吗?
A:可以。通过标准 OpenAPI 开箱同步,支持 PLM(Teamcenter/Windchill)、ERP(SAP)、MES 等主流系统,也能和飞书、钉钉、企业微信协同,不必从零定制。
Q2:法规数据敏感,上平台会不会泄到外面?能自家服务器跑吗?
A:支持大模型与向量数据库全本地私有化部署,核心数据不出域;底层写操作强制写独立审计日志,且系统不提供删改接口,形成不可篡改证据链。
Q3:老法规是扫描件、图片,没有文字层,能处理吗?
A:能。平台用 OCR 图像解析与版面分析引擎,自动解析纯图片版老旧法规或传真件,提供和电子版 PDF 一致的左右分栏联动高亮核对体验。
Q4:法规一升版,怎么知道影响了哪些车型和零件?
A:变更风险雷达自动沿"变动条款 → 波及零件 → 受影响车型"链路下发整改工单,并在大盘把异常件亮红黄灯,不用人工逐条比对。
Q5:工程师每天查法规,能直接问、还能溯源原文吗?
A:能。自然语言提问,AI 每句结论末尾带超链接,点开即拉开 PDF 原件并高亮具体位置,既快又防胡编。
Q6:这是飞书项目自带的功能吗?
A:不是。高远-全球法规管理平台由北京高远华信科技自主研发,属于独立合规平台,通过标准接口与飞书项目等协同工具对接,并非飞书项目原生能力。
如果你们正规划海外车型认证、多国法规梳理或零部件合规管控,想少花人力逐页翻 PDF,欢迎在评论区留言【出海】,我把整理好的法规数字化资料发你。