研发评审里最常被问、又最难答的一句,是"这个需求我们之前是不是做过?"。
难点不在判断,在于"做过"这件事的痕迹散落各处:同一指标,客户叫"工作温度范围",系统里记成 operating_temp;客户说"10% 反射率下最远能看多远",参数表写的是 range_10pct。字面对不上,检索自然找不到。本文以高远Himee-ALM 的需求智能相似度匹配能力为样本,拆一套可复用的工程实现:先把说法统一,再做带背书的三分加权判定,最后让结论可核验、可审计。全文数据来自客户项目实测,方法可迁移到任意需求库治理场景。
一、同义归一化:让"同一个意思"只认一个标准名
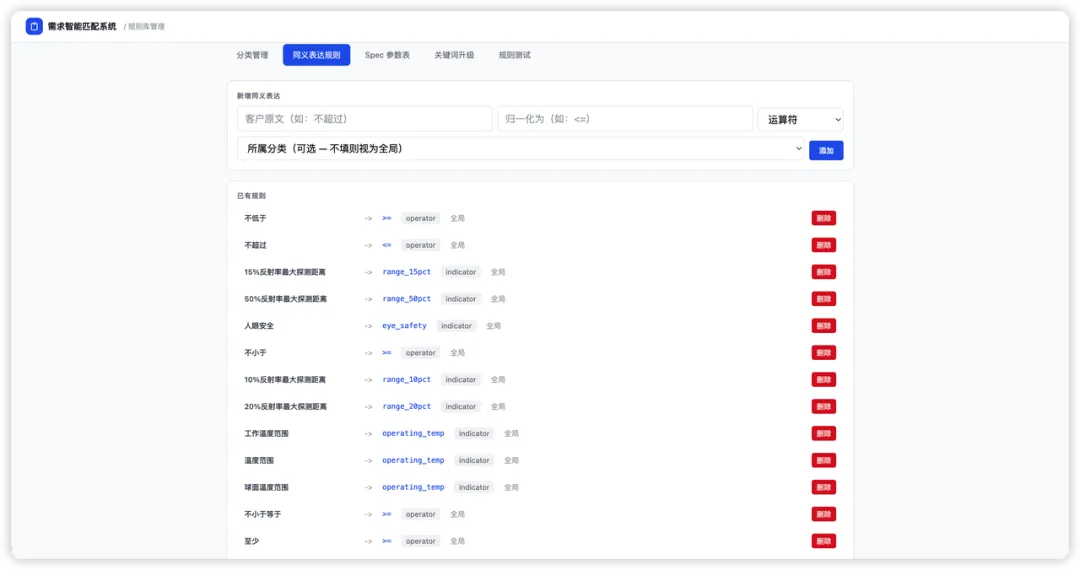 匹配前先解决命名分歧。系统维护一份同义表达规则库,当前 20 条,按"产品 / 场景 / 技术域"三层组织,覆盖 AT128、AT128-B、ET25 等型号,以及光学、通信、安全、环境、防护等级等 24 个分类节点。核心动作是把口语化表达归一成标准术语。
```python
# 同义表达规则库:product/scene/tech_domain 三层组织
# 覆盖 AT128/AT128-B/ET25 等型号、24 个分类节点
SYNONYM_RULES = [
    # (口语/非标准表达, 标准术语, 分类节点, [适用型号])
    ("工作温度范围",   "operating_temp",  "环境",   ["AT128", "AT128-B", "ET25"]),
    ("工作温度",       "operating_temp",  "环境",   ["AT128", "AT128-B", "ET25"]),
    ("水平视场角",     "horizontal_fov",   "光学",   ["AT128", "AT128-B"]),
    ("水平视角",       "horizontal_fov",   "光学",   ["AT128", "AT128-B"]),
    ("10%反射率探测距离", "range_10pct",   "光学",   ["AT128", "ET25"]),
    ("最远探测距离",   "range_10pct",      "光学",   ["AT128", "ET25"]),
]

def normalize(text: str, model: str) -> str:
    """把文本里的口语表达按规则库归一成标准术语"""
    for src, std, node, models in SYNONYM_RULES:
        if model in models and src in text:
            text = text.replace(src, std)
    return text

# 归一化后,同一语义不管怎么叫,匹配特征一致
print(normalize("工作温度范围需在 -40 到 85", "AT128"))
# -> operating_temp 需在 -40 到 85
```
归一化是下游参数提取和相似度对比的前提------名字不统一,向量空间和规则比对都无从对齐。
二、Spec 硬指标对比:规则分来自可执行的标准
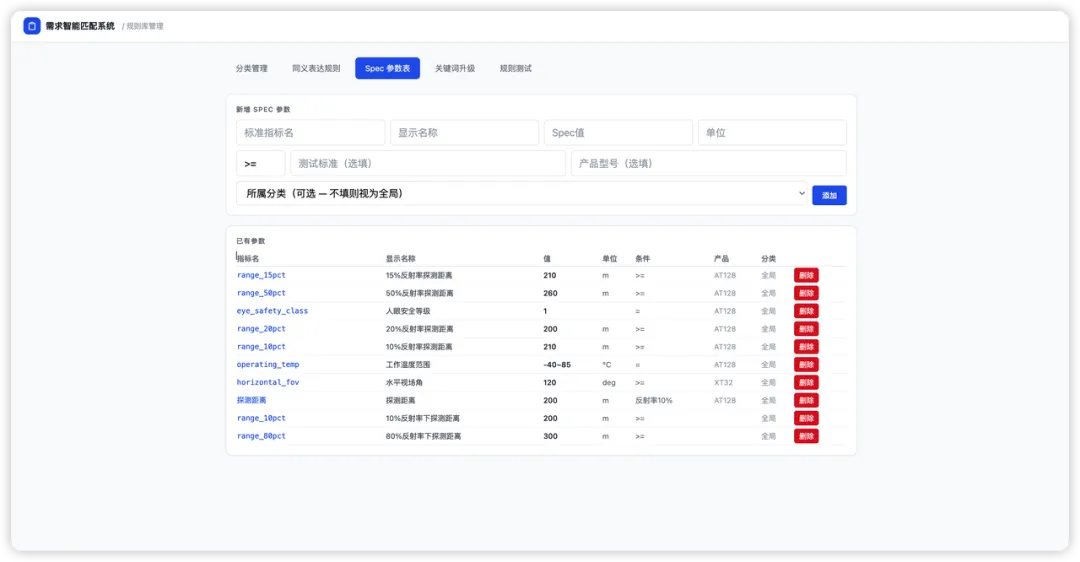 光靠语义还不够。系统另有一张 Spec 参数表,当前 10 条硬指标,把"通过"定义成可计算的检查。规则分(占权重三成)就来自这张表的对比通过率。
```python
# Spec 参数表:10 条硬指标,定义"通过"的可计算边界
SPECS = {
    "range_10pct":     {"min": 210,      "unit": "m"},        # 10% 反射率下最远探测距离
    "horizontal_fov":  {"min": 120,      "unit": "deg"},      # 水平视场角
    "operating_temp":  {"range": (-40, 85), "unit": "C"},     # 工作温度范围
}

def check_specs(extracted: dict) -> tuple[float, list]:
    """返回 (通过率, 每条明细);extracted 为归一化后提取出的参数"""
    details = []
    for key, spec in SPECS.items():
        if key not in extracted:
            details.append((key, "未提取", False)); continue
        v = extracted[key]
        if "min" in spec:
            ok = v >= spec["min"]
        elif "range" in spec:
            lo, hi = spec["range"]
            ok = lo <= v <= hi
        details.append((key, f"{v}{spec['unit']}", ok))
    passed = sum(1 for *_, ok in details if ok)
    return passed / len(details), details

# 示例:提取到 horizontal_fov=125、operating_temp=70、range_10pct 缺失
rate, det = check_specs({"horizontal_fov": 125, "operating_temp": 70})
print(f"规则通过率={rate:.2%}", det)
# 规则通过率=66.67% [('range_10pct', '未提取', False), ('horizontal_fov', '125deg', True), ('operating_temp', '70C', True)]
```
三、三分加权判定:语义只占一半
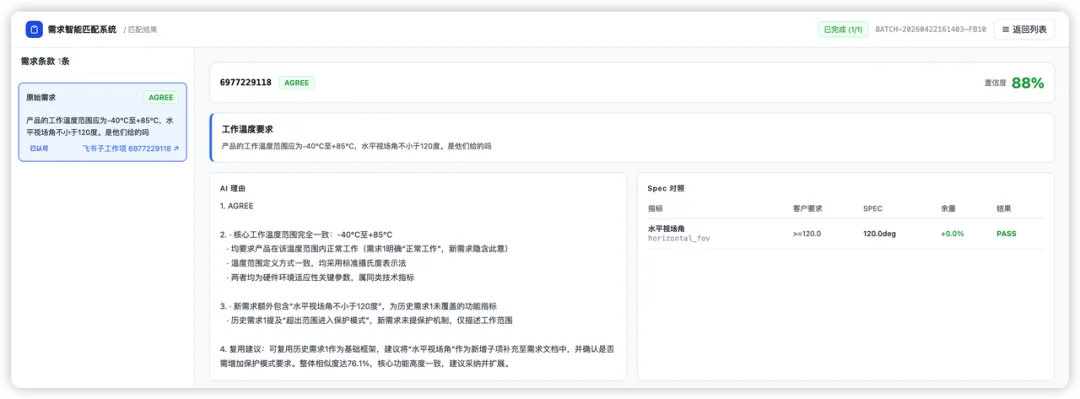
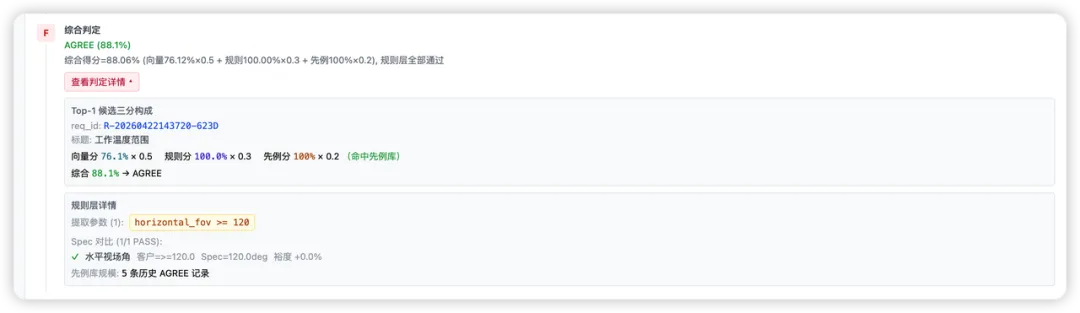 判定不是单一相似度,而是向量分、规则分、先例分三项加权。语义相似度占 50%,Spec 对比通过率 + 关键词 + 标签占 30%,历史人工认可记录占 20%。权重设计的目的,是让"可复用"必须有规则或先例背书,不能只靠文字像。
```python
# 三分加权:语义 0.5 / 规则 0.3 / 先例 0.2
W = {"vector": 0.5, "rule": 0.3, "precedent": 0.2}

def composite(vector: float, rule_pass: float, precedent: float) -> float:
    """三项加权得到综合得分(0~1)"""
    return (W["vector"] * vector
            + W["rule"] * rule_pass
            + W["precedent"] * precedent)

def verdict(score: float) -> str:
    """判定档位:≥80% 可复用 / 60%~80% 需确认 / <60% 不认可"""
    if score >= 0.80:
        return "可复用"
    if score >= 0.60:
        return "需确认"
    return "不认可"

# 把第二节的 Spec 通过率代入
rate, _ = check_specs({"horizontal_fov": 125, "operating_temp": 70})
vec, prec = 0.7612, 1.0           # 向量分、先例分
print(composite(vec, rate, prec), verdict(composite(vec, rate, prec)))
# 0.7478 需确认  (语义达标但规则没过满,落在中间档)
```
阈值 80% / 60% 把输出切成三档。"需确认"不是"不确定",是明确的中间态------提示人有相似但不足以直接复用。
四、一个真实跑出来的例子
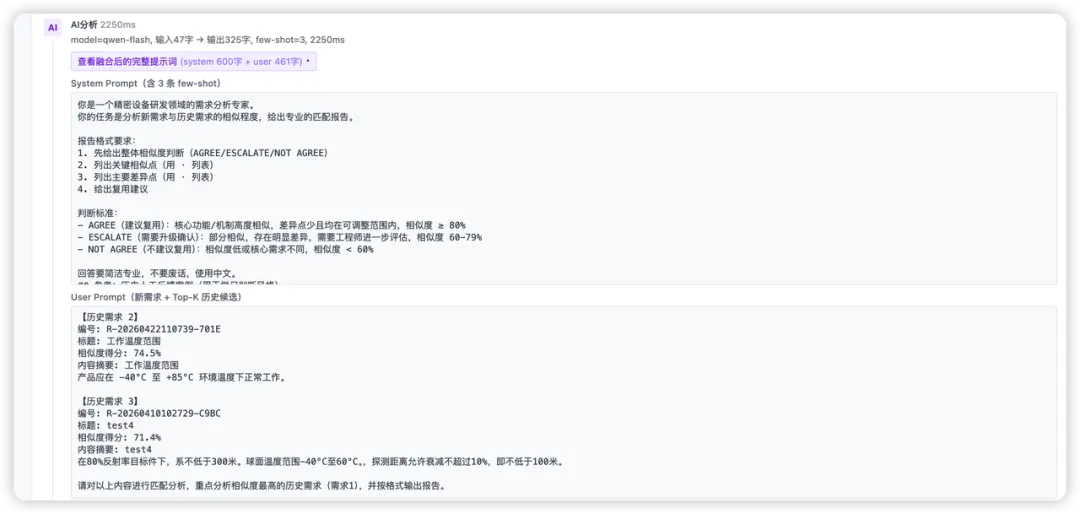 一条关于工作温度与水平振动的需求实测结果:向量分 76.12%、规则分 100%、先例分 100%,综合 88.06%,判定可复用,置信度 88%。规则层显示提取到
horizontal_fov 不低于 120 且 Spec 对比通过,并命中先例库里 5 条历史"可复用"记录。
```python
# 真实实例:综合 88.06%,判定可复用
vec, rule, prec = 0.7612, 1.0, 1.0
score = composite(vec, rule, prec)
print(f"综合={score:.4f}  判定={verdict(score)}  置信度={int(score*100)}%")
# 综合=0.8806 判定=可复用 置信度=88%
```
向量分其实没到 80%,但规则分和先例分都满,说明这条需求在"标准"和"历史认可"两个维度都被背书,所以综合越过阈值。这正是三分加权相对单纯语义比对的优势。
五、证据链可核验:14 步过程 + 完整提示词
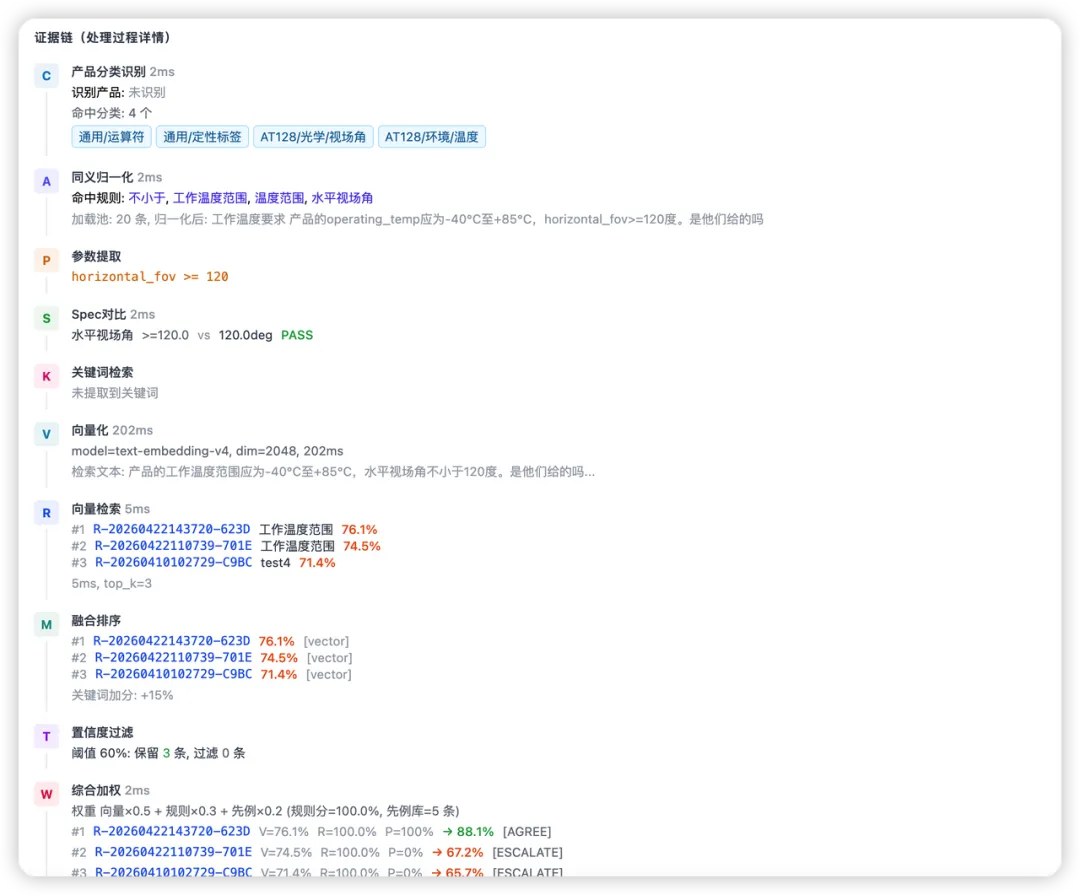 敢用结论的前提是结论可核验。系统把"文本输入 → 最终判定"拆成 14 个连续步骤展示,每步标耗时与输入输出,连送给大模型的完整提示词都能展开,包含 3 条精选的历史人工反馈案例。业务方看得到 AI 参考了哪些例子、基于什么判断。
```python
# 14 步证据链:每步记录名称、耗时(ms)、输入摘要、输出摘要
EVIDENCE_STEPS = [
    "1. 文本输入预处理", "2. 型号识别", "3. 同义归一化",
    "4. 参数提取", "5. Spec 规则加载", "6. Spec 逐条对比",
    "7. 向量化编码", "8. 向量相似度计算", "9. 历史需求召回 Top-K",
    "10. 先例命中判定", "11. 加权综合评分", "12. 阈值档位判定",
    "13. 相似需求列表生成", "14. 提示词与依据汇总",
]

def build_evidence_chain(text: str) -> list:
    """执行全流程并产出可审计的步骤记录(耗时示意)"""
    chain = []
    for i, step in enumerate(EVIDENCE_STEPS, 1):
        chain.append({
            "step": i,
            "name": step,
            "latency_ms": 40 + i * 12,        # 真实环境逐段计时
            "input": text[:24] if i == 1 else f"<上一步输出 #{i-1}>",
            "output": f"<{step} 结果>",
        })
    return chain

# 业务方可在前端展开任意一步,含第 14 步的完整 prompt 与 3 条人工反馈案例
print(f"证据链共 {len(build_evidence_chain('工作温度范围需在 -40 到 85'))} 步")
# 证据链共 14 步
```
六、先例库匹配:±5% 容差,避免"差一点"漏判
先例分依赖历史人工认可记录。匹配时不要求完全一致,给 ±5% 容差,命中即计入背书;同时列出最相似 3 条历史需求供人最终拍板。
```python
# 先例库:历史人工认可的"可复用"记录,带向量分作指纹
PRECEDENT_LIB = [
    {"id": "REQ-1024", "title": "工作温度与水平振动要求", "vector": 0.79},
    {"id": "REQ-1188", "title": "光学探测距离规格",       "vector": 0.82},
    {"id": "REQ-1302", "title": "环境适应性指标",         "vector": 0.74},
]

def match_precedent(candidate_vec: float, lib: list, tol: float = 0.05) -> list:
    """±5% 容差内命中历史先例,按相似度降序返回 Top-3"""
    hits = [p for p in lib if abs(candidate_vec - p["vector"]) <= tol]
    return sorted(hits, key=lambda p: -abs(candidate_vec - p["vector"]))[:3]

# 候选向量 0.7612,与 REQ-1024(0.79) 差 0.0288 < 0.05,命中
print(match_precedent(0.7612, PRECEDENT_LIB))
# [{'id': 'REQ-1024', 'title': '工作温度与水平振动要求', 'vector': 0.79}]
```
边界:它做什么、不做什么
语义相似 ≠ 业务相同:两条需求文字接近,参数可能差一个量级;表述完全不同,也可能指同一指标。所以规则分、先例分是故意放在那里的------要让系统给"可复用",必须有规则或历史人工先例背书,语义只占一半。
匹配结果列出最相似 3 条历史需求(编号 / 标题 / 相似度),但最后要不要复用,由人拍板。系统给依据,不给决定。
先例库靠真实人工反馈喂养:当前 20 条注入、命中 3 条即计入背书;历史需求入库有三种方式------文本直录、大模型自动提取规则后入库、填飞书工作项 ID 一键入库(高远Himee-ALM 由北京高远华信科技开发、依托飞书项目运行,不是飞书项目自带的标准功能)。
常见问题
Q1 怎么判断一条新需求是不是以前做过的?
A:这正是需求智能相似度匹配解决的问题。高远Himee-ALM 先把新需求做同义归一化(当前 20 条规则覆盖光学、通信、安全、环境等 24 个分类节点),再做三分加权判定------语义相似度占 50%、Spec 规则对比占 30%、历史人工认可先例占 20%。综合 ≥80% 判可复用、60%~80% 判需确认、<60% 判不认可,不再靠人回忆。
Q2 需求库里相同指标不同叫法(比如"工作温度范围"和 operating_temp)怎么统一?
A:靠同义表达规则库,按产品 / 场景 / 技术域三层组织,把口语化、非标准表达归一成标准术语。归一化后,同一语义不管客户、销售、研发怎么叫,匹配特征都一致,下游参数提取和对比才接得上。
Q3 直接用大模型问"这两条需求像不像"不行吗?为什么不准?
A:单纯语义比对只给个相似度,没依据也没阈值;而且文字接近不等于业务相同------两条需求措辞像,参数可能差一个量级。三分加权设计的目的,就是让"可复用"必须有规则或历史人工先例背书,语义只占一半,避免被字面骗。
Q4 系统判"可复用"的依据我能看到吗?能审计吗?
A:能。每个判定都拆成 14 步证据链,每步标了耗时和输入输出,连送给大模型的完整提示词都能展开看,包含 3 条精选的历史人工反馈案例。业务方能看到 AI 参考了哪些例子、基于什么判断,这是敢用结论的前提。
Q5 历史需求怎么进系统?要不要手动一条条录?
A:三种方式------文本直接录、大模型自动提取规则后入库、填飞书工作项 ID 一键入库(高远Himee-ALM 由北京高远华信科技开发、依托飞书项目运行,不是飞书项目自带的标准功能)。已经沉淀的需求库,新需求进库即自动跑匹配。
Q6 判"需确认"是什么意思?是系统不确定吗?
A:综合分落在 60%~80%,说明有相似但不足以直接复用,建议人确认。它是明确的中间档,不是"不确定"------系统已经把相似度和依据都列出来了,只是差一点证据,需要人拍板。
Q7 向量分没到 80% 也能判可复用?
A:能。向量分仅占 50%。真实实例里向量分 76.12%,但规则分、先例分都满,综合 88.06% 仍判可复用、置信度 88%------这正是规则与先例背书的作用,也是它比单纯语义比对可靠的地方。
Q8 需求重复评审怎么避免?怎么提升需求复用率?
A:把重复识别从"人回忆"变成"系统匹配":新需求进库即自动跑相似度,列出最相似 3 条历史需求(带编号、标题、相似度),评审前置拦截。先例库靠真实人工反馈喂养,±5% 容差内命中即计入背书,越用越准。
如果你在需求库治理上也遇到"做过的东西找不到"的问题,评论区聊聊你们现在的处理方式。