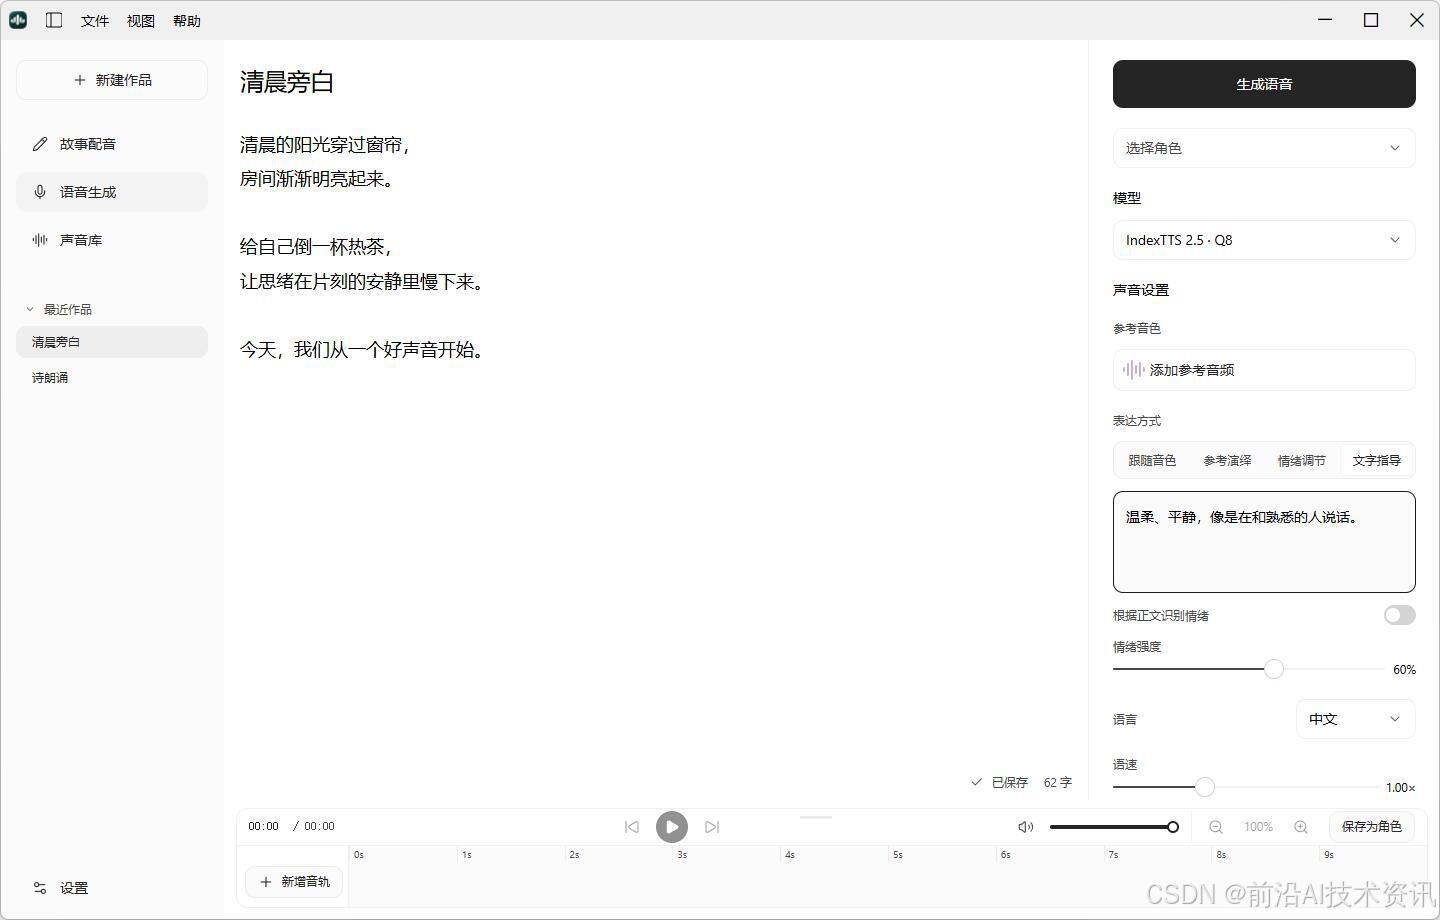
yovoice 是一款开源的本地语音创作工具,主要面向 macOS(Apple Silicon)和 Windows 用户。它的核心目标是:在电脑本地把文字变成自然、有感情的语音,完全不依赖云端 API,也没有按字数收费。简单说,就是一个免费的"本地配音软件",让你自己控制声音,成本更低,隐私也更好。
yovoice 把"本地高质量配音"做成了开箱即用的桌面工具,特别适合不想依赖云服务、也不想按字付费的创作者。
主要特点
本地运行:所有生成都在你电脑上完成,模型下载后即可离线使用。
音色克隆:导入或录制一段参考音频,就能复刻类似的音色。
情绪与表达控制:可以调整情绪,或者用文字描述想要的说话风格(比如温柔、激动、平静等)。
声音设计:部分模型支持直接用文字描述想要的声音(例如"年轻女性,声音清澈温柔"),不需要参考音频。
完整工作流:支持导入/录制音频、裁剪、预览、导出,还能管理音色库和作品历史。
多种 TTS 模型:内置支持 IndexTTS、VoxCPM2、OmniVoice、Qwen3-TTS、Kokoro 等,可按需下载不同精度版本。
硬件加速:macOS 支持 Metal,Windows 支持 CPU / NVIDIA CUDA(还有实验性 Vulkan)。
应用领域
视频旁白 / 配音:给短视频、教程、解说视频加旁白。
有声书 / 有声内容:把文字故事转成有感情的朗读。
故事配音:支持导入字幕、分段生成,方便做多角色故事。
个人创作与试听:快速实验不同音色和情绪,反复调整效果。
使用教程: (支持CPU和独显运行)
windows版支持CPU、CUDA和VulkanGPU,需要在设置里的引擎库手动切换
下载对应系统的安装包。macOS 是 .dmg,拖进应用程序就行;Windows 是 setup.exe,装完从开始菜单打开。
首次用的时候在设置里下载模型(模型使用的是国内的魔搭镜像,速度很快),后面断点续传也支持。模型文件存在 ~/.yovoice,卸载软件不会删掉。
装好后四步走:下模型 → 建项目(故事配音或语音生成)→ 输入文字或导入字幕,选角色调声音 → 生成、预览、导出。更新在后台检查,提示重启就装上。
下载地址: 点此下载