numpy.random .Statistics统计实战指南
一份实用 numpy.random 统计指南,覆盖随机生成器、概率分布、模拟、抽样、收敛、相关性和 Bootstrap。
- 使用 Generator 对象和可复现随机流,避免隐藏的全局状态。
- 把分布参数与假设、期望、方差和观测数据联系起来。
- 使用清晰单位和诊断设计 Monte Carlo 与重采样实验。
- 负责任地解释随机性、不确定性、收敛性、依赖性和可复现性。
示例均为独立代码片段,可复制到 Python 3 环境中运行。
1. 随机生成器、种子与统计含义
NumPy 的现代随机 API 以 Generator 对象为核心。Generator 把位生成器和分布方法结合起来,使随机状态明确可见。种子初始化一个可复现的随机流;但使用相同种子并不意味着不同实验在统计上彼此独立。
|-------------------|----------------|-----------------|
| 对象或方法 | 用途 | 推荐用法 |
| default_rng(seed) | 创建现代 Generator | 每个实验使用局部生成器 |
| rng.random | [0, 1) 上的均匀值 | 概率和单位正方形采样 |
| rng.integers | 离散均匀整数 | 索引、类别和随机选择 |
| rng.choice | 抽样或重采样 | Bootstrap 和分类抽样 |
| rng.permutation | 随机重排 | 不放回打乱 |
| rng.shuffle | 原地打乱数组 | 只在明确需要修改时使用 |
import numpy as np
rng = np.random.default_rng(2026)
a = rng.normal(loc=10.0, scale=2.0, size=5)
b = rng.integers(0, 10, size=5)
print(a)
print(b)
重新创建生成器会重现随机流
same_rng = np.random.default_rng(2026)
assert np.allclose(a, same_rng.normal(10.0, 2.0, size=5))
可复现不只是种子
- 记录种子、NumPy 版本、生成器类型、分布参数、样本量和随机调用顺序。
- 可复用库或测试中不要依赖隐式全局随机状态。
- 并行模拟需要独立随机流时,应使用独立或派生的生成器。
- 结果可复现并不代表实验无偏或模型正确;重复性不是有效性的同义词。
2. 分布、参数、矩与抽样
随机分布编码关于可能取值及出现频率的假设。NumPy 可以从多种常见连续和离散分布中抽样。参数应通过期望、方差、支持范围和实际生成机制解释,而不能只因为直方图看起来方便就选择某个分布。
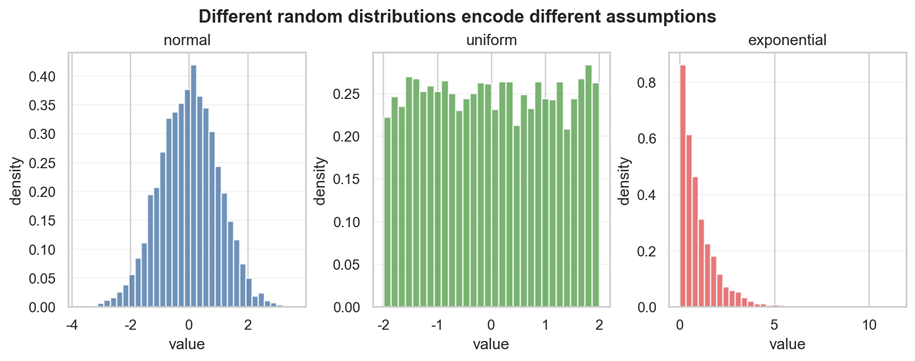
图 1:正态、均匀和指数分布表达不同形状与假设。
rng = np.random.default_rng(2026)
normal = rng.normal(loc=50.0, scale=8.0, size=10_000)
uniform = rng.uniform(low=0.0, high=1.0, size=10_000)
exponential = rng.exponential(scale=3.0, size=10_000)
poisson = rng.poisson(lam=4.0, size=10_000)
for name, values in ("normal", normal), ("uniform", uniform), ("exponential", exponential), ("poisson", poisson):
print(name, values.mean(), values.var())
|-------------|-----------------|--------------|
| 分布 | 参数 | 常见解释 |
| normal | loc、scale | 对称测量噪声或聚合效应 |
| uniform | low、high | 有界区间内等可能 |
| exponential | scale | 恒定风险假设下的等待时间 |
| binomial | n、p | n 次试验中的成功次数 |
| poisson | lam | 曝光区间中的计数 |
| lognormal | 对数值的 mean、sigma | 正值乘法量 |
矩与样本估计
理论矩描述分布;样本矩会围绕理论值波动。描述样本时通常使用 ddof=1 的样本方差,并明确区分模拟汇总中的总体式统计与推断中的样本估计。
3. 大数定律与中心极限定理直觉
在适当条件下,大数定律说明独立观测的平均值会随着样本增加趋近于期望值。中心极限定理解释了为什么即使原始分布不是正态,标准化的和或样本均值也常常趋近于正态形状。
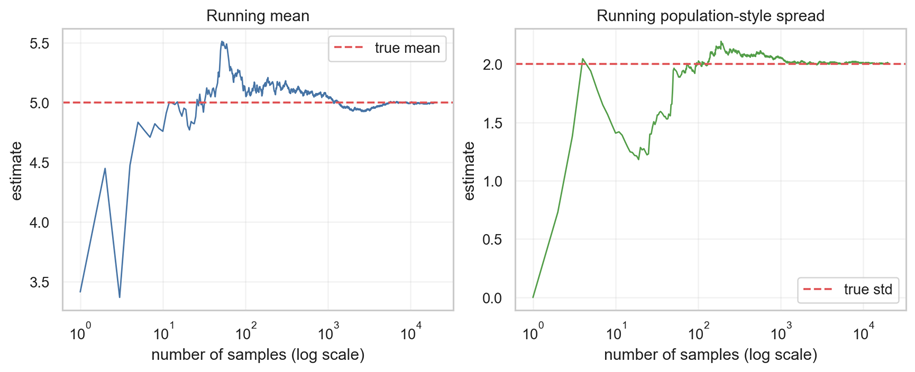
图 2:随着独立样本累积,运行估计通常趋于稳定。
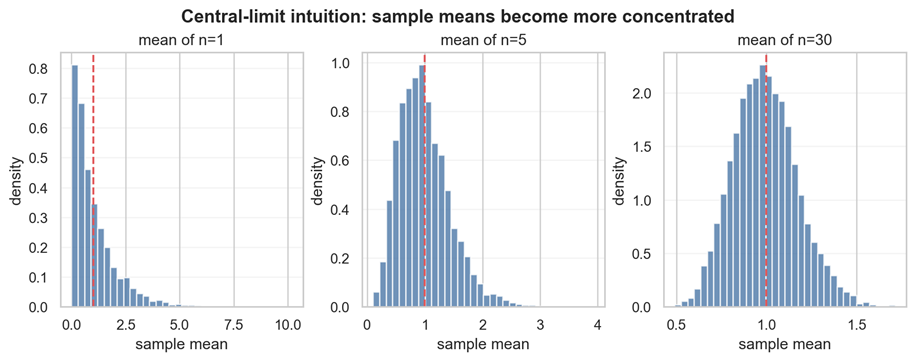
图 3:越来越大的指数分布样本均值更集中,也更接近钟形。
rng = np.random.default_rng(2026)
values = rng.exponential(scale=2.0, size=50_000)
running_mean = np.cumsum(values) / np.arange(1, values.size + 1)
for n in 10, 100, 1_000, 10_000, 50_000:
print(n, running_meann - 1)
print("theoretical mean:", 2.0)
|----------------|------------------|-------------|
| 思想 | n 增加时的变化 | 不会改变的内容 |
| 大数定律 | 样本平均更稳定 | 分布的期望 |
| 中心极限定理 | 均值的标准化形状趋近正态 | 有限样本的偏态可能保留 |
| 标准误 | 通常按 1/sqrt(n) 下降 | 依赖性可能改变速度 |
| Monte Carlo 误差 | 估计方差随样本增加降低 | 错误模拟模型带来的偏差 |
依赖性很重要
上述收敛直觉通常假设观测独立或只有合适的弱依赖。自相关、聚类、自适应抽样或反复使用同一随机值,都可能让名义样本量高估实际信息量。
4. Monte Carlo 积分、概率与随机游走
Monte Carlo 方法通过随机抽样估计目标量。对于均匀采样的区域,可以用落入区域的点比例估计面积;对于期望,可以用模拟值的平均估计。Monte Carlo 很灵活,但通常收敛较慢,因此应在模拟前声明精度要求。
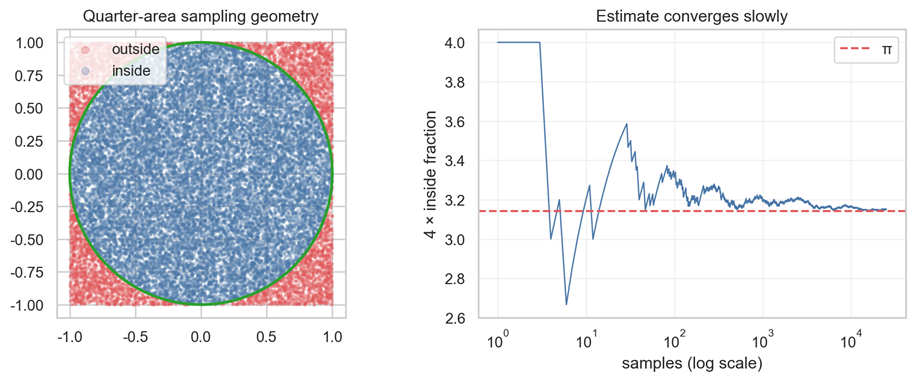
图 4:通过单位圆内点的比例估计 π。
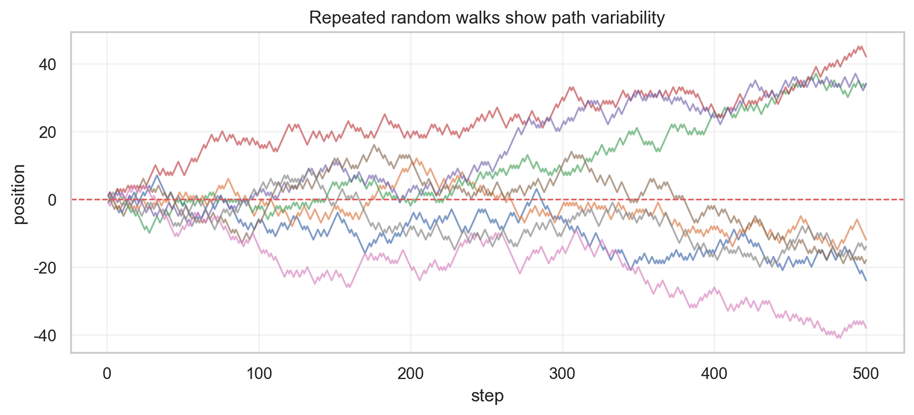
图 5:相同规则的随机游走也可能产生差异很大的路径。
rng = np.random.default_rng(2026)
用模拟平均估计 Eg(X)
x = rng.normal(loc=0.0, scale=1.0, size=1_000_000)
estimate = np.mean(np.exp(-0.5 * x**2))
standard_error = np.std(np.exp(-0.5 * x**2), ddof=1) / np.sqrt(x.size)
print(estimate, standard_error)
随机游走路径
steps = rng.choice(-1, 1, size=(100, 500))
paths = np.cumsum(steps, axis=1)
|--------------------|---------------|--------------|
| Monte Carlo 组成 | 问题 | 实践 |
| 目标量 | 估计什么期望、概率或积分? | 先用数学形式写出 |
| 提议/采样器 | 点如何生成? | 检查支持范围和权重 |
| 估计量 | 如何从样本计算结果? | 说明偏差和方差行为 |
| 误差估计 | 模拟有多不确定? | 使用重复运行或标准误逻辑 |
| 停止规则 | 何时达到足够精度? | 设置容差或样本预算 |
Monte Carlo 注意事项
再多的抽样也不能纠正错误目标、有偏采样器、错误单位转换或被忽略的依赖性。应绘制运行估计,并在可能时与已知解析值比较。
5. 多元抽样、协方差与依赖性
随机变量可以联合模拟。协方差描述线性共同变化,相关系数则用边际尺度标准化协方差。多元正态模型的协方差矩阵必须是对称半正定的;实际工作中数值舍入可能需要轻微修正。
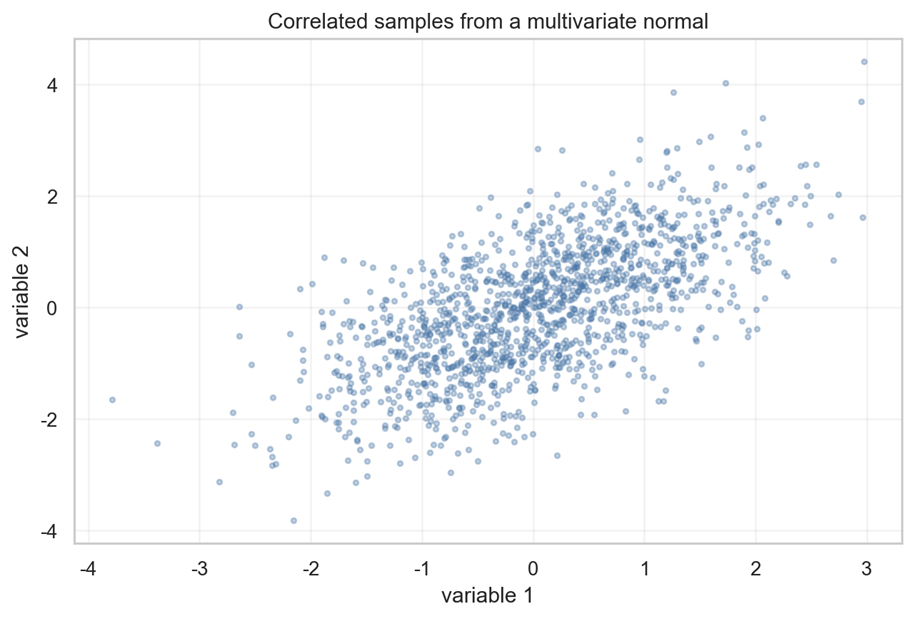
图 6:多元正态生成器可以产生相关观测。
rng = np.random.default_rng(2026)
mean = np.array(10.0, 20.0)
covariance = np.array(\[4.0, 2.4, 2.4, 9.0])
sample = rng.multivariate_normal(mean, covariance, size=5000)
sample_covariance = np.cov(sample, rowvar=False, ddof=1)
sample_correlation = np.corrcoef(sample, rowvar=False)
print(sample.mean(axis=0))
print(sample_covariance)
print(sample_correlation)
|-------|-------------------|------------|
| 量 | 公式思想 | 含义 |
| 协方差 | E(X−μX)(Y−μY) | 原始单位下的共同变化 |
| 相关系数 | cov(X,Y)/(σXσY) | 无量纲线性依赖 |
| 协方差矩阵 | 成对协方差组成的矩阵 | 联合离散程度和方向 |
| 边际分布 | 单个分量的分布 | 忽略其他变量后的行为 |
| 联合分布 | 所有分量的共同分布 | 依赖性和边际分布 |
相关不等于因果
- 共同驱动因素可能产生相关,但不代表直接关系。
- 非线性依赖可能无法被协方差和相关系数发现。
- 模拟的依赖性反映协方差模型,并不能验证模型本身。
- 把样本协方差与目标协方差比较,并检查散点图。
6. Bootstrap、置换与抽样设计
Bootstrap 通过有放回地重复抽取观测,近似统计量的抽样分布。置换方法在零假设的可交换性条件下重新分配标签或数值。两者都很有用,但重采样单位必须与研究设计一致。
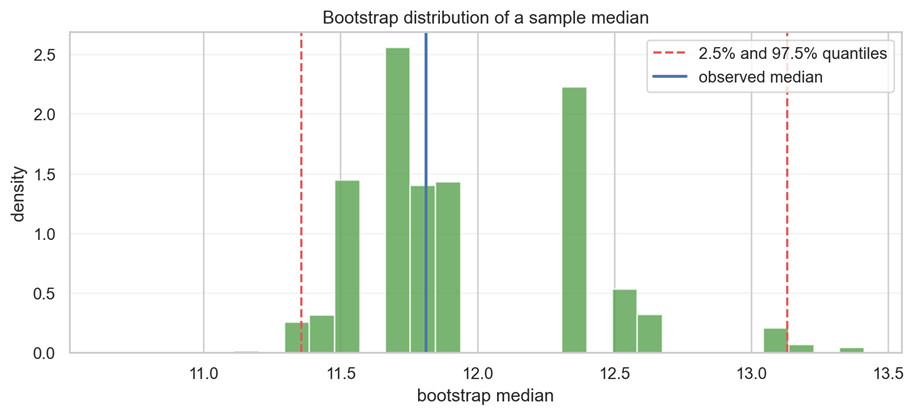
图 7:Bootstrap 中位数形成用于不确定性分析的经验分布。
rng = np.random.default_rng(2026)
sample = np.array(11.2, 12.4, 9.8, 13.1, 10.7, 12.0, 11.6)
statistics = np.array(
np.median(rng.choice(sample, size=sample.size, replace=True))
for _ in range(10_000)
)
interval = np.quantile(statistics, 0.025, 0.975)
print("observed:", np.median(sample))
print("percentile interval:", interval)
|-------------|-------------|------------|
| 方法 | 重采样规则 | 适合对齐 |
| Bootstrap | 有放回地抽取观测 | 估计量的抽样不确定性 |
| Permutation | 在零假设下重新分配标签 | 基于随机化的零分布 |
| Jackknife | 每次去掉一个观测 | 影响度和近似方差 |
| 分层抽样 | 在组内抽样 | 保持子组代表性 |
| 区块抽样 | 抽取连续或成组单位 | 处理依赖和时间结构 |
Bootstrap 的限制
普通 Bootstrap 可能不适用于相关时间序列、聚类观测、边界参数或极小样本。数据生成过程需要时,应使用区块、聚类、分层或基于模型的设计。
7. 统计验证与可复现模拟检查表
随机模拟应被视为计算实验。运行前定义目标、假设、生成器、样本量、估计量、诊断和不确定性。应在干净环境中重现结果,并测试简单的极限情况。
|---------|-------------------------|-----------------|
| 检查项 | 问题 | 行动 |
| 生成器 | 随机状态是否明确且可复现? | 创建并记录 Generator |
| 分布 | 支持范围和参数是否符合模型? | 检查边界、矩和图形 |
| 独立性 | 抽样或重采样单位是否独立? | 合理使用随机流或区块 |
| 样本量 | Monte Carlo 或抽样误差是否可接受? | 估计标准误并重复运行 |
| 估计量 | 样本如何映射到结果? | 写出公式和单位 |
| 验证 | 是否有已知值或不变量? | 进行比较和往返检查 |
| 报告 | 他人能否重新生成? | 保存种子、版本、参数和代码 |
可复现模拟摘要
rng = np.random.default_rng(2026)
sample = rng.normal(loc=5.0, scale=2.0, size=100_000)
summary = {
"seed": 2026,
"distribution": "normal",
"loc": 5.0,
"scale": 2.0,
"n": sample.size,
"sample_mean": float(sample.mean()),
"sample_std_ddof1": float(sample.std(ddof=1)),
"standard_error": float(sample.std(ddof=1) / np.sqrt(sample.size)),
}
print(summary)
numpy.random 统计最终检查表
- 使用 default_rng,并记录种子、生成器、参数和调用顺序。
- 根据建模量的机制和支持范围选择分布。
- 区分理论矩、有限样本估计和 Monte Carlo 误差。
- 使重采样和抽样设计匹配独立性、聚类和时间结构。
使用已知结果、收敛图、不确定性估计和独立重复进行验证。