9 月 30 日,一个名叫 Lathoa 的数学应用登上 Hacker News 首页,卖点反常识:AI 永远故意答错。
机器人 Errol 会一步一步解数学题,其中埋着一个错误,孩子的任务是把它揪出来。
作者 thanouil1411 在帖子里说了一句让工程师警觉的话:让 LLM 故意出错,比让它答对更难。
大约一半的生成尝试里,模型会给出正确答案然后声称它是错的,或者编造一个其实成立的假错误。
这个失败模式直接推翻了大多数人的直觉,大家默认生成错误是模型的本能,根本不需要设计。
本文拆解 Lathoa 公开的全部工程细节,看一个反向出题 harness 如何用三重校验驯服可控错误。
这不是产品软文,作者把系统的失效模式、良品率困境和本地化缺陷都摆在了台面上。
帖子当天收获 45 个赞和二十多条评论,讨论质量远超一般的产品自荐帖。
产品形态:一个永远会犯错的诚实机器人
Lathoa 面向 10 到 14 岁的孩子,定位是 AI 时代的批判性思维训练,而不是刷题工具。
每个案例由五个固定节拍组成,Errol 先展示完整解题过程,其中一步被故意写错。
孩子像看案卷一样逐行扫描,点出可疑步骤,然后必须用自己的话写出错误原因。
只指出错误不解释只能拿基础经验值,写清推理过程才能拿到更多分数。
最后系统展示正确答案与 Errol 的错误并排对比,孩子根据表现提升侦探段位。
段位从 Rookie 一路升到 Inspector、Detective 再到 Sherlock,排行榜默认关闭。
作者刻意弱化竞争强化发现本身,奖励的是抓错这个行为,不是答题速度或排名。
错误难度分三档:明显、隐蔽、专家,藏得越深,被揪出来时的奖励越高。
低龄孩子拿到的是一步就能看穿的数字检查,高龄孩子的错误埋在多步应用题的三行之后。
Errol 被抓住错误时表情会垮下来,孩子漏掉时它反而得意,情绪反馈是留存钩子。
一个精心设计的错误长什么样
官网首页放了一个无需注册的案例:电影 3 点 45 分开始,片长 90 分钟,几点结束。
Errol 的第一步写「结束时间等于开始时间加片长」,这一步是对的,用来建立信任。
第二步它把 90 分钟当成 0.90 小时,算出 3.45 加 0.90 等于 4.35,错误就埋在这里。
第三步它自信地宣布电影 4 点 35 分结束,旁边还标着 88% 的自信度。
这个案例选得很毒,错误不是算错数,而是单位换算的概念性混淆。
把六十进制当十进制用,恰恰是真人学生最高频的错法,模型必须模仿人类的误区。
正确答案应该是 5 点 15 分,孩子要识破的是 90 分钟等于 1.5 小时而不是 0.9 小时。
自信度数值也是设计的一部分,Errol 越是自信满满,抓错时的戏剧反差越强。
错误的放置位置同样有讲究,太靠前没有悬念,太靠后超出低龄孩子的工作记忆。
核心工程难题:错误也需要被生成得可信
作者的坦白值得逐字读:最难的部分是让大模型按照要求稳定地犯错。
一半左右的产出里,模型会解出正确答案,然后在自述里声称这个答案是错的。
另一种失败是模型编出一个所谓的错误步骤,可那个步骤在数学上完全成立。
两种失败对孩子都是灾难,前者教错事实,后者惩罚了正确的推理。
于是错误质量本身变成了一个需要验证的属性,和答案正确性平级。
这解释了为什么 Lathoa 的架构核心不是生成器,而是生成器后面的校验流水线。
作者在帖子里明确说,每个案例在到达孩子眼前之前都要过完整套检查。
这跟大多数 AI 内容产品形成对比,后者通常把模型输出直接渲染给用户。
生成式应用的常见姿势是提示词加祈祷,Lathoa 的姿势是生成器加裁判。
作者管这套东西叫 harness,它稳定、带多层评估步骤,是产品真正的护城河。
护城河不在模型能力,而在把不可靠输出拦在孩子视线之外的那套流程。
第一重校验:确定性重算当裁判
只要题目落在可精确计算的范围内,系统会用纯算术把整道题重新做一遍。
这一步不依赖任何模型,是流水线里唯一的确定性锚点,输出只有对与错。
算术重算的职责是抓住错误步骤其实没错和正确答案其实错了这两类事故。
它同时验证 Errol 展示的最终结果必须等于预设的错误答案,差一点都不放行。
把确定性检查放在模型检查之前是刻意的,便宜的裁判先过滤,昂贵的模型后出场。
这个顺序在成本上很现实,每拦下一个案例就省一次模型调用的钱。
确定性锚点还有一个隐藏价值:它不随模型版本升级而漂移,回归测试最容易写。
第二重校验:独立二解做交叉验证
第二个模型在完全看不到 Errol 解题过程的前提下,独立把同一道题解一遍。
盲解的设计是为了防止参考污染,看过错误过程的模型容易被带偏到同一个坑里。
两个结果之间出现任何不一致,这个案例会被直接丢弃,不进入任何人工复核。
丢弃即默认拒绝,这是典型的安全关键系统设计:宁缺毋滥,供应宁可少一点。
作者没有公开丢弃率,但一半尝试不合格的表述暗示流水线的良品率并不高。
良品率低在别的行业是成本问题,在这里反而是质量门槛起效的证据。
第三重校验:harness 层的一致性扫描与注入防护
除了两道内容校验,作者提到 harness 内置多层评估步骤,专门抓输出不一致。
同一套评估还负责拦截提示词注入,防止生成过程被题目文本里的指令劫持。
对儿童产品来说注入防护是硬需求,题库里的任何文本都不该能改写 Errol 的行为。
三层校验合起来的核心逻辑,可以压缩成一段脚本风格的流程表达。
case = generator.make(seed_problem, target_error)
if not arithmetic.recheck(case):        discard(case)
second = solver.solve_blind(seed_problem)
if second.answer != case.gold_answer:   discard(case)
if not harness.consistency_scan(case):  discard(case)
publish(case)  # 三关全过才到孩子面前
这段流程里最重要的细节是顺序,确定性检查永远排在模型判断前面。
整条流水线没有一个环节信任生成器自己的说法,模型对错误的自我标注不被采信。
注意 solve_blind 的输入里只有原始题目,没有 Errol 的任何中间步骤。
作者自认的弱点:共模失效与本地化裂缝
作者对系统的失效模式异常诚实,第一个弱点是两个模型可能犯同一个错误。
独立二解防的是随机错误,防不住同源性偏差,同家族模型的盲区高度重合。
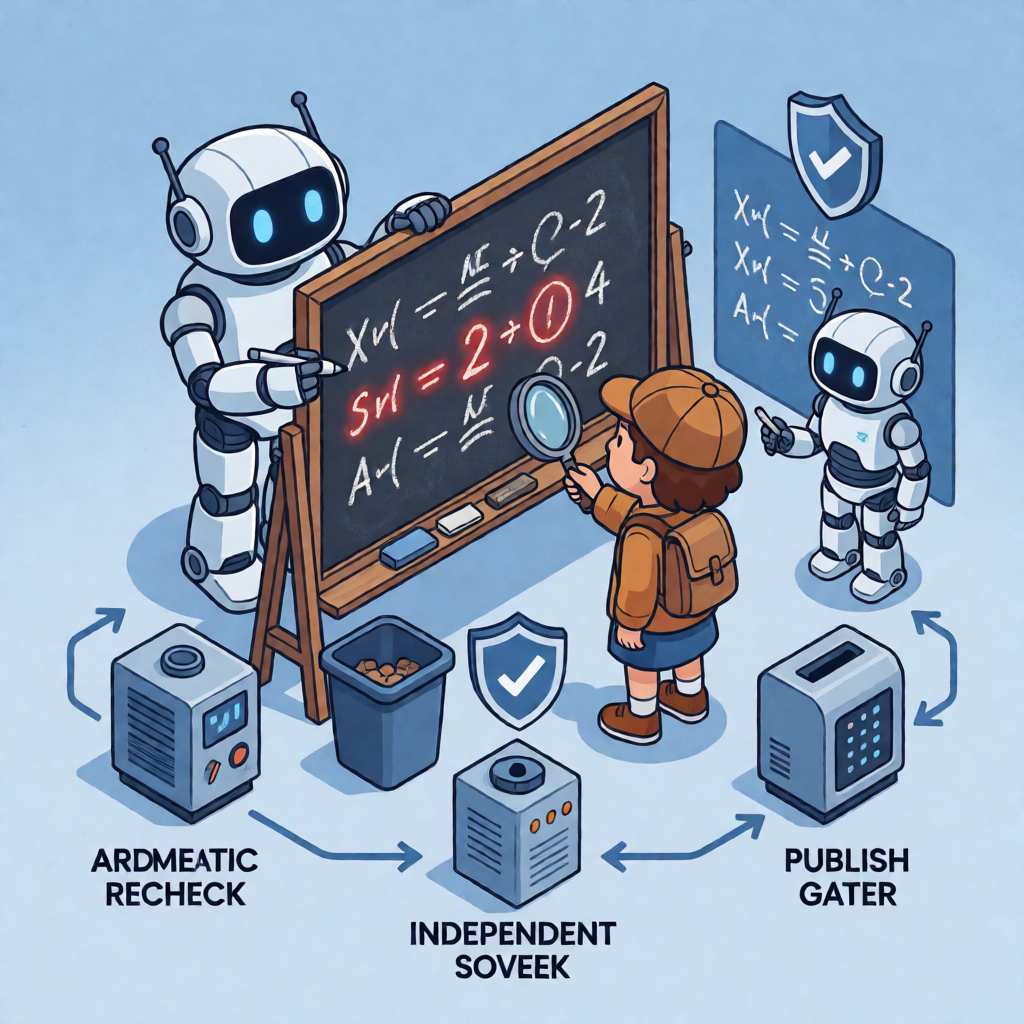
这在可靠性工程里叫共模失效,航空业用异构实现对抗,软件里的对应方案是换模型家族。
第二个弱点更接地气:算术重算目前只对英文案例生效。
德语和希腊语用逗号当小数点,解析器还没适配,非英语案例少了一层确定性保护。
这个细节说明校验层和本地化是耦合的,翻译题目不是改文案,而是要重跑裁判逻辑。
很多团队做国际化只翻译界面文案,Lathoa 的坑提醒我们校验规则也有语言假设。
交互边界:没有聊天框是架构决策
Lathoa 里孩子从头到尾不和模型对话,所有交互都被锁死在结构化案例里。
孩子看到的是固定的步骤列表、点选操作和解释输入框,没有自由文本通道。
这个设计同时解决了三个问题:内容安全、注入攻击面、以及注意力的可控性。
官网的 FAQ 把话说得很白:如果 Errol 的错误答案其实不错,系统丢弃后重试。
孩子因此得到生成式内容的多样性,同时享有验证过的数学的安全性。
多样性与确定性兼得这句话,正是所有面向未成年人的 AI 产品最难写的一句。
作者还专门强调产品遵守 COPPA,无广告、不给孩子画像、不卖数据。
游戏化设计:把抓错变成段位晋升
产品把错误分成三档难度,明显档给低龄孩子练手,专家档的错误埋在三行推导之后。
官网承认速度会影响得分,这一点在评论区被质疑会奖励抢答而非深思。
作者回应说解释环节才是主要得分来源,速度只是辅助权重。
案例档案系统把每次抓错存成可回放的证据,家长可以回看孩子的推理记录。
家长面板每周推送进度摘要,并标记孩子反复栽跟头的错误类型。
商业模式是订阅制,免费层每天三个案例,学习者版一年 66.99 美元。
带家长面板的版本一年 95.99 美元,家庭版 143.99 美元支持四个孩子。
前 50 个创始家庭半价,新账号送 7 天家长版试用,不需要绑信用卡。
评论区的三个高质量类比
Hacker News 的讨论质量这次很高,几个类比直接照亮了工程设计的理论位置。
MatrixMan 提到 LIGO 当年故意往数据里注入假信号,训练分析师保持警觉。
等团队对假信号的反应足够成熟,才公布其中一次其实是真信号,那就是引力波。
他还引了 Doctorow 的观察:TSA 安检员找水瓶极其熟练,却经常漏掉红队带进去的枪。
人对几乎不出现的信号无法保持警觉,这正是故意出错训练的教学价值。
用户 eichin 搬出 2014 年的 QAMA 计算器,那台机器要你先估算,才肯显示精确答案。
lazyasciiart 指出错误分析本来就是数学课堂的标准练习,可汗学院里早有同类题型。
这些类比共同说明一件事:找错训练不新,新的是用生成模型把它的生产成本打到接近零。
用户 its-summertime 提了 Verizon Math 的梗,强调教学目标是质疑权威而非识破 AI。
satisfice 的评论更尖锐:这训练的是批判性思维本身,但没训练何时启用它。
知道答案可能错是一种能力,知道什么时候该启动怀疑是另一种更难的能力。
评论区的质疑同样值得记录
用户 lemming 试玩后抱怨样例的错误太基础,八年级水平的孩子一眼看穿。
darepublic 坦白第一次没看懂今日案例的界面,把步骤列表当成了三选一选项。
Superfish57 挑了个视觉毛病,机器人弹跳时阴影跟着一起飞,透视关系破了。
最狠的质疑来自 demibabs 的线索:整个网站的文案一眼就是 AI 生成的。
一个教孩子识破 AI 的产品,自己的门面却散发着浓重的机器味,这个反讽被顶了上来。
作者的回应很务实:先把验证流水线的骨架跑通,界面和文案的打磨排在后面。
这些质疑反而成了免费的产品评审,把可用性问题和品牌定位问题都暴露了出来。
对 AI 应用开发者的可复用清单
抛开教育场景,Lathoa 的架构对任何模型输出必须被约束的产品都有参照价值。
第一条经验是确定性裁判优先,能用代码算的就不要让模型投票。
第二条是盲解防污染,交叉验证的参与者必须看不到彼此的推理过程。
第三条是丢弃即默认,拿不准的案例直接报废,供应短缺比内容事故便宜。
第四条是警惕共模失效,两个同家族模型的一致不等于正确。
第五条是把注入防护放进生成流水线,而不是等上线后再补。
三层校验的对照关系可以整理成一张表,方便评估自己的产品缺了哪一层。
| 校验层 | 方法 | 能抓住 | 抓不住 |
|---|---|---|---|
| 算术重算 | 确定性代码 | 计算事实错误 | 概念性错误 |
| 独立二解 | 盲解模型 | 随机性偏差 | 共模失效 |
| harness 扫描 | 一致性评估 | 注入与自相矛盾 | 新型攻击 |
这张表里每一行都在提醒,任何单层校验都有明确的失效边界。
把三层叠起来依然不完美,但每一层都让漏网之错的概率乘上一个小于 1 的因子。
对抗共模失效的进阶做法是引入不同厂商、不同架构的模型担任二解裁判。
成本允许的话,裁判模型的多样性比裁判模型的数量更值得花钱。
更深一层:可控错误是一种新资产
Lathoa 最值得琢磨的洞察是,模型的不可靠性可以被产品设计成可运营的资产。
过去我们把幻觉当作要消灭的缺陷,这个产品把它变成按难度分级的教学内容。
前提是错误必须经过验证,未经校验的幻觉是事故,经过校验的幻觉是课程。
这个思路可以平移到很多场景:红队训练、审核员培训、客服质检的对抗样本。
凡是需要以假乱真的错例的领域,都面临同一个工程问题:如何批量制造可信错误。
Lathoa 给出的答案是生成器加裁判流水线,用丢弃率换取每一个流出案例的可信度。
作者目前一个人维护这个项目,商标挂在 ZeroEx Tsitsipas Labs 名下。
题库覆盖算术、分数、比例、初级代数和几何入门,对齐 Common Core 四到八年级。
阅读理解和基础逻辑排在路线图的下一位,那时校验流水线要面对没有标准答案的题。
数学题的裁判是好写的,主观题的裁判又是一场新的可靠性长征。
结语
Lathoa 的故事表面是个教育产品,里子是一堂模型可靠性工程课。
它证明了一件事:让模型答错不难,让模型按规格答错、错得可信、错得有教学价值,很难。
三重校验、盲解防污染、丢弃即默认,这三招不属于教育行业,属于所有 AI 产品。
下次设计生成管线时,先想清楚你的错误案例谁来验证,比优化提示词重要得多。
当 AI 生成的答案泛滥成灾,能识别错误的眼睛才是稀缺资源,无论对孩子还是对工程师。