文章目录
- [📚 1. map 基础](#📚 1. map 基础)
-
- [1.1 创建](#1.1 创建)
- [1.2 增删改查](#1.2 增删改查)
- [1.3 遍历 map](#1.3 遍历 map)
- [1.4 存在性检查](#1.4 存在性检查)
- [📚 2. map 进阶用法](#📚 2. map 进阶用法)
-
- [2.1 零值 map](#2.1 零值 map)
- [2.2 值类型和指针类型](#2.2 值类型和指针类型)
- [2.3 函数传递](#2.3 函数传递)
- [2.4 map 类型的切片](#2.4 map 类型的切片)
- [📚 3. 小结](#📚 3. 小结)
本系列文章:
- Java 转 go 学习 - 项目管理
- Java 转 go 学习 - 基本语法
- Java 转 go 学习 - 类型转换
- Java 转 go 学习 - 流程控制结构
- Java 转 go 学习 - 数组和切片
上面几篇文章学习了数组和切片的基本概念和用法,这篇文章学习 map 的基础用法,类似 Java 的 Map。
📚 1. map 基础
1.1 创建
go 中的 map (无序的键值对 (Key-Value) 集合)是 引用类型 ,也就是说 函数传递时会作为引用传递,同样的 go 中 map 的属性和 java 的一样,下面先来看下 map 的初始化,由下面几种方式。
首先通过 make 创建,这也是比较推荐的方式,下面是创建的例子:
go
func test1() {
	// 创建空 map, 不指定初始容量
	m1 := make(map[string]int)

	// 指定初始容量
	m2 := make(map[string]int, 100)

	fmt.Println(m1) // map[]
	fmt.Println(m2) // map[]
}
然后可以通过字面量创建,也就是说可以创建的时候顺便初始化一些 key-value,下面是例子:
go
func test2() {
	// 字面量初始化
	m1 := map[string]int{
		"a": 1,
		"b": 2,
		"c": 3,
	}

	// 空的 map 字面量
	m2 := map[string]int{}

	fmt.Println(m1) // map[a:1 b:2 c:3]
	fmt.Println(m2) // map[]
}
接下来是第三种,可以先声明再初始化,声明的时候 map == nil,声明完成之后必须要初始化之后才能使用,下面是例子:
go
func test3() {
	// var 声明的 map 是 nil, 需要初始化之后才能用
	var m1 map[string]int
	var m2 map[string]int
	var m3 map[string]int

	// 初始化
	m1 = make(map[string]int)
	m2 = map[string]int{}
	m3 = map[string]int{"a": 1, "b": 2}

	fmt.Println(m1) // map[]
	fmt.Println(m2) // map[]
	fmt.Println(m3) // map[a:1 b:2]
}
当然上一篇文章我们通过 new 创建了切片,这里也可以通过 new 创建 map,但是要注意 new 分配的引用对象并没有初始化,相当于声明一个没有初始化的变量,然后返回地址,下面可以看下例子:
go
func test4() {
	m1 := new(map[string]int)

	// 报错 panic: assignment to entry in nil map
	// (*m1)["key"] = 1

	// 初始化
	*m1 = make(map[string]int)
	(*m1)["a"] = 1
	(*m1)["b"] = 2
	(*m1)["c"] = 3
	fmt.Println(*m1) // map[a:1 b:2 c:3]
}
1.2 增删改查
同理,map 也可以进行增删改查,要注意的是查询的时候有两个返回值:value, exist,如果我们选择用一个变量去接收,那么这个变量就是 value,如果用两个变量,第二个变量接受到的就是 exist,也就是 key-value 是否存在,最后删除需要通过函数 delete 完成。
下面来看下这几个例子:
go
func test5() {
	scores := make(map[string]int)

	// 增加
	scores["a"] = 1
	scores["b"] = 2
	scores["c"] = 3
	fmt.Println(scores)	// map[a:1 b:2 c:3]

	// 修改
	scores["c"] = 3

	// 查询
	n1, exist := scores["a"]
	fmt.Println(n1, exist)	// 1 true

	// 查询不存在的值
	n2, exist := scores["d"]
	fmt.Println(n2, exist)	// 0 false

	// 删除
	delete(scores, "a")
	fmt.Println(scores)	// map[b:2 c:3]

	// 删除不存在的 key, 不会 panic
	delete(scores, "f")
	fmt.Println(scores)	// map[b:2 c:3]

	// 查询 map 长度
	fmt.Println("map 长度: ", len(scores))	// map 长度:  2
}
1.3 遍历 map
还是通过 range 遍历 map,同样的可以遍历 key-value,也可以单独遍历 key 或者单独遍历 value。
go
func test6() {
	m := map[string]int{
		"apple":  5,
		"banana": 3,
		"orange": 8,
	}
	// 遍历 key - value
	for key, value := range m {
		fmt.Printf("%s - %d\n", key, value)
		// apple - 5
		// banana - 3
		// orange - 8
	}

	// 只遍历 key
	for key := range m {
		fmt.Printf("%s\n", key)
		// apple
		// banana
		// orange
	}

	// 只遍历 value
	for _, value := range m {
		fmt.Printf("%d\n", value)
		// 8
		// 5
		// 3
	}
}
map 的遍历是无序遍历,也就是不按照添加的顺序遍历,这点跟 Java 是一样的,那么如果要有序遍历就需要先获取所有 key,然后排序,最后通过 key 访问 value 来实现有序遍历,下面可以先看下遍历的例子,但是要注意这里的无序是说 每一次遍历顺序都不固定。
go
func test7() {
	m := map[string]int{
		"apple":  5,
		"banana": 3,
		"orange": 8,
	}

	// 多次运行,输出顺序不同!
	for i := 0; i < 3; i++ {
		fmt.Println("第", i, "次遍历:")
		for k, v := range m {
			fmt.Printf("%s:%d ", k, v)
		}
		fmt.Println()
	}
	// 第 0 次遍历:
	// orange:8 apple:5 banana:3
	// 第 1 次遍历:
	// apple:5 banana:3 orange:8
	// 第 2 次遍历:
	// banana:3 orange:8 apple:5
}
最后再来看下有序遍历:
go
func test8() {
	m := map[int]string{
		1: "one",
		2: "two",
		3: "three",
		4: "four",
		5: "five",
	}

	// 注意这里不要用 make([]int, len(m)) 去初始化, 因为这样初始化就相当于创建了一个初始长度为 5, 且 [0, 4] 全是 0 的切片, 下面
	// append 的时候 key 追加的下标就会是 [5, 9], 后面遍历 keys 就会有 10 个 key
	keys := make([]int, 0, len(m))
	for key := range m {
		keys = append(keys, key)
	}

	// 排序
	sort.Ints(keys)

	for index, value := range keys {
		fmt.Printf("index: %d, key: %d, value: %s\n", index, value, m[value])
		// index: 0, key: 1, value: one
		// index: 1, key: 2, value: two
		// index: 2, key: 3, value: three
		// index: 3, key: 4, value: four
		// index: 4, key: 5, value: five
	}
}
1.4 存在性检查
存在性就是检查一个 key 是否存在,这一点和 Java 有点不一样,大家都知道 Java 的 Map 不能存储基本数据类型,也就是说如果获取不到 key,返回的就是 null,当然你也可以自己往里面添加 null,比如下面的例子:
go
public class Main {
    public static void main(String[] args) {
        HashMap<Integer, Integer> map = new HashMap<>();
        map.put(123, null);
        System.out.println(map.get(123) == null);
    }
}
一般来说为了减少存储,Java 中如果是 null 的 value 都会把 key 给删掉,所以判断的时候通过 value == null 来判断一个 key 是否存在也是没问题的,但是 go 就不一样了,go 没有包装类,map 里面可以存储基本数据类型,换句话说 map 的 value 可以存储任何类型。
而 map 在获取一个不存在的 key 会返回 value 的零值,比如 int 就是 0,如果我们不判断存在性就有可能存在下面问题:
go
func test9() {
	m := map[string]int{
		"score": 0,
	}
	v := m["score"]
	v2 := m["unknown"]
	fmt.Println(v, v2) // 0 0
}这种情况下我们没办法分辨:score 和 unknown 这两个 key 到底是存在还是不存在,所以一般来说都会结合两个参数,如下面的写法:
go
func test10() {
	m := map[string]int{
		"score": 0,
	}
	v, exist1 := m["score"]
	v2, exist2 := m["unknown"]
	fmt.Println(v, exist1)	// 0 true
	fmt.Println(v2, exist2)	// 0 false
}
这样就能通过 exist1 和 exist2 来判断一个 key 到底是否存在了,一个比较好的写法如下:
go
func test10() {
	m := map[string]int{
		"score": 0,
	}
	// 1. 关心 key-value
	if val, ok := m["score"]; ok {
		fmt.Println("存在: ", val)
	} else {
		fmt.Println("不存在 score 这个 key")
	}
	// 存在:  0

	// 2. 只关心 key 是否存在
	if _, ok := m["unknown"]; !ok {
		fmt.Println("不存在 unknown 这个 key")
	} else {
		fmt.Println("存在 unknown 这个 key")
	}
	// 不存在 unknown 这个 key

	// 3. 不存在的时候给默认值
	val, ok := m["unknown"]
	if !ok {
		val = 1
	}
	fmt.Println(val)
	// 1
}
📚 2. map 进阶用法
2.1 零值 map
假设现在我们声明了一个 map 但是不初始化,这种情况下声明出来的 map == nil 会返回 true,但是注意如果此时通过这个 map 获取某个 key,这种情况下会获取到 value 的 零值 ,比如 value 是 int 类型,那么获取到的就是 0,并不会 panic,但是如果此时往里面写入数据就会 panic 了,比如下面的例子:
go
func test11() {
	// 声明但不初始化
	var m1 map[string]int
	fmt.Println(m1 == nil)   // true
	fmt.Println(m1["score"]) // 0
}
此时我们往声明的 m1 里面获取数据是不会 panic 的,但是如果像下面这种写入数据就不行了。
go
func test11() {
	// 声明但不初始化
	var m1 map[string]int

	// panic: assignment to entry in nil map
	m1["score"] = 1
}
比较特殊的是,删除一个 key 不管是 nil map 还是 empty map 都是没问题的。
go
func test11() {
	// 声明但不初始化
	var m1 map[string]int
	// 初始化为空 map
	m2 := make(map[string]int)
	fmt.Println(m1 == nil)   // true
	fmt.Println(m1["score"]) // 0

	// 空 map 可以写入
	m2["score"] = 1
	fmt.Println(m2["score"]) // 1

	// 都没问题, 不会报错
	delete(m1, "score")
	delete(m2, "score")
}
⚠️ 下面要注意,在写代码的时候结构体中的 Map 初始化是 nil,此时不能直接往里面添加或者修改数据,需要初始化。
go
func test12() {
	cfg := Config{}
	fmt.Println(cfg.Settings == nil) // true

	// cfg.Settings["key"] = "value"
	// panic: assignment to entry in nil map

	// 1. 初始化的时候就创建 map
	cfg = Config{
		Settings: make(map[string]string),
	}

	cfg.Settings["key"] = "value"
	fmt.Println(cfg.Settings)
	// map[key:value]

	// 2. 使用构造函数来创建结构体
	cfg = NewConfig()

	cfg.Settings["key"] = "value"
	fmt.Println(cfg.Settings)
	// map[key:value]
}
2.2 值类型和指针类型
这里是说 map 存储的 value 什么时候存值类型,什么时候存指针类型,一般来说存值就意味着通过 map 去获取的时候获取的是副本,此时 修改这个 value 不会影响到 map 里面存储的原有的 map,那如果存的是指针类型,那么这时候修改 value 会影响原来 map 里面的值。
go
func test13() {
	// 1. value 存的是值类型
	stuMapVal := make(map[int]Student)
	stu1 := Student{Name: "张三", Age: 18}
	// 存到 map 中, 但是此时存的是值的拷贝
	stuMapVal[1] = stu1

	// 修改 stu1
	stu1.Name = "李四"
	// 输出 map 里面的存储值
	fmt.Println(stuMapVal) // map[1:{张三 18}]

	// 2. value 存的是指针类型
	stuMapPtr := make(map[int]*Student)
	stu2 := Student{Name: "李四", Age: 19}
	stuMapPtr[1] = &stu2 // 存入指针, 指向 stu2 的内存地址

	// 修改 stu2
	stu2.Age = 21
	fmt.Println(stuMapPtr[1].Age)                 // 21
	fmt.Println(&(stuMapPtr[1].Age), &(stu2.Age)) // 0xc0000080d0 0xc0000080d0
}
可以看到 stu2 的 Age 和 stuMapPtr 里面的 Age 地址是一样的,也就是说存指针类型的情况下可以直接对原始结构体里面的值进行修改。
既然有了这两种类型,下面就是这两种存储方式的区别:
| 维度 | 存储「值」 | 存储「指针」 |
|---|---|---|
| 内存占用 | 存储完整数据拷贝,占用更大(尤其结构体大时) | 仅存储内存地址(8 字节 / 64 位系统),占用小 |
| 修改行为 | 修改原变量不影响 map,需重新赋值 map | 修改原变量 / 通过指针直接改,都影响 map |
| 性能 | 存入 / 取出时需拷贝数据,结构体越大越慢 | 仅拷贝指针,性能稳定(无数据拷贝) |
| 空值 / 零值处理 | 直接存储类型零值(如 Student {}) | 可能存储 nil 指针(需额外判空) |
既然有了上面的比较,什么时候存值什么时候存指针也可以得出:
- 基础数据类型: 如果是基础数据类型,比如 int/bool/string 等,这种要么本身的内存大小比 8 字节小,要么就是不需要修改,这种情况下存指针没啥意义,直接存值就行。
- 避免误修改: 如果不想
map里面的数据被修改,这时候就存值类型就行,比如像上面示例里面的结构体就按照第一种方式存,通过stuMapVal[1]获取到的 value 也是复制之后的值,修改不会对原来 map 里面的属于有影响。 - 小结构体(占用内存 ≤ 指针大小): 比如结构体只有 1-2 个字段(总大小
≤ 8字节),存值和存指针性能几乎无差别,存值更加简单,不需要考虑nil的问题。反过来需存储nil表示不存在,这种情况下就存指针,因为如果存值,那么如果不存在获取到的就是 零值,没办法区分这个 key 对应的 value 到底是零值还是说就是不存在。
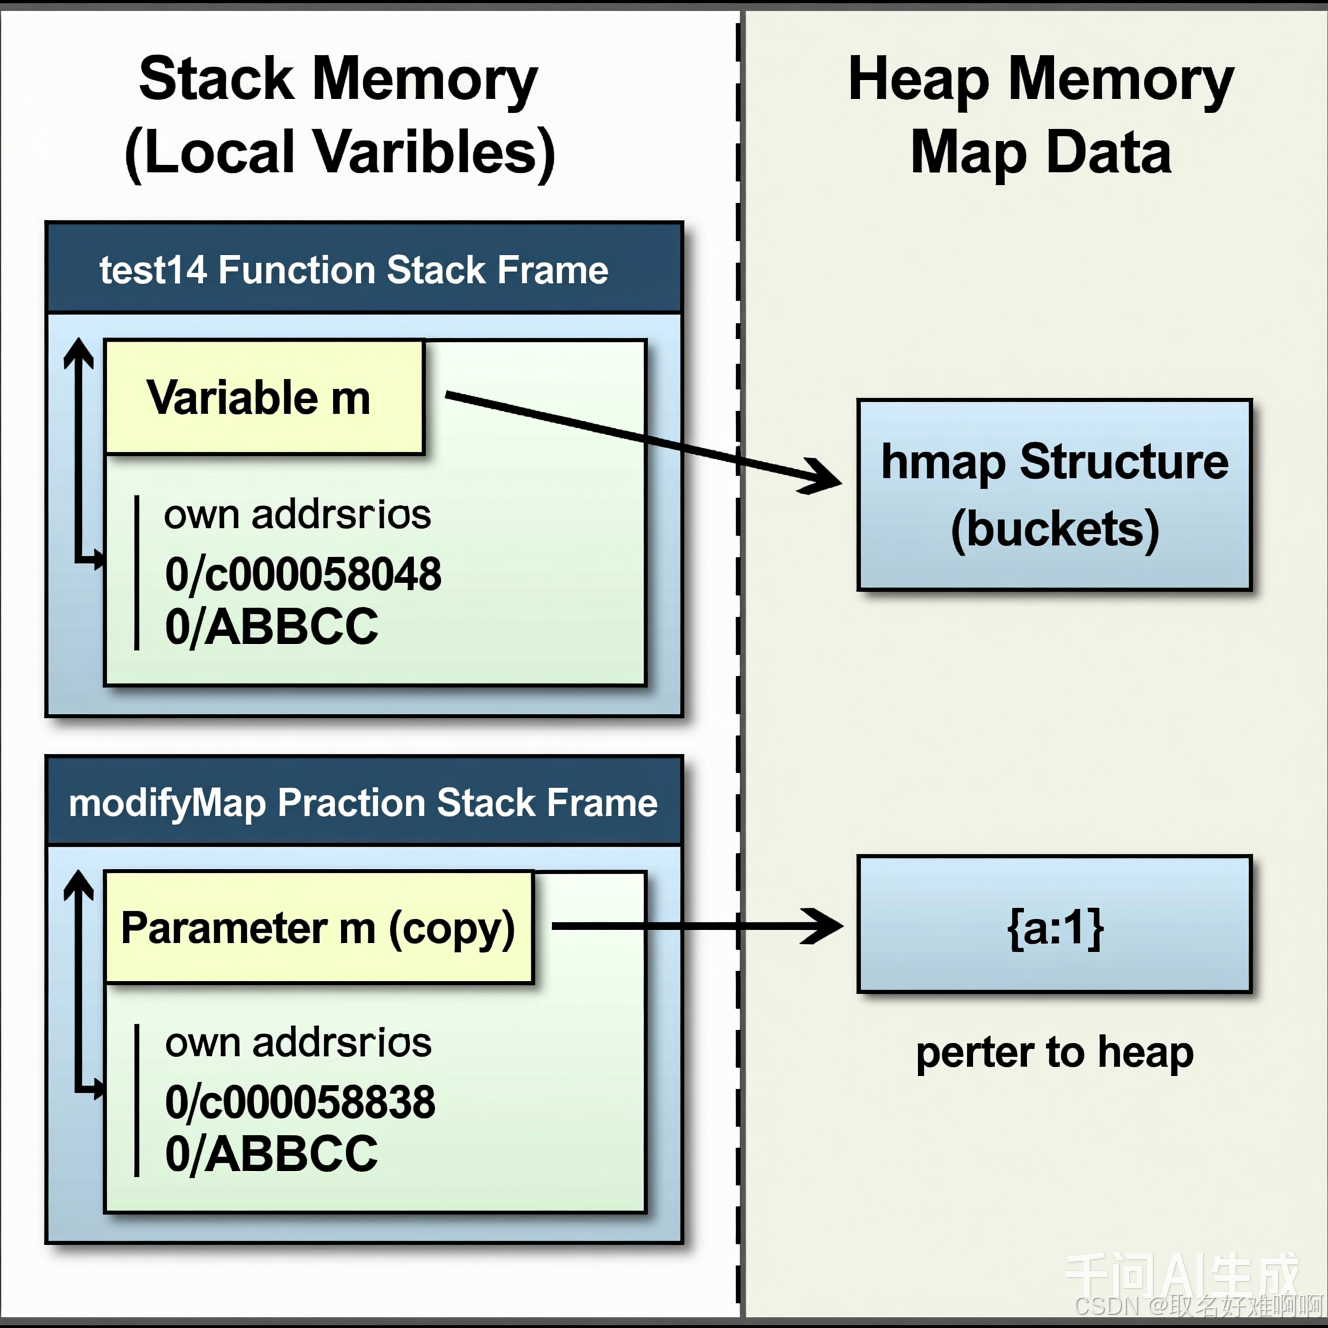
2.3 函数传递
go
func modifyMap(m map[string]int) {
	fmt.Printf("%p\n", &m) // 0xc000058038
	m["b"] = 2
}

func test14() {
	m := map[string]int{"a": 1}
	fmt.Printf("%p\n", &m) // 0xc000058048

	modifyMap(m)
	fmt.Println(m) // map[a:1 b:2]
}
上面的例子说明了 map 作为引用传递,函数里面修改 map 里面的内容,原来 map 里面的内容也会改变,modifyMap 接收 map 的时候在这个方法的栈里面为 m 分配了一个新的内存空间,整体表现来看就是将指针复制了一份,这两个地址就是两个变量各自在栈中的地址,但是两个指针指向堆内存里面的地址是同一个。
2.4 map 类型的切片
假设我们想获取一个 map 类型的切片,就需要用两次 make 函数,第一次 make 分配切片,第二次 make 是分配切片里面的每个 map,如下面例子。
go
func test15() {
	// 第一次 make 创建切片
	items := make([]map[string]int, 5)
	for i := range items {
		// 第二次 make 创建 map
		items[i] = make(map[string]int, 10)
		items[i]["idx"] = i
	}

	for i := range items {
		fmt.Println(items[i])
	}
	// map[idx:0]
	// map[idx:1]
	// map[idx:2]
	// map[idx:3]
	// map[idx:4]
}
📚 3. 小结
好了,这篇文章就先学到这里,这里是关于 map 的基础用法,后面有一些进阶的用法比如线程安全的 map 就到后面再看,下一篇文章就来看下函数的内容。
如有错误,欢迎指出!!!!