多表查询刚跑完,很容易形成一个习惯:只要碰到两张表,先写 JOIN。这个习惯不算错,JOIN 确实是多表查询的主力。但有些需求并不需要把另一张表的字段带出来,只是想判断有没有、有没有缺失、给列表补一个统计值,或者先把从表聚合好再拿来关联。这个时候,子查询会更直接。
子查询不只有 where id in (...) 这一种写法。它可以出现在 where 里,也可以出现在 select 里,还可以放在 from 里当成一张临时结果表。位置不同,承担的任务也不同。这里继续在金仓数据库 KingbaseES 的 ksql 里验证,使用用户、订单、支付三张测试表,先把结果跑出来,再看这些写法各自适合什么场景。
这类 SQL 在接口里很常见。比如用户列表页只需要知道"这个用户有没有下过单",并不一定要把订单号、金额、支付状态全部查出来;又比如列表上要显示订单数和最大订单金额,直接 JOIN 明细表后再处理重复行,反而会把问题弄复杂。换到 KingbaseES 后,先把这些基础写法跑一遍,比直接背兼容结论更踏实。
先确认测试数据还在
这次没有重新建用户、订单、支付三张表,直接复用前面准备好的 t_join_user、t_join_order、t_join_payment。这些 SQL 都在同一个 KingbaseES 单机实验环境里执行。先数一下行数:用户 5 行,订单 5 行,支付 4 行。
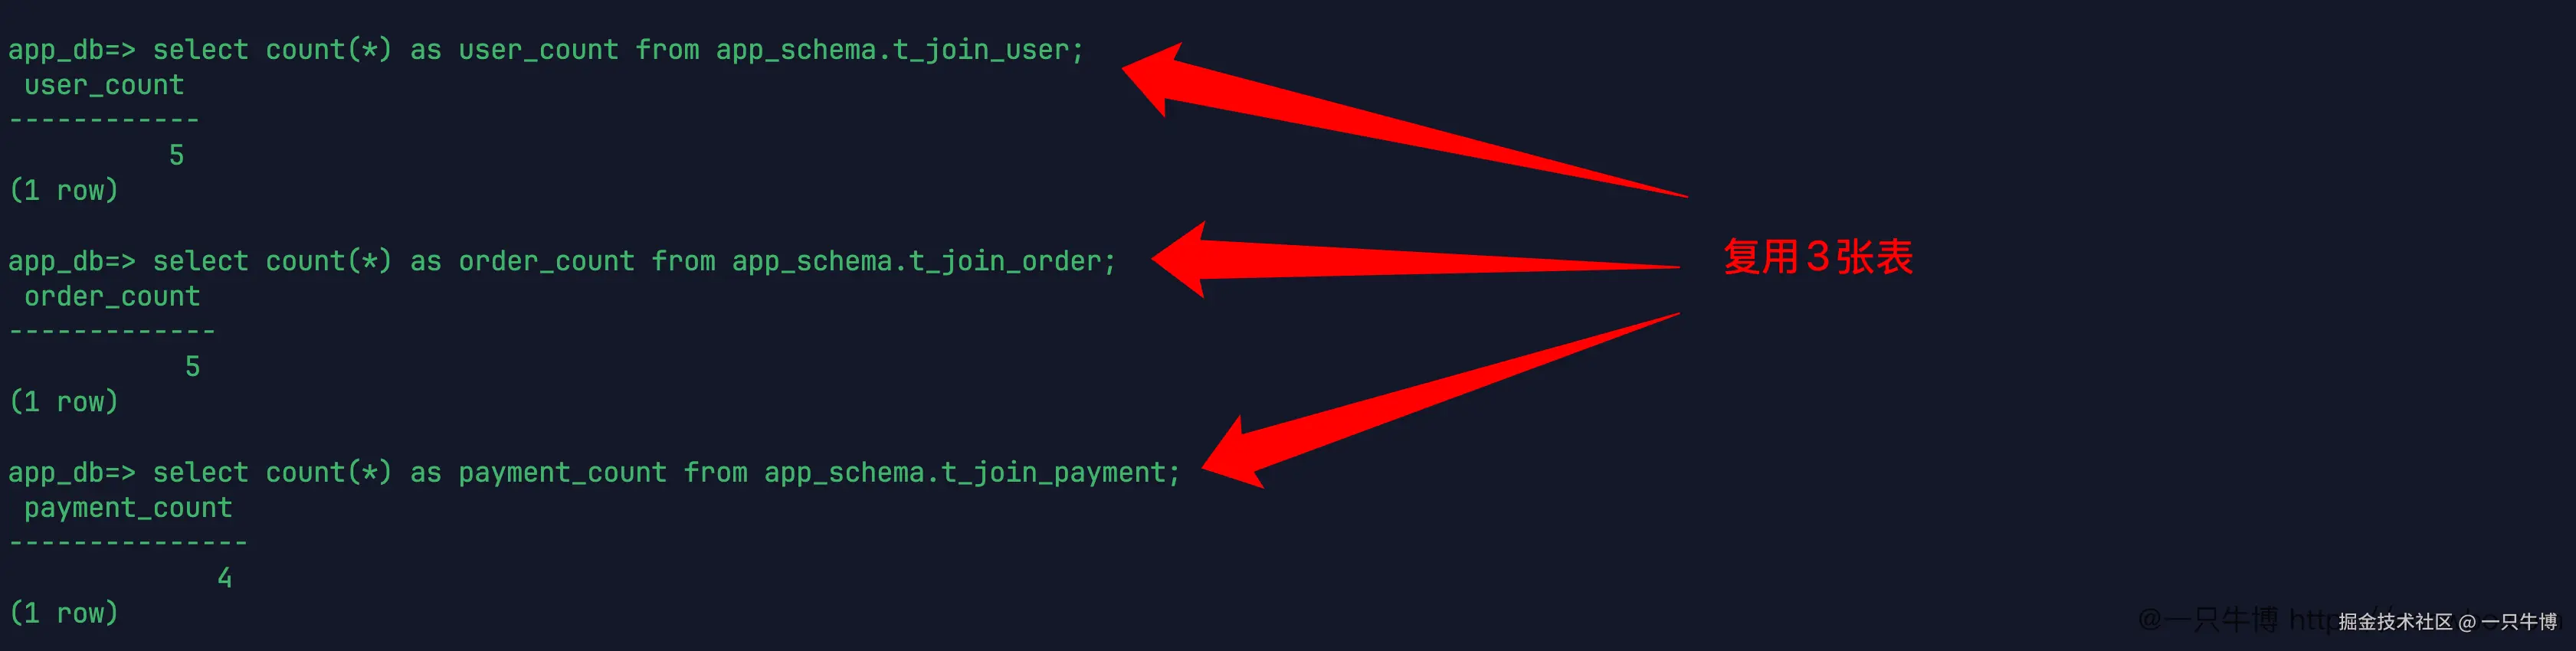
这批数据里有几个故意保留的边界:david 和 eric 没有订单;订单表里有一条 user_id = 6 的订单,但用户表里没有这个用户;支付表里有一条 order_id = 106 的支付记录,但订单表里没有这笔订单。子查询不是为了掩盖这些边界,正好要借它们看结果。
先确认数据量,是为了避免后面把 SQL 结果误读成语法差异。用户表如果不是 5 行,订单表如果不是 5 行,后面的 in、exists、统计结果都会跟着变。小实验最好先把底表固定住,尤其是这种连续写几篇文章、反复复用同一组表的情况。
IN:外层字段匹配一组值
先用最熟悉的 in 查有订单的用户:
csharp
select
  u.user_id,
  u.user_name,
  u.status
from app_schema.t_join_user u
where u.user_id in (
  select o.user_id
  from app_schema.t_join_order o
)
order by u.user_id;
子查询从订单表里拿出一组 user_id,外层用户表再判断自己的 user_id 是否在这组值里。结果返回 3 行:alice、bob、cindy。
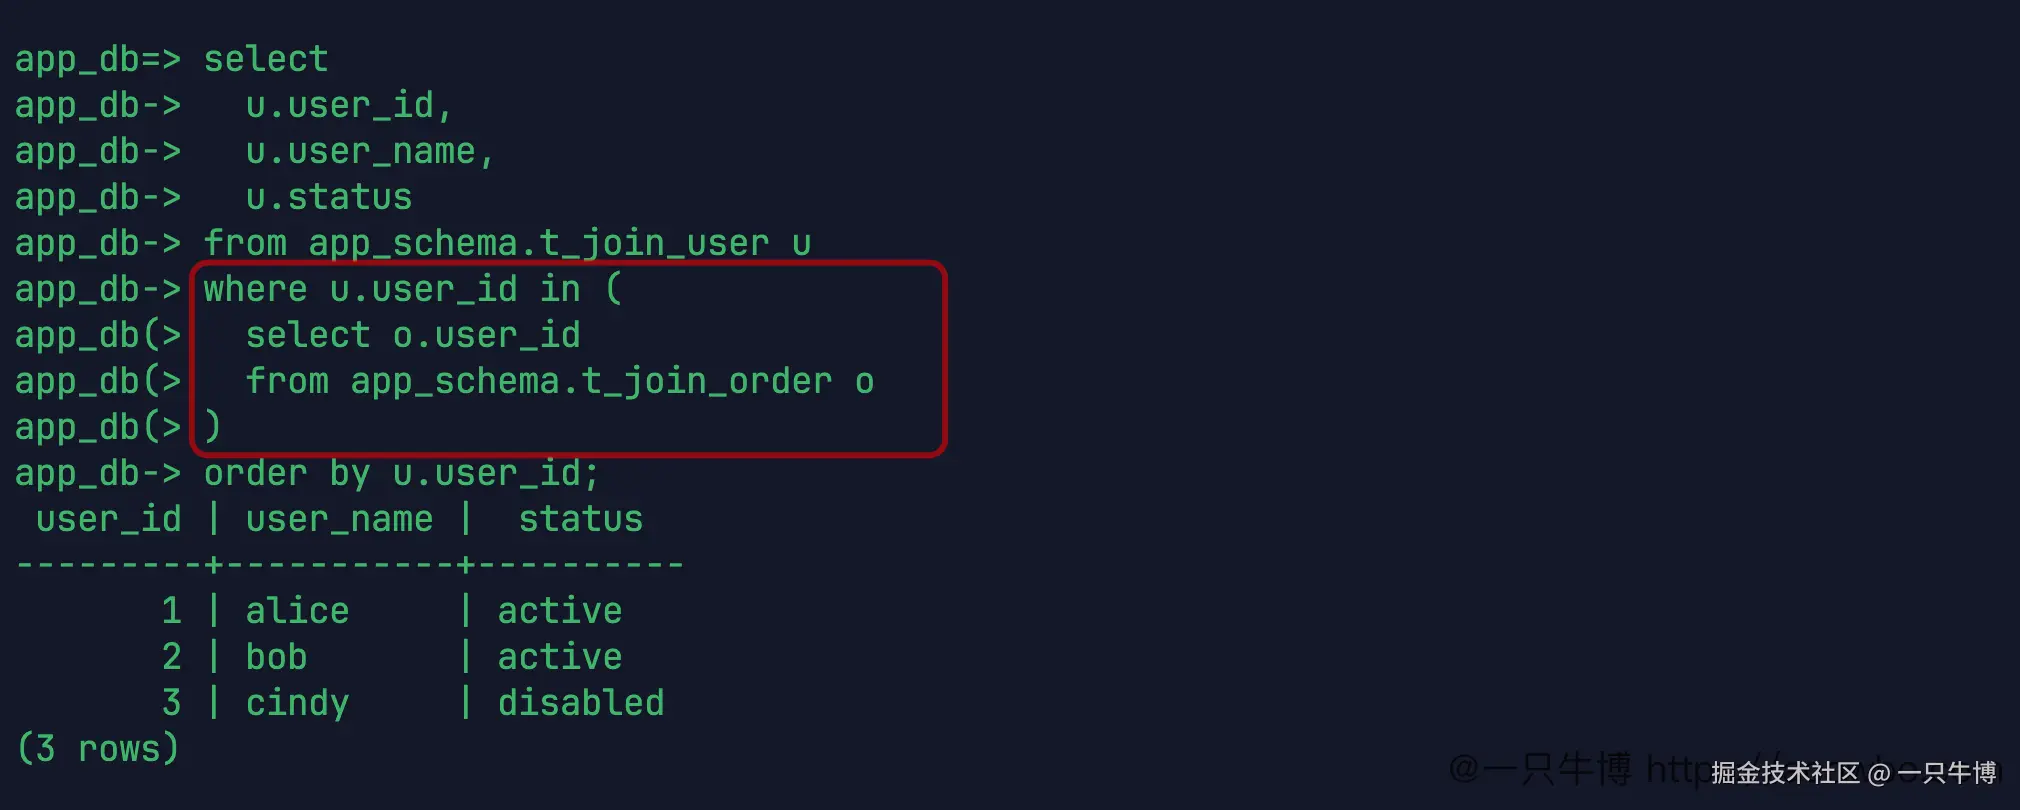
这个结果里没有 david、eric,因为他们没有订单。也没有用户 6,因为 6 只存在于订单表,用户表里没有对应记录。在这套 KingbaseES 测试环境里,in 这类写法适合表达"外层字段属于子查询返回的集合",语义很直。
EXISTS:只关心有没有匹配行
同样的需求,用 exists 也能写:
csharp
select
  u.user_id,
  u.user_name,
  u.status
from app_schema.t_join_user u
where exists (
  select 1
  from app_schema.t_join_order o
  where o.user_id = u.user_id
)
order by u.user_id;
结果仍然是 alice、bob、cindy 三行。
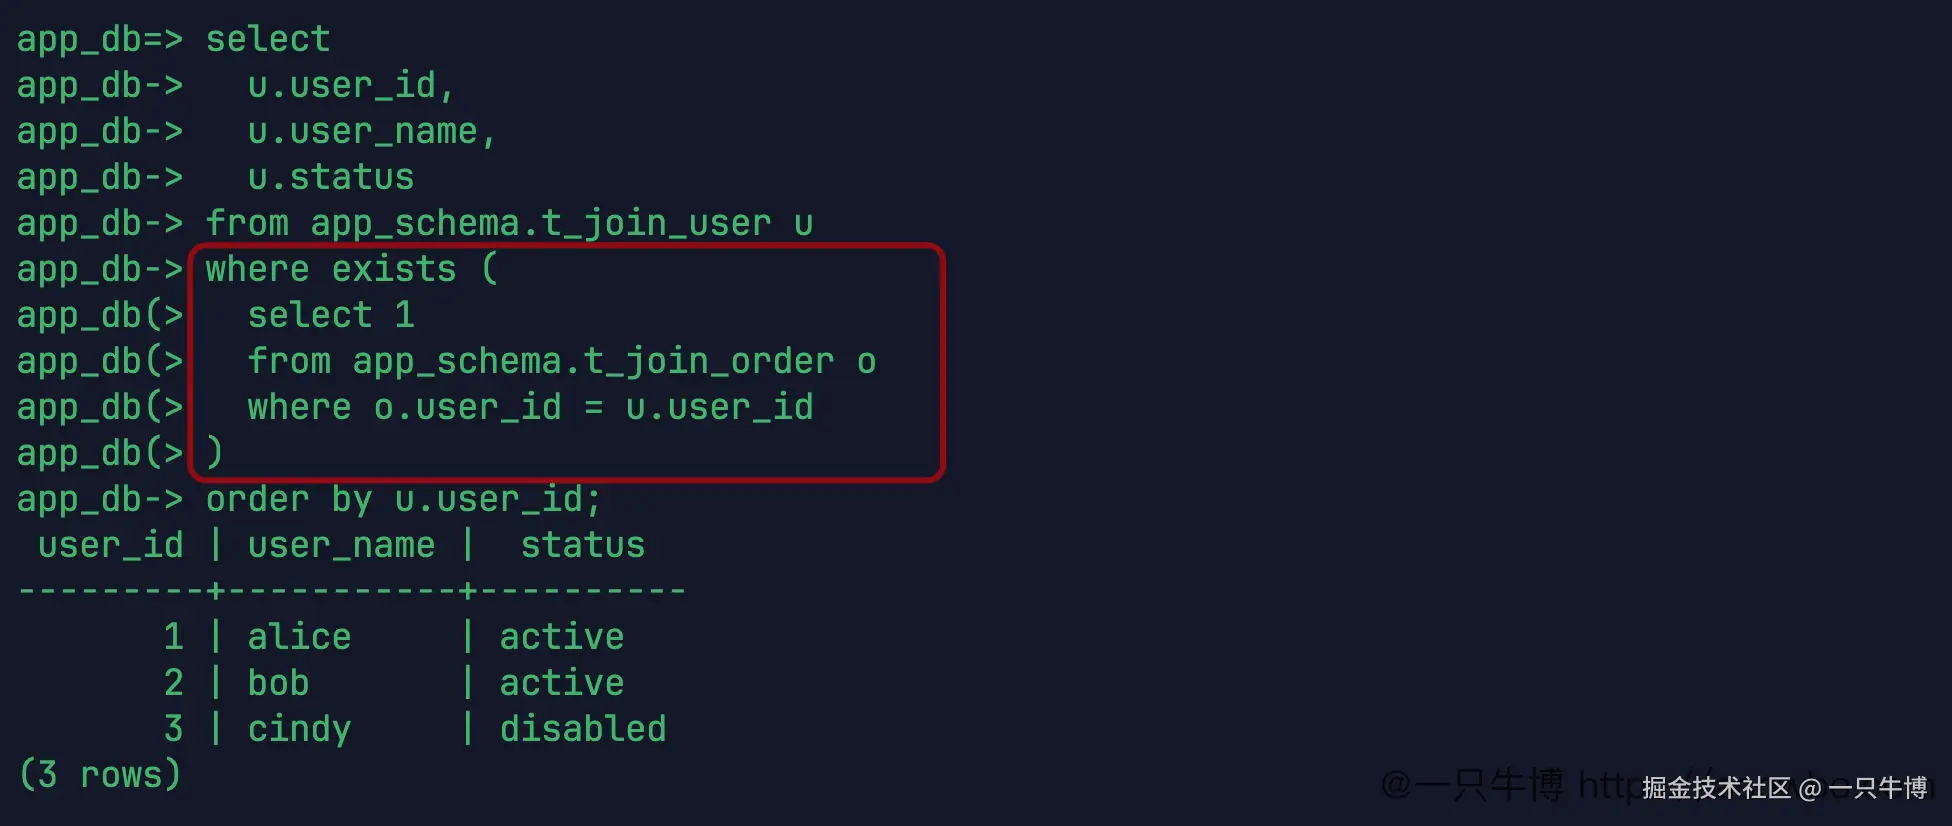
这里的子查询引用了外层的 u.user_id,属于相关子查询。它不关心订单表里具体返回什么字段,select 1 已经够了;真正起作用的是 where o.user_id = u.user_id。只要能找到一行匹配订单,这个用户就保留。
in 更像"拿一组值来比",exists 更像"去从表里找一下有没有"。在小数据实验里,两者返回一样。没有执行计划和大数据量测试,不需要在这里下谁更快的结论。先把语义分清楚更重要。
对从 MySQL 过来的开发者来说,in 通常更顺手,因为它像是在写一个集合判断。但 exists 的可读性也很强,尤其是子查询里需要引用外层表字段时,条件关系会直接写在子查询内部。这里的 o.user_id = u.user_id 就很清楚:外层每个用户,都去订单表里找有没有对应订单。
如果后面要继续加订单状态条件,比如只判断有没有已支付订单,exists 里直接加 and o.order_status = 'paid' 就能把语义写在同一个地方。in 也能写,但子查询返回集合和过滤条件混在一起时,读起来会稍微绕一点。不是不能用,而是要看哪种写法更贴近需求。
NOT EXISTS:查没有匹配记录
反过来查没有订单的用户,用 not exists:
csharp
select
  u.user_id,
  u.user_name,
  u.status
from app_schema.t_join_user u
where not exists (
  select 1
  from app_schema.t_join_order o
  where o.user_id = u.user_id
)
order by u.user_id;
结果返回 david 和 eric。
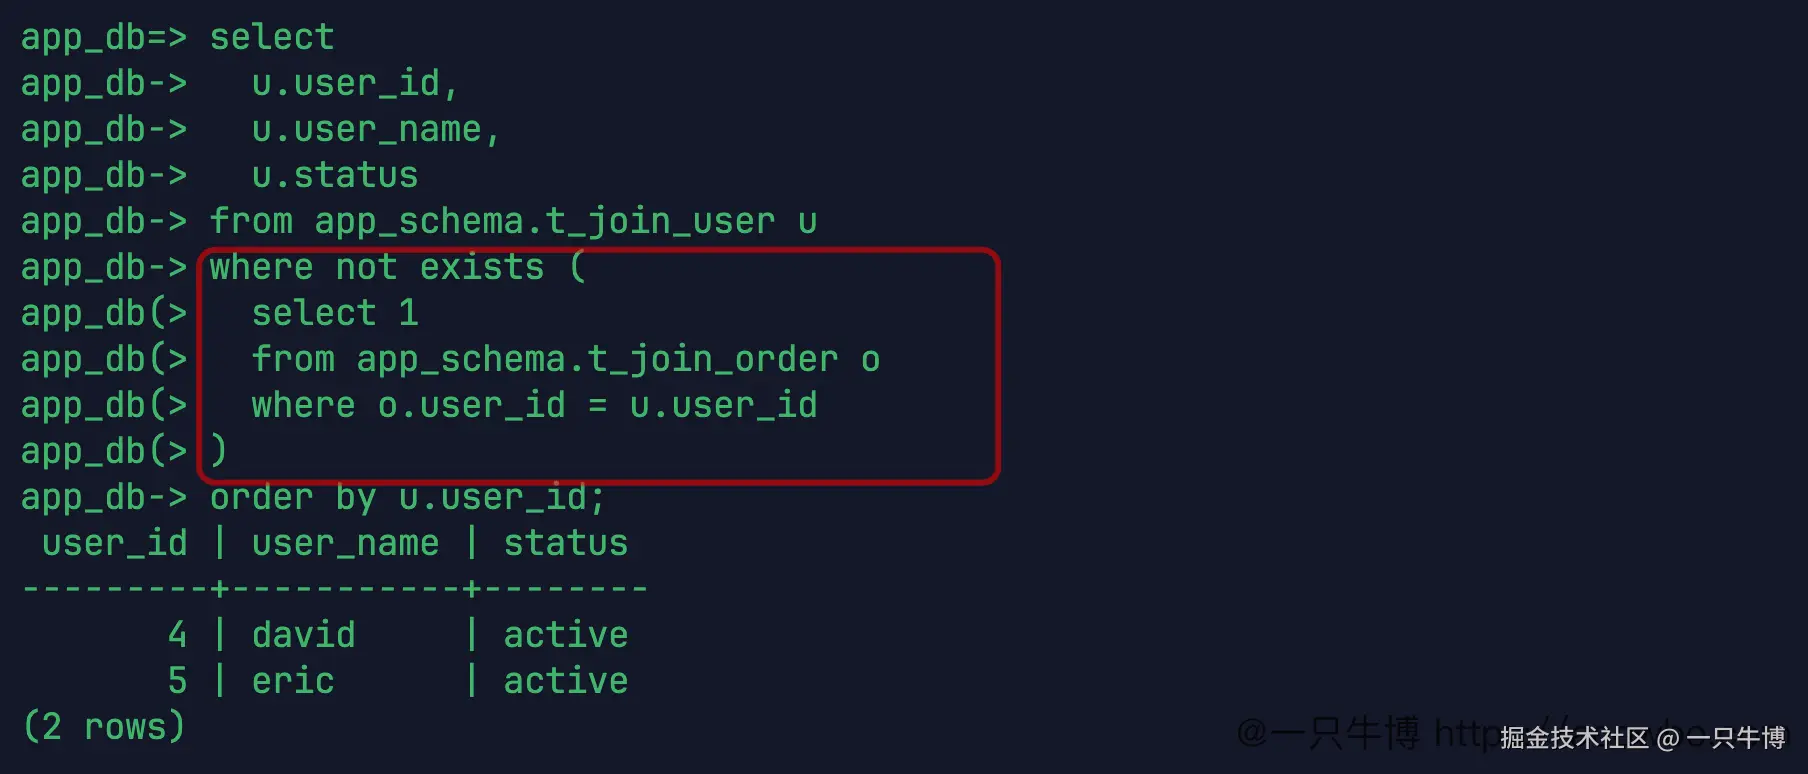
这个需求也可以写成 left join 后判断订单字段为 NULL,但 not exists 读起来很直接:用户表里这行数据,在订单表里找不到匹配记录。对于"没有订单的用户""没有支付记录的订单""没有分配角色的账号"这类需求,not exists 很适合先拿来写验证 SQL。
它还有一个好处:结果不会因为从表一对多而展开。alice 有两笔订单,但在 exists 和 not exists 这种判断里,用户表仍然是一行用户对应一次判断。查询目标是用户时,这种写法能少处理很多重复行。
这和 JOIN 的区别很实际。JOIN 后如果不小心忘了 distinct 或分组,alice 会因为两笔订单出现两行;not exists 这类写法从一开始就围绕用户表判断,不会把订单明细带进结果集。查询目标越明确,SQL 后面越少补救。
NOT IN 遇到 NULL,结果会很刺眼
not in 最容易被写顺手。为了单独看它和 NULL 的关系,先建一张黑名单表 t_subquery_block_user。表里只有两行:一行是 user_id = 2,表示 bob 在黑名单里;另一行 user_id 是 NULL,模拟脏数据。
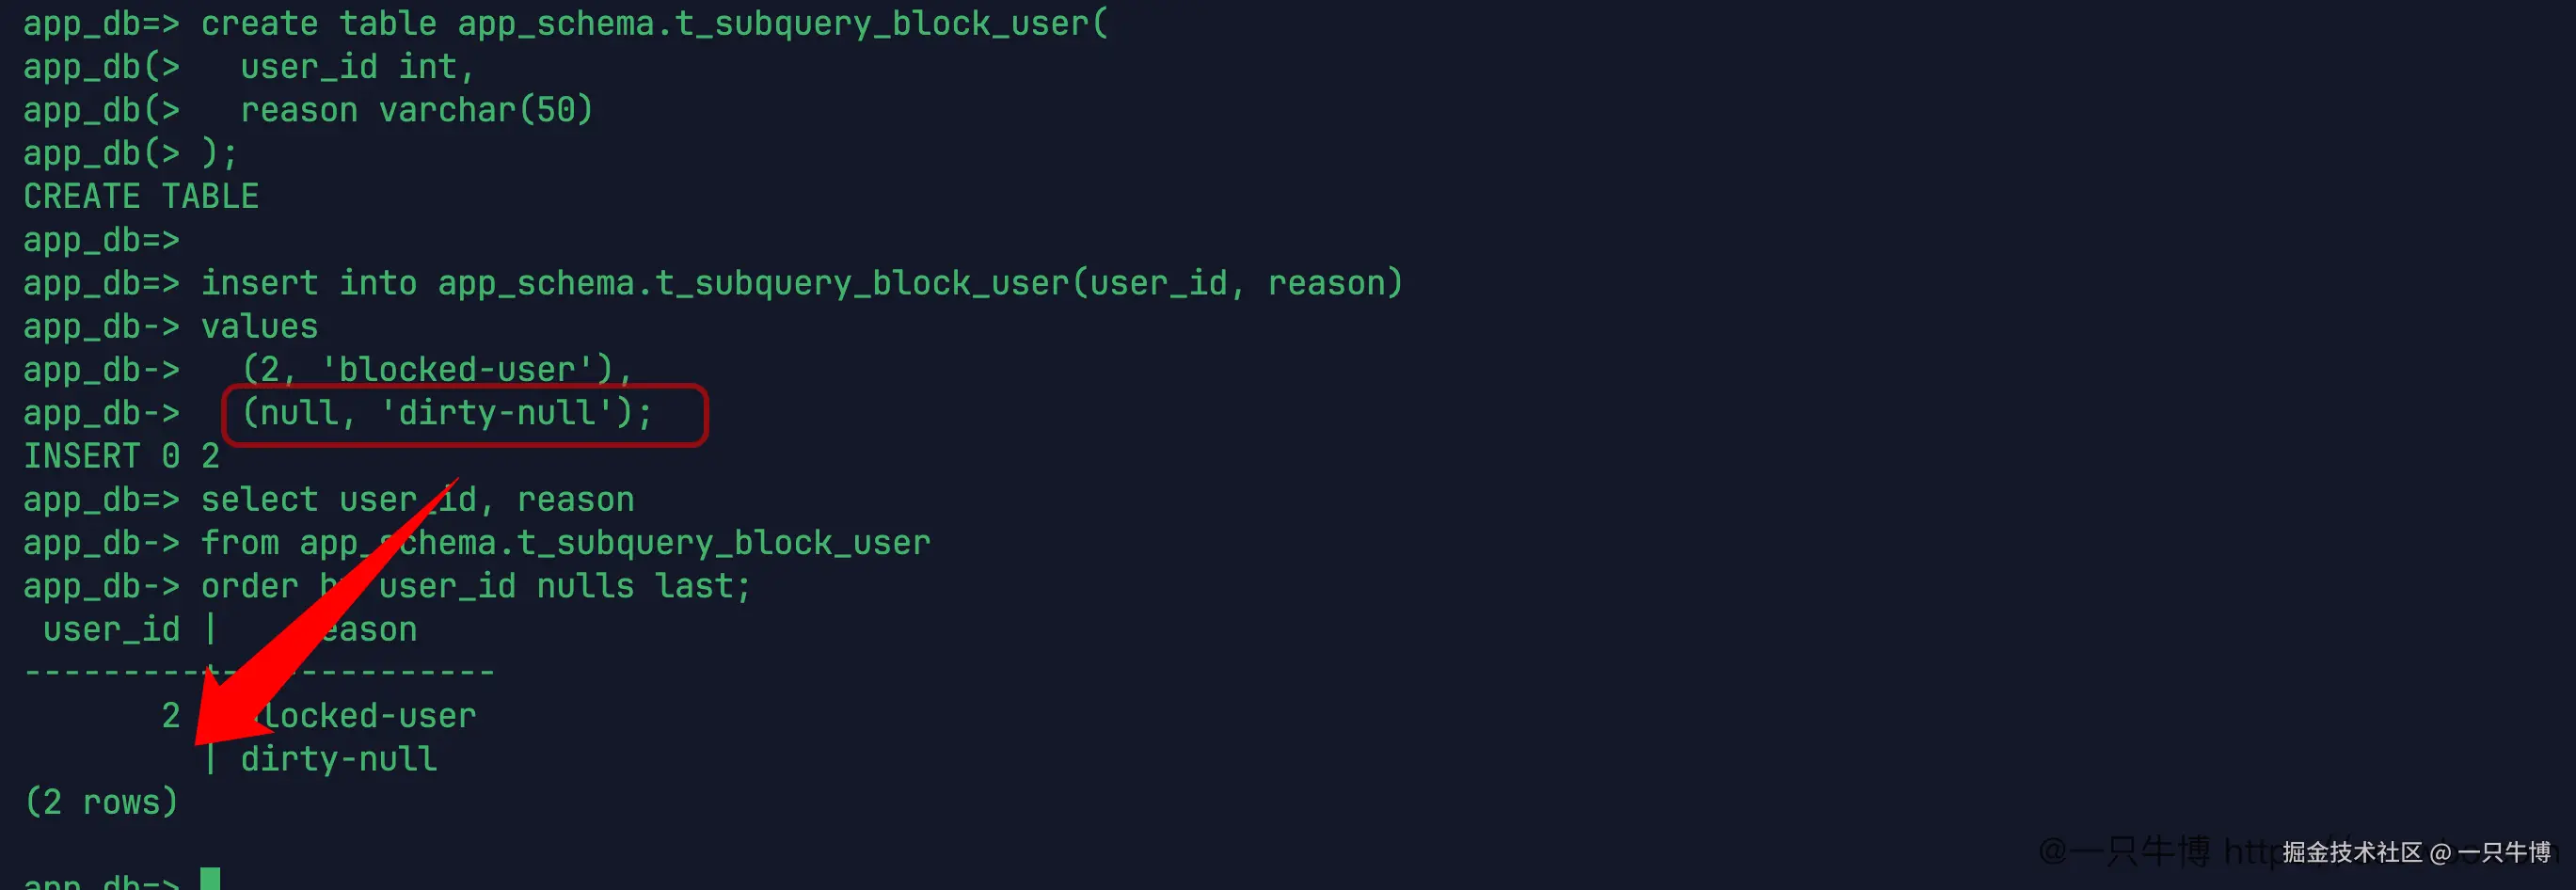
先写 not in:
黑名单表里真正想排除的只有 user_id = 2。如果按直觉理解,结果应该返回 1、3、4、5 四个用户。但子查询结果不是只有 2,还混了一行 NULL。这个 NULL 会把 not in 的判断拖进三值逻辑里,结果就不是简单的"排除 2"了。
csharp
select
  u.user_id,
  u.user_name
from app_schema.t_join_user u
where u.user_id not in (
  select b.user_id
  from app_schema.t_subquery_block_user b
)
order by u.user_id;
结果是 0 行。
再换成 not exists:
csharp
select
  u.user_id,
  u.user_name
from app_schema.t_join_user u
where not exists (
  select 1
  from app_schema.t_subquery_block_user b
  where b.user_id = u.user_id
)
order by u.user_id;
这次返回 1、3、4、5,也就是除了 bob 之外的四个用户。
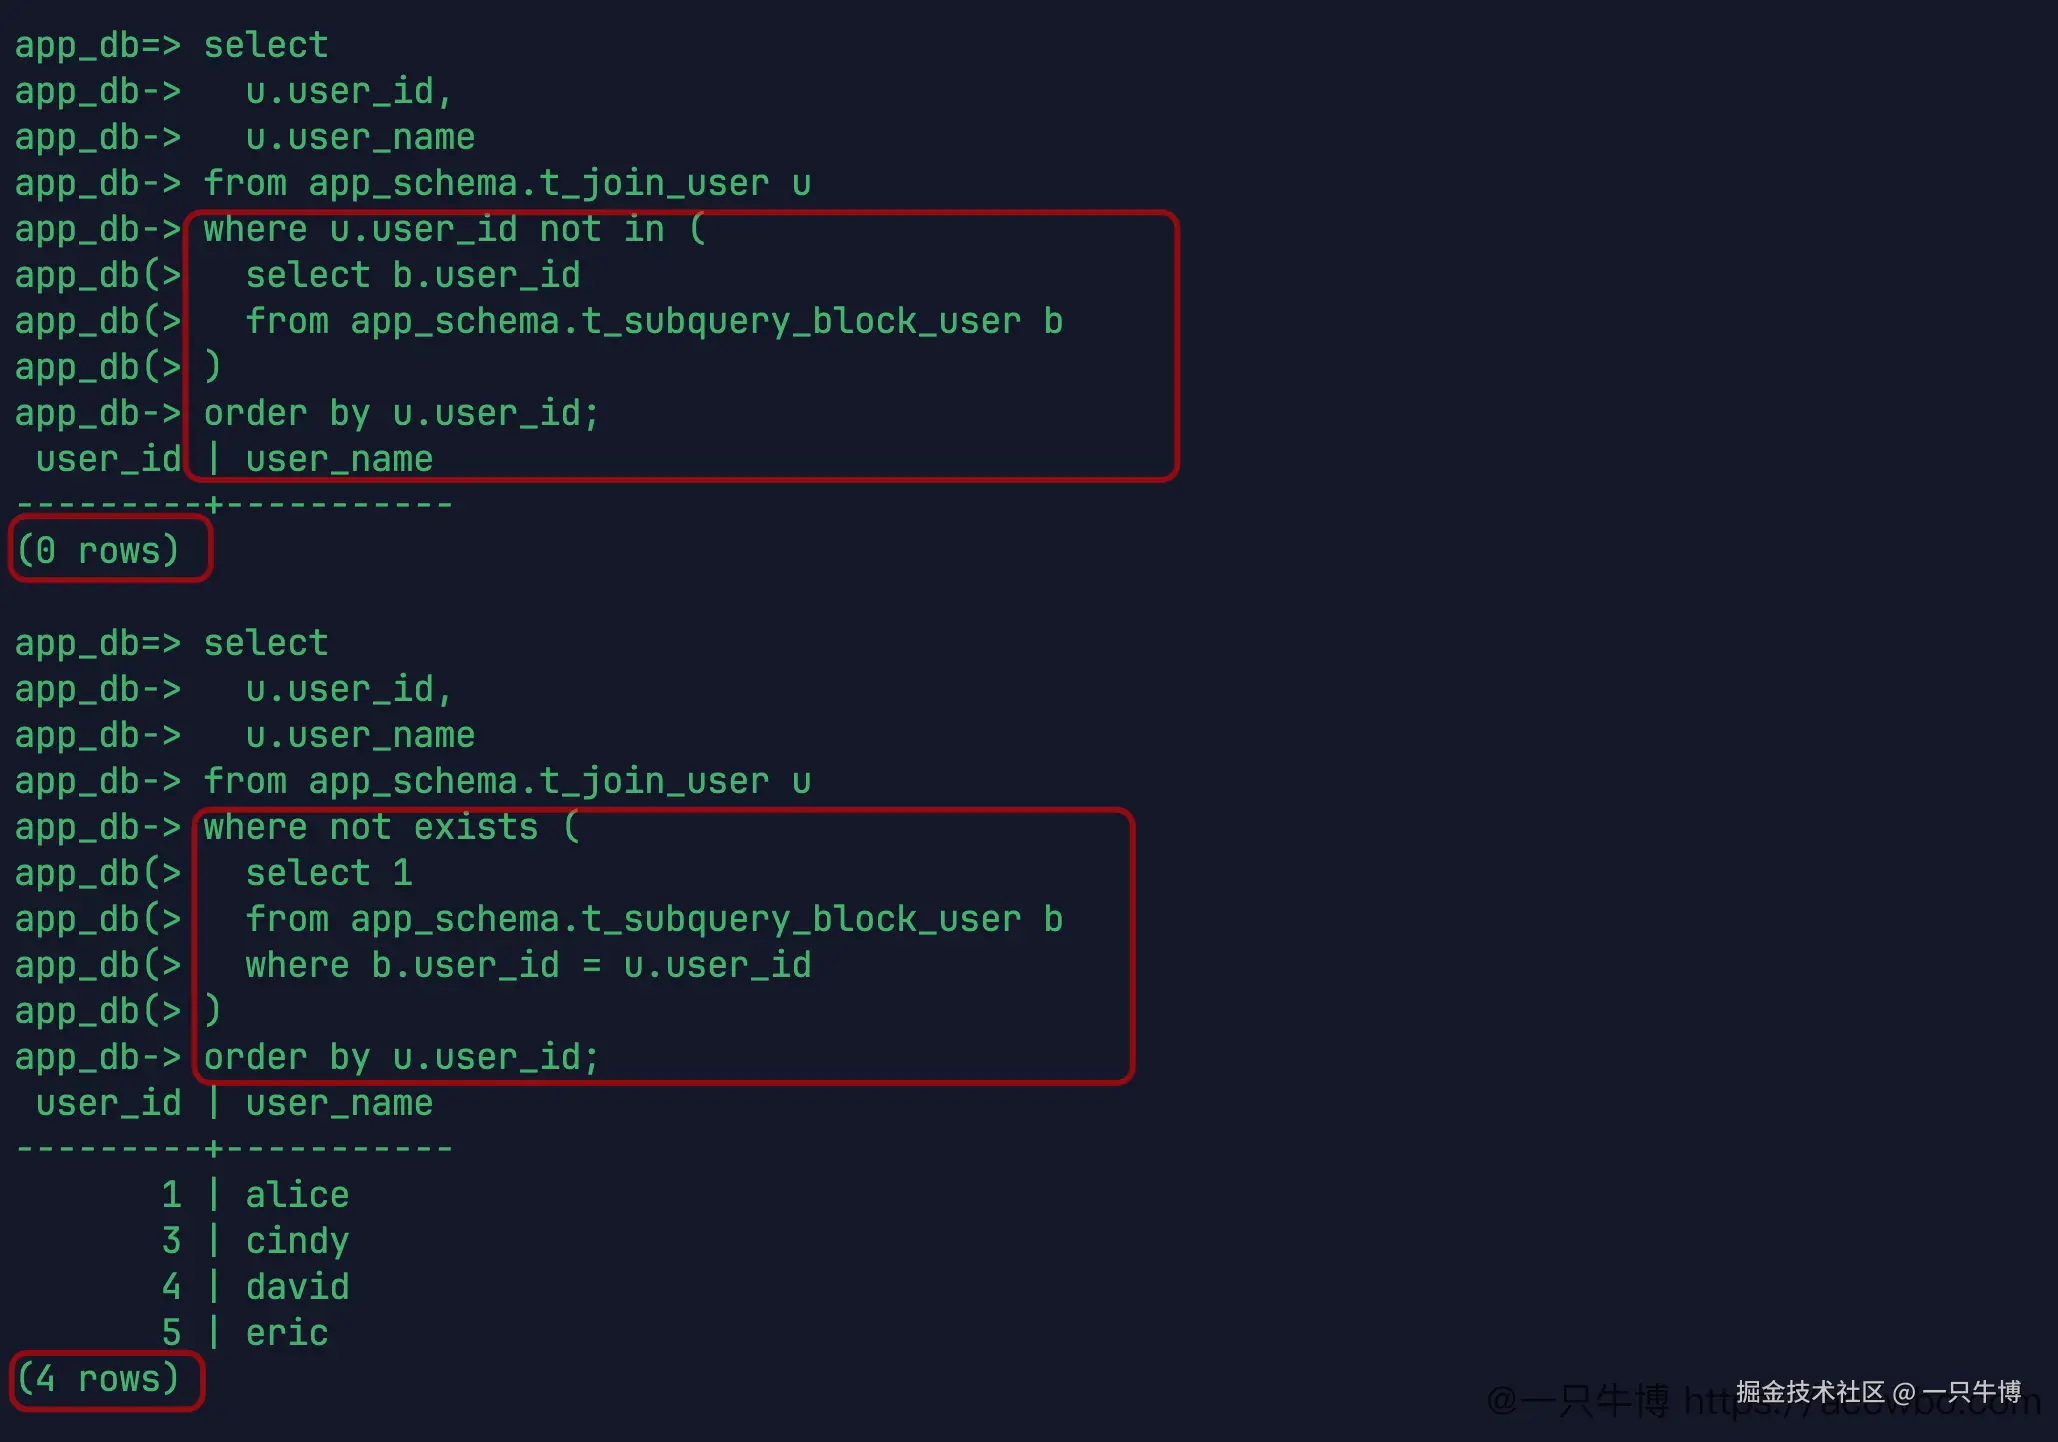
这就是 not in 遇到 NULL 时最容易踩的地方。子查询结果里混进 NULL 后,u.user_id not in (...) 不会按"除了 2 以外都返回"去理解,而是直接返回 0 行。写黑名单、排除名单、反选条件时,如果子查询列可能有 NULL,优先把 NULL 处理掉,或者改成 not exists 这种更贴近匹配关系的写法。
当然,也可以在 not in 的子查询里加 where b.user_id is not null,把脏数据先过滤掉。只是从维护角度看,not exists 更不容易忘这一步。看到 where b.user_id = u.user_id,就知道判断的是两边是否存在明确匹配,而不是拿一个可能带 NULL 的集合去做反选。
SELECT 里的子查询:给每行补一个值
子查询不一定只放在 where 里。比如用户列表里想顺手带出订单数、最大订单金额、最近下单时间,可以把子查询写在 select 字段位置:
csharp
select
  u.user_id,
  u.user_name,
  (
    select count(*)
    from app_schema.t_join_order o
    where o.user_id = u.user_id
  ) as order_count,
  (
    select max(o.amount)
    from app_schema.t_join_order o
    where o.user_id = u.user_id
  ) as max_amount,
  (
    select max(o.created_at)
    from app_schema.t_join_order o
    where o.user_id = u.user_id
  ) as latest_order_time
from app_schema.t_join_user u
order by u.user_id;
结果返回 5 个用户。alice 的订单数是 2,最大金额 199,最近下单时间是 2026-06-01 10:00:00;bob 的最大金额是 399;cindy 的最大金额是 88。david、eric 没有订单,订单数是 0,最大金额和最近下单时间为空。
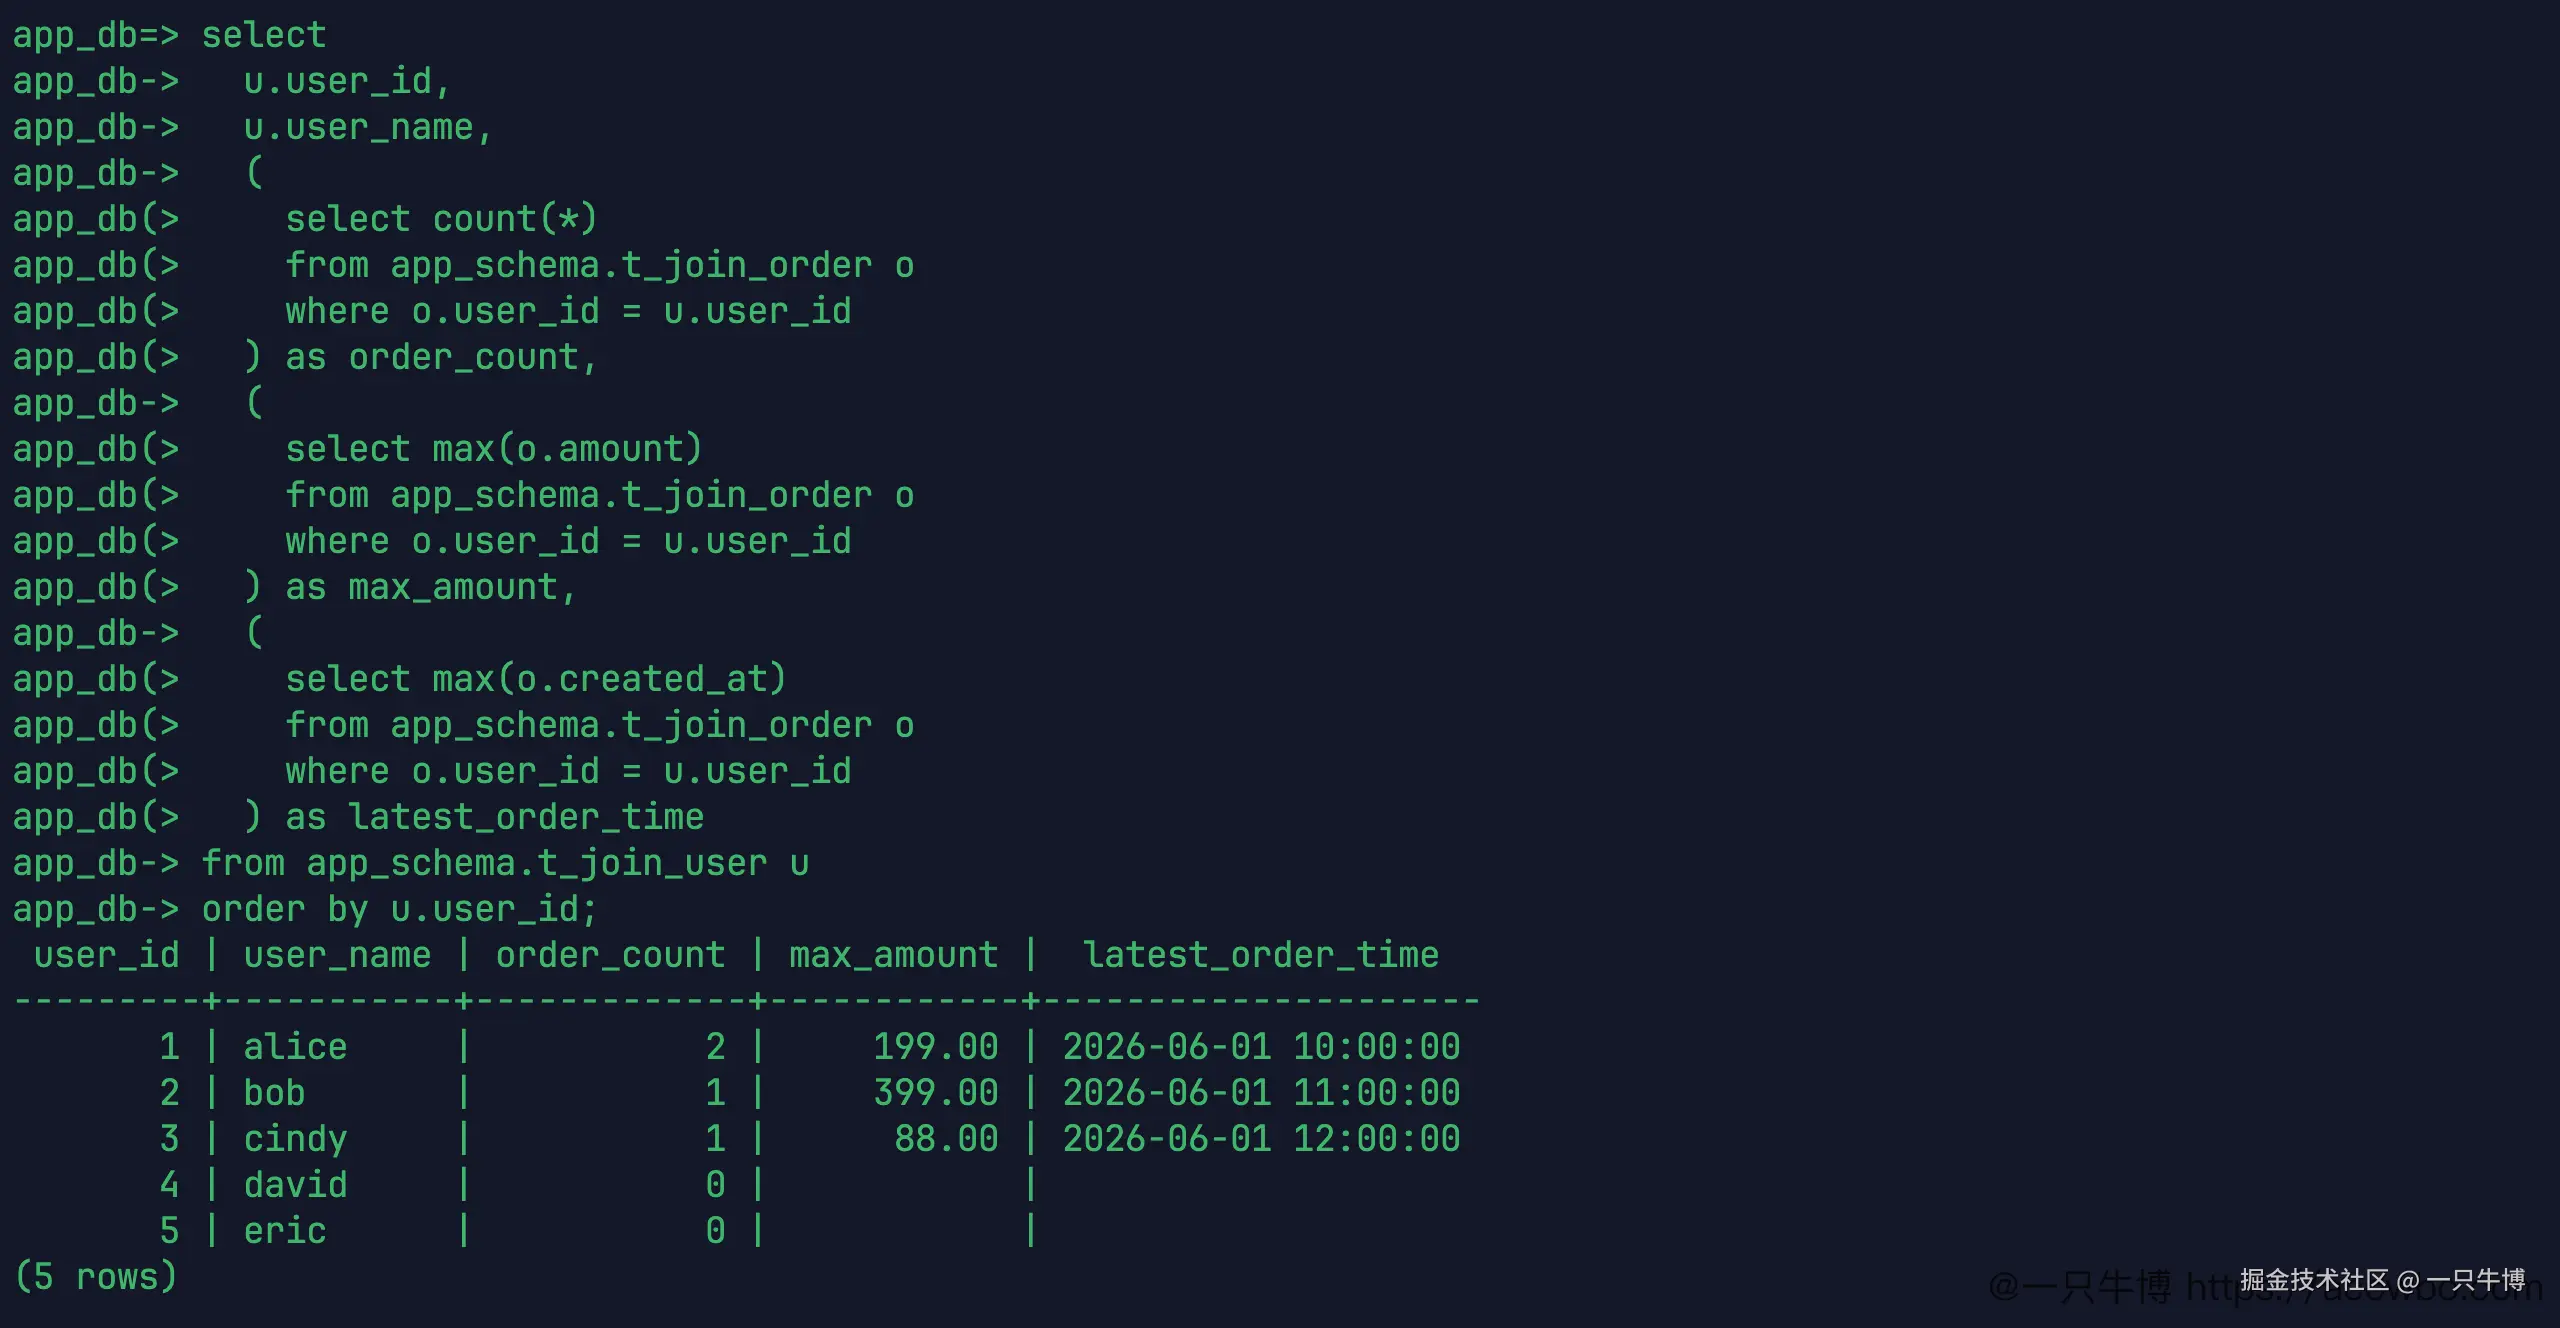
这种写法适合给主表每一行补一个单值。count(*) 没有匹配行时返回 0,max(...) 没有匹配行时返回 NULL,这两个结果也要分开看。列表页偶尔补一两个统计值时,这样写很直观;如果字段越堆越多,就该考虑派生表或 JOIN 后聚合了。
这里的三个子查询都引用了外层的 u.user_id,所以每个用户都会按自己的 user_id 去订单表里算一次。读 SQL 时可以把它理解成:先拿到一行用户,再给这行用户补订单数、最大金额、最近时间。它的优点是局部清楚,缺点是统计项多了以后,SQL 会变得很长,而且相同的过滤条件会重复写很多遍。
标量子查询不能返回多行
标量子查询的限制也很明确:它要返回一行一列。下面这条 SQL 故意写错:
vbnet
select
  u.user_id,
  u.user_name,
  (
    select o.order_id
    from app_schema.t_join_order o
    where o.user_id = u.user_id
  ) as any_order_id
from app_schema.t_join_user u
order by u.user_id;
alice 有两笔订单,子查询会返回 101 和 102 两行。执行后直接报错:
vbnet
ERROR: more than one row returned by a subquery used as an expression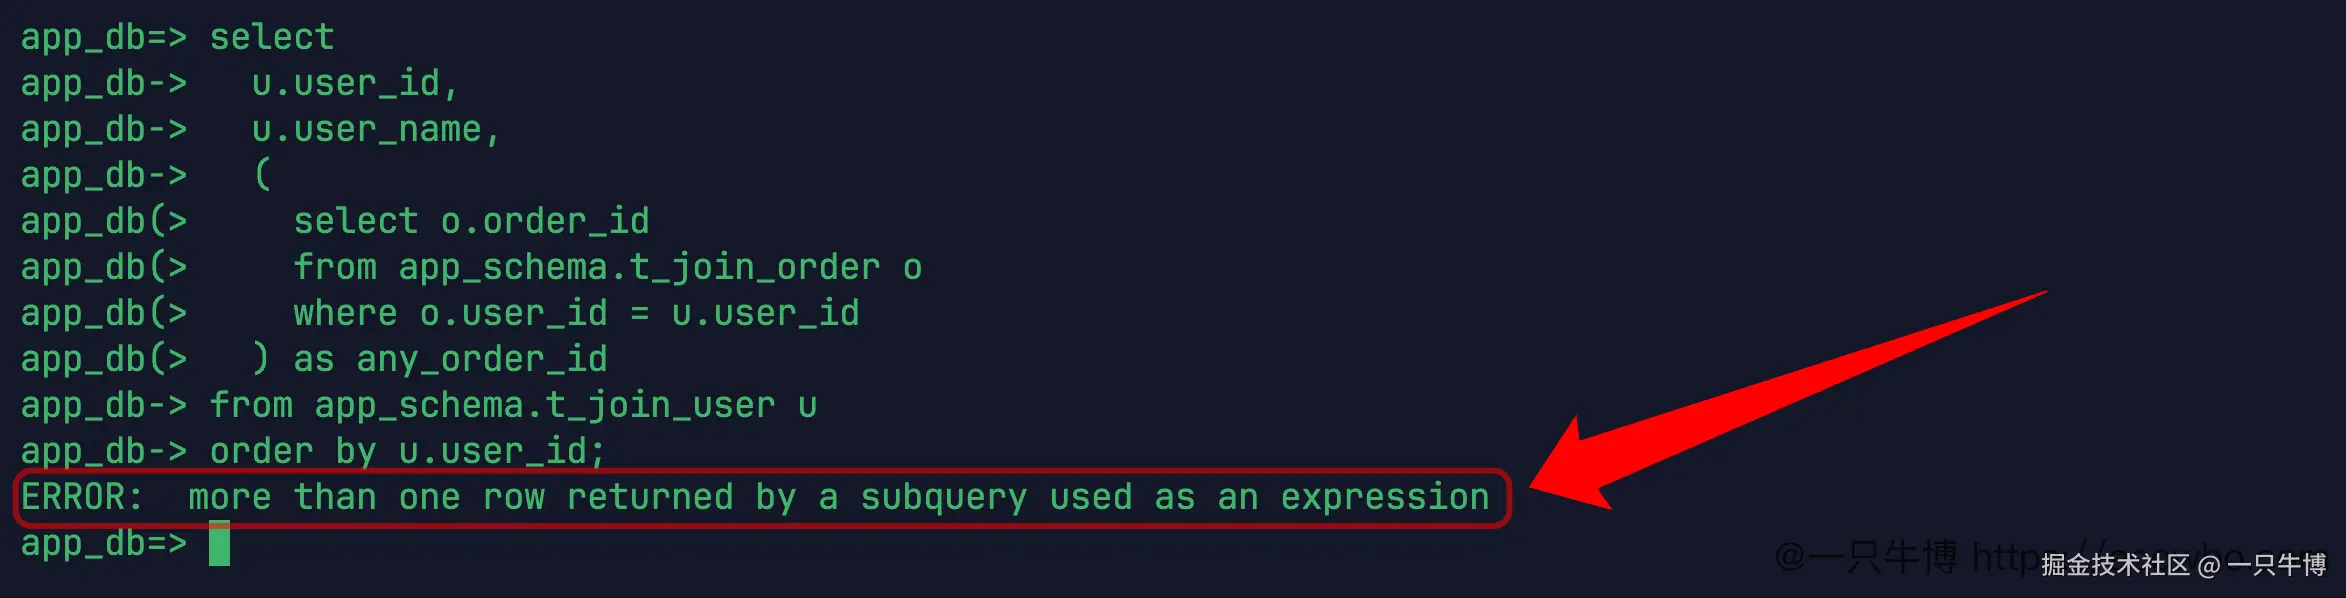
这个错误比成功案例更有提醒意义。把子查询放在字段位置时,数据库需要的是一个值,不是一组明细行。要么用 count、max 这类聚合把多行压成单值,要么加明确的排序和 limit 1,要么改成 JOIN 把明细行展开。不能把多行结果硬塞到一个字段里。
如果只是想随便拿一笔订单,直接加 limit 1 也不够严谨,还要写清楚排序规则。否则"第一笔"到底是哪一笔,取决于数据库实际返回顺序,后面数据量一变就可能换行。更常见的写法是先想清楚要最大金额、最近时间、最早订单,还是订单数量,然后用对应的聚合或排序表达出来。
FROM 里的派生表:先聚合,再关联
前面用三个标量子查询补了三个统计值。换一种写法,可以先在 from 里把订单按用户聚合好,再和用户表关联:
vbnet
select
  u.user_id,
  u.user_name,
  coalesce(s.order_count, 0) as order_count,
  s.max_amount,
  s.latest_order_time
from app_schema.t_join_user u
left join (
  select
    o.user_id,
    count(*) as order_count,
    max(o.amount) as max_amount,
    max(o.created_at) as latest_order_time
  from app_schema.t_join_order o
  group by o.user_id
) s
  on s.user_id = u.user_id
order by u.user_id;结果和前面统计口径一致:alice 2 笔订单,bob 1 笔,cindy 1 笔,david、eric 订单数为 0。
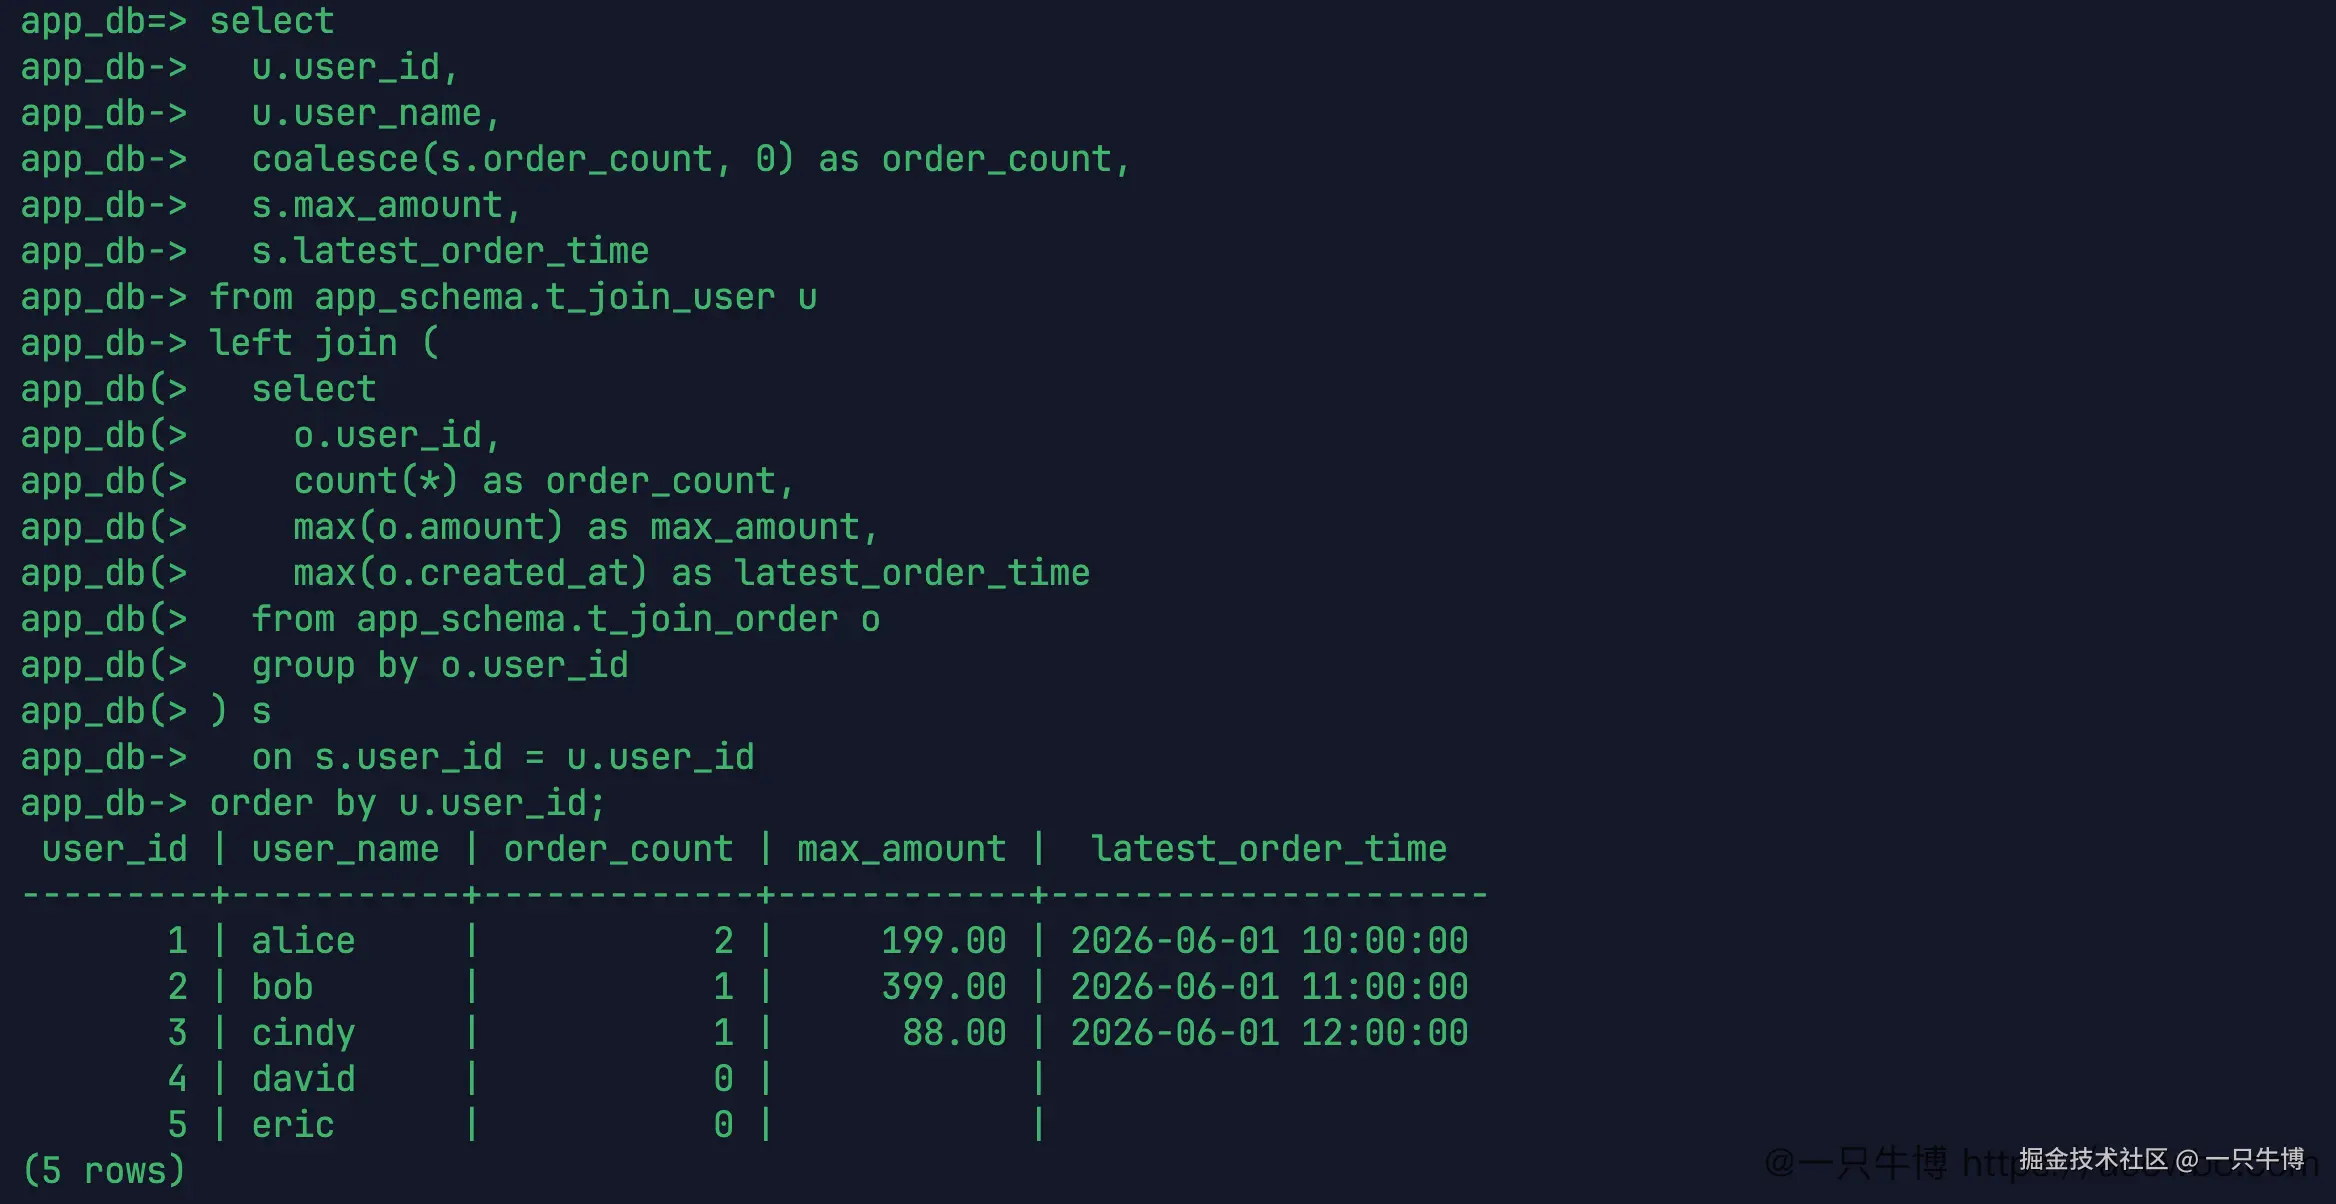
派生表适合"先把从表整理成一个结果集,再拿来关联"。它不像单个标量子查询那样分散在多个字段里,订单统计逻辑集中在一个子查询块中。字段多了以后,这种结构更容易读,也更方便继续调整统计口径。
这条 SQL 里还有一个细节:派生表 s 里只会有存在订单的用户,也就是 1、2、3。外层再用 left join 接回用户表,才把 4、5 保留下来。没有订单的用户,s.order_count 是 NULL,所以外层用 coalesce(s.order_count, 0) 转成 0。这个处理不写,页面上就可能显示空值,而不是 0。
WHERE 里的相关子查询:按统计结果筛选
子查询还可以放在 where 里当条件表达式。比如查最大订单金额大于等于 200 的用户:
sql
select
  u.user_id,
  u.user_name,
  u.status
from app_schema.t_join_user u
where (
  select max(o.amount)
  from app_schema.t_join_order o
  where o.user_id = u.user_id
) >= 200
order by u.user_id;
结果只返回 bob。
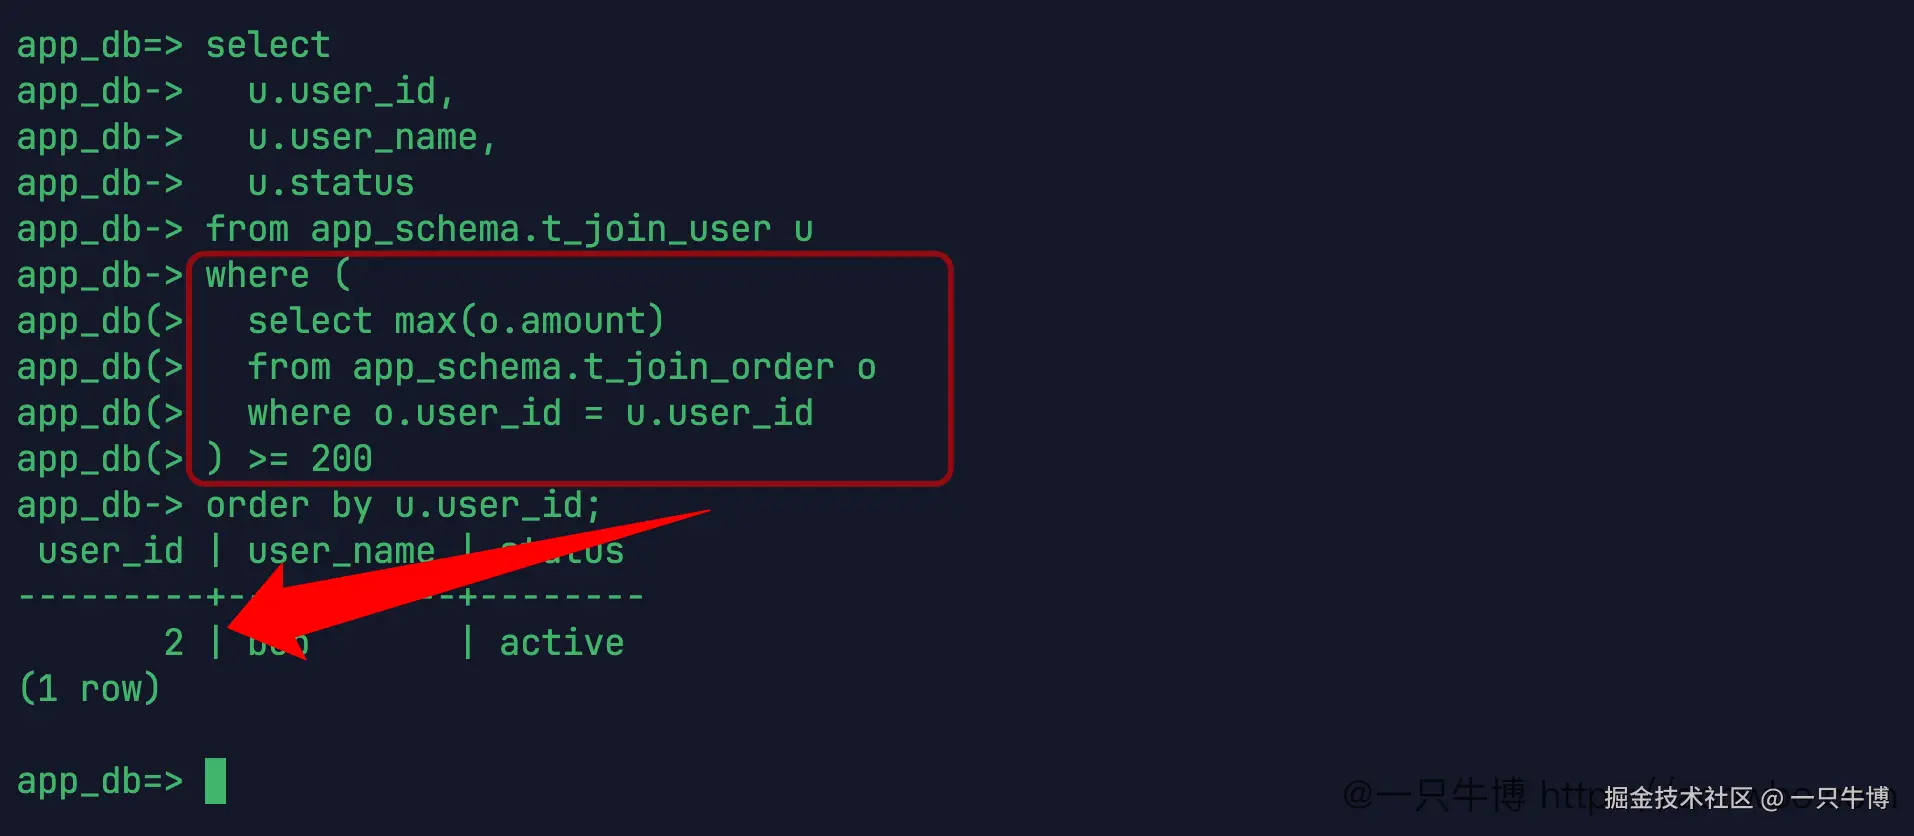
alice 的最大订单金额是 199,不满足条件;cindy 是 88,也不满足;david、eric 没有订单,max(amount) 返回 NULL,NULL >= 200 不成立。这个写法适合把聚合结果直接作为筛选条件,语义上很紧凑。
这里返回 bob 也能反查前面的数据:他的订单 103 金额是 399,超过 200。订单表里还有一条 user_id = 6 的订单,金额 128,但用户表里没有 6,所以外层用户查询不会返回它。KingbaseES 执行这类相关子查询时,结果仍然围绕外层用户逐行计算,外层没有的用户不会凭空进入结果。
在金仓数据库 KingbaseES 里练这些写法时,不需要把子查询和 JOIN 放成互相替代的关系。只判断有没有,exists 很顺;查没有匹配,not exists 很稳;补一个单值,标量子查询能直接放在字段里;先聚合再关联,派生表更集中;要把右表明细字段带出来,JOIN 仍然是更自然的写法。写 SQL 前先判断需求要的是"存在性""单个值""聚合后的结果集"还是"明细字段",比一上来就套固定写法更靠谱。
写到这里,子查询的几个常用位置基本够日常开发先用起来:where 里做存在性和条件筛选,select 里补单个值,from 里承接一段聚合结果。遇到更复杂的 SQL,再去看执行计划、索引和改写方式也不迟。眼下先把返回值形状看清楚:一组值、一行一列、还是一张派生结果表。形状对了,SQL 才不容易写偏。
还有一点可以先留在习惯里:子查询写完后,不要只看能不能执行,要看它返回的形状是否和外层使用位置匹配。in 需要一列值,标量位置需要单个值,from 里需要一张带别名的结果表。形状不对,轻则结果偏,重则直接报错。