你在做先导化合物优化时想在几分钟内看到候选分子的静电势(ESP)表面,而不是排队等 DFT;你想给 espsim、MMGBSA 或者可视化软件喂一套"近 DFT 质量"的原子电荷,而不是粗糙的 Gasteiger;你找到 Astex 2019 年开源的 ESP-DNN 图卷积模型,结果发现官方仓库是 Python 2.7 + TF 1.10 的"化石",
python -m esp_dnn.predict第一行就报 SyntaxError。本文带你从 git clone 开始,用 6 处最小补丁把 ESP_DNN 搬到 Python 3.11 + TF 2.15,跑通 ligand / protein 双模式,4 个配体 + 2 个蛋白的 PQR 输出与官方 ground truth md5 逐字节一致,阿司匹林 / 咖啡因新分子全链 0.2--0.3 秒出结果。
关键词:ESP-DNN、静电势表面、图卷积网络、Astex、PQR、PLI、off-center 电荷、Python 3 迁移
相关教程与核心文献
| 资源 | 链接 | 与本文关系 |
|---|---|---|
| AstexUK/ESP_DNN 仓库 | github.com/AstexUK/ESP_DNN | 部署对象:DNN 模型 + PLI 二进制 + 示例 |
| Rathi P, Ludlow RF, Verdonk ML, J. Med. Chem. 2020, 63(16), 8778--8790 | 10.1021/acs.jmedchem.9b01129 | 原始论文(online 2019-09-25) |
| NGL Viewer | nglviewer.org/ngl | 官方推荐的 ESP 表面可视化 |
| AstexUK/esp-surface-generator | github.com/AstexUK/esp-surface-generator | NGL 表面网格导出脚本 |
| PQR 格式说明 | apbs-pdb2pqr 文档 | 输出格式:坐标+电荷+半径 |
先看看文章中模型的效果:
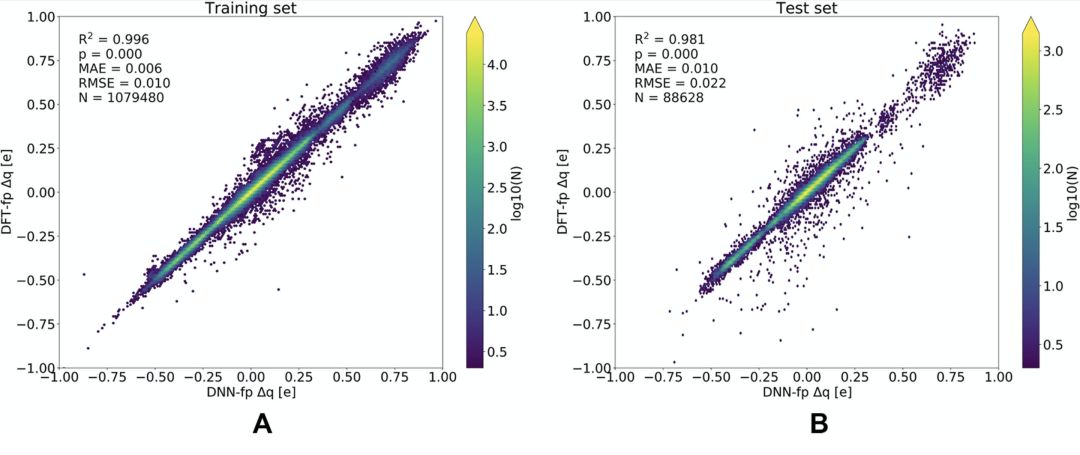
训练集以及测试集上的验证
针对训练集生成的DFT-fp对DNN模型进行了训练。 上图显示了DFT-fp Δq值相对于训练集的预测DNN-fp值的曲线图。 显然,该模型能够很好地描述训练集分子的点电荷,R2 = 0.996,RMSE Δq= 0.010e。 此外,在整个训练集中RMSEV平均值为3.30 kcal / mol,DNN-fp 模型生成的ESP表面质量近似于DFT-fp计算出的ESP表面。 将DNN-fp模型在测试集中的表现,显示DNN-fp和DFT-fpΔq值之间具有良好的相关性,其中R2 = 0.981,RMSE Δq= 0.022e。
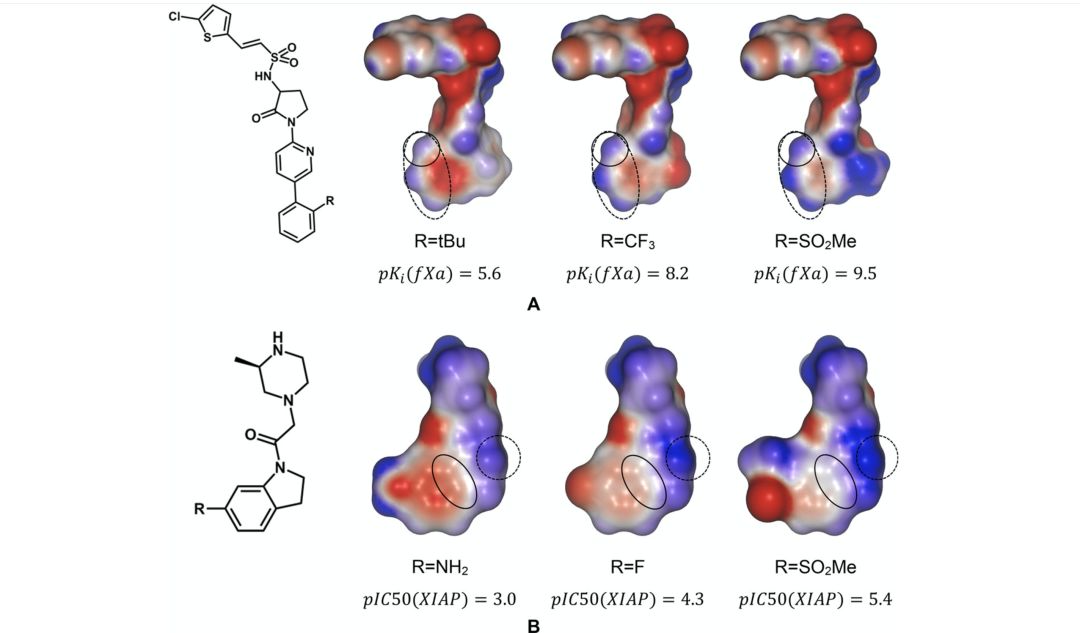
通过DNN-fp模型生成的ESP表面积
§1. 这个工具解决什么问题
众所周知,分子的静电性质可以用于预测化学反应性及分子间相互作用。常规流程是在分子表面移动单位电荷探针、逐点算 ESP 再着色,得到 ESP 表面。药物研发中静电互补优化至关重要------但 ESP 表面质量基本取决于底层静电模型,而蛋白-配体相互作用的静电效应只有量子力学(QM)计算能准确捕获,DFT 单分子动辄小时级,没法当常规药物设计工具用。
行业折中一直很尴尬:
| 电荷模型 | 速度 | 质量 | 问题 |
|---|---|---|---|
| Gasteiger / MMFF | 毫秒 | 粗糙 | σ-hole、孤对方向性几乎不体现 |
| AM1-BCC | 分钟级 | 中等 | 仍是半经验拟合,非 ESP 直接拟合 |
| RESP / DFT-fp | 小时级 | 精确 | 无法交互式使用 |
| ESP-DNN | ~0.2 s/分子 | 近 DFT | 需本地部署 + Py2 迁移 |
ESP-DNN 的卖点是:给配体预测的原子电荷外加 off-center 虚拟电荷点(孤对、σ-hole、p 轨道位置),一起写进 PQR 文件,直接喂 NGL/APBS 生成"近 DFT 质量"的 ESP 表面------化学家在可视化软件里编辑结构的间隙,ESP 表面就能刷新。
§2. 方法速览:图卷积 DNN 怎么学静电势
论文的构建路线(也是用户实测背景素材的对应关系):
训练集 :从 eMolecules 和 Sigma-Aldrich 可购买化合物中选取,最大程度覆盖化学空间,约束 HAC≤17、仅含 B/Br/C/Cl/F/H/I/N/O/P/S,共 100,500 个分子 ;测试集从 ChEMBL 构建,共 4,815 个。
标签生成:对每个分子(1)DFT 算电子密度 →(2)生成分子表面 →(3)在表面逐点算 ESP 值 →(4)拟合超额点电荷 Δq(含 off-center 位点),得到 DFT-fp 参照。
模型 :图卷积网络,输入原子特征 + 邻居矩阵,输出每个原子的 Δq。论文数字(测试集):DNN-fp 与 DFT-fp 的 Δq 相关性 R² = 0.981,RMSE = 0.022 e (训练集 R² = 0.996,RMSE = 0.010 e);测试集 ESP 表面平均 RMSE_V 3.27 kcal/mol,与 DFT-fp 自身的 3.15 几乎持平,显著优于 AM1-BCC ESP。速度上比 DFT 快 4 个数量级。
推理链路(部署后实际跑的就是这条):
.mol → RDKit MolToPDBBlock → pdb
                            → DNN 预测重原子 Δq → dq.dat
→ PLI 二进制(加 off-center 点)→ .pqr带电分子的处理:模型只在中性分子 上训练,推理时先把输入中性化再预测,随后 apply_charge_correction 对形式电荷原子加 0.4×formal-charge 增量、等价原子(羧酸根两个 O 等)电荷取平均。这意味着对带电配体它的 ESP 形貌预测有系统性局限(后文 §10)。
§3. 本地部署:从 clone 到跑通
4.1 系统要求
README 写"仅支持 64 位 Linux"------严格说这是 PLI 二进制的要求:ext/pli/bin/pli 是静态链接 ELF (file 输出 statically linked,5.3 MB),任何 x86-64 Linux 直接 exec,无需装任何动态库;Windows 用户走 WSL2 即可。Python 部分纯跨平台。
4.2 克隆仓库
git clone --depth 1 https://github.com/AstexUK/ESP_DNN.git
cd ESP_DNN
实测 20,909 个文件、311 MB ------大头是 PLI 的 pdbdict 和模型文件(esp_dnn/model/trained_model.h5 约 300 MB 级 h5 + norm_params.pkl)。clone 一次几分钟。
4.3 建环境(Py3.11 + TF 2.15)
官方 environment.yml 是化石级配置:
# 官方 environment.yml(2019)
python=2.7.15, rdkit==2018.09.3, keras==2.2.4,
tensorflow==1.10.0, numpy==1.16.2, xarray==0.11.3
Py2.7 环境在 2026 年的机器上已经没有维护意义,直接建 Py3 环境(TF 2.15 的 wheel 只到 Python 3.11,这是版本锚点):
# venv(uv 或 python -m venv 均可)
uv venv --python 3.11 ./venv
uv pip install --python ./venv/bin/python \
  "numpy==1.26.4" pandas xarray \
  "tensorflow==2.15.0" rdkit scipy
GPU 非必需:本机实测纯 CPU 推理单分子 0.2--0.3 s,消费级机器完全够用,模型也小(加载 1.9 s)。
4.4 第一跑:SyntaxError
python -m esp_dnn.predict -m ligand -i examples/ligands

File ".../esp_dnn/predict.py", line 412
    except AIChargeError, e:
           ^^^^^^^^^^^^^^^^
SyntaxError: multiple exception types must be parenthesized
Py2 的 except X, e: 语法,Py3.11 连 import 都过不去。这就是需要补丁的信号。
§4. 6 处最小补丁:Py2/TF1 → Py3.11/TF2.15
原则:只改兼容性,不动算法逻辑,改完以官方 ground truth 的 md5 做回归验证。共 6 处,按文件分组:
| # | 文件 | Py2/TF1 原写法 | Py3/TF2.15 修法 | 不改会怎样 |
|---|---|---|---|---|
| 1 | predict.py | except AIChargeError, e: |
except AIChargeError as e: |
SyntaxError,第一步就死 |
| 2 | predict.py | pickle.load(f)(文本模式) |
open(..., "rb") + pickle.load(f, encoding="latin1") |
norm_params.pkl 是 Py2 写的,Py3 默认 ASCII 解码直接 UnicodeDecodeError |
| 3 | predict.py | tf.get_default_graph() + with self.graph.as_default(): |
删除,直接 self.model.predict(...) |
TF2 无 default graph 概念,AttributeError |
| 4 | predict.py | self.featurizer.get_mol_fetaures(mol) |
get_mol_features(mol)(与修好的 featurize.py 统一) |
AttributeError(原名就是拼写错误) |
| 5 | atom_features.py / graph_conv.py / model_factory.py | from rdkit.Chem.AtomPairs.Utils import NumPiElectrons;from keras.engine.topology import Layer;keras.optimizers.Adam |
RDKit 2024+: rdchem.GetNumPiElectrons;TF2: tensorflow.keras.layers.Layer;tensorflow.keras.optimizers.legacy.Adam;另 range(1,19)+[None] → list(range(1,19))+[None] |
ImportError 逐个爆 |
| 6 | data_processing.py | pickle.load(f) |
同 #2 加 encoding="latin1" |
同 #2 |
几点说明:
- 最隐蔽的是 #2 的
latin1:Py2 pickle 里 str 是原生字节,Py3 默认按 ASCII 解码,文件头几个字节就抛 UnicodeDecodeError,报错位置还不在业务代码里,容易误判成文件损坏。 - TF2 的 Adam 落点 :
tf.keras.optimizers.Adam在 TF 2.16+ 整体移到optimizers.legacy,TF 2.15 环境两者都可,但写 legacy 路径向下兼容更稳。 graph_conv.py里 TF1 的tf.Print调试层在 TF2 已删,随 #5 一起清理。- 模型 h5 本身不需要 任何转换------Keras 2.15 的
load_model(配合自定义层注册)能直接读 2019 年的权重,这是这次迁移成本低的关键。
打完补丁先做语法检查:
python -m py_compile esp_dnn/predict.py esp_dnn/atom_features.py \
  esp_dnn/graph_conv.py esp_dnn/model_factory.py \
  esp_dnn/data_processing.py esp_dnn/featurize.py
§5. 安装测试:md5 逐字节复现官方结果
验证标准:仓库 examples/ 里每个输入都带 *.pqr.saved 官方输出,本地跑完 md5sum 逐字节对比。字节级一致 = 补丁没有引入任何数值偏差(浮点都一样,说明 DNN 前向传播 + PLI 参数链完全复现)。
6.1 ligand 模式(README 官方命令)
cd ESP_DNN
python -m esp_dnn.predict -m ligand -i examples/ligands -o ./out_lig   # out_lig 需先 mkdir
python -m esp_dnn.predict -m protein -i examples/proteins -o ./out_prot
实测结果(消费级 CPU,2026-09-30):
| 模式 | 输入 | 输出 | md5 vs 官方 saved | 耗时 |
|---|---|---|---|---|
| ligand | lig1.pdb | lig1.pdb.pqr(63 行) | 一致 | 全批 4 分子 3.0 s(含模型加载) |
| ligand | lig2.pdb | lig2.pdb.pqr(62 行) | 一致 | --- |
| ligand | lig3.pdb | lig3.pdb.pqr(65 行) | 一致 | --- |
| ligand | lig1_charged.pdb | lig1_charged.pdb.pqr(63 行) | 一致 | --- |
| protein | 1akg_neutral.pdb | 27,619 B | 一致 | 全批 0.56 s |
| protein | 5c7a_charged.pdb | 177,926 B | 一致 | --- |
6/6 全部 md5 一致。 protein 模式不经过 DNN(氨基酸用参数化电荷,由 PLI 直接处理),所以更快;5c7a_charged 这种上千原子的蛋白也在半秒内完成。
注意 ligand 模式如果输入目录里有 .mol 文件(examples 自带),程序会先用 RDKit 转出 .mol.pdb 再统一处理------所以 examples 里 4 个配体实际产出的 PQR 文件名是 lig1.mol.pdb.pqr 系,和 *.saved 的 md5 是对得上的(lig1.pdb.pqr.saved 与 lig1.mol.pdb.pqr 内容一致,两条路殊途同归)。
§6. 新分子实测:阿司匹林与咖啡因
示例复现只能证明"补丁无害",还要看对新分子的泛化。从 SMILES 出发走完整链路(这是实际使用时的标准姿势):
from rdkit import Chem
from rdkit.Chem import AllChem

for name, smi in {
    "aspirin": "CC(=O)Oc1ccccc1C(=O)O",
    "caffeine": "CN1C=NC2=C1C(=O)N(C)C(=O)N2C",   # C8H10N4O2, 24 原子
}.items():
    m = Chem.AddHs(Chem.MolFromSmiles(smi))
    AllChem.EmbedMolecule(m, randomSeed=42)
    w = Chem.SDWriter(f"{name}.mol"); w.write(m); w.close()
然后把这两个 .mol 放进一个空目录(目录里不要有别的 pdb),从仓库根目录跑:
python -m esp_dnn.predict -m ligand -i /path/to/mols实测(暖模型后逐分子计时):
| 分子 | 原子数 | PQR 行数 | 构成 | 总电荷 | 单分子耗时 |
|---|---|---|---|---|---|
| 阿司匹林 | 21 | 49 | 13 重原子 + 8 H + 8 Hlp + 20 Hp | −0.0009 e | 260 ms |
| 咖啡因 | 24 | 51 | 14 重原子 + 10 H + 5 Hlp + 22 Hp | +0.0001 e | 216 ms |
总电荷归零到 10⁻³ e 量级(推理后减均值 + 等价原子平均),off-center 点数量随杂原子数变化------咖啡因 4 个 N 出 5 个孤对位,阿司匹林酯/羧酸 O 出 8 个。一个小坑提醒:写 SMILES 时先 CalcMolFormula 核一遍分子式再往下走,我第一版咖啡因 SMILES 手滑多写了一个 N,29 原子的"咖啡因"照样全链跑通------工具不会替你检查化学合理性。
速度上:模型加载 1.92 s(一次性),之后每个分子 0.2--0.3 s(DNN 前向 + PLI),确实到了"交互式刷新 ESP"的量级,和论文宣传一致。
§7. PQR 输出解读与可视化
PQR 每行 = PDB 坐标 + 电荷(occupancy 列)+ 半径(bfactor 列)。三种"虚拟原子"的命名语义(从 ext/pli/params/features.pli 实查,H 前缀表示伪原子):
| 名称 | 含义 | 来源 |
|---|---|---|
Hh |
真实氢原子(带 DNN/Gasteiger 链路的电荷) | on-atom |
Hlp |
孤对(lone pair)off-center 点,如 N/O 孤对方向 | ftype lp "lone pair" off-centred |
Hp |
p 轨道 off-center 点,芳香/共轭体系 π 分布 | ftype p |
Hsh |
σ-hole off-center 点,卤素/硫反键方向 | ftype sh "sigma hole" off-centred |
阿司匹林 PQR 节选(第 2 列电荷):
HETATM   12  O3 UNL _   1    0.786  -2.058   0.526  -0.4164  1.6000   # 羰基 O, 负电荷集中
HETATM   19 Hlp UNL _   1   -2.694  -0.726   1.877  -0.0060  0.8700   # 孤对虚拟点
HETATM   43 Hlp UNL _   1    1.013  -2.773   0.805  -0.0074  0.8700
可视化按 README 走 NGL Viewer(nglviewer.org/ngl):File 打开 PQR → 添加 surface 表示 → surfaceType=av、radiusType=explicit、colorScheme=electrostatic,colorDomain 建议 -50, 50 kcal/mol,colorScale=rwb。Jupyter 内用 nglview 同参数。要导出表面网格数据(顶点+ESP 值)就用官方配套的 NodeJS 脚本 esp-surface-generator。
对药化工作流,这套 PQR 还有两个下游用法:电荷列直接作为 espsim 的自定义电荷算 ESP 相似度;或与蛋白 PQR(protein 模式产物)一起做静电互补定性检查。
§8. 踩坑清单
| # | 症状 | 根因 | 修复 |
|---|---|---|---|
| 1 | SyntaxError: multiple exception types must be parenthesized |
Py2 except X, e: 语法 |
§5 补丁 #1 |
| 2 | UnicodeDecodeError(加载 norm_params.pkl) |
Py2 pickle 字节流 vs Py3 ASCII 默认解码 | open(...,"rb") + encoding="latin1" |
| 3 | AttributeError: module 'tensorflow' has no attribute 'get_default_graph' |
TF1 graph API 在 TF2 删除 | 删掉 graph 上下文直接 predict |
| 4 | OSError: Bad output file .../lig2.mol.pdb |
-o 输出目录不会自动创建 |
先 mkdir -p 输出目录 |
| 5 | -o 指定独立目录时只产出 .mol.pdb 中间文件,没有 PQR,日志末尾 No input files found |
源码两阶段 glob 脱节:.mol→.pdb 写进输出 目录,但第二阶段 glob *.pdb 只扫输入 目录。官方 examples 能跑通纯粹因为仓库自带 .pdb |
不用 -o,让输入输出同目录(PQR 会产在 .mol 旁边);或先把 .mol 转成 .pdb 后放入输入目录 |
| 6 | ModuleNotFoundError: No module named 'esp_dnn' |
python -m 需要仓库根在 sys.path |
cd 进仓库根再跑(README 有说明),或 pip install -e . |
| 7 | Windows git clone 报设备名错误 | 仓库 cif/CON/CON.cif、cif/PRN/PRN.cif 撞 Windows 保留设备名 |
用 codeload tarball + unzip 绕过 |
| 8 | 想设 PLI_DIR 环境变量 |
其实不必须 | predict.py 自动探测 esp_dnn/ext/pli,只有挪动二进制时才需要设 |
坑 5 是这次实测抓到的最有价值的一个:它不是报错,而是静默空转 (exit 0、无 PQR、只有一行 INFO 级 No input files found),如果不在 examples 之外的目录试新分子根本发现不了。
§9. 局限与适用边界
- 训练集全中性 + HAC≤17 + 11 种元素:带电配体的电荷预测靠中性化+0.4 修正近似,ESP 形貌对净电荷差异不敏感(此前实测同一骨架 ±0.4 e 对,ESP 相似度仍高达 0.9+,判别力丢失);超出元素/大小域的分子(金属配体、大环)慎用。
- 模型是 2019 年定格的:仓库 6 年未更新主模型,后续有 EspalomaCharge 等 GNN 电荷新工作可作对比,但"off-center 点 + 蛋白参数化电荷 + NGL 交互"这套完整链路仍是 Astex 独家。
- PLI 二进制闭源 (静态 ELF 可执行,参数表
elements.pli/features.pli可读但不可改):想自定义 off-center 类型或扩元素只能等上游。 - 何时该切换任务:要绝对精确 → 直接 DFT/RESP;要蛋白-配体互补性打分 → 这套 PQR 定性看可以,定量要上 APBS 类求解器。
参考来源
| 资源 | 链接 |
|---|---|
| AstexUK/ESP_DNN | github.com/AstexUK/ESP_DNN |
| Rathi 等 J. Med. Chem. 2020, 63(16), 8778--8790 | 10.1021/acs.jmedchem.9b01129 |
| NGL Viewer | nglviewer.org/ngl |
| esp-surface-generator | github.com/AstexUK/esp-surface-generator |
| PQR 格式 | apbs-pdb2pqr.readthedocs.io |
| iwatobipen ESP_DNN Py3 fork(早期参照) | github.com/iwatobipen/ESP_DNN |
系列导航 :本专栏为 CADD 中的机器学习模型 ,本文是静电势预测模型部署方向,专栏全集点 这里。
更多专栏: