目录
[Graph API 编码思路](#Graph API 编码思路)
[步骤2:定义节点 Nodes,创建配送站点](#步骤2:定义节点 Nodes,创建配送站点)
[步骤3:定义 StateGraph图,成立快递公司](#步骤3:定义 StateGraph图,成立快递公司)
[步骤4:添加节点 Nodes,建设配送站点](#步骤4:添加节点 Nodes,建设配送站点)
[步骤5:添加边 Edges,规划运输路线](#步骤5:添加边 Edges,规划运输路线)
一、智能快递配送系统
Graph API 编码思路
构建 Graph 图,首先需要【定义状态】,然后【定义并添加节点和边】,最后【编译】它。编译提供了对图形结构的一些基本检查(没有孤立节点等)。
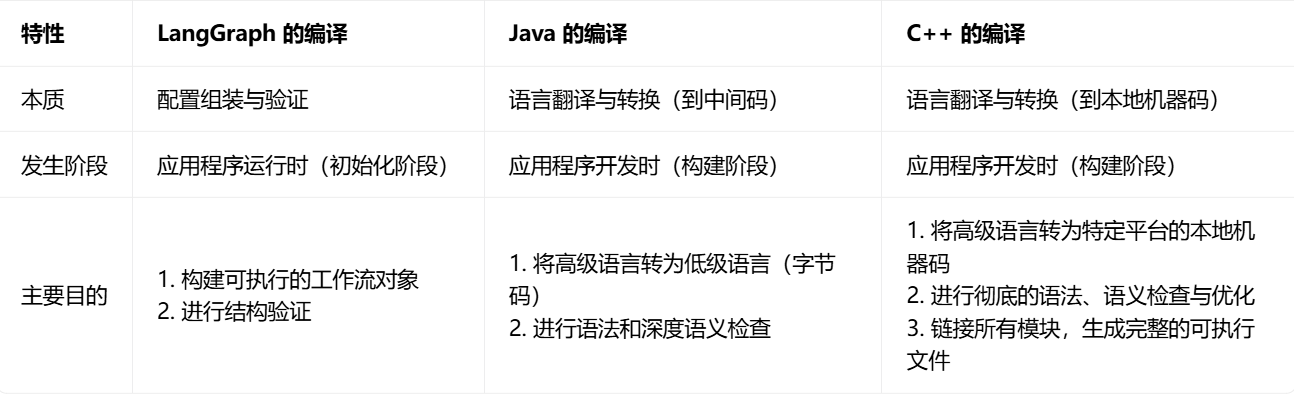
LangGraph 所谓的 "编译" 与传统意义上的语言编译完全不同,LangGraph 编译本质是在运行时动态构建和验证一个复杂的图,而非翻译代码。
C++ 的编译是 "完整编译" 或 "静态编译" 的典范。它追求在程序运行之前,就将所有代码 "解决" 完毕,生成一个独立、高效、可直接被操作系统调用的 "成品"。它比 Java 的编译更彻底 (直接到机器码,而非中间码),也更底层 (紧密绑定操作系统和 CPU 架构)。
"编译" 对比表格:
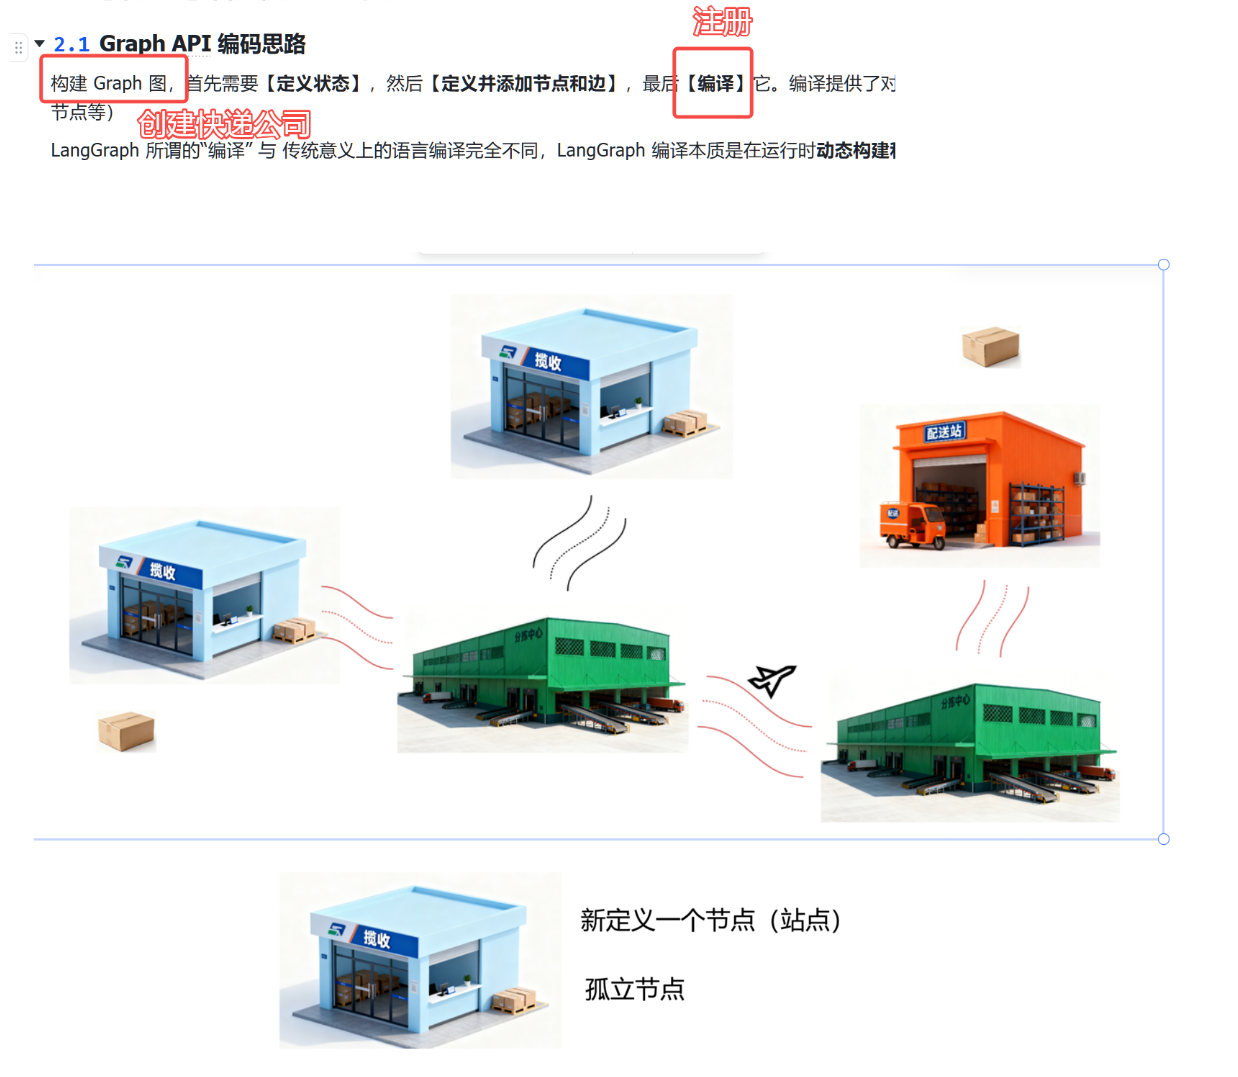
智能快递配送系统图讲解
下面用这张图的快递公司的业务类比 LangGraph 构建 Graph 图的完整流程:
整体流程分为三大步骤:定义状态 → 定义并添加节点和边 → 编译。
- 定义状态:相当于定义快递包裹的数据结构,包裹 id、始发地、目的地、流转记录这些信息,就是 Graph 的 State,所有站点都共用这份包裹信息。
- 定义并添加节点和边
- **节点:**就是一个个快递站点,揽收站、分拣中心、配送站,每一个站点对应 LangGraph 里面的一个 node 节点函数,每个站点只负责自己那一部分业务逻辑。
- **边:**就是站点之间的运输路线,规定包裹跑完 A 站点之后,接下来去往哪一个站点。把揽收站、分拣中心、配送站通过运输路线(边)串联起来。
- 图里的孤立节点:只新建了一个揽收站点,但是没有给它配置任何进出的运输路线,没有边把它接入整个业务网络。
- 编译 (compile):类比 "注册快递公司"。 编译并不是翻译代码,而是做两件核心工作:
- 把已经写好的节点、边组装起来,生成一个可以直接调用运行的工作流对象。
- 做图结构校验:检测是否存在孤立节点。像图中这个只创建、没有连线的揽收站,编译的时候就会检测出来并报错,防止出现有节点但是流程无法走到的问题。
智能快递配送流程:
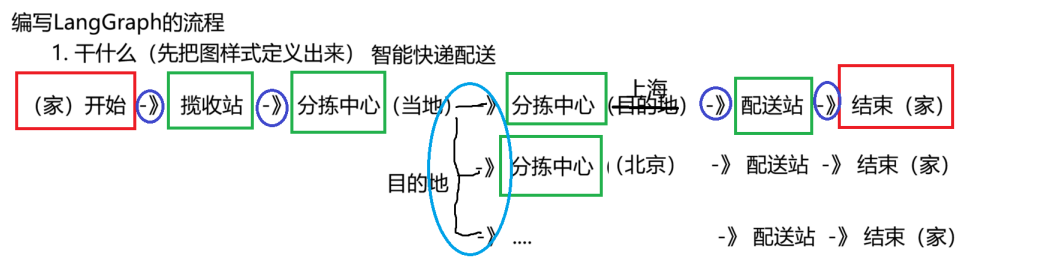 这张图是智能快递配送完整的流程图。
整个流程从 START 起点开始,首先完成包裹信息的初始化,也就是给 state 赋值包裹 id、始发地、目的地、优先级等全部数据。
流程第一步进入揽收站节点,完成包裹揽收操作,更新包裹的状态与流转记录。
揽收完成之后,流转到主分拣中心,这里作为默认中转节点。主分拣中心读取包裹 state 里面的目的地字段,做条件判断,执行路由分发。根据目的地归属,把包裹分流到分支分拣中心 A(东部)、分支分拣中心 B(西部)、分支分拣中心 C(南部)其中的某一个分支。
每一个分支分拣中心拿到包裹之后,会读取包裹的 priority 优先级。如果包裹标记为加急就选择飞机运输;普通包裹则走陆运运输。不同分支的飞机、陆运两条运输路径,最终全部汇聚流向派送站节点。
到达派送站之后,执行最终配送业务逻辑,更新包裹状态为已签收,记录流转日志。
全部业务处理完毕,流转到 END,整个快递配送流程正式结束。
这两张图体现了 LangGraph 条件边的能力:同样一个节点执行完毕之后,可以根据 state 内部的业务数据动态选择下一跳去往哪一个节点,不再是固定一条直线流程。多个不同分支路径,最后又可以汇聚到同一个节点,继续往下执行。
二、编码
编码流程
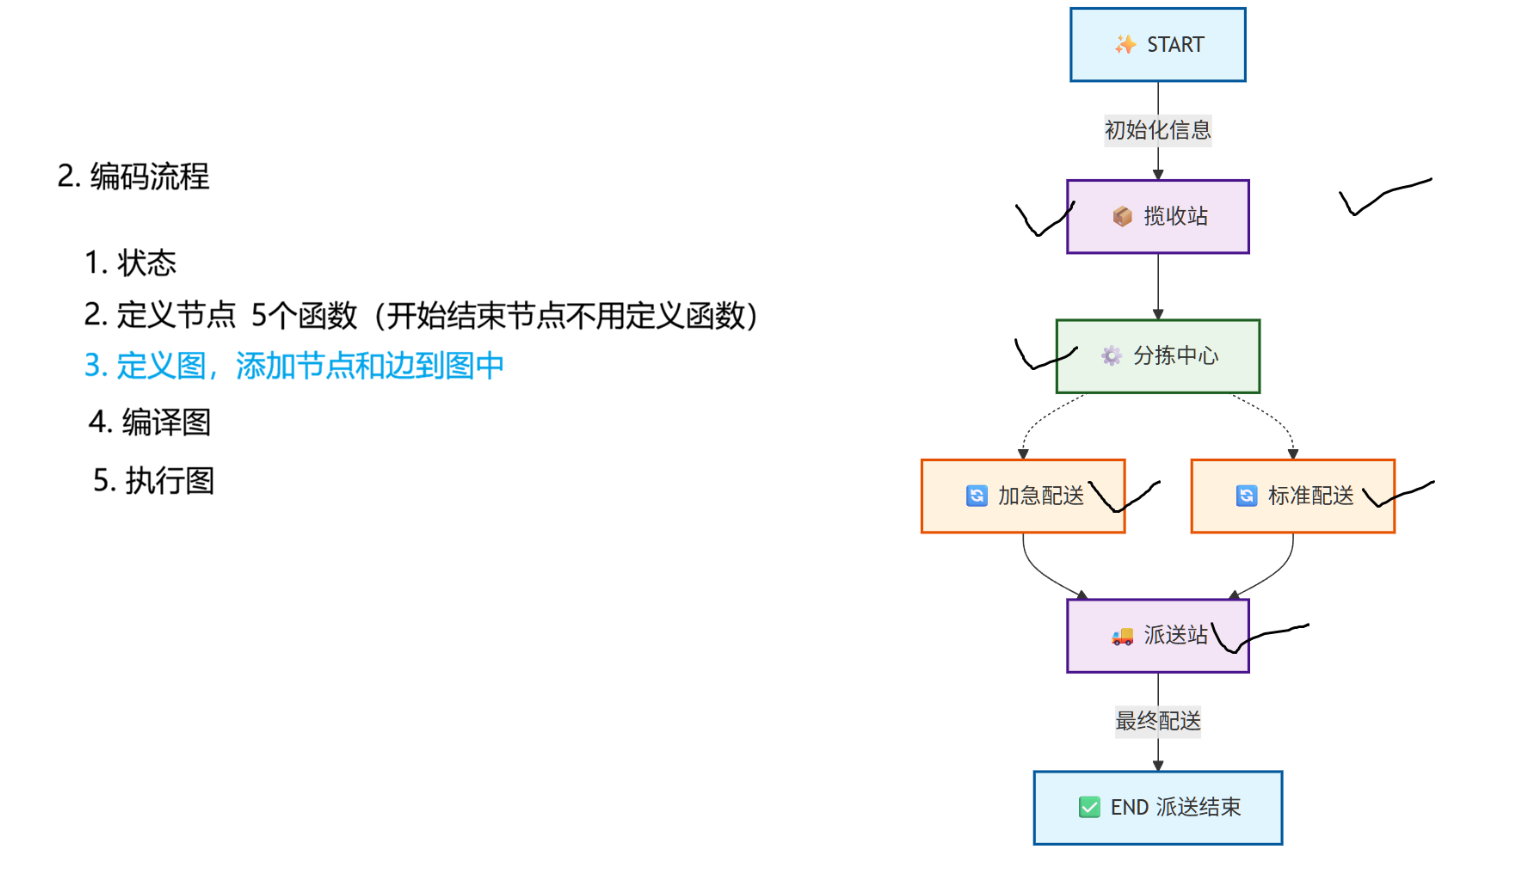 整套 LangGraph 编码一共分为 5 个步骤,和上面的流程图一一对应。
**第一步,定义状态。**我们先定义好 PackageState,用来存放包裹全部业务数据,整张图所有节点共享这一份状态数据,包裹 id、目的地、priority 优先级、流转历史都保存在这里。后续所有节点函数读取、修改的数据都来自这个状态。
**第二步,定义节点,**一共 5 个业务函数。这里要注意,流程图里的 START、END 是 LangGraph 内置的起点、结束标记,不需要我们自己编写函数,框架内部已经实现。 我们需要手写函数的业务节点分别是:揽收站、分拣中心、加急配送、标准配送、派送站,一共 5 个,每一个节点就对应一个 Python 函数。
**节点和函数的关系:**一个业务节点绑定一个函数。函数是这个节点真正要执行的业务逻辑。当流程流转到这个节点的时候就会自动调用绑定的函数,传入当前 state,函数执行完成返回状态更新字典,LangGraph 自动合并更新全局状态。
**第三步,定义图,添加节点和边到图中。**实例化 StateGraph 图构建器,把上面写好的 5 个函数通过 add_node 注册到图,给每个函数起节点名字。再通过边配置流转逻辑:START 指向揽收站;揽收站固定流向分拣中心;分拣中心这里配置条件边,读取 state 里面 priority 字段,如果是加急就走到加急配送节点,如果是普通就走到标准配送节点;加急配送、标准配送两个分支最后都汇聚到派送站;派送站再指向 END。这一步就是把流程图上的连线全部用代码描述出来。
**第四步,编译图。**调用 compile() 方法,完成图的组装与结构校验,检查有没有孤立节点、连线是否合法,输出一个可以调用执行的图对象。编译不会运行业务逻辑,只是把图结构准备就绪。
**第五步,执行图。**调用 graph.invoke(),传入初始化的包裹 state,图就会从 START 开始,按照我们配置好的节点、边,自动依次调用各个节点绑定的函数,走完整个配送流程,直到走到 END,流程终止。
重点总结: START 和 END 只是流程标记,代表流程的入口和出口,不是业务节点,没有业务逻辑,不需要开发者定义函数。所有真正要干活的业务步骤,都必须自己写函数,再通过add_node把函数注册为图里面的节点。
三、代码编写
步骤1:定义State,设置快递的"包裹信息"
定义图时要做的第一件事是定义图的状态。状态将是图中所有节点和边的输入,可以是 TypedDict 或 Pydantic 模型(Pydantic 的性能不如 TypedDict)。如下所示:
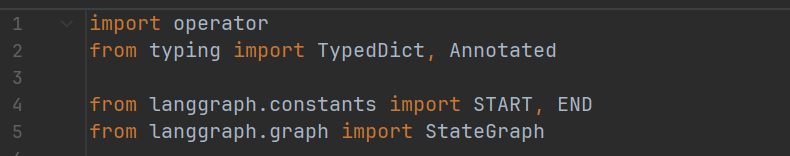 首先看导入部分。第一行 import operator,导入 Python 内置 operator 模块,这里主要使用operator.add 用来告诉 LangGraph 使用 operator.add 的字段做追加合并,而不是直接覆盖。
第二行 from typing import TypedDict, Annotated,TypedDict 用来定义带类型注解的字典结构,也就是我们的状态;Annotated 是给字段附加额外元信息,在这里附加合并规则。后面两行导入 LangGraph 组件,START、END 是图内置的起点、结束标记;StateGraph 是构建状态图的核心类。
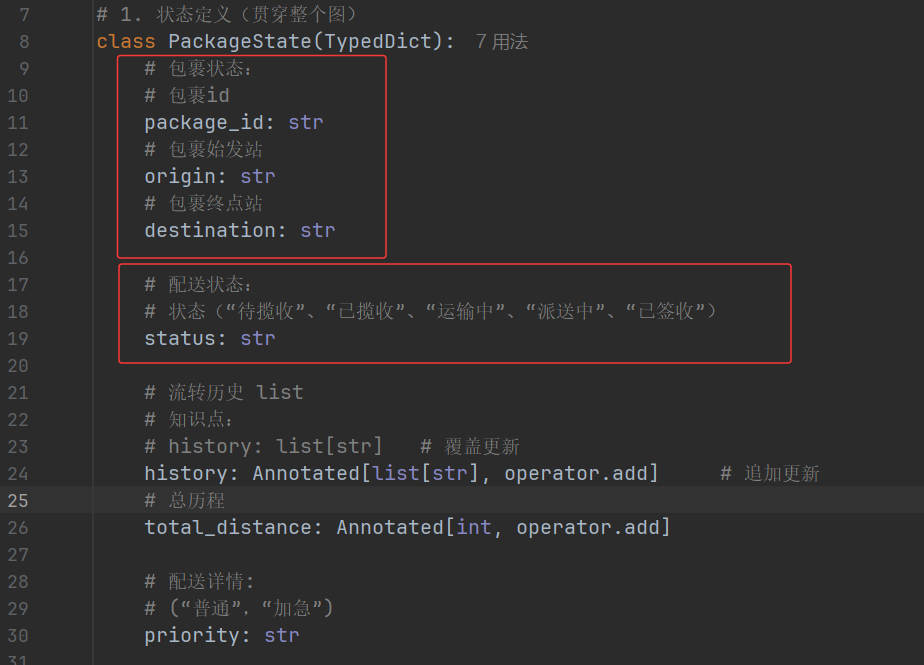 **接下来定义 PackageState(TypedDict),这个类就是整张图的状态模板,图运行全程,所有节点函数拿到的 state 都遵循这个结构。**所有节点都可以读取 state 里面的字段,节点返回的更新字典会和全局 state 做合并。
package_id、origin、destination 这三个普通字符串字段,对应包裹编号、始发站点、目的站点。这类普通字段,节点返回更新字典时会直接覆盖原值。比如节点返回 {"package_id":"PKG002"},就直接把原来的 package_id 替换掉。
status 字段是字符串,用来记录包裹当前配送状态,可选值为待揽收、已揽收、运输中、派送中、已签收。同样属于覆盖更新,节点返回新 status,直接替换旧的 status。
然后是 history 字段,这里做了关键处理。如果直接写 history: liststr,节点返回新列表的时候 LangGraph 会直接把旧的 history 整个覆盖掉,旧流转记录直接丢失。而使用 Annotatedlist\[str, operator.add],就是给这个字段指定合并策略:当多个节点返回新的列表片段,执行列表相加,也就是追加。比如节点返回 {"history":"在西安揽收"},不会覆盖旧列表,而是把新字符串追加到原有列表后面,完整保存全部流转日志。
total_distance: Annotatedint, operator.add 是整型字段,同样附加 operator.add。它的合并行为是数值相加。节点返回 {"total_distance":300},不会直接把总里程设置成 300,而是在原来 total_distance 数值基础上做加法,累加里程。
最后 priority 字符串字段,标记包裹是普通或者加急,用于后续分拣中心做条件分支判断,同样是覆盖更新。
这里重点区分两种更新行为。普通字段默认是覆盖更新,新值直接替换旧值。被 Annotated 加上 operator.add 修饰的字段会执行追加、累加合并,适合日志列表、累计数值这类场景,不需要我们在节点函数内部手动去拼接、累加,LangGraph 底层自动完成合并。
步骤2:定义节点 Nodes,创建配送站点
接着我们可以定义各个配送站点 (节点)。在 LangGraph 中,节点就是一个 Python函数 (同步或
异步)。注意
- 节点接收状态作为参数。
- 节点不需要返回整个状态模式,只需一个更新。
我们一共有 5 个节点,也就是 5 个函数,如下所示:
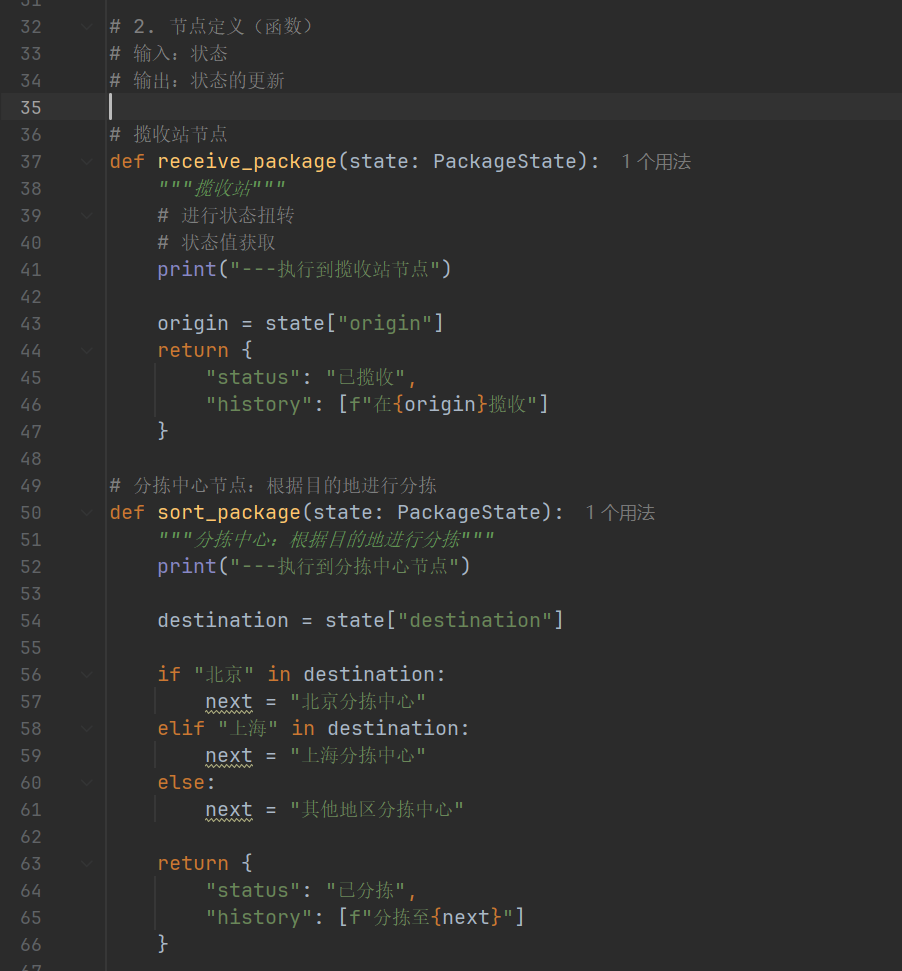 首先看节点函数通用规则。LangGraph 里面每一个业务节点本质就是普通 Python 函数。函数的入参是 state: PackageState,代表当前整张图最新的状态对象,我们可以从 state 里面读取包裹的全部信息。**函数不需要返回完整的全部 state,只需要返回发生变更的字段字典。**LangGraph 会自动把返回的更新字典和全局 state 做合并。
第一个函数 receive_package,对应流程图里的揽收站节点。 函数内部第一处是打印语句 print("---执行到揽收站节点"),这是调试用的输出,可以直观看到当前走到了哪一个节点。origin = state"origin",从传入的 state 字典取出始发站点,拿到包裹从哪里发出这个业务数据。
然后 return 返回更新字典。"status": "已揽收",status 是普通覆盖更新字段,会直接把全局 state 的 status 修改为 "已揽收"。"history": f"在{origin}揽收",history 字段之前定义过Annotatedlist\[str, operator.add],不会直接覆盖旧列表,而是把这个新的字符串元素追加到原来 history 列表末尾,实现流转日志累加。
**第二个函数 sort_package,对应流程图的分拣中心节点。**同样先打印日志,方便调试观察节点执行。 destination = state"destination"从 state 读取包裹的目的地。
接下来做业务判断,判断目的地字符串里面包含什么城市关键词。如果目的地包含北京,就赋值next = "北京分拣中心"; 如果包含上海,next = "上海分拣中心"; 其余所有情况走到 else 分支,next = "其他地区分拣中心"。这里只是在函数内部算出了下一个分拣中心的名字,注意:这个函数本身不能直接控制流程跳转。函数只负责修改 state 数据,真正决定下一个走哪个节点,是后面代码里的条件边逻辑。
return 返回更新字典。 "status": "已分拣",把全局状态的配送状态更新为已分拣。"history": f"分拣至{next}",把本次分拣去向记录为一条新日志,依靠 operator.add 自动追加到 history 列表,保存完整流转记录。
补充一个关键点:这两个节点函数只负责读取 state、产出状态变更。节点函数不会写任何跳转代码,流程走向由 add_edge、add_conditional_edges 在外部定义,业务逻辑和流程控制相互分离开。
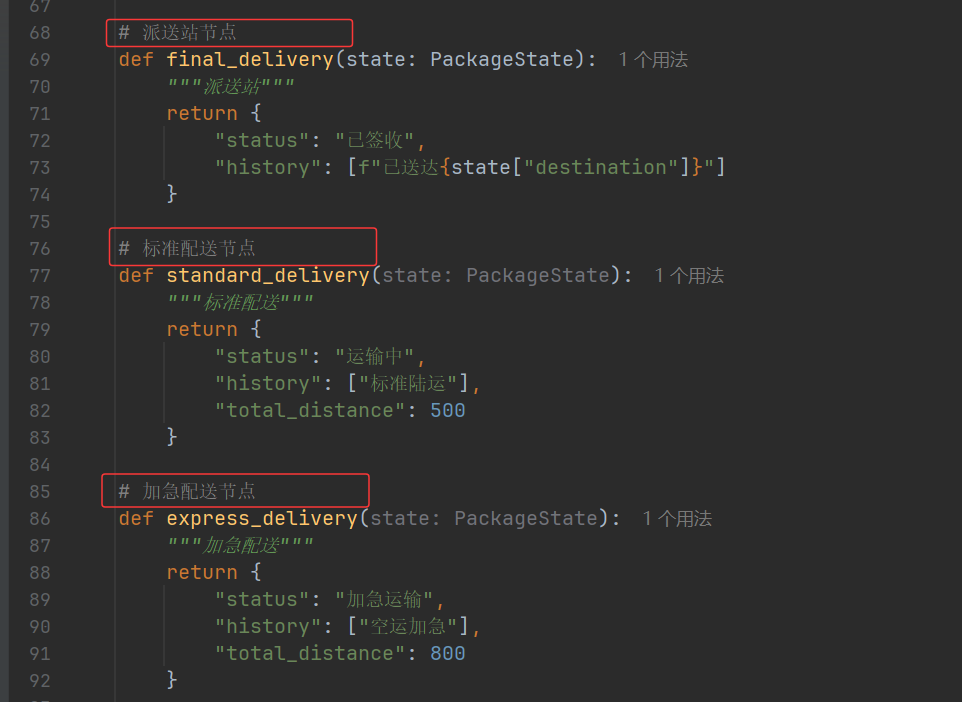 这是剩下的 3 个业务节点函数,同样遵循 LangGraph 节点函数统一规则:接收当前 state 作为入参,只返回需要更新的字段字典,框架自动合并更新全局状态。
**第一个 final_delivery,对应流程图的派送站节点,代表包裹最后一步派送签收。**函数从 state 读取 destination 拿到包裹目的地。返回字典中 status 被覆盖更新为 "已签收",代表整个配送业务完成。history 传入一条新日志 "已送达{state\['destination'}"],依靠 operator.add 将这条记录追加到历史列表末尾,记录完成派送这件事。这个节点执行完之后,流程就会走向 END 结束。
**第二个 standard_delivery 标准配送节点,对应普通优先级包裹走陆运的业务。**status 覆盖更新为 "运输中",标记包裹正在运输。history增加一条 "标准陆运",记录本次是陆运运输。 total_distance 返回数值 500。这个字段定义的时候标注了 Annotatedint, operator.add,不会直接把总里程改成 500,而是在原有 total_distance 数值基础上加 500。
**第三个 express_delivery 加急配送节点,对应加急包裹走空运的业务。**status覆盖更新为 "加急运输",区分普通运输状态。history追加 "空运加急" 日志,标记本次是空运加急。total_distance 返回数值 800,同样触发 operator.add,在原有里程基础上累加 800。
这里重点区分两个里程数值的含义。500 和 800 不是设置最终总里程,而是本次运输环节新增的里程,LangGraph 自动做加法。同时要再次强调,**这两个配送函数本身不会自己做分支判断。到底执行标准配送还是加急配送,不由函数内部 if 判断决定,而是后面代码写条件边,读取 state 里面 priority 字段动态选择调用哪一个函数。**函数只负责业务逻辑,流程路由交给边来控制,实现业务逻辑和流程控制解耦。
至此 5 个业务节点函数全部讲完:receive_package 揽收站、sort_package 分拣中心、standard_delivery 标准配送、express_delivery 加急配送、final_delivery 派送站。START 与 END是框架内置标记,不需要编写函数。
步骤3:定义 StateGraph图,成立快递公司
StateGraph 是一个有状态图计算框架,它基于有向图(DirectedGraph)模型构建,专门设计用于处理多步骤、有状态的工作流程。
StateGraph 用来将复杂的工作流程可视化、模块化,让开发者能够像设计快递配送网络一样设计软件系统。通过这种思维方式,即使是复杂的多步骤AI应用也变得清晰可控。我们需要使用 langgraph.graph.state.StateGraph 来定义。StateGraph 仅是一个构建器类,可以使用 State 来构建。如下所示:
 这是编码流程的第三步,实例化 StateGraph 对象,类比于创建一家快递公司。
StateGraph 是 LangGraph 提供的状态图核心类,实例化的时候必须传入我们前面定义好的状态类PackageState。传入 PackageState 代表这整张图运行的时候全程都会使用这一套状态结构,所有节点读取、修改的 state,都必须遵守 PackageState 里面定义的字段、类型、合并规则。
变量名 delivery 就是我们这个图实例,后续所有注册节点、添加边的操作,都要操作这个 delivery 对象。
这里泛型部分 Any, None, Any, Any 是类型提示,属于 IDE 静态类型注解,不影响程序运行。
执行完这一行代码,只是完成了图对象的初始化。此时图里面是空的,还没有任何节点,也没有任何连线。就好比快递公司只是注册完成,还没有把揽收站、分拣中心这些站点入驻进来,下一步就要调用 add_node 把 5 个业务函数注册成为图里面的节点。
步骤4:添加节点 Nodes,建设配送站点
接下来,我们需要将各节点,组织进图中,即添加节点到 StateGraph 中。我们使用 add_node() 将新节点添加到 StateGraph。
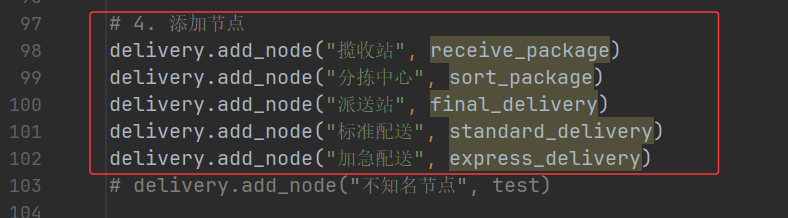 这一步是向已经实例化完成的 delivery 图对象中注册业务节点,类比给快递公司入驻各个业务站点。
add_node() 是 StateGraph 提供的方法,它接收两个参数。第一个参数是节点名字,是字符串 ,这是图流程内部识别节点的唯一标识,后面配置边、配置跳转逻辑都要用这个字符串名字。第二个参数传入我们之前写好的业务函数对象,我们只需要把函数本身交给图,图运行流转到这个节点的时候,会自动调用该函数。
第一行 delivery.add_node("揽收站", receive_package) 把字符串名字 "揽收站" 和函数 receive_package 绑定。当流程走到 "揽收站" 这个节点,框架自动调用 receive_package(state),传入当前全局状态。 剩下四行逻辑完全一致,分别注册分拣中心、派送站、标准配送、加急配送,正好对应我们 5 个业务函数。
执行完这 5 行 add_node 之后,图里面已经拥有全部业务节点,但是节点和节点之间没有任何连线,不知道执行顺序。就好比所有站点都建好,但公路还没有修,包裹不知道该从哪个站点去往哪个站点。下一步就要添加边 add_edge 以及条件边,定义节点之间流转的路线。
步骤5:添加边 Edges,规划运输路线
各节点(站点)准备好后,则需要为快递运输规划路线。
实际上,这就是为图定义边。边有几种关键类型:
- 普通边 / 固定边(Normal Edges):直接从一个节点转到下一个节点。
- 条件边(Conditional Edges):调用函数来确定下一步要转到哪个节点。
例如,设置最简单运输路线:快递由揽收站接收,下一站固定为分拣中心,最后到派送中进行派送。这就是固定边。如下图:
再例如,我们可以根据以下条件,判断快递如何运输:
- 包裹是加急件→ 走空运线路
- 包裹不是加急件 → 走标准线路 这就是条件边。
这就是条件边。
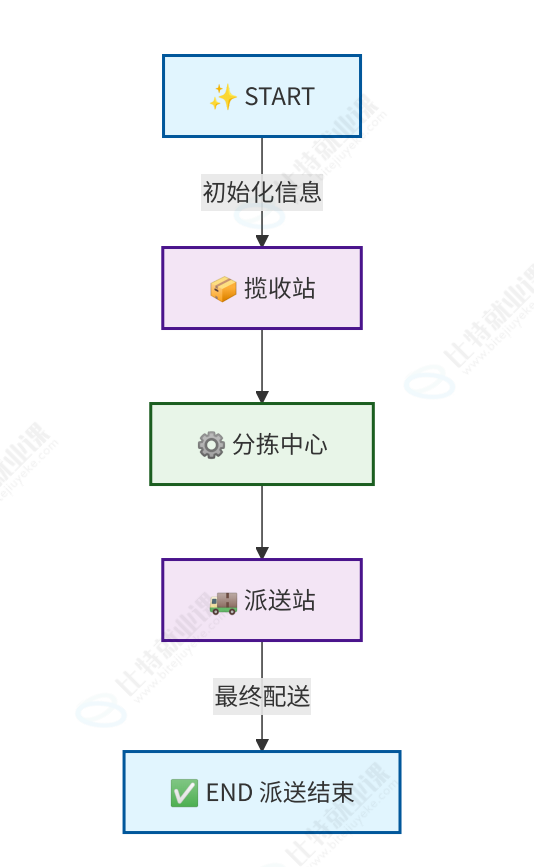
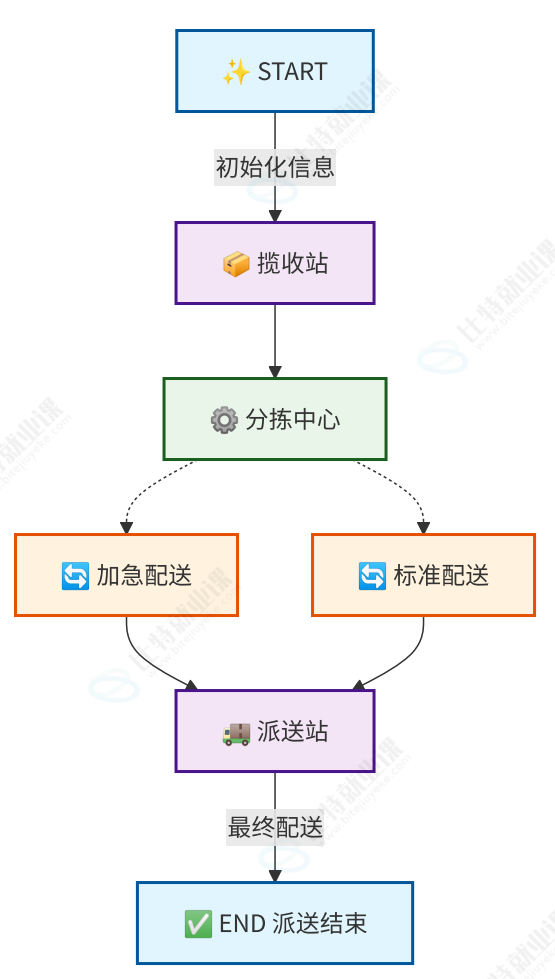
要说明的是,在 LangGraph 中:
- START 节点:是一个特殊节点,表示将用户输入发送到图形的节点。引用此节点的主要目的是确定应该首先调用哪些节点。
- END 节点:是一个表示终端节点的特殊节点。当想要指示哪些边在完成后没有后续动作时,将引用此节点。
- 条件入口点(Conditional Entry Point):调用一个函数来确定在用户输入到达时首先调用哪个节点。
下面我们来看 LangGraph 提供的添加固定边和条件边的两个函数:
1. 使用 add_edge() 向图中添加从开始节点(或起始节点列表)到结束节点的固定边。 add_edge() 方法常用参数说明:
普通固定边 add_edge,就是写死的单向公路,A 节点执行完毕,一定走到 B 节点,没有别的选择。
2. 使用 add_conditional_edges() 向图中添加从起始节点到任意数量的目标节点的条件边。 add_conditional_edges() 方法常用参数说明:
条件边 add_conditional_edges,相当于岔路口,节点执行完之后,会执行 path 传入的判断函数,读取当前 state 状态,动态决定下一站去哪一个节点。
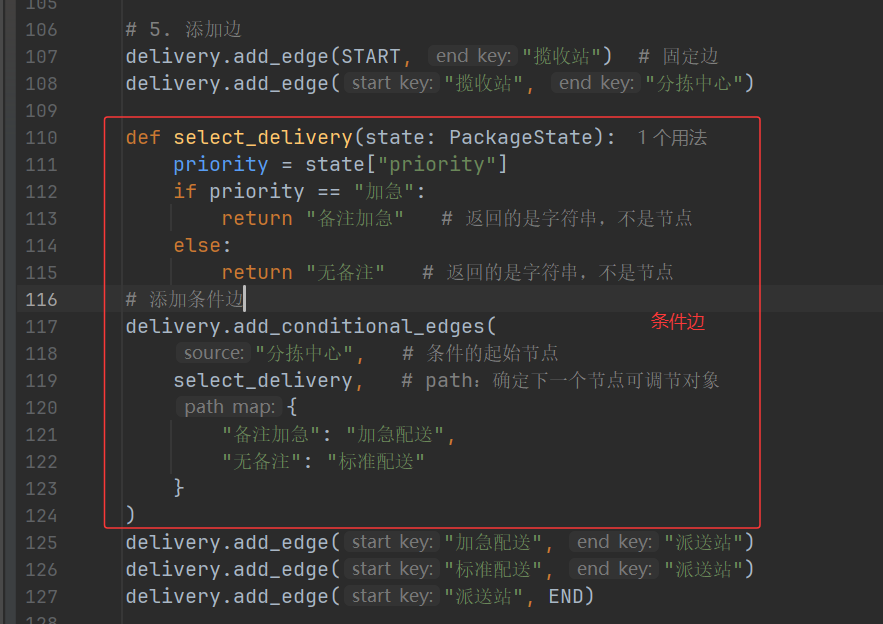 现在调用 add_edge、add_conditional_edges 来修建公路,定义节点之间流转的运输路线。
delivery.add_edge(START, "揽收站"),这是一条固定边。START 是 LangGraph 内置的特殊入口节点,代表整个图的起点,这条语句含义:图一启动,第一个执行的业务节点就是揽收站。
delivery.add_edge("揽收站", "分拣中心"),普通固定边。揽收站业务逻辑执行完毕之后,没有任何分支判断,一定会流转到分拣中心节点。
接下来定义 select_delivery 路由函数,专门用来做分支判断。这个函数接收全局状态 state,只能读取 state 里面的数据,不允许修改 state,只负责做路由判断。读取 state 当中的 priority 优先级字段,如果是加急,返回标记字符串"备注加急",否则返回标记字符串"无备注"。注意返回的这两个字符串并不是节点名称,只是中间标记,需要交给 path_map 做映射。
delivery.add_conditional_edges() 用来添加条件边,也就是分岔路口。
- source="分拣中心":代表当分拣中心节点全部执行完成之后,就触发这个条件逻辑,执行 select_delivery 路由函数。
- 第二个参数传入 select_delivery 函数对象,函数后面不能写括号,交给框架在合适时机自动调用。
- path_map 字典完成标记字符串向真实节点名称的映射: 路由函数返回"备注加急",就跳转到"加急配送"节点; 路由函数返回"无备注",就跳转到"标准配送"节点。
delivery.add_edge("加急配送", "派送站")固定边,加急配送节点执行完成,流转到派送站。 delivery.add_edge("标准配送", "派送站")固定边,标准配送节点执行完成,同样流转到派送站。
两条不同业务分支,在这里汇合,统一流入派送站节点。
delivery.add_edge("派送站", END),派送站执行结束,流转到内置END节点。END是图的终止标记,走到这里整个工作流直接结束,返回最终的 state 状态。
步骤6:StateGraph图编译,从公司创建到运行
在步骤2中,我们仅是构建出 StateGraph,还无法直接用于执行。LangGraph要求:必须先编译
图,然后才能使用它。编译提供了对图结构的一些基本检查,这会验证:
- 从START到所有节点的可达性
- 从所有节点到END的可达性
- 没有孤立节点或死循环
使用 compile() 方法即可编译图。该方法将 StateGraph 编译为 CompiledStateGraph 对
象。编译后的图实现了 Runnable 接口,可以异步调用、流式传输、批处理和运行。
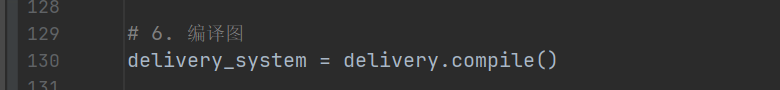 调用 .compile() 就是对这份图纸做编译,做校验、组装,生成一个可以真正执行的可运行图实例,赋值给变量 delivery_system。
compile() 编译方法内部会做语法校验:检查引用的节点是否全部存在、边的起点终点是否合法、有没有出现循环错误、START 和 END 链路是否连通。如果配置写错,编译阶段就直接抛出异常,不会等到运行时报错。把节点、边、条件路由函数全部组装成内部可执行的数据结构。
delivery_system 就是编译完成之后得到的可运行图实例,后续真正调用执行工作流,就使用这个变量。
步骤6:测试
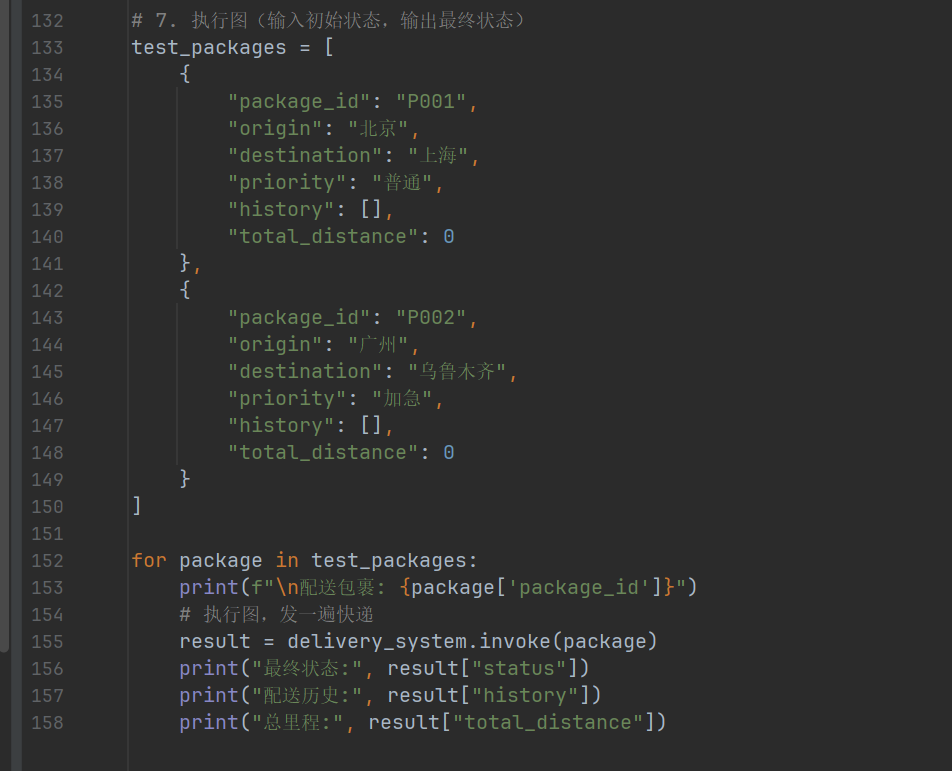 前面我们已经完成图的编译,得到可运行对象 delivery_system。编译后的图可以反复多次运行,每次运行只需要传入一份初始状态,就会完整走完整套业务流程。
test_packages 是测试用的包裹列表,里面准备了两份包裹的初始状态字典。每一个字典就是传给 LangGraph 的初始 PackageState。P001 是普通包裹,P002 是加急包裹。字段全部初始化,history 为空,total_distance 初始值等于 0。工作流启动之后,各个节点内部会读取并且修改这份状态。
接下来写 for 循环,遍历 test_packages 列表依次处理每一个包裹。不需要再次调用 compile,编译好的图实例支持重复执行。
print(f"\n配送包裹: {package'package_id'}") 做控制台打印输出,用来区分两次不同包裹的运行日志,方便我们看控制台输出,分辨哪一段输出对应哪一个包裹。
**result = delivery_system.invoke(package) 是整段代码最核心的一行。**invoke 是同步执行方法,把包裹初始状态传进去。程序就会从 START 起点,顺着我们定义好的节点、普通边、条件边一步步流转,依次执行揽收站、分拣中心等各个业务节点。节点内部会修改 state 当中的各个字段。当流转走到 END 节点之后,整个图停止运行,把更新完成的完整状态返回,赋值给 result。
后面三行 print 就是打印图执行完成之后返回的最终状态。 result"status" 拿到包裹最终业务状态,由各个业务节点负责更新。result"history" 拿到配送历史数组,每经过一个站点,节点就会往数组追加记录,可以看到包裹完整走过哪些业务节点。 result"total_distance" 打印全程累计的配送里程。
运行结果:
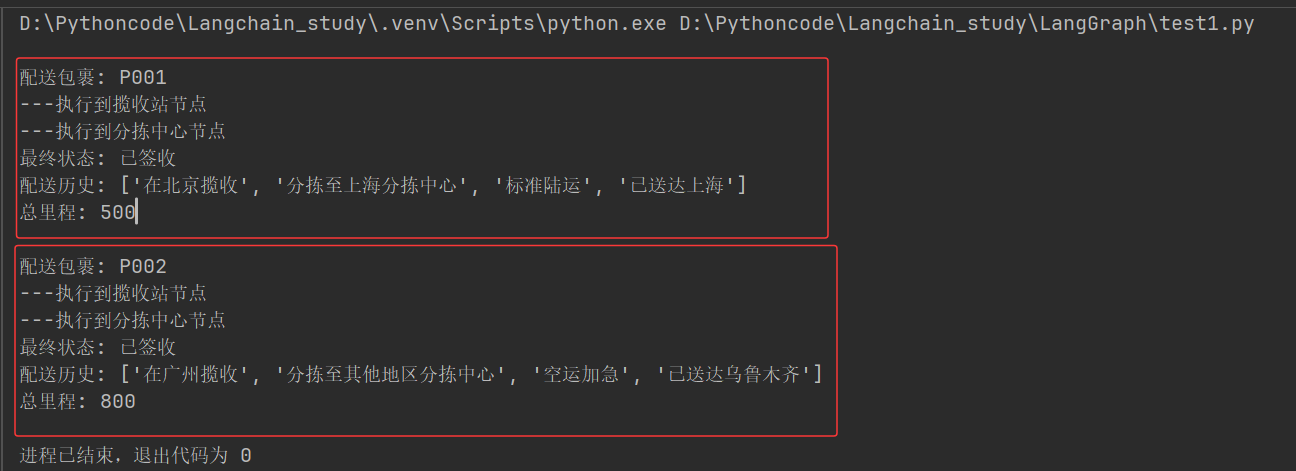 程序运行后会先后跑两次图。
处理 P001 普通包裹,会走普通配送分支,链路是 START → 揽收站 → 分拣中心 → 标准配送 → 派送站 → END,控制台打印出这个包裹的最终状态、站点历史、总里程。
处理 P002 加急包裹,会走加急配送分支,链路是 START → 揽收站 → 分拣中心 → 加急配送 → 派送站 → END,控制台打印加急包裹对应的一套输出。
到此,我们已经构建出了一个图式的智能快递配送系统,来理解 LangGraph 图的基本能力与用法!核心概念回顾:
- State=包裹信息卡(记录所有状态)
- Nodes=配送站点(执行具体操作)
- Edges=运输路线(控制流转顺序)
- Reducers=信息更新规则(如何记录变更)
四、相关问题
Q1:这个快递案例没有接入 ChatGPT、DeepSeek 这类大模型,为什么 LangGraph 图还能完整跑通整个快递派送流程?
LangGraph 本质是通用状态工作流编排框架 ,它不是大模型的专属附属工具。它的核心职责是管理状态、定义节点流转逻辑、处理分支条件、控制执行流程。节点里面的业务逻辑可以是任意 Python 代码,不一定非得调用大模型。这个案例里每个节点函数写的都是普通 Python 逻辑,做状态字段修改、追加历史记录、累加里程,不需要 LLM 参与,整张图照样可以正常执行。
Q2:那 LangGraph 本来不都是要和大模型结合使用吗?
这是大家很常见的误解。LangGraph 有两大使用场景。
- 第一种,也是大家见得最多的场景:AI Agent 场景 ,节点内部调用大模型,让 LLM 做思考、做工具选择、做决策,用来实现智能代理,这是 LangGraph 出圈的用法。
- 第二种,通用业务工作流场景:节点只是普通业务函数,不调用大模型,就像我们这个快递案例,用来实现带状态、带分支的业务流水线。
大模型只是节点里面可以选用的其中一种业务组件,不是 LangGraph 运行的强制必需品。
Q3:那这个不带大模型的案例,学它意义是什么?
这个案例是用来吃透 LangGraph 底层基础能力。我们在这里学会了 State 状态定义、add_node 注册节点、普通边、条件分支边、compile 编译、invoke 执行这些底层核心机制。搞懂这套基础之后,后续只需要把其中某一个节点内部的普通 Python 函数替换成调用 DeepSeek/ChatGPT 的代码,就可以直接变成 AI Agent。如果直接一上来就学带大模型的 Agent,会把「图框架本身的流程逻辑」和「大模型的输出」混在一起出问题,排错的时候分不清 bug 是来自大模型,还是图流转逻辑写错。先用纯 Python 业务跑通案例,可以把 LangGraph 自身的机制先学明白。
Q4:什么时候才需要把大模型引入 LangGraph?
**当业务流程里面,需要模型自主做决策、理解自然语言、选择工具、不确定下一步该走哪个分支的时候才需要在节点内部调用 LLM。**像快递这个案例,分拣判断加急/普通,判断规则写死在路由函数里,规则固定,不需要 AI 理解;如果改造一下:把 priority 优先级不再手动传入,交给大模型读取包裹备注文本,让 LLM 自己判断该走加急还是标准配送,这个时候就需要在节点内部引入大模型。