无 Function Call 的结构化通用 Agent
项目介绍
概念解释
无 Function Call 的 Agent,就是不用平台原生 Function Call,改用提示词约定 + 自己写代码,手动实现"模型输出调用请求 → 执行工具 → 回填结果"这整套机制,换来跨模型的通用、自由、可控、便宜,代价是可靠性低、易翻车。
项目背景
现阶段大部分智能Agent依赖大模型原生Function Call 能力实现工具调用,但部分轻量化、开源大模型不支持原生函数调用 功能,存在适配局限性。同时,原生Function Call调用模式耦合度高、定制化难度大,难以适配自定义轻量化工具的快速拓展场景。
基于该痛点,本项目打造纯Prompt工程实现的结构化通用Agent ,放弃模型原生函数调用接口,通过人工定义交互协议与格式约束 ,实现工具调用、多轮迭代推理能力,完美适配无Function Call能力的大模型,具备低耦合、高可定制、易拓展的核心优势。
核心功能
本项目是独立可复用的Agent工具调度模块,核心实现轻量化智能体的思考、决策、工具执行闭环,具体功能如下:
- 结构化指令生成:通过自定义 Prompt 约束模型输出固定格式的思考、动作、入参指令,替代原生函数调用
- 多类型工具适配:原生支持数学计算器、系统时间查询、本地文档检索三大自定义工具
- 文本指令解析:通过代码解析模型结构化输出,精准提取思考内容、工具标识、调用参数
- 工具路由调度:自动匹配对应工具函数,完成指令执行与结果返回
- ReAct多轮闭环:支持思考-行动-复盘迭代循环,直至用户问题完全解决
- 异常兼容处理:适配无效工具、格式异常、无需工具问答等全场景,规避程序报错与死循环
项目核心价值
打破大模型原生能力限制,仅通过Prompt工程与轻量化Python代码,实现工业级Agent工具调度 能力,分层架构设计降低模块耦合度 ,支持快速新增自定义工具、适配各类无函数调用能力的大模型,可复用性与拓展性极强。
完整代码实现
整体架构设计
项目采用三层分层模块化架构,自上而下拆分职责,各层级独立解耦、各司其职,架构清晰、便于迭代维护。
- 上层:大模型决策层:核心负责语义理解、问题推理、按照约定格式生成结构化指令,仅承担思考决策能力,不参与具体工具执行
- 中层:解析调度层:项目核心枢纽,包含文本格式解析器、工具路由调度器,负责拆解模型指令、校验合法性、分发工具执行任务
- 底层:工具执行层:封装各类自定义功能工具,提供标准化的入参、出参能力,支撑上层调度调用
核心协议设计:为实现无Function Call工具调用,项目自定义一套通用结构化交互协议 ,统一模型输出标准与工具调用规则,是整个项目的核心基石。
解析模块
通过文本切割、正则匹配的核心原理,解析模型输出的结构化文本 ,精准拆分 Thought、Action、Action Input三段内容,同时做数据清洗 (去除空格、换行)与合法性校验。若解析失败,判定为无需工具调用,保证程序稳定性。
python
def parser(input):
    lines = input.splitlines()

    thought = ""
    action = ""
    action_input = ""

    for line in lines:
        if line.find("Action:") != -1:
            action = line.split("Action:", 1)[1]
        elif line.find("Thought:") != -1:
            thought = line.split("Thought:", 1)[1]
        elif line.find("Action Input:") != -1:
            action_input = line.split("Action Input:", 1)[1]

    return {
        "thought": thought.strip(),
        "action": action.strip(),
        "action_input": action_input.strip()
    }
工具模块
独立封装 三大工具函数,统一入参出参规范 ,增加异常容错 机制,同时通过字典建立工具标识与函数的映射关系 ,便于中层调度调用。
- calculator 计算器工具:接收数学表达式字符串,解析运算并返回结果,捕获运算异常,返回错误提示
- time_query 时间查询工具:无需入参,读取系统当前时间并格式化输出标准时间文本
- doc_search 文档检索工具:基于内置模拟文档数据,根据关键词模糊匹配,返回检索结果或无匹配提示
python
import time
from langchain_core import documents

# 计算器工具
def calculator(input):
    # input: 字符串数学表达式
    try:
        # Python 的内置函数,作用是把字符串当作 Python 代码来执行
        # 把传入的字符串解析并求值,返回结果。
        res = eval(input)
        #  f-string 格式化字符串, 把变量塞进字符串
        return f"计算结果:{res}"
    except Exception as e:
        print("格式有误")

# 时间查询工具
def time_query(input):
    # 把时间元组(struct_time)格式化成字符串
    return time.strftime("%Y-%m-%d %H:%M:%S", time.localtime())

documents = {
    "项目介绍": "这是一个无FunctionCall的结构化Agent",
    "工具列表": "计算器、时间查询、文档检索",
    "使用规则": "必须按指定格式输出调用指令"
}

# 本地文档检索工具
def doc_search(input):
    if input in documents:
        return documents[input]
    else:
        return "未找到相关文档"

# 工具映射表
TOOL_MAP = {
    "calculator": calculator,
    "time_query": time_query,
    "doc_search": doc_search
}
调度模块
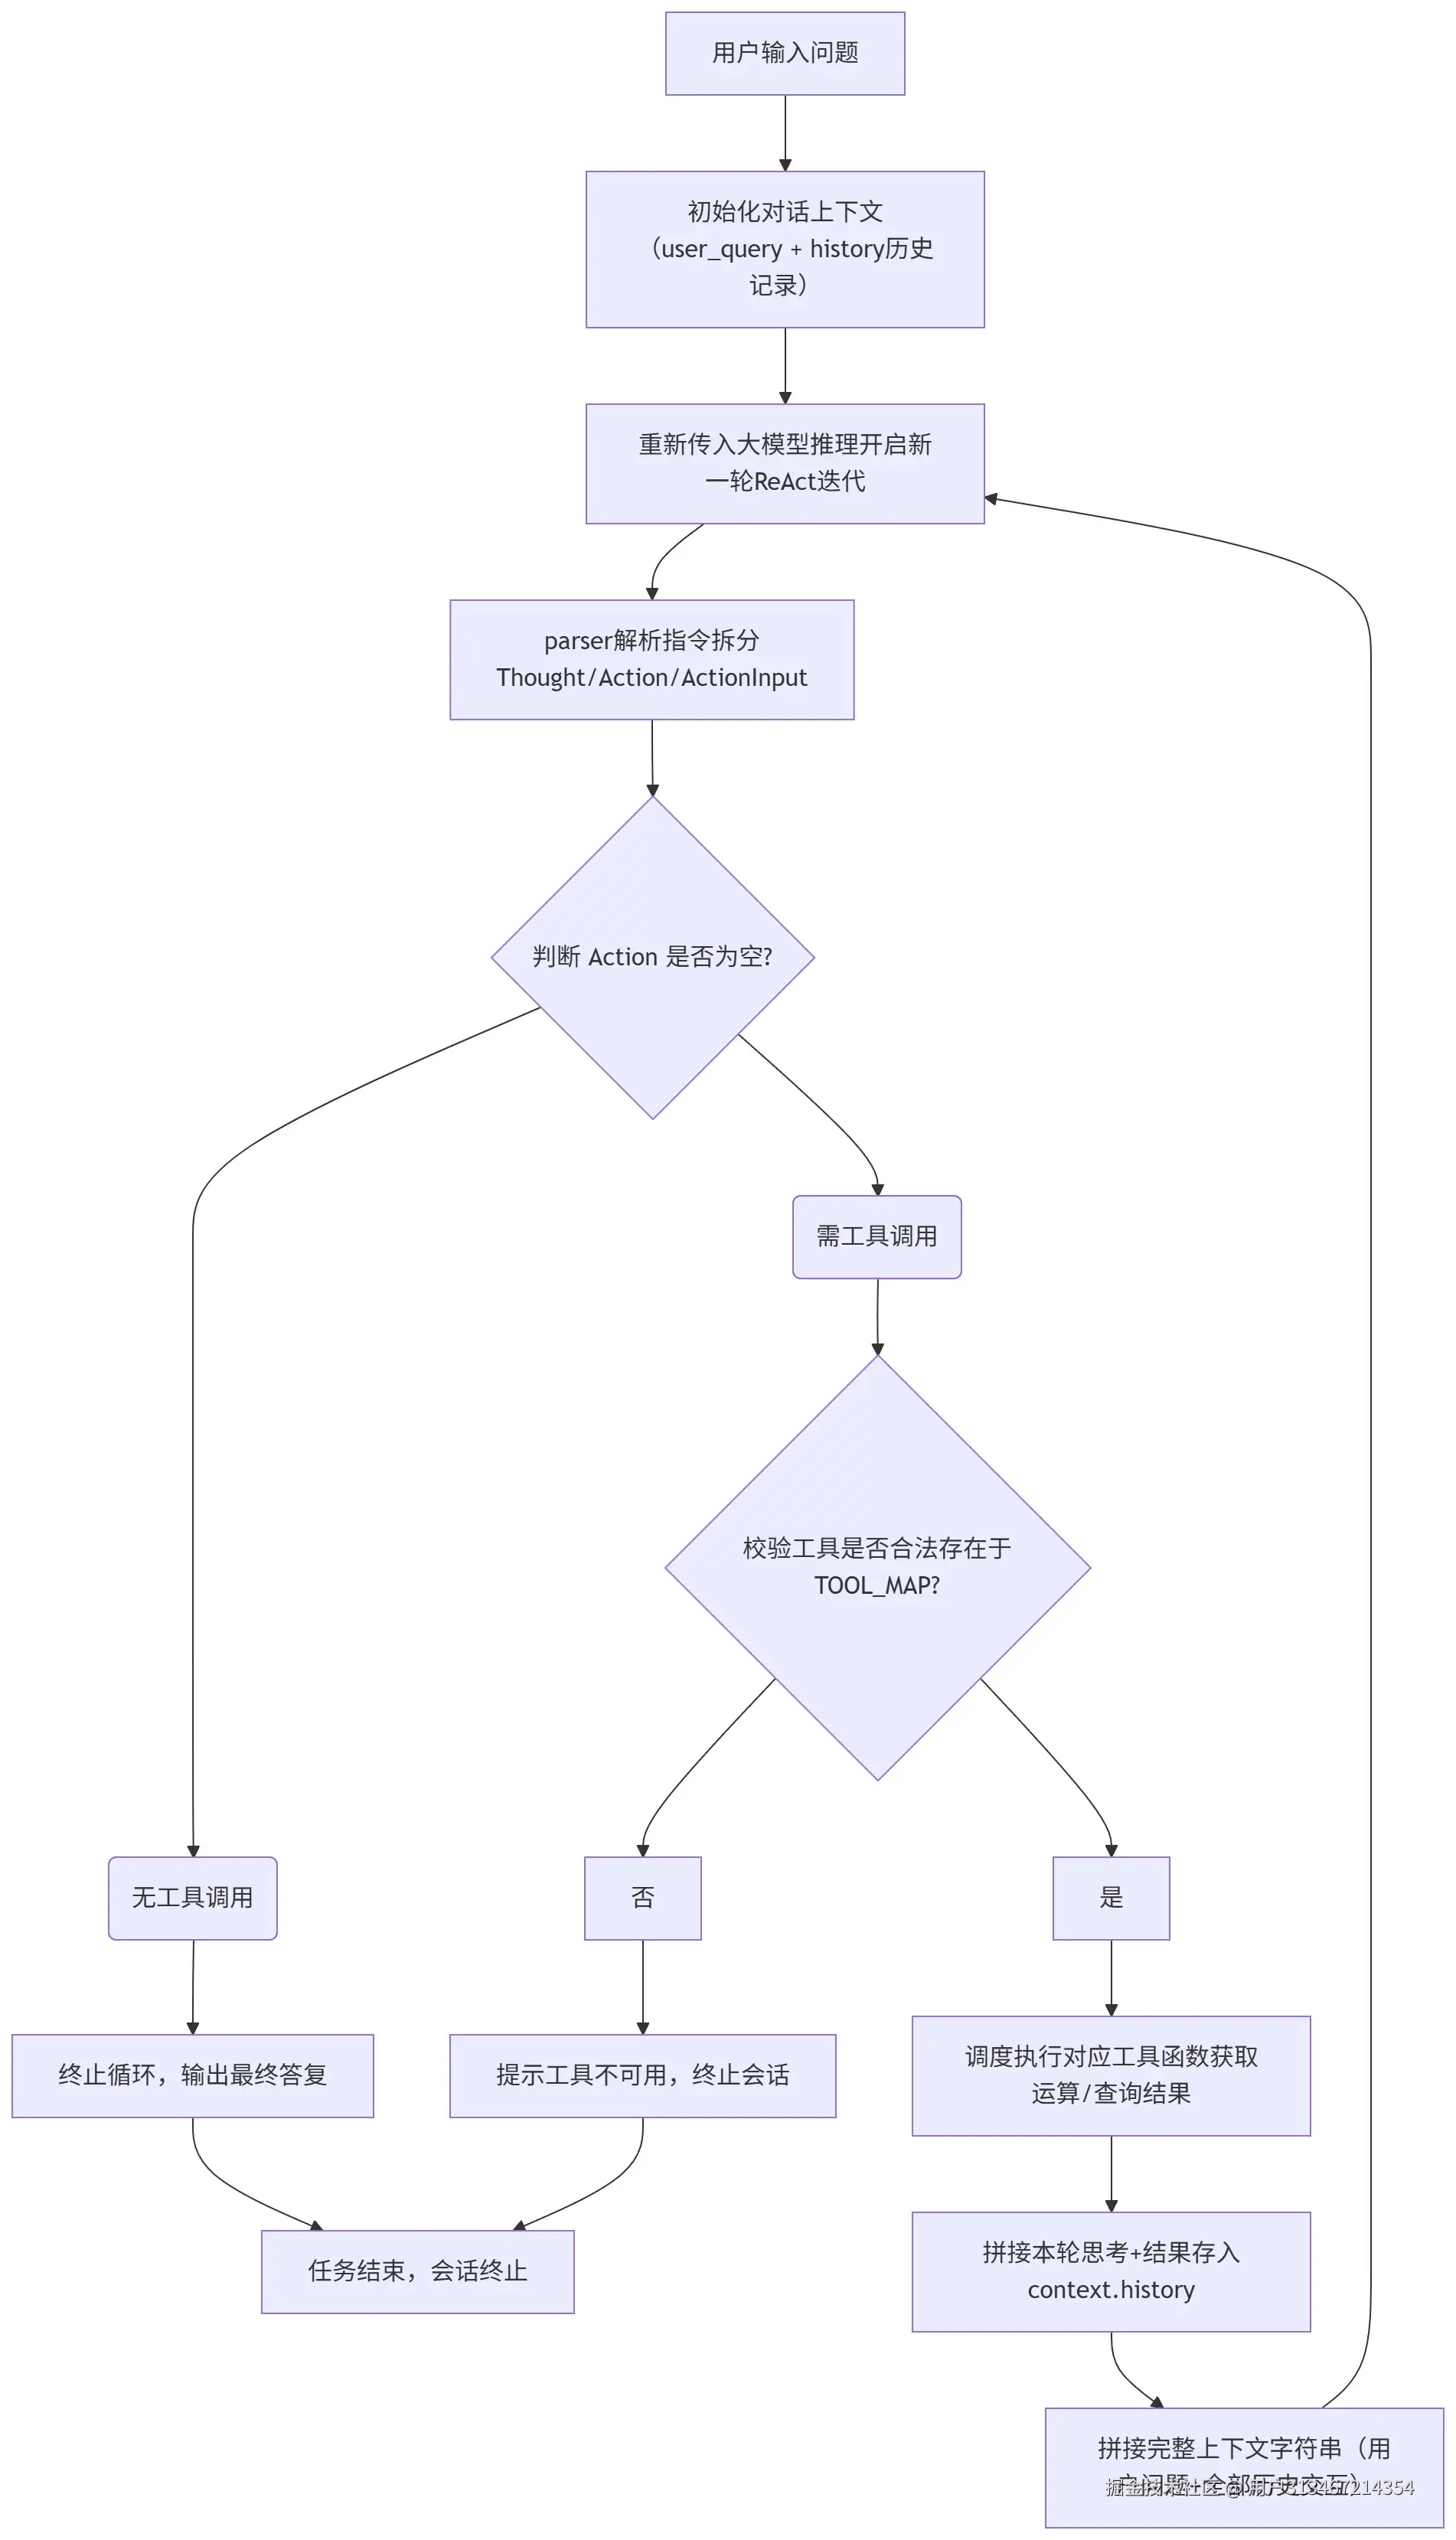
ReAct 多轮迭代设计:基于 Agent 经典 ReAct 框架( Reason 推理 + Act 行动),设计循环迭代机制,实现问题闭环解决。
核心逻辑为:模型思考决策→工具执行行动→结果复盘回传→二次推理迭代,直至问题无需进一步处理,终止流程输出最终答案。
-
用户提问
-
LLM 推理:根据输入产出规范的
Thought / Action / Action Input文本 -
进入循环
-
解析器解析 LLM 输出,得到含
thought / action / action_input的 dict -
若action为空,退出循环(视为任务完成)
-
检索工具表,工具不存在 → 退出循环
-
工具存在,则匹配到对应的工具函数,传入 action_input 参数并执行
-
获取执行结果
-
将本轮thought和本轮工具输出追加进历史信息
-
拼接用户问题和历史信息,再次输入给 LLM 推理
-
LLM 输出新的thought/action → 回到步骤1,继续循环
-
-
循环结束,会话终止
代码实现
作为项目入口,实现单轮调用链路与多轮ReAct闭环能力,核心包含三大逻辑:
- 模型推理模拟:根据用户问题语义,匹配对应工具场景,输出标准结构化指令
- 工具路由调度:调用解析器拆分指令,校验工具合法性,匹配对应工具执行并返回结果
- 多轮循环闭环:定义对话上下文存储用户问题、历史思考与执行结果,循环迭代推理,以Action为空作为终止条件,自动结束任务
python
# 对话上下文
context = {
    "user_query":"",
    "history":[]
}
# 思考:义接收用户问题的入口
# 抽取成变量,方便切换测试
user_question = "现在是什么时间"
llm_output = invoke(user_question)
context['user_query'] = user_question

count = 0
while count < 2:
    count += 1
    # 增加全局异常捕获,防止崩溃
    try:
        # 调用解析器,拆分出思考内容、工具标识、传入参数
        input_parser = parser(llm_output)

        # 当 action 为空时退出循环
        if input_parser['action'] == '':
            break

        res = ''
        # 检索工具映射表,校验当前工具是否合法可用
        if input_parser['action'] not in TOOL_MAP:
            print('当前工具不可用')
            break  # 跳出循环,结束Agent
        else:
            # 行动:匹配到对应工具函数,传入参数执行运算查询
            tool = TOOL_MAP[input_parser['action']]
            # 汇总思考过程与工具执行结果,统一对外输出
            output = tool(input_parser['action_input'])
            res += f"thought: {input_parser['thought']}\n output: {output}"

        context['history'].append(res)
        print('---')
        print(context)
        print('---')
        # 复盘
        # 拼接上下文:用户问题 + 历史结果
        context_str = f"用户问题:{context['user_query']},历史结果:{str(context['history'])}"
        llm_output =  invoke(context_str)
    except Exception as e:
        print(f"执行异常:{e}")
        break

# 结束提示,更清晰
print("\n任务结束,会话终止")
整体流程图
项目总结
项目成果
本项目成功落地零原生Function Call依赖的纯Prompt结构化智能Agent ,彻底摆脱大模型原生能力限制,通过人工定义结构化协议+Prompt约束 ,配合轻量化Python代码,完整实现「思考-解析-调度-执行-迭代」的智能体闭环。
项目原生支持数学计算、时间查询、本地文档检索三大工具,完美适配单轮问答、多轮ReAct迭代、无效工具请求、格式异常、程序报错 等全场景,具备完整、稳定 的智能决策与工具执行能力。
同时,项目采用分层模块化架构 ,实现了决策、解析、执行三层解耦,代码结构清晰、拓展性强,无需复杂第三方依赖,可快速移植、二次开发、新增自定义工具,适配各类轻量化大模型落地 场景。
核心优势
- 模型兼容性极强:不依赖任何大模型原生Function Call接口,适配所有无函数调用能力的轻量化、开源、端侧模型,解决小众模型无法部署Agent的痛点
- 低耦合高拓展:工具、解析、调度模块独立拆分,新增工具无需修改核心逻辑
- 稳定性高:完善的异常捕获、格式校验、终止机制,规避死循环与程序报错
- 轻量化低成本:纯Prompt+内置Python模块实现,无额外部署与资源成本
可优化拓展方向
- 拓展工具生态:新增天气查询、文件读写、接口请求等更多自定义工具
- 优化解析逻辑:增强正则匹配能力,适配模型不规则输出,提升容错率
- 接入真实大模型:替换模拟推理逻辑,对接真实大模型接口,实现端到端智能问答
- 增加参数校验:强化工具入参合法性校验,进一步提升程序稳定性
可展开的问题
高频
-
为什么不用原生 Function Call?它和你这套方案的本质区别是什么?
- 原生:模型侧结构化输出 + 平台侧自动执行,可靠性高但绑定模型。
- 你的:Prompt 约定 + 手写解析,跨模型但可靠性靠工程兜底。
- 要能说出「可靠性 vs 通用性」的权衡。
-
模型不按格式输出怎么办?
- 这是这套方案最大的痛点,必须能答:正则容错、重试机制、few-shot 约束、输出后校验、失败降级为直接回答。
-
ReAct 的循环怎么保证不死循环?
- 最大轮数、Action 为空终止、工具不存在终止、异常终止、重复 Action 检测。
-
parser为什么用split而不是正则?有什么坑?- 能说出多行、代码块、冒号变体、
Action Input包含Action子串等边界情况。
- 能说出多行、代码块、冒号变体、
-
eval的安全问题怎么解决?ast.literal_eval、白名单、沙箱、正则校验。
进阶
-
多轮对话里 history 越来越长,怎么控制上下文长度?
- 滑动窗口、摘要压缩、只保留最近 N 轮 observation。
-
工具执行失败时 Agent 应该怎么反应?
- 把错误信息作为 observation 回填,让模型决定重试还是换工具,而不是直接崩。
-
你怎么评估这个 Agent 的效果?
- 工具调用准确率、任务完成率、平均轮数、格式解析成功率、端到端延迟。
-
如果模型输出
Action: calculator但Action Input为空,你怎么处理?- 参数校验,回填「参数缺失」让模型重试。
-
这套方案和 LangChain 的 Agent 有什么区别?
- LangChain 也是 Prompt + parser + executor,你相当于手写了一个极简版;优势是可控、无依赖,劣势是生态和容错不如成熟框架。
加分项
-
怎么支持并行工具调用?
- 协议改成输出 JSON 数组,parser 解析多个 action,串行或并发执行后统一回填。
-
怎么让模型自己发现「该用哪个工具」?
- 工具描述进 Prompt、few-shot 示例、必要时做工具检索(工具多时)。
-
如果换成小模型,格式遵循能力差,你怎么提升成功率?
- 更严格的 few-shot、输出模板填空、JSON mode、后处理纠错、降低协议复杂度。
-
这套架构怎么做单元测试?
- parser 用固定输入输出做表驱动测试;工具函数独立测试;调度层用 mock LLM 测循环终止。