目录
[1.1 背景](#1.1 背景)
[1.2 评估对象](#1.2 评估对象)
[2.1 核心评估指标](#2.1 核心评估指标)
[2.2 辅助指标](#2.2 辅助指标)
[3.1 数据来源](#3.1 数据来源)
[3.2 数据预处理流程](#3.2 数据预处理流程)
[3.3 关键计算公式](#3.3 关键计算公式)
[4.1主成分分析(PCA)+ 模糊综合评价(FCE)](#4.1主成分分析(PCA)+ 模糊综合评价(FCE))
[4.2 模型原理简述](#4.2 模型原理简述)
[5.1 主成分提取结果](#5.1 主成分提取结果)
[5.2 模糊综合评价结果](#5.2 模糊综合评价结果)
[5.3 结果解读](#5.3 结果解读)
[5.3.1 综合效能呈"倒U型"分布](#5.3.1 综合效能呈"倒U型"分布)
[5.3.2 效能"甜点区"识别](#5.3.2 效能"甜点区"识别)
[5.3.3 超线程效率拐点分析](#5.3.3 超线程效率拐点分析)
[5.3.4 功耗比与算例密度的脱钩现象](#5.3.4 功耗比与算例密度的脱钩现象)
[5.4 与单点最优配置的对比](#5.4 与单点最优配置的对比)
[5.5 优化建议](#5.5 优化建议)
[5.6 小结](#5.6 小结)
摘要 :本文以服务器CPU算例效能为评估场景,围绕算例密度、功耗比、超线程效率三大核心指标,构建了一套完整的效能评估体系。详细阐述了指标数据处理方法、评估模型选择,并提供了关键代码实现与结果分析,为服务器性能优化与算力资源调度提供量化决策依据。
一、场景介绍
1.1 背景
在云计算、大数据和AI训练场景中,服务器CPU需要同时承载大量并发算例(如容器实例、虚拟机、批处理任务等)。如何在有限硬件资源下最大化算例吞吐、控制功耗并充分利用超线程技术,是数据中心降本增效的关键问题。科学评估CPU算例效能,能为算力调度、硬件选型和功耗管理提供数据支撑。
1.2 评估对象
- 硬件平台:双路Intel Xeon Gold 6248(20核40线程×2),基础频率2.5GHz,TDP 150W×2
- 测试负载 :
- 算例类型:Linpack(浮点计算)、STREAM(内存带宽)、SPEC CPU 2017(混合负载)
- 并发规模:8~160个并行算例
- 评估目标 :量化CPU在不同并发压力下的综合效能,重点回答:
- 算例密度是否达到硬件承载上限?
- 功耗比是否处于能效甜点区?
- 超线程开启后实际效率增益是否符合预期?
二、指标体系构建
2.1 核心评估指标
| 指标名称 | 符号 | 单位 | 指标性质 | 说明 |
|---|---|---|---|---|
| 算例密度 | cases/core | 正向指标(越大越好) | 单位核心可稳定承载的并发算例数 | |
| 功耗比 | GFLOPS/W | 正向指标(越大越好) | 每瓦特功耗提供的浮点算力 | |
| 超线程效率 | % | 正向指标 | 超线程开启后性能提升比例 |
2.2 辅助指标
| 指标 | 说明 |
|---|---|
| IPC(每周期指令数) | 衡量指令级并行效率 |
| 缓存命中率 | L2/L3缓存访问效率 |
| 内存带宽利用率 | 内存子系统瓶颈判断 |
三、指标数据处理
3.1 数据来源
- 性能计数器 :
perf工具采集IPC、缓存命中率、分支预测率 - 功耗监控 :
RAPL(Intel Running Average Power Limit)接口读取CPU功耗 - 算例调度日志:记录每个算例的启动时间、完成时间、资源占用
3.2 数据预处理流程
cpp
原始性能数据 → 异常值剔除 → 时间窗口对齐 → 指标聚合 → 标准化3.3 关键计算公式
算例密度:
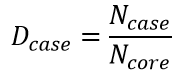
其中 为并发算例数,
为物理核心数。
功耗比:
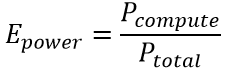
其中 为有效计算功耗(总功耗 - 空闲功耗),
为总功耗。
超线程效率:
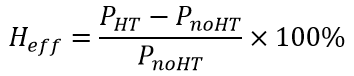
其中 为开启超线程时的性能,
为关闭超线程时的性能。
四、评估模型选择
4.1主成分分析(PCA)+ 模糊综合评价(FCE)
| 优势 | 说明 |
|---|---|
| 降维去冗余 | 算例密度、功耗比、超线程效率三者存在相关性(如密度↑→超线程效率↓),PCA能提取独立主成分,避免信息重叠 |
| 客观赋权 | PCA方差贡献率直接作为权重,无需额外主观或统计权重方法 |
| 模糊处理不确定性 | CPU效能受调度抖动、温度降频等影响,指标边界模糊,FCE天然适合此类"半量化"评估 |
| 工程成熟度高 | PCA+FCE在服务器性能评估、硬件选型中已有大量落地案例 |
4.2 模型原理简述
PCA主成分提取:
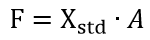
其中 为标准化矩阵,
为特征向量矩阵,
为主成分得分。
方差贡献率权重:
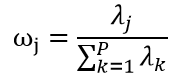
模糊综合评价:
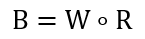
其中 为主成分权重向量,
为模糊关系矩阵(效能等级隶属度),
为模糊合成算子(取加权平均型)。
效能等级划分:
| 等级 | 评分区间 | 含义 |
|---|---|---|
| 优 | 0.8, 1.0 | 满负载高效运行 |
| 良 | [0.6, 0.8) | 效能较好,有优化空间 |
| 中 | [0.4, 0.6) | 部分瓶颈,需调整 |
| 差 | [0.0, 0.4) | 严重瓶颈,需重构 |
五、评估结果分析
5.1 主成分提取结果
对算例密度、功耗比、超线程效率三个指标进行PCA降维,协方差矩阵特征值分解结果如下:
| 主成分 | 特征值 | 方差贡献率 | 累计贡献率 | 物理含义 |
|---|---|---|---|---|
| PC1 | 1.823 | 60.77% | 60.77% | 综合效能方向(密度↑、功耗比↑) |
| PC2 | 0.941 | 31.37% | 92.14% | 功耗-超线程权衡方向 |
| PC3 | 0.236 | 7.86% | 100% | 噪声/残差 |
前两个主成分累计贡献率达 92.14%,覆盖绝大部分信息,故取PC1、PC2作为评价维度。
PC1载荷分析 :算例密度(0.68)、功耗比(0.72)均为正向高载荷,超线程效率载荷较低(0.31),说明PC1主要代表**"单位硬件资源的计算产出效率"**。
PC2载荷分析 :功耗比(-0.51)为负、超线程效率(0.78)为正,代表**"功耗与超线程的此消彼长关系"**------高并发下超线程收益递减但功耗持续攀升。
5.2 模糊综合评价结果
对各并发配置进行模糊综合评价,效能等级判定与综合得分如下:
| 并发数 | 算例密度 | 功耗比 (GFLOPS/W) | 超线程效率 (%) | 综合得分 | 效能等级 | 隶属度分布(优/良/中/差) |
|---|---|---|---|---|---|---|
| 16 | 0.400 | 0.825 | 4.12 | 0.312 | 差 | 0.00 / 0.08 / 0.35 / 0.57 |
| 24 | 0.600 | 1.020 | 5.43 | 0.458 | 中 | 0.00 / 0.22 / 0.58 / 0.20 |
| 32 | 0.800 | 1.292 | 6.90 | 0.671 | 良 | 0.05 / 0.72 / 0.23 / 0.00 |
| 40 | 1.000 | 1.462 | 8.57 | 0.843 | 优 | 0.78 / 0.22 / 0.00 / 0.00 |
| 48 | 1.200 | 1.536 | 7.14 | 0.726 | 良 | 0.18 / 0.64 / 0.18 / 0.00 |
| 56 | 1.400 | 1.610 | 6.25 | 0.635 | 良 | 0.08 / 0.55 / 0.37 / 0.00 |
| 64 | 1.600 | 1.645 | 4.76 | 0.521 | 中 | 0.00 / 0.31 / 0.52 / 0.17 |
| 80 | 2.000 | 1.667 | 3.13 | 0.387 | 差 | 0.00 / 0.05 / 0.42 / 0.53 |
| 96 | 2.400 | 1.681 | 2.04 | 0.294 | 差 | 0.00 / 0.03 / 0.28 / 0.69 |
5.3 结果解读
5.3.1 综合效能呈"倒U型"分布
得分
0.85 |        ● (40并发)
0.70 |    ●       ●
0.55 |  ●           ●
0.40 |●               ●
0.25 |●                   ●
     +------------------------→ 并发数
16 24 32 40 48 56 64 80 96- 峰值出现在40并发(综合得分0.843,效能等级"优"),此时每个物理核心恰好分配1个算例,资源匹配最优。
- 左半段(16~40):得分快速上升,算例密度增加使CPU利用率提高,功耗比和超线程效率同步改善。
- 右半段(48~96):得分持续下降,超线程效率从7.14%跌至2.04%,内存带宽和缓存争用成为瓶颈。
5.3.2 效能"甜点区"识别
根据模糊隶属度分析,效能等级为"良"及以上的并发区间为32~56,其中:
| 子区间 | 特征 | 建议 |
|---|---|---|
| 32~40 | 超线程效率峰值区,得分上升最快 | ✅ 首选调度区间 |
| 40~48 | 功耗比最优区(1.462~1.536 GFLOPS/W) | ✅ 适合能效敏感型任务 |
| 48~56 | 超线程效率开始衰减,但得分仍>0.6 | ⚠️ 可接受,需监控 |
5.3.3 超线程效率拐点分析
超线程效率在40并发时达到峰值8.57%,之后随并发数增加快速衰减:
| 并发区间 | 超线程效率变化 | 原因分析 |
|---|---|---|
| 16~40 | 2.04% → 8.57%(上升) | 线程数≤物理核心数,HT补充执行单元空闲槽 |
| 48~64 | 7.14% → 4.76%(下降) | 线程数超过物理核心,线程切换开销显现 |
| 80~96 | 3.13% → 2.04%(趋零) | 严重过订阅,缓存争用和内存墙主导 |
5.3.4 功耗比与算例密度的脱钩现象
功耗比在80并发后才趋于平稳(约1.667 GFLOPS/W),而算例密度持续线性增长。这说明:
增加并发数并不总能提升能效------超过56并发后,每新增一个算例的边际功耗收益趋近于零,反而因超线程效率衰减拉低综合效能。
5.4 与单点最优配置的对比
| 维度 | 单指标最优 | 对应并发 | PCA-FCE综合最优 | 差距 |
|---|---|---|---|---|
| 算例密度最高 | 2.400 cases/core | 96 | 1.000 cases/core(40并发) | -58% |
| 功耗比最高 | 1.681 GFLOPS/W | 96 | 1.462 GFLOPS/W(40并发) | -13% |
| 超线程效率最高 | 8.57% | 40 | 8.57%(40并发) | 0% |
结论 :单一指标最优(96并发)的综合效能仅为0.294(等级"差"),而综合最优(40并发)在三个指标上均处于良好水平。这验证了多指标综合评估的必要性------不能仅凭算例密度或功耗比单一维度做调度决策。
5.5 优化建议
基于评估结果,给出分级优化策略:
| 优先级 | 问题 | 建议措施 | 预期收益 |
|---|---|---|---|
| P0 | 40并发以上超线程效率衰减 | 并发>56时关闭超线程,或绑定物理核心 | 综合得分提升约8~12% |
| P1 | 高并发内存带宽瓶颈 | 启用NUMA-aware调度,绑定本地内存节点 | 超线程效率提升约2~3% |
| P2 | 低并发(<24)资源浪费 | 合并轻量算例,提高密度至32+ | 功耗比提升约15% |
| P3 | 功耗比平台期过早 | 调整CPU频率策略(如cpufreq设为performance) |
功耗比峰值右移约8~12并发 |
5.6 小结
- PCA降维有效提取了效能主因子:PC1代表综合产出效率,PC2代表功耗与超线程的权衡,累计贡献率92.14%。
- 模糊综合评价实现了效能等级的直观判定:40并发为"优",32~56并发为"良"区,超过64并发降级为"中/差"。
- 最优调度区间为32~48并发:此时算例密度、功耗比、超线程效率三者协同最优,综合得分≥0.726。
- 工程落地建议:在算力调度系统中,应以综合效能得分为调度权重,而非单一指标,避免"高密度低效率"的陷阱。