👉 欢迎阅读这篇文章 👇
目录
1、排序的概念
1.1概念及应用
排序就是将一个数据元素的任意序列,重新排列成一个按关键字有序的序列。假设含有n个记录的序列为{ R 1 , R 2 , . . . . . . , R n R_1,R_2,......,R_n R1,R2,......,Rn},其对应的关键字是{ k 1 , k 2 , . . . . . . , k n k_1,k_2,......,k_n k1,k2,......,kn},需确定1, 2, ..., n的一种排列 p 1 , p 2 , . . . . . . , p n , p_1,p_2,......,p_n, p1,p2,......,pn,使其对应的关键字满⾜如下的⾮递减或⾮递增关系 k p 1 < = k p 2 < = . . . . . . < = k p n k_{p_1}<=k_{p_2}<=......<=k_{p_n} kp1<=kp2<=......<=kpn使得序列成为按关键字有序的序列{ R p 1 , R p 2 , . . . . . . , R p n R_{p_1},R_{p_2},......,R_{p_n} Rp1,Rp2,......,Rpn}
排序在实际⽣活中随处可⻅,如购物软件中通过综合评分、评价、价格等排序商品⽅便筛选。再或者⼤学综合实⼒排⾏榜,再或者华润富豪排⾏榜等等。
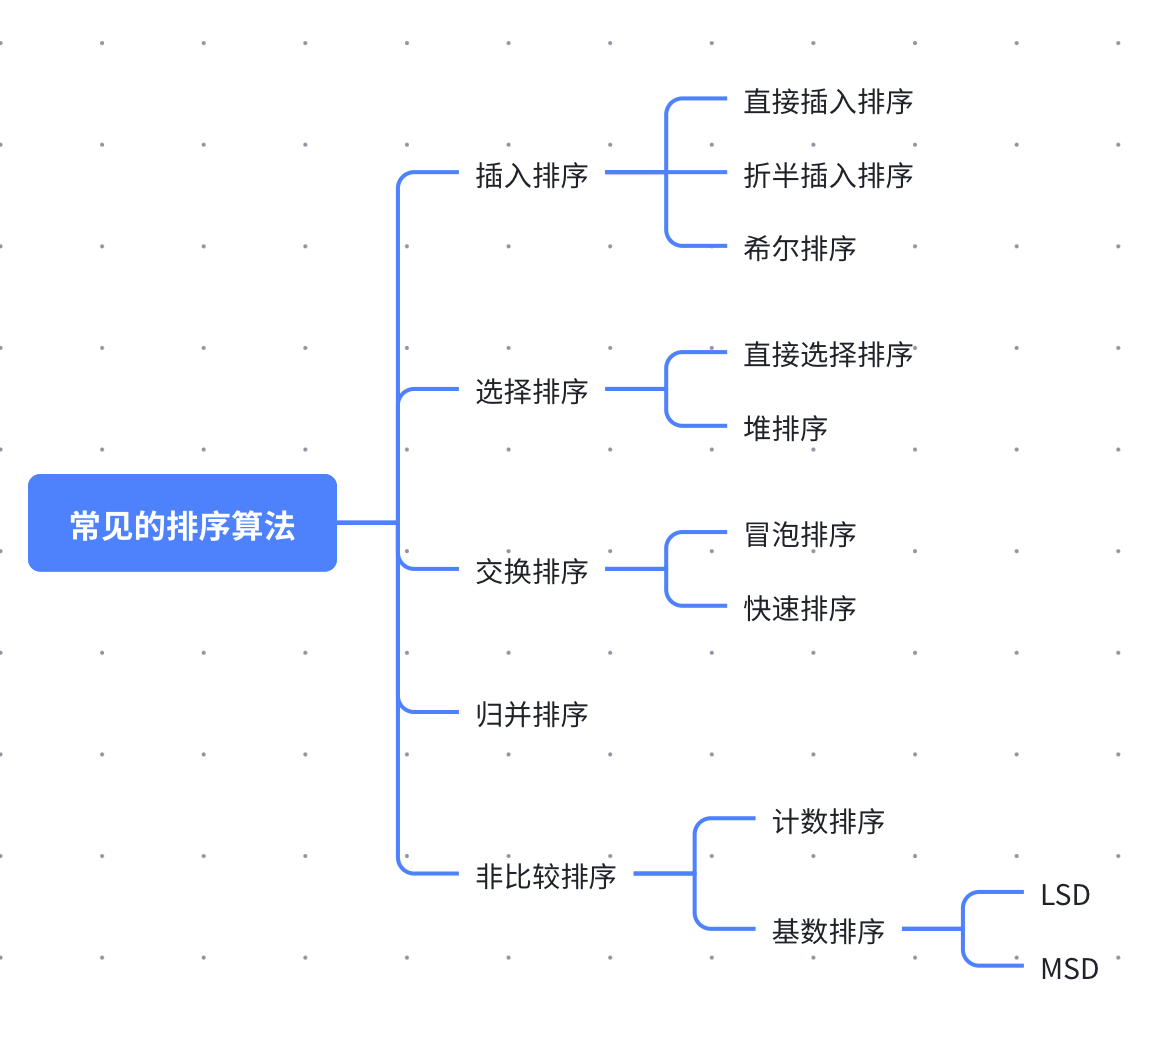
1.2常见的排序算法
1.3排序算法的评价指标
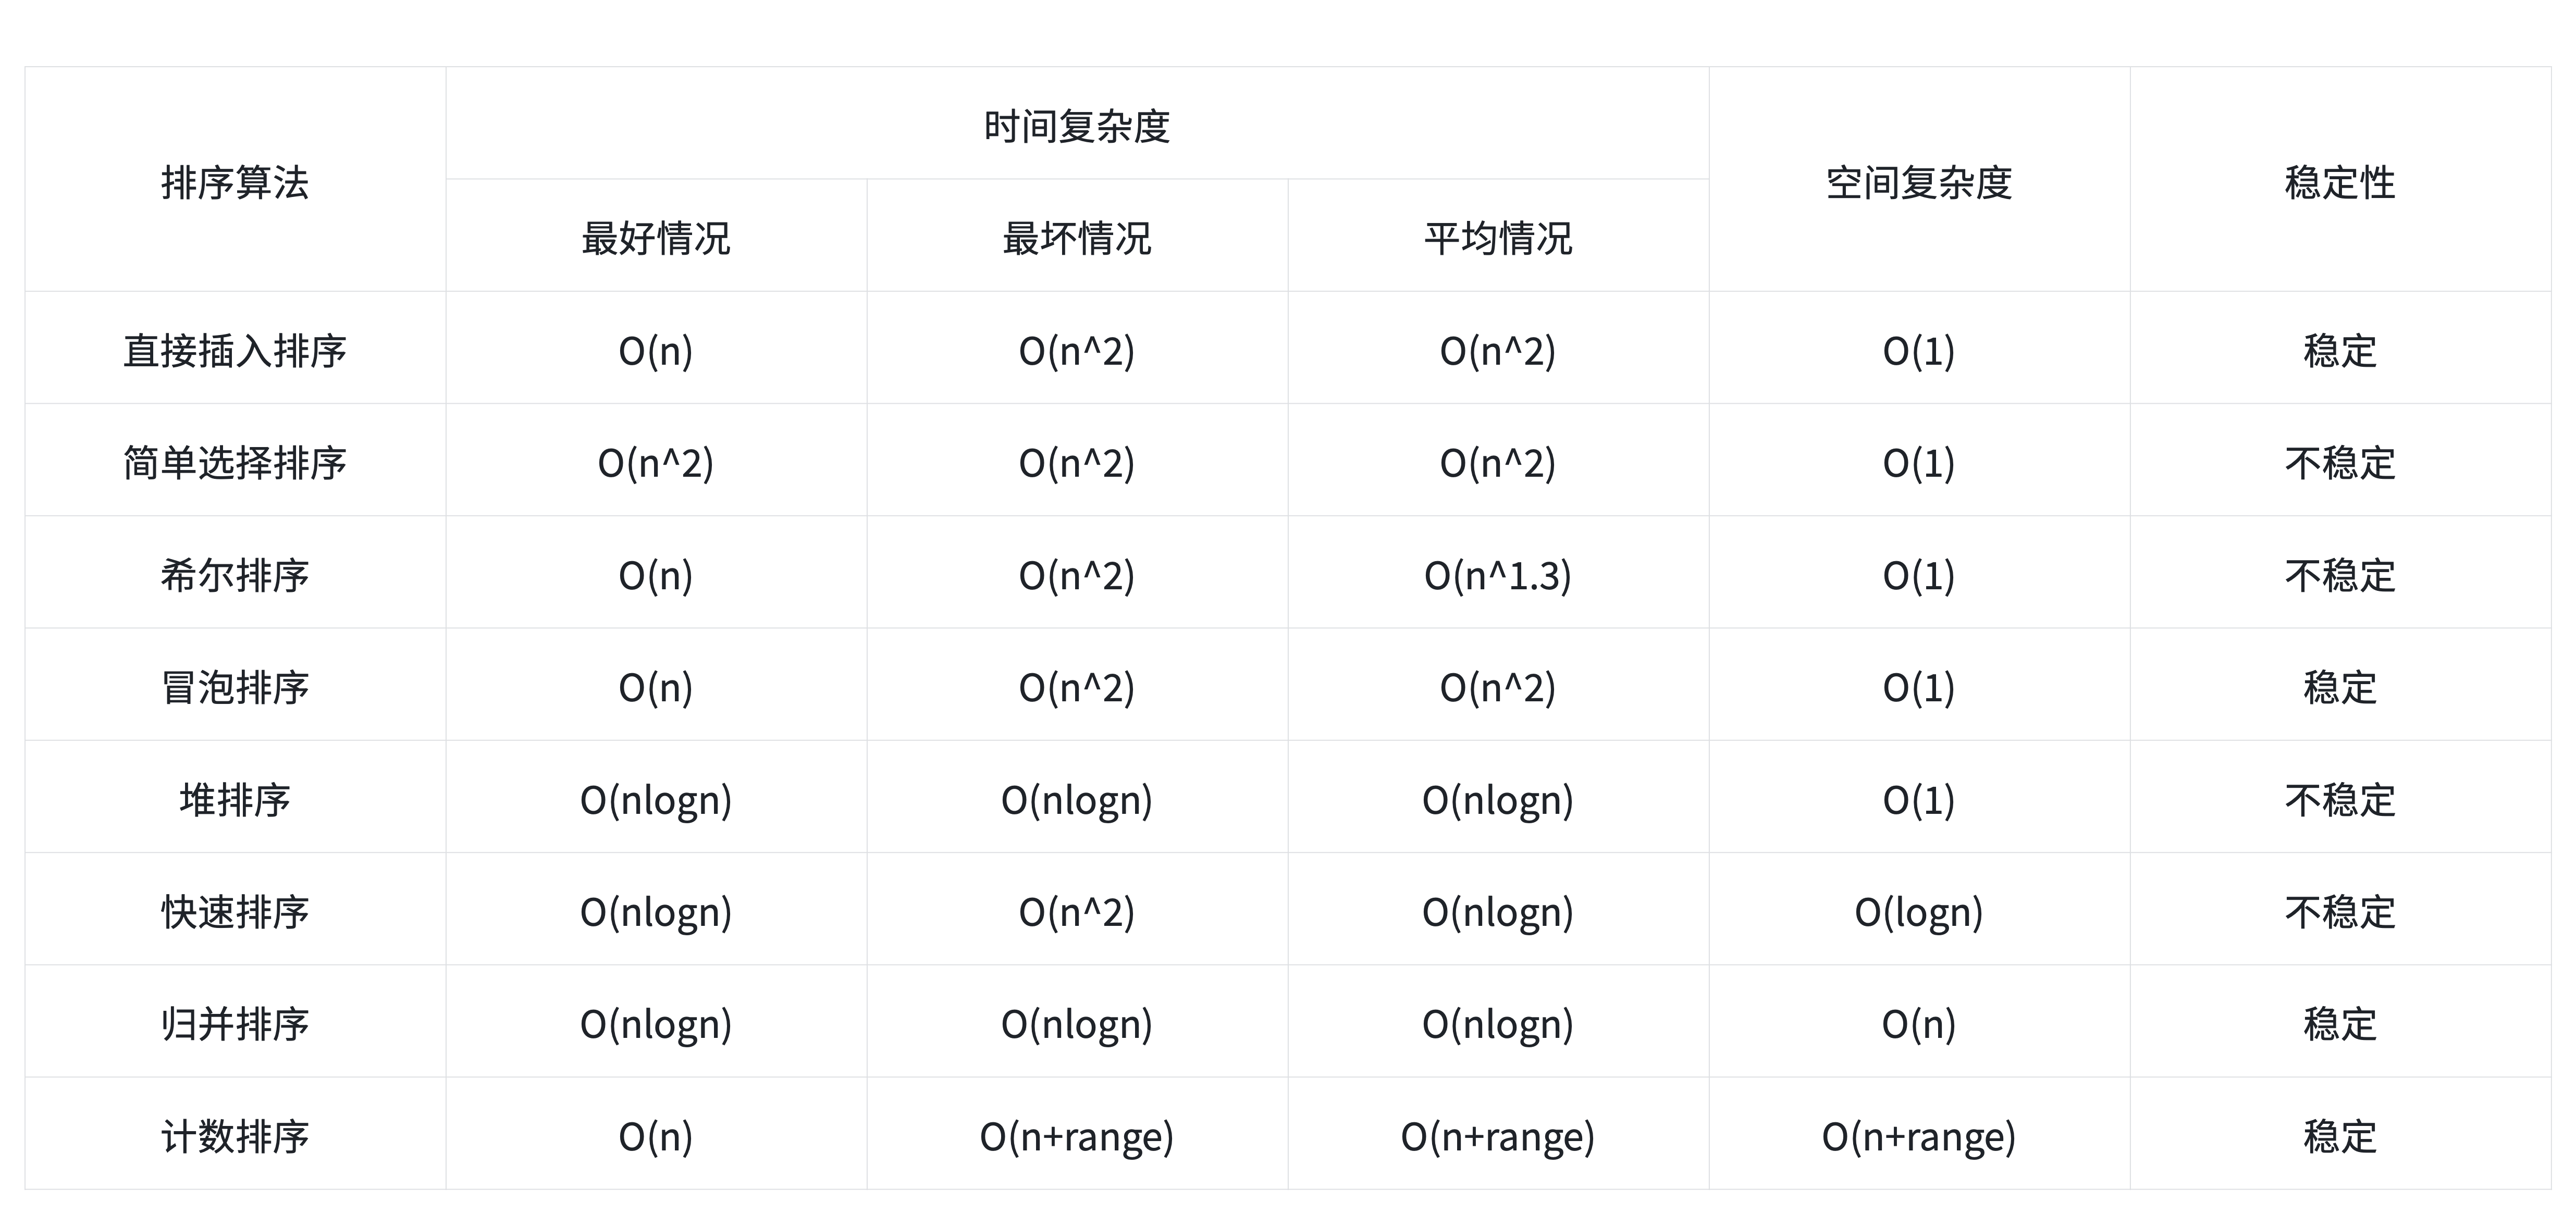
- 复杂度:评价排序算法的第⼀⼤指标就是时间复杂度和空间复杂度,它衡量算法的时间效率和空间效率。
- 稳定性:假定在待排序的数据元中有两个元素 R i R_i Ri和 R j R_j Rj,他们对应的关键字为 k i k_i ki和 k j k_j kj且 k i = k j k_i=k_j ki=kj,排序前 R i R_i Ri在 R j R_j Rj的前⾯,排序后可以保证 R i R_i Ri依旧在 R j R_j Rj的前⾯(相对顺序不变),则称这个排序算法是稳定的。
性能测试代码
c
void TestPerformance() {
	srand(time(0));
	const int N = 10000000;
	int* a1 = (int*)malloc(sizeof(int) * N);
	int* a2 = (int*)malloc(sizeof(int) * N);
	int* a3 = (int*)malloc(sizeof(int) * N);
	int* a4 = (int*)malloc(sizeof(int) * N);
	int* a5 = (int*)malloc(sizeof(int) * N);
	int* a6 = (int*)malloc(sizeof(int) * N);
	int* a7 = (int*)malloc(sizeof(int) * N);
	int* a8 = (int*)malloc(sizeof(int) * N);
	int* a9 = (int*)malloc(sizeof(int) * N);
	for (int i = 0; i < N; ++i) {
		a1[i] = rand() + i;
		//a1[i] = rand(); // 重复数据较多
		a2[i] = a1[i];
		a3[i] = a1[i];
		a4[i] = a1[i];
		a5[i] = a1[i];
		a6[i] = a1[i];
		a7[i] = a1[i];
		a8[i] = a1[i];
		a9[i] = a1[i];
	}

	int begin1 = clock();
	InsertSort(a1, N);
	int end1 = clock();

	int begin2 = clock();
	ShellSort(a2, N);
	int end2 = clock();

	int begin3 = clock();
	SelectSort(a3, N);
	int end3 = clock();

	int begin4 = clock();
	HeapSort(a4, N);
	int end4 = clock();

	int begin5 = clock();
	BubbleSort(a5, N);
	int end5 = clock();

	int begin6 = clock();
	QuickSort(a6, 0, N - 1);
	int end6 = clock();

	int begin7 = clock();
	MergeSort(a7, N);
	int end7 = clock();

	int begin8 = clock();
	CountSort(a8, N);
	int end8 = clock();

	int begin9 = clock();
	RadixSortLSD(a9, N);
	int end9 = clock();

	printf("InsertSort:%d\n", end1 - begin1);
	printf("ShellSort:%d\n", end2 - begin2);
	printf("SelectSort:%d\n", end3 - begin3);
	printf("HeapSort:%d\n", end4 - begin4);
	printf("BubbleSort:%d\n", end5 - begin5);
	printf("QuickSort:%d\n", end6 - begin6);
	printf("MergeSort:%d\n", end7 - begin7);
	printf("CountSort:%d\n", end8 - begin8);
	printf("RadixSortLSD:%d\n", end9 - begin9);


	free(a1);
	free(a2);
	free(a3);
	free(a4);
	free(a5);
	free(a6);
	free(a7);
	free(a8);
	free(a9);
}
1.4内部排序和外部排序
由于待排序的记录数量不同,使得排序过程中涉及的存储器不同,可以将排序⽅法分为两⼤类:
- 内部排序:待排序的记录存放在计算机随机存储器(内存)中进⾏排序的过程。内部排序关注如何让复杂度更低。
- 外部排序:待排序的记录数据量太⼤,以致内存⼀次不能容纳全部记录,在排序过程中需要对外存(硬盘)进⾏访问的排序过程。外部排序关注如何使读写硬盘的次数更少。
2、 插入排序
2.1直接插入排序
2.1.1思想及代码
插入排序类似于玩扑克牌等插牌过程,每次将⼀个待排序的元素按照其关键字⼤⼩插⼊到前⾯已排好序的序列中,按照该种⽅式将所有元素全部插⼊完成即可。
单次插入思想:
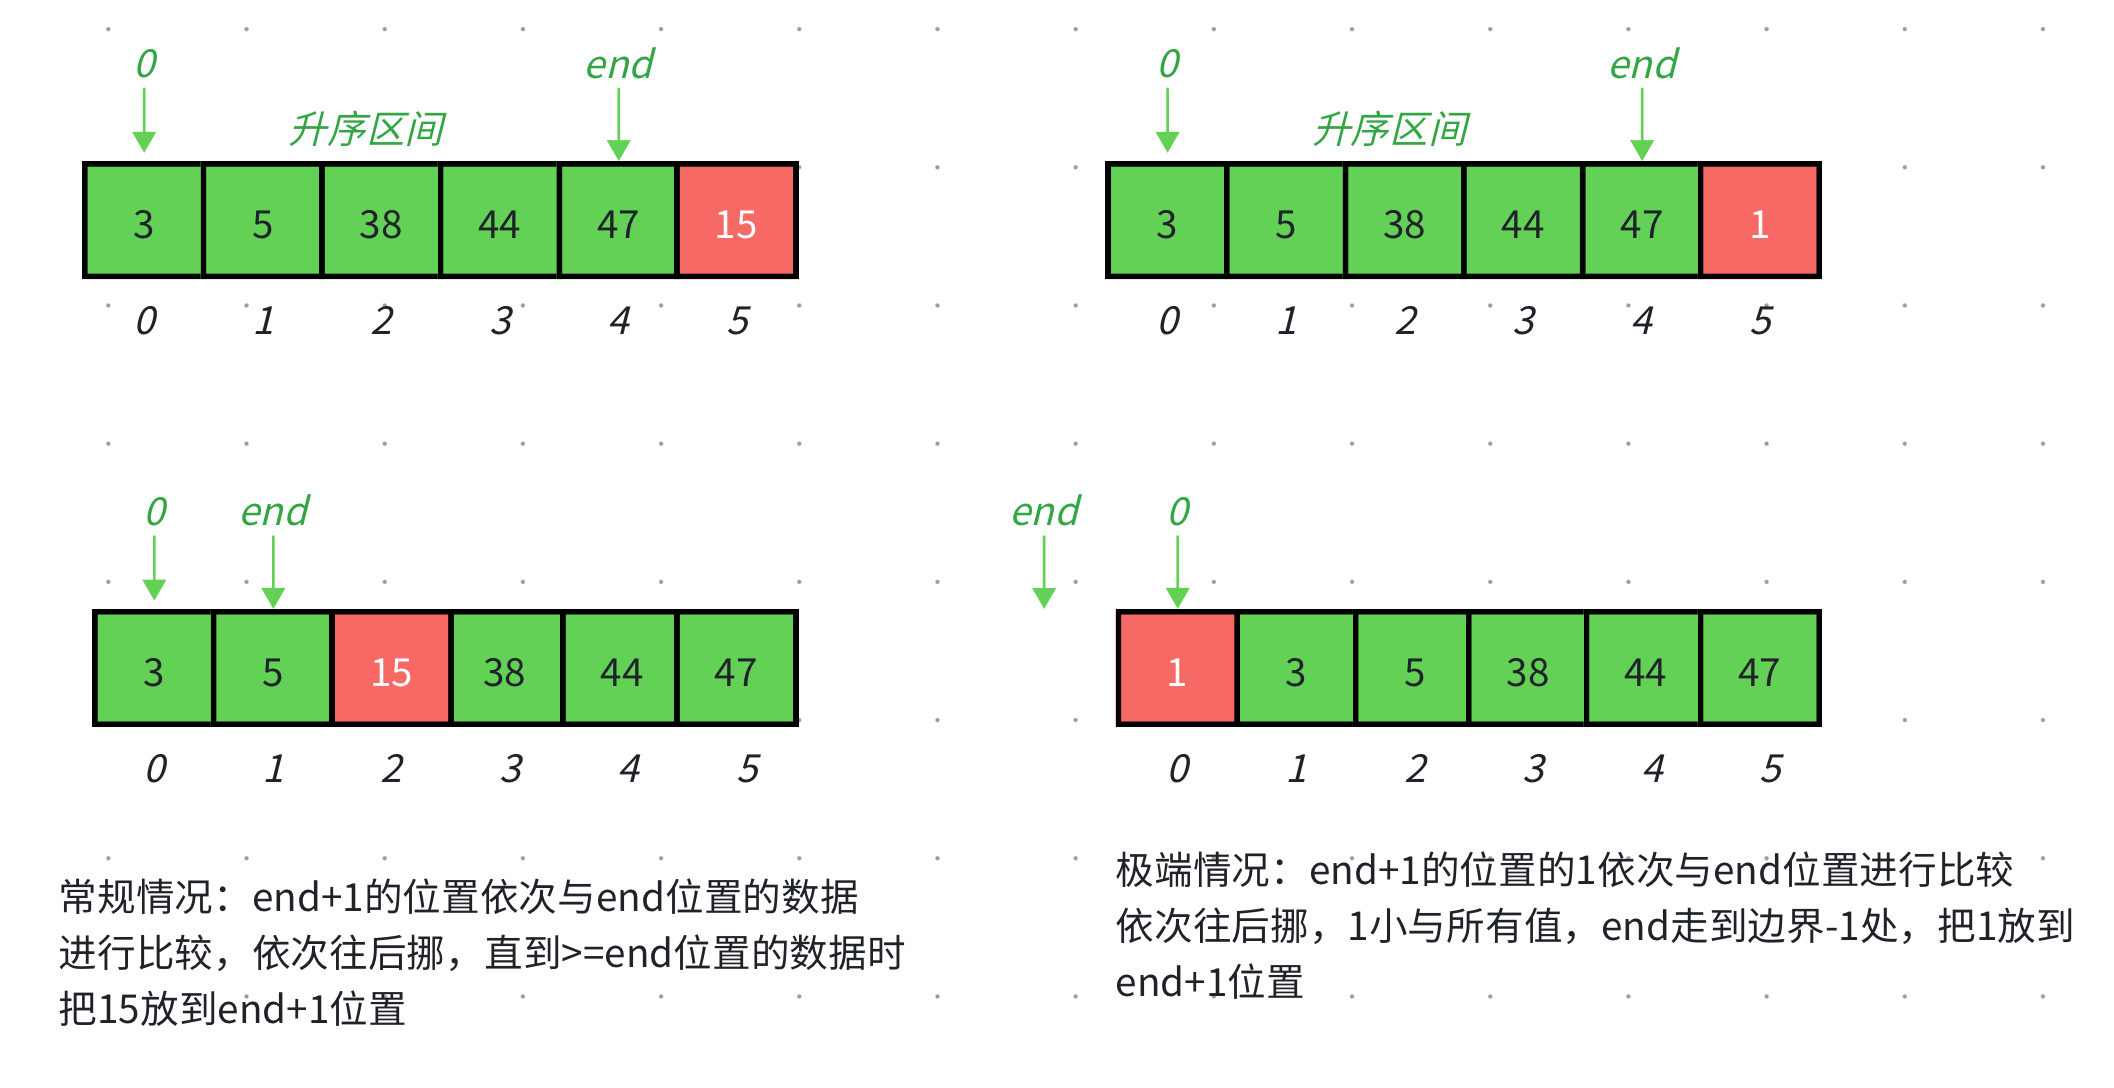
记[0,end]为有序区间,我们要做的是将end+1位置的关键字插⼊到[0,end]有序区间,使得[0,end+1]区间有序。
代码演示
c
// [0,end]有序 end+1位置的值插⼊[0,end],保持有序
int end;
int tmp = a[end + 1];
while (end >= 0)
{
	if (a[end] > tmp)
	{
		a[end + 1] = a[end];
		end--;
	}
	else
	{
		break;
	}
}
a[end + 1] = tmp;
整体插入思想:
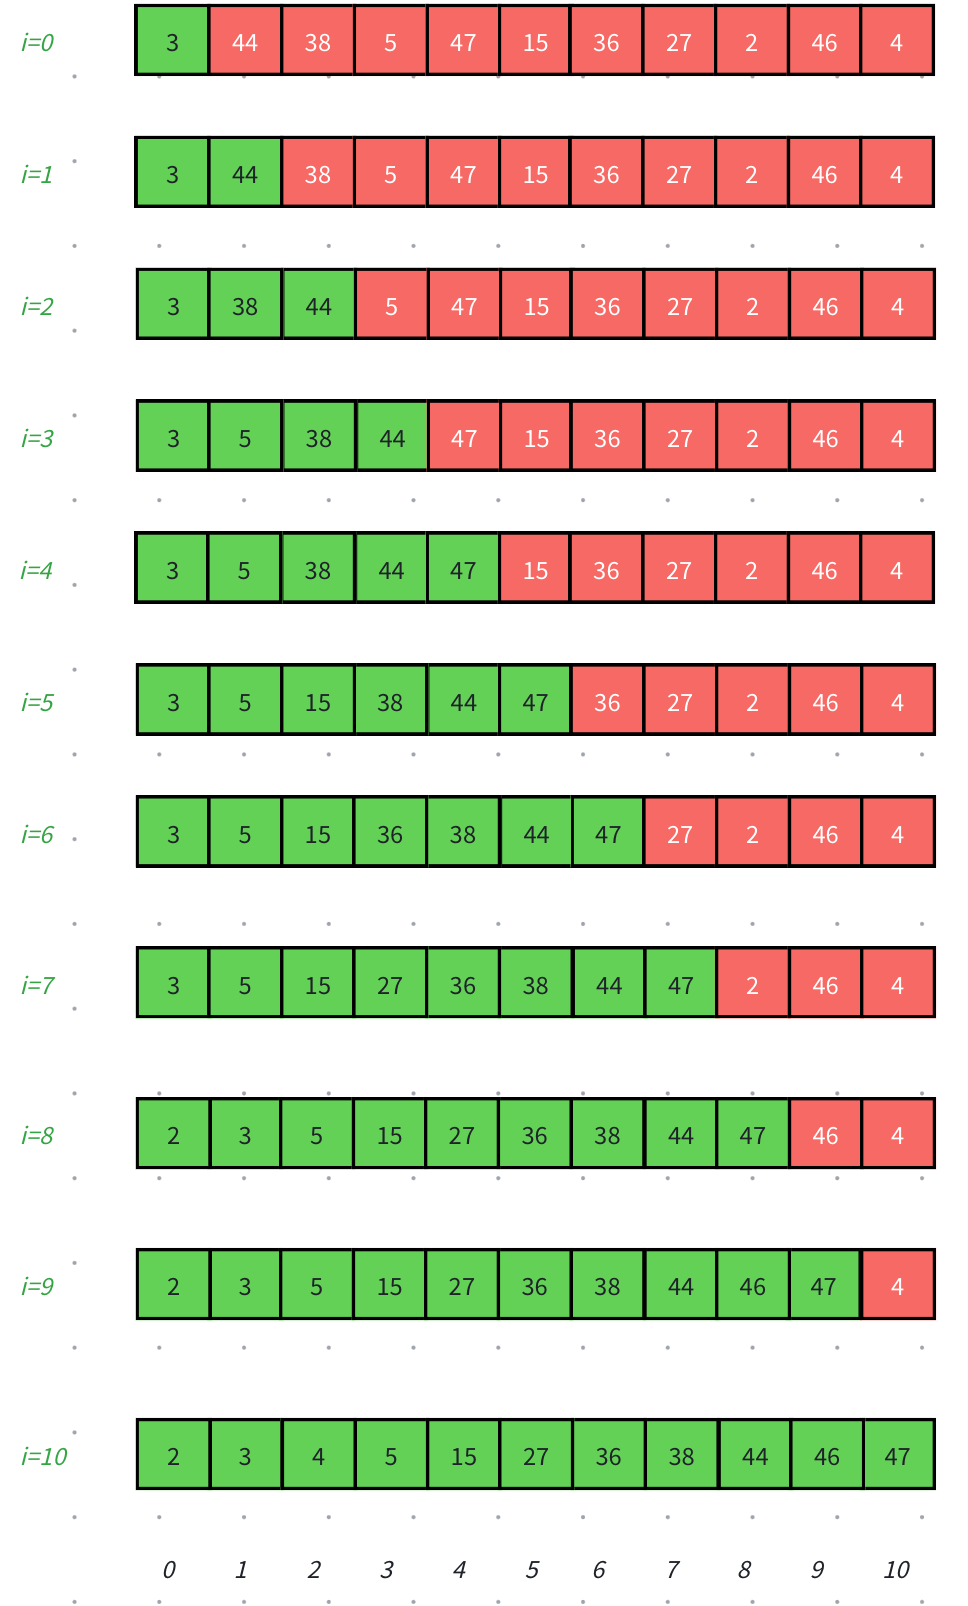
- 直接插入排序最开始将
[0,0]作为第一个有序区间,将1位置的值插入到[0,0],使[0,1]区间有序。 - 再将
[0,1]作为第二个有序区间,2位置的值插入到[0,1],使[0,2]区间有序。 - 不断重复上述过程,直到
[0,n-2]有序,n-1位置的值插入到[0,n-2],使[0,n-1]区间有序,就排序完成了。
代码演示
c
void InsertSort(int* a, int n)
{
	for (int i = 0;i < n-1;i++)
	{
		int end = i;
		int tmp = a[end + 1];
		while (end >= 0)
		{
			if (tmp < a[end])
			{
				a[end + 1] = a[end];
				end--;
			}
			else
			{
				break;
			}
		}
		a[end + 1] = tmp;
	}
}
2.1.2复杂度和稳定性
- 直接插入排序最好的情况是正序,如:要排升序,序列本身为升序或类似升序,则每次不需要挪动数据或挪动很少次,数据间比较n-1次,时间复杂度为 O ( n ) O(n) O(n)。
- 直接插入排序最坏的情况是逆序,如:要排升序,序列本身为将序,则需要挪动的数据个数是一个1到n-1的等差数列,时间复杂度是 O ( n 2 ) O(n^2) O(n2)。
- 直接插⼊排序只需要常数个辅助变量,空间复杂度为 O ( 1 ) O(1) O(1)。
从上述结论可⻅直接插⼊排序⽐较挑序列的原始顺序,当序列顺序有序或接近顺序有序时,效率较⾼。
- 直接插⼊排序只要end+1位置的值插⼊到0,end序列⽐较时,相等则插⼊到相等值的后⾯位置就可以保证稳定性。
2.1.3折半插入排序
下⼀个要插⼊的元素是key,key前⾯的 [0,end] 为有序区间。
直接插入排序是从后往前逐个比较,如果key非常小,则比较次数较多;如果使用二分查找找在前⾯有序区间确认待插⼊元素key的位置,则可以减少元素间的比较次数,这种方式叫折半插入排序。
2.2希尔排序
2.2.1思想及代码
希尔排序 是直接插入排序的一种改进,又称缩小增量排序,由1959年由Donald Shell提出来的。
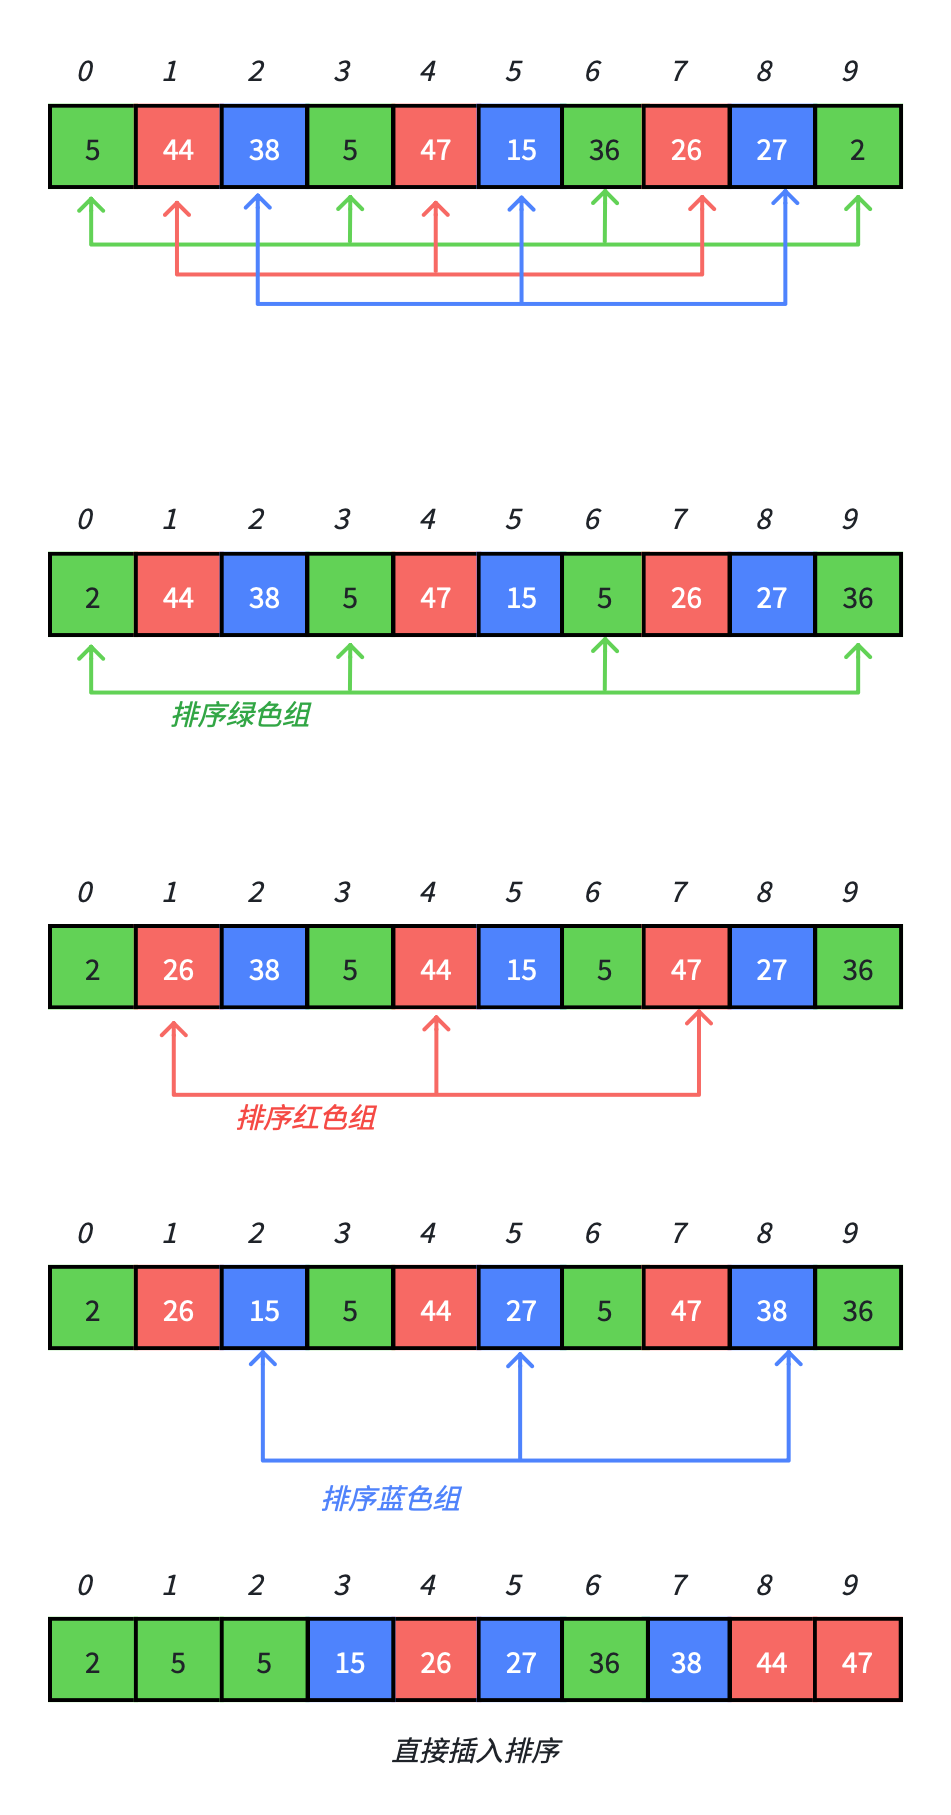
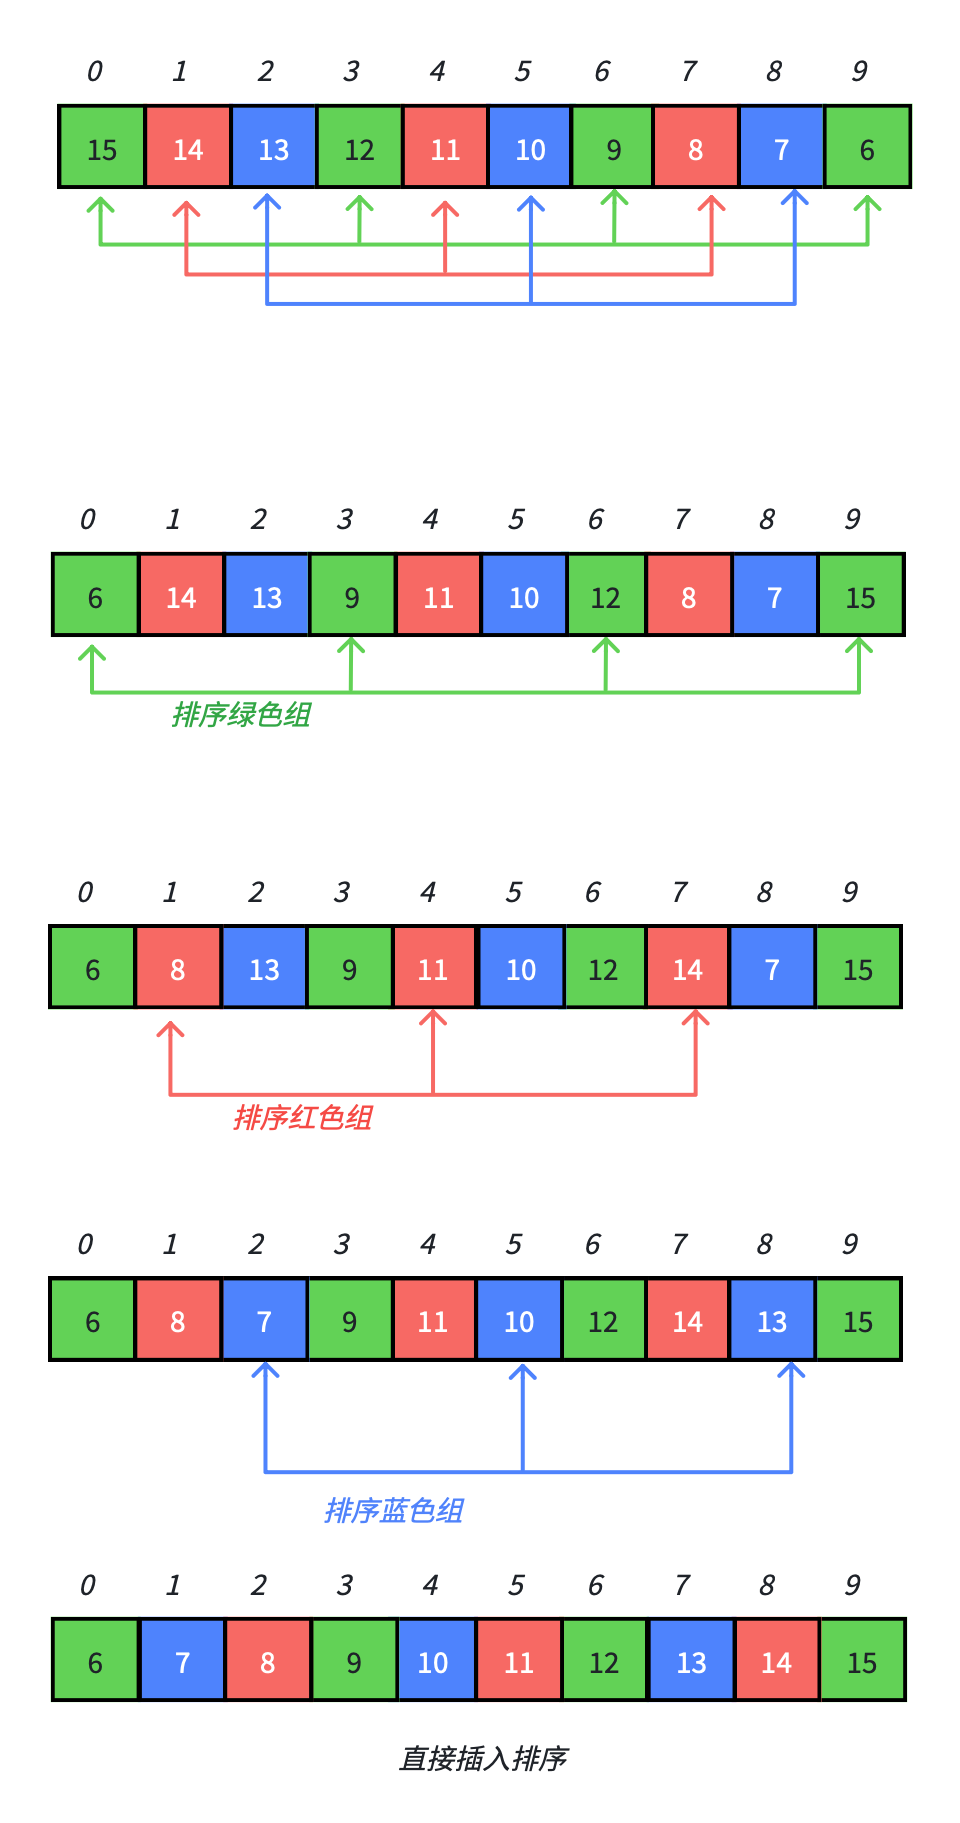
我们知道,直接插入排序在逆序的情况下,每次单趟插⼊都需要⼤量挪动数据。希尔排序是将带排序序列下标按照增量d分成d组,对每组数据分别进⾏直接插⼊排序。然后再不断缩⼩增量d,直至为1时,排序完成。当d>1时,可以认为上述过程是预排序(d>1称为预排序只是为了⽅便理解定义的名词,并不是官方的叫法),它会让待排序序列接近正序,当d=1时,上述过程就是直接插⼊排序,保证数据有序。这样最后⼀趟d=1时效率就很⾼。
总结⼀下希尔排序的本质是先通过预排序(d>1)让待排序序列接近有序,最后再通过直接插⼊排序(d=1)快速让序列有序。
- 假设d=3时,随机数组进⾏预排序过程展示
- 假设d=3时,逆序数组进⾏预排序过程展示
假设d=1时,所以数据看做⼀组,就是直接插⼊排序
一趟 :每更换一次增量 d,就代表一趟结束,准备开始下一趟。
2.2.1.1间距为d的单组单趟插⼊代码实现
c
//单组单趟排序逻辑
void __ShellSort(int* a, int n)
{
	int d = 3;
	for (int i = 0;i < n - d;i+=d)
	{
		int end = i;
		int tmp = a[end + d];
		while (end >= 0)
		{
			if (tmp < a[end])
			{
				a[end + d] = a[end];
				end -= d;
			}
			else
			{
				break;
			}
		}
		a[end + d] = tmp;
	}
}2.2.2.2间距为d的多组单趟插入代码实现
2.2.2.2.1版本1
c
//间距为d的多组单趟插入代码实现
void _ShellSort(int* a, int n)
{
	int d = 3;
	for (int j = 0;j < d;j++)//j=0时------第一组;j=1时------第二组;j=2时------第三组
	{
		for (int i = j;i < n - d;i += d)
		{
			int end = i;
			int tmp = a[end + d];
			while (end >= 0)
			{
				if (tmp < a[end])
				{
					a[end + d] = a[end];
					end -= d;
				}
				else
				{
					break;
				}
			}
			a[end + d] = tmp;
		}
	}
}
2.2.2.2.2版本2
可以进行一下改造,使得代码更简洁
c
//间距为d的多组单趟插入代码实现(改造)
void _ShellSort1(int* a, int n)
{
	int d = 3;
	for (int i = 0;i < n - d;i++)
	{
		int end = i;
		int tmp = a[end + d];
		while (end >= 0)
		{
			if (tmp < a[end])
			{
				a[end + d] = a[end];
				end -= d;
			}
			else
			{
				break;
			}
		}
		a[end + d] = tmp;
	}
}
2.2.2.2.3总结
以上两种版本的代码主要区别在于
- 第一种是第一组排完再排第二组接着第三组
- 第二种是三组同时排,排完第一组的第一个排第二组的第一个接着第三组的第一个然后第一组的第二个、第二组的第二个、第三组的第二个然后第一组的第三个、第二组的第三个、第三组的第三个
2.2.2.3完整代码(间距为d的多组多趟插入代码实现)
- Shell提出的缩⼩增量⽅案为d = d/2;
- Knuth提出的缩⼩增量⽅案为d = d/3+1;
- Sedgewick提出的缩⼩增量⽅案为 9 ∗ 4 i − 9 ∗ 2 i + 1 9*4^i-9*2^i+1 9∗4i−9∗2i+1和 4 i − 3 ∗ 2 i + 1 4^i-3*2^i+1 4i−3∗2i+1组合交错序列。
- Knuth的⽅案⾼效简洁,应⽤⾮常⼴泛,在很多算法教科书和实际⼯程代码中都能⻅到它的⾝影。
c
//希尔排序------最终代码
void ShellSort(int* a, int n)
{
	int d = n;
	while (d > 1)
	{
		//d>1是预排序
		//d==1是整体插入排序
		//+1是为了保证最后一次是1
		d = d / 3 + 1;
		for (int i = 0;i < n - d;i++)
		{
			int end = i;
			int tmp = a[end + 1];
			while (end >= 0)
			{
				if (tmp < a[end])
				{
					a[end + d] = a[end];
					end -= d;
				}
				else
				{
					break;
				}
			}
			a[end + d] = tmp;
		}
	}
}
2.2.2复杂度和稳定性
希尔排序的复杂度和稳定性,相比于直接插入排序要复杂得多。因为它依赖于增量序列的选择。并且涉及⼀些尚未完全解决的数学问题(希尔排序涉及多轮插⼊排序,前⼀轮排序的结果会影响后⼀轮的初始状态(即"预排序"效果)。分析这种多轮交互对逆序数的具体减少量在数学上⾮常困难)。直到今天,对于⼀些增量序列,其精确的时间复杂度仍然是⼀个开放的研究问题。
- Shell提出的缩⼩增量⽅案为d = d/2,如果数组恰好在奇数位置均是很⼩的数,偶数位置均是很⼤的数,且增量序列有公因⼦(如 8,4,2,1),那么前⼏轮预排序⼏乎没起到什么作⽤,直到最后⼀轮d=1时,数据⼏乎还是乱的,导致插⼊排序近乎满负荷运⾏,从⽽退化成平⽅级复杂度,最坏情况下复杂度经过证明为 O ( n 2 ) O(n^2 ) O(n2) ,平均情况时间复杂度经过证明为 O ( n 2 ) O(n^2 ) O(n2) 。
- Knuth提出的缩⼩增量⽅案为d = d/3+1,最坏情况时间复杂度经过严格证明为 O ( n 1.5 ) O(n^{1.5}) O(n1.5);⽽平均情况时间复杂度为 O ( n 1.25 ) O(n^{1.25}) O(n1.25),⾄今尚未得到严格的数学证明,但是包括Knuth本⼈在内的多位科学家通过复杂的数学分析,给出了⾮常接近这个结论的论证,⼤量试验数据也和这个结论吻合。
- Sedgewick提出的缩⼩增量⽅案为 9 ∗ 4 i − 9 ∗ 2 i + 1 9*4^i-9*2^i+1 9∗4i−9∗2i+1和 4 i − 3 ∗ 2 i + 1 4^i-3*2^i+1 4i−3∗2i+1组合交错序列,最坏情况时间复杂度经过严格证明为 O ( n 1.33 ) O(n^{1.33}) O(n1.33);⽽平均情况时间复杂度经过证明为 O ( n 1.17 ) O(n^{1.17}) O(n1.17)
理论⽽⾔Sedgewick的增量⽅案为最优⽅案,但是实践中Knuth更简洁,且效率也很不错,所以在教学和实践中我们⼀般都使⽤Knuth的⽅案。
- 总结:被问到希尔排序的时间复杂度 时,我们可以说它取决于增量序列的选择,在优良增量序列下可达到 O ( n 1.3 ) O(n^{1.3}) O(n1.3)至 O ( n 1.5 ) O(n^{1.5}) O(n1.5)之间。
- 希尔排序只需要常数个辅助变量,空间复杂度 为 O ( 1 ) O(1) O(1)。
- 希尔排序**⽆法保持稳定性**,相同的值预排时可能分到不同的组,不同组排序,则相对顺序就乱了。
3、选择排序
3.1简单选择排序
3.1.1思想及代码
在每一趟待排序的n-i-1(i = 1, 2, ..., n − 1)个元素中找关键字最小或最大的元素,作为有序序列的第i个元素(mini或maxi),等到第 n − 1 趟排完之后,待排序区间中就剩⼀个元素就⽆需再选,区间就有序了。
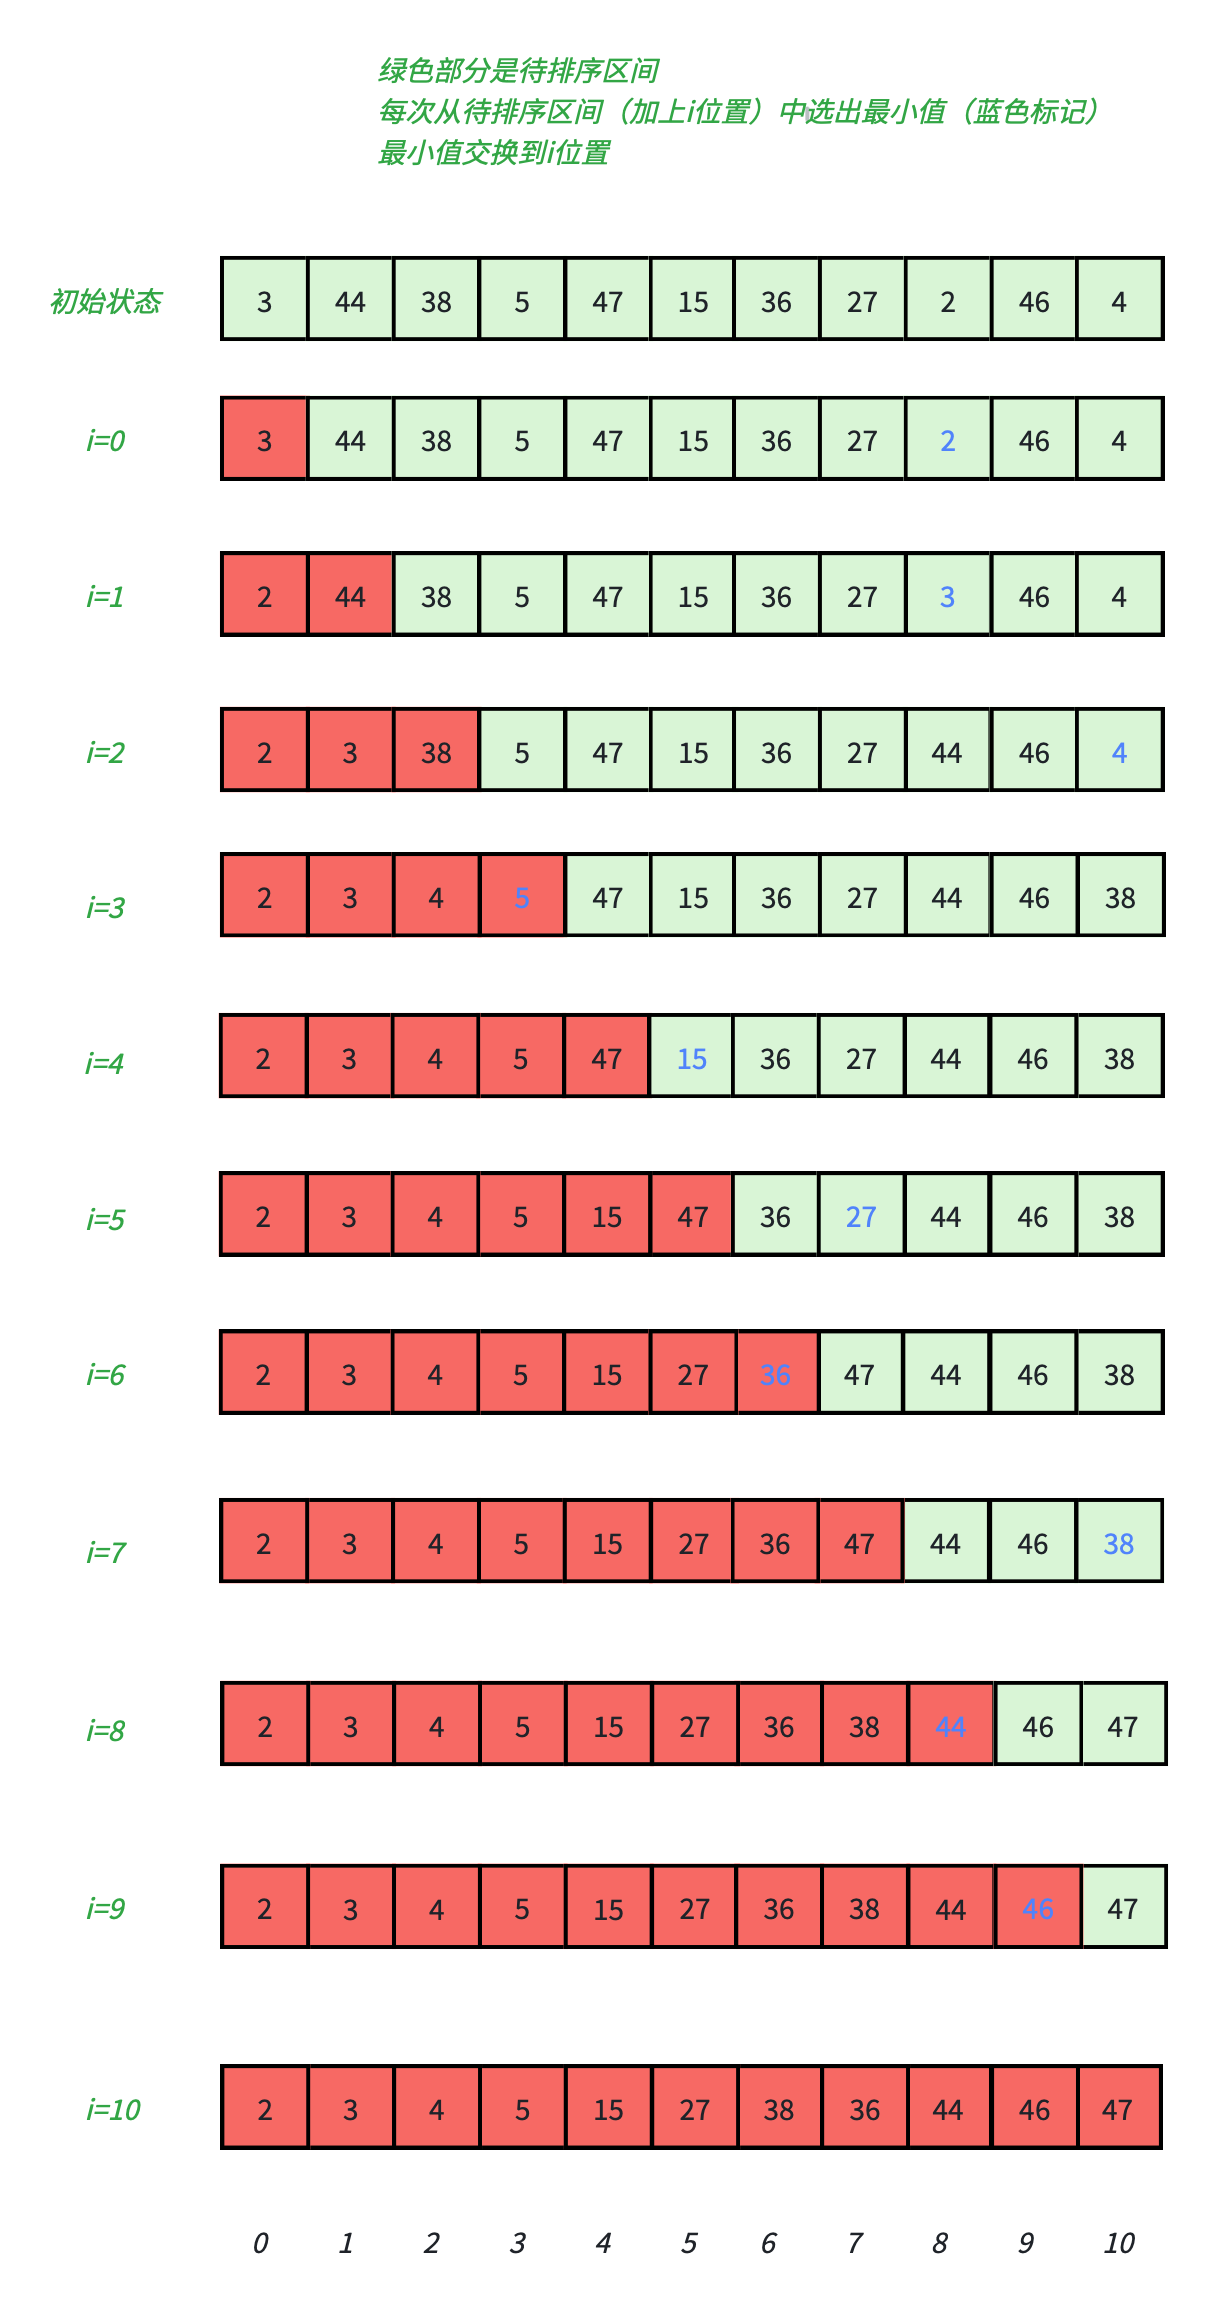
代码演示
c
void Swap(int* a, int* b)
{
	int tmp = *a;
	*a = *b;
	*b = tmp;
}

void SelectSort(int* a, int n)
{
	for (int i = 0;i < n - 1;i++)
	{
		int mini = i;
		for (int j = i+1;j < n;j++)
		{
			if (a[j] < a[mini])
			{
				mini = j;
			}
		}
		if(mini!=i)
		{
			Swap(&a[mini], &a[i]);
		}
	}
}
3.1.2复杂度和稳定性
⽆论待排序序列为正序、逆序、乱序,每趟都需要去⽐较选出最⼩数据,累积⽐较次数为1⾄n-1的等差数列,所以时间复杂度 是 O ( n 2 ) O(n^2) O(n2)。
简单选择排序只需要常数个辅助变量,空间复杂度 为 O ( 1 ) O(1) O(1)。
简单选择排序**⽆法保持稳定性** ,如{5,6,5,0,2,0,3},我们可以遍历⼀遍选出第⼀个0交换到最左边的位置,保持0的相对顺序,但是在交换过程中5的相对顺序就被破坏了,所以简单选择排序⽆法保持稳定性。
3.2堆排序
3.2.1思想及代码
堆排序也是⼀种选择排序,简单选择排序每次使⽤暴⼒遍历来选出最⼩或者最⼤的数,⽽堆排序则将数组逻辑上看做完全⼆叉树 ,建堆/调堆后来选出最⼤或最⼤的数实现排序。堆排序思想及实现细节在树和二叉树文章中有详细介绍。
代码演示
c
//向下调整算法(建大堆)
void AdjustDown(int* a, int n, int parent)
{
	int child = parent * 2 + 1;
	while (child<n)
	{
		if (child + 1 < n&&a[child] < a[child + 1])
		{
			child = child + 1;
		}

		if (a[child] > a[parent])
		{
			Swap(&a[child], &a[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else
		{
			break;
		}
	}
}

void HeapSort(int* a, int n)
{
	//建堆
	for (int i = (n - 1 - 1) / 2;i >= 0;i--)
	{
		AdjustDown(a, n, i);
	}

	//排序
	int j = 1;
	while (j < n)
	{
		Swap(&a[0], &a[n - j]);
		AdjustDown(a, n-j, 0);
		j++;
	}
}
3.2.2复杂度和稳定性
堆排序优势是通过建堆/调堆选数效率极⾼,时间复杂度 为 O ( n l o g n ) O(nlogn) O(nlogn)。
堆排序只需要常数个辅助变量,空间复杂度 为 O ( 1 ) O(1) O(1) 。
堆排序**⽆法保持稳定性**,如{2,1,2,2}建堆后排序,把堆顶的数据换到最后位置,则相对顺序就乱了。
4、交换排序
4.1冒泡排序
4.1.1思想及代码
单趟冒泡:假设排升序,冒泡的过程是从前往后两两比较相邻元素的值,如果逆序(ai>ai+1)则交换,直到序列中相邻元素⽐较交换完成,称为⼀趟冒泡。
整体冒泡:假设排升序,⼀趟冒泡结束后,会将最⼤元素放在区间最后,即最⼤元素已经排列好。下⼀趟冒泡可以对除最⼤元素外的⼦序列从前往后继续冒泡,结束后次⼤元素就可以排列好。以此循环,共n-1趟趟冒泡后序列就排好了。(注意最后⼀趟区间中只有⼀个元素,本趟冒泡可以不需要,因此是n-1趟冒泡过程。)
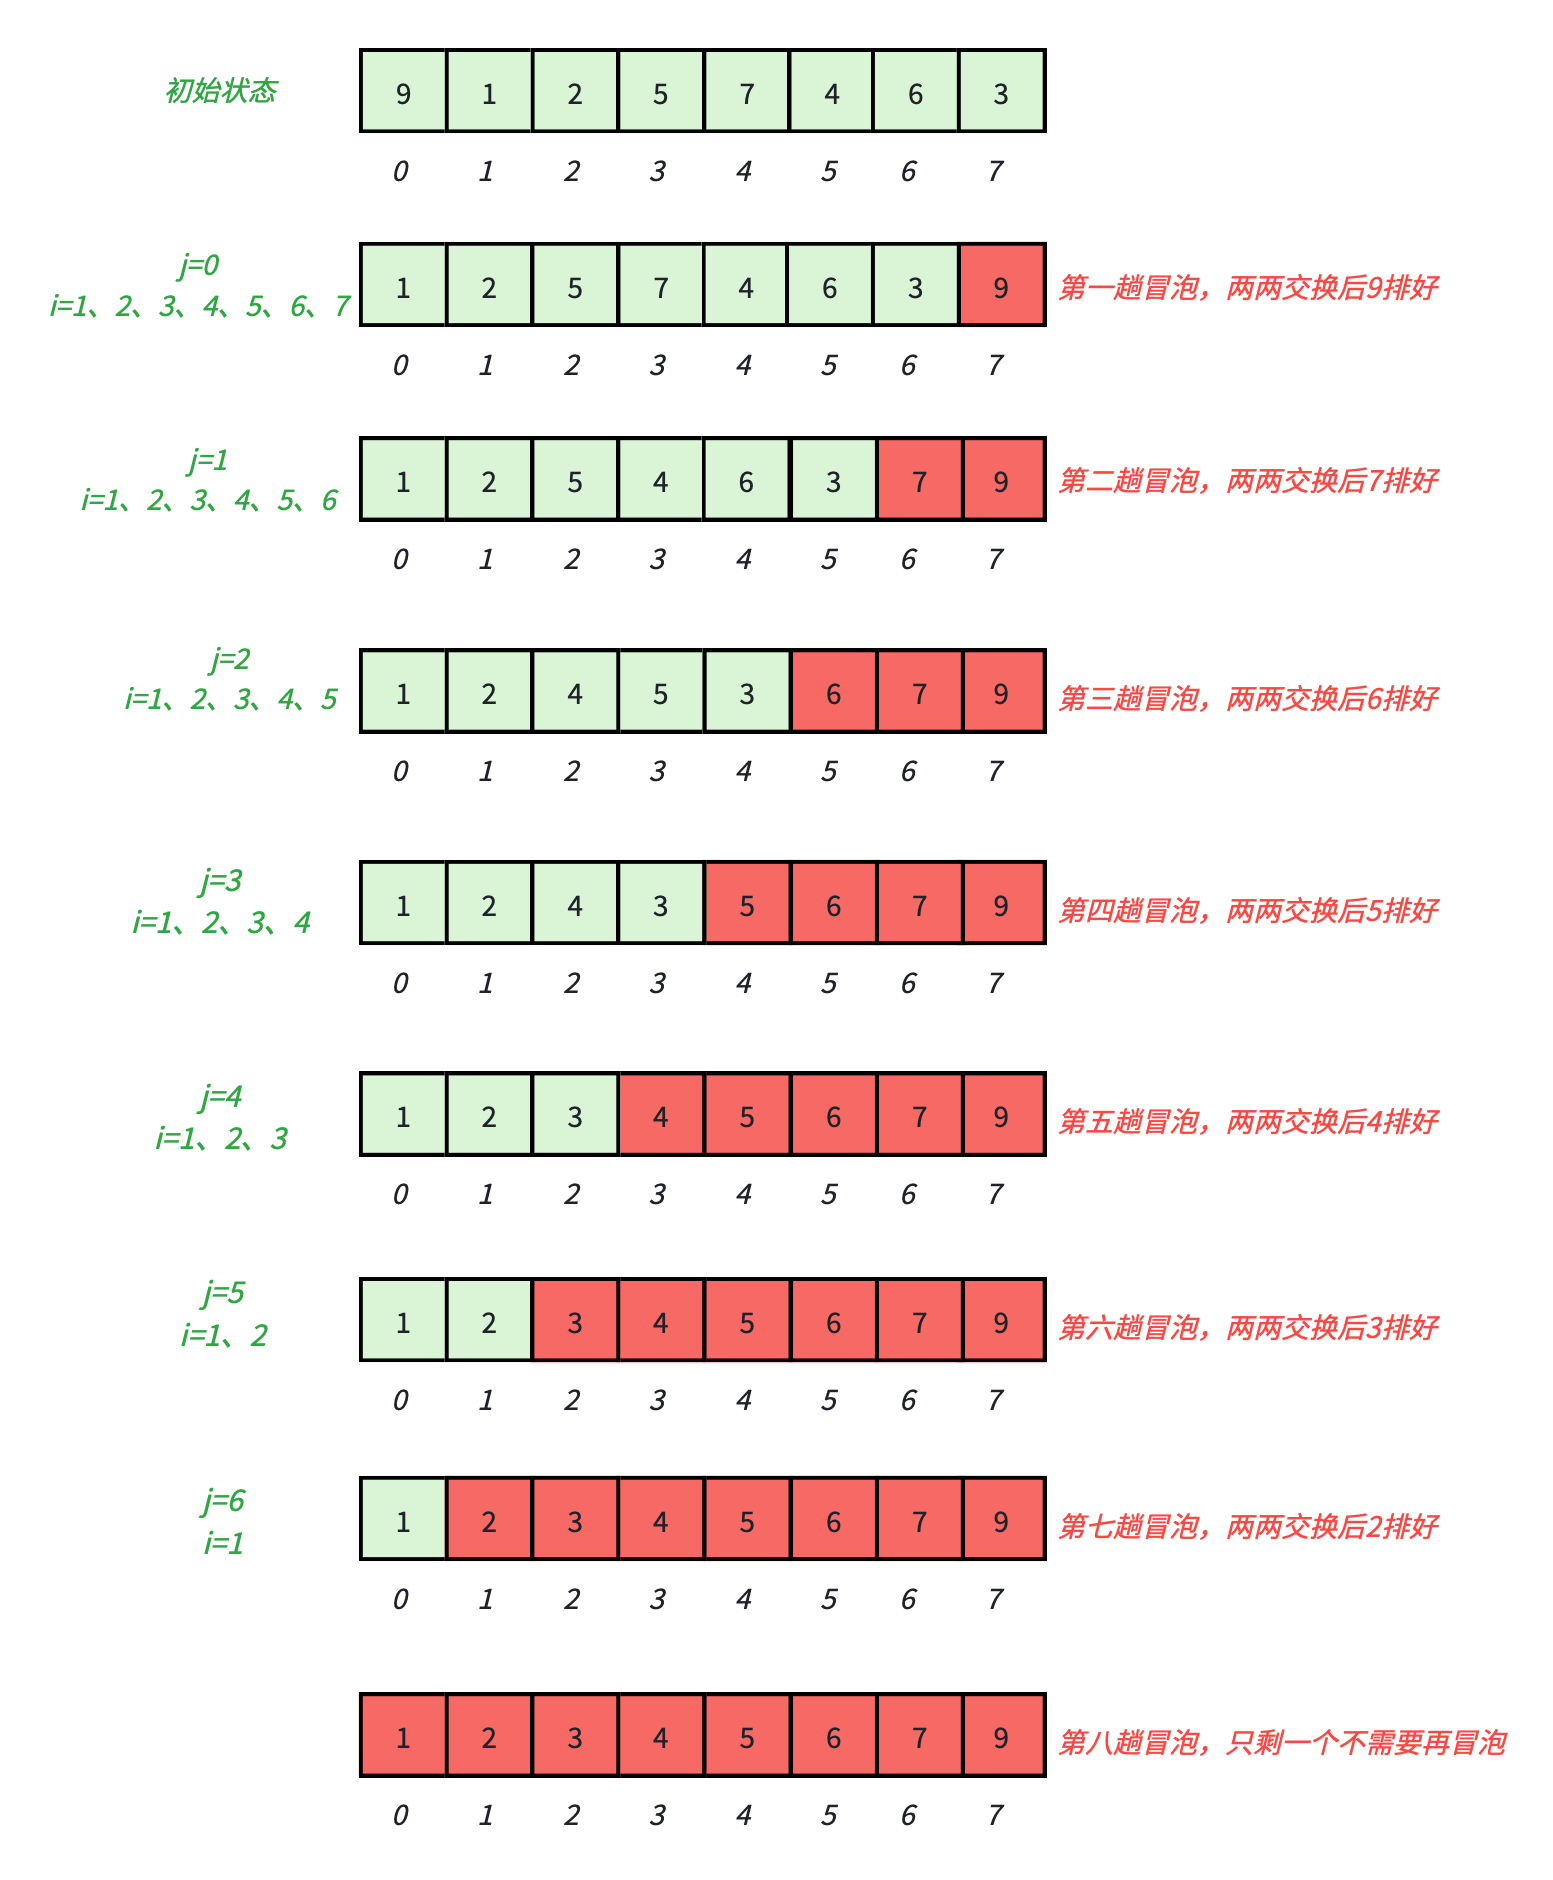
代码演示
c
//冒泡排序
void BubbleSort(int* a, int n)
{
	for (int j = 0;j < n - 1;j++)
	{
		int flag = 0;
		for (int i = 1;i < n-j;i++)
		{
			if (a[i - 1] > a[i])
			{
				Swap(&a[i - 1], &a[i]);
				flag = 1;
			}
		}
		//flag == 0代表在上⼀趟冒泡两两⽐较中,⼀次交换都没发⽣,则说明这段序列已经有序。
		if (flag == 0)
		{
			break;
		}
	}
}
4.1.2复杂度和稳定性
最坏情况下,序列逆序,累积⽐较次数为1⾄n-1的等差数列,所以冒泡排序时间复杂度 为 O ( n 2 ) O(n^2) O(n2)。
最好情况下,序列正序,⽐较n-1次,没有发⽣交换,时间复杂度为 O ( n ) O(n) O(n)。
冒泡排序只需要常数个辅助变量,空间复杂度为 O(1)。
冒泡排序⽐较时,前⼀个元素等于后⼀个元素时不交换,则可以保持稳定性。
4.2快速排序
4.2.1思想及过程
快速排序是由C.A.R.Hoare在1960年提出的,基于分治思想。它是在待排序区间中任取一个元素作为枢轴(pivot,或称基准值,通常选取区间⾸元素),然后按照基准值大小将区间中元素分割成左右两部分,左侧区间中元素小于等于基准值,右侧区间中元素大于等于基准值(升序是这样,降序就是反过来),即基准值已经放在最终该放的位置上,该过程称为⼀次单趟划分。划分结束后再对基准值左右两段⼦区间重复执⾏上述过程的过程(⼀般使⽤递归),直到⼦区间只有⼀个值或者不存在。
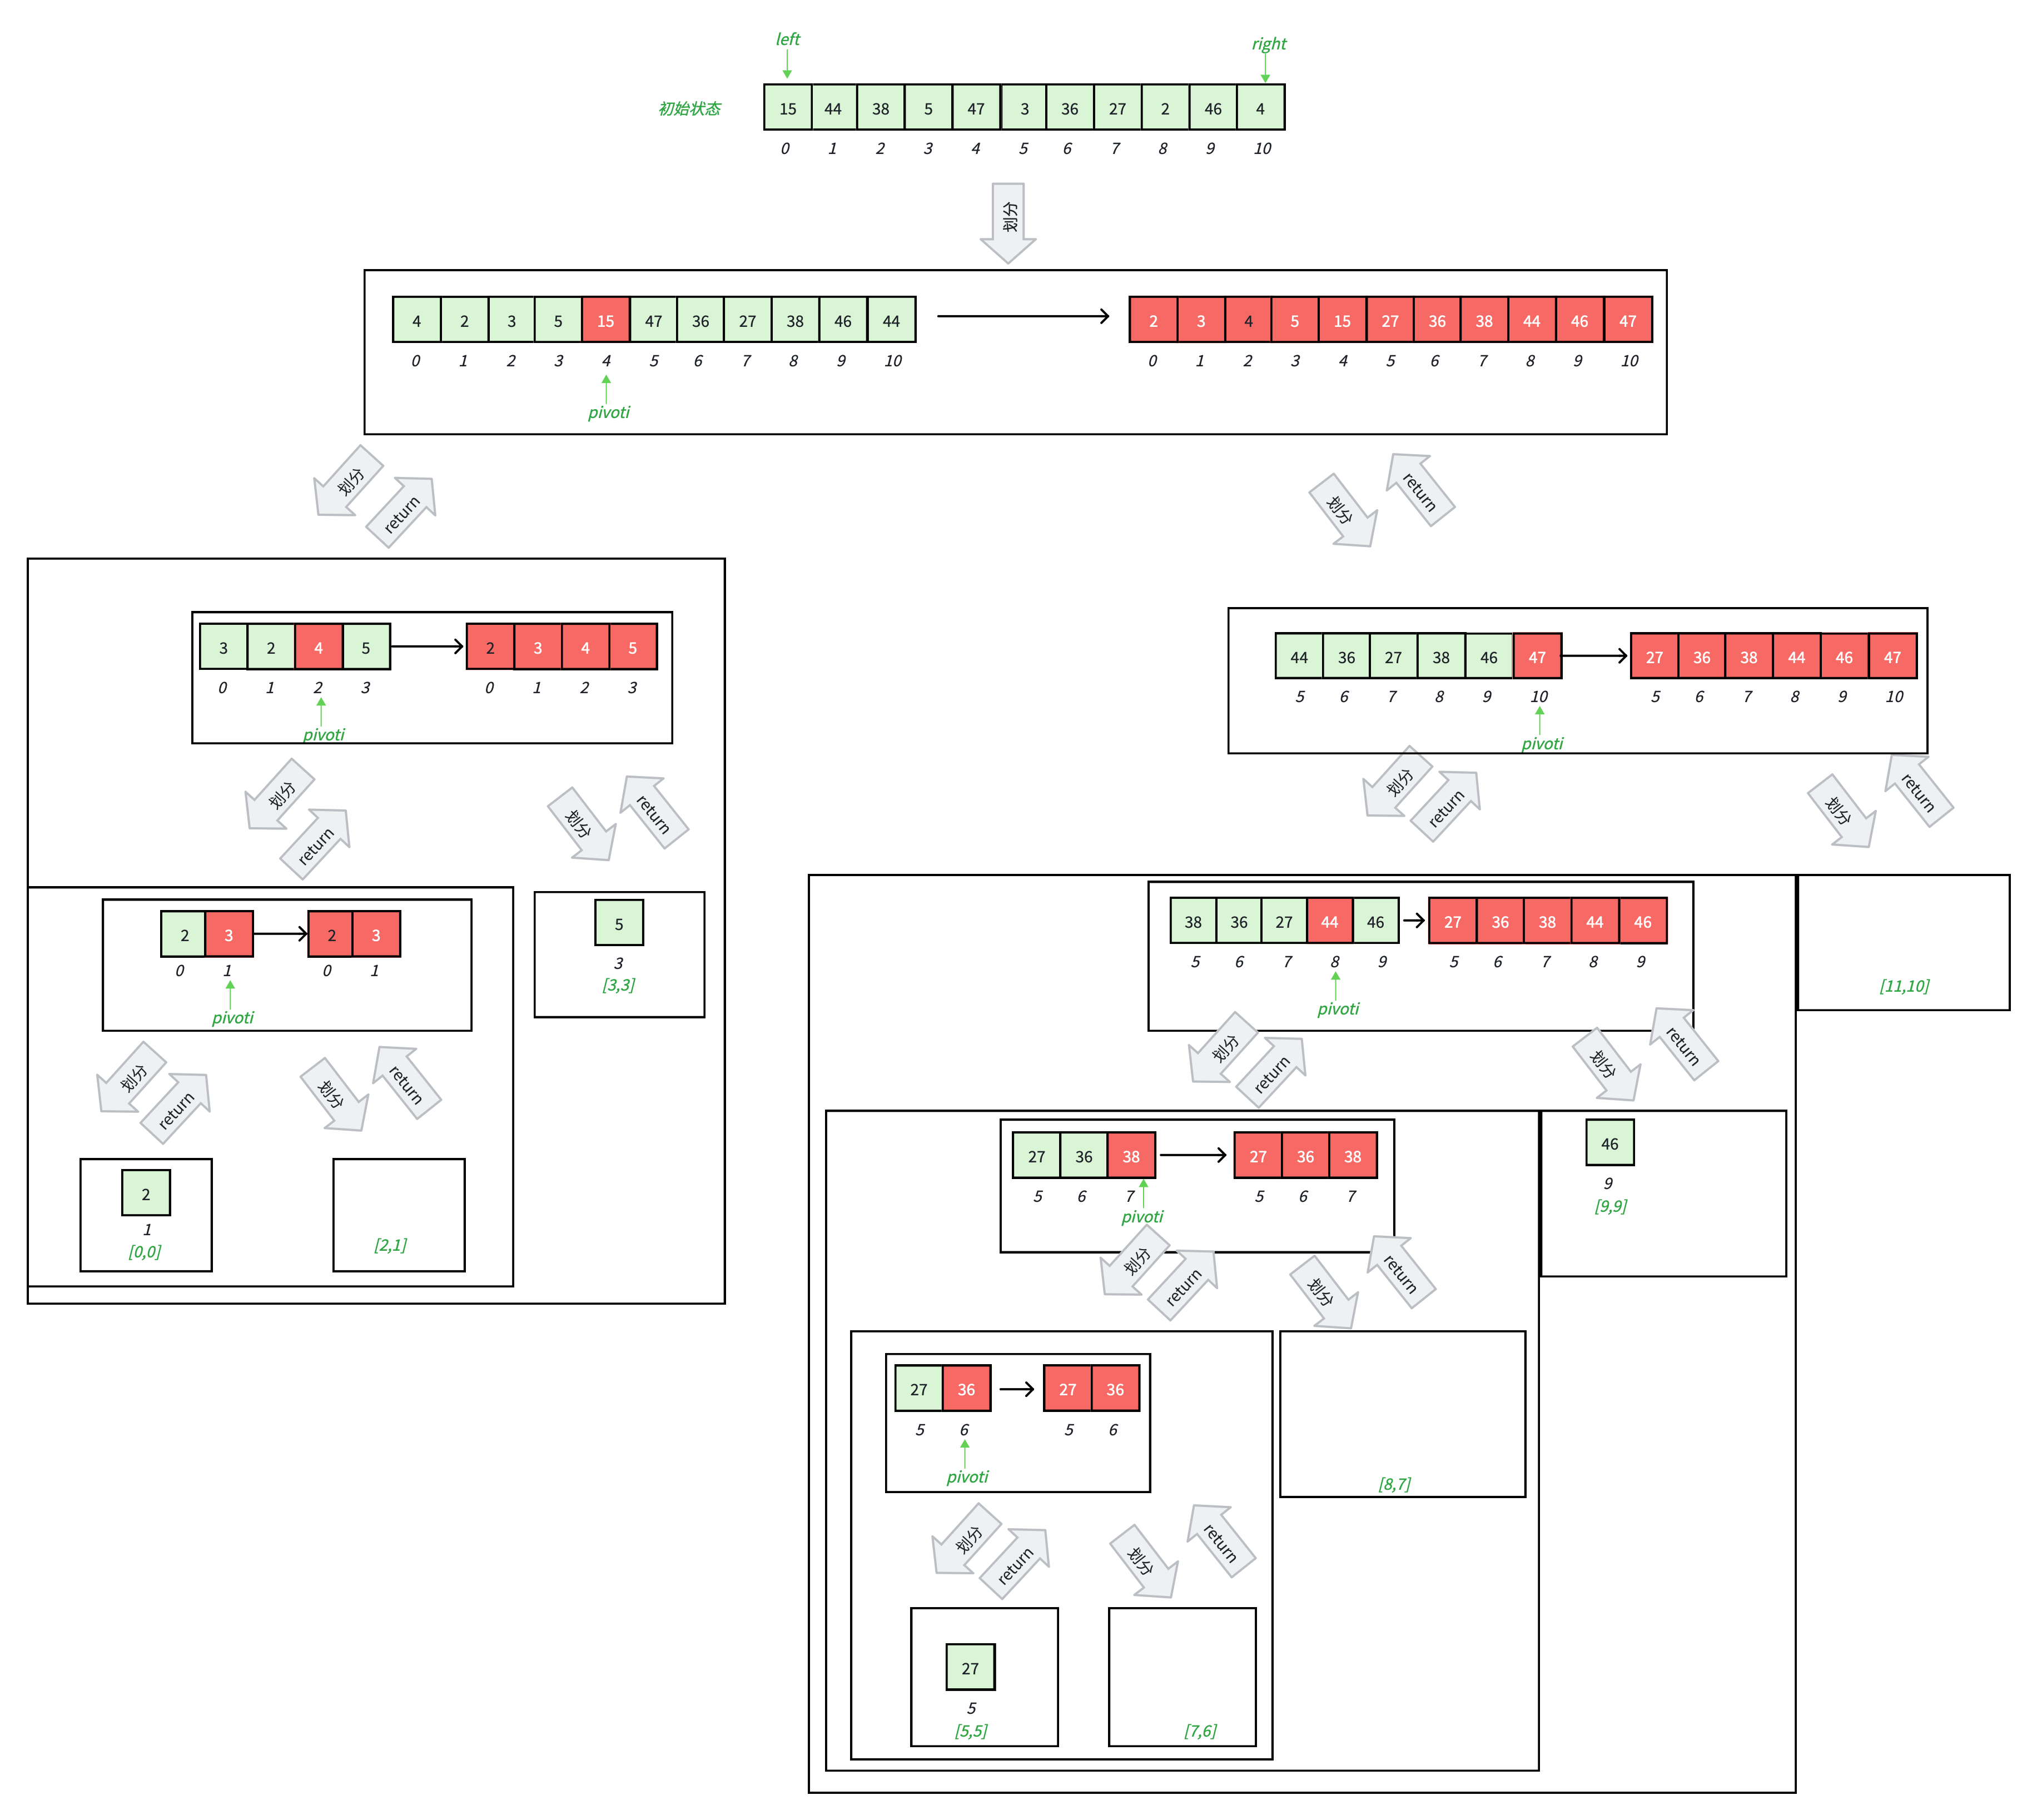
快速排序整体代码演示
c
//快速排序
void QuickSort(int* a, int left,int right)
{
	if (left >= right)
	{
		return;
	}

	//挖坑法/Lomuto的⽅法进⾏单趟划分
	int pivotkey = Partition(a,left,right);

	//递归左右子区间
	QuickSort(a, left, pivotkey - 1);
	QuickSort(a, pivotkey+1, right);
}
4.2.1.1单趟划分方法
4.2.1.1.1挖坑法单趟划分
挖坑法的过程:
1.假设用最左边的值做枢轴基准值,把最左边的值保存到变量pivotkey中,形成第一个坑
2.在right上找比基准值pivotkey小的,若有则直接入坑并且right处变为新坑,若没有则执行right--,直到找到后入坑并且right处变为新坑。
3.在left上找比基准值pivotkey大的,若有则直接入坑并且left处变为新坑,若没有则执行left++,直到找到后入坑并且left处变为新坑。
4.不断重复2和3,直到left和right相遇,left和right一定会在最新的坑的位置相遇,再把之前保存的基准值pivotkey放到这里,就完成了单趟划分。
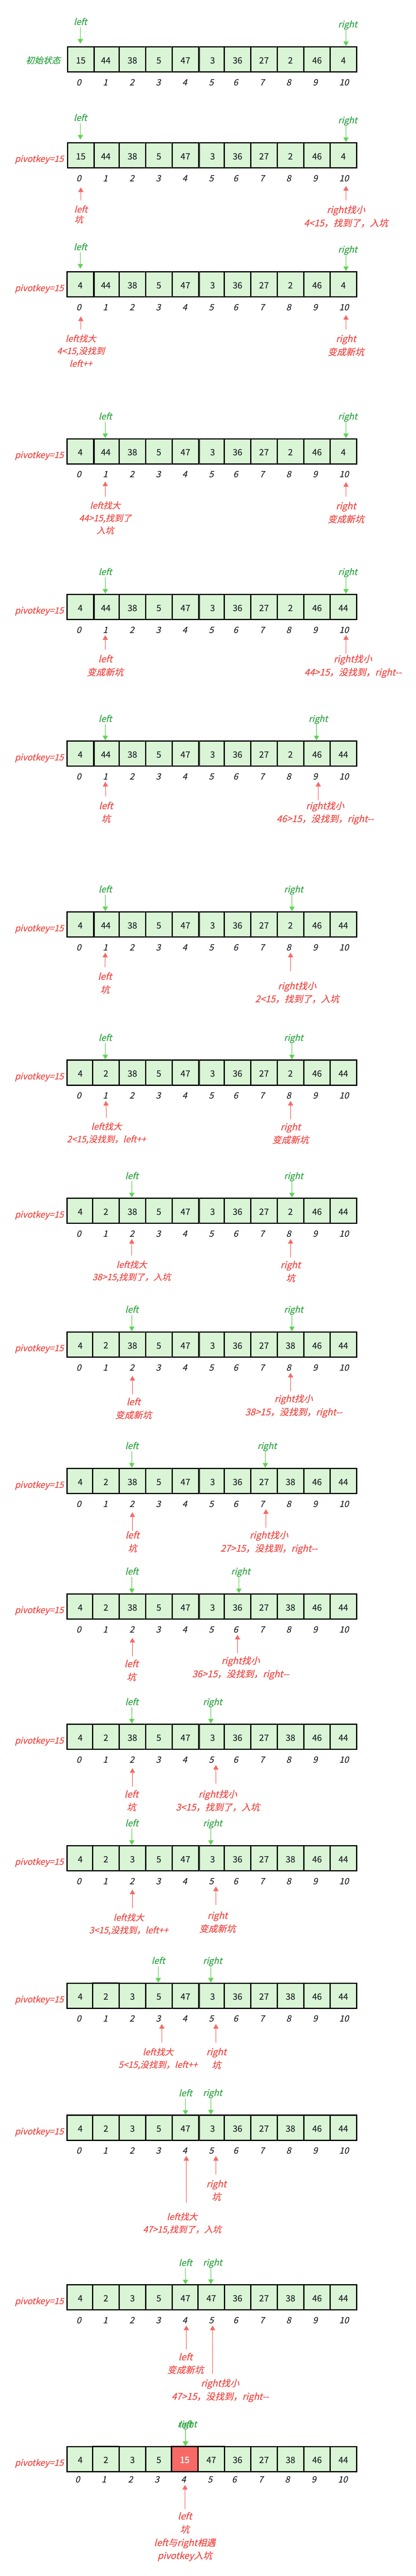
代码演示
c
int PartitionDigHole(int* a, int left, int right)
{
	//假设第一个是基准值
	 int pivotkey = a[left];
	//left与right未相遇时
	while (left < right)
	{
		//右侧找小
		while (left < right && a[right] >= pivotkey)
		{//没找到,--
			right--;
		}
		//右边的⼩的放到左边的坑,并使right变为新坑
		a[left] = a[right];

		//左侧找大
		while (left < right && a[left] <= pivotkey)
		{
			//没找到,++
			left++;
		}

		//左边大的放到右边的坑,并使left变为新坑
		a[right] = a[left];
	}
	//left与right相遇,pivotkey入坑
	a[left] = pivotkey;

	return left;
}
4.2.1.1.2Lomuto的单趟划分
Lomuto单趟划分的过程:
1.假设用最右边的值作枢轴基准值pivotkey
2.用prev和cur双指针一前一后指向区间开始的地方。
3.用cur指针去寻找比基准值pivotkey小的值,跟++prev位置的值交换(++prev位置的值一定比基准值大)这里就是把比pivotkey小的值放到前面,比pivotkey大的值放到后面。
4.不断重复3的操作,直到cur走到右边界pivotkey的位置结束,交换prev+1和pivotkey位置的值,这样pivotkey就来到了中间,pivotkey左边的区间小于pivotkey,pivotkey右边的区间大于pivotkey。
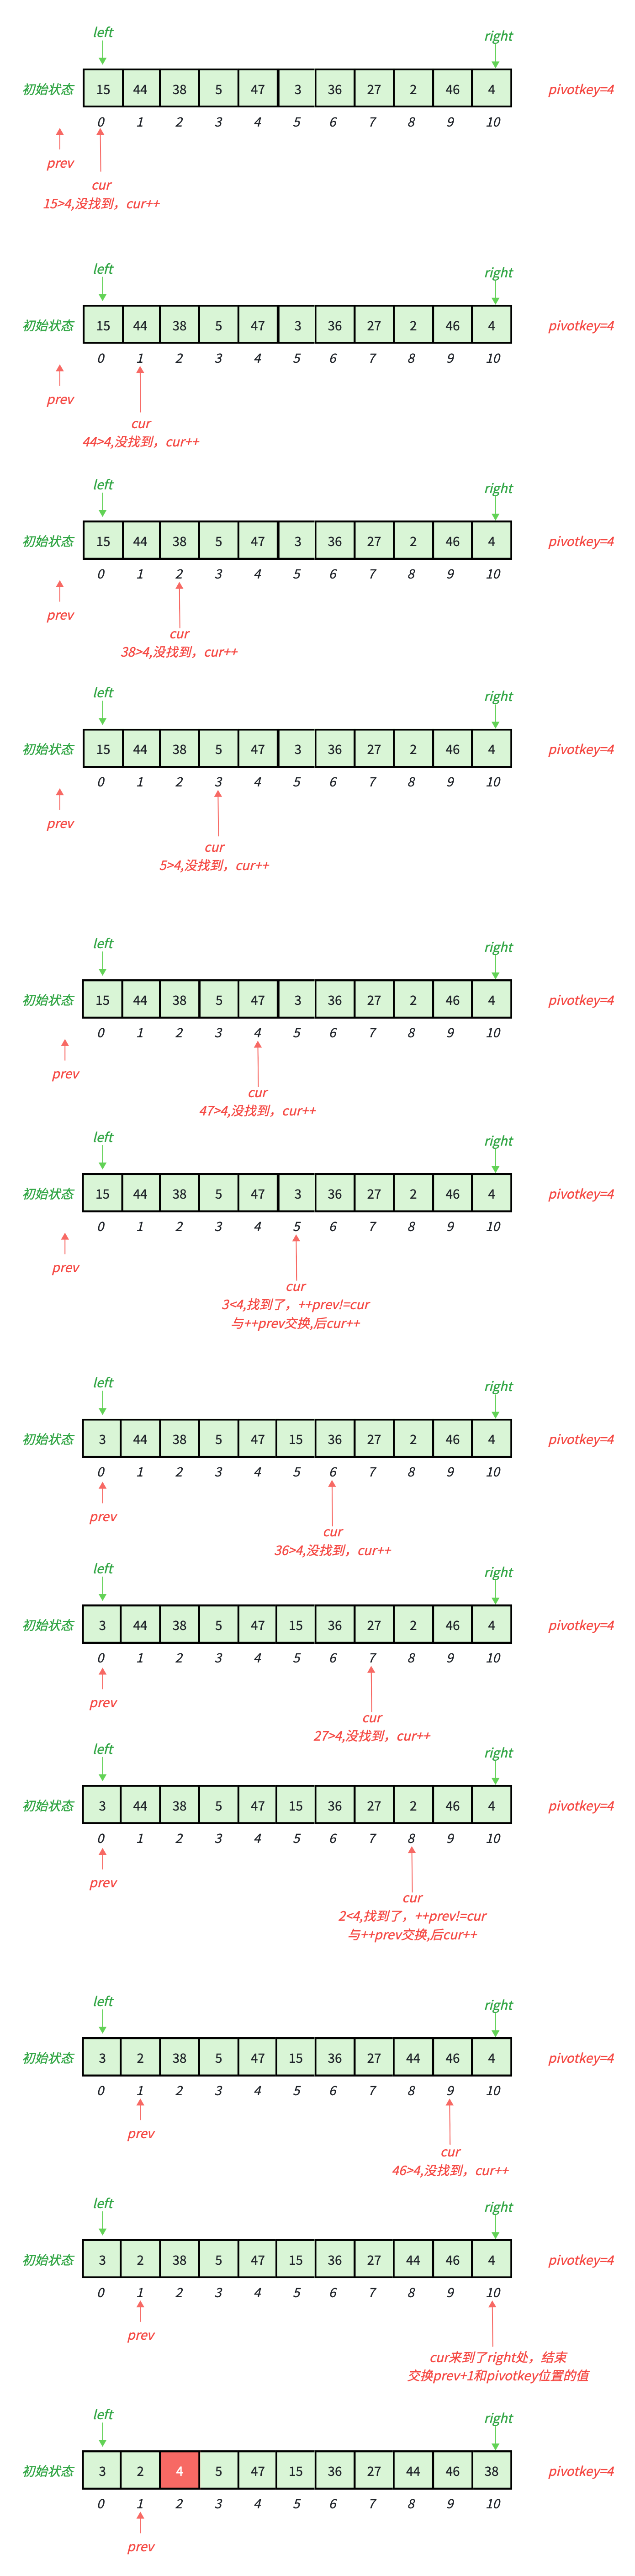
代码演示
c
int PartitionLomuto(int* a, int left, int right)
{
	int pivotkeyi = right;
	int prev = left-1;
	int cur = left;
	while (cur < right)
	{
		if (a[cur] < a[pivotkeyi]&&++prev!=cur)
		{
			Swap(&a[prev], &a[cur]);
		}
		cur++;
	}
	Swap(&a[prev + 1] , &a[pivotkeyi]);

	return prev + 1;
}
4.2.2复杂度和稳定性
快速排序效率取决于基准值的选取
如果每次选择的基准值恰巧都能将区间中元素分割成左右⼏乎相等的两部分,快排的效率会达到最优,整个递归过程展开近似⼀颗平衡⼆叉树。整体⽽⾔对每⼀层序列进⾏划分为 O ( n ) O(n) O(n),递归的深度为 l o g 2 n log_2n log2n,因此最好情况时间复杂度为 O ( n l o g n ) O(nlogn) O(nlogn),空间复杂度是 O ( l o g n ) O(logn) O(logn)。
如果每次选择的基准值恰巧是区间的最⼩值或最⼤值(有序时就会),快排的效率会达到最坏,n个数据的区间被划分为n-1个和0个的⼦区间,整体划分是⼀个1到n的等差数列,因此最坏情况时间复杂度为 O ( n 2 ) O(n^2) O(n2)。空间复杂度是 O ( n ) O(n) O(n)
是快速排序的平均时间复杂度 为 O ( n l o g n ) O(nlogn) O(nlogn),空间复杂度 是 O ( l o g n ) O(logn) O(logn),快速排序基本是同级中平均性能最优的排序。
快速排序**⽆法保持稳定性**。如: {2,2,2,2,2} 单趟划分以后相对顺序就乱了。
快速排序每次选取区间最左边或者最右边的值做基准值,有序时⼀定会出现最坏情况,所以我们可以针对性的优化⼀下:
- 三数取中。每次取区间的最左边/最右边/中间位置的三个值中的中位数作为基准值,这样有序场景就会瞬间变为最好情况。
- 随机选基准值。每次单趟划分时利⽤随机函数在区间内随机选取⼀个值作为基准值。
c
//挖坑法改造------随机选基准值
int PartitionDigHole_(int* a, int left, int right)
{
	//随机生成一个基准值
	int pivoti = left + rand() % (right - left + 1);
	Swap(&a[pivoti], &a[left]);
	int pivotkey = a[left];
	//left与right未相遇时
	while (left < right)
	{
		//右侧找小
		while (left < right && a[right] >= pivotkey)
		{//没找到,--
			right--;
		}
		//右边的⼩的放到左边的坑,并使right变为新坑
		a[left] = a[right];

		//左侧找大
		while (left < right && a[left] <= pivotkey)
		{
			//没找到,++
			left++;
		}

		//左边大的放到右边的坑,并使left变为新坑
		a[right] = a[left];
	}
	//left与right相遇,pivotkey入坑
	a[left] = pivotkey;

	return left;
}
c
//Lomotu改造------随机选基准值
int PartitionLomuto_(int* a, int left, int right)
{
	//随机生成一个基准值
	int pivotkeyi = left + rand() % (right - left + 1);
	Swap(&a[pivotkeyi], &a[right]);
	pivotkeyi = right;

	int prev = left - 1;
	int cur = left;
	while (cur < right)
	{
		if (a[cur] < a[pivotkeyi] && ++prev != cur)
		{
			Swap(&a[prev], &a[cur]);
		}
		cur++;
	}
	Swap(&a[prev + 1], &a[pivotkeyi]);

	return prev + 1;
}
4.2.3排序数组
使⽤Lomuto和挖坑法都⽆法AC这个OJ;加上三数取中或者随机选取基准值也⽆法通过;因为最终有⼀组⼤量重复元素的测试⽤例,Lomuto和挖坑法没办法单趟划分都很极端,导致效率退化。
5、归并排序
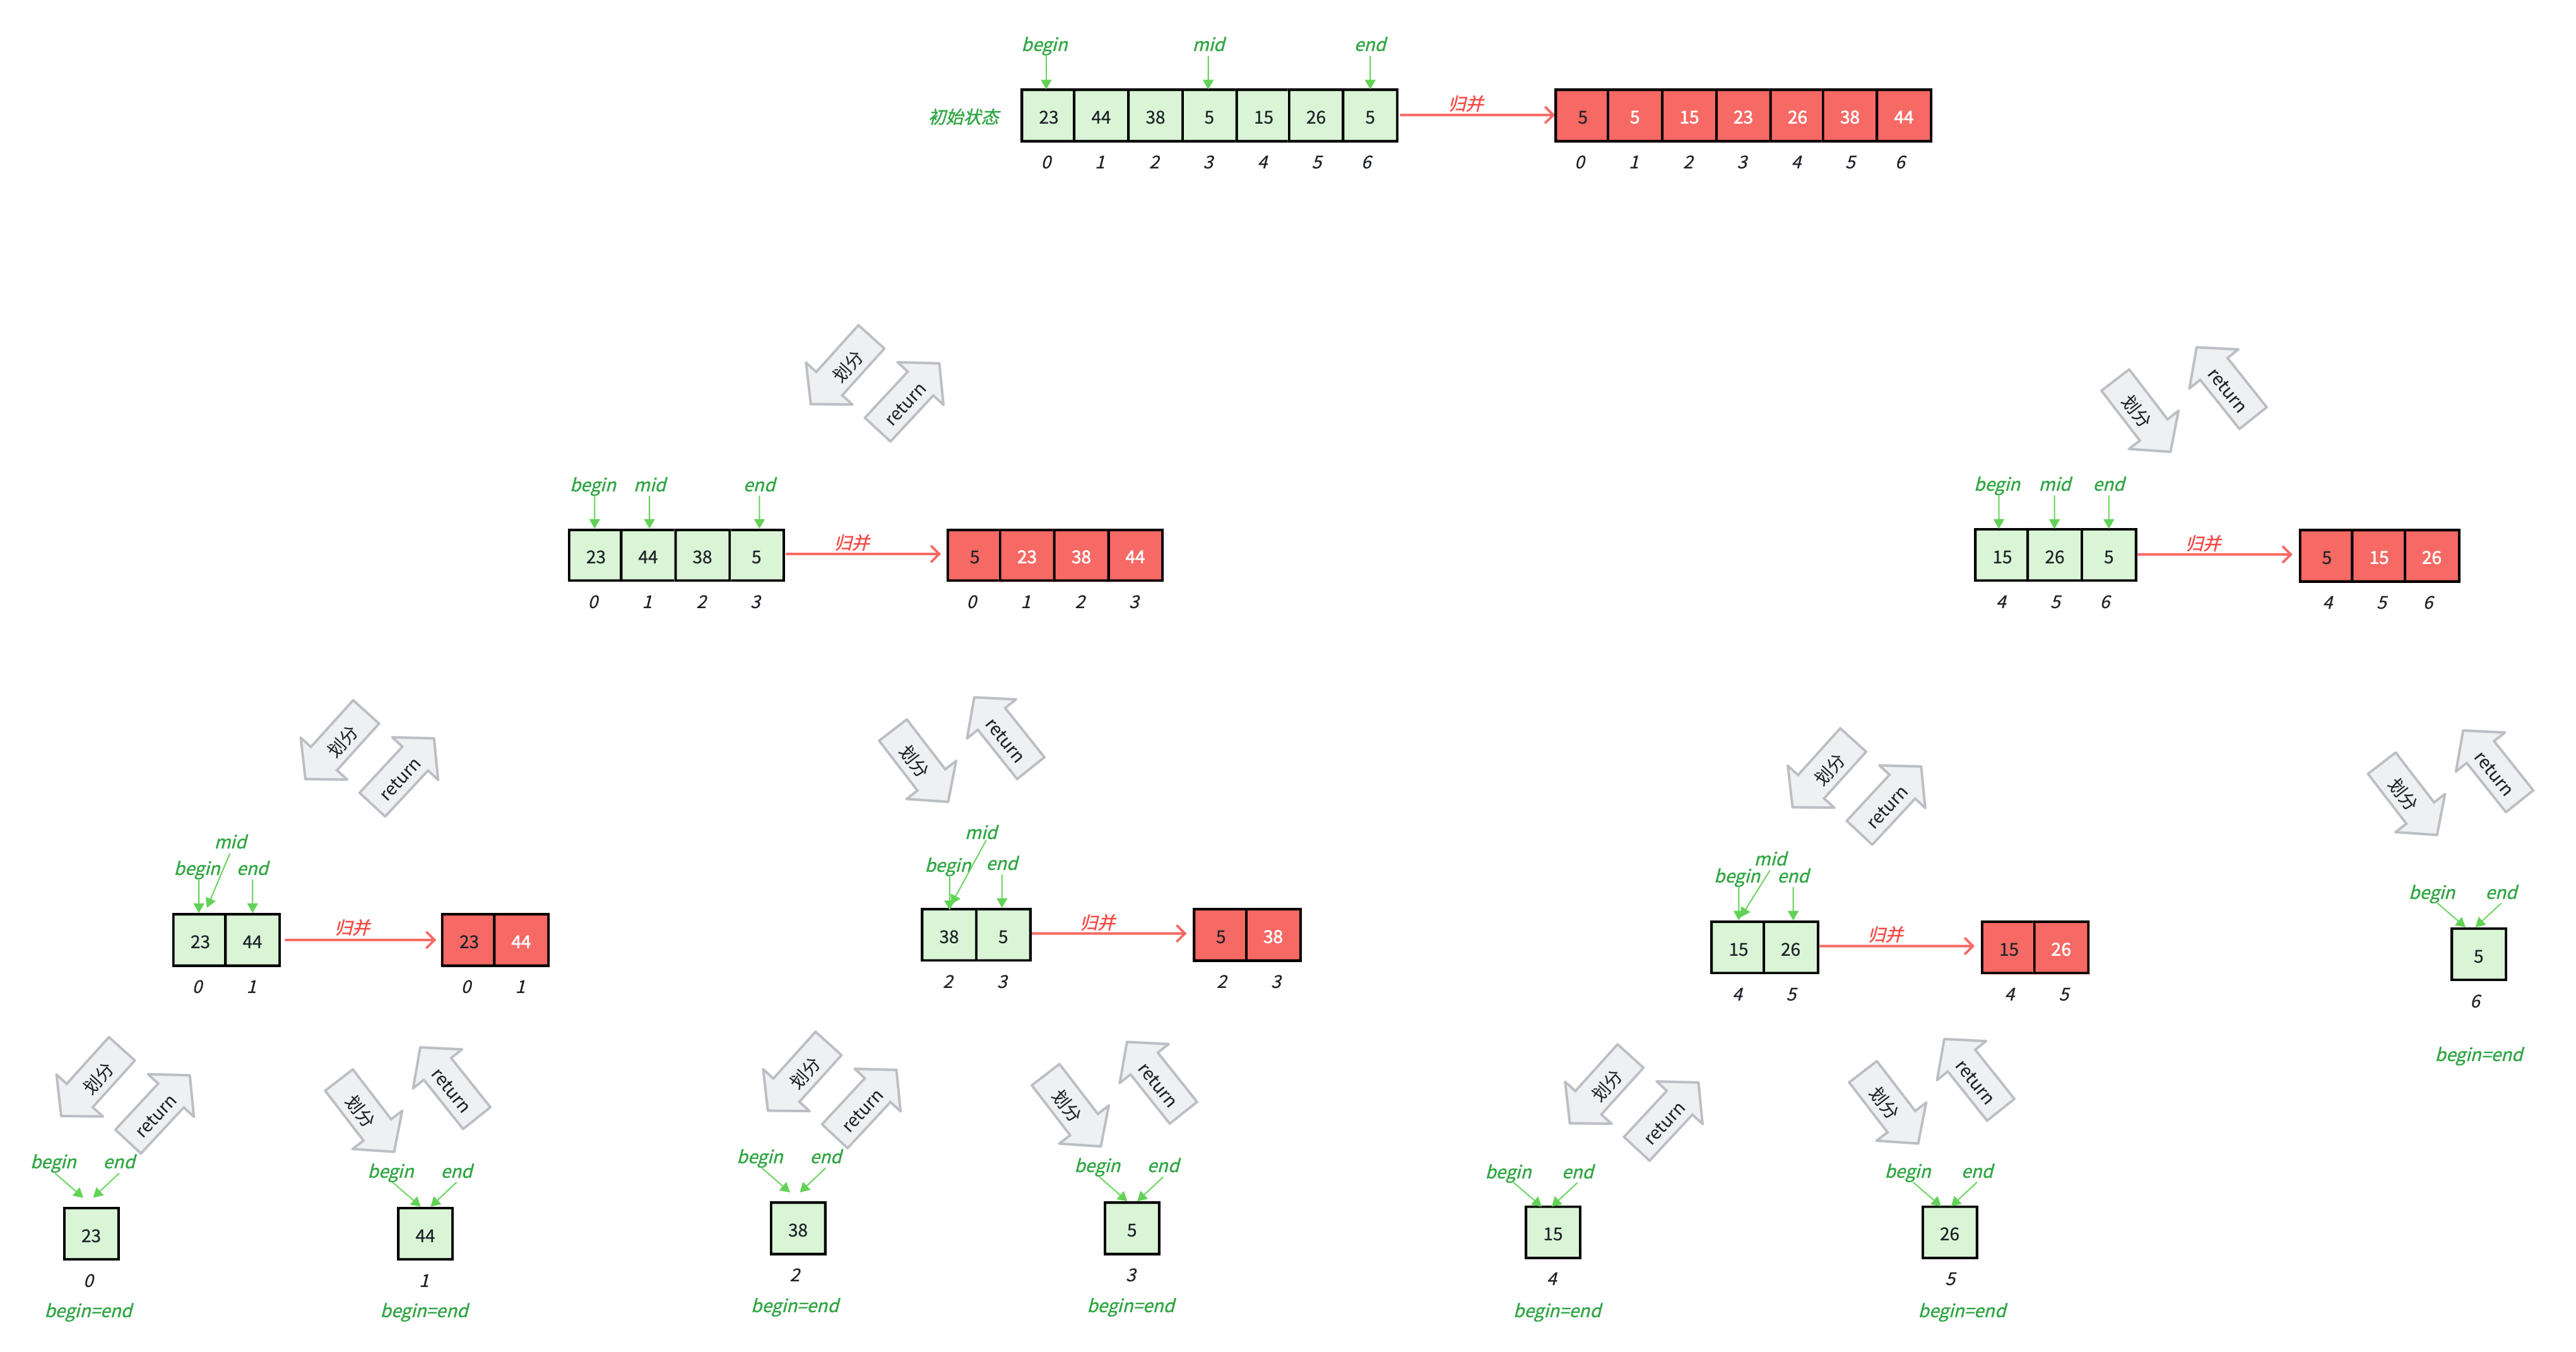
5.1思想及过程
归并的含义是将两个或两个以上的有序表合并成一个新的有序表。链表归并可以直接取结点下来归并,数组归并则必须借助⼀个额外的数组空间归并,归并后再拷⻉回去。
归并的过程:
- 1.
begin1和begin2分别指向a数组两段有序区间 ,i指向tmp数组的开始位置。 - 2.
begin1和begin2的值进行比较,取小(相等取begin1)的赋值到tmp[i],i++,小的位置下标++。 - 3.不断重复2过程,直到其中一个区间结束。最后把还没结束的区间的值依次拷贝到
tmp数组中。
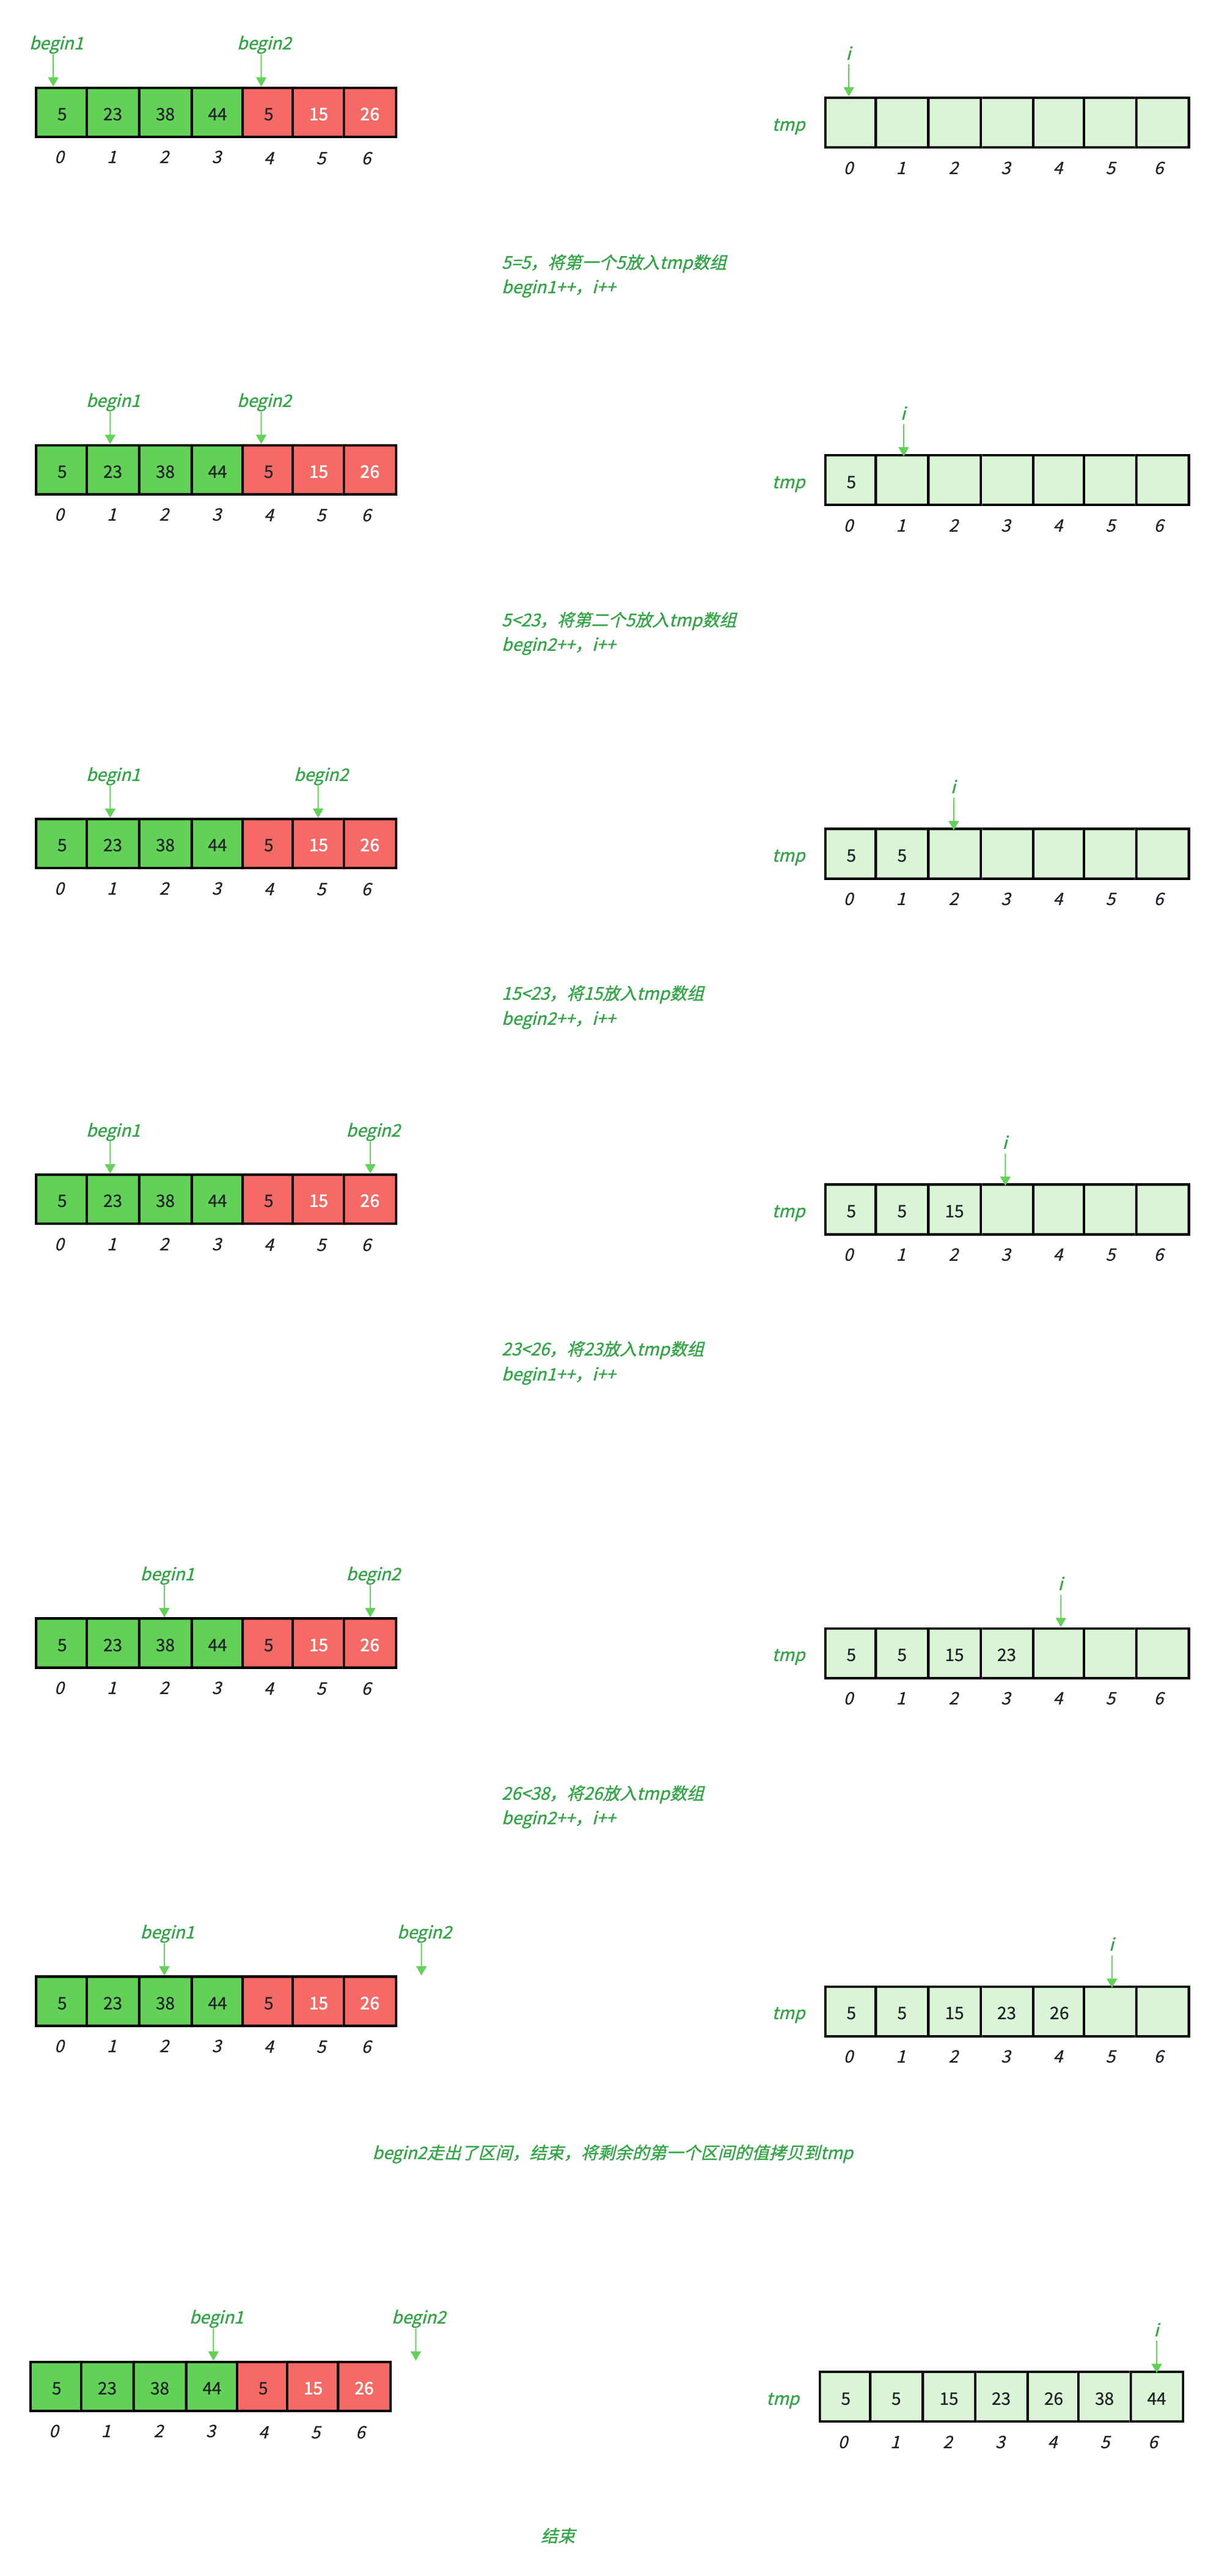
如果⼀个数组分成两个⼦数组,⼦数组有序了,两个⼦数组归并⼀下,整体就有序了。
那么如何让子数组有序,我们类似快排使⽤分治的思想即可,不断递归划分数组,直到⼦数组为1个值的区间时返回,递归回退时进⾏归并。
代码演示
c
//归并子函数------递归
void _MergeSort(int* a, int* tmp, int begin, int end)
{
	if (begin >= end)
	{
		return;
	}

	int mid = (begin + end) / 2;
	_MergeSort(a, tmp, begin, mid);
	_MergeSort(a, tmp, mid + 1, end);

	//归并
	int begin1 = begin, end1 = mid;
	int begin2 = mid + 1, end2 = end;
	int i = begin;

	while (begin1 <= end1 && begin2 <= end2)
	{
		if (a[begin1] <= a[begin2])
		{
			tmp[i++] = a[begin1++];
		}
		else
		{
			tmp[i++] = a[begin2++];
		}
	}

	//将剩余的放入到tmp中
	while (begin1 <= end1)
	{
		tmp[i++] = a[begin1++];
	}

	while (begin2 <= end2)
	{
		tmp[i++] = a[begin2++];
	}

	//将完成归并的拷贝回a中
	memmove(a, tmp, i * sizeof(int));
}

//归并排序
void MergeSort(int* a, int n)
{
	int begin = 0;
	int end = n - 1;
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL) {
		perror("malloc fail");
		return;
	}

	_MergeSort(a, tmp, begin, end);

	free(tmp);
	tmp = NULL;
}
5.2复杂度和稳定性
归并的过程两个有序子数组的时间复杂度是 O ( n ) O(n) O(n)。
和快速排序类似,归并排序的递归调用过程也是一棵二叉树。归并排序不存在最好和最坏的情况,因为每次都是均分,且数组数据分布不会影响他归并的复杂度,归并排序整体累计 l o g 2 n log_2n log2n层,每层归并为 O ( n ) O(n) O(n),所以整体时间复杂度 是 O ( n l o g n ) O(nlogn) O(nlogn)
归并排序的空间复杂度 为 O ( n ) O(n) O(n) 。
归并排序在归并⽐较相等时,让前半区间的值先归并则可以保持稳定性。
6、计数排序
6.1思想及过程
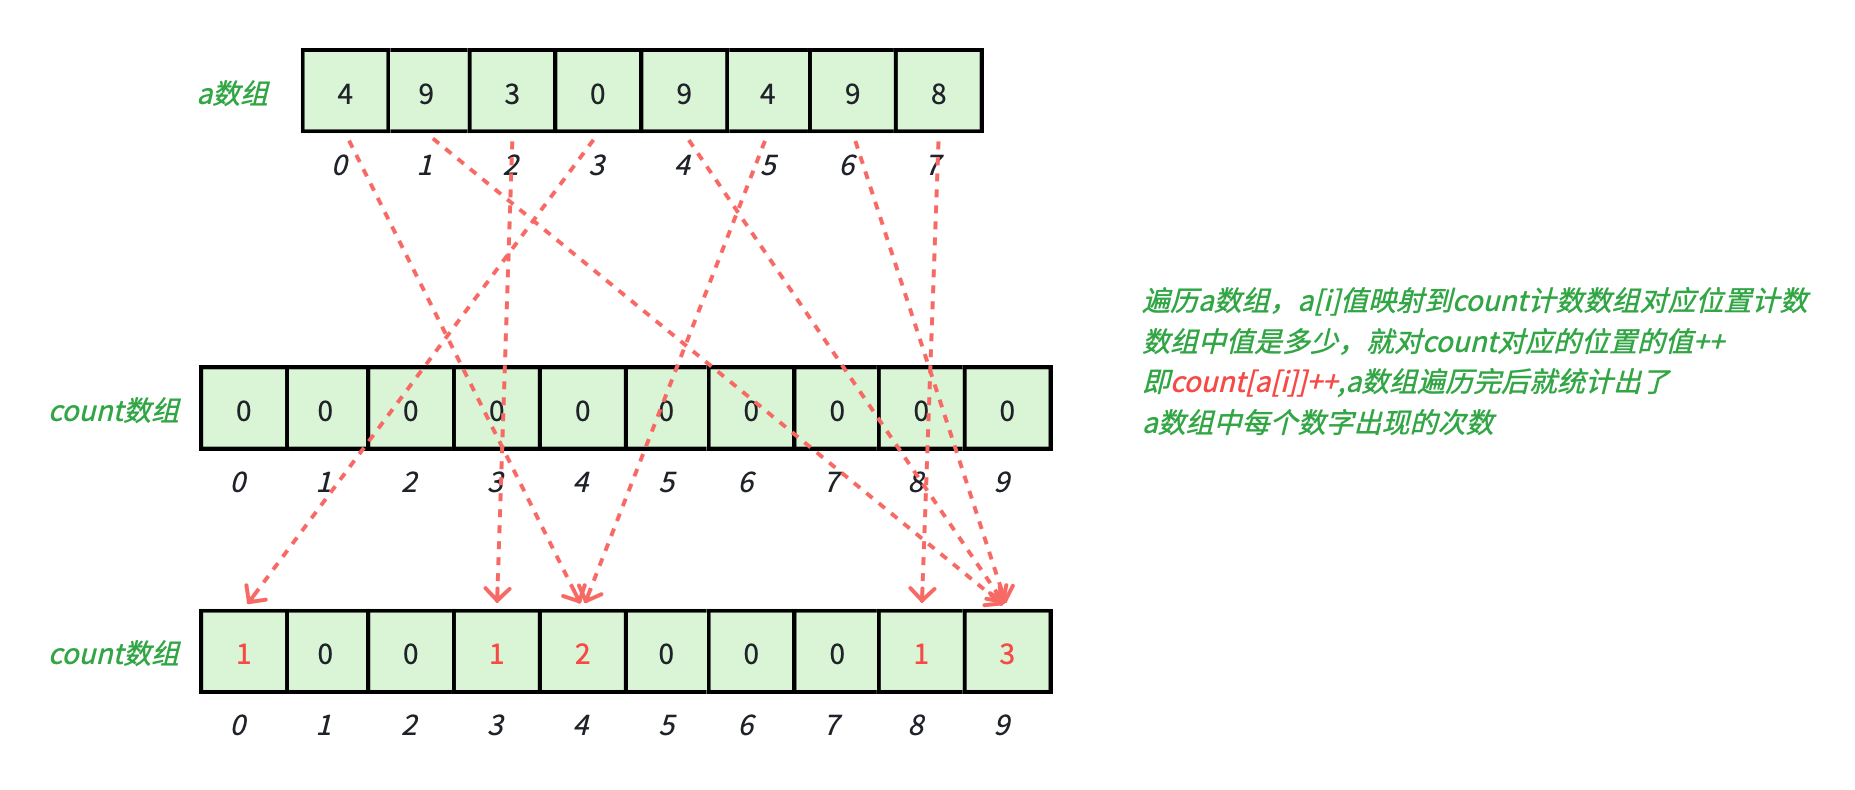
计数排序是一种非比较型的整数排序算法。它的核心算法不是通过"比较"元素大小来决定顺序,而是通过统计每个元素出现的次数,直接计算出该元素在最终有序数组中的位置。
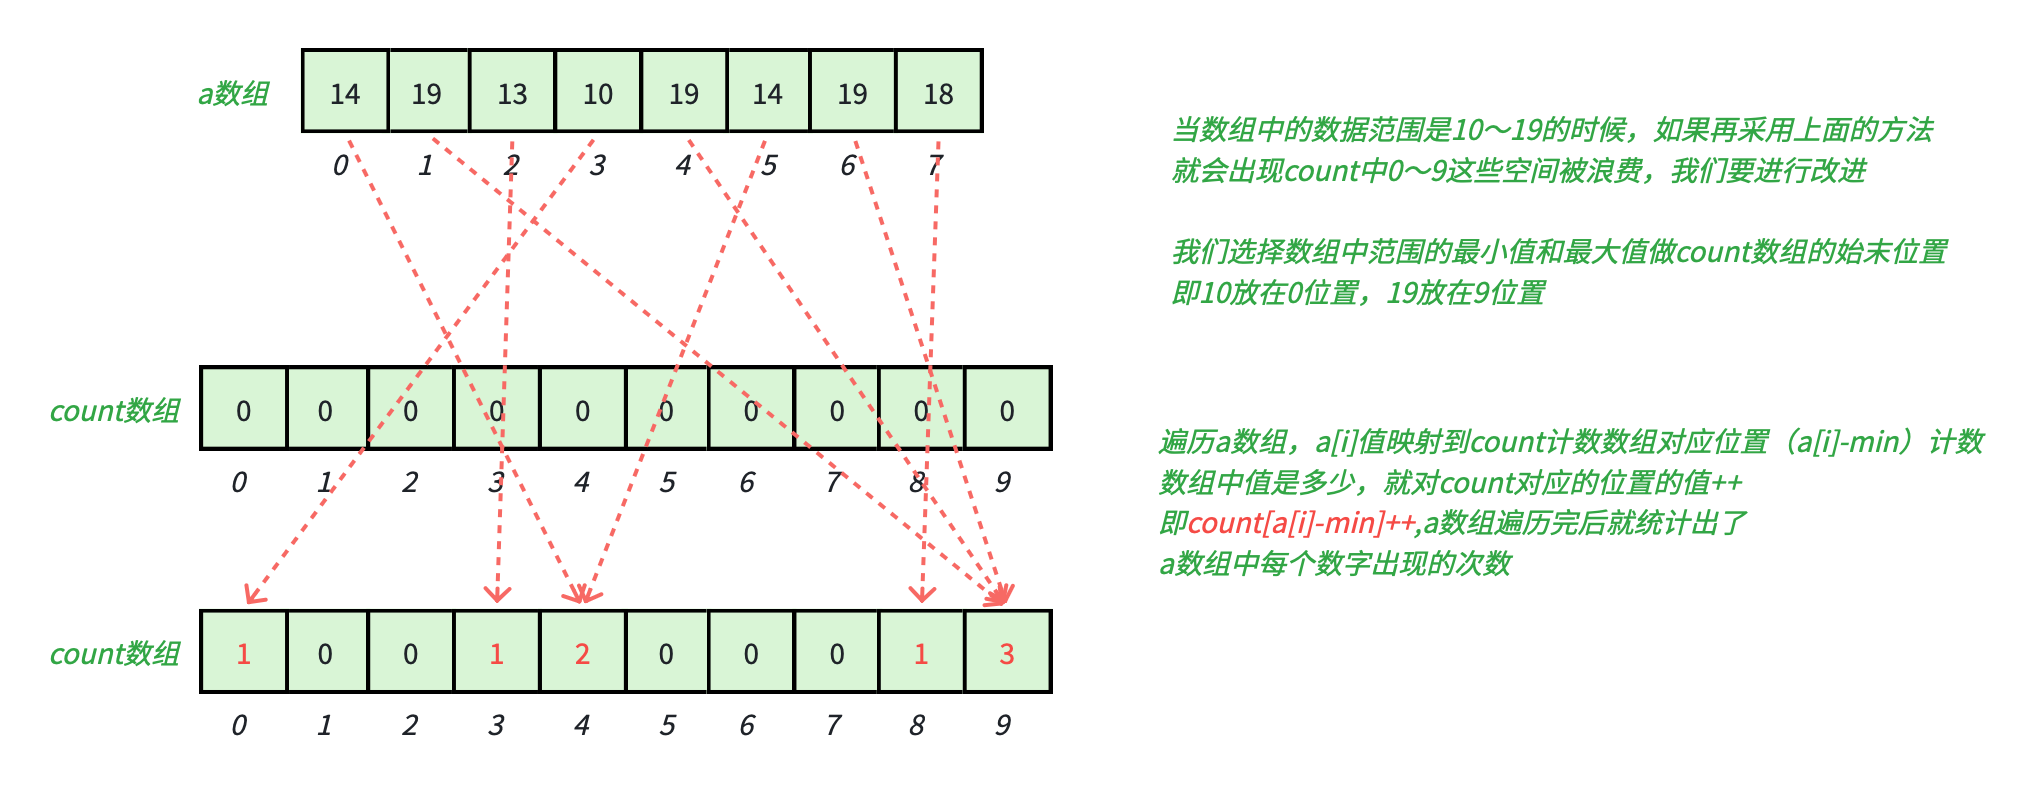
当数组中的数据范围是10~19的时候,如果再采用上面的方法就会出现count中0~9这些空间被浪费,我们要进行改进
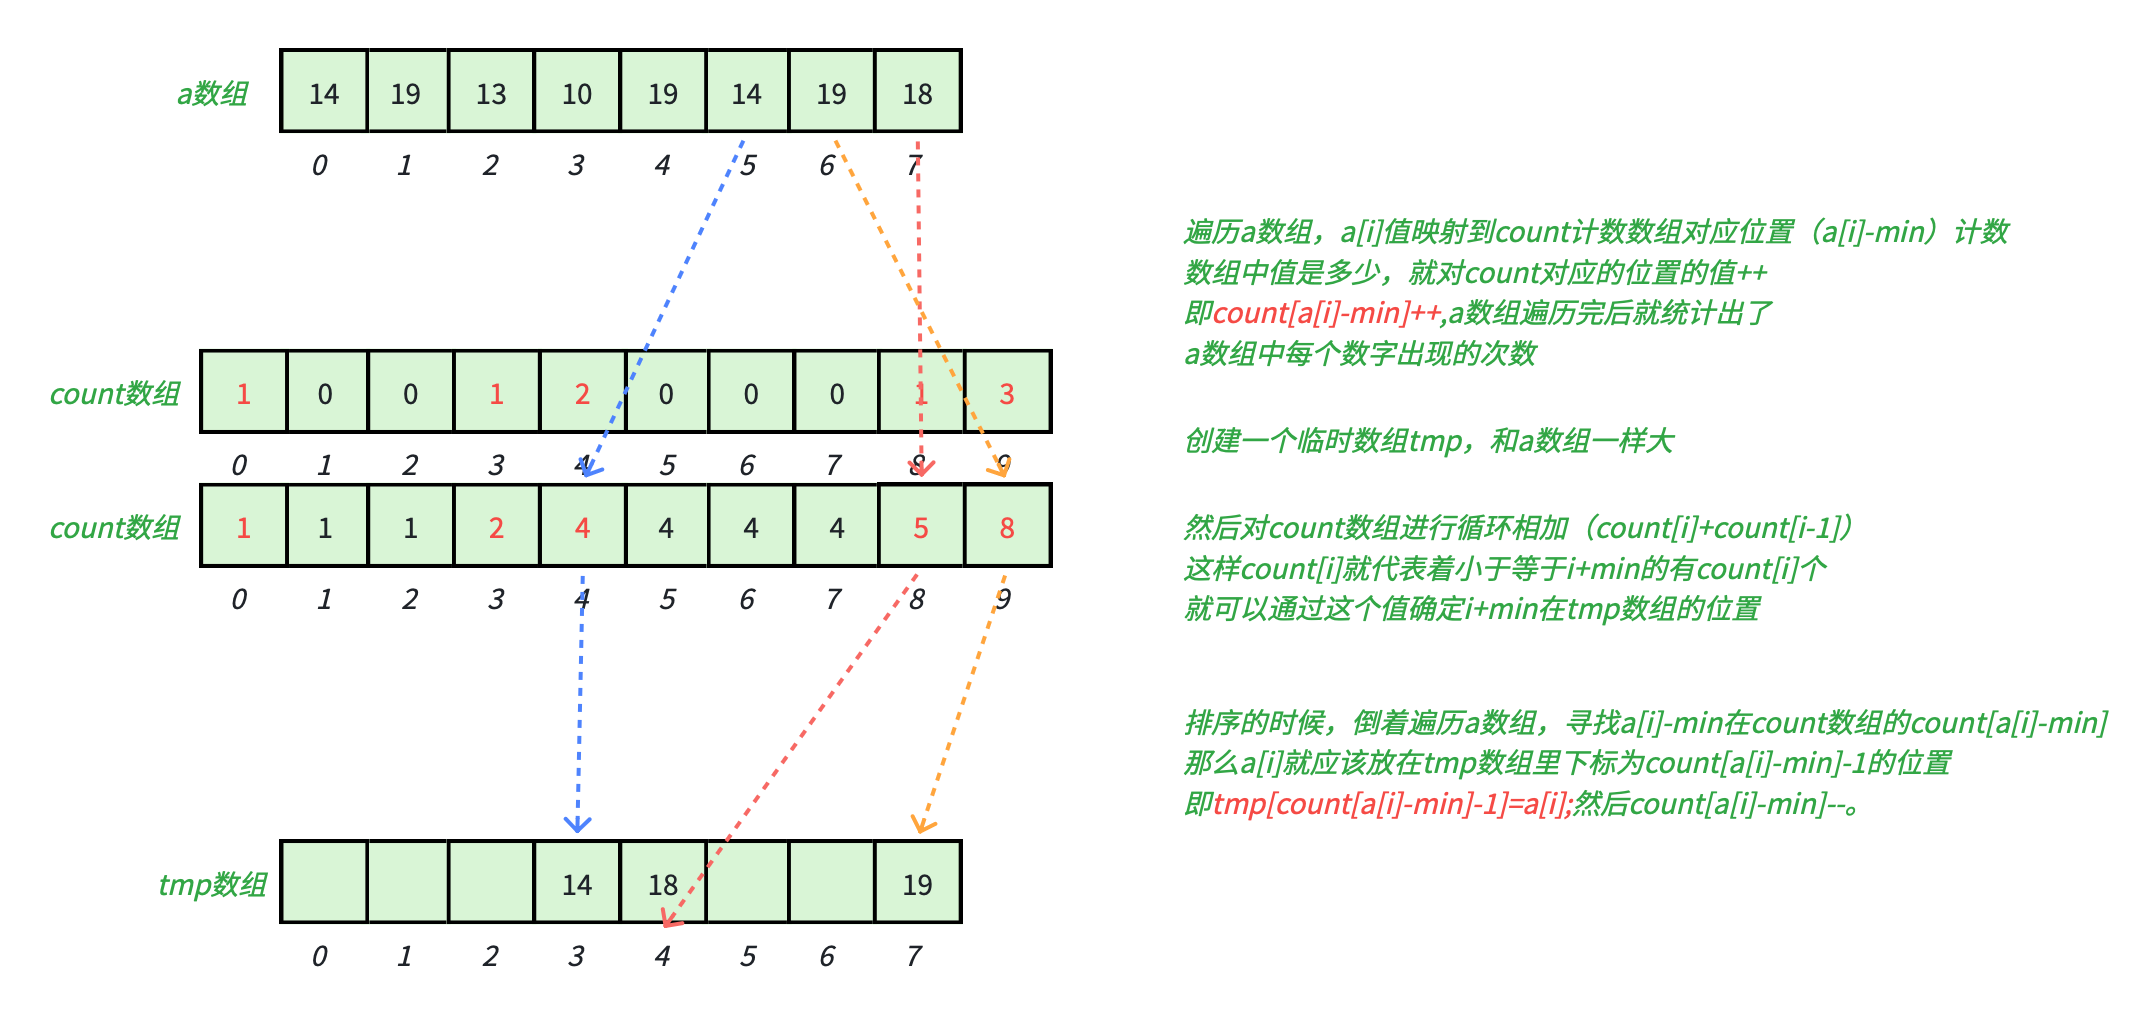
以上方法可以做到排序,但是无法保证稳定性,我们还要进行改造,以实现稳定性。
代码演示
c
//计数排序
void CountSort(int* a, int n)
{
	//寻找min,max
	int min = a[0];
	for (int i = 1;i < n;i++)
	{
		if (a[i] < min)
		{
			min = a[i];
		}
	}
	int max = a[0];
	for (int i = 1;i < n;i++)
	{
		if (a[i] > max)
		{
			max = a[i];
		}
	}
	int size = max - min + 1;
	//开辟临时数组tmp和count数组,并初始化为0;
	int* count = (int*)calloc(size, sizeof(int));
	int* tmp = (int*)calloc(n, sizeof(int));
	if (count == NULL || tmp == NULL)
	{
		perror("use calloc");
		return;
	}

	//统计a数组各个值的出现次数
	for (int i = 0;i < n;i++)
	{
		count[a[i] - min]++;
	}

	//对count数组进行循环相加
	for (int i = 1;i < size;i++)
	{
		count[i] += count[i - 1];
	}

	//通过count数组寻找a[i]在tmp数组的位置
	for (int i = n - 1;i >= 0;i--)
	{
		tmp[count[a[i] - min] - 1] = a[i];
		count[a[i] - min]--;
	}

	//将tmp数组拷贝回a数组
	memcpy(a, tmp, n * sizeof(int));

	free(tmp);
	free(count);
	tmp = NULL;
	count = NULL;
}
6.2复杂度和稳定性
假设n是数据个数,range是数据范围,则时间复杂度 是 O ( n + r a n g e ) O(n+range) O(n+range)
若range接近于n,则时间复杂度是 O ( n ) O(n) O(n),明显优于 O ( n l o g n ) O(nlogn) O(nlogn)级别的快排/堆排等,说明计数排序适合范围⽐较集中的整数进⾏排序,可以得到超乎想象的效率。
空间复杂度 也是 O ( n + r a n g e ) O(n+range) O(n+range)
计数排序只要计算元素位置时,从后往前处理可以保证稳定性。
7、内部排序总结