💡 一句话总结 :非营利机构 Ai2 于 10 月 1 日开源 Olmo-core 3------一套重写过的 MoE(混合专家)训练系统:8 张 B300 上吞吐约 2.7 倍于旧实现、512 卡验证 1.2 万亿参数模型、MXFP8 低精度再提速 21%。它不是新模型,而是下一代 Olmo 的训练基座,也是目前 Megatron-Core 之外少有的开放替代。
先从一个扎心的现实说起:大模型训练的成本曲线,这几年基本把学术实验室挤出了牌桌------参数量上去,卡和电费按亿美元计,能玩万亿参数训练的只剩少数大厂。MoE(混合专家架构,总参数很大但每个输入只激活一小部分「专家」)本来是省算力的希望,但它有个隐蔽的坑:专家越多,把数据路由给正确专家的通信与调度成本越高,省下来的算力红利又被吃回去。
10 月 1 日,Ai2 把补这个洞的整套方案开源了。
想自己动手或查证?
先说清它是什么:训练框架,不是新模型
容易混淆的点先澄清:Olmo-core 3 不是模型权重。Ai2 的 Olmo 系列里,OlmoE 是 64 专家的 MoE 模型,2025 年 11 月的 Olmo 3 反而转回了密集架构;而 Olmo-core 3 是这一切下面的训练基础设施------下一代 Olmo 将确定采用 MoE 架构,用 Ai2 最大的数据集和最长的上下文窗口,训练栈就是这套新框架。
也就是说,这是一个「把方法先于模型公开」的发布:万亿参数 MoE 怎么训,牌先亮出来,模型后到。
关键数字:2.7 倍吞吐是怎么来的
上一代 Olmo-core 的 MoE 实现用 FSDP(全分片数据并行,每批数据都要把权重聚集再分片一遍),批次一多,搬运权重的开销就成了大头。Olmo-core 3 换成 DDP(分布式数据并行)思路:专家常驻在各自的 GPU 上不动,把数据路由过去。
效果用一组受控对比说最清楚:专家池从 8 个扩到 128 个,每个 token 仍只激活 4 个专家,单 token 激活参数稳定在约 32 亿------总容量从 46 亿拉到 470 亿(10 倍),训练吞吐却只下降不到 5%。在 8 张 NVIDIA B300 的初步测试中,这个 470 亿参数的 MoE 跑到每卡每秒 52,000 token,旧实现只有 19,400。
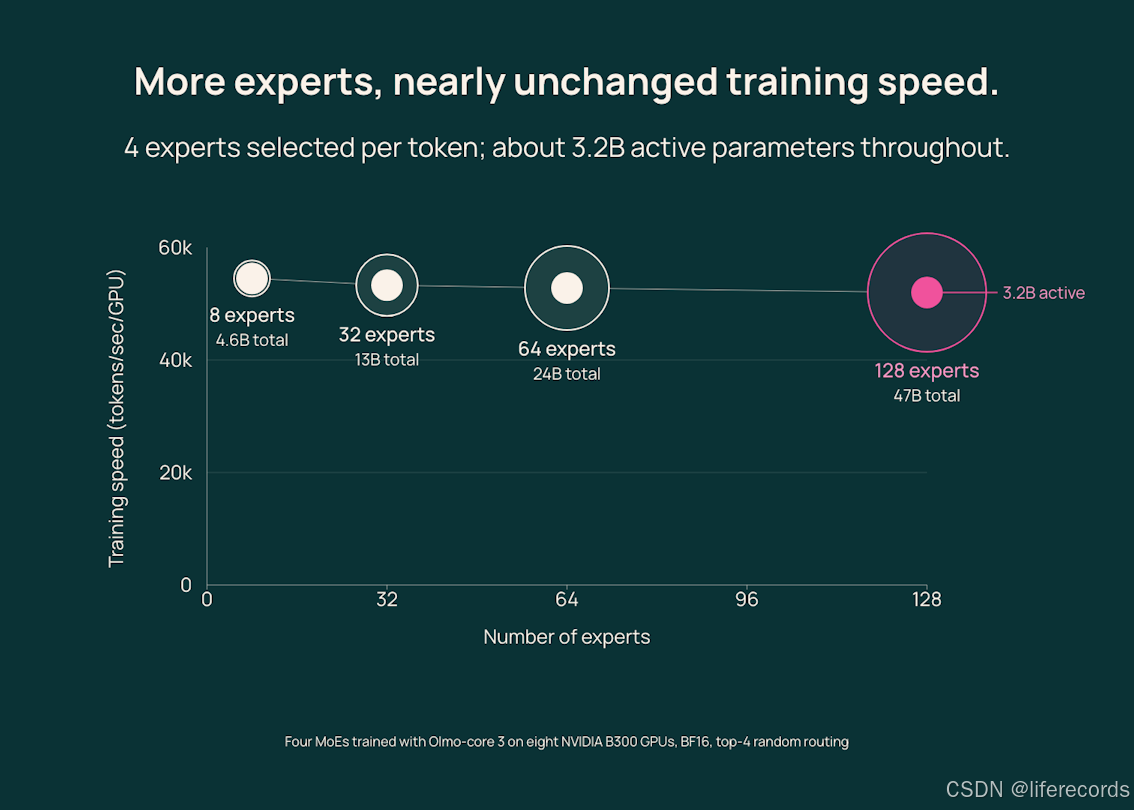
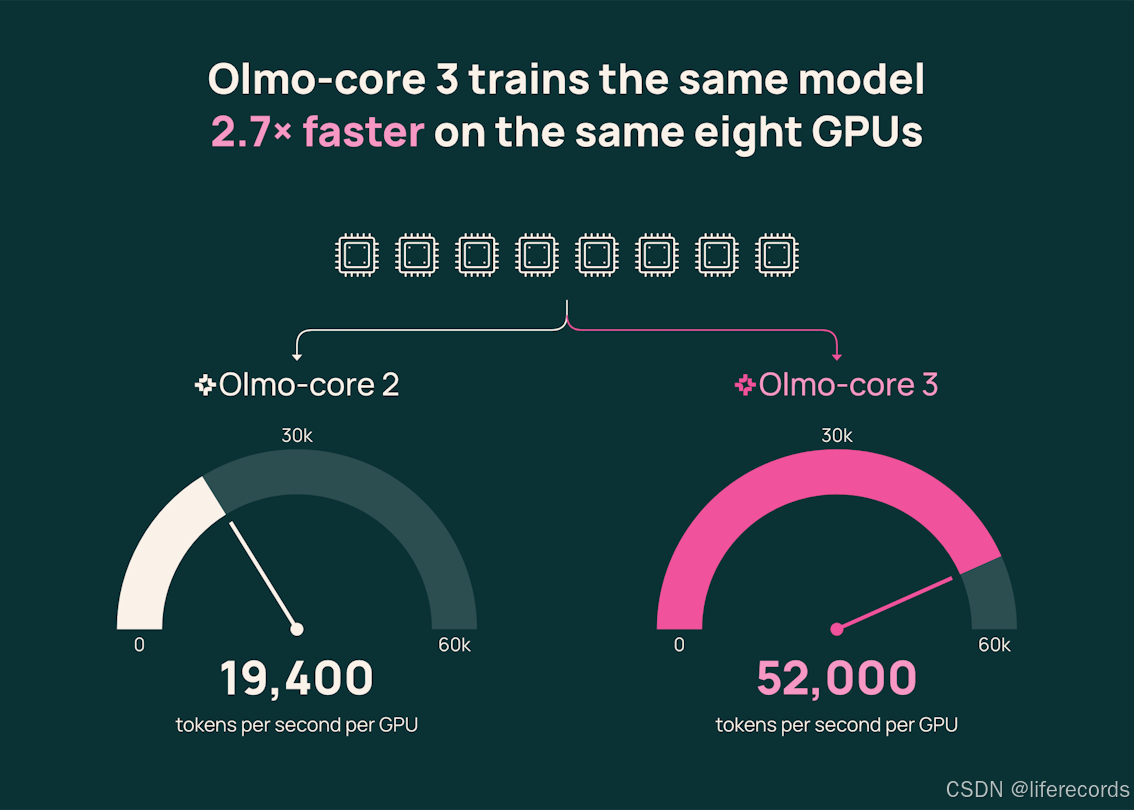
这里需要澄清一句口径: trillion 级的数字来自「随机路由」的系统基准,测的是基础设施性能而非训练出的模型质量;512 卡跑通的 1.2 万亿参数模型(每 token 激活 583.6 亿)观测到最高每卡 858 TFLOP/s。数字是框架能力的天花板展示,持续训练表现要看下一代 Olmo 的实际训练。
三招拆分、三项优化、一个精度开关
具体怎么把大 MoE 摊到集群上,框架用了三层拆分加一组路由优化:
- 🧩 专家并行:每张卡只存一部分专家池;
- 🔗 流水线并行:把模型分层切给不同 GPU 组;
- 💾 分布式优化器:优化器状态不再每卡存全量副本。
路由侧的省钱三件套:行式专家并行把数据直接摆进专家输入缓冲区、GPU 常驻路由让 CPU 排活不用等元数据拷回、分组 GEMM 把小而多的专家计算合并批量执行。再叠加 MXFP8 低精度格式开关------4 卡受控测试里端到端吞吐比 BF16 高约 21%,峰值活动显存从 103 GiB 降到 95 GiB,收益主要来自前馈计算和专家间数据搬运,而不是注意力。
难得的是,失败实验也一起交了
技术报告里最有价值的部分,恰恰是「试过但没采用」的路径:
- 一个本意鼓励负载均衡的评分,可能在真实负载变得更不均衡时反而「变好看」------Ai2 称之为 token gerrymandering(token 分配舞弊);
- 因为专家处理的 token 少就调低其学习率,在测试的模型族里没有带来改善;
- 相同矩阵维度下,GPU 计算耗时随输入数值变化,性能对比必须对齐输入值与形状;
- 通信与计算分流重叠并不总能加速,某些测试里反而拖慢端到端执行。
对要自己搭训练栈的团队,这些负结果可能比 2.7 倍的正面数字更省真金白银------别人踩过的坑直接绕开。
这事跟你有多大关系?
分三类读者说:
- 🎓 要训(而非微调)大模型的实验室/团队:这是目前 NVIDIA 生态里 Megatron-Core 之外少有的开放替代,且经过 512 卡验证、连工程决策记录都公开。但注意门槛:「有框架」不等于「训得起」------万亿参数的真实成本仍以亿美元计,512 张 B300 本身就是多数团队的全部算力预算。
- 🏗️ 做推理/训练 infra 的工程师:报告里关于通信重叠、精度格式、路由开销的实测结论,直接可借鉴到自家系统的调优决策里。
- 📱 纯应用层开发者:短期影响有限。间接影响是下一代 Olmo(开源阵营里透明度最高的系列之一)的成型速度,以及「训练栈公共品化」这个行业趋势------同周 DeepSeek 开源了昇腾平台的六个训练组件,两大生态在同一个星期把训练基础设施摆上了开源货架。
把话说明白:这次发布没有争议、数字口径也诚实(官方自己标注了随机路由的测试性质),真正值得玩味的是趋势------开放的边界从模型权重、数据配方,推进到了训练基础设施本身。模型能力的差距会不会从「谁有钱」慢慢转向「谁会调」?下一代 Olmo 出来之前,这个问题没有答案,但入场券确实发出去了。
参考来源
- Ai2 官方公告(一手):Introducing Olmo-core 3 | Ai2 Blog
- Hugging Face 同步发布(一手):HF Blog · allenai/olmocore3
- 技术报告(一手):allenai.org/papers/olmocore3
- Unite.AI 行业报道:Ai2 Releases Olmo-Core 3
- 中文解读:梭哈 AI · Ai2 开源 Olmo-core 3、Agent E 报告