上一篇《Flink Actor源码深度剖析》讲了 Flink 中 Actor 模型的应用和 Akka RPC 框架的源码实现。但很多人看完后仍然有疑问:ActorSystem 内部到底是怎么管理 Actor 的?一条消息从发送到接收,底层经历了哪些步骤?Dispatcher 调度器是如何将 Actor 绑定到线程执行的?这篇深入 Akka 底层,从 ActorSystem 架构、Actor 内部结构、消息传递机制、Dispatcher 调度器四个维度,把 Akka 的底层实现讲透。
一、Akka ActorSystem底层架构
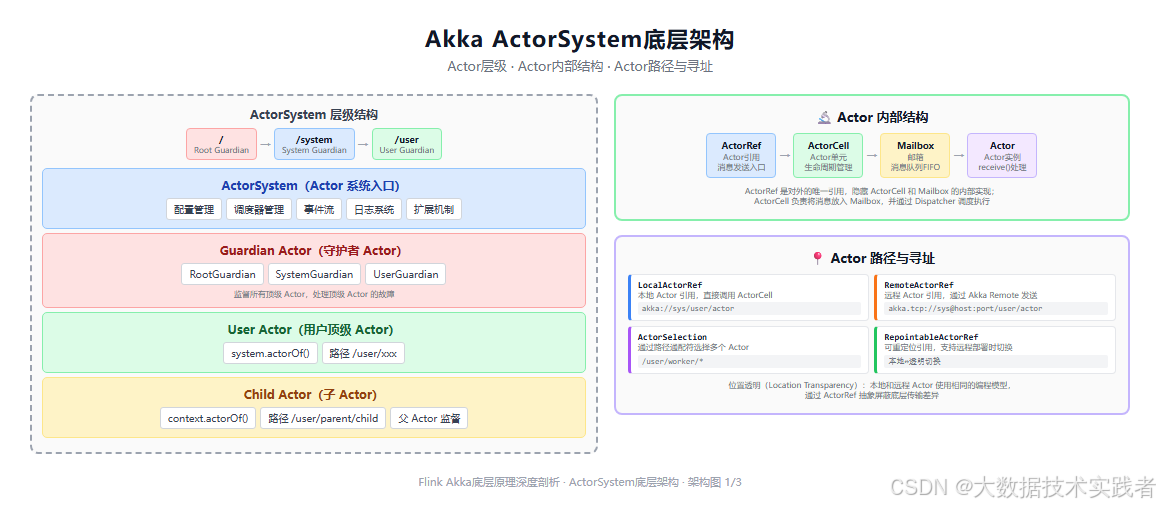
下面这张图是 Akka ActorSystem 底层架构,包括 Actor 层级、Actor 内部结构和 Actor 路径与寻址。
1.1 ActorSystem是什么
ActorSystem 是 Akka 的核心入口,负责管理所有 Actor 的生命周期。可以把 ActorSystem 理解为一个"Actor 的世界",所有 Actor 都在这个世界中创建、运行和销毁。
ActorSystem 的核心职责:
- 配置管理:加载和管理 Akka 配置(application.conf)
- 调度器管理:创建和管理 Dispatcher 调度器和线程池
- 事件流:管理 EventStream,用于发布订阅事件
- 日志系统:管理 LoggingBus 和日志适配器
- 扩展机制:管理 Akka Extension(如 Cluster、Persistence、Remoting)
- Actor 创建:通过 actorOf() 创建顶级 Actor
创建 ActorSystem 的代码:
java
// 创建默认配置的 ActorSystem
ActorSystem system = ActorSystem.create("flink");

// 使用自定义配置
Config config = ConfigFactory.load("akka.conf");
ActorSystem system = ActorSystem.create("flink", config);
1.2 Actor层级结构
Akka 中的 Actor 天然形成层级结构,每个 Actor 都有一个父 Actor,最顶层是三个 Guardian Actor(守护者):
- Root Guardian(/):所有 Actor 的根,监督 System Guardian 和 User Guardian
- System Guardian(/system):监督系统级 Actor,如日志、事件流、远程传输等
- User Guardian(/user):监督用户创建的顶级 Actor,通过 system.actorOf() 创建
Actor 层级的创建方式:
java
// 创建顶级 Actor(在 /user 下)
ActorRef parent = system.actorOf(Props.create(ParentActor.class), "parent");

// 在 Actor 内部创建子 Actor(在 /user/parent 下)
ActorRef child = getContext().actorOf(Props.create(ChildActor.class), "child");
Actor 路径示例:
akka://flink/user/parent--- 顶级 Actorakka://flink/user/parent/child--- 子 Actorakka://flink/system/log1--- 系统 Actor
1.3 Actor内部结构
很多人以为 Actor 就是一个简单的对象,实际上 Actor 的内部结构非常精巧,由四层组成:
第一层:ActorRef(Actor 引用)
- ActorRef 是对外的唯一引用,用于发送消息
- 隐藏 Actor 的内部实现,支持本地和远程透明
- 主要实现:LocalActorRef(本地)、RemoteActorRef(远程)、RepointableActorRef(可重定位)
第二层:ActorCell(Actor 单元)
- ActorCell 是 Actor 的核心管理单元
- 持有 Actor 实例、Mailbox、Dispatcher、父 Actor 引用、子 Actor 列表
- 负责消息分发、生命周期管理、监督处理
- ActorRef.tell() 最终调用的是 ActorCell.sendMessage()
第三层:Mailbox(邮箱)
- Mailbox 是消息队列,FIFO 顺序
- 实现了 Runnable 接口,可以被线程池执行
- 内部包含 MessageQueue(实际存储消息的队列)
- 默认实现:UnboundedMailbox(无界)、BoundedMailbox(有界)、PriorityMailbox(优先级)
第四层:Actor(Actor 实例)
- Actor 是实际处理消息的对象
- 包含 receive() 方法,通过模式匹配处理消息
- 持有 context(ActorContext),可以创建子 Actor、监督、获取自身引用
- 用户自定义的 Actor 逻辑都在这里
Actor 内部结构的关系:
ActorRef → ActorCell → Mailbox → Actor
  (引用)    (管理单元)   (消息队列)   (业务逻辑)
1.4 Actor路径与寻址
Akka 支持多种 Actor 引用类型,实现位置透明(Location Transparency):
| 引用类型 | 说明 | 路径示例 |
|---|---|---|
| LocalActorRef | 本地 Actor 引用,直接调用 ActorCell | akka://sys/user/actor |
| RemoteActorRef | 远程 Actor 引用,通过 Akka Remote 发送 | akka.tcp://sys@host:port/user/actor |
| ActorSelection | 通过路径通配符选择多个 Actor | /user/worker/* |
| RepointableActorRef | 可重定位引用,支持远程部署时切换 | 本地↔远程透明切换 |
位置透明是 Akka 的核心设计理念:本地 Actor 和远程 Actor 使用相同的编程模型,通过 ActorRef 抽象屏蔽底层传输差异。开发者不需要关心 Actor 是在本地还是远程,只需要通过 ActorRef 发送消息即可。
二、消息传递底层机制
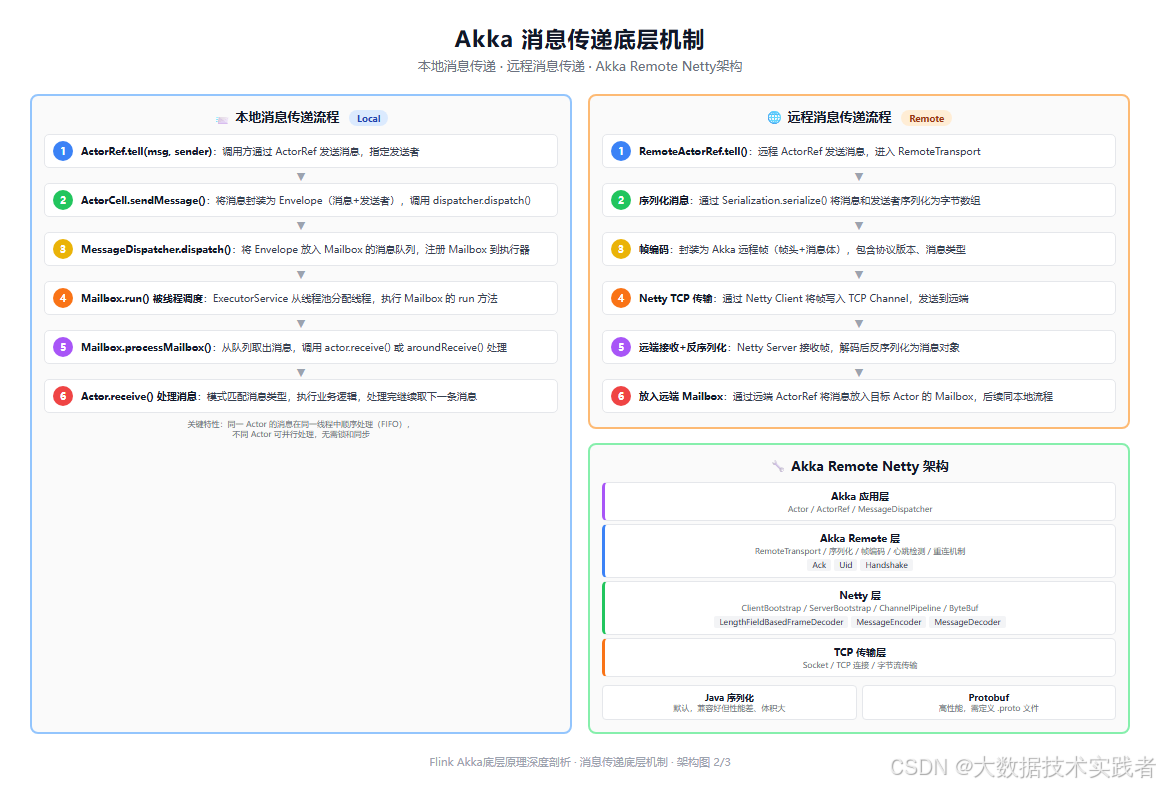
下面这张图是 Akka 消息传递底层机制,包括本地消息传递、远程消息传递和 Akka Remote Netty 架构。
2.1 本地消息传递6步流程
以 actorRef.tell(msg, sender) 为例,本地消息传递的完整流程:
第1步:ActorRef.tell()
- 调用方通过 ActorRef 发送消息,指定发送者(sender)
- LocalActorRef.tell() 内部调用 underlying.sendMessage()
- 消息和发送者被封装为 Envelope(信封)
第2步:ActorCell.sendMessage()
- ActorCell 接收消息,创建 Envelope(message + sender)
- 调用 dispatcher.dispatch(this, envelope) 将消息交给 Dispatcher
- ActorCell 持有 Dispatcher 的引用
第3步:MessageDispatcher.dispatch()
- Dispatcher 将 Envelope 放入 Mailbox 的 MessageQueue
- 调用 Mailbox.setAsScheduled() 标记为已调度
- 通过 executorService.execute(mailbox) 将 Mailbox 提交到线程池
第4步:Mailbox.run() 被线程调度
- ExecutorService 从线程池分配一个线程
- 执行 Mailbox 的 run() 方法
- Mailbox 实现了 Runnable 接口
第5步:Mailbox.processMailbox()
- 从 MessageQueue 取出消息(FIFO 顺序)
- 调用 actor.aroundReceive() 或 actor.receive() 处理消息
- 循环处理消息,直到队列为空或达到 throughput 限制
- 处理完后,如果队列还有消息,重新提交到线程池
第6步:Actor.receive() 处理消息
- 用户自定义的 receive() 方法,通过 PartialFunction 模式匹配消息类型
- 执行业务逻辑
- 处理完一条消息后,继续取下一条消息
关键特性:同一 Actor 的消息在同一线程中顺序处理(FIFO),不同 Actor 可并行处理,无需锁和同步。这是 Actor 模型线程安全的基础。
2.2 远程消息传递6步流程
远程消息传递比本地多了序列化、帧编码、Netty 传输、反序列化等步骤:
第1步:RemoteActorRef.tell()
- 远程 ActorRef 发送消息,进入 RemoteTransport
- RemoteActorRef 内部持有远程地址(host:port)和 Actor 路径
第2步:序列化消息
- 通过 Serialization.serialize() 将消息和发送者序列化为字节数组
- Akka 默认使用 Java 序列化,也支持 Protobuf、Kryo 等
- 消息必须实现 Serializable 接口,否则序列化失败
第3步:帧编码
- 将序列化后的字节封装为 Akka 远程帧
- 帧结构:帧头(协议版本、消息类型、长度)+ 消息体
- 通过 LengthFieldBasedFrameDecoder 解决粘包问题
第4步:Netty TCP 传输
- 通过 Netty Client 将帧写入 TCP Channel
- Netty 的 ChannelPipeline 包含编码器、解码器、业务处理器
- 发送到远端的 Netty Server
第5步:远端接收+反序列化
- 远端 Netty Server 接收字节流,通过 LengthFieldBasedFrameDecoder 解码为帧
- 反序列化为消息对象(Envelope)
- 通过远端 ActorRef 将消息放入目标 Actor 的 Mailbox
第6步:放入远端 Mailbox
- 后续流程与本地消息传递完全相同:Dispatcher 调度 → Mailbox.run() → Actor.receive()
- 位置透明:远端 Actor 不需要知道消息来自本地还是远程
2.3 Akka Remote Netty架构
Akka Remote 底层基于 Netty 实现,分为四层:
第一层:Akka 应用层
- Actor / ActorRef / MessageDispatcher
- 业务逻辑层,不关心底层传输
第二层:Akka Remote 层
- RemoteTransport:远程传输抽象
- 序列化:将消息序列化为字节
- 帧编码:封装为 Akka 远程帧
- 心跳检测:定期发送心跳,监控连接状态
- 重连机制:连接断开后自动重连
- 握手协议:建立连接时的握手,交换 UID 和协议版本
第三层:Netty 层
- ClientBootstrap / ServerBootstrap:Netty 启动器
- ChannelPipeline:Channel 处理流水线
- ByteBuf:Netty 字节缓冲区,零拷贝
- LengthFieldBasedFrameDecoder:基于长度字段的帧解码器,解决粘包
- MessageEncoder / MessageDecoder:消息编码器/解码器
第四层:TCP 传输层
- Socket / TCP 连接
- 字节流传输
- 可靠有序传输
2.4 序列化机制
Akka 远程通信需要序列化消息,支持多种序列化方式:
| 序列化方式 | 性能 | 体积 | 兼容性 | 适用场景 |
|---|---|---|---|---|
| Java 序列化 | 低 | 大 | 好 | 默认,兼容所有 Serializable |
| Protobuf | 高 | 小 | 需定义 | 高性能,需定义 .proto |
| Kryo | 高 | 小 | 较好 | 高性能,无需定义文件 |
Flink 中 Akka 默认使用 Java 序列化,因为 Flink 的 RPC 消息(RpcInvocation)已经实现了 Serializable。对于性能敏感的场景,可以配置使用 Kryo 或 Protobuf。
三、Dispatcher调度器底层
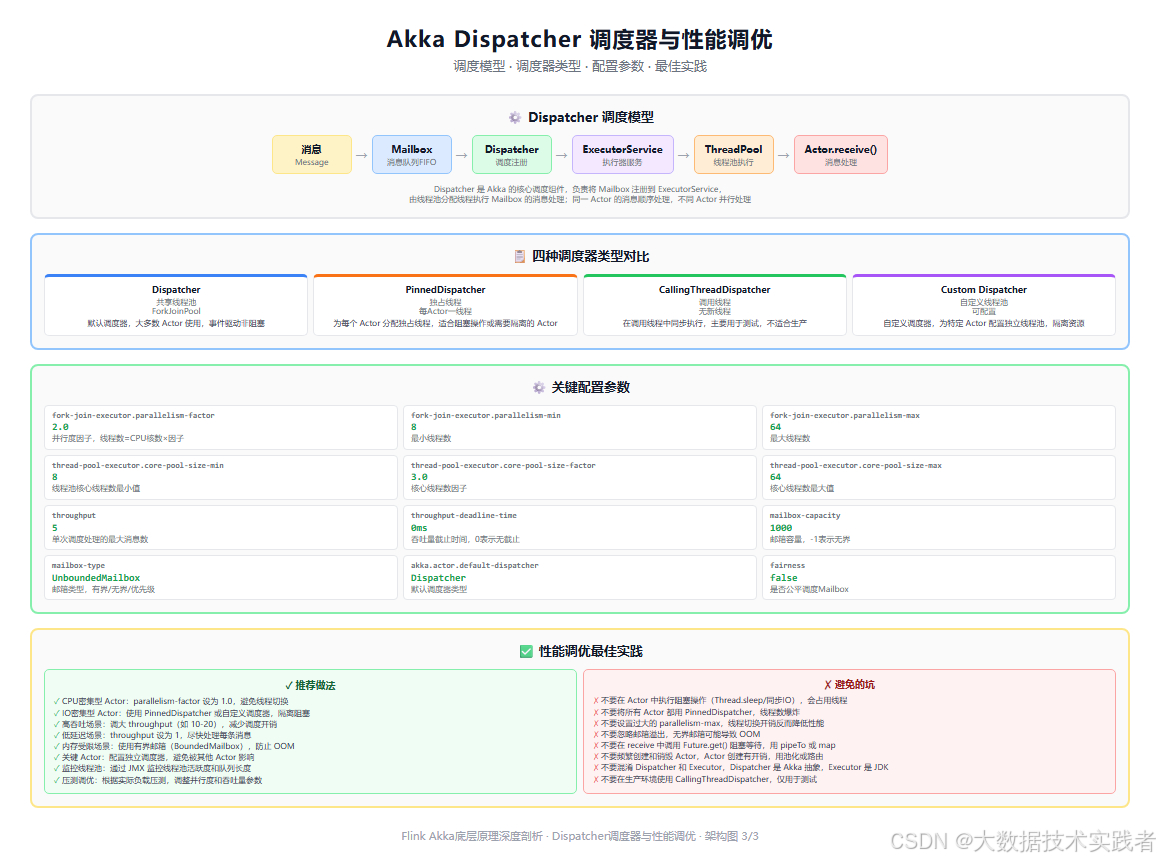
下面这张图是 Akka Dispatcher 调度器与性能调优,包括调度模型、四种调度器类型、配置参数和最佳实践。
3.1 Dispatcher调度模型
Dispatcher 是 Akka 的核心调度组件,负责将 Actor 的 Mailbox 调度到线程池执行。调度模型的完整流程:
消息 → Mailbox(消息队列)→ Dispatcher(调度注册)→ ExecutorService(执行器)→ ThreadPool(线程池)→ Actor.receive()(消息处理)Dispatcher 的核心职责:
- 消息分发:将消息放入 Mailbox 的 MessageQueue
- 调度注册:将 Mailbox 注册到 ExecutorService,等待线程执行
- 线程分配:从线程池分配线程执行 Mailbox.run()
- 吞吐量控制:控制单次调度处理的最大消息数(throughput)
Dispatcher 的关键代码逻辑:
java
public class Dispatcher extends MessageDispatcher {
    private final ExecutorService executorService;
    private final int throughput;

    @Override
    public void dispatch(ActorCell cell, Envelope handle) {
        // 1. 将消息放入 Mailbox
        Mailbox mailbox = cell.mailbox();
        mailbox.enqueue(handle);
        // 2. 注册 Mailbox 到执行器
        registerForExecution(mailbox);
    }

    protected void registerForExecution(Mailbox mailbox) {
        if (mailbox.setAsScheduled()) {
            // 3. 提交到线程池执行
            executorService.execute(mailbox);
        }
    }
}
3.2 四种调度器类型
Akka 提供四种调度器,适用于不同场景:
1. Dispatcher(默认调度器)
- 线程模型:共享线程池(ForkJoinPool)
- 特点:事件驱动、非阻塞、多个 Actor 共享线程池
- 适用:大多数 Actor,CPU 密集型和非阻塞操作
- 配置:
akka.actor.default-dispatcher
2. PinnedDispatcher(独占调度器)
- 线程模型:每个 Actor 独占一个线程
- 特点:为每个 Actor 分配专属线程,隔离性好
- 适用:阻塞操作(同步 IO、Thread.sleep)、需要隔离的关键 Actor
- 注意:Actor 数量多时线程数爆炸,谨慎使用
3. CallingThreadDispatcher(调用线程调度器)
- 线程模型:在调用线程中同步执行,不创建新线程
- 特点:同步执行,消息在发送者线程中处理
- 适用:仅用于测试,不适合生产环境
- 注意:会阻塞调用线程
4. Custom Dispatcher(自定义调度器)
- 线程模型:自定义线程池配置
- 特点:为特定 Actor 配置独立线程池,隔离资源
- 适用:需要独立资源隔离的 Actor 组,如 IO 密集型 Actor
- 配置:在 application.conf 中自定义 dispatcher 配置
自定义调度器配置示例:
hocon
my-io-dispatcher {
  type = Dispatcher
  executor = "thread-pool-executor"
  thread-pool-executor {
    core-pool-size-min = 10
    core-pool-size-factor = 3.0
    core-pool-size-max = 30
  }
  throughput = 100
}
使用自定义调度器:
java
ActorRef ioActor = system.actorOf(
    Props.create(IOActor.class).withDispatcher("my-io-dispatcher"),
    "io-actor"
);
3.3 ForkJoinPool底层原理
Akka 默认使用 ForkJoinPool 作为线程池,这是因为 ForkJoinPool 非常适合 Actor 模型的工作窃取(Work Stealing)特性。
ForkJoinPool 的核心特性:
- 工作窃取(Work Stealing):空闲线程从其他线程的任务队列尾部窃取任务,提高线程利用率
- 双端队列(Deque):每个工作线程有一个双端队列,LIFO 处理自己的任务,FIFO 窃取其他线程的任务
- ** Fork/Join 任务**:支持任务拆分(fork)和结果合并(join),适合分治算法
- 轻量级:ForkJoinTask 比 Runnable/Callable 更轻量,开销更小
Actor 模型与 ForkJoinPool 的契合点:
- 每个 Mailbox 是一个 ForkJoinTask,提交到 ForkJoinPool
- 空闲线程可以窃取其他 Mailbox 任务,避免线程空闲
- Actor 消息处理是轻量级的,适合 ForkJoinTask
ForkJoinPool 并行度配置:
hocon
fork-join-executor {
  parallelism-min = 8          # 最小线程数
  parallelism-factor = 2.0     # 并行度因子,线程数=CPU核数×因子
  parallelism-max = 64         # 最大线程数
}
实际线程数 = max(min, min(max, CPU核数 × factor))
3.4 Mailbox调度机制
Mailbox 是消息队列,同时实现了 Runnable 接口,可以被线程池执行。Mailbox 的调度机制:
Mailbox 的状态机:
- Idle(空闲):队列为空,未被调度
- Scheduled(已调度):已提交到线程池,等待执行
- Running(运行中):正在被线程执行,处理消息
Mailbox.run() 的执行逻辑:
java
public class Mailbox implements Runnable {
    private final MessageQueue messageQueue;
    private final Actor cell;
    private volatile boolean scheduled = false;

    @Override
    public void run() {
        try {
            // 1. 处理消息,最多处理 throughput 条
            int processed = 0;
            while (processed < throughput && !messageQueue.isEmpty()) {
                Envelope msg = messageQueue.dequeue();
                cell.aroundReceive(msg.message(), msg.sender());
                processed++;
            }
        } finally {
            // 2. 处理完后,如果队列还有消息,重新调度
            setAsIdle();
            if (!messageQueue.isEmpty()) {
                dispatcher.registerForExecution(this);
            }
        }
    }

    public boolean setAsScheduled() {
        if (!scheduled) {
            scheduled = true;
            return true;
        }
        return false; // 已调度,避免重复提交
    }
}
关键设计:
- setAsScheduled():原子操作,避免 Mailbox 被重复提交到线程池
- throughput 控制:单次调度最多处理 throughput 条消息,避免一个 Actor 长时间占用线程
- 重新调度:处理完后如果队列还有消息,重新提交到线程池,保证消息不丢失
3.5 配置参数详解
Akka Dispatcher 的关键配置参数:
| 参数 | 默认值 | 说明 |
|---|---|---|
| parallelism-factor | 2.0 | 并行度因子,线程数=CPU核数×因子 |
| parallelism-min | 8 | 最小线程数 |
| parallelism-max | 64 | 最大线程数 |
| core-pool-size-min | 8 | 线程池核心线程数最小值(ThreadPoolExecutor) |
| core-pool-size-factor | 3.0 | 核心线程数因子(ThreadPoolExecutor) |
| core-pool-size-max | 64 | 核心线程数最大值(ThreadPoolExecutor) |
| throughput | 5 | 单次调度处理的最大消息数 |
| throughput-deadline-time | 0ms | 吞吐量截止时间,0表示无截止 |
| mailbox-capacity | 1000 | 邮箱容量,-1表示无界 |
| mailbox-type | UnboundedMailbox | 邮箱类型 |
| fairness | false | 是否公平调度 Mailbox |
throughput 参数的影响:
- throughput 大(如 100):减少调度开销,提高吞吐量,但增加单个 Actor 的延迟
- throughput 小(如 1):降低延迟,提高响应性,但增加调度开销
- 默认值 5 是吞吐量和延迟的平衡点
mailbox-capacity 的影响:
- 无界邮箱(UnboundedMailbox):不会丢消息,但可能导致 OOM
- 有界邮箱(BoundedMailbox):容量满后新消息被丢弃或阻塞,防止 OOM
- 生产环境建议使用有界邮箱,配合监控告警
四、Flink中Akka的使用与优化
4.1 Flink中Akka的配置
Flink 中 Akka 相关的配置参数(flink-conf.yaml):
yaml
# Actor 线程池配置
akka.actor.default-dispatcher.fork-join-executor.parallelism-factor: 2.0
akka.actor.default-dispatcher.fork-join-executor.parallelism-min: 8
akka.actor.default-dispatcher.fork-join-executor.parallelism-max: 64

# 远程连接配置
akka.remote.netty.tcp.connection-timeout: 120s

# 心跳检测配置
akka.remote.watch-failure-detector.heartbeat-interval: 10s
akka.remote.watch-failure-detector.acceptable-heartbeat-pause: 60s
akka.remote.transport-failure-detector.heartbeat-interval: 10s
akka.remote.transport-failure-detector.acceptable-heartbeat-pause: 60s

# 监督策略
akka.actor.guardian-supervisor-strategy: "akka.actor.StoppingSupervisorStrategy"

# 远程事件日志
akka.remote.log-remote-lifecycle-events: off

# 序列化
akka.serialization-java.enabled: on

# Akka 框架超时
akka.actor.ask-timeout: 100s
akka.client.timeout: 60s
4.2 Flink中Akka的优化建议
1. 线程池优化
- JobManager:RPC 调用量不大,保持默认配置即可
- TaskManager:如果 Task 数量多,可以适当调大 parallelism-max
- 注意:Actor 线程池和 Flink 的 Task 执行线程池是分开的,不要混淆
- CPU 密集型:parallelism-factor 设为 1.0,避免线程切换
- IO 密集型:使用自定义调度器或 PinnedDispatcher 隔离
2. 心跳检测优化
- 网络不稳定的环境:适当调大 acceptable-heartbeat-pause(如 120s),避免误判节点故障
- 对延迟敏感的场景:调小 heartbeat-interval(如 5s),更快感知故障
- 跨机房部署:必须调大心跳超时,避免网络抖动导致节点被误判为故障
3. 邮箱优化
- 生产环境建议使用有界邮箱,防止 OOM
- 监控邮箱队列长度,发现持续增长及时排查
- 高吞吐场景调大 throughput(如 10-20),减少调度开销
- 低延迟场景 throughput 设为 1,尽快处理每条消息
4. 序列化优化
- 默认 Java 序列化性能差、体积大,性能敏感场景考虑 Kryo 或 Protobuf
- 确保所有 RPC 消息实现 Serializable
- 大对象考虑传引用或分片传输,避免单条消息过大
5. 避免阻塞操作
- 不要在 Actor 中执行阻塞操作(Thread.sleep、同步 IO、Future.get())
- 阻塞操作会占用线程,导致其他 Actor 无法被调度
- IO 密集型 Actor 使用 PinnedDispatcher 或自定义调度器隔离
- 异步操作使用 pipeTo 将 Future 结果回传给 Actor
五、总结
Flink Akka 底层原理深度剖析要点回顾:
第一,ActorSystem 底层架构是理解 Akka 的基础。ActorSystem 是 Akka 的核心入口,管理所有 Actor 的生命周期。Actor 天然形成层级结构,Root Guardian → System Guardian → User Guardian → User Actor → Child Actor。Actor 内部由四层组成:ActorRef(对外引用,支持本地/远程透明)→ ActorCell(管理单元,持有 Mailbox/Dispatcher/Actor实例)→ Mailbox(消息队列,FIFO,实现 Runnable)→ Actor(业务逻辑,receive() 处理消息)。位置透明是 Akka 的核心设计理念,通过 ActorRef 抽象屏蔽本地和远程差异。
第二,消息传递底层机制是 Akka 的核心。本地消息传递 6 步流程:ActorRef.tell() → ActorCell.sendMessage() → Dispatcher.dispatch() → Mailbox.run() 被线程调度 → Mailbox.processMailbox() → Actor.receive()。远程消息传递多了序列化、帧编码、Netty TCP 传输、反序列化等步骤。Akka Remote 基于 Netty 实现,分为应用层、Remote 层、Netty 层、TCP 层四层。关键特性:同一 Actor 的消息顺序处理,不同 Actor 并行处理,无需锁和同步。
第三,Dispatcher 调度器是 Akka 性能的关键。Dispatcher 负责将 Mailbox 调度到线程池执行,调度模型:消息 → Mailbox → Dispatcher → ExecutorService → ThreadPool → Actor.receive()。四种调度器:Dispatcher(默认,共享 ForkJoinPool)、PinnedDispatcher(独占线程,适合阻塞操作)、CallingThreadDispatcher(调用线程,仅用于测试)、Custom Dispatcher(自定义线程池,资源隔离)。ForkJoinPool 的工作窃取特性非常适合 Actor 模型。Mailbox 实现 Runnable,通过 setAsScheduled() 避免重复调度,throughput 控制单次处理消息数。
第四,配置参数与性能调优是生产环境的关键。核心参数:parallelism-factor/min/max(线程池大小)、throughput(单次处理消息数)、mailbox-capacity(邮箱容量)、heartbeat-interval/acceptable-heartbeat-pause(心跳检测)。调优建议:CPU 密集型 parallelism-factor=1.0,IO 密集型用 PinnedDispatcher 隔离,高吞吐调大 throughput,低延迟 throughput=1,生产环境用有界邮箱防 OOM,避免在 Actor 中执行阻塞操作。
第五,Flink 中 Akka 的使用与优化:Flink 使用 Akka 作为 RPC 框架,JobManager 和 TaskManager 各有独立的 ActorSystem。优化建议包括线程池配置、心跳检测调优、邮箱优化、序列化优化、避免阻塞操作等。Flink 2.0 已移除 Akka 依赖,改用自研 RPC 框架,但 Actor 模型的设计思想仍然值得深入学习。
Akka 的底层设计体现了分布式系统的经典设计思想:位置透明、消息驱动、监督容错、工作窃取。理解这些底层原理,不仅能帮助排查 Flink RPC 问题,更能体会到分布式系统设计的精妙之处。