目标:
训练基于transformer的单向语言模型,并完成文本生成。
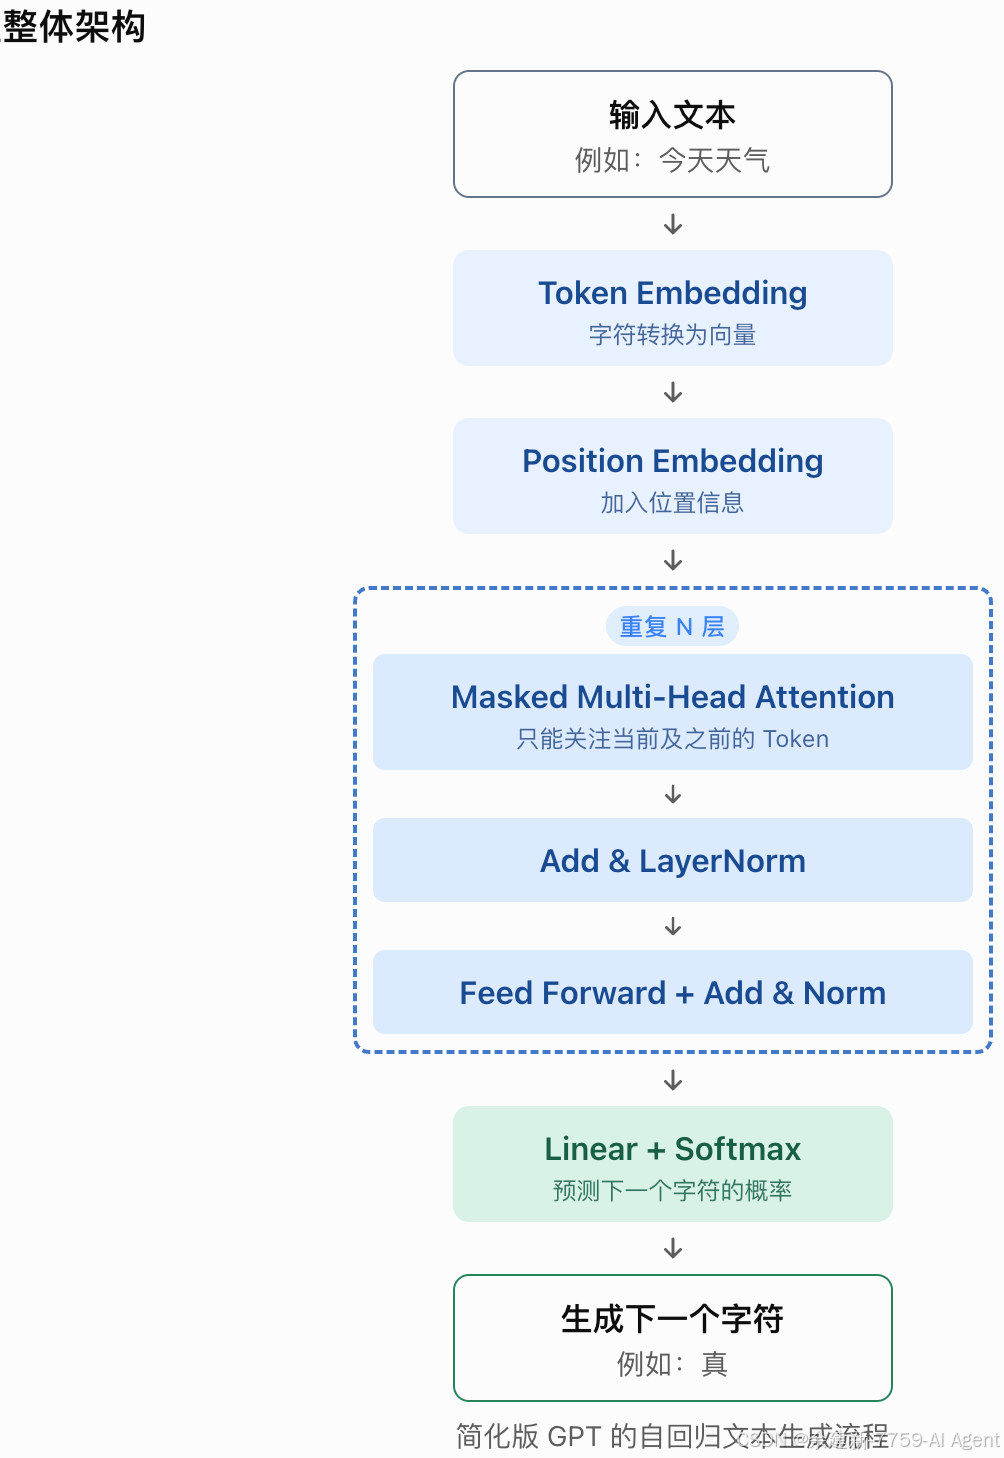
示意图:
内容:
python
import math
import os
import torch
import torch.nn as nn
import torch.nn.functional as F

# ====================================
# 1. 模型超参数
# ====================================
torch.manual_seed(42)

batch_size = 32
block_size = 64        # 最大上下文长度
n_embd = 128           # 词向量维度
n_head = 4             # 注意力头数
n_layer = 3            # Transformer 层数
dropout = 0.1
learning_rate = 3e-4
max_iters = 1500
eval_interval = 300

device = (
    "cuda" if torch.cuda.is_available()
    else "mps" if torch.backends.mps.is_available()
    else "cpu"
)

print("当前设备:", device)


# ====================================
# 2. 准备训练数据
# ====================================
# 建议准备自己的中文语料 data.txt。
# 没有文件时使用演示语料,仅用于验证训练流程。
if os.path.exists("data.txt"):
    with open("data.txt", "r", encoding="utf-8") as f:
        text = f.read()
else:
    sentences = [
        "今天天气很好,我们一起出去散步。",
        "人工智能正在改变我们的生活。",
        "深度学习是机器学习的重要分支。",
        "自然语言处理可以帮助计算机理解文本。",
        "神经网络可以通过训练学习数据中的规律。",
        "Transformer使用注意力机制处理序列信息。",
        "语言模型的任务是预测下一个字符。",
        "机器学习需要大量数据进行训练。",
        "学习编程需要不断地练习和思考。",
        "使用PyTorch可以方便地构建深度学习模型。",
        "我们正在学习如何训练一个语言模型。",
        "文本生成是自然语言处理的重要应用。",
    ]
    text = "\n".join(sentences * 200)

# 字符级 Tokenizer
chars = sorted(list(set(text)))
vocab_size = len(chars)

stoi = {ch: i for i, ch in enumerate(chars)}
itos = {i: ch for ch, i in stoi.items()}

def encode(s):
    return [stoi[c] for c in s]

def decode(ids):
    return "".join(itos[int(i)] for i in ids)

data = torch.tensor(encode(text), dtype=torch.long)

# 训练集与验证集
n = int(0.9 * len(data))
train_data = data[:n]
val_data = data[n:]

assert min(len(train_data), len(val_data)) > block_size

print("词表大小:", vocab_size)
print("训练字符数:", len(train_data))


# ====================================
# 3. 构建训练批次
# ====================================
def get_batch(split):
    source = train_data if split == "train" else val_data

    ix = torch.randint(
        0,
        len(source) - block_size,
        (batch_size,)
    )

    x = torch.stack([
        source[i:i + block_size] for i in ix
    ])

    # y 相对于 x 向右移动一个位置
    y = torch.stack([
        source[i + 1:i + block_size + 1] for i in ix
    ])

    return x.to(device), y.to(device)


# ====================================
# 4. 多头因果自注意力
# ====================================
class CausalSelfAttention(nn.Module):
    def __init__(self):
        super().__init__()

        assert n_embd % n_head == 0

        self.num_heads = n_head
        self.head_dim = n_embd // n_head

        self.qkv = nn.Linear(n_embd, 3 * n_embd)
        self.proj = nn.Linear(n_embd, n_embd)

        self.attn_dropout = nn.Dropout(dropout)
        self.resid_dropout = nn.Dropout(dropout)

        # 下三角因果 Mask
        self.register_buffer(
            "mask",
            torch.tril(
                torch.ones(block_size, block_size)
            ).view(1, 1, block_size, block_size)
        )

    def forward(self, x):
        B, T, C = x.shape

        # 一次线性映射生成 Q、K、V
        q, k, v = self.qkv(x).split(C, dim=2)

        # [B, T, C] -> [B, Head, T, HeadDim]
        q = q.view(B, T, self.num_heads,
                   self.head_dim).transpose(1, 2)
        k = k.view(B, T, self.num_heads,
                   self.head_dim).transpose(1, 2)
        v = v.view(B, T, self.num_heads,
                   self.head_dim).transpose(1, 2)

        # Scaled Dot-Product Attention
        scores = q @ k.transpose(-2, -1)
        scores = scores / math.sqrt(self.head_dim)

        # 遮挡未来 Token
        scores = scores.masked_fill(
            self.mask[:, :, :T, :T] == 0,
            float("-inf")
        )

        weights = F.softmax(scores, dim=-1)
        weights = self.attn_dropout(weights)

        out = weights @ v

        # 拼接所有注意力头
        out = out.transpose(1, 2).contiguous()
        out = out.view(B, T, C)

        return self.resid_dropout(self.proj(out))


# ====================================
# 5. 前馈神经网络
# ====================================
class FeedForward(nn.Module):
    def __init__(self):
        super().__init__()

        self.net = nn.Sequential(
            nn.Linear(n_embd, 4 * n_embd),
            nn.GELU(),
            nn.Linear(4 * n_embd, n_embd),
            nn.Dropout(dropout)
        )

    def forward(self, x):
        return self.net(x)


# ====================================
# 6. Transformer Block
# ====================================
class TransformerBlock(nn.Module):
    def __init__(self):
        super().__init__()

        self.ln1 = nn.LayerNorm(n_embd)
        self.attn = CausalSelfAttention()

        self.ln2 = nn.LayerNorm(n_embd)
        self.ffn = FeedForward()

    def forward(self, x):
        # Pre-Norm + 残差连接
        x = x + self.attn(self.ln1(x))
        x = x + self.ffn(self.ln2(x))
        return x


# ====================================
# 7. GPT 单向语言模型
# ====================================
class MiniGPT(nn.Module):
    def __init__(self):
        super().__init__()

        self.token_embedding = nn.Embedding(
            vocab_size, n_embd
        )

        self.position_embedding = nn.Embedding(
            block_size, n_embd
        )

        self.blocks = nn.Sequential(
            *[TransformerBlock() for _ in range(n_layer)]
        )

        self.ln_f = nn.LayerNorm(n_embd)
        self.lm_head = nn.Linear(n_embd, vocab_size)

    def forward(self, idx, targets=None):
        B, T = idx.shape

        assert T <= block_size

        token_emb = self.token_embedding(idx)

        positions = torch.arange(
            T, device=idx.device
        )
        pos_emb = self.position_embedding(positions)

        x = token_emb + pos_emb
        x = self.blocks(x)
        x = self.ln_f(x)

        logits = self.lm_head(x)

        loss = None

        if targets is not None:
            B, T, V = logits.shape

            loss = F.cross_entropy(
                logits.reshape(B * T, V),
                targets.reshape(B * T)
            )

        return logits, loss

    @torch.no_grad()
    def generate(
        self,
        idx,
        max_new_tokens=100,
        temperature=1.0,
        top_k=None
    ):
        assert temperature > 0

        self.eval()

        for _ in range(max_new_tokens):
            # 只使用最后 block_size 个 Token
            idx_cond = idx[:, -block_size:]

            logits, _ = self(idx_cond)

            # 获取最后一个位置的预测
            logits = logits[:, -1, :]

            # 温度调节
            logits = logits / temperature

            # Top-K 采样
            if top_k is not None:
                k = min(top_k, logits.size(-1))
                values, _ = torch.topk(logits, k)

                logits[logits < values[:, [-1]]] = -float(
                    "inf"
                )

            probs = F.softmax(logits, dim=-1)

            next_token = torch.multinomial(
                probs,
                num_samples=1
            )

            idx = torch.cat(
                [idx, next_token],
                dim=1
            )

        return idx


# ====================================
# 8. 训练与验证
# ====================================
model = MiniGPT().to(device)

print(
    "模型参数量:",
    sum(p.numel() for p in model.parameters())
)

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=learning_rate
)

@torch.no_grad()
def estimate_loss():
    model.eval()
    results = {}

    for split in ["train", "val"]:
        losses = torch.zeros(20)

        for i in range(20):
            xb, yb = get_batch(split)
            _, loss = model(xb, yb)
            losses[i] = loss.item()

        results[split] = losses.mean().item()

    model.train()
    return results


for step in range(max_iters):
    if step % eval_interval == 0 or step == max_iters - 1:
        losses = estimate_loss()

        print(
            f"step {step:4d} | "
            f"train loss: {losses['train']:.4f} | "
            f"val loss: {losses['val']:.4f}"
        )

    xb, yb = get_batch("train")

    logits, loss = model(xb, yb)

    optimizer.zero_grad(set_to_none=True)
    loss.backward()

    # 梯度裁剪
    torch.nn.utils.clip_grad_norm_(
        model.parameters(), 1.0
    )

    optimizer.step()


# ====================================
# 9. 保存模型
# ====================================
torch.save({
    "model_state_dict": model.state_dict(),
    "stoi": stoi,
    "itos": itos,
    "block_size": block_size,
    "n_embd": n_embd,
    "n_head": n_head,
    "n_layer": n_layer,
}, "mini_gpt.pth")

print("模型已保存:mini_gpt.pth")


# ====================================
# 10. 文本生成
# ====================================
prompt = "人工智能"

# 字符级词表无法识别训练集外的字符
unknown = set(prompt) - set(stoi)
if unknown:
    raise ValueError(f"提示词包含词表外字符: {unknown}")

context = torch.tensor(
    [encode(prompt)],
    dtype=torch.long,
    device=device
)

generated = model.generate(
    context,
    max_new_tokens=100,
    temperature=0.8,
    top_k=10
)

print("\n========== 生成结果 ==========")
print(decode(generated[0].tolist()))