【数据结构】栈_OJ题
概览
- 配对消除:有效的括号、删除相邻重复项
- 两个容器互倒:用队列实现栈、用栈实现队列
- 辅助栈记账:最小栈
- 操作数栈与过程模拟:逆波兰表达式求值、验证栈序列
- 单调栈:每日温度、下一个更大元素、柱状图最大矩形
- 字符串分层:字符串解码、简化路径
核心知识
一、基本套路
这一组题目都围绕栈(stack)展开,题型分布较散,但按栈里存什么、在什么时机弹出栈顶,可以归成六类。
第一类,配对消除。 当前元素要和最近的一个同类元素配对,配上就一起消掉。有效的括号是这一类里最直接的形式:左括号进栈,右括号与栈顶比较,对得上就弹出,对不上直接判定为无效。删除字符串中的所有相邻重复项把配对条件换成了相邻两个字符相同,动作与括号匹配完全一致。这一类题的所有操作都发生在栈顶,栈里其余的元素不需要访问。
第二类,两个容器互倒。 用队列(queue)模拟栈、用栈模拟队列都属于这一类。起作用的不在容器本身,而在倒的过程:把一批元素依次移进另一个容器,它们的顺序就反过来了。用栈实现队列需要两个栈,一个负责进、一个负责出;用队列实现栈需要两个队列,也可以只用一个队列,通过反复出队和入队把顺序调正。
第三类,辅助栈记账。 主栈照常存放数据,另一个栈专门记录「到目前为止的最小值」。数据栈压入一个元素,辅助栈跟着记录一份当前最小值;数据栈弹出一个元素,辅助栈跟着弹出。代价是多用一份空间,换来的是取最小值只需 O(1)。把最小值换成最大值或者前缀和,这个思路同样成立。
第四类,表达式与过程模拟。 逆波兰表达式(Reverse Polish Notation,RPN)求值把操作数压进栈,遇到运算符就弹出两个操作数参与计算,算完把结果压回去。验证栈序列反过来提问:给出一串入栈顺序和一串出栈顺序,问这一对能否对应同一个栈的操作过程。做法是按照出栈顺序模拟,栈顶与当前需要的元素相等时就弹出,不相等就继续压入入栈序列的下一个元素。
第五类,单调栈(monotonic stack)。 栈里存下标,对应的高度或温度从栈底到栈顶保持单调。新元素进入时,把比它小的栈顶元素全部弹出,被弹出的那几个元素正好在这一刻找到了自己的答案。每日温度问的是右边第一个更暖的日子,下一个更大元素问的是右边第一个更大的数,柱状图最大矩形问的是左右两边第一个比当前柱子矮的位置。三道题的骨架相同,区别只在于弹出栈顶时用哪个值更新答案。
第六类,字符串分层。 字符串解码的方括号可以嵌套,每一层都需要自己的重复次数和前缀,因此两个栈同时工作;简化路径按斜杠把字符串切成若干段,遇到上一级目录就让栈顶出栈。两者的共同点是栈里存放字符串,出栈顺序与嵌套层次一致。
六类归完之后,判断一道新题要不要用栈就有了依据。拿到题目先看两点:有没有「最近的还没处理完」这种关系,有就属于前三类或者第六类;有没有「找右边第一个比它大或比它小」的需求,有就是单调栈。两点都不成立时,再考虑别的手法。
十二道题里有十道能被这两个问题直接命中;剩下两道把栈藏在结构里,也就是用队列实现栈和用栈实现队列,考的是两种容器的相互转换。
二、边界值
栈题的代码普遍不长,出错的地方往往不在主循环,而在几个固定的位置。下面六类边界都应当提前想到,每一类在这十二道题里都能找到对应的例子。
第一类,长度。 空串和只有一个字符的串是两个特殊点。空串一次循环都不会进入,返回值要么是空串要么是真;单字符的串只经历一次进栈或者一次比较,对栈顶的访问恰好落在边界上。
第二类,全部符合与全部不符合。 全是左括号的串在循环结束时栈里还留着没有配对的括号;全是右括号的串在第一次取栈顶时栈就是空的。删除相邻重复项里,一串完全相同的字符会两两抵消,最终得到空串,输出长度为零。
第三类,栈空的时刻。 栈题出错多半出在这里。取栈顶之前必须先判空:右括号多余时栈可能已经空了,路径里连着几个上级目录时栈可能已经见底,表达式里第一个 token 就可能是运算符。漏掉判空时正常用例仍然能通过,一遇到边界输入就会崩溃。
第四类,嵌套与多位数。 字符串解码的方括号可以嵌套三层以上,重复次数可以是两位数,解析数字时要把连续的数字位拼成一个整数,只看一位会得到错误的结果。简化路径里连续的斜杠需要跳过,末尾有没有斜杠对结果没有影响。
第五类,题目前提。 下一个更大元素要求 nums2 里的数互不相同,并且可以用数组直接寻址;前提一旦被破坏,直接寻址表就只能保存一份答案,实测里给出了反例。逆波兰表达式的除法按 C 的规则向零截断,两个整数相除并不等于向下取整。这些边界不由输入的大小决定,而取决于题目的前提是否仍然成立。
第六类,内存。 C 没有自动回收机制,题解返回的指针要么指向调用者提供的内存,要么由函数自己申请,谁申请谁释放必须写清楚。字符串解码和简化路径都要拼接结果串,长度不够时需要扩容,扩容之后旧指针不能再使用。
三、题目概览
| 题号 | 题目 | 套路 | 时间复杂度 | 空间复杂度 |
|---|---|---|---|---|
| 20 | 有效的括号 | 配对消除 | O(n) | O(n) |
| 225 | 用队列实现栈 | 两个队列互倒 | 入栈 O(1),出栈 O(n) | O(n) |
| 232 | 用栈实现队列 | 两个栈互倒 | 均摊 O(1) | O(n) |
| 155 | 最小栈 | 辅助栈记账 | 每个操作 O(1) | O(n) |
| 150 | 逆波兰表达式求值 | 操作数栈 | O(n) | O(n) |
| 946 | 验证栈序列 | 过程模拟 | O(n) | O(n) |
| 739 | 每日温度 | 单调栈 | O(n) | O(n) |
| 496 | 下一个更大元素 I | 单调栈加直接寻址 | O(n + m) | O(值域) |
| 394 | 字符串解码 | 双栈 | O(输出长度) | O(输出长度) |
| 71 | 简化路径 | 字符串栈 | O(n) | O(n) |
| 1047 | 删除相邻重复项 | 原地栈 | O(n) | O(1) |
| 84 | 柱状图最大矩形 | 单调栈 | O(n) | O(n) |
十二道题的时间复杂度基本都是 O(n),差别体现在空间上。删除相邻重复项是唯一能把栈写在原串里的题,空间 O(1);下一个更大元素开的是值域大小的直接寻址表;其余十道都需要一份与输入等长的栈空间。单调栈最坏情况下也是 O(n),输入严格递减时栈里积压全部下标,实测里量过这个数字。
排列顺序按套路递进。第一题到第四题打基础,配对消除、两个容器互倒、辅助栈记账各走一遍,代码量都不大,重点是把判空的习惯建立起来。第五题到第八题难度上升,逆波兰求值和验证栈序列考的是能不能把题目的过程翻译成栈的动作,每日温度和下一个更大元素是单调栈入门,两题骨架完全相同,做完一道之后另一道的做法可以直接沿用。第九题到第十二题属于进阶,字符串解码同时使用两个栈,简化路径把栈用在字符串分段上,删除相邻重复项展示原地写法,柱状图最大矩形集中体现了单调栈的用法,面试出现频率也最高。
如果时间有限,可以先做第一题、第七题和第十二题,它们分别对应配对、单调栈和边界结算三个最常考的落点。
实例代码
全部代码在 CentOS 7 上用 gcc 4.8.5 编译,编译命令统一为 gcc -std=c99 -Wall -Wextra -g,十二个程序零告警,涉及动态内存的题目逐题通过 valgrind 检查。十二道题放在同一个目录下,每题一个 .c 文件,解法和测试驱动写在一起,共用一个头文件。
目录结构如下:
text
ds07/
├── stack.h                              三种元素类型的栈,十二道题共用
├── p01_valid_parentheses.c              20   有效的括号
├── p02_implement_stack_using_queues.c   225  用队列实现栈
├── p03_implement_queue_using_stacks.c   232  用栈实现队列
├── p04_min_stack.c                      155  最小栈
├── p05_eval_rpn.c                       150  逆波兰表达式求值
├── p06_validate_stack_sequences.c       946  验证栈序列
├── p07_daily_temperatures.c             739  每日温度
├── p08_next_greater_element_i.c         496  下一个更大元素 I
├── p08b_next_greater_stl.cpp            496  同一个题的 STL 写法
├── p09_decode_string.c                  394  字符串解码
├── p10_simplify_path.c                  71   简化路径
├── p11_remove_adjacent_duplicates.c     1047 删除字符串中的所有相邻重复项
└── p12_largest_rectangle_histogram.c    84   柱状图中最大的矩形
公共头文件里放三套栈,元素类型分别是整数、字符和字符串,名字带类型前缀,十二个文件各取所需:
c
typedef struct IntStack  { int* a;     int top; int cap; } IntStack;
typedef struct CharStack { char* a;    int top; int cap; } CharStack;
typedef struct StrStack  { char** a;   int top; int cap; } StrStack;

void  IntStackInit(IntStack* s);
void  IntStackPush(IntStack* s, int x);
void  IntStackPop(IntStack* s);
int   IntStackTop(const IntStack* s);
bool  IntStackEmpty(const IntStack* s);
int   IntStackSize(const IntStack* s);
void  IntStackDestroy(IntStack* s);
字符栈和字符串栈的接口与整数栈一一对应,区别只在元素类型,这里不再逐一列出。三套栈都用动态数组实现,容量不够时翻倍,出栈只移动 top,容量保持不变,销毁时释放底层数组;字符串栈入栈时会把字符串复制一份,销毁时逐个释放。它的元素是各自独立申请的内存,复制和释放都要按元素进行,三套栈里只有它需要处理二级指针。
公共头文件里放三套栈而不是一套,原因在于 C 没有模板。想让一个栈同时装下 int、char 和 char*,只有三条路:用 void* 加上元素大小自己计算地址、用宏展开出三份代码、或者直接写三遍。第一条路每次存取都要转换指针,调试时看不出栈里存放的到底是什么;第二条路的报错信息指向宏展开之后的代码,读起来费力。写三遍的做法显得重复,但每套只有三十来行,接口名带前缀之后,调用处可以直接看出元素类型,出问题也只牵连那一套。
这类取舍在 C 里很常见:靠命名和重复换来的可读性,通常比省下那几十行更有价值。
第一题 有效的括号(20)
题目:给定一个只包括小括号、中括号、大括号的字符串 s,判断它是否有效。有效的条件是左括号必须用相同类型的右括号闭合,并且必须以正确的顺序闭合。力扣给 C 语言的签名是 bool isValid(char* s)。
原题链接: leetcode 20 Valid Parentheses
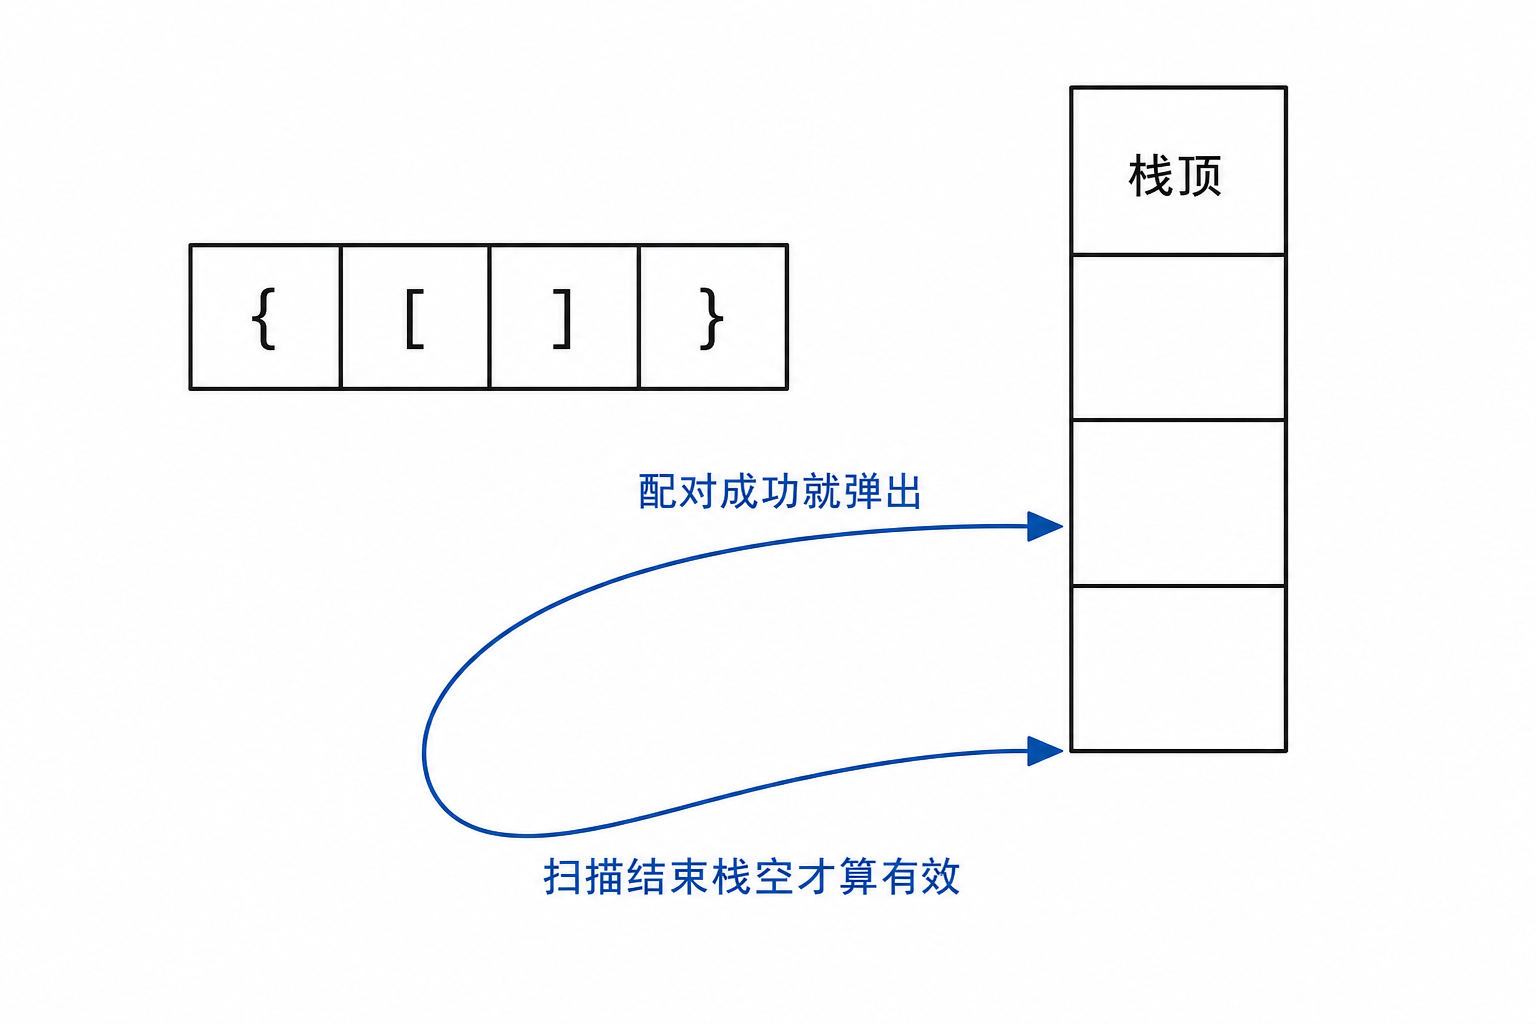
图 1 括号匹配时栈的生长与收缩
暴力解先列出来。 反复扫描这个串,每次删掉一对相邻的括号,直到再也找不到可删的一对,最后看串是否为空。它成立的理由是:任何有效的括号串里一定存在一对相邻的配对括号,也就是最内层的那一对,删掉它之后剩下的仍然是有效串。反过来,如果串本身无效,删到最后总会剩下删不掉的部分。开销集中在重复扫描上:每删一对就要从头再扫一遍,最坏情况是 ((((...)))) 这种形状,需要删 n/2 轮,每轮扫描 n 个字符,时间达到 O(n²)。
消除重复扫描。 暴力解的浪费在于每次都从串头重新看起,而真正可能配对的两个括号永远相邻:右括号只能和它左边最近的、还没有配对的左括号配对。这个「最近的还没有配对的左括号」正好就是栈顶。于是动作只剩下三条:左括号入栈,右括号与栈顶比较,扫描结束时栈必须为空。
正确性可以按扫描位置归纳。假设处理到第 i 个字符之前,栈里存的恰好是前 i 个字符中所有还没配对的左括号,顺序与它们出现的顺序一致。那么第 i 个字符只有三种可能:如果是左括号,它必然还没有配对,压到栈顶正好维持这个性质;如果是右括号,能和它配对的只有栈顶那一个,配得上就弹出,配不上说明这个右括号永远找不到配对,直接判定为无效;扫描结束后还留在栈里的左括号没有任何右括号可以配对,所以栈空是必要条件。三条合起来构成充要条件。
c
bool isValid(char* s)
{
	CharStack st;
	int i;
	bool ok = true;

	CharStackInit(&st);
	for (i = 0; s[i] != '\0' && ok; ++i)
	{
		char c = s[i];
		if (MatchOf(c) == 0)
		{
			CharStackPush(&st, c);
		}
		else if (CharStackEmpty(&st) || CharStackTop(&st) != MatchOf(c))
		{
			ok = false;
		}
		else
		{
			CharStackPop(&st);
		}
	}
	if (ok && !CharStackEmpty(&st))
	{
		ok = false;
	}
	CharStackDestroy(&st);
	return ok;
}
MatchOf 是一个三行的小函数,把右括号映射成对应的左括号,不是右括号就返回 0。右括号与左括号的区分、类型是否对得上,都集中在同一次比较里。
三种失败原因分别由三个不同的分支拦下:右括号多余时栈已经空了,CharStackEmpty 先短路;类型对不上时 CharStackTop 的比较失败;左括号多余时循环正常结束,靠最后那句 !CharStackEmpty 拦住。三个判断缺任何一个,都会有一类输入被判成有效。分支的先后顺序同样重要:必须先判空再取栈顶,顺序反了就会在空栈上取栈顶。
推演一遍。 用例取 {[]},每一步的栈顶变化如下:
| 下标 | 字符 | 动作 | 栈内容(栈底在左) |
|---|---|---|---|
| 0 | { | 左括号,入栈 | { |
| 1 | [ | 左括号,入栈 | { [ |
| 2 | ] | 栈顶是 [,配对成功,弹栈 | { |
| 3 | } | 栈顶是 {,配对成功,弹栈 | 空 |
| 结束 | 无 | 栈已空,返回 true | 空 |
换成 ([) 这种交叉嵌套,处理到下标 2 就会被拦下:当前字符是 ),栈顶是 [,类型对不上,直接返回 false。两个括号的类型都没有错,错的是嵌套顺序,只有栈顶比较能发现这一点。
text
输入 { [ ] }                         输入 ( [ ) ]

第 1 步  {      入栈   栈: {          第 1 步  (      入栈   栈: (
第 2 步  [      入栈   栈: { [        第 2 步  [      入栈   栈: ( [
第 3 步  ]      配对   栈: {          第 3 步  )      栈顶是 [
第 4 步  }      配对   栈: 空                 类型对不上,返回 false
        扫描结束,栈空,返回 true
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p01_valid_parentheses p01_valid_parentheses.c
./p01_valid_parentheses
text
输入 s = ()[]{}
输出 true(对照解法 true)
输入 s = ([)]
输出 false(对照解法 false)
输入 s = {[]}
输出 true(对照解法 true)
输入 s = (]
输出 false(对照解法 false)
输入 s = (
输出 false(对照解法 false)
输入 s = ]
输出 false(对照解法 false)
程序里同时保留了反复删除的对照解法,六组用例中两个解法的结果逐组相同,相当于做了一次对拍。
边界值。
- 空串:循环一次都不进,栈本来就是空的,返回 true。
- 全是左括号:扫描结束时栈里有 n 个元素,被最后那句判空拦住,返回 false。
- 全是右括号:第一个字符就要取栈顶,判空必须写在取栈顶之前。
- 单个左括号、单个右括号:都返回 false,两条失败路径各走一次。
- 交叉嵌套
([)]、{[}]:类型都能对上,顺序不对,靠栈顶比较拦住。 - 题目前提:s 只由六种括号字符组成,长度在 1 到 10⁴ 之间,所以不需要考虑别的字符。
复杂度:时间 O(n),每个字符最多进栈一次、出栈一次;空间 O(n),最坏是串里全是左括号,栈要装下整个串。
第二题 用队列实现栈(225)
题目:只用两个队列实现一个后进先出的栈,支持 push、pop、top、empty 四个操作,队列只能用标准操作:从队尾进、从队头取、取队头、判空、取长度。
原题链接: leetcode 225 Implement Stack using Queues
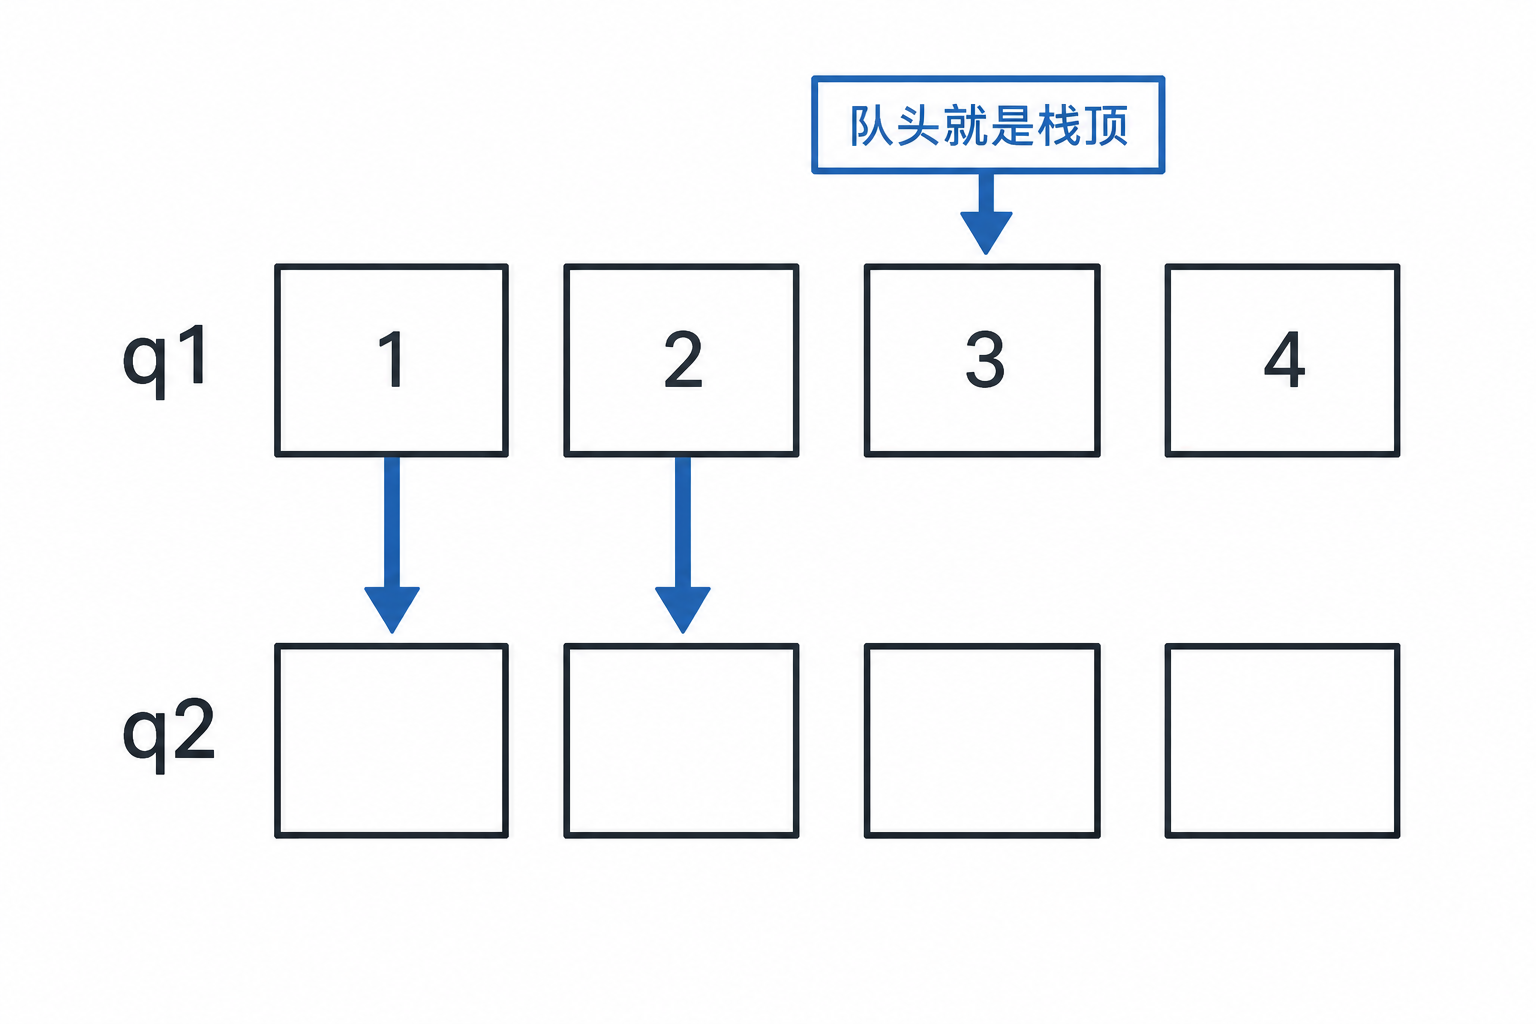
图 2 两个队列把前 n 减 1 个元素倒过去
入队时把顺序调正。 队列先进先出,栈后进先出,两者只差一个顺序。最直接的做法是在入队时就把顺序调正:每次 push 之后,把队列里前面 n 减 1 个元素依次出队再入队,转一圈之后新元素就到了队头,队头始终是栈顶。这一步的正确性不需要额外证明:转完一圈之后,新元素确实位于队头。代价落在 push 上:每加入一个元素,都要陪着前面所有元素转一圈,最坏情况是 O(n)。
把旋转推迟到取数时。 这项操作可以推迟到取数的时候再做,还可以借助第二个队列把「转一圈」变成「搬一遍」:入数据永远进非空的那个队列,耗时 O(1);出数据时把非空队列里前 size 减 1 个元素搬到另一个队列,剩下的那一个就是栈顶,取走它即可。两种写法的总工作量相同,区别在于把代价记在 push 上还是 pop 上。操作序列里 top 和 pop 密集时,把代价放在 push 上更合适;如果只是持续进数据,两个队列的写法开销更小。
之所以留下最后一个而不是全部搬过去,原因有两方面:搬过去的元素保持相对顺序,回到原队列时顺序与原来一致,栈的语义不受影响;留下来的那一个恰好是最晚进入的,也就是栈顶。取走它之后原队列为空,数据全部落在另一个队列里,下一轮 push 又可以重新挑选队列。
c
void myStackPush(MyStack* obj, int x)
{
	if (!QueueEmpty(&obj->q1) || QueueEmpty(&obj->q2))
	{
		QueuePush(&obj->q1, x);
	}
	else
	{
		QueuePush(&obj->q2, x);
	}
}

/* 把 from 里前 size - 1 个搬到 to,剩下那个就是栈顶 */
static void MoveAllButLast(IntQueue* from, IntQueue* to)
{
	while (QueueSize(from) > 1)
	{
		QueuePush(to, QueueFront(from));
		QueuePop(from);
	}
}

int myStackPop(MyStack* obj)
{
	IntQueue* from = QueueEmpty(&obj->q1) ? &obj->q2 : &obj->q1;
	IntQueue* to = (from == &obj->q1) ? &obj->q2 : &obj->q1;
	int v;

	MoveAllButLast(from, to);
	v = QueueFront(from);
	QueuePop(from);
	return v;
}
入栈处的判断需要多解释一下:两个队列都空时进入 q1,之后一直进入非空的那个,因此任意时刻最多只有一个队列存有数据。这个不变量让出栈时定位数据变得简单,只需要判断 q1 是否为空。如果不写成这个形式,就要先假设一个非空队列再去修正,代码里会多出一层判断。
c
int myStackTop(MyStack* obj)
{
	IntQueue* from = QueueEmpty(&obj->q1) ? &obj->q2 : &obj->q1;
	IntQueue* to = (from == &obj->q1) ? &obj->q2 : &obj->q1;
	int v;

	MoveAllButLast(from, to);
	v = QueueFront(from);
	QueuePop(from);
	QueuePush(to, v);
	return v;
}
取栈顶和出栈只差最后一步:出栈取走元素之后不再放回,取栈顶则需要把这个元素放回去。放回的位置必须是搬空之后剩下的那个队列,也就是 to,只有这样才能维持前面的不变量。
逐步推演。 操作序列是 push(1) push(2) push(3) pop top push(4) pop pop empty,每一步两个队列的内容:
| 操作 | q1 | q2 | 返回 |
|---|---|---|---|
| push 1 | 1 | \[\] | 无 |
| push 2 | 1 2 | \[\] | 无 |
| push 3 | 1 2 3 | \[\] | 无 |
| pop | 3 搬前 2 个到 q2 后剩 \[\] | 1 2 | 3 |
| top | 1 | 2 取到 2 再放进 q1 后剩 \[\] | 2 |
| push 4 | 1 2 4 | \[\] | 无 |
| pop | \[\] | 1 2 取走 4 后 | 4 |
| pop | 1 | 2 取走 2 后 | 2 |
| empty | 1 | \[\] | false |
第 5 行的 top 是这一步的重点:搬完之后 q2 里是 1 2,队头 2 就是栈顶;取完之后 q2 变空,把 2 压回 q1,两个队列的状态回到 1 2 加一个空队列,与 push 完成时完全一致。
text
push 1   q1:[1]        q2:[]           push 3   q1:[1 2 3]    q2:[]
push 2   q1:[1 2]      q2:[]           pop      q1:[]         q2:[1 2]   返回 3
top      q1:[1 2]      q2:[]           push 4   q1:[1 2 4]    q2:[]
pop      q1:[]         q2:[1 2]   返回 4       pop      q1:[1]   q2:[]  返回 2
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p02_implement_stack_using_queues p02_implement_stack_using_queues.c
./p02_implement_stack_using_queues
text
输入 push(1) push(2) top pop empty
输出 两队列版 push 1 push 2 top=2 pop=2 empty=false
     单队列版 push 1 push 2 top=2 pop=2 empty=false
输入 push(1) push(2) push(3) pop top push(4) pop pop empty
输出 两队列版 push 1 push 2 push 3 pop=3 top=2 push 4 pop=4 pop=2 empty=false
     单队列版 push 1 push 2 push 3 pop=3 top=2 push 4 pop=4 pop=2 empty=false
单队列版就是前面提到的旋转写法:入队之后转一圈,只需要两行代码;两组操作序列的结果与两个队列的版本逐字相同。
边界值。
- 空栈上判空:两个队列都空才返回 true,只看一个会出错。
- 只有一个元素时出栈:循环一次都不进,直接取队头,返回的就是这个元素。
- 连续取栈顶:
top不该改变结构,连着取两次结果必须一样。 - 出栈之后再入栈:新元素要进那个还有数据的队列,不能固定进 q1。
- 题目前提:力扣保证
pop和top只在栈非空时调用,所以函数里不处理空栈取值。 - 队列自己的容量:搬来搬去会让底层数组的下标一直涨,队列在空的时候把队头队尾归零,避免数组无限扩容。
复杂度:入栈 O(1),出栈和取栈顶 O(n),最坏要把 n 减 1 个元素搬一遍;空间 O(n),两个队列加起来存的是同一批数据。
第三题 用栈实现队列(232)
题目:只用两个栈实现一个先进先出的队列,支持 push、pop、peek、empty,栈只能用标准操作:入栈、出栈、取栈顶、判空、取大小。
原题链接: leetcode 232 Implement Queue using Stacks
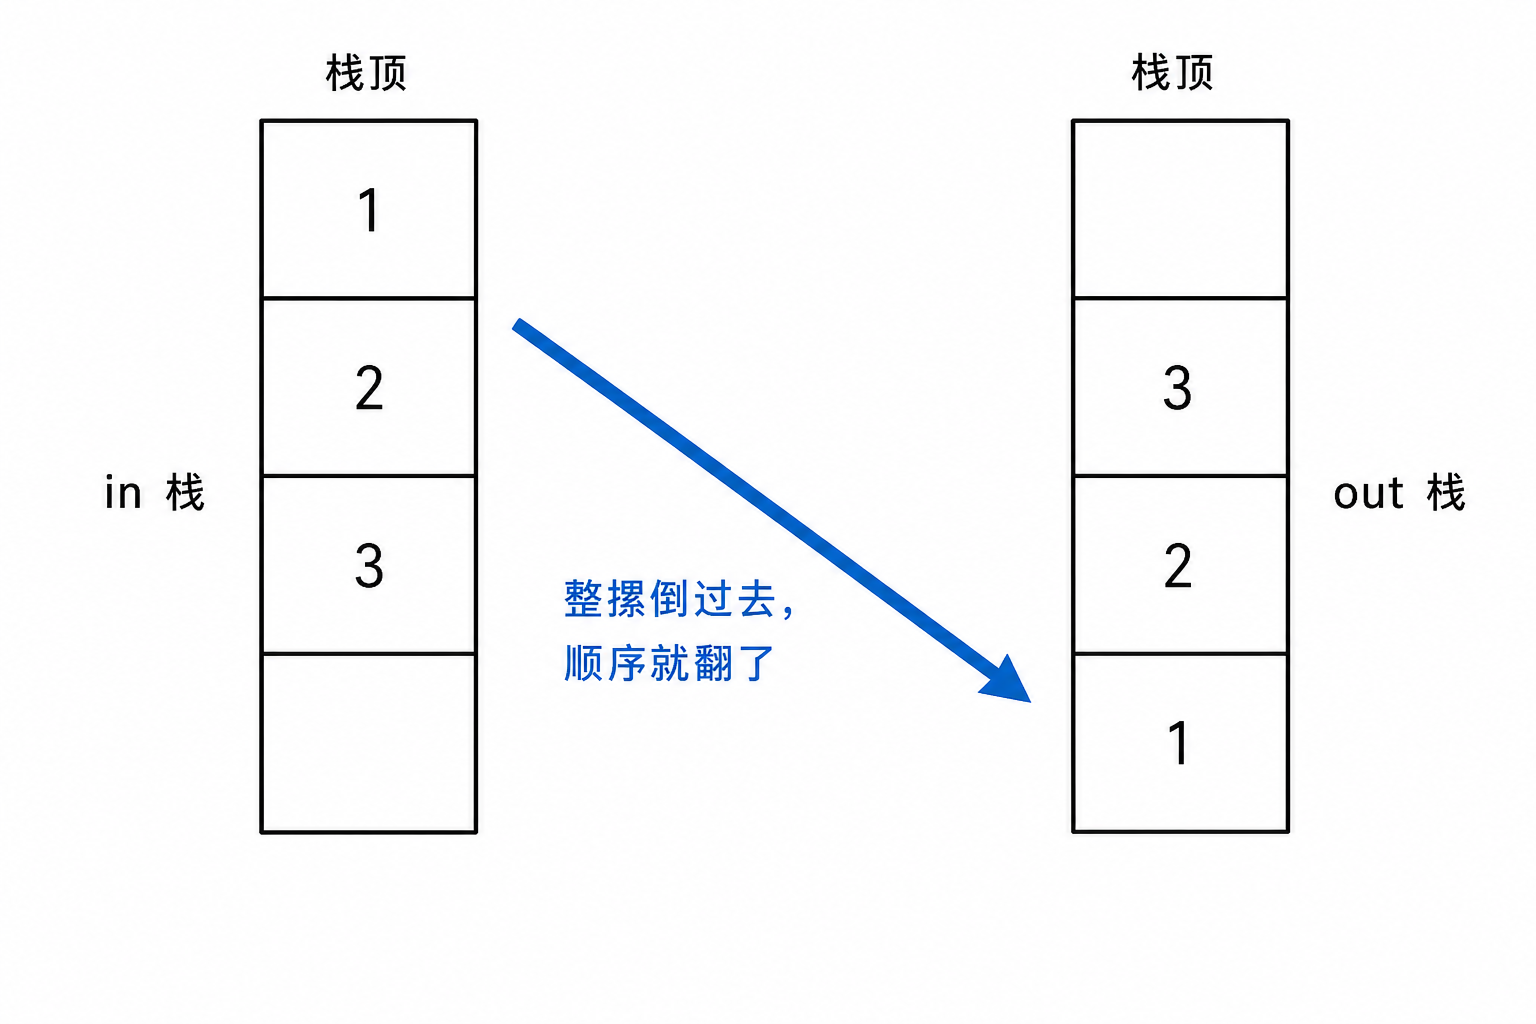
图 3 两个栈一进一出,倒一次顺序就翻过来
每次取队头都倒一遍。 把入栈里的元素全部倒进出栈,出栈的栈顶就是最早进入的那个元素。倒的动作很直观:把一批元素整体转移到另一个容器,顺序自然反转。这个做法是正确的,问题在于每一轮都要把整个栈倒一遍,出队一次是 O(n)。
倒过来的数据留着继续用。 倒进出栈的数据不必马上丢弃。既然倒一次就已经是正序,就可以留着继续使用:出栈不为空时一直从出栈取,只有出栈空了才需要再倒一次。每个元素在整个生命周期里最多被倒一次,均摊到每次操作是 O(1)。
均摊(amortized)复杂度的账可以这样算:倒一次的开销等于当时入栈里的元素个数,倒完之后这些元素全部转入出栈,不再参与后面的倒。一个元素只会被搬一次,n 次入队总共搬 n 次,摊到每次出队是常数。这是均摊而不是最坏情况:某一次 pop 恰好赶上倒数据,那一次仍然是 O(n)。入队能够一直保持 O(1),代价是集中到倒数据的那一刻。
c
typedef struct
{
	IntStack in;
	IntStack out;
} MyQueue;

void myQueuePush(MyQueue* obj, int x)
{
	IntStackPush(&obj->in, x);
}

/* 出栈空了才倒,倒一次要等出栈再次空掉才倒第二次 */
static void Transfer(MyQueue* obj)
{
	while (!IntStackEmpty(&obj->in))
	{
		IntStackPush(&obj->out, IntStackTop(&obj->in));
		IntStackPop(&obj->in);
	}
}

int myQueuePop(MyQueue* obj)
{
	int v;

	if (IntStackEmpty(&obj->out))
	{
		Transfer(obj);
	}
	v = IntStackTop(&obj->out);
	IntStackPop(&obj->out);
	return v;
}
条件写成 if (IntStackEmpty(&obj->out)) 而不是每次出队都倒,这一句正是均摊分析的落点。少写这个判断,程序的结果依然正确,复杂度却退化成 O(n)。
换一组序列。 push(1) push(2) pop push(3) pop pop empty:
| 操作 | in 栈(栈底在左) | out 栈(栈底在左) | 返回 |
|---|---|---|---|
| push 1 | 1 | \[\] | 无 |
| push 2 | 1 2 | \[\] | 无 |
| pop | \[\] 全部倒进 out | 2 1 取走栈顶 1 后剩 2 | 1 |
| push 3 | 3 | 2 | 无 |
| pop | 3 | 2 栈顶是 2,直接取,不倒 | 2 |
| pop | 3 | \[\] 空了,把 3 倒过来再取 | 3 |
| empty | \[\] | \[\] | true |
第 5 行是关键:入栈里还存放着 3,出栈里却有更早进入的 2,必须先把 2 取完。这正是延迟倒数据的作用,提前倒一次会把顺序弄错。
text
push 1   in:[1]      out:[]          push 3   in:[3]      out:[2]
push 2   in:[1 2]    out:[]          pop      in:[3]      out:[]      返回 2
pop      in:[]       out:[2]  返回 1  pop     in:[]       out:[]      返回 3
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p03_implement_queue_using_stacks p03_implement_queue_using_stacks.c
./p03_implement_queue_using_stacks
text
输入 push(1) push(2) peek pop empty
输出 延迟倒 push 1 push 2 peek=1 pop=1 empty=false
     每次倒 push 1 push 2 peek=1 pop=1 empty=false
输入 push(1) push(2) pop push(3) pop pop empty
输出 延迟倒 push 1 push 2 pop=1 push 3 pop=2 pop=3 empty=true
     每次倒 push 1 push 2 pop=1 push 3 pop=2 pop=3 empty=true
程序里的对照版本把 Transfer 直接接在每次取数前面,不判空。两组用例的结果与延迟倒的版本完全一致,差别只在于数据被搬运的次数;小规模用例看不出这个差别,规模一大就会体现出来。
边界值。
- 空队列判空:两个栈都空才是真,只看入栈会把刚倒完数据的队列判成非空。
- 连续出队:出栈里还有数据时不倒,顺序才对。
- push 和 pop 交替:
push(1) pop push(2) pop必须返回 1 和 2。 - 取队头不改变结构:
peek之后紧接着pop,两次拿到的必须是同一个值。 - 题目前提:力扣保证
pop和peek只在队列非空时调用。
复杂度:入队 O(1);出队和取队头均摊 O(1),单次最坏 O(n);空间 O(n)。
第四题 最小栈(155)
题目:设计一个栈,支持 push、pop、top 和 getMin,并且要求 getMin 在 O(1) 时间里返回栈里的最小元素。
原题链接: leetcode 155 Min Stack
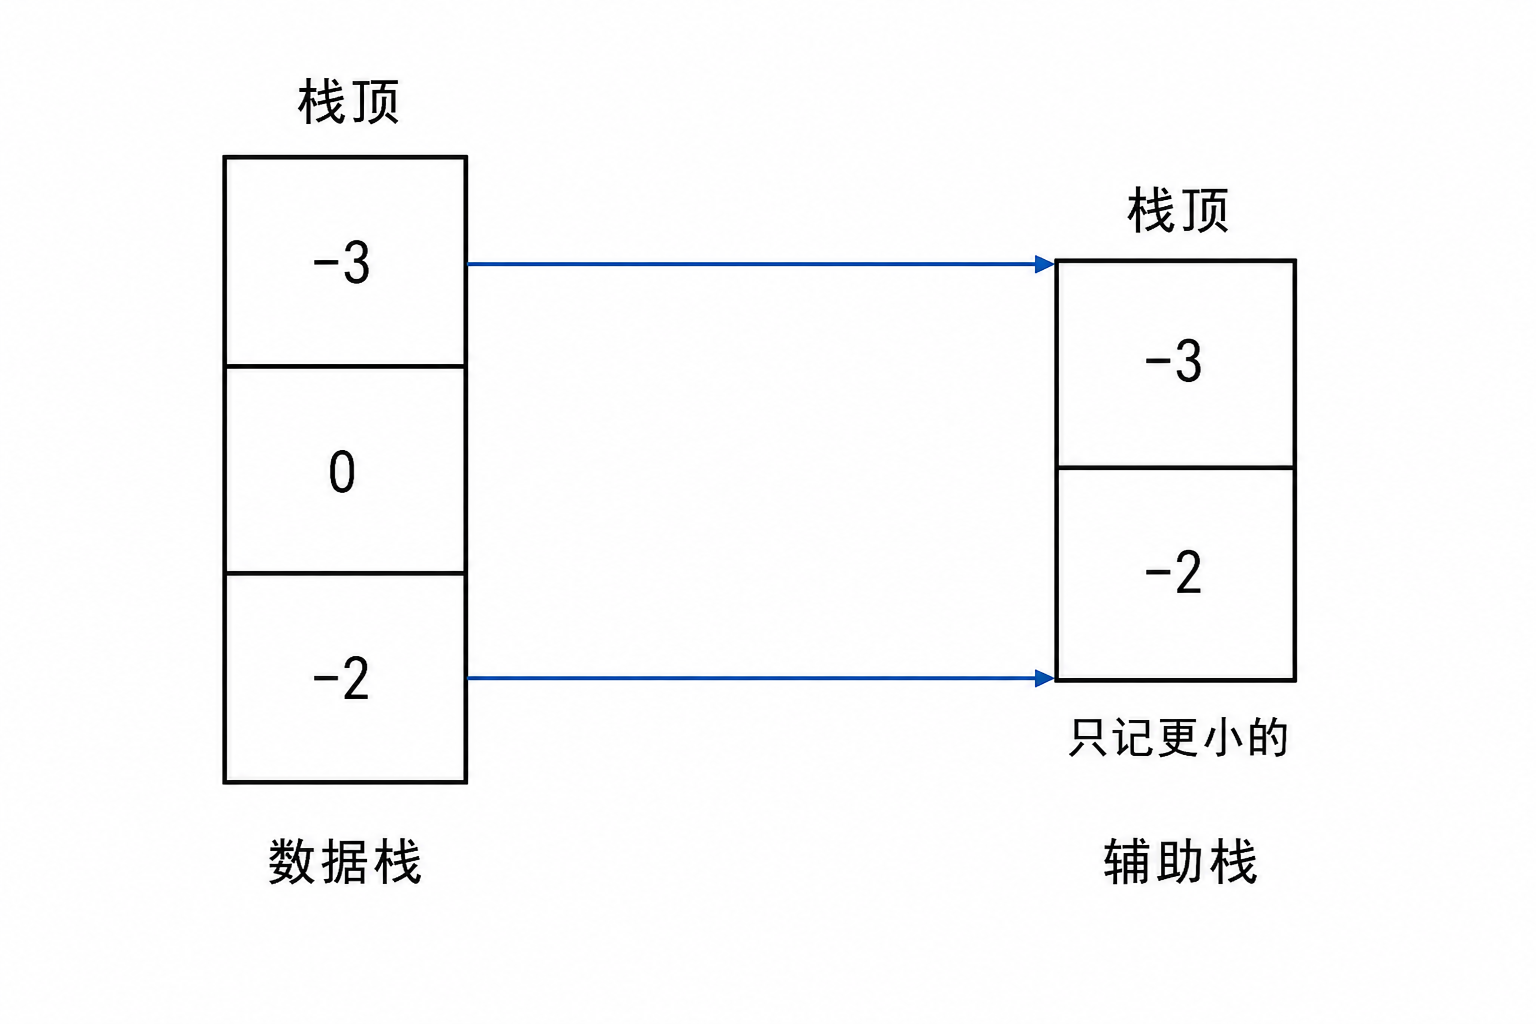
图 4 数据栈与辅助栈同步进出
每次重新查找最小值。 只用一个栈存放数据,getMin 的时候把栈里所有元素看一遍,找出最小的再放回去。这个解法完全正确,代价是每次取最小值都要 O(n);getMin 的调用一多,这份开销就会累积起来。
把最小值记录下来。 最小值的查询结果在两次入栈之间是稳定的:只要栈里不进入新元素,最小值就不会变化。查询多、变化少,就可以把每次的最小值都记录下来,用第二个栈专门保存。数据栈压入一个元素,辅助栈记录一份当前最小值;数据栈弹出一个元素,辅助栈跟着弹出一个。
一个关键细节是相等的时候压不压入。压入的值等于辅助栈栈顶时必须压入,因为出栈的判断依据是「数据栈弹出的值等于辅助栈栈顶」,辅助栈里缺了这份记录,弹掉数据之后最小值就恢复不回去。测试用例里专门放了 push(2) push(2) getMin pop getMin 这一组,两种记录方式都能跑通;如果把压入条件改成严格小于,第二次 getMin 就会给出错误的最小值。
c
typedef struct
{
	IntStack data;
	IntStack mins;
} MinStack;

void minStackPush(MinStack* obj, int val)
{
	IntStackPush(&obj->data, val);
	if (IntStackEmpty(&obj->mins) || val <= IntStackTop(&obj->mins))
	{
		IntStackPush(&obj->mins, val);
	}
}

void minStackPop(MinStack* obj)
{
	int val;
	if (IntStackEmpty(&obj->data))
	{
		return;
	}
	val = IntStackTop(&obj->data);
	IntStackPop(&obj->data);
	if (!IntStackEmpty(&obj->mins) && IntStackTop(&obj->mins) == val)
	{
		IntStackPop(&obj->mins);
	}
}

int minStackGetMin(MinStack* obj)
{
	return IntStackTop(&obj->mins);
}
getMin 就是取辅助栈的栈顶,只有一行代码。辅助栈的栈顶永远是当前数据栈里的最小值:每次入栈都把新的最小值和旧的最小值比较过一次,出栈时又同步把过期的那个弹掉。两个栈的高度不必相同,但栈顶始终是对应关系。
逐步展开。 操作序列是 push(-2) push(0) push(-3) getMin pop top getMin:
| 操作 | data 栈(栈底在左) | mins 栈(栈底在左) | 返回 |
|---|---|---|---|
| push -2 | -2 | -2 辅助栈空,直接记 | 无 |
| push 0 | -2 0 | -2 0 比 -2 大,不记 | 无 |
| push -3 | -2 0 -3 | -2 -3 -3 比 -2 小,记 | 无 |
| getMin | -2 0 -3 | -2 -3 | -3 |
| pop | -2 0 | -2 弹出的 -3 等于栈顶,同步弹 | 无 |
| top | -2 0 | -2 | 0 |
| getMin | -2 0 | -2 | -2 |
第 2 步容易被忽略:0 比当前最小值大,辅助栈不需要记录,只要 0 还在栈里,最小值就不会是它。第 5 步是同步出栈,弹出的值正好等于辅助栈栈顶时才弹出辅助栈;如果不相等,说明这个元素从来不是最小值。
text
data:  [-2]        [-2 0]      [-2 0 -3]   [-2 0]      [-2 0]
mins:  [-2]        [-2]        [-2 -3]     [-2]        [-2]
        push -2     push 0      push -3     pop         getMin -> -2
                                  getMin -> -3
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p04_min_stack p04_min_stack.c
./p04_min_stack
text
输入 push(-2) push(0) push(-3) getMin pop top getMin
输出 辅助栈不设下限 push -2 push 0 push -3 getMin=-3 pop top=0 getMin=-2
     辅助栈同高 push -2 push 0 push -3 getMin=-3 pop top=0 getMin=-2
输入 push(2) push(2) getMin pop getMin pop push(5) getMin
输出 辅助栈不设下限 push 2 push 2 getMin=2 pop getMin=2 pop push 5 getMin=5
     辅助栈同高 push 2 push 2 getMin=2 pop getMin=2 pop push 5 getMin=5
程序里的对照版本让辅助栈和数据栈严格同高,每个元素都记录一份当前最小值,写法更短,空间多占一份。两组用例的结果一致,具体选择取决于更看重代码长度还是空间占用。
边界值。
- 压入相等的最小值:必须记录,否则弹出之后最小值就恢复不回去。
- 全部元素相同:辅助栈和数据栈同高,
getMin一直是那个值。 - 单个元素:
getMin、top和pop面对的是同一个元素。 - 空栈上出栈:力扣保证不会调用,函数里加了一道判空返回,属于防御性写法。
- 比当前最小值更小的负数:
-3压进来之后getMin必须立刻变成-3。
复杂度:四个操作都是 O(1);空间 O(n),辅助栈最坏和数据栈一样高。
第五题 逆波兰表达式求值(150)
题目:给你一个字符串数组 tokens,表示一个按逆波兰表示法写成的算术表达式,求它的值。合法的运算符是加、减、乘、除四种,每个操作数都是整数,两个整数相除只保留整数部分。力扣给 C 语言的签名是 int evalRPN(char** tokens, int tokensSize)。
原题链接: leetcode 150 Evaluate Reverse Polish Notation
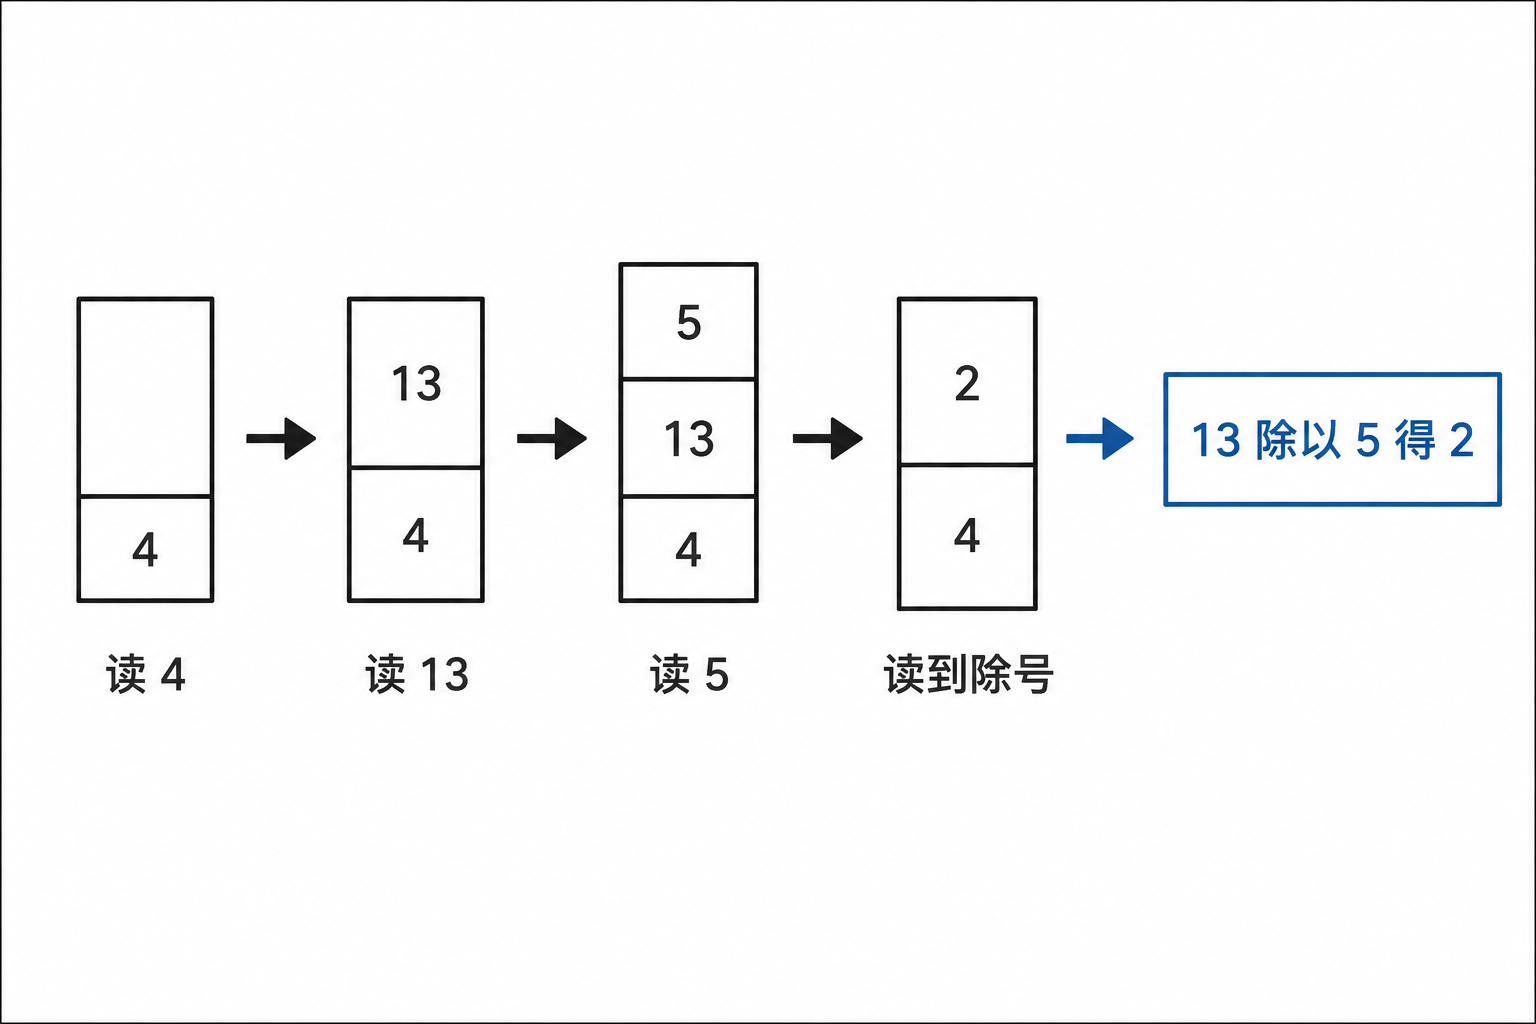
图 5 逆波兰表达式求值时操作数栈的变化
就地替换三项。 从左往右找第一个运算符,它左边两个位置一定是两个操作数,这是后缀表达式(postfix expression)的性质:运算符写在两个操作数后面。把这两个数按运算符计算出来,用结果替换掉这三项,数组长度减 2,如此重复直到只剩一个数。这个做法的正确性直接来自后缀表达式的定义,代价在元素的搬移上:每计算一次都要把后面的元素整体往前挪两格,n 个 token 要计算 n 减 1 次,总体是 O(n²)。
一遍扫描。 后缀表达式的求值顺序天然是先出现的先计算,中间结果只在被用到的那一刻才有价值。一个运算符所需要的两个操作数,就是它左边最近的两个还没有被用掉的结果。这正是栈的适用场景:遇到数字压栈,遇到运算符弹出两个操作数进行计算,算完把结果压回去;一遍扫描结束,栈里只剩一个数,就是答案。
这个做法成立的理由可以从表达式树(expression tree)的角度看:任何一个合法的后缀表达式都对应一棵表达式树,后缀形式就是这棵树的后序遍历。按照后序的顺序扫描时,栈里存放的是已经计算完、但父结点还没有凑齐的那几棵子树的值。遇到运算符时,栈顶两个元素正好是它的右子树和左子树,弹出计算完再压回去,相当于把这棵子树折叠成一个数。扫描结束时整棵树折叠成一个值,也就是栈顶那个数。中间结果在被父结点取走之前必须留在栈里,这是后缀表达式能够一遍扫完的原因。
c
int evalRPN(char** tokens, int tokensSize)
{
	IntStack st;
	int i;
	int res;

	IntStackInit(&st);
	for (i = 0; i < tokensSize; ++i)
	{
		char* tk = tokens[i];
		if (strcmp(tk, "+") == 0 || strcmp(tk, "-") == 0 ||
			strcmp(tk, "*") == 0 || strcmp(tk, "/") == 0)
		{
			int r = IntStackTop(&st);
			int l;
			IntStackPop(&st);
			l = IntStackTop(&st);
			IntStackPop(&st);
			if (tk[0] == '+') IntStackPush(&st, l + r);
			else if (tk[0] == '-') IntStackPush(&st, l - r);
			else if (tk[0] == '*') IntStackPush(&st, l * r);
			else IntStackPush(&st, l / r);
		}
		else
		{
			IntStackPush(&st, atoi(tk));
		}
	}
	res = IntStackTop(&st);
	IntStackDestroy(&st);
	return res;
}
有两个地方容易写反。第一处是弹出顺序:先弹出的是右操作数,后弹出的是左操作数,减法和除法对顺序敏感,写反之后 4 2 - 会算出 -2 而不是 2。第二处是运算符的判断:这里先按字符串比较识别出运算符,再按首字符分派到具体的运算,atoi 负责把负数也正确转成整数。
走一遍。 用例取 4 13 5 / +,看除法那一步的两个操作数从哪来:
| 步骤 | token | 动作 | 栈内容(栈底在左) |
|---|---|---|---|
| 1 | 4 | 数字,入栈 | 4 |
| 2 | 13 | 数字,入栈 | 4 13 |
| 3 | 5 | 数字,入栈 | 4 13 5 |
| 4 | / | 弹出右操作数 5、左操作数 13,13 除以 5 得 2,结果入栈 | 4 2 |
| 5 | + | 弹出右操作数 2、左操作数 4,相加得 6,结果入栈 | 6 |
| 结束 | 无 | 栈里只剩一个数,就是表达式的值 | 6 |
第 4 步如果把弹出的两个数写反,13 和 5 会变成 5 除以 13 得 0,后面整个结果就错了。除法的另一个细节是 C 的整数除法向零截断,7 -3 / 得到 -2 而不是 -3。
text
输入 4 13 5 / +                左操作数在栈顶下面,别拿反

push 4   栈: [4]          push 5    栈: [4 13 5]
push 13  栈: [4 13]       /         栈: [4 2]     13 / 5 = 2
                          +         栈: [6]       4 + 2 = 6
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p05_eval_rpn p05_eval_rpn.c
./p05_eval_rpn
text
输入 tokens = [2 1 + 3 *]
输出 9(对照解法 9)
输入 tokens = [4 13 5 / +]
输出 6(对照解法 6)
输入 tokens = [10 6 9 3 + -11 * / * 17 + 5 +]
输出 22(对照解法 22)
输入 tokens = [7 -3 /]
输出 -2(对照解法 -2)
输入 tokens = [18]
输出 18(对照解法 18)
第三组是力扣的官方长用例,十三项里既有负数又有多层嵌套,两个解法的结果都是 22。对照解法把栈换成了定长数组,逻辑完全一样,说明这道题的关键不在栈的实现上。
边界值。
- 只有一个 token:循环里的运算符分支一次都不进,直接返回那个数。
- 负数操作数:
-11这种要靠atoi认出来,自己写解析容易只处理正数。 - 除法结果:
7除以-3得-2,向零截断,不是向下取整。 - 减法的方向:
10 6 -是 4,不是 -4,弹出顺序反了就会得到后者。 - 深层嵌套:力扣的长用例里连着四个运算符,栈最深时有四个操作数。
- 题目前提:表达式一定合法,结果和中间结果都在 32 位整数范围内,不需要考虑溢出。
复杂度:时间 O(n),每个 token 进栈出栈各一次;空间 O(n),最坏是表达式先写完所有操作数再写运算符。
第六题 验证栈序列(946)
题目:给两个整数序列 pushed 和 popped,每个序列里的值互不相同,pushed 是元素入栈的顺序,问 popped 有没有可能是这些元素出栈的顺序。力扣给 C 语言的签名是 bool validateStackSequences(int* pushed, int pushedSize, int* popped, int poppedSize)。
原题链接: leetcode 946 Validate Stack Sequences
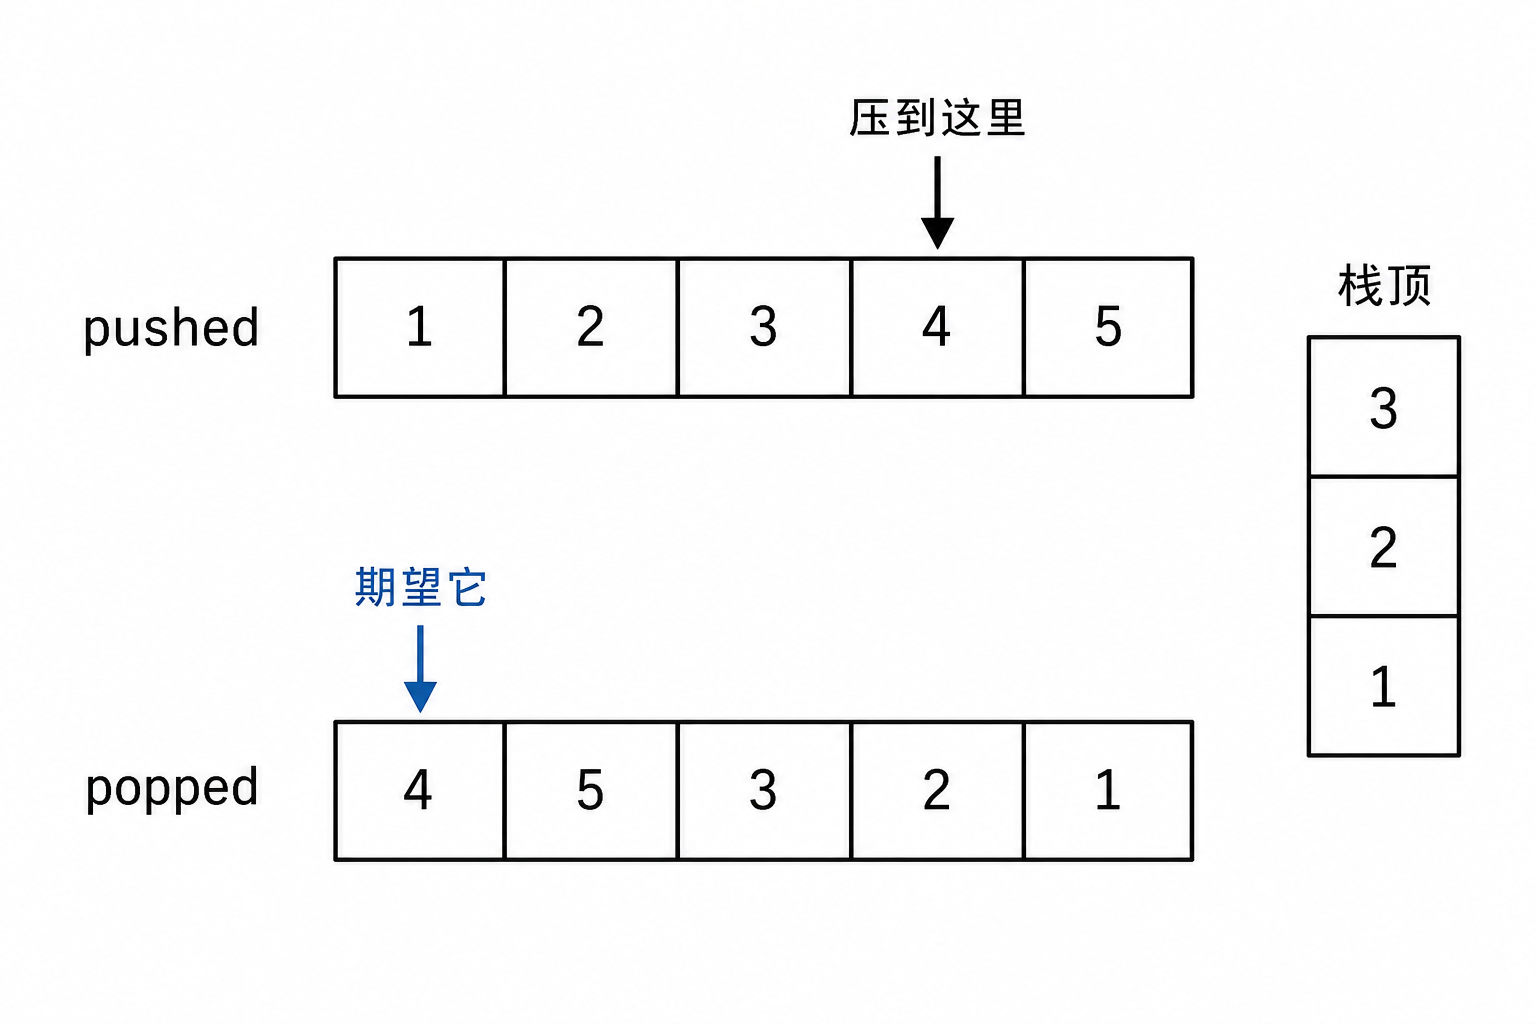
图 6 照着出栈顺序模拟,能弹就弹
两条路都尝试。 每一步只有两个选择:把下一个元素压进来,或者把栈顶弹出去。两条路都尝试并递归下去,看是否存在一条路径能够正好走出 popped。这是穷举,绝对正确,代价是指数级:n 个元素对应卡特兰数(Catalan number)那么多种出栈序列,n 到了二十就慢得无法接受。程序里保留了这个穷举版本作为对照,只用来跑长度 6 和 8 的随机数据。
只有一条分支有效。 只要栈顶元素等于 popped 里下一个要输出的元素,这一步就必须弹出。如果继续压入,新压进来的元素按后进先出的规则一定排在这个元素后面出栈,输出的下一个元素就不再是它,这条路径走不通。因此「能弹就弹」不会丢掉答案,贪心策略成立。
具体的动作是:按 pushed 的顺序压栈,每压入一个元素就检查栈顶是否等于 popped 当前要输出的元素,相等就弹出并把 popped 的下标往前推,重复到不相等为止;pushed 全部压完之后,如果栈为空并且 popped 的下标也走完了,就是合法的出栈序列。两个序列各扫描一遍,每个元素压栈和出栈也各只有一次。
c
bool validateStackSequences(int* pushed, int pushedSize, int* popped, int poppedSize)
{
	IntStack st;
	int i = 0, j = 0;

	IntStackInit(&st);
	while (i < pushedSize)
	{
		IntStackPush(&st, pushed[i++]);
		while (!IntStackEmpty(&st) && j < poppedSize && IntStackTop(&st) == popped[j])
		{
			IntStackPop(&st);
			++j;
		}
	}
	i = IntStackEmpty(&st) && j == poppedSize;
	IntStackDestroy(&st);
	return i != 0;
}
内层循环是 while 而不是 if,这道题写错多半错在这里:压进一个新元素之后可能连着弹出好几个。pushed 是 1 到 5、popped 是 4 5 3 2 1 时,压到 5 会连着把 5、3、2、1 全部弹出去;写成 if 就只能弹出一个,剩下的留在栈里,答案会被误判成假。压入和弹出在同一次外层循环里交替发生,判定的时机只能放在压栈之后。
照着 pushed 走一遍。 pushed 是 [1 2 3 4 5],popped 是 [4 5 3 2 1]:
| 轮次 | 动作 | 栈内容(栈底在左) | j 与期望值 |
|---|---|---|---|
| 压 1 | 入栈 1,栈顶 1 不等于期望的 4 | 1 | j = 0,期望 4 |
| 压 2 | 入栈 2,栈顶 2 不等于 4 | 1 2 | j = 0,期望 4 |
| 压 3 | 入栈 3,栈顶 3 不等于 4 | 1 2 3 | j = 0,期望 4 |
| 压 4 | 入栈 4,栈顶 4 等于 4,弹出去 | 1 2 3 | j = 1,期望 5 |
| 压 5 | 入栈 5,栈顶 5 等于 5,弹出;接着栈顶 3 等于 3,弹出 | 1 2 | j = 3,期望 2 |
| 继续弹 | 栈顶 2 等于 2,弹出;栈顶 1 等于 1,弹出 | 空 | j = 5,popped 走完 |
| 结束 | 栈空且 j 等于长度,返回 true | 空 | 无 |
换成 popped 是 [4 3 5 1 2],走到压完 5 的时候栈里是 [1 2 3],栈顶 3 和期望的 1 对不上;此时 pushed 已经用完,栈里还有元素没有弹出来,返回 false。
text
输入 pushed [1 2 3 4 5]  popped [4 5 3 2 1]        输入 pushed [1 2 3 4 5]  popped [4 3 5 1 2]

push 1  [1]     期望 4               push 1  [1]     期望 4
push 2  [1 2]   期望 4               push 2  [1 2]   期望 4
push 3  [1 2 3] 期望 4               push 3  [1 2 3] 期望 4
push 4  [1 2 3] 弹出 4,期望 5        push 4  [1 2 3] 弹出 4,期望 3
push 5  []      弹出 5 3 2 1,走完    push 5  [1 2 3] 栈顶 3 不等于 1,压完了
返回 true                            返回 false,栈里还剩 3 个
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p06_validate_stack_sequences p06_validate_stack_sequences.c
./p06_validate_stack_sequences
text
输入 pushed = [1 2 3 4 5]  popped = [4 5 3 2 1]
输出 true(穷举法 true)
输入 pushed = [1 2 3 4 5]  popped = [4 3 5 1 2]
输出 false(穷举法 false)
输入 pushed = [1 0]  popped = [0 1]
输出 true(穷举法 true)
对拍 2000 组随机排列(长度 6),不一致 0 组
对拍 2000 组随机排列(长度 8),不一致 0 组
随机对拍的做法是构造两个长度相同的随机排列,一个作为入栈顺序,一个作为出栈顺序,模拟法和穷举法各判定一次,四千组结果全部一致。第三组用例 pushed [1 0]、popped [0 1] 是力扣官方给出的边界:压 1 再压 0,弹出 0 再弹出 1,合法。
边界值。
- 长度为一:压进来立刻弹出去,返回 true。
- 完全逆序:pushed 是 1 到 n、popped 是 n 到 1,一路压到底再一路弹出,返回 true。
- 完全顺序:popped 和 pushed 相同,每压一个就弹一个,栈深始终是 1,返回 true。
- 明显不合法:
[4 3 5 1 2]这种,扫描结束时栈里还有元素。 - 弹多个:内层必须是
while,写if会在真用例上误判。 - 题目前提:两个序列里的值互不相同且长度相等,值重复时同一个值可能对应多个位置,题目本身就没法判了。
复杂度:时间 O(n),每个元素进栈一次出栈一次;空间 O(n),栈最深时可能装下整个 pushed。
第七题 每日温度(739)
题目:给一个整数数组 temperatures 表示每天的温度,返回一个数组 answer,其中 answeri 表示第 i 天之后第一个更高温度出现在第几天之后,如果之后都不会更高,answeri 填 0。
原题链接: leetcode 739 Daily Temperatures
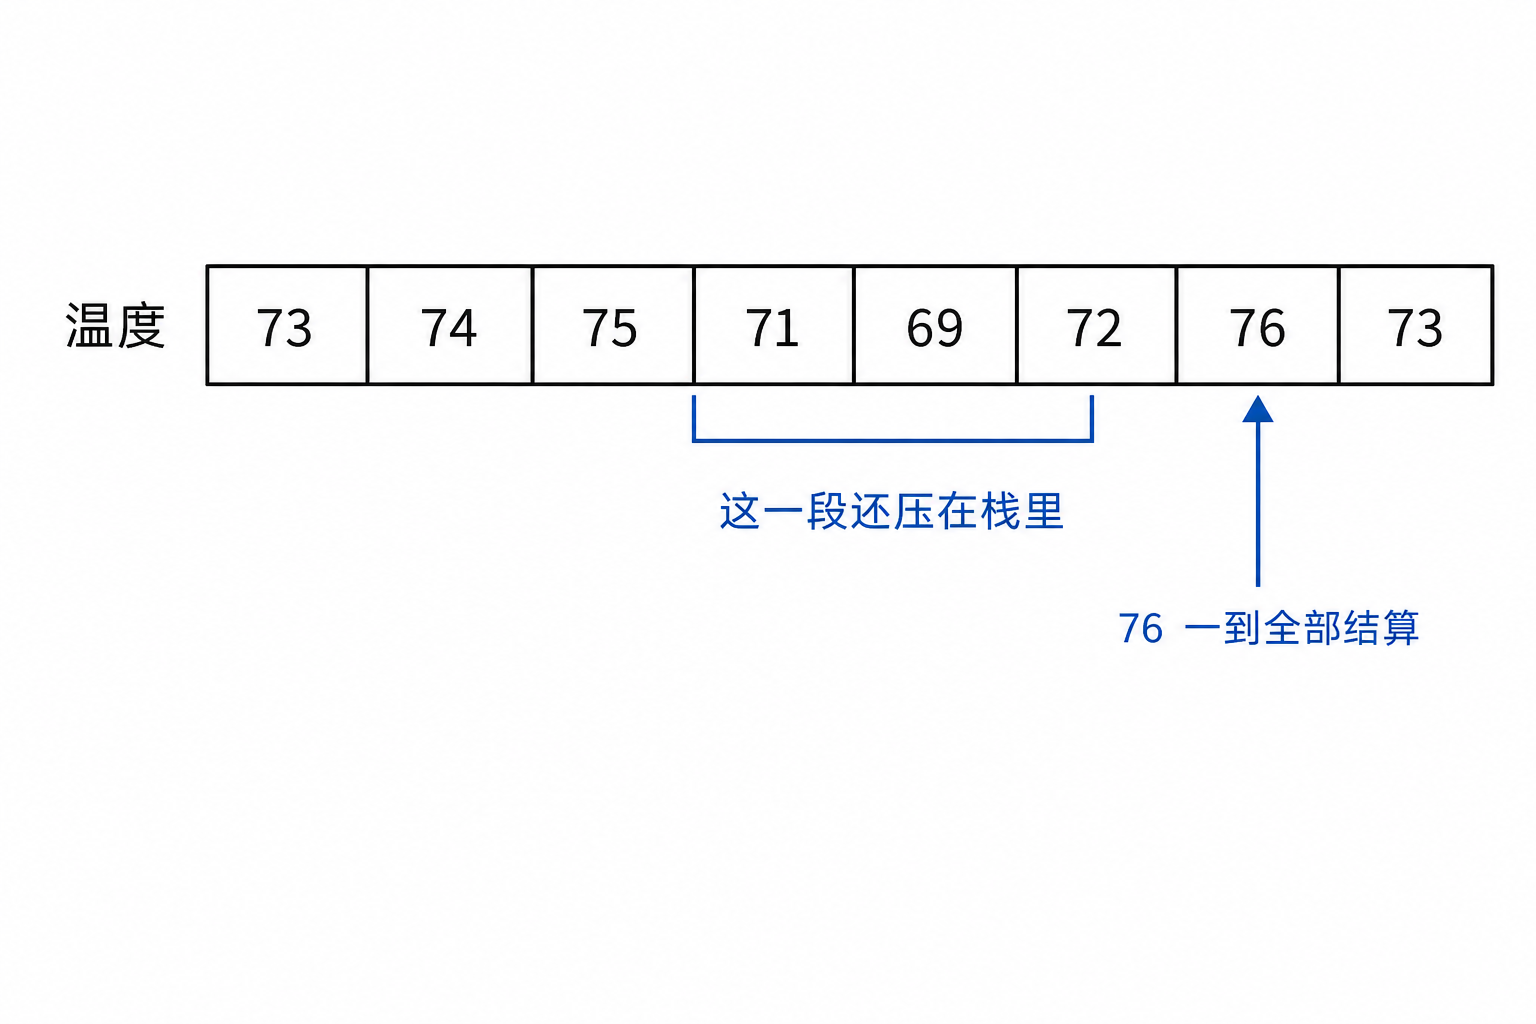
图 7 单调栈里积压的是还没等到更暖日子的那些天
逐天往后数。 对每一天,从它后面一天开始往后数,数到第一个温度更高的日子就把距离记下来,数不到就填 0。这个写法不需要额外的理解成本,代价是最坏 O(n²):温度一路递减时,每一天都要数到数组末尾才发现没有更暖的日子。实测里特意构造了一组递减的温度来测量这个差距。
让每一天只结算一次。 暴力解的浪费在于重复查看同一段数据:第 3 天往后看时路过第 4、5 天,第 4 天往后看时又路过第 5 天。换一个角度,让每一天只在遇到「更暖的一天」时才结算一次,就可以一遍扫完。维护一个栈,里面存还没有找到更暖日子的那些天的下标,它们的温度从栈底到栈顶严格递减;新来的一天温度是 t 时,把温度比 t 低的栈顶下标全部弹出,这些天等到的第一个更暖的日子就是今天,距离是下标之差。
关键在于栈里那一串温度为什么一定递减。如果栈里有两个下标 i 小于 j,而第 i 天的温度不高于第 j 天,那么在第 j 天入栈时,第 i 天早就被弹出去结算过了,不可能还留在栈里。所以栈里留下的日子温度必然递减。由此可以得到两点:某一天 d 还在栈里,说明从 d 到当前这一天之间的所有日子温度都不超过第 d 天;新来的一天温度一旦超过第 d 天,它就是第 d 天右边第一个更暖的日子,可以直接结算。每个下标进栈一次、出栈一次,总共 O(n)。比较的对象始终是栈顶,温度从数组里直接读取。
c
int* dailyTemperatures(int* temperatures, int temperaturesSize, int* returnSize)
{
	int* res;
	IntStack st;
	int i;

	*returnSize = temperaturesSize;
	res = (int*)calloc((size_t)(temperaturesSize > 0 ? temperaturesSize : 1), sizeof(int));
	if (res == NULL)
	{
		fprintf(stderr, "dailyTemperatures: calloc failed\n");
		exit(1);
	}
	IntStackInit(&st);
	for (i = 0; i < temperaturesSize; ++i)
	{
		while (!IntStackEmpty(&st) && temperatures[IntStackTop(&st)] < temperatures[i])
		{
			int idx = IntStackTop(&st);
			IntStackPop(&st);
			res[idx] = i - idx;
		}
		IntStackPush(&st, i);
	}
	IntStackDestroy(&st);
	return res;
}
栈里存的是下标而不是温度,因为结果需要的是天数之差,只有温度算不出距离。结果数组用 calloc 一次清零,那些等不到更暖日子的位置自然就是 0,省掉了一趟初始化。
把数组扫一遍。 输入 [73 74 75 71 69 72 76 73]:
| 下标 | 温度 | 动作 | 栈内容(栈底在左) | 结果 |
|---|---|---|---|---|
| 0 | 73 | 栈空,入栈 | 0 | 未定 |
| 1 | 74 | 74 比 73 高,弹 0,记第 0 天,距离 1;入栈 1 | 1 | answer0 = 1 |
| 2 | 75 | 75 比 74 高,弹 1,距离 1;入栈 2 | 2 | answer1 = 1 |
| 3 | 71 | 71 不高于 75,直接入栈 | 2 3 | 未定 |
| 4 | 69 | 69 不高于 71,直接入栈 | 2 3 4 | 未定 |
| 5 | 72 | 弹 4,距离 1;弹 3,距离 2;72 不高于 75,停;入栈 5 | 2 5 | answer4 = 1,answer3 = 2 |
| 6 | 76 | 弹 5,距离 1;弹 2,距离 4;栈空;入栈 6 | 6 | answer5 = 1,answer2 = 4 |
| 7 | 73 | 73 不高于 76,入栈 | 6 7 | 未定 |
| 结束 | 无 | 栈里剩 6 和 7,没有更暖的日子,保持 0 | 6 7 | answer6 = 0,answer7 = 0 |
第 5 步一次弹出两个下标,因为一天可能给好几天当答案,内层循环必须写成 while。第 6 步弹出的下标 2 距离是 4,它和下标 6 之间隔着 71、69、72 三天。
text
下标      0    1    2    3    4    5    6    7
温度     73   74   75   71   69   72   76   73
                  ↑         ↑    ↑    ↑
栈的变化   [0]→[1]→[2]→[2 3]→[2 3 4]→[2 5]→[6]→[6 7]
结算                  0    1         4    3    5
答案      1    1    4    2    1    1    0    0
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p07_daily_temperatures p07_daily_temperatures.c
./p07_daily_temperatures
text
输入 temperatures = [73 74 75 71 69 72 76 73]
输出 [1 1 4 2 1 1 0 0](对照解法 [1 1 4 2 1 1 0 0])
输入 temperatures = [30 40 50 60]
输出 [1 1 1 0](对照解法 [1 1 1 0])
输入 temperatures = [90 80 70]
输出 [0 0 0](对照解法 [0 0 0])
输入 temperatures = [30]
输出 [0](对照解法 [0])
对拍 2000 组随机温度(长度 8),不一致 0 组
对拍 2000 组随机温度(长度 16),不一致 0 组
规模 8000 的递减温度:单调栈单次约 0.0550 毫秒(2000 次平均),暴力一次 80.00 毫秒,相差 1455 倍
递减输入下单调栈最深积压 8000 个下标,每个下标 4 字节
最后两行是特意加入的实测。递减的温度是暴力解最不利的输入,每一天都要看到数组末尾才知道没有更暖的日子;同一组数据下,单调栈快了三个数量级。第二行测量的是空间:递减输入下没有任何一天会被弹出,栈里积压了全部 8000 个下标,这是单调栈空间复杂度的最坏情况,每个下标占四个字节。
边界值。
- 只有一个元素:循环一次,栈里留一个下标,结果是 0。
- 严格递增:每天都被下一天结算,答案全是 1,除了最后一天是 0。
- 严格递减:没有任何一天被结算,答案全是 0,栈里积压全部下标。
- 温度全部相同:比较用的是严格小于,相等的日子不会互相结算,答案全是 0。
- 数组为空:
calloc申请一个元素避免申请零字节,循环不进,返回空数组。 - 题目前提:温度在 30 到 100 之间,长度最多 10⁵,结果数组要由调用者释放。
复杂度:时间 O(n),每个下标进栈一次、出栈一次,均摊到每天是常数;空间 O(n),最坏是递减序列,栈里积压 n 个下标。
第八题 下一个更大元素 I(496)
题目:给两个没有重复元素的数组 nums1 和 nums2,nums1 是 nums2 的子集。对 nums1 里的每个数,找出它在 nums2 中右边第一个比它大的数,不存在就填 -1。
原题链接: leetcode 496 Next Greater Element I
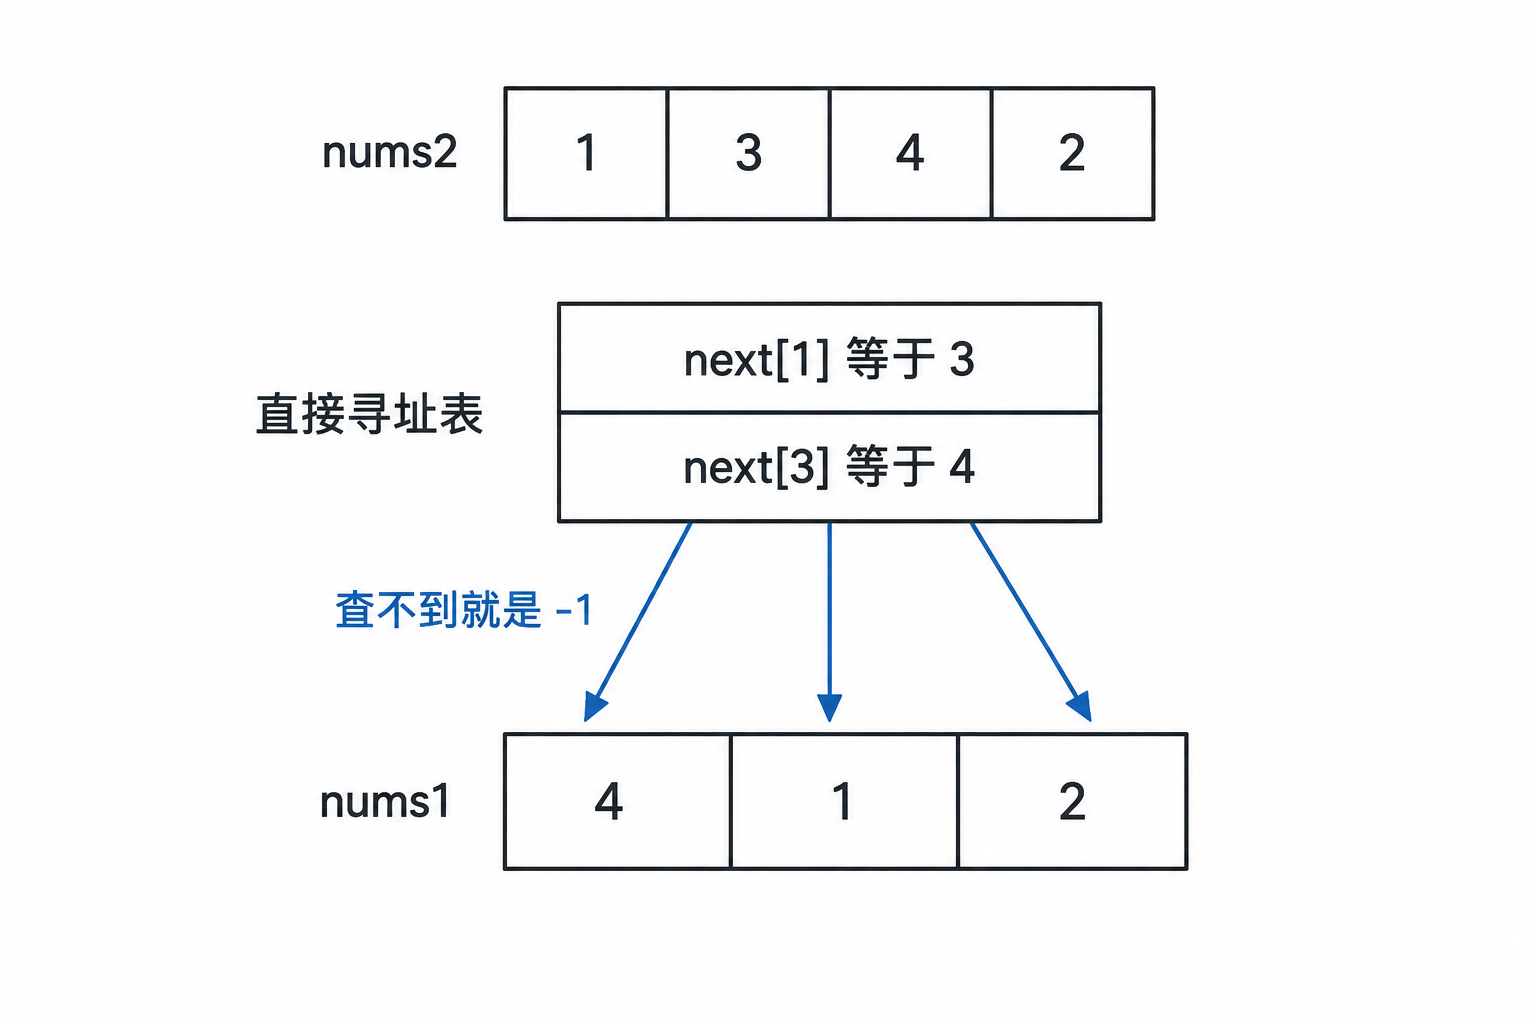
图 8 单调栈求出的答案存进直接寻址表再查回来
逐个定位再线性查找。 对 nums1 里的每个数,先在 nums2 里从头找到它,再从它右边逐个比较过去,找到第一个更大的就记下来,找不到就填 -1。开销是两层循环外加上一层定位,最坏 O(n 乘 m),同时 nums2 里每个数的答案会被反复计算:nums1 里的数在 nums2 中的位置关系不会因为查询次数而改变。
改成一遍扫描加查表。 把「在 nums2 上求下一个更大元素」这件事做成一遍扫描,答案保存起来,nums1 只负责查表。求答案的部分和每日温度是同一个骨架:栈里存还没有找到更大元素的值,从栈底到栈顶递减;新元素进入时,把比它小的栈顶全部弹出并记下答案。区别只有两点:栈里存的是值而不是下标,因为结果需要的是那个数本身;答案记录在一张按值索引的表里,而不是按下标记录在结果数组里。
表采用直接寻址(direct addressing)数组,因为题目的值域只有 1 到 10⁴,开一个 10001 个整数的数组,用值作为下标,比哈希表(hash table)更快也更容易实现。这个选择有前提,本节末尾会给出前提被破坏时的实测结果。
c
int* nextGreaterElement(int* nums1, int nums1Size, int* nums2, int nums2Size, int* returnSize)
{
	int* res = (int*)malloc((size_t)(nums1Size > 0 ? nums1Size : 1) * sizeof(int));
	int* next = (int*)malloc((VALUE_MAX + 1) * sizeof(int));
	IntStack st;
	int i;

	if (res == NULL || next == NULL)
	{
		fprintf(stderr, "nextGreaterElement: malloc failed\n");
		exit(1);
	}
	for (i = 0; i <= VALUE_MAX; ++i)
	{
		next[i] = -1;
	}
	IntStackInit(&st);
	for (i = 0; i < nums2Size; ++i)
	{
		while (!IntStackEmpty(&st) && IntStackTop(&st) < nums2[i])
		{
			next[IntStackTop(&st)] = nums2[i];
			IntStackPop(&st);
		}
		IntStackPush(&st, nums2[i]);
	}
	for (i = 0; i < nums1Size; ++i)
	{
		res[i] = next[nums1[i]];
	}
	IntStackDestroy(&st);
	free(next);
	*returnSize = nums1Size;
	return res;
}
表先整体填入 -1,在 nums2 里找不到更大元素的数自然对应 -1,不需要再写第二个分支。next 是扫描过程中的临时空间,函数返回前释放掉,返回给调用者的只有结果数组。
扫描与查表分开看。 nums2 是 [1 3 4 2],nums1 是 [4 1 2]:
| 下标 | nums2 的值 | 动作 | 栈内容(栈底在左) | 表的变化 |
|---|---|---|---|---|
| 0 | 1 | 栈空,入栈 | 1 | 无 |
| 1 | 3 | 3 大于 1,弹 1 并记答案;入栈 3 | 3 | next1 = 3 |
| 2 | 4 | 4 大于 3,弹 3 并记答案;入栈 4 | 4 | next3 = 4 |
| 3 | 2 | 2 小于 4,入栈 | 4 2 | 无 |
| 结束 | 无 | 栈里剩 4 和 2,都没有更大的数,表里保持 -1 | 4 2 | next4 = -1,next2 = -1 |
| 查表 | nums1 = 4 1 2 | 依次查 next4、next1、next2 | 无 | 输出 -1 3 -1 |
第 1 步和第 2 步是这道题的全部动作,剩下的都是查表。栈里永远只存放还没有找到答案的数,找到就立刻弹出,栈的深度等于「还没有被更大的数覆盖的那些数」的个数,栈越浅说明已经有越多的数被后面更大的数覆盖过去。
text
nums2  1    3    4    2          nums1  4   1   2
       ↑    ↑    ↑                        ↓   ↓   ↓
栈     [1]→[3]→[4]→[4 2]          查表  -1  3  -1
表     next[1]=3  next[3]=4
       next[4]=-1 next[2]=-1(栈里剩下的保持 -1)
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p08_next_greater_element_i p08_next_greater_element_i.c
./p08_next_greater_element_i
text
输入 nums1 = [4 1 2]  nums2 = [1 3 4 2]
输出 [-1 3 -1](对照解法 [-1 3 -1])
输入 nums1 = [2 4]  nums2 = [1 2 3 4]
输出 [3 -1](对照解法 [3 -1])
输入 nums1 = [1]  nums2 = [1]
输出 [-1](对照解法 [-1])
输入 nums1 = [3 5]  nums2 = [5 3 4 3 6](值有重复)
输出 [6 6](按第一次出现算 [4 6])
两组答案在值 3 上不同
对拍 2000 组随机数据(nums2 长度 8,值互不相同),不一致 0 组
第四组是故意构造的破坏前提的输入。题目保证 nums2 里的数互不相同;一旦出现重复,同一个值在 nums2 里出现两次,而直接寻址表只有一个格子,后一次写入会把前一次的答案覆盖掉。这里的输出 6 6 对应最后出现的那一次,按第一次出现理解的答案是 4 6。用 C 写这道题时,值域和互不相同这两条前提都要先确认;把这份代码搬到别的数据上,破坏前提的代价是静默出错。
换成 C++ 的写法。 值域一旦变大,直接寻址表就容纳不下,这时候应当改用哈希表。C 里没有现成的哈希表,用 C++ 的 unordered_map 写起来只有十来行,逻辑和前面完全一样:
cpp
class Solution
{
public:
	vector<int> nextGreaterElement(vector<int>& nums1, vector<int>& nums2)
	{
		unordered_map<int, int> next;
		stack<int> st;

		for (size_t i = 0; i < nums2.size(); ++i)
		{
			while (!st.empty() && st.top() < nums2[i])
			{
				next[st.top()] = nums2[i];
				st.pop();
			}
			st.push(nums2[i]);
		}

		vector<int> res;
		for (size_t i = 0; i < nums1.size(); ++i)
		{
			unordered_map<int, int>::iterator it = next.find(nums1[i]);
			res.push_back(it == next.end() ? -1 : it->second);
		}
		return res;
	}
};
bash
# 所属目录:/home/cocatrice/ds07
g++ -std=c++11 -Wall -Wextra -g -o p08b_next_greater_stl p08b_next_greater_stl.cpp
./p08b_next_greater_stl
text
输入 nums1 = [4 1 2]  nums2 = [1 3 4 2]
输出 [-1 3 -1]
输入 nums1 = [2 4]  nums2 = [1 2 3 4]
输出 [3 -1]
输入 nums1 = [1]  nums2 = [1]
输出 [-1]
两个版本的输出逐行相同。取舍很清楚:C 的直接寻址表占用 O(值域) 空间,一次寻址就是一次数组下标运算;unordered_map 占用 O(nums2 长度) 空间,多一层哈希开销,但值域多大都能使用,还提供了现成的 find 判断存在性。面试里先讲直接寻址,就要补充一句它的前提。两份代码的输出一致,说明答案只由扫描逻辑决定,与表的实现方式无关。
边界值。
- 只有一对数且没有更大的:返回 -1,栈里留着一个元素。
- nums2 严格递减:所有数的答案都是 -1,栈里积压 m 个元素。
- nums2 严格递增:每个数入栈后立刻被下一个数弹掉,栈深始终是 1。
- nums1 里的数是 nums2 的最大值:答案一定是 -1。
- 值重复:前提被破坏,直接寻址表只能记住一份答案,实测里给出了反例。
- 值域:直接寻址表要开到最大值那么大,本题是 1 到 10⁴,值域更大就得换成哈希表。
复杂度 :时间 O(n + m),nums2 扫一遍、nums1 查一遍;空间 O(值域) 加 O(n),值域那份是直接寻址表,换成 unordered_map 之后是 O(m)。
第九题 字符串解码(394)
题目:给一个经过编码的字符串,按规则解码。编码规则是 kencoded_string,方括号里的内容重复 k 次,k 是正整数。输入保证合法,没有多余空格,方括号总是配对,原始数据里也不含数字。
原题链接: leetcode 394 Decode String
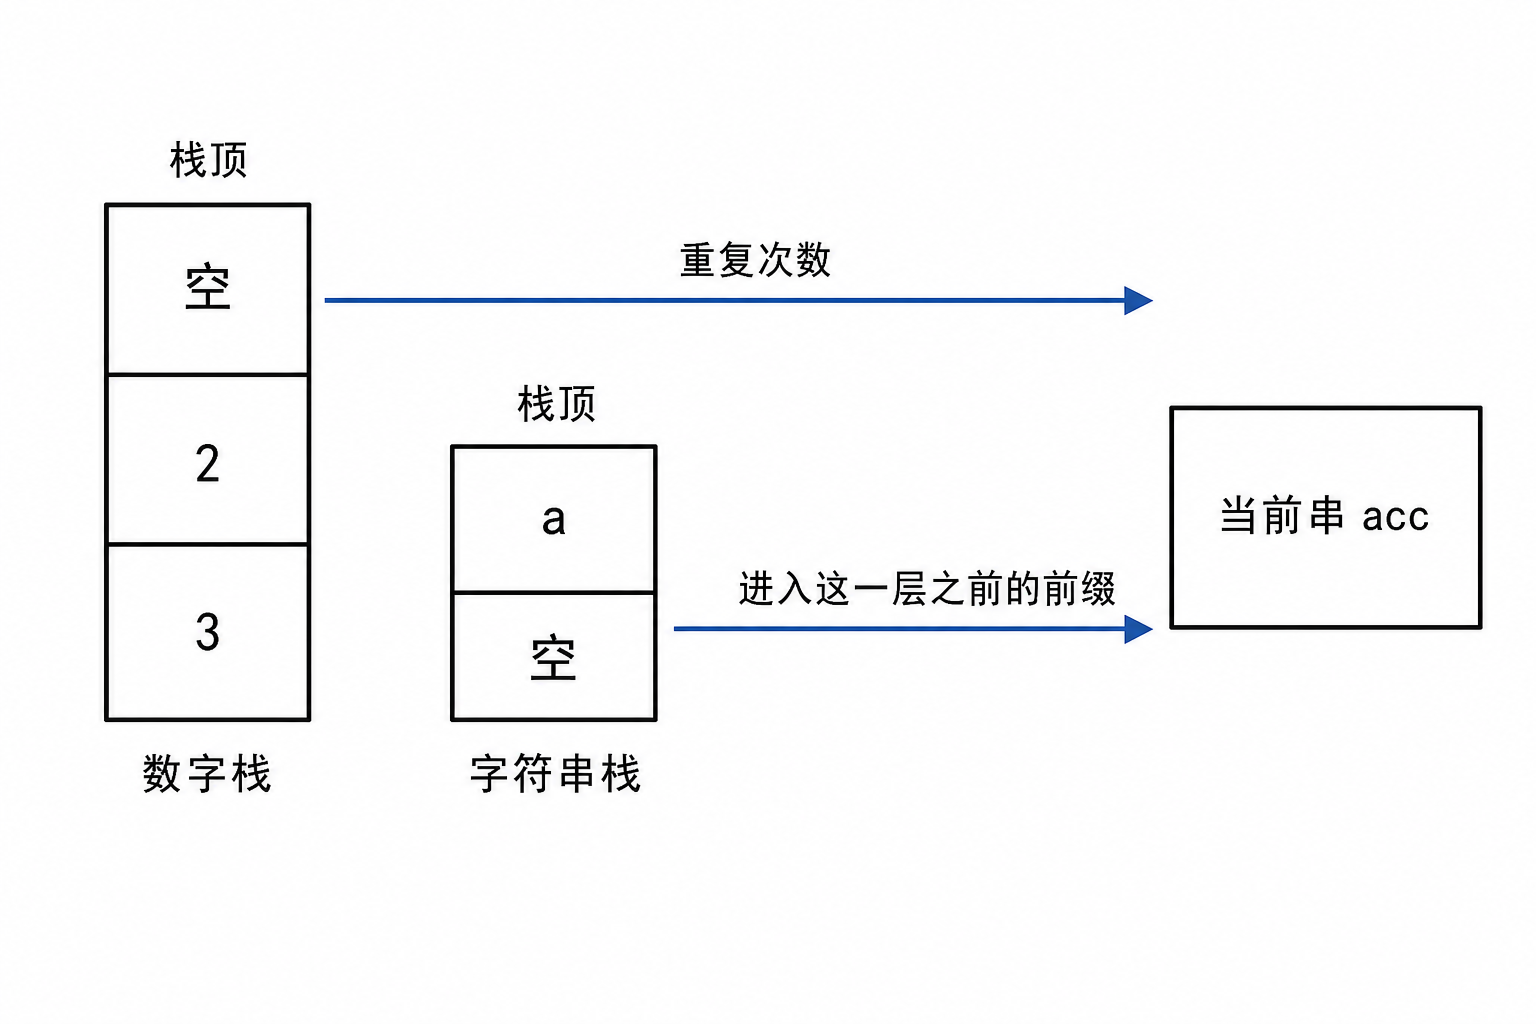
图 9 字符串解码里两个栈同时进出
从最内层括号往外替换。 找到最后一对相邻的左右括号,把里面的内容按次数重复,再用结果替换掉整段 k...;替换完继续找下一对,直到串里没有括号。这个解法完全按照定义实现,慢在每替换一次都要重建整个字符串,嵌套几层就要重建几次,最坏是 O(n²)。
两个栈加一个缓冲。 方括号构成分层结构,每一层需要记住两样东西:这一层的重复次数,以及进入这一层之前已经拼好的外面前缀。因此用两个栈:数字栈保存次数,字符串栈保存前缀,另外用一个动态缓冲存放当前这一层正在拼接的内容。动作只有四条:遇到数字,把连续的数字位拼成完整的次数压进数字栈;遇到左括号,把当前缓冲压进字符串栈并清空它;遇到右括号,弹出次数和前缀,把前缀与当前缓冲重复若干次拼接起来作为新的当前缓冲;遇到字母,追加到缓冲末尾。
这一做法成立的理由在于,整个过程可以看成一棵树的深度优先遍历。每遇到一个左括号就进入一层,左括号之前的成果和这一层的重复次数一起入栈保存;每遇到一个右括号就退出一层,把这一层的成果按次数展开,接回到上层保存的前缀后面。扫描结束时所有层都已经退出,缓冲里的内容就是最终答案。每个字符只被处理一次,进出栈的次数与嵌套层数成正比。两个栈的高度始终等于当前的嵌套层数,最外层退出之后它们同时为空。
c
char* decodeString(char* s)
{
	IntStack nums;
	StrStack prefix;
	char* cur;
	int cap = 16;
	int len = 0;
	int i = 0;

	IntStackInit(&nums);
	StrStackInit(&prefix);
	cur = (char*)malloc((size_t)cap);
	cur[0] = '\0';
	while (s[i] != '\0')
	{
		char c = s[i];
		if (c >= '0' && c <= '9')
		{
			int num = 0;
			while (s[i] >= '0' && s[i] <= '9')
			{
				num = num * 10 + (s[i] - '0');
				++i;
			}
			IntStackPush(&nums, num);
		}
		else if (c == '[')
		{
			StrStackPush(&prefix, cur);
			free(cur);
			cap = 16;
			len = 0;
			cur = (char*)malloc((size_t)cap);
			cur[0] = '\0';
			++i;
		}
		else if (c == ']')
		{
			int times = IntStackTop(&nums);
			char* prev = StrStackPop(&prefix);
			int prevLen = (int)strlen(prev);
			int need = prevLen + len * times + 1;
			char* merged = (char*)malloc((size_t)need);
			int t;

			memcpy(merged, prev, (size_t)prevLen);
			for (t = 0; t < times; ++t)
			{
				memcpy(merged + prevLen + t * len, cur, (size_t)len);
			}
			merged[need - 1] = '\0';
			free(prev);
			free(cur);
			cur = merged;
			len = need - 1;
			cap = need;
			IntStackPop(&nums);
			++i;
		}
		else
		{
			if (len + 2 > cap)
			{
				cap *= 2;
				cur = (char*)realloc(cur, (size_t)cap);
			}
			cur[len++] = c;
			cur[len] = '\0';
			++i;
		}
	}
	StrStackDestroy(&prefix);
	IntStackDestroy(&nums);
	return cur;
}
这道题比前面几道多了一份手工内存管理。左括号那一步把当前缓冲的所有权交给字符串栈,再申请一块新的缓冲给这一层使用;右括号那一步申请合并后的新串,把前缀和当前缓冲都释放掉。字符串栈的出栈接口把指针交出来而不是释放,正是为了这两处交接。少释放一次 valgrind 立刻就会报错,多释放一次程序直接崩溃。字符串栈自己的销毁函数同样要逐个释放栈里剩下的元素,正常流程走完它应当是空的。
程序里还保留了一个递归版本:遇到数字就递归解出一层括号里的内容,返回之后按次数展开。它不需要字符串栈,依靠函数调用栈保存上层状态;代码更短,代价是嵌套过深会加深调用栈,每层还要返回一块动态内存,释放时机更难写对。
拆一层看一层。 输入 3[a2[c]]:
| 下标 | 字符 | 动作 | 数字栈 | 字符串栈 | 当前串 |
|---|---|---|---|---|---|
| 0 | 3 | 数字,拼出次数 3 | 3 | \[\] | 空 |
| 1 | [ | 当前串入字符串栈,清空当前串 | 3 | 空 | 空 |
| 2 | a | 字母,追加 | 3 | 空 | a |
| 3 | 2 | 数字,拼出次数 2 | 3 2 | 空 | a |
| 4 | [ | 当前串入字符串栈,清空当前串 | 3 2 | 空 a | 空 |
| 5 | c | 字母,追加 | 3 2 | 空 a | c |
| 6 | ] | 弹出次数 2 和前缀 a,拼成 acc | 3 | 空 | acc |
| 7 | ] | 弹出次数 3 和前缀空串,拼成 accaccacc | \[\] | \[\] | accaccacc |
| 结束 | 无 | 扫完,返回当前串 | \[\] | \[\] | accaccacc |
第 4 步把已经拼好的 a 存进字符串栈,是为了让内层的 c 使用一个干净的缓冲。如果共用一块缓冲,第 6 步拼出来的就会是 acacc 这类错误结果。
text
输入 3 [ a 2 [ c ] ]

第 1 步  3      数字栈 [3]                 当前串 ""
第 2 步  [      字符串栈 [""]             当前串 ""      前缀存起来
第 3 步  a                                当前串 "a"
第 4 步  2      数字栈 [3 2]               当前串 "a"
第 5 步  [      字符串栈 ["", "a"]         当前串 ""      前缀再存一层
第 6 步  c                                当前串 "c"
第 7 步  ]      弹出 2 和 "a",拼成 "acc"   当前串 "acc"
第 8 步  ]      弹出 3 和 "",拼成 "accaccacc"
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p09_decode_string p09_decode_string.c
./p09_decode_string
text
输入 s = 3[a]2[bc]
输出 aaabcbc(递归解法 aaabcbc)
输入 s = 3[a2[c]]
输出 accaccacc(递归解法 accaccacc)
输入 s = 2[abc]3[cd]ef
输出 abcabccdcdcdef(递归解法 abcabccdcdcdef)
输入 s = abc
输出 abc(递归解法 abc)
输入 s = 10[a]
输出 aaaaaaaaaa(递归解法 aaaaaaaaaa)
对拍 2000 组随机串,不一致 0 组
随机对拍的做法是构造一串随机嵌套的编码串,两个解法各解一次并比对结果,两千组没有分歧。第五组的 10 是两位数,拼数字那一步有没有处理多位,用这一组就能判断。
边界值。
- 没有括号:
abc原样返回,两条括号分支一次都不进。 - 重复次数是多位数:
10[a]要拼出十个 a,只看一位会变成 0 个 a。 - 三层嵌套:
3[a2[c]],两个栈都用到第二层。 - 括号前后还有字母:
2[abc]3[cd]ef,收尾的 ef 要接在最后。 - 次数为 1:
1[a]返回 a,循环一次也要走通。 - 结果比输入长得多:
10[a]的输出长度是输入的三倍,缓冲扩容要跟上。 - 内存:每一步都要想清楚谁申请谁释放,字符串栈出栈交出所有权,合并时释放前缀和当前串。
复杂度:时间最坏 O(输出长度 乘 嵌套层数),每展开一层都要复制一遍内容,本题嵌套层数很小;空间 O(输出长度),栈和缓冲加起来不超过最终结果的两倍。
第十题 简化路径(71)
题目:给一个 Unix 风格的绝对路径,把它简化成规范路径。规则是:多个连续斜杠当作一个;单个点表示当前目录;两个点表示切换到上一级目录;结果必须以斜杠开头,除了根目录之外不能以斜杠结尾;结果里不能出现单个点和两个点。
原题链接: leetcode 71 Simplify Path
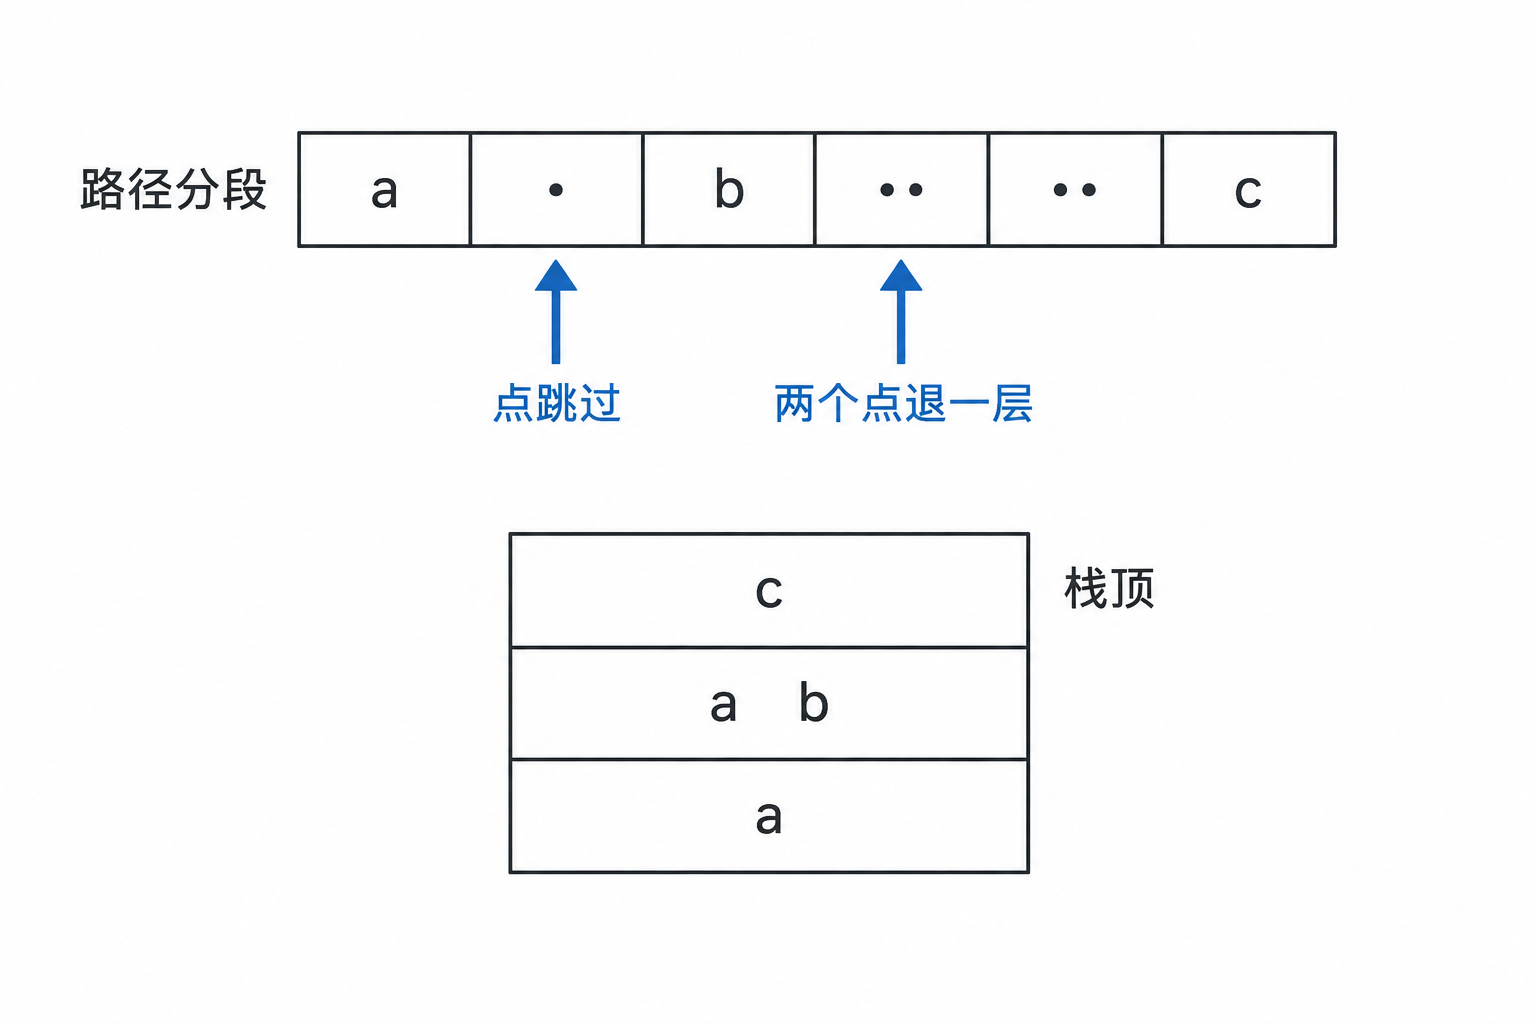
图 10 按段切分路径,遇到上一级就退栈
反复做字符串替换。 把连续斜杠替换成一个,把斜杠加点加斜杠替换成一个斜杠,把斜杠加两个点加斜杠连同它前面的一段一起删掉,反复替换到串不再变化为止。这个做法的正确性从规则上看是直接的,麻烦在于第三类替换要往前找到上一段的起点,路径开头出现两个点还要单独判断,写起来容易漏掉边界;每轮替换还要重建字符串,最坏是 O(n²)。
按斜杠切段。 把路径切成一段一段,每段单独判断,处理规则就很短:空段和单个点直接跳过,两个点把栈顶弹出(栈空时什么都不做),其余的都算普通目录名,压进栈。全部处理完之后,把栈里从栈底到栈顶的段用斜杠连接起来,前面补一个斜杠。
简化规则是逐段生效的,两个点只影响它左边最近的那个还没有被消掉的目录,这正是栈顶的定义。栈里存的就是当前还没被消掉的目录序列,从栈底到栈顶正好是它们在路径里的先后顺序。处理两个点时只需要看栈顶,不必回到路径里去找上一段的起点。
c
char* simplifyPath(char* path)
{
	StrStack st;
	char* seg = (char*)malloc(16);
	int segCap = 16;
	int i = 0, pos = 0;
	int total = 2;
	char* res;

	StrStackInit(&st);
	while (path[i] != '\0')
	{
		int n = 0;
		while (path[i] == '/')
		{
			++i;
		}
		while (path[i] != '\0' && path[i] != '/')
		{
			if (n + 1 >= segCap)
			{
				segCap *= 2;
				seg = (char*)realloc(seg, (size_t)segCap);
			}
			seg[n++] = path[i++];
		}
		seg[n] = '\0';
		if (n == 0 || strcmp(seg, ".") == 0)
		{
			continue;
		}
		if (strcmp(seg, "..") == 0)
		{
			if (!StrStackEmpty(&st))
			{
				free(StrStackPop(&st));
			}
			continue;
		}
		StrStackPush(&st, seg);
	}
	free(seg);
	/* 先算总长度再一次性申请,避免反复拼接 */
	total = 2;
	for (i = 0; i < StrStackSize(&st); ++i)
	{
		total += (int)strlen(StrStackAt(&st, i)) + 1;
	}
	res = (char*)malloc((size_t)total);
	for (i = 0; i < StrStackSize(&st); ++i)
	{
		res[pos++] = '/';
		strcpy(res + pos, StrStackAt(&st, i));
		pos += (int)strlen(StrStackAt(&st, i));
	}
	if (pos == 0)
	{
		res[pos++] = '/';
	}
	res[pos] = '\0';
	StrStackDestroy(&st);
	return res;
}有三个细节需要单独说明。切段时先把连续的斜杠跳完,// 和单个斜杠没有区别。两个点出栈之前必须判空,/.. 在根目录下没有上一级,按规则什么都不做。拼接结果是先遍历一遍算出总长度、一次申请到位,而不是边拼边扩容,省掉了一串 realloc。长度先算准,写入时只需要一个下标从头走到尾。
按段推演。 输入 /a/./b/../../c/:
| 段 | 动作 | 栈内容(栈底在左) |
|---|---|---|
| a | 普通目录名,入栈 | a |
| . | 当前目录,跳过 | a |
| b | 普通目录名,入栈 | a b |
| ... | 上一级,弹栈 | a |
| ... | 上一级,弹栈 | 空 |
| c | 普通目录名,入栈 | c |
| 结束 | 栈里只剩 c,拼成斜杠加 c | c |
第 5 步需要注意:栈里只剩 a 的时候再来一个两个点,弹完之后栈是空的,这并不是错误,而是说明路径回到了根目录。最后 c 进栈,结果就是 /c。
text
输入 / a / . / b / . . / . . / c /

段 a    入栈   栈: [a]        段 ..   弹栈   栈: [a]
段 .    跳过   栈: [a]        段 ..   弹栈   栈: 空
段 b    入栈   栈: [a b]      段 c    入栈   栈: [c]
                              拼结果: /c
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p10_simplify_path p10_simplify_path.c
./p10_simplify_path
text
输入 path = /home/
输出 /home(对照解法 /home)
输入 path = /../
输出 /(对照解法 /)
输入 path = /home//foo/
输出 /home/foo(对照解法 /home/foo)
输入 path = /a/./b/../../c/
输出 /c(对照解法 /c)
输入 path = /a/../../b/../c//.//
输出 /c(对照解法 /c)
输入 path = /.../
输出 /...(对照解法 /...)
输入 path = /
输出 /(对照解法 /)
程序里的对照解法换了一种切分方式,直接按斜杠把副本切开再逐段处理,逻辑与主解法一样。七组用例中两个解法的结果逐组相同。第六组的三个点是普通目录名,不是上一级,这一组专门验证比较使用的是完整字符串而不是前缀。
边界值。
- 根目录:
/切完没有任何段,结果补一个斜杠,返回/。 - 根目录下往上跳:
/../栈空时不弹,返回/。 - 连续斜杠:
/home//foo/中间的多个斜杠当作一个,末尾的斜杠丢掉。 - 末尾斜杠:
/home/返回/home,只有根目录例外。 - 三个点:
/.../是普通目录名,返回/...。 - 长度为一的段:单个字母、单个点、两个点、三个点四条分支各走一次。
- 题目前提:path 一定是绝对路径,以斜杠开头,长度在 1 到 3000 之间。
复杂度:时间 O(n),每个字符被扫一次,拼结果时每个段被复制一次;空间 O(n),栈里最坏装下所有段。
第十一题 删除字符串中的所有相邻重复项(1047)
题目:给出由小写字母组成的字符串 s,重复项删除操作会选择两个相邻且相同的字母并把它们删除。在 s 上反复执行这个操作直到无法继续,返回最终字符串。力扣给 C 语言的签名是 char* removeDuplicates(char* s)。
原题链接: leetcode 1047 Remove All Adjacent Duplicates In String
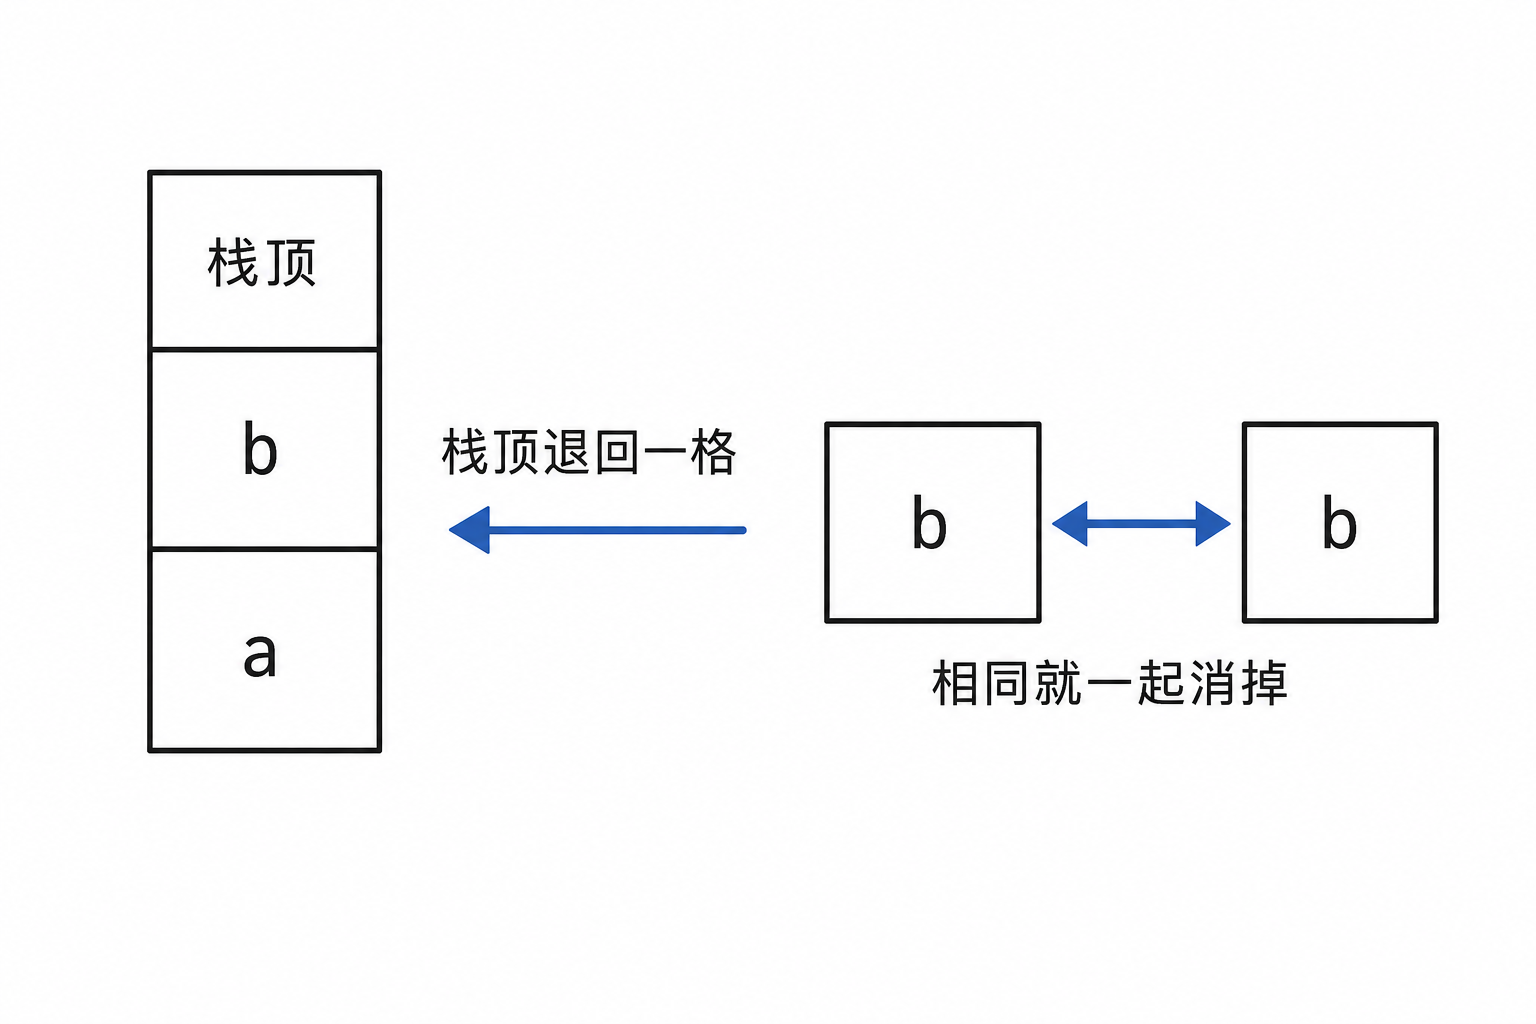
图 11 栈顶与当前字符比较,相同就消掉
一轮一轮删除。 反复扫描字符串,遇到相邻且相同的两个字符就删掉,删完从头再扫一遍,直到某一轮扫完没有删掉任何字符为止。它成立的理由是:题目要求的本来就是反复执行,一轮一轮扫描正好对应这个定义。慢在两处:每删一次要把后面的字符整体往前挪,每轮又要从头再扫,最坏是 O(n²)。
把消除后的结果看成栈。 栈顶就是当前字符左边紧挨着的、还没有被消掉的那个字符。当前字符和栈顶相同就一起消掉,也就是弹出栈顶;不相同就入栈。一趟扫描下来,栈里的内容就是答案。
正确性可以按扫描位置归纳。假设处理到第 i 个字符之前,栈里存的是前 i 减 1 个字符反复消除之后剩下的串,那么第 i 个字符在新串里只会和栈顶相邻,因为栈顶就是消除完之后它左边紧挨着的那个字符。两者相同,它们在新串里也相邻,可以一起消掉;两者不同,第 i 个字符和左边任何字符都不同,不可能被消掉,只能留在栈里。两种情况下归纳都成立。
c
char* removeDuplicates(char* s)
{
	int top = 0;
	int i;

	for (i = 0; s[i] != '\0'; ++i)
	{
		if (top > 0 && s[top - 1] == s[i])
		{
			--top;
		}
		else
		{
			s[top++] = s[i];
		}
	}
	s[top] = '\0';
	return s;
}
这道题的栈可以就地写在原串里,因为栈顶指针永远不会超过读指针:读指针每走一格,栈顶最多也上涨一格。于是 top 就是栈顶位置,写入的位置要么是当前字符本身所在的位置,要么是前面已经读过、确认不再需要的位置。最后在 top 处补一个结束符,返回原串即可,额外空间是 O(1)。
程序里另有一版显式开辟字符栈的写法:字符栈压完之后再倒回一个新串返回。两种写法的结果一致,区别在于一个就地修改原串,另一个需要多一份空间。
逐步消一遍。 输入 abbaca:
| 下标 | 字符 | 比较 | 结果串(栈内容) | 说明 |
|---|---|---|---|---|
| 0 | a | 栈空 | a | 直接入栈 |
| 1 | b | b 不等于 a | ab | 入栈 |
| 2 | b | b 等于栈顶 b | a | 弹出,两个 b 一起消掉 |
| 3 | a | a 等于栈顶 a | 空 | 弹出,新出现的相邻相同也要消 |
| 4 | c | 栈空 | c | 入栈 |
| 5 | a | a 不等于 c | ca | 入栈 |
| 结束 | 无 | 无 | ca | 返回 ca |
第 2 步和第 3 步连起来看:消掉两个 b 之后,原来隔着它们的两个 a 变成相邻,第 3 步正好把这两个 a 也消掉。这就是反复执行的含义,用栈来实现会自动带上这个效果,不需要额外再扫描一遍。
text
输入 a b b a c a

读 a  栈: a          读 b  栈: a b
读 b  栈顶是 b,消掉  栈: a
读 a  栈顶是 a,消掉  栈: 空
读 c  栈: c          读 a  栈: c a
结果: ca
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p11_remove_adjacent_duplicates p11_remove_adjacent_duplicates.c
./p11_remove_adjacent_duplicates
text
输入 s = abbaca
输出 ca(字符栈解法 ca)
输入 s = azxxzy
输出 ay(字符栈解法 ay)
输入 s = a
输出 a(字符栈解法 a)
输入 s = aaaaaaaa
输出 (空串)(字符栈解法 (空串))
输入 s = abba
输出 (空串)(字符栈解法 (空串))
第四组八个 a 全部两两消掉,第五组 abba 先消掉中间的 bb、再消掉剩下的 aa,两层消除都得到空串。程序里对空串结果打印的是 (空串) 三个字,便于在回显里看出差别。
边界值。
- 单个字符:栈里留一个字符,返回它自己。
- 偶数个相同字符:全部消掉,返回空串。
- 奇数个相同字符:每次消掉一对,最后剩一个。
- 消完又出现相邻相同:
abba是典型,先消 bb 再消 aa,返回空串。 - 不相邻的重复:
abca里两个 a 不相邻,返回原串。 - 空串:题目保证长度至少是 1,函数本身对空串也返回空串。
- 输入可写:力扣给的参数是
char*,可以原地改;如果参数是常量串就不能用原地写法。
复杂度:时间 O(n),每个字符进出栈各一次;空间 O(1),原地写法只用了一个栈顶指针,显式开栈的写法是 O(n)。
第十二题 柱状图中最大的矩形(84)
题目:给定 n 个非负整数,表示柱状图中各根柱子的高度,每根柱子的宽度是 1,求能勾勒出的最大矩形面积。力扣给 C 语言的签名是 int largestRectangleArea(int* heights, int heightsSize)。
原题链接: leetcode 84 Largest Rectangle in Histogram
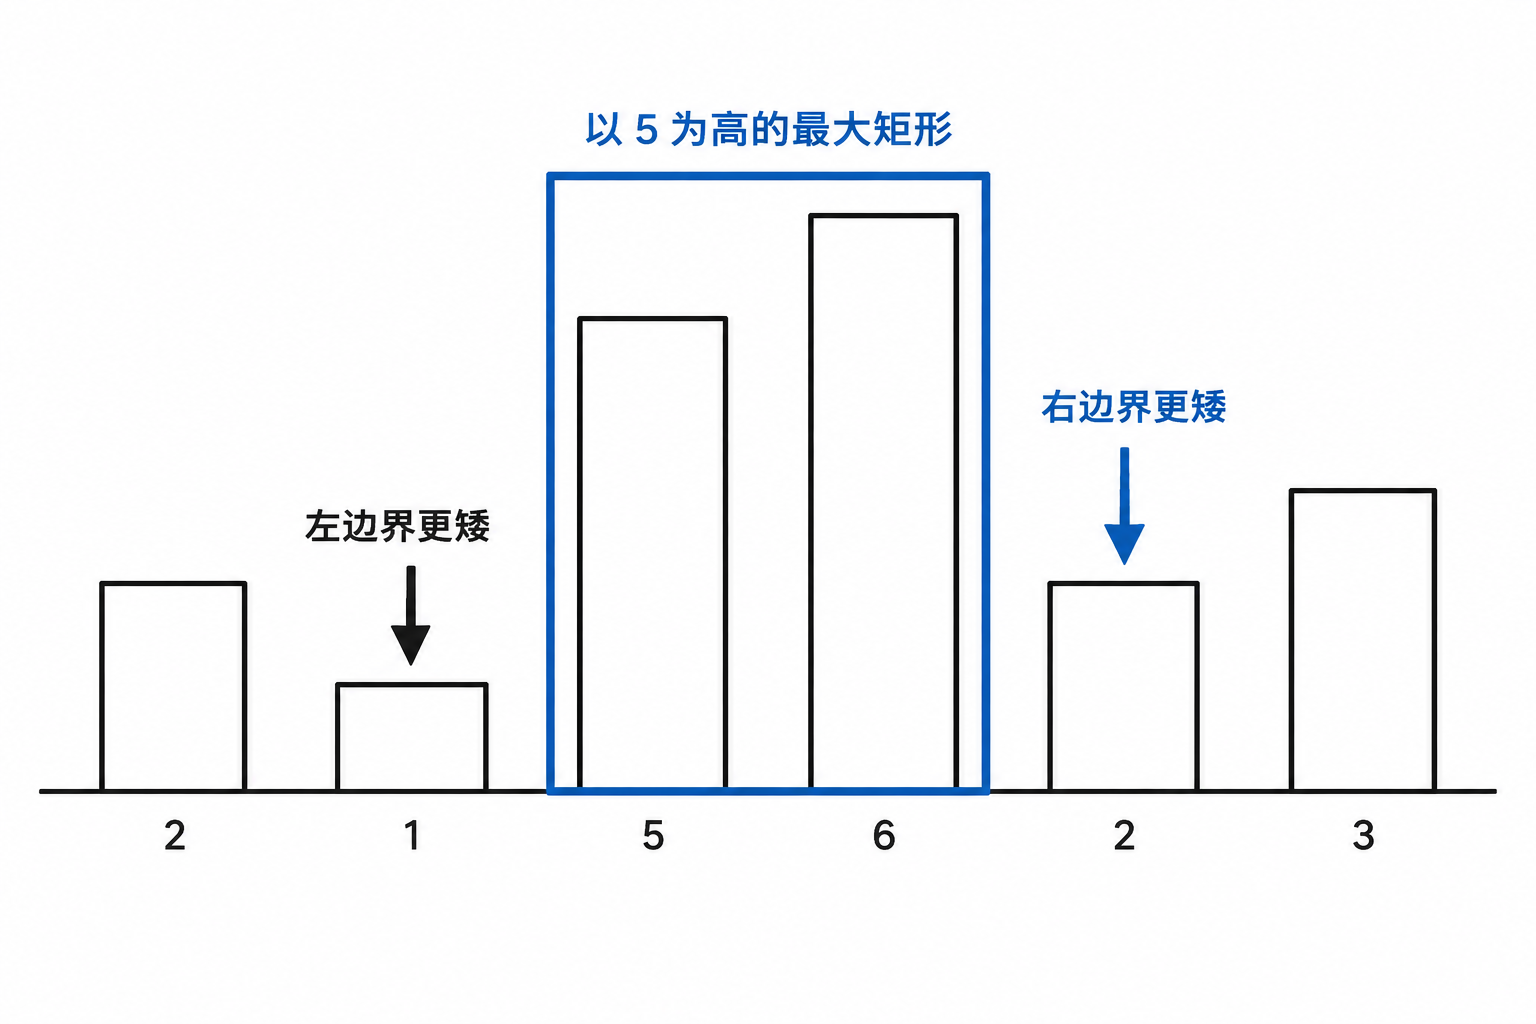
图 12 单调栈为每根柱子找左右第一个更矮的位置
枚举左右边界。 枚举矩形的左边界,再往右一格一格扩展右边界,扩展过程中维护这段区间里的最小高度,面积等于最小高度乘区间宽度,全程取最大值。这个解法把「矩形以某两根柱子为边界」的情况直接枚举完了,正确性没有疑问,代价是两层循环 O(n²),n 到十万就无法在时限内完成。
换成枚举高度。 不枚举矩形的两条边,改枚举矩形的高度由哪根柱子决定。对每根柱子,以它的高度为高的最大矩形,宽度等于它左边第一个更矮的柱子和右边第一个更矮的柱子之间的距离。用单调递增栈一趟就能求出这两个边界:栈里存下标,对应的高度从栈底到栈顶递增;新柱子的高度不大于栈顶时,栈顶那根柱子的右边界就是当前位置,弹出之后新的栈顶就是它的左边界,面积等于高度乘下标的差减一。为了让栈里剩下的柱子也能结算,在数组末尾补一根高度 0 的哨兵。
结论落在被弹出的那根柱子 h 上。它右边第一个比它矮的柱子一定是当前这一根,否则它在此之前的某一根更矮的柱子出现时就被弹走了;它左边第一个比它矮的柱子一定是弹出之后新的栈顶,因为栈里剩下的下标都比它小,高度又递增,栈顶就是离它最近的那个更矮的柱子。两个边界之间的宽度就是以 h 为高的矩形的最大可能宽度,任何更宽的区间都会碰到那两根更矮的柱子,高度就无法维持在 h。这段区间里也不会再出现比 h 矮的柱子,因此这个宽度是矩形能够达到的最大范围。
c
int largestRectangleArea(int* heights, int heightsSize)
{
	IntStack st;
	int i;
	int best = 0;

	IntStackInit(&st);
	for (i = 0; i <= heightsSize; ++i)
	{
		int h = (i == heightsSize) ? 0 : heights[i];
		while (!IntStackEmpty(&st) && heights[IntStackTop(&st)] >= h)
		{
			int height = heights[IntStackTop(&st)];
			int width;
			IntStackPop(&st);
			width = IntStackEmpty(&st) ? i : i - IntStackTop(&st) - 1;
			if (height * width > best)
			{
				best = height * width;
			}
		}
		IntStackPush(&st, i);
	}
	IntStackDestroy(&st);
	return best;
}
宽度那一句分两种情况:弹出之后栈为空,说明这根柱子左边没有比它矮的柱子,宽度从下标 0 一直算到当前位置,也就是 i;栈不为空时,宽度就是当前下标减去新栈顶下标再减一。漏掉栈空这一支,最矮的那根柱子的面积就算不出来。这一支对应的正是整个数组里最矮的那根柱子,它的矩形可以横跨全部下标。
柱子依次进栈。 输入 [2 1 5 6 2 3]:
| 下标 | 高度 | 动作 | 栈内容(存下标) | 最大面积 |
|---|---|---|---|---|
| 0 | 2 | 栈空,入栈 | 0 | 0 |
| 1 | 1 | 1 不大于 2,弹 0,高度 2 宽 1 得 2;入栈 1 | 1 | 2 |
| 2 | 5 | 5 大于 1,入栈 | 1 2 | 2 |
| 3 | 6 | 6 大于 5,入栈 | 1 2 3 | 2 |
| 4 | 2 | 弹 3,高度 6 宽 1 得 6;弹 2,高度 5 宽 2 得 10;2 大于 1 停下;入栈 4 | 1 4 | 10 |
| 5 | 3 | 3 大于 2,入栈 | 1 4 5 | 10 |
| 6 | 哨兵 0 | 弹 5,高度 3 宽 1 得 3;弹 4,高度 2 宽 4 得 8;弹 1,高度 1 宽 6 得 6 | 6 | 10 |
| 结束 | 无 | 全部结算完,返回 10 | 6 | 10 |
第 4 步一次弹出两根柱子,第 6 步的哨兵把栈里剩下的三根全部结算;少了这个哨兵,栈里积压的柱子就没有机会算出面积。
text
输入 2 1 5 6 2 3

下标 0  高 2   栈: [0]              弹出 0        高 2 宽 1 = 2
下标 1  高 1   栈: [1]              入栈
下标 2  高 5   栈: [1 2]            入栈
下标 3  高 6   栈: [1 2 3]          入栈
下标 4  高 2   栈: [1 4]            弹 3 -> 6×1 = 6   弹 2 -> 5×2 = 10
下标 5  高 3   栈: [1 4 5]          入栈
哨兵 0         栈: [6]             弹 5 -> 3×1   弹 4 -> 2×4 = 8   弹 1 -> 1×6 = 6
答案 10
bash
# 所属目录:/home/cocatrice/ds07
gcc -std=c99 -Wall -Wextra -g -o p12_largest_rectangle_histogram p12_largest_rectangle_histogram.c
./p12_largest_rectangle_histogram
text
输入 heights = [2 1 5 6 2 3]
输出 10(对照解法 10)
输入 heights = [2 4]
输出 4(对照解法 4)
输入 heights = [1]
输出 1(对照解法 1)
输入 heights = [5 4 3 2 1]
输出 9(对照解法 9)
输入 heights = [2 2 2]
输出 6(对照解法 6)
对拍 2000 组随机高度(长度 8),不一致 0 组
对拍 2000 组随机高度(长度 12),不一致 0 组
对拍的参照物就是那个枚举左右边界的暴力解,四千组随机高度的结果全部一致。第二组 [2 4] 的答案是 4:单根柱子取 4 比两根合起来取 2 的收益更大,说明矩形不一定越高越好,面积是高度和宽度的乘积。第四组完全递减,答案是前三根柱子按高度 3 拼出来的 9。
边界值。
- 只有一根柱子:宽度 1,返回它的高度。
- 两根高度不同的柱子:取单根里较高的那根,或者两根合起来取较矮的那根,两者的较大值需要实际计算才能确定。
- 高度全部相同:宽度铺满,返回高度乘长度。
- 严格递减:栈里积压所有下标,最后靠哨兵一次结算,这是栈最深的情况。
- 出现高度为 0 的柱子:它就是天然的哨兵,会把左右两段彻底断开。
- 溢出:高度最大 10⁴,长度最大 10⁵,面积最大 10⁹ 量级,32 位整数放得下。
- 哨兵:末尾补高度 0 是为了结算栈里剩下的柱子,漏掉它结果会偏小。
复杂度:时间 O(n),每根柱子进栈一次出栈一次;空间 O(n),栈最深时积压全部下标。
踩坑点
- 栈上的错误几乎都和空栈有关,取栈顶、弹栈、出栈之前都有一次判空的义务;漏掉判空时正常用例全部通过,一遇到右括号多余、路径跳过头就崩溃。
- 用队列实现栈,任意时刻最多只有一个队列有数据,这个不变量是出栈逻辑的前提;固定往 q1 里压,第一个元素之后队列的状态就乱了,应该判断哪个队列非空。
- 用栈实现队列,倒数据要延迟到出栈空了再做,写成一进一出就丢掉了均摊 O(1);每次出队都倒一遍数据,结果依然正确,复杂度却退化成 O(n)。
- 最小栈的辅助栈记录的是当前最小值,相等也要记;压入条件写成严格小于,弹出时同步不上,重复的最小值弹掉之后最小值就恢复不回去。
- 逆波兰表达式的右操作数先弹出,左操作数后弹出,顺序反了减法和除法就错;顺手把栈顶当成左操作数,写出来的就是错的顺序。
- 运算符用字符串比较识别出来之后,还要按首字符分派,不要把四个分支写成同一种运算。
- 后缀表达式求值对应表达式树的后序遍历,栈里存的是已经折叠完的子树的值。
- 验证栈序列的贪心依据是后进先出:下一个要输出的元素已经在栈顶时,继续压入只会把它压在后面。
- 验证栈序列的内层循环写成 if,压进一个元素后只弹出一个,正确的用例会被判成假。
- 单调栈里存的是下标还是值,取决于结果要的是距离还是那个数,每日温度要的是天数之差,栈里就得存下标,混着写会少一次减法。
- 单调栈里从栈底到栈顶保持单调,靠的是「破坏单调性的元素早就被弹走了」这个不变量。
- 下一个更大元素的直接寻址表要求值域有限并且值互不相同,两条前提缺一不可。
- 柱状图末尾忘了补高度 0 的哨兵,栈里积压的柱子没有机会被结算。
- 计算宽度时漏掉弹出后栈为空的情况,最矮的那根柱子的面积算不出来。
- 柱状图最大矩形枚举的是高度由哪根柱子决定,宽度由左右两边第一个更矮的柱子确定。
- 简化路径的两个点只影响左边最近的一段,栈空时什么都不做;出栈前不判空,路径开头就是两个点时下标跑成负数。
- 路径切段时用前缀比较判断两个点,三个点会被误判成上一级。
- 字符串解码用两个栈:数字栈记次数,字符串栈记前缀,当前缓冲只属于最内层。
- 字符串解码解析重复次数只看一位,两位数以上就解错。
- 字符串栈入栈时如果没有复制一份,原来的缓冲被释放之后,栈里留下的全是悬空指针。
- 拼结果串时边拼边扩容,忘了更新指针,realloc 重新分配之后旧指针写入的是已经释放的内存。
- 删除相邻重复项就是栈的原地版本,栈顶指针永远不超过读指针。
- 单调栈的空间最坏是 O(n),输入单调的时候栈里会积压全部下标。
本篇总结(模拟面试问题)
问:怎么判断一道题该不该用栈?
核心要点:看题目里有没有「最近还没处理完」的关系。括号和最近的左括号配对,目录退回最近的一层,柱子找左右两边最近的更矮柱子,这些描述都指向栈顶。反过来,如果每次要访问的是最早进来的元素,那就该用队列。
问:单调栈和普通栈有什么区别?
核心要点:结构上没有区别,都是后进先出,区别在入栈之前的动作。单调栈压入新元素之前,先把会破坏单调性的栈顶弹掉,被弹出去的元素就在这一刻结算答案。栈里始终单调,每个元素进去一次、出来一次,整体是 O(n)。
问:用两个栈实现队列,为什么出队是均摊 O(1)?
核心要点:每个元素在生命周期里最多被从入栈搬到出栈一次,搬完就一直在出栈里等着被取走。n 次入队总共搬 n 次,摊到每次出队是常数。这是均摊而不是最坏情况,恰好赶上倒数据的那一次仍然是 O(n)。
问:最小栈的辅助栈为什么要记录相等的元素?
核心要点:出栈时的同步依据是「数据栈弹出的值等于辅助栈栈顶」,辅助栈里缺了这一份,弹掉数据之后最小值就恢复不回去。测试用例 push(2) push(2) getMin pop getMin 专门盯这一处,第二次 getMin 必须还是 2。
问:括号匹配的失败有哪几种情况?
核心要点:三种。右括号多余时取栈顶就已经空了;类型对不上时栈顶比较失败;左括号多余时循环正常结束但栈里还有剩余元素。三种情况分别对应三个不同的判断,缺一个就会漏判一类输入。
问:柱状图最大矩形为什么要在末尾补一个高度 0 的哨兵?
核心要点:单调栈的结算发生在元素被弹出的时候。单调递增的输入里没有元素会被弹出去,栈里积压的柱子永远等不到结算。补一个比所有柱子都矮的哨兵,循环最后一步会把栈里剩下的柱子全部弹出来算一遍。
问:单调栈为什么能保证 O(n)?
核心要点:每个下标只入栈一次,出栈次数不超过入栈次数,内层循环的总执行次数就是所有元素出栈次数之和,也就是 O(n)。内层循环不改变总的计算量,它只是把每个元素的那次出栈提前执行。
问:验证栈序列里,能弹就弹的贪心为什么不会错过答案?
核心要点:如果栈顶元素正好是下一个要输出的元素,任何合法的操作序列都必须在这里弹出它。一旦继续压入新元素,按后进先出的规则,新元素一定排在这个元素后面出栈,输出的下一个就不再是它,这条路径走不通。因此能弹就弹是唯一可行的选择,不会丢掉答案。
问:字符串解码为什么需要两个栈,用一个行不行?
核心要点:进入一层括号时要保存两样东西:这一层的重复次数和进入之前已经拼好的前缀。次数是整数,前缀是字符串,类型不同,用同一个栈要么多包一层结构体,要么来回转换。分成两个栈之后,每次进出栈都是同一种类型,代码清楚,代价只是多一个栈的空间。
问:下一个更大元素用直接寻址表有什么前提,值域很大怎么办?
核心要点:前提是值域有限并且值互不相同。值域决定了表要开多大;值重复会让同一个格子的答案被后一次覆盖,实测里 5 3 4 3 6 这种输入两个答案就不一致。值域大或者有负数时换成哈希表,C 里没有现成的,用 C++ 的 unordered_map 十来行就能写完。
问:简化路径里的两个点在根目录下怎么处理?
核心要点:什么都不做。根目录没有上一级,规则要求 /.../ 的结果还是根目录。实现上就是弹出之前先判栈空,栈空直接跳过这一段。这也是栈题里判空最典型的一处。
问:均摊复杂度和最坏复杂度有什么区别?
核心要点:最坏复杂度说的是某一次操作可能有多慢,均摊说的是连续多次操作平摊下来的代价。用两个栈实现队列,单次出队最坏是 O(n),但每个元素只会被搬一次,所以均摊是 O(1)。面试里被问到这种结构,两个复杂度都要说清楚。
问:入栈序列是 1 2 3 4 5,下面哪个不可能是出栈序列:4 5 3 2 1、4 3 5 1 2、5 4 3 2 1?
核心要点:4 3 5 1 2 不可能。压到 4 之后弹出 4,压 5 之前栈里是 1 2 3,先弹出 3 之后就轮到 5,弹出 5 之后栈顶是 2,不可能先输出 1。
问:括号串 () 是否有效,为什么?
核心要点:无效。两个右括号的类型都能在栈里找到对应的左括号,但顺序错了,第一个右括号遇到的是栈顶的中括号,配对失败。
问:最小栈里依次压入 3、1、2,getMin 返回什么?
核心要点:1。辅助栈记录的是当前最小值,压入 3 时记 3,压入 1 时记 1,压入 2 时 2 比 1 大所以不记,栈顶仍然是 1。
问:后缀表达式 4 13 5 / + 的值是多少?
核心要点:6。13 除以 5 得 2,4 加 2 得 6。
问:柱状图各柱高度依次是 2 1 5 6 2 3,最大矩形面积是多少?
核心要点:10。高度 5 和 6 这两根柱子拼出来的矩形宽 2 高 5,面积 10。
问:长度为 n 的入栈序列一共有多少种合法的出栈序列?
核心要点:卡特兰数,第 n 项等于 C(2n, n) 除以 n 加 1。n 等于 3 时是 5 种,n 等于 4 时是 14 种,n 等于 5 时是 42 种。
问:柱状图那道题,单调栈里为什么存下标而不是高度?
核心要点:宽度要靠下标算。存高度只能知道矩形有多高,算不出左右边界之间有多少根柱子,也就得不到宽度,而面积是高度乘宽度。
问:用两个栈实现队列,n 次入队之后连续 n 次出队,一共搬了多少次数据?
核心要点:n 次。第一次出队发生时入栈里有 n 个元素,一次全部搬进空的出栈,此后出栈一直非空,后面的出队不需要再搬。
问:递归解法和栈解法是什么关系?
核心要点:递归本身就是靠系统栈保存现场,把递归改成循环加显式栈,就是把这层系统栈搬到用户态自己管理。字符串解码的递归版本和双栈版本做的是同一件事,只是保存前缀的地方从字符串栈变成了函数调用栈。
参考
- 栈的定义、实现与常见应用:https://oi-wiki.org/ds/stack/
- 单调栈与单调队列的完整讲解:https://oi-wiki.org/ds/monotonic-stack/
- 表达式求值,中缀转后缀的规则:https://oi-wiki.org/misc/expression/
- 栈的基本操作与复杂度总结:https://www.geeksforgeeks.org/stack-data-structure/
- 下一个更大元素一题的多种解法:https://www.geeksforgeeks.org/next-greater-element/
- 柱状图最大矩形的分治与栈两种思路:https://www.geeksforgeeks.org/largest-rectangle-under-histogram/
- memcpy 的手册页,字符串解码里拼结果用的就是它:https://manpages.debian.org/buster/manpages-dev/memcpy.3.en.html
- 力扣栈标签题库,按标签接着刷:https://leetcode.cn/tag/stack/problemset/
下一篇标题:队列:先进先出与循环队列