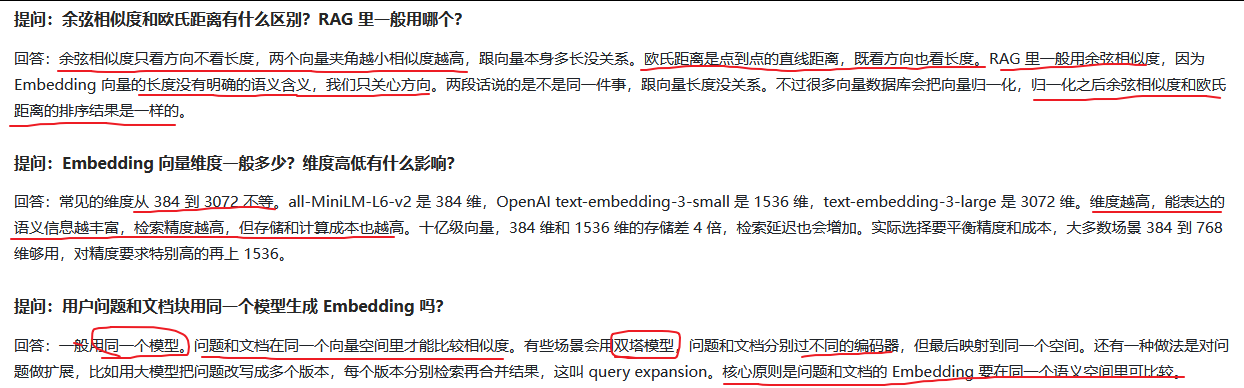
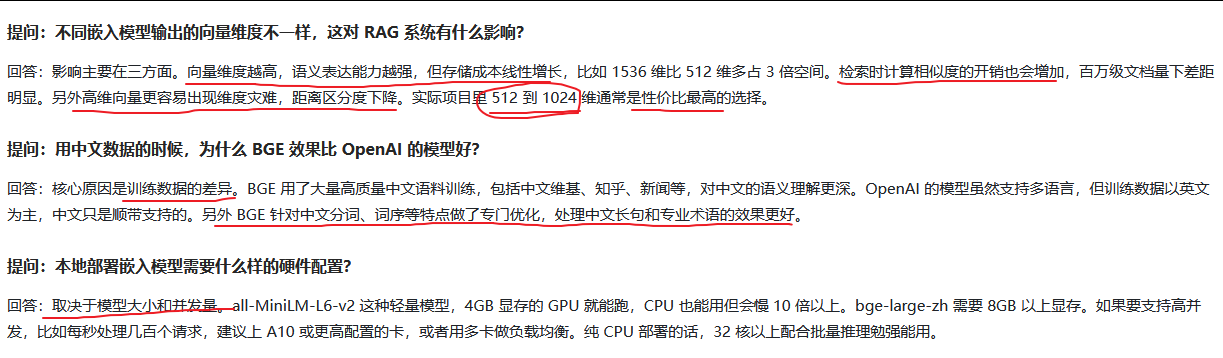
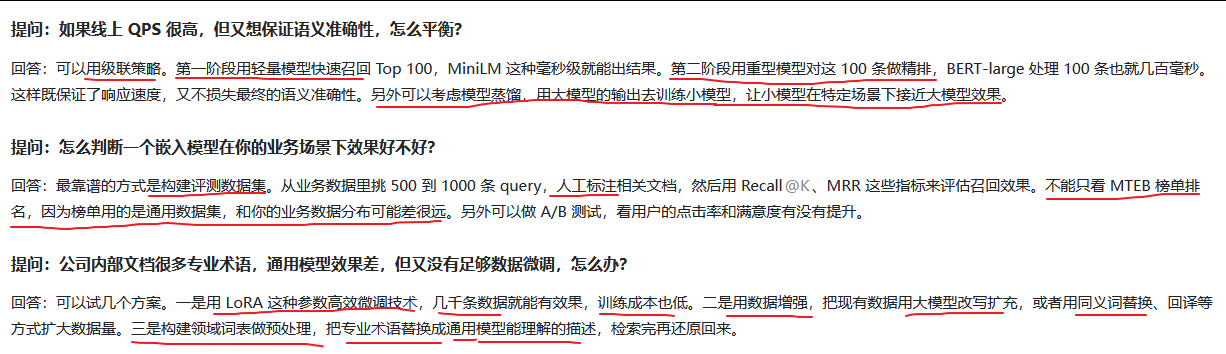
1.基础知识


python
from sentence_transformers import SentenceTransformer

# 加载 embedding 模型
model = SentenceTransformer('all-MiniLM-L6-v2')

# 文本转向量
texts = ["如何煮奶茶", "奶茶制作步骤", "Python 入门教程"]
embeddings = model.encode(texts)

# 计算相似度
from sklearn.metrics.pairwise import cosine_similarity
similarity = cosine_similarity([embeddings[0]], [embeddings[1]])
# 输出约 0.85,说明"如何煮奶茶"和"奶茶制作步骤"语义相近
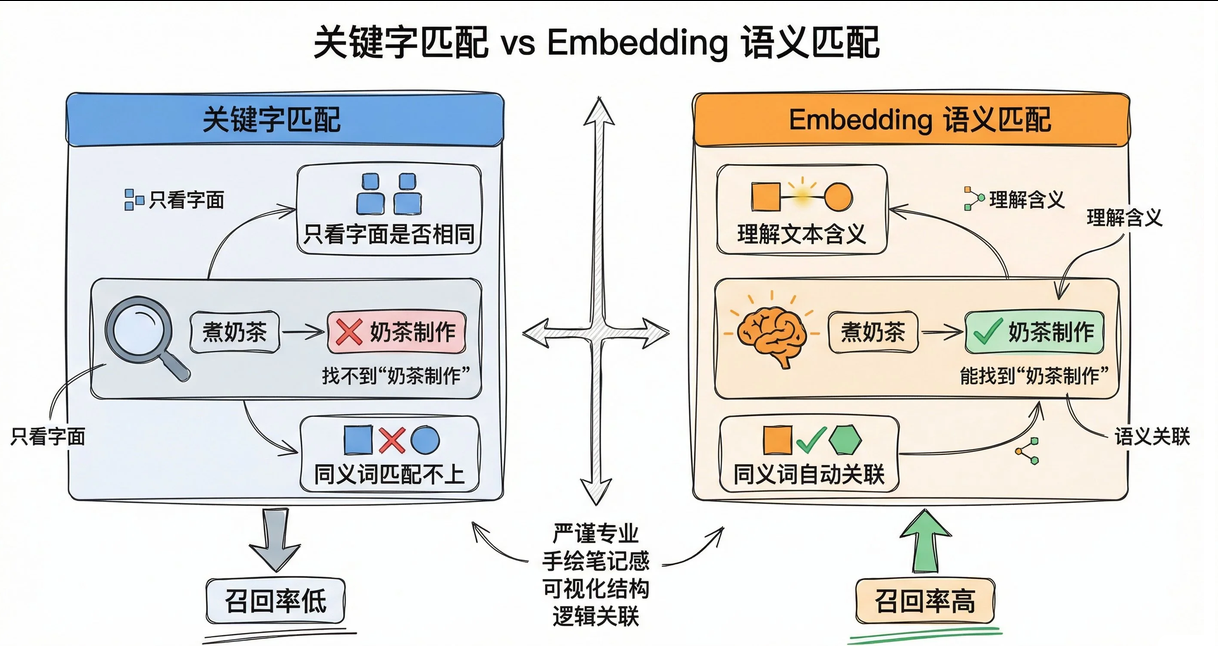
2.为什么需要Embedding

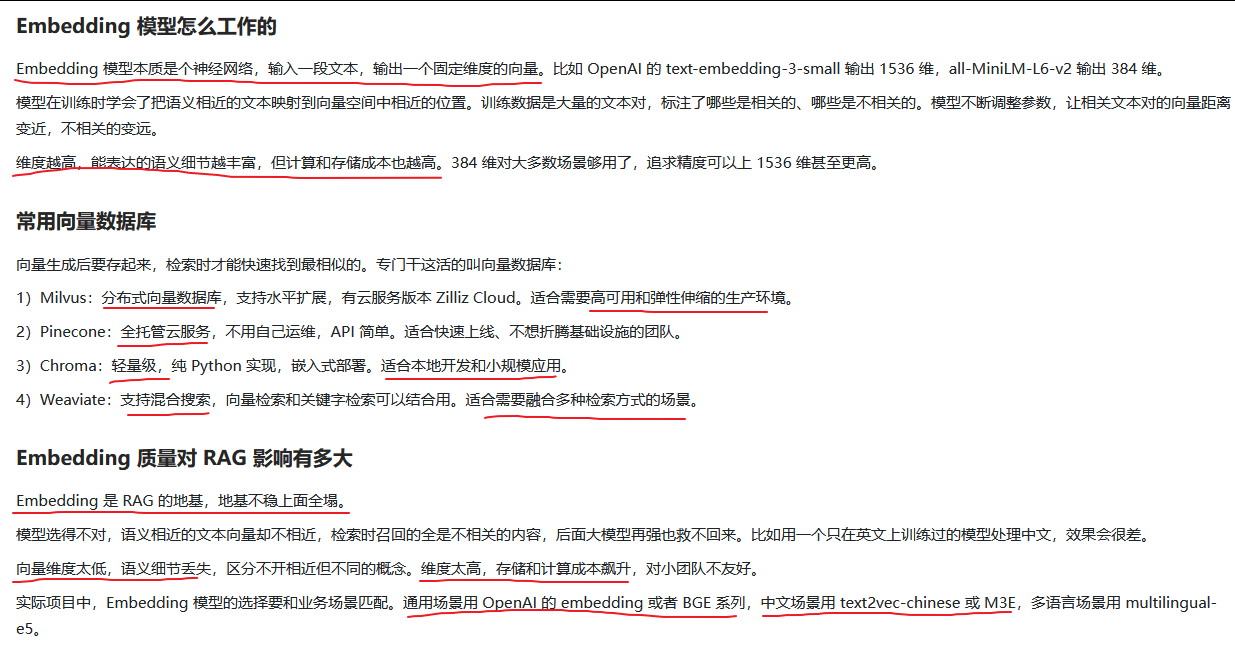
3.常见嵌入模型
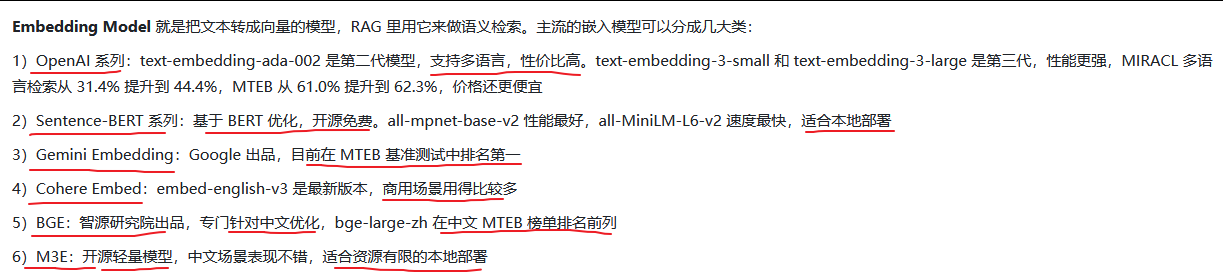
一句话:中文选BGE或M3E、英文选OpenAI或Cohere、轻量级选Sentence-BERT
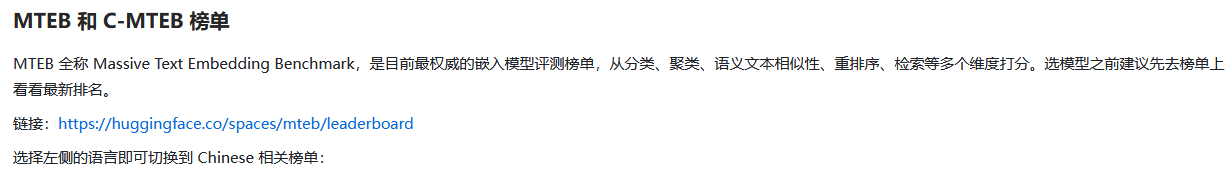
https://huggingface.co/spaces/mteb/leaderboard
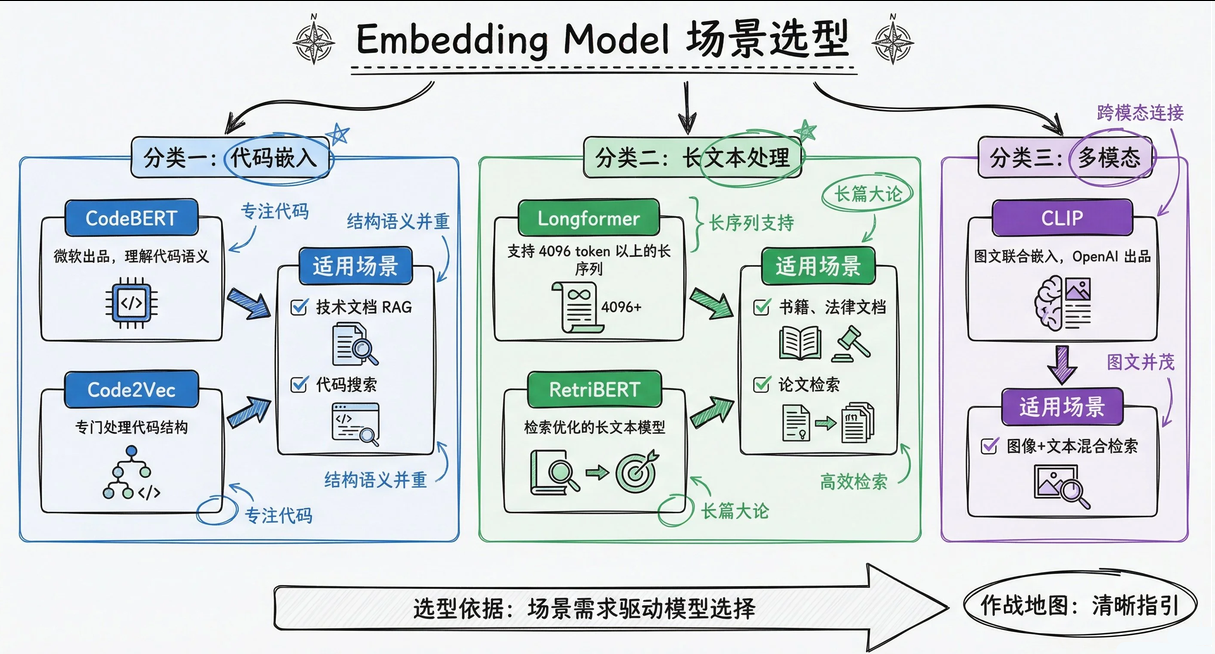
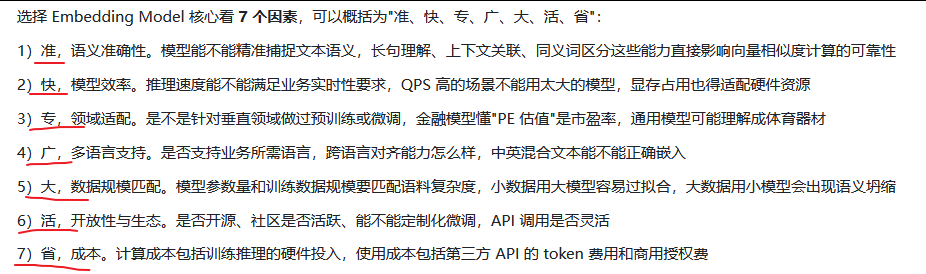
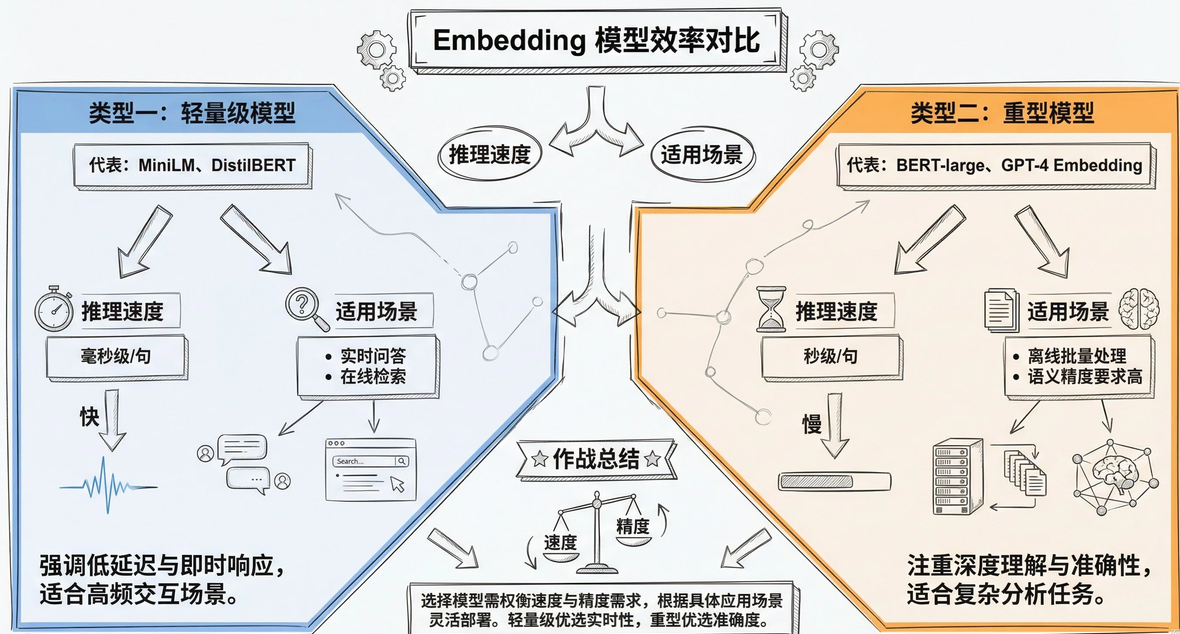
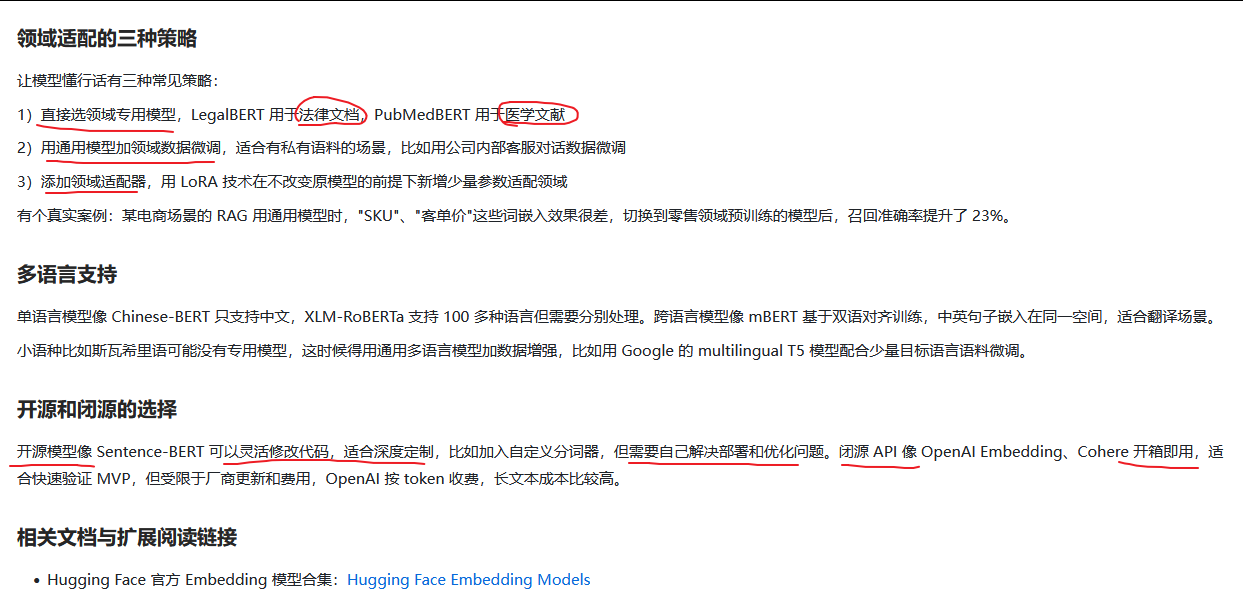
4.如何选嵌入模型
https://huggingface.co/models?library=sentence-transformers
5.追问