1.概述
Pandas 是 Python 的一个第三方包,也是商业和工程领域最流行的结构化数据工具集,用于数据清洗,处理及分析
Pandas 在数据处理上有独特优势:
- 底层是基于 Numpy 构建的,所以运行速度特别快
- 有专门处理缺失值 Null 的API
- 强大而灵活的分组,聚合,转换功能
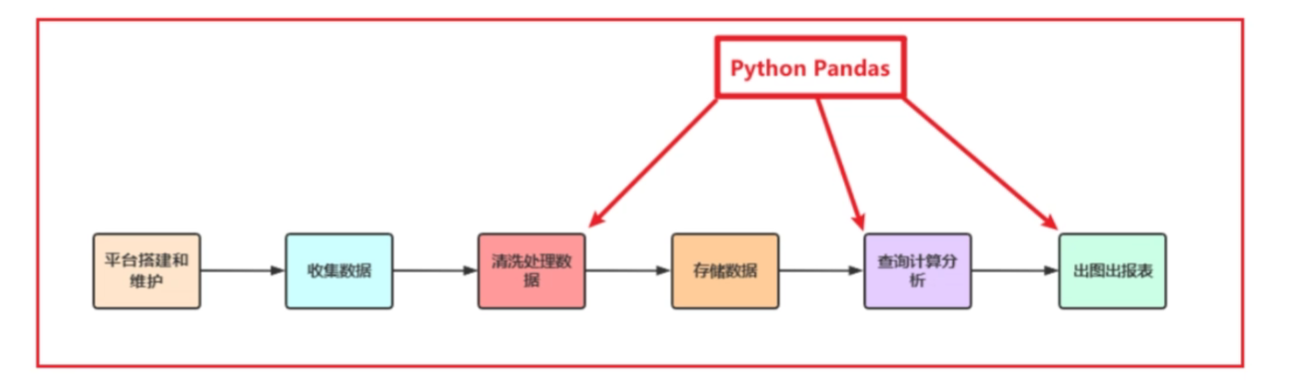
适用场景:
- 数据量大到 Excel 卡顿,且又都是单机数据
- Pandas用于处理单机数据(小数据集(相对于大数据来说))
- 在大数据 ETL 数据仓库中,对数据进行清洗及处理的环节使用Pandas
2.Pandas 数据结构与数据类型
2.1 Pandas 数据结构
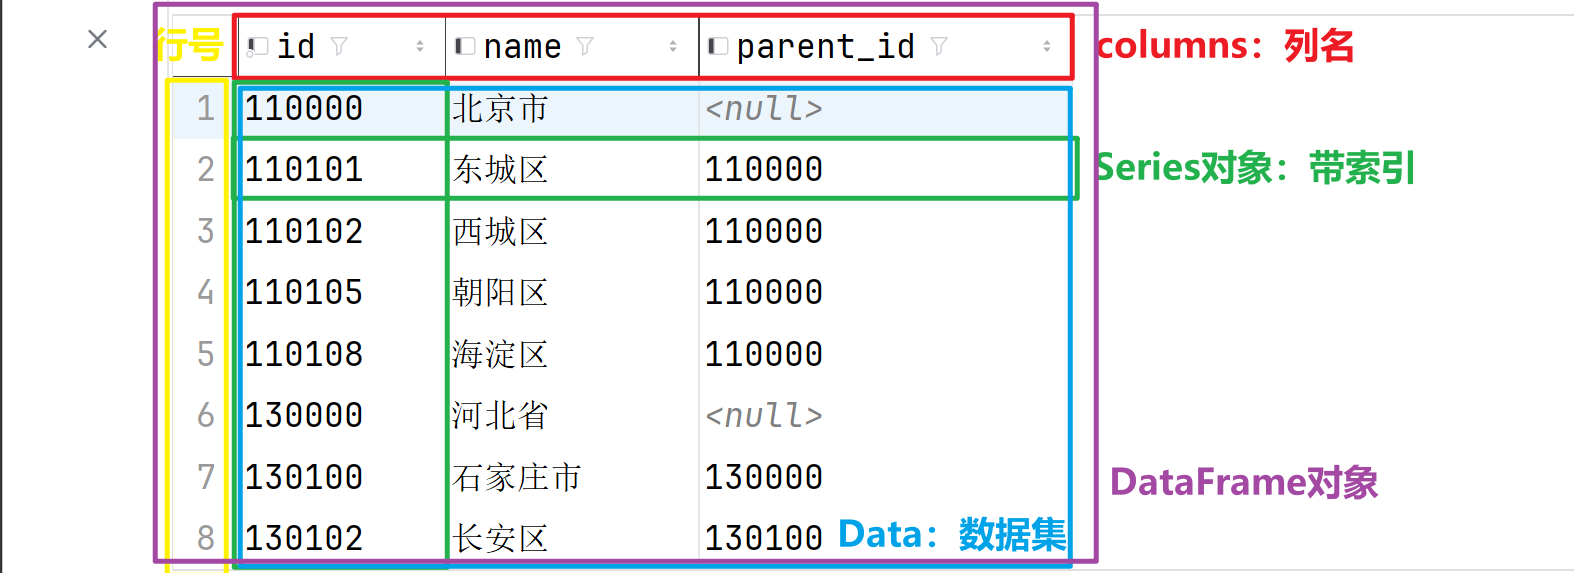
2.1.1 Series对象
1. 概述
Series:一维带索引数组对象 ,是DataFrame 的列对象
- 由索引(index) + **值(values)**组成
- 支持所有数值、字符串等 Python 数据类型
示例如下:
s = pd.Series([12, 4, 7, 9], index=[0, 1, 2, 3])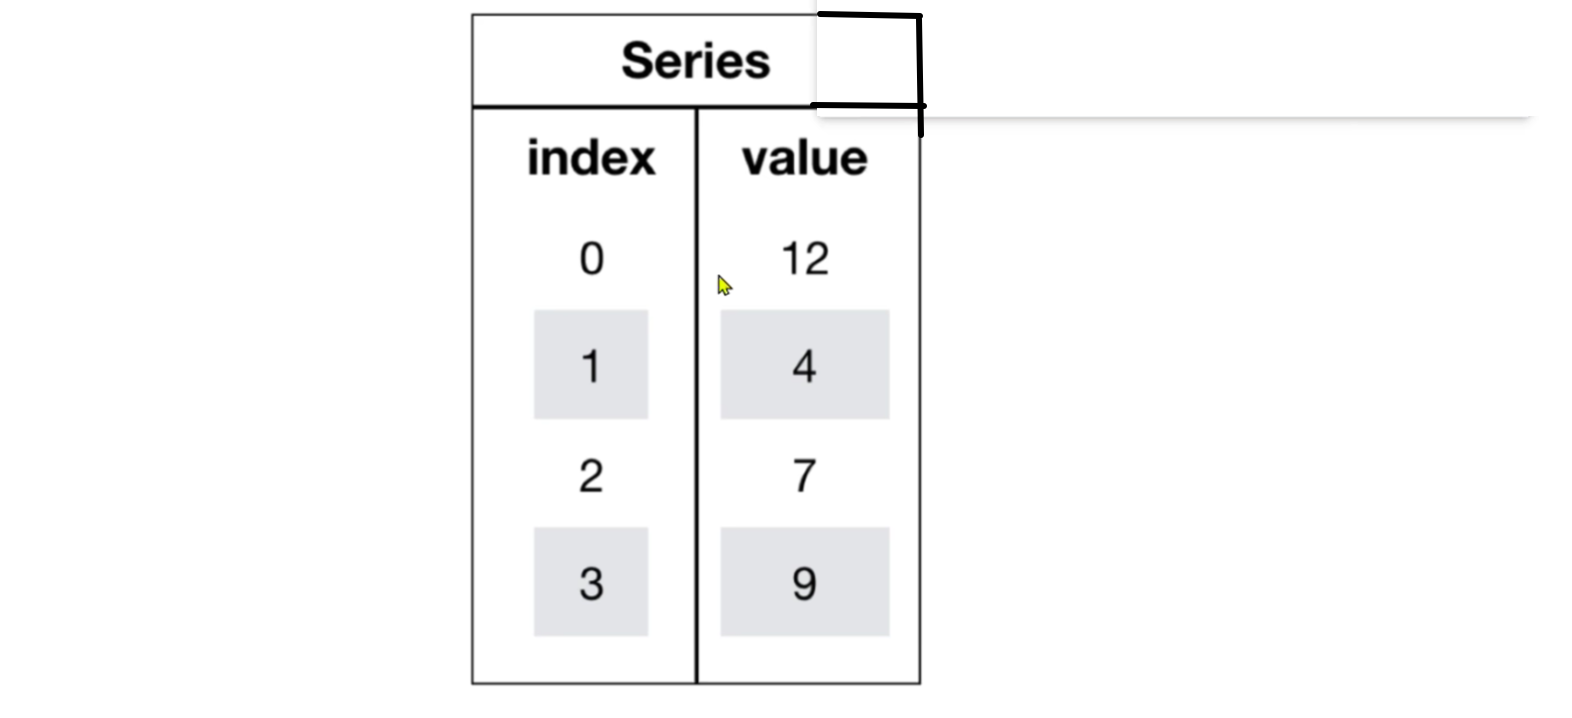
- value:一维数组(numpy.ndarry类型)
- index:相关的数据索引标签;如果没有为数据指定索引,于是会自动创建一个 0 到 N-1 的整数型索引(数据长度为N)
Series 可以表示 DataFrame 中的一行或一列:
-
DataFrame 的每一列取出,就是一个 Series:
df = pd.DataFrame({"a":[1,2], "b":[3,4]})
s = df["a"] # 取出一列,得到Series -
DataFrame 的每一行取出,返回的也是 Series
s = df.loc[0] # 取出一行,得到Series
2. 创建 Series 对象
第一步:导入pandas包
import pandas as pd第二步:创建 Series 对象
方式1:使用默认自增索引: [0, 1, 2, 3, ...]
s1 = pd.Series([1, 2, 3])

# 方法2:使用自定义索引
s2 = pd.Series([1, 3, 5, 7, 9], index=['a', 'b', 'c', 'd', 'e'])
print(s2)

# 方法3:使用字典
s3 = pd.Series({'a': 1, 'b': 3, 'c': 5, 'd': 7, 'e': 9})
print(s3)

# 方法4:使用元组(默认自增索引)
s4 = pd.Series((1, 3, 5, 7, 9))
print(s4)

# 方法5:使用Numpy创建
import numpy as np
s5 = pd.Series(np.array([1, 3, 5, 7, 9]))
print(s5)
3. Series 对象属性
- 索引:Series对象.index
- 值:Series对象.values
注意 :可通过所用获取值:Series对象索引
2.1.2 DataFrame
1. 概述
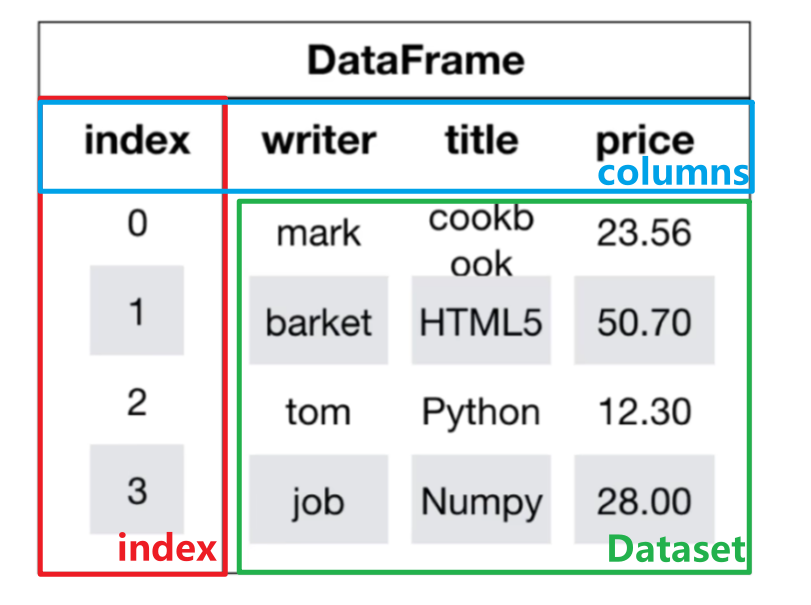
DataFrame:二维数组(表格)对象
- 由行索引(index)、列索引(columns)和数据集组成
- 每一列本质上是一个 Series,且各列可以是不同的数据类型
- 行索引:表明不同行,横向索引,命名为 index,axis=0
- 列索引:表明不同列,纵向索引,命名为 columns,axis=1
示例如下:
df = pd.DataFrame({
    "index": [0, 1, 2, 3]
    "writer": ["mark", "barket", "tom", "job"],
    "title": ["cookbook", "HTML5", "Python", "Numpy"],
    "price": [23.56, 50.70, 12.30, 28.00]
})
2. 创建 DataFrame 对象
第一步:导入pandas包
import pandas as pd第二步:创建 DataFrame 对象
# 方式1:使用 "字典 + 列表" 创建(默认自增行索引) ----> 列构建
data1 = {
     'name': ['张三', '李四', '王五'],
     'age': [25, 30, 35]
}
df1 = pd.DataFrame(data)


# 方式2:使用 "列表 + 元组" 创建 ----> 行构建
data2 = [
     ('张三', 25),
     ('李四', 30),
     ('王五', 35)
]
df2 = pd.DataFrame(data2, columns=['name', 'age'], index=[1, 2, 3])

# 方式3:使用 Numpy 创建 ----> 整体构建
data = np.array([
    ['张三', 25],
    ['李四', 30],
    ['王五', 35]
])
df3 = pd.DataFrame(data, columns=['name', 'age'], index=[1, 2, 3])

# 方式4:读取文件数据并返回df
df4 = pd.read_csv('csv格式数据文件路径')
3. DataFrame 对象属性
- 形状 :df对象.shape,返回元组
- 行索引 :df对象.index
- 列索引 :df对象.columns
- 值 :df对象.values,直接获取 Data 值
- 转置 :df对象.T
4. DataFrame 对象方法
1.head(n):显示前 n 行内容
2.tail(n):显示后 n 行内容
3.info():查看 DataFrame 对象详细信息
4.describe():查看 DataFrame 对象描述性统计信息
5. DataFrame 索引的设置
-
修改行列索引值
1.准备数据
data = np.array([['张三', 25], ['李四', 30], ['王五', 35]])
2.创建 DataFrame 对象
df3 = pd.DataFrame(data, columns=['a', 'b'], index=["A", "B", "C"])
3.修改行索引值
3.1 修改行索引值
df3.index = [1, 2, 3]
3.2 修改列索引值
df3.columns = ["name", "age"]
注意:修改索引值时必须整体全部修改,单独修改某处索引值是错误的
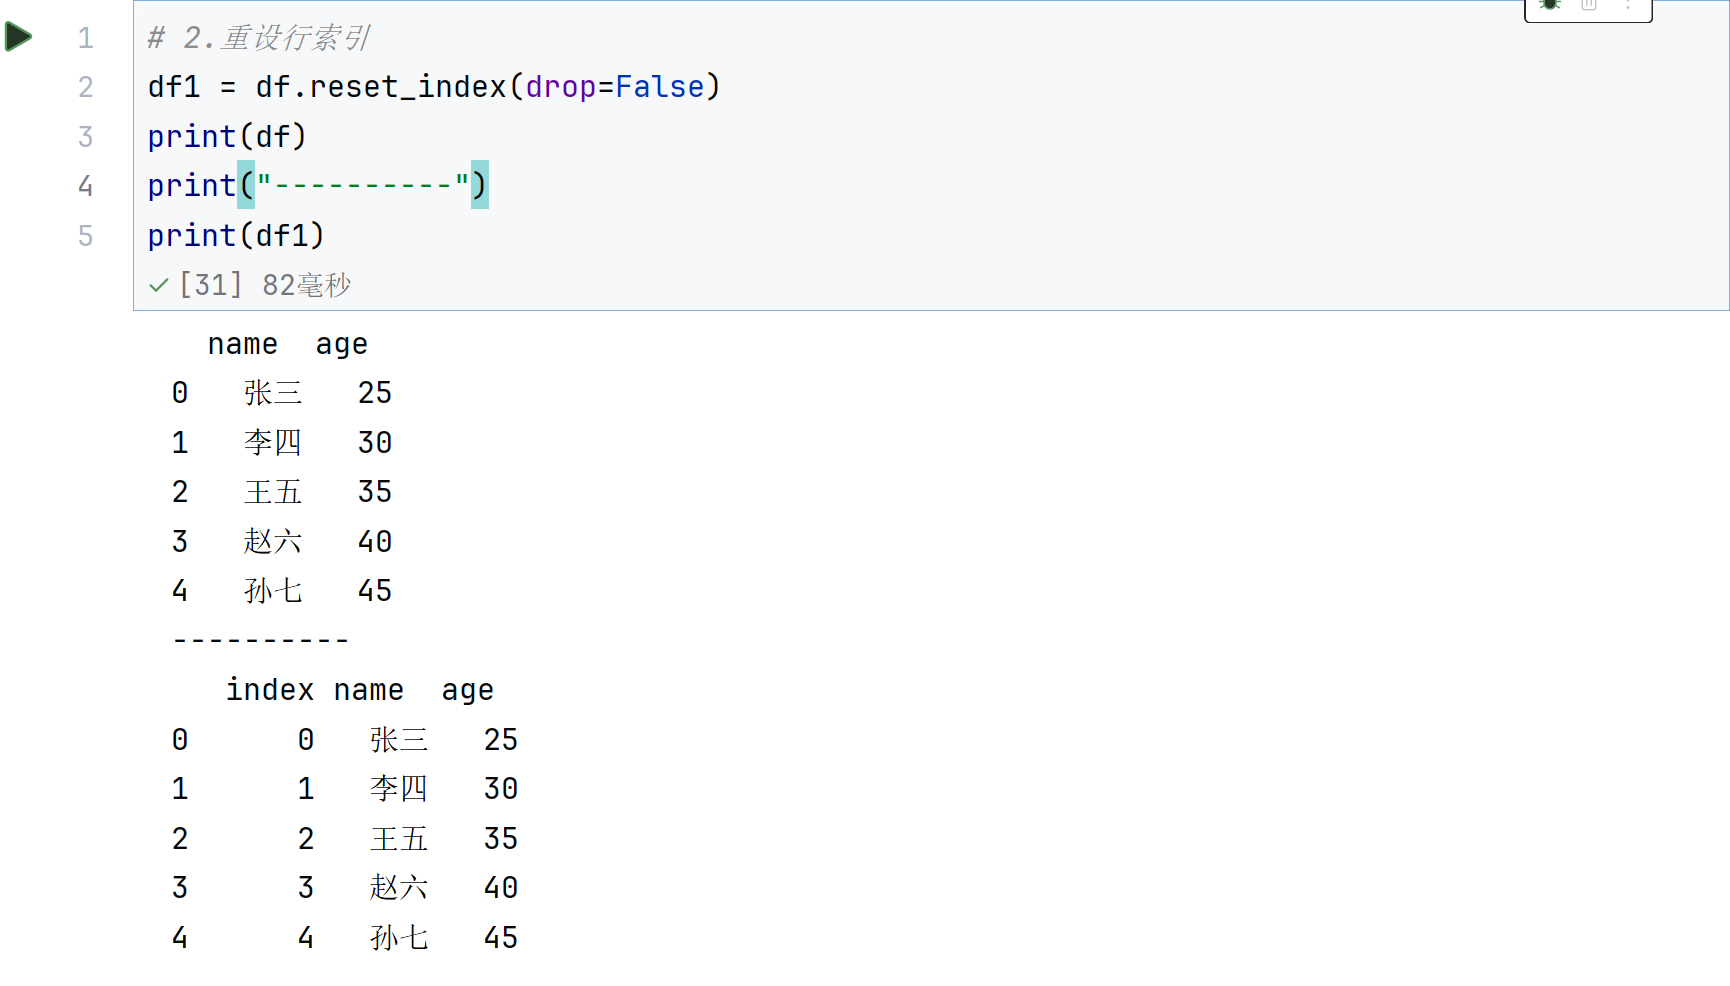
- 重设行索引
重设行索引:reset_index(drop=False)
- 设置新的行索引
- drop:默认为False,表示保留原来索引值;如果为True,表示删除原来索引值
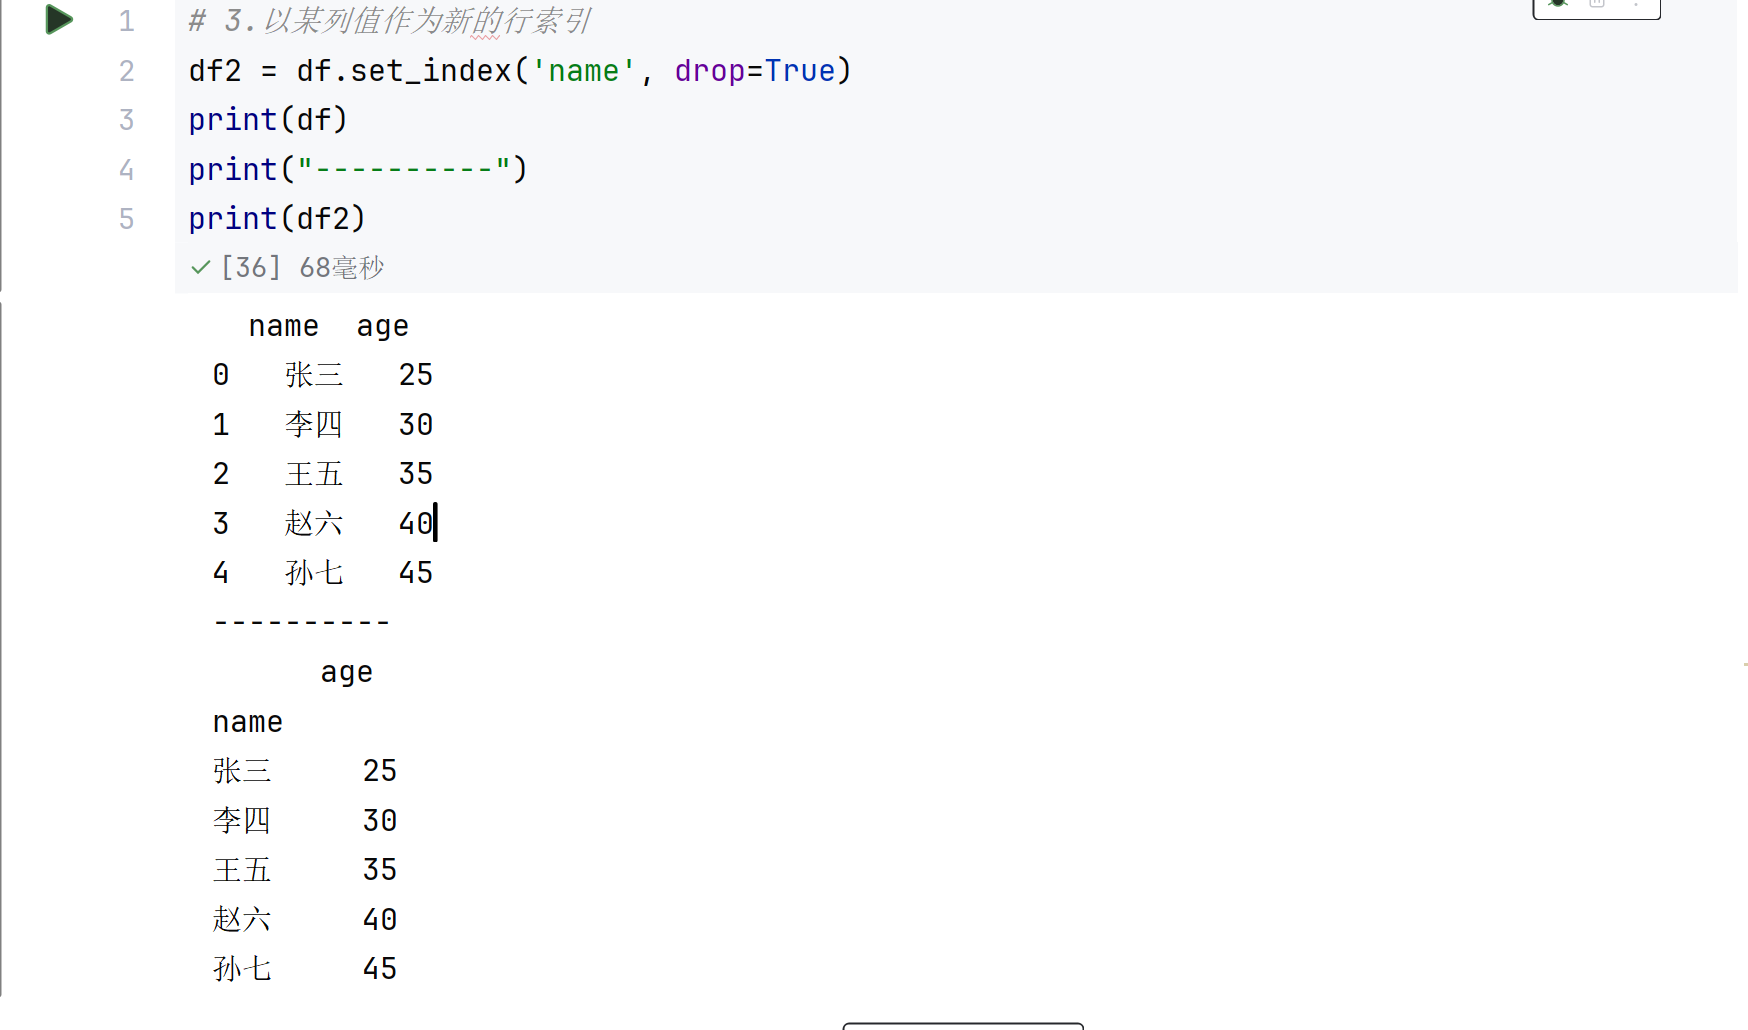
- 以某列值设置为新行索引
set_index(keys,drop=True)
- keys:列索引名 / 列索引名称的列表
- drop:默认为True,表示删除原来索引值
2.2 Pandas 数据类型
Pandas 的 Series 对象和 DataFrame 对象中具体每一个值的数据类型有很多
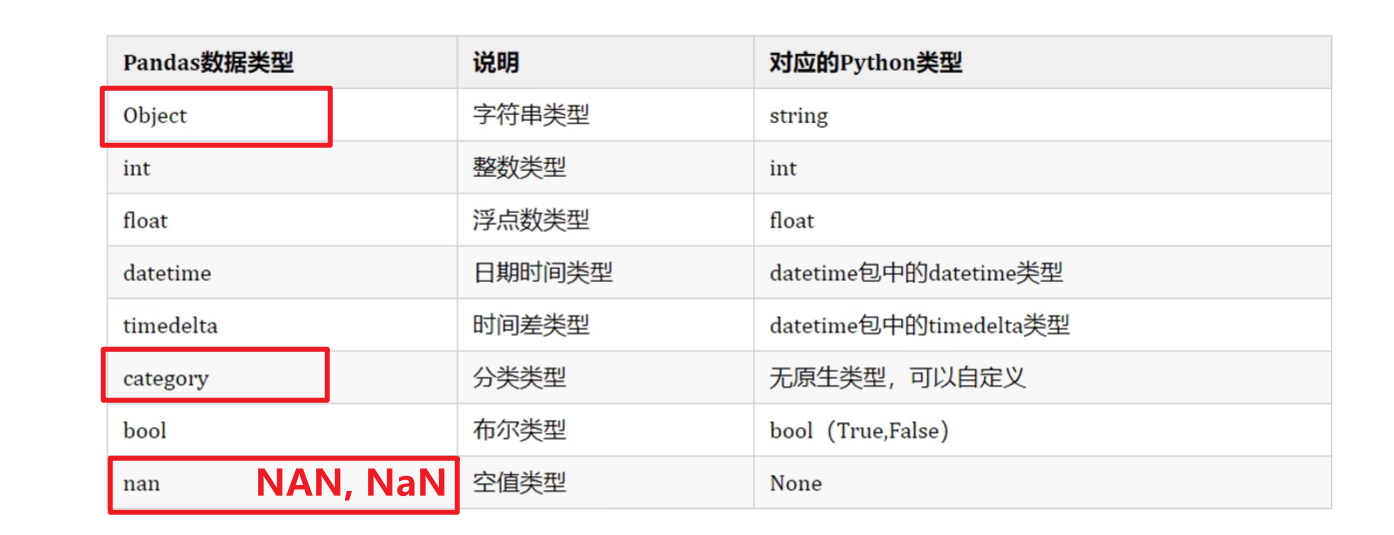
可以通过下面 API 查看 Series 对象和 DataFrame 对象中数据的类型
- Series 对象 :Series对象.dtypes
- DataFrame 对象 :DataFrame对象.dtypes,DataFrame对象.info()
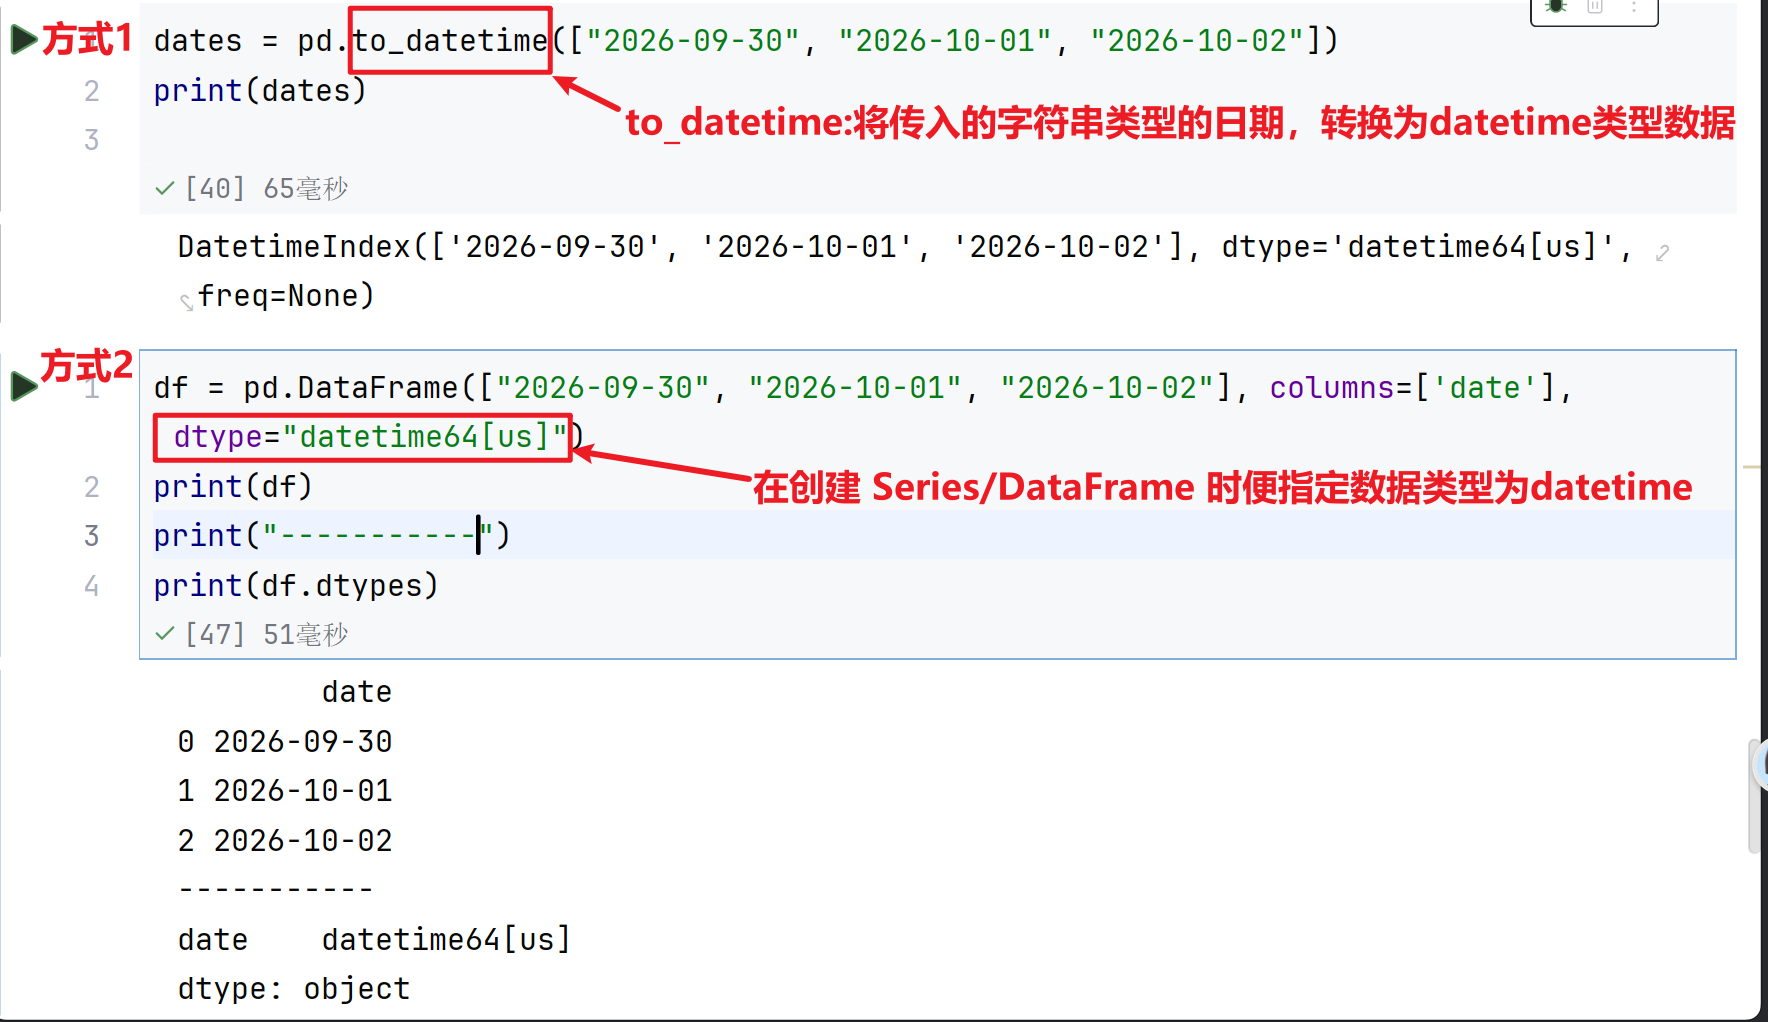
几种特殊数据类型:
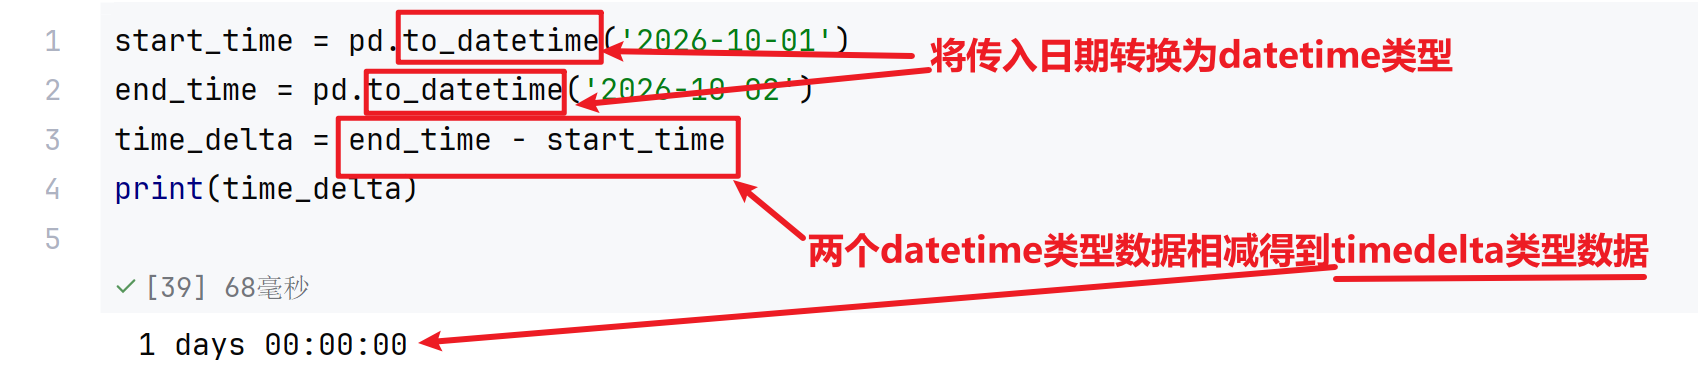
- datetime类型
- timedelta类型
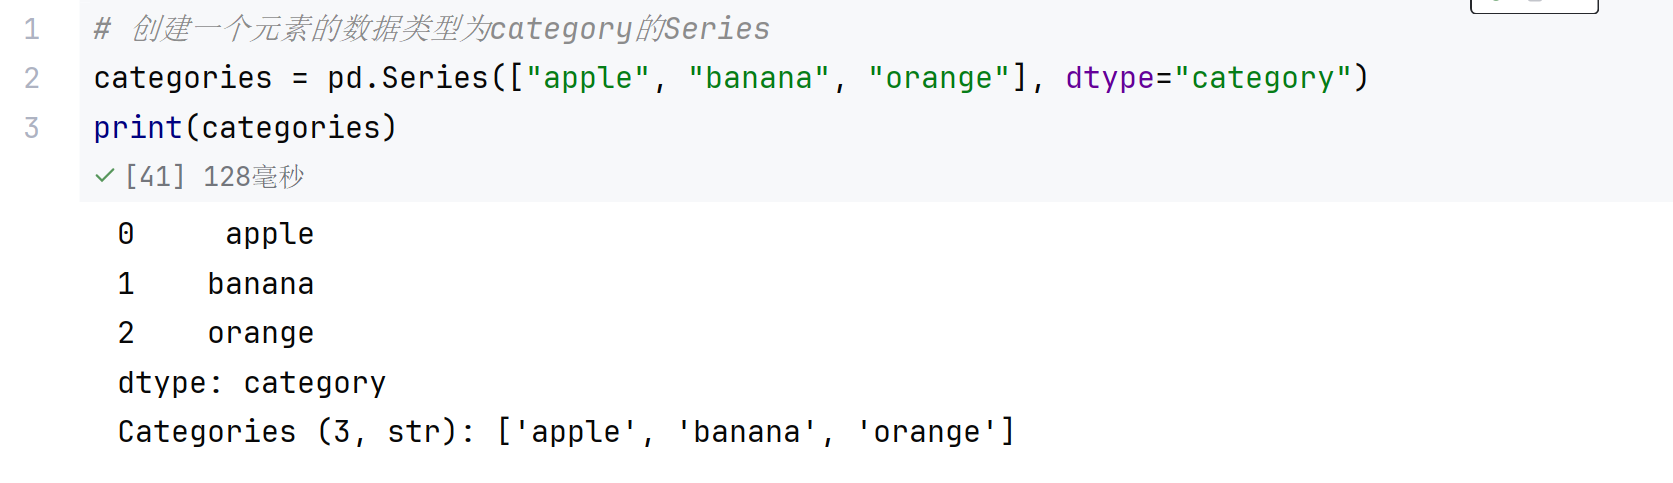
- category类型
category类型数据用于表示分类数据,通常用于有限集合中的数据类型,例如:性别,颜色,产品类型等;这种数据类型的优点在于占用更少的内存,并且分类操作更快
2.3 Pandas 基本数据操作
2.3.1 索引操作
2.3.1.1 索引查询操作
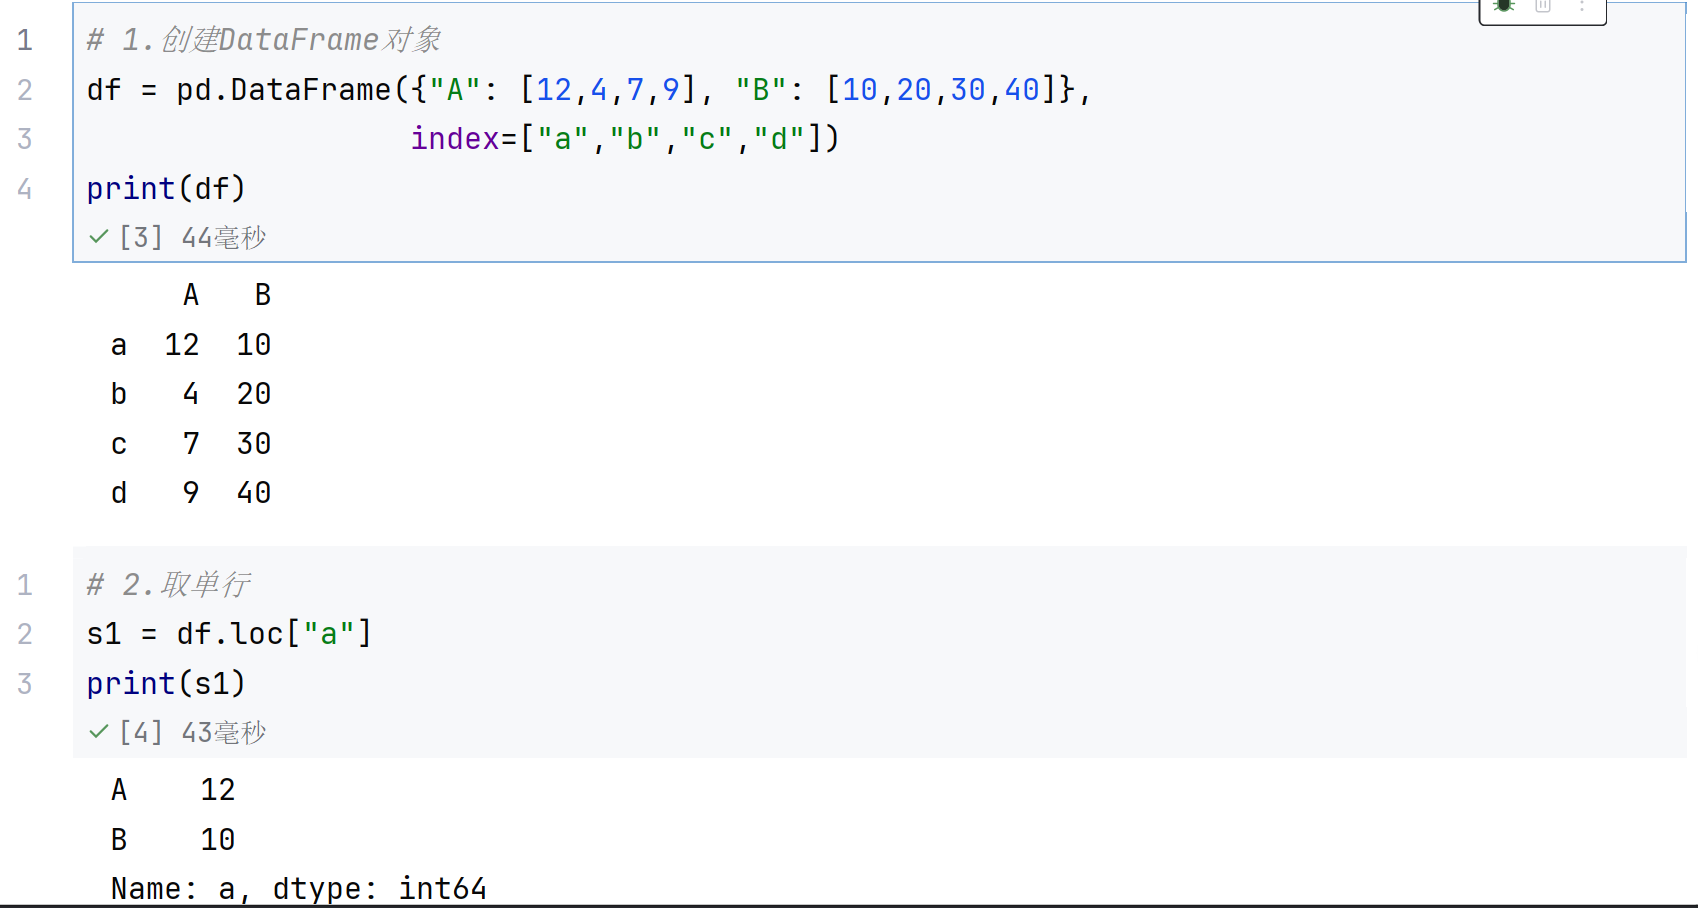
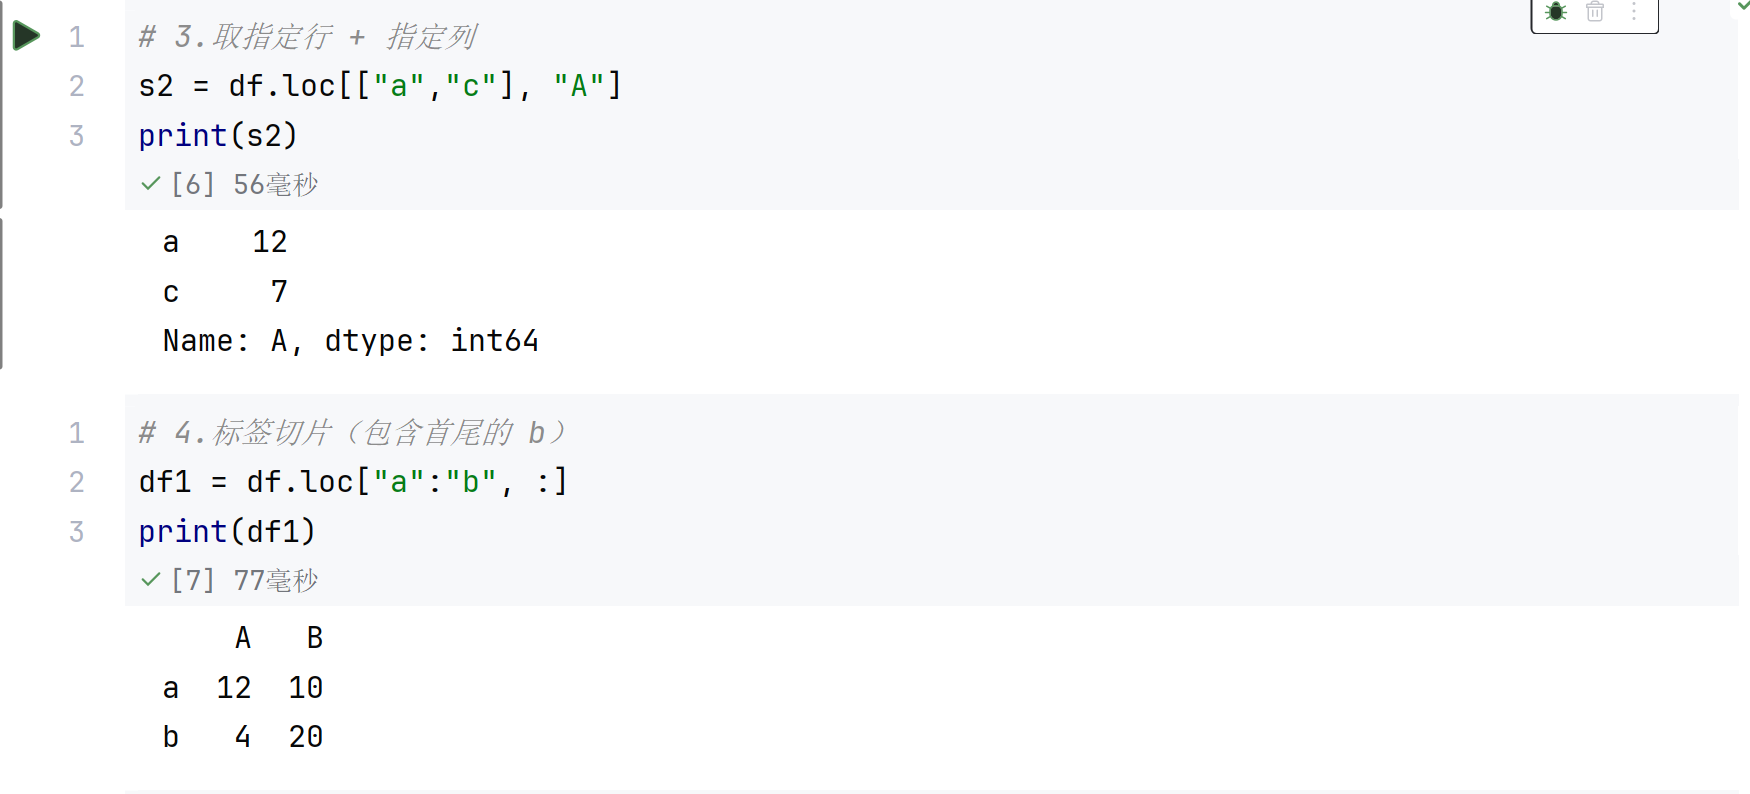
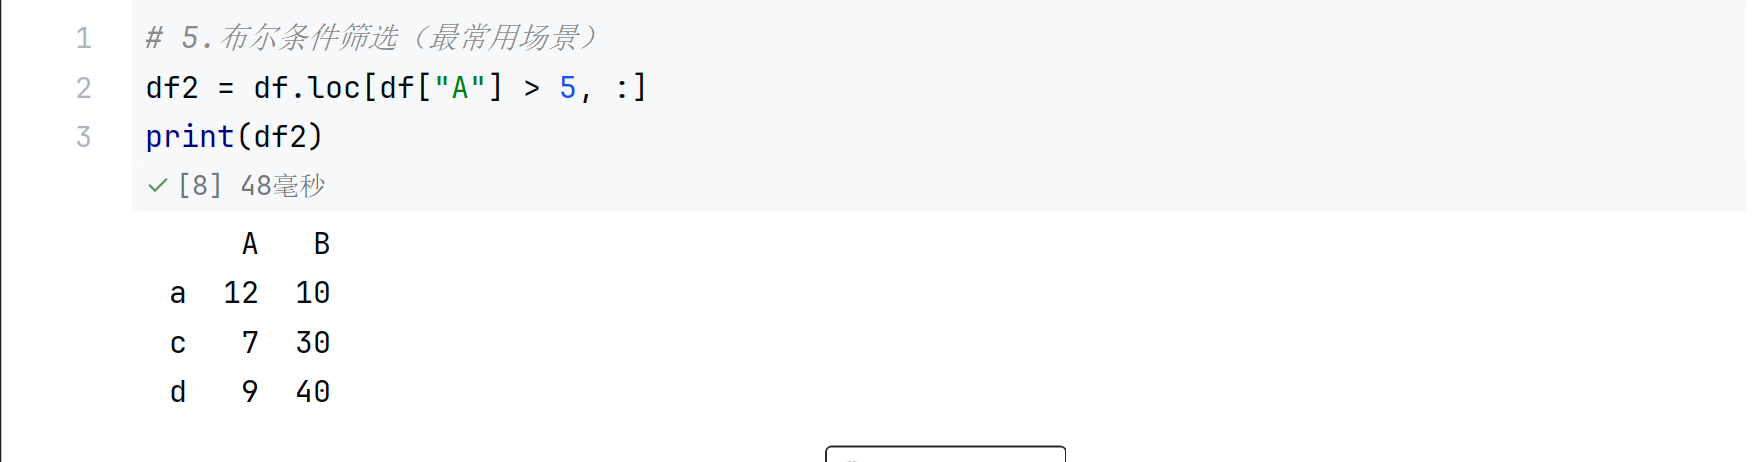
1. loc :按索引取值
语法如下:
df.loc[行索引, 列索引]支持单行、列表、切片、布尔条件筛选,示例如下:
2. iloc :按下标位置取值
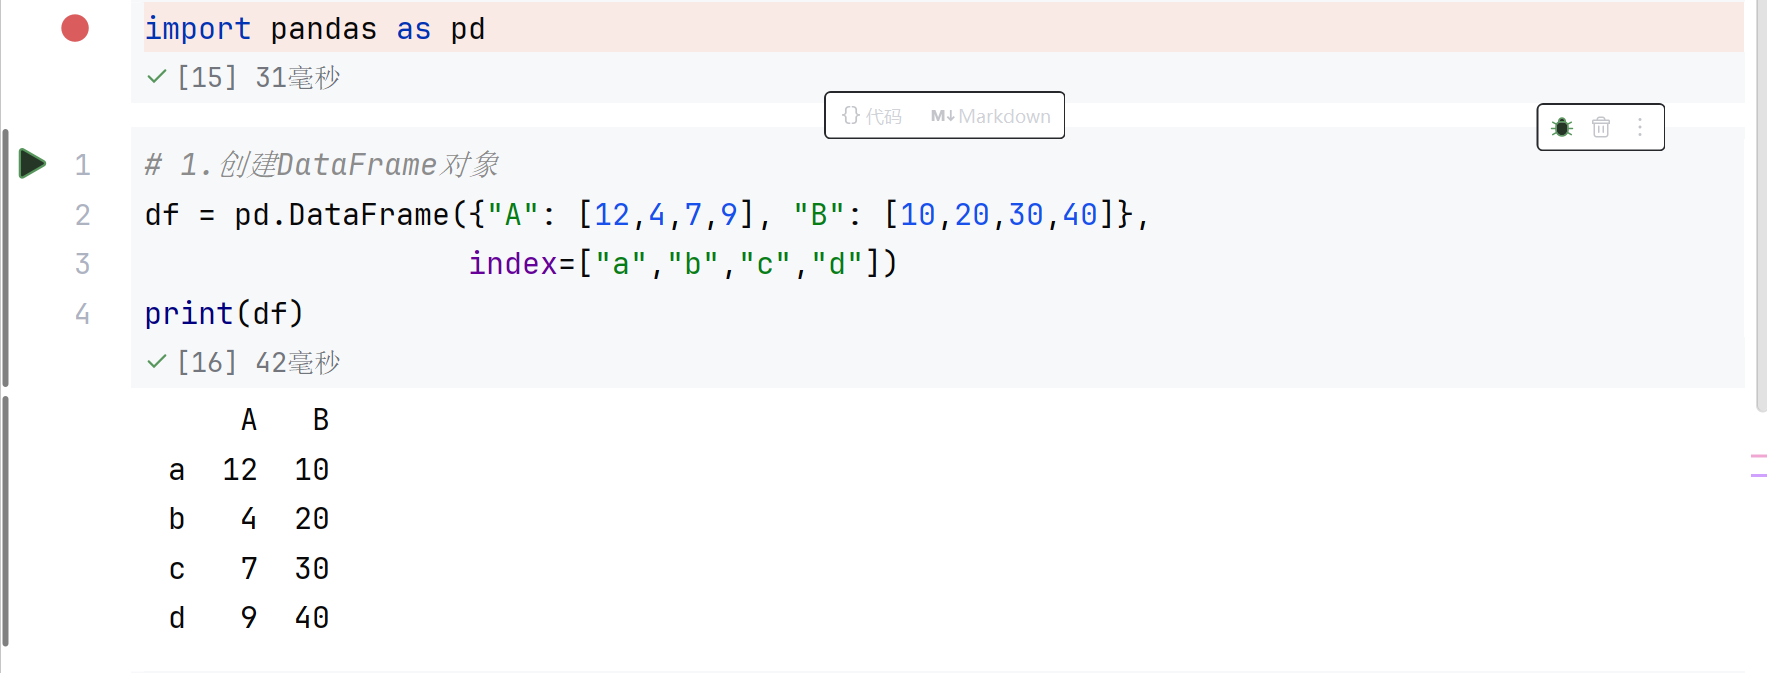
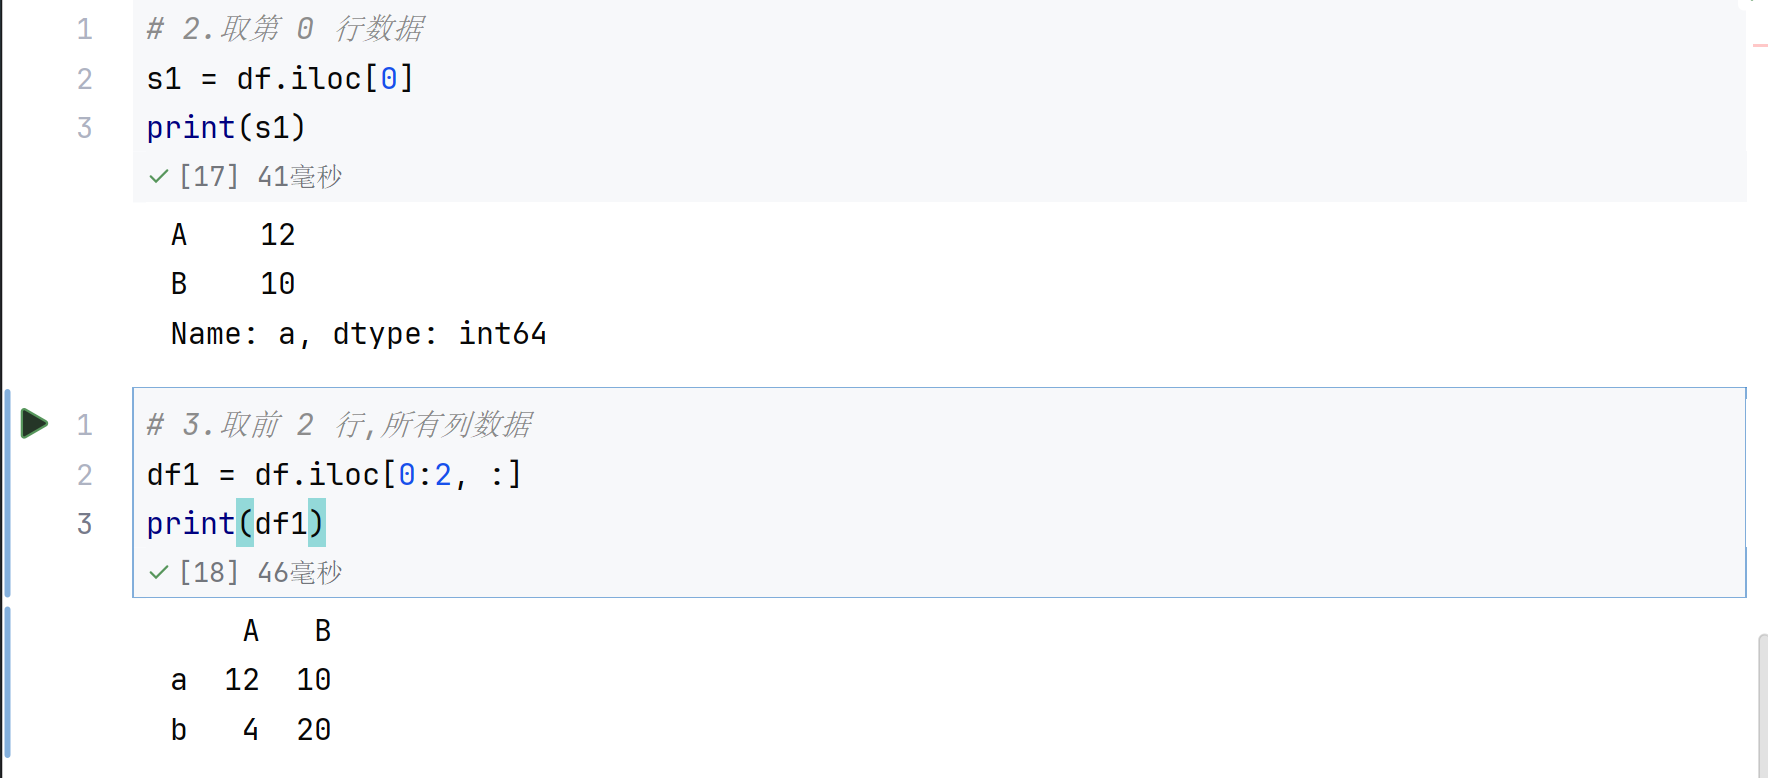
语法如下:
df.iloc[行号, 列号]注意:行号,列号从 0 开始
只接受整数、整数列表、整数切片,示例如下:
3.直接使用行列索引
- Series :s 索引,按索引取单个值
- DataFrame :
- df 列索引名 取列;
- df 行索引切片 取多行;
- df 列索引名行索引名 取某列某行数据(先列后行)
语法如下:
# Series取值
s[1]

# DataFrame 取列
df["A"]

# DataFrame 取前 2 行
df[0:2]

# DataFrame 取"A"列下的第2行
df["A"][1]
2.3.1.2 索引修改操作
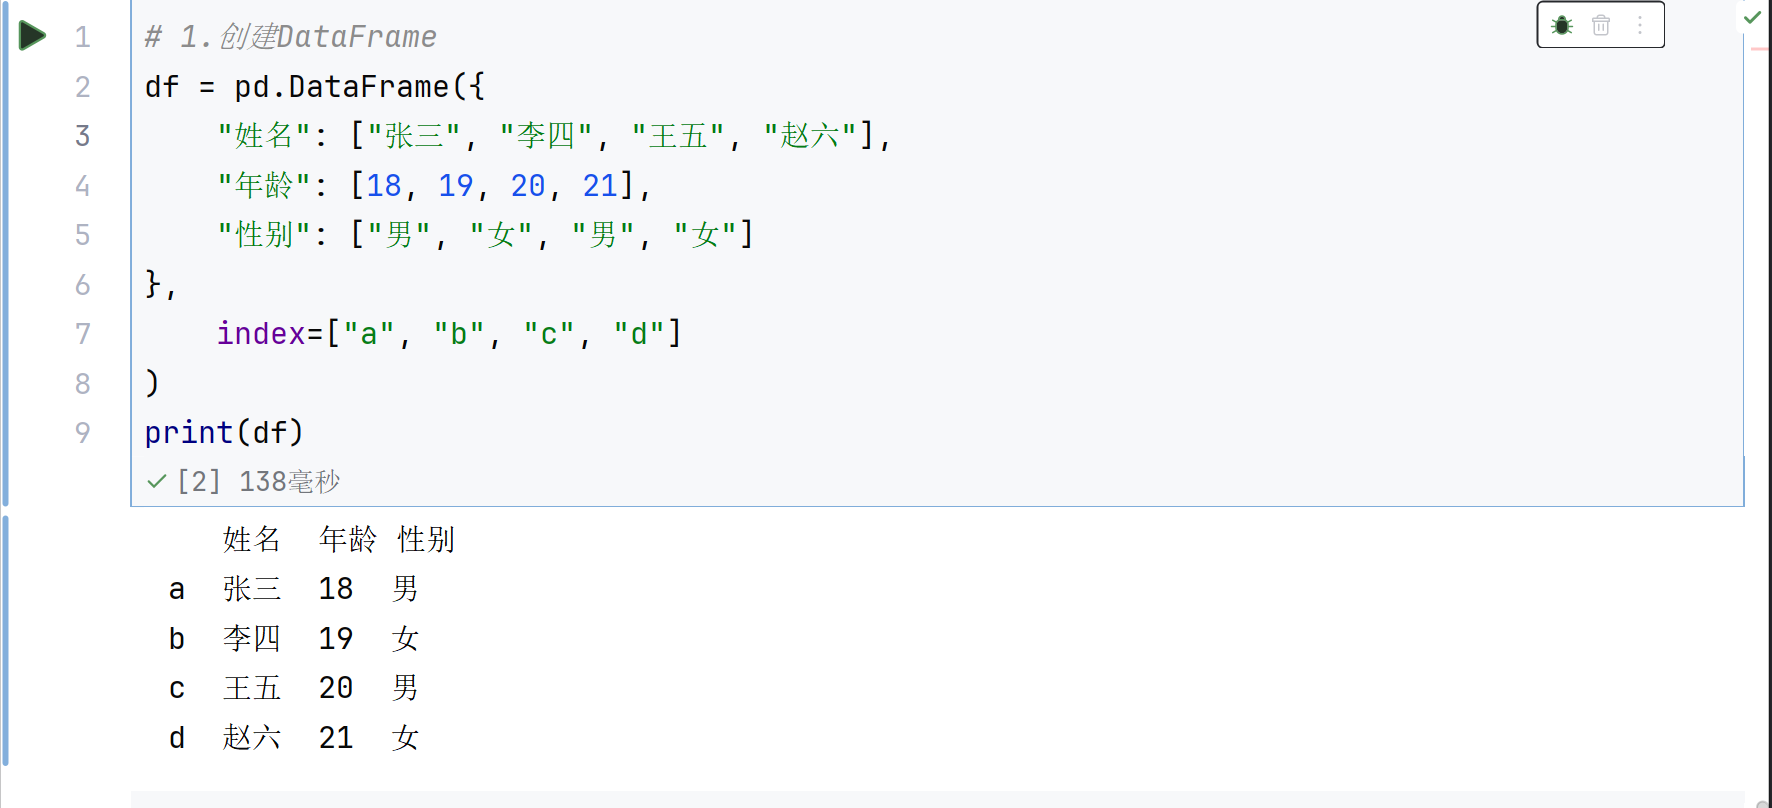
rename ():重命名索引
修改指定行索引或列索引的标签,核心作用是给已有的索引标签 "改名"
语法如下:
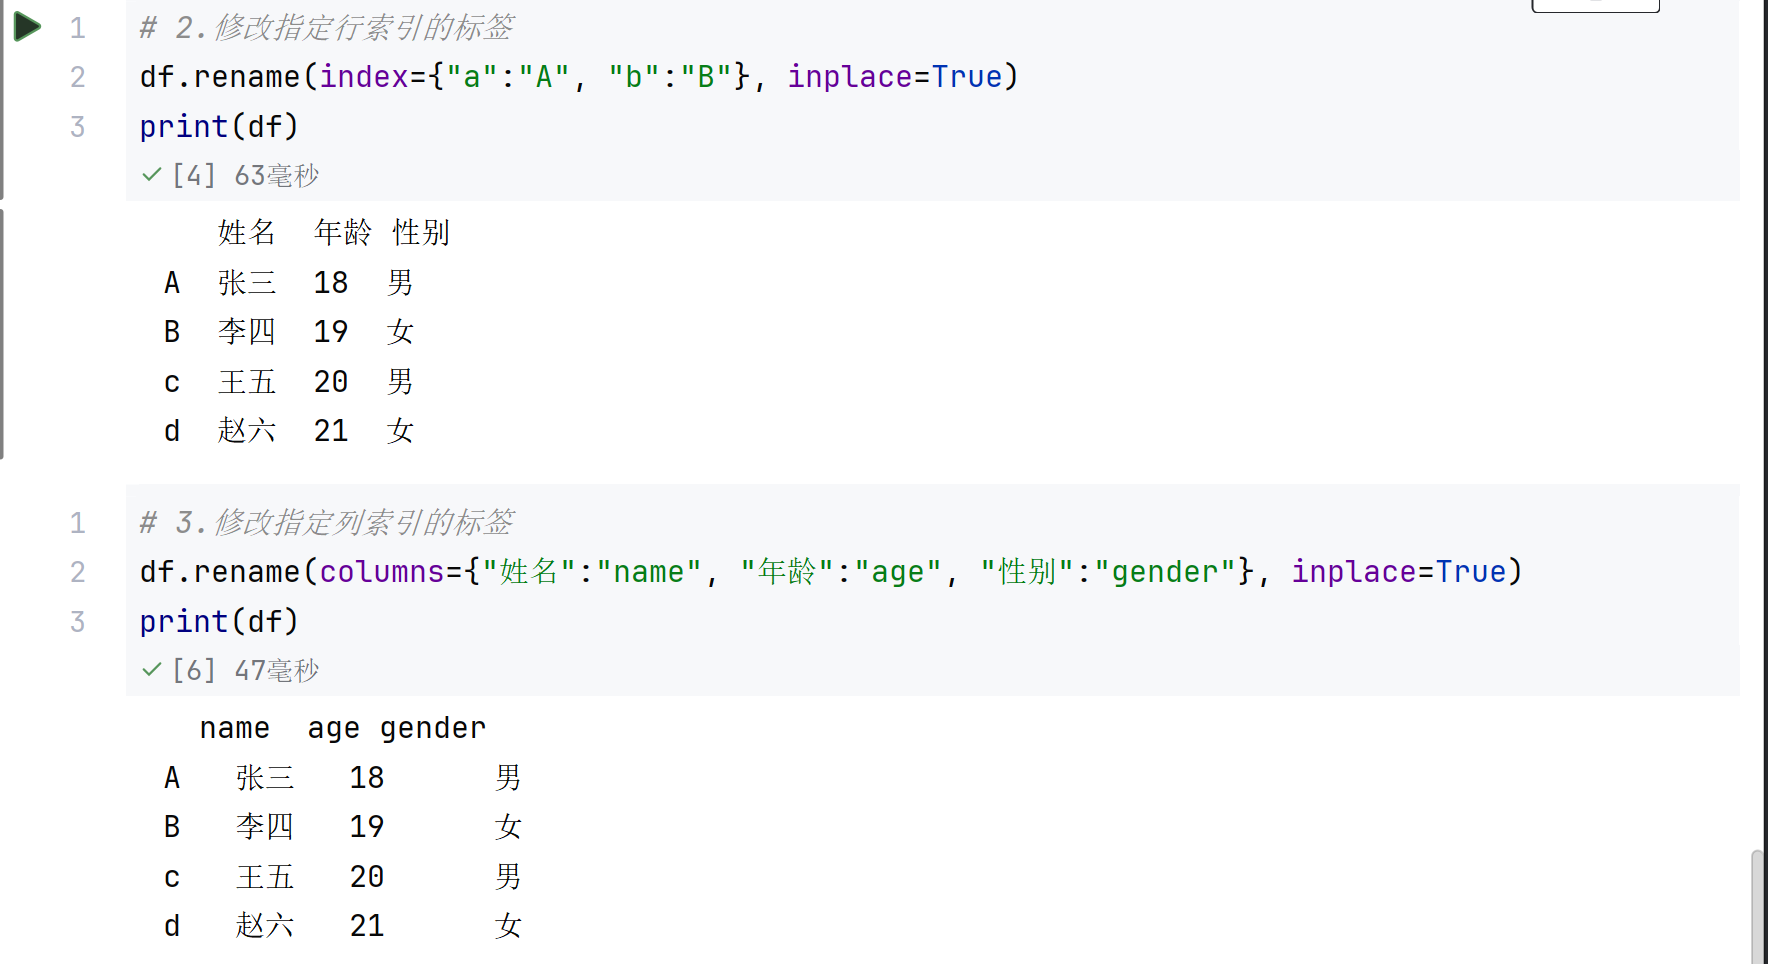
inplace :就地修改,核心作用是控制操作的作用方式:是直接修改原数据对象,还是生成新的副本返回
| 取值 | 默认值 | 行为 | 原对象变化 |
|---|---|---|---|
inplace=False |
✅ 默认 | 生成一份修改后的新副本,原数据丝毫不动 | 完全不变 |
inplace=True |
❌ 非默认 | 直接在原对象上做修改,不生成副本 | 直接被覆盖修改 |
2.3.2 赋值操作
赋值是 Pandas 数据修改的基础操作,核心准则:优先通过 loc / iloc 一步定位再赋值
1. 整列赋值与新增列
1.标量广播赋值:赋单个数值时,会自动广播到整列所有行
import pandas as pd
df = pd.DataFrame({"A": [1, 2, 3], "B": [4, 5, 6]})

# 修改 A 列所有值为 100
df["A"] = 100

# 新增 C 列,全部填充 0
df["C"] = 02.序列赋值 :传入列表、数组或 Series,长度必须与 DataFrame 行数一致,逐行对应赋值
df["D"] = [10, 20, 30]3.表达式计算赋值:基于已有列计算生成新列
df["总和"] = df["A"] + df["B"]
df["翻倍"] = df["A"] * 2
2. 局部精准赋值:loc /iloc
修改指定单元格、指定行 / 列区域,必须用 loc (按索引)或 iloc(按下标位置)
1.loc 按索引赋值
语法如下:
df.loc[行索引, 列索引] = 值示例如下:
# 修改单个单元格:索引 0 行、A 列
df.loc[0, "A"] = 999

# 修改指定多行多列
df.loc[[0, 2], ["A", "B"]] = 0

# 标签切片赋值
df.loc[0:1, "B"] = 50
2. iloc 按下标位置赋值
语法如下:
df.iloc[行位置, 列位置] = 值示例如下:
# 修改第 0 行第 0 列
df.iloc[0, 0] = 888

# 修改前 2 行、前 2 列区域
df.iloc[0:2, 0:2] = 1
3.条件赋值
只修改满足筛选条件的行,是数据清洗、异常值处理的核心操作
# 把 A 列大于 2 的行,B 列设为 100
df.loc[df["A"] > 2, "B"] = 100

# 多条件:A>1 且 B<6 的行,C 列设为 "符合"
df.loc[(df["A"] > 1) & (df["B"] < 6), "C"] = "符合"
2.3.3 排序操作
Pandas 排序核心分为两类:按数据值排序 sort_values()、按索引标签排序 sort_index()
另外补充排名函数 rank() 用于生成排名序号,不改变原数据顺序
1.按值排序:sort_values ()
根据一列或多列的数值大小排序,Series 和 DataFrame 均支持
核心参数:
| 参数 | 说明 | 默认值 |
|---|---|---|
by |
字段名 / Series,DataFrame 必填,指定按哪列排序 | --- |
axis |
0 = 按行排序,1 = 按列排序 |
0 |
ascending |
True 升序,False 降序;多列时可一 一对应升降序 |
True |
inplace |
是否直接修改原数据 | False |
na_position |
空值 NaN 的位置:'last' 放最后,'first' 放最前 |
'last' |
ignore_index |
排序后是否重置为从 0 开始的连续整数索引 | False |
Series排序:
import pandas as pd
s = pd.Series([12, 4, 7, 9, None])

# 默认升序,空值放末尾
s.sort_values()

# 降序排列,空值放最前面
s.sort_values(ascending=False, na_position='first')
DataFrame 单列排序:
df = pd.DataFrame({
    "班级": ["一班","一班","二班","二班"],
    "分数": [85, 92, 78, 92],
    "姓名": ["张三","李四","王五","赵六"]
})

# 按分数升序排列
df.sort_values(by="分数")

# 按分数降序,同时重置索引
df.sort_values(by="分数", ascending=False, ignore_index=True)
DataFrame 多列排序:by 列表中越靠前的列,排序优先级越高;第一列值相同时,再按第二列排序
# 先按班级升序,同班内再按分数降序
df.sort_values(by=["班级", "分数"], ascending=[True, False])
2.按索引排序:sort_index ()
根据行索引或列索引顺序排序
核心参数:
| 参数 | 说明 | 默认值 |
|---|---|---|
axis |
0:行索引排序;1:列索引排序 |
0 |
ascending |
True:升序(默认);False:降序; |
True |
inplace |
是否就地修改原数据 | False |
na_position |
索引缺失值的位置:'last' 放最后,'first' 放最前 | last(默认排最后) |
level |
指定排序层级(多层索引用) | 层级名称或层级序号 |
kind |
排序算法 | quicksort(快排) |
常用写法如下:
# 行索引降序排列
df.sort_index(ascending=False)

# 按列名字母顺序,左右调换列的顺序
df.sort_index(axis=1)
3.排名函数:rank ()
不改变数据行的顺序,仅新增一列排名序号,专门处理并列排名的不同规则
核心参数:
| method | 规则说明 | 示例:值 [92, 92, 78] 的降序排名 |
|---|---|---|
average |
平均排名(默认) | 1.5, 1.5, 3 |
min |
并列取最小名次 | 1, 1, 3 |
max |
并列取最大名次 | 2, 2, 3 |
first |
按出现先后排,同名次不并列 | 1, 2, 3 |
dense |
密集排名,名次不跳号 | 1, 1, 2 |
示例:
# 给分数列生成排名,并列分数取相同最小名次
df["排名"] = df["分数"].rank(method="min", ascending=False)
2.4 DataFrame 运算
2.4.1 算数运算
对两个 DataFrame 对应位置的元素执行算术计算,支持运算符和专用方法两种写法
1.基础运算符
运算符写法简洁,但无法控制缺失值
| 运算 | 运算符 | 说明 |
|---|---|---|
| 加法 | + |
|
| 减法 | - |
|
| 乘法 | * |
|
| 除法 | / |
浮点除法 |
| 整除 | // |
向下取整 |
| 取余 | % |
|
| 幂运算 | ** |
语法如下:
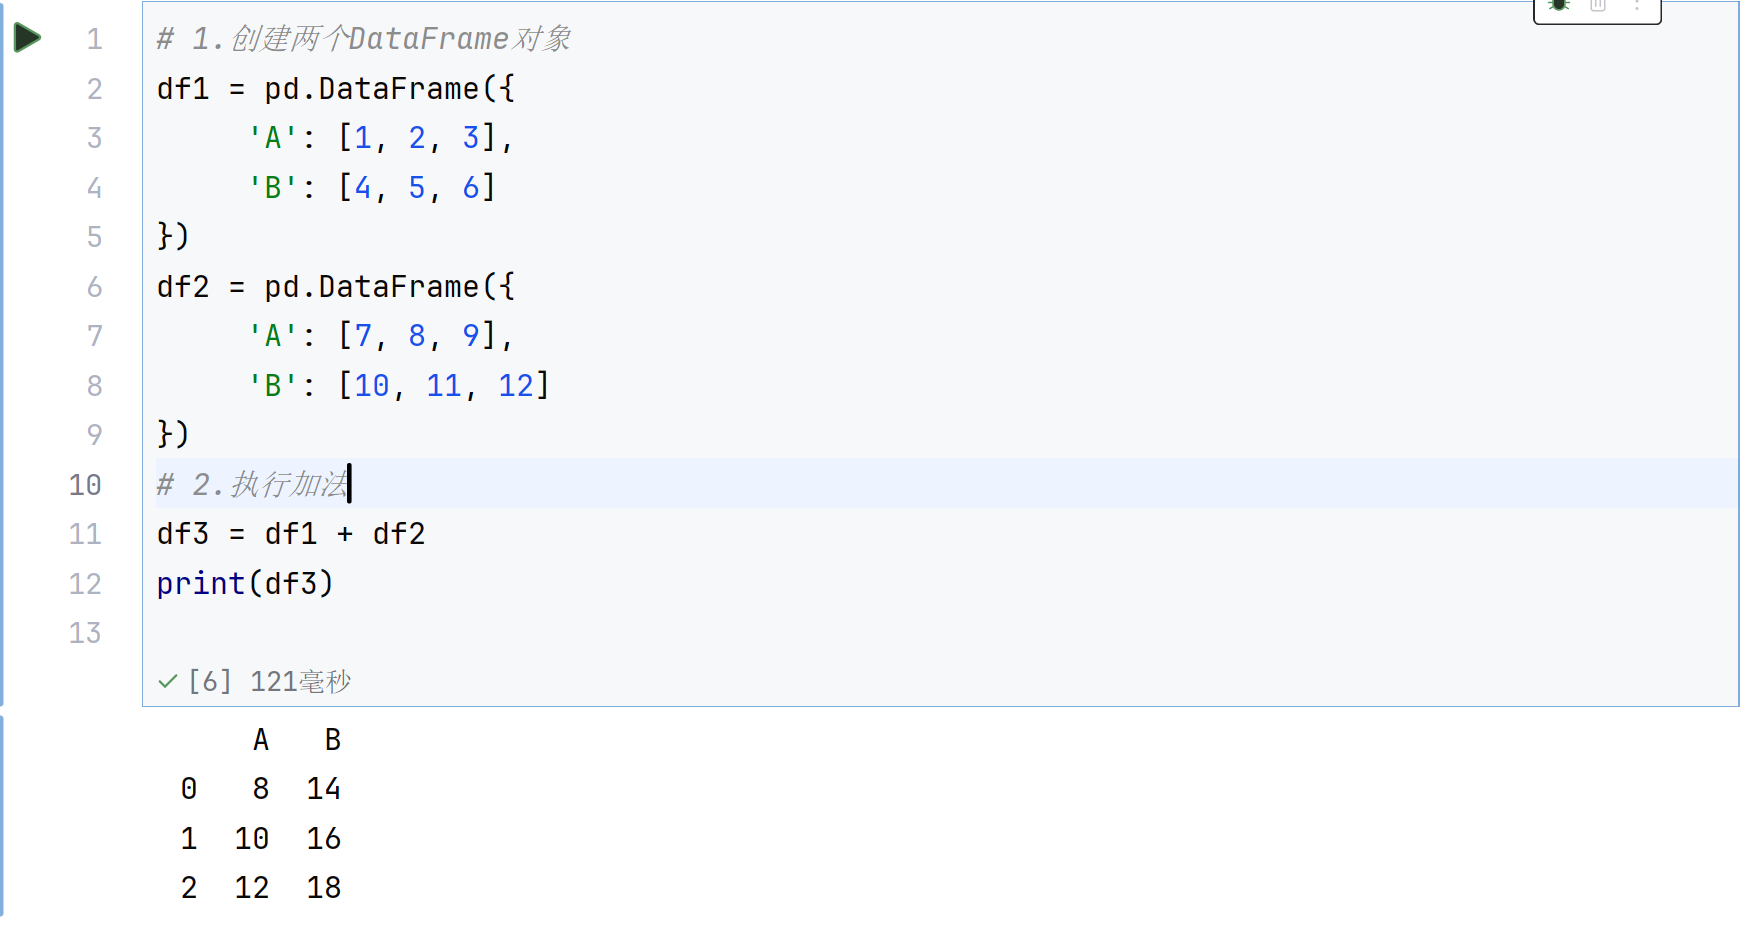
df1 + df2   # 加法
df1 * df2   # 对应位置相乘
示例如下:
2.专用方法
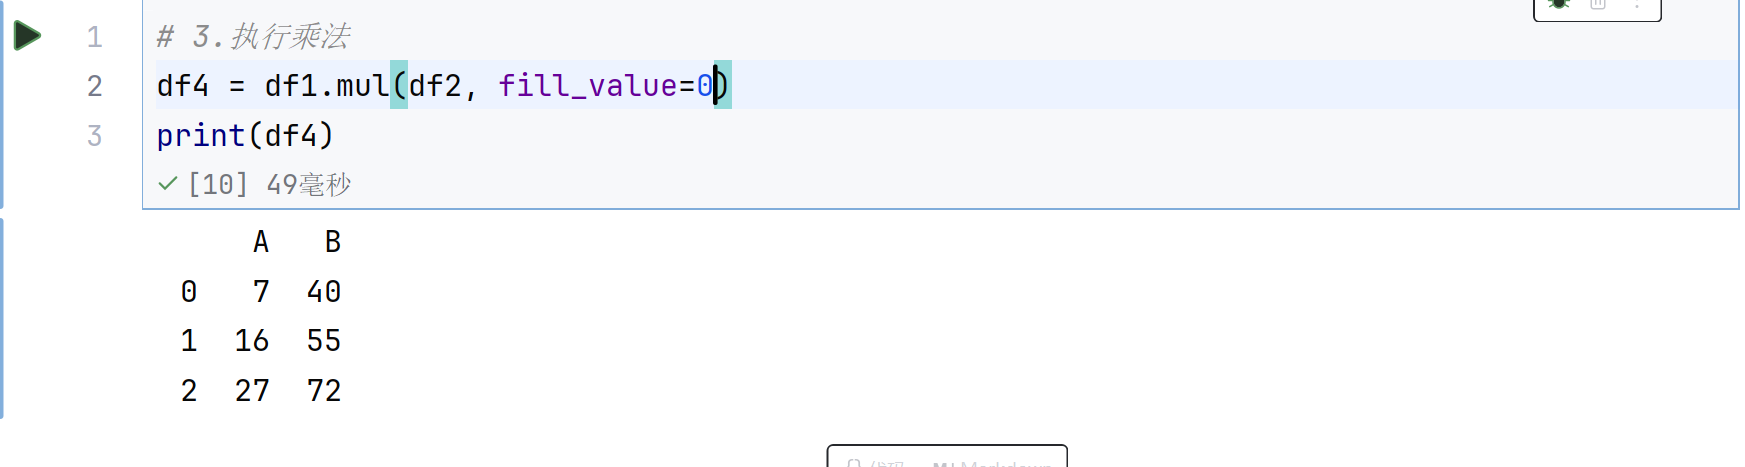
专用方法支持 fill_value 参数,可先填充缺失值再运算,避免 NaN 传播
| 运算 | 方法 |
|---|---|
| 加 | add() |
| 减 | sub() / subtract() |
| 乘 | mul() / multiply() |
| 除 | div() / truediv() |
| 整除 | floordiv() |
| 取余 | mod() |
| 幂 | pow() |
语法如下:
# 缺失位置用0填充后再相加
df1.add(df2, fill_value=0)
示例:
2.4.2 比较与逻辑运算
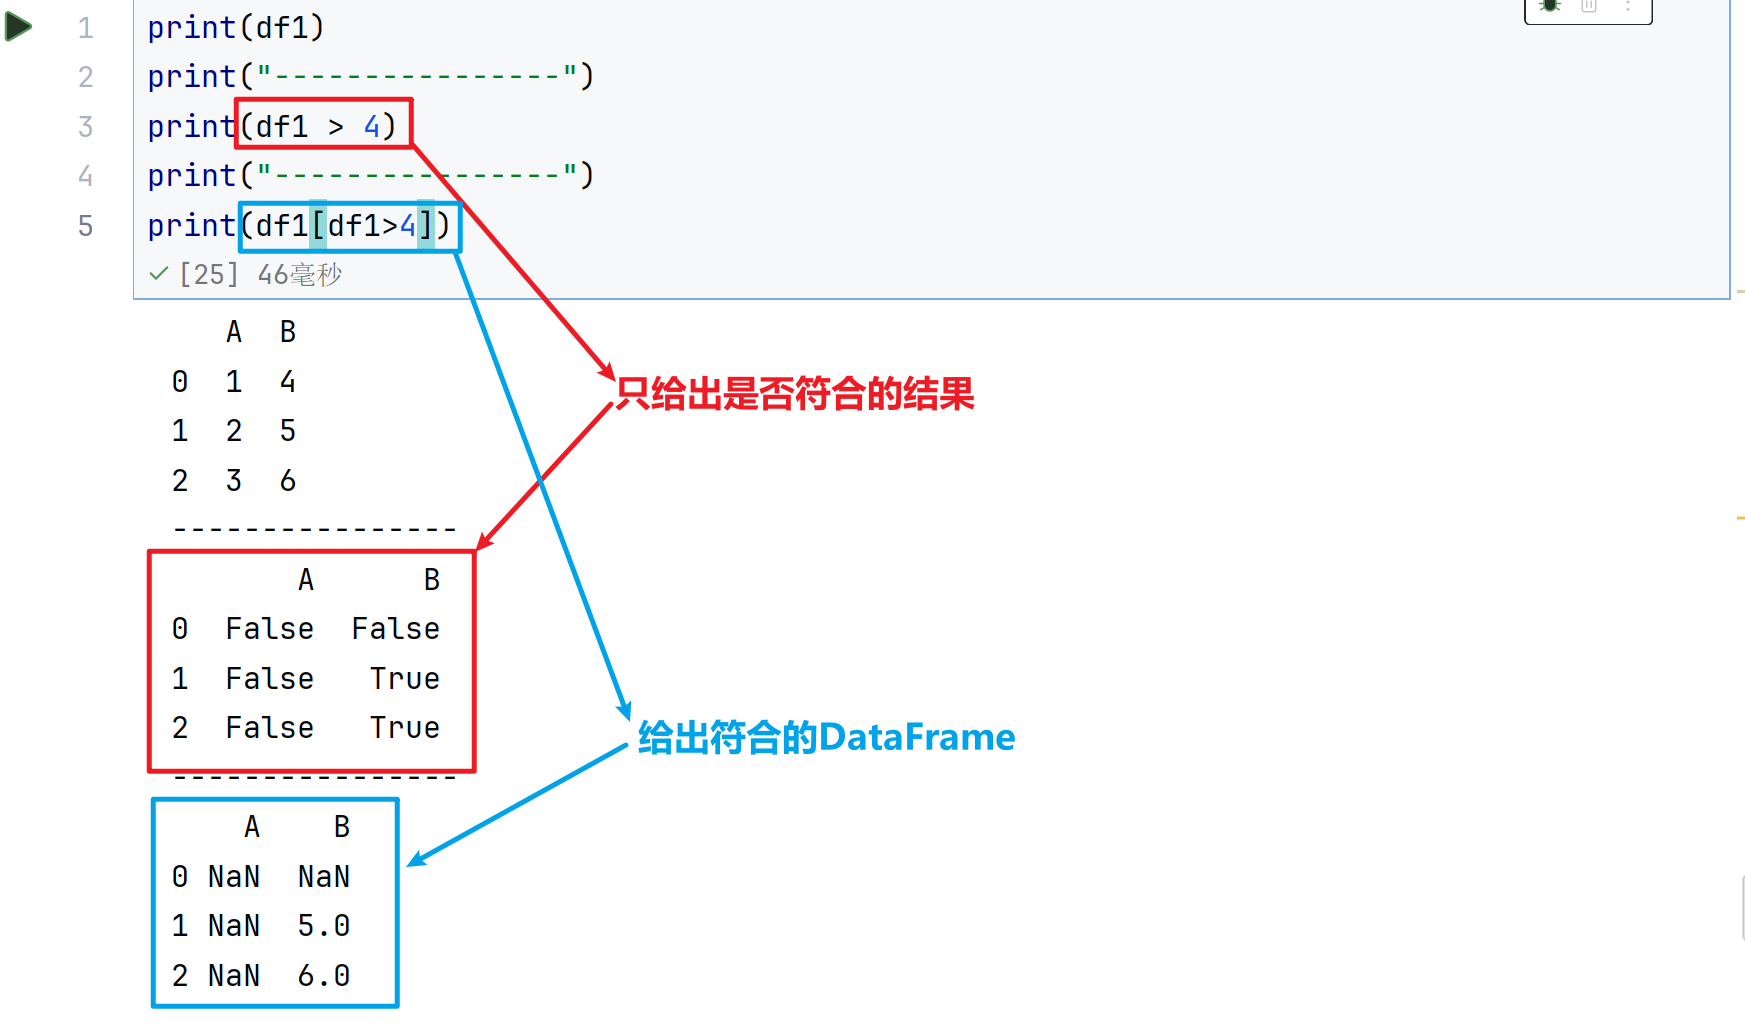
1.比较运算
逐元素进行大小比较,返回布尔型 DataFrame/Series
| 运算符 | 含义 |
|---|---|
> |
大于 |
< |
小于 |
== |
等于 |
!= |
不等于 |
>= |
大于等于 |
<= |
小于等于 |
语法如下:
df > 0          # 判断每个元素是否大于0
df['A'] == 1    # 判断A列每个元素是否等于1
示例:
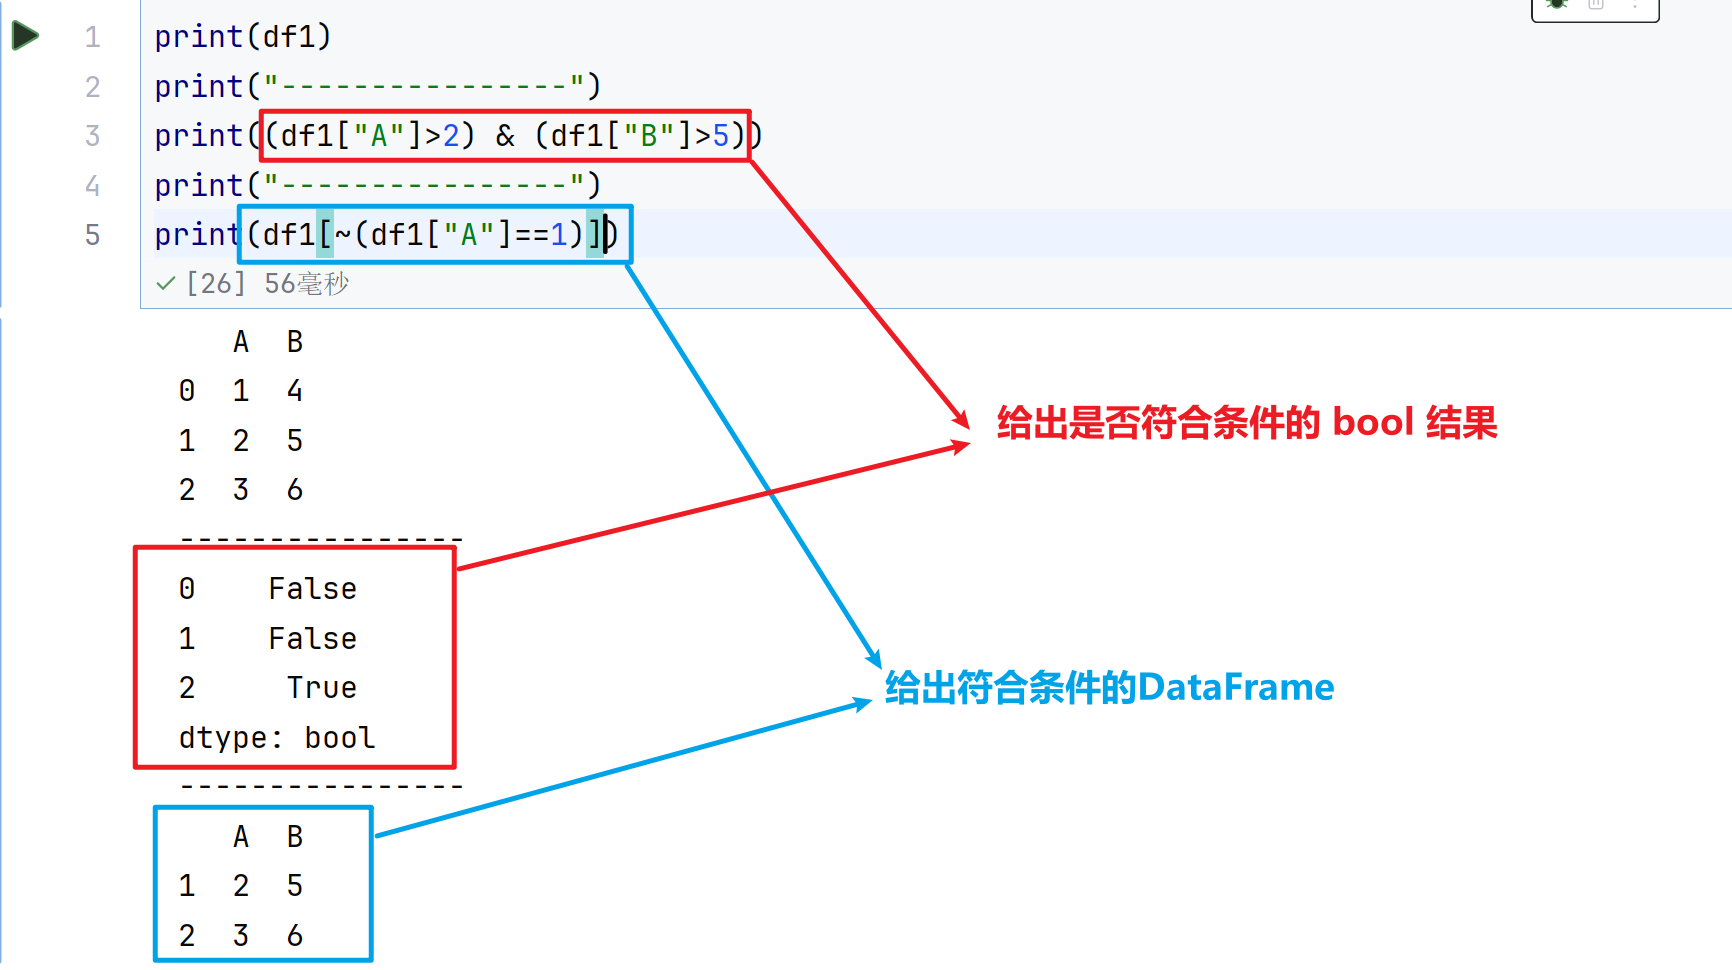
2.逻辑运算
用于组合多个布尔条件,注意:
- 必须用**&(与),|(或),~(非)**,不能用 and/or/not
- 每个条件必须用括号包裹,否则会因运算符优先级报错
语法如下:
# 筛选 A列>0 且 B列<10 的行
df[(df['A'] > 0) & (df['B'] < 10)]

# 筛选 A列 不等于 3 的行
df[~(df['A'] == 3)]
示例:
3.query()方法
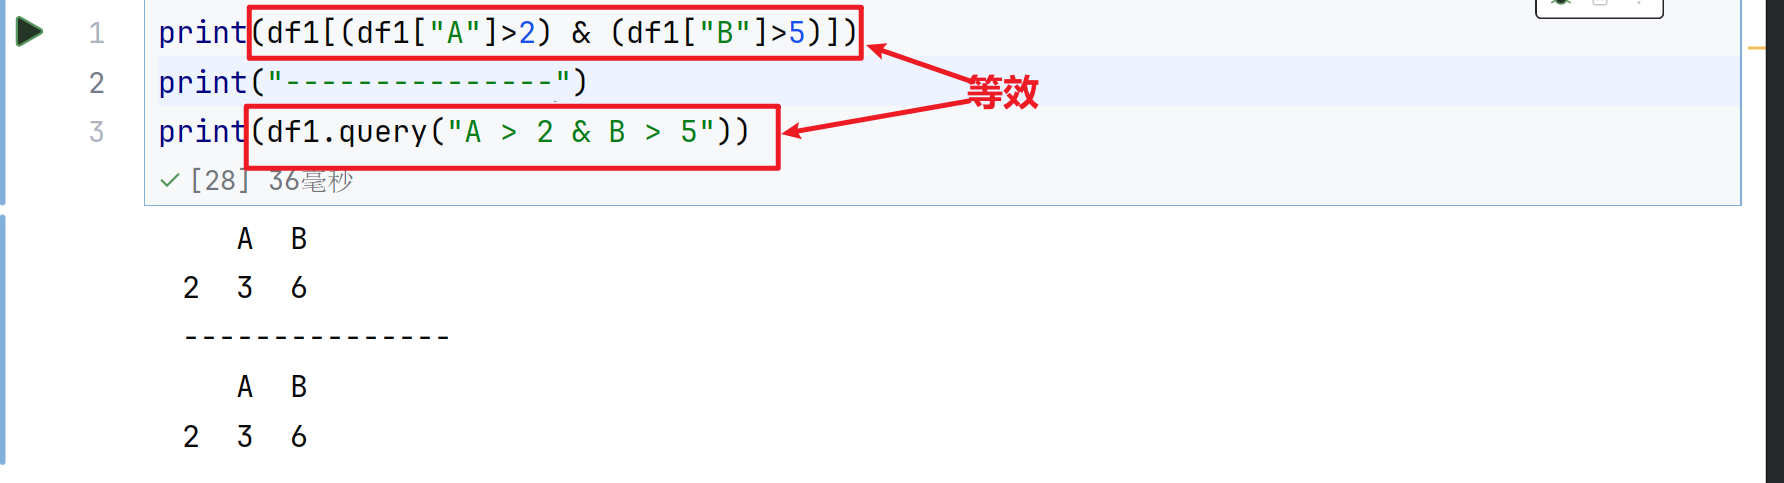
query()方法 :是 Pandas 提供的字符串表达式式行筛选方法
语法如下:
df.query(expr, inplace=False, **kwargs)核心参数:
| 参数 | 说明 |
|---|---|
expr |
核心参数 :字符串形式的查询表达式,直接使用列名作为变量 |
inplace |
是否就地修改原数据,默认False |
示例如下:
4.isin()方法
isin()方法 :是 Pandas 中成员资格判断 的核心方法,用于逐个判断元素是否属于指定集合(离散),返回布尔型结果
语法:isin() 同时支持 Series 和 DataFrame 调用
# Series 调用:返回同长度布尔Series
Series对象名.isin(values)

# DataFrame 调用:返回同形状布尔DataFrame
DataFrame对象名.isin(values)
values 参数支持的类型:
- 列表 / 元组 / 集合:最常用,指定匹配的取值集合
- Series:判断元素是否在另一个 Series 的取值中
- 字典 :仅 DataFrame 可用,按列分别指定不同的匹配集合
- DataFrame :按位置一 一对应匹配
2.4.3 统计计算
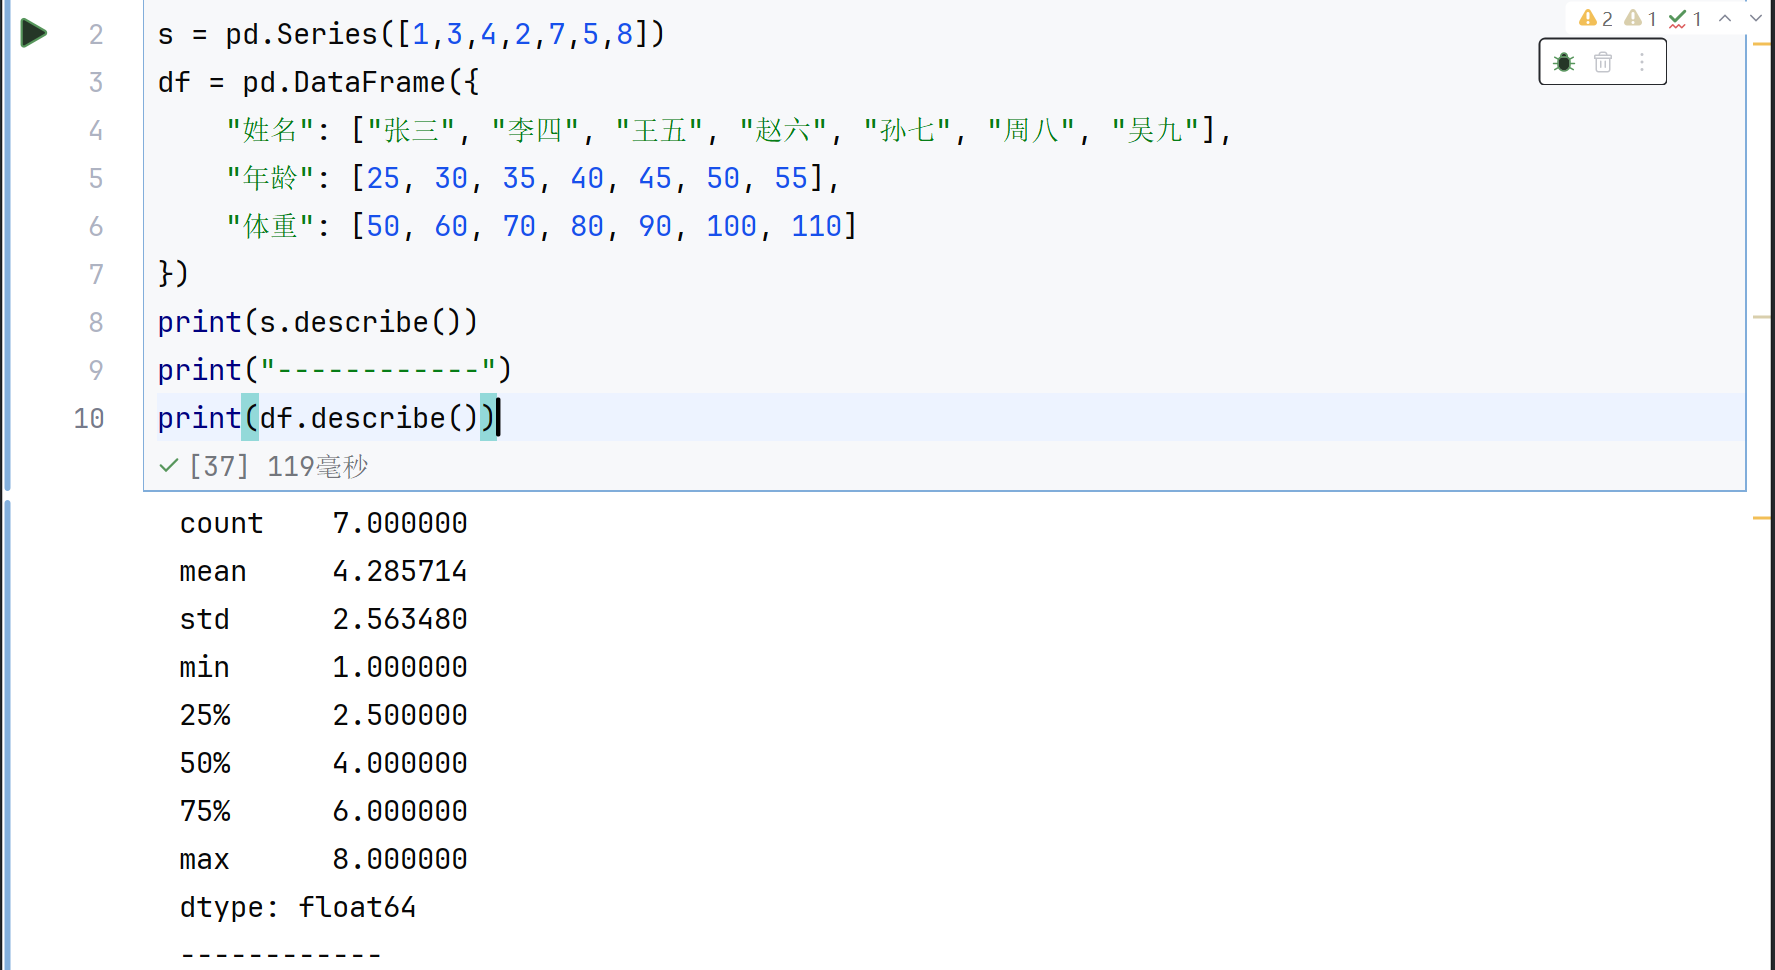
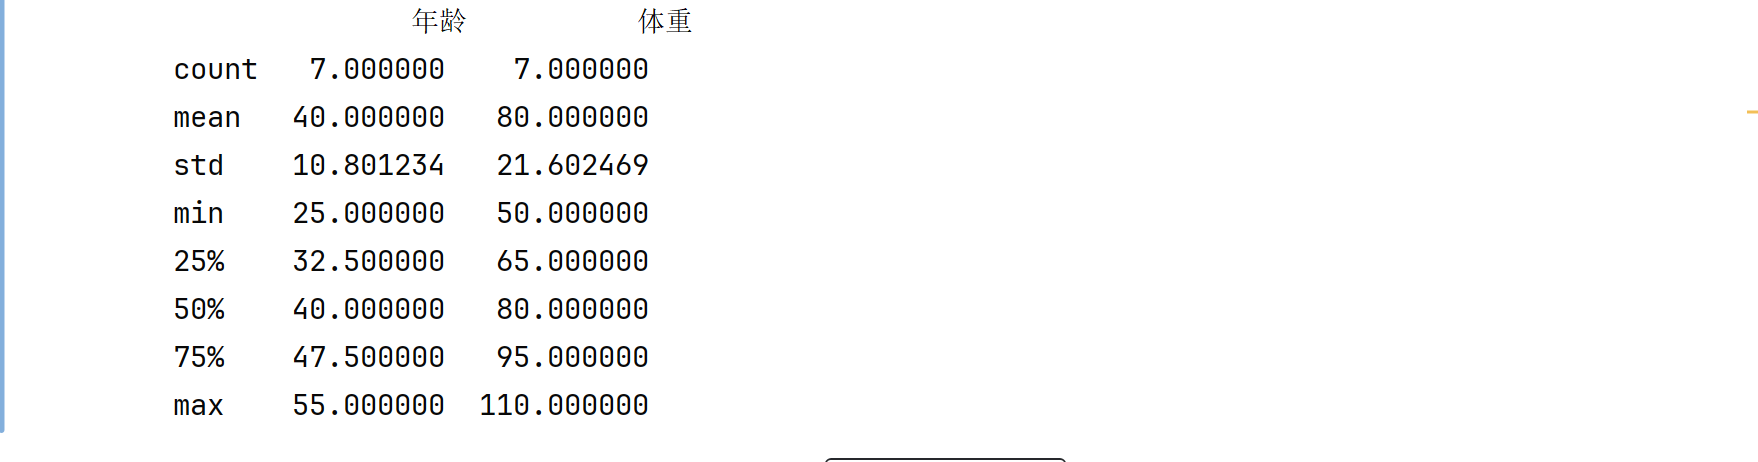
1.describe()
用于查看 Series / DataFrame 各列的描述性统计信息:count,mean,std,min,max 等
2.统计函数(聚合统计)
聚合统计的核心是沿指定轴将一组数据计算为单个汇总值,是最常用的统计形式
核心参数如下:
| 参数 | 默认值 | 说明 |
|---|---|---|
axis |
0 |
0= 按列聚合(每列输出一个结果);1= 按行聚合(每行输出一个结果) |
skipna |
True |
是否自动跳过缺失值 NaN;设为False时,只要有 NaN 结果就为 NaN |
numeric_only |
False |
是否仅对数值列计算,避免字符串列报错 |
常用聚合函数如下:
| 函数 | 含义 |
|---|---|
sum() |
求和 |
mean() |
平均值 |
median() |
中位数 |
mode() |
众数 |
max() |
最大值 |
min() |
最小值 |
std() |
标准差(样本标准差,分母 n-1) |
var() |
方差 |
count() |
非空值数量 |
| abs() | 绝对值 |
nunique() |
去重值数量 |
quantile(q) |
分位数,q 取 0-1 |
| idxmax() | 最大值的索引 |
| dixmin() | 最小值的索引 |
3.累计统计函数
| 函数 | 含义 |
|---|---|
cumsum() |
累计求和 |
cumprod() |
累计乘积 |
cummax() |
累计最大值 |
cummin() |
累计最小值 |
2.4.4 apply() 自定义运算
apply :是 Pandas 的自定义扩展接口
适用场景:当内置函数无法满足复杂逻辑时,可以通过 apply 将自定义函数应用到 DataFrame 的每一列、每一行,或分组后的每个子集
本质:是对轴方向的循环封装
核心语法与关键参数:
DataFrame对象名.apply(func, axis=0, args=(), result_type=None, **kwargs)| 参数 | 说明 |
|---|---|
func |
自定义函数,可以是 def 定义的函数,也可以是 lambda 匿名函数 |
axis |
核心参数 :0= 按列应用(默认);1= 按行应用 |
args |
给自定义函数传递的额外位置参数,必须是元组格式 |
result_type |
控制返回结果的格式,常用 expand 将多返回值展开为多列 |