✨作者主页 :IT毕设梦工厂✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、PHP、.NET、Node.js、GO、微信小程序、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
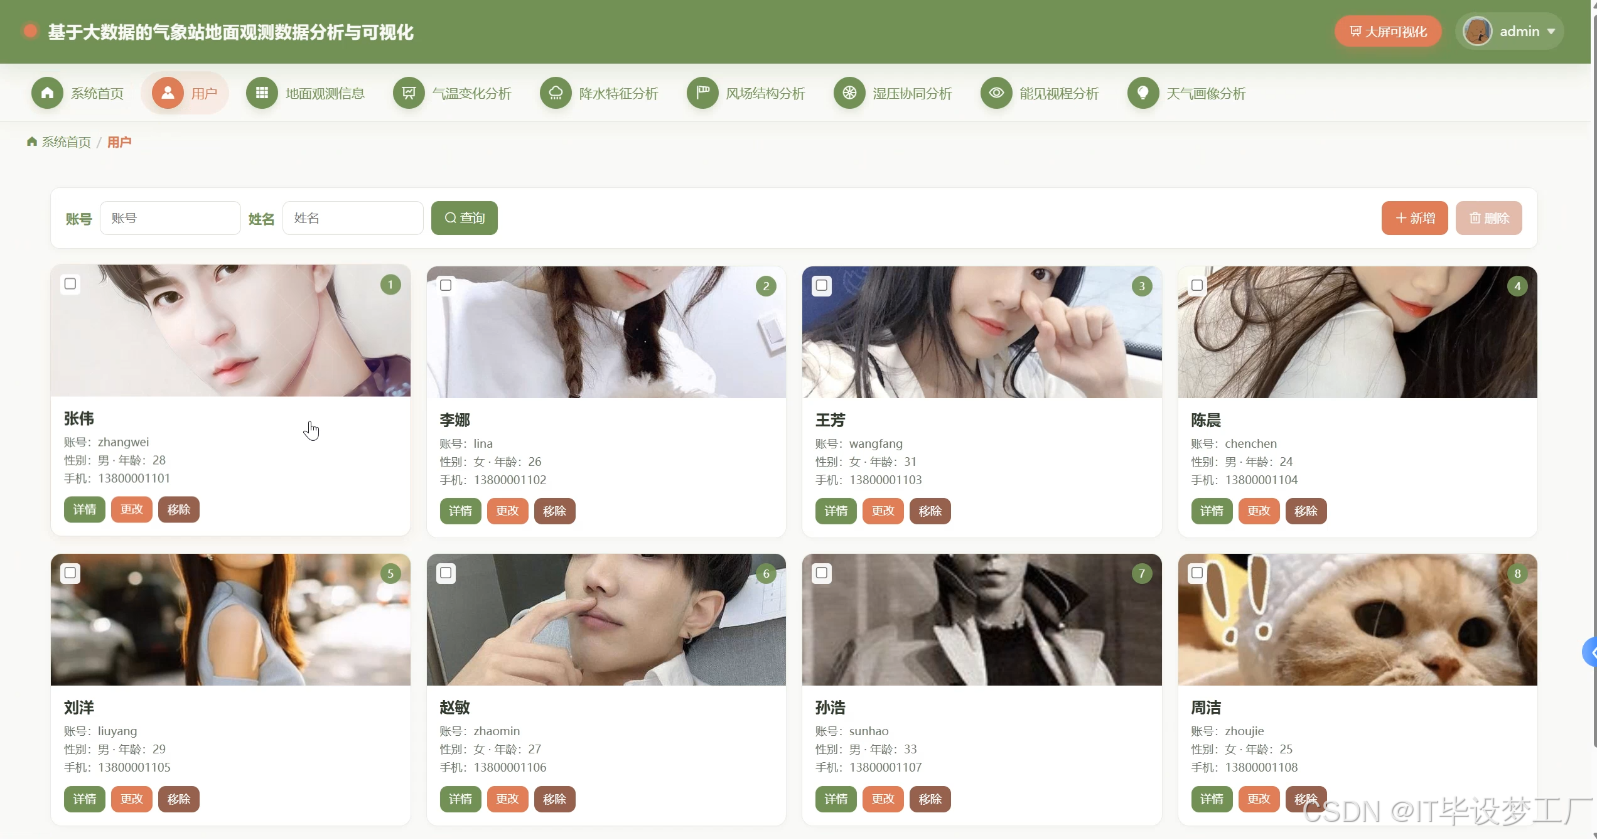
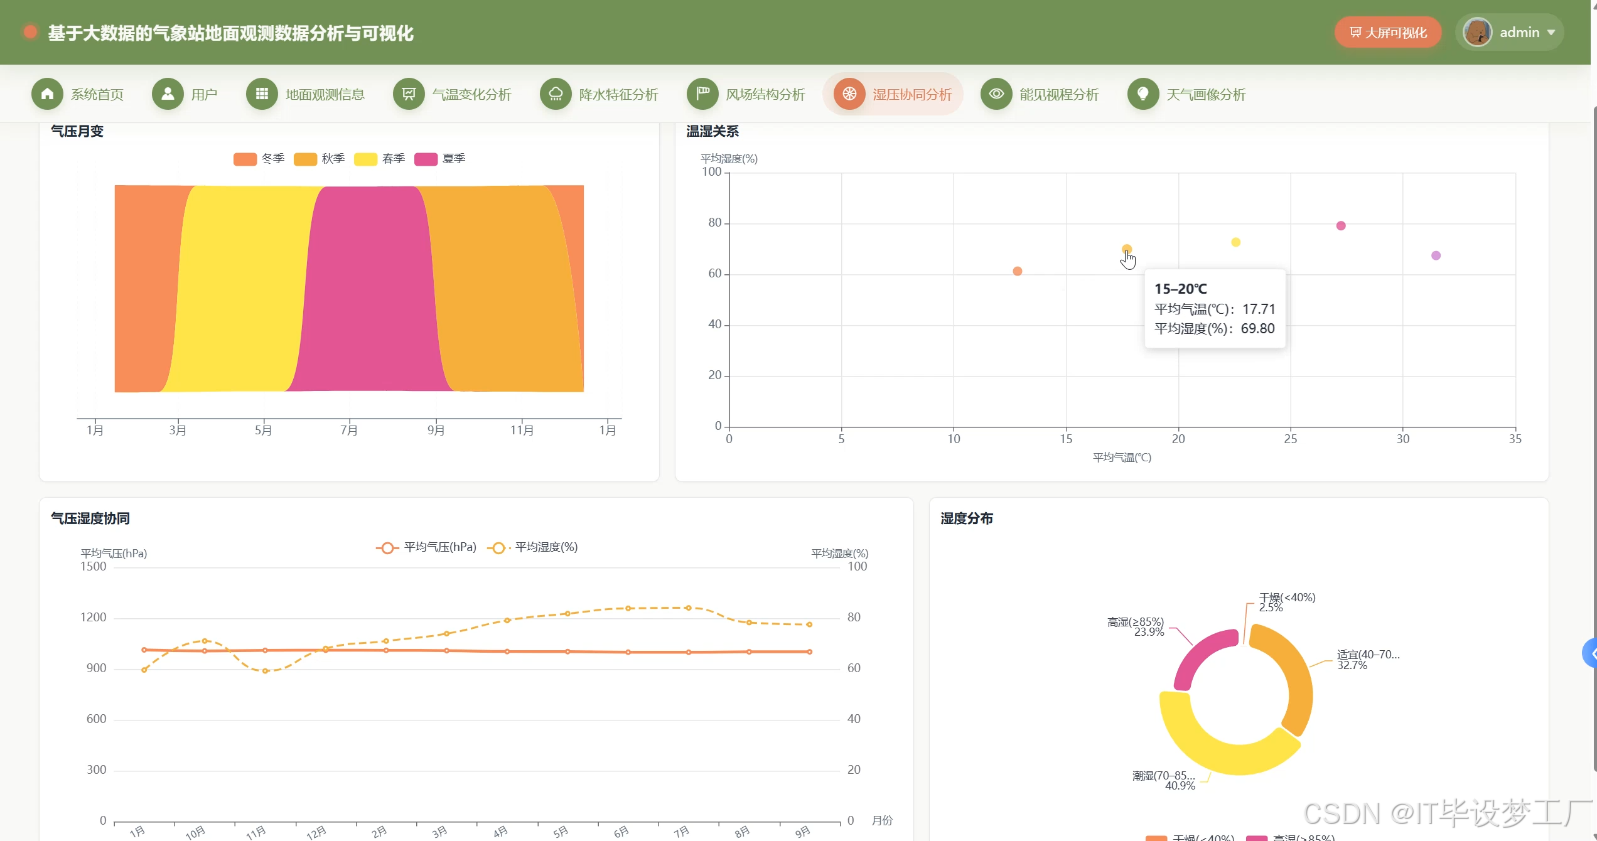
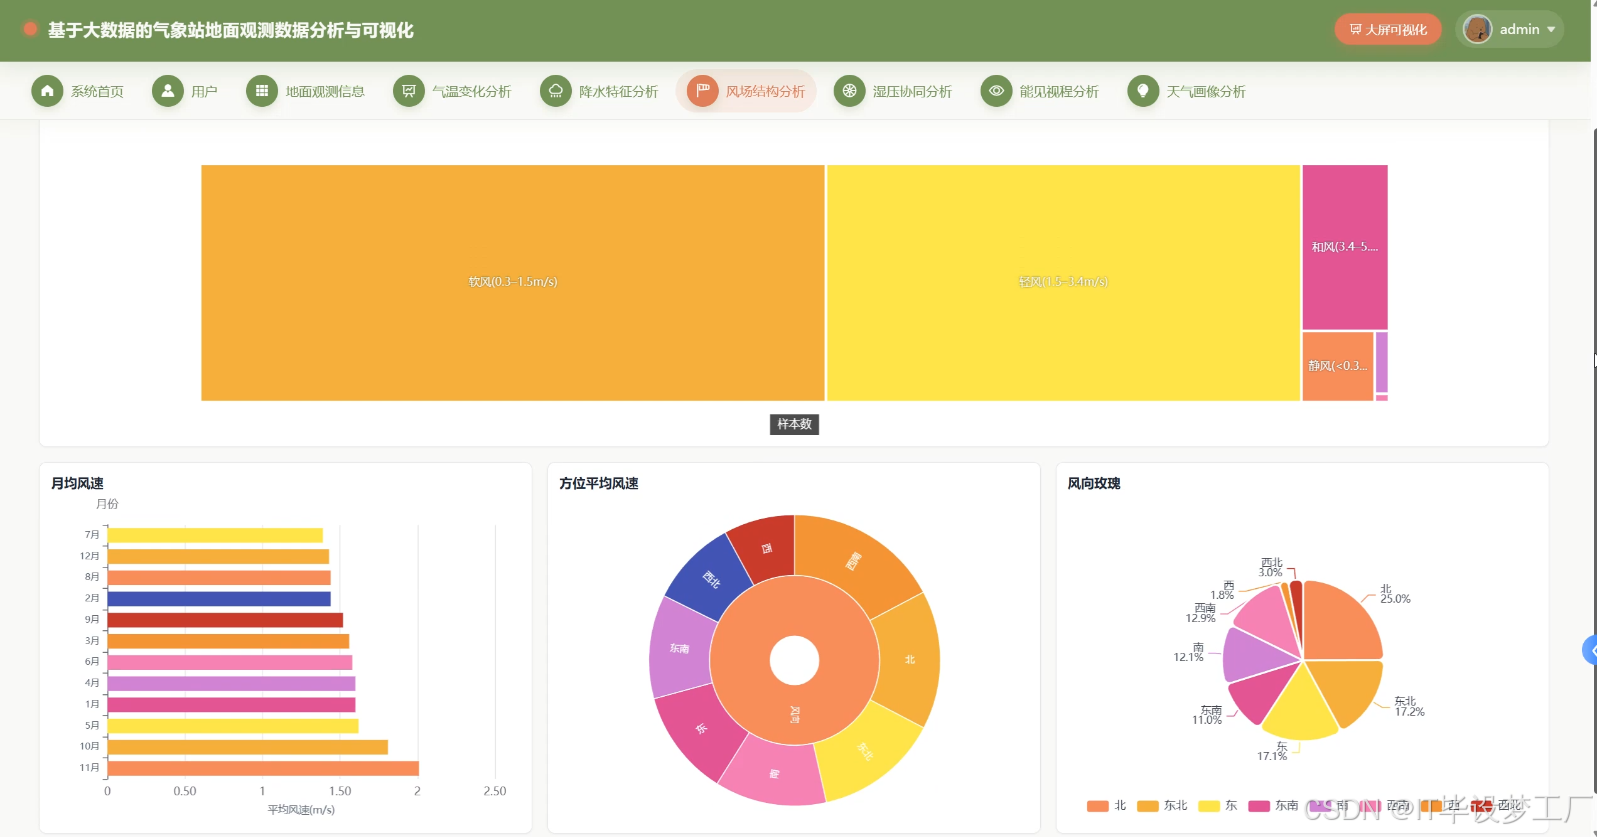
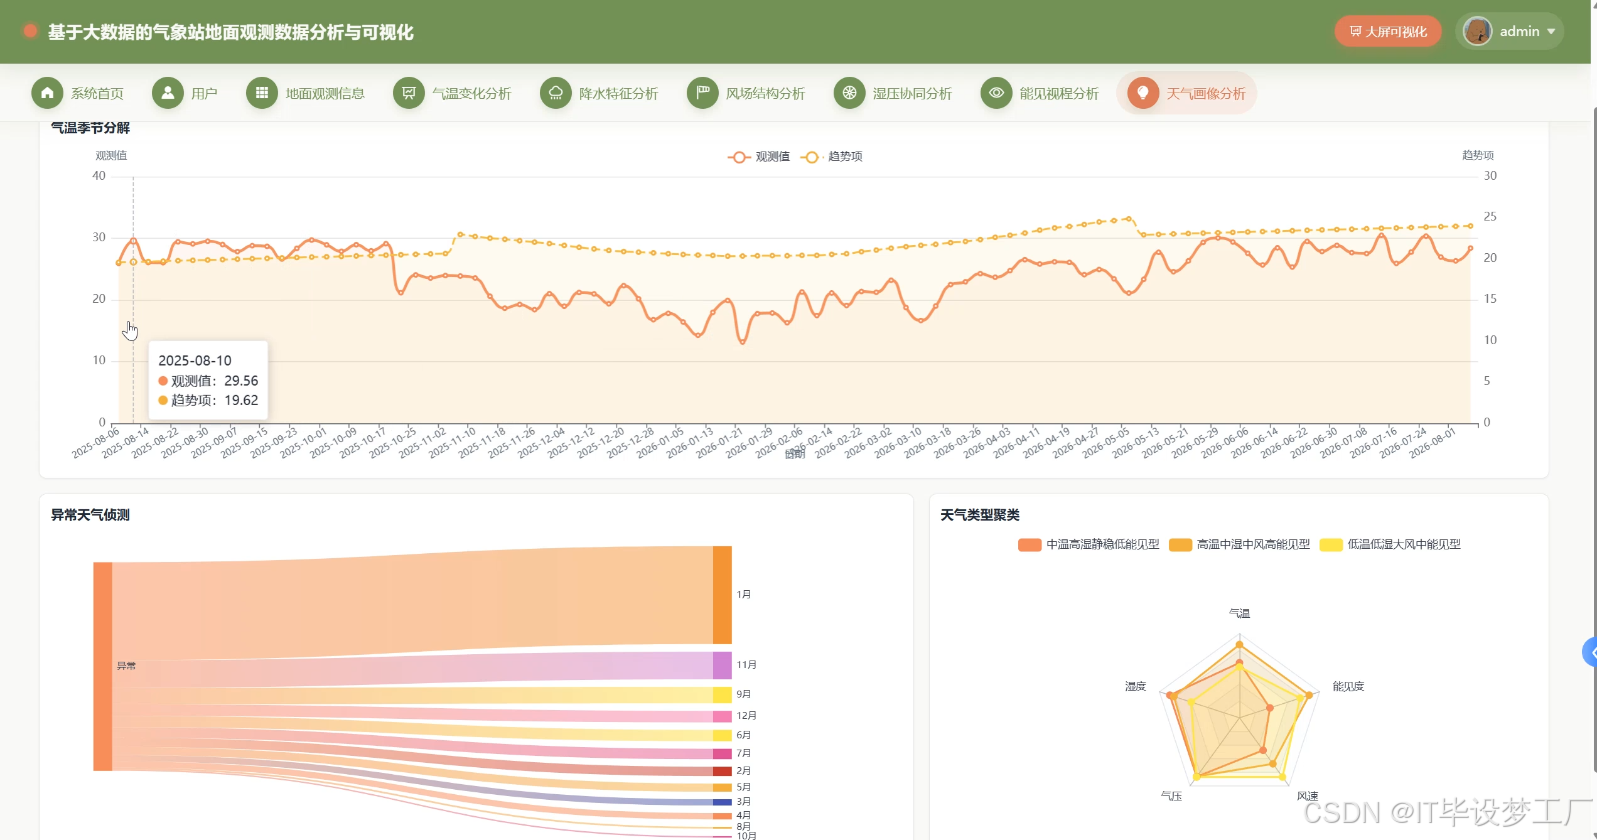
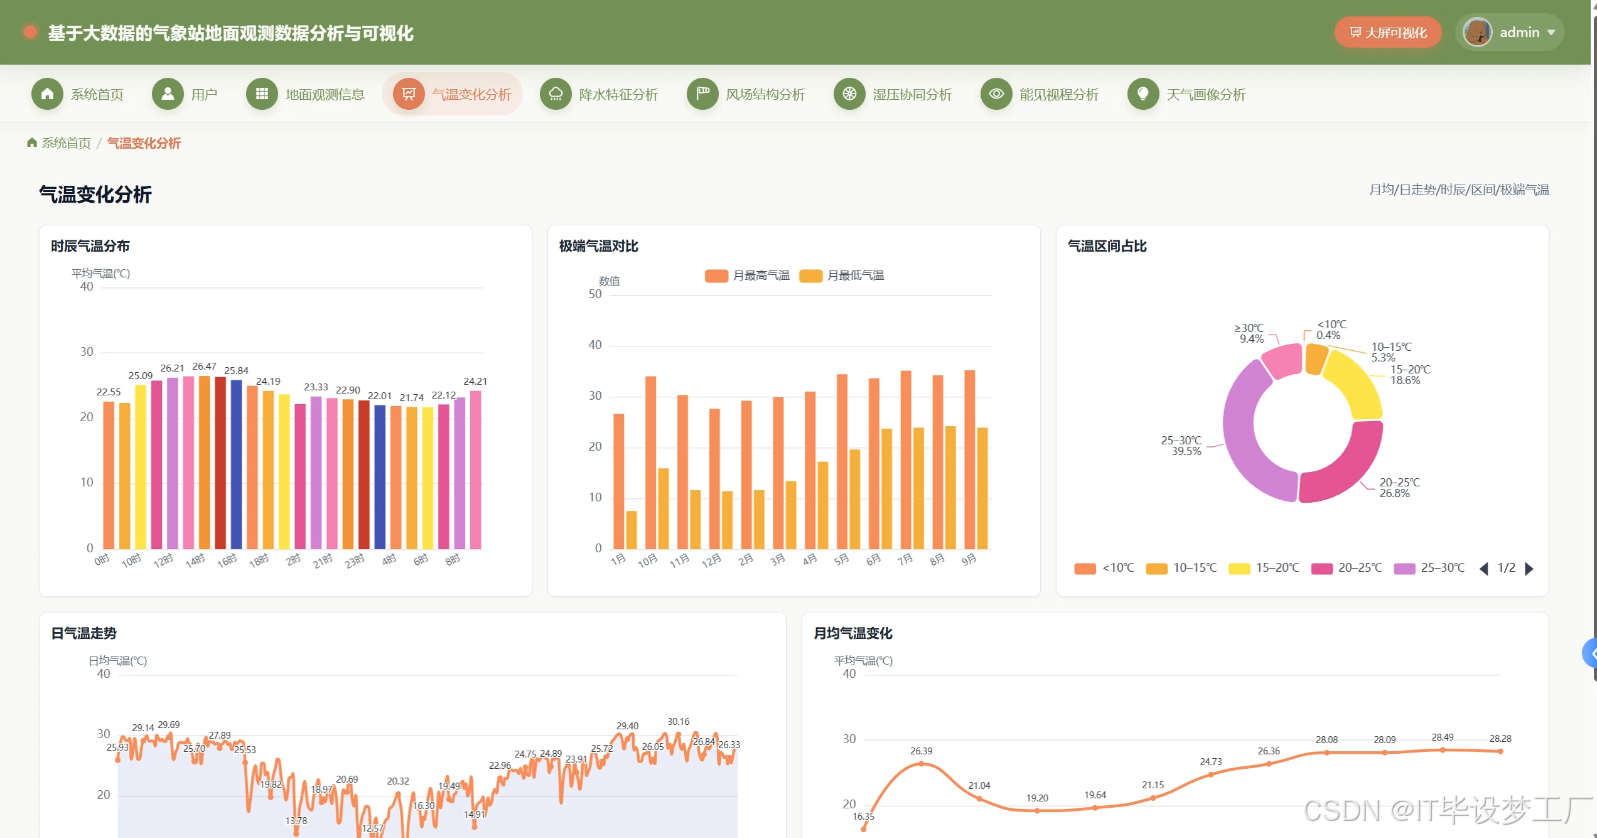
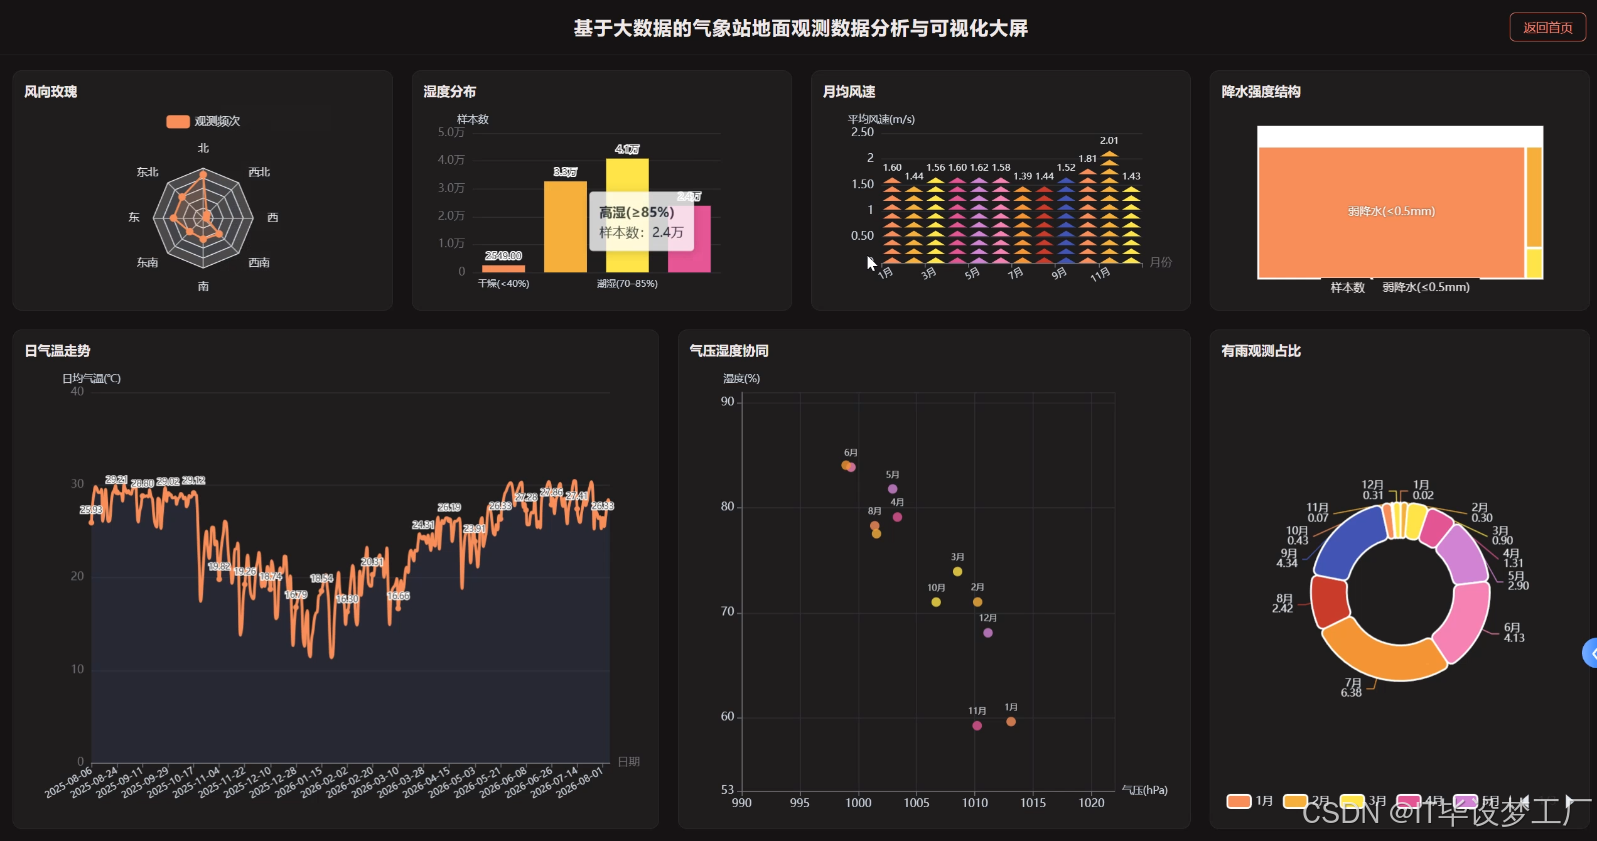
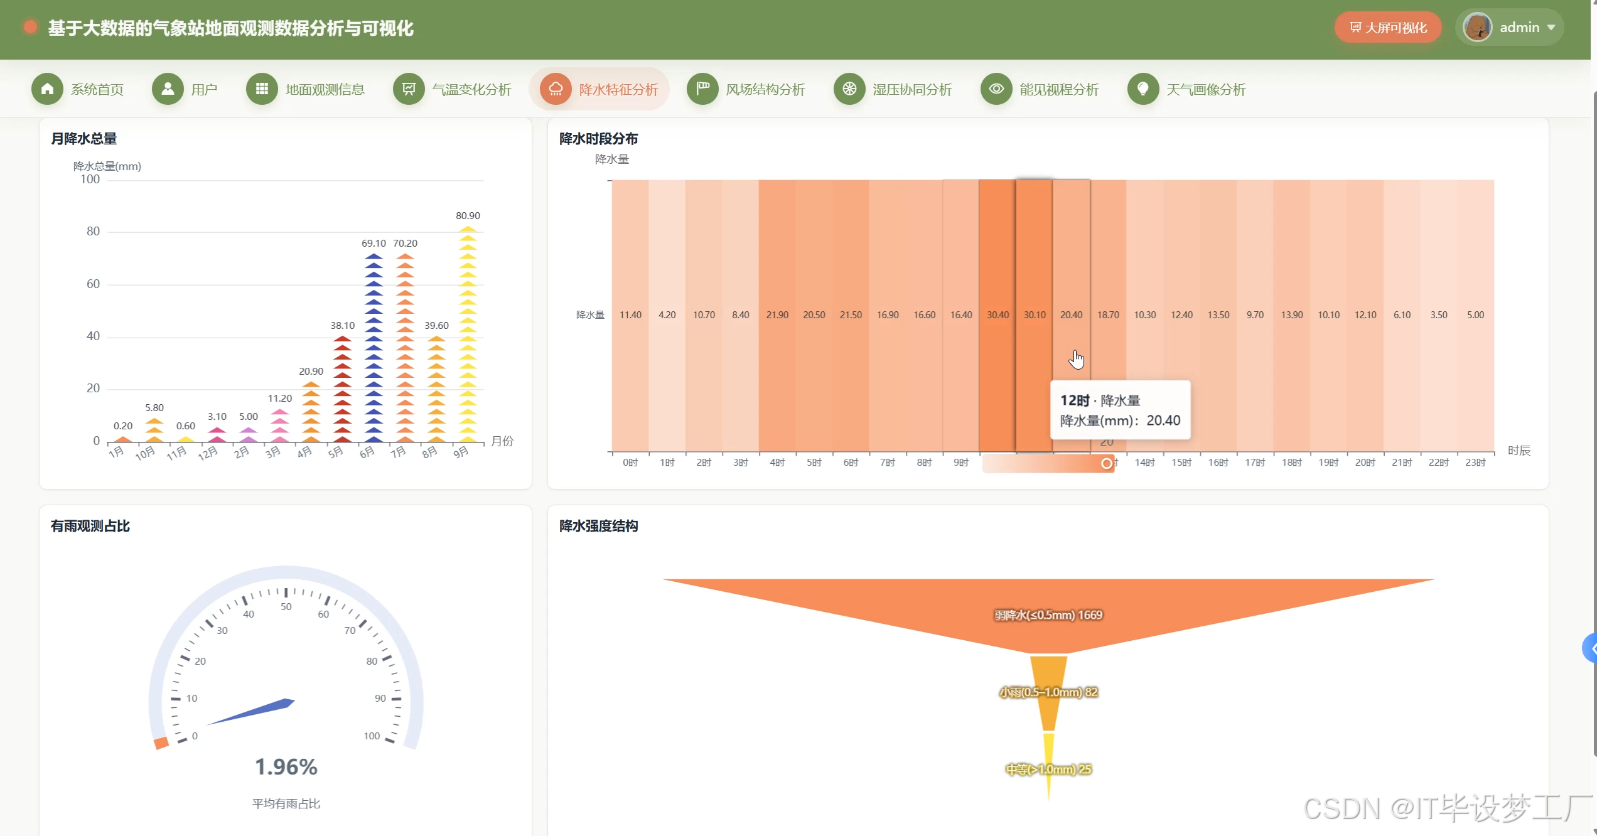
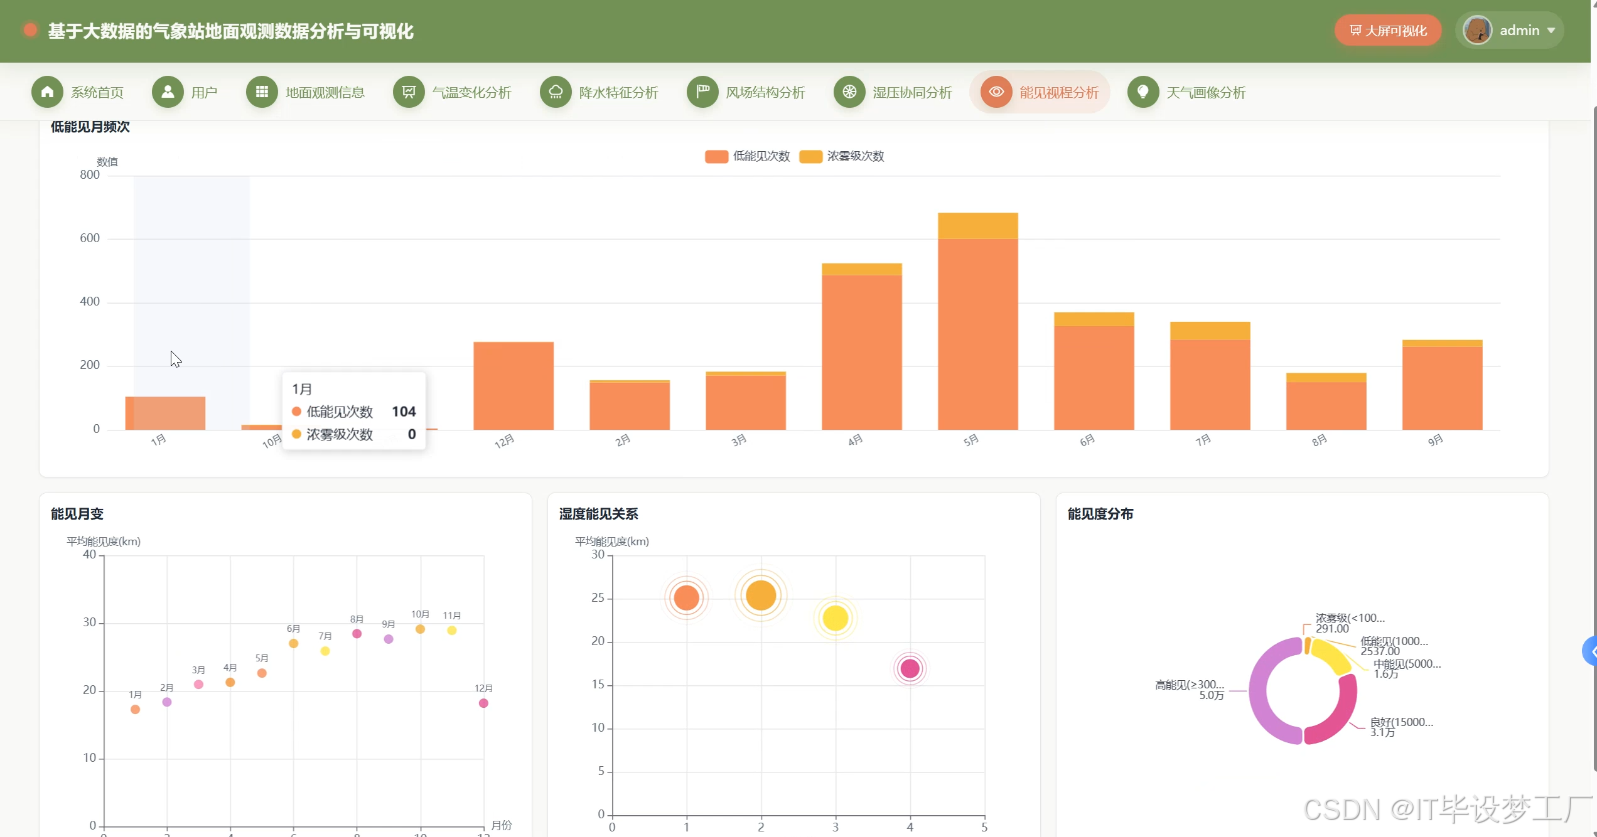
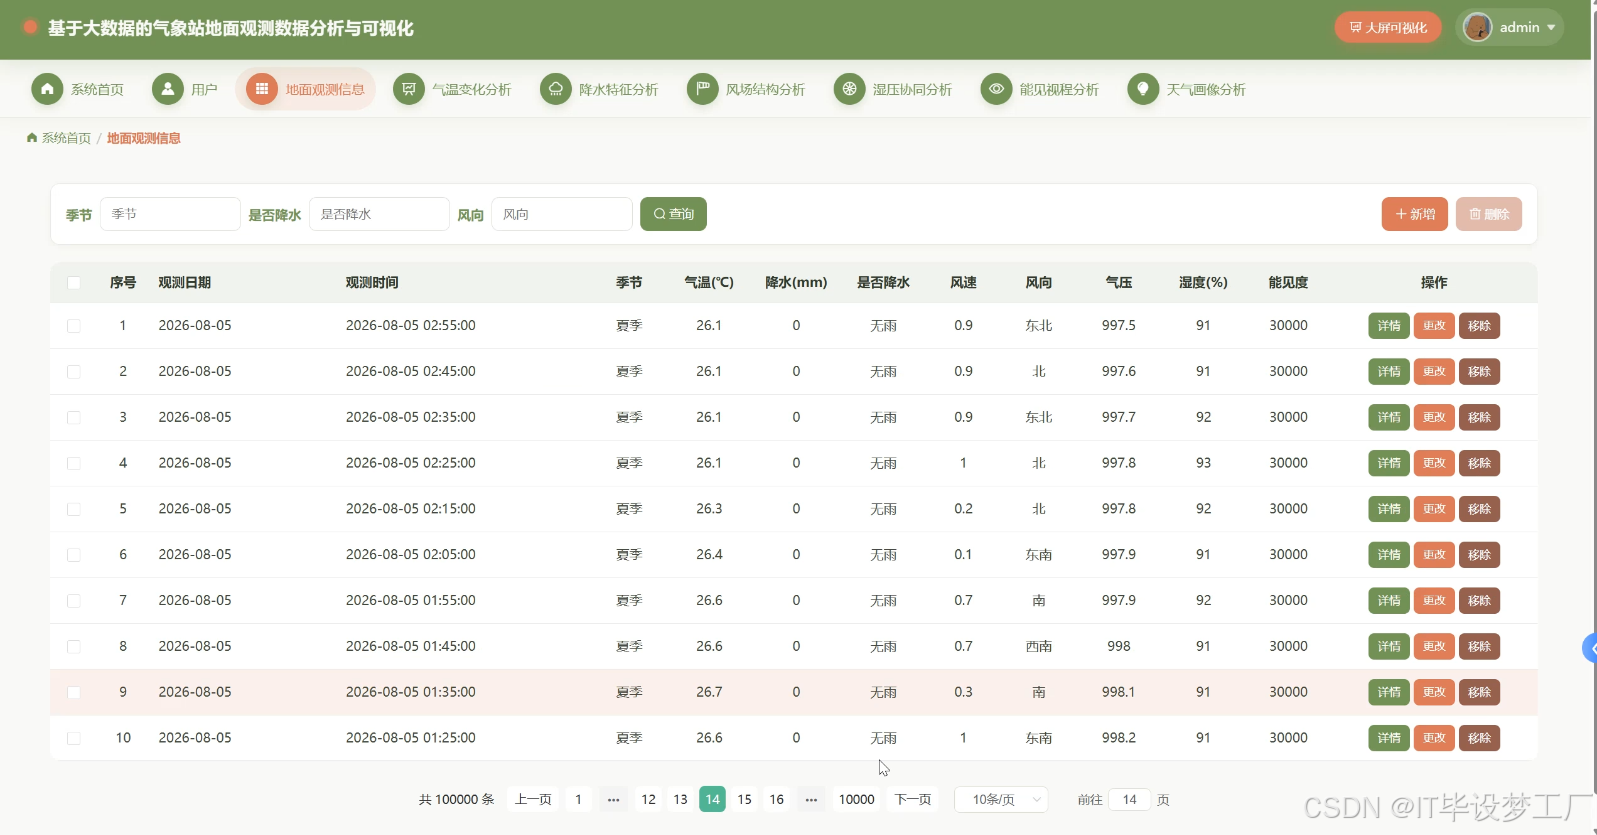
本系统《基于大数据的气象站地面观测数据分析与可视化》主要围绕气象站地面观测数据的存储、处理、分析和展示来展开,后端采用 Python 版本的 Django 或 Java 版本的 Spring Boot 实现,大数据处理部分使用 Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy,把气象站地面观测数据先放到 HDFS 中保存,再通过 Spark 做数据清洗、字段转换、聚合统计和指标计算,最后把结果交给前端使用 Vue、ElementUI、Echarts、HTML、CSS、JavaScript、jQuery 做页面展示,数据库使用 MySQL 保存用户信息和部分业务数据。系统功能包含系统首页、大屏可视化、用户、地面观测信息、温变化分析、降水特征分析、风场结构分析、湿压协同分析、能见视程分析、天气画像分析、个人信息和修改密码。用户登录后可以查看地面观测记录,按站点、时间等条件筛选数据,也能在大屏上观察温度、降水、风速风向、湿度气压和能见度等指标的变化情况。温变化分析主要统计平均温度、最高最低温和月度趋势,降水特征分析关注降水量、降水天数和强降水分布,风场结构分析展示风速、风向频率和强风情况,湿压协同分析、能见视程分析和天气画像分析则把多个气象要素放在一起做组合展示,形成更直观的图表和画像结果。整个系统把 Hadoop 与 Spark 的大数据处理能力、Django 或 Spring Boot 的后端接口能力以及 Echarts 可视化能力结合起来,让气象站地面观测数据不再只是静态表格,而是能通过图表和大屏被快速理解。
二、开发环境
大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
开发语言:Python+Java(两个版本都支持)
后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
数据库:MySQL
三、系统界面展示
- 基于大数据的气象站地面观测数据分析与可视化系统界面展示:
四、部分代码设计
- 项目实战-代码参考:
python
spark = SparkSession.builder.appName("WeatherGroundObservationAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
def temperature_analysis(request):
    path = "hdfs:///weather/ground_observation/*.csv"
    df = spark.read.option("header", True).option("inferSchema", True).csv(path)
    df.createOrReplaceTempView("ground_observation")
    temp_df = spark.sql("""
        select station_id, year(obs_time) as year, month(obs_time) as month,
               avg(temperature) as avg_temp, max(temperature) as max_temp,
               min(temperature) as min_temp, count(1) as sample_count
        from ground_observation
        where temperature is not null
        group by station_id, year(obs_time), month(obs_time)
        order by year, month
    """)
    temp_pd = temp_df.toPandas()
    temp_pd["avg_temp"] = temp_pd["avg_temp"].round(2)
    temp_pd["max_temp"] = temp_pd["max_temp"].round(2)
    temp_pd["min_temp"] = temp_pd["min_temp"].round(2)
    trend_data = temp_pd.to_dict(orient="records")
    month_labels = temp_pd["month"].astype(str).tolist()
    avg_values = temp_pd["avg_temp"].tolist()
    max_values = temp_pd["max_temp"].tolist()
    min_values = temp_pd["min_temp"].tolist()
    result = {"labels": month_labels, "avg": avg_values, "max": max_values, "min": min_values, "rows": trend_data}
    return JsonResponse(result, json_dumps_params={"ensure_ascii": False})
def precipitation_analysis(request):
    path = "hdfs:///weather/ground_observation/*.csv"
    df = spark.read.option("header", True).option("inferSchema", True).csv(path)
    df.createOrReplaceTempView("ground_observation")
    rain_df = spark.sql("""
        select station_id, year(obs_time) as year, month(obs_time) as month,
               sum(precipitation) as total_rain, avg(precipitation) as avg_rain,
               count(case when precipitation > 0 then 1 end) as rain_days,
               max(precipitation) as max_rain
        from ground_observation
        where precipitation is not null
        group by station_id, year(obs_time), month(obs_time)
        order by year, month
    """)
    rain_pd = rain_df.toPandas()
    rain_pd["total_rain"] = rain_pd["total_rain"].round(2)
    rain_pd["avg_rain"] = rain_pd["avg_rain"].round(2)
    rain_pd["rain_days"] = rain_pd["rain_days"].fillna(0).astype(int)
    rain_pd["max_rain"] = rain_pd["max_rain"].round(2)
    month_labels = rain_pd["month"].astype(str).tolist()
    total_values = rain_pd["total_rain"].tolist()
    day_values = rain_pd["rain_days"].tolist()
    max_values = rain_pd["max_rain"].tolist()
    result = {"labels": month_labels, "total": total_values, "days": day_values, "max": max_values, "rows": rain_pd.to_dict(orient="records")}
    return JsonResponse(result, json_dumps_params={"ensure_ascii": False})
def wind_field_analysis(request):
    path = "hdfs:///weather/ground_observation/*.csv"
    df = spark.read.option("header", True).option("inferSchema", True).csv(path)
    df.createOrReplaceTempView("ground_observation")
    wind_df = spark.sql("""
        select station_id, year(obs_time) as year, month(obs_time) as month,
               avg(wind_speed) as avg_speed, max(wind_speed) as max_speed,
               count(case when wind_speed >= 10 then 1 end) as strong_wind_count,
               wind_direction
        from ground_observation
        where wind_speed is not null and wind_direction is not null
        group by station_id, year(obs_time), month(obs_time), wind_direction
        order by year, month, wind_direction
    """)
    wind_pd = wind_df.toPandas()
    wind_pd["avg_speed"] = wind_pd["avg_speed"].round(2)
    wind_pd["max_speed"] = wind_pd["max_speed"].round(2)
    direction_group = wind_pd.groupby("wind_direction")["strong_wind_count"].sum().reset_index()
    direction_labels = direction_group["wind_direction"].tolist()
    direction_values = direction_group["strong_wind_count"].tolist()
    month_group = wind_pd.groupby("month")["avg_speed"].mean().reset_index()
    month_labels = month_group["month"].astype(str).tolist()
    speed_values = month_group["avg_speed"].round(2).tolist()
    result = {"direction_labels": direction_labels, "direction_values": direction_values, "month_labels": month_labels, "speed_values": speed_values, "rows": wind_pd.to_dict(orient="records")}
    return JsonResponse(result, json_dumps_params={"ensure_ascii": False})
五、论文参考
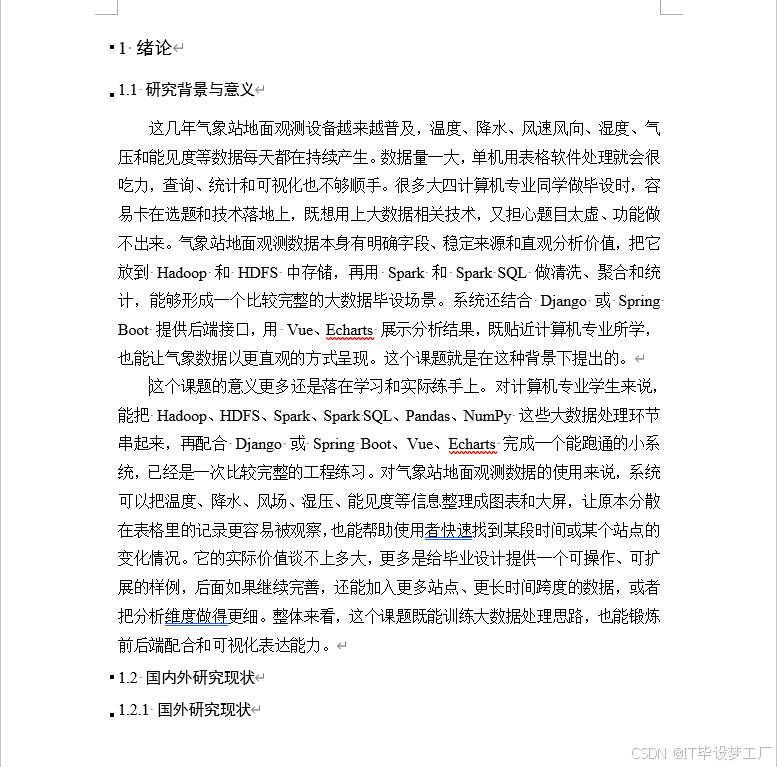
- 计算机毕业设计选题推荐-基于大数据的气象站地面观测数据分析与可视化系统-论文参考:
六、系统视频
- 基于大数据的气象站地面观测数据分析与可视化系统-项目视频:
项目演示视频
结语
计算机毕业设计选题推荐:基于大数据的气象站地面观测数据分析与可视化|毕业设计选题|计算机毕设|选题推荐|毕设指导|项目定制|源码|高质量项目
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇