一、神经网络基本结构
1. 卷积层的基本使用
1)卷积层类型
主要类型:
nn.Conv1d: 一维卷积
nn.Conv2d: 二维卷积(图像处理最常用)
nn.Conv3d: 三维卷积
使用场景:
图像处理主要使用二维卷积
1D和3D在图像处理中应用较少
2)torch.nn.Conv2d核心参数
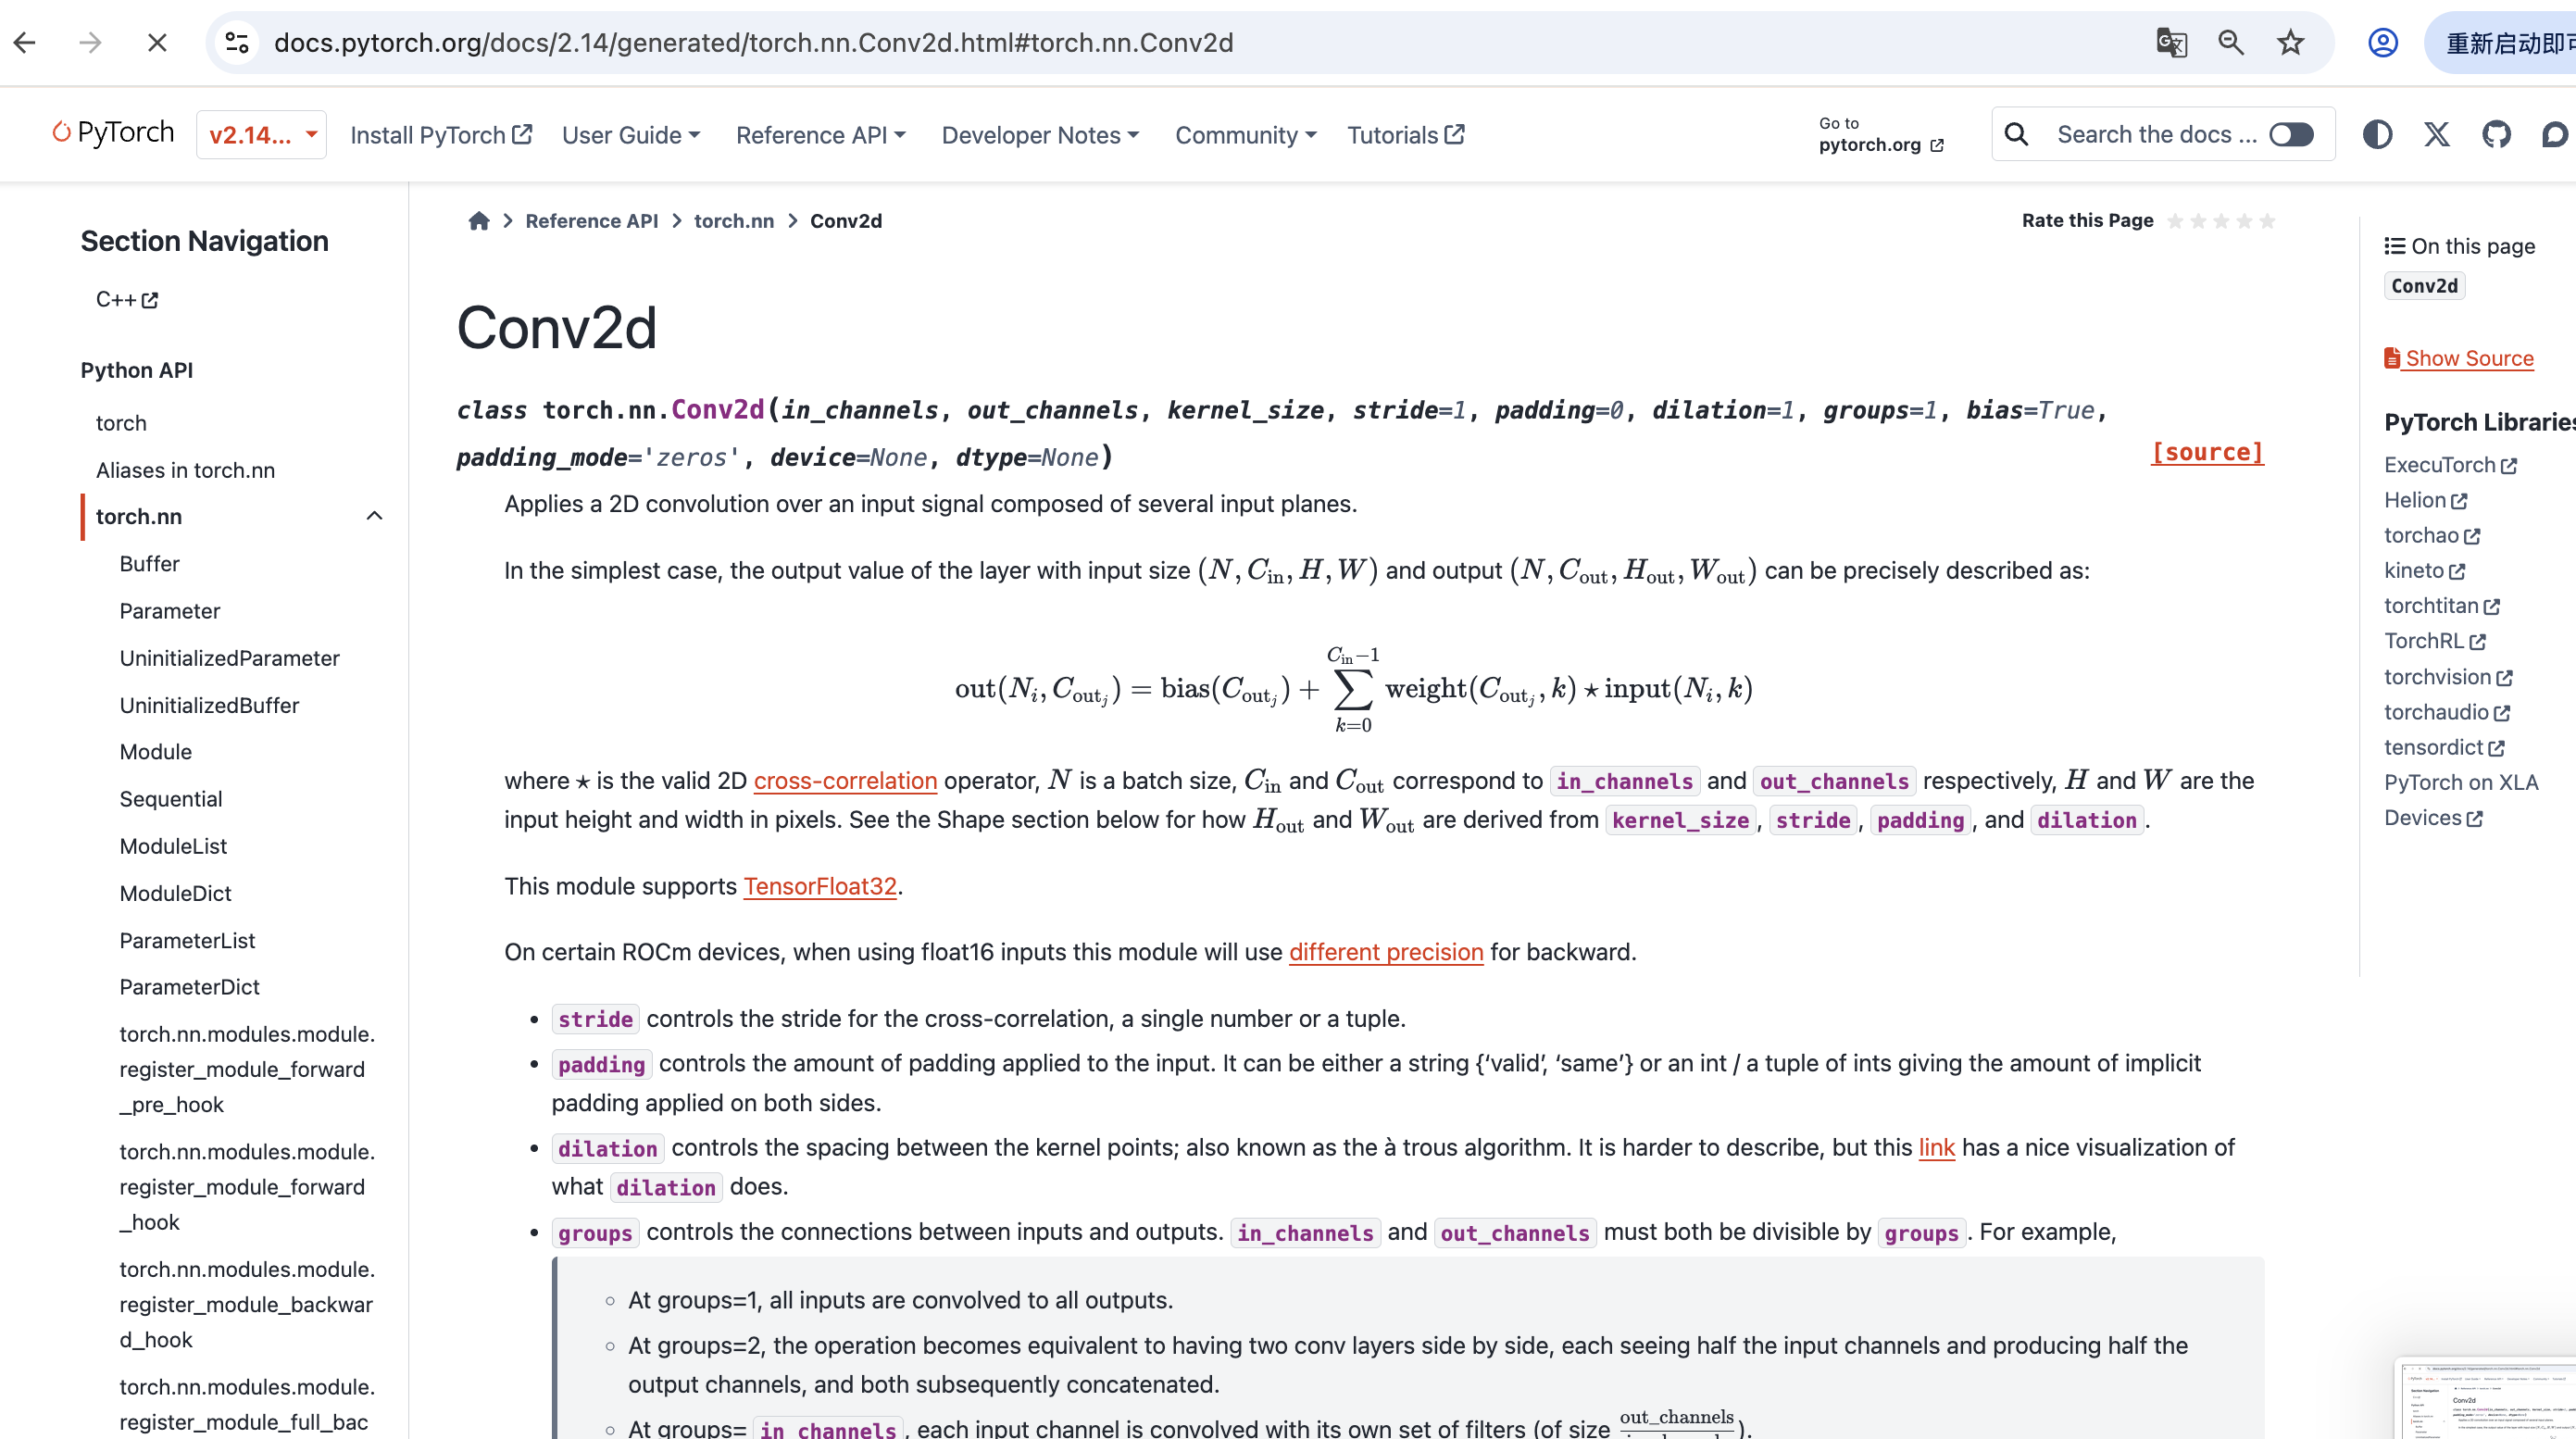
必设参数:
in_channels: 输入图像的通道数,如彩色图像一般为3个通道
out_channels: 卷积后输出的通道数,决定卷积核的数量
kernel_size: 卷积核尺寸,可以是整数(如3表示3×3)或元组(如(1,2)表示1×2)
常用参数:
stride: 卷积步长,控制卷积核移动的步幅,默认为1
padding: 填充方式,边缘填充像素数,默认为0不填充
默认参数:
dilation: 卷积核元素间距(默认为1),空洞卷积参数,控制卷积核元素间距,几乎不常用
groups: 分组卷积数(通常设为1),输入输出通道连接方式
bias: 是否添加偏置(通常设为True)
padding_mode: 填充模式,默认为'zeros'零填充
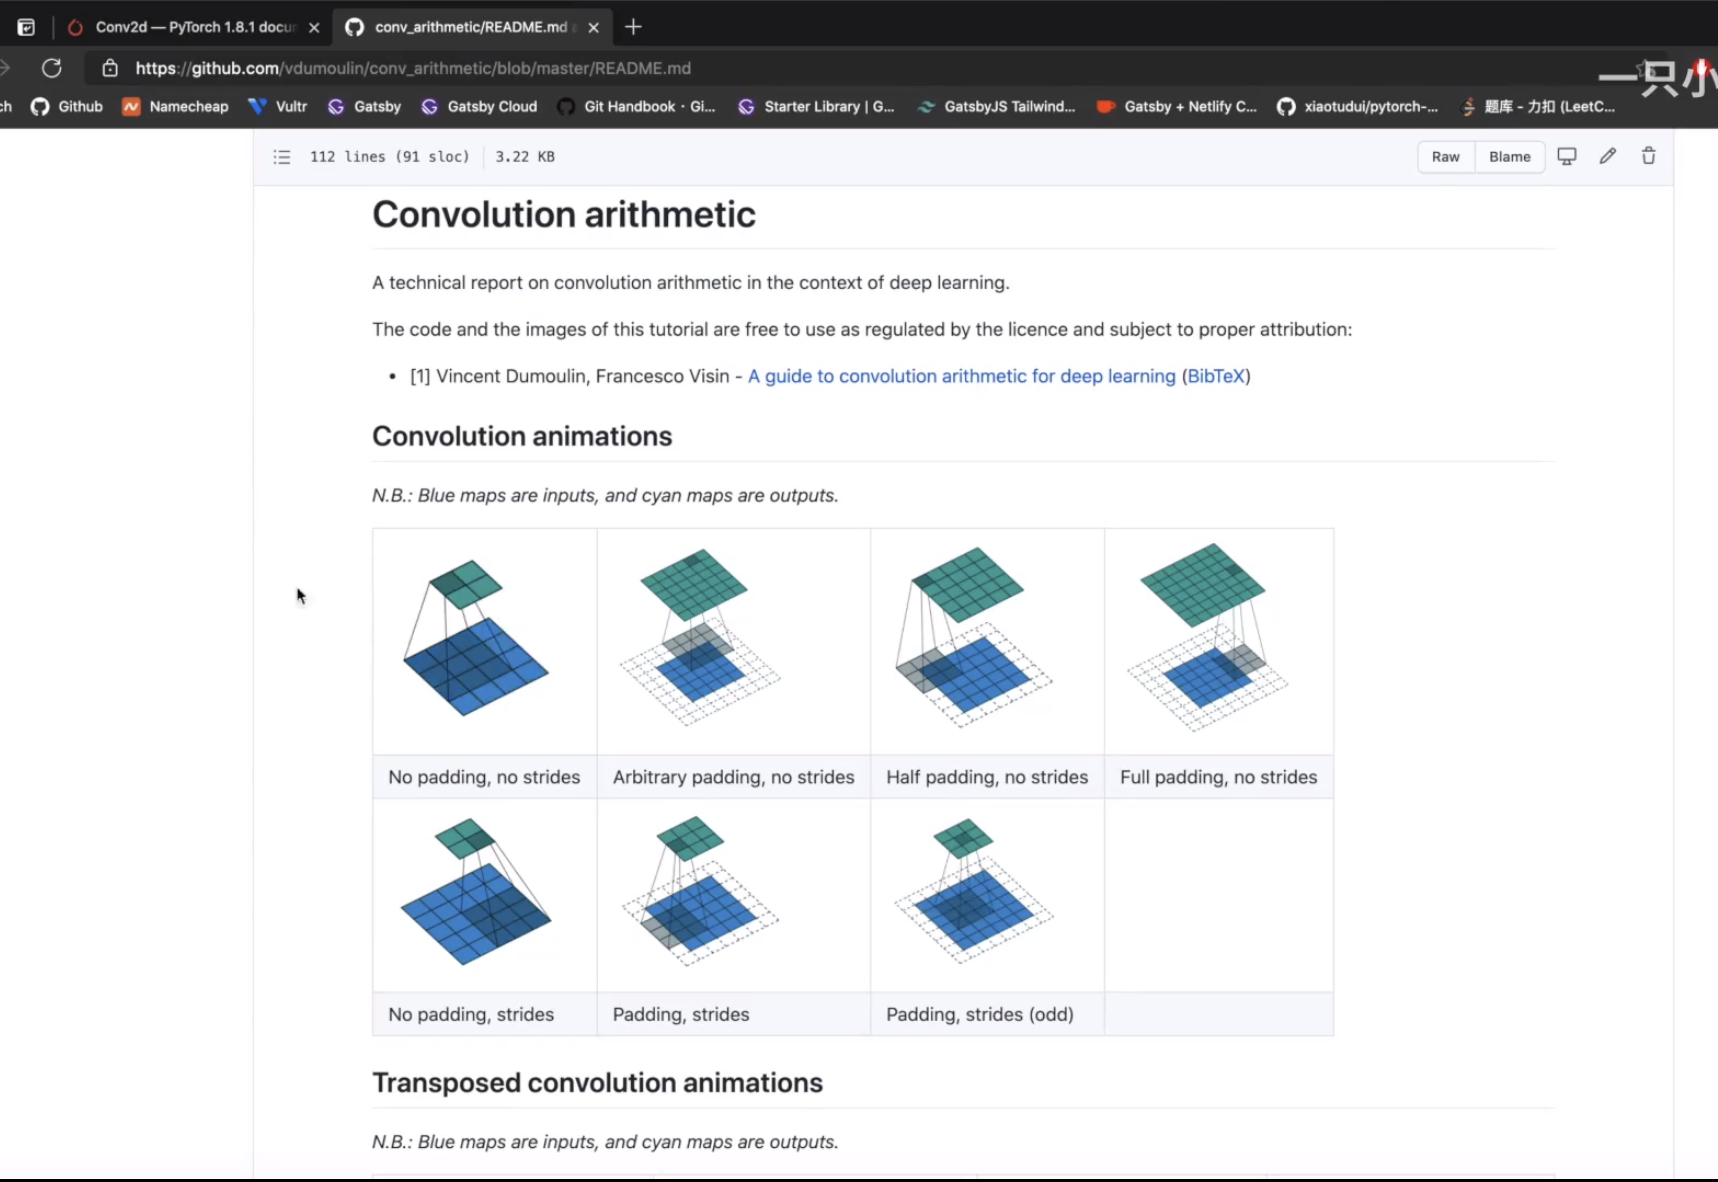
卷积动画示例
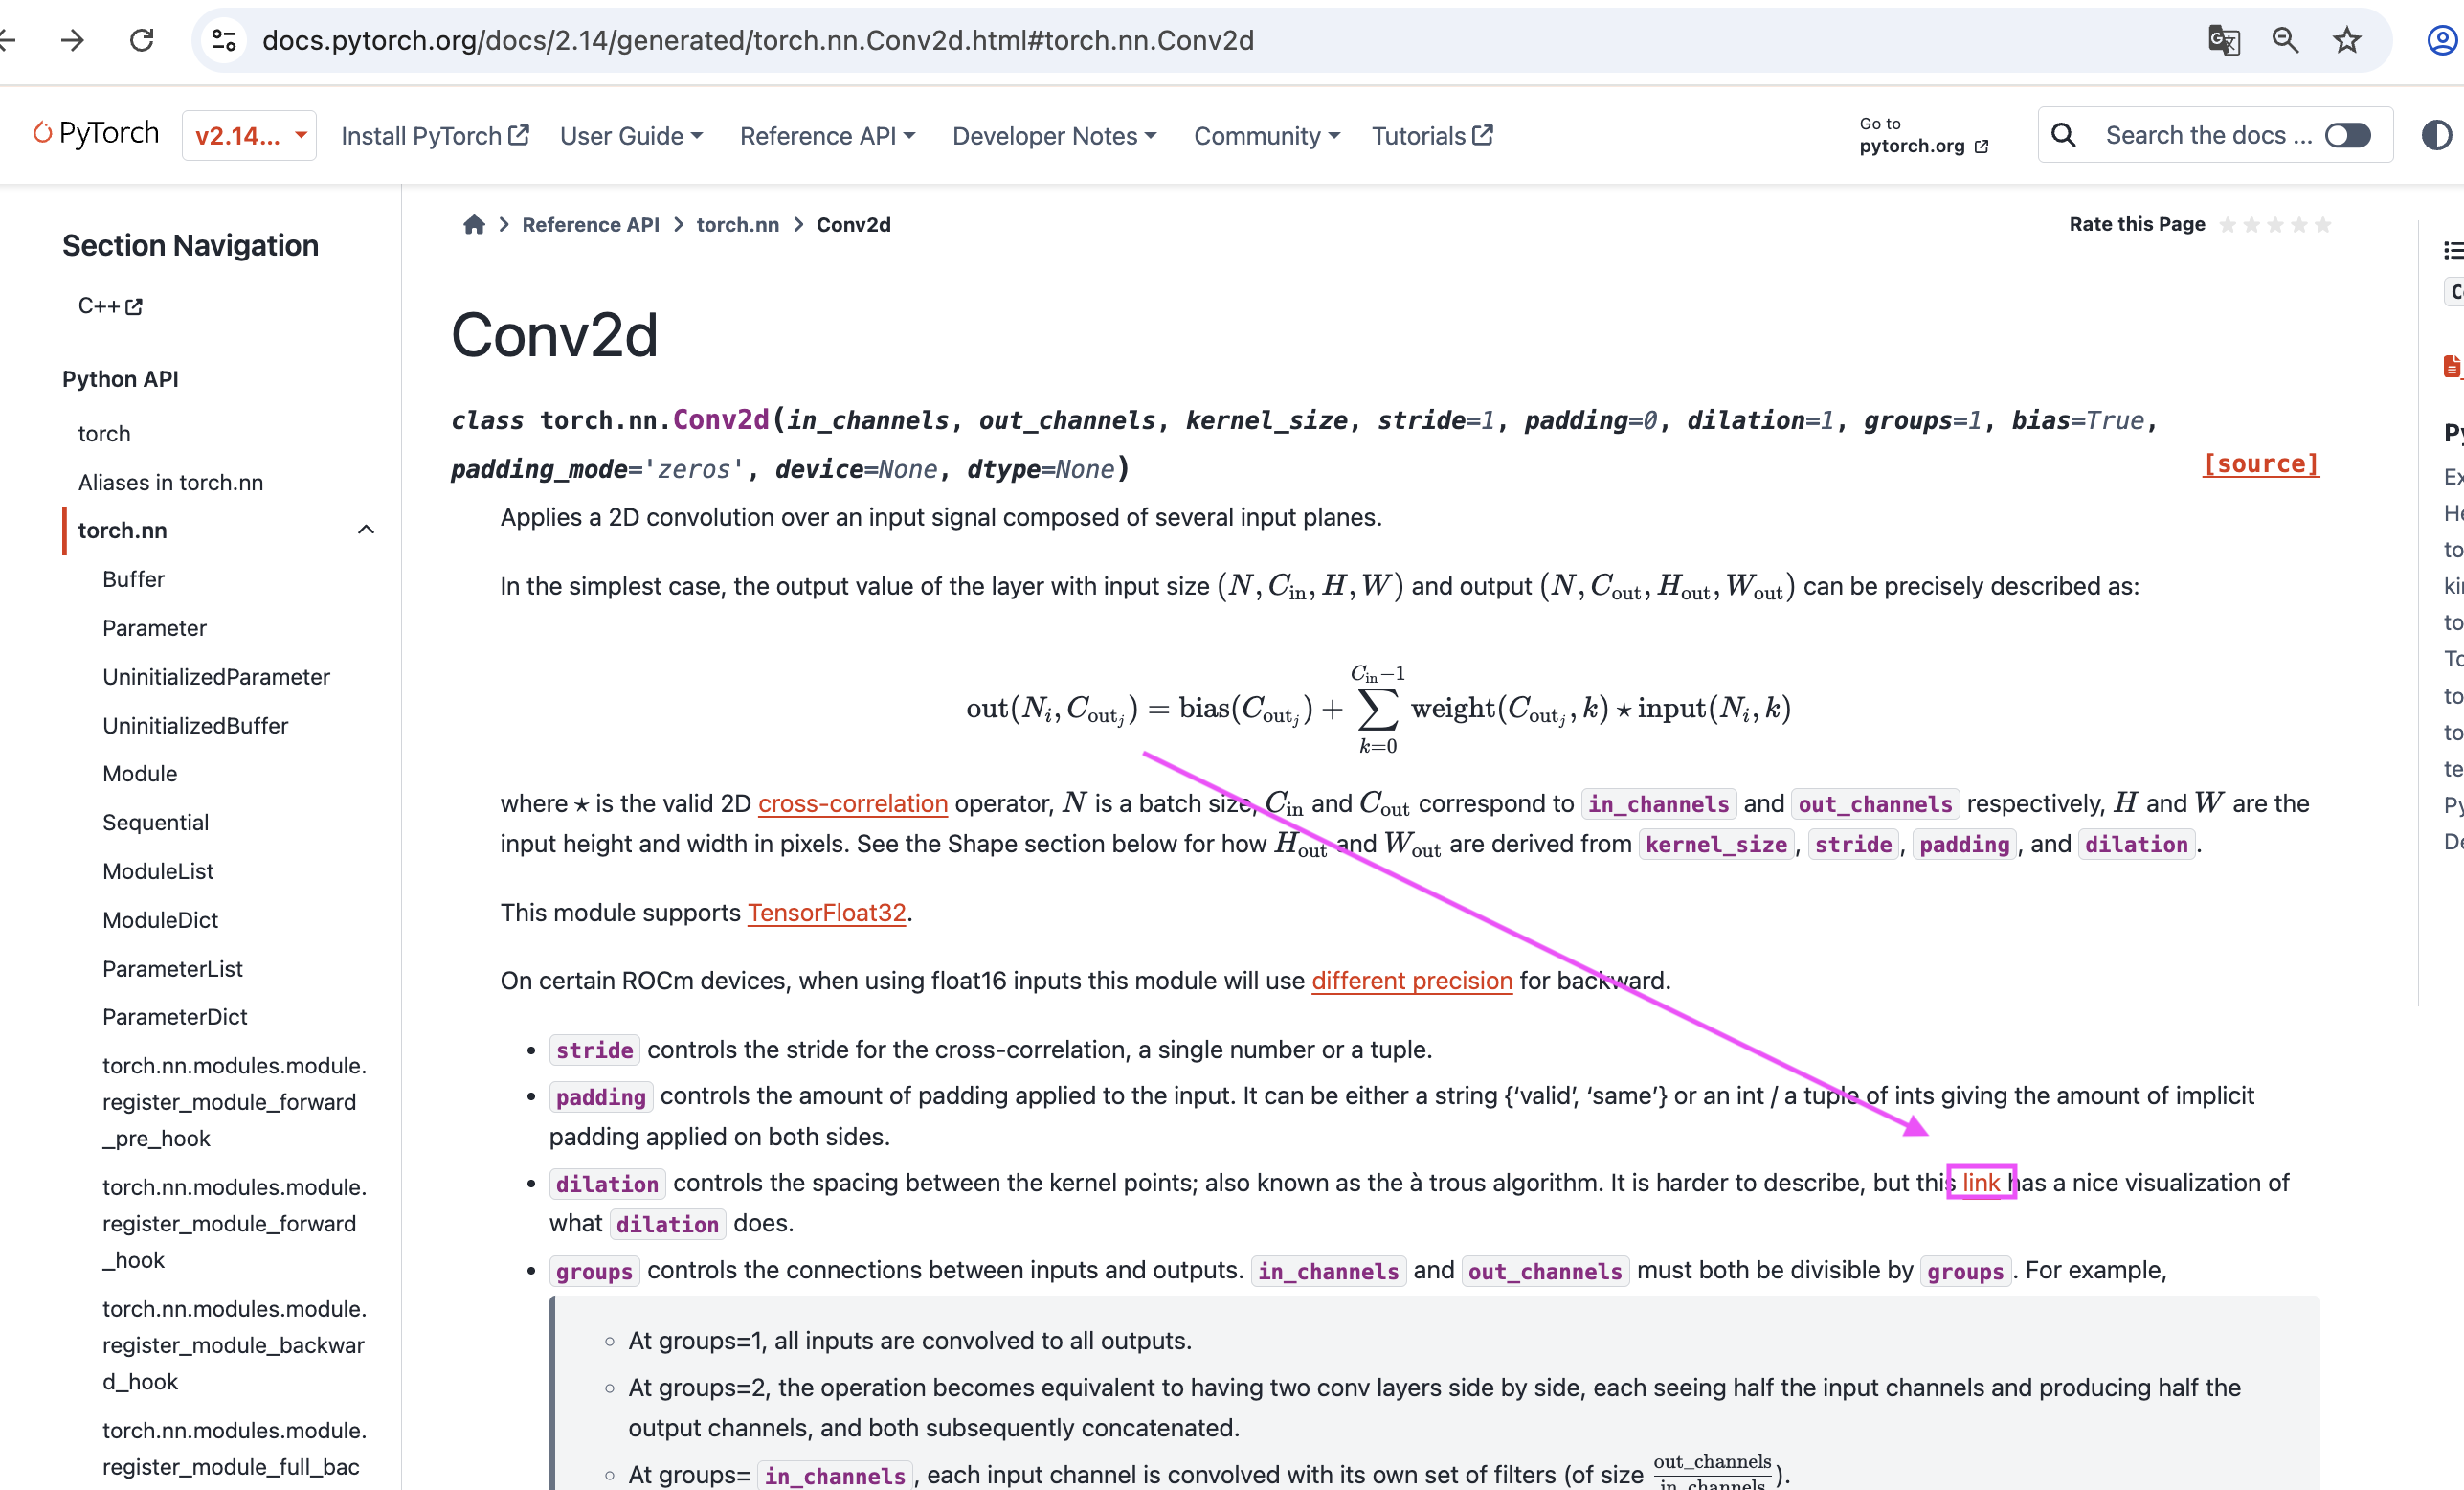
点击上图中的link 可以看到各种参数设置的动画演示。
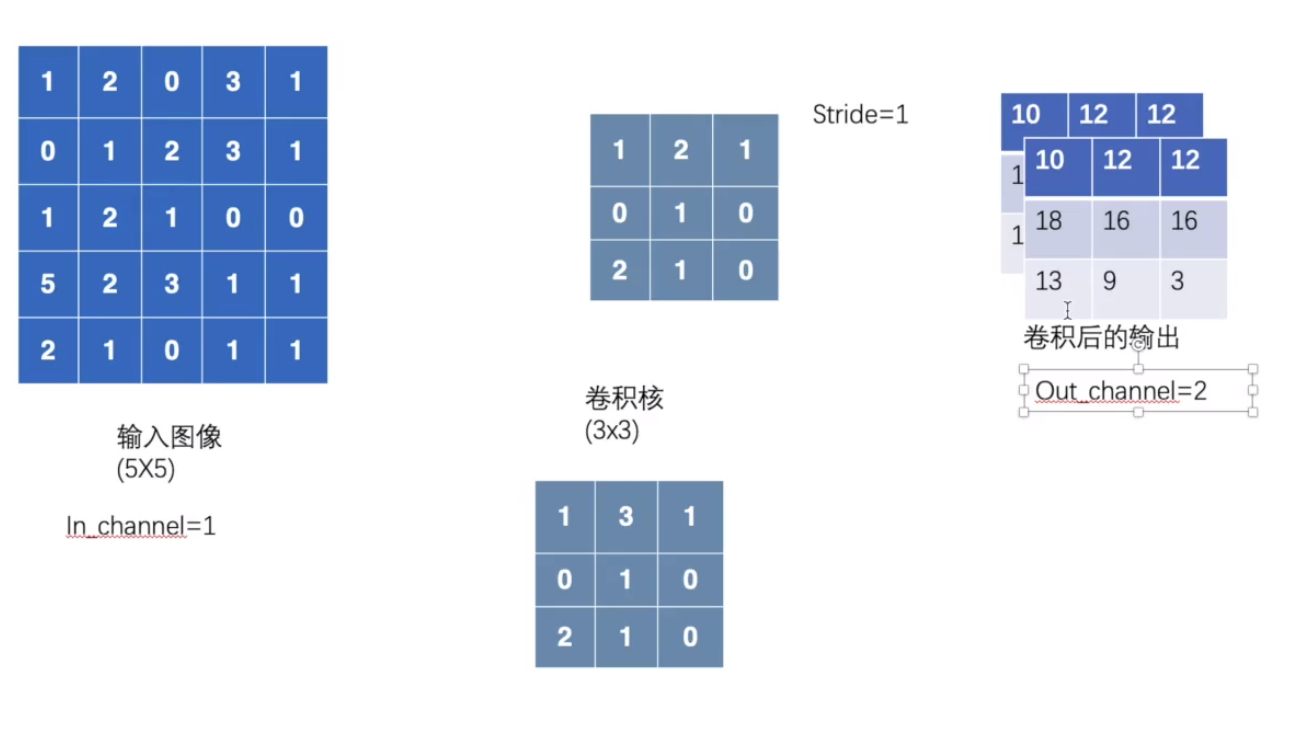
out_channel的含义
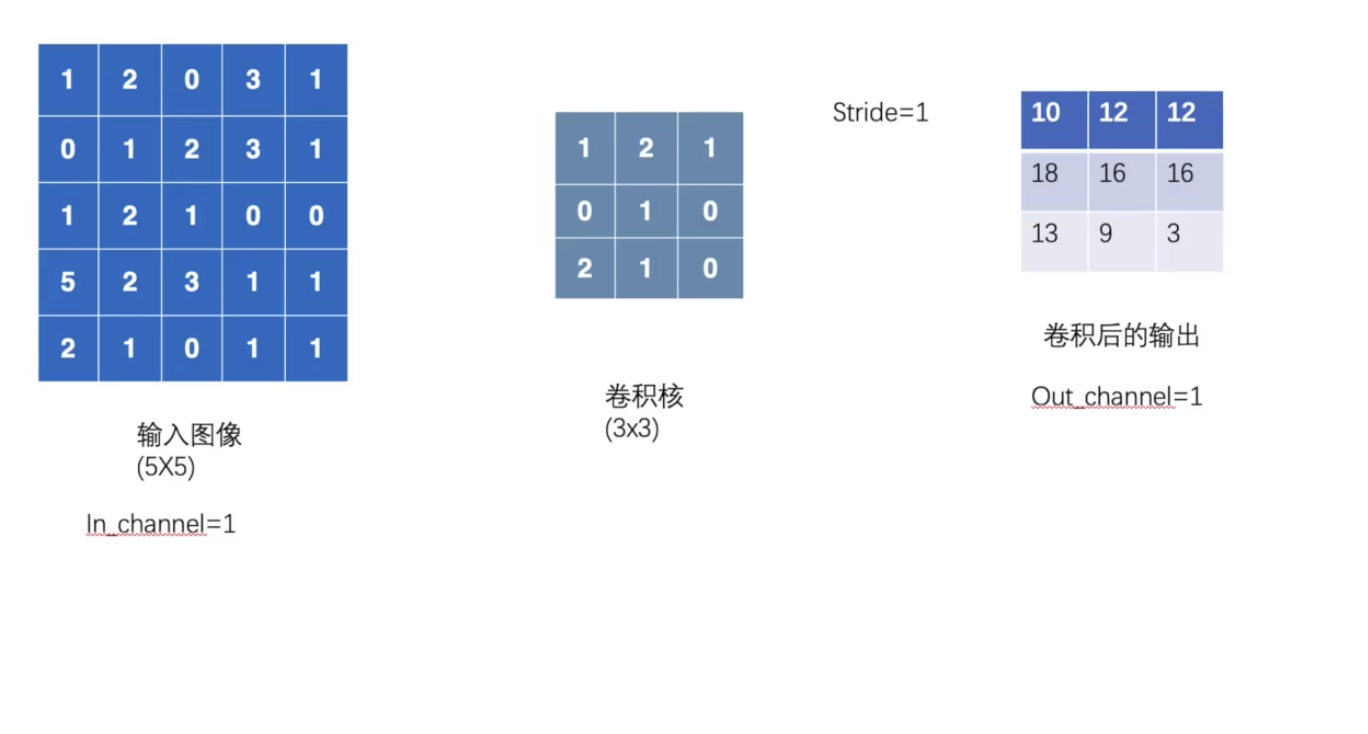
单输出通道:
如上是in_channel是1和outchannel是1的情况。
当out_channel=1时,使用单个卷积核对输入图像进行卷积,得到单个特征图输出。
卷积核与输入图像逐元素相乘后求和,得到输出特征图的每个像素值。
多输出通道:
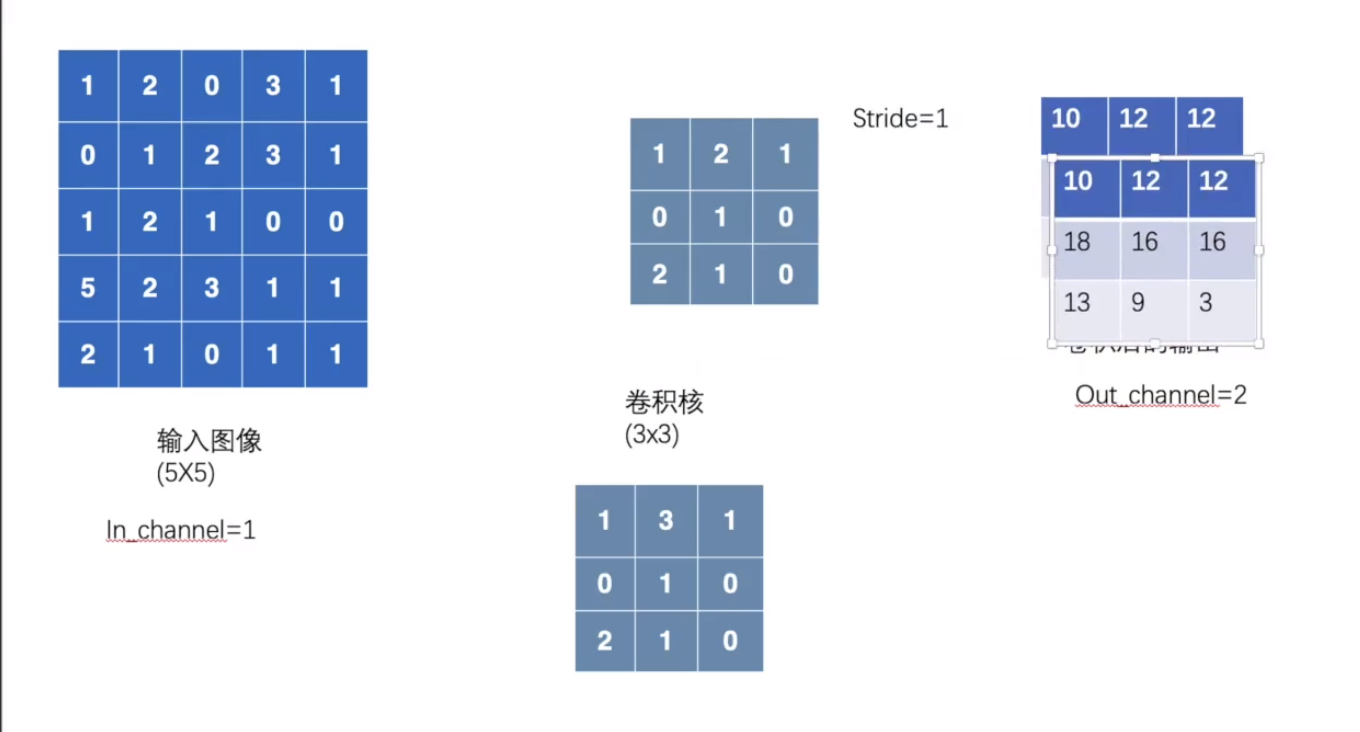
当out_channel=2时,卷积层会自动生成两个不同的卷积核(这两个卷积核尺寸一致,但是不一定是完全一样的),
每个卷积核独立与输入图像进行卷积运算,分别产生输出特征图,即生成两个特征图。
两个特征图叠加形成最终输出,通道数变为2
每个卷积核产生独立输出,最终输出特征图通道数与卷积核数量一致
实际代码演示
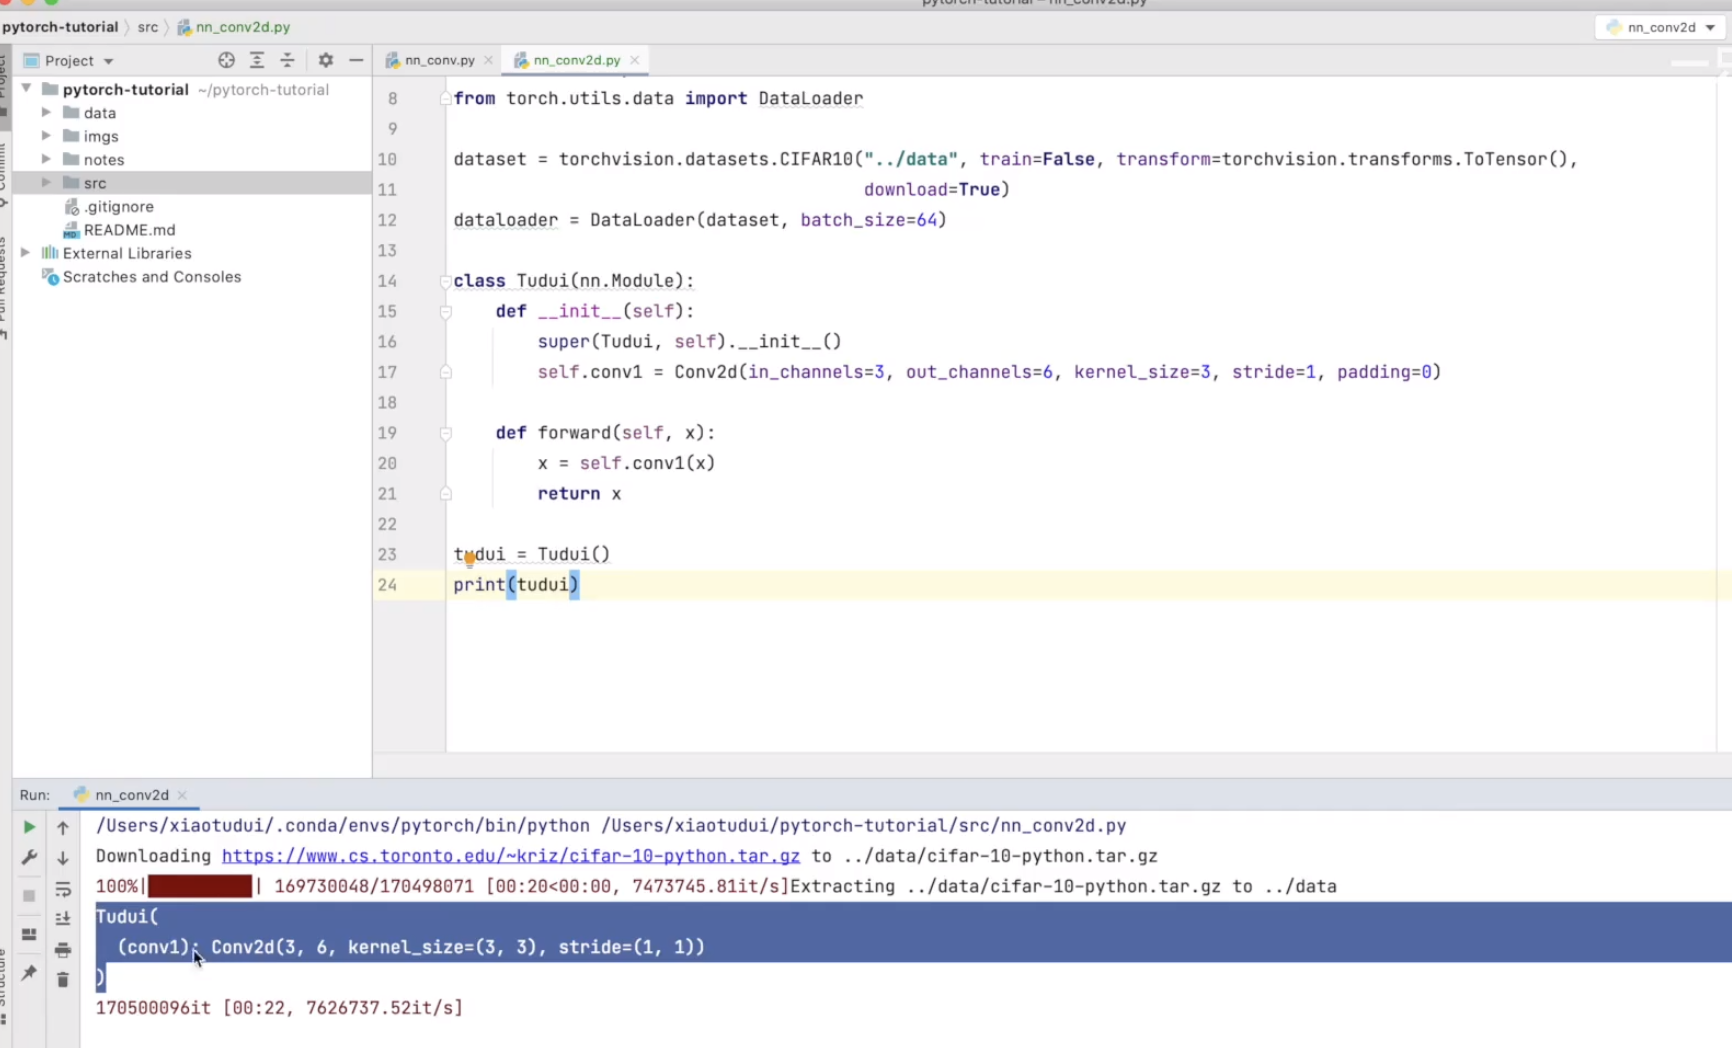
上图我们发现打印出来的tudui实例,kernel_size是3 * 3,是因为卷积函数会将传入的kernel_size=3,这个3的数值拆解成3 * 3。所以打印出来卷积和尺寸是(3,3),stride同理。
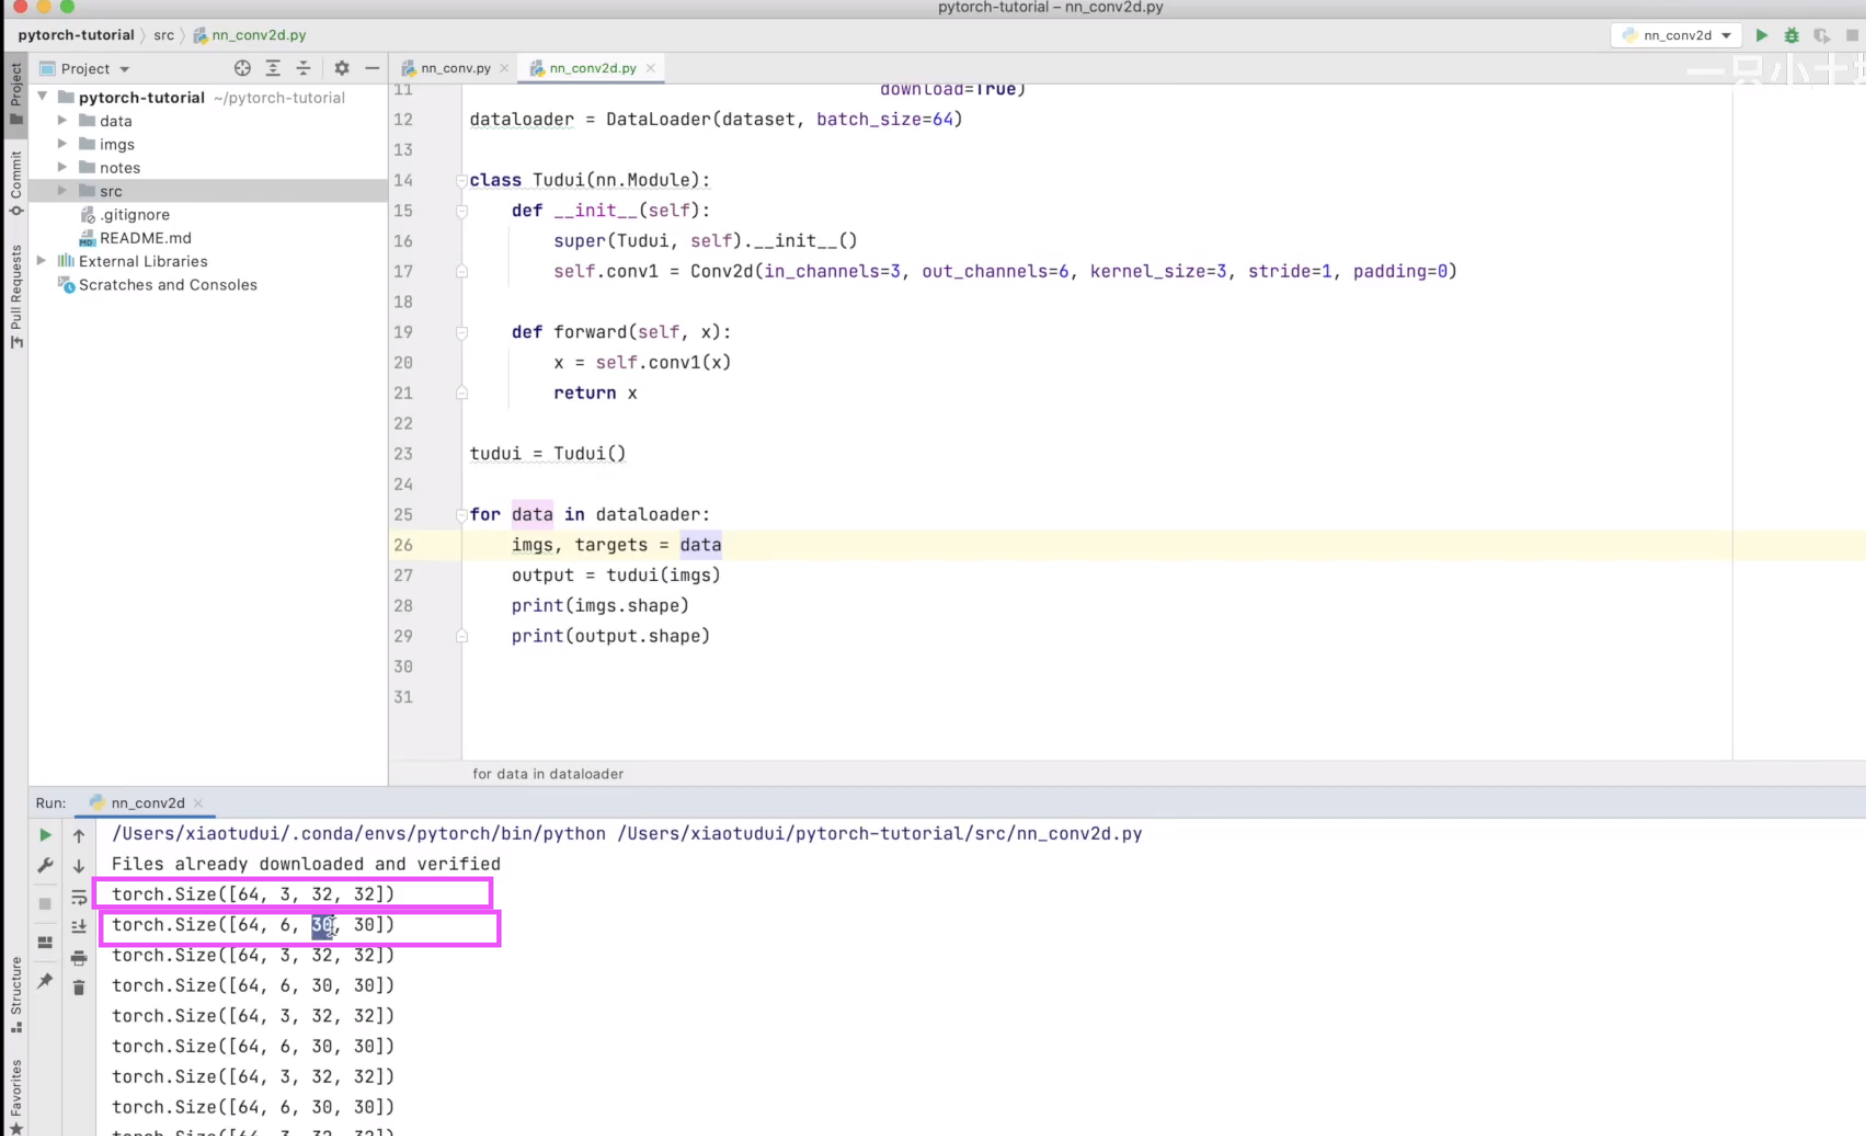
如上代码,我们可以查看到控制台打印的信息里,输入图片的shape信息是64,3,32,32,64是64张,因为batch_size是64,也就是64张图为一批的数量。3是3通道的意思,因为图片是彩色的,所以是3通道。32和末尾的32是图片尺寸,也就是32 * 32的尺寸大小。
我们可以看到输出图片的大小是64,6,30,30,64也是64张,由于输入图片是64张一批,经过卷积操作后,输出图片也仍为64张一批,6是6通道的含义(因为我们卷积操作中设置的outchannel是6,所以这个经过卷积操作后,输出图片的outchannel就是6),30和末尾的30是图片尺寸,也就是30 * 30的输出图片大小(这个是可以计算得出的,我们卷积操作中kernel_size是3,那么意味着3 * 3尺寸的卷积核对32 * 32对输入图片做卷积操作,由于stride=1,padding是0,那么卷积核左上角对准输入图片左上角,从左向右一格一格移动去做乘积和来算得输出图片的数值结果,横向方向是计算30次,同理,纵向方向也是计算30次。所以输出图片的尺寸大小是30 * 30)
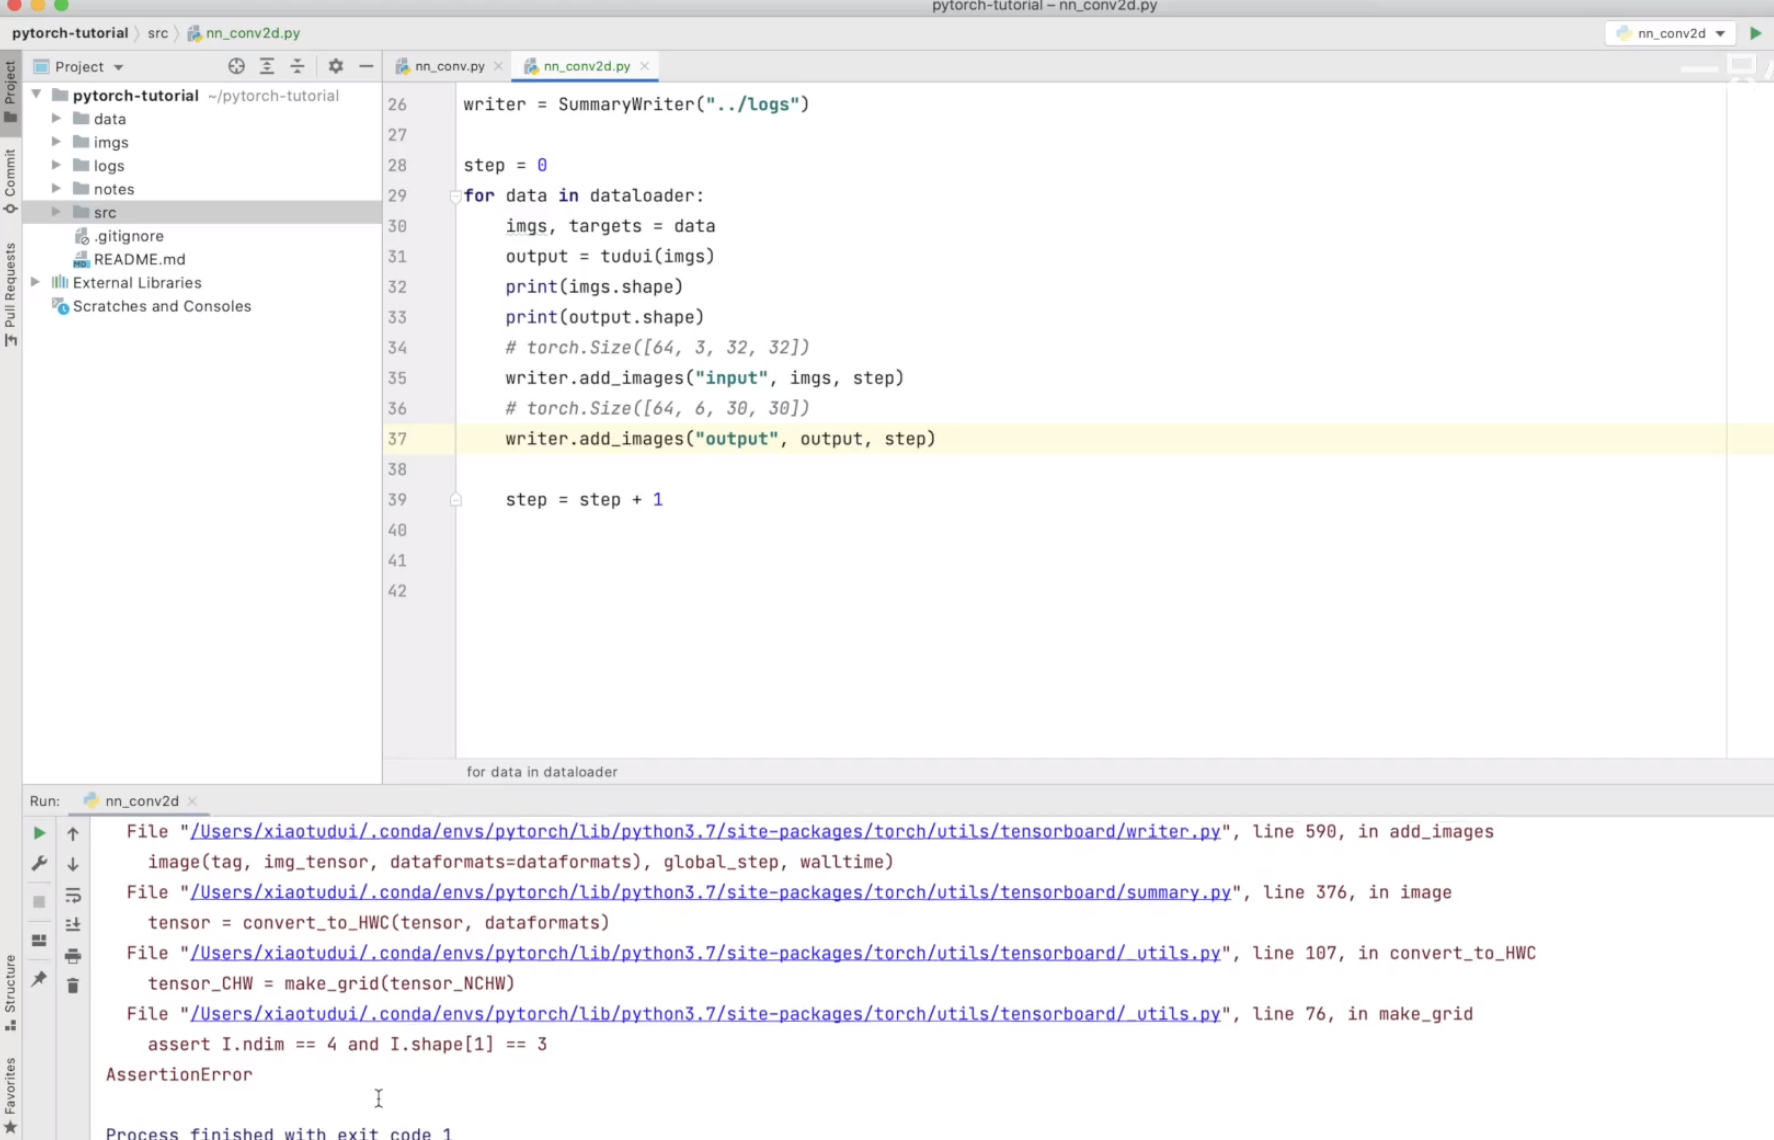
如上代码报错,原因是add_image的时候,通道是6,插件不知道如何展示,所以报错了。
那么我们就reshape一下
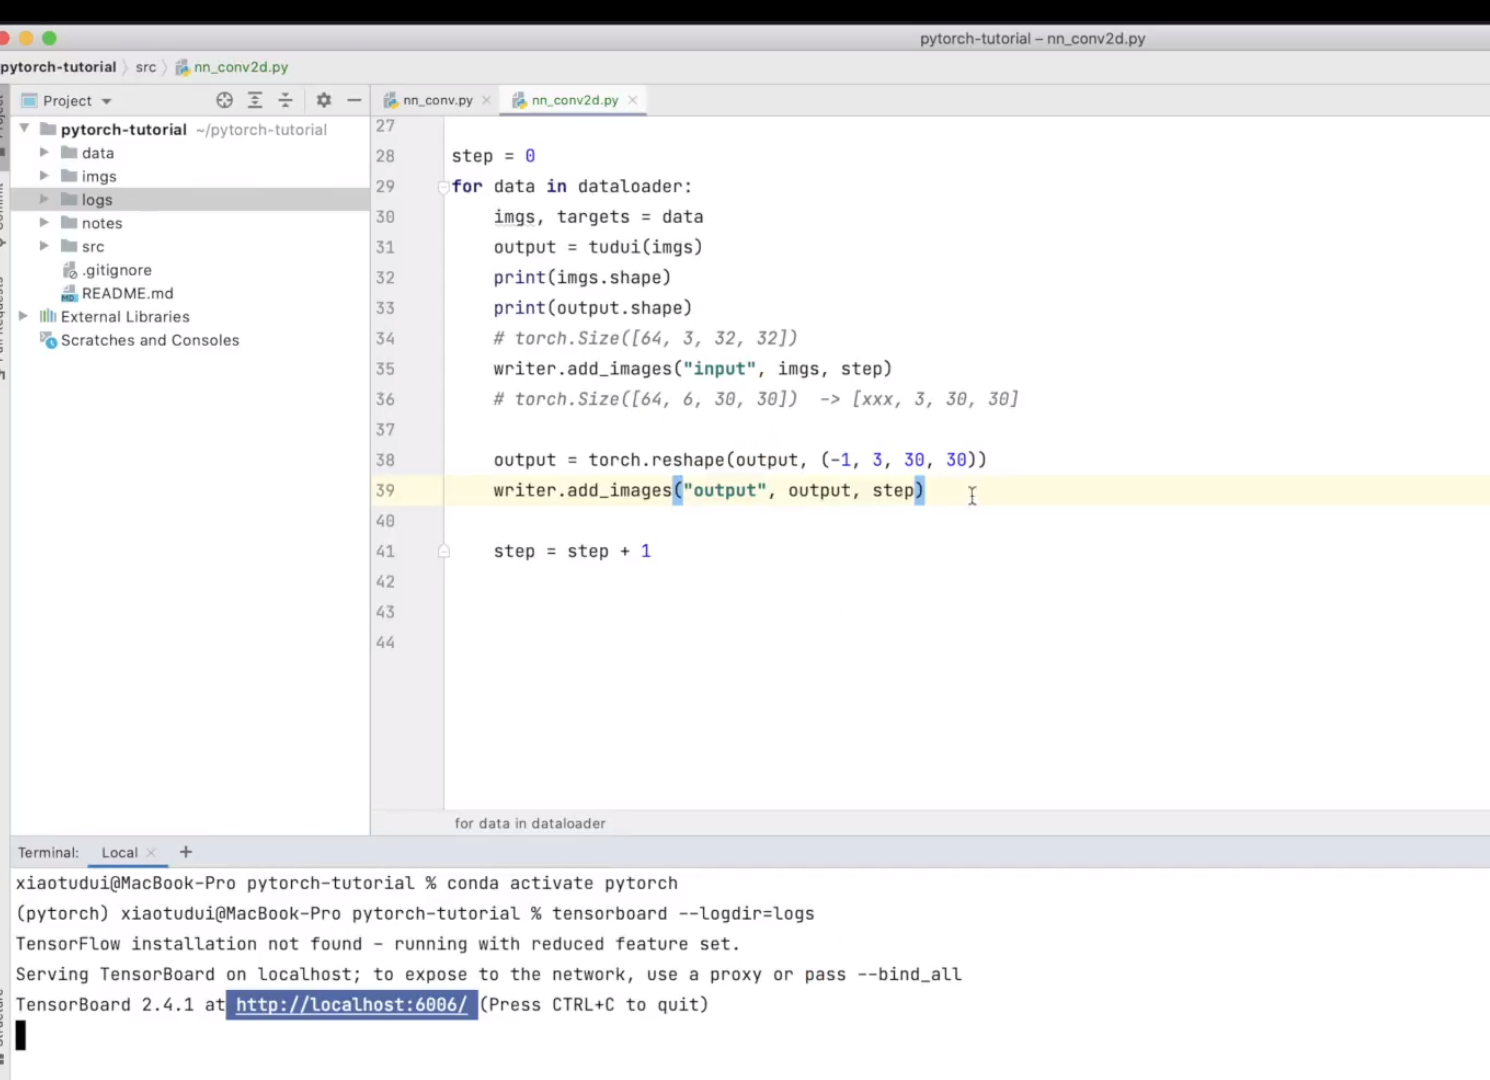
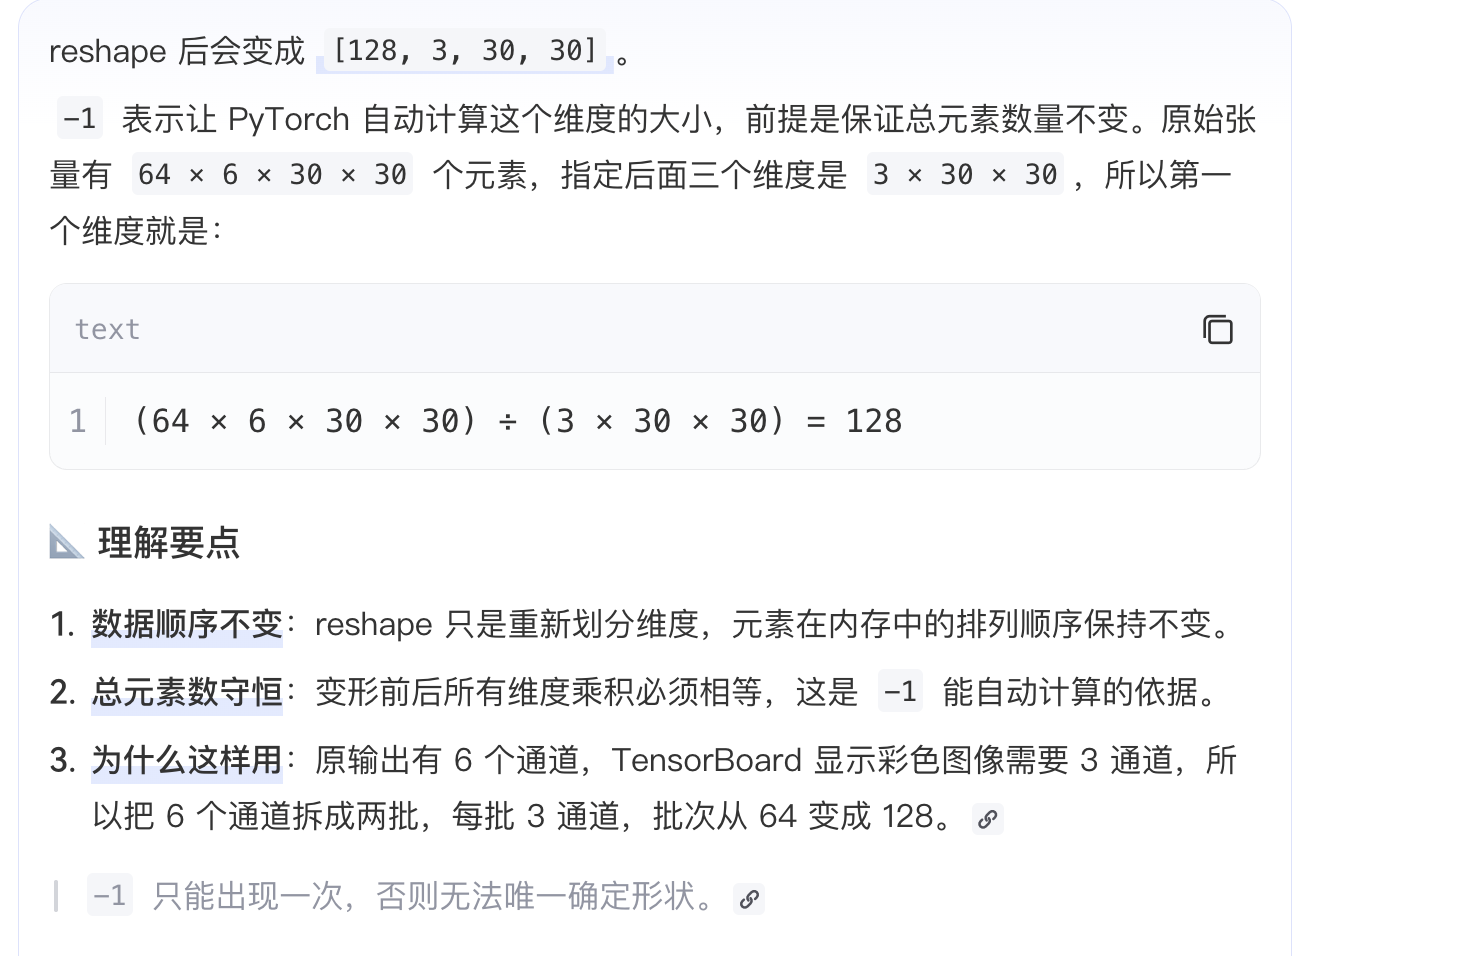
通过如上reshape处理,也就是对6通道输出reshape为-1,3,30,30以适应三通道显示
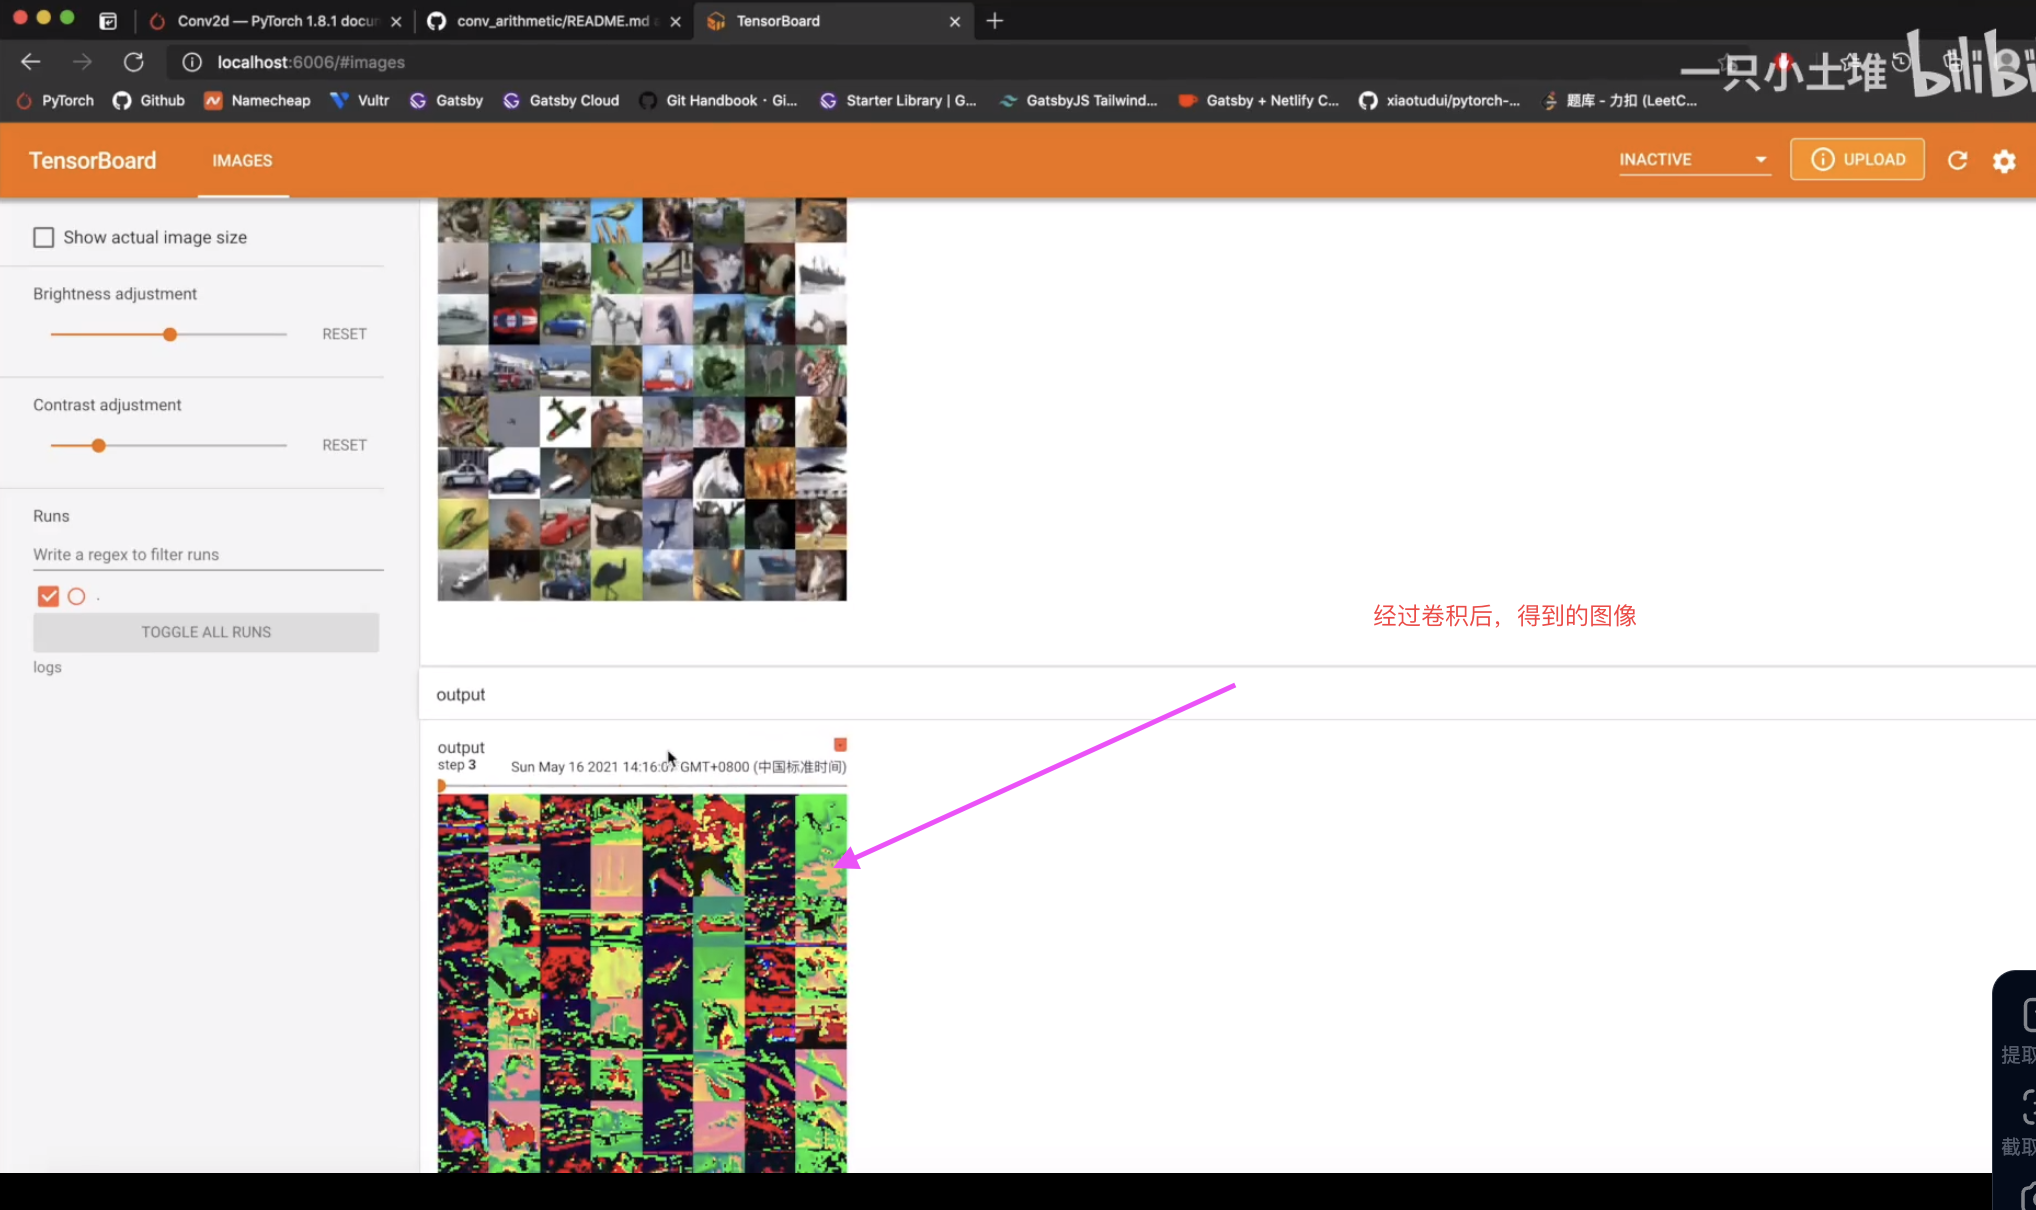
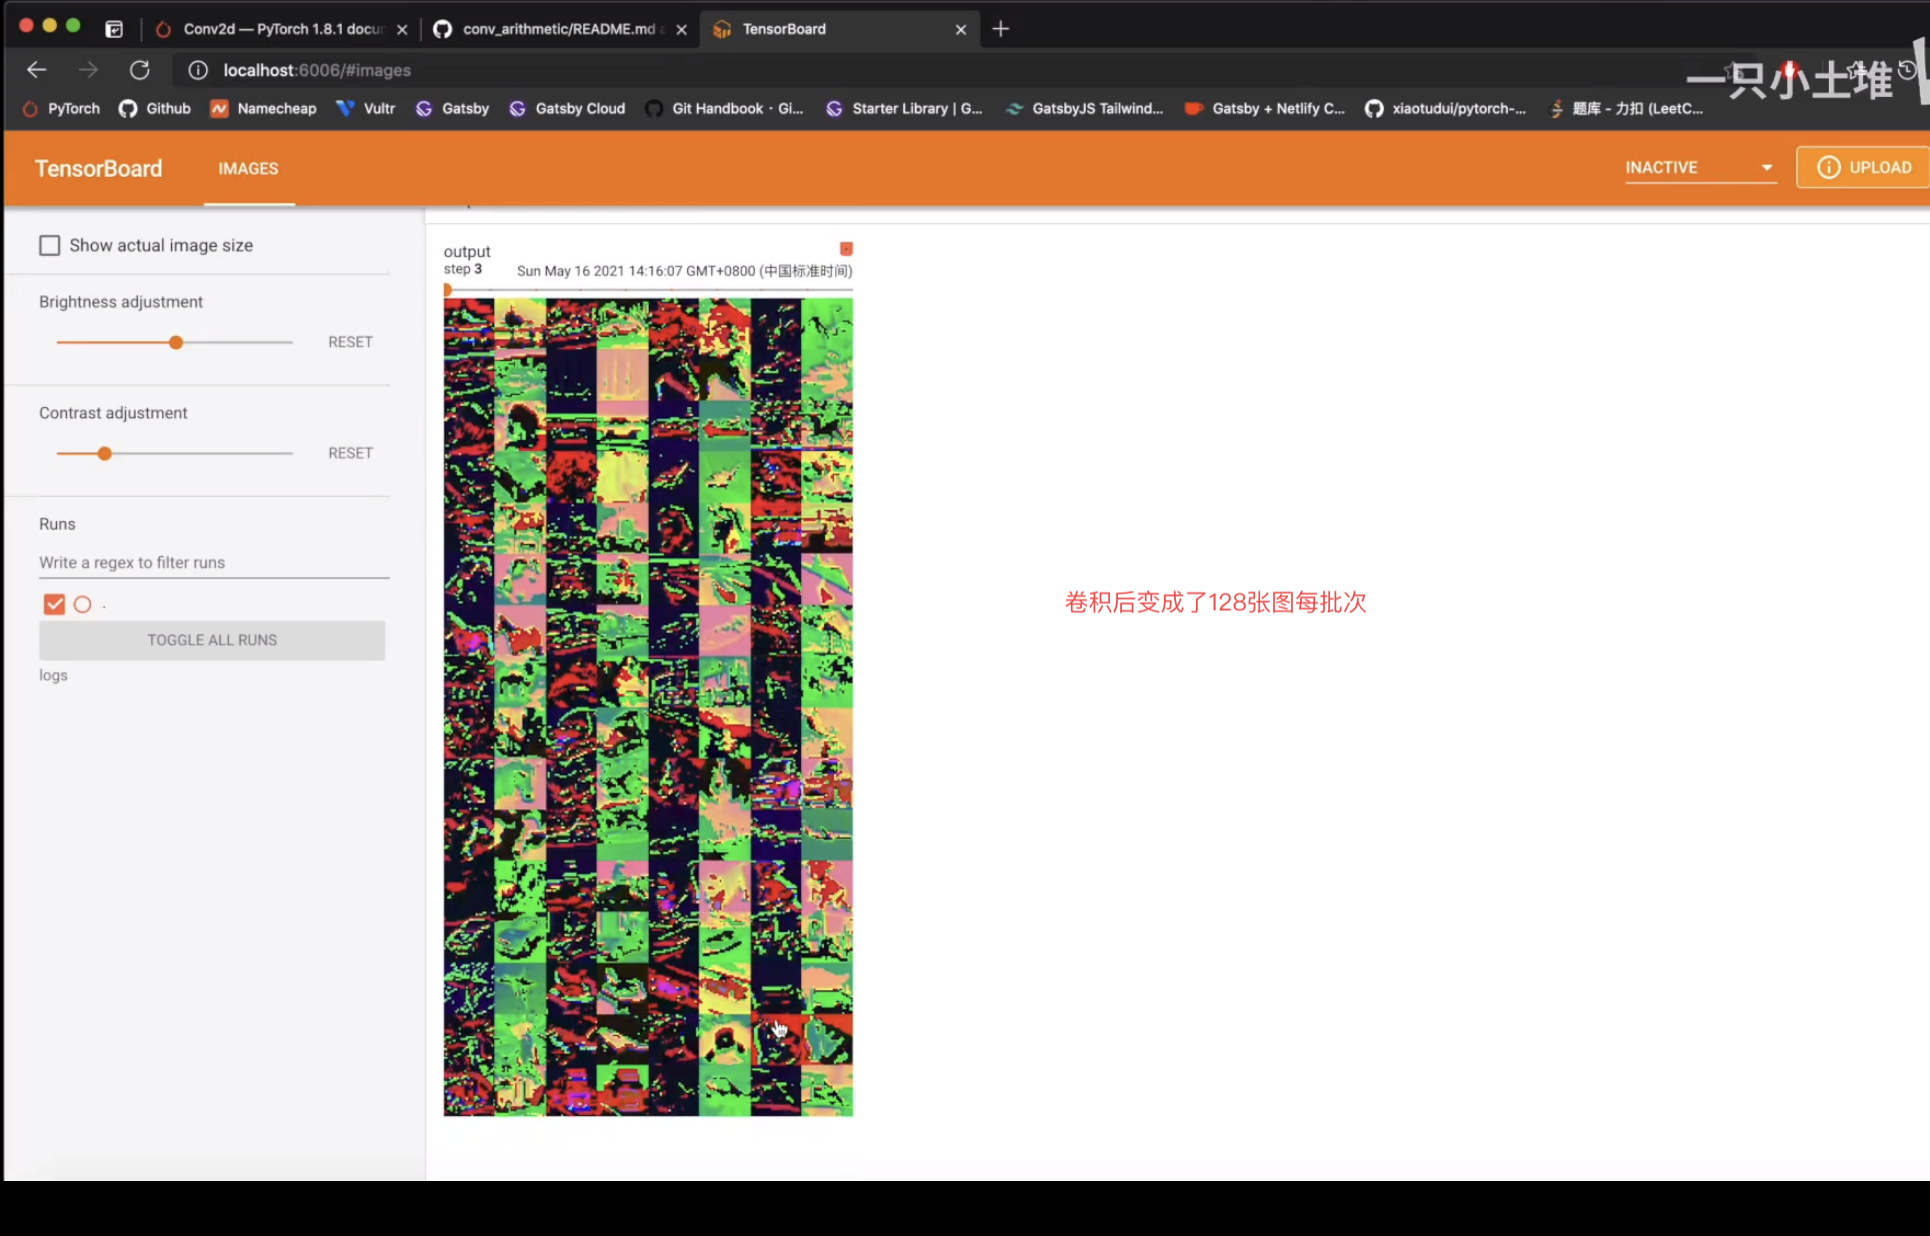
我们发现卷积后的图像每个批次是有128张图的。
就比如如下两个通道的输出,我们想改成一个通道,那么原来两个通道是叠加在一起的,现在只有把它切开,batch_size会变多。
整体代码:
python
# -*- coding: utf-8 -*-
# 作者:小土堆
# 公众号:土堆碎念
import torch
import torchvision
from torch import nn
from torch.nn import Conv2d
from torch.utils.data import DataLoader
from torch.utils.tensorboard import SummaryWriter

dataset = torchvision.datasets.CIFAR10("../data", train=False, transform=torchvision.transforms.ToTensor(),
                                       download=True)
dataloader = DataLoader(dataset, batch_size=64)

class Tudui(nn.Module):
    def __init__(self):
        super(Tudui, self).__init__()
        # in_channels因为是彩色图像,所以输入是三层。
        self.conv1 = Conv2d(in_channels=3, out_channels=6, kernel_size=3, stride=1, padding=0)

    def forward(self, x):
        x = self.conv1(x)
        return x

tudui = Tudui()

writer = SummaryWriter("../conv2d")

step = 0
for data in dataloader:
    imgs, targets = data
    output = tudui(imgs)
    print(imgs.shape)
    print(output.shape)
    # torch.Size([64, 3, 32, 32])
    writer.add_images("input", imgs, step)
    # torch.Size([64, 6, 30, 30])  -> [xxx, 3, 30, 30]

    output = torch.reshape(output, (-1, 3, 30, 30))
    print("output.shape",output.shape)

    writer.add_images("output", output, step)

    step = step + 1

writer.close()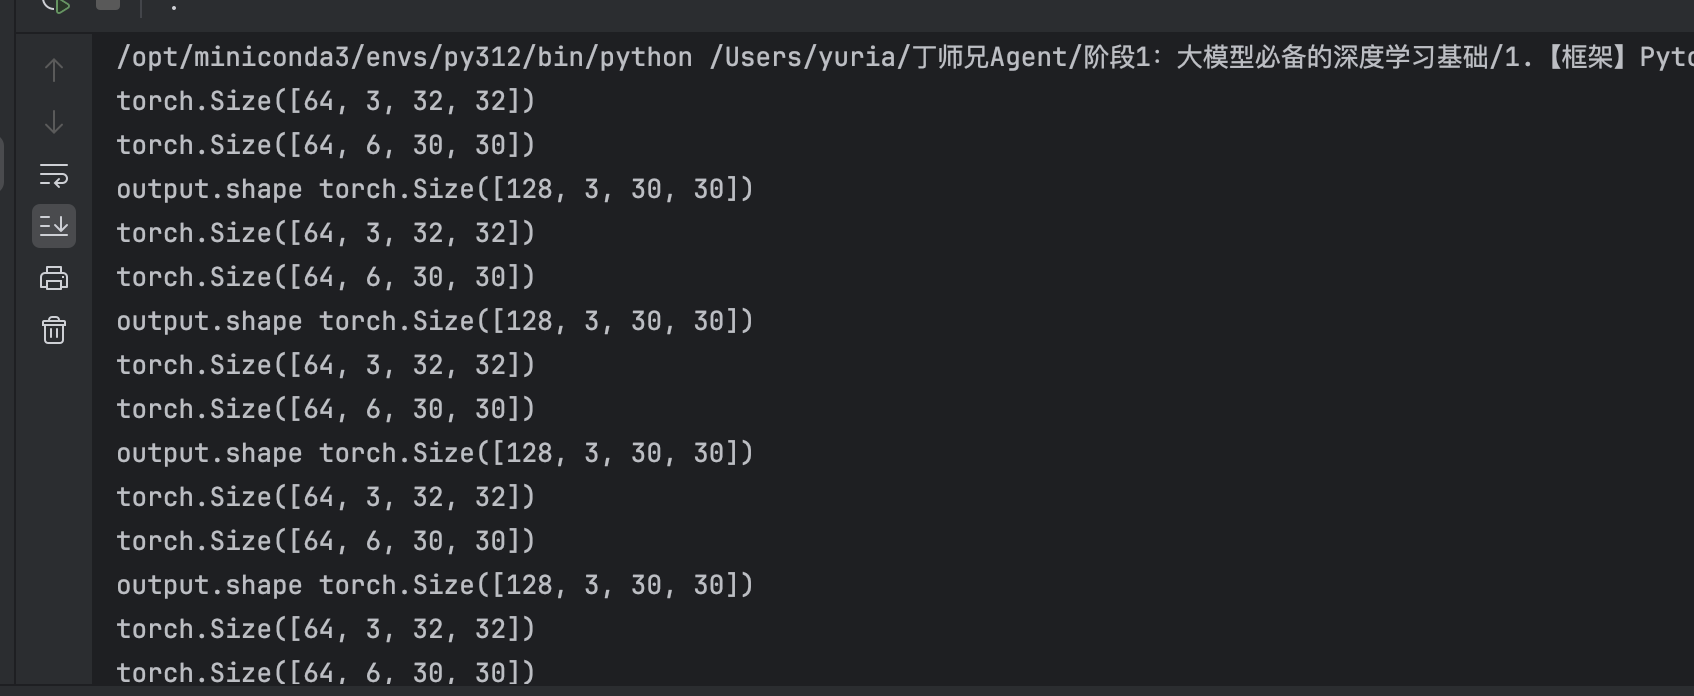
代码执行后,终端打印出来的经过reshape的图像的batchsize确实变大了,为128.
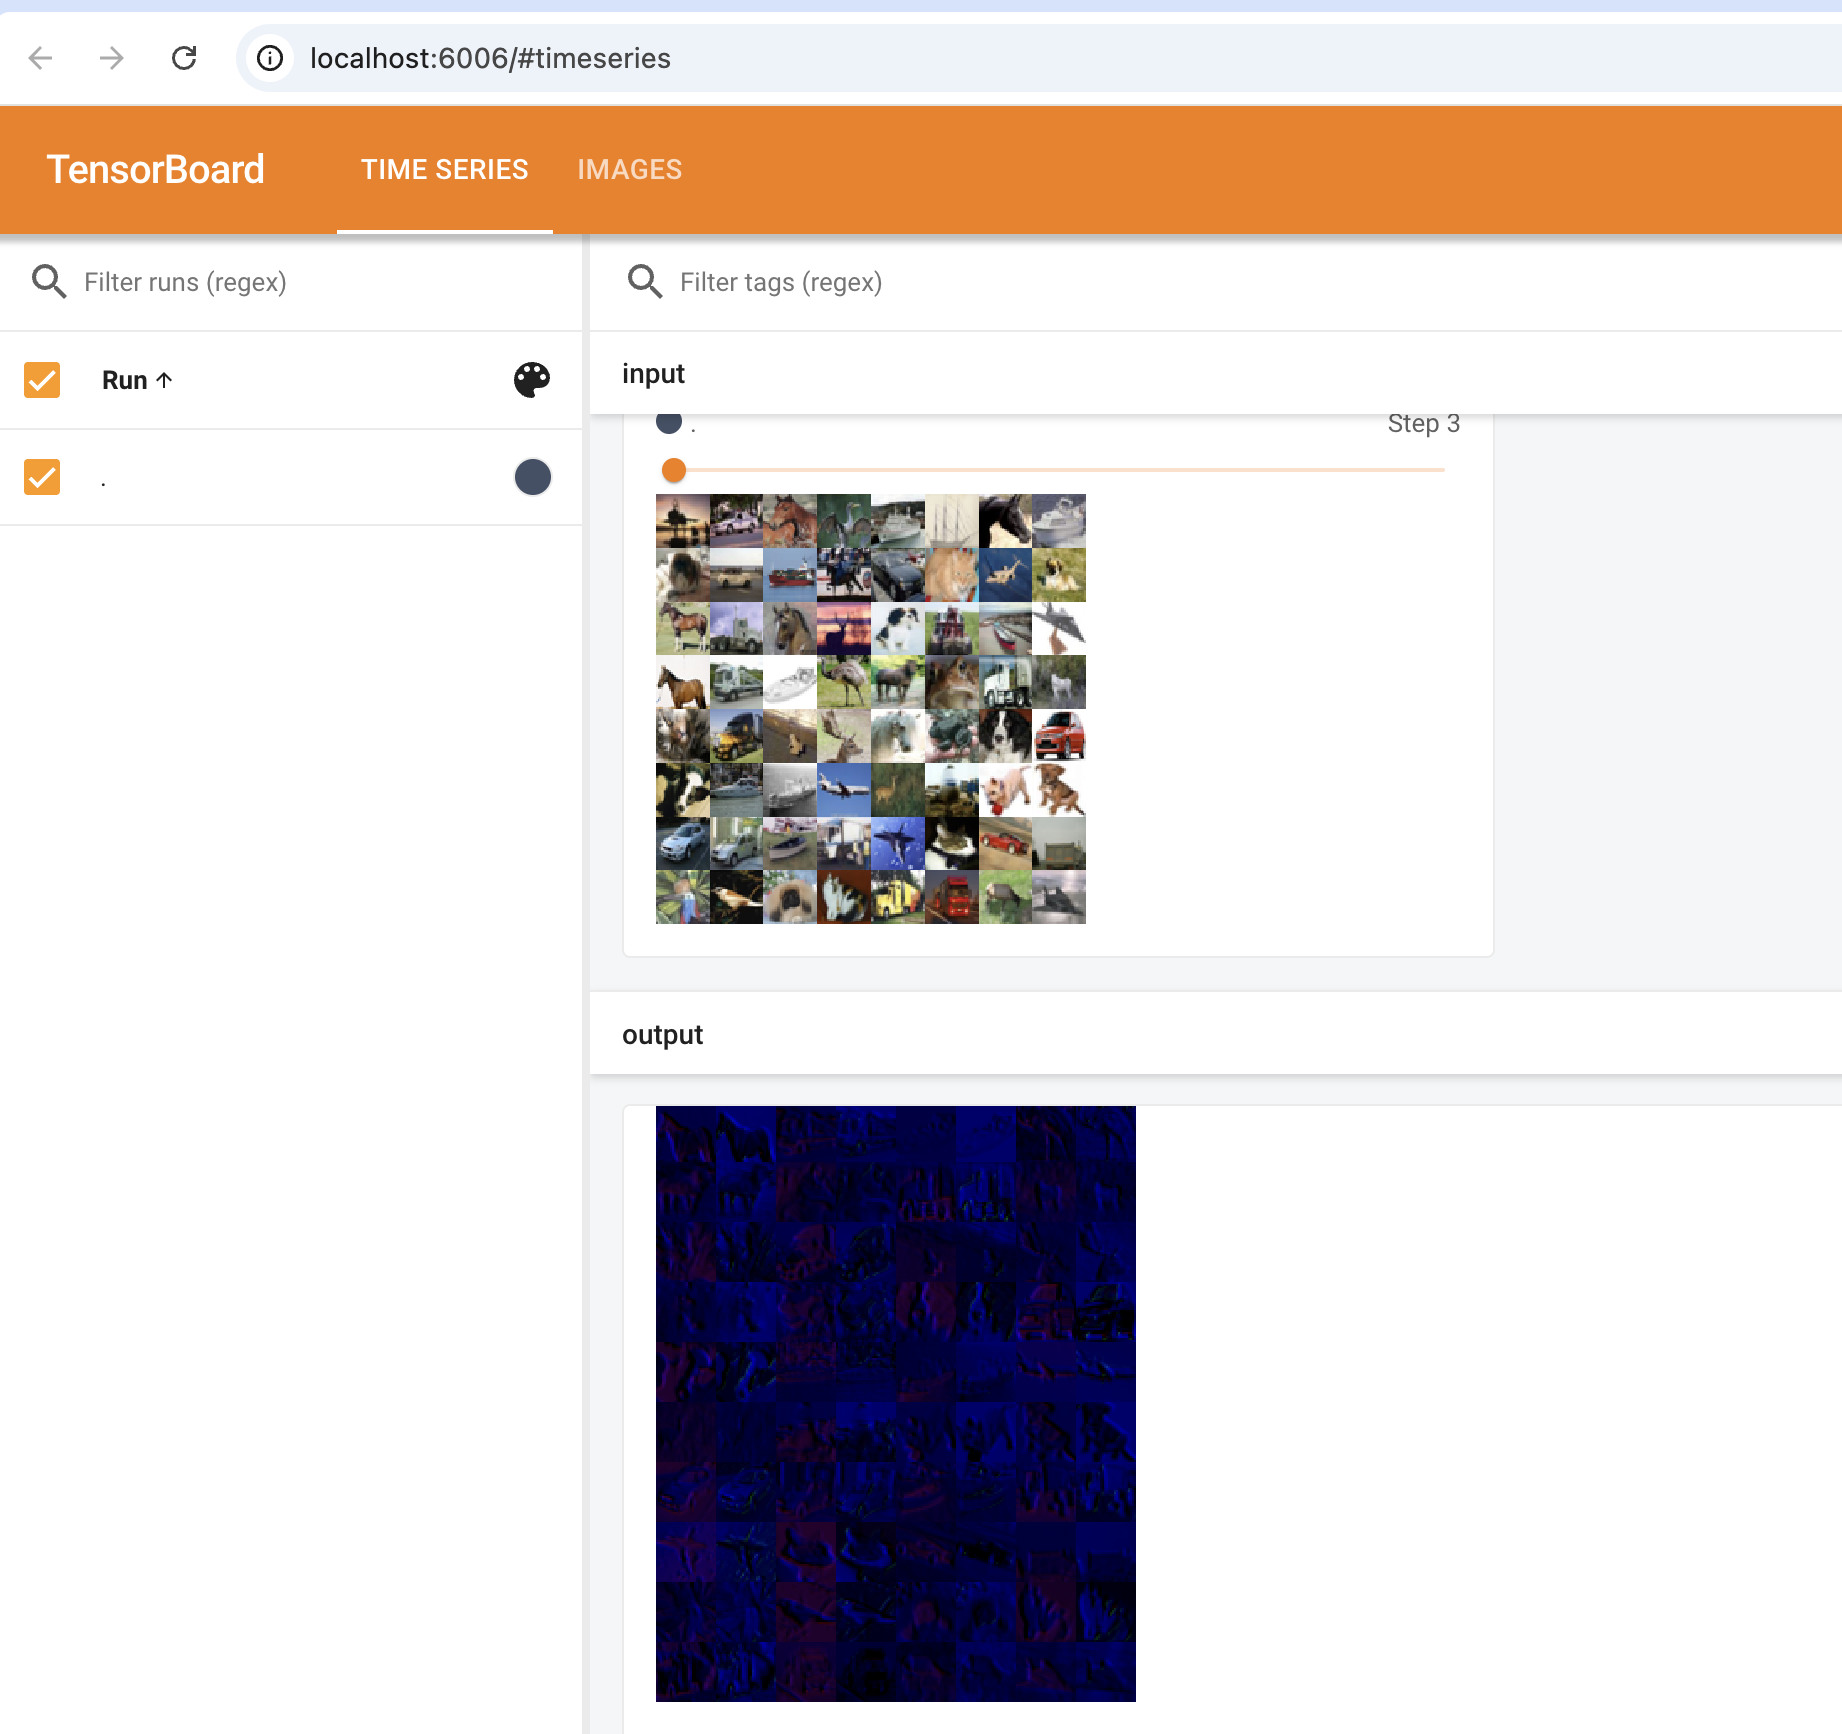
通过tensorboard进行可视化,发现output的图像确实是128张图片为一批量的。
根据输入尺寸计算输出图像的尺寸公式
如何根据输入的尺寸计算输出的尺寸如下:
N是batch_size, C下角标是in,是in_channel
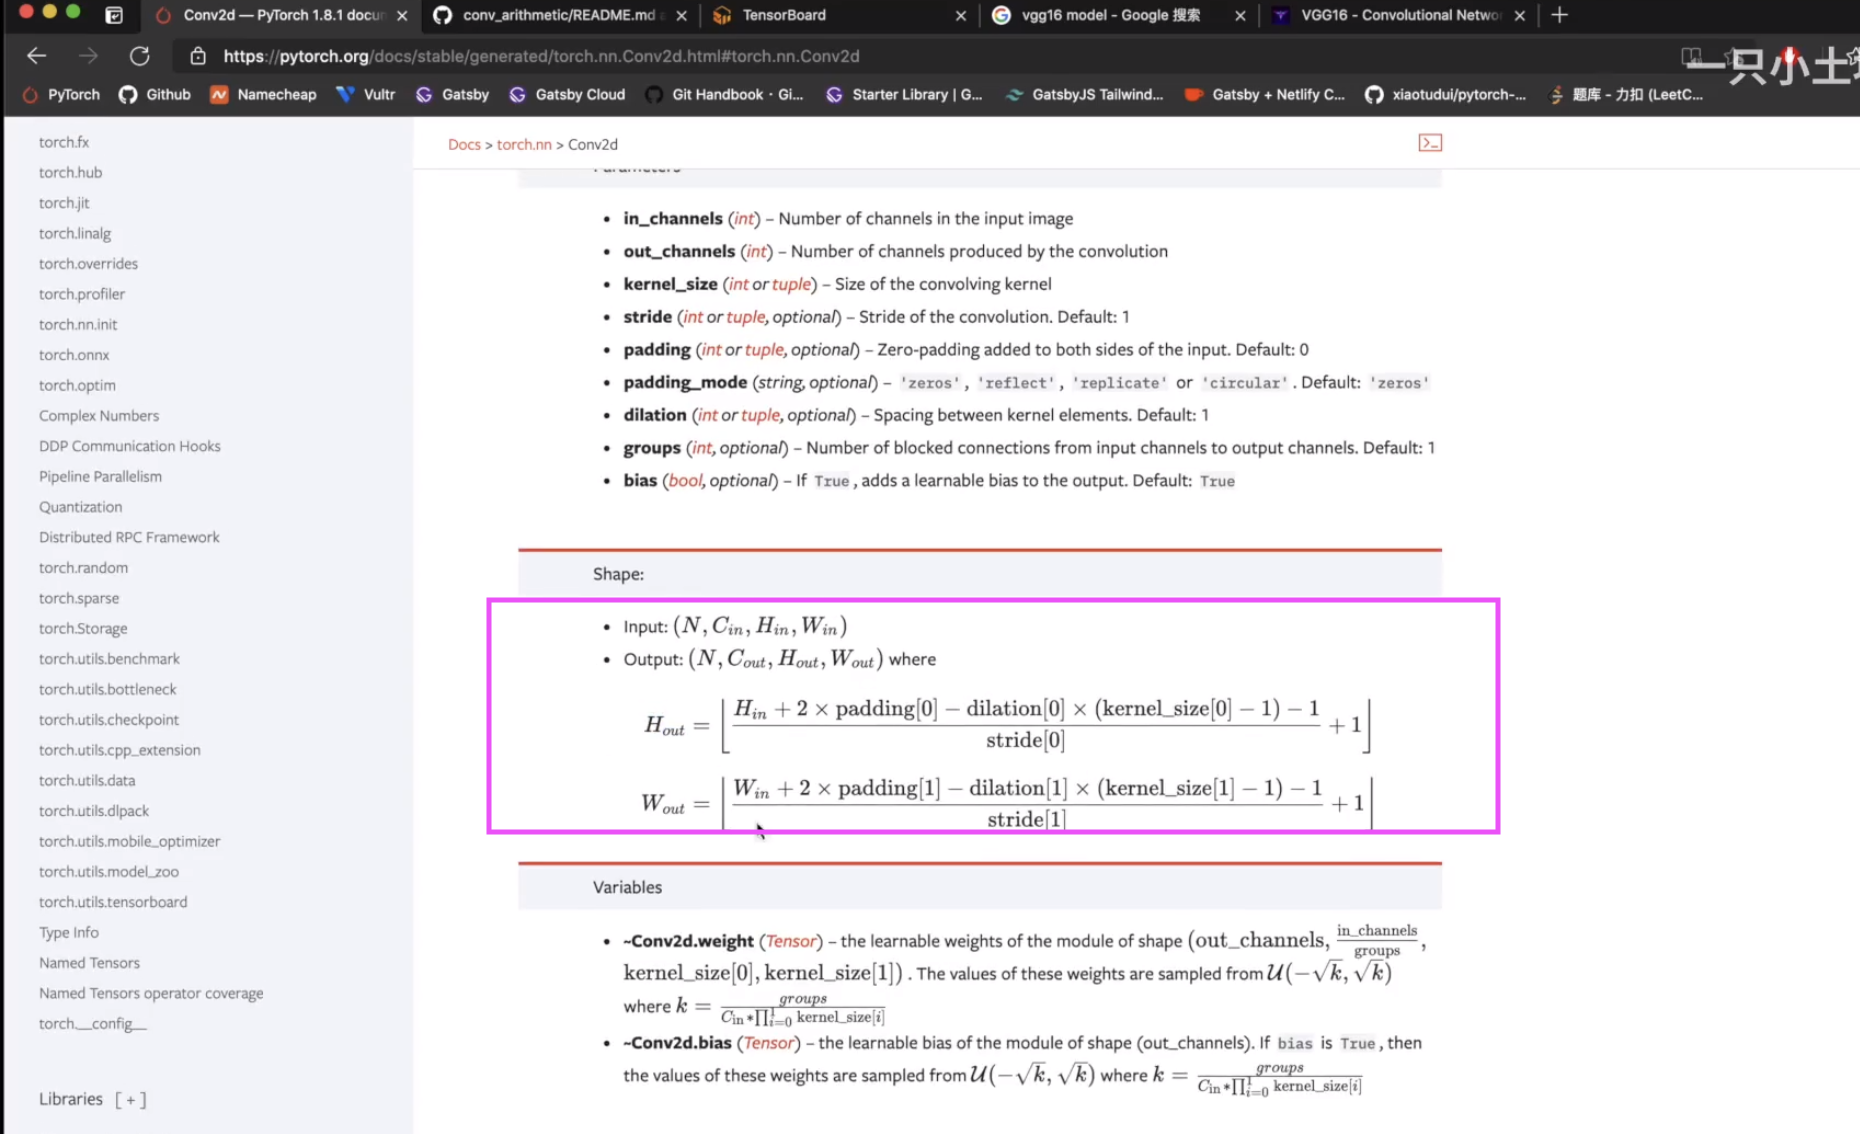
以我们代码演示的为例,输入图像尺寸是32 * 32, padding是0,0(即横向和纵向的padding都是0的意思),dilation是默认值(1,1),
kernel_size是(3,3),stride步长是1,那么out输出图像的H计算出来就是30,W也是30.也就是输出图像的尺寸是30 * 30,和我们代码演示里的一致。