论文题目:Normalizing Flow based Feature Synthesis for Outlier-Aware Object Detection (基于归一化流的特征合成用于异常感知目标检测)
会议:CVPR 2023
摘要:可靠目标检测器的真实部署对自动驾驶等应用十分重要,但 Faster R-CNN 等通用检测器容易对异常目标给出过度自信的预测。近期方法通常使用类别条件 Gaussian 估计实例特征密度,并从低似然区域合成异常特征训练模型,但某一类别下的低似然样本并不保证在其他类别下仍是低似然。本文提出 FFS:利用可逆 Normalizing Flow 学习所有 ID 类别特征的联合分布,并从联合分布的低似然区域合成异常特征。这样生成的样本相对于所有 ID 类别都具有更低似然,从而形成更好的 ID/OD 决策边界。FFS 在图像和视频异常感知目标检测上均取得了更好的结果。
一、研究背景:VOS 的问题在哪里
目标检测中的异常检测比整图分类更复杂,因为同一张图中可能同时出现已知目标(ID)和未知目标(论文记作 OD,Outlier)。模型不仅要找到目标,还要避免把未知目标高置信度分类成某个已知类别。
VOS 已经提出一种很自然的思路:不在像素空间生成异常图像,而是在对象特征空间中为每个类别拟合 Gaussian,再从低似然区域采样 virtual outliers。但这里存在一个关键问题:"对类别 A 来说是异常"不代表"对所有类别来说都是异常"。 从 A 类 Gaussian 低似然区域采出的样本,可能恰好落入 B 类 Gaussian 的高似然区域,于是这个所谓 outlier 实际上仍像某个 ID 类。
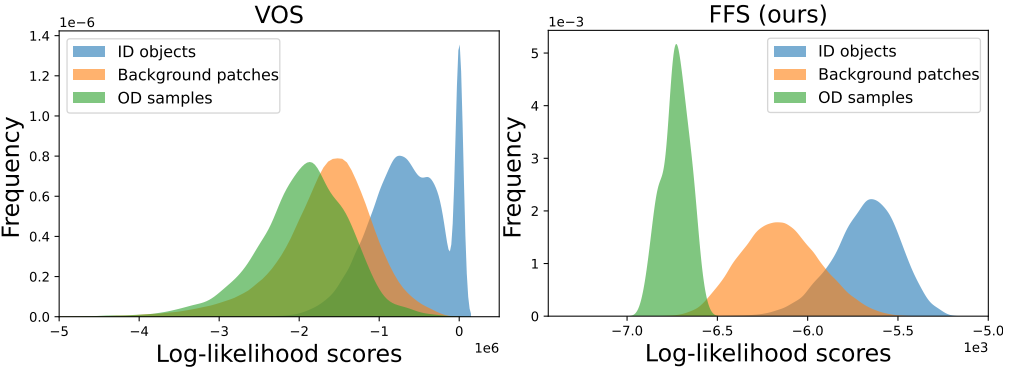
论文 Figure 1:VOS 与 FFS 对 ID、background patches 和 synthetic OD 的 log-likelihood 分布比较
Figure 1 直接展示了这个问题。FFS 得到的 ID、背景与 synthetic OD 的 likelihood 分布分离更清晰。作者因此把问题从"分别拟合每个类别"改成了:学习所有 ID 类共同构成的联合特征分布。
一句话概括 FFS:用 Normalizing Flow 建模整个 ID manifold,再从联合分布的低似然区域生成真正有价值的异常特征。
二、FFS 整体框架
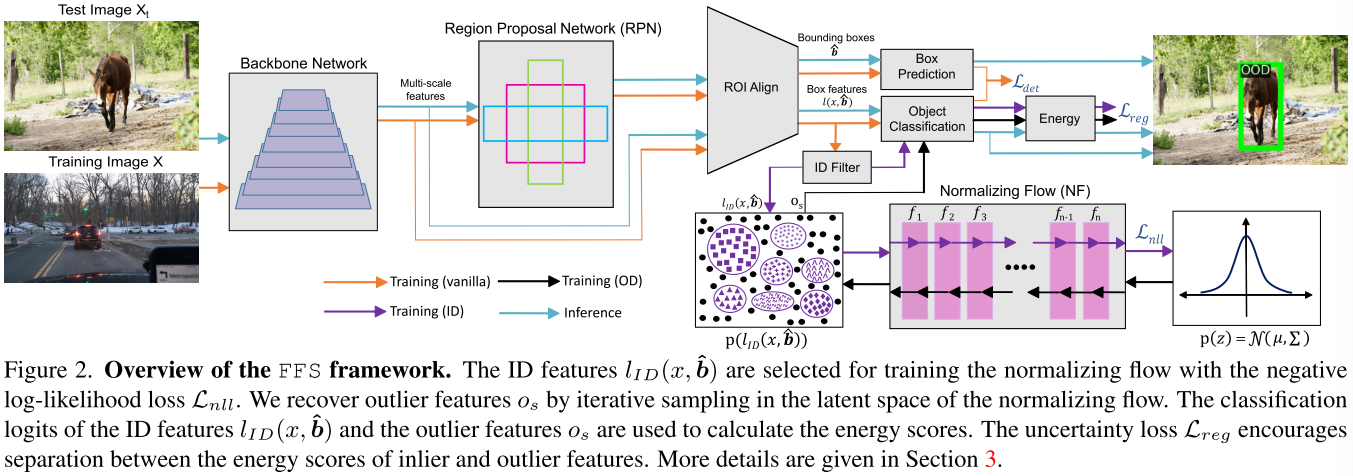
论文 Figure 2:FFS 的训练与推理框架
FFS 建立在 Faster R-CNN 上。Backbone 和 RPN 产生 proposals,ROI Align 得到固定维度的 box feature ()。背景 proposal 被过滤,只保留真实 ID 对象特征
) 训练 Normalizing Flow。
训练中有三条路径:
普通检测:feature → classification / box regression →
密度建模:ID feature → Normalizing Flow →
异常感知:Flow sampling → synthetic outlier → Energy →
训练初期先关闭 (),让 Flow 学到稳定的 ID 分布;随后从 latent space 采样并通过逆映射生成 synthetic features,再从中选择低似然样本作为 outliers。ID 与 synthetic outlier 进入分类头计算 Energy,并通过 (
) 拉开两者。
推理时不再生成异常样本,只对检测框计算 Energy。阈值 () 被设为在验证集上接受 95% 的 ID;若 Energy 低于阈值判为 ID,否则判为 OD。
三、Normalizing Flow 如何合成异常特征
FFS 使用可逆映射 (),把复杂的 ID feature 分布映射到零均值、单位协方差的 multivariate Gaussian latent space,即 (
)。
Normalizing Flow 在这里最关键的不是"能生成",而是可逆且可以精确计算 likelihood。给定 ID feature (l),令 (z=f(l)),通过变量替换公式:
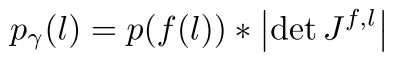
因此可以直接使用 negative log-likelihood 训练 Flow:
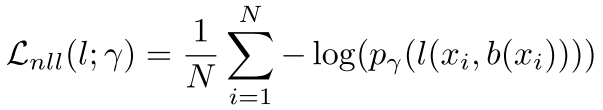
直观理解就是:Flow 学会回答"一个 box feature 在整个 ID 分布下到底有多正常"。
训练一段时间后,从 latent Gaussian 随机采样 (),再通过 (
) 回到原特征空间。由于 Flow 可逆,生成的 (
) 还能直接计算 likelihood。大部分样本处于 ID 高密度区域,但大量候选中也会出现靠近边界或位于边界外的低似然样本,这些才是 FFS 真正需要的 synthetic outliers。
四、如何选择有效 Outlier,并完成 Energy Regularization
4.1 Rejection Sampling
FFS 默认使用 rejection sampling:一次生成 (k) 个候选 (),再从最低 likelihood 区域挑选 (s) 个 (
),且 (
)。
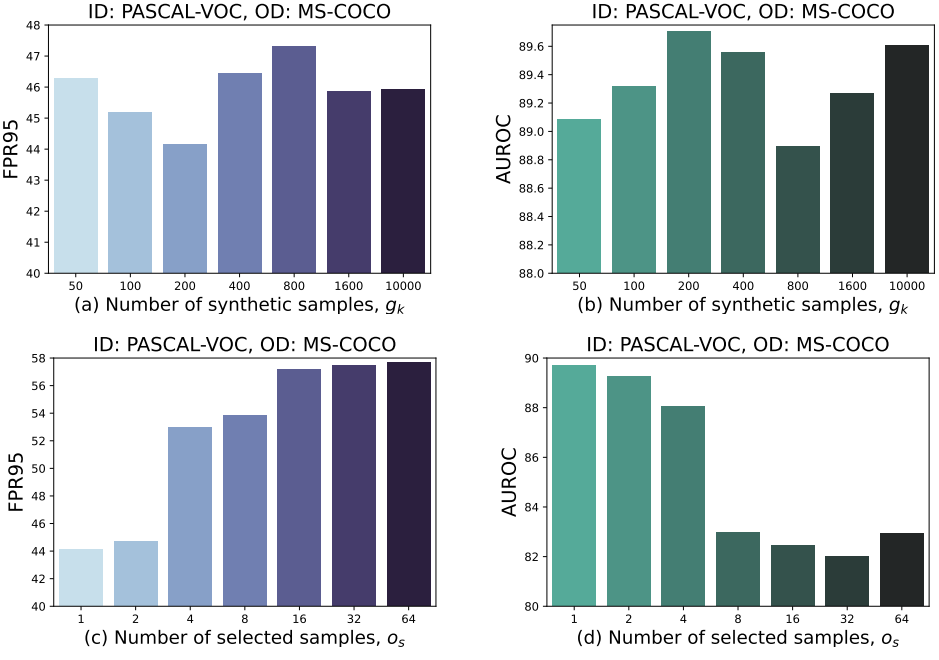
论文 Figure 3:候选生成数量与最终选择数量对 FPR95 / AUROC 的影响
固定只选一个最低似然样本时,增加候选数量通常能找到更有效的异常点;但候选过多,最低似然样本可能离决策边界太远,反而变成过于简单的异常。另一方面,如果一次选择太多 outliers,后续入选样本的 likelihood 会越来越高,甚至落回 ID manifold。
因此最好的异常并不是"越远越好",而是既覆盖决策边界,又确实位于 outlier space。
4.2 Projection Sampling
论文还尝试基于 Langevin Dynamics 的 projection sampling。它先用真实 ID 中最低 likelihood 定义边界 (),再沿 log-likelihood 的反梯度更新:
直到 synthetic outlier 被推到近边界区域。不过实验发现它不如简单 rejection sampling,因为 projection 强制样本集中在固定边界附近,对更广的 outlier manifold 覆盖不足。
4.3 Energy-based regularization
FFS 将 ID 与 synthetic outlier 的分类 logits 转成 Energy:ID 应该低能量,outlier 应该高能量。Energy 再进入二分类器,用 BCE 构造 (。最终整体目标为:
其中 ( 保留原检测能力,(
) 学习 ID 联合密度,(
) 用 synthetic outliers 塑造 ID/OD 边界。
五、实验结果与消融分析
5.1 图像主实验
默认模型为 Faster R-CNN + RegNetX-4.0GF,Flow 使用 Glow。PASCAL-VOC 2012 为 ID,MS-COCO 和 OpenImages 为 OD;指标包括 FPR95↓、AUROC↑ 和 ID mAP↑。
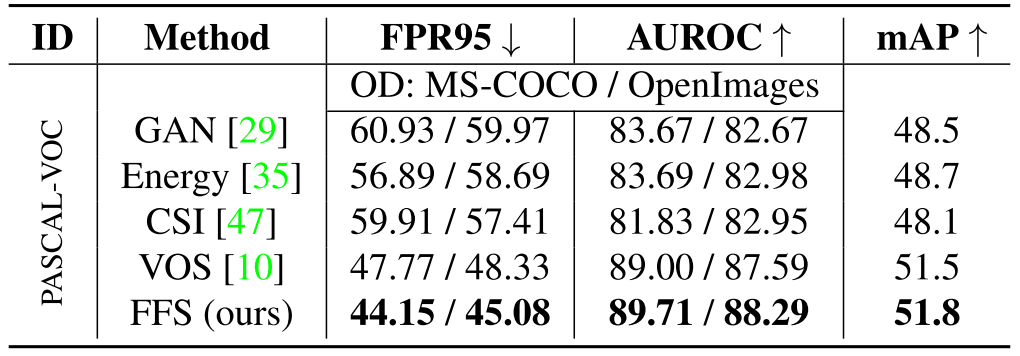
论文 Table 1:PASCAL-VOC 上的图像 OD 主实验
FFS 在 COCO / OpenImages 上的 FPR95 为 44.15 / 45.08 ,VOS 为 47.77 / 48.33;AUROC 为 89.71 / 88.29 ,ID mAP 为 51.8。论文按相对比例计算,FFS 相比 VOS 的 FPR95 分别下降 7.58% 和 6.73%。训练时间也从 VOS 的 2.43 h 降至 2.18 h。
5.2 视频数据与 backbone 泛化
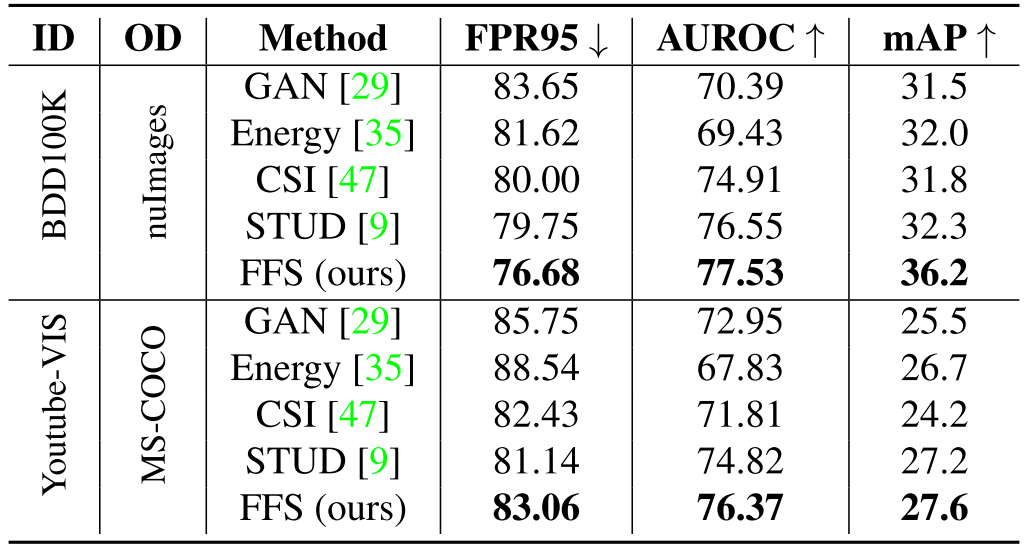
论文 Table 2:BDD100K / Youtube-VIS 视频 OD 主实验
BDD100K→nuImages 时,FFS 的 FPR95 / AUROC 为 76.68 / 77.53 ,STUD 为 79.75 / 76.55;mAP 则为 36.2,高于 STUD 的 32.3。训练时间约 2.7 h,而 STUD 约 11 h。
Youtube-VIS→COCO 时,FFS 的 FPR95 为 83.06,高于 STUD 的 81.14,但 AUROC 76.37 、mAP 27.6 高于 STUD 的 74.82 和 27.2。因此并不是所有单项指标都领先,但同一框架可以统一处理图像与视频,并显著降低训练时间。
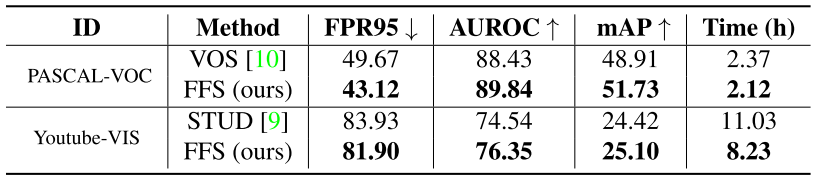
论文 Table 3:ResNet-50 backbone 下的结果
换用 ResNet-50 后,PASCAL-VOC→COCO 的 FFS FPR95 为 43.12,VOS 为 49.67;Youtube-VIS→COCO 时 FFS 为 81.90,STUD 为 83.93,说明收益不只来自默认 RegNetX backbone。
5.3 "联合分布"是否真的是关键
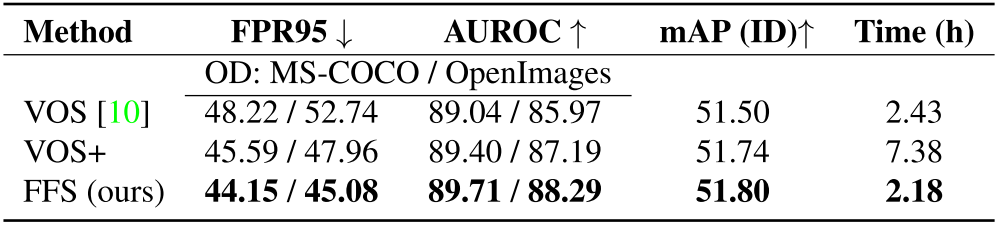
论文 Table 4:VOS、VOS+ 与 FFS 对比
作者构造了 VOS+:仍使用 class-conditional Gaussian,但把候选 outlier 放到所有类别 Gaussian 下重新计算 likelihood,只要它在其他类别下 likelihood 较高就拒绝。
VOS+ 确实优于 VOS,COCO 上 FPR95 从 48.22 降到 45.59,说明跨类别冲突确实存在;但逐类别判断使训练时间达到 7.38 h 。FFS 则做到 44.15 FPR95、89.71 AUROC、2.18 h 。这组实验直接支持了论文最核心的设计:与其事后排除每个类别的冲突,不如直接学习联合 ID 分布。
5.4 Flow、Loss 与超参数
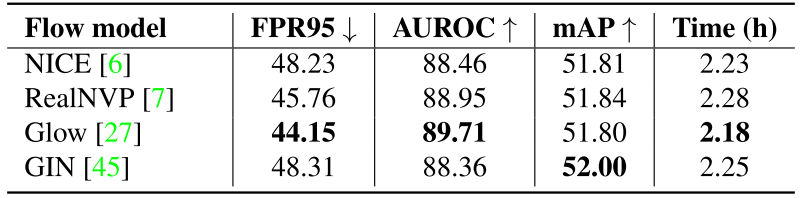
论文 Table 5:NICE、RealNVP、Glow、GIN 四种 Flow 模型对比
Glow 的 FPR95 / AUROC 为 44.15 / 89.71,优于其他 Flow,因此作为默认结构。GIN 的 mAP 最高,但 OD 检测更弱,说明论文的主要目标仍是 outlier detection。
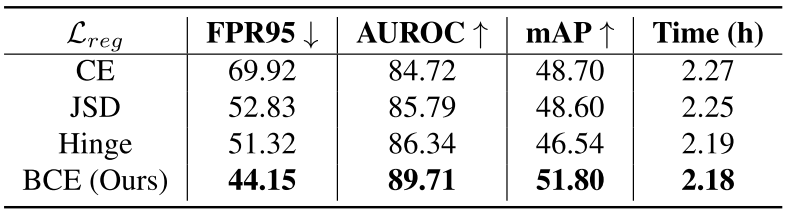
论文 Table 6:CE、JSD、Hinge 与 BCE regularization 对比
BCE () 得到 44.15 FPR95、89.71 AUROC、51.80 mAP;Hinge 为 51.32 FPR95,CE 更达到 69.92。说明性能不仅来自 Flow 采样,Energy surface 如何被正则同样关键。
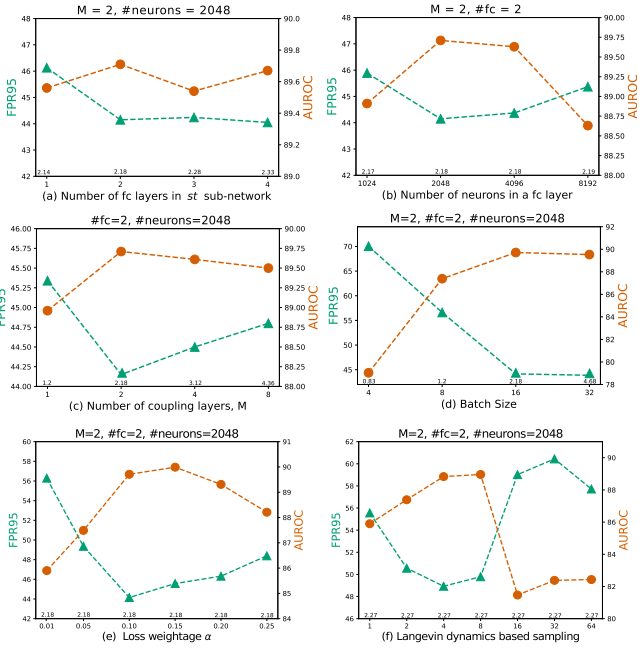
论文 Figure 5:Flow 深度、子网络规模、batch size、(
) 与 projection sampling 消融
作者最终使用 2 个 coupling layers,每个 (s/t) 子网络含 2 个 fc layers、每层 2048 neurons。Flow 并非越深越好,参数增多会增加训练时间并可能导致过拟合;(\alpha) 也存在合适区间,过强 regularization 会使性能下降。
5.5 定性结果
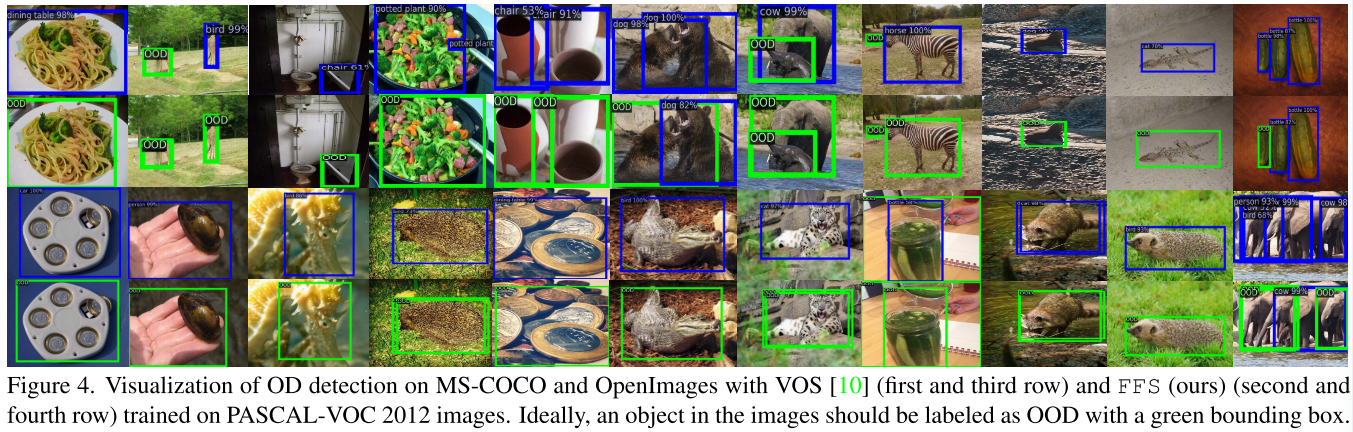
论文 Figure 4:VOS 与 FFS 在 MS-COCO / OpenImages 上的 OD 检测可视化
绿色框表示应该识别为 OOD 的目标。FFS 能识别出更多异常对象;即使两种方法都误分类,FFS 的 softmax confidence 往往更低。这个现象与 Figure 1 中更清晰的 likelihood separation 相互对应。
六、总结与思考
如果把 FFS 压缩成一句话:它用 Normalizing Flow 把 VOS 的"每类独立建模"改成"所有 ID 类联合建模",从而生成对整个 ID manifold 都更可信的 synthetic outliers。
这篇论文真正解决的是一个很具体的问题:低 likelihood 到底是相对于哪个分布而言?多个 class-conditional Gaussian 下,"对 A 异常"可能只是"更像 B";而联合 Flow 将所有 ID 类放进同一个 density model 后,低 likelihood 才更接近"远离整体 ID 分布"。
论文没有单独的 Limitations 章节,结尾将进一步验证其他 OD detector、扩展到 outlier-aware instance segmentation 和 active learning 作为未来方向。从研究思路上看,FFS 最值得记住的是:当真实未知样本不可得时,与其直接猜未知长什么样,不如先更准确地建模"已知整体长什么样",再从低密度区域反推出有价值的未知监督。