先回答标题里那个问题:List 是链表吗?
严格说,3.2 之后的 List 是"链表 + 紧凑数组"拼起来的东西,叫 quicklist。它整体是一条双向链表,但链表的每个节点里装的不是一个元素,而是一整块连续内存,里面塞了很多个元素。所以你说它是链表也对,说是数组也对,得看哪一层。
要讲清楚这个结构,得先看它踩过的两个坑:ziplist 的连锁更新,和纯链表的指针开销。
ziplist
ziplist(压缩列表)是一整块连续内存,从头到尾排了一串元素,没有任何指针:
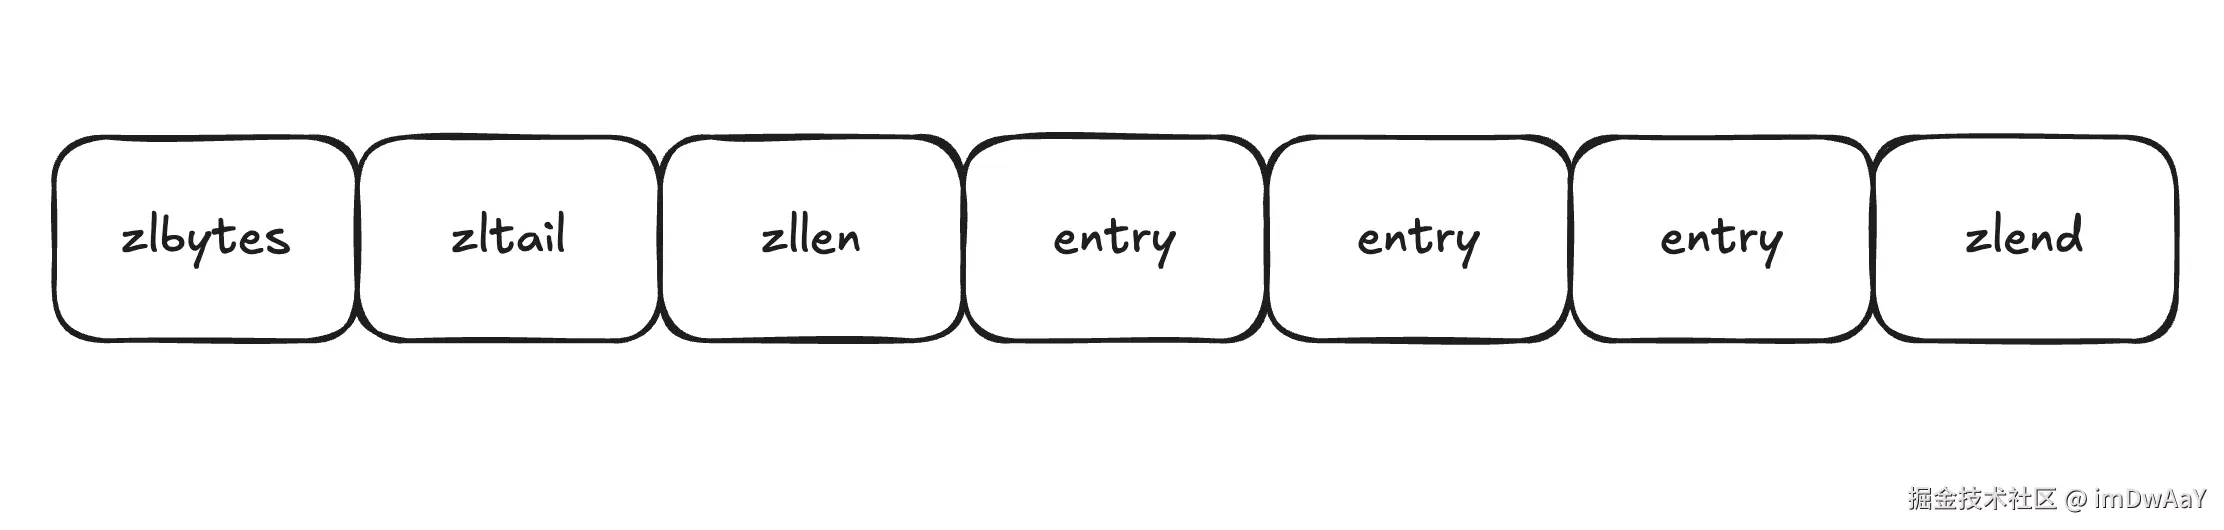
头部三个字段:
zlbytes:整个 ziplist 占多少字节zltail:最后一个 entry 距离起始位置的偏移,有了它,访问尾部不用遍历zllen:entry 的个数,只有 2 字节,所以最大只能表示 65535。超过这个数时,zllen会被写成65535表示"不知道",真实个数得遍历一遍才知道zlend:一个0xFF字节,标记结束
每个 entry 由三部分组成:
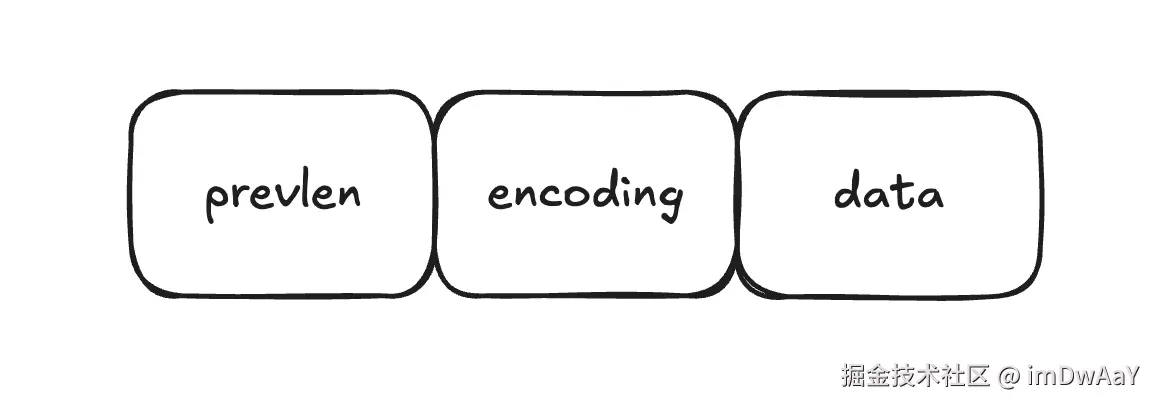
encoding:既标数据类型(整数还是字符串),又标长度。整数有专门的紧凑编码data:实际内容prevlen:前一个 entry 的长度。这一项存在的唯一原因是支持从后往前遍历
ziplist 想从后往前走的时候,自己在哪个位置是知道的,但不知道前一个 entry 的头在哪。prevlen 就是答案,减去它就能跳到前一个 entry。
prevlen 是变长的:
text
前一个 entry 长度 <  254   →  用 1 字节存
前一个 entry 长度 >= 254   →  用 5 字节存(第一个字节是 0xFE,后面跟 4 字节长度)
设计成变长是为了省空间,大部分 entry 都短,1 字节就够了,不用为罕见的长 entry 每次都留 5 字节。
连锁更新
变长的 prevlen 埋了个雷。
假设一个 ziplist 里每个 entry 的内容都是 253 字节,那么每个 entry 的 prevlen 都只要 1 字节(因为前一个 253 < 254),整个 entry 长度是 1 + encoding + 253 这么多。
现在在最前面插一个内容为 254 字节的 entry。第二个 entry 的 prevlen 要记录"前一个 entry 是 254 字节",1 字节装不下了(1 字节能表示的最大值是 253),必须扩成 5 字节,于是第二个 entry 整体长了 4 字节。
第二个 entry 一长,它自己就从 253 左右变成了 257 往上,超过 254 了。那么第三个 entry 的 prevlen 原本记的是 253(1 字节),现在前一个变成 257,也得扩成 5 字节,第三个也长了。接着第四个、第五个......
一次插入可能引发后面一连串 entry 都要扩展,每次扩展还要把后面所有数据 memmove 往后挪。最坏情况是 O(n²)。删除也类似,一个 entry 变短可能让后面一串 prevlen 从 5 字节缩成 1 字节。
连锁更新的根源是
prevlen这个字段:它记录的是别人的长度,所以别人的长度一变,它就得跟着变,一变又影响下一个人。这是一个"每个节点都在描述邻居"的结构必然会有的毛病。
listpack
listpack 是 Redis 7.0 引入的,目的就是干掉连锁更新。它的整体布局和 ziplist 像,也是一整块连续内存:
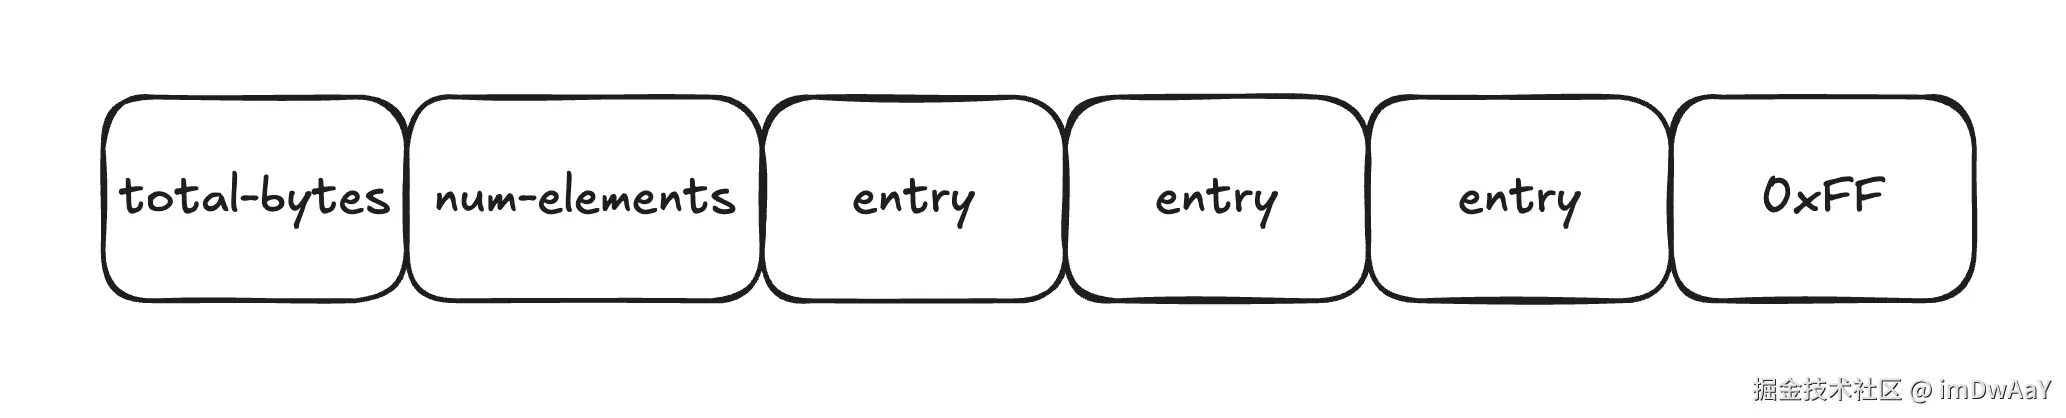
关键在于 entry 的构成变了:
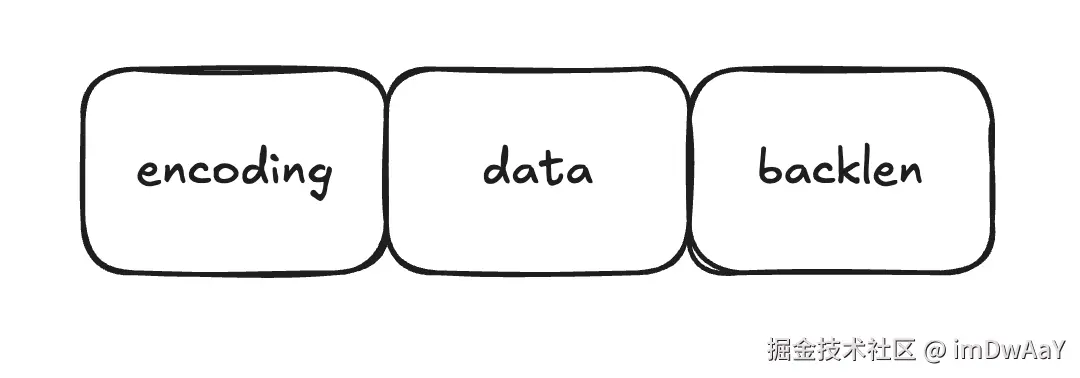
prevlen 没了,换成了一个 backlen。区别在哪:
prevlen存的是前一个 entry 有多长,是描述别人的backlen存的是自己这个 entry 有多长(encoding + data 的长度),是描述自己的
存自己的长度,插入、删除一个 entry 就只影响它自己,不会波及邻居,连锁更新从根上没了。那反向遍历怎么办?backlen 就是干这个的:从后往前走的时候,当前 entry 的起始位置减去它自己的 backlen,就落到了前一个 entry 的末尾,再按 backlen 的长度规则往回退,就能定位到前一个 entry。
一个字段的语义从"记录邻居"换成"记录自己",问题就解决了。listpack 具体被哪些类型用,第 1 篇 里那张编码表已经列过,Hash、ZSet、Set 的小对象,加上 List 的每个节点,用的都是它。
quicklist
有了 listpack,单个紧凑数组的问题解决了,但 List 还面临一个更大的选择:整条 List 到底用一个 listpack 装,还是用链表一个元素一个节点。
两种极端都不行:
- 整条 List 一个 listpack:元素一多,往中间插入或删除要
memmove一大块内存,是 O(n);而且 Redis 对单个 listpack 有大小上限,撑不住很长的 List - 纯链表,一个元素一个节点:每个节点要两个指针(
prev、next,64 位上 16 字节),再加节点本身的头,元素可能就十几个字节,指针开销比数据还大
quicklist 是这两者的折中:用链表分段,每一段是一个 listpack。
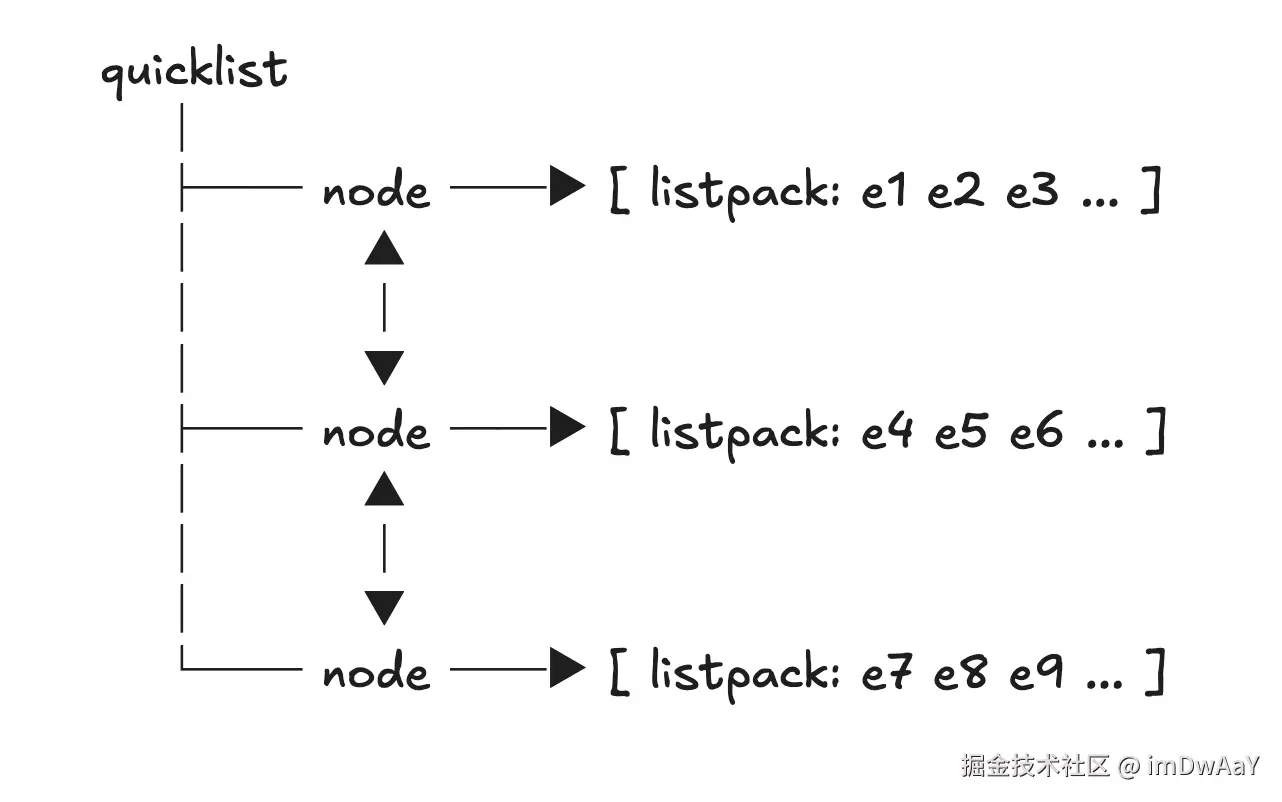
节点结构大概是这样:
c
typedef struct quicklist {
    quicklistNode *head;
    quicklistNode *tail;
    unsigned long count;     // 所有元素总数,LLEN 直接读它
    unsigned long len;       // 节点个数
    int fill;                // 对应 list-max-listpack-size
    unsigned int compress;   // 压缩深度,对应 list-compress-depth
} quicklist;

typedef struct quicklistNode {
    struct quicklistNode *prev, *next;
    unsigned char *entry;    // 指向 listpack(7.0 之前是 ziplist)
    size_t sz;               // listpack 占的字节数
    unsigned int count;      // 这个 listpack 里有几个元素
    unsigned int container;  // PACKED 或 PLAIN
    ...
} quicklistNode;
这样链表只管"段和段之间",元素在段内是紧凑排列的。指针开销从"每个元素 16 字节"降到"每 128 个元素 16 字节",可以忽略;段内还是连续内存,CPU 缓存友好。
两个参数
list-max-listpack-size。 控制每个节点的容量:
text
正数 n   →  每个节点最多 n 个元素(默认 128)
-1      →  每个节点最大 4KB
-2      →  每个节点最大 8KB
-3 / -4 / -5  →  16KB / 32KB / 64KB
正数按个数切,负数按字节数切。默认 128 是走出来的折中:节点太小指针开销占比高,节点太大中间插入的 memmove 又变慢。
list-compress-depth。 控制节点压缩(LZF):
text
0  →  不压缩(默认)
1  →  链表首尾各 1 个节点不压,中间的压缩
2  →  首尾各 2 个不压,中间的压缩
...
为什么不压首尾?因为 LPUSH、RPUSH、LPOP、RPOP 这些命令都在两头操作,压了就又得频繁解压。中间的节点一般不会被碰到,压起来省内存,代价是访问时解压。默认不压缩是因为压缩本身要花 CPU,很多场景用不上。
两端操作与中间访问
quicklist 这个结构决定了 List 的性能特点。
两头的操作是 O(1)。head 和 tail 指针直接指向首尾节点,LPUSH、RPUSH、LPOP、RPOP 定位到节点之后在 listpack 的首尾插删,都是常数时间。LLEN 也是 O(1),因为 quicklist.count 一直维护着元素总数。
中间的操作就慢了。LINDEX、LINSERT、LSET 这些是 O(n),要分两步:
- 沿着链表走,找到目标元素在哪个节点。这一步 Redis 会先看下标靠近头还是靠近尾,从近的那头走,平均走一半
- 在节点内的 listpack 里继续走,直到目标位置
所以 List 的定位是明确的:
| 操作 | 复杂度 | 说明 |
|---|---|---|
LPUSH RPUSH LPOP RPOP |
O(1) | 两端,quicklist 的主场 |
LLEN |
O(1) | 读 count |
LINDEX LINSERT LSET |
O(n) | 要先走到那个位置 |
LRANGE key start stop |
O(S+N) | S 是 start 的偏移,N 是要取的元素数 |
LREM |
O(n) | 要遍历找匹配的元素 |
用 List 的时候,尽量只碰两头。当队列、当栈、当最新列表,都是两头的操作,正合适。如果业务需要频繁按位置访问中间的元素,比如"取第 500 个",那 List 就不合适,得换成 ZSet 或者别的能按位置快速定位的结构。
LINSERT 还有个副作用。往中间插一个元素会让某个 listpack 多一个成员,如果这个节点插满了(到了 list-max-listpack-size),Redis 会把节点拆成两个。频繁往中间插,会不断触发拆分,节点数量涨起来,指针开销也跟着涨。