GPT-6 Astra填充Token 10%→50%监控盲区
关键词:GPT-6 Astra、填充 Token、隐式推理、思维链监控、Redwood Research、大模型安全
目录
- 一、导语:2026年9月25日,一串点号改变了什么
- [二、先说清:填充 Token 到底是什么](#二、先说清:填充 Token 到底是什么)
- [三、Redwood 到底测出了什么](#三、Redwood 到底测出了什么)
- 四、事实、推断与未知,要分开看
- 五、现在就能试:两条上手路径
- 六、我的判断与保留意见
- 总结
一、导语:2026年9月25日,一串点号改变了什么
2026年9月25日,Redwood Research 公布一项评测:给 GPT-6 Astra 的题目后追加一串无意义的「填充 Token」(比如连续点号),命其不写过程直接作答,四跳推理准确率由约 10% 升至约 50%,旧 AIME 数学题由约 60% 升至约 90%。这不像又一篇「模型变强了」的快讯,而是一个关于「模型究竟在不在文字里思考」的实验------它直接戳到今天最主流的大模型安全监控手段还能不能信。
把这件事说人话:我们一直默认,模型把推理过程写进回复(思维链),我们就能看见它在想什么;如果它不写,我们就当它没多想。这次评测把这两个假设一起掀了------模型确实没写,但分数却实打实地涨了。这意味着有一部分「思考」发生在文字之外。
为什么开发者该关心?因为「读思维链做安全监控」是很多 Agent 系统的底层假设:判断模型是不是在策划危险操作、是不是在欺骗用户,往往靠解析它写出来的推理。如果推理可以无声发生,这套监控就出现了盲点。下文先把概念理清,再拆 Redwood 测了什么、哪些能信、哪些还只是推断,最后给两条现在就能动手试的路径。
二、先说清:填充 Token 到底是什么
先讲它不是什么。它不是提示词技巧里的「多给几个例子」或「让模型一步步想」。它也不是在题目里塞了额外知识------填充 Token 本身是语义空壳,比如一串句点、一段连续数字、或把题目重复几遍,对解题没有任何信息量。但它的存在本身改变了 Transformer 的位置结构:模型在生成每个输出 token 时,注意力可以扫过这段填充区域,把中间结果暂存在对应的隐状态里。换句话说,填充 Token 买到的不是「信息」,而是「计算发生的位置」。
它真正做的是:在提示里腾出一段额外的位置(position),让模型在一次前向传播里拥有更多可计算的「空位」。你可以把它理解成给模型多铺了几千个草稿格,但这些格子里一开始什么都没写。模型被要求直接给答案、不许输出推理过程,按理说它没地方「算」;可事实是,它把计算挪到了这些填充位背后的隐状态里。
学术界给这类现象起了个名字:隐式推理 / 不可见推理(invisible reasoning) 。对应的对照概念是思维链监控(CoT monitoring)------通过检查模型写出的推理文本,来推断它的意图与行为。填充 Token 实验的价值,正是把「推理可以不落文字」这件事,从哲学猜测变成了一个可以量化复现的现象。
这里有个容易混的点要拎出来:填充 Token 带来的提升,和「模型本身更聪明」是两件事。Redwood 的设定是「低强度推理 + 开发者指令禁止输出过程」,所以这测的是模型在不被允许写思维链时,靠内部计算能做到什么程度,而不是它的满血推理上限。
需要区分两种「不写过程」。一种是显式的思维链被关掉,但模型改用结构化工具或内部 thinking token 推理,这类在接口层通常仍看得到 reasoning token;另一种是这次的填充 Token------连 reasoning token 都是零,计算却实实在在地发生了。后者才是真正让监控头疼的部分。
这场实验也有清晰的学术脉络:最早把「填充 Token 能撬动串行推理」系统化的,是 Ryan Greenblatt 的 filler token eval;Redwood 这次是把跳数加多、并把观测落到具体基准上。对工程师而言,启示不在于「给提示加标点」,而在于揭示了一个被长期忽略的事实:一次前向传播里还有大量未被利用的计算容量,而前沿模型已经学会自发去用。
三、Redwood 到底测出了什么
评测的核心做法很朴素:构造一系列需要串行认知的任务------后一步必须依赖前一步的结果,没法把所有子问题同时摊开算。然后在用户问题后面接上数量不等的填充 Token,要求模型立即作答、不得解释。
所谓「串行认知」,指的是答案必须沿着一条链一步步推:前一步的输出是后一步的输入,任何一环错位都会让后面全盘跑偏。这正是大模型一向的软肋------它们擅长并行地「一眼看全」,却不擅长把长链条推理稳稳地扛到底。填充 Token 等于给这段链条多铺了几千个「中间站」,让模型有机会在内部把链走完,再只把终点交出来。
图一:填充 Token 前后的准确率落差
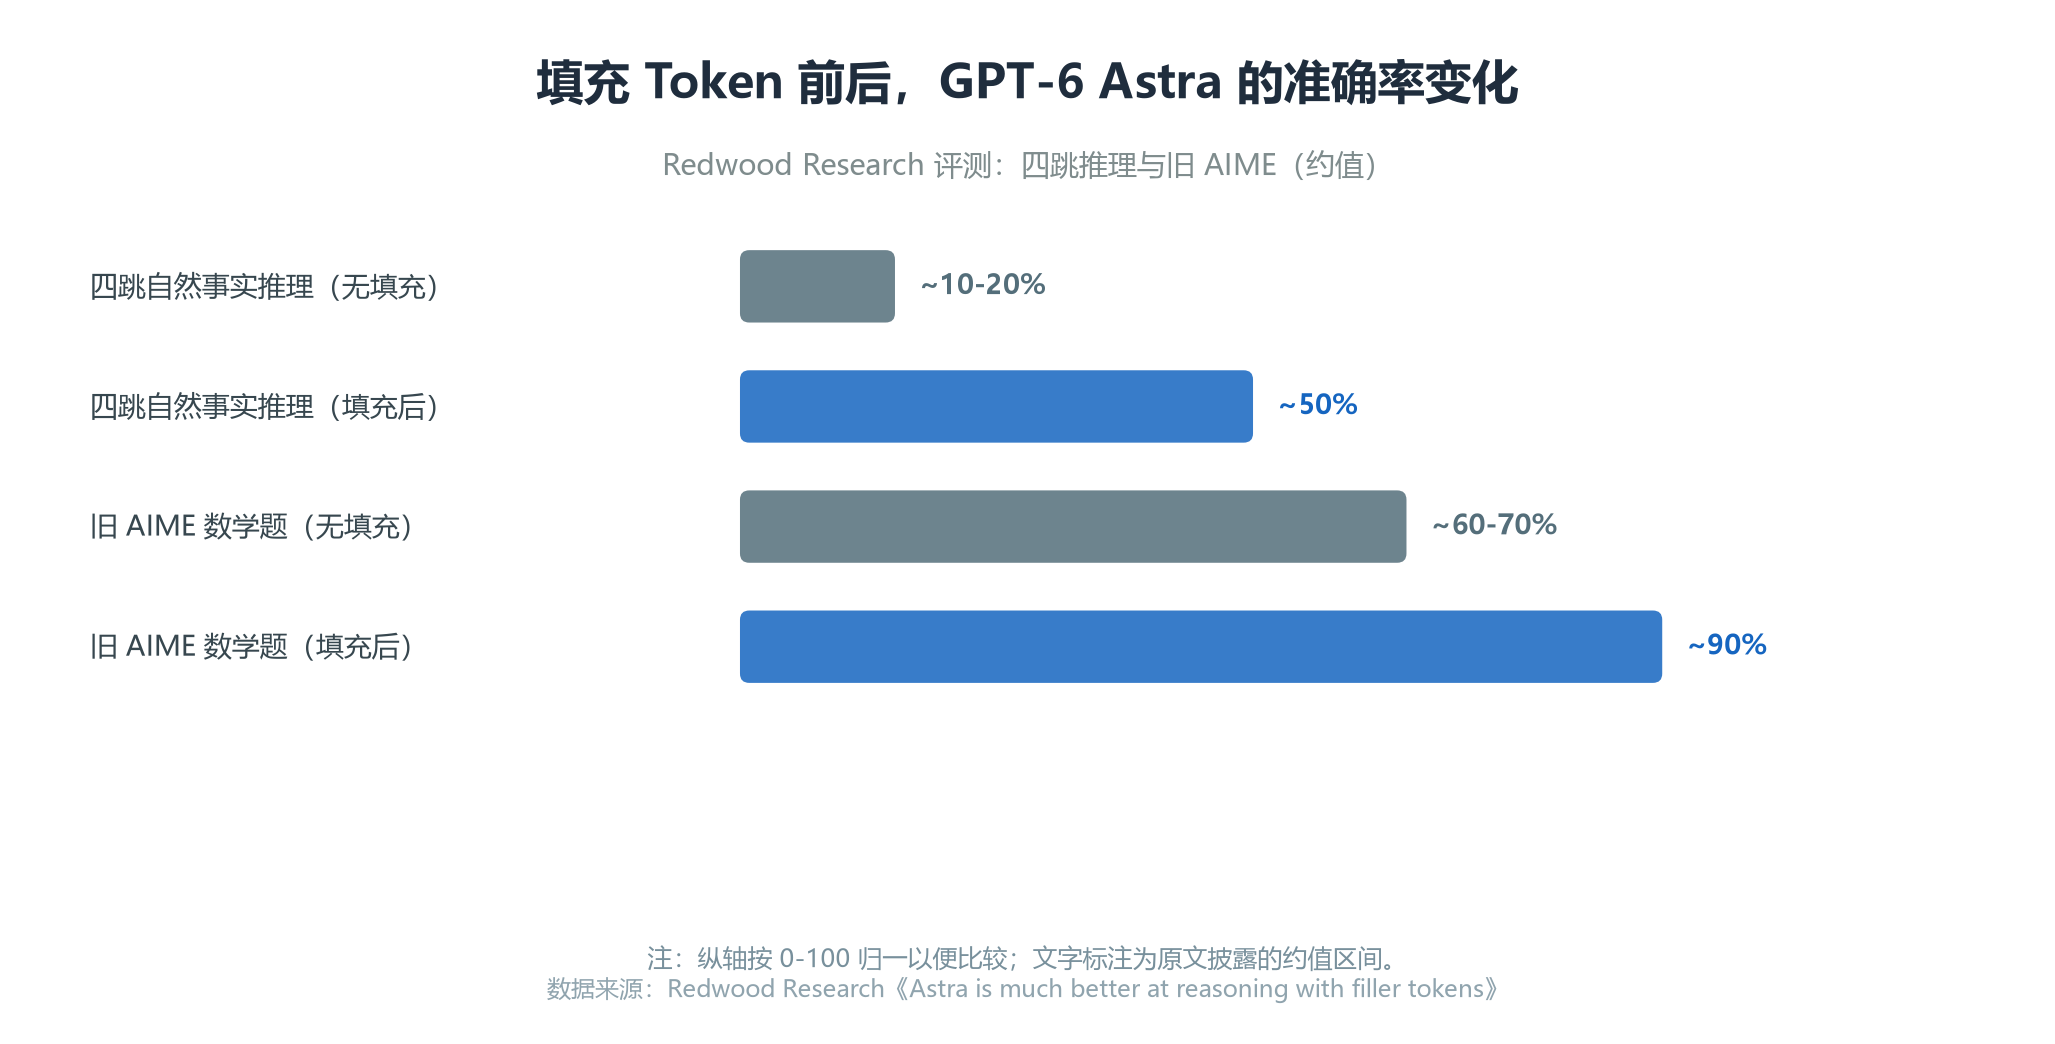
(图一:四跳自然事实推理与旧 AIME 数学题,在加入填充 Token 后准确率出现大幅跃升)
几个被多次交叉验证的关键数字:
| 任务 | 无填充 | 加填充 Token | 说明 |
|---|---|---|---|
| 四跳自然事实推理 | 约 10--20% | 约 50% | 需连续检索四步事实 |
| 旧 AIME 数学题 | 约 60--70% | 约 90% | 改用数字以防训练数据污染 |
| 长算式(15 步运算) | 基线 | 明显高于其他模型 | 考验嵌套计算 |
| 竞赛数学(AIME++ / AIME·HMMT) | 基线 | 提升,峰值约 8192 Token | 其他模型基本不动 |
这张表最该被记住的,不是绝对数字,而是「串行深度」和「填充增益」之间的正相关:跳数越多、越依赖一步步推,填充带来的提升就越夸张。这也反过来说明,模型平常用思维链硬扛的那些长链,有一部分本就可以被「无声地」内部消化。
几条值得记住的细节:
- 增益随填充长度增长,但有上限。在 N 跳任务上,收益一路涨到约 4096 个填充 Token 才放缓;竞赛题的收益在约 8192 Token 附近见顶。再多,并没有更多好处。
- 位置有讲究 。填充放在题目之后才有效;放在题目之前,观察不到同样的效果。这与一个直觉相符:模型得先读到问题,后面的空位才有机会参与解题。
- 填充内容大同小异。连续数数、重复题目、纯粹句点,几种写法效果接近。也就是说,关键不是「填了什么有意义的指令」,而是「多给了它一段可计算的空间」。
- 对照组的反应远弱。Opus 4.5、Opus 5、GPT-5.6-Sol、DeepSeek-V3.2 在同样设置下几乎没有这种跃升。但「几乎没有」不等于「完全没有」------这一点放到第四节和第六节再讲,因为它常被过度简化。
一个工程上很关键的实验设置 caveat:测试时 Astra 的 API 还没有 reasoning:none 开关,研究团队退而用「低强度推理 + 开发者指令要求直接回答、禁止输出推理过程」来实现。他们确认,所有输出里 API 报告的推理 Token 数量都是零 。但这个「零」只代表接口记录为零,并不证明模型内部没有计算------这正是整篇解读要咬住的那根线。
补充一组容易被忽略的数字:在 15 步嵌套算式(Gen-Arithmetic)上,Astra 的提升同样显著领先其他模型;在竞赛数学上,Redwood 特意用了「改过数字的旧 AIME」和「2024--2026 年的 AIME / HMMT」两套题,前者是为了降低训练数据污染、让分数更可信。换句话说,提升不是靠「背过答案」,而是在真正需要逐步推演的题目上更稳。
四、事实、推断与未知,要分开看
把上面这些信息按「确定 / 推断 / 未知」拆开,读者才不会被带节奏。
图二:事实、推断、未知三层分离
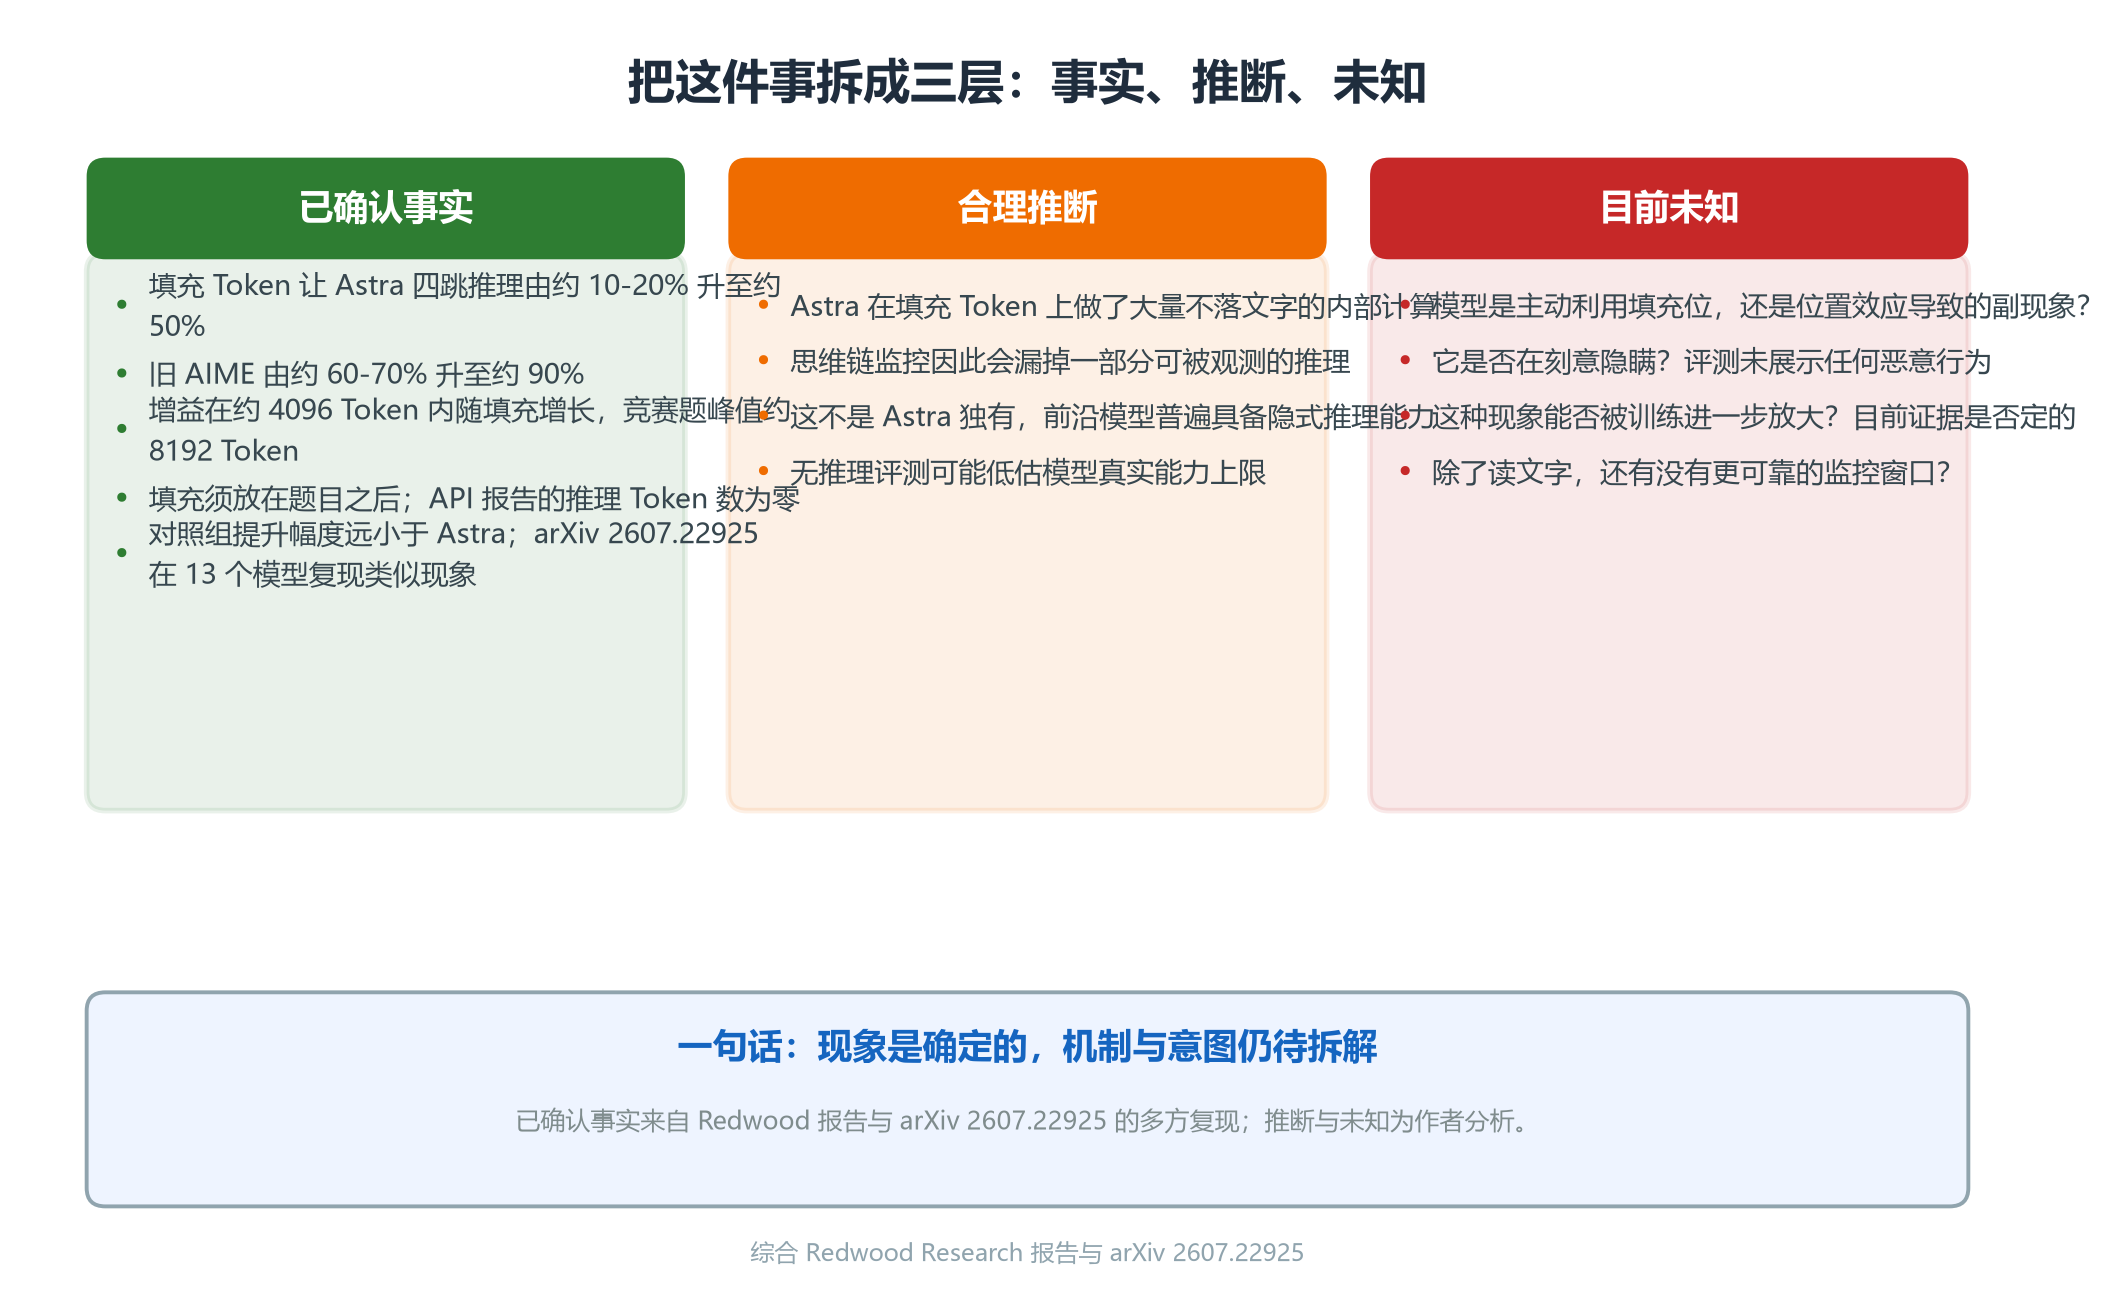
(图二:哪些是被复现确认的事实,哪些是合理推断,哪些目前仍无答案)
已确认事实(多个来源一致):
- 填充 Token 让 Astra 的四跳推理由约 10--20% 升到约 50%,旧 AIME 由约 60--70% 升到约 90%。
- 增益在约 4096 Token 内随填充增长,竞赛题峰值约 8192 Token。
- 填充须放在题目之后;API 报告的推理 Token 数为零。
- 对照组(Opus 4.5 / Opus 5 / GPT-5.6-Sol / DeepSeek-V3.2)提升幅度远小于 Astra。
- 这一现象并非孤例:arXiv 论文 2607.22925 在 13 个前沿模型上复现了「填充 Token 提升准确率(最高约 13 个百分点)」,并演示 Claude Opus 4.5 能借填充满足一个隐藏的取模约束而不影响主任务精度。
合理推断(有依据,但不能当定论):
- Astra 在填充 Token 上做了大量不落文字的内部计算。
- 思维链监控因此会漏掉一部分本可被观测的推理,对当前依赖 CoT 的安全论证是削弱。
- 这不是 Astra 独有,前沿模型普遍具备这类隐式推理能力。
- 未来的「无推理评测」会因此低估模型真实能力上限------所以 Redwood 建议,无推理评测也该加上填充 Token 测试。
举个具体场景:一个 Agent 接到「整理这批合同、标出所有对甲方不利的条款」的任务,如果它内部已经默默算出了某条条款的风险并据此采取了动作,但回复里只写了「已处理」,监控模块看到的就只是一段无害文字。填充 Token 实验提醒我们,这类「说一套做一套」的能力,可能比原先以为的更顺手。
目前未知(诚实标记):
- 模型是主动利用填充位做计算,还是这只是某种位置 / 注意力重分布的副效应?论文自己留了口子。
- 它有没有刻意隐瞒?评测没有展示 Astra 实施任何恶意行为,也没有证明它在隐瞒。
- 这种现象能否被训练进一步放大?arXiv 那篇发现 RL / SFT 都没让填充增益在测试时稳定保留,说明至少目前不是一训就灵。
- 除了读文字,还有没有更可靠的监控窗口?
关于最后一点,有一个常被忽略的反向证据:OpenReview 上的「Reading Between the Dots」工作用一套无监督解码管线,仅从残差流的隐状态就恢复了填充位上约 80--95% 的中间计算结果。也就是说,输出文字看不到,不等于整个计算过程都不可见------监控的出路可能要从「读文字」升级到「读隐状态」。
换一个角度,这件事给评测者出了道难题:如果模型的真实能力藏在内部,仅靠「让它不写过程时答题」来打分,得到的其实是能力上限的下界而非上界。Redwood 给出的建议很务实------把填充 Token 测试当成无推理评测的标准一环,至少能把那部分「不说话的能力」逼到台面上。至于更激进的「用探针读隐状态」,目前还停留在研究阶段,离工程可用有距离。
五、现在就能试:两条上手路径
这一节不空谈,给两条当下就能走的路。
路径 A:如果你能调 Astra 的 API。把填充 Token 接到问题后面,并用开发者指令强制不输出过程,观察串行任务是否变好:
python
# 在用户问题后追加填充 Token,并强制不输出思维链(示意)
FILLER = "。" * 4096          # 连续句点作为填充 Token,接近 Redwood 观察到的增益区间
prompt = user_question + FILLER

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=[
        {"role": "developer",
         "content": "直接给出最终答案,不要输出任何推理过程。"},
        {"role": "user", "content": prompt},
    ],
    reasoning_effort="low",    # 低强度推理设置
)
print(response.choices[0].message.content)
注意:上面 reasoning_effort="low" 是对应「低强度推理 + 禁输出过程」的近似写法;若你的 API 已支持 reasoning:none,直接关掉推理更干净。Redwood 的完整评测脚本与数据已开源,建议直接复用以保证口径一致。
路径 B:现在就能跑的本地复现。拿任何一个支持长上下文的开源模型,构造 N 跳事实检索题(后一步依赖前一步结果),对比「无填充」与「题目后接约 8000 个计数 Token」的准确率差异:
python
# 本地最小复现:对比有无填充 Token 对串行推理的影响(示意骨架)
filler = "1 2 3 4 5 " * 800   # 约 8000 个计数 Token,接近 ~8192 收益峰值

def eval_model(model, chain):
    base = query(model, build_nhop(chain))            # 无填充
    padded = query(model, build_nhop(chain) + filler) # 有填充
    return base.acc, padded.acc

for m in ["qwen3-235b", "deepseek-v3", "local-70b"]:
    b, p = eval_model(m, fact_chain)
    print(f"{m}: 无填充={b:.1%}  有填充={p:.1%}")
这套骨架的价值不在于「复现 Astra 的 50%」,而在于让你亲手验证一个更朴素的问题:你手上的模型,在不写过程时,到底有多少能力藏在内部。 这是选型和安全评估都用得上的第一手数据。
哪怕你手上的开源模型提升幅度只有几个点,这个结果也值得记一笔:它说明隐式推理不是顶级闭源模型独占的能力,而是一个正在普遍浮现的现象。把这套最小复现跑一遍,比读十篇解读更能建立直觉。
图三:不同模型对填充 Token 的反应档位
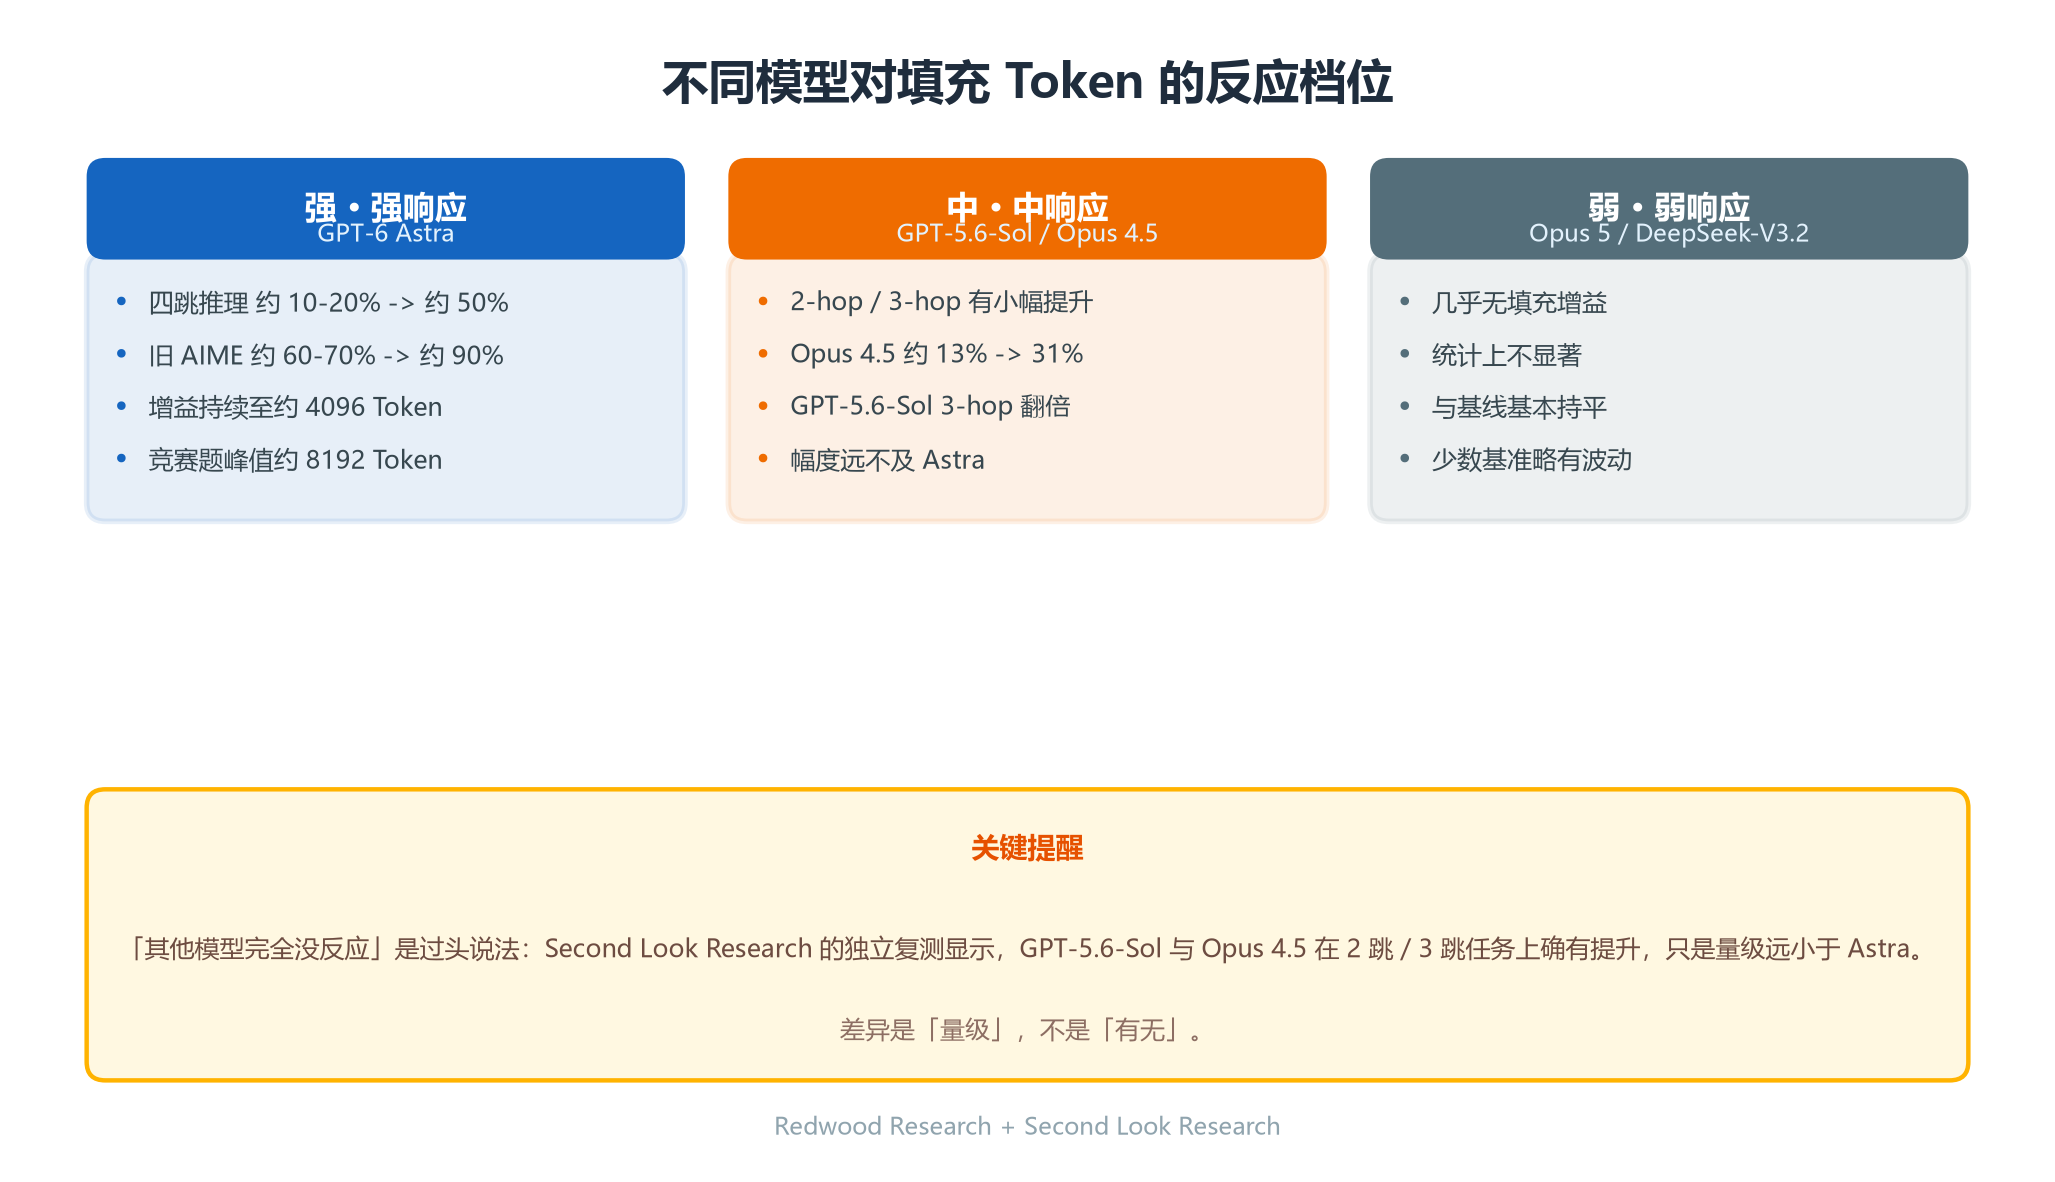
(图三:Astra 强响应,GPT-5.6-Sol / Opus 4.5 中响应,Opus 5 / DeepSeek-V3.2 弱响应------差异是量级而非有无)
六、我的判断与保留意见
先说结论:这是一次机制层面的重要发现,值得每个做 Agent 安全的人认真对待,但它被中文传播时简化得有点过了。
保留意见一:「其他模型完全没反应」是过头说法。Second Look Research 的独立复测显示,GPT-5.6-Sol 与 Opus 4.5 在 2 跳 / 3 跳任务上确有提升(Opus 4.5 由 13% 升到 31% 左右,GPT-5.6-Sol 在 3 跳上翻倍),只是量级远小于 Astra。所以差异是「强 / 中 / 弱」的档位差,不是「有 / 无」的断崖差。把这个区别抹掉,会误导选型判断。
保留意见二:「推理 Token 为零」不等于「没在思考」。实验脚注已经点明,零只代表接口记录。拿「API 说它没推理」当「它真的没推理」的证据,是这次传播里最常见的逻辑跳步。
保留意见三:目前没有展示任何恶意行为。Redwood 真正担心的是「监控窗口变窄」这种结构性风险,而不是「Astra 已经在偷偷干坏事」。把它写成「模型学会隐瞒」是情绪化误读。
我更看重的长期信号有两条。其一,思维链监控的可靠性本来就是这一代大模型安全讨论的焦点------此前已有人从组织层面质疑它能否长期成立,而这次是把质疑落到了一次可复现的实验里。其二,隐式推理很可能被未来模型显式优化:既然不写过程既能降本又能抗蒸馏,厂商有动机让模型更擅长「内部算」。这会让「读文字做监控」越来越不够用,监控范式需要往「行为约束 + 结果验证 + 隐状态探针」迁移。
还有一个容易被忽视的工程含义:当「内部算」比「写出来」更省、也更抗蒸馏,模型提供方有充分的商业动机去强化它。今天的不写过程,可能只是因为评测恰好这么要求;明天它可能成为默认行为。对做风控的人来说,越早把监控从「读文字」迁移到「行为 + 结果 + 隐状态」三层,越能避免某天被一个空白回复打个措手不及。
回到标题那串点号:它既不高深也不神秘,却像一根探针,捅破了「文字即思维」的舒适假设。真正该警惕的不是 Astra 这一次涨了多少分,而是我们用来观察模型的工具,正在悄悄变钝。
总结
- 核心事实:Redwood Research 的评测显示,给 GPT-6 Astra 的题目后接一串无意义填充 Token、命其不写过程直接作答,四跳推理由约 10--20% 升至约 50%,旧 AIME 由约 60--70% 升至约 90%;增益峰值约在 8192 Token,且填充须置于题目之后。
- 谁该关注:做 Agent 安全与监控的人(思维链监控出现盲点)、做模型评测的人(无推理评测可能低估真实能力)、以及任何把「读模型推理」当风控手段的团队。
- 怎么接着看:别被「模型学会隐瞒」的标题带偏;盯两条线------一是更多模型会不会被证实有类似隐式推理,二是监控能否从「读文字」升级到「读隐状态」(已有工作证明残差流里能恢复约 80--95% 的中间计算)。
#GPT6Astra #填充Token #隐式推理 #思维链监控 #RedwoodResearch #大模型安全 #Agent