我曾把员工查经理的 SQL 里的 LEFT JOIN 写成 INNER JOIN,结果 CEO 整个人从报表里消失了,我对着结果数了半小时人头。
这篇文章把自连接、交叉连接、复杂 JOIN 串成一条递进问题链,读完你能独立拆解多层关联查询,并避开我踩过的每一个坑。
一、场景:答案不在另一张表,而在同一张表内部
你写 JOIN 时默认要拼两张表,但如果问题的答案就藏在同一张表里呢?
| 业务场景 | 表结构 | 关联字段指向 |
|---|---|---|
| 员工与经理 | employees(employee_id, name, manager_id) |
manager_id → 本表 employee_id |
| 分类父子层级 | categories(category_id, name, parent_id) |
parent_id → 本表 category_id |
| 同用户同天订单 | orders(order_id, user_id, order_date) |
user_id 相等且 order_date 相等 |
这些场景的共同点,是关联的两方本质上为同一张表的不同行。这种用法叫自连接(Self Join)。
自连接不是新语法,只是在 FROM 子句里给同一张表取两个别名,然后像连接两张表一样连接它们。
那同一张表到底怎么连自己?先看我踩的第一个坑。
二、踩坑:CEO 为什么从结果里消失
我当时的写法,CEO 直接没了:
sql
SELECT e.name AS employee_name,
       m.name AS manager_name
FROM employees e
JOIN employees m
  ON e.manager_id = m.employee_id;
把 JOIN 换成 LEFT JOIN,CEO 回来了:
sql
SELECT e.name AS employee_name,
       m.name AS manager_name
FROM employees e
LEFT JOIN employees m
  ON e.manager_id = m.employee_id;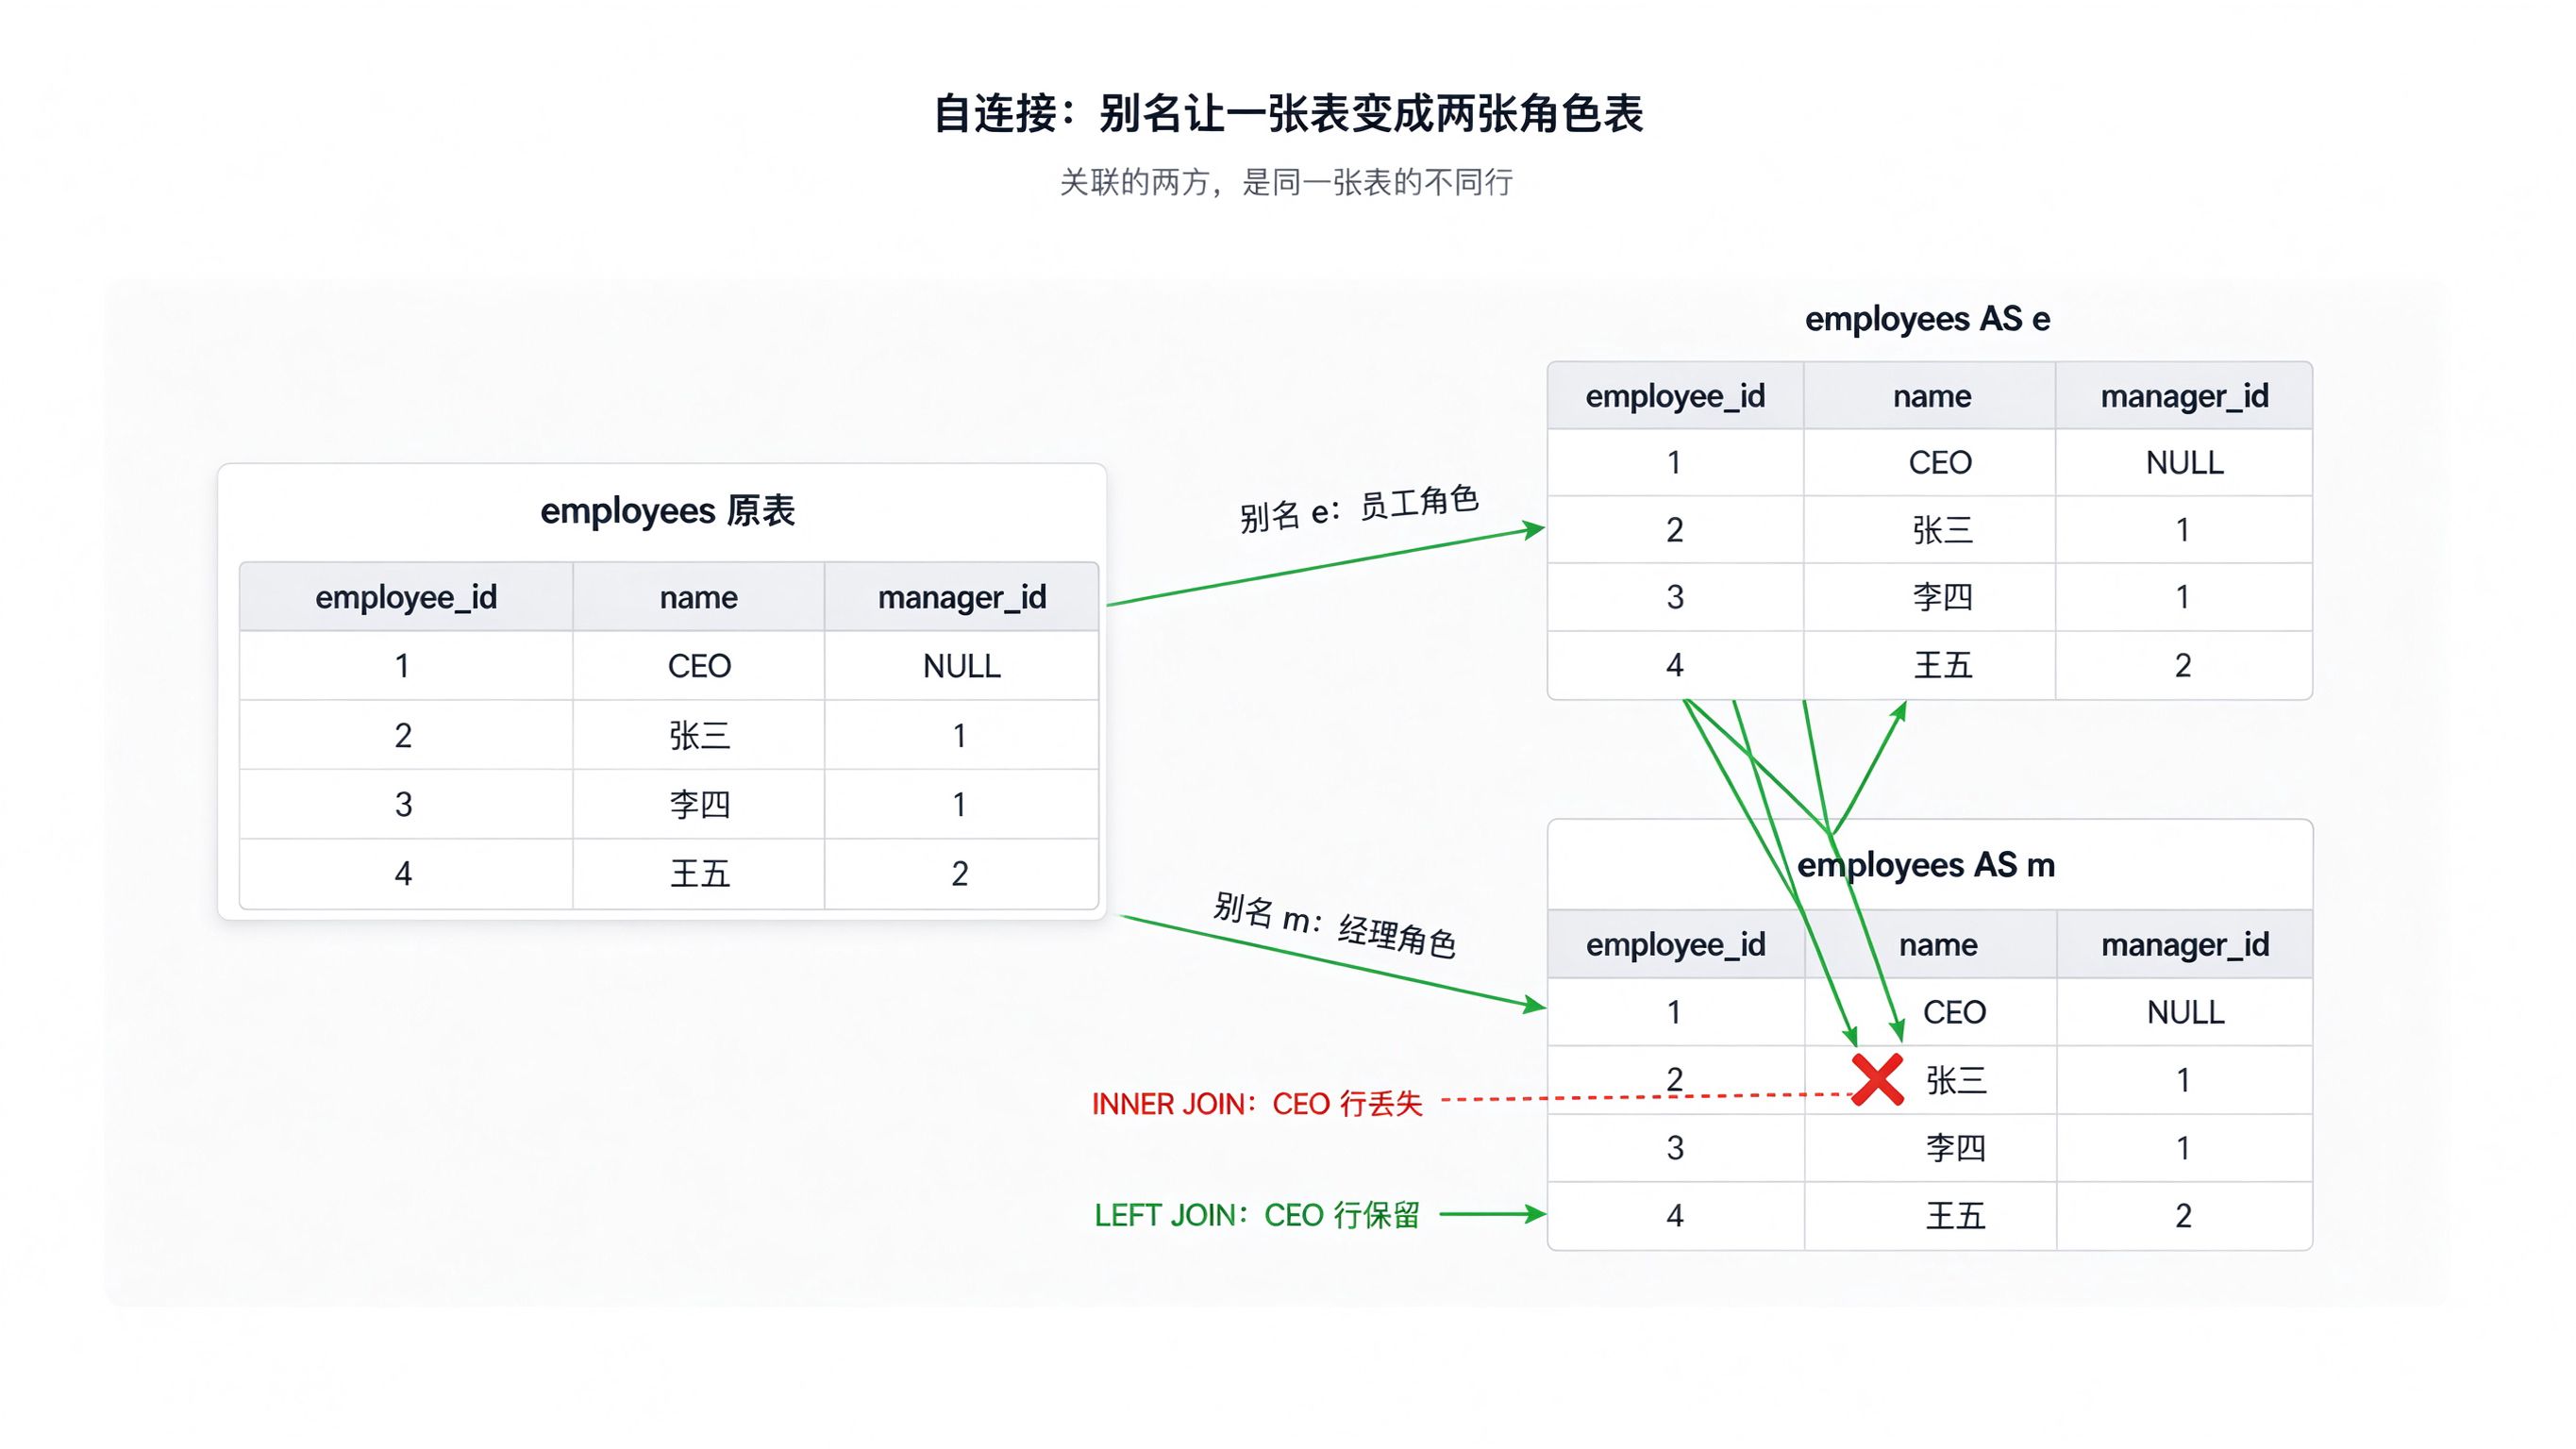
别名让同一张表在逻辑上变成两张表:e 扮演员工,m 扮演经理。CEO 的 manager_id 为 NULL,内连接找不到匹配行,根节点被丢弃;外连接保留左表全部行,右表列填充 NULL。
latex
 employees e                employees m
┌────┬──────┬────────┐     ┌────┬──────┐
│ id │ name │ mgr_id │     │ id │ name │
├────┼──────┼────────┼────►├────┼──────┤
│ 1  │ CEO  │ NULL   │ ✗        无匹配行
│ 2  │ 张三 │ 1      │────►│ 1  │ CEO  │
│ 3  │ 李四 │ 1      │────►│ 1  │ CEO  │
└────┴──────┴────────┘     └────┴──────┘
  INNER JOIN:第 1 行被丢弃
LEFT JOIN:第 1 行保留,右侧为 NULL注意:自连接先定角色,再定连接类型;根节点要保留,就用 LEFT JOIN。
三、比较与去重:同表的行怎么比、怎么不重复
根节点保住了,但同一张表还会遇到两类问题:两行之间怎么比较,重复行怎么找。
| 模式 | 典型问题 | 推荐写法 | 最容易错的点 |
|---|---|---|---|
| 层级查询 | 员工及其经理 | 同表 LEFT JOIN | 内连接丢根节点 |
| 同表比较 | 工资高于部门均值 | 窗口函数 / 子查询 | 比较时漏掉部门条件 |
| 同表去重 | 找同名同邮箱用户 | 同表 JOIN + 不等号 | 不等号方向导致翻倍 |
同表去重的标准写法:
sql
SELECT a.user_id, a.name, a.email
FROM users a
JOIN users b
  ON a.email = b.email
 AND a.user_id < b.user_id;
我在 a.user_id < b.user_id 这个条件上翻过车,三种写法结果完全不同:
| 连接条件 | 自己配自己 | 重复对输出 | 结果行数 |
|---|---|---|---|
a.user_id = b.user_id |
是,全部无效 | --- | 全是噪声 |
a.user_id <> b.user_id |
否 | (1,2) 与 (2,1) 各一次 | 2 倍 |
a.user_id < b.user_id |
否 | 只保留一个方向 | 1 倍 |
同表比较用窗口函数,只需扫描一次表,找工资高于本部门均值的员工:
sql
SELECT name, salary, department_id
FROM (
    SELECT name, salary, department_id,
           AVG(salary) OVER (PARTITION BY department_id) AS avg_salary
    FROM employees
) t
WHERE salary > avg_salary;
要查 CEO 到基层员工的完整层级路径,用递归公用表表达式(Recursive CTE),锚点查询找根,递归部分找下一层:
sql
WITH RECURSIVE org AS (
    SELECT employee_id, name, manager_id, 1 AS level
    FROM employees
    WHERE manager_id IS NULL
    UNION ALL
    SELECT e.employee_id, e.name, e.manager_id, o.level + 1
    FROM employees e
    JOIN org o ON e.manager_id = o.employee_id
)
SELECT * FROM org ORDER BY level, employee_id;还要注意连接方向:e.manager_id = m.employee_id 表示"e 的经理是 m",反写成 m.manager_id = e.employee_id,整条上下级关系就倒了。
注意:自连接去重靠不等号定方向: <** 只留一条,<> 结果翻倍。**
四、交叉连接:漏掉 ON 是灾难,还是另一种原材料
连接条件写错会丢行、会翻倍;那如果干脆不写条件,会发生什么?
我有一次漏写 ON,测试库瞬间返回几十万行,客户端直接卡死。这背后就是交叉连接(Cross Join):不指定任何连接条件,左表每行与右表每行逐一配对,结果为笛卡尔积(Cartesian Product),行数等于 m × n。
| 左表 m 行 | 右表 n 行 | 结果 m × n 行 |
|---|---|---|
| 10 | 10 | 100 |
| 1,000 | 1,000 | 1,000,000 |
| 100,000 | 100,000 | 10,000,000,000 |
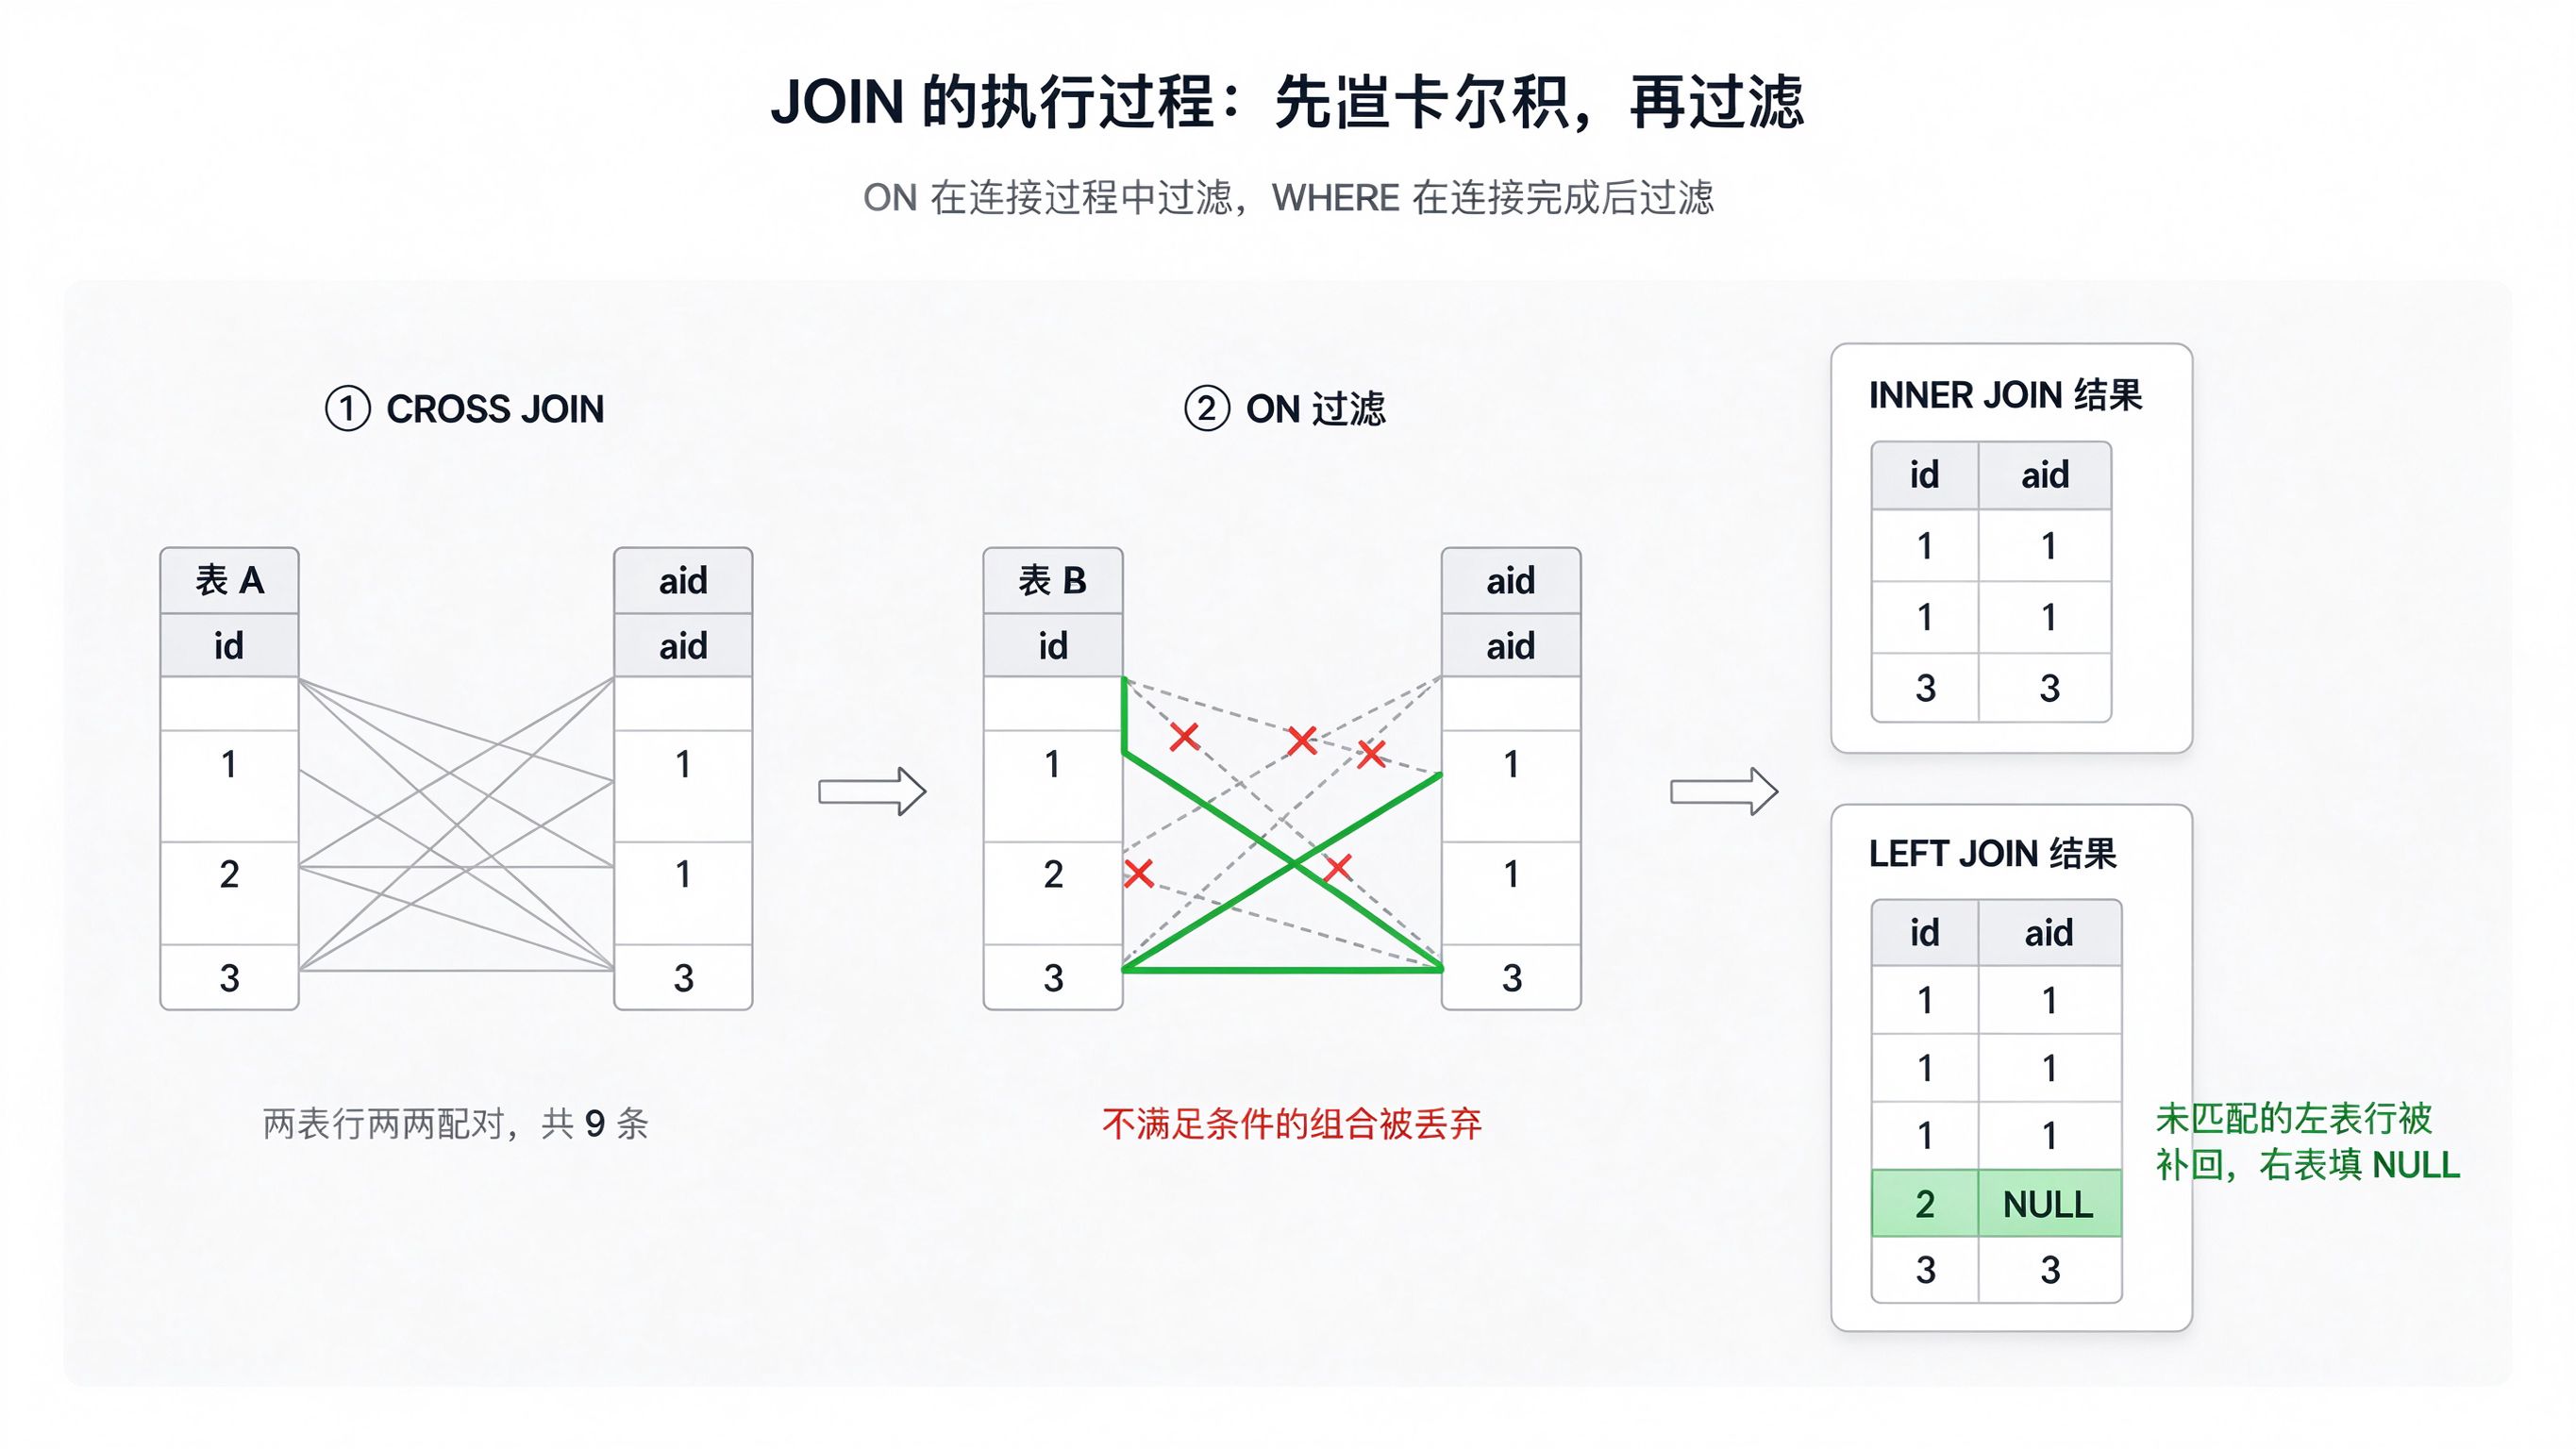
所有 JOIN 都等价于"先做交叉连接,再按条件过滤"。内连接过滤后即为结果;外连接再把未匹配的左表行补回,右表列填 NULL。
交叉连接的合法用途:
- 生成组合:颜色表 × 尺寸表,直接生成电商 SKU
- 生成序列:数字表自交叉得到 100 个数,再配合日期函数补齐缺失日期
- 理解
ON与WHERE:ON在连接过程中过滤,WHERE在连接完成后过滤;内连接下两者等价,外连接下结果可能完全不同
生成颜色与尺寸的全部组合:
sql
SELECT c.color, s.size
FROM colors c
CROSS JOIN sizes s;
用数字表交叉连接生成 1 到 100 的序列:
sql
WITH digits AS (
    SELECT 0 AS d UNION ALL SELECT 1 UNION ALL SELECT 2
    UNION ALL SELECT 3 UNION ALL SELECT 4 UNION ALL SELECT 5
    UNION ALL SELECT 6 UNION ALL SELECT 7 UNION ALL SELECT 8
    UNION ALL SELECT 9
)
SELECT a.d + b.d * 10 + 1 AS n
FROM digits a
CROSS JOIN digits b
ORDER BY n;
控制风险只有一条:先用 CTE 过滤、降数据量,再 CROSS JOIN,绝不让两张原始大表直接交叉。
注意:交叉连接是 JOIN 的原材料,不是废物;但大表直接交叉,等于给数据库埋雷。
五、复杂 JOIN:三个真实业务案例,逐个拆
单点都清楚了,可真实业务是多层关联叠在一起,该怎么下手?
案例一:找出每个部门工资最高的员工及其经理。
latex
employees
   │ GROUP BY department_id
   ▼
dept_max(部门最高工资)
   │ JOIN  e.department_id = dm.department_id
   │  AND  e.salary = dm.max_salary
   ▼
JOIN departments        ── 取部门名
   ▼
LEFT JOIN employees m   ── 取经理名
sql
WITH dept_max AS (
    SELECT department_id, MAX(salary) AS max_salary
    FROM employees
    GROUP BY department_id
)
SELECT e.name AS employee_name,
       e.salary,
       d.department_name,
       m.name AS manager_name
FROM employees e
JOIN dept_max dm
  ON e.department_id = dm.department_id
 AND e.salary = dm.max_salary
JOIN departments d
  ON e.department_id = d.department_id
LEFT JOIN employees m
  ON e.manager_id = m.employee_id;
我漏过 department_id 条件,只写 salary = max_salary,结果别的部门同薪资的员工被串了进来。"本部门"和"最高工资"两个条件必须同时成立。
案例二:分类树展开祖先路径,并统计每个分类的商品数。
sql
WITH RECURSIVE category_tree AS (
    SELECT category_id, name, parent_id, name AS path
    FROM categories
    WHERE parent_id IS NULL
    UNION ALL
    SELECT c.category_id, c.name, c.parent_id,
           CONCAT(ct.path, ' > ', c.name)
    FROM categories c
    JOIN category_tree ct ON c.parent_id = ct.category_id
)
SELECT ct.category_id, ct.name, ct.path,
       COUNT(p.product_id) AS product_count
FROM category_tree ct
LEFT JOIN products p ON p.category_id = ct.category_id
GROUP BY ct.category_id, ct.name, ct.path
ORDER BY ct.path;
LEFT JOIN 保证没有商品的分类不消失;COUNT(p.product_id) 统计的是商品数,写成 COUNT(*) 会把补出来的 NULL 行也算进去。
案例三:找出连续下单的用户。连续两天用自连接:
sql
SELECT DISTINCT a.user_id, a.order_date
FROM orders a
JOIN orders b
  ON a.user_id = b.user_id
 AND b.order_date = DATE_ADD(a.order_date, INTERVAL 1 DAY);
连续三天再自连接就很绕,用窗口函数 LAG 更清晰:
sql
WITH daily AS (
    SELECT DISTINCT user_id, order_date
    FROM orders
)
SELECT user_id, order_date
FROM (
    SELECT user_id, order_date,
           LAG(order_date, 1) OVER (PARTITION BY user_id ORDER BY order_date) AS prev_date,
           LAG(order_date, 2) OVER (PARTITION BY user_id ORDER BY order_date) AS prev2_date
    FROM daily
) t
WHERE prev_date  = DATE_SUB(order_date, INTERVAL 1 DAY)
  AND prev2_date = DATE_SUB(order_date, INTERVAL 2 DAY);
从"能跑"到"可维护",手段就这四类:
| 手段 | 做法 | 作用 |
|---|---|---|
| CTE 拆分 | 每步中间结果命名 | 可读、可单独调试 |
| 窗口函数 | AVG OVER、LAG、LEAD |
单次扫描,替代部分自连接 |
| 索引 | manager_id、department_id、user_id 等连接字段 |
连接提速可达数量级 |
| EXPLAIN | 查看执行计划 | 确认驱动表与连接顺序 |
注意:复杂 JOIN 不靠一把梭,靠 CTE 拆解;每步有名字,才谈得上可维护。
六、总结延伸:JOIN 没有玄学,只有三步
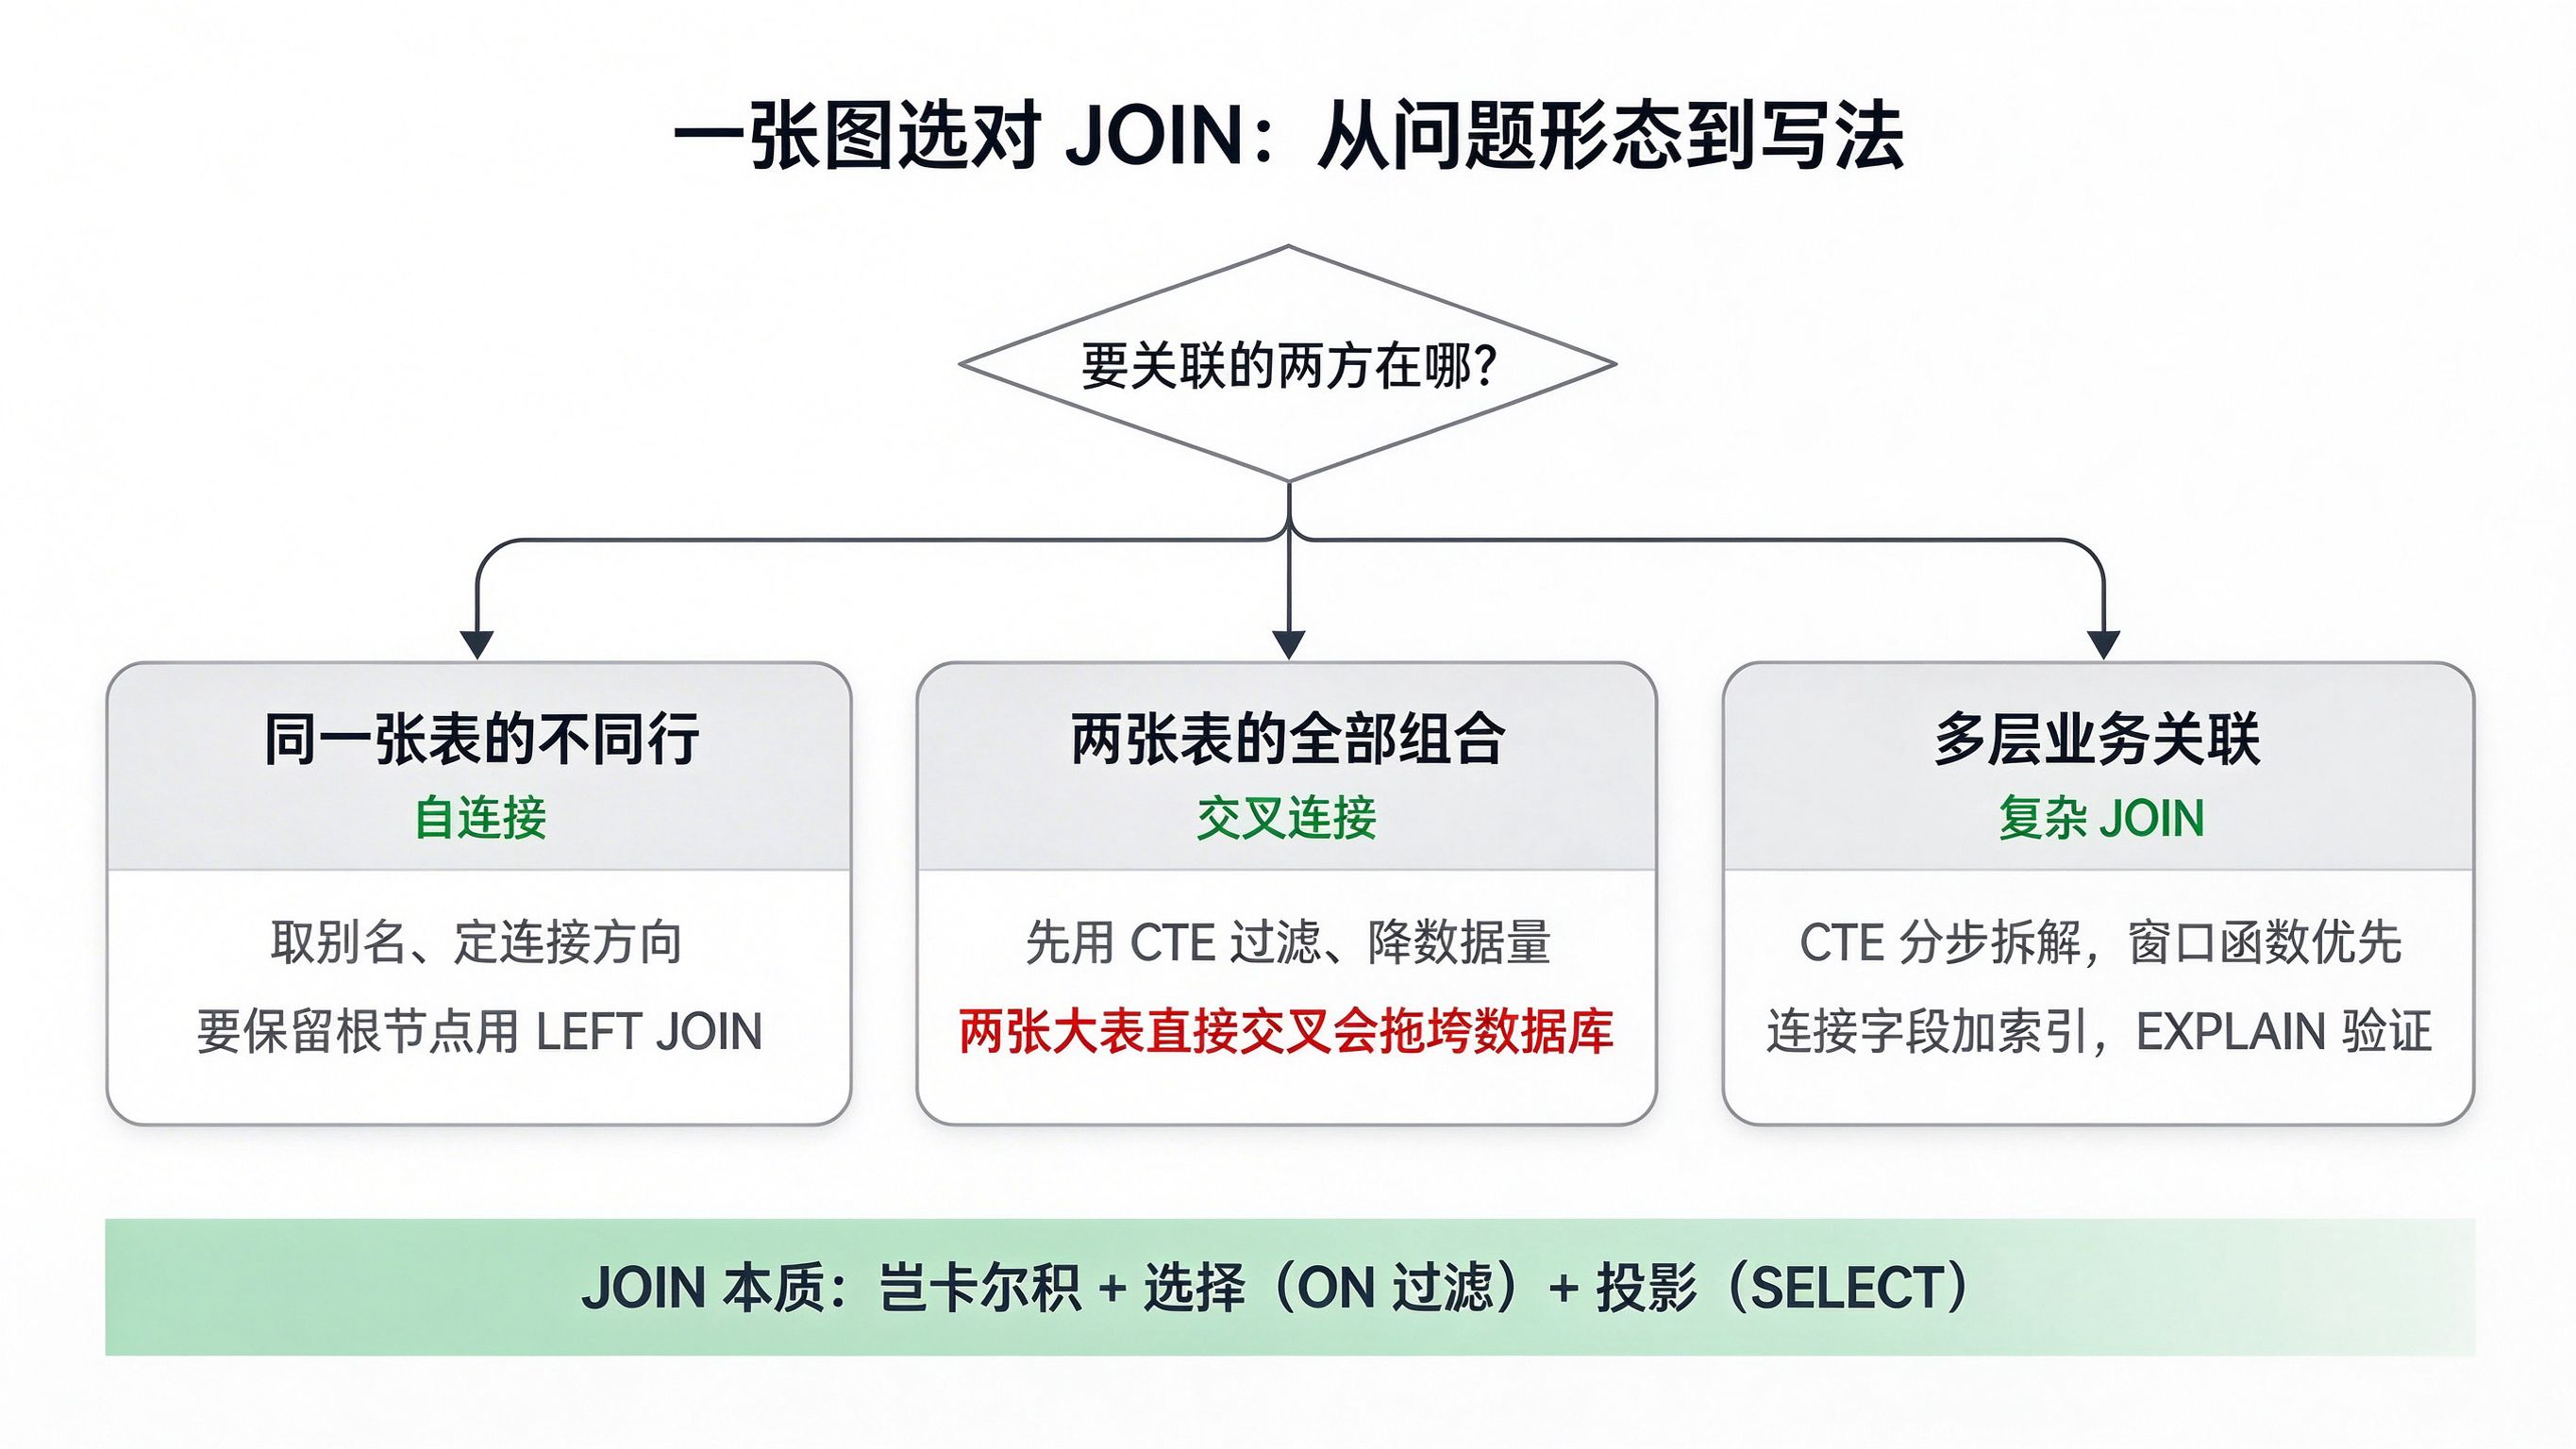
JOIN 的本质是"笛卡尔积 + 选择 + 投影":交叉连接提供全部组合,ON 条件做选择,SELECT 做投影。
三类问题各有一个关键:
- 自连接:别名、方向、根节点
- 交叉连接:先降数据量,再做配对
- 复杂 JOIN:CTE 拆解、窗口函数、索引、EXPLAIN
我现在写 JOIN 固定三个习惯:
- 永远写清别名与连接条件,不依赖数据库默认行为
- 能用 CTE 就不写巨型嵌套子查询
- 先拿小数据量验证结果,再用 EXPLAIN 看执行计划
术语速查表
| 术语 | 英文 | 一句话解释 |
|---|---|---|
| 自连接 | Self Join | 同一张表取两个别名互相连接 |
| 交叉连接 | Cross Join | 不写连接条件,返回两表全部组合 |
| 笛卡尔积 | Cartesian Product | 两表行两两配对,行数为 m × n |
| 递归公用表表达式 | Recursive CTE | 锚点查询加递归查询,用于层级展开 |
| 窗口函数 | Window Function | 不折叠行的聚合计算,如 AVG OVER、LAG |
| 内连接 | Inner Join | 只保留两表匹配成功的行 |
| 外连接 | Outer Join | 保留左表全部行,未匹配处右表填 NULL |
| 执行计划 | Execution Plan | 数据库执行 SQL 的步骤与连接顺序说明 |