从一条召回结果说起
用户输入:"我膝盖不太舒服,想恢复腿部训练,应该怎么安排?"
系统的检索结果里出现了三篇文档:"标准深蹲动作要领""箭步蹲的进阶变式""腿举的三种握距"。
这三篇文档在向量空间里和用户的 query 确实离得很近。"腿部训练""恢复""膝盖"这些词在语义上指向了"腿"这个主题,向量检索捕捉到了。但问题是,用户说的是"膝盖不太舒服,想恢复训练",这是一个带有明确限制条件的诉求。深蹲对膝关节的负荷模式、箭步蹲对单侧稳定性的要求,和"膝盖不适时恢复训练"这个场景是否匹配,向量相似度不负责回答这个问题。
这就是 RAG 检索里一个容易被忽略的裂缝:向量检索衡量的是语义相近程度,而业务需要的是适用条件匹配。 两者在某些场景下会重合,但在带有约束条件的问题上,它们会分叉。
我当时在这个训练助手的检索链路里做排查,从 query 改写一路看到 Cross-Encoder 精排,最后发现每一层都有各自的"失效模式"。这篇文章不打算写成 RAG 概念百科,我想把这条链路拆开,说清楚每一层在做什么、什么时候会骗你、以及怎么判断问题出在哪一层。
第一层:查询改写------约束条件最容易丢的地方
用户原始 query:"我膝盖不太舒服,想恢复腿部训练,应该怎么安排?"
这句话里其实包含三个层面的信息:
意图 :想要一个训练安排方案。
约束 :膝盖不适,需要谨慎处理。
目标:恢复训练,不是从零开始,也不是冲击极限。
查询改写的本质,是把用户的自然语言 query 映射到一个检索系统更容易匹配的表达空间。这个映射有两个目标:一是补全 query 里隐含的检索意图(比如"膝盖不舒服"背后可能指向"低冲击训练"),二是保留 query 里的约束条件。两个目标经常冲突------补全意图需要泛化,保留约束需要精确,LLM 在泛化的时候很容易把约束也一起泛化掉。
常见做法是用 LLM 把口语化 query 改写成"更适合检索"的形式,比如改写成:"膝盖不适 恢复 腿部训练 安排"。这个改写保留了关键词,但代价是丢失了原始 query 里最微妙的那部分约束语义------"不太舒服"的程度是模糊的,"恢复"意味着用户已经有训练基础,这些在改写后的短查询里几乎不可见。
更严重的问题是,如果改写 prompt 没有显式要求保留约束条件,LLM 很容易把"膝盖不太舒服"抽象成"腿部训练",然后彻底丢掉"膝盖"这个限制。改写后的 query 变成了一个纯粹的"腿部训练计划"查询,向量检索自然会召回深蹲、箭步蹲这类标准动作。
我后来在改写环节加了一个约束抽取的步骤。不是让 LLM 自由发挥,而是先做一次结构化的信息抽取:
json
json
{
  "intent": "训练恢复安排",
  "body_part": "腿部",
  "constraints": [
    {
      "type": "physical_limitation",
      "description": "膝盖不适",
      "severity": "unspecified",
      "action_required": "avoid_high_knee_load"
    }
  ],
  "training_stage": "recovery"
}这个结构不做检索,它做的是把用户 query 里的约束显式化。有了这个结构,后面的检索层可以决定:是把约束作为关键词拼进检索 query,还是用它去过滤文档的元数据字段。
这里容易踩的坑是 :约束抽取本身也可能出错。如果 LLM 把"膝盖不太舒服"抽取成了"膝盖疼痛",严重程度被放大了,后续过滤可能会过严,把本来可以用的"低冲击腿部训练"文档也过滤掉了。所以抽取出来的约束结构不能直接当作硬过滤条件使用,它更适合作为加权信号 或者软过滤依据。
第二层:混合召回------关键词和向量各自补对方的短板
只做向量检索,在这个场景里会漏掉一类文档:那些标题或正文里明确写了"膝盖友好"但语义表达和用户 query 不太一样的训练内容。
向量检索的机制是:把 query 和文档分别编码成稠密向量,在向量空间里算相似度。它的强项是语义泛化------"膝盖不适"和"膝关节疼痛""膝部恢复"在向量空间里距离很近,这是关键词检索做不到的。但它的问题是对"精确约束"不敏感。一篇文档讲的是"膝盖手术后康复训练",另一篇讲的是"膝盖不适时的低冲击训练",向量可能给它们差不多的相似度分数,但在业务上它们的适用条件差异很大。
关键词检索(通常是 BM25 或类似的词频统计方法)的机制是:基于词项匹配和统计权重打分。它的强项是精确匹配。如果用户的约束条件里有"膝盖""恢复"这类词,关键词检索能确保包含这些词的文档不会在第一轮就被漏掉。它的弱项是词汇不匹配:用户说"不太舒服",文档写的是"疼痛"或"不适",关键词就匹配不上了。
所以混合检索的直觉是:让两路召回各自保留自己的结果,在融合层做合并。 而不是先让向量召回过滤一遍,再让关键词在过滤后的结果里找。
工程上有一个细节值得注意:两路召回返回的候选数量不需要一样。向量检索可以多取一些(比如 top 30),关键词检索少取一些(比如 top 15),因为关键词检索的精确度更高但覆盖更窄。融合时按 rank 位置做加权,而不是按原始分数。这也是为什么 RRF 在这种场景下被广泛使用:它不需要两路检索的分数可比。
第三层:RRF------解决排序合并,不解决正确性判断
RRF(Reciprocal Rank Fusion)做的事情非常简单:对于每一篇文档,取它在各路召回结果里的 rank,计算 1 / (k + rank) 然后求和(k 通常取 60 左右的常数)。按总分排序。
它解决的问题是:向量检索的余弦相似度分数和 BM25 的分数不在同一个量纲上,直接加权求和没有意义。 RRF 只用 rank,绕开了分数归一化的问题。
但 RRF 有一个容易被忽略的局限:它丢弃了分数分布信息。 假设向量检索的第一名相似度是 0.95,第二名是 0.94,第三名突然掉到 0.72。这个"掉档"的信息在 rank 表示里变成了 1、2、3,和其他场景下第一名 0.72、第二名 0.71、第三名 0.70 的 rank 完全一样。一篇文档出现在两路召回的第 5 名,和它出现在一路的第 1 名、另一路没出现,RRF 给出的分数可能差不多,但两种情况的意义完全不同。
我查到的一篇 ACM TOIS 论文也验证了这一点:RRF 对参数 k 敏感,而且因为只看 rank 不看分数分布,它丢弃了有用的信息;在域外泛化能力上,学习到的凸组合融合表现更好。这不是说 RRF 不能用,而是说 RRF 的输出是一个排序信号,不是一个"这篇文档确实相关"的判断。 把它当作准确性判断,是排查时容易犯的错误。
在"膝盖训练"这个例子里,深蹲文档和一篇"膝盖友好替代动作"文档可能都在 RRF 融合结果的前列,因为深蹲在向量路排得很高,膝盖友好文档在关键词路排得不错(如果它正文里出现了"膝盖"和"恢复")。RRF 分不出哪篇更适合这个用户的约束,它只能告诉你"这两篇在各自的召回里位置不错"。
第四层:Cross-Encoder------能重新排序,不能创造候选
Cross-Encoder 和向量检索用的 Bi-Encoder 在输入方式上完全不同。Bi-Encoder 把 query 和文档分别 编码成向量,然后算余弦相似度。Cross-Encoder 把 query 和文档拼接在一起送进 Transformer,让两者在每一层注意力里充分交互,输出一个标量相关性分数。
这个结构差异决定了 Cross-Encoder 的精度更高:它能捕捉 query 里"膝盖不适"和文档里"膝关节负荷"之间的细粒度关联,而 Bi-Encoder 在分别编码时很可能丢掉这种跨文本的约束对齐信号。
但 Cross-Encoder 有一个硬边界:它只能在已有的候选集里排序,不能把没召回的文档"补回来"。 如果深蹲文档在召回阶段就没进候选集,Cross-Encoder 根本看不到它。有一篇关于冷启动推荐系统重排序的论文把这一点说得很直接:重排序器的主要失效模式不是模型能力不够,而是候选生成阶段的覆盖率不足------当召回阶段的 recall@200 只有 10.9% 时,再强的 Cross-Encoder 也无法补救。
Azure 的 RAG 架构文档也提到了一个细节:Cross-Encoder 的分数是相对分数,不是绝对分数,应该用于排序,而不是设一个固定阈值来判断"这篇文档相关"。在排查场景里这意味着:精排分数 0.8 的文档不一定就比精排分数 0.6 的文档"更适合用户",它只是在这个候选集里排得靠前。
在"膝盖训练"这个例子里,如果召回阶段同时返回了深蹲和膝盖友好文档,Cross-Encoder 有机会把膝盖友好文档排到前面------前提是它的训练数据或 fine-tuning 数据里见过类似的"约束条件 + 动作选择"的配对。如果 Cross-Encoder 是在通用段落排序数据上训练的,它对"膝盖不适"和"深蹲"之间的业务不匹配可能并不敏感。这不是模型的问题,是任务的特殊性超出了模型的训练分布。
第五层:业务校验------检索链路之外的那一步
即使前面的每一层都工作正常,精排之后排在第一位的文档是"膝盖不适时的低冲击腿部训练",如果文档内容本身没有覆盖用户的具体训练阶段("恢复"意味着用户有基础,不是完全卧床),生成的回答仍然可能不适用。
这就是为什么我在这个链路里加了一层结构化约束校验,放在精排之后、送进 LLM 生成之前。它不是检索的一部分,它是对检索结果做一次业务规则的检查。检索层负责"找到相关文档",业务校验层负责"判断这些文档是否满足用户的具体约束"。两者的职责不同,不能互相替代。
java
scss
public class RetrievalResultValidator {

    public ValidationResult validate(
            UserConstraints constraints,
            List<ScoredDocument> rerankedDocs) {

        List<ScoredDocument> valid = new ArrayList<>();
        List<String> violations = new ArrayList<>();

        for (ScoredDocument doc : rerankedDocs) {
            DocumentMetadata meta = doc.getMetadata();

            // 软检查:不是硬过滤,是标记
            if (constraints.getBodyPart().equals("腿部")
                    && meta.hasContraindication("knee_high_load")
                    && !meta.hasModificationFor("knee_friendly")) {

                violations.add(String.format(
                    "doc=%s may conflict with constraint=%s",
                    doc.getId(),
                    constraints.getPhysicalLimitation()
                ));
                // 不直接丢弃,降权后保留,让 LLM 看到冲突
                doc.setScore(doc.getScore() * 0.5);
            }

            valid.add(doc);
        }

        return new ValidationResult(valid, violations);
    }
}这里的设计取舍是:不用硬过滤,用降权和标记。 硬过滤的风险是,当约束抽取本身不够准确时,会把本来可用的文档也过滤掉,导致空结果。降权加标记的做法让 LLM 有机会在生成时看到"这篇文档可能和用户约束有冲突",而不是让系统替用户做决定。
训练助手的场景还有一个特殊性:它不应该对用户的膝盖状况做出医学判断。校验层只做一件事------检查文档是否被标注了"可能不适合该约束条件",然后把冲突信息透传给生成层。最终说"建议咨询专业人士"还是"可以尝试低冲击替代动作",留给 LLM 按照预设的安全策略处理。
我踩过的坑
只做向量检索。 最开始链路里只有向量召回,因为我以为"语义搜索比关键词搜索更高级"。实际排查时发现,用户 query 里的"膝盖"这个约束词在向量空间里被"腿部训练"的主题稀释了,相似度最高的反而是那些泛腿部训练文档。关键词检索的价值不是"更高级",是更精确地锁定约束词。
改写时丢掉用户限制条件。 我一开始用的改写 prompt 只说了"把用户问题改写成更适合检索的查询",没有说"必须保留所有身体部位限制和恢复阶段信息"。LLM 把"膝盖不太舒服"压缩成了"腿部",改写后的 query 干净了很多,但检索质量反而下降了。后来我在 prompt 里显式要求保留限制条件,并且加了一个约束抽取的独立步骤来兜底。
把 RRF 当成准确性判断。 我一度用 RRF 融合分数来决定"哪些文档应该送进精排"。RRF 排在前面的文档里有不少是两路召回都靠前但实际不适用的,RRF 分数高只说明"两路都认为它和 query 在形式上相关",不说明"它满足用户的约束"。RRF 应该用来做候选合并 ,而不是候选筛选。
误以为 Cross-Encoder 可以补回没有召回的文档。 我在看 bad case 的时候发现,某条 query 最该出现的一篇文档在精排后确实没排上来。我第一反应是"精排模型不够好",后来查了召回日志才发现,那篇文档在向量路和关键词路的 top 30 里都没有出现。精排从来没见过它。
过滤条件过严导致结果为空。 在加约束抽取的初期,我把"膝盖不适"直接映射成了硬过滤条件 exclude: knee_high_load,结果一批文档被过滤掉之后,剩下的候选里没有一条覆盖"恢复训练"这个意图。后来改成降权加标记,空结果率明显下降。这里的教训是:约束抽取的输出应该是一个概率性的信号,不是一个确定性的过滤条件。
离线评测:怎么判断问题出在哪一层
排查 RAG 链路失败最困难的地方是,你看到一个错误答案,但不知道是改写错了、召回没捞到、融合把对的挤掉了、精排排反了、还是生成阶段没有正确使用检索结果。
我的做法是给每一层单独建一个"最小可判断"的评测集。不是端到端的 Recall@K,而是分层的归因信号。
改写层评测:约束保留率。 对一批带有明确约束的 query,人工标注改写后的 query 是否保留了原始约束的语义。这里不用打分,用三分类:完全保留、部分保留(约束词还在但语义被弱化)、完全丢失。部分保留是最值得关注的,因为"膝盖"变成了"腿部"这种改写,从关键词看好像还在,但约束的指向已经变了。
召回层评测:分路 Recall@K。 分别看向量路和关键词路的 Recall@K,不要看融合后的。融合后的 Recall@K 如果掉了,你不知道是两路本身就没捞到,还是融合把对的排到 K 之外了。分路看的好处是你能判断:这个 bad case 是"向量检索的语义泛化太强导致约束词被稀释",还是"关键词检索因为词汇不匹配漏掉了"。
融合层评测:排序变化分析。 对比融合前后的 rank 变化。如果一篇正确文档在向量路排第 3、关键词路排第 5,融合后排到了第 12,说明融合策略有问题------可能是 RRF 的 k 值让两路中靠前的文档被后路的 rank 拉下来了。这个分析不需要新指标,只需要记录融合前后的 rank 映射。
精排层评测:候选覆盖率和精排提升量。 候选覆盖率看的是"正确文档在不在精排的输入候选集里"。如果不在,精排层没有责任。如果在但没排上来,再去看精排分数和错误文档的分数差。这个差值是判断"精排模型对这个任务不敏感"还是"错误文档的文本确实和 query 更接近"的依据。
在离线评测里我观察到,约束保留率低的时候,召回层的错误通常表现为"召回了语义相关但约束不匹配的文档";约束保留率正常但召回分路都够不到正确文档的时候,问题更可能出在文档本身没有明确的约束标注,或者向量模型的领域适配不够。这些判断不依赖具体数值,依赖的是分层信号之间的因果关系。
召回为空或过滤过严时的兜底
兜底策略的设计取决于一个判断:空结果是因为"知识库里确实没有",还是因为"过滤条件太紧"。
如果是后者,最直接的做法是放宽约束的强度。软过滤(降权加标记)天然比硬过滤多一层缓冲。如果软过滤之后仍然候选很少,可以走一个降级策略:把约束从检索条件降级为生成条件------让检索先返回宽泛的"腿部恢复训练"相关文档,然后在生成阶段把用户的膝盖约束作为 prompt 的一部分传给 LLM,让 LLM 在生成时判断文档内容的适用性。
如果是前者(知识库里确实没有),系统应该有一个明确的"无足够信息"路径,而不是硬凑一个答案。有一条工程经验值得参考:在 RAG 链路里插入一个 Retrieve-Check-Route 的检查点,在生成之前判断"检索到的内容是否足以支撑回答",不足以支撑时走"受控无答案"或"基于模型参数知识回答(不注入检索内容)"的分支,而不是把低相关度的 chunk 注入上下文。
在这个训练助手的场景里,如果检索结果里确实没有覆盖"膝盖不适 + 恢复训练"的文档,让系统说"当前知识库中没有针对膝盖不适的恢复训练方案,建议咨询专业人士",比让它基于深蹲文档生成一段"膝盖友好变式"的回答更安全。
这套方案还能怎么优化
结构化元数据。 如果文档入库时能给每个 chunk 打上 body_part、contraindications、difficulty_level、training_stage 这样的标签,检索时的约束匹配就不需要完全依赖文本语义了。这是成本前置的做法:入库时多花一点标注成本,检索时少花大量调试成本。但不适用于所有知识库,纯自然语言的文档源很难自动抽取出可靠的元数据。
查询意图和约束抽取的分离。 把"用户想要什么"和"用户有什么限制"拆成两个独立步骤,而不是让一次 LLM 调用同时输出。分开的好处是每部分的评测信号更干净:意图识别错了和约束抽取错了,修法完全不同。
错误样本集的持续维护。 不需要很大的数据集,几十条带有明确归因标注的 bad case 就足够指导优化方向。关键不是数量,是每条 bad case 都标注了"失败发生在哪一层"。
指标的选择。 Recall@K 看的是召回覆盖能力,但它不反映"召回的文档是否满足约束"。约束违反率(检索结果中不满足用户约束的文档占比)是补充指标。空结果率是另一个独立的监控项------它不衡量质量,衡量的是链路的鲁棒性边界。
日志和链路追踪。 每一次检索请求,把改写后的 query、每路召回的 top-K 及分数、融合后的排序、精排后的排序、最终送入 LLM 的上下文,全部用同一个 trace_id 串起来。没有这个,排查就是盲猜。如果之前没有链路追踪,加一层 OpenTelemetry 的 span 到检索链路的每个阶段,成本不高,但对排查效率的提升是数量级的。
人工审核和安全兜底。 涉及身体限制、医疗建议这类场景,自动校验的覆盖率不可能做到 100%。保留一条人工审核的路径,或者在生成层设置明确的"当约束条件无法被满足时,拒绝给出具体动作建议"的安全策略,比追求检索的完美更有实际意义。
完整链路
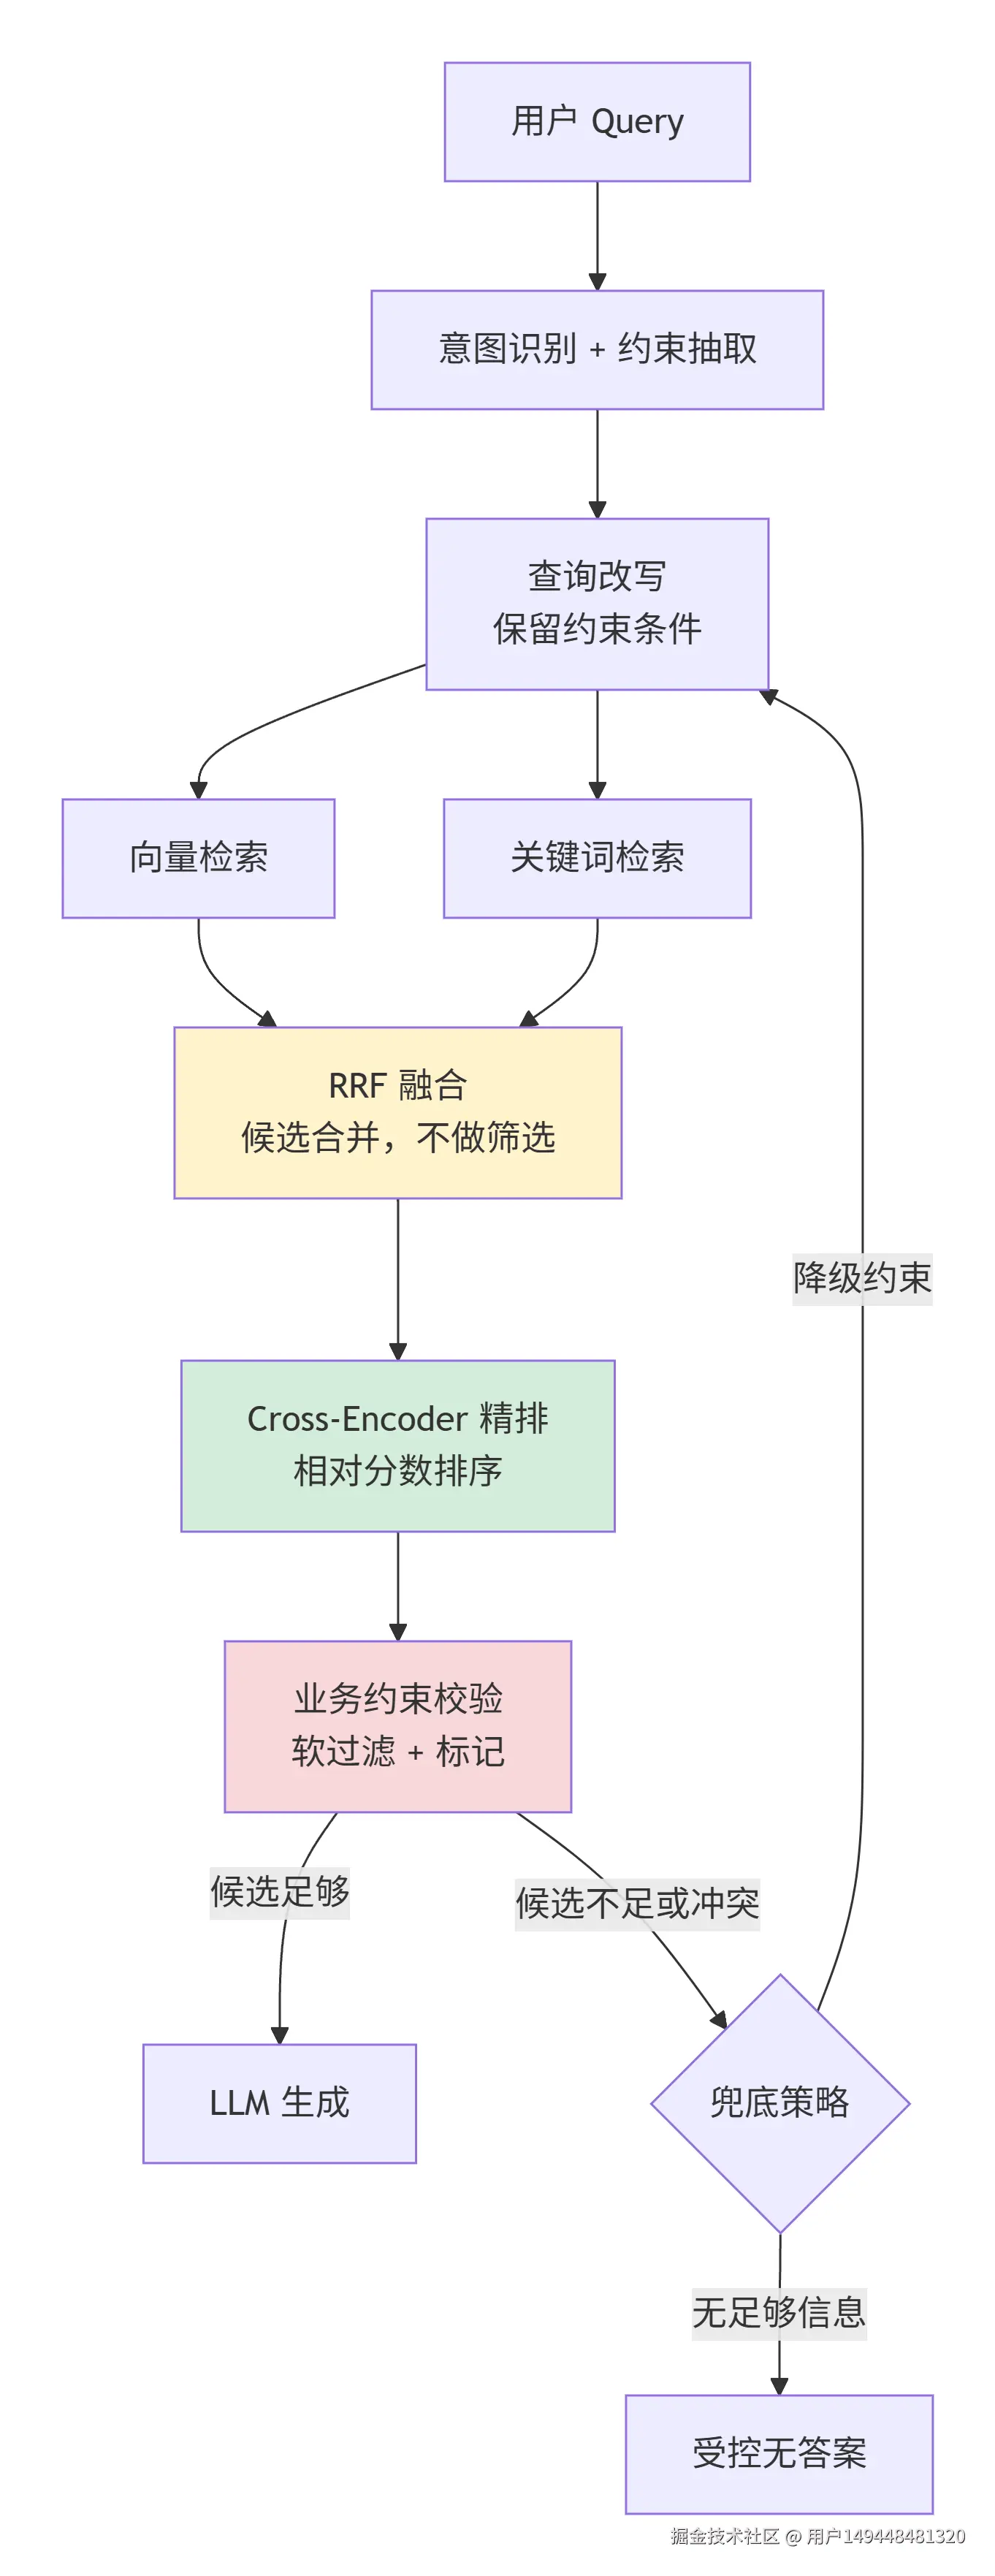
结尾
这套链路里没有哪一层是"错的"。向量检索做的是它被设计来做的事,RRF 做的是它被设计来做的事,Cross-Encoder 也是。问题出在用检索的指标去衡量业务的适用性:语义相似度不是适用性判断,融合分数不是准确性判断,精排分数不是约束满足度判断。
适用场景是那些用户 query 里带有显式或隐式约束的检索场景------训练助手的身体限制、商品搜索的尺寸和价格区间、客服里的账户状态条件、法律检索里的适用法域。当 query 只是"我想了解腿部训练"的时候,这套链路的复杂度可能是多余的;当 query 变成"我膝盖不舒服想恢复训练"的时候,约束的处理就变成了链路里最关键的环节。
局限性在于:约束抽取本身依赖 LLM 的稳定性,结构化元数据依赖文档入库时的标注质量,精排模型对领域约束的敏感度依赖训练数据。这些都不是检索算法层面能完全解决的。
可以继续研究的方向:把约束抽取的输出做成检索层的加权信号而不是独立的过滤层,以及探索在精排模型上做轻量 fine-tuning 来提升领域约束对齐的能力。