本文中的 Mem0 源码片段来自 Mem0 官方 GitHub 仓库,并使用了AI工具进行学习,仅用于个人学习与源码阅读记录。源码链接参见:mem0/mem0 at main · mem0ai/mem0 · GitHub
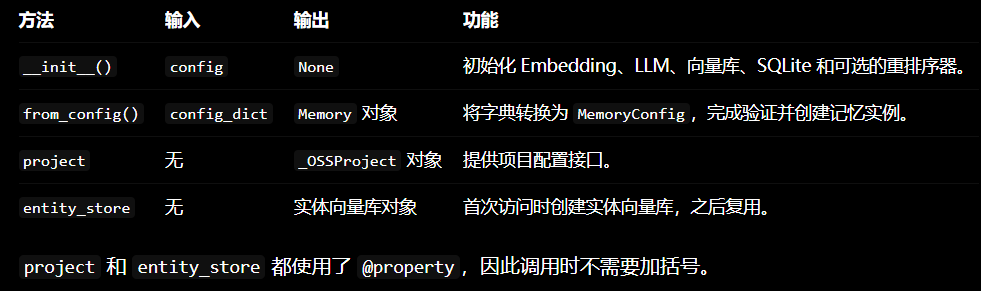
同步版 Memory 类中的所有方法总结:
1. 初始化与对象创建
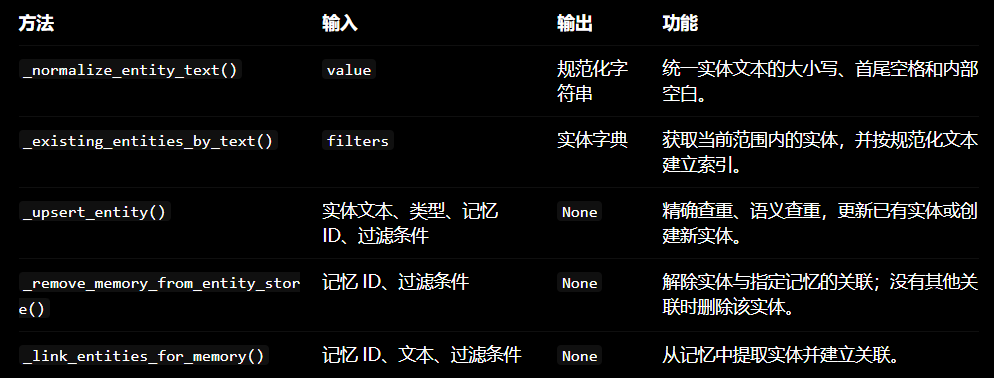
2. 实体管理
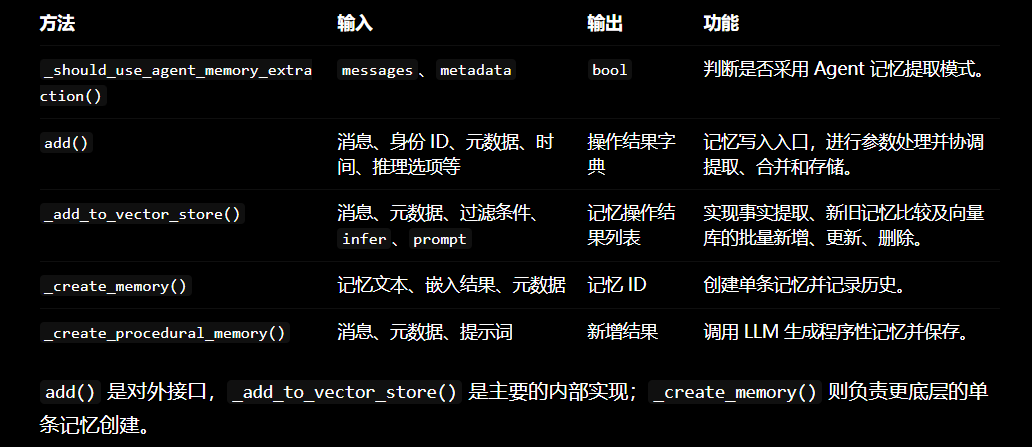
3. 记忆写入与提取
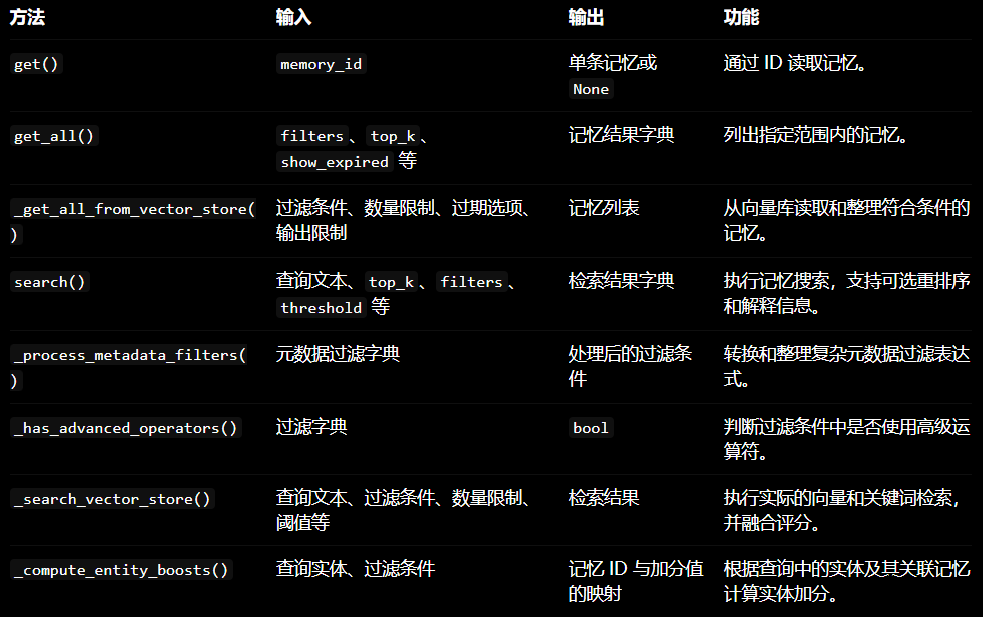
4. 记忆读取与检索
5. 记忆更新、删除及历史管理
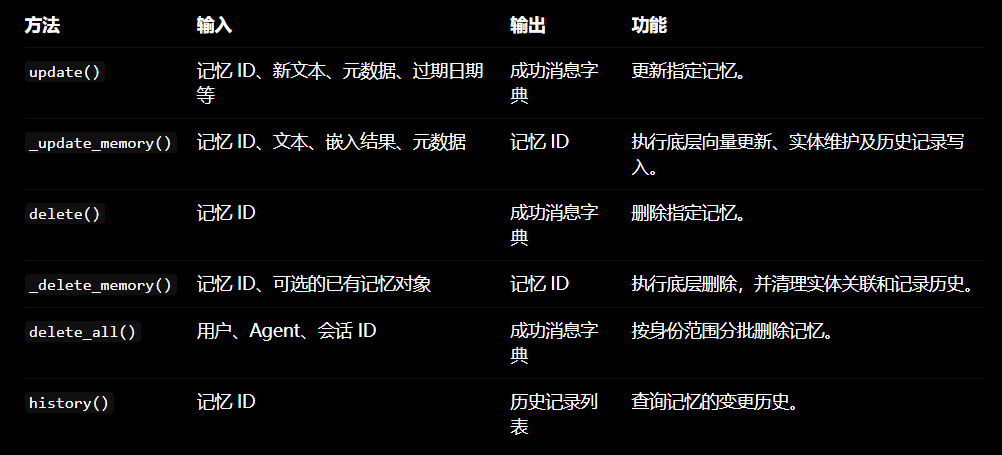
6. 重置、关闭及其他接口
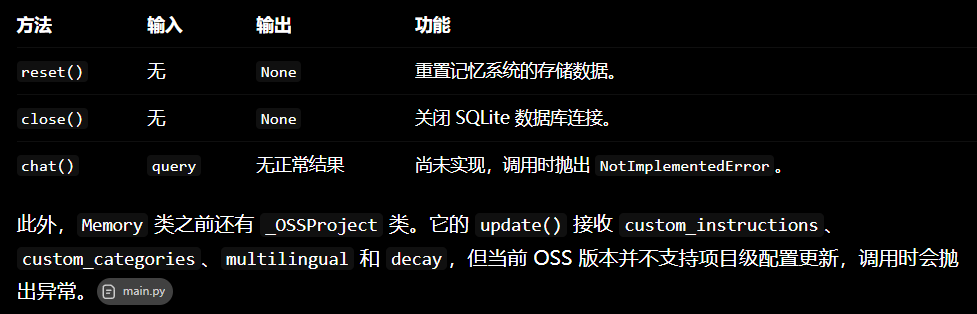
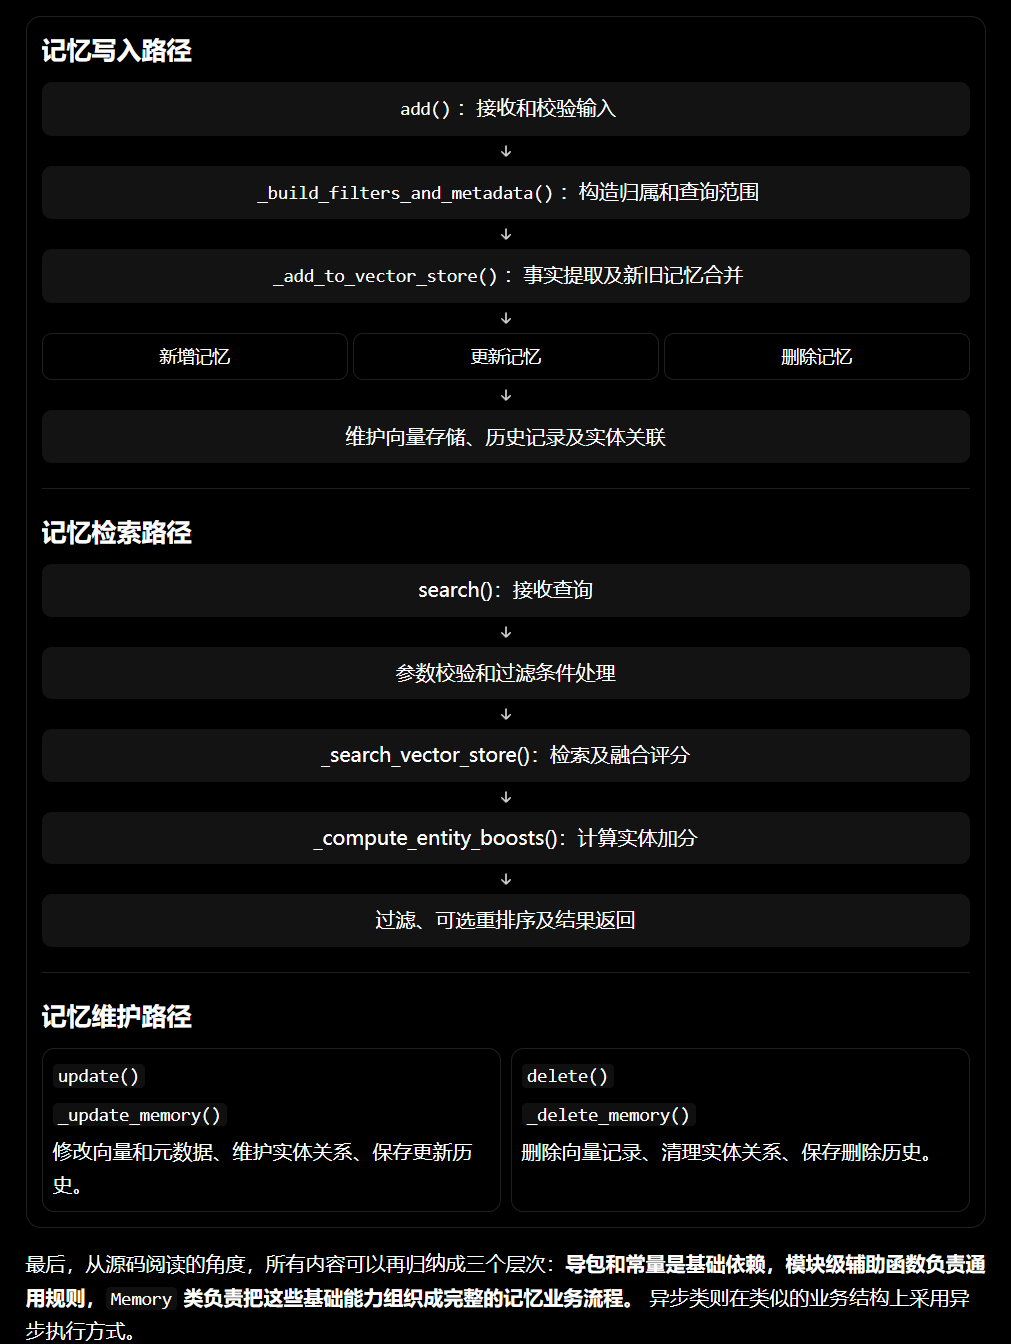
7. 把这些分类对应到实际执行流程
python
    """
Memory 是 Mem0 开源版中同步操作记忆的核心类,负责协调:
LLM
嵌入模型
向量数据库
历史数据库
重排序器
实体存储

它本身不是单纯的数据库,而是这些组件的组织者。

MemoryBase 定义了记忆系统应该提供的基本接口,例如:
add()
get()
get_all()
search()
update()
delete()
delete_all()
history()
其中很多方法只有接口定义,具体功能由 Memory 实现。
"""
class Memory(MemoryBase):
    """
    __init__() 完成了以下内容:
    保存配置
        ↓
    创建嵌入模型
        ↓
    创建向量数据库
        ↓
    创建 LLM
        ↓
    创建 SQLite 历史库
        ↓
    按需创建重排序器
        ↓
    准备实体存储
        ↓
    检查搜索能力
        ↓
    记录初始化事件

    执行:memory = Memory() 之后,
    Mem0 进行记忆存储和搜索所需要的主要组件就准备好了。
    """
    def __init__(self, config: MemoryConfig = MemoryConfig()):
        # 把配置保存到当前对象中
        self.config = config

        # 创建嵌入模型
        self.embedding_model = EmbedderFactory.create(
            self.config.embedder.provider,      # 嵌入模型提供商,例如 openai。
            self.config.embedder.config,        # 模型名称、API Key、维度等配置。
            self.config.vector_store.config,    # 向量库配置,可能用于确定向量维度。
        )
        # 创建向量数据库
        # provider:例如 Qdrant、Chroma、FAISS。
        # config:地址、端口、集合名称等。
        self.vector_store = VectorStoreFactory.create(
            self.config.vector_store.provider, self.config.vector_store.config
        )

        # 创建大语言模型
        """
        主要用于:
        - 从对话中提取记忆;
        - 判断记忆应该新增、修改还是删除;
        - 处理程序性记忆。
        """
        self.llm = LlmFactory.create(self.config.llm.provider, self.config.llm.config)

        # 创建历史数据库
        """
        创建 SQLite 管理器,保存:
        - 记忆更新历史;
        - 最近消息;
        - 记忆操作记录。
        """
        self.db = SQLiteManager(self.config.history_db_path)

        # 保存常用配置
        self.collection_name = self.config.vector_store.config.collection_name
        # 保存当前 Mem0 API 或数据结构版本。
        self.api_version = self.config.version
        # 保存自定义记忆提取指令。
        self.custom_instructions = self.config.custom_instructions

        # Initialize reranker if configured
        # 默认不使用重排序器。
        self.reranker = None
        # 如果配置中提供了重排序器:根据配置创建重排序器。
        # 重排序器会对搜索结果重新评分,使更相关的记忆排在前面。
        if config.reranker:
            self.reranker = RerankerFactory.create(
                config.reranker.provider,
                config.reranker.config
            )

        # Entity store is initialized lazily on first use
        # 延迟初始化实体存储,先不创建实体向量库。
        # 只有第一次访问:memory.entity_store 时才真正创建,这叫"延迟初始化",
        # 可以减少启动时间和不必要的资源消耗。
        self._entity_store = None

        # 初始化遥测相关向量库
        if MEM0_TELEMETRY:
            # Create telemetry config manually to avoid deepcopy issues with thread locks
            # 创建一个空字典,用于构造遥测向量库配置。
            """
            hasattr() 是 Python 内置函数,用于检查对象是否存在某个属性:hasattr(对象, "属性名")
            返回布尔值
            """
            telemetry_config_dict = {}
            # Pydantic 模型是继承 BaseModel 的 Python 类
            # model_dump() 是 Pydantic v2 模型常用的方法,用于把模型转换成字典。
            if hasattr(self.config.vector_store.config, 'model_dump'):
                # For pydantic models
                telemetry_config_dict = self.config.vector_store.config.model_dump()
            else:
                # For other objects, manually copy common attributes
                # 逐个检查常用配置字段。
                for attr in ['host', 'port', 'path', 'api_key', 'index_name', 'dimension', 'metric']:
                    # 读取属性值并放进配置字典。
                    if hasattr(self.config.vector_store.config, attr):
                        telemetry_config_dict[attr] = getattr(self.config.vector_store.config, attr)

            # Override collection name for telemetry
            # 设置独立集合名称,让该辅助向量库使用独立集合,避免与用户的主记忆集合混在一起。
            # 普通的字典赋值
            """
            结果:
            {
                "collection_name": "mem0migrations",
            }
            """
            telemetry_config_dict['collection_name'] = "mem0migrations"

            # Set path for file-based vector stores
            """
            为本地向量库设置路径, 如果使用的是本地文件型 FAISS 或 Qdrant,则生成目录名称和完整存储路径
            """
            telemetry_config = _safe_deepcopy_config(self.config.vector_store.config)
            if self.config.vector_store.provider in ["faiss", "qdrant"]:
                # 生成目录名称
                provider_path = f"migrations_{self.config.vector_store.provider}"
                # 生成完整存储路径。
                telemetry_config_dict['path'] = os.path.join(mem0_dir, provider_path)
                # 创建目录;如果目录已经存在,不报错。
                os.makedirs(telemetry_config_dict['path'], exist_ok=True)

            # Create the config object using the same class as the original
            # 创建辅助向量库,使用原配置对象的类,根据新字典创建配置对象。
            # self.config.vector_store.config.__class__  取得当前配置对象所属的类。
            # **telemetry_config_dict: 将字典展开成关键字参数。
            telemetry_config = self.config.vector_store.config.__class__(**telemetry_config_dict)
            # 根据该配置创建独立的辅助向量库实例。
            self._telemetry_vector_store = VectorStoreFactory.create(
                self.config.vector_store.provider, telemetry_config
            )
        # 检查是否支持关键词搜索,检查当前向量库是否没有自己实现 keyword_search()。
        # type(self.vector_store): 取得实际向量库对象的类。
        # 等价于 type(self.vector_store).keyword_search
        # 第三个参数 None 表示:如果不存在该属性,就返回 None,而不是抛出 AttributeError
        if getattr(type(self.vector_store), "keyword_search", None) is VectorStoreBase.keyword_search:
            logger.warning(
                "The '%s' vector store does not support keyword search. "
                "Hybrid (BM25) scoring will be disabled and search will use "
                "semantic similarity only. To enable hybrid search, switch to a "
                "store with keyword_search support (e.g. qdrant, elasticsearch, pgvector).",
                self.config.vector_store.provider,
            )

        # 记录初始化事件,记录一次 Memory 初始化事件。创建的是同步版 Memory,不是异步版 AsyncMemory
        capture_event("mem0.init", self, {"sync_type": "sync"})

    """
    Python 装饰器,把下面的 project() 方法变成属性。
    有了它以后,调用时写:memory.project, 而不需要写:memory.project()
    """
    @property
    def project(self):
        # 返回 _OSSProject 类型对象,因此可以继续调用:memory.project.update(...)
        return _OSSProject()

    # Memory 类的属性方法,用于"按需创建并返回实体向量库"。
    @property
    def entity_store(self):
        """Lazily initialize entity store on first use."""
        # 检查实体库是否还没有创建。
        if self._entity_store is None:
            # 复制向量库配置,避免后面修改实体库配置时影响主记忆库。
            entity_config = _safe_deepcopy_config(self.config.vector_store.config)
            '''
            根据主集合名称生成独立的实体集合名,例如:
                主集合:mem0
                实体集合:mem0_entities
            '''
            entity_collection = _entity_collection_name(self.config.vector_store.provider, self.collection_name)
            # Set collection name on the cloned config
            '''
            修改集合名称。如果配置是带 collection_name 属性的对象,就直接修改属性。
            如果配置是普通字典,就修改字典键。
            '''
            if hasattr(entity_config, 'collection_name'):
                entity_config.collection_name = entity_collection
            elif isinstance(entity_config, dict):
                entity_config['collection_name'] = entity_collection
            # For Qdrant, share the existing client to avoid RocksDB lock contention
            # when using embedded mode (path=...). QdrantConfig.client takes precedence
            # over host/port/path.
            # Qdrant 复用客户端
            # Qdrant 客户端(QdrantClient)是 Python 程序用来操作 Qdrant 向量数据库的对象。
            # 这里的"客户端"不是指用户,而是:Python 程序与 Qdrant 数据库之间的通信工具。
            # 一句话概括:QdrantClient 是操作 Qdrant 数据库的 Python 接口对象,
            # 负责建立连接以及执行创建集合、写入向量、搜索、读取和删除等具体操作。
            # 如果使用 Qdrant,并且主向量库已经有客户端连接,则进入复用逻辑。
            if self.config.vector_store.provider == "qdrant" and hasattr(self.vector_store, "client"):
                # 配置是对象时,设置 client 属性。
                if hasattr(entity_config, "client"):
                    entity_config.client = self.vector_store.client
                # 配置是字典时,设置 client 键。
                elif isinstance(entity_config, dict):
                    entity_config["client"] = self.vector_store.client
            # 创建实体向量库
            # 通过工厂创建与主记忆库相同类型的向量库,但使用实体集合配置。
            self._entity_store = VectorStoreFactory.create(
                self.config.vector_store.provider, entity_config
            )
        # 返回已经创建或缓存的实体向量库。
        return self._entity_store

    # 规范化实体文本,方便比较和去重
    @staticmethod
    def _normalize_entity_text(value: str) -> str:
        return " ".join(value.strip().lower().split())

    '''
    读取当前范围内已经保存的实体,并构造成:
    {
        "规范化后的实体文本": 实体记录对象
    }
    它主要用于实体精确匹配和去重。
    filters:查询范围,例如 user_id、agent_id。

    一句话概括 _existing_entities_by_text 函数:
    该函数读取指定用户、Agent 或运行范围内的已有实体,
    用规范化文本作为字典键,方便快速精确匹配并避免重复创建实体。
    '''
    def _existing_entities_by_text(self, filters):
        """Return existing entity rows keyed by normalized payload data."""
        try:
            # 从实体向量库中最多读取 10000 条符合过滤条件的实体。
            listed = self.entity_store.list(filters=filters, top_k=10000)
        # 如果实体列表查询失败, 后续调用者会改用向量语义相似度进行去重。
        except Exception as e:
            logger.debug(f"Exact entity lookup failed, falling back to semantic dedup: {e}")
            return {}

        # 用于保存:规范化实体文本 → 实体记录
        rows_by_text = {}
        for row in _vector_store_list_rows(listed):
            # 如果没有 payload 或值是 None,就使用空字典。
            payload = getattr(row, "payload", None) or {}
            '''
            实体文本保存在 payload 的 data 字段中,例如:
            {
                "data": "OpenAI",
                "entity_type": "organization",
            }
            此时:text = "OpenAI"
            '''
            text = payload.get("data")
            # 如果 data 不是字符串,就跳过这条记录。
            if not isinstance(text, str):
                continue
            '''
                规范化实体文本, 例如:
                    "  OpenAI " → "openai"
                    "New   York" → "new york"
            '''
            normalized = self._normalize_entity_text(text)
            '''
                只有在以下条件同时满足时才保存:
                    - 规范化结果不是空字符串;
                    - 字典中还没有这个实体。
            '''
            if normalized and normalized not in rows_by_text:
                rows_by_text[normalized] = row
        return rows_by_text

    '''
    用于把实体写入实体库,并把实体与某条记忆关联起来。
    update(存在则更新)+ insert(不存在则插入)
    参数含义:
    entity_text:实体文本,例如 "OpenAI"。
    entity_type:实体类型,例如 "organization"。
    memory_id:包含该实体的记忆 ID。
    filters:用户、Agent、运行等范围条件。
    '''

    '''
    _upsert_entity 函数的整体流程如下:
        实体文本
            ↓
        生成向量
            ↓
        精确文本查重
            ↓ 没找到
        语义相似度查重
            ↓
        找到实体?─────────────┐
            │是                │否
            ↓                  ↓
        追加 memory_id       创建新实体
            ↓                   ↓
        更新 payload         插入实体库
    '''
    def _upsert_entity(self, entity_text, entity_type, memory_id, filters):
        """Upsert an entity into the entity store, linking it to a memory."""
        try:
            # 把实体文本转换成向量。
            entity_embedding = self.embedding_model.embed(entity_text, "add")
            # 只保留有效的 ID
            search_filters = {k: v for k, v in filters.items() if k in ("user_id", "agent_id", "run_id") and v}
            '''
            下面一行执行过程:
            读取当前范围的所有实体
                    ↓
            按规范化文本建立字典
                    ↓
            规范化当前 entity_text
                    ↓
            在字典中精确查找
            '''
            exact_match = self._existing_entities_by_text(search_filters).get(self._normalize_entity_text(entity_text))

            existing = []
            # 只有没有找到精确匹配时,才进行向量语义搜索。
            if exact_match is None:
                existing = self.entity_store.search(
                    query=entity_text,              # 原始实体文本。
                    vectors=entity_embedding,       # 实体向量。
                    top_k=1,                        # 只取最相近的一条。
                    filters=search_filters,         # 限定用户、Agent 或运行范围。
                )

            '''
            只有同时满足以下条件才算语义匹配:
                - 搜索结果不为空;
                - 第一条结果的相似度不低于 0.95。
            '''
            semantic_match = existing[0] if existing and existing[0].score >= 0.95 else None
            # 优先使用精确匹配
            match = exact_match or semantic_match
            if match:
                # Update existing entity's linked_memory_ids
                payload = match.payload or {}
                # 取得该实体已经关联的记忆 ID 列表。
                linked_ids = payload.get("linked_memory_ids", [])
                # 如果当前记忆还没有关联,就加入当前记忆 ID。
                if memory_id not in linked_ids:
                    linked_ids.append(memory_id)
                    payload["linked_memory_ids"] = linked_ids
                    '''
                    更新已有实体:
                        - vector_id=match.id:要更新的实体 ID。
                        - vector=None:不修改实体向量。
                        - payload=payload:更新关联的记忆 ID。
                    '''
                    self.entity_store.update(
                        vector_id=match.id,
                        vector=None,
                        payload=payload,
                    )
            else:
                # Create new entity
                # 生成唯一实体 ID。
                entity_id = str(uuid.uuid4())
                entity_payload = {
                    "data": entity_text,
                    "entity_type": entity_type,
                    "linked_memory_ids": [memory_id],
                    **{k: v for k, v in search_filters.items()},    # 把 search_filters 中的字段展开并合并进字典。
                }
                # 把新实体写入向量库:
                self.entity_store.insert(
                    vectors=[entity_embedding],
                    ids=[entity_id],
                    payloads=[entity_payload],
                )
        # 实体更新或插入失败
        except Exception as e:
            logger.warning(f"Entity upsert failed for '{entity_text}': {e}")
python
    '''
    用于在一条记忆被删除或修改时,清理实体与该记忆之间的关联。核心规则是:
        实体还关联其他记忆 → 只移除当前 memory_id
        实体没有关联任何记忆 → 删除整个实体

        self:当前 Memory 对象。
        memory_id:要解除关联的记忆 ID。
        filters:用户、Agent、运行范围。

        整体流程是:
        准备删除/修改一条记忆
                ↓
        查找当前范围内所有实体
                ↓
        实体是否关联该 memory_id?
                ↓ 是
        移除 memory_id
                ↓
        还有其他关联吗?
        ┌──────┴──────┐
        │有           │没有
        ↓             ↓
        更新实体       删除实体
    '''
    def _remove_memory_from_entity_store(self, memory_id, filters):
        """Strip `memory_id` from every entity record scoped to `filters`.

        For each entity whose `linked_memory_ids` contains `memory_id`:
          - remove the id; if the list becomes empty, delete the entity record.
          - otherwise re-embed the entity text and update the payload
            (the vector store's update() requires a vector).

        No-op if the entity store has never been initialized in this process.
        Errors on individual entities are swallowed at debug level; outer
        failures are swallowed at warning level so the primary delete/update
        path is never broken by entity cleanup.
        """
        # 如果当前程序还没有创建实体库,就直接结束,不为了清理操作额外创建实体库。
        if self._entity_store is None:
            return
        # 只保留有效的身份范围
        search_filters = {k: v for k, v in filters.items() if k in ("user_id", "agent_id", "run_id") and v}
        try:
            # 最多取得当前范围内的 10000 条实体记录。
            listed = self.entity_store.list(filters=search_filters, top_k=10000)
            '''
            不同向量库可能返回: [row1, row2] 或者 [[row1, row2]],如果是嵌套列表,就取第一层:
            rows = listed[0]
            表示判断 listed 是否为以下任意一种类型:list 或 tuple
            '''
            rows = listed[0] if isinstance(listed, (list, tuple)) and listed and isinstance(listed[0], list) else listed
            for row in rows or []:
                # 单独捕获每条实体的清理异常,某一条失败不会影响其他实体。
                try:
                    # 取得实体附加信息;不存在时使用空字典。
                    payload = getattr(row, "payload", None) or {}
                    # 取得该实体关联的记忆 ID 列表。
                    linked = payload.get("linked_memory_ids", [])
                    '''
                    以下情况直接跳过:
                        - linked_memory_ids 不是列表;
                        - 当前实体没有关联这个 memory_id。
                    '''
                    if not isinstance(linked, list) or memory_id not in linked:
                        continue
                    # 生成一个新列表,移除所有等于当前 memory_id 的元素。
                    remaining = [mid for mid in linked if mid != memory_id]
                    # 如果列表为空,说明实体已经不属于任何记忆。直接删除该实体记录。
                    if not remaining:
                        try:
                            self.entity_store.delete(vector_id=row.id)
                        except Exception as e:
                            logger.debug(f"Entity delete failed for id={row.id}: {e}")
                    else:
                        # 取得实体文本。
                        entity_text = payload.get("data")
                        # 如果实体文本不存在或不是字符串,无法重新生成向量,因此跳过更新。
                        if not isinstance(entity_text, str) or not entity_text:
                            logger.debug(f"Entity id={row.id} missing 'data'; skipping update during cleanup")
                            continue
                        try:
                            # 重新把实体文本转换成向量。
                            vec = self.embedding_model.embed(entity_text, "update")
                        except Exception as e:
                            logger.debug(f"Entity re-embed failed for '{entity_text}': {e}")
                            continue
                        # 复制原 payload,然后用 remaining 覆盖旧的关联列表。
                        # ** 表示把原字典中的所有键值对展开到新字典。
                        # Python 字典中如果出现重复的键,后面的值会覆盖前面的值。
                        new_payload = {**payload, "linked_memory_ids": remaining}
                        try:
                            self.entity_store.update(
                                vector_id=row.id,
                                vector=vec,
                                payload=new_payload,
                            )
                        except Exception as e:
                            logger.debug(f"Entity update failed for id={row.id}: {e}")
                except Exception as e:
                    logger.debug(f"Entity cleanup error: {e}")
        except Exception as e:
            logger.warning(f"Entity store cleanup failed for memory_id={memory_id}: {e}")

    '''
    从一条记忆文本中提取实体,并把这些实体与该记忆的 memory_id 建立关联。
    memory_id:当前记忆的 ID。
    text:当前记忆的文本。
    filters:user_id、agent_id、run_id 等范围。
    记忆文本
        ↓
    提取实体
        ↓
    规范化并去重
        ↓
    逐个调用 _upsert_entity()
        ↓
    实体存在就更新关联
    实体不存在就创建
    '''
    def _link_entities_for_memory(self, memory_id, text, filters):
        """Extract entities from `text` and link them to `memory_id` in the
        entity store, scoped to `filters`. Simpler single-memory variant of
        Phase 7 in add(): per-entity search-then-update-or-insert via the
        existing `_upsert_entity` helper. Non-fatal on any failure.
        """
        try:
            # 不太明白是怎么提取的,输入和输出各是什么?
            entities = extract_entities(text)
            if not entities:
                return
            # 用于记录当前文本中已经处理过的实体,防止重复关联。
            seen = set()
            for entity_type, entity_text in entities:
                key = self._normalize_entity_text(entity_text)
                if not key or key in seen:
                    continue
                seen.add(key)
                try:
                    self._upsert_entity(entity_text, entity_type, memory_id, filters)
                except Exception as e:
                    logger.debug(f"Entity link failed for '{entity_text}': {e}")
        except Exception as e:
            logger.warning(f"Entity linking failed for memory_id={memory_id}: {e}")

    # from_config() 接收普通配置字典,先通过 Pydantic 转换和校验为 MemoryConfig,
    # 校验成功后再调用构造函数创建 Memory 对象;配置错误时记录日志并继续抛出异常。
    @classmethod
    def from_config(cls, config_dict: Dict[str, Any]):  # cls 表示当前类本身,例如Memory类
        try:
            # ** 将字典展开成关键字参数。
            config = MemoryConfig(**config_dict)
        except ValidationError as e:
            logger.error(f"Configuration validation error: {e}")
            raise
        # 当:cls is Memory, 这行等价于:return Memory(config)
        return cls(config)

    '''
    用于判断:当前是否应该使用"Agent 记忆提取模式",而不是普通的用户记忆提取模式。
    self:当前 Memory 对象。
    messages:对话消息列表。
    metadata:记忆元数据,可能包含 agent_id。

    messages
    ├── role=user
    │   └── 用户说的话
    └── role=assistant
        └── AI 说的话

    agent_id
    └── 说明这个 AI 具体是哪一个 Agent
    '''
    def _should_use_agent_memory_extraction(self, messages, metadata):
        """Determine whether to use agent memory extraction based on the logic:
        - If agent_id is present and messages contain assistant role -> True
        - Otherwise -> False

        Args:
            messages: List of message dictionaries
            metadata: Metadata containing user_id, agent_id, etc.

        Returns:
            bool: True if should use agent memory extraction, False for user memory extraction
        """
        # Check if agent_id is present in metadata
        has_agent_id = metadata.get("agent_id") is not None

        # Check if there are assistant role messages
        # any() 只要发现一个 True
        has_assistant_messages = any(msg.get("role") == "assistant" for msg in messages)

        # Use agent memory extraction if agent_id is present and there are assistant messages
        return has_agent_id and has_assistant_messages
python
'''
Memory.add() 是 Mem0 写入记忆的入口方法。
它负责接收消息、整理参数、校验格式,然后调用 _add_to_vector_store() 完成真正的记忆提取和保存。
- messages:对话消息
- user_id:记忆属于哪个用户
- agent_id:记忆属于哪个 Agent
- run_id:记忆属于哪次运行
- metadata:额外元数据
- expiration_date:过期日期
- infer:是否让 LLM 提取关键记忆
- memory_type:记忆类型
- prompt:自定义记忆提取提示词
* 表示它后面的参数必须使用参数名传递
'''
def add(
self,
messages,
*,
user_id: Optional[str] = None,
agent_id: Optional[str] = None,
run_id: Optional[str] = None,
metadata: Optional[Dict[str, Any]] = None,
timestamp: Optional[Any] = None,
expiration_date: Optional[Any] = None,
infer: bool = True,
memory_type: Optional[str] = None,
prompt: Optional[str] = None,
):
"""
Create a new memory.
Adds new memories scoped to a single session id (e.g. `user_id`, `agent_id`, or `run_id`). One of those ids is required.
Args:
messages (str or List[Dict[str, str]]): The message content or list of messages
(e.g., `[{"role": "user", "content": "Hello"}, {"role": "assistant", "content": "Hi"}]`)
to be processed and stored.
user_id (str, optional): ID of the user creating the memory. Defaults to None.
agent_id (str, optional): ID of the agent creating the memory. Defaults to None.
run_id (str, optional): ID of the run creating the memory. Defaults to None.
metadata (dict, optional): Metadata to store with the memory. Defaults to None.
timestamp (Any, optional): Platform-only temporal parameter. Not supported in OSS.
expiration_date (Any, optional): Date in YYYY-MM-DD format. Expired memories are hidden
from search and get_all unless show_expired is True.
infer (bool, optional): If True (default), an LLM is used to extract key facts from
'messages' and decide whether to add, update, or delete related memories.
If False, 'messages' are added as raw memories directly.
memory_type (str, optional): Specifies the type of memory. Currently, only
`MemoryType.PROCEDURAL.value` ("procedural_memory") is explicitly handled for
creating procedural memories (typically requires 'agent_id'). Otherwise, memories
are treated as general conversational/factual memories.
prompt (str, optional): Prompt to use for the memory creation. Defaults to None.
Note:
`search()` and `get_all()` scope queries via `filters={"user_id": "...", "agent_id": "...", "run_id": "..."}` ---
they reject top-level `user_id`/`agent_id`/`run_id` arguments. `add()` accepts them top-level, but passing
the same arguments to `search()`/`get_all()` raises a `ValueError`; use the `filters` form there instead.
Returns:
dict: A dictionary containing the result of the memory addition operation, typically
including a list of memory items affected (added, updated) under a "results" key.
Example for v1.1+: `{"results": [{"id": "...", "memory": "...", "event": "ADD"}]}`
Raises:
Mem0ValidationError: If input validation fails (invalid memory_type, messages format, etc.).
VectorStoreError: If vector store operations fail.
EmbeddingError: If embedding generation fails.
LLMError: If LLM operations fail.
DatabaseError: If database operations fail.
"""
# 开源版 OSS 的 add() 不支持 timestamp。如果传入,就抛出错误。为啥不支持?
# OSS: Open Source Software 开源软件
if timestamp is not None:
raise ValueError(get_temporal_feature_error_message("sync", "add", "timestamp"))
# 把日期统一转换成:YYYY-MM-DD
normalized_expiration_date = _normalize_expiration_date(expiration_date)
# 这个函数检查 metadata 中是否包含明显的时间信息。
temporal_usage_notice = detect_temporal_usage_from_metadata(metadata)
# 构建元数据和过滤条件
# processed_metadata # 写入记忆的元数据
# effective_filters # 查询已有记忆时的过滤条件
processed_metadata, effective_filters = _build_filters_and_metadata(
user_id=user_id,
agent_id=agent_id,
run_id=run_id,
input_metadata=metadata,
)
if normalized_expiration_date is not None:
processed_metadata["expiration_date"] = normalized_expiration_date
# 检查记忆类型。如果传入了 memory_type,当前这里只接受:"procedural_memory",否则抛出参数校验错误。
# 为什么 memory_type 只接受 procedural_memory?当前 Memory.add() 中,memory_type 参数只被用来开启一种特殊流程:
# 普通事实记忆不需要传 memory_type,默认流程就会处理。
# 程序性记忆描述的是 Agent 如何完成任务,例如:先读取配置文件,然后连接数据库,最后执行查询。
# 因此,当前代码只允许通过 memory_type 显式选择程序性记忆。
# semantic_memory 和 episodic_memory 虽然存在于枚举中,但没有在当前 add() 参数中实现对应的独立处理分支。
if memory_type is not None and memory_type != MemoryType.PROCEDURAL.value:
raise Mem0ValidationError(
message=f"Invalid 'memory_type'. Please pass {MemoryType.PROCEDURAL.value} to create procedural memories.",
error_code="VALIDATION_002",
details={"provided_type": memory_type, "valid_type": MemoryType.PROCEDURAL.value},
suggestion=f"Use '{MemoryType.PROCEDURAL.value}' to create procedural memories."
)
if isinstance(messages, str):
messages = [{"role": "user", "content": messages}]
elif isinstance(messages, dict):
messages = [messages]
elif not isinstance(messages, list):
raise Mem0ValidationError(
message="messages must be str, dict, or list[dict]",
error_code="VALIDATION_003",
details={"provided_type": type(messages).__name__, "valid_types": ["str", "dict", "list[dict]"]},
suggestion="Convert your input to a string, dictionary, or list of dictionaries."
)
'''
messages 是需要被理解和提取记忆的对话内容:
messages = [
{"role": "user", "content": "我喜欢喝拿铁"}
]
绝大部分 metadata 是调用 memory.add() 时,由你的应用程序或开发者主动传进去的。
metadata 是附加在记忆上的说明信息:
metadata = {
"source": "mobile_app",
"category": "food",
}
也即: messages = 记忆的内容, metadata = 记忆身上的标签和附加信息。
例如:那么Mem0 读到"披萨"后 是怎么分类的?
准确来说,Mem0 读到"披萨"后,默认不会把它分类成:{"category": "food"},
它主要进行了"事实提取"和"向量化",而不是传统的标签分类。处理过程大致是:
"我喜欢吃披萨"
↓
LLM 提取事实
↓
"用户喜欢吃披萨"
↓
Embedding 模型转换成向量
↓
保存到向量数据库
如果希望自动分类,需要在调用 add() 前,由应用程序或 LLM 生成标签。
一句话总结:Mem0 默认不会把"披萨"明确分类为 food,而是把相关事实转换成语义向量;
category="food" 需要调用者或额外分类程序主动提供。
'''
if agent_id is not None and memory_type == MemoryType.PROCEDURAL.value:
results = self._create_procedural_memory(messages, metadata=processed_metadata, prompt=prompt)
scale_threshold_notice = detect_scale_threshold_from_add_result(self, results)
if temporal_usage_notice:
display_temporal_usage_notice(self, "sync", "add", *temporal_usage_notice)
elif scale_threshold_notice:
display_scale_threshold_notice(self, "sync", "add", *scale_threshold_notice)
else:
display_first_run_notice(self, "sync", "add")
return results
# 处理图片消息
# 如果模型支持视觉,就让模型把图片转换成文字描述;否则主要保留其中的文本内容。
if self.config.llm.config.get("enable_vision"):
messages = parse_vision_messages(messages, self.llm, self.config.llm.config.get("vision_details"))
else:
messages = parse_vision_messages(messages)
# 保存到向量数据库
vector_store_result = self._add_to_vector_store(messages, processed_metadata, effective_filters, infer, prompt=prompt)
# 检测当前记忆库的规模是否达到了提示阈值。
scale_threshold_notice = detect_scale_threshold_from_add_result(self, vector_store_result)
# 这些 notice 主要是提示和遥测逻辑,不是记忆保存的核心流程;
# 即使最终没有真正显示提示,前面的记忆通常也已经保存完成。
if temporal_usage_notice:
display_temporal_usage_notice(self, "sync", "add", *temporal_usage_notice)
elif scale_threshold_notice:
display_scale_threshold_notice(self, "sync", "add", *scale_threshold_notice)
else:
display_first_run_notice(self, "sync", "add")
return {"results": vector_store_result}
'''
_add_to_vector_store 函数的核心作用是:把输入的对话转化为可长期检索的记忆,
生成向量后写入向量数据库,同时维护历史记录、原始消息和实体索引。
messages:已经统一格式的对话消息
metadata:写入每条记忆的附加信息
filters:查找当前用户、Agent 或运行范围内的旧记忆
infer:是否使用 LLM 提取记忆
prompt:自定义提取提示词
'''
def _add_to_vector_store(self, messages, metadata, filters, infer, prompt=None):
if not infer:
returned_memories = []
# 不让 LLM 提取事实,直接保存消息原文。
for message_dict in messages:
# 过滤无效的信息,比如不符合格式、消息内容为空等
if (
not isinstance(message_dict, dict)
or message_dict.get("role") is None
or message_dict.get("content") is None
):
logger.warning(f"Skipping invalid message format: {message_dict}")
continue
# 系统提示词不作为用户记忆保存。
if message_dict["role"] == "system":
continue
# 深拷贝元数据,避免处理一条消息时修改其他消息的元数据。这点其实不太明白
per_msg_meta = deepcopy(metadata)
per_msg_meta["role"] = message_dict["role"]
# 获取说话者名称。
actor_name = message_dict.get("name")
# 如果提供了说话者名称,将说话者写入元数据。
if actor_name:
per_msg_meta["actor_id"] = actor_name
msg_content = message_dict["content"]
# 将消息正文转换为向量。
msg_embeddings = self.embedding_model.embed(msg_content, "add")
# 创建记忆并写入向量库及历史库。这个函数定义在后面
mem_id = self._create_memory(msg_content, {msg_content: msg_embeddings}, per_msg_meta)
# 将记忆 ID、正文、事件类型等加入返回结果。
returned_memories.append(
{
"id": mem_id,
"memory": msg_content,
"event": "ADD",
"actor_id": actor_name if actor_name else None,
"role": message_dict["role"],
}
)
return returned_memories
# === V3 PHASED BATCH PIPELINE ===
# 收集上下文
# Phase 0: Context gathering
# 下面三行代码基础内容:会话隔离、上下文窗口、消息格式化。
# 根据 user_id、agent_id、run_id 建立当前会话范围。
session_scope = _build_session_scope(filters)
# 读取当前范围最近的 10 条原始消息,给 LLM 提供上下文。
last_messages = self.db.get_last_messages(session_scope, limit=10)
# 将消息列表整理成适合检索及提示词使用的字符串。
parsed_messages = parse_messages(messages)
# Phase 1: Existing memory retrieval
# 阶段 1:检索已有记忆
# 只保留有效的实体范围字段,避免把无关 metadata 当作检索条件。
search_filters = {k: v for k, v in filters.items() if k in ("user_id", "agent_id", "run_id") and v}
# 把整段新对话转换为查询向量。这个还不太清楚转换流程,之前看的忘了
query_embedding = self.embedding_model.embed(parsed_messages, "search")
# 从当前用户或会话的向量库中检索最相关的 10 条旧记忆。
# 语义检索:新对话向量 ≈ 旧记忆向量,向量越接近,通常表示语义越相似。
existing_results = self.vector_store.search(
query=parsed_messages,
vectors=query_embedding,
top_k=10,
filters=search_filters,
)
# Map UUIDs to integers (anti-hallucination)
existing_memories = []
uuid_mapping = {}
for idx, mem in enumerate(existing_results):
# 把 "0"、"1" 等短编号映射到真实 UUID,减少 LLM 复制复杂 UUID 时出现幻觉或拼写错误的概率。
# "0"、"1" 是程序临时生成的编号
'''
enumerate(existing_results) 会生成:
idx=0, mem=第一条旧记忆
idx=1, mem=第二条旧记忆
idx=2, mem=第三条旧记忆
'''
uuid_mapping[str(idx)] = mem.id
# 只把短 ID 和记忆正文交给 LLM。
# mem.payload.get("data", ""): 从 mem.payload 中读取键 "data" 对应的值;如果没有 "data",就返回空字符串 ""。
existing_memories.append({"id": str(idx), "text": mem.payload.get("data", "")})
# Phase 2: LLM extraction (single call)
# 阶段 2:使用 LLM 提取新记忆
# 判断当前记忆是否只属于 Agent,而不是某个用户。
is_agent_scoped = bool(filters.get("agent_id")) and not filters.get("user_id")
# 使用"增量记忆提取"系统提示词,其目标是只提取值得长期保存的新事实。
system_prompt = ADDITIVE_EXTRACTION_PROMPT
# 如果是 Agent 级记忆,就追加 Agent 专用提取规则。
if is_agent_scoped:
system_prompt += AGENT_CONTEXT_SUFFIX
# 优先使用本次调用传入的 prompt,否则使用实例级自定义指令。这里利用了 Python or 的短路规则。
custom_instr = prompt or self.custom_instructions
# 将以下信息组合成用户提示词:已有相关记忆;当前新消息;最近 10 条消息;自定义提取规则。
user_prompt = generate_additive_extraction_prompt(
existing_memories=existing_memories,
new_messages=parsed_messages,
last_k_messages=last_messages,
custom_instructions=custom_instr,
)
'''
LLM 调用失败时:
记录错误;
将原始异常包装成统一的 LLMError;
使用 from e 保留原始异常链;
交给上层进行重试或备用模型切换。
模型是如何理解规则和完成任务的:
1. 从训练中学到语言、概念和任务模式;
2. 根据提示词识别当前任务;
3. 根据示例推断输出结构;
4. 根据上下文预测最合适的后续内容;
5. 通过指令微调学习优先遵守 system 和 user 指令。
模型可能因为以下原因偏离规则:
- 指令含糊;
- 多条规则互相矛盾;
- 输入内容太长;
- 用户输入试图覆盖系统规则;
- 模型能力不足;
- 示例和文字规则不一致;
- 模型生成了带代码块的 JSON;
- 模型产生幻觉;
- 使用的模型并不严格支持 response_format。
LLM 负责语义理解和信息提取;Python 代码负责格式校验、去重、持久化和错误处理。
'''
try:
# 调用 LLM。
response = self.llm.generate_response(
# 按照聊天模型的 system/user 消息格式组织提示词。
messages=[
{"role": "system", "content": system_prompt},
{"role": "user", "content": user_prompt},
],
# 要求模型输出 JSON 对象,方便程序解析。
response_format={"type": "json_object"},
)
except Exception as e:
# Re-raise so callers can implement provider fallback / retry.
# The original silent ``return []`` made upstream callers unable to
# distinguish "LLM unavailable" (429/5xx/timeout) from "LLM
# extracted no facts" -- both surfaced as an empty list.
logger.error(f"LLM extraction failed: {e}")
raise LLMError(f"LLM extraction failed: {e}") from e
# Parse response
# 解析 LLM 输出
try:
# 去掉 LLM 可能附加的 Markdown 代码块
response = remove_code_blocks(response)
# 如果结果为空或只有空白字符,就认为没有提取到记忆。
if not response or not response.strip():
extracted_memories = []
else:
try:
# 把 JSON 字符串转换为 Python 字典,并读取 "memory" 列表。
extracted_memories = json.loads(response, strict=False).get("memory", [])
# 如果整个回复不是合法 JSON,就尝试从夹杂说明文字的回复中截取 JSON 部分。
except json.JSONDecodeError:
extracted_json = extract_json(response)
extracted_memories = json.loads(extracted_json, strict=False).get("memory", [])
# 解析仍失败时,记录日志并按"没有记忆"处理。
except Exception as e:
logger.error(f"Error parsing extraction response: {e}")
extracted_memories = []
# 即使没有提取出长期记忆,也会保存原始消息,以便下一次提取时作为上下文。
if not extracted_memories:
# Save messages even if nothing extracted
self.db.save_messages(messages, session_scope)
return []
# Phase 3: Batch embed all extracted memory texts
# 阶段 3:批量生成记忆向量
# 使用列表推导式提取所有非空记忆正文。
mem_texts = [m.get("text", "") for m in extracted_memories if m.get("text")]
try:
# 一次性批量生成向量,通常比逐条调用更快。向量生成函数定义忘了,后面再回忆一下
mem_embeddings_list = self.embedding_model.embed_batch(mem_texts, "add")
# 利用 zip() 将文本和向量一一配对:
embed_map = dict(zip(mem_texts, mem_embeddings_list))
# 如果批量接口失败,就进入 except,逐条调用 embed();单条失败只跳过该条,不中断整个任务。
except Exception:
# Fallback: embed individually
embed_map = {}
for text in mem_texts:
try:
embed_map[text] = self.embedding_model.embed(text, "add")
except Exception as e:
logger.warning(f"Failed to embed memory text: {e}")
# Phase 4: Per-memory CPU processing + Phase 5: Hash dedup
# Build set of existing hashes for dedup
# 阶段 4、5:构造记录并去重
# 创建集合,保存已有记忆的哈希值。集合查询通常是近似 O(1)。
'''
existing_hashes 和 seen_hashes 都用于记忆去重,但检查范围不同。
existing_hashes:防止与旧记忆重复。保存的是:从向量数据库检索出的已有记忆的哈希值。
seen_hashes:防止当前批次内部重复。本次正在处理的新记忆的哈希值。
'''
existing_hashes = set()
for mem in existing_results:
# 安全地读取旧记忆的 hash。
h = mem.payload.get("hash") if hasattr(mem, "payload") and mem.payload else None
if h:
existing_hashes.add(h)
# 待写入的完整记录
records = [] # (memory_id, text, embedding, payload)
# 当前批次中已出现的记忆,用于批内去重。
seen_hashes = set() # dedup within the current batch
for mem in extracted_memories:
# 跳过空文本或向量生成失败的记忆。
text = mem.get("text")
if not text or text not in embed_map:
continue
# 过程为:字符串 → UTF-8 字节 → MD5 → 十六进制字符串
# 这里 MD5 只是用来快速判断文本是否完全相同,不用于密码或安全认证。
mem_hash = hashlib.md5(text.encode()).hexdigest()
# 同时避免:与数据库已有记忆重复;同一批次内部重复。
if mem_hash in existing_hashes or mem_hash in seen_hashes:
logger.debug(f"Skipping duplicate memory (hash match): {text[:50]}")
continue
seen_hashes.add(mem_hash)
# 对文本进行词形归一化,供 BM25 关键词检索使用。例如将英语复数、时态尽量归一到基础词形。
text_lemmatized = lemmatize_for_bm25(text)
# 为新记忆生成全局唯一 ID。
memory_id = str(uuid.uuid4())
# 为每条记忆建立独立 metadata,避免不同记录相互污染。
mem_metadata = deepcopy(metadata)
'''
接下来依次写入:
data:记忆原文;
text_lemmatized:BM25 检索文本;
hash:去重哈希;
created_at:创建时间;
updated_at:更新时间;
attributed_to:该事实归属于哪个参与者。
为什么要考虑这些变量?
'''
mem_metadata["data"] = text
mem_metadata["text_lemmatized"] = text_lemmatized
mem_metadata["hash"] = mem_hash
if "created_at" not in mem_metadata:
mem_metadata["created_at"] = datetime.now(timezone.utc).isoformat()
mem_metadata["updated_at"] = mem_metadata["created_at"]
if mem.get("attributed_to"):
mem_metadata["attributed_to"] = mem["attributed_to"]
# 把一条待保存记录组织为元组:(ID, 文本, 向量, 元数据)
records.append((memory_id, text, embed_map[text], mem_metadata))
# 经过所有过滤后,没有任何可以写入向量库的新记忆
# 没有合格的新记忆时,不写向量库;但仍保存原始消息,然后返回空结果。
if not records:
self.db.save_messages(messages, session_scope)
return []
# Phase 6: Batch persist
# 阶段 6:批量写入向量库
# 分别提取向量、ID 和元数据,以符合向量库的批量接口。
all_vectors = [r[2] for r in records]
all_ids = [r[0] for r in records]
all_payloads = [r[3] for r in records]
try:
# 批量写入向量库。
self.vector_store.insert(
vectors=all_vectors,
ids=all_ids,
payloads=all_payloads,
)
except Exception:
# Fallback: insert one by one
# 如果批量写入失败,则通过:逐条重试。
# 某条仍失败时记录错误,但继续处理其他记录。这属于"批量优先、单条降级"的容错设计。
for mid, vec, pay in zip(all_ids, all_vectors, all_payloads):
try:
self.vector_store.insert(vectors=[vec], ids=[mid], payloads=[pay])
except Exception as e:
logger.error(f"Failed to insert memory {mid}: {e}")
# Batch history
# 写入记忆变更历史
'''
每条历史记录包含:
- memory_id:记忆 ID;
- old_memory=None:新增操作没有旧值;
- new_memory:新增的记忆正文;
- event="ADD":操作类型;
- created_at:发生时间;
- is_deleted=0:未删除。
'''
history_records = [
{
"memory_id": r[0],
"old_memory": None,
"new_memory": r[1],
"event": "ADD",
"created_at": r[3].get("created_at"),
"is_deleted": 0,
}
for r in records
]
# 优先调用 batch_add_history() 批量写入;失败后使用 add_history() 逐条写入。
try:
self.db.batch_add_history(history_records)
except Exception:
# Fallback: add one by one
for hr in history_records:
try:
self.db.add_history(hr["memory_id"], None, hr["new_memory"], "ADD", created_at=hr.get("created_at"))
except Exception as e:
logger.error(f"Failed to add history for {hr['memory_id']}: {e}")
# Phase 7: Batch entity linking
# 阶段 7:实体抽取与关联
try:
# 批量从记忆中识别人名、地点、组织等实体。
all_texts = [r[1] for r in records]
all_entities = extract_entities_batch(all_texts)
# 7a: Global dedup --- collect unique entities across all memories
# 建立本批次的全局实体表。一个实体可以关联多条记忆。
global_entities = {} # normalized_key -> (entity_type, entity_text, set of memory_ids)
for idx, (memory_id, text, embedding, payload) in enumerate(records):
entities = all_entities[idx] if idx < len(all_entities) else []
for entity_type, entity_text in entities:
# 规范化实体名称,例如处理大小写、空格等差异。
key = self._normalize_entity_text(entity_text)
if key in global_entities:
# 如果实体已经出现,把新的记忆 ID 加入集合;集合可以自动去重。
global_entities[key][2].add(memory_id)
else:
global_entities[key] = [entity_type, entity_text, {memory_id}]
'''
接下来:
1. 批量生成实体向量;
2. 修正向量数量与实体数量不一致的情况;
3. 排除向量生成失败的实体;
4. _existing_entities_by_text() 查找文本完全相同的实体;
5. search_batch() 查找语义相似实体;
6. 相似度达到 0.95 时视为同一个实体;
7. 已有实体就更新 linked_memory_ids;
8. 新实体就批量插入 entity_store。
这里组合了两种实体去重方法:
精确文本匹配
或
向量相似度 >= 0.95
'''
# 判断是否提取到了实体
if global_entities:
# 获取所有字典键,即取出规范化实体键并转成列表
ordered_keys = list(global_entities.keys())
entity_texts = [global_entities[k][1] for k in ordered_keys]
# 7b: Single batch embed for all unique entities
try:
entity_embeddings = self.embedding_model.embed_batch(entity_texts, "add")
except Exception:
# Fallback: embed individually, use None for failures
entity_embeddings = []
for t in entity_texts:
try:
entity_embeddings.append(self.embedding_model.embed(t, "add"))
except Exception:
entity_embeddings.append(None)
#比较:实际返回的向量数量;原始实体数量
# 因为某些 embed_batch() 实现可能少返回或多返回向量。
if len(entity_embeddings) != len(ordered_keys):
logger.warning(
"embed_batch returned %d vectors for %d entity texts --- "
"padding/truncating to avoid dropping entity links",
len(entity_embeddings),
len(ordered_keys),
)
# 向量太多时截断,只保留与实体数量相同的前几个向量。
entity_embeddings = list(entity_embeddings[: len(ordered_keys)])
# 向量太少时补充 None
entity_embeddings += [None] * (len(ordered_keys) - len(entity_embeddings))
# Filter out entities with failed embeddings
# 过滤向量生成失败的实体
'''
enumerate(ordered_keys) 同时产生下标和键:
[
(0, "openai"),
(1, "beijing"),
(2, "shanghai"),
]
'''
valid = [(i, k) for i, k in enumerate(ordered_keys) if entity_embeddings[i] is not None]
# 判断是否还有有效实体
if valid:
'''
valid = [
(0, "openai"),
(2, "shanghai"),
]
分离下标与实体键,*valid 相当于把列表拆开:
zip(
(0, "openai"),
(2, "shanghai"),
)
zip() 将同一列的数据组合起来,结果相当于:
valid_indices = (0, 2)
valid_keys = ("openai", "shanghai")
'''
valid_indices, valid_keys = zip(*valid)
# 取得有效向量
valid_vectors = [entity_embeddings[i] for i in valid_indices]
# 查找文本完全相同的已有实体
# 从实体库中读取当前用户、Agent 或会话范围内已有的实体,并按照规范化文本建立索引。
exact_matches = self._existing_entities_by_text(search_filters)
# 7c: Batch search for existing entities
# 根据有效实体键取得实体原文。
valid_texts = [global_entities[k][1] for k in valid_keys]
# 在实体向量库中批量搜索相似实体。
existing_matches = self.entity_store.search_batch(
# 提供原始查询文本: ["OpenAI", "Shanghai"]
queries=valid_texts,
# 传入每个实体对应的查询向量。
vectors_list=valid_vectors,
# 每个实体只返回最相似的一条旧实体。
top_k=1,
# 只搜索当前用户、Agent 或会话范围中的实体。
filters=search_filters,
)
# 7d: Separate into inserts vs updates
to_insert_vectors, to_insert_ids, to_insert_payloads = [], [], []
# 遍历有效实体键,并取得它在有效列表中的下标。
for j, key in enumerate(valid_keys):
# 取出实体完整信息。序列解包
entity_type, entity_text, memory_ids = global_entities[key]
# 取出当前实体的语义匹配结果
matches = existing_matches[j] if j < len(existing_matches) else []
# 取得文本精确匹配结果,即从精确匹配字典中查找当前实体。
exact_match = exact_matches.get(key)
# 判断语义相似度是否足够高
# 检查搜索结果非空,相似度达到 0.95,才认为可能是同一个实体
semantic_match = matches[0] if matches and matches[0].score >= 0.95 else None
# 优先使用精确匹配
match = exact_match or semantic_match
if match:
# Update existing entity
'''
取得已有实体的 payload。例如:
payload = {
"data": "OpenAI",
"entity_type": "organization",
"linked_memory_ids": ["memory-001"],
}
'''
payload = match.payload or {}
# 读取已有的记忆关联,没有该字段时使用空列表。再使用 set() 转换为集合。
# 使用集合是因为集合可以自动去重。
linked = set(payload.get("linked_memory_ids", []))
# 合并新旧记忆 ID
linked |= memory_ids
# 把合并结果写回 payload
# sorted() 将集合排序并转换为列表。排序可以使数据输出更稳定,也方便测试和比较。
payload["linked_memory_ids"] = sorted(linked)
# 尝试更新已有实体
try:
self.entity_store.update(
# 指定需要更新的实体 ID
vector_id=match.id,
# 实体文字没有变化,只是增加了关联记忆 ID,因此通常不需要重新生成或替换向量。
# 不更新实体向量,只更新 payload。
vector=None,
# 写入已经合并好 linked_memory_ids 的元数据。
payload=payload,
)
except Exception as e:
logger.debug(f"Entity update failed for '{entity_text}': {e}")
# 没找到已有实体,表示精确匹配和语义匹配都没有找到已有实体,因此需要新建实体。
else:
# New entity --- collect for batch insert
# 把当前新实体的向量加入待插入向量列表。
to_insert_vectors.append(valid_vectors[j])
# 使用 UUID4 生成一个新的唯一 ID,并转成字符串。
to_insert_ids.append(str(uuid.uuid4()))
# 构造新实体的 payload
to_insert_payloads.append({
"data": entity_text,
# 保存实体类型
"entity_type": entity_type,
# 保存与该实体关联的记忆 ID,并排序、转换为列表。
"linked_memory_ids": sorted(memory_ids),
# 使用字典解包,把检索范围字段合并进 payload。
**search_filters,
})
# 7e: Single batch insert for all new entities
# 判断待插入向量列表是否非空。
if to_insert_vectors:
try:
self.entity_store.insert(
vectors=to_insert_vectors,
ids=to_insert_ids,
payloads=to_insert_payloads,
)
except Exception as e:
logger.warning(f"Batch entity insert failed: {e}")
except Exception as e:
logger.warning(f"Batch entity linking failed: {e}")
# Phase 8: Save messages + return
# 保存本次原始消息,供未来记忆提取使用。
self.db.save_messages(messages, session_scope)
# 把内部记录转换成对外返回的简化格式。
returned_memories = [
{"id": r[0], "memory": r[1], "event": "ADD"}
for r in records
]
# 处理并上报遥测数据,例如:API 版本;使用了哪些过滤字段;- 同步调用类型。
keys, encoded_ids = process_telemetry_filters(filters)
capture_event(
"mem0.add",
self,
{"version": self.api_version, "keys": keys, "encoded_ids": encoded_ids, "sync_type": "sync"},
)
# 返回本次新增的记忆。
return returned_memories