文章目录
- 前言
- 零、论文基本信息
- [一、个性化 Agent 缺少的不是又一份用户画像](#一、个性化 Agent 缺少的不是又一份用户画像)
-
- [1. 群体对齐不等于个人对齐](#1. 群体对齐不等于个人对齐)
- [2. User-specific Fine-tuning 为什么不够现实](#2. User-specific Fine-tuning 为什么不够现实)
- [3. RAG/PAG 为什么仍然不是 Agent 级个性化](#3. RAG/PAG 为什么仍然不是 Agent 级个性化)
- [4. 通用 Agent 为什么仍是一刀切](#4. 通用 Agent 为什么仍是一刀切)
- [二、相关方法与 PersonaAgent 的位置](#二、相关方法与 PersonaAgent 的位置)
- [三、PersonaAgent 方法总览](#三、PersonaAgent 方法总览)
- [四、个性化记忆:Episodic Memory 与 Semantic Memory](#四、个性化记忆:Episodic Memory 与 Semantic Memory)
-
- [1. 为什么需要两类记忆](#1. 为什么需要两类记忆)
- [2. Episodic Memory:保存具体经历](#2. Episodic Memory:保存具体经历)
- [3. Semantic Memory:抽象稳定画像](#3. Semantic Memory:抽象稳定画像)
- [4. 记忆模块的边界](#4. 记忆模块的边界)
- 五、Persona:连接记忆与行动的中介
-
- [1. Persona 不是静态 Profile](#1. Persona 不是静态 Profile)
- [2. Persona 为什么能控制行动空间](#2. Persona 为什么能控制行动空间)
- [3. 一个完整行动例子](#3. 一个完整行动例子)
- 六、测试时用户偏好对齐
-
- [1. 动机:初始 Persona 仍然只是粗略总结](#1. 动机:初始 Persona 仍然只是粗略总结)
- [2. 构造近期交互批次](#2. 构造近期交互批次)
- [3. 优化目标](#3. 优化目标)
- [4. TextGrad:把自然语言批评当作梯度](#4. TextGrad:把自然语言批评当作梯度)
- [5. 一轮优化怎样工作](#5. 一轮优化怎样工作)
- [6. 为什么强调异步更新](#6. 为什么强调异步更新)
- 七、实验设置
-
- [1. 数据集与用户划分](#1. 数据集与用户划分)
- [2. 六项个性化任务](#2. 六项个性化任务)
- [3. 基线](#3. 基线)
- [4. 模型与实现](#4. 模型与实现)
- [5. 指标与证据强度](#5. 指标与证据强度)
- [八、主实验:PersonaAgent 是否真的更好](#八、主实验:PersonaAgent 是否真的更好)
-
- [1. 四项决策任务](#1. 四项决策任务)
- [2. 两项文本生成任务](#2. 两项文本生成任务)
- 九、消融实验:哪个组件最关键
-
- [1. Test-time Alignment 是稳定增益项](#1. Test-time Alignment 是稳定增益项)
- [2. Persona 的价值在于集中控制](#2. Persona 的价值在于集中控制)
- [3. Memory 是个性化证据源](#3. Memory 是个性化证据源)
- [4. Action 是最大贡献项,但消融有混杂因素](#4. Action 是最大贡献项,但消融有混杂因素)
- [十、Persona 分析:不同用户是否学到了不同画像](#十、Persona 分析:不同用户是否学到了不同画像)
- 十一、测试时扩展规律
-
- [1. 增加对齐样本通常有帮助](#1. 增加对齐样本通常有帮助)
- [2. 对齐迭代不是越多越好](#2. 对齐迭代不是越多越好)
- [3. 更多检索记忆总体更好,但并非严格单调](#3. 更多检索记忆总体更好,但并非严格单调)
- [十二、基础模型能力是否影响 PersonaAgent](#十二、基础模型能力是否影响 PersonaAgent)
- 十三、冷启动实验
- 十四、效率分析
- 十五、失败模式与反例
-
- [1. Persona 可能把短期行为固化为长期规则](#1. Persona 可能把短期行为固化为长期规则)
- [2. LLM 同时扮演被优化者与批评者](#2. LLM 同时扮演被优化者与批评者)
- [3. Persona 越写越长](#3. Persona 越写越长)
- [4. 真实行为不总是"偏好标签"](#4. 真实行为不总是“偏好标签”)
- [5. 用户偏好可能与安全规则冲突](#5. 用户偏好可能与安全规则冲突)
- [6. 跨任务 Persona 未必可迁移](#6. 跨任务 Persona 未必可迁移)
- 十六、论文局限性
-
- [1. 真实世界证据仍然有限](#1. 真实世界证据仍然有限)
- [2. 只选历史最丰富的 100 个用户](#2. 只选历史最丰富的 100 个用户)
- [3. 单次运行,没有统计不确定性](#3. 单次运行,没有统计不确定性)
- [4. 缺少成本完整核算](#4. 缺少成本完整核算)
- [5. 没有公开代码](#5. 没有公开代码)
- [6. 基线公平性仍可加强](#6. 基线公平性仍可加强)
- [7. Persona 的正确性缺少直接评估](#7. Persona 的正确性缺少直接评估)
- [十七、与 Agent Memory 系列方法的横向比较](#十七、与 Agent Memory 系列方法的横向比较)
- [十八、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发](#十八、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发)
-
- [1. Coding Agent:Persona 应控制工作流,而不只是回答风格](#1. Coding Agent:Persona 应控制工作流,而不只是回答风格)
- [2. Tool Agent:把偏好写入工具参数](#2. Tool Agent:把偏好写入工具参数)
- [3. Multi-Agent:共享用户 Persona,保留角色策略](#3. Multi-Agent:共享用户 Persona,保留角色策略)
- [4. Persona 必须可审计、可撤销](#4. Persona 必须可审计、可撤销)
- 十九、我的理解与启发
-
- [1. PersonaAgent 最有价值的地方是把"个性化"从内容推向策略](#1. PersonaAgent 最有价值的地方是把“个性化”从内容推向策略)
- [2. Persona 是一种可读的策略压缩](#2. Persona 是一种可读的策略压缩)
- [3. TextGrad 的优势是可解释,风险也是由语言产生](#3. TextGrad 的优势是可解释,风险也是由语言产生)
- [4. 下一步应该从"单份 Persona"走向分层状态](#4. 下一步应该从“单份 Persona”走向分层状态)
- [5. 论文结果强,但结论仍应克制](#5. 论文结果强,但结论仍应克制)
- 二十、总结
- 参考资料
前言
过去的 Agent Memory 系列,核心问题通常是"Agent 如何记住":如何压缩长期交互,如何组织事实与经历,如何从庞大历史中找回真正相关的信息。
但对一个真正面向个人长期服务的 Agent 来说,仅仅记住用户还不够。
假设两个用户都问:
这部带有魔法元素的电影应该归到哪个标签?
对普通模型而言,这是一个通用电影分类问题;对个性化 Agent 而言,问题却变成:这个用户过去习惯怎样给电影打标签?面对"魔法 + 喜剧"这种混合类型时,他更偏好 fantasy、sci-fi,还是 comedy?
这时,记忆不应该只出现在最终回答之前的一次 RAG 检索中。它还应该影响 Agent 如何搜索、查什么历史、怎样消解冲突,以及最终采用哪条行动路径。
PersonaAgent 处理的正是这个问题。它把用户专属的 persona 定义为一份可动态优化的系统提示词:一边接收情景记忆与语义记忆总结出的用户信息,一边约束 Agent 的搜索、检索、推理和回答动作;完成交互后,再利用真实用户行为与 Agent 模拟行为之间的文字反馈更新 persona。
因此,这篇论文的唯一核心增量可以概括为:
PersonaAgent 将可测试时优化的 persona 作为"个性化记忆---Agent 行动"之间的中介控制器,使用户历史不只影响最终文本,还能持续塑造工具选择、检索参数和多步行动策略。
与上一篇 PAMU 相比,两者都在测试时适应用户偏好,但角度不同:PAMU 用 SW + EMA 估计偏好随时间的变化,再把偏好标签注入 Prompt;PersonaAgent 则用文字梯度直接重写整份 persona,让偏好进一步进入 Agent 的行动空间。
零、论文基本信息
- 论文名称: PersonaAgent: Bridging Memory and Action for Personalized LLM Agents
- 发表平台: Findings of ACL 2026
- 代码仓库: 正式论文与 ACL Anthology 页面均未提供官方代码仓库
- 作者: Weizhi Zhang、Xinyang Zhang、Chenwei Zhang、Liangwei Yang、Jingbo Shang、Zhepei Wei、Henry Peng Zou、Zijie Huang、Zhengyang Wang、Yifan Gao、Xiaoman Pan、Lian Xiong、Jingguo Liu、Philip S. Yu、Xian Li
一、个性化 Agent 缺少的不是又一份用户画像
1. 群体对齐不等于个人对齐
SFT、RLHF、DPO 等方法让模型更符合普遍人类偏好,例如更有帮助、更安全、更自然。但这些方法优化的是群体层面的平均偏好。
个体用户之间可能存在完全不同的决策习惯:
- 有人喜欢一句话给结论,有人希望看到完整推导;
- 有人按电影题材分类,有人更关注叙事风格;
- 有人评分严格,三星已经代表"不错",有人习惯给四到五星;
- 有人希望 Agent 先搜索公开知识,有人更信任自己的历史数据。
所以"对人类整体对齐"并不能自动得到"对某个具体用户对齐"。
2. User-specific Fine-tuning 为什么不够现实
为每个用户单独微调模型,理论上可以吸收细粒度偏好,但会带来三个现实问题:
- 用户数量增长时,参数与训练成本随之增长;
- 用户行为不断变化,需要频繁重新训练;
- 每个用户早期数据很少,很难稳定微调。
PersonaAgent 因而选择非参数路线:基础模型保持不变,用户差异主要存在记忆和 persona 中。
3. RAG/PAG 为什么仍然不是 Agent 级个性化
个性化 RAG 会从用户历史中检索相关案例;PAG 会先把历史总结成用户 Profile,再把 Profile 加入生成上下文。这些方法已经能利用个人数据,却大多遵循固定流水线:
User History → Retrieve/Summarize → LLM Output \text{User History}\rightarrow\text{Retrieve/Summarize}\rightarrow\text{LLM Output} User History→Retrieve/Summarize→LLM Output
它们通常不决定:
- 当前应调用哪个工具;
- 搜索关键词应怎样贴合这个用户;
- 公开知识与个人历史冲突时应信哪一边;
- 是否需要继续检索,或何时停止行动。
也就是说,个性化只发生在"输入上下文"中,没有进入 Agent 的"动作策略"。
4. 通用 Agent 为什么仍是一刀切
ReAct、MemGPT、MemoryBank 等 Agent 可以推理、调用工具和读写记忆,但相同的工具说明、策略提示和行动规则通常服务所有用户。
PersonaAgent 的问题定义是:
能否让每个用户拥有一份独立、可演化的 Agent 控制策略,使个性化同时覆盖记忆内容和行动空间?
二、相关方法与 PersonaAgent 的位置
在看具体架构前,先用论文的对比维度区分几类方案。
| 方法类别 | Agentic Intelligence | 真实应用适配 | 个人数据利用 | 个体偏好对齐 |
|---|---|---|---|---|
| Human-preference aligned | 否 | 是 | 否 | 部分 |
| User-specific fine-tuning | 否 | 否 | 是 | 部分 |
| Personalized LLM workflow | 部分 | 是 | 部分 | 是 |
| General LLM Agent | 是 | 是 | 部分 | 否 |
| Personalized LLM Agent | 是 | 是 | 是 | 是 |
Table 1:不同个性化智能路线的能力比较。 论文认为 Personalized LLM Agent 同时覆盖 Agent 行动、真实部署、个人数据利用与实时个体偏好对齐。
这张表表达的是作者的设计目标,不是严格实验结论。"真实应用适配""完全覆盖"等判断依赖作者定义,尤其论文的主要证据仍来自离线 LaMP Benchmark,因此不能把最后一行直接理解为已经在真实在线产品中全面验证。
从 Agent Memory 生命周期看,PersonaAgent 不只增加一个 Memory Store,而是把整个循环改写为:
Personal Data → Episodic/Semantic Memory → Persona → Personalized Action → New Interaction → Persona Update \text{Personal Data} \rightarrow \text{Episodic/Semantic Memory} \rightarrow \text{Persona} \rightarrow \text{Personalized Action} \rightarrow \text{New Interaction} \rightarrow \text{Persona Update} Personal Data→Episodic/Semantic Memory→Persona→Personalized Action→New Interaction→Persona Update
其中 persona 是最关键的中间状态。
三、PersonaAgent 方法总览
先看 Figure 1,是因为它把普通模型、固定个性化工作流、通用 Agent 和 PersonaAgent 放在同一坐标系中。纵轴强调行动能力,横轴强调个人数据利用与个体偏好对齐。
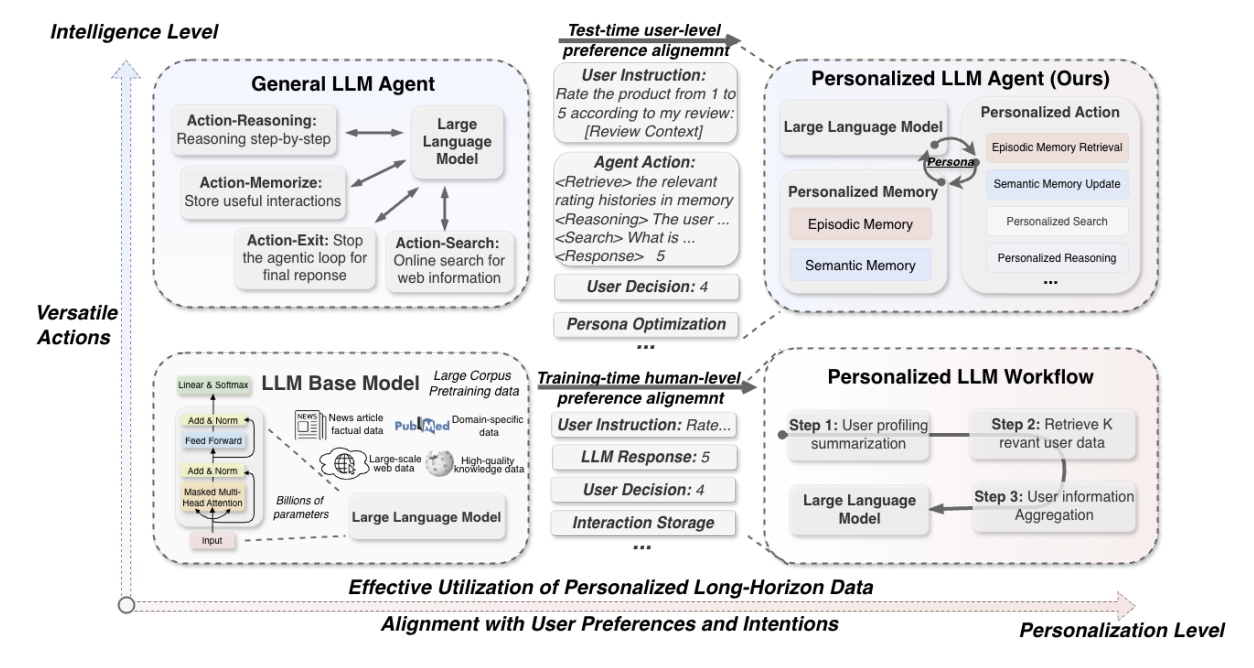
Figure 1:个性化智能的设计原则与四类框架。 PersonaAgent 在通用 Agent 的记忆和工具能力上增加用户专属 persona,并通过测试时偏好对齐持续优化该控制器。
PersonaAgent 包含四个紧密连接的部分:
- Episodic Memory: 保存带时间和上下文的细粒度交互;
- Semantic Memory: 把大量事件总结成稳定用户画像;
- Personalized Action: 让 persona 影响工具选择、检索、搜索和推理;
- Test-time Alignment: 用近期交互产生文字损失反馈,重写 persona。
论文对 persona 的定义不是普通角色卡,而是:
一份统一承载长期用户偏好与明确 Agent 行动规则的结构化用户表示,并作为该用户全部 Agent 交互的专属系统提示词。
因此,PersonaAgent 的 persona 同时包含两种内容:
- "用户是谁、偏好什么"的描述;
- "Agent 面对这个用户应怎样行动"的规则。
四、个性化记忆:Episodic Memory 与 Semantic Memory
1. 为什么需要两类记忆
单纯保留全部原始交互,细节丰富但难以扩展;只保留一份摘要,读取方便但会丢失具体证据。
PersonaAgent 用两类记忆承担不同角色:
- Episodic Memory 回答"过去具体发生过什么";
- Semantic Memory 回答"这个用户总体上是什么样的人"。
这与人类认知中的情景记忆和语义记忆划分类似。
2. Episodic Memory:保存具体经历
对用户 u u u,论文定义情景记忆缓冲区:
D u = { ( q i , r i g t , m i ) } i = 1 N u D^u=\left\{(q_i,r_i^{gt},m_i)\right\}_{i=1}^{N_u} Du={(qi,rigt,mi)}i=1Nu
其中:
- q i q_i qi 是过去的任务或查询;
- r i g t r_i^{gt} rigt 是用户真实行为或真实答案;
- m i m_i mi 是时间戳、Session 等辅助元数据;
- N u N_u Nu 是该用户的历史交互数量。
对新问题 q ∗ q^* q∗,先编码当前查询与历史事件:
h q ∗ = f e n c ( q ∗ ) h_{q^*}=f_{enc}(q^*) hq∗=fenc(q∗)
h i = f e n c ( D i u ) h_i=f_{enc}(D_i^u) hi=fenc(Diu)
再根据相似度检索 Top- K K K:
R u ( q ∗ ) = TopK i ∈ 1 , N u sim ( h q ∗ , h i ) R^u(q^*)=\operatorname{TopK}{i\in1,N_u}\operatorname{sim}(h{q^*},h_i) Ru(q∗)=TopKi∈1,Nusim(hq∗,hi)
这部分与常规向量检索相似。它保留实例级证据,例如用户过去如何给具有幽默与科幻元素的电影打标签。
例子
若当前电影同时包含魔法、科幻设定和夸张喜剧,通用知识可能更倾向 sci-fi;但情景记忆检索发现,这个用户过去总把"荒诞、搞笑占主导"的混合类型电影标成 comedy。这个具体历史就能成为最终决策依据。
3. Semantic Memory:抽象稳定画像
语义记忆把大量事件压缩成用户 Profile:
P u = f s ( S t , D u ) P^u=f_s(S_t,D^u) Pu=fs(St,Du)
其中:
- f s f_s fs 是总结函数;
- S t S_t St 是与任务相关的总结 Prompt;
- D u D^u Du 是用户情景记忆;
- P u P^u Pu 是稳定、紧凑的用户画像。
例如,多次交互可能被概括为:
- 熟悉经典电影与电影史;
- 偏好简洁、直接的回答;
- 对暗黑喜剧、讽刺作品和历史电影感兴趣;
- 标签决策更看重叙事主调,而不是表层题材元素。
Semantic Memory 提供全局先验,Episodic Memory 则在具体任务中补充证据。二者不是重复关系,而是"画像 + 案例"的互补。
4. 记忆模块的边界
论文没有提出新的检索算法。Episodic Memory 仍是 Embedding + Top- K K K,Semantic Memory 也采用 LLM 总结。因此,PersonaAgent 真正的新意不在记忆存储本身,而在于这些记忆如何通过 persona 进入行动策略。
五、Persona:连接记忆与行动的中介
1. Persona 不是静态 Profile
普通 Profile 往往只是放在 Prompt 中的一段用户描述。PersonaAgent 的 persona 还包含严格行动规则,例如:
- 回答当前用户时优先考虑哪些信息;
- 搜索时使用怎样的关键词;
- 必须调用哪些工具;
- 公开知识与用户历史冲突时怎样裁决;
- 最终回答应该多长、使用什么风格。
因此 persona 不只是"关于用户的记忆",更像这个用户专属的轻量策略层。
2. Persona 为什么能控制行动空间
通用 Agent 在时间步 t t t 接收环境观察 o t o_t ot,其上下文为:
c t = ( o 1 , a 1 , ... , o t − 1 , a t − 1 , o t ) c_t=(o_1,a_1,\ldots,o_{t-1},a_{t-1},o_t) ct=(o1,a1,...,ot−1,at−1,ot)
普通策略从通用动作集合 A A A 中选择动作。PersonaAgent 将动作空间扩展为:
A ^ = A ∪ D \hat{A}=A\cup D A^=A∪D
这里 A A A 是通用工具,例如 Wikipedia Search; D D D 是个人数据与历史访问工具,例如 Episodic Memory RAG。
在 persona P P P 条件下,动作采样写为:
a t ∼ π P ( ⋅ ∣ c t ) , a t ∈ A ^ a_t\sim\pi_P(\cdot\mid c_t),\qquad a_t\in\hat{A} at∼πP(⋅∣ct),at∈A^
π P \pi_P πP 并不是单独训练出的神经网络策略。它更接近"由系统 Prompt 条件化的 LLM Agent Policy":persona 改变 Agent 对工具、检索词、行动顺序和结果冲突的判断。
3. 一个完整行动例子
Figure 6 展示了论文附录中的电影标签案例。它值得看,因为这里最直观地体现了 persona 如何改变行动,而不只是改变最终语气。
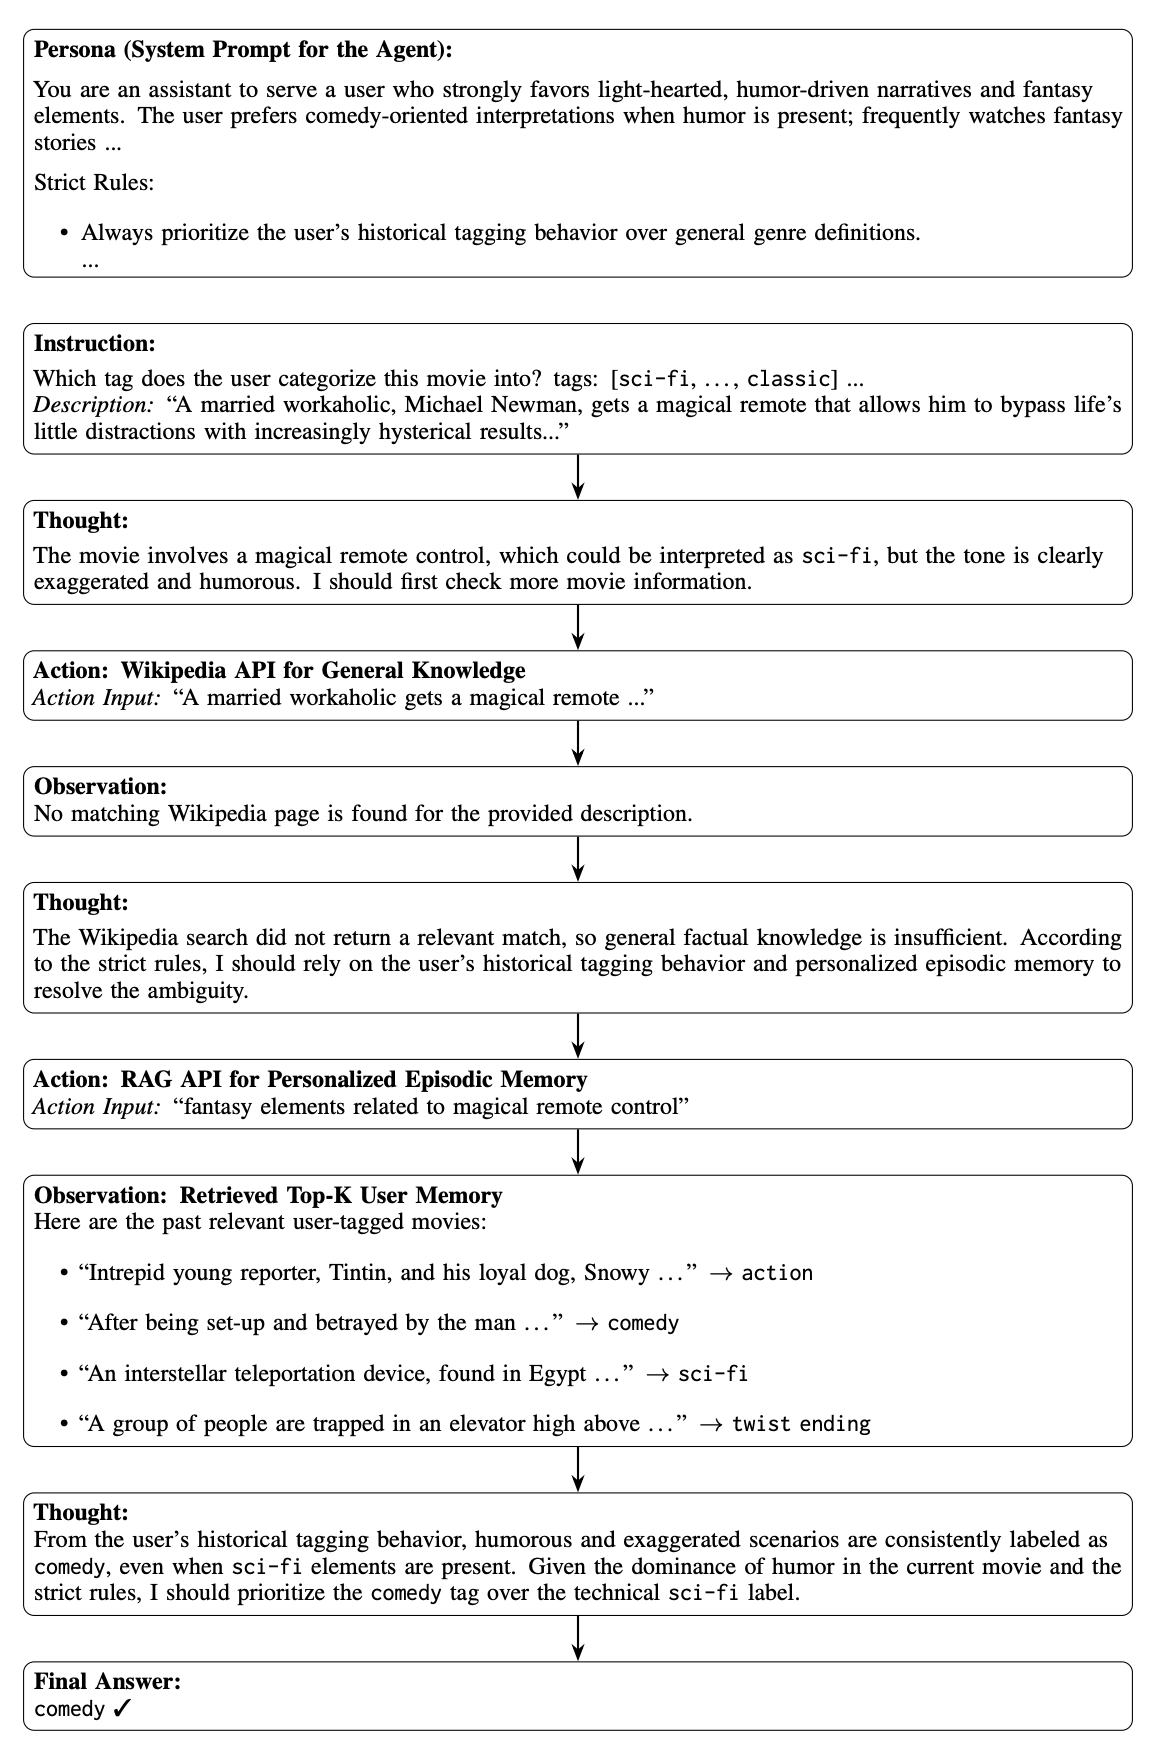
Figure 6:个性化电影标签任务的完整执行过程。 Agent 先用 Wikipedia 查询通用信息;结果不足后,根据 persona 转向用户 Episodic Memory,并优先采用该用户历史上的标签习惯,最终输出 comedy。
这个例子包含一个完整闭环:
- Persona 指出用户偏好轻松、幽默叙事,并规定个人历史优先于通用类型定义;
- Agent 先尝试查询公开知识;
- Wikipedia 没找到有效结果;
- Agent 转而检索用户过去的电影标签;
- 历史表明该用户在科幻元素与喜剧主调冲突时更偏向 comedy;
- Agent 输出用户化答案,而不是通用分类答案。
这就是"个性化行动"的含义:相同工具箱下,不同 persona 会形成不同搜索词、证据优先级和决策路径。
六、测试时用户偏好对齐
1. 动机:初始 Persona 仍然只是粗略总结
初始 persona 来自用户历史的语义总结,但普通总结未必能直接指导 Agent 做出正确行动。例如,"喜欢经典电影"太宽泛,无法告诉 Agent 在某个分类冲突中应该怎样选择。
论文于是把 persona 当作可优化文本变量。优化不发生在模型参数上,而发生在系统 Prompt 本身。
2. 构造近期交互批次
对某个用户,从近期历史中取得 n n n 条交互:
D b a t c h = { ( q j , r ^ j , r j g t ) } j = 1 n D_{batch}=\{(q_j,\hat{r}j,r_j^{gt})\}{j=1}^{n} Dbatch={(qj,r^j,rjgt)}j=1n
其中:
- q j q_j qj 是历史问题;
- r ^ j \hat{r}_j r^j 是当前 PersonaAgent 模拟生成的行为;
- r j g t r_j^{gt} rjgt 是用户真实行为。
论文默认 n = 3 n=3 n=3,即每次优化只使用三个近期样本,并默认执行一次对齐迭代。
3. 优化目标
作者把 persona 优化形式化为:
P ∗ = arg min P ∑ j = 1 n L ( r ^ j , r j g t ∣ q j ) P^*=\arg\min_P\sum_{j=1}^{n}\mathcal{L}(\hat{r}_j,r_j^{gt}\mid q_j) P∗=argPminj=1∑nL(r^j,rjgt∣qj)
直觉上,就是寻找一份更好的 persona,使 Agent 在这些历史问题上的模拟答案更接近真实用户行为。
这里的 L \mathcal{L} L 不是可微数值损失,而是由 LLM 生成的自然语言批评。比如:
当前 persona 只描述了用户喜欢科幻,但没有体现用户在幽默占主导时更偏向 comedy。应增加一条规则,在多标签冲突中优先匹配用户历史上的主调判断。
4. TextGrad:把自然语言批评当作梯度
论文采用 TextGrad。对由多个 LLM 调用组成的系统:
Prediction = L L M ( Prompt + Question ) \text{Prediction}=LLM(\text{Prompt}+\text{Question}) Prediction=LLM(Prompt+Question)
Evaluation = L L M ( EvalInst + Prediction ) \text{Evaluation}=LLM(\text{EvalInst}+\text{Prediction}) Evaluation=LLM(EvalInst+Prediction)
文字梯度被定义为:
∂ L ∂ x ≜ ∇ L L M ( x , y , ∂ L ∂ y ) \frac{\partial\mathcal{L}}{\partial x} \triangleq \nabla_{LLM}\left(x,y,\frac{\partial\mathcal{L}}{\partial y}\right) ∂x∂L≜∇LLM(x,y,∂y∂L)
它不计算数值导数,而是让 LLM 阅读变量 x x x、输出 y y y 和下游批评,再说明如何修改 x x x。
得到批评后,通过文字梯度下降重写变量:
x n e w = TGD.step ( x , ∂ L ∂ x ) x_{new}=\operatorname{TGD.step}\left(x,\frac{\partial\mathcal{L}}{\partial x}\right) xnew=TGD.step(x,∂x∂L)
放在 PersonaAgent 中, x x x 就是当前 persona。多个样本的批评先聚合,再让 LLM 生成一份新的系统 Prompt。
5. 一轮优化怎样工作
算法可以整理为:
- 用当前 persona 在近期历史问题上重新运行 Agent;
- 比较模拟回答与真实用户行为;
- 为每个样本生成"persona 应如何修改"的文字反馈;
- 聚合一批反馈;
- 重写 persona;
- 下一轮继续模拟与修正,或将新 persona 用于后续 Session。
这相当于在推理时做 Prompt Optimization,而不是 Parameter Optimization。
6. 为什么强调异步更新
论文在每个 Session 结束后立刻启动 persona 优化,并要求在下一个 Session 到来前完成。这样用户当前请求的在线响应不必等待优化。
但"异步"不等于"没有成本"。系统仍要额外执行:
- 多个历史任务的 Agent 模拟;
- 文字损失评估;
- 聚合反馈;
- Persona 重写。
成本被转移到会话间隙,而不是消失。若用户连续交互、没有足够 Session 间隔,系统仍需要处理更新滞后或资源竞争。
七、实验设置
1. 数据集与用户划分
论文采用时间排序版本的 LaMP,并选择历史活动最丰富的 100 个用户。每个用户的数据按时间划分为:
- Profile Set:用于建立记忆和测试时对齐;
- Test Set:只用于最终评估。
这种按时间切分比随机切分更符合长期个性化场景,也降低未来信息泄露风险。但只选"历史最丰富"的 100 个用户,会偏向重度用户,不能代表普通或真正冷启动用户。
2. 六项个性化任务
主文重点报告四个决策任务:
- LaMP-1:个性化论文引用识别;
- LaMP-2M:个性化电影标签;
- LaMP-2N:个性化新闻分类;
- LaMP-3:个性化商品评分。
附录另报告两个生成任务:
- LaMP-4:个性化新闻标题生成;
- LaMP-5:个性化学术标题生成。
3. 基线
论文比较三类方法:
- 非个性化:Prompt、ICL;
- 个性化工作流:RAG、PAG;
- 通用 Agent:ReAct、MemoryBank。
所有主要方法在统一输入与输出格式下评估。Agent 方法使用 Wikipedia 工具;PersonaAgent 另有访问个人情景记忆的 RAG 工具。
4. 模型与实现
默认基础模型为 Claude 3.5 Sonnet,所有 Agent 基于 LangChain 实现,通过 Amazon Bedrock 运行。
默认超参数:
- 对齐批大小 n = 3 n=3 n=3;
- 对齐迭代数 E = 1 E=1 E=1;
- 检索记忆数量 K = 4 K=4 K=4;
- 采样温度 0.1。
值得注意的是,初始 Persona Prompt 明确要求 Agent 至少调用两个工具。这有利于展示行动机制,但也意味着方法设计中人为加入了额外工具调用约束,不能把所有增益都归因于"自然学得的最佳策略"。
5. 指标与证据强度
- LaMP-1、2M、2N:Accuracy、F1;
- LaMP-3:MAE、RMSE;
- LaMP-4、5:ROUGE-1、ROUGE-L。
论文固定温度后只进行单次运行,没有报告方差、置信区间或显著性检验。因此数字适合说明整体趋势,但不足以判断较小差距是否稳定。
八、主实验:PersonaAgent 是否真的更好
1. 四项决策任务
| 数据集 | 指标 | Prompt | ICL | RAG | PAG | ReAct | MemBank | PersonaAgent |
|---|---|---|---|---|---|---|---|---|
| LaMP-1 | Acc. ↑ | 0.772 | 0.780 | 0.715 | 0.837 | 0.837 | 0.862 | 0.919 |
| LaMP-1 | F1 ↑ | 0.771 | 0.766 | 0.714 | 0.837 | 0.853 | 0.861 | 0.918 |
| LaMP-2M | Acc. ↑ | 0.387 | 0.283 | 0.427 | 0.430 | 0.450 | 0.470 | 0.513 |
| LaMP-2M | F1 ↑ | 0.302 | 0.217 | 0.386 | 0.387 | 0.378 | 0.391 | 0.424 |
| LaMP-2N | Acc. ↑ | 0.660 | 0.388 | 0.742 | 0.768 | 0.639 | 0.741 | 0.796 |
| LaMP-2N | F1 ↑ | 0.386 | 0.145 | 0.484 | 0.509 | 0.381 | 0.456 | 0.532 |
| LaMP-3 | MAE ↓ | 0.295 | 0.277 | 0.313 | 0.339 | 0.313 | 0.321 | 0.241 |
| LaMP-3 | RMSE ↓ | 0.590 | 0.543 | 0.713 | 0.835 | 0.590 | 0.582 | 0.509 |
Table 2:四项个性化决策任务的主实验结果。 PersonaAgent 在三项分类任务和一项评分任务的全部指标上取得最佳结果。
LaMP-1 上,PersonaAgent 的 Accuracy 为 0.919,比次优 MemBank 的 0.862 高 5.7 个百分点;F1 同样高 5.7 个百分点。这说明在引用识别任务中,完整 persona 对齐比单纯长期记忆更有效。
LaMP-2M 上,PersonaAgent 相比 MemBank 的 Accuracy 提高 4.3 个百分点,F1 提高 3.3 个百分点。电影标签本身具有很强主观性,因此用户历史和 persona 冲突规则能发挥作用。
LaMP-2N 上,PAG 已经达到 0.768 Accuracy 和 0.509 F1,说明 Profile + Retrieval 很强;PersonaAgent 进一步提升到 0.796 和 0.532,增益存在但小于 LaMP-1。
LaMP-3 是最有意思的反例场景:除 ICL 外,RAG、PAG、ReAct、MemBank 均未超过直接 Prompt 的 MAE。这说明"加入更多个人历史"不一定改善数值评分,错误或不匹配的历史反而会干扰预测。PersonaAgent 将 MAE 降到 0.241,相对次优 ICL 的 0.277 降低约 13.0%,表明对用户评分尺度做整体 persona 建模比简单拼接案例更有效。
2. 两项文本生成任务
| 数据集 | 指标 | Prompt | ICL | RAG | PAG | ReAct | MemBank | PersonaAgent |
|---|---|---|---|---|---|---|---|---|
| LaMP-4 | ROUGE-1 ↑ | 0.129 | 0.140 | 0.161 | 0.160 | 0.167 | 0.160 | 0.178 |
| LaMP-4 | ROUGE-L ↑ | 0.118 | 0.127 | 0.145 | 0.143 | 0.150 | 0.142 | 0.166 |
| LaMP-5 | ROUGE-1 ↑ | 0.455 | 0.444 | 0.475 | 0.472 | 0.468 | 0.463 | 0.503 |
| LaMP-5 | ROUGE-L ↑ | 0.384 | 0.380 | 0.424 | 0.413 | 0.407 | 0.399 | 0.434 |
Table 4:个性化文本生成结果。 PersonaAgent 在新闻标题与学术标题生成中均取得最高 ROUGE-1 和 ROUGE-L。
LaMP-4 上,PersonaAgent 相比次优 ReAct 的 ROUGE-1 提高 0.011,ROUGE-L 提高 0.016;LaMP-5 上,相比次优 RAG 分别提高 0.028 和 0.010。
这些增益支持 persona 能吸收作者风格与主题偏好,但 ROUGE 主要衡量词面重叠,不能完整代表用户是否真的更喜欢生成标题。若要证明"偏好对齐",还需要用户盲评或成对偏好评估。
九、消融实验:哪个组件最关键
| 变体 | LaMP-1 Acc. | LaMP-1 F1 | LaMP-2M Acc. | LaMP-2M F1 | LaMP-2N Acc. | LaMP-2N F1 | LaMP-3 MAE | LaMP-3 RMSE |
|---|---|---|---|---|---|---|---|---|
| PersonaAgent | 0.919 | 0.918 | 0.513 | 0.424 | 0.796 | 0.532 | 0.241 | 0.509 |
| 去掉 Alignment | 0.894 | 0.893 | 0.487 | 0.403 | 0.775 | 0.502 | 0.259 | 0.560 |
| 去掉 Persona | 0.846 | 0.855 | 0.463 | 0.361 | 0.769 | 0.483 | 0.277 | 0.542 |
| 去掉 Memory | 0.821 | 0.841 | 0.460 | 0.365 | 0.646 | 0.388 | 0.348 | 0.661 |
| 去掉 Action | 0.764 | 0.789 | 0.403 | 0.329 | 0.626 | 0.375 | 0.375 | 0.756 |
Table 3:PersonaAgent 组件消融。 完整系统在全部任务上最好;去掉 Personalized Action 的退化最大,去掉 Memory 次之。
1. Test-time Alignment 是稳定增益项
去掉 Alignment 后,LaMP-1 Accuracy 从 0.919 降到 0.894,LaMP-3 RMSE 从 0.509 升到 0.560。说明初始语义画像已经有用,但用近期行为重写 persona 还能进一步对齐。
不过这一消融没有与更简单的 Prompt 自我修订方法比较,因此还不能确认 TextGrad 比普通"根据三条历史总结新 persona"优越多少。
2. Persona 的价值在于集中控制
去掉 persona 后,记忆和工具仍可存在,但缺少连接二者的统一系统提示,全部任务进一步下降。LaMP-2M F1 从完整系统的 0.424 降到 0.361,说明零散记忆若无法转成行动规则,作用有限。
3. Memory 是个性化证据源
去掉 Memory 后,LaMP-2N Accuracy 从 0.796 降到 0.646,LaMP-3 MAE 从 0.241 恶化到 0.348。没有历史证据,persona 容易退化为泛化描述,无法捕捉用户具体标签和评分习惯。
4. Action 是最大贡献项,但消融有混杂因素
去掉 Action 的下降最大:LaMP-1 Accuracy 低至 0.764,甚至低于直接 Prompt 的 0.772;LaMP-3 RMSE 上升至 0.756。
这支持论文的核心判断:个性化不应只控制最终文本,还应控制 Agent 如何行动。
但该消融可能同时移除了工具调用、迭代推理和个性化检索入口,而不只是"个性化 Action Policy"。因此,它证明行动模块整体重要,却没有完全隔离 persona 对"动作选择"本身的净贡献。
十、Persona 分析:不同用户是否学到了不同画像
论文在 LaMP-2M 上把优化后的 persona 做 Embedding 和 t-SNE 可视化。三个代表用户呈现出明显差异:
- User A:经典电影、历史片、纪录片、政治和社会评论、暗黑喜剧;
- User B:电影史、全球电影、文化背景、经典与高影响力作品;
- User C:文学、畅销书改编、科幻和动作类型。
附录中的 Jaccard 相似度矩阵显示,对角线为 1.0,而多数不同用户间的相似度不超过 0.4。作者据此认为 persona 能保持用户区分度。
但这里有两个证据边界:
- t-SNE 的分离效果会受降维参数影响,视觉分开不等于真实任务空间中稳定可分;
- Persona 模板本身包含大量共同规则,而 Jaccard 的 Token/集合定义没有充分展开,低重叠不必然意味着画像准确。
更强的验证方式应是:交换两位用户的 persona 后,性能是否显著下降;或者人工判断 persona 是否准确描述该用户。
十一、测试时扩展规律
Figure 3 同时观察三种推理成本:对齐样本数、对齐迭代数和检索记忆数。
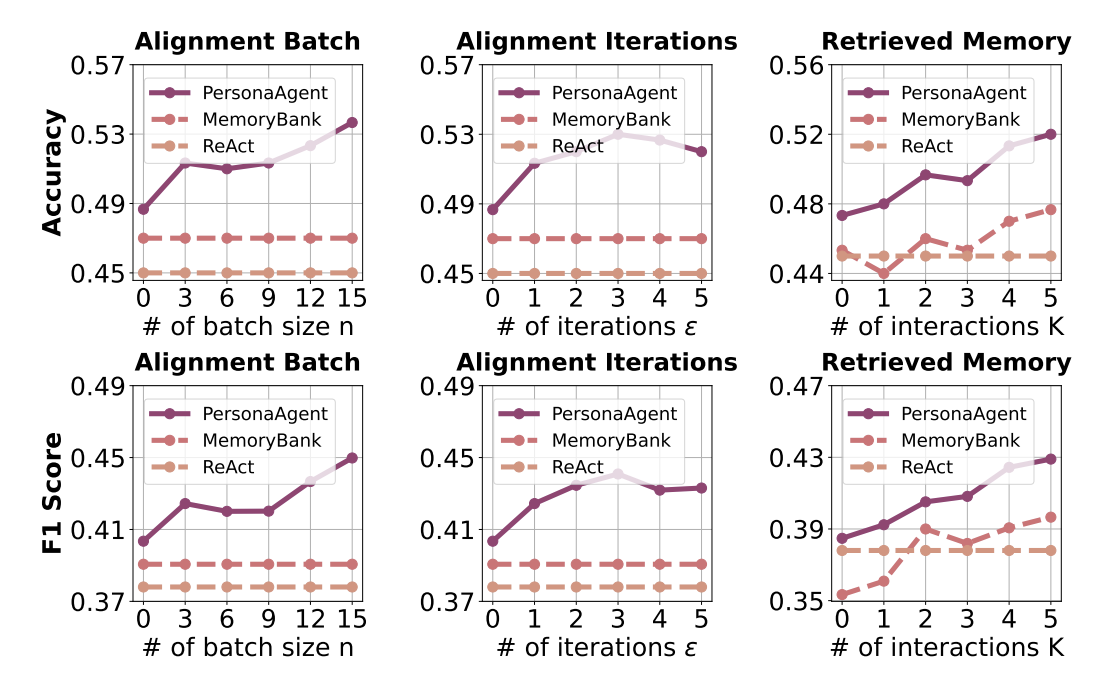
Figure 3:PersonaAgent 的测试时扩展。 上排为 Accuracy,下排为 F1;分别改变对齐 Batch Size、对齐迭代次数和检索记忆条数。
1. 增加对齐样本通常有帮助
从 n = 0 n=0 n=0 增加到 3 时,Accuracy 和 F1 明显提升;继续增加时存在波动,但总体趋势仍向上。更多近期行为可以减少单个样本噪声,让 persona 更完整。
2. 对齐迭代不是越多越好
性能大约在 3 次迭代达到峰值,随后持平或略降。这可能说明反复根据同一小批样本重写 Prompt 会过拟合近期交互,或者 LLM 重写逐渐引入冗余规则。
论文默认只做 1 次迭代,是效果与成本之间的保守选择,而不是图中的最优性能设置。
3. 更多检索记忆总体更好,但并非严格单调
PersonaAgent 随 K K K 增加总体上升,但在部分点位会回落。MemoryBank 也有明显波动。这说明增加历史可以带来更多证据,也可能加入不相关或相互冲突的信息。
论文没有报告 Context Token 成本,因此"更多记忆"的收益还不能直接转换为实际性价比。
十二、基础模型能力是否影响 PersonaAgent
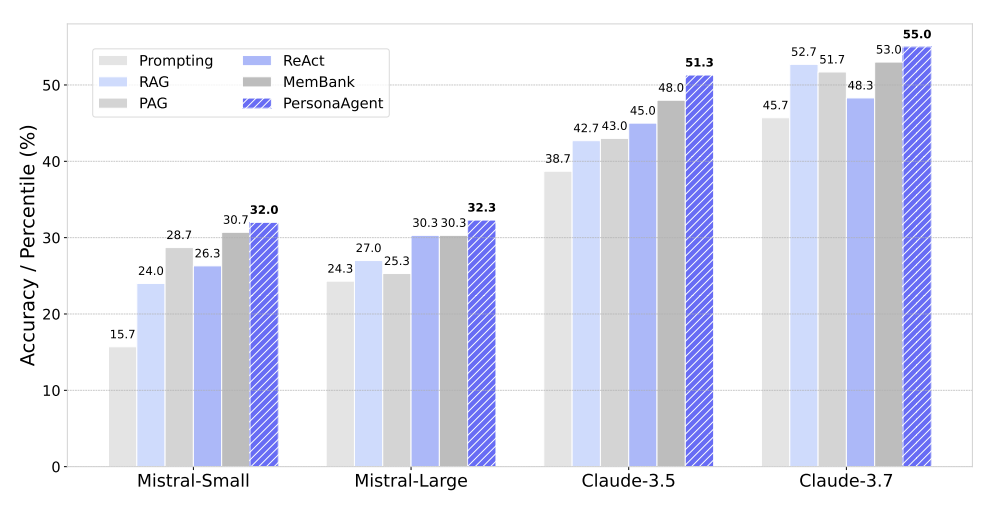
Figure 4:基础模型能力的影响。 PersonaAgent 在 Mistral-Small、Mistral-Large、Claude 3.5 和 Claude 3.7 上均取得最高 Accuracy。
| 方法 | Mistral-Small | Mistral-Large | Claude 3.5 | Claude 3.7 |
|---|---|---|---|---|
| Prompt | 15.7 | 24.3 | 38.7 | 45.7 |
| RAG | 24.0 | 27.0 | 42.7 | 52.7 |
| PAG | 28.7 | 25.3 | 43.0 | 51.7 |
| ReAct | 26.3 | 30.3 | 45.0 | 48.3 |
| MemBank | 30.7 | 30.3 | 48.0 | 53.0 |
| PersonaAgent | 32.0 | 32.3 | 51.3 | 55.0 |
Figure 4 数值复现:不同 Backbone 上的 Accuracy。 PersonaAgent 在四种基础模型上分别领先次优方法 1.3、2.0、3.3 和 2.0 个百分点。
结果说明 PersonaAgent 不是只对 Claude 3.5 有效。即便使用 Mistral-Small,它也能在相同 Backbone 下超过其他方法。
不过,大模型能力提高时,所有方法都在进步。PersonaAgent 的绝对提升与基础模型的指令遵循、工具调用和文字评估能力密切相关;若模型无法稳定生成高质量文字梯度,persona 优化也会失效。
十三、冷启动实验
作者把每个用户的历史限制为 10 条,构造更接近新用户的设置。
| 数据集 | 指标 | PAG | ReAct | MemBank | PersonaAgent |
|---|---|---|---|---|---|
| LaMP-1 | Acc. ↑ | 0.772 | 0.802 | 0.789 | 0.845 |
| LaMP-1 | F1 ↑ | 0.764 | 0.792 | 0.781 | 0.837 |
| LaMP-2M | Acc. ↑ | 0.392 | 0.428 | 0.415 | 0.476 |
| LaMP-2M | F1 ↑ | 0.328 | 0.361 | 0.349 | 0.407 |
| LaMP-2N | Acc. ↑ | 0.678 | 0.714 | 0.698 | 0.756 |
| LaMP-2N | F1 ↑ | 0.438 | 0.468 | 0.452 | 0.509 |
| LaMP-3 | MAE ↓ | 0.341 | 0.328 | 0.332 | 0.301 |
| LaMP-3 | RMSE ↓ | 0.924 | 0.726 | 0.743 | 0.612 |
Table 6:每位用户只有 10 条历史时的冷启动结果。 PersonaAgent 在四项任务的全部指标上仍优于 PAG、ReAct 和 MemBank。
这说明 persona 抽象在稀疏数据下比直接保存与检索原始记录更有归纳优势。但 10 条历史仍不等于真正的零样本冷启动,而且实验没有与主表完全相同的全部基线,因此只能证明"少历史"鲁棒性,不能证明"无历史"个性化。
十四、效率分析
| 任务 | PAG | ReAct | MemBank | PersonaAgent |
|---|---|---|---|---|
| LaMP-1 | 0.84 | 1.95 | 2.35 | 1.42 |
| LaMP-2M | 1.46 | 2.92 | 3.10 | 1.62 |
| LaMP-2N | 1.08 | 2.48 | 2.90 | 2.12 |
| LaMP-3 | 1.58 | 3.10 | 3.34 | 1.98 |
| 平均 | 1.24 | 2.61 | 2.92 | 1.79 |
Table 5:平均每个测试样本的运行时间。 PersonaAgent 比 PAG 慢,但明显快于 ReAct 和 MemoryBank;单位为秒,越低越好。
PersonaAgent 平均耗时 1.79 秒:
- 相比 PAG 的 1.24 秒增加约 44.4%;
- 相比 ReAct 的 2.61 秒减少约 31.4%;
- 相比 MemBank 的 2.92 秒减少约 38.7%。
它的效率优势来自 persona 对行动空间的约束:Agent 更早知道该用什么工具、怎样构造查询,减少无效探索。
但这张表主要反映在线样本推理耗时。Session 之间异步执行的 persona 对齐需要额外 LLM 调用,论文没有报告其总 Token、成本、GPU/API 用量或完成时间。因此,更准确的结论是:
PersonaAgent 的在线推理比完整 Agent 基线更快,但系统总成本仍包含未被 Table 5 完整计入的异步对齐开销。
十五、失败模式与反例
1. Persona 可能把短期行为固化为长期规则
用户最近三次都选择 comedy,未必代表长期偏好,也可能只是最近任务恰好集中在喜剧电影。默认 Batch Size 只有 3,文字梯度容易过拟合局部行为。
2. LLM 同时扮演被优化者与批评者
系统用 LLM 生成 Agent 回答、评价差异并重写 persona。若评估模型存在偏见,错误批评会被写回系统提示,并在后续行动中放大。
3. Persona 越写越长
反复追加用户特征和行动规则可能造成 Prompt 膨胀、规则冲突和注意力稀释。论文没有报告长期多 Session 更新后的 Persona 长度,也没有压缩、去重或冲突消解机制。
4. 真实行为不总是"偏好标签"
LaMP 将历史引用、标签、评分和标题当作用户偏好证据。但真实行为可能受任务约束、组织政策、候选集和当时情境影响。直接把一次选择写成人格规则,可能错误归因。
5. 用户偏好可能与安全规则冲突
Persona 是系统提示的一部分。如果用户历史诱导系统形成"总是忽略公开证据、优先相信个人历史"等规则,可能损害事实性。个性化策略必须受更高优先级的安全、权限和事实验证规则约束。
6. 跨任务 Persona 未必可迁移
电影标签中的"偏好简洁、重视主调"是否应该迁移到论文引用、商品评分或复杂工作任务,并不明确。论文按任务构造总结 Prompt,尚未证明一份统一跨域 persona 能稳定工作。
十六、论文局限性
论文明确承认两点:
- 文字反馈只利用显式文本,可能忽略情绪、视觉等隐式或多模态信号;
- 大量使用个人数据会带来隐私风险,需要联邦学习等隐私保护机制。
结合实验与实现,还可以进一步看到以下边界。
1. 真实世界证据仍然有限
论文强调 Real-world Applicability,但主要在离线 LaMP 任务上评估,没有在线用户长期使用、偏好满意度、会话留存或真实工具执行成功率。
2. 只选历史最丰富的 100 个用户
这种选择有利于充分构建记忆和 persona,却会高估普通用户场景的可用信息量。附录的 10 条历史实验缓解了问题,但还不是真正零冷启动。
3. 单次运行,没有统计不确定性
所有实验只跑一次。主表中 1 到 3 个百分点的差异可能受生成随机性、外部 API 和 Agent 路径波动影响。
4. 缺少成本完整核算
在线推理耗时得到报告,但异步对齐需要多少 LLM 调用、Token 和费用没有披露。对面向大规模用户的系统,这正是关键部署指标。
5. 没有公开代码
附录提供了 Prompt、工具描述和主要超参数,但官方代码仓库未公开。MemoryBank 的 LaMP 适配、TextGrad 调用图、Persona 解析和 Agent 停止条件仍需自行复现。
6. 基线公平性仍可加强
PersonaAgent 明确要求至少使用两个工具,而部分 Workflow 基线本身没有相同动作预算。更严格比较应统一最大 Tool Calls、Token Budget、API 成本和可访问个人数据。
7. Persona 的正确性缺少直接评估
t-SNE 分布、Jaccard 区分度和下游任务成绩说明 persona 有用,但没有直接验证"这份文字画像是否真实、可接受、没有冒犯用户"。真实产品还需要用户查看、修改、删除和纠正 Persona 的机制。
十七、与 Agent Memory 系列方法的横向比较
| 方法 | 核心问题 | 主要记忆形态 | 更新/控制机制 | 与 PersonaAgent 的差别 |
|---|---|---|---|---|
| MemoryBank | 如何长期保存、检索并遗忘用户记忆 | 向量化历史与用户画像 | 遗忘曲线与记忆更新 | 有长期记忆,但没有测试时优化的用户行动策略 |
| A-MEM | 如何让记忆自组织并建立动态关联 | 结构化 Note 与链接网络 | 新事件驱动记忆网络演化 | 重点是记忆组织;PersonaAgent 重点是把记忆变成行动规则 |
| MAGMA | 如何组织多粒度、多关系记忆 | 多粒度、多图结构 | 跨粒度检索与更新 | MAGMA 强在结构检索,PersonaAgent 强在个体策略控制 |
| CoM | 如何让记忆参与认知与推理 | 认知化记忆结构 | 推理中的记忆读写 | CoM 处理通用认知过程;PersonaAgent 面向用户级偏好与工具行动 |
| ReMemR1 | 边读边记时如何主动回访历史 | 可回访记忆状态 | Callback Retrieval 与学习策略 | ReMemR1 修复信息遗漏,PersonaAgent 修复行动的一刀切 |
| Mem²Evolve | 记忆系统如何随经验自演化 | 可演化记忆组件 | 经验驱动的元级更新 | PersonaAgent 主要演化 persona 文本,不演化整套记忆架构 |
| PAMU | 如何跟踪偏好的短期变化与长期趋势 | 五维偏好向量 | SW + EMA + Prompt 注入 | PAMU 估计偏好状态;PersonaAgent 用文字梯度重写完整行动 Persona |
| PersonaAgent | 如何让个人记忆真正控制 Agent 行动 | Episodic + Semantic Memory + Persona | 测试时文字梯度优化 Persona | 将个性化从回答层扩展到动作空间 |
PersonaAgent 与 A-MEM、MAGMA 并不冲突。完全可以用 A-MEM 或 MAGMA 替换它较简单的 Episodic Retrieval,再把检索出的证据交给 Persona 控制行动。
同样,PAMU 可以作为 PersonaAgent 的状态估计前端:先判断哪些偏好是近期临时变化、哪些是长期稳定趋势,再决定是否把它们写进 persona。这样可以缓解 PersonaAgent 用三个近期样本过拟合的问题。
十八、对 Coding Agent、Tool Agent 与 Multi-Agent 的启发
以下是基于论文机制的工程推演,不是 PersonaAgent 已经完成的实验。
1. Coding Agent:Persona 应控制工作流,而不只是回答风格
对 Coding Agent,有价值的 persona 不只是"用户喜欢简洁回答",还应包含:
- 修改前是否先解释方案;
- 偏好小补丁还是集中重构;
- 测试应跑到什么范围;
- 遇到模糊需求时倾向直接假设还是先询问;
- 是否重视向后兼容;
- 代码审查更关注正确性、性能还是可维护性。
这些规则会直接影响搜索文件、选择工具、编辑范围和验证策略,正符合 PersonaAgent 的"个性化行动空间"。
2. Tool Agent:把偏好写入工具参数
同一个搜索工具可以因为 persona 产生不同查询:
- 专家用户:优先官方文档、论文、精确术语;
- 新手用户:优先教程、示例和解释性材料;
- 成本敏感用户:先查询低成本方案;
- 隐私敏感用户:优先本地工具,减少外部上传。
这比在工具执行完之后改变回答语气更有价值,因为偏好已经影响证据获取过程。
3. Multi-Agent:共享用户 Persona,保留角色策略
多 Agent 系统可以把状态拆成:
P a g e n t = P u s e r + P r o l e + P t a s k P_{agent}=P_{user}+P_{role}+P_{task} Pagent=Puser+Prole+Ptask
- P u s e r P_{user} Puser:跨 Agent 共享的长期用户偏好;
- P r o l e P_{role} Prole:Research、Coding、Review 等角色规则;
- P t a s k P_{task} Ptask:当前任务的临时约束。
这样既能保持一致的个性化体验,又不会让 Writing Agent 的"表达自然"规则错误覆盖 Security Agent 的严格验证策略。
4. Persona 必须可审计、可撤销
生产系统不应让 LLM 在后台无限重写用户画像。每次修改最好保存:
- 修改前后 Diff;
- 触发更新的交互证据;
- 规则置信度;
- 生效范围和过期时间;
- 用户纠正与删除入口。
PersonaAgent 已证明可优化文本 Persona 有潜力,但工程上还需要完整的治理层。
十九、我的理解与启发
1. PersonaAgent 最有价值的地方是把"个性化"从内容推向策略
过去很多个性化方法的本质是:给模型更多"关于用户的文本"。PersonaAgent 更进一步:个人信息应该影响 Agent 的动作分布。
这意味着个性化的真正对象不只是 Final Answer,而是:
Tool Selection + Query Formulation + Memory Retrieval + Evidence Arbitration + Final Response \text{Tool Selection} + \text{Query Formulation} + \text{Memory Retrieval} + \text{Evidence Arbitration} + \text{Final Response} Tool Selection+Query Formulation+Memory Retrieval+Evidence Arbitration+Final Response
这是它区别于普通 Profile/RAG 的关键。
2. Persona 是一种可读的策略压缩
大量历史交互不能每次全部放进上下文。Semantic Memory 将历史压缩成用户画像,而 Persona 又把画像进一步转成行动规则。
从这个角度看,Persona 是对用户历史策略的可读压缩:它保留的不只是"发生了什么",而是"面对类似情况以后应该怎样做"。
3. TextGrad 的优势是可解释,风险也是由语言产生
数值梯度难以直接作用于一段系统提示,文字梯度则可以明确写出失败原因和修改建议。这使优化过程可阅读、可审查。
但自然语言批评没有稳定的数学方向性。一次更新可能改善三个样本,却破坏其他任务;规则也可能越来越冗长、互相冲突。未来需要 Persona Validation Set、更新回滚和约束式 Prompt Rewrite。
4. 下一步应该从"单份 Persona"走向分层状态
论文把长期画像、当前任务偏好和工具规则都写进同一系统 Prompt。更稳健的架构应至少分成:
- 用户长期事实与偏好;
- 当前 Session 状态;
- 当前任务硬约束;
- Agent 安全与权限规则;
- 工具级策略。
不同层有不同更新频率、证据要求和优先级。用户当前明确指令应覆盖长期偏好,而系统安全规则不能被任何 persona 更新覆盖。
5. 论文结果强,但结论仍应克制
PersonaAgent 在所有报告任务上都取得最好结果,消融、冷启动、Backbone 和效率分析也比较完整。相比只给主表的工作,它的证据链更丰富。
但只运行一次、只选重度用户、缺少在线用户评估、未完整核算对齐成本,也意味着"真实世界个性化 Agent"仍是一个方向性结论,而不是已经完成的大规模产品验证。
二十、总结
PersonaAgent 试图补上通用 Agent 与个性化 LLM 之间的断层:前者会行动,却不了解具体用户;后者能读取用户数据,却通常只在固定工作流中生成文本。
它使用 Episodic Memory 保存具体历史,用 Semantic Memory抽象稳定画像,再让 persona 作为每个用户独有的系统提示词,统一控制工具选择、个人记忆检索、搜索、推理和最终回答。Session 结束后,系统从近期真实行为与模拟行为的差异中生成文字梯度,继续重写 persona。
实验上,PersonaAgent 在 LaMP 的四项决策任务和两项生成任务上均取得最佳结果;消融显示 Personalized Action 的贡献最大,Memory、Persona 和 Test-time Alignment 也都不可缺少;它还在四种 Backbone、10 条历史的冷启动条件下保持优势。在线推理平均耗时 1.79 秒,快于 ReAct 和 MemoryBank,但异步 Persona 优化的完整成本仍未报告。
一句话总结:
PersonaAgent 的核心不是再为用户建一份静态画像,而是把可持续优化的 persona 变成 Agent 的个体化策略层,让记忆真正进入工具行动与决策过程。
参考资料
- Zhang, W. et al. PersonaAgent: Bridging Memory and Action for Personalized LLM Agents. Findings of ACL 2026.
- Salemi, A. et al. LaMP: When Large Language Models Meet Personalization.
- Richardson, C. et al. PAG: Profile-Augmented Generation.
- Zhong, W. et al. MemoryBank: Enhancing Large Language Models with Long-Term Memory.
- Yao, S. et al. ReAct: Synergizing Reasoning and Acting in Language Models.
- Yuksekgonul, M. et al. TextGrad: Automatic Differentiation via Text.
- ACL Anthology 论文主页
- 正式论文 PDF