提示:文章写完后,目录可以自动生成,如何生成可参考右边的帮助文档
文章目录
- 引言:为什么还要学习JVM?
- 一、JVM整体架构概率
- 二、从源码到运行:一次完整旅程
- 三、类加载机制
- [3.1 类的生命周期](#3.1 类的生命周期)
- [3.2 类加载器与双亲委派](#3.2 类加载器与双亲委派)
- [3.3 自定义类加载器的典型场景](#3.3 自定义类加载器的典型场景)
- 四、JVM运行时数据区
- [4.1 程序计数器](#4.1 程序计数器)
- [4.2 Java虚拟机栈与栈帧](#4.2 Java虚拟机栈与栈帧)
- [4.3 堆:对象的【大仓库】](#4.3 堆:对象的【大仓库】)
- [4.4 方法区与元空间](#4.4 方法区与元空间)
- [4.5 直接内存](#4.5 直接内存)
- 五、对象创建于内存分配
- 六、垃圾回收机制
- [6.1 如何判断对象存活?](#6.1 如何判断对象存活?)
- [6.2 常见垃圾回收算法](#6.2 常见垃圾回收算法)
- [6.3 Minor / Major / Full GC](#6.3 Minor / Major / Full GC)
- 七、常见垃圾收集器
- 八、JIT编译与性能优化基础
- [九、常见 JVM 参数(附示例)](#九、常见 JVM 参数(附示例))
- 十、常见问题与排查思路
- [10.1 OutOfMemoryError](#10.1 OutOfMemoryError)
- [10.2 StackOverflowError](#10.2 StackOverflowError)
- [10.3 频繁 Full GC](#10.3 频繁 Full GC)
- [10.4 内存泄漏 vs 内存溢出](#10.4 内存泄漏 vs 内存溢出)
- [10.5 CPU 过高](#10.5 CPU 过高)
- 十一、监控与诊断工具
- [11.1 命令行(至少会这几条)](#11.1 命令行(至少会这几条))
- [11.2 GUI / 增强工具](#11.2 GUI / 增强工具)
- 十二、实战案例:静态集合导致的堆溢出
- 十三、总结
引言:为什么还要学习JVM?
JVM(Java Virtual Machine,Java 虚拟机) 是执行 Java 字节码的运行时引擎。你写的 `.java` 先被编译成 `.class`,再由 JVM 加载、解释或即时编译为本地机器码并执行。
很多人写了几年业务代码,对 JVM 仍停留在「有个垃圾回收」------直到线上出现:
-
`OutOfMemoryError: Java heap space`
-
接口 P99 突然飙高(频繁 Full GC)
-
CPU 打满却找不到热点业务逻辑
这时,堆、栈、元空间、GC 日志、`jstack`/`jmap` 不再是面试题,而是排障工具。
学习 JVM 的价值可以概括为三点:
-
建立正确心智模型 :知道对象、类元数据、线程栈各自在哪,避免「栈上存对象」「方法区就是堆」这类概念混淆。
-
具备性能分析能力: 能看懂 GC 日志,能解释 Minor GC / Full GC,能判断该调参数还是改代码。
-
缩短故障定位时间:OOM、泄漏、线程死锁、CPU 飙高,有一套可复用的排查路径。
下文按「架构 → 类加载 → 内存 → GC → JIT/参数 → 排查工具 → 案例」展开。
提示:以下是本篇文章正文内容,下面案例可供参考
一、JVM整体架构概率
可以把一次Java程序运行粗分为三层:
┌─────────────────────────────────────────────────────────┐
│ 类加载子系统(Class Loading Subsystem) │
│ Bootstrap / Platform(Ext) / App / Custom ClassLoader │
└───────────────────────────┬─────────────────────────────┘
│ 加载字节码
▼
┌─────────────────────────────────────────────────────────┐
│ 运行时数据区(Runtime Data Areas) │
│ PC | 虚拟机栈 | 本地方法栈 | 堆 | 方法区/元空间 | 常量池 │
│ (另:直接内存 / Direct Memory,属本地内存) │
└───────────────────────────┬─────────────────────────────┘
│ 执行引擎驱动
▼
┌─────────────────────────────────────────────────────────┐
│ 执行引擎(Execution Engine) │
│ 解释器 Interpreter + JIT(C1/C2 或 Graal) │
│ + 垃圾收集器 GC │
└─────────────────────────────────────────────────────────┘
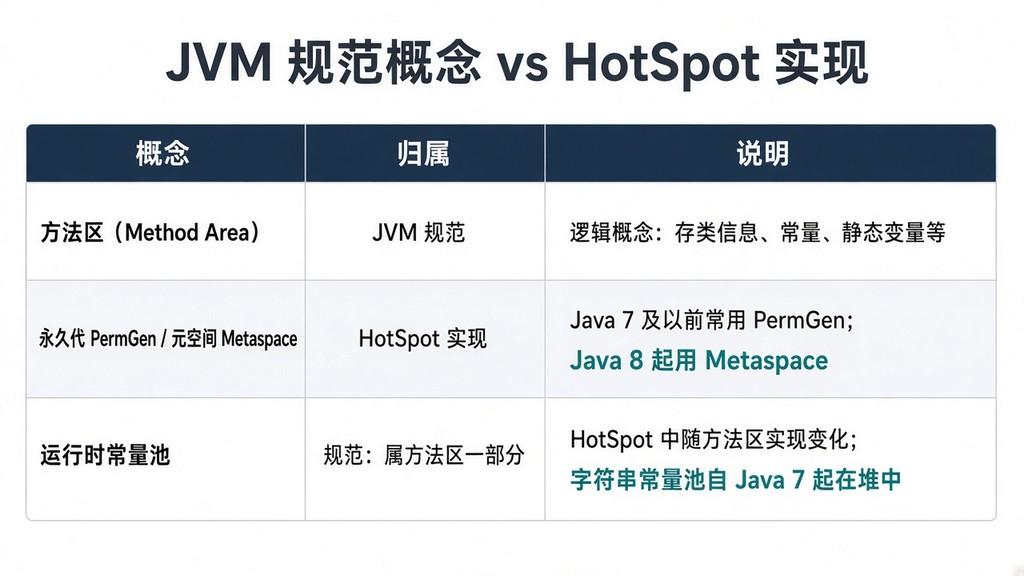
规范 vs 实现
二、从源码到运行:一次完整旅程
.java --javac--> .class --类加载--> 方法区/元空间 + Class 对象
--new--> 堆中对象
--调用--> 栈帧入栈,PC 指向字节码
--热点--> JIT 编译为本地代码(CodeCache)
java
String s = new String("abc");1.字面量"abc":若字符串常量池中尚无,则再池中放入对应引用(JDK 7+ 字符串常量池在堆中)。
2.new String(...):在堆上再创建一个String实例。
3.局部变量s:存在当前线程虚拟机栈 的栈帧局部变量表里,存的是引用,不是对象本身。
因此:池中可能有一个"abc",堆上还有一个new 出来的实例------这是面试常考点,也是理解【栈存引用、堆存对象)的最佳例子。
三、类加载机制
3.1类的生命周期
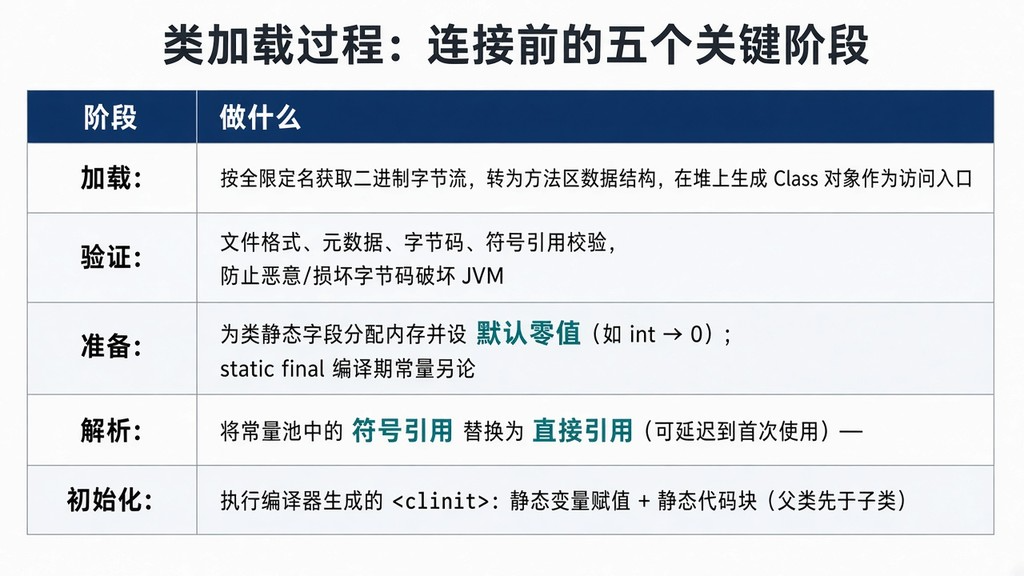
类从进入JVM到离开,经历:
加载 → 验证 → 准备 → 解析 → 初始化 → 使用 → 卸载
其中【验证 + 准备 + 解析】合称连接(Linking)。
3.2 类加载器与双亲委派
类加载器(ClassLoader)负责把字节码【变成】JVM可识别的类。
Bootstrap ClassLoader(启动类加载器,C++ 实现,Java 侧为 null)
▲
Platform ClassLoader(Java 9+;Java 8 为 Extension ClassLoader)
▲
Application ClassLoader(应用/系统类加载器,加载 classpath)
▲
Custom ClassLoader(自定义)
**双亲委派模型(Parents Delegation Model):**子加载器收到加载请求,先委派给父亲加载器;父亲加载器无法完成时,子加载器才自己加载。
作用:
**1.安全:**防止自定义`java.lang.String` 覆盖核心类。
2.唯一性:同一类由同一加载器加载,避免重复与类型混乱。
实践建议:自定义加载器时,优先重写`findClass()`,而不是随意覆盖`loadClass()`,以免破坏双亲委派只有SPI、热部署、模块隔离等场景才考虑【打破】委派。
3.3 自定义类加载器的典型场景
- 从网络/数据库/加密文件加载字节码(插件化)。
- 热部署:同一类名用不同 ClassLoader 实现隔离与卸载。
- 框架SPI:如JDBC驱动加载时需打破双亲委派,由应用加载器实现类。
java
package Exercise.jvm;
public class DiskClassLoader extends ClassLoader{
private  final  String classDir;
public DiskClassLoader(String classDir){
this.classDir = classDir;
}
@Override
protected Class<?> findClass(String name) throws ClassNotFoundException {
    //仅再父加载器都找不到才会走到这里(若未破环双亲委派)
    byte[] bytes = readClassFile(name); // 从 classDir 读取 .class
    return defineClass(name, bytes, 0, bytes.length);
}

private byte[] readClassFile(String name) throws ClassNotFoundException {
    //省略:按name 拼路径、读文件;失败抛ClassNotFoundException
    throw  new ClassNotFoundException(name);
}
}
面试延申:【同一个`.class` 被两个自定义 ClassLoader各加载一次,是不是同一个类?】------不是.JVM用【类加载器+全限定名】判定类的唯一性,跨加载器无法直接强转。
四、JVM运行时数据区
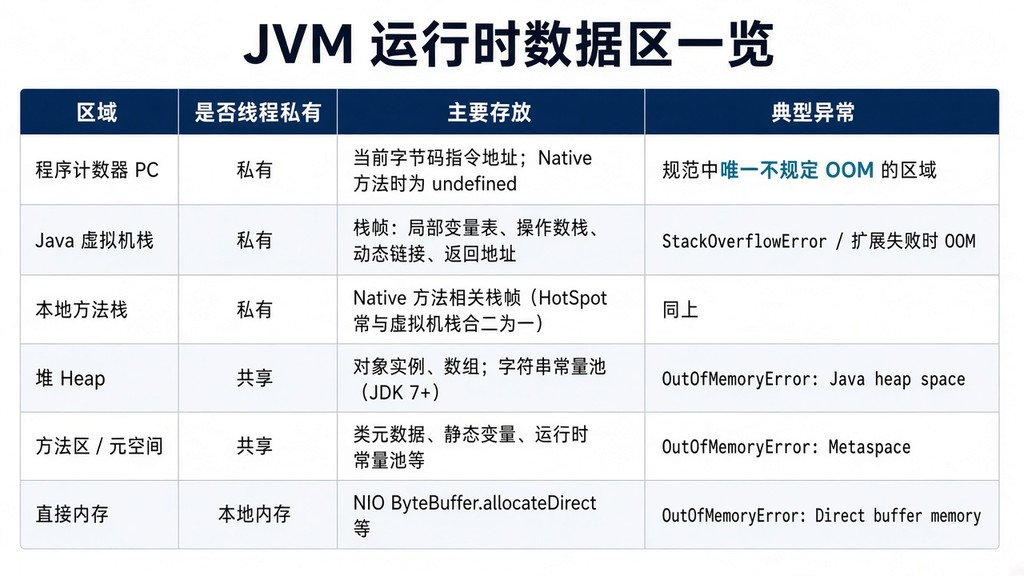
先牢记一张表:
4.1 程序计数器
多线程靠时间片切换。每个线程必须记住【下一条要执行哪条字节码】,因此PC必须线程私有。
它体积小,实现简单,几乎不会成为故障源,却是理解线程切换的关键拼图。
4.2 Java虚拟机栈与栈帧
每个方法调用对应一个栈帧(Stack Frame):
┌──────────────────────┐
│ 局部变量表 │ ← 基本类型 / 对象引用
│ 操作数栈 │ ← 计算的「草稿纸」
│ 动态链接 │ ← 指向运行时常量池中方法引用
│ 方法出口 │ ← 返回后回到哪里
└──────────────────────┘
栈帧过大(局部变量极多)或调用过深(无限递归),会触发`StackOverflowError`。
4.3 堆:对象的【大仓库】
从垃圾回收视角(传统分带收集器,如Parallel),堆常划分为:
┌──────────────── Young Generation ────────────────┐ ┌── Old ──┐
│ Eden (约 8) │ Survivor0 (1) │ Survivor1 (1) │ │ Tenured │
└──────────────────────────────────────────────────┘ └─────────┘
-
新对象优先进 Eden;Eden 满 →*Minor GC(Young GC)
-
多次 GC 仍存活(年龄达阈值,默认常为 15,可用 `-XX:MaxTenuringThreshold` 调整)→ 晋升老年代
-
大对象可能直接进老年代(或 G1 的 Humongous Region),避免在新生代反复复制。
**常见误区:**元空间不是堆的一部分;堆OOM和MetaspaceOOM是两类问题。
4.4 方法区与元空间
-**方法区:**规范层逻辑区域。
-
永久代(PermGen) :Java 7 及以前 HotSpot 实现,大小受 `-XX:MaxPermSize` 限制,易因动态类过多而 OOM。
-
元空间(Metaspace) :Java 8+ 使用本地内存存放类元数据,默认随本地内存增长,可用 `-XX:MaxMetaspaceSize` 限制。
运行时常量池属于方法区概念的一部分:字符串常量池再JDK 7后迁到堆,不要和【永久代里的字符串】混为一谈。
4.5 直接内存
不属于运行时数据区五块,但生产中极常见(Netty,NIO)。它不受`-Xmx` 直接约束,却占用进程物理内存;只盯堆、忽略 Direct Memory,是排查「进程 RSS 很大但堆不大」时的常见盲区。
五、对象创建于内存分配
HotSpot 中 `new` 一个对象,大致步骤:
1**.类加载检查:**常量池能否解析到类符号引用;类是否已初始化。
2.**分配内存:**按对象大小在堆上划出一块空间(指针碰撞/空闲列表;并发下用TLAB等优化)。
3.**零值初始化:**实例字段置零值(不含对象头)。
4**.设置对象头**:类型指针、哈希、GC年龄、锁状态等。
5.执行 `<init>`:构造方法按程序员意图完成初始化。
java
package Exercise.jvm;
public class ObjectAllocDemo {
private int id;
private String name;
public ObjectAllocDemo(int id, String name) {
    this.id = id;
    this.name = name;
}

public static void main(String[] args) {
    // 1) 确保 ObjectAllocDemo 已加载并初始化
    // 2) 在堆(通常 Eden/TLAB)分配对象内存并写对象头
    // 3) 执行构造:id、name 赋值;name 引用指向堆中 String
    ObjectAllocDemo demo = new ObjectAllocDemo(1,"jvm");
    System.out.println(demo.id + ":" +demo.name);
}
}
**分配路径速记:**小对象 → TLAB/Eden;熬过多次 Young GC → 老年代;超大对象 → 老年代或 G1 Humongous。
六、垃圾回收机制
6.1 如何判断对象存活?
引用计数: 引用+1/-1,为0可回收。无法很好处理循环引用,主流JVM不用它做主要判定。
可达性分析(Reachability Analysis): 从 GC Roots出发沿引用链遍历,不可达则判为可回收。
常见 GC Roots 包括:
-
虚拟机栈局部变量表中的引用
-
方法区静态属性、常量引用
-
JNI 引用
-
被同步锁持有的对象等
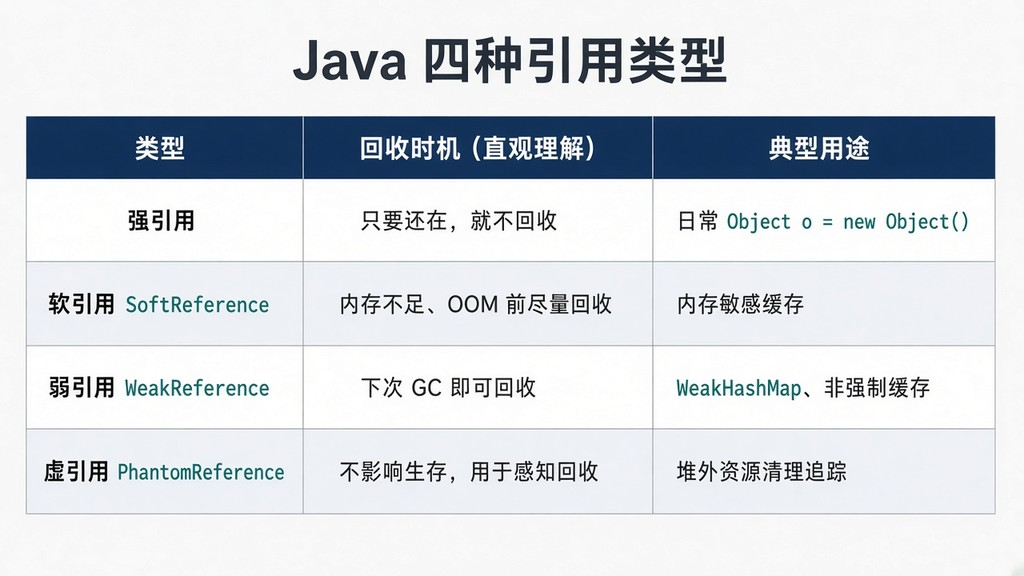
四种引用(由强到弱)
对象真正死亡前还可能经历 `finalize()`(已不推荐依赖),现代代码应优先用 `try-with-resources`、Cleaner 等机制。
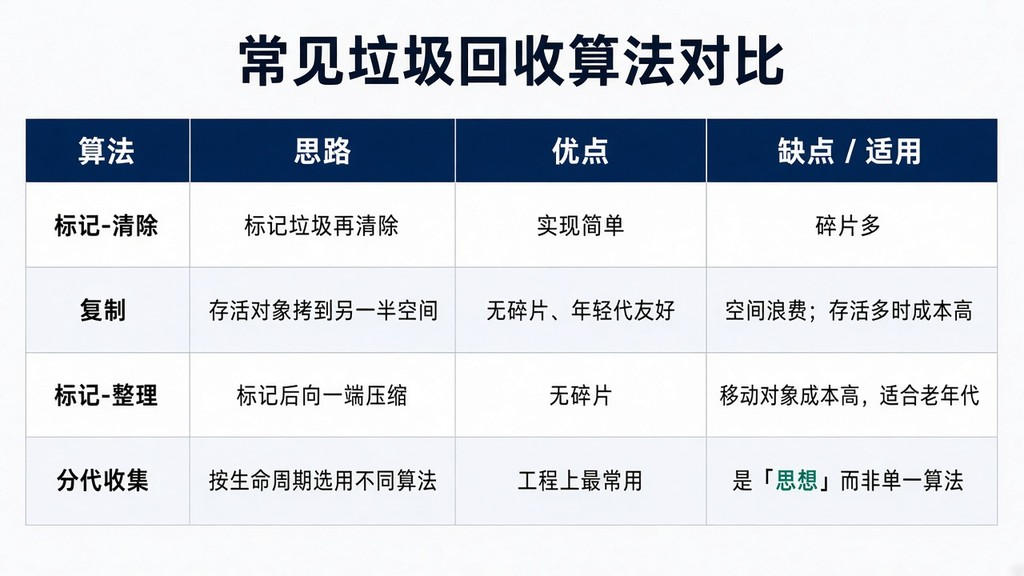
6.2 常见垃圾回收算法
6.3 Minor / Major / Full GC
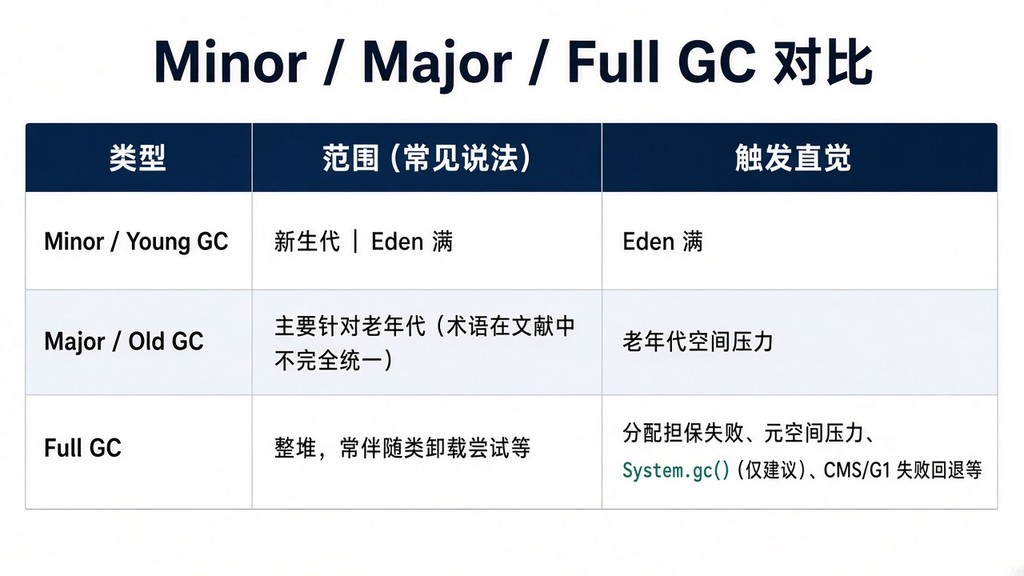
**实践建议:**关注 Full GC 频率与停顿;Young GC 频繁未必是坏事,但若伴随大量晋升,要查对象是否「偶然变老」。
七、常见垃圾收集器
下表以HotSpot 为主,标记版本背景(以常见发行版行为为准,具体以自己使用的JDK文档为准)
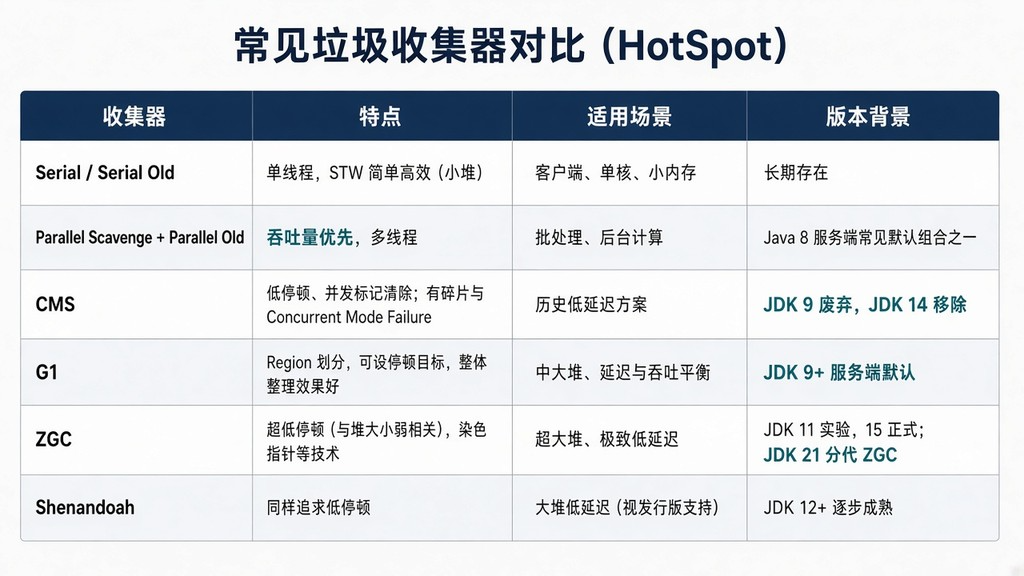
怎么选:
-
通用服务、几 GB~几十 GB 堆:优先G1 ,设合理 `-XX:MaxGCPauseMillis`。
-
超大堆、对尾延迟极敏感:评估 ZGC(Java 17/21 更稳妥)。
-
纯吞吐、可接受较长停顿:Parallel 仍有价值。
-
新项目不要再规划 CMS。
八、JIT编译与性能优化基础
JVM 先用解释器 快速启动,对热点方法用JIT(Just-In-Time) 编译为本地代码,缓存在 CodeCache。
HotSpot 分层编译常见分工:
- C1(Client Compiler): 更快编译,优化较少
- C2(Server Compiler):更慢编译,优化更激进
对开发者的实践含义:
-
基准测试要预热 :第一次执行往往偏慢,别拿冷启动当稳态性能。
-
避免极端写法破坏优化 :过度反射、巨型方法、错误的异常控制流,可能影响内联与编译质量。
-
关注 CodeCache:动态生成大量代码时,可能出现编译关闭、性能回落(可结合 `jcmd` / 相关参数排查)。
九、常见 JVM 参数(附示例)
以下参数在 HotSpot 中广泛使用;具体默认值随 JDK 版本与 GC 变化,上线前请用 `java -XX:+PrintFlagsFinal` 核对。
bash
# 堆:初始与最大(生产常设相等,减少运行时扩容抖动)
-Xms2g -Xmx2g
线程栈大小(过大会限制可创建线程数)
-Xss512k
元空间上限(防类元数据无限膨胀)
-XX:MaxMetaspaceSize=256m
选择 G1,并给出停顿目标(目标非硬保证)
-XX:+UseG1GC -XX:MaxGCPauseMillis=200
OOM 时自动 dump,便于事后用 MAT 分析
-XX:+HeapDumpOnOutOfMemoryError
-XX:HeapDumpPath=/var/log/app/heapdump.hprof
GC 日志(JDK 9+ 统一日志框架示例)
-Xlog:gc*:file=/var/log/app/gc.log:time,uptime,level,tags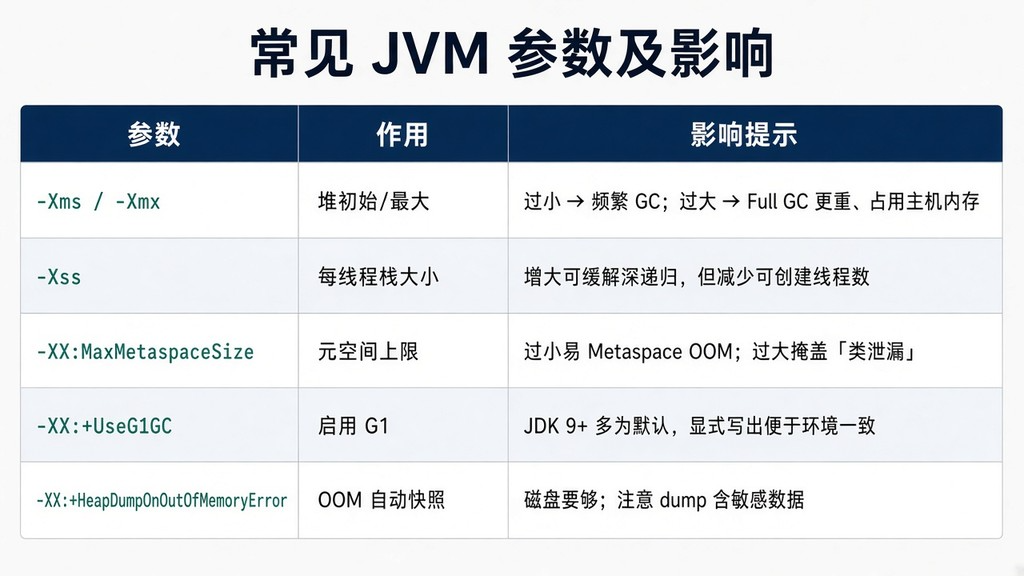
十、常见问题与排查思路
10.1 OutOfMemoryError
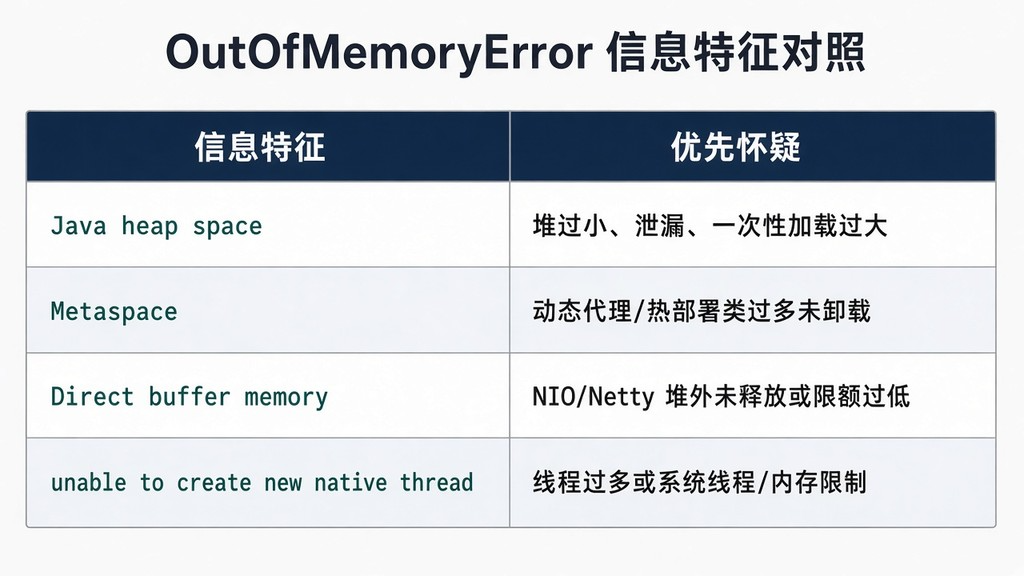
排查骨架:开 HeapDump → MAT 看 Dominator Tree / Leak Suspects → 区分「真需要更大堆」还是「引用没放开」。
10.2 StackOverflowError
优先查无限递归或过深调用,其次才是调大 `-Xss`。能改成迭代就别靠堆栈硬扛。
10.3 频繁 Full GC
看 GC 日志:老年代是否持续上涨?是否存在晋升失败?元空间是否频繁触发?再决定是扩容、换 GC,还是改缓存/对象生命周期。
10.4 内存泄漏 vs 内存溢出
-
泄漏: 用完的对象仍被引用,GC 收不走,可用内存缓慢被蚕食。
-
**溢出:**申请时内存不够,抛 OOM。泄漏发展到最后常常表现为溢出。
10.5 CPU 过高
`top` 找进程 → `top -H` 找线程 → 线程 ID 转十六进制 → `jstack` 对齐 nid → 看是否死循环、激烈锁竞争、或 GC 线程占满(后者要回到 GC 问题)。
十一、监控与诊断工具
11.1 命令行(至少会这几条)
bash
# 1) 列出 Java 进程
jps -lvm
2) 查看 GC / 堆概况(pid 换成实际进程号)
jstat -gcutil <pid> 1000 10
输出中 S0/S1/E/O/M 等为各区使用百分比;YGC/YGCT、FGC/FGCT 为 Young/Full GC 次数与耗时
3) 堆转储(注意:live 会先触发 GC;生产慎用,优先低峰或用更轻量方案)
jmap -dump:format=b,file=heap.hprof <pid>
4) 线程快照(死锁、阻塞首选)
jstack -l <pid> > thread.txt
5) 现代统一入口:堆信息示例
jcmd <pid> GC.heap_info
jcmd <pid> Thread.print
读 `jstat -gcutil` 的直觉:`O`(老年代)持续升高且 `FGC` 频繁增加,要警惕晋升过多或泄漏;`E` 频繁归零但业务 RT 正常,可能只是 Young GC 活跃。
11.2 GUI / 增强工具
-
VisualVM / JConsole: 本地观察堆、线程、CPU,适合开发与预发。
-
MAT: 分析 `hprof`,找大对象与泄漏链。
-
Arthas:线上动态观测、反编译、方法耗时、线程、dashboard,改动小、见效快。
十二、实战案例:静态集合导致的堆溢出
现象
批量任务运行数小时后偶发:
java.lang.OutOfMemoryError: Java heap space
重启后短期内正常,说明不像「堆固定过小到立刻炸」,更像内存随时间累积。
复现与简化模型
java
package Exercise.jvm;
import java.util.ArrayList;
import java.util.List;
/**
演示:静态集合长期持有对象 → GC 无法回收 → 最终堆溢出。
可用较小堆复现:
java -Xms32m -Xmx32m -XX:+HeapDumpOnOutOfMemoryError StaticLeakDemo
*/
public class StaticLeakDemo {
//    生命周期几乎等于整个JVM进程
private  static  final List<byte[]> CACHE = new ArrayList<>();
public static void main(String[] args) {
    int batch = 0;
    while (true){
//            模拟【每批结果都塞进全局缓存]
CACHE.add(new byte[1024*1024]);//1MB
batch++;
if (batch %10 ==0){
System.out.println("cached MB =" +CACHE.size());
}
}
}
}
JVM 层面发生了什么:
-
每次 `new byte1MB` 在堆上分配。
-
引用进入静态 `CACHE`,成为 GC Roots 可达对象。
-
Young GC / Full GC 都无法回收这些数组。
-
堆被填满 → `Java heap space`。
排查步骤(生产同构)
-
启动时带 `-XX:+HeapDumpOnOutOfMemoryError`,拿到 `hprof`。
-
MAT 中 Dominator Tree 看到 `byte\[\]` 被 `StaticLeakDemo.CACHE` 持有。
-
对照代码:批处理结果本应写库后释放,却进了全局 List。
修复
java
public void processBatch(List<Item> items) {
    List<Result> buffer = new ArrayList<>(items.size());
    for (Item item : items) {
        buffer.add(handle(item));
    }
    repository.saveAll(buffer);
    buffer.clear(); // 或让 buffer 离开作用域,无需静态缓存
}
若确需缓存:设上限(Caffeine/Guava)、过期时间,或对可丢数据使用软/弱引用,并监控命中率与堆曲线。
对比实验
去掉 `static`,把 `CACHE` 改成 `main` 局部变量并在循环外创建、循环内不无限 add,或改为「每 N 次 clear」,用 VisualVM 会看到堆呈锯齿状回落------这就是「可被 GC 回收」与「泄漏」的可视化差异。
十三、总结
重点回顾
-
规范概念 ≠ HotSpot 实现 :方法区 vs 元空间;字符串池位置随版本变化。
-
栈存引用与基本类型,堆存对象 ;元空间存类元数据;直接内存在堆外。
-
类加载 靠双亲委派保安全与唯一;自定义加载器用 `findClass` 扩展。
-
GC 以可达性分析为根基,分代/分区是工程折中;现代默认看 G1,低延迟看 ZGC。
-
调优顺序:先证据(GC 日志、dump、栈),再改代码与架构,最后才拧参数。
常见误区
-
以为 `System.gc()` 会立刻、完整地清理一切------它只是建议。
-
把 Full GC 一律当成「老年代 GC」------范围与触发因收集器而异,要以日志为准。
-
堆设得越大越好------更大的堆可能换来更长的停顿(视 GC 而定)和更高的主机成本。