✨作者主页 :IT研究室✨
个人简介:曾从事计算机专业培训教学,擅长Java、Python、微信小程序、Golang、安卓Android等项目实战。接项目定制开发、代码讲解、答辩教学、文档编写、降重等。
☑文末获取源码☑
文章目录
一、前言
系统介绍
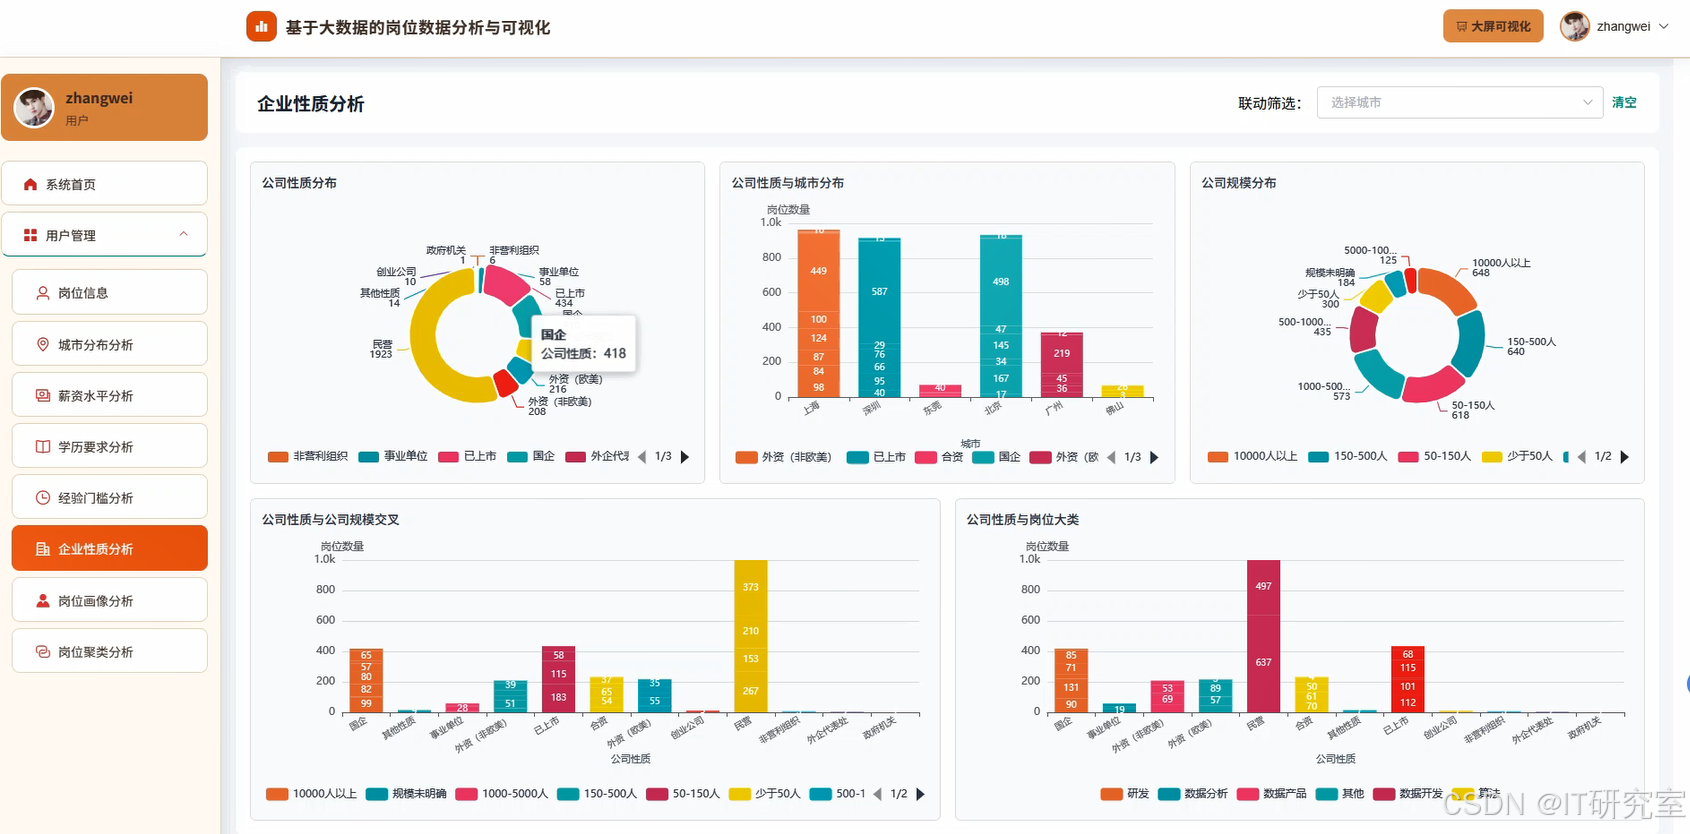
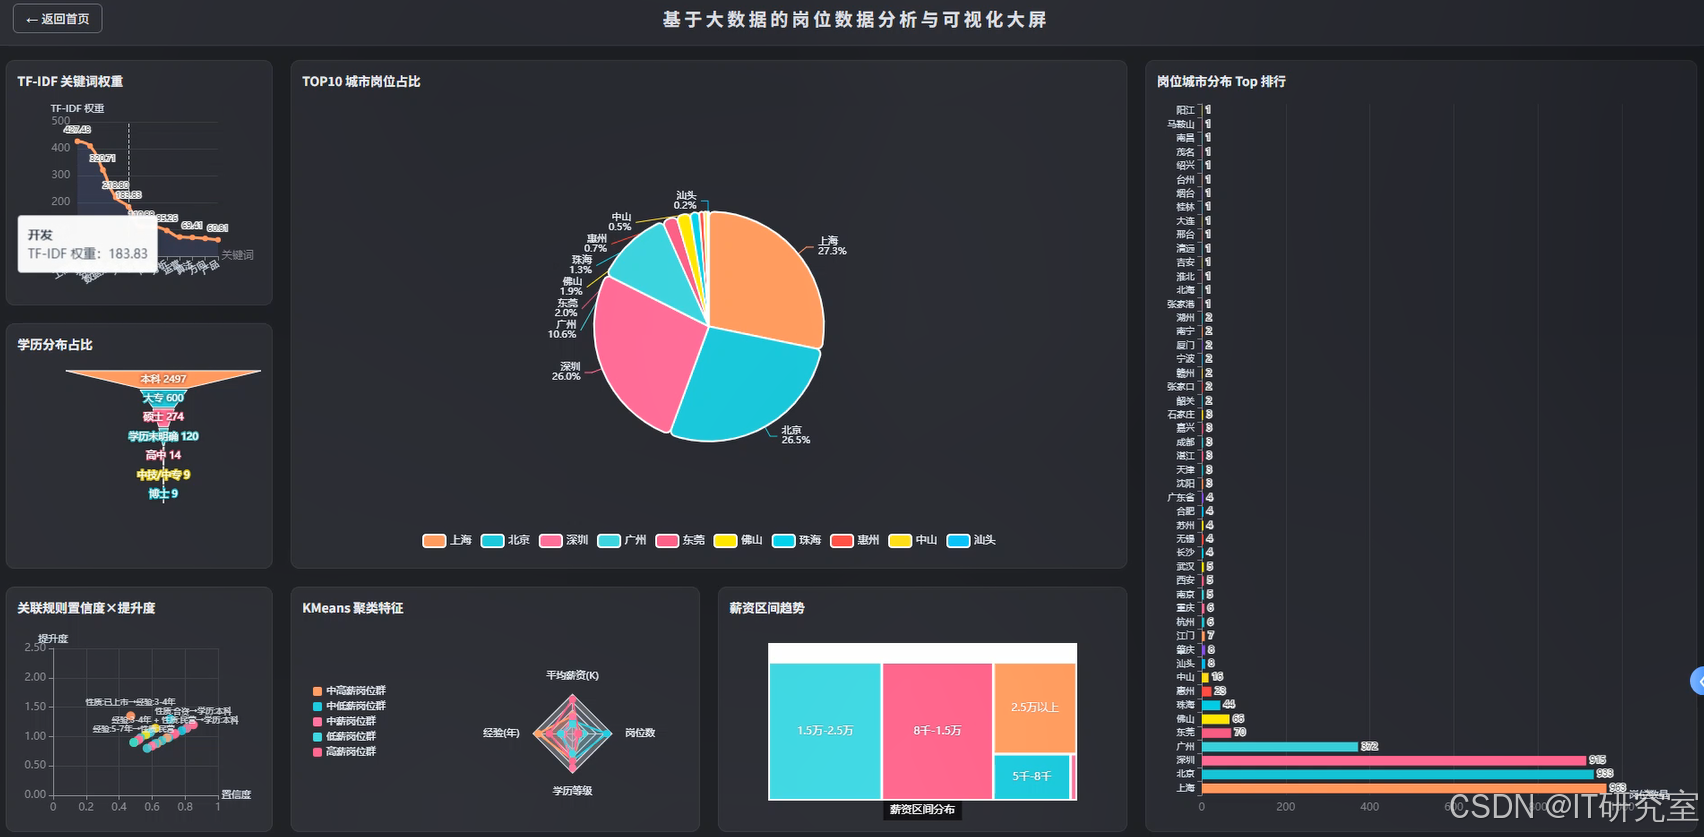
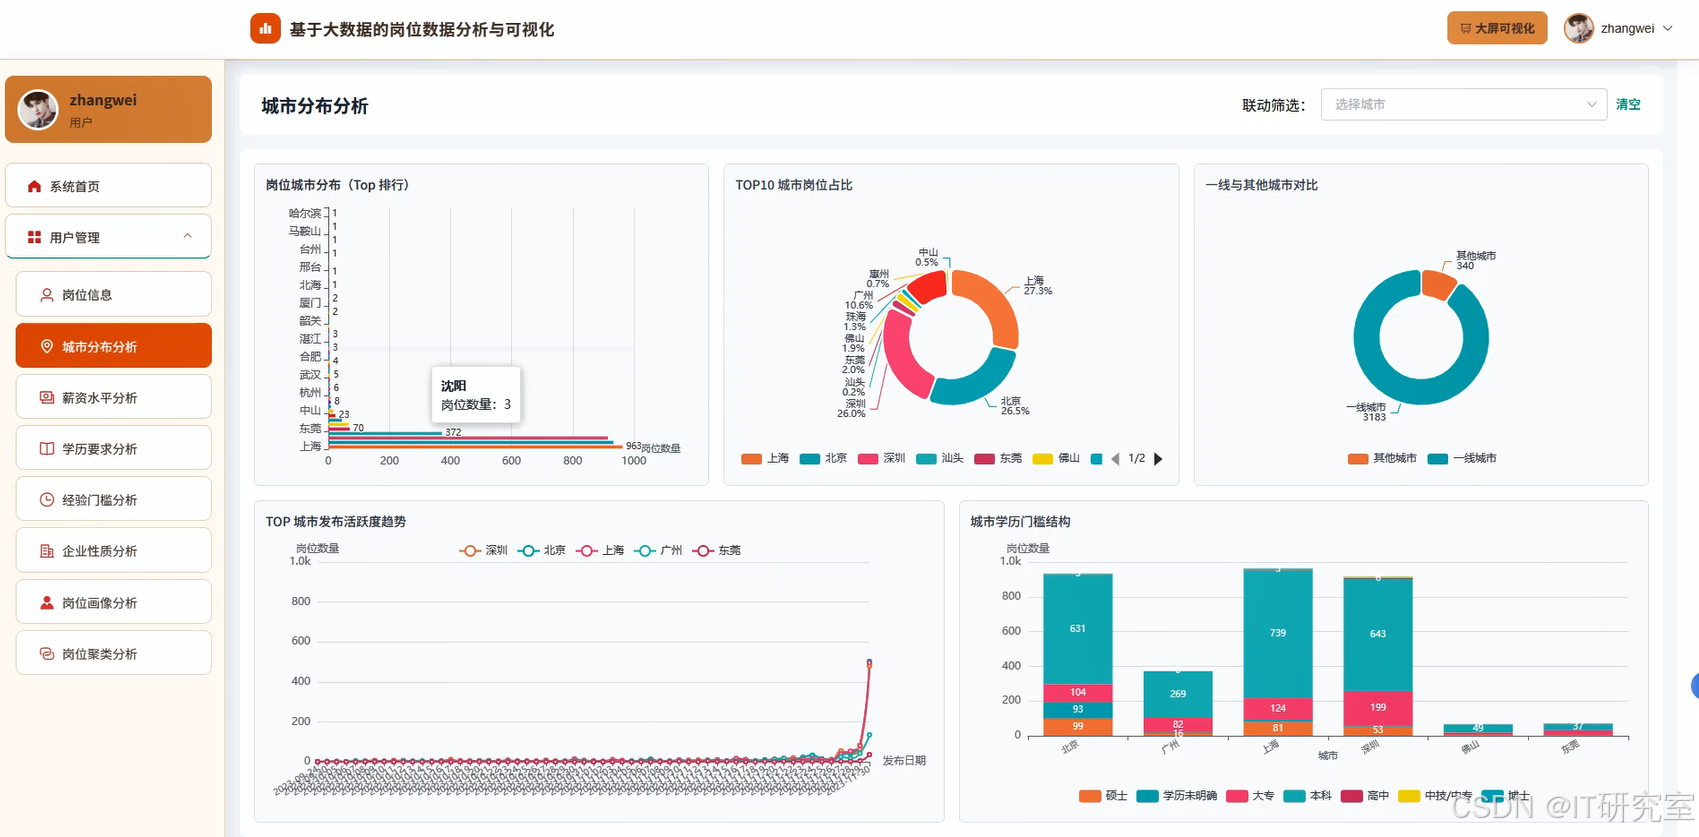
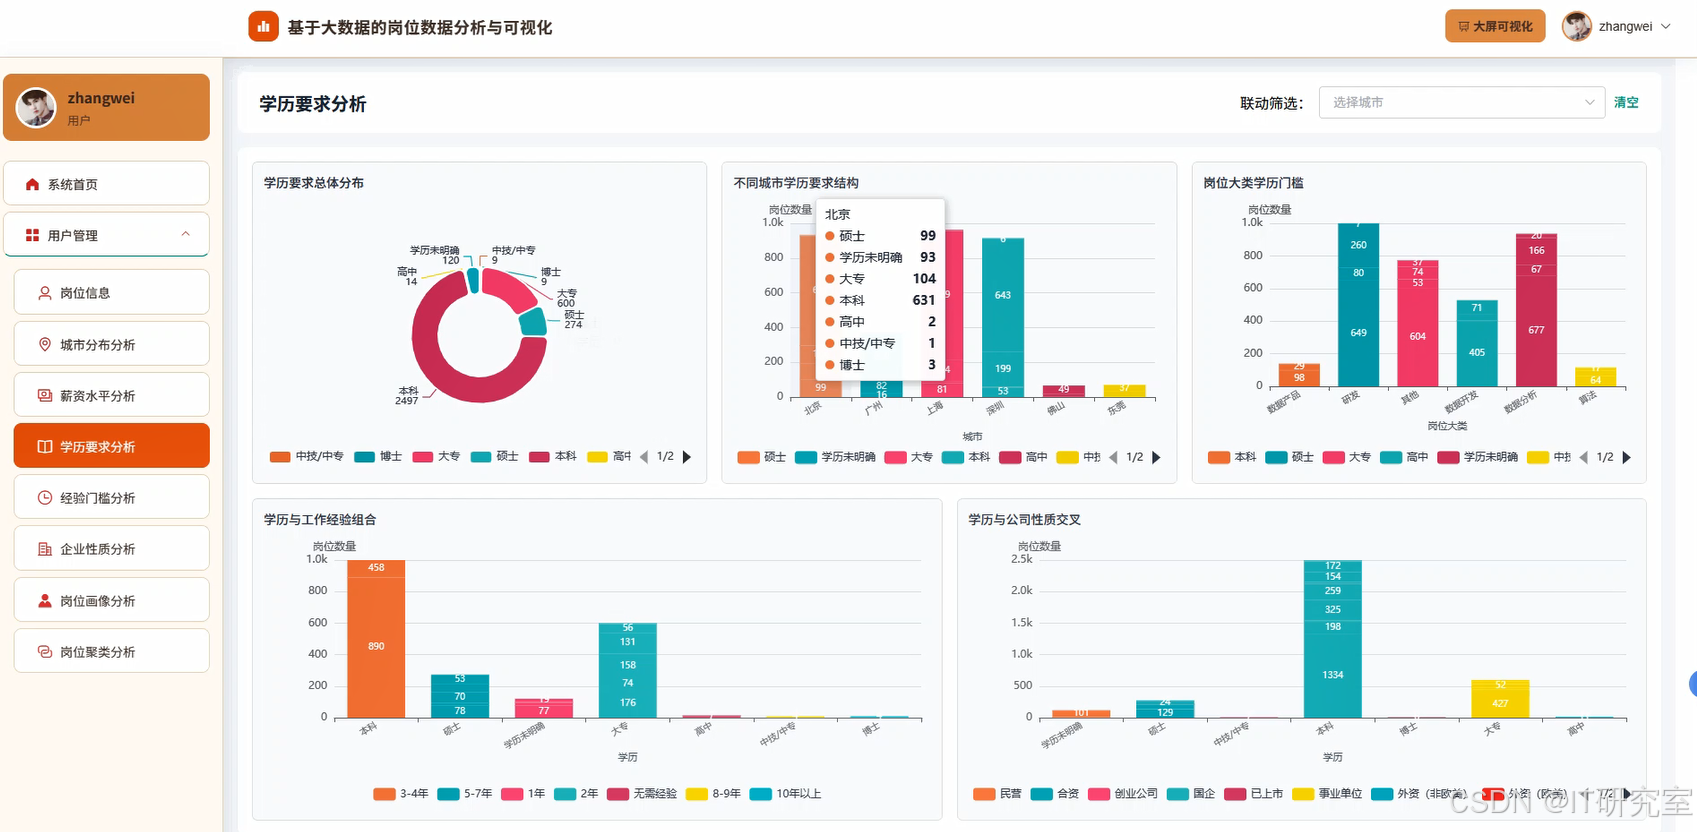
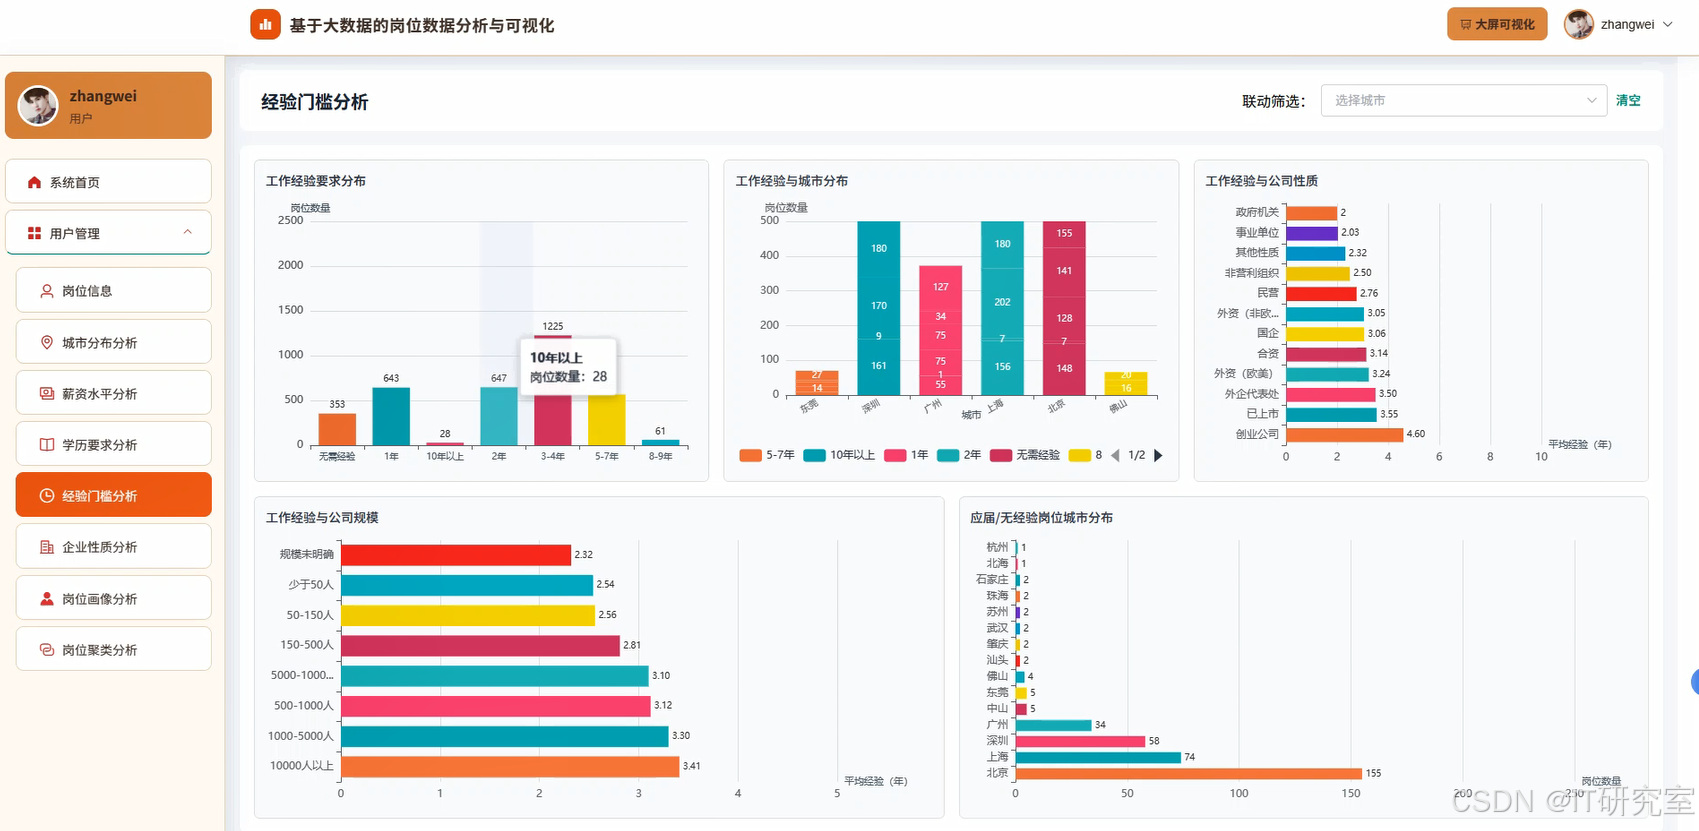
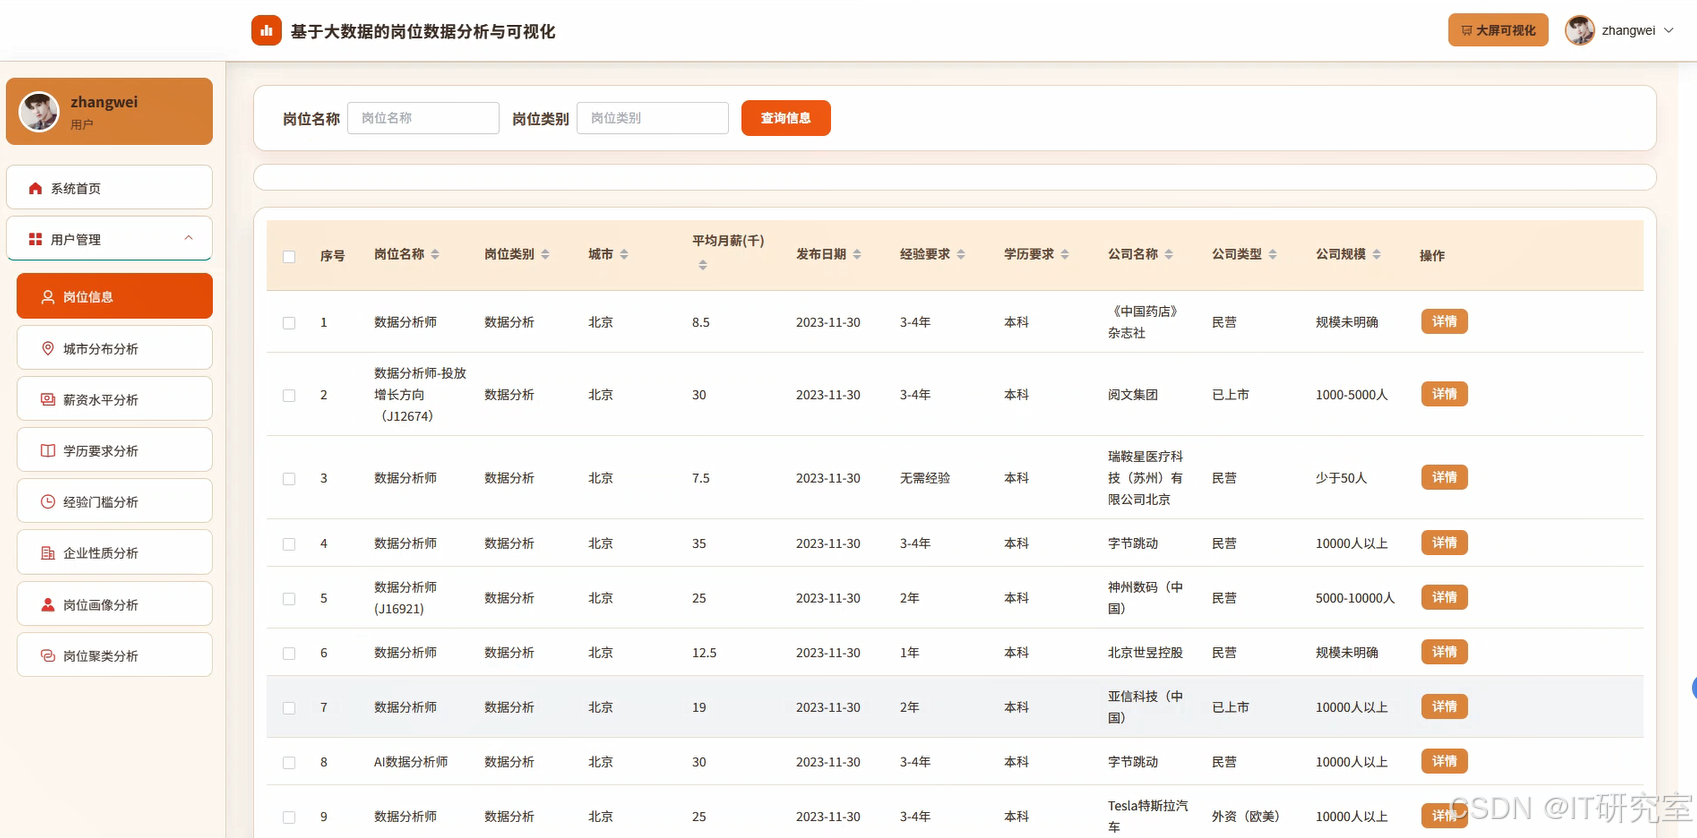
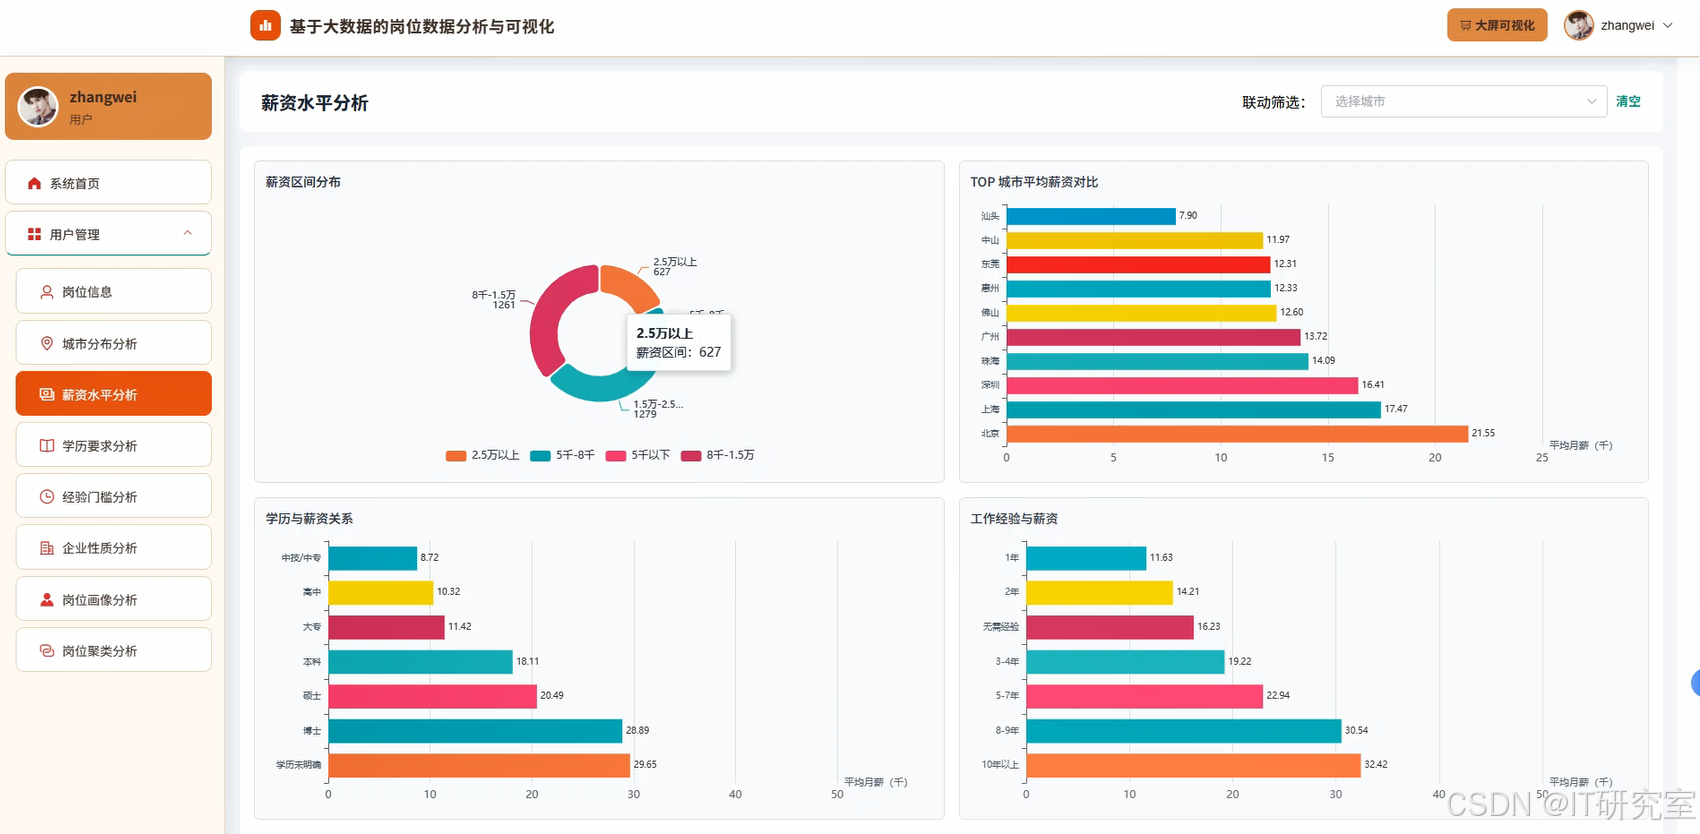
本系统为《基于大数据的岗位数据分析与可视化》,采用Hadoop与Spark作为大数据处理框架,结合Python与Java双版本开发,后端分别使用Django与Spring Boot,前端基于Vue、ElementUI与ECharts实现可视化展示。系统主要功能包括系统首页、用户管理、岗位信息、城市分布分析、薪资水平分析、学历要求分析、经验门槛分析、企业性质分析、岗位画像分析以及岗位聚类分析。数据处理流程上,系统通过HDFS存储原始岗位数据,利用Spark与Spark SQL完成数据清洗、统计与聚合计算,再经由Pandas与NumPy进行辅助处理,最终将分析结果写入MySQL并由前端ECharts进行图表呈现。系统围绕岗位数据展开多维度分析,城市分布分析用于展示岗位地域集中情况,薪资水平分析用于呈现不同岗位的薪酬区间,学历要求与经验门槛分析用于反映岗位的准入条件,企业性质分析用于区分不同类型企业的招聘特征,岗位画像与岗位聚类分析则用于归纳岗位特征与类别划分,整体形成一个从数据存储、计算处理到可视化展示的完整大数据分析流程。
选题背景
近几年大数据技术逐渐从概念走向实际应用,企业招聘过程中产生的岗位信息越来越依赖数据化手段进行处理。招聘平台每天都会积累大量岗位记录,这些记录包含城市、薪资、学历、经验、企业性质等字段,靠人工去整理和对比效率很低。Hadoop与Spark这类大数据框架的出现,让批量处理和分析这些岗位数据变得可行,HDFS可以存放原始数据,Spark SQL可以完成统计与聚合,再配合可视化图表就能把结果直观地呈现出来。对于计算机专业的学生来说,毕业设计选题如果只做普通的增删改查,很难体现专业能力,而岗位数据分析这个方向既贴近实际场景,又能把大数据处理流程走一遍。基于这样的考虑,我选择了基于大数据的岗位数据分析与可视化作为课题,希望通过Hadoop与Spark完成一次相对完整的数据分析实践。
选题意义
从实际应用角度看,这个系统可以把分散的岗位信息按城市、薪资、学历、经验、企业性质等维度整理出来,让查看的人对岗位分布有一个大概的了解,省去逐条翻看的时间。从学习角度看,做这个课题的过程本身就是在走一遍大数据处理的流程,HDFS存数据、Spark做计算、Spark SQL做统计、MySQL存结果、ECharts做展示,这些环节串起来之后,对大数据相关技术的理解会比单纯看书更具体一些。从毕业设计的角度看,这个系统涉及的功能模块比较多,城市分布分析、薪资水平分析、岗位画像分析和岗位聚类分析各有侧重,能够支撑起一篇毕设的篇幅,也能在答辩时说明清楚每个模块的处理逻辑。当然,这个系统只是一个毕业设计层面的实现,分析深度和工程完整度都比较有限,主要目的还是把大数据分析的基本流程跑通,为以后进一步学习打下一个基础。
二、开发环境
- 大数据框架:Hadoop+Spark(本次没用Hive,支持定制)
- 开发语言:Python+Java(两个版本都支持)
- 后端框架:Django+Spring Boot(Spring+SpringMVC+Mybatis)(两个版本都支持)
- 前端:Vue+ElementUI+Echarts+HTML+CSS+JavaScript+jQuery
- 详细技术点:Hadoop、HDFS、Spark、Spark SQL、Pandas、NumPy
- 数据库:MySQL
三、系统界面展示
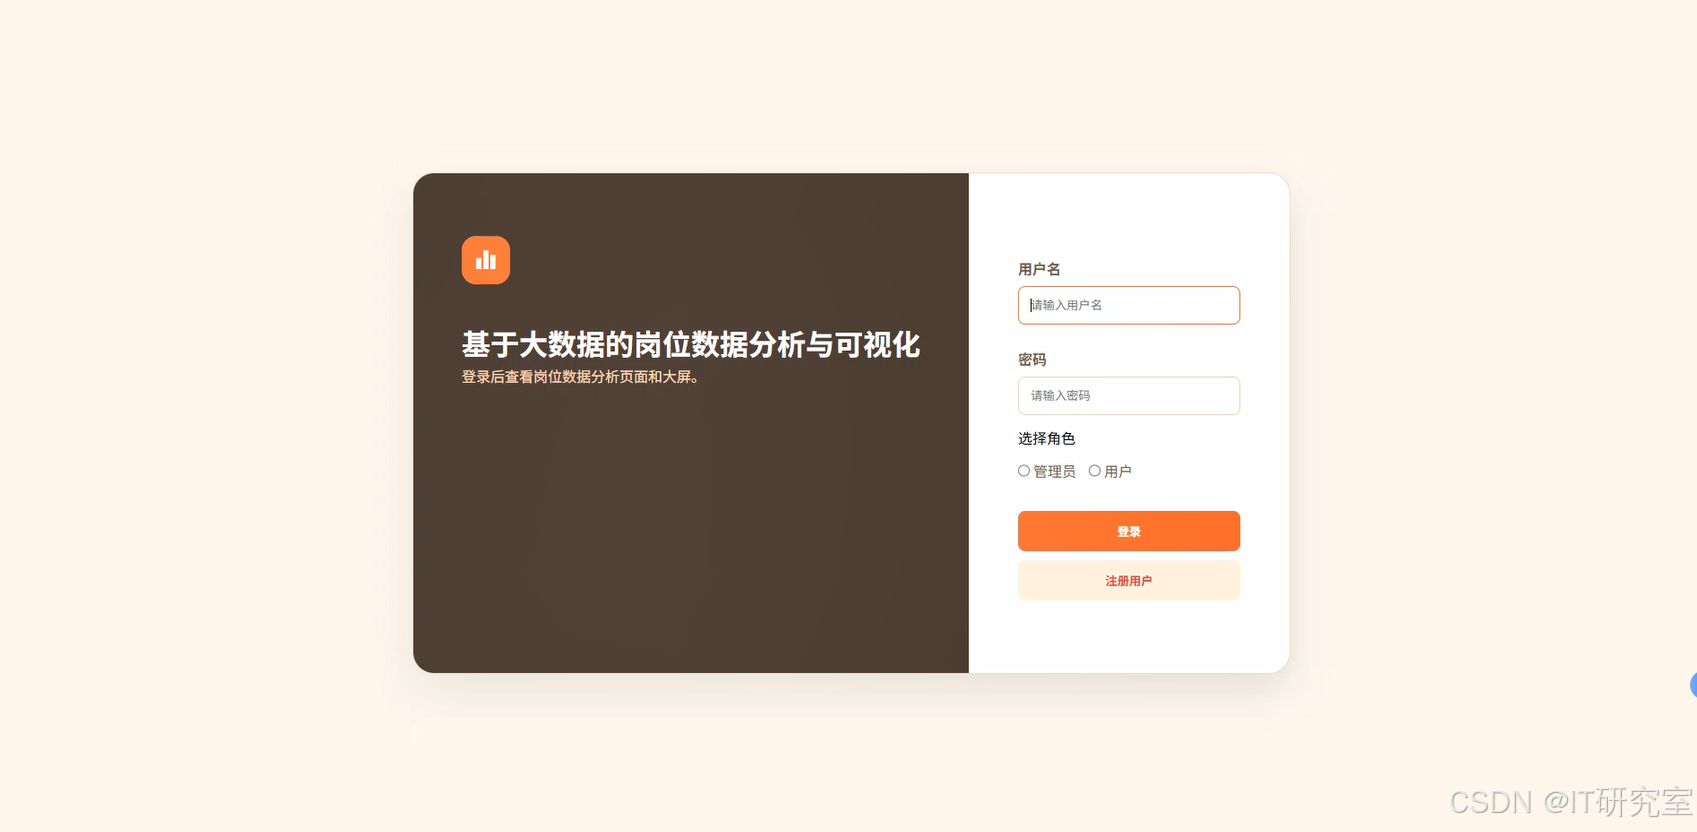
- 基于大数据的岗位数据分析与可视化界面展示:
四、代码参考
- 项目实战代码参考:
java(贴上部分代码)
from pyspark.sql import SparkSession
from pyspark.sql.functions import col, count, avg, when, desc
from pyspark.ml.feature import VectorAssembler
from pyspark.ml.clustering import KMeans

spark = SparkSession.builder.appName("JobAnalysis").master("local[*]").config("spark.sql.shuffle.partitions", "4").getOrCreate()
job_df = spark.read.option("header", "true").option("inferSchema", "true").csv("hdfs://localhost:9000/job/job_data.csv")
job_df = job_df.dropna(subset=["city", "salary_min", "salary_max", "education", "experience", "company_type"])
job_df = job_df.withColumn("salary_avg", (col("salary_min") + col("salary_max")) / 2)
def analyze_salary_by_city(job_df):
    city_salary = job_df.groupBy("city").agg(count("job_id").alias("job_count"), avg("salary_avg").alias("avg_salary")).orderBy(desc("avg_salary"))
    city_salary.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/job_analysis").option("dbtable", "city_salary_result").option("user", "root").option("password", "123456").save()
    return city_salary
def analyze_education_requirement(job_df):
    edu_df = job_df.withColumn("edu_level", when(col("education").contains("博士"), 5).when(col("education").contains("硕士"), 4).when(col("education").contains("本科"), 3).when(col("education").contains("大专"), 2).otherwise(1))
    edu_result = edu_df.groupBy("education", "edu_level").agg(count("job_id").alias("job_count"), avg("salary_avg").alias("avg_salary")).orderBy(desc("edu_level"))
    edu_result.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/job_analysis").option("dbtable", "education_result").option("user", "root").option("password", "123456").save()
    return edu_result
def analyze_job_cluster(job_df):
    cluster_df = job_df.select("salary_avg", "experience", "education").dropna()
    cluster_df = cluster_df.withColumn("exp_num", when(col("experience").contains("1"), 1).when(col("experience").contains("3"), 3).when(col("experience").contains("5"), 5).otherwise(0))
    cluster_df = cluster_df.withColumn("edu_num", when(col("education").contains("博士"), 5).when(col("education").contains("硕士"), 4).when(col("education").contains("本科"), 3).when(col("education").contains("大专"), 2).otherwise(1))
    assembler = VectorAssembler(inputCols=["salary_avg", "exp_num", "edu_num"], outputCol="features")
    feature_df = assembler.transform(cluster_df)
    kmeans = KMeans(k=4, seed=42, featuresCol="features", predictionCol="cluster")
    model = kmeans.fit(feature_df)
    result_df = model.transform(feature_df)
    cluster_result = result_df.groupBy("cluster").agg(count("salary_avg").alias("job_count"), avg("salary_avg").alias("avg_salary"), avg("exp_num").alias("avg_exp"), avg("edu_num").alias("avg_edu"))
    cluster_result.write.mode("overwrite").format("jdbc").option("url", "jdbc:mysql://localhost:3306/job_analysis").option("dbtable", "cluster_result").option("user", "root").option("password", "123456").save()
    return cluster_result
analyze_salary_by_city(job_df)
analyze_education_requirement(job_df)
analyze_job_cluster(job_df)
spark.stop()
五、系统视频
基于大数据的岗位数据分析与可视化项目视频:
结语
最新大数据毕业设计选题推荐-基于大数据的岗位数据分析与可视化-大数据-Spark-Hadoop-Bigdata
想看其他类型的计算机毕业设计作品也可以和我说都有 谢谢大家!
有技术这一块问题大家可以评论区交流或者私我~
大家可以帮忙点赞、收藏、关注、评论啦~
源码获取:⬇⬇⬇