【数据结构】堆_OJ题
概览
- 堆排序与 TOP-K
- 维护 K 个候选
- 多路归并
- 对顶堆与数据流中位数
- 模拟最值:撞石头
- 序列生成:丑数
核心知识
一、基本套路
堆对外只有插入、删除堆顶和取堆顶三个接口,算法题里用到堆的地方几乎都能归入下面五类,分类的依据是「题目反复要的那个东西是不是极值」。
第一类,维护 K 个候选。 题目问第 K 大、前 K 个还是最小的 K 个,做法都是开一个大小为 K 的堆当候选集,新元素和堆顶比一次,再决定要不要挤掉堆顶。求最大的 K 个建小堆,求最小的 K 个建大堆,方向由堆顶的角色决定:堆顶是候选里最没资格留下的那一个,每一轮被挤掉的都是它。数组中的第 K 个最大元素、前 K 个高频元素、数据流中的第 K 大元素、最小的 k 个数都属于这一类。
第二类,多路归并。 有几条各自有序的序列,要按全局顺序把它们取出来。把每条序列当前的最小值放进堆里,取走堆顶之后,再从那条序列补下一个进来。合并 K 个升序链表是最直接的一道;有序矩阵的每一行都是升序,同样可以看成若干条有序序列;查找和最小的 K 对数字把这套做法用在两数之和上,堆里存的是候选的下标对。
第三类,对顶堆。 数据流的中位数要同时拿到较小一半的最大值和较大一半的最小值,一个堆给不出两个极值,于是用两个堆对着放:大堆存较小的一半,小堆存较大的一半,两个堆顶合起来就是中间的那两个数。这类结构在面试里出现得很多,难点在元素于两个堆之间的搬运规则上,堆本身的操作并不复杂。
第四类,值域二分。 有序矩阵中第 K 小的元素还有第二种做法:不去一个一个地取,而是猜一个数 mid,数出矩阵里不大于 mid 的元素有多少个,靠这个计数把答案二分逼近出来。这种做法与堆无关,但它回答的是同一个「第 K 小」的问题,可以拿来和堆做法对照:一个按元素逐个逼近,一个按值域折半逼近。
第五类,模拟过程。 最后一块石头的重量要求每次挑两块最重的撞,用大堆每次取两个堆顶就够了。丑数 II 也属于这一类,只是堆里放的东西是自己生成的:取一个丑数出来,把它乘 2、乘 3、乘 5 的结果再放回去。
二、边界值
第一类,K 与数据量的关系。 K 等于 1 时题目退化成求最值,堆里始终只有一个元素;K 等于数据总长时堆装下了全部数据,效果等同于全排序;K 大于数据总长时要注意代码不能越界读,稳妥的写法是在开头把 K 截到数据量。这三种情况的处理各不相同,尤其是 K 大于数据总长的那一档,堆还没装满就要能给出正常的返回值。
第二类,元素相同。 全部元素一样时,候选集里始终是同一个值,堆的形态看不出变化,可是每一次比较、每一次替换判断都走到过。前 K 个高频元素里还有出现次数相同的情况要处理:次数相同时谁先谁后都算对,但两种做法给出的顺序可能不同,需要事先把输出顺序固定下来。
第三类,空与单元素。 空链表数组、只有一个元素的数组、只有一块石头、数据流里只有一个数,这些输入都要单独考虑。合并 K 个链表的输入可能整组都是空链表;数据流的中位数在第一个数进来时就要能给出答案。
第四类,有序与逆序。 已经升序、完全降序、严格递增的矩阵,这几种输入会让调整走的层数出现最坏和最好情况。堆排序碰上已经升序的数组,建堆阶段完全不用交换,取堆顶阶段每一轮都要调整。
第五类,数值范围。 丑数那道题的数据范围卡得很紧,第 1690 个丑数是 2123366400,离 int 的上限只差两千万,堆里存的数再乘 5 就会溢出。这一类边界的根源是类型的宽度不够,逻辑本身没有错,只有在最大规模的数据上才会暴露出来。
第六类,负数与零。 查找和最小的 K 对数字、最小的 k 个数、数据流的中位数都可能出现负数,比较逻辑本身不受影响,需要留意的是初始值的选取,不能一律定成 0。
三、题目总览
| 序号 | 题目 | 题号 | 套路 | 时间复杂度 |
|---|---|---|---|---|
| 1 | 手写堆排序 | 打底题 | 建堆加取堆顶 | O(N log N) |
| 2 | TOP-K | 打底题 | 维护 K 个候选 | O(N log K) |
| 3 | 数组中的第 K 个最大元素 | 215 | 维护 K 个候选 | O(N log K),快选平均 O(N) |
| 4 | 前 K 个高频元素 | 347 | 哈希计数加维护 K 个候选 | O(N log K) |
| 5 | 数据流中的第 K 大元素 | 703 | 维护 K 个候选 | 每次 O(log K) |
| 6 | 最后一块石头的重量 | 1046 | 模拟过程 | O(N log N) |
| 7 | 合并 K 个升序链表 | 23 | 多路归并 | O(N log K) |
| 8 | 有序矩阵中第 K 小的元素 | 378 | 多路归并或值域二分 | O(K log N) 或 O(N log 值域) |
| 9 | 查找和最小的 K 对数字 | 373 | 多路归并 | O(K log K) |
| 10 | 丑数 II | 264 | 序列生成 | O(N log N),三指针 O(N) |
| 11 | 数据流的中位数 | 295 | 对顶堆 | 每次 O(log N) |
| 12 | 最小的 k 个数 | 面试题 17.14 | 维护 K 个候选 | O(N log K) |
十二道题里有八道共用同一个内核:往一个固定大小的堆里塞元素,比堆顶大(或小)就替换。把这些题区分开来的是三个地方:堆里存什么(数、下标对、链表结点)、堆的大小是多少(K 还是全部)、元素从哪里来(现成的数组还是自己生成的)。
实例代码
工程结构
text
ds11/
├── heap.h            共用的 int 堆,初始化时传 0 是小堆、1 是大堆
├── heap.c
├── p01_heap_sort.c              课件题:手写堆排序
├── p02_topk.c                   课件题:TOP-K
├── p03_kth_largest.c            215 数组中的第 K 个最大元素
├── p04_top_k_frequent.c         347 前 K 个高频元素
├── p05_kth_largest_stream.c     703 数据流中的第 K 大元素
├── p06_last_stone_weight.c      1046 最后一块石头的重量
├── p07_merge_k_lists.c          23 合并 K 个升序链表
├── p08_kth_smallest_matrix.c    378 有序矩阵中第 K 小的元素
├── p09_k_smallest_pairs.c       373 查找和最小的 K 对数字
├── p10_ugly_number_ii.c         264 丑数 II
├── p11_median_finder.c          295 数据流的中位数
└── p12_smallest_k.c             面试题 17.14 最小的 k 个数
共用的堆把方向收在一个比较函数里,小堆和大堆只差传参,调整逻辑只有一份:
c
# 文件:/home/cocatrice/ds11/heap.c
static bool Higher(Heap* hp, HPDataType a, HPDataType b)
{
	if (hp->dir == 0)
	{
		return a < b;
	}
	return a > b;
}
十二个程序都用 gcc -std=gnu99 -Wall -Wextra -O2 heap.c pXX.c -o pXX 编译,开启 -Wall -Wextra 之后仍然是零告警。
第一题 手写堆排序(打底题)
题目:给一个整数数组,用堆排序把它按升序排好,不许调用标准库的排序函数。
原题链接: 洛谷 P3378 【模板】堆
思路。 堆排序分两步:先建一个大堆,然后反复把堆顶(当前最大值)换到未排序部分的末尾,再把堆的范围缩小一格、对新的堆顶做一次向下调整。建堆是 O(N),后面 N 次调整每次 O(log N),总共 O(N log N),额外空间 O(1)。升序排列要建大堆,原因在知识篇里推过:换到末尾的必须是剩余元素里的最大值,位置才对得上。
用例走一遍。 数组是 5、11、7、2、3、17,下面按轮次看每一步的变化。
| 轮次 | 堆的范围 | 动作 | 换完之后的数组 |
|---|---|---|---|
| 建堆后 | 6 个 | 建大堆得到 17 11 7 2 3 5 | 17 11 7 2 3 5 |
| 1 | 6 个 | 堆顶 17 和末尾 5 交换,范围缩到 5 | 5 11 7 2 3 17 |
| 2 | 5 个 | 调整后堆顶 11,和末尾 3 交换 | 3 5 7 2 11 17 |
| 3 | 4 个 | 调整后堆顶 7,和末尾 2 交换 | 2 5 3 7 11 17 |
| 4 | 3 个 | 调整后堆顶 5,和末尾 3 交换 | 3 2 5 7 11 17 |
| 5 | 2 个 | 调整后堆顶 3,和末尾 2 交换 | 2 3 5 7 11 17 |
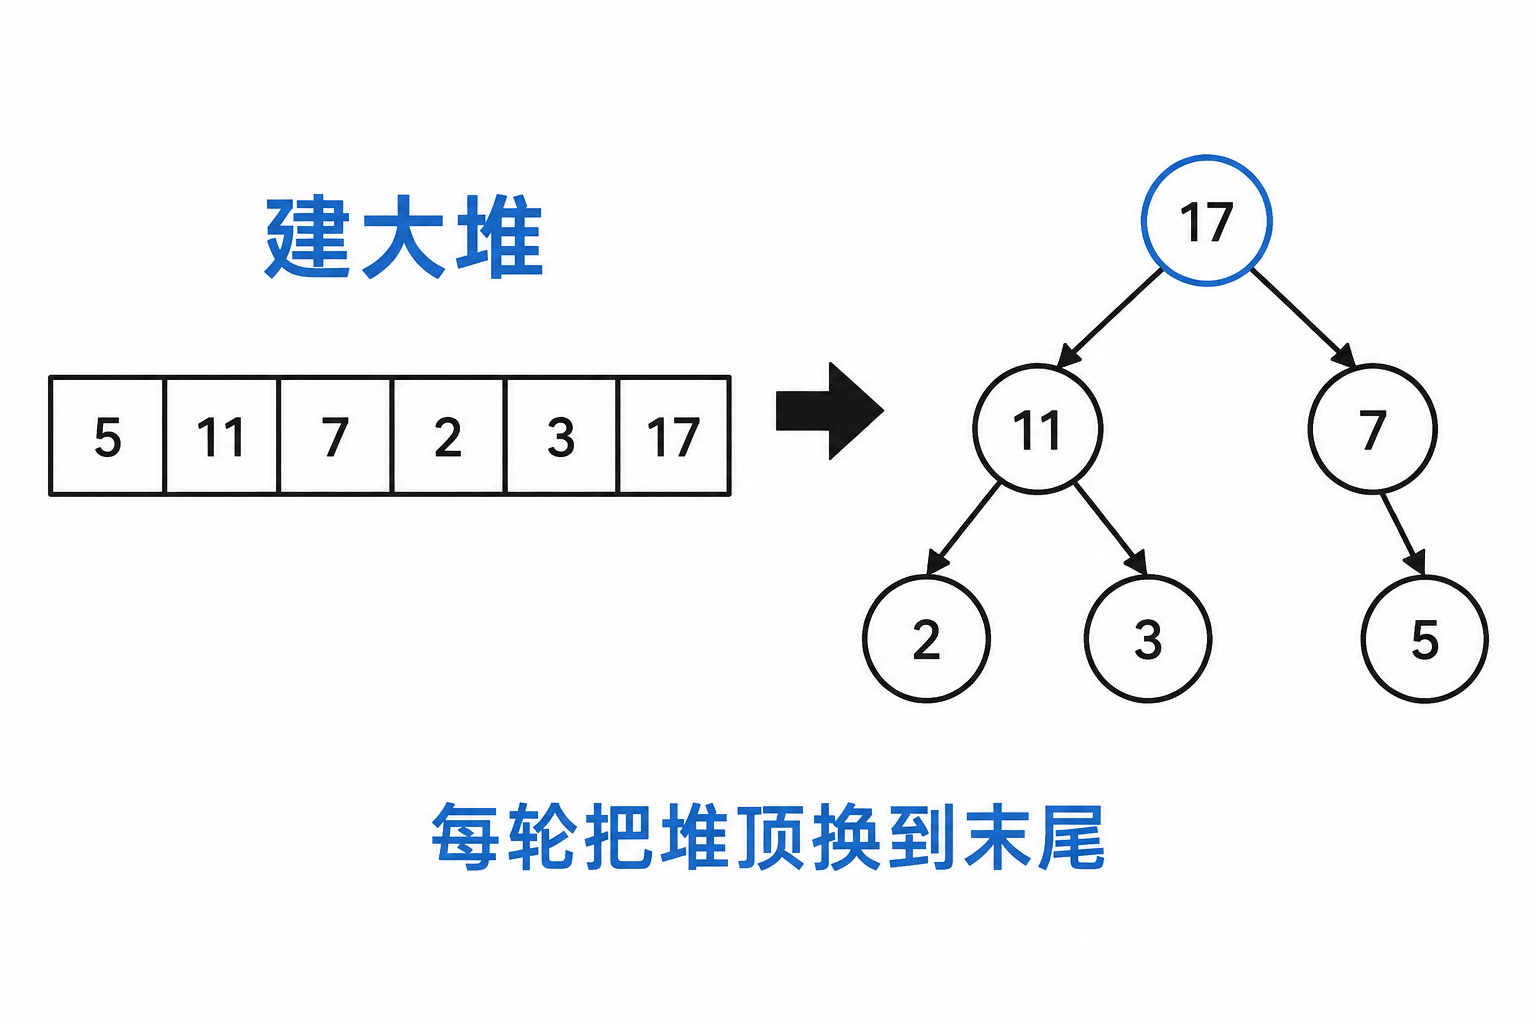
图 1 堆排序的两步
代码。
c
# 文件:/home/cocatrice/ds11/p01_heap_sort.c
static void HeapSort(int* arr, int n)
{
	int i;
	for (i = n / 2 - 1; i >= 0; i--)      /* 建大堆 */
	{
		AdjustDownBig(arr, n, i);
	}
	for (i = n - 1; i > 0; i--)           /* 反复换堆顶到末尾 */
	{
		SwapInt(&arr[0], &arr[i]);
		AdjustDownBig(arr, i, 0);         /* 范围是 i,不是 n */
	}
}
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p01_heap_sort
小例子:
排序前      5 11 7 2 3 17
排序后      2 3 5 7 11 17
升序了吗:是

边界:
  单个元素:42
  两个元素:1 2
  全部相同:7 7 7 7
  已经升序: 1 2 3 4 5
  完全降序: 1 2 3 4 5

两百万个随机整数,和 qsort 对照:
  堆排序 271.626 毫秒
  qsort  266.149 毫秒
  结果一致:是
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 单个元素 | 原样返回 | 建堆循环从 -1 开始,一次都不调 |
| 两个元素 | 比较一次 | 堆里只有根和一个叶子 |
| 全部相同 7 7 7 7 | 不变 | 每次比较都取等号,不交换 |
| 已经升序 1 2 3 4 5 | 不变 | 本来就是大堆,建堆阶段零交换 |
| 完全降序 5 4 3 2 1 | 排成升序 | 建堆阶段交换最多 |
复杂度。 时间是 O(N log N),空间是 O(1),排序本身不稳定。两百万个随机整数用时 271.626 毫秒,标准库 qsort 是 266.149 毫秒,差距在百分之二以内。
第二题 TOP-K(打底题)
题目:从一大段数据里找出最大的 K 个元素,数据量大到内存装不下时也要能用。
思路。 先取前 K 个元素建一个小堆,堆顶是这 K 个里最小的,用它当门槛:后面的元素比门槛大就替换掉堆顶,再做一次向下调整。全部读完,堆里剩下的就是最大的 K 个。时间是 O(N log K),额外空间只有 O(K),数据可以一个一个读,不需要一次性装进内存。
用例走一遍。 数据是 3、1、4、1、5、9、2、6,要最大的 3 个。
| 读到的元素 | 堆顶 | 比门槛大吗 | 动作 | 堆里的三个数 |
|---|---|---|---|---|
| 前三个 3、1、4 | 无 | 无 | 建小堆 | 1 3 4 |
| 1 | 1 | 不大于 | 跳过 | 1 3 4 |
| 5 | 1 | 大于 | 换掉堆顶 | 3 4 5 |
| 9 | 3 | 大于 | 换掉堆顶 | 4 5 9 |
| 2 | 4 | 不大于 | 跳过 | 4 5 9 |
| 6 | 4 | 大于 | 换掉堆顶 | 5 6 9 |
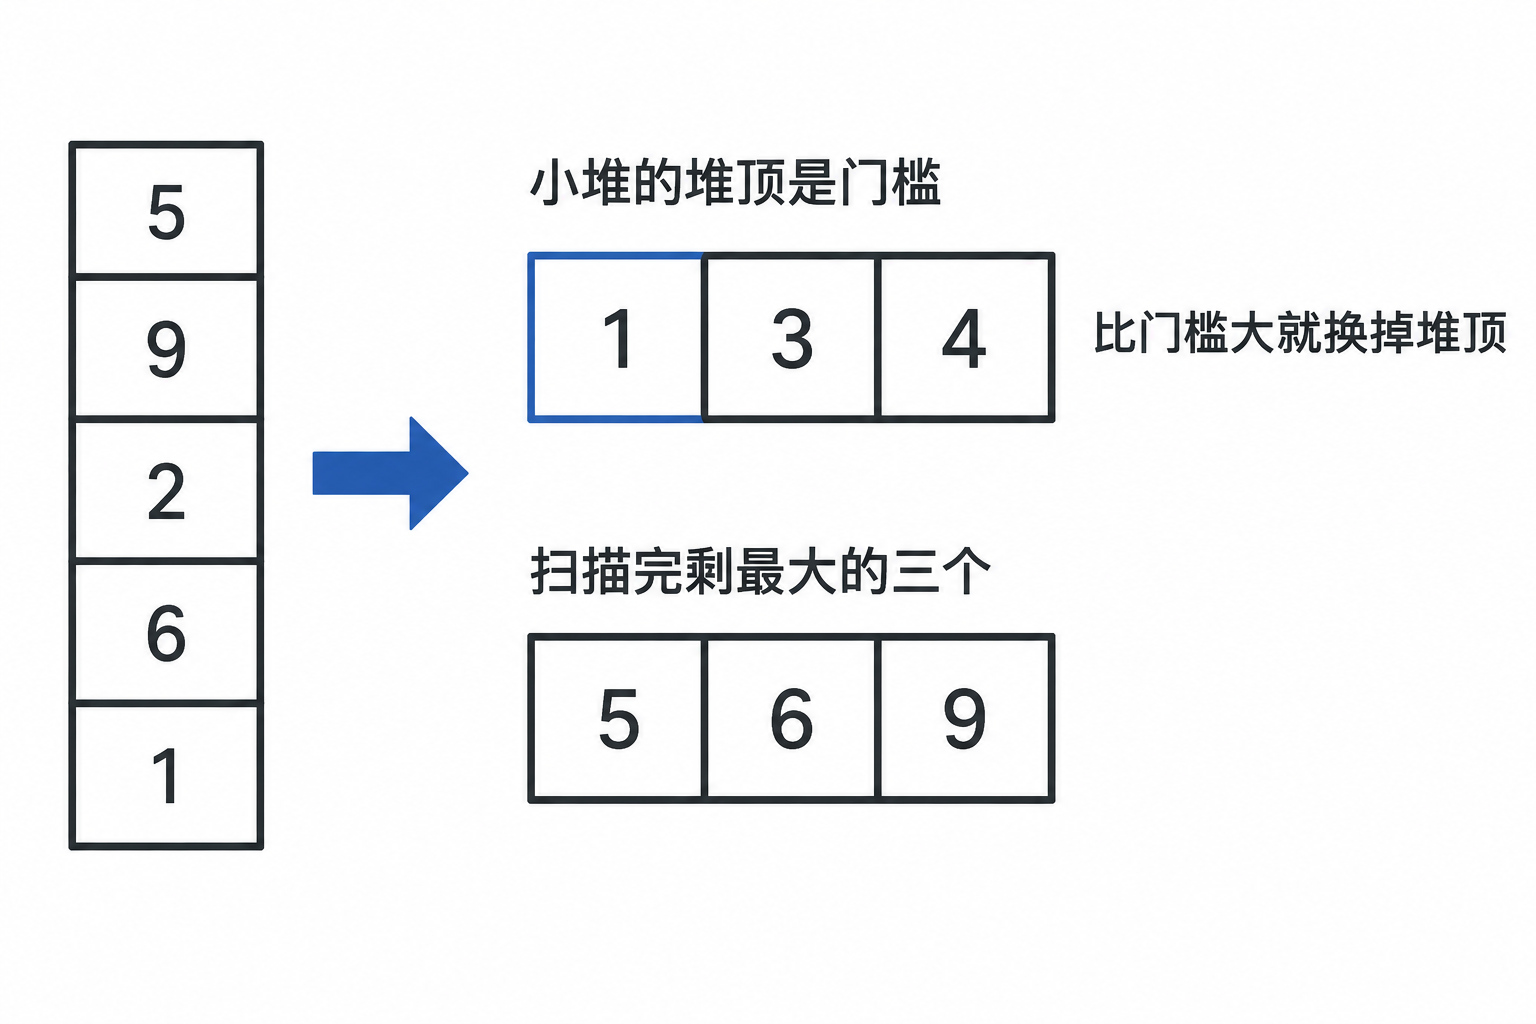
图 2 TOP-K 的小堆扫描
代码。
c
# 文件:/home/cocatrice/ds11/p02_topk.c
static void TopKByHeap(int* a, int n, int k, int* out)
{
	Heap hp;
	int i;
	HeapCreate(&hp, a, k, 0);          /* 前 k 个建小堆 */
	for (i = k; i < n; i++)
	{
		if (a[i] > HeapTop(&hp))       /* 比门槛大才动堆 */
		{
			HeapPop(&hp);
			HeapPush(&hp, a[i]);
		}
	}
	for (i = 0; i < k; i++)            /* 把堆里的 k 个取出来 */
	{
		out[i] = HeapTop(&hp);
		HeapPop(&hp);
	}
	HeapDestroy(&hp);
	qsort(out, (size_t)k, sizeof(int), cmpInt);
}
代码里先弹出再压入,两步都是 O(log K),合起来仍然是一次调整的量级。想少做一次调整,也可以直接把堆顶覆盖掉再向下调整,代价是代码要多写几行。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p02_topk
小例子:从 3 1 4 1 5 9 2 6 里取最大的 3 个
  全排序后取: 5 6 9  小堆扫描: 5 6 9

边界:
  全部相同取前 2:5 5
  K 等于数组长度: 1 2 3 4 5
  K 等于 1:9

一百万个随机数取最大的 100 个:
  全部排序后取 132.486 毫秒
  小堆扫描     1.298 毫秒
  结果一致:是,快了 102 倍
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 全部相同的 5 5 5 5,K 取 2 | 5 5 | 每个元素都和门槛相等,一次替换都不发生 |
| K 等于数组长度 | 全部元素 | 堆装下所有数据,退化成全排序 |
| K 取 1 | 最大值 | 堆里只有一个元素,堆顶就是答案 |
| 一百万个随机数 | 快了 102 倍 | 全排序 132.486 毫秒,小堆 1.298 毫秒 |
复杂度。 时间是 O(N log K),空间是 O(K)。和全排序相比,K 越小优势越明显:这道题里 K 是 100,N 是一百万,log K 大约是 7,而 log N 大约是 20,所以小堆那一列的耗时只有全排序的百分之一左右。
第三题 数组中的第 K 个最大元素(215)
题目:给一个整数数组和一个整数 k,返回数组里第 k 个最大的元素。注意是排序后的第 k 个,不是第 k 个不同的元素。
原题链接: leetcode 215 数组中的第 K 个最大元素
思路。 常见的做法有三种,代价各不相同:最直接的是全部排序取倒数第 k 个,O(N log N);用小堆维护 k 个候选,堆顶就是第 k 大,O(N log K);还有一种是快选,按基准把数组划分成两半,只往目标所在的那一半递归,平均 O(N),最坏 O(N²)。
小堆的做法和 TOP-K 是同一个动作,区别只在最后一步:TOP-K 要把 K 个都取出来,这道题只要读一次堆顶。快选的优势在 K 接近 N 的时候,小堆的优势在 K 很小的时候,实测中两者差了一个数量级。
用例走一遍。 数组 3、2、1、5、6、4,k 取 2,用小堆做。
| 读到的元素 | 堆顶(门槛) | 比门槛大吗 | 动作 | 堆里的两个数 |
|---|---|---|---|---|
| 前两个 3、2 | 无 | 无 | 建小堆 | 2 3 |
| 1 | 2 | 不大于 | 跳过 | 2 3 |
| 5 | 2 | 大于 | 换掉堆顶 | 3 5 |
| 6 | 3 | 大于 | 换掉堆顶 | 5 6 |
| 4 | 5 | 不大于 | 跳过 | 5 6 |
五步之后堆里的两个数是 5 和 6,堆顶 5 就是数组里第 2 大的元素。
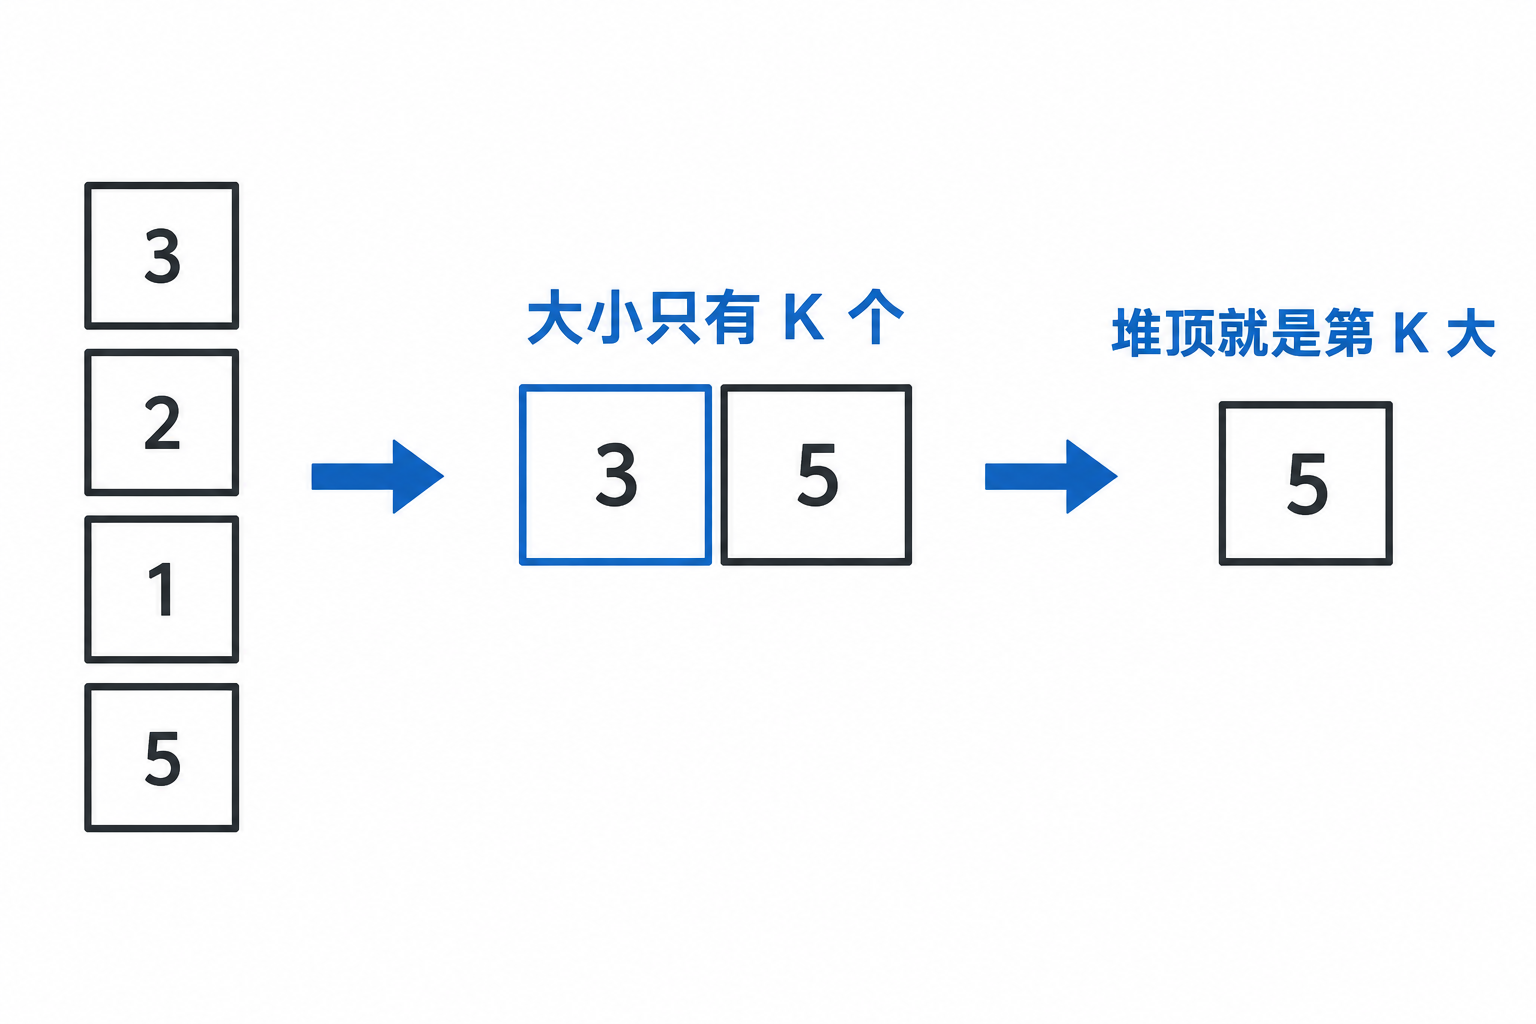
图 3 第 K 大的候选堆
代码。
c
# 文件:/home/cocatrice/ds11/p03_kth_largest.c
static int ByHeap(int* nums, int n, int k)
{
	Heap hp;
	int i;
	int ans;
	HeapCreate(&hp, nums, k, 0);
	for (i = k; i < n; i++)
	{
		if (nums[i] > HeapTop(&hp))
		{
			HeapPop(&hp);
			HeapPush(&hp, nums[i]);
		}
	}
	ans = HeapTop(&hp);
	HeapDestroy(&hp);
	return ans;
}
快选那一边的边界要小心:目标下标是从小到大数的 n - k,划分函数返回的位置要和它比较,返回值偏小就往右半边接着找,偏大就往左半边找,相等说明答案已经落在这个位置上。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p03_kth_largest
题目给的例子:
3 2 1 5 6 4,k=2          第 2 大 = 5        排序 5 / 小堆 5 / 快选 5  三种一致
3 2 3 1 2 4 5 5 6,k=4    第 4 大 = 4        排序 4 / 小堆 4 / 快选 4  三种一致

边界值:
只有一个元素,k=1   第 1 大 = 7        排序 7 / 小堆 7 / 快选 7  三种一致
全部相同,k=2         第 2 大 = 4        排序 4 / 小堆 4 / 快选 4  三种一致
升序,k=1(最大)   第 1 大 = 5        排序 5 / 小堆 5 / 快选 5  三种一致
升序,k=5(最小)   第 5 大 = 1        排序 1 / 小堆 1 / 快选 1  三种一致
降序,k=1(最大)   第 1 大 = 5        排序 5 / 小堆 5 / 快选 5  三种一致
降序,k=5(最小)   第 5 大 = 1        排序 1 / 小堆 1 / 快选 1  三种一致

随机数据核对:
  500 组随机数据,三种做法不一致 0 组

两百万个随机数取第 100 大,三种做法计时:
  全排序   278.175 毫秒
  小堆     2.937 毫秒
  快选     21.096 毫秒
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 只有一个元素,k 取 1 | 该元素 | 三种做法都给 7 |
| 全部相同 4 4 4 4,k 取 2 | 4 | 比较全部取等号 |
| 升序数组,k 取 1 | 最大值 | 第 1 大就是最后一个元素 |
| 升序数组,k 取 n | 最小值 | 第 n 大就是第一个元素 |
| 降序数组,k 取 1 和 n | 一头一尾 | 反过来同理 |
| 500 组随机数据 | 三种做法结果完全一致 | 不一致 0 组 |
复杂度。 小堆是 O(N log K),快选平均 O(N)、最坏 O(N²),全排序是 O(N log N)。两百万个数据取第 100 大:小堆 2.937 毫秒,快选 21.096 毫秒,全排序 278.175 毫秒。K 小的时候小堆明显更快,因为它的代价只和 K 有关。
第四题 前 K 个高频元素(347)
题目:给一个整数数组和一个整数 k,返回出现频率前 k 高的元素,顺序不限。
原题链接: leetcode 347 前 K 个高频元素
思路。 解题分成两段:先数出每个元素出现了几次,再按次数取前 k 个。计数用哈希表,取前 k 个用小堆,堆里存的是「元素加次数」这一对,比较时按次数比。总的时间复杂度是 O(N log k)。
把去重结果直接排序同样可以做出答案,复杂度 O(N log N),在这道题的数据范围下两种做法都能通过。小堆的优势仍然体现在数据量大、k 小的时候:排序要对所有去重结果排一遍,小堆只维护 k 个候选。
用例走一遍。 数组 1、1、1、2、2、3,k 取 2。
| 元素 | 出现次数 | 小堆里的候选(按次数) |
|---|---|---|
| 1 | 3 | 1 次 3 |
| 2 | 2 | 1 次 3、2 次 2 |
| 3 | 1 | 堆顶是次数 2 的那个,1 不大于 2,跳过 |
| 结果 | 1(3 次)和 2(2 次) |
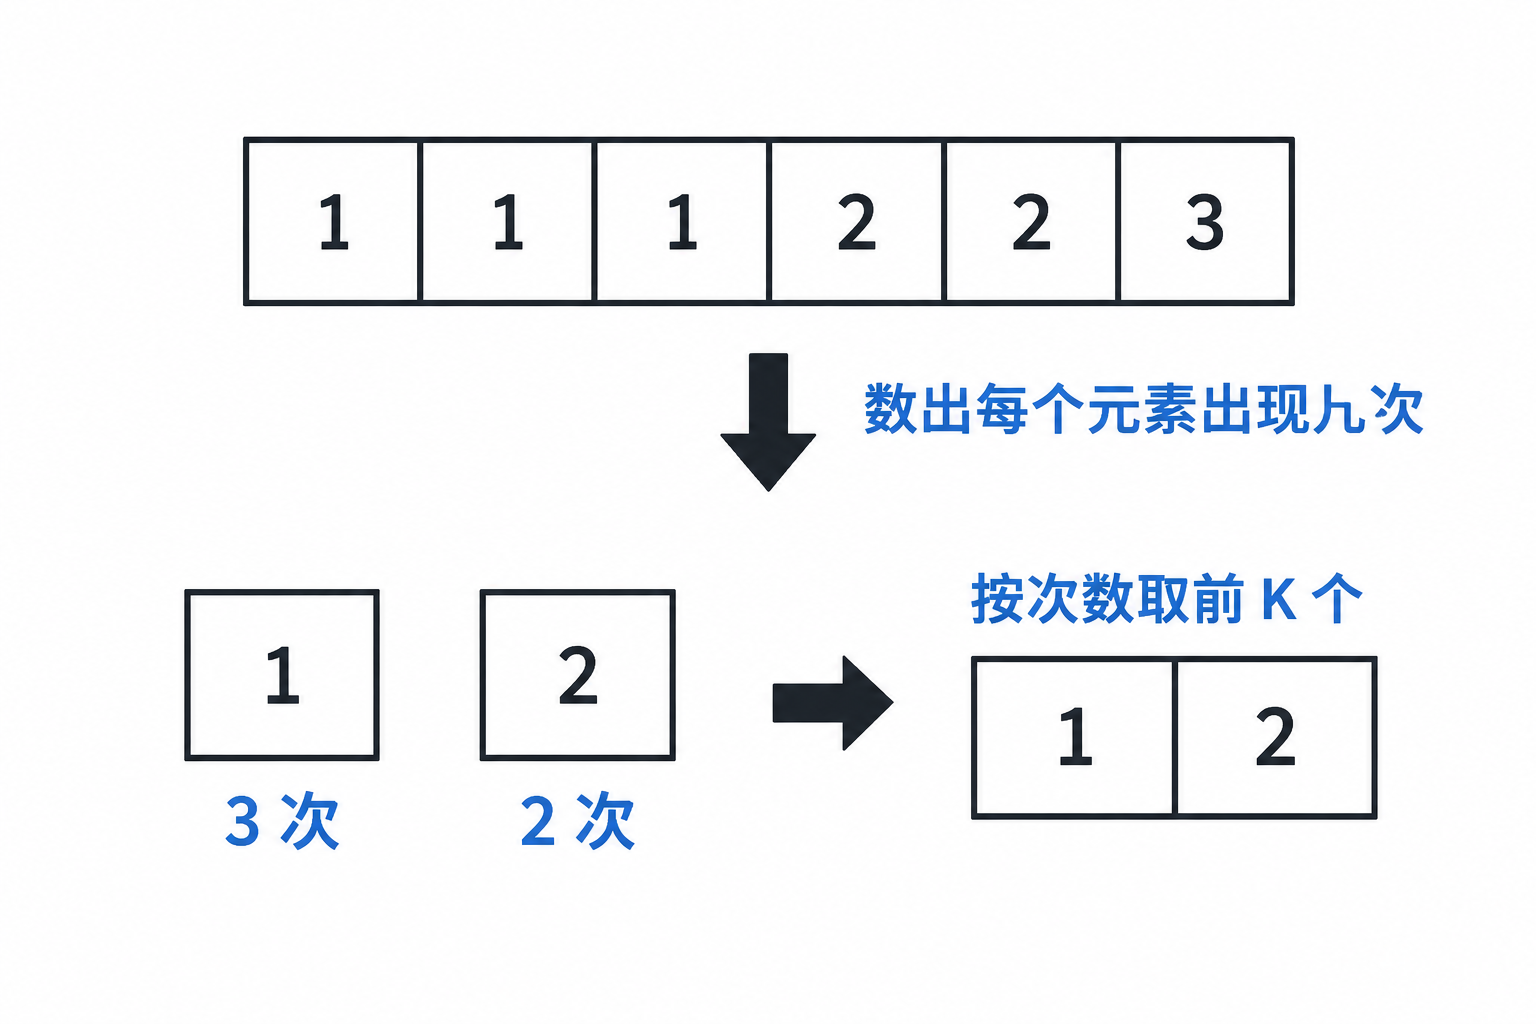
图 4 先数频率再取前 K
代码。
c
# 文件:/home/cocatrice/ds11/p04_top_k_frequent.c
for (i = 0; i < distinct; i++)
{
	if (size < k)
	{
		heapArr[size] = items[i];
		size++;
		AdjustUp(heapArr, size - 1);
	}
	else if (items[i].count > heapArr[0].count ||
		(items[i].count == heapArr[0].count && items[i].value < heapArr[0].value))
	{
		heapArr[0] = items[i];
		AdjustDown(heapArr, size, 0);
	}
}
代码里特意加上了后面那个条件:次数相同时按元素值定先后。题目写着顺序不限,不加这一句同样能通过,只是同一批数据在不同写法下会排出不同的顺序,排查问题时容易被当成逻辑错误。写这类顺序不限的题,把输出顺序固定下来更稳妥。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p04_top_k_frequent
题目给的例子:
1 1 1 2 2 3 取前 2           k=2
  小堆         1 2
  排序对照   1 2
  一致:是

边界值:
只有一个元素             k=1        小堆 1        对照 1        一致:是
两个不同元素,k=2       k=2        小堆 1 2      对照 1 2      一致:是
两个元素次数差很多,k=1 k=1        小堆 4        对照 4        一致:是
三个元素次数相同,k=2 k=2        小堆 1 2      对照 1 2      一致:是
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 只有一个元素 | 该元素 | 去重结果只有一个 |
| 两个不同元素,k 取 2 | 两个都返回 | k 等于去重后的个数 |
| 次数差很多,k 取 1 | 次数最多的那个 | 4 出现四次,5 出现两次 |
| 三个元素次数相同,k 取 2 | 任意两个都对 | 规范化之后按值排序取前两个 |
复杂度。 时间 O(N + D log k),D 是不同元素的个数,哈希计数是 O(N),小堆是 O(D log k);空间 O(D + k)。
第五题 数据流中的第 K 大元素(703)
题目:设计一个类,初始化时给定 k 和一段初始数据,之后每次调用 add(val) 往数据流里加入一个数,返回当前数据流里第 k 大的元素。
原题链接: leetcode 703 数据流中的第 K 大元素
思路。 数据流一直在变,每次调用都要给出第 k 大,用一个小堆维护 k 个元素正好合适:堆里装当前最大的 k 个,堆顶是这 k 个里最小的,也就是第 k 大。新元素进来先入堆,堆的大小超过 k 就把堆顶弹掉。堆的大小始终不超过 k,所以每次操作是 O(log k)。
初始化的那一段也要做同样的限制:把初始数据逐个入堆,超过 k 个就弹掉堆顶,这样初始数据再多,堆里也只保留最大的 k 个,空间是 O(k)。
用例走一遍。 k 取 3,初始数据是 4、5、8、2,五次调用里堆的内容变化如下。
| 调用 | 动作 | 堆里的元素 | 返回 |
|---|---|---|---|
| 初始化 | 4、5、8、2 依次入堆,超过 3 个就弹堆顶 | 4 5 8 | 无 |
| add(3) | 3 入堆,堆里有 4 个,弹掉堆顶 3 | 4 5 8 | 4 |
| add(5) | 5 入堆,弹掉堆顶 4 | 5 5 8 | 5 |
| add(10) | 10 入堆,弹掉堆顶 5 | 5 8 10 | 5 |
| add(9) | 9 入堆,弹掉堆顶 5 | 8 9 10 | 8 |
| add(4) | 4 入堆,弹掉堆顶 4 | 8 9 10 | 8 |
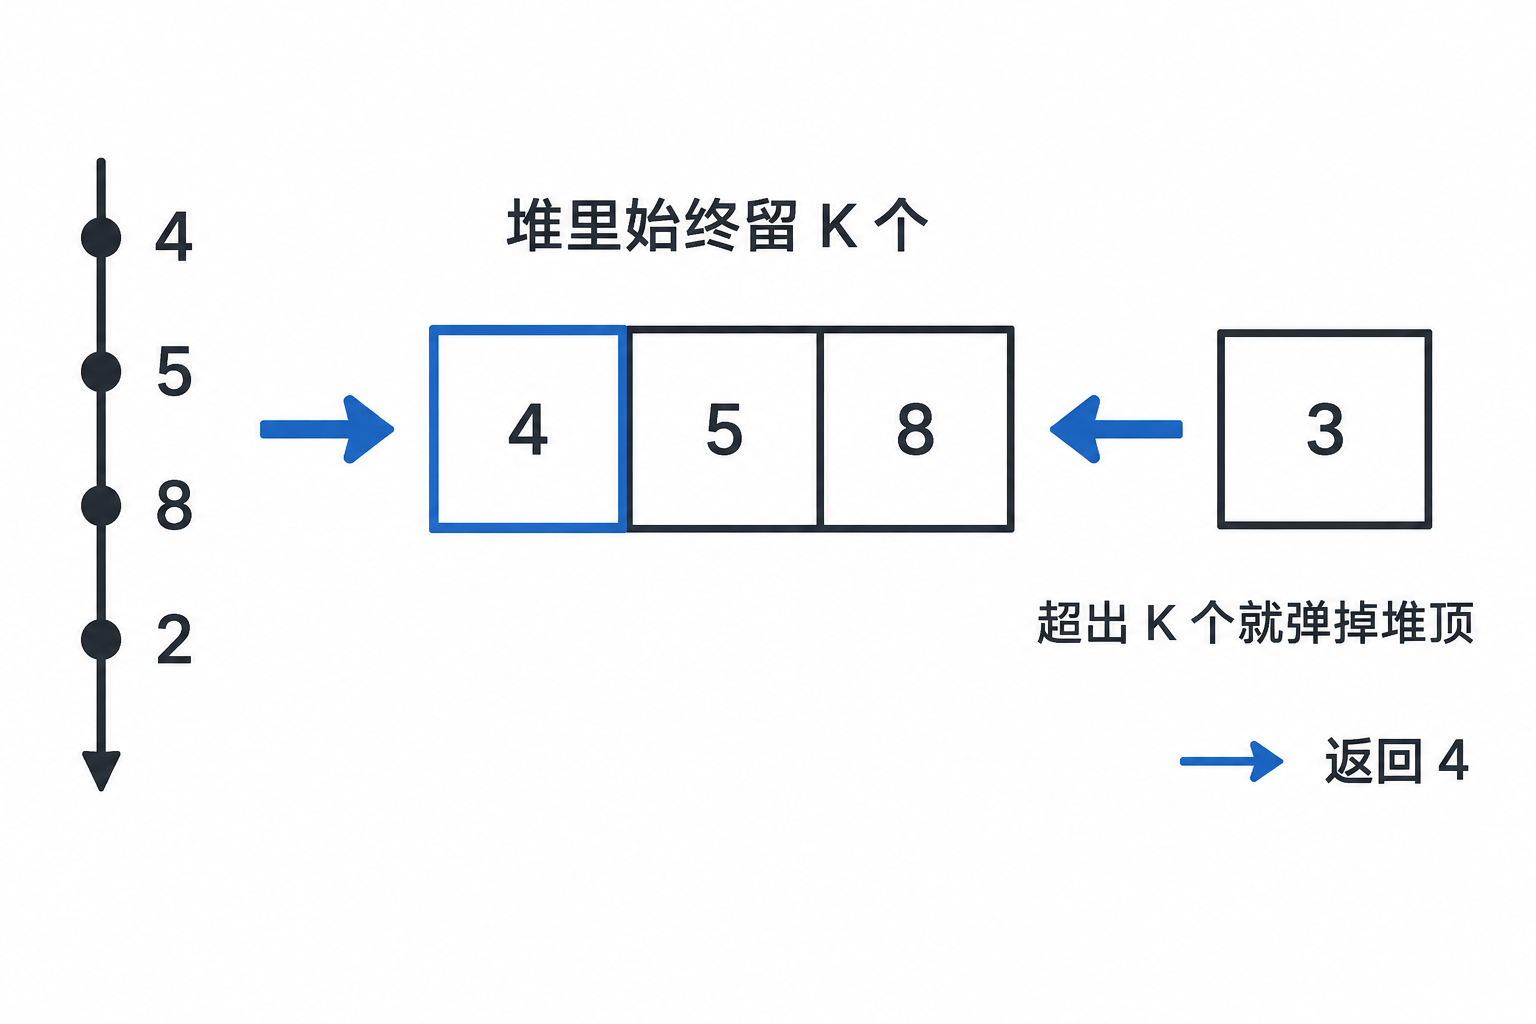
图 5 数据流里固定大小的堆
代码。
c
# 文件:/home/cocatrice/ds11/p05_kth_largest_stream.c
static int KthLargestAdd(KthLargest* obj, int val)
{
	HeapPush(&obj->hp, val);
	if (HeapSize(&obj->hp) > obj->k)
	{
		HeapPop(&obj->hp);         /* 超出 k 个就把最小的弹掉 */
	}
	return HeapTop(&obj->hp);      /* 堆顶就是第 k 大 */
}
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p05_kth_largest_stream
题目给的例子:k=3,初始数据 4 5 8 2
  加入 3   返回 4   期望 4   一致
  加入 5   返回 5   期望 5   一致
  加入 10  返回 5   期望 5   一致
  加入 9   返回 8   期望 8   一致
  加入 4   返回 8   期望 8   一致
  全部一致:是

边界:
  初始数据为空,k=1,加 5:
    返回 5
    再加 -3:返回 5
    再加 9:返回 9
  初始数据全是 5,k=2:
    加 5 返回 5
    加 1 返回 5
  k 等于 1 时退化成求最大值:
    加 50 返回 100
    加 200 返回 200
    加 1 返回 200
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 初始数据为空,k 取 1 | 每次返回当前最大值 | 堆里只有一个元素 |
| 初始数据全相同,k 取 2 | 一直返回 5 | 加 1 之后 1 被弹掉 |
| k 取 1 | 退化成求最大值 | 加 50 时堆里是 100 和 50,弹掉 50 |
| 加负数 | 不影响 | 比较关系对负数一样成立 |
复杂度。 每次 add 要做一次入堆和至多一次出堆,代价是 O(log k);初始化要处理 n 个数据,代价是 O(n log k);两个阶段堆里都不超过 k 个元素,空间是 O(k)。
第六题 最后一块石头的重量(1046)
题目:给一堆石头的重量,每次挑两块最重的互相撞。两块一样重就都碎掉,不一样重就留下较轻的那块(重量为两者之差)。重复到只剩一块或者没有石头,返回最后剩下的重量,没有就返回 0。
原题链接: leetcode 1046 最后一块石头的重量
思路。 每次都要挑两块最重的,正好是大堆的用法:连续取两次堆顶,算出差值,差值不为零就把它放回堆里。堆里只剩一块石头或者一块都不剩时循环结束。每块石头进出堆的次数是个常数,整体的时间是 O(N log N)。
另一种做法是每一轮把数组重新排序再取最后两个,结果同样正确,代价是 O(N² log N) 级别的重复排序。
用例走一遍。 石头的重量依次是 2、7、4、1、8、1,每一轮取两块最重的相撞。
| 轮次 | 取出的两块 | 差值 | 放回堆里 | 剩下的石头 |
|---|---|---|---|---|
| 1 | 8 和 7 | 1 | 1 | 2 4 1 1 1 |
| 2 | 4 和 2 | 2 | 2 | 1 1 1 2 |
| 3 | 2 和 1 | 1 | 1 | 1 1 1 |
| 4 | 1 和 1 | 0 | 不放 | 1 |
| 结束 | 1 |
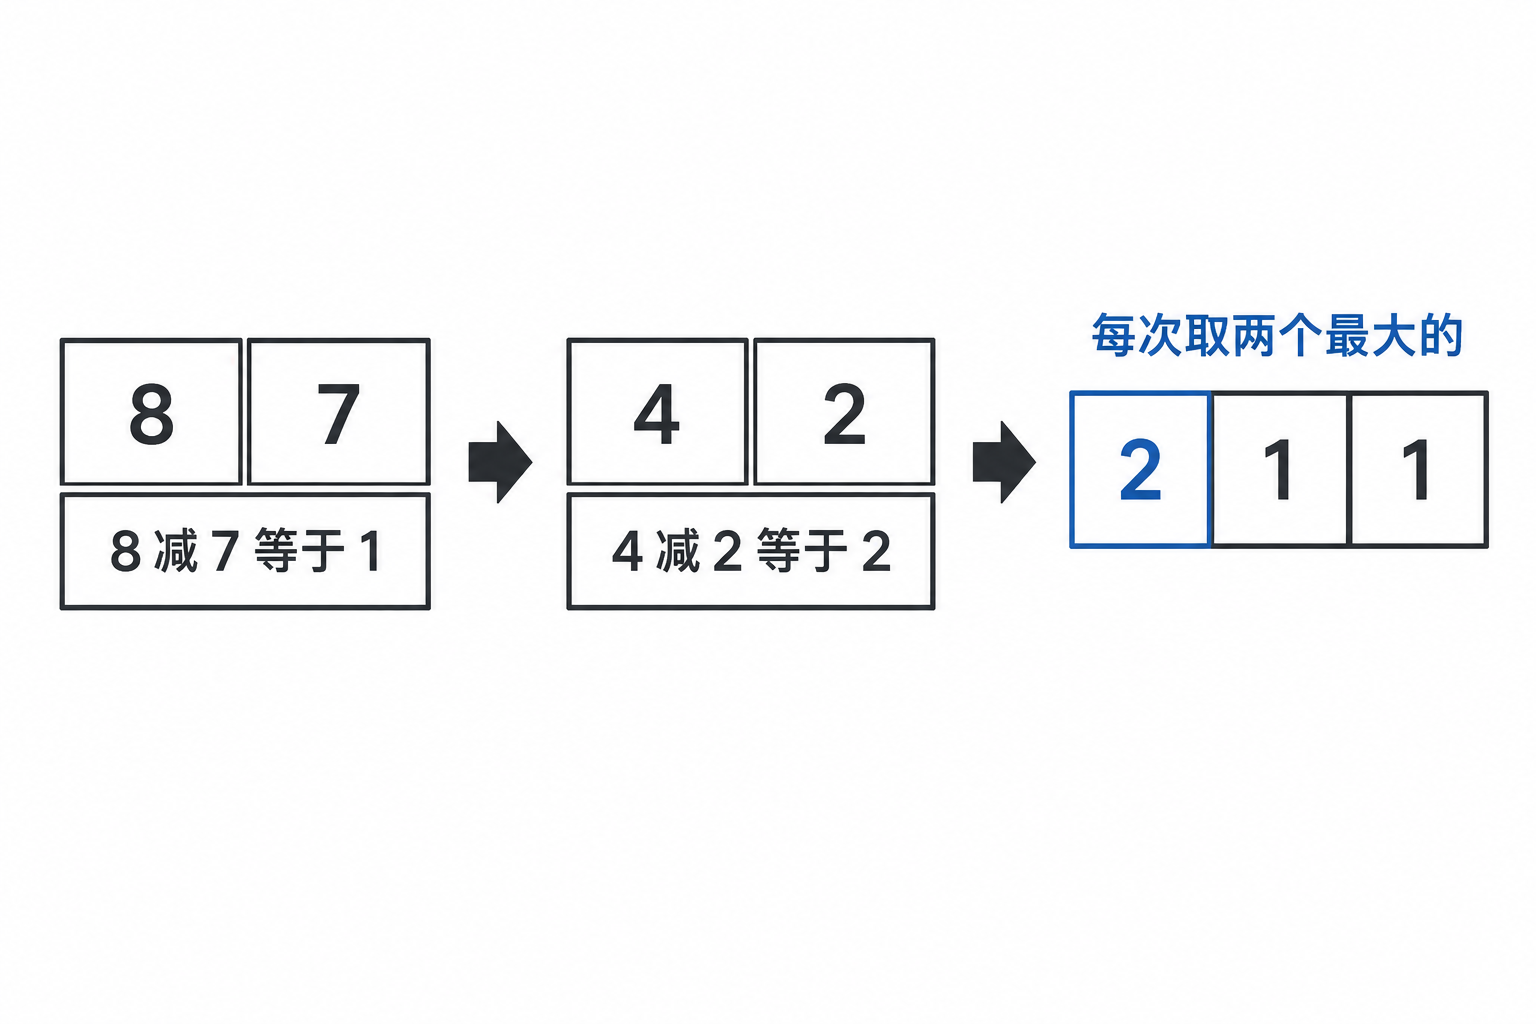
图 6 大堆模拟撞石头
代码。
c
# 文件:/home/cocatrice/ds11/p06_last_stone_weight.c
static int LastStoneWeight(int* stones, int n)
{
	Heap hp;
	int a, b;
	HeapCreate(&hp, stones, n, 1);        /* 大堆 */
	while (HeapSize(&hp) > 1)
	{
		a = HeapTop(&hp);
		HeapPop(&hp);
		b = HeapTop(&hp);
		HeapPop(&hp);
		if (a != b)
		{
			HeapPush(&hp, a - b);         /* 差值不为零才放回去 */
		}
	}
	if (HeapEmpty(&hp))
	{
		HeapDestroy(&hp);
		return 0;                          /* 全碎光了 */
	}
	b = HeapTop(&hp);
	HeapDestroy(&hp);
	return b;
}
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p06_last_stone_weight
题目给的例子:
2 7 4 1 8 1                    大堆 = 1    排序对照 = 1    一致

边界值:
只有一块石头             大堆 = 1    排序对照 = 1    一致
两块一样重,全部碎掉 大堆 = 0    排序对照 = 0    一致
两块不一样重             大堆 = 2    排序对照 = 2    一致
3 7 2                          大堆 = 2    排序对照 = 2    一致
7 6 5 4 3 2 1                  大堆 = 0    排序对照 = 0    一致

数据核对:
  300 组随机数据,不一致 0 组
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 只有一块石头 | 原样返回 | 循环一次都不进 |
| 两块一样重 | 0 | 两块都碎掉,堆空 |
| 两块不一样重 | 差值 | 1 和 3 撞完剩 2 |
| 3 7 2 | 2 | 7 和 3 撞剩 4,4 和 2 撞剩 2 |
| 7 6 5 4 3 2 1 | 0 | 最后一块也碎掉 |
| 300 组随机数据 | 两种做法结果完全一致 | 不一致 0 组 |
复杂度。 时间是 O(N log N),每一轮要做两次出堆和至多一次入堆;空间是 O(N)。
第七题 合并 K 个升序链表(23)
题目:给一个链表数组,每个链表都已经按升序排好,把它们合并成一个升序链表。
原题链接: leetcode 23 合并 K 个升序链表
思路。 直接的做法是每一轮从 K 个链表头里挑出最小的一个接到结果后面,挑一次要比较 K 次,一共 N 个结点,复杂度是 O(NK),K 大的时候这个代价会很明显。
改用小堆存这 K 个链表头,每次取堆顶只要 O(log K),取出之后把它后面的那个结点补进堆里,总的时间复杂度是 O(N log K)。堆里存的类型从整数换成了结点指针,比较的是结点里的值。
用例走一遍。 三条链表分别是 1→4→5、1→3→4、2→6。
| 步 | 堆里的结点值 | 取出的 | 补进堆的 | 结果链表 |
|---|---|---|---|---|
| 初始 | 1 1 2 | |||
| 1 | 1 2 4 | 1(第一条链的头) | 4 | 1 |
| 2 | 1 3 4 | 1(第二条链的头) | 3 | 1 1 |
| 3 | 3 4 6 | 2(第三条链的头) | 6 | 1 1 2 |
| 4 | 4 4 6 | 3 | 4 | 1 1 2 3 |
| 5 | 4 5 6 | 4 | 5 | 1 1 2 3 4 |
| 6 | 5 6 | 4 | 无 | 1 1 2 3 4 4 |
| 7 | 空 | 5 | 无 | 1 1 2 3 4 4 5 |
| 8 | 空 | 6 | 无 | 1 1 2 3 4 4 5 6 |
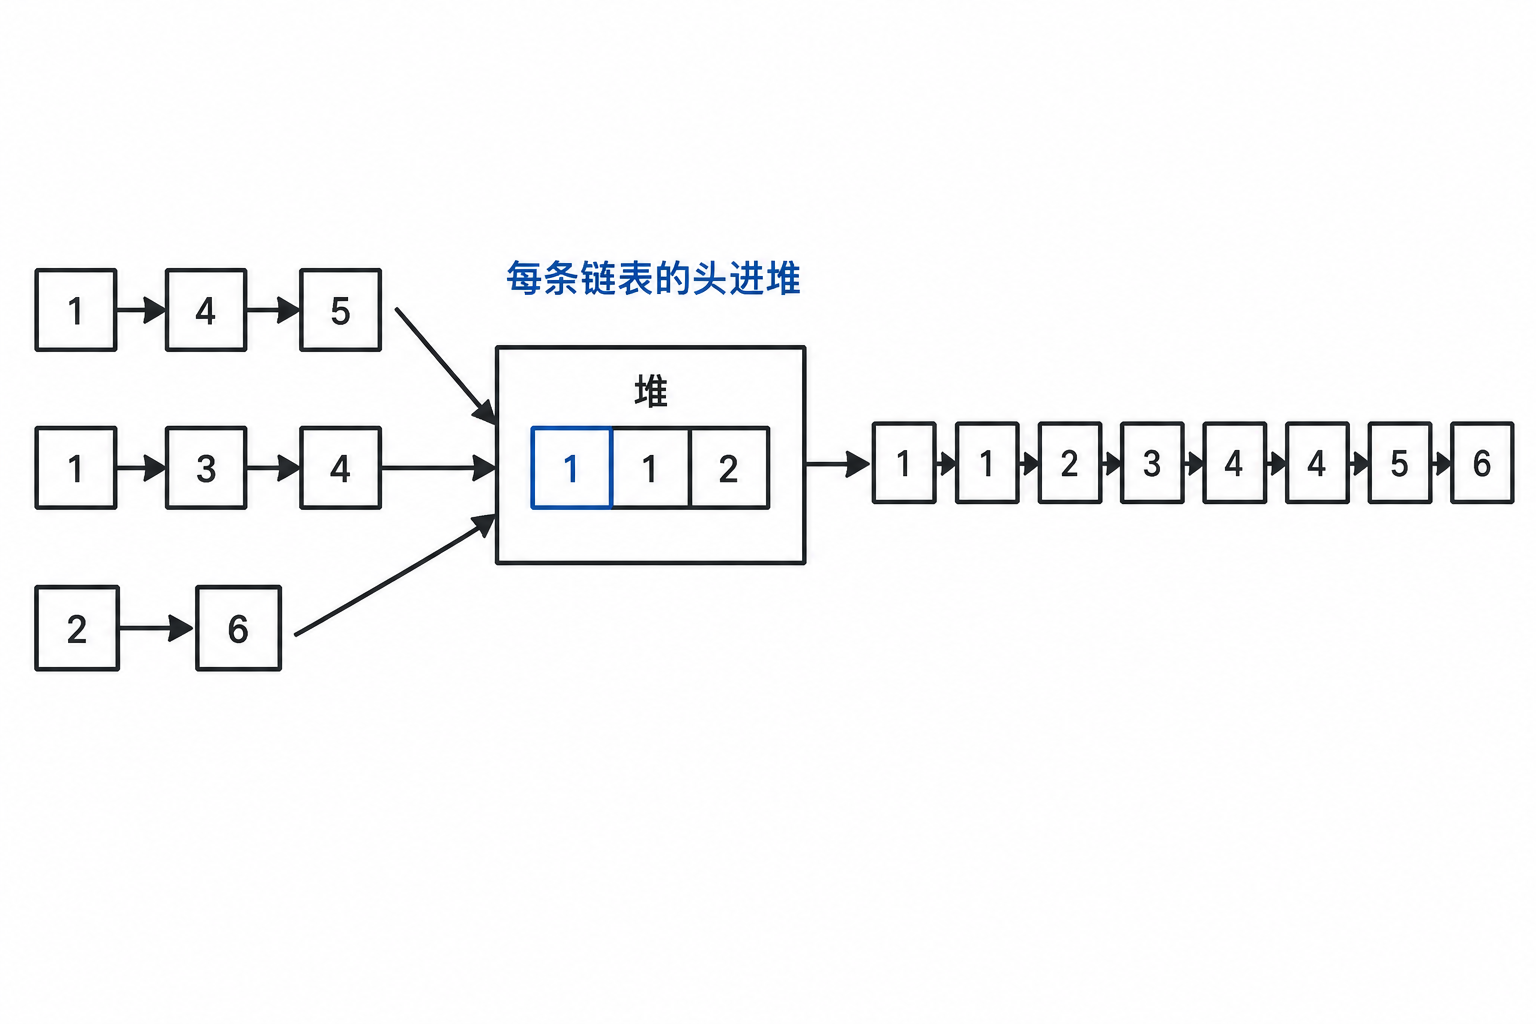
图 7 多路归并里的堆
代码。
c
# 文件:/home/cocatrice/ds11/p07_merge_k_lists.c
static ListNode* MergeKLists(ListNode** lists, int k)
{
	ListNode dummy;
	ListNode* tail = &dummy;
	int i;

	dummy.next = NULL;
	heapSize = 0;
	for (i = 0; i < k; i++)
	{
		if (lists[i] != NULL)          /* 空链表不进堆 */
		{
			Push(lists[i]);
		}
	}
	while (heapSize > 0)
	{
		ListNode* p = Pop();
		tail->next = p;
		tail = p;
		if (p->next != NULL)
		{
			Push(p->next);             /* 取走之后补下一个 */
		}
	}
	tail->next = NULL;
	return dummy.next;
}
用一个哑结点当结果链表的头,可以省掉「第一个结点要单独判断」的分支。空链表不入堆这一句同样不能省:空指针进了堆,弹出来之后取 next 就会崩溃。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p07_merge_k_lists
题目给的例子:
  输入:1->4->5,1->3->4,2->6
  输出:1 -> 1 -> 2 -> 3 -> 4 -> 4 -> 5 -> 6
  有序:是

边界值:
  三个空链表:(空链表)
  一个空链表:(空链表)
  只有一条链表:5 -> 6 -> 7
  一条空、一条非空:9
  四条各一个结点:0 -> 1 -> 2 -> 3
  有序:是
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 三个空链表 | 空链表 | 堆里一个元素都没有,循环不进 |
| 只有一个空链表 | 空链表 | 同样直接返回 |
| 只有一条链表 | 原样返回 | 堆里始终只有一个结点 |
| 一条空、一条非空 | 非空那条 | 空的那条不入堆 |
| 四条各一个结点 | 0 1 2 3 | 堆的初始状态就是全部结点 |
复杂度。 时间 O(N log K),N 是结点总数,每个结点入堆出堆各一次;空间 O(K),堆里最多放 K 个结点。
第八题 有序矩阵中第 K 小的元素(378)
题目:给一个 n 乘 n 的矩阵,每行每列都按升序排列,返回矩阵中第 k 小的元素。注意是排序后的第 k 个,不是第 k 个不同的元素。
原题链接: leetcode 378 有序矩阵中第 K 小的元素
思路。 第一种做法是多路归并:每一行都是升序的,把每一行的第一个元素放进小堆,取走堆顶之后从同一行补下一个。取 k 次,每次 O(log n),总共 O(k log n)。
第二种做法是值域二分:猜一个数 mid,数出矩阵里不大于 mid 的元素有几个。计数利用行列都有序这个性质,从右上角出发,往左走数值变小、往下走数值变大,O(n) 就能数完。如果个数小于 k,说明 mid 偏小,答案在右半边;否则答案在左半边或者就是 mid 本身。二分作用在数值上,与下标无关,循环次数是 log(值域)。
两种做法一个按元素逼近,一个按值域逼近,在合法的输入上给出的答案必须相同,两边对不上就说明其中一边的实现有问题。
用例走一遍。 矩阵是 1、5、9 / 10、11、13 / 12、13、15,k 取 8,用多路归并。
| 取出的次序 | 取出的值 | 来自哪一行 | 补进堆的值 |
|---|---|---|---|
| 1 | 1 | 第 0 行 | 5 |
| 2 | 5 | 第 0 行 | 9 |
| 3 | 9 | 第 0 行 | 无(这行取完了) |
| 4 | 10 | 第 1 行 | 11 |
| 5 | 11 | 第 1 行 | 13 |
| 6 | 12 | 第 2 行 | 13 |
| 7 | 13 | 第 1 行 | 无 |
| 8 | 13 | 第 2 行 | 15 |
第 8 个取出来的是 13,答案就是 13。
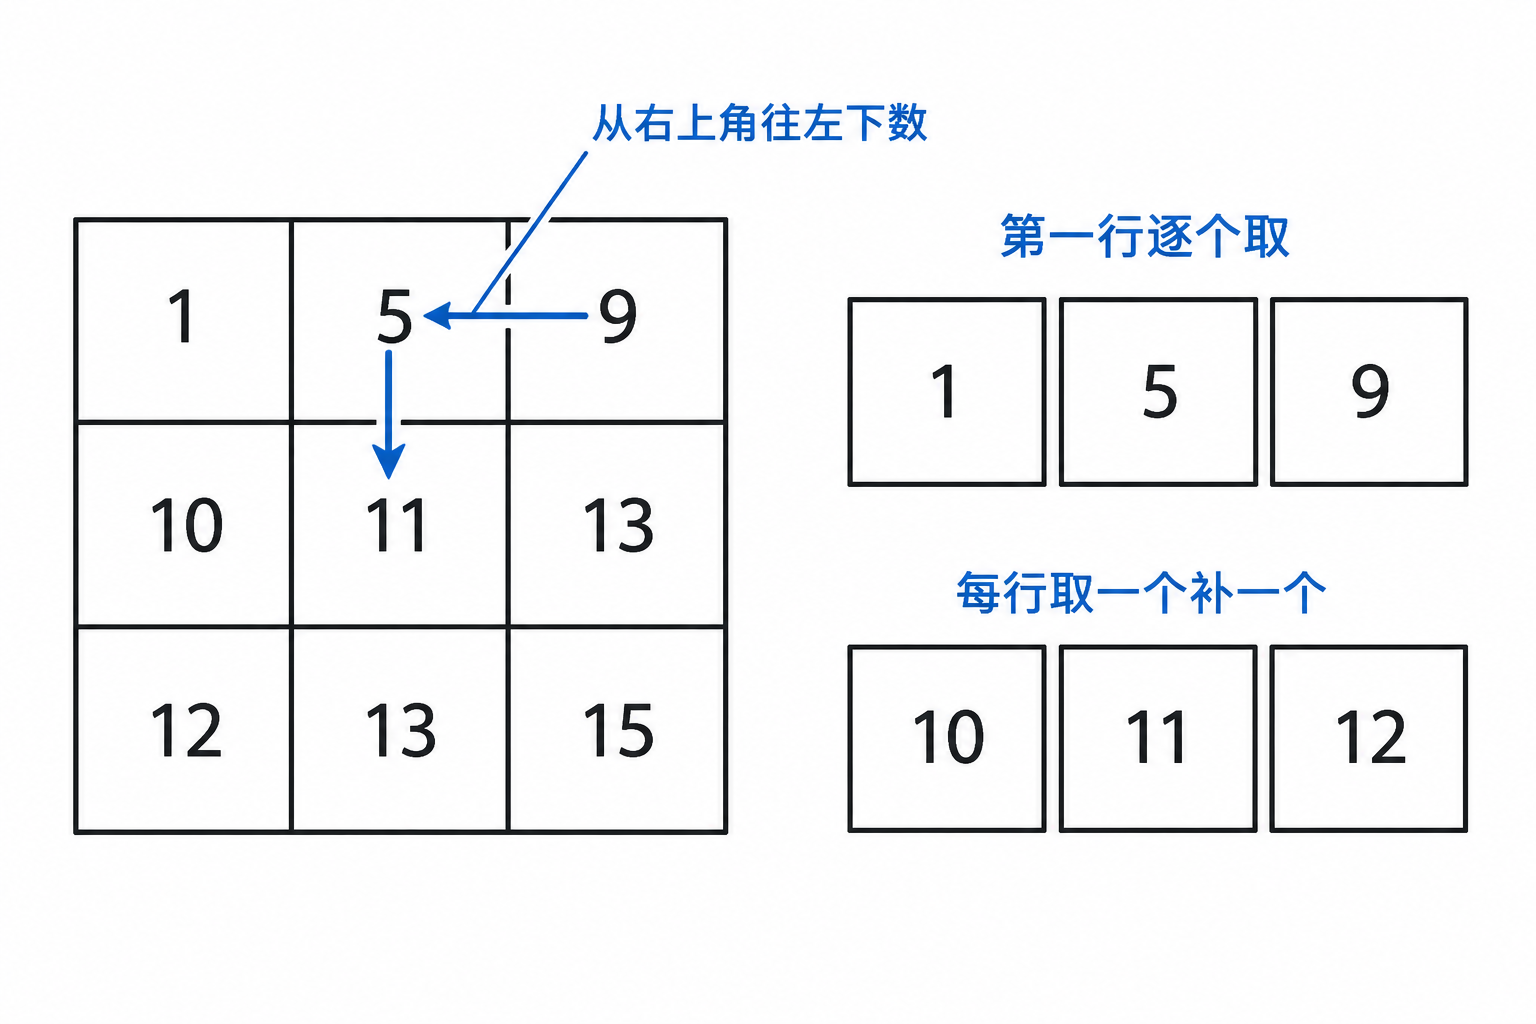
图 8 有序矩阵的两种数法
代码。
c
# 文件:/home/cocatrice/ds11/p08_kth_smallest_matrix.c
// 数一数矩阵里不大于 mid 的元素有多少个:从右上角往左下角走
static int CountLessEqual(int** matrix, int n, int mid)
{
	int count = 0;
	int row = 0;
	int col = n - 1;
	while (row < n && col >= 0)
	{
		if (matrix[row][col] <= mid)
		{
			count += col + 1;      /* 这一行从 0 到 col 都不大于 mid */
			row++;
		}
		else
		{
			col--;                 /* 这一格太大,往左走 */
		}
	}
	return count;
}
从右上角出发是关键:这个位置处在本行最大、本列最小的交界处,当前元素大于 mid 就往左走,不大于 mid 就往下走,每一步都能排除一整行或者一整列。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p08_kth_smallest_matrix
题目给的例子:
3x3 矩阵,k=8             第 8 小 = 13    小堆归并 13 / 值域二分 13  一致

边界值:
1x1 矩阵,k=1             第 1 小 = -5    小堆归并 -5 / 值域二分 -5  一致
3x3 矩阵,k=1(最小) 第 1 小 = 1     小堆归并 1 / 值域二分 1  一致
3x3 矩阵,k=9(最大) 第 9 小 = 15    小堆归并 15 / 值域二分 15  一致
3x3 全是 7,k=5           第 5 小 = 7     小堆归并 7 / 值域二分 7  一致
3x3 严格递增,k=4       第 4 小 = 4     小堆归并 4 / 值域二分 4  一致
值域跨度大,k=3        第 3 小 = 3     小堆归并 3 / 值域二分 3  一致

数据核对:
  200 组随机矩阵,两种做法不一致 0 组
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 1 乘 1 的矩阵,k 取 1 | 该元素 | 堆里只有一个元素 |
| k 取 1 | 矩阵最小值 | 左上角那个元素 |
| k 取 n² | 矩阵最大值 | 右下角那个元素 |
| 全是 7 | 7 | 比较全部取等号 |
| 严格递增 | 第 4 个 | 两种做法一致 |
| 200 组随机矩阵 | 两种做法结果完全一致 | 不一致 0 组 |
复杂度。 多路归并取 k 次堆顶,时间是 O(k log n),空间是 O(n);值域二分每次计数 O(n),一共 log(最大值减最小值) 轮,时间是 O(n log(最大值减最小值)),空间是 O(1)。
第九题 查找和最小的 K 对数字(373)
题目:给两个升序排列的整数数组和一个整数 k,从两个数组里各取一个数组成一对,找出和最小的 k 对。
原题链接: leetcode 373 查找和最小的 K 对数字
思路。 两个数组都有序,所以对每个下标 i,组合 (i, 0) 是这一「行」里和最小的。小堆里放若干候选的 (i, j),弹出最小的那一对之后,把同一行的 (i, j+1) 补进去。i 只需要考虑前 min(k, n1) 个,因为更靠后的行第一次出现在堆里的时间一定晚于前 k 次弹出。
用例走一遍。 数组一是 1、7、11,数组二是 2、4、6,k 取 3。
| 步 | 堆里的候选(值) | 弹出的 | 输出的对 | 补进堆的 |
|---|---|---|---|---|
| 初始 | 3、9、13 | |||
| 1 | 5、9、13 | 3 | (1,2) | (1,4) 的和是 5 |
| 2 | 7、9、13 | 5 | (1,4) | (1,6) 的和是 7 |
| 3 | 9、13 | 7 | (1,6) | 第一行取完了,不补 |
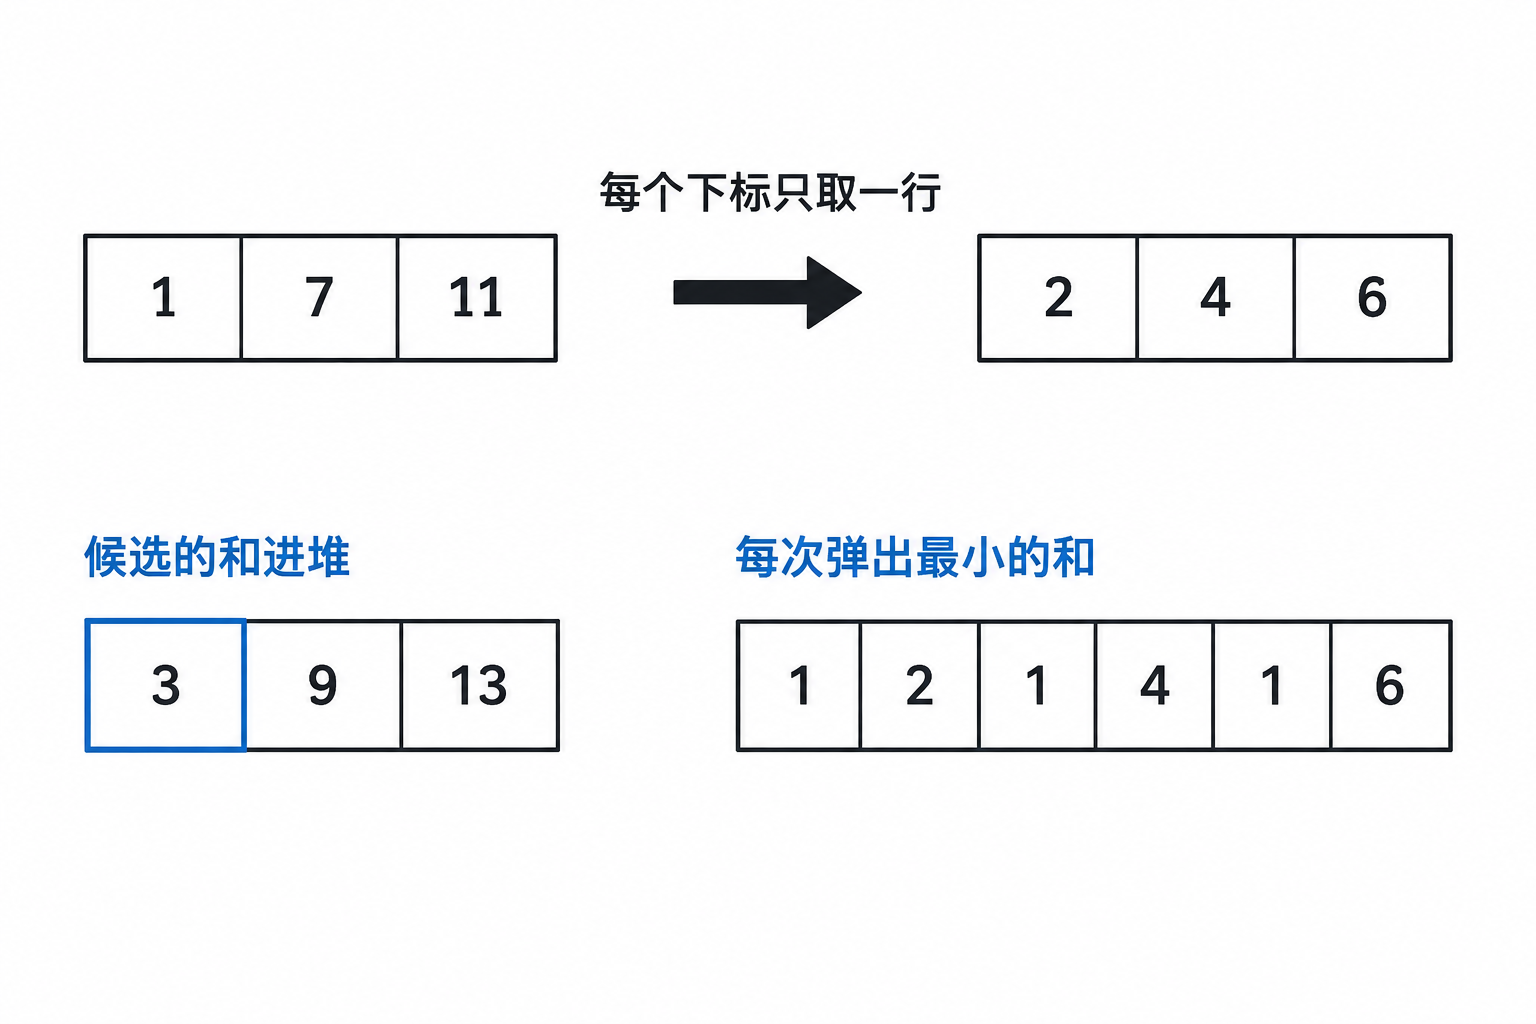
图 9 和最小的 K 对数字
代码。
c
# 文件:/home/cocatrice/ds11/p09_k_smallest_pairs.c
	hpSize = 0;
	for (i = 0; i < rows; i++)                 /* rows = min(n1, k) */
	{
		Push(nums1[i] + nums2[0], i, 0);
	}
	while (cnt < k && hpSize > 0)
	{
		Pair p = Pop();
		out[cnt * 2] = nums1[p.i];
		out[cnt * 2 + 1] = nums2[p.j];
		cnt++;
		if (p.j + 1 < n2)
		{
			Push(nums1[p.i] + nums2[p.j + 1], p.i, p.j + 1);
		}
	}
两处下标都要判边界:i 只放 min(n1, k) 行,j 在补下一个之前要确认没有越界。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p09_k_smallest_pairs
题目给的例子:
nums1=1 7 11 nums2=2 4 6           k=3
  小堆       (1,2) (1,4) (1,6)
  排序对照 (1,2) (1,4) (1,6)
  一致:是

边界值:
两个数组各一个元素        k=1        小堆 (1,1)                          一致:是
k 比组合总数还大            k=100      小堆 (1,2) (1,4) (1,6) (7,2) ...   一致:是
含负数                          k=4        小堆 (-10,-8) (-10,-2) (-4,-8) ... 一致:是
全部相同                       k=5        小堆 五个 (2,2)                     一致:是
一个数组只有一个元素     k=3        小堆 (5,1) (5,2) (5,3)              一致:是
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 两个数组各一个元素 | (1,1) | 只有一种组合 |
| k 比组合总数还大 | 返回全部组合 | 循环条件里带着 k 与堆空的双重判断 |
| 含负数 | 和最小的仍然排在最前 | 比较用和的大小,不受符号影响 |
| 全部相同 | 五个 (2,2) | 每一对都相等 |
| 一个数组只有一个元素 | 和另一个数组逐个配对 | 行数只有 1 |
复杂度。 一共弹出 k 次,每次 O(log k),时间是 O(k log k),堆里最多同时存在 k 个候选;空间是 O(k)。
第十题 丑数 II(264)
题目:丑数是只包含质因数 2、3、5 的正整数,1 也算,给一个整数 n 返回第 n 个丑数。
原题链接: leetcode 264 丑数 II
思路。 小堆的做法是:堆里先放 1,每次取出最小的丑数,把它乘 2、乘 3、乘 5 的结果放回堆里,重复的结果跳过,取够 n 个就得到答案,时间是 O(n log n)。
三指针做法更快:用一个数组按顺序记下已经生成的丑数,三个指针分别表示「下一个该乘 2、乘 3、乘 5 的位置」,每轮取三个候选值里最小的放进数组,对应的指针再往前走一步,时间是 O(n),空间同样是 O(n)。
用例走一遍。 前五个丑数的生成过程如下,每一轮取出堆顶,再把它乘 2、乘 3、乘 5 的结果放回去。
| 取出 | 放回堆里的三个 | 堆里的候选(去重后) |
|---|---|---|
| 1 | 2、3、5 | 2 3 5 |
| 2 | 4、6、10 | 3 4 5 6 10 |
| 3 | 6、9、15 | 4 5 6 9 10 15 |
| 4 | 8、12、20 | 5 6 8 9 10 12 15 20 |
| 5 | 10、15、25 | 6 8 9 10 12 15 20 25 |
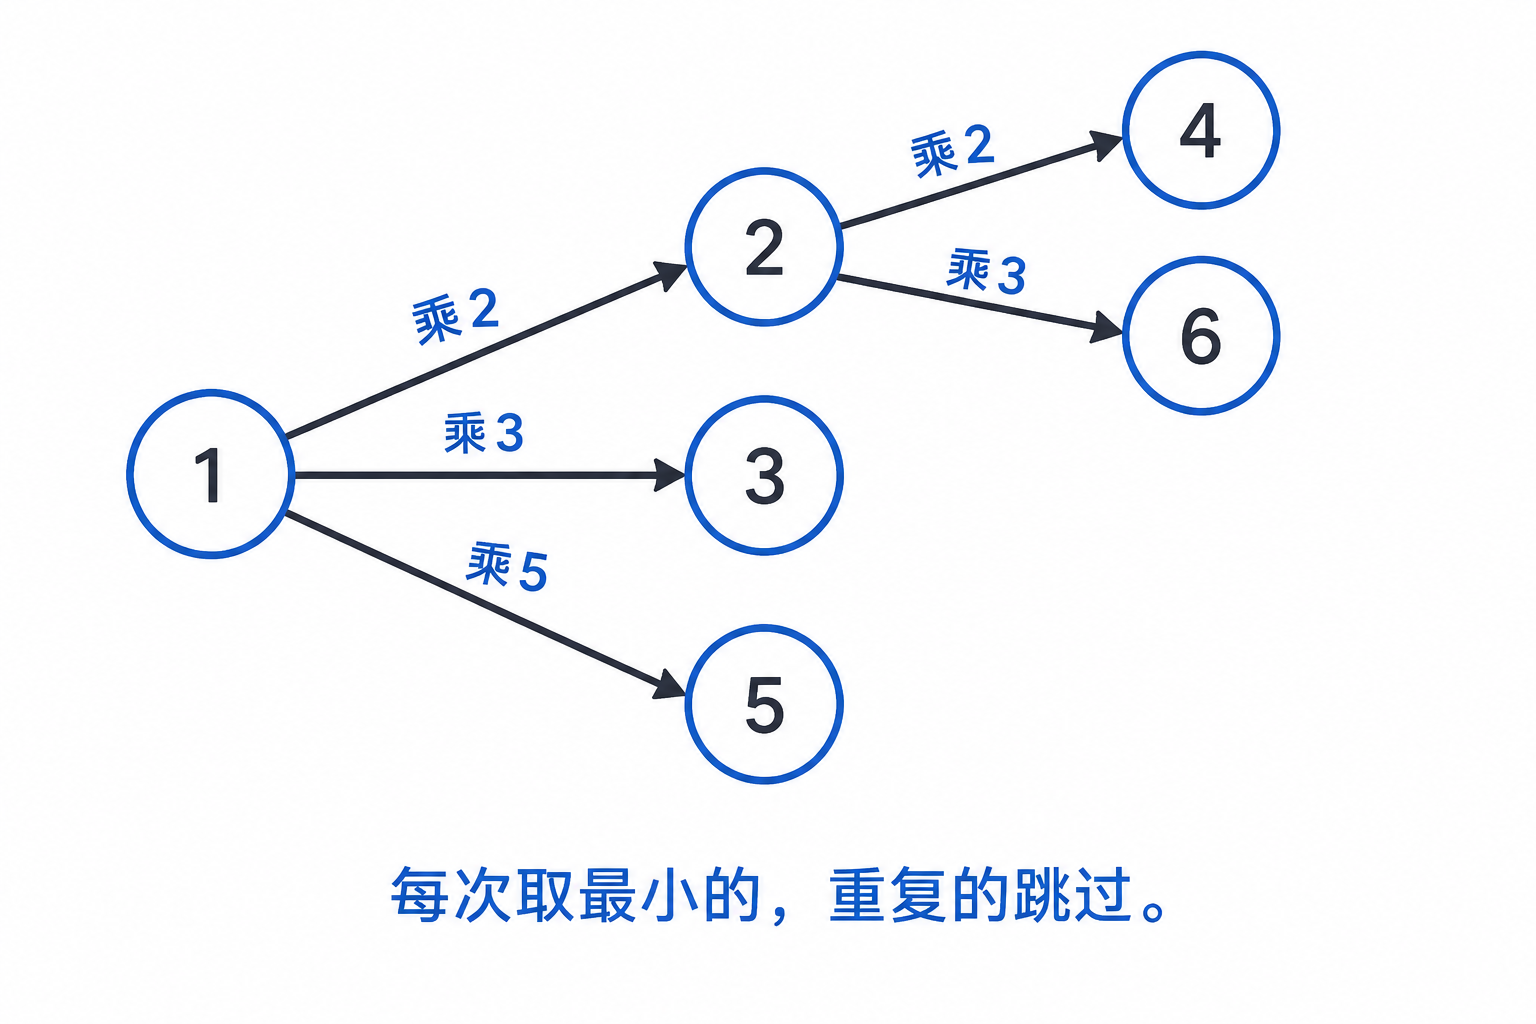
图 10 丑数的生成过程
代码。
c
# 文件:/home/cocatrice/ds11/p10_ugly_number_ii.c
static int NthUglyByPointer(int n)
{
	int* ugly = (int*)malloc(sizeof(int) * (size_t)n);
	int i2 = 0, i3 = 0, i5 = 0;
	int i;
	int ans;

	ugly[0] = 1;
	for (i = 1; i < n; i++)
	{
		int a = ugly[i2] * 2;
		int b = ugly[i3] * 3;
		int c = ugly[i5] * 5;
		int next = a < b ? a : b;
		if (c < next)
		{
			next = c;
		}
		ugly[i] = next;
		if (next == a) { i2++; }        /* 三个判断是并列的,可能同时前进 */
		if (next == b) { i3++; }
		if (next == c) { i5++; }
	}
	ans = ugly[n - 1];
	free(ugly);
	return ans;
}
三个 if 不能写成 else if:候选值相等时(比如 6 既等于 2 乘 3 也等于 3 乘 2),两个指针都要往前走一步,否则同一个丑数会被生成两次。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p10_ugly_number_ii
n        小堆(long long) 小堆(int)    三指针      一致
1        1              1              1              是
2        2              2              2              是
3        3              3              3              是
4        4              4              4              是
5        5              5              5              是
6        6              6              6              是
10       12             12             12             是
11       15             15             15             是
20       36             36             36             是
100      1536           1536           1536           是
500      937500         937500         937500         是
1690     2123366400     -2113929216    2123366400     int 版溢出

十二组用例,宽类型版本和三指针不一致 0 组

前十五个丑数: 1 2 3 4 5 6 8 9 10 12 15 16 18 20 24
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| n 取 1 | 1 | 1 也算丑数 |
| n 取 6 | 6 | 前六个是 1 2 3 4 5 6 |
| 重复值 6 | 只生成一次 | 2 乘 3 和 3 乘 2 都得到 6,去重靠判断 |
| n 取 1690 | 2123366400 | 堆里存 int 会溢出,得到负数 |
第 1690 个丑数是 2123366400,离 int 的上限只差两千多万,堆里把这个数取出来再乘 5 就会溢出,结果是负数,这也是边界值表最后一行记录的那一档。堆的做法必须用 long long 存;三指针做法每一步只用数组里已有的值乘 2、3、5,同样要注意别让中间结果溢出。
复杂度。 小堆做法每生成一个丑数要做一次出堆和三次入堆,时间是 O(n log n),空间是 O(n),堆里会有重复元素,峰值比 n 大;三指针做法每轮只取一个最小值,时间是 O(n),空间同样是 O(n)。
第十一题 数据流的中位数(295)
题目:设计一个结构,支持不断加入整数,并随时返回当前所有数的中位数。元素个数是偶数时中位数取中间两个数的平均值。
原题链接: leetcode 295 数据流的中位数
思路。 一个堆只能拿到一个极值,中位数要同时拿到较小一半的最大值和较大一半的最小值,所以用两个堆对着放:大堆存较小的一半,小堆存较大的一半。加入元素时先按大小放进对应的一半,然后检查两边个数差,超过 1 就从多的那边搬一个到少的那边。取中位数时,如果两边个数相等,就是两个堆顶的平均值;否则是元素多的那边堆顶。
用例走一遍。 依次加入 1、2、3,观察两个堆的内容和每次返回的中位数。
| 加入 | 大堆(较小一半) | 小堆(较大一半) | 中位数 |
|---|---|---|---|
| 1 | 1 | 空 | 1 |
| 2 | 1 | 2 | 1.5 |
| 3 | 1 2 | 3 | 2 |
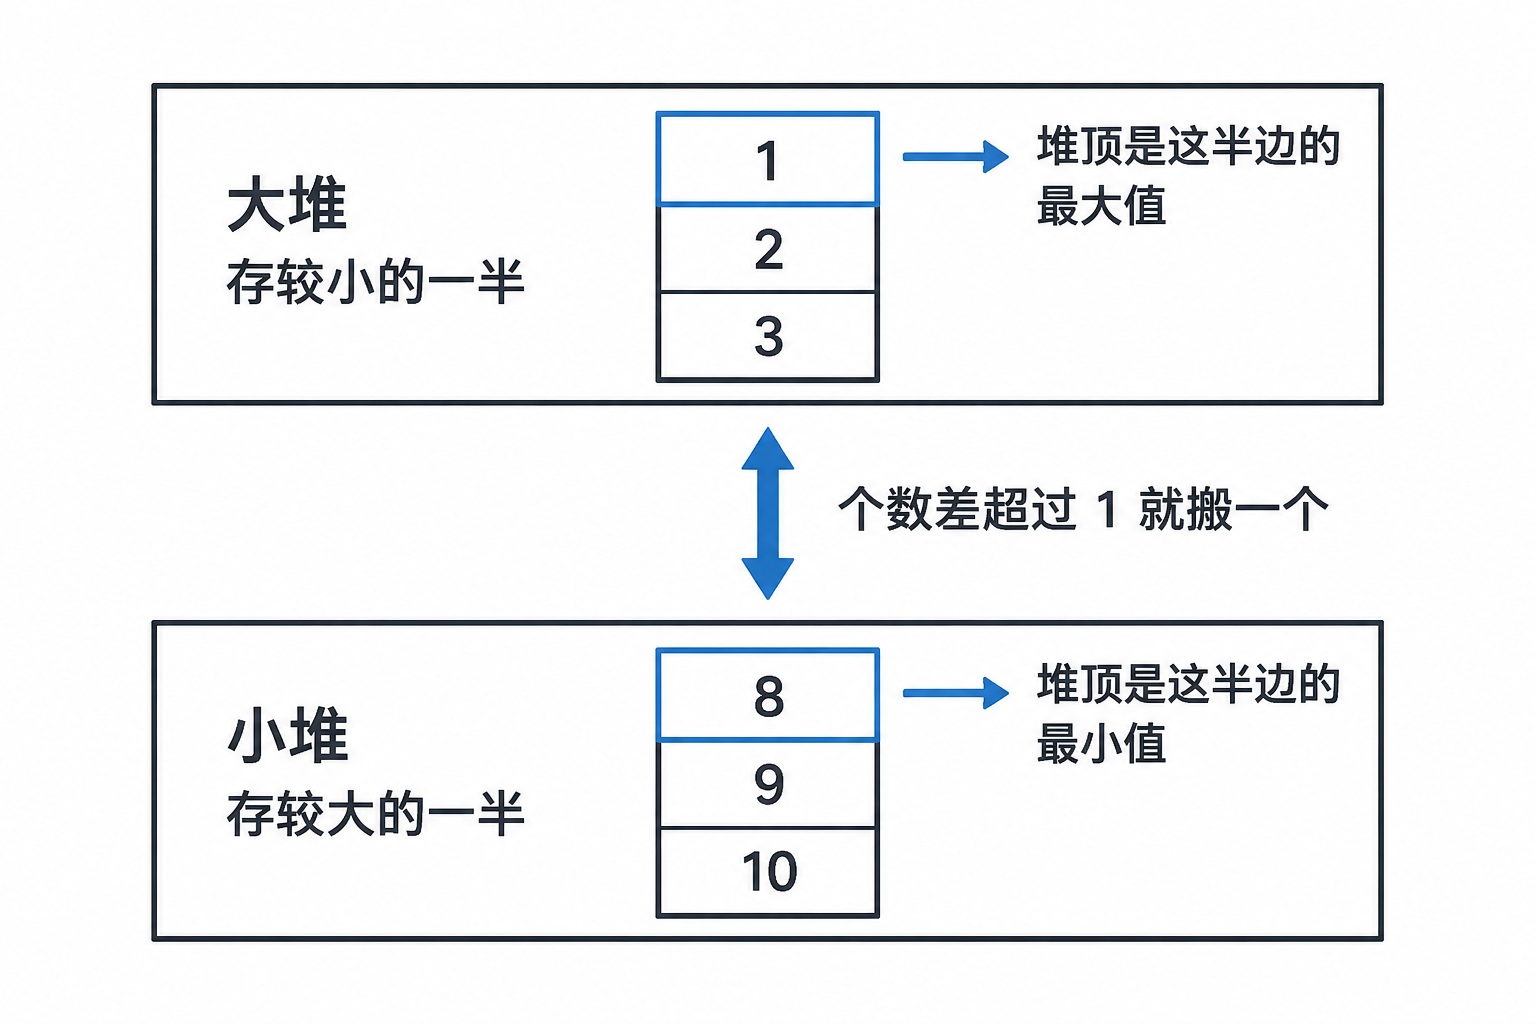
图 11 对顶堆
代码。
c
# 文件:/home/cocatrice/ds11/p11_median_finder.c
static void MedianFinderAddNum(MedianFinder* obj, int num)
{
	if (HeapEmpty(&obj->small) || num <= HeapTop(&obj->small))
	{
		HeapPush(&obj->small, num);
	}
	else
	{
		HeapPush(&obj->large, num);
	}
	if (HeapSize(&obj->small) > HeapSize(&obj->large) + 1)
	{
		HeapPush(&obj->large, HeapTop(&obj->small));
		HeapPop(&obj->small);
	}
	else if (HeapSize(&obj->large) > HeapSize(&obj->small) + 1)
	{
		HeapPush(&obj->small, HeapTop(&obj->large));
		HeapPop(&obj->large);
	}
}
搬元素那两句的前后顺序不能颠倒:先压入目标堆,再弹出源堆。写成先弹后压的话,被搬走的那个元素在中间那一步已经不在任何一边,如果压入时出了意外,比如扩容失败,这个元素就丢失了。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p11_median_finder
题目给的例子:
依次加入 1、2、3
  加入 1     中位数 = 1.0      对照 = 1.0      一致
  加入 2     中位数 = 1.5      对照 = 1.5      一致
  加入 3     中位数 = 2.0      对照 = 2.0      一致
  全部一致:是
依次加入 1、2
  加入 1     中位数 = 1.0      对照 = 1.0      一致
  加入 2     中位数 = 1.5      对照 = 1.5      一致
  全部一致:是

边界值:
只有一个数
  加入 5     中位数 = 5.0      对照 = 5.0      一致
  全部一致:是
全部相同
  加入 7     中位数 = 7.0      对照 = 7.0      一致(连续四次相同)
正负混在一起
  加入 6     中位数 = 6.0      对照 = 6.0      一致
  加入 10    中位数 = 8.0      对照 = 8.0      一致
  加入 2     中位数 = 6.0      对照 = 6.0      一致
  ...(十个数据逐个比对,全部一致)
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 只有一个数 | 该数 | 大堆有元素、小堆为空 |
| 全部相同 | 一直是该数 | 等号走的是「放进小的一半」分支 |
| 正负混合 | 逐个与排序结果一致 | 十个数据全部吻合 |
| 偶数个元素 | 两个堆顶的平均 | 用 double 计算,别写成整数除法 |
复杂度。 加入元素要做一次入堆,必要时再从另一侧搬一个过来,代价都是 O(log n);取中位数只读两个堆顶,代价是 O(1);两个堆合起来存放全部元素,空间是 O(n)。
第十二题 最小的 k 个数(面试题 17.14)
题目:给一个整数数组,返回其中最小的 k 个数,顺序不限。
原题链接: leetcode 面试题 17.14 最小的 k 个数
思路。 这道题和求最大的 K 个方向相反:这次要建的是大堆。堆里放当前最小的 k 个,堆顶是这 k 个里最大的,用它当门槛;新元素比门槛小就把堆顶换掉。判断依据和前面一致:堆顶要当门槛,它必须是候选里最差的那一个,而「最小的 k 个」里最差的就是其中最大的那个。
用例走一遍。 数组是 1、3、5、7、2、4、6、8,k 取 4,每读一个元素就和门槛比一次。
| 读入 | 堆顶(门槛) | 比门槛小吗 | 动作 | 堆里的四个数 |
|---|---|---|---|---|
| 1 3 5 7 | 7 | 无 | 建大堆 | 1 3 5 7 |
| 2 | 7 | 小于 | 换掉堆顶 | 1 2 3 5 |
| 4 | 5 | 小于 | 换掉堆顶 | 1 2 3 4 |
| 6 | 4 | 不小于 | 跳过 | 1 2 3 4 |
| 8 | 4 | 不小于 | 跳过 | 1 2 3 4 |
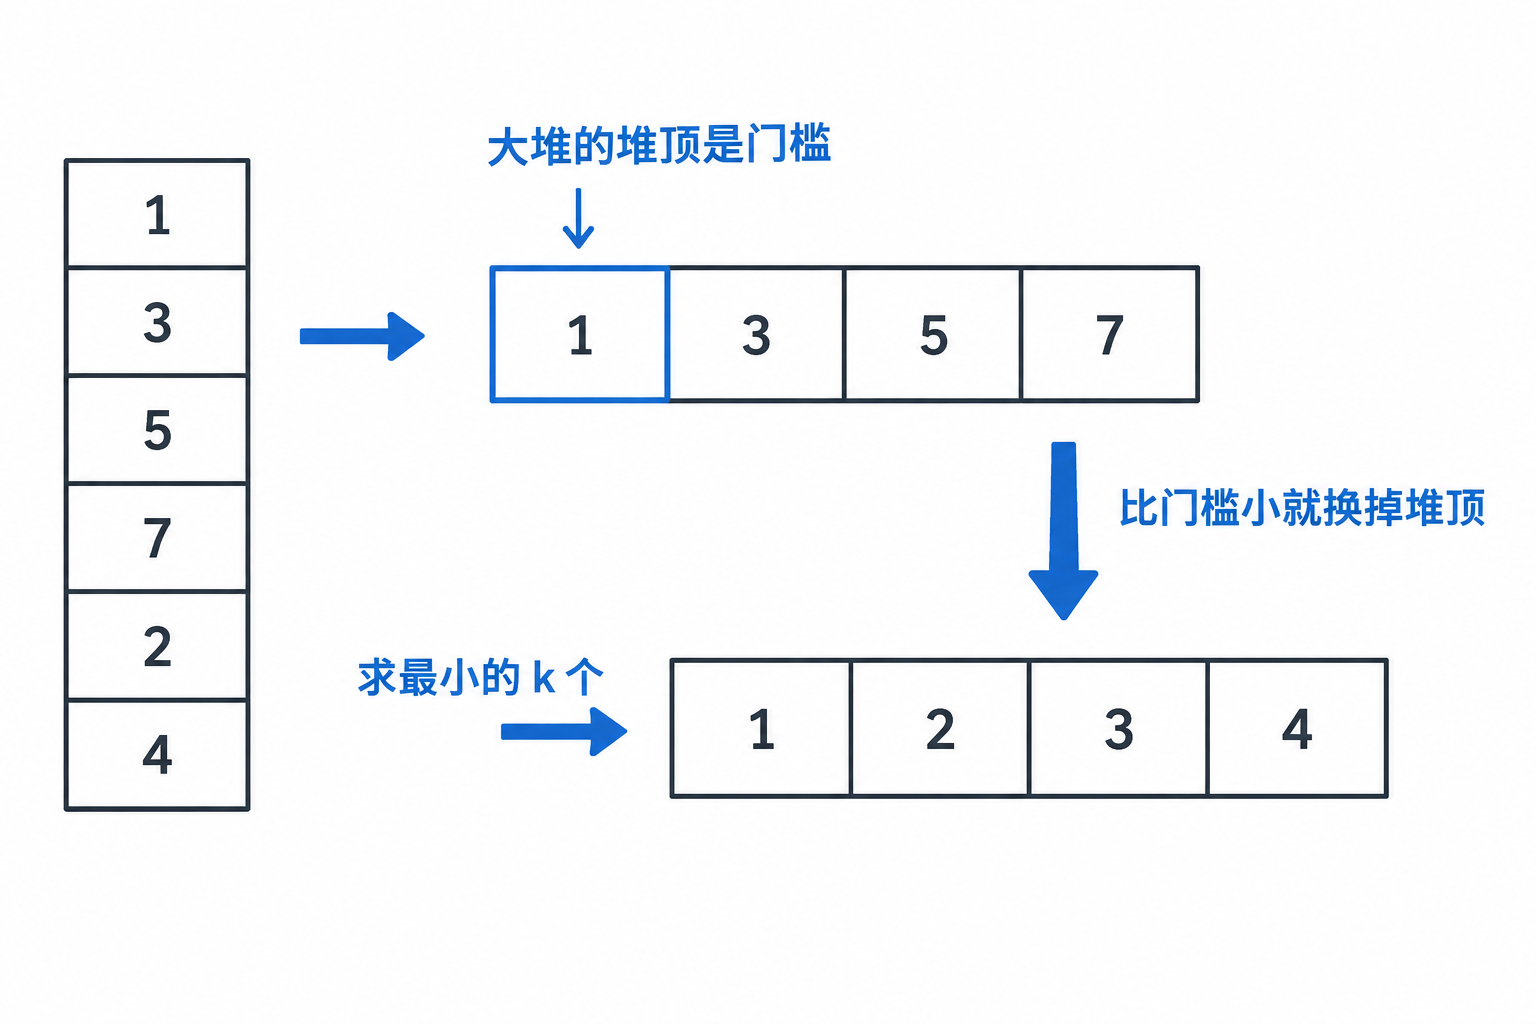
图 12 求最小的 k 个用大堆
代码。
c
# 文件:/home/cocatrice/ds11/p12_smallest_k.c
	HeapInit(&hp, 1);              /* 大堆 */
	for (i = 0; i < n; i++)
	{
		if (HeapSize(&hp) < k)
		{
			HeapPush(&hp, arr[i]);
		}
		else if (arr[i] < HeapTop(&hp))   /* 比门槛小才换 */
		{
			HeapPop(&hp);
			HeapPush(&hp, arr[i]);
		}
	}
从大堆里逐个弹出,得到的是从大到小的顺序,输出之前要反转一次;题目说顺序不限,代码里为了和排序结果对照做了这个反转。
实测回显。
text
[cocatrice@hcss-ecs-4cd1 ds11]$ ./p12_smallest_k
题目给的例子:
1 3 5 7 2 4 6 8              k=4
  大堆     1 2 3 4
  排序对照 1 2 3 4
  一致:是

边界值:
只有一个元素,k=1     k=1      大堆 1              对照 1              一致:是
k 等于数组长度         k=3      大堆 1 2 3          对照 1 2 3          一致:是
全部相同                 k=2      大堆 5 5            对照 5 5            一致:是
k 比数组长度还大      k=10     大堆 1 2 3          对照 1 2 3          一致:是
含负数                    k=3      大堆 -7 -3 -1       对照 -7 -3 -1       一致:是
边界值。
| 输入 | 结果 | 说明 |
|---|---|---|
| 只有一个元素,k 取 1 | 该元素 | 堆里一个元素 |
| k 等于数组长度 | 全部元素 | 退化成全排序 |
| 全部相同 | 任意 k 个 | 比较全部取等号 |
| k 比数组长度还大 | 返回全部 | 堆始终没装满 |
| 含负数 | -7 -3 -1 | 比较不受符号影响 |
复杂度。 每个元素最多入堆一次、出堆一次,堆的大小不超过 k,所以时间是 O(N log k);堆里最多同时存放 k 个元素,空间是 O(k)。
踩坑点
- 求最大的 K 个建小堆,求最小的 K 个建大堆,这两句最容易记反。判断依据只有一条:堆顶是用来当门槛的,它必须是候选里最差的那个。
- 维护 K 个候选时,先入堆再判断有没有超出 K 个。顺序反过来会漏掉刚好排在第 K 位的元素。
- 数据流那道题初始化时也要限制堆的大小。初始数据全部入堆之后不做限制,堆里会留下超出 K 个的元素,后面第一次 add 返回的就是错的。
- 合并 K 个链表时,空链表不能入堆。空指针进了堆,弹出来之后取 next 立刻崩溃。
- 多路归并补下一个元素之前都要判越界:矩阵里是 j + 1 < n,链表里是 p->next != NULL,数组对里是 j + 1 < n2。
- 丑数那道题的堆做法必须用 long long。第 1690 个丑数是 2123366400,取出来再乘 5 就溢出 int,实测得到负数 -2113929216。
- 丑数的三指针写法里,三个判断是并列的 if,不能写成 else if。候选值相等时两个指针都要前进,否则同一个丑数会被生成两次。
- 对顶堆搬元素要先压入再弹出。写成先弹后压,元素在中间那一步已经离开了两边。
- 中位数在元素个数为偶数时是两个堆顶的平均值,用 double 计算,不能写成整数除法。
- 值域二分里数不大于 mid 的元素个数时,从右上角出发,往左走是排除列、往下走是累计整行,两个方向的作用不一样,写反了计数会错。
- 题目写着顺序不限的题,输出顺序也要定下来。次数相同时按元素值排序,否则同一份逻辑在不同写法下会给出不同的排列,看起来像是答案错了。前 K 个高频元素就是这么处理的。
- 一句 printf 里连着调用三次会改变状态的函数,C 没有规定参数的求值顺序,打出来的结果顺序会和预期相反。带副作用的调用要拆成独立语句写。
- 用例本身要满足题目的前提。有序矩阵那道题的前提是每行每列都升序,拿一个行升序、列降序的矩阵去跑,两种做法会给出不同答案,因为值域二分依赖的前提已经不存在了。
本篇总结(模拟面试问题)
问:什么时候该用堆,什么时候排序就够了?
核心要点:看要不要反复取极值。只要一次全量有序结果,排序更直接;不断问「现在最大的是哪个」,堆合适。数据量大到装不下、只关心前 K 个时,堆的额外空间只有 O(K),排序要 O(N)。判断标准可以简单记成:题目的答案只和少数几个元素有关,就用堆。
问:求最大的 K 个为什么要建小堆?
核心要点:堆里放的是「目前见过的最大的 K 个」,堆顶是这 K 个里最小的,也就是最没资格留下的那个,拿它当门槛最合适:新元素比门槛小就直接丢,比门槛大就替换。反过来建大堆的话,堆顶是这 K 个里最大的,拿它当门槛会把大量本该入选的元素挡在外面。
问:这道第 K 大的题,堆和快速选择怎么选?
核心要点:堆的复杂度是 O(N log K),快选平均 O(N) 但最坏 O(N²)。K 很小时堆更快,因为 log K 很小;K 接近 N 时快选的优势明显。堆还有一个额外的优点:数据可以一个一个读,不要求全部在内存里,快选做不到。
问:数据流的中位数为什么必须用两个堆?
核心要点:中位数依赖中间的两个位置,一个堆只能给出一个极值。大堆存较小的一半、堆顶是这半边的最大值,小堆存较大的一半、堆顶是这半边的最小值,两个堆顶正好是中间那两个数。加元素时按大小放入,再让两边的个数差不超过 1 就行。
问:多路归并里堆里存的是什么?
核心要点:存每一条序列当前的第一个元素,以及它是从哪条序列的哪个位置取出来的。取出堆顶之后,从同一条序列里补下一个元素进堆。堆里始终只有 K 个元素,所以每次操作是 O(log K),总复杂度 O(N log K)。这两个信息都需要保留,否则取走堆顶之后不知道该从哪里补下一个。
问:丑数这道题的堆做法有什么坑?
核心要点:一是重复,2 乘 3 和 3 乘 2 都得到 6,取出来的时候要和上一个取出的值比一次,相同就跳过;二是溢出,第 1690 个丑数是 2123366400,堆里再用 int 存、还要乘 5,就会溢出成负数。三指针做法没有这两个问题,时间也降到 O(N)。
问:堆排序在算法题里为什么用得少?
核心要点:堆排序的价值在空间,O(1) 的额外空间加上稳定的 O(N log N),适合嵌入式这类内存紧张的场合。算法题里更常见的是「用堆解决 K 相关的问题」,因为那些问题的正解就是维护一个大小为 K 的候选集。单纯排序时,标准库的排序在常数因子上更快。
问:堆里能不能存结构体或者指针?
核心要点:能,只要给一个比较规则。C 里没有模板,比较那一行要按类型重写;C++ 用 priority_queue 配一个自定义比较器就行。合并 K 个链表那道题存的就是结点指针,比较的是结点里的值。要注意的是堆里存的如果是指针,比较函数里解引用之前需要确认指针非空。
参考
- 二叉堆的概念、实现与建堆复杂度的推导:https://oi-wiki.org/ds/heap/
- C++ 优先队列的接口说明,默认是大堆:https://en.cppreference.com/cpp/container/priority_queue
- 堆的数据结构综述与图解:https://www.geeksforgeeks.org/dsa/heap-data-structure/
- 求最大或最小的 K 个元素的几种解法对照:https://www.geeksforgeeks.org/dsa/k-largestor-smallest-elements-in-an-array/