摘要
深度学习技术的发展带来了关于训练数据和测试数据的新隐私问题。本文研究对抗场景下的模型反演问题:攻击者试图根据目标模型的预测值推断其训练数据和测试数据的信息。我们提出训练第二个神经网络作为目标模型的逆映射,以执行反演;该反演模型可以通过对目标模型的黑盒访问来训练。针对对抗场景下的训练,我们提出两项主要技术。第一,利用攻击者的背景知识构造辅助数据集来训练反演模型,无须访问原始训练数据。第二,设计基于截断的对齐方法,使反演模型能够根据攻击者在受害用户数据上获得的部分预测结果有效地反演目标模型。我们在多个图像数据集上,针对多种机器学习任务和模型架构系统评估了该方法。实验表明,即使并不完全了解目标模型的训练数据,且只能获得部分预测值,我们的方法仍能准确反演目标模型,并优于先前方法。
一 引言
机器学习模型,尤其是深度神经网络,正广泛应用于各种场景。机器学习技术的大规模采用显著提升了软件系统处理复杂数据的能力,从而支持了大量应用。例如,Apple ARKit 等人脸识别 API 会提供情绪、眼睛睁开程度等面部属性分数;一些在线服务还会评估用户的颜值和年龄。用户有时会出于娱乐目的在社交媒体上分享颜值评分。预测分数显然与输入人脸数据有关,但原始数据究竟能以多高的准确度被恢复,并不直观。这类应用因此引发隐私担忧。
模型反演已有大量研究,目标是从模型预测中获取有关训练数据的信息。相关方法大致分为两类。第一类在数据空间中使用基于梯度的优化来反演模型,本文称为基于优化的方法。例如,模型反演攻击(MIA)通过为目标类别生成代表性样本,推断神经网络的训练类别;它把反演视为一个优化问题,为给定类别寻找"最优"数据。MIA 对简单网络有效,但已有研究显示,它面对卷积神经网络等复杂网络时效果不佳。我们的实验也得到相似结果(图1(f))。主要原因是这类方法的优化目标不能真正刻画数据空间的语义(见第二节B)。第二类方法通过学习第二个模型来充当原模型的逆映射,本文称为基于训练的方法。这些工作旨在从计算机视觉特征(包括神经网络各层的激活值)重建图像,因此会在与分类器相同的训练数据上,利用完整预测向量训练第二个模型,以尽可能重建图像。
本文关注对抗场景:攻击者获得分类器及其预测结果,并试图理解输入数据和/或分类任务的语义。这类问题也称为反演攻击,即从预测值推断输入数据的信息。我们考虑两种对抗式反演任务:
数据重建:给定分类器对未知数据输出的预测向量,攻击者要重建该未知数据,这相当于反演分类器。例如,对输出人脸身份的分类器,攻击者的目标是重建某人的人脸图像。
训练类别推断:攻击者要为已训练分类器的每个训练类别恢复语义上有意义的数据。仍以人脸识别为例,攻击者希望得到训练数据中任意一个人的可识别人脸图像。可以通过反演分类器生成一个被判定为目标类别的代表性样本来实现。
然而,对抗场景下的反演不同于已有模型反演设定。具体而言,攻击者并不了解分类器的训练数据,因此先前需要使用相同训练数据训练反演模型的方法无法直接应用。已有基于优化的方法又要求白盒访问分类器以计算梯度,所以在黑盒场景中不可用。更重要的是,攻击者可能只能获得受害者数据的部分预测结果。例如,ImageNet 有两万多个类别,而预测向量中的大多数值很小,因此实际系统通常只发布排名前5至10的类别。用户也可能只在社交媒体上发布部分预测分数。部分预测会明显限制重建能力:图1(a)展示了将预测向量截断、只保留最大五分之一的值并将其余值置零后,反演结果很差;这可能源于反演模型过拟合。即使模型能根据完整预测准确重建,预测向量稍有变化(例如被截断)也会导致输出发生巨大差异。
本文形式化了上述对抗场景,并提出一种有效的神经网络反演方法。我们采用基于训练的思路,训练第二个神经网络(称为反演模型)执行反演。与先前工作不同,我们不使用目标模型训练数据的同一分布,而从基于背景知识构造的、更通用的数据分布中抽取反演模型训练集;攻击者通常更容易获得这类数据。例如,面对人脸识别分类器,攻击者可以从互联网随机收集人脸图像,构造辅助集,而无须知道精确的训练数据或其分布。图1(c)显示,仅用辅助样本训练的反演模型优于图1(a)。我们认为,这是因为辅助样本保留了通用的人脸特征(例如脸部轮廓、眼睛和鼻子),足以为原本病态的反演问题提供正则化。有趣的是,即使实际训练数据可用,用通用样本扩充训练数据也能提高反演准确度。
为使反演模型能够处理受害者数据的部分预测结果,我们提出一种截断训练方法:训练时将辅助样本的预测值截断。这样会迫使反演模型根据截断后的预测尽可能重建样本,从而使模型与截断值对齐。截断也类似特征选择,有助于降低过拟合。图1(b)展示了保留最大五分之一预测值、其余置零后使用该技术得到的重建结果。
截断技术同样适用于训练类别推断。为推断训练类别,我们把辅助样本的分类器预测截断为 one-hot 向量。训练完成后,将各类别的 one-hot 向量输入反演模型,即可为每个训练类别生成代表性样本。图1(e)表明,该结果显著优于 MIA(图1(f))和先前的基于训练方法(图1(g))。
根据攻击者的角色,我们设计了两种训练反演模型的方式。第一种适用于只有黑盒分类器访问权限、不了解训练数据的用户:从头单独训练反演模型。第二种适用于分类器开发者:可在同一训练数据上联合训练分类器和反演模型,得到更精确的反演模型。其目标是使分类器的预测同时保留有助于重建数据的关键信息,因此使用反演模型的重建损失来正则化分类器训练。
我们在多个图像数据集上,针对不同机器学习任务和模型架构评估了该方法。结果表明,即使不了解训练数据分布,我们的攻击仍能从部分预测中精确重建数据;在训练类别推断方面也优于先前方法。本文揭示了模型预测中隐藏的丰富信息,即使攻击者只能访问有限信息,也可能从中提取出这些信息。我们希望本研究能增强用户处理衍生数据时的隐私意识。
本文贡献概括如下:即使只部分了解训练集,也可以利用背景知识正则化原本病态的反演问题;形式化了攻击者仅获得部分预测结果的现实场景,并提出使反演模型与截断预测空间对齐的方法;将该方法应用于训练类别推断,并通过实验表明其优于已有工作;还发现即使分类器训练集已对攻击者开放,用通用样本扩充训练数据仍可提高反演准确度。
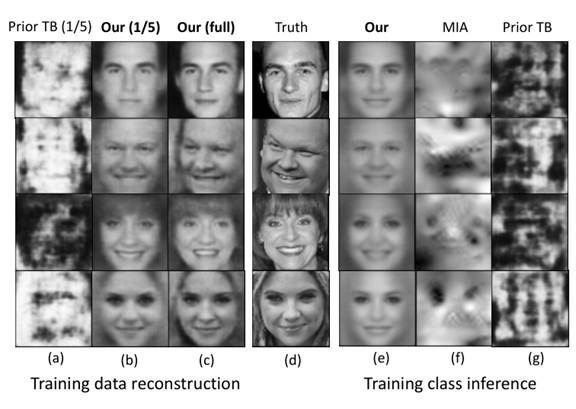
图1 面对人脸识别分类器时,训练数据重建与训练类别推断的结果。列(a)、(b)比较了仅能获得五分之一预测结果时,本文方法与已有基于训练(TB)方法的表现;列(c)展示用辅助样本训练反演模型后反演完整预测向量的结果;列(e)至(g)比较本文方法、MIA 和已有 TB 方法。所有实验中,本文方法均使用辅助样本。
二 背景
A 机器学习
本文关注监督学习,具体而言,是使用神经网络训练分类模型(分类器)。模型用于预测输入数据。模型的生命周期通常包括训练阶段(创建模型)和推理阶段(发布模型供使用)。
机器学习模型。分类器编码一个带参数 w 的一般假设函数 Fw,该函数从训练数据集中学习,目标是预测未见过的数据。函数输入为从数据分布 px(x) 抽取的数据点 x∈R^d,位于 d 维空间 X 中,每一维代表一个属性(特征);输出 Fw(x) 位于 k 维空间 Y 中,每一维对应一个预定义类别。学习目标是找到输入数据与类别之间的映射 Fw:X→Y。神经网络由多个相连的非线性激活函数(神经元)层构成,连接由模型参数 w 加权。最后一层的激活信号(logits)经过归一化指数函数 softmax 转换为概率向量:
softmax(z)ᵢ = exp(zᵢ) / Σⱼ exp(zⱼ)
softmax 将任意实数转换为 0,1 范围内、总和为1的向量,因此输出可解释为输入属于各类别的概率。
训练阶段。令 x 表示从底层数据分布 px(x) 抽取的数据,y 为其向量化类别。训练目标是找到函数 Fw,使其尽可能逼近空间 X×Y 中每个数据对 (x,y) 的映射。我们使用损失函数 L(Fw(x),y) 衡量类别 y 与分类器预测 Fw(x) 的差异。形式化地,训练目标是最小化期望损失:
L(Fw) = Eₓ~px L(Fw(x), y) (1)
真实概率函数 px(x) 难以精确表示,实践中可用从该分布抽取的样本估计。样本构成训练集 D⊂X,为其中每个 x 预先指定类别 y 作为监督信号,从而最小化训练集上的经验损失:
Lᴅ(Fw) = (1/|D|) Σₓ∈D L(Fw(x), y) (2)
不过,该目标可能导致过拟合:模型在训练数据上的预测误差很低,却无法很好泛化到从 px(x) 抽取的未见数据。通常在 Lᴅ(Fw) 上增加正则项 R(Fw) 来防止过拟合。分类器训练过程可概括为求解以下最小化目标:
C(Fw) = Lᴅ(Fw) + λR(Fw) (3)
其中正则化系数 λ 控制分类函数与正则函数之间的权衡。求解该优化问题的算法通常是梯度下降的变体。随机梯度下降(SGD)通过在随机选择的小批量训练数据上逐步计算平均梯度来更新参数,是一种高效方法。
推理阶段。推理(或测试)阶段使用 Fw 对未见数据分类。函数 Fw 接收从相同分布 px(x) 抽取的任意数据 x,输出预测向量 Fw(x)=(Fw(x)₁,...,Fw(x)ₖ),其中 Fw(x)ᵢ 表示数据 x 属于类别 i 的概率,且 ΣᵢFw(x)ᵢ=1。
B 模型反演
本文方法与机器学习和计算机视觉领域的多种神经网络反演研究相关。反演神经网络有助于理解和解释模型行为及特征表示。例如,计算机视觉中的典型反演任务是从 HOG、SIFT 等视觉特征,或网络各层的激活(包括分类器预测 Fw(x))重建图像 x。总体而言,这些方法分为基于优化的反演和基于训练的反演两类。
基于优化的反演。基本思路是在输入空间 X 中进行基于梯度的优化,寻找预测近似于给定 Fw(x) 的图像 x̂。也就是说,x̂ 应使 Fw(x) 与 Fw(x̂) 之间的某个损失最小。然而,反演神经网络预测实际上是一个困难的病态问题,优化过程容易产生不像自然图像的结果,尤其面对大型网络时。为缓解这一问题,研究者使用自然图像先验 P(x̂) 对优化进行正则化。先验定义图像的某些统计特性,反演目标可写为:
O(x̂) = L(Fw(x̂), Fw(x)) + P(x̂) (4)
其中 L 是距离度量(如 L2 距离)。将 Fw(x) 替换为类别 y 的向量化表示,即可为某个类别生成代表性图像。基于优化的反演需要白盒访问模型来计算梯度。
文献研究了多种图像先验。例如,常见的 α 范数先验 Pα(x)=||x||αα 会鼓励恢复图像具有较小范数。Simonyan 等人使用 L2 范数;Mahendran 和 Vedaldi 发现较大的 α 能得到更好的结果,并在实验中选择 L6 范数。他们还研究总变差(TV)先验 PVβ(x),使图像包含分段常量区域:
PVβ(x) = Σᵢ,ⱼ (xᵢ,ⱼ₊₁−xᵢ,ⱼ)² + (xᵢ₊₁,ⱼ−xᵢ,ⱼ)² ^(β/2) (5)
近期工作还会在输入图像送入网络前随机平移,以正则化优化。Yosinski 等人研究了另外三种先验的组合:用高斯模糊惩罚图像中的高频信息;裁剪范数较小的像素以保留主体;并裁剪对激活贡献较小的像素。贡献度衡量将像素置零时激活增加或减少的程度。Fredrikson 等人在模型反演攻击(MIA)中采用去噪和锐化滤波器作为先验,目标是为训练类别生成代表性图像。
然而,这些方法中简单、人工设计的先验 P 有局限,无法真正捕捉训练数据空间中的语义信息,因此面对大型网络时重建质量不理想。此外,这类方法需要在测试时进行优化并计算梯度,速度较慢(例如在 GPU 上每张图约需6秒)。
基于训练的反演。此类方法训练另一个神经网络 Gθ(本文称为反演模型)来反演原模型。具体而言,给定同一训练集中的图像及其预测对 (Fw(x),x),从头学习第二个神经网络 Gθ,使其逼近预测到图像的逆映射。反演模型以 Fw(x) 为输入并输出图像。形式化目标为:
C(Gθ) = Eₓ~px R(Gθ(Fw(x)), x) (6)
其中 R 是图像重建损失,例如已有工作使用的 L2 损失。Dosovitskiy 和 Brox 研究了两种额外损失来正则化反演模型:特征空间损失鼓励重建图像保留感知上重要的图像特征(例如反演模型某一层的激活);对抗损失则用于保持重建结果的真实感。受生成对抗网络(GAN)启发,该方法使用判别器 Dφ 区分重建图像与真实图像,同时训练反演模型"欺骗"判别器,使其把重建图像判为真实。对抗损失为:
A(Gθ,Dφ) = Eₓ~pxlog Dφ(x) + Eₓ~pxlog(1−Dφ(Gθ(Fw(x)))) (7)
与基于优化的反演不同,基于训练的反演只在训练反演模型时需要较高计算成本,该过程只需执行一次。给定预测后,只需对网络进行一次前向传播即可重建(例如 GPU 上每张图约5毫秒)。
三 对抗式模型反演
攻击者可以是黑盒分类器 Fw 的用户,也可以是 Fw 的开发者。其能力与目标取决于角色,本文考虑三种场景:(1)好奇的用户希望根据受害者的截断预测向量重建其输入数据;(2)好奇的用户希望推断 Fw 的功能;(3)恶意开发者训练 Fw,并希望之后能根据用户的截断预测向量重建其输入。
A 场景一:对黑盒分类器进行数据重建
此场景中的攻击者是好奇用户,可以黑盒访问分类器 Fw,即可自适应地向 Fw 输入数据并获得输出。攻击者不知道分类器的训练数据(分布)、架构或参数,但具有一些关于 Fw 的背景知识:
• 虽然攻击者不知道用于训练 Fw 的实际数据,但可以从一个比原训练数据分布 px 更通用的分布 pa 中抽取样本。例如,对一个用少数个人的人脸训练的人脸识别分类器,攻击者虽不知道这些人的面孔,却知道训练数据是人脸图像,因此可以从大量公开人脸图像中抽取样本。辅助样本仍保留脸部轮廓、眼睛和鼻子位置等通用特征,这些特征也存在于原训练数据中。直观上,如果对原始数据做某些维度约简后得到 pa,则 pa 比原分布更通用。
• 攻击者知道 Fw 的输入格式,因为他了解分布 pa;也知道 Fw 的输出格式,即预测向量的维数。即使 Fw 只返回选定预测值,攻击者仍可估计预测向量维数,例如向 Fw 输入一组数据并收集返回结果中的不同类别。
分类器 Fw 也供其他良性用户使用。我们假设攻击者能够获得受害者输入 x 对应的 m 截断预测向量 f,其中 m 是受害者预先确定的参数。给定预测向量 g,若保留 g 中最大的 m 个值、其余置零,则称 f=truncₘ(g)。例如:
trunc₂((0.6, 0.05, 0.06, 0.2, 0.09)) = (0.6, 0, 0, 0.2, 0)
给定 f、对 Fw 的黑盒访问以及分布 pa 的样本,攻击者希望找到分布 pa 中最可能且满足截断预测等于 f 的数据:
x̂ = arg maxₓ∈Xf pa(x),其中 Xf = {x∈X | trunc(Fw(x)) = f} (8)
将从 Fw、f 和 pa 中求得 x̂ 的问题称为数据重建问题。
B 场景二:训练类别推断
与场景一相同,攻击者是可以黑盒访问 Fw、且知道通用分布 pa 样本的好奇用户。此处攻击者不重建特定数据,而是寻找训练类别的代表性数据。给定 Fw 的黑盒访问权限和目标类别 y,攻击者要寻找满足下式的数据 x̂:
x̂ = arg maxₓ∈Xy pa(x),其中 Xy = {x∈X | Fw(x)y 较高} (9)
其中 Fw(x)y 是 Fw 将 x 判为类别 y 的置信度。
C 场景三:分类器与模型反演联合训练
我们还考虑攻击者是分类器开发者的情形:攻击者训练 Fw 并将其销售或分发给用户。与前两种场景不同,攻击者完全了解分类器训练数据、架构和参数,并可自行决定 Fw 的形式。假设 Fw 发布后,攻击者能够获得用户的截断预测,并希望重建用户输入。
因此,该场景的目标是训练一个满足原分类任务准确率要求、同时提高数据重建质量的分类器 Fw。
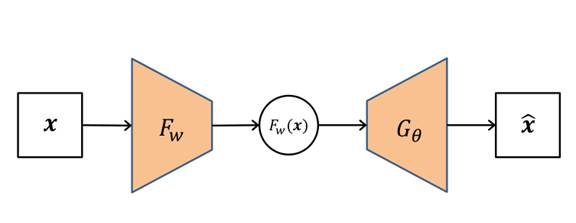
图2 基于训练的反演框架。分类器 Fw 接收数据 x 并生成预测向量 Fw(x);反演模型 Gθ 以预测为输入,输出重建数据 x̂。
D 在对抗场景中应用既有方法
需要强调本文对抗场景与先前反演设定中攻击者能力的差异。第一,在本文设定中,若用户攻击者只有分类器的黑盒访问权限,包含 MIA 在内的基于优化方法都不可用,因为它们需要白盒访问以计算梯度。此外,许多研究表明,MIA 面对大型神经网络时往往产生语义上无意义、甚至不像自然图像的结果;图1(f)也得到相同结论。第二,用户攻击者不知道分类器训练数据(分布),因此无法像先前基于训练的方法那样用同一训练数据训练反演模型。第三,用户或开发者攻击者都可能只能获得截断预测,这会让在完整预测上训练的反演模型无法从部分预测重建数据,如图1(a)、(g)所示。
四 方法
本文采用前述基于训练的策略反演分类器。整体框架如图2所示。与直接从 Fw 对给定预测向量进行优化的基于优化方法不同,我们先训练反演模型 Gθ;之后将给定预测向量输入 Gθ,由其输出重建样本。这与自编码器相似:Fw 相当于"编码器",Gθ 相当于"解码器",预测结果则是潜在空间。两者有三点差异:第一,当 Fw 固定(场景一、二)时,需要训练数据来训练 Gθ,但攻击者没有 Fw 的训练数据,因此要构造 Gθ 的训练集(第四节A);第二,攻击者只能获得截断预测,需要方法重新对齐潜在空间(第四节B);第三,在场景三中 Fw 并非固定,攻击者可决定 Fw 的形式,因此这是分类器与反演模型的联合训练问题(第四节C)。
A Gθ 的训练数据:辅助集
构建 Gθ 的首要环节是训练集,本文后文称其为辅助集。辅助集应包含足够的语义信息,以正则化病态的反演问题。
我们从比原训练数据分布 px 更通用的数据分布 pa 中抽取样本,构造辅助集。例如,对包含1000个身份的人脸识别分类器,可从互联网收集随机人群的公开人脸图像。这些辅助样本仍保留一般人脸特征,如脸部轮廓以及眼睛、鼻子的位置;这些特征与原训练数据共享。我们认为,共享特征足以为原本病态的反演任务提供正则化。还可以有针对性地选择辅助集,使其更好地对齐反演模型。例如,面对人脸识别分类器,可选择主要包含正脸的图像集,使反演模型与正脸对齐。
第五节B的实验结果验证了从更通用分布抽取辅助集的有效性:即使构建过程中从未见过目标训练类别,反演模型仍能精确重建训练数据点。
B 模型反演的截断方法
我们提出一种训练 Gθ 的截断方法,使其与部分预测结果对齐。图3展示分类器 Fw 与反演模型 Gθ 的架构。核心思路是:将 Fw 对辅助样本的预测截断到与受害用户部分预测相同的维数,并将截断结果作为输入特征训练反演模型,迫使其根据截断预测尽可能重建输入数据。形式化地,令 a 是从 pa 抽取的样本,Fw(a) 是分类器预测;令 m 为受害者数据部分预测向量的维数。将 Fw(a) 截断至 m 维(保留最大 m 个分数,其余置零),训练 Gθ 最小化以下目标:
C(Gθ) = Eₐ~pa R(Gθ(truncₘ(Fw(a))), a) (10)
其中 R 为损失函数,本文使用 L2 范数。也可以加入公式(7)中的对抗损失、公式(5)中的 TV 损失等,使生成数据更真实自然,作者将此留作未来工作。截断过程类似特征选择:移除 Fw(a) 中不重要的类别(置信度较低者),从而帮助降低 Gθ 的过拟合,使其仍可根据保留下来的重要类别重建输入。
Gθ 训练完成后,攻击者可将 Fw(x) 的截断预测输入 Gθ,获得重建的 x。该模型也可用于训练类别推断(场景二),与 MIA 的攻击目标相同。训练类别推断可视作设置 m=1,即攻击者只知道类别信息,并希望为每个训练类别生成代表性样本。MIA 假设攻击者在推理阶段可白盒访问 Fw;本文方法则只要求黑盒访问。此外,即使 Fw 只发布置信度最高的类别及其分数,本文方法仍可运行:攻击者可通过收集分类器对辅助集的预测中出现的不同类别,估计训练类别总数。这大幅降低了推断训练类别所需的攻击者能力。
实验表明,使用截断方法训练反演模型,可以提高从截断预测进行重建的质量。先前基于训练的方法直接把部分预测输入反演模型,会得到无意义的重建结果(详见第五节C)。
C 分类器与反演模型的联合训练
当攻击者是分类器开发者时,也可以将反演模型与分类器联合训练,从而提升反演质量。令 D 为分类器训练数据。我们在分类损失 Lᴅ(Fw)(公式(2))中加入额外的重建损失 Rᴅ(Fw,Gθ)。直观上,这会鼓励分类器预测在潜在空间中保留输入数据的关键信息,使反演模型能够将其解码并恢复输入。本文使用 L2 范数作为重建损失:
Rᴅ(Fw,Gθ) = (1/|D|) Σₓ∈D ||Gθ(trunc(Fw(x))) − x||²₂ (11)
联合训练确保 Fw 在适配分类任务的同时,Gθ 也针对截断预测向量优化数据重建。
值得注意的是,训练 Gθ 时直接使用预测向量 Fw(x) 并不能得到最优反演结果。输出层 logits z 经 softmax 缩放至 0,1 且总和为1,形成预测 Fw(x);这会削弱输出层激活,从而丢失部分供后续解码使用的信息。为解决此问题,我们把预测重新缩放为对应的 logits z,并在实验中用 z 替代 Fw(x):
z = log(Fw(x)) + c (12)
其中 c 为常数,训练反演模型时也会对其进行优化。
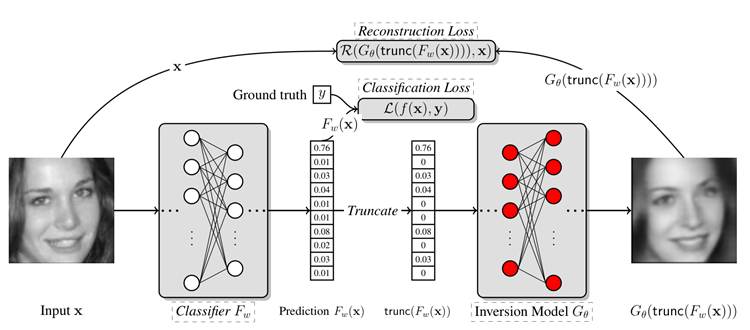
图3 分类器与反演模型的架构。分类器 Fw 接收数据 x 并产生预测 Fw(x);预测向量(如有需要)被截断为 trunc(Fw(x))。反演模型 Gθ 接收截断预测并输出重建数据 Gθ(trunc(Fw(x)))。图中同时标出了分类损失、重建损失及真实标签。
五 实验
本节评估本文方法的反演性能,并与已有工作比较。首先介绍实验设置;随后评估辅助集选择、截断方法和完整预测维数三个因素;接着评估训练类别推断;最后比较使用黑盒分类器 Fw 训练的反演模型 Gθ 与和 Fw 联合训练的 Gθ。
A 实验设置
我们在四个基准图像识别数据集上进行评估。为简化实验,所有数据集都转换为灰度图像,像素值范围为 0,1。
FaceScrub:包含约10万张、来自530人的图像 URL。由于部分 URL 在论文撰写时已不可用,作者最终下载到530人的48,579张图像。根据官方边界框信息提取人脸,并将每张图缩放至64×64。
CelebA:包含从互联网收集的10,177位名人的202,599张图像。作者移除了与 FaceScrub 重叠的296位名人,最终得到9,881位名人的195,727张图像。这样修改后的 CelebA 与 FaceScrub 不存在类别交集。该大规模人脸数据集可代表通用人脸数据分布。作者从官方对齐裁剪图(178×218)中,以左上角坐标(35,70)、宽和高均为108进行裁剪,再缩放为64×64及32×32。
CIFAR10:包含10个类别(飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船和卡车)的60,000张图像。图像被缩放至64×64及32×32。
MNIST:包含10个类别的70,000张手写数字图像。每张图像缩放至32×32。
作者使用 FaceScrub 和 MNIST 训练目标分类器 Fw。对每个使用数据集 D 训练的 Fw,分别使用同一训练集、来自 D 更通用分布的训练集,以及来自语义上可能不同分布的训练集训练 Gθ,并依次称为"相同""通用"和"不同"数据。表I给出了 Fw 与对应 Gθ 的数据分配。通用辅助集与 Fw 的训练数据(FaceScrub 和 MNIST)没有类别交集:CelebA 已清除与 FaceScrub 重叠的名人;作者随机选择 MNIST 的5个类别训练 Fw,并用另外5个类别构造辅助集。不同分布的辅助集则明确来自与训练数据分布不同的数据。
作者使用 CNN 训练 Fw,使用转置 CNN 训练 Gθ。FaceScrub 分类器包含4个 CNN 块,每块依次包括卷积层、批归一化层、最大池化层和 ReLU 激活层;CNN 块之后接两个全连接层,最后使用 Softmax 将任意神经信号转换为总和为1且取值在 0,1 的向量。FaceScrub 反演模型包含5个转置 CNN 块:前4块各包括转置卷积层、批归一化层和 Tanh 激活;最后一块包括转置卷积层和 Sigmoid 激活,将输出转换到与辅助数据相同的 0,1 范围。MNIST 分类器和反演模型架构与 FaceScrub 类似,分别使用3个 CNN 块和4个转置 CNN 块。模型架构详见附录A。FaceScrub 和 MNIST 分类器在其测试集上的准确率分别为85.7%和99.6%(训练/测试比例为80%/20%),与当时最先进的分类性能相当。
表I 分类器 Fw 及其反演模型 Gθ 的数据分配
|-------------|-------------|---------------------|------|
| Fw 任务 | Fw 数据 | Gθ 辅助数据 | 分布关系 |
| FaceScrub | 50%训练,50%测试 | FaceScrub 其余50%测试数据 | 相同 |
| FaceScrub | 80%训练,20%测试 | CelebA | 通用 |
| FaceScrub | 80%训练,20%测试 | CIFAR10 | 不同 |
| MNIST | 50%训练,50%测试 | MNIST 其余50%测试数据 | 相同 |
| MNIST(5个标签) | 80%训练,20%测试 | MNIST 另外5个标签 | 通用 |
| MNIST | 80%训练,20%测试 | CIFAR10 | 不同 |
B 辅助集的影响
辅助集是决定 Gθ 反演质量的重要因素。我们用不同辅助集(相同、通用、不同)训练 Gθ,并在黑盒 Fw 条件下评估。使用 Gθ 重建 Fw 的训练数据和测试数据(场景一)。本实验假设攻击者获得完整预测值。
图4和图5展示了随机选择的训练数据和测试数据的反演结果。辅助集的数据分布越接近训练数据分布,反演质量越好。值得注意的是,通用辅助集与分类器训练数据没有类别交集,即反演模型构建时从未见过目标训练类别,但仍能准确重建这些类别的数据。例如,MNIST 的数字5、6、7、9并未包含在辅助集中,Gθ 仍能通过捕捉这些数字尽可能多的语义特征,较准确地重建视觉上相似的数字。这进一步表明,通用背景知识足以正则化病态反演。但如果辅助集分布与通用分布相差过大,反演结果就不理想(图4、图5第三行)。作者认为,这是因为分类器无法从这些辅助样本中充分提取语义特征,其预测也就无法提供足够信息供反演模型解码。
小结I:即使并不完全了解分类器 Fw 的训练数据,只要使用从基于背景知识得到的、更通用分布中抽取的辅助样本训练 Gθ,仍可能准确反演。这类辅助集通常更易获得。
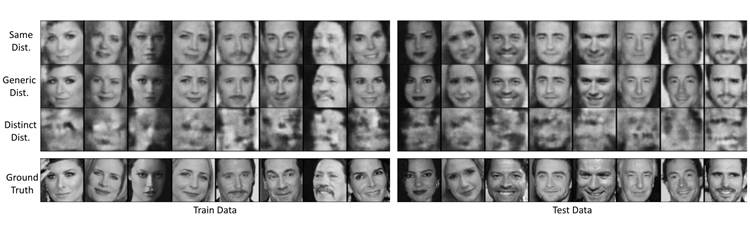
图4 辅助集对反演质量的影响。使用相同(第1行)、通用(第2行)和不同(第3行)分布的辅助集训练反演模型;针对 FaceScrub 分类器 Fw,对 Fw 的训练数据和测试数据进行反演。
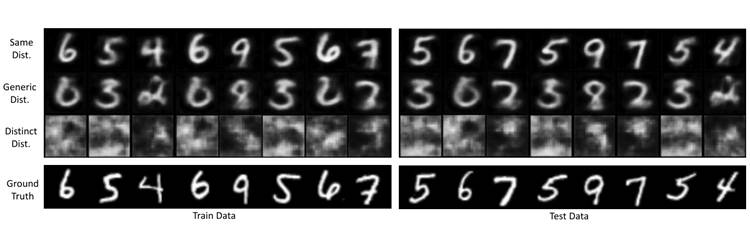
图5 辅助集对反演质量的影响。使用相同(第1行)、通用(第2行)和不同(第3行)分布的辅助集训练反演模型;针对 MNIST 分类器 Fw,对 Fw 的训练数据和测试数据进行反演。
C 截断的影响
训练反演模型时使用截断方法,可显著提高攻击者只能获得受害者部分预测结果时的反演质量。令 m 表示攻击者获得的受害者数据部分预测的维数。针对 FaceScrub 分类器的实验取 m=10、50、100、530;针对 MNIST 分类器取 m=3、5、10。图6、图7分别展示本文截断方法与先前未使用截断的基于训练方法的结果。FaceScrub 的辅助集来自通用分布,MNIST 的辅助集来自相同分布;图中训练数据和测试数据均为随机选择。
结果显示,本文方法优于先前方法,尤其在攻击者只能获得部分预测时优势明显。对于所有 m,本文方法都能生成具有足够语义信息、且高度可辨认的图像。先前方法在 m 很大时尚能生成可识别图像,但 m 较小时会产生无意义结果。本文方法在 m 较小时,反演结果更像目标人物的一张通用人脸,无法充分表示面部细节。例如图6第7列的真实图像是侧脸,m=10和50时本文方法生成正脸,m=100时才生成侧脸。这表明截断确实有助于降低过拟合,使 Gθ 与正脸图像对齐;m 越小,泛化越明显。
小结II:本文提出的反演模型截断训练方法,使攻击者仅获得部分预测结果时仍可能准确反演。
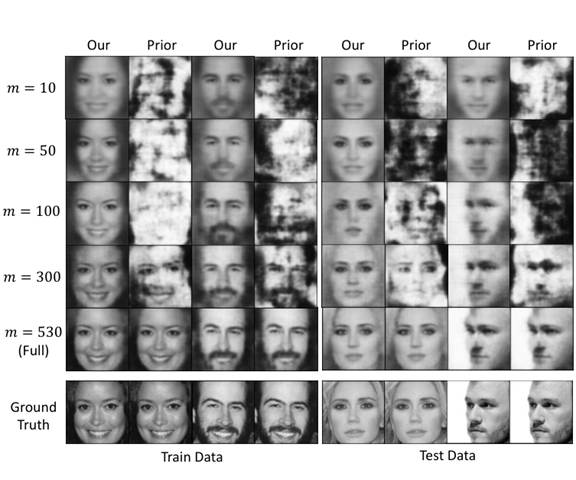
图6 截断对反演模型 Gθ 反演质量的影响。攻击者分别获得分类器预测类别中的10、50、100和530个(各行标为 m)。奇数列为本文方法,偶数列为先前方法。针对 FaceScrub 分类器,对随机选择的训练数据和测试数据进行反演;辅助集来自通用分布。
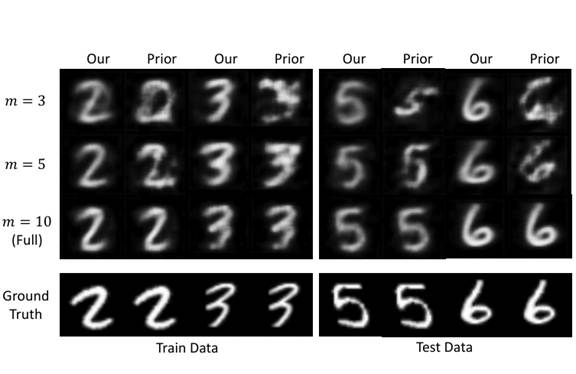
图7 截断对反演模型 Gθ 反演质量的影响。攻击者分别获得3、5和10个预测类别(各行标为 m)。奇数列为本文方法,偶数列为先前方法。针对 MNIST 分类器,对随机选择的训练数据和测试数据进行反演;辅助集来自相同分布。
D 完整预测维数的影响
第五节C研究了截断预测规模 m 的影响。本节研究完整预测维数 k 的影响。实验中,从 FaceScrub 和 MNIST 数据集随机选取 k 个类别作为 Fw 的训练数据。FaceScrub 取 k=10、50、100、530;MNIST 取 k=3、5、10。图8和图9分别展示针对 FaceScrub 和 MNIST 分类器的反演结果。所有实验均假设攻击者获得完整预测向量(即 m=k);FaceScrub 辅助集来自通用分布,MNIST 辅助集来自相同分布;训练数据和测试数据均随机选取。
实验结果显示,k 的影响与 m 类似。k 越大,目标数据重建越准确;k 较小时,反演结果更像相应类别的通用样本。这是因为 k 和 m 都影响攻击者能获得的预测信息量:k 决定完整预测向量规模,m 决定分类器从 k 维预测向量中实际发布多少个预测类别。
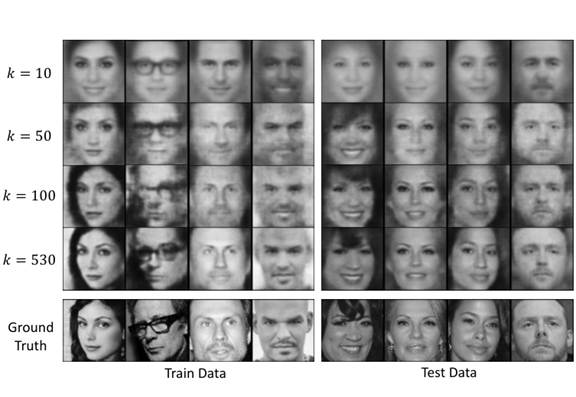
图8 完整预测规模对反演质量的影响。完整预测向量规模分别为10、50、100和530个类别(各行标为 k);假设攻击者获得完整预测向量。针对 FaceScrub 分类器,对随机选择的训练数据和测试数据进行反演;辅助集来自通用分布。
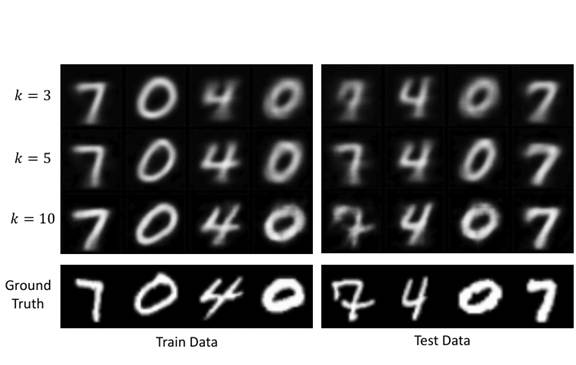
图9 完整预测规模对反演质量的影响。完整预测向量规模分别为3、5和10个类别(各行标为 k);假设攻击者获得完整预测向量。针对 MNIST 分类器,对随机选择的训练数据和测试数据进行反演;辅助集来自相同分布。
E 训练类别推断
本节评估 Gθ 在训练类别推断攻击(场景二)中的表现,并在同一个 FaceScrub 训练分类器上比较本文方法、MIA 与先前未使用截断的基于训练方法。本文攻击使用 CelebA 作为辅助集;它与 FaceScrub 没有类别交集,因此 Gθ 构建时从未见过目标训练类别。具体而言,我们先用辅助集估计训练类别总数,得到530个类别,恰好是真实类别数。训练反演模型时,将分类器对每个辅助样本的预测结果(置信度最高的类别及其置信度)编码为530维向量,其余类别位置填零,并将编码后的预测作为特征训练 Gθ。训练完成后,把每个训练类别转换为530维 one-hot 向量并输入 Gθ,输出即为推断得到的类别图像。
图10展示推断结果。MIA 生成的图像在语义上毫无意义,无法形成可识别人脸,这与先前研究结论一致。再次表明,MIA 面对复杂网络结构(本文实验中的 CNN)时效果不佳。先前基于训练的反演方法也无法生成可识别人脸。本文方法则能为每个人(类别)生成高度可识别的人脸,并捕捉眼睛、鼻子和胡须等语义特征。有趣的是,尽管 Fw 的训练人脸具有不同角度、表情、背景甚至光照,本文方法仍持续生成正脸。这表明反演模型已与正脸对齐,并能捕捉训练人物的语义特征,从而准确推断训练类别。
小结III:针对复杂神经网络进行训练类别推断时,本文方法优于先前方法;实验表明,它能为训练类别生成高度可识别且具有代表性的样本。
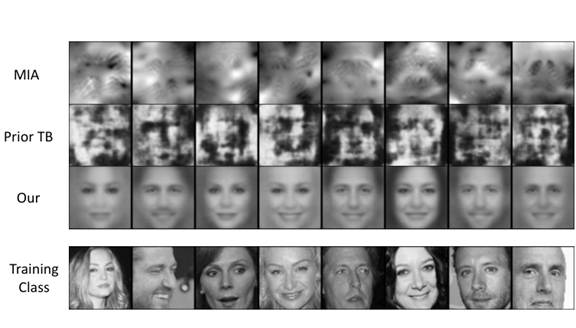
图10 训练类别推断结果。第一行是 MIA,第二行是先前基于训练(TB)的反演,第三行是本文反演;目标为 FaceScrub 分类器,本文方法使用通用分布的辅助集。
F 反演模型构建方式比较:黑盒 Fw 训练与联合训练
反演模型 Gθ 可以在给定的固定黑盒 Fw 上训练(场景一、二),也可以与 Fw 联合训练(场景三)。我们比较两种构建方式下 Gθ 的反演质量和 Fw 的分类准确率。为仅考察 Gθ 构建方式的影响,黑盒 Fw 方案使用与 Fw 相同的训练数据作为辅助集;两种方式的其他训练细节(如 epoch、批大小、优化器)均相同。我们用 Gθ 分别针对 FaceScrub 和 MNIST 分类器重建测试数据。具体而言,将分类数据集一分为二,50%作训练数据、其余50%作测试数据。
图11和图12展示两种构建方式在 FaceScrub 和 MNIST 分类器上的反演结果。与在黑盒 Fw 上训练相比,将 Gθ 与 Fw 联合训练能更准确地重建测试数据。表II第5、6列给出 Gθ 的平均重建损失;联合训练在测试集上损失更低。这符合直觉:联合训练可使 Fw 的预测在保留分类信息的同时保留输入数据的关键信息,供 Gθ 解码重建。不过,较好的重建质量以分类准确率降低为代价。表II第2、3列显示,联合训练会降低分类准确率,但降幅仍在可接受范围内(0.2%至1.5%)。这里 FaceScrub 准确率为78.3%,略低于前述实验的85.7%,因为此处只使用原始数据集的50%训练 Fw,而前述使用80%。
当然,场景三中的恶意开发者也可以放弃联合训练:先训练高准确率的 Fw,再训练 Gθ。有趣的是,攻击者可使用两个不同训练集,一个训练 Fw,另一个作为 Gθ 的辅助集。本实验用 CelebA 扩充原训练集作为辅助集。图11第三行和表II最后一列给出测试集平均重建损失。结果显示,用通用数据扩充训练集后,黑盒 Fw 上训练的 Gθ 可达到与联合训练的 Gθ 相当的重建质量。
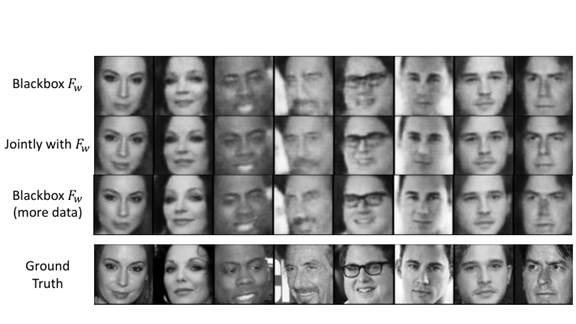
图11 黑盒 Fw 训练与和 Fw 联合训练所得 Gθ 的反演结果。目标为 FaceScrub,针对测试数据反演。黑盒 Fw 方案使用 Fw 的相同训练数据(第一行)作为辅助集,也展示将该训练数据与 CelebA 扩充后的结果(第三行);两种构建方式的其他训练细节相同。
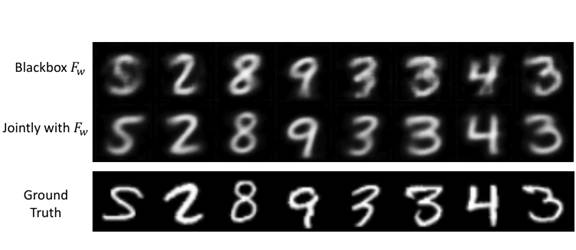
图12 黑盒 Fw 训练与和 Fw 联合训练所得 Gθ 的反演结果。目标为 MNIST,针对测试数据反演。黑盒 Fw 方案使用 Fw 的相同训练数据作为辅助集;两种构建方式的其他训练细节相同。
表II 分类器 Fw 的分类准确率及反演模型 Gθ 的平均重建损失(测试集)
|-----------|-------|-------|-------|--------|--------|--------|
| 分类器 | 准确率1 | 准确率2 | 准确率3 | 重建损失1 | 重建损失2 | 重建损失3 |
| FaceScrub | 78.3% | 76.8% | 78.3% | 0.1072 | 0.0085 | 0.0083 |
| MNIST | 99.4% | 99.2% | --- | 0.3120 | 0.0197 | --- |
**注:**1 先训练 Fw,再通过黑盒访问 Fw 训练 Gθ。2 联合训练 Fw 与 Gθ。3 先训练 Fw,再通过黑盒访问 Fw 训练 Gθ,并使用 CelebA 扩充训练数据。
小结IV:与在黑盒 Fw 上训练相比,与分类器 Fw 联合训练的反演模型 Gθ 反演质量更高,但会带来可接受的准确率损失。用更多通用数据扩充辅助集,可使黑盒 Fw 方案得到的 Gθ 达到与联合训练相当的质量,同时保持准确率。
六 相关工作
虽然基于深度学习的系统在多种应用中取得很高准确率,但仍有一些局限阻碍其广泛采用。一方面,多项研究表明,与其他数据驱动应用类似,神经网络会带来隐私威胁;此外,神经网络在对抗攻击下的脆弱性也已有报告。另一方面,神经网络缺乏解释能力。因此,出于安全或解释方面的动机,已有大量研究。
A 机器学习隐私
研究者指出,机器学习模型会对训练数据造成多种隐私威胁。例如,攻击者只需访问机器学习模型,就可能推断训练集中的非平凡且有用的信息。Shokri 等人研究针对机器学习模型的成员推断攻击,攻击者试图判断自己选择的一条记录是否属于私有训练集。Fredrikson 等人研究模型反演攻击,以推断目标训练类别的代表性样本;他们还提出另一种攻击,从已发布模型推断训练数据的敏感属性。Hidano 等人进一步研究在未必掌握非敏感属性的情形下推断敏感属性。Wu 等人提出形式化此类属性推断攻击的方法。Ateniese 等人表明,攻击者可在目标模型推理阶段推断训练数据的统计信息。Hitaj 等人研究协同学习训练阶段的信息泄露;Melis 等人研究协同机器学习训练过程中的成员推断和属性推断;Wang 等人研究协同机器学习训练过程中的用户级隐私泄露。Song 等人则利用神经网络的大容量或模型参数空间中大量未使用的容量,在训练阶段将若干训练数据点的敏感信息嵌入网络,使攻击者之后可在推理阶段提取这些信息。
上述训练数据隐私攻击中,有些推断训练数据的敏感属性或统计信息,另一些则能提取训练数据点,但需要操纵模型训练过程。成员推断攻击发生在推理阶段,但需要提供待判断的数据。与这些工作不同,本文研究如何在推理阶段根据模型预测结果,重建特定训练数据点或测试数据点。
B 对抗场景中的机器学习
深度学习在多个应用领域取得很高准确率,但其最初并非为安全性而设计。近年来,深度学习模型越来越多地用于安全敏感任务,因此模型预测准确性会对所在任务的安全产生重要影响。多项工作表明机器学习模型容易受到对抗攻击:攻击者可迫使受害模型偏离预定任务,并按攻击者意图产生异常行为。攻击者可通过污染训练阶段(例如使用对抗数据增强污染训练集、采用对抗损失函数)、恶意修改受害模型,或向模型输入精心构造的对抗样本来实施攻击。
Szegedy 等人利用约束优化提出规避技术,通过对干净样本作最小且视觉上难以察觉的扰动,令受害模型误分类。Papernot 等人进一步表明,针对一个受害模型构造的对抗样本也可能有效规避另一个受害模型,说明对抗样本对不同模型配置具有一定稳健性。虽然已有多种防御对抗样本的方法(如防御性蒸馏、去噪自编码器),其有效性仍不断受到不同攻击的挑战。
另一条研究路线是 Liu 等人提出的神经网络木马攻击:攻击者将预训练模型修改为木马模型,使其在正常数据上的性能与原模型相似,但遇到特定木马触发器(贴在干净样本上的小标记)时会产生恶意行为。BadNets 也提出相关攻击:攻击者用精心构造的恶意样本污染训练集,从而在输出模型中植入"后门"。后门模型在干净数据上准确率良好,但遇到攻击者选择的特定输入时会表现异常。
与上述工作不同,本文并不试图使机器学习模型偏离预定任务,而是考察从模型对输入的预测中重建输入数据是否可行。
C 安全与隐私保护机器学习
面对机器学习技术的安全和隐私威胁,许多研究致力于提供安全且保护隐私的模型训练方法。例如,Abadi 等人研究具有差分隐私保障的深度学习训练框架;Shokri 等人提出隐私保护协同深度学习协议,使参与方能够联合训练模型而不泄露各自私有训练数据。随后 Phong 等人使用同态加密,进一步保护数据免受"诚实但好奇"的服务器窥探。Bonawitz 等人提出高维数据的安全聚合方案。研究者还利用可信硬件原语构建了用于混淆多方机器学习的系统。
这些技术的威胁模型主要是保护参与训练的用户数据隐私。本文研究的是不同威胁模型:攻击者根据模型预测结果重建用户数据。
近期也有研究保护机器学习模型的预测结果。例如,Dwork 和 Feldman 研究使模型预测相对于训练数据满足差分隐私的方法。与之不同,本文通过训练另一个反演模型研究预测向量到输入数据的映射。Juvekar 等人提出 Gazelle,这是一个用于"机器学习即服务"场景的安全神经网络推理框架,使用密码学工具使服务器无法获得预测结果。本文研究的则是用户将预测结果(例如颜值和穿衣品味预测分数)发布到社交媒体,从而暴露模型预测的场景。
D 用于解释的机器学习反演
虽然深度神经网络在多种应用中表现出色,但其效果出众的原因仍不完全清楚。大量研究致力于解释和理解神经网络,而反演神经网络是理解网络所学习表示的重要方法。
Simonyan 等人通过生成最大化类别分数的图像,以及对给定图像和类别计算类别显著图来可视化分类模型;这两种方法都基于类别分数相对于输入图像的梯度。Zeiler 和 Fergus 提出 DeConvNet 方法,回溯网络计算以识别导致特定神经激活的图像区域;他们为每个卷积网络层连接反卷积网络,将信号反向传播至图像像素。Du 等人提出引导式特征反演框架来解释基于 DNN 的预测,识别输入中各特征的贡献,并检查 DNN 用于预测任务的信息;实验表明,DNN 较高层确实能捕捉输入的高层特征。Jacobsen 等人提出可逆神经网络,在各层中间表示中保留输入特征信息,并以可逆组件替换 RevNet 中不可逆的组件。Gilbert 等人从理论角度解释 CNN 的可逆性,提出从稀疏表示恢复图像的数学模型;但其数学分析作出若干模型假设,理论模型与实际场景的 CNN 之间仍有差距。Nash 等人训练生成式反演模型,用自回归神经密度模型表达给定中间表示时输入特征的分布。
上述研究反演神经网络的目的是理解和解释网络,因此可利用模型和训练数据的全部信息。与之相反,本文研究攻击者能力受限的对抗场景下的神经网络反演。
七 结论
本文提出一种有效的对抗场景模型反演方法:训练一个作为原模型逆映射的反演模型。我们发现,即使并不完全了解原训练数据,只要用从更通用数据分布中抽取的辅助样本训练反演模型,仍可能实现准确反演。我们还提出使用截断预测作为反演模型输入的训练方法,使模型与攻击者可能获得的受害者部分预测对齐。实验表明,本文方法能够在对抗场景下准确反演,并优于先前方法。
预测结果看似粗略,但用户和开发者可能会不经意地分享这类信息。本文展示了反演模型在对抗场景中令人惊讶的重建准确度。未来值得研究如何将其他损失函数及 GAN 等生成技术纳入对抗式反演问题。
参考文献
以下参考文献保留论文原始英文著录,以维持作者、题名、出版信息和链接的准确性。
1 Apple, "ARFaceAnchor.BlendShapeLocation," https://developer.apple. com/documentation/arkit/arfaceanchor/blendshapelocation.
2 Microsoft, "How-Old.net," https://www.how-old.net/.
3 Beauty.AI, "Beauty.AI," http://beauty.ai/.
4 Microsoft, "Xiaoice," https://kan.msxiaobing.com/ImageGame/Portal.
5 M. Fredrikson, S. Jha, and T. Ristenpart, "Model Inversion Attacks that Exploit Confidence Information and Basic Countermeasures," in Proceedings of the 22nd {ACM} {SIGSAC} Conference on Computer and Communications Security, Denver, CO, USA, October 12-6, 2015, 2015, pp. 1322--1333. Online. Available: http://doi.acm.org/10.1145/ 2810103.2813677
6 S. Lee and R. M. Kil, "Inverse mapping of continuous functions using local and global information," IEEE Transactions on Neural Networks, vol. 5, no. 3, pp. 409--423, May 1994.
7 Linden and Kindermann, "Inversion of multilayer nets," in International 1989 Joint Conference on Neural Networks, 1989, pp. 425--430 vol.2.
8 B.-L. Lu, H. Kita, and Y. Nishikawa, "Inverting feedforward neural networks using linear and nonlinear programming," IEEE Transactions on Neural Networks, vol. 10, no. 6, pp. 1271--1290, Nov 1999.
9 C. A. Jensen, R. D. Reed, R. J. Marks, M. A. El-Sharkawi, J.-B. Jung, R. T. Miyamoto, G. M. Anderson, and C. J. Eggen, "Inversion of feedforward neural networks: algorithms and applications," Proceedings of the IEEE, vol. 87, no. 9, pp. 1536--1549, sep 1999.
10 A. R. Várkonyi-Kóczy, Observer-Based Iterative Fuzzy and Neural Network Model Inversion for Measurement and Control Applications. Berlin, Heidelberg: Springer Berlin Heidelberg, 2009, pp. 681--702. Online. Available: https://doi.org/10.1007/978-3-642-03737-5{_}49
11 A. Mahendran and A. Vedaldi, "Understanding deep image representations by inverting them," in {IEEE} Conference on Computer Vision and Pattern Recognition, {CVPR} 2015, Boston, MA, USA, June 7-12, 2015, 2015, pp. 5188--5196. Online. Available: https://doi.org/10.1109/CVPR.2015.7299155
12 N. Papernot, P. Mcdaniel, and P. State, "Security and Privacy in Machine Learning," in 2018 IEEE European Symposium on Security and Privacy (EuroS\&P), vol. 392001, no. December, 2018, pp. 1--16. Online. Available: https://project.inria.fr/wifs2017/files/2017/12/ WIFS{}T2{}Papernot.pdf
13 R. Shokri, M. Stronati, C. Song, and V. Shmatikov, "Membership Inference Attacks Against Machine Learning Models," in 2017 {IEEE} Symposium on Security and Privacy, {SP} 2017, San Jose, CA, USA, May 22-26, 2017, 2017, pp. 3--18. Online. Available: https://doi.org/10.1109/SP.2017.41
14 B. Hitaj, G. Ateniese, and F. Perez-Cruz, "Deep Models Under the GAN: Information Leakage from Collaborative Deep Learning," in Proceedings of the 2017 ACM SIGSAC Conference on Computer and Communications Security, vol. 1, 2017, pp. 603--618. Online. Available: http://arxiv.org/abs/1702.07464
15 C. M. Bishop, Neural Networks for Pattern Recognition. New York, NY, USA: Oxford University Press, Inc., 1995.
16 A. Dosovitskiy and T. Brox, "Inverting Visual Representations with Convolutional Networks," in 2016 {IEEE} Conference on Computer Vision and Pattern Recognition, {CVPR} 2016, Las Vegas, NV, USA, June 27-30, 2016, 2016, pp. 4829--4837. Online. Available: https://doi.org/10.1109/CVPR.2016.522
17 ------, "Generating Images with Perceptual Similarity Metrics based on Deep Networks," in Advances in Neural Information Processing Systems 29, D. D. Lee, M. Sugiyama, U. V. Luxburg, I. Guyon, and R. Garnett, Eds. Curran Associates, Inc., 2016, pp. 658--666.
18 C. Nash, N. Kushman, and C. K. Williams, "Inverting supervised rep- resentations with autoregressive neural density models," arXiv preprint arXiv:1806.00400, 2018.
19 M. Fredrikson, E. Lantz, S. Jha, S. Lin, D. Page, and T. Ristenpart, "Privacy in pharmacogenetics: An end-to-end case study of personalized warfarin dosing." in USENIX Security Symposium, 2014, pp. 17--32.
20 A. Krizhevsky, I. Sutskever, and G. E. Hinton, "ImageNet Classifica- tion with Deep Convolutional Neural Networks," Advances In Neural Information Processing Systems, pp. 1--9, 2012.
21 R. K. Srivastava, K. Greff, and J. Schmidhuber, "Training very deep networks," in Proceedings of the 28th International Conference on Neural Information Processing Systems - Volume 2, ser. NIPS'15. Cambridge, MA, USA: MIT Press, 2015, pp. 2377--2385. Online. Available: http://dl.acm.org/citation.cfm?id=2969442.2969505
22 M. A. Hall and L. A. Smith, "Feature selection for machine learning: Comparing a correlation-based filter approach to the wrapper," in Proceedings of the Twelfth International Florida Artificial Intelligence Research Society Conference. AAAI Press, 1999, pp. 235--239. Online. Available: http://dl.acm.org/citation.cfm?id=646812.707499
23 Y. LeCun, Y. Bengio, and G. Hinton, "Deep learning," Nature, 2015.
24 M. Avriel, Nonlinear programming: analysis and methods. Courier Corporation, 2003.
25 T. Zhang, "Solving large scale linear prediction problems using stochas- tic gradient descent algorithms," in Proceedings of the twenty-first international conference on Machine learning. ACM, 2004, p. 116.
26 N. Dalal and B. Triggs, "Histograms of oriented gradients for human detection," in 2005 IEEE Computer Society Conference on Computer Vision and Pattern Recognition (CVPR'05), vol. 1, June 2005, pp. 886-- 893 vol. 1.
27 D. G. Lowe, "Distinctive image features from scale-invariant keypoints," Int. J. Comput. Vision, vol. 60, no. 2, pp. 91--110, Nov. 2004. Online. Available: https://doi.org/10.1023/B:VISI.0000029664.99615.94
28 J. Yosinski, J. Clune, A. Nguyen, T. Fuchs, and H. Lipson, "Under- standing neural networks through deep visualization," in Deep Learning Workshop, ICML, 2015.
29 K. Simonyan, A. Vedaldi, and A. Zisserman, "Deep inside convolutional networks: Visualising image classification models and saliency maps," in ICLR workshop track, 2014.
30 A. Mahendran and A. Vedaldi, "Visualizing deep convolutional neural networks using natural pre-images," International Journal of Computer Vision, no. Springer, 2016.
31 I. Goodfellow, J. Pouget-Abadie, M. Mirza, B. Xu, D. Warde-Farley, S. Ozair, A. Courville, and Y. Bengio, "Generative adversarial nets," in Advances in neural information processing systems, 2014, pp. 2672-- 2680.
32 P. Baldi, "Autoencoders, unsupervised learning and deep architectures," in Proceedings of the 2011 International Conference on Unsupervised and Transfer Learning Workshop - Volume 27, ser. UTLW'11. JMLR.org, 2011, pp. 37--50. Online. Available: http://dl.acm.org/ citation.cfm?id=3045796.3045801
33 H.-W. Ng and S. Winkler, "A data-driven approach to cleaning large face datasets," in IEEE International Conference on Image Processing (ICIP). IEEE, 2014, pp. 343--347.
34 Z. Liu, P. Luo, X. Wang, and X. Tang, "Deep learning face attributes in the wild," in Proceedings of International Conference on Computer Vision (ICCV), 2015.
35 A. Krizhevsky, V. Nair, and G. Hinton, "The cifar-10 dataset," online: http://www. cs. toronto. edu/kriz/cifar. html, 2014.
36 Y. LeCun, "The mnist database of handwritten digits," http://yann. lecun. com/exdb/mnist/, 1998.
37 D. Silver et al., "Mastering the game of go with deep neural networks and tree search," Nature, 2016.
38 K. He, X. Zhang, S. Ren, and J. Sun, "Delving deep into rectifiers: Surpassing human-level performance on imagenet classification," in IEEE International Conference on Computer Vision (ICCV), 2015.
39 G. Ateniese, L. V. Mancini, A. Spognardi, A. Villani, D. Vitali, and G. Felici, "Hacking smart machines with smarter ones: How to extract meaningful data from machine learning classifiers," International Jour- nal of Security and Networks, vol. 10, no. 3, pp. 137--150, 2015.
40 N. Carlini and D. Wagner, "Towards evaluating the robustness of neural networks," in IEEE Symposium on Security and Privacy (SP), 2017.
41 C. Szegedy, W. Zaremba, I. Sutskever, J. Bruna, D. Erhan, I. Good- fellow, and R. Fergus, "Intriguing properties of neural networks," in International Conference on Learning Representations, 2014.
42 R. Andrews, J. Diederich, and A. B. Tickle, "Survey and critique of techniques for extracting rules from trained artificial neural networks," Know.-Based Syst., vol. 8, no. 6, pp. 373--389, Dec. 1995. Online. Available: https://doi.org/10.1016/0950-7051(96)81920-4
43 J. Jia and N. Z. Gong, "AttriGuard: A Practical Defense Against Attribute Inference Attacks via Adversarial Machine Learning," in 27th {USENIX} Security Symposium ({USENIX} Security 18). Baltimore, MD: {USENIX} Association, 2018, pp. 513--529. Online. Available: https://www.usenix.org/conference/ usenixsecurity18/presentation/jia-jinyuan
44 S. Hidano, T. Murakami, S. Katsumata, S. Kiyomoto, and G. Hanaoka, "Model Inversion Attacks for Prediction Systems : Without Knowledge of Non-Sensitive Attributes," in 2017 15th Annual Conference on Privacy, Security and Trust (PST), 2017.
45 X. Wu, M. Fredrikson, S. Jha, and J. F. Naughton, "A Methodology for Formalizing Model-Inversion Attacks," in 2016 IEEE 29th Computer Security Foundations Symposium (CSF), jun 2016, pp. 355--370.
46 G. Ateniese, L. V. Mancini, A. Spognardi, A. Villani, D. Vitali, and G. Felici, "Hacking Smart Machines with Smarter Ones: How to Extract Meaningful Data from Machine Learning Classifiers," International Journal of Security and Networks, vol. 10, no. 3, pp. 137--150, sep 2015. Online. Available: http://dx.doi.org/10.1504/IJSN.2015.071829
47 L. Melis, C. Song, E. De Cristofaro, and V. Shmatikov, "Exploiting Unintended Feature Leakage in Collaborative Learningâ´L ˚U," in Proceedings of 40th IEEE Symposium on Security & Privacy (S&P 2019), 2018. Online. Available: http://arxiv.org/abs/1805.04049
48 Z. Wang, M. Song, Z. Zhang, Y. Song, Q. Wang, and H. Qi, "Beyond Inferring Class Representatives : User-Level Privacy Leakage From Federated Learning," in The 38th Annual IEEE International Conference on Computer Communications (INFOCOM 2019), 2019.
49 C. Song, T. Ristenpart, and V. Shmatikov, "Machine Learning Models that Remember Too Much," in Proceedings of the 2017 {ACM} {SIGSAC} Conference on Computer and Communications Security, {CCS} 2017, Dallas, TX, USA, October 30 - November 03, 2017, 2017, pp. 587--601. Online. Available: http://doi.acm.org/10.1145/3133956. 3134077
50 H. Dang, Y. Huang, and E.-C. Chang, "Evading classifiers by morphing in the dark," in Proceedings of the 2017 ACM SIGSAC Conference on Computer and Communications Security. ACM, 2017.
51 T. Gu, B. Dolan-Gavitt, and S. Garg, "Badnets: Identifying vulnera- bilities in the machine learning model supply chain," arXiv preprint arXiv:1708.06733, 2017.
52 B. Biggio, B. Nelson, and P. Laskov, "Poisoning attacks against support vector machines," in Proceedings of the 29th International Coference on International Conference on Machine Learning. Omnipress, 2012.
53 Y. Liu, S. Ma, Y. Aafer, W.-C. Lee, J. Zhai, W. Wang, and X. Zhang, "Trojaning attack on neural networks," in 25nd Annual Network and Distributed System Security Symposium (NDSS), 2018.
54 I. J. Goodfellow, J. Shlens, and C. Szegedy, "Explaining and harnessing adversarial examples," arXiv preprint arXiv:1412.6572, 2014.
55 N. Papernot, P. McDaniel, I. Goodfellow, S. Jha, Z. B. Celik, and A. Swami, "Practical black-box attacks against machine learning," in ASIACCS, 2017.
56 N. Papernot, P. D. McDaniel, X. Wu, S. Jha, and A. Swami, "Distillation as a Defense to Adversarial Perturbations Against Deep Neural Networks," in {IEEE} Symposium on Security and Privacy, {SP} 2016, San Jose, CA, USA, May 22-26, 2016, 2016, pp. 582--597. Online. Available: https://doi.org/10.1109/SP.2016.41
57 D. Meng and H. Chen, "Magnet: a two-pronged defense against adver- sarial examples," arXiv preprint arXiv:1705.09064, 2017.
58 M. Abadi, A. Chu, I. Goodfellow, H. B. McMahan, I. Mironov, K. Talwar, and L. Zhang, "Deep learning with differential privacy," in Proceedings of the 2016 ACM SIGSAC Conference on Computer and Communications Security. ACM, 2016, pp. 308--318.
59 R. Shokri and V. Shmatikov, "Privacy-preserving deep learning," in Proceedings of the 22nd ACM SIGSAC conference on computer and communications security. ACM, 2015, pp. 1310--1321.
60 O. Ohrimenko, F. Schuster, C. Fournet, A. Mehta, S. Nowozin, K. Vaswani, and M. Costa, "Oblivious multi-party machine learning on trusted processors." in USENIX Security Symposium, 2016, pp. 619--636.
61 C. Dwork and V. Feldman, "Privacy-preserving Prediction," in Proceedings of the 31st Conference On Learning Theory, ser. Proceedings of Machine Learning Research, S. Bubeck, V. Perchet, and P. Rigollet, Eds., vol. 75. PMLR, 2018, pp. 1693--1702. Online. Available: http://proceedings.mlr.press/v75/dwork18a.html
62 C. Juvekar, V. Vaikuntanathan, and A. Chandrakasan, "Gazelle: A Low Latency Framework for Secure Neural Network Inference," in 27th {USENIX} Security Symposium ({USENIX} Security 18), 2018. Online. Available: http://arxiv.org/abs/1801.05507
63 L. T. Phong, Y. Aono, T. Hayashi, L. Wang, and S. Moriai, "Privacy- Preserving Deep Learning via Additively Homomorphic Encryption," IEEE Transactions on Information Forensics and Security, vol. 13, no. 5, pp. 1333--1345, 2018.
64 K. Bonawitz, V. Ivanov, B. Kreuter, A. Marcedone, H. B. McMahan, S. Patel, D. Ramage, A. Segal, and K. Seth, "Practical secure aggregation for privacy preserving machine learning." IACR Cryptology ePrint Archive, vol. 2017, p. 281, 2017.
65 E. W. Saad and D. C. Wunsch, II, "Neural network explanation using inversion," Neural Netw., vol. 20, no. 1, pp. 78--93, Jan. 2007. Online. Available: http://dx.doi.org/10.1016/j.neunet.2006.07.005
66 A. Mahendran and A. Vedaldi, "Visualizing deep convolutional neural networks using natural pre-images," International Journal of Computer Vision, vol. 120, no. 3, pp. 233--255, 2016.
67 C. Nash, N. Kushman, and C. K. Williams, "Inverting supervised rep- resentations with autoregressive neural density models," arXiv preprint arXiv:1806.00400, 2018.
68 Q. Zhang, Y. N. Wu, and S.-C. Zhu, "Interpretable Convolutional Neural Networks," in The IEEE Conference on Computer Vision and Pattern Recognition (CVPR), 2018. Online. Available: http: //arxiv.org/abs/1710.00935
69 M. D. Zeiler and R. Fergus, "Visualizing and Understanding Convolutional Networks," in Computer Vision - {ECCV} 2014 - 13th European Conference, Zurich, Switzerland, September 6-12, 2014, Proceedings, Part {I}, 2014, pp. 818--833. Online. Available: https://doi.org/10.1007/978-3-319-10590-1{_}53
70 M. Du, N. Liu, Q. Song, and X. Hu, "Towards explanation of dnn-based prediction with guided feature inversion," in Proceedings of the 24th ACM SIGKDD International Conference on Knowledge Discovery & Data Mining, ser. KDD '18. New York, NY, USA: ACM, 2018, pp. 1358--1367. Online. Available: http: //doi.acm.org/10.1145/3219819.3220099
71 J.-H. Jacobsen, A. W. Smeulders, and E. Oyallon, "i-revnet: Deep invertible networks," in International Conference on Learning Representations, 2018. Online. Available: https://openreview.net/ forum?id=HJsjkMb0Z
72 A. N. Gomez, M. Ren, R. Urtasun, and R. B. Grosse, "The Reversible Residual Network : Backpropagation Without Storing Activations," in Advances in Neural Information Processing Systems, vol. 1, no. Nips, 2017, pp. 1--11.
73 A. C. Gilbert, Y. Zhang, K. Lee, Y. Zhang, and H. Lee, "Towards understanding the invertibility of convolutional neural networks," IJCAI International Joint Conference on Artificial Intelligence, pp. 1703--1710, 2017.
附录
A 模型架构
以下网络层配置保留原文代码记法;正文中的模型层名称与参数不作翻译,以保证技术配置可核对。
图13 FaceScrub 分类器架构。
Sequential(
(0): Conv2d(1, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(2): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(3): ReLU(inplace)
(4): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(5): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(6): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(7): ReLU(inplace)
(8): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(9): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(10): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(11): ReLU(inplace)
(12): Conv2d(512, 1024, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(13): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(14): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(15): ReLU(inplace)
(16): Linear(in_features=16384, out_features=2650, bias=True)
(17): Dropout(p=0.5)
(18): Linear(in_features=2650, out_features=530, bias=True)
)
图14 FaceScrub 反演模型架构。
Sequential(
(0): ConvTranspose2d(530, 1024, kernel_size=(4, 4), stride=(1, 1))
(1): BatchNorm2d(1024, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(2): Tanh()
(3): ConvTranspose2d(1024, 512, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1))
(4): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(5): Tanh()
(6): ConvTranspose2d(512, 256, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1))
(7): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(8): Tanh()
(9): ConvTranspose2d(256, 128, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1))
(10): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(11): Tanh()
(12): ConvTranspose2d(128, 1, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1))
(13): Sigmoid()
)
图15 MNIST 分类器架构。
Sequential(
(0): Conv2d(1, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(1): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(2): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(3): ReLU(inplace)
(4): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(5): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(6): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(7): ReLU(inplace)
(8): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(9): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(10): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(11): ReLU(inplace)
(12): Linear(in_features=8192, out_features=50, bias=True)
(13): Dropout(p=0.5)
(14): Linear(in_features=50, out_features=10, bias=True)
)
图16 MNIST 反演模型架构。
Sequential(
(0): ConvTranspose2d(10, 512, kernel_size=(4, 4), stride=(1, 1))
(1): BatchNorm2d(512, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(2): Tanh()
(3): ConvTranspose2d(512, 256, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1))
(4): BatchNorm2d(256, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(5): Tanh()
(6): ConvTranspose2d(256, 128, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1))
(7): BatchNorm2d(128, eps=1e-05, momentum=0.1, affine=True, track_running_stats=True)
(8): Tanh()
(9): ConvTranspose2d(128, 1, kernel_size=(4, 4), stride=(2, 2), padding=(1, 1))
(10): Sigmoid()
)