程序可以模拟万物
变量
变量是程序基本组成单位,变量的基本要素类型、名称、值。
- 类型决定了变量的取值范围
- 值决定了变量的空间大小。
变量表示内存中一个数据存储区域,该区域有自己的名称(变量名)和类型(数据类型)。不同类型的变量,占用的空间大小不同(具体表现为存储值的范围 )。该区域的数据可以在同一类型的范围内不断变化。
变量名的长度基本上没有限制, 尽管$ 是一个合法的Java 字符, 但不要在你自己的代码中使用这个字符。它只用在Java 编译器或其他工具生成的名字中。
java 中变量需要先声明;
变量在同一个作用域 内不能重名
在Java中,变量的声明尽可能地靠近变量第一次使用的地方 ,这是一种良好的程序编写风格。
在Java中,利用关键字final指示常量。在Java中,经常希望某个常量可以在一个类中的多个方法中使用,通常将这些常量称为类常量 。可以使用关键字static final 设置一个类常量。
+ 的使用
表达式左右两边都是数值类型时,则做的是加法运算。
表达式左右两边有一方为字符串,则做的拼接运算。
数据类型
java中,每一种数据都定义了明确的数据类型,在内存中分配了不同大小的内存空间。所以说java是强类型语言 。
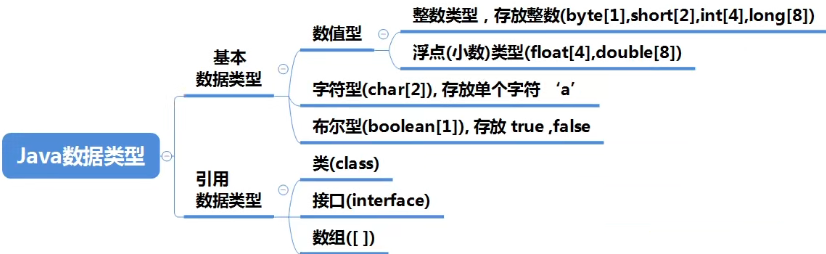
基本数据类型是CPU可以直接进行运算的类型。这些基本数据类型有什么区别呢?
计算机内存的最小存储单元是字节 (byte),一个字节就是一个8位二进制数,即8个bit。它的二进制表示范围从00000000~11111111,换算成十进制是0~255,换算成十六进制是00~ff 。
内存单元从0开始编号,称为内存地址。每个内存单元可以看作一间房间,内存地址就是门牌号。
一个字节是1byte,1024字节是1K,1024K是1M,1024M是1G,1024G是1T。一个拥有4T内存的计算机的字节数量就是:
4T = 4 x 1024G
   = 4 x 1024 x 1024M
   = 4 x 1024 x 1024 x 1024K
   = 4 x 1024 x 1024 x 1024 x 1024
= 4398046511104不同的数据类型占用的字节数不一样。我们看一下Java基本数据类型占用的字节数:
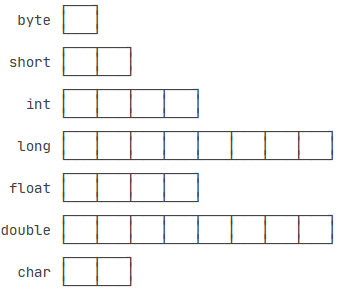
byte类型恰好就是一个字节,而long和double需要8个字节。
数值类型
整形的类型
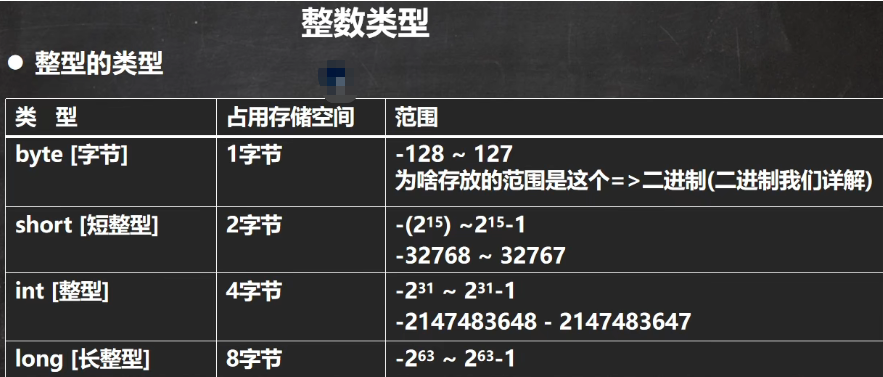
byte short int long 大小是从1开始2倍自增
-
java各整数类型有固定的范围和字段长度,不受具体的操作系统的影响。
-
java的整型常量默认为int 型,声明long型常量必须后加'l'或"L"。
-
bit 计算机中最小的存储单位,byte:计算机中基本存储单元,1 byte = 8 bit。
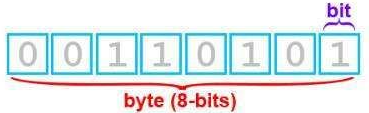
short、int、long在计算机中存储地位补0。 -
赋值时,只要常量或变量(这里指的是变量的范围,而不是变量的值 )的类型范围在被赋值的变量的范围内,都可以进行赋值
javapublic class VarDetail { public static void main(String[] args){ int a = 10; //int b = 20L; //会抛异常 long c = 10; System.out.println(c); } } -
整数的数值表示不仅是精确的,而且整数运算永远是精确的,即使是除法也是精确的(不会像浮点型那样会有精度损失),两个整数相除只能得到结果的整数部分。
浮点
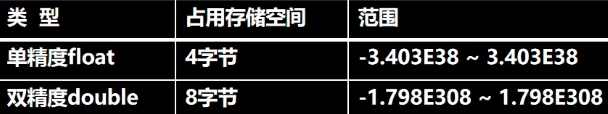
float double 大小从4开始2倍自增
说明:
-
关于浮点数在机器中存放形式的简单说明,浮点数=符号位+指数位+尾数位。
-
浮点数运算和整数运算相比,不能做位运算和移位运算。
-
java的浮点型常量默认为double型,声明float型常量,必须加f或F
-
浮点型常量表示形式有两种:
十进制:5.12512.0f.512(意思本来是0.512,这里省略了0)3.15d
科学计数法5.12e25.12E-2 -
在不知道使用任何浮点类型的情况下,使用double类型。
-
浮点数使用陷阱:有些浮点数在计算中无法精确表示 。例如:浮点数
0.1在计算机中就无法精确表示,因为十进制的0.1换算成二进制是一个无限循环小数,很显然,无论使用float还是double,都只能存储一个0.1的近似值 。但是,0.5这个浮点数又可以精确地表示。
浮点型在运算的时候赋值给变量时,结果和预想的会有很小的误差, 原因:无法精确表示的,会存储为一个近似值 。javapublic class FloatDetail { public static void main(String[] args){ double d1 = 3.2+1; System.out.println(d1); double d3 = 0.1; System.out.println(d3); // 0.1 double d2 = 5.4-5.3; // 0.10000000000000053 System.out.println(d2); double num8 = 2.7; double num9 = 8.1 / 3; System.out.println(num8); //2.7 System.out.println(num9); //2.6999999999999997 } }所以两个浮点数在比较时候就要小心。所以这里当遇到精度数据比较时候,我们可以这样写:
javapublic class FloatDetail { public static void main(String[] args){ double num8 = 2.7; double num9 = 8.1 / 3; System.out.println(num8); System.out.println(num9); if (num8 == num9) { System.out.println("num8和num9相等"); } System.out.println(Math.abs(num8 - num9)); if (Math.abs(num8 - num9) < 0.00001) { System.out.println("num8和num9相差很小的时候,几乎不影响业务。就认为num8和num9相等"); } } }
整数运算在除数为0时会报错,而浮点数运算在除数为0时,不会报错,但会返回几个特殊值:
NaN表示Not a NumberInfinity表示无穷大-Infinity表示负无穷大
浮点数值不适用于无法接受舍入误差的金融计算中。例如,命令System.out.println(2.0-1.1)将打印出0.8999999999999999,而不是人们想象的0.9。这种舍入误差的主要原因是浮点数值采用二进制系统表示,而在二进制系统中无法精确地表示分数1/10。这就好像十进制无法精确地表示分数1/3一样。如果在数值计算中不允许有任何舍入误差,就应该使用**BigDecimal类**。
整数被0除将会产生一个异常,而浮点数被0除将会得到无穷大或NaN结果。对于浮点数运算来说,如果想采用严格模式进行运算需要关键字strictfp,严格模式有可能导致精度溢出。默认情况下都会采用扩展精度。
字符类型
字符类型可以表示单个字符,字符类型的是char, 大小为两个字节(可以存放汉字),使用单引号引起来。
字符类型可以直接赋值给一个整数常量。
字符使用细节:
-
java中char的本质是一个整数,在输出时,是**unicode码对应的字符**
https://tool.chinaz.com/tools/unicode.aspx?qq-pf-to=pcqq.group
-
既然char的本质是一个整数,char类型的运行就相当于unicode码整数的运算。
javapublic class CharDetail { public static void main(String[] args){ System.out.println('a' + 10); // 输出107 这里a字符会先转化成unicode的数字,然后与10相加 System.out.println('是' + 10); // 26169 } }
转义序列\u还可以出现在加引号的字符常量或字符串之外,例如:方法参数 a(\u2922), 这样写法一般用于逆向中,可以使编码混淆.
Unicode 转义序列会在解析代码之前得到处理。
字符类型的本质
字符型数据在计算机中读取和存储需要进行字符<-->码值<-->二进制之间的转换
存储过程:'a'>码值97=二进制
读取过程: 二进制==>码值97==>'a'
Java中的"字母"和"数字"表示的范围更大。字母包括'A' ~ 'Z'、'a' ~ 'z'、'_'、'$',或在某种语言中表示字母的任何Unicode字符。同样,数字包括'0'~'9'和在某种语言中表示数字的任何Unicode字符。
char数据类型是一个采用UTF-16编码表示Unicode码点的代码单元。大多数的常用Unicode字符使用一个代码单元就可以表示,而辅助字符需要一对代码单元表示。
码点(codepoint)是指与一个编码表中的某个字符对应的代码值。在Unicode标准中,码点采用十六进制书写,并加上前缀U+,例如U+0041就是拉丁字母A的码点。
UTF-16编码采用不同长度的编码表示所有Unicode码点。在基本的多语言级别中,每个字符用16位表示,通常被称为代码单元(code unit);而辅助字符采用一对连续的代码单元。
要想得到实际的长度,即码点数量,可以调用:
int cpCount = greeting.codePointCount(0, greeting.length();
调用s.charAt(n)将返回位置n的代码单元,n介于0~s.length()-1之间。例如:
char first = greeting.charAt(0); // first is 'H'
char last = greeting.charAt(4); // last is 'o'
要想得到第i个码点,应该使用下列语句
int index = greeting.offsetByCodePoints(0,i);
int cp = greeting.codePointAt(index);
编码
因为计算机只能处理数字,如果要处理文本,就必须先把文本转换为数字才能处理。最早的计算机在设计时采用8个比特(bit)作为一个字节(byte),所以,一个字节能表示的最大的整数就是255(二进制11111111=十进制255),如果要表示更大的整数,就必须用更多的字节。比如两个字节可以表示的最大整数是65535,4个字节可以表示的最大整数是4294967295。
由于计算机是美国人发明的,因此,最早只有127个字符被编码到计算机里,也就是大小写英文字母、数字和一些符号,这个编码表被称为ASCII编码,比如大写字母A的编码是65,小写字母z的编码是122。
但是要处理中文显然一个字节是不够的,至少需要两个字节,而且还不能和ASCII编码冲突,所以,中国制定了GB2312编码,用来把中文编进去。
你可以想得到的是,全世界有上百种语言,日本把日文编到Shift_JIS里,韩国把韩文编到Euc-kr里,各国有各国的标准,就会不可避免地出现冲突,结果就是,在多语言混合的文本中,显示出来会有乱码。
因此,Unicode字符集应运而生。Unicode把所有语言都统一到一套编码里,这样就不会再有乱码问题了。
Unicode标准也在不断发展,但最常用的是UCS-16编码,用两个字节表示一个字符(如果要用到非常偏僻的字符,就需要4个字节)。现代操作系统和大多数编程语言都直接支持Unicode。
现在,捋一捋ASCII编码和Unicode编码的区别:ASCII编码是1个字节,而Unicode编码通常是2个字节。
字母A用ASCII编码是十进制的65,二进制的01000001;
字符0用ASCII编码是十进制的48,二进制的00110000,注意字符'0'和整数0是不同的;
汉字中已经超出了ASCII编码的范围,用Unicode编码是十进制的20013,二进制的01001110 00101101。
你可以猜测,如果把ASCII编码的A用Unicode编码,只需要在前面补0就可以,因此,A的Unicode编码是00000000 01000001。
新的问题又出现了:如果统一成Unicode编码,乱码问题从此消失了。但是,如果你写的文本基本上全部是英文的话,用Unicode编码比ASCII编码需要多一倍的存储空间,在存储和传输上就十分不划算。
所以,本着节约的精神,又出现了把Unicode编码转化为"可变长编码"的UTF-8编码。UTF-8编码把一个Unicode字符根据不同的数字大小编码成1-6个字节,常用的英文字母被编码成1个字节,汉字通常是3个字节,只有很生僻的字符才会被编码成4-6个字节。如果你要传输的文本包含大量英文字符,用UTF-8编码就能节省空间:
| 字符 | ASCII | Unicode | UTF-8 |
|---|---|---|---|
| A | 01000001 | 00000000 01000001 | 01000001 |
| 中 | x | 01001110 00101101 | 11100100 10111000 10101101 |
从上面的表格还可以发现,UTF-8编码有一个额外的好处,就是ASCII编码实际上可以被看成是UTF-8编码的一部分,所以,大量只支持ASCII编码的历史遗留软件可以在UTF-8编码下继续工作。
小结:
-
ASCII编码编码表 用一个字节表示,一个128个字符。实际上一个字节可以表示256个字符,但是只用了128个。
-
Unicode(UCS-16) 用两个字节表示一个字符(如果要用到非常偏僻的字符,就需要4个字节)
-
UTF-8编码: 把一个Unicode字符根据不同的数字大小编码成1-6个字节,常用的英文字母被编码成1个字节,汉字通常是3个字节(可以表示更多的汉字),只有很生僻的字符才会被编码成4-6个字节。
-
gbk gb2312(表示的汉字比较少,一般不用) big5(可以存储繁体字)
。。。
搞清楚了ASCII、Unicode和UTF-8的关系,我们就可以总结一下现在计算机系统通用的字符编码工作方式:
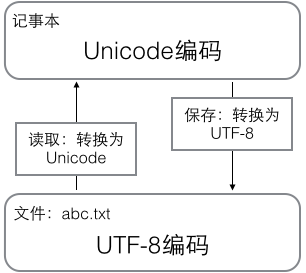
在计算机内存中,统一使用Unicode编码,当需要保存到硬盘或者需要传输的时候,就转换为UTF-8编码。
用记事本编辑的时候,从文件读取的UTF-8字符被转换为Unicode字符到内存里,编辑完成后,保存的时候再把Unicode转换为UTF-8保存到文件:
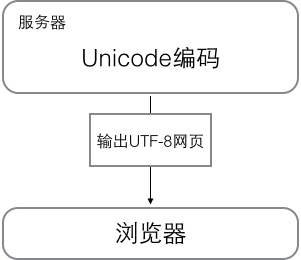
浏览网页的时候,服务器会把动态生成的Unicode内容转换为UTF-8再传输到浏览器:
所以你看到很多网页的源码上会有类似<meta charset="UTF-8" />的信息,表示该网页正是用的UTF-8编码。
布尔类型
布尔类型 占用一个字节,只允许表示true或false,一般用于逻辑判断。
布尔类型无法进行强制转换。
Java语言对布尔类型的存储并没有做规定,因为理论上存储布尔类型只需要1bit,但是通常JVM内部会把boolean表示为4字节整数。
自动转换和强制转换
自动转换
当java程序进行赋值或运算时,精度小的类型自动转换为精度大的数据类型,这个就是自动类型转换。一般遵循以下规则(低精度可以转换至高精度 ):
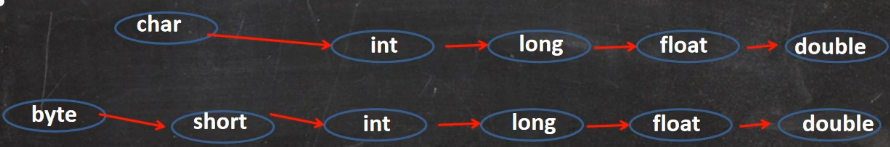
这里注意long->float可能会产生精度溢出。
使用细节
-
多种类型的数据混合运算时,系统首先会自动将所有数据转换成容量最大的那种数据类型,然后进行计算。接受计算结果类型变量必须要和最大类型一样。
javafloat d1 = n1 + 1.1; //这样写是错误的,因为1.1默认是double, n1 + 1.1后也是double类型,double类型不能直接赋值给float类型。 double d1 = n1 + 1.1; //正确 float d2 = n1 + 1.1f; //正确 int n2 = 1.1 //错误 会报错 -
在常量赋值给变量的时,编译器会先判断右边的常量是否定义在左边的变量的类型大小的范围内。如果在,就可以先赋值(前提要遵循自动转换图的前提下)。如果是变量赋值时,会直接使用变量的范围进行判断(右边的变量范围必须在左边的范围内)。
javabyte b1 = 10; // byte 范围-128~127 10在范围内,可以赋值。 byte b2 = 300; //没在范围内,编译器就会报错。 int n1 = 21; byte b3 = n1; //由于n1是int类型4字节,b3是byte类型1字节。n1的类型没有在b3的类型范围内(或者说n1容量大,b3容量小),所以这里是错误的 -
byte,short类型与char类型之间不能相互转换, 但可以进行计算,计算时精度提升到int(包括byte、short、char自身相互运算)。javabyte b1 = 10; char c1 = b1; //错误:byte, short 类型与char 类型之间不能相互转换 //.................. byte b1 = 10; short s1 = 15; short s2 = s1 + b1; //错误: s1 + b1 精度是int int类型赋值给short 高精度转低精度,有可能精度丢失,会报错 char s3 = 15; short s4 = s1 + s3; //错误: byte、short、char自身相互运算精度也会提升到int。int类型赋值给short 高精度转低精度,有可能精度丢失,会报错 -
bool类型不参与自动转换(这块跟php不一样)。
两个数进行运算:
如果两个操作数中有一个是double类型,另一个操作数就会自动转换为double类型。
否则,如果其中一个操作数是float类型,另一个操作数将会自动转换为float类型。
否则,如果其中一个操作数是long类型,另一个操作数将会自动转换为long类型。
否则,两个操作数都将被转换为int类型。
强制转换
将精度大的类型手动转换为精度小的数据类型,使用是要加上强制转换符()。强制转换可能会造成精度丢失和数据溢出,需要格外的注意(对于业务允许的情况下,可以进行强制转换)。
java
public class ForceConvert {
	public static void main(String[] args){
		int i = (int)1.9;
		System.out.println(i); //1 精度丢失
		int n1= 23000;
		byte b1 = (byte)n1;
		System.out.println(b1); //-40 数据溢出
	}
}
使用细节
强转符号只针对最近操作数有效,往往使用小括号提升优先级。
java
int n2 = (int)10*3.5 + 2*3.6; //报错:因为结果是double类型 double赋值给int 高精度转低精度精度丢失
int n2 = (int)(10*3.5 + 2*3.6); //正确 42
警告:如果试图将一个数值从一种类型强制转换为另一种类型,而又超出了目标类型的表示范围,结果就会截断成一个完全不同的值。例如,(byte)300的实际值为44。
基本数据类型与字符串互转
基本数据类型转换成String类型特别简单,只需要 基本数据类型 + ""就可以了
JAVA
int n1 = 100;
float f1 = 2.234f;
String s1 = n1 + f1 + ""; //102.234
String s2 = n1 + "" + f1; //1002.234
字符类型转String 也可以使用 + ""
String 类型转换成基本数据类型则需要通过基本数据类型包装类调用parseXX方法既可。
java
String s3 = "123";
int num1 = Integer.parseInt(s3);
double num2 = Double.parseDouble(s3);
float num3 = Float.parseFloat(s3);
long num4 = Long.parseLong(s3);
short num5 = Short.parseShort(s3);
byte num6 = Byte.parseByte(s3); //注意:不能大于255
boolean num7 = Boolean.parseBoolean("true");
使用细节
将String转换成基本数据类型时,要确保String类型能够转换成有效的数据。所以如果格式不正确,就会抛出异常(会在运行时候抛出 ),程序终止。
比如:"123"可以转换成整数,"hello"却不能。
转化成基本类型时要注意转化后的基本类型范围,比如:
java
String str = "999";
byte b1 = Byte.parseByte(str);
System.out.println(b1);上述代码会抛出NumberFormatException异常,因为转化后的数字范围已经超出了Byte的最大值。