(一).前言
Redis的主从复制是为了避免单点问题。"单点问题"指的是,某个服务器程序只有一个节点,此时就会有很多问题。第一个问题就是,可用性问题,如果这个机器挂了,那么这个服务就挂了。第二个问题就是单台设备所能支持的并发量和性能也是比较有限的。
此时我们引入分布式系统,来解决这样的问题。在分布式系统中,我们会有多个服务器来部署Redis服务,从而构成一个redis集群,这个集群可以给整个分布式系统的其他服务提供稳定的存储功能。
在分布式系统中,存在以下几种redis的部署方式:①.主从模式②.主从+哨兵模式③.集群模式。这里主要介绍第一种,后面的两种在后面进行介绍。
(二).概念
主从模式,指的是在若干个redis节点中,有的节点为"主节点",有的节点为"从节点"。从节点上的数据要跟随着主节点的变化而变化,从节点的数据要和主节点保持一致。例如,现在有3个redis-server,此时就可以把其中的一个节点作为主节点,其他两个节点为从节点。
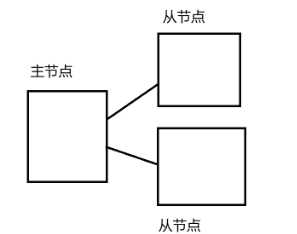
这里,我们需要注意一点:在Redis的主从模式中,从节点上的数据是不允许进行修改的,只能读取数据。所以说,主从模式,主要针对的是"读操作",对"读操作"进行了并发量和可用性的提高。但是对于"写操作"即主节点,无论是可用性还是并发性都是没有提高的。并且,主节点也不能同时搞多个。
通过上面的图我们可以发生,如果某个从节点挂了,那么基本不会有什么影响,我们可以继续从主节点或者其他从节点上读取数据,这是因为其他的从节点也都是先从主节点上读取数据,所以从汉主节点上读和从其他从节点上读没什么区别。但是如果注解点挂了,那么还是会有一点的影响的。
(三).配置
1.配置主从复制
(1).创建从节点
这里我们配置的时候,是在一台服务器上进行配置,同时运行多个redis-server进行,只需要博爱正这多个redis端口是不一样的即可。这里我们设置的是,一个主节点,两个从节点。我们可以直接在这两个从节点的不同的配置文件中设置不同的端口。
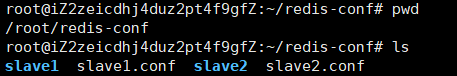
可以看到,我现在在我的服务器上的redis-conf文件夹中,将redis.conf配置文件复制了两份,一份是slave1.conf,一份是slave2.conf,表示这两个丛节点的配置信息。
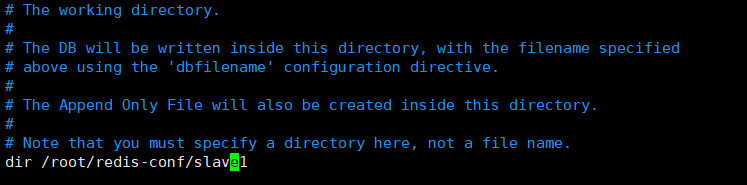
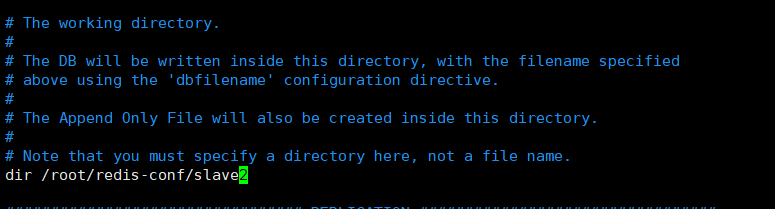
并且,分别将这两个从节点的工作目录进行重新指向,避免主节点和从节点使用同一个工作目录,导致后面出现新的问题
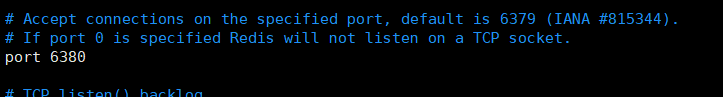
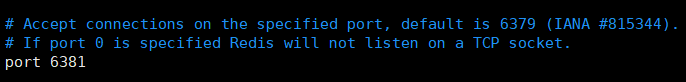
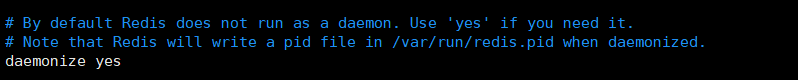

同时,针对这两个从节点使用新端口号,避免三个服务之间产生冲突。修改完节点之后,我们还需要将daemonize设置为yes,表示该服务按照后台进程的方式来运行。
(2).配置主从结构
将这些设置完成之后,这三个节点目前来说,还是没有任何关系的。要想建立主从关系,还需要我们进一步的配置。
这里,我们直接在slave1和slave2两个从节点的配置文件中添加slaveof 命令
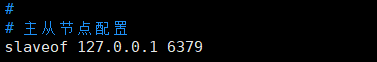
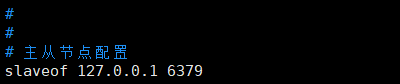
这里,我们默认6379这个端口为主节点,6380和6381这两个端口为从节点。127.0.0.1指的是主节点的地址,6379指的是主节点的端口。
事实上,我们可以通过3种方式来配置主从结构。
第一种是在配置文件中添加salveof,随着Redis服务的启动就会生效。
第二种是在redis-server启动的时候添加 --salveof 指令。
第三种是在redis服务中,使用redis命令 slaveof 127.0.0.1 6379
2.查看主从结构信息
(1).查看连接
配置完成之后,我们启动redis服务
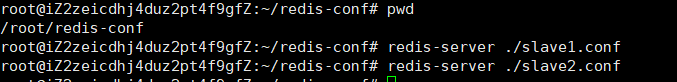
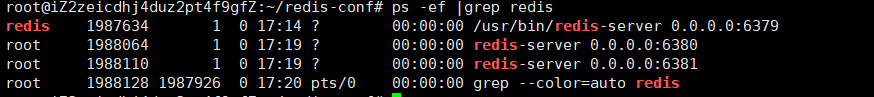
可以看到,我们已经成功启动了这三个节点
我们可以通过netstat -anp | grep redis命令来查看系统中和redis相关的连接,监听的端口以及对应的进程
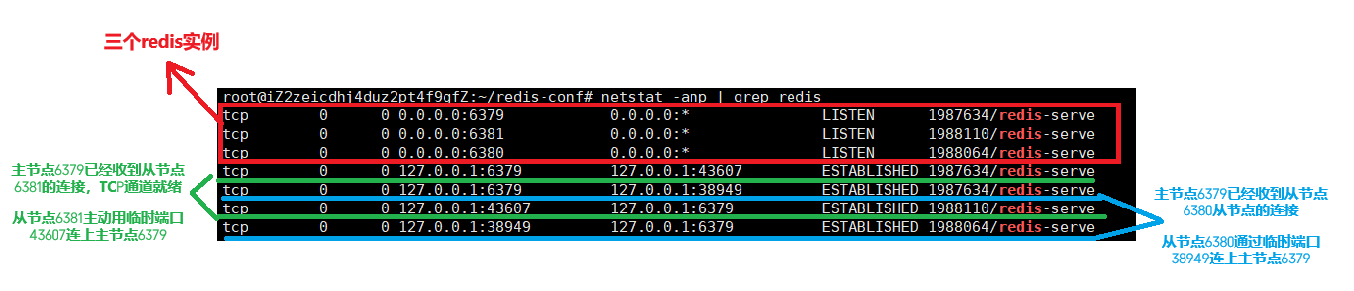
此时,主节点这边发生任何数据的修改,从节点都可以感受得到,这就是tcp连接起到的效果。
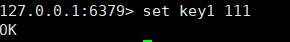
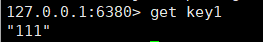
可以发现,从节点是可以感受到的

但是,从节点是不可以写操作的,只能进行读操作
(2).查看主从配置
我们可以在redis客户端中使用 info replication 命令来查看当前的主从配置信息
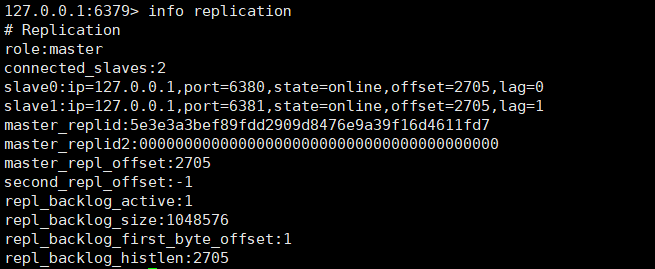
上图是主节点的配置信息
role表示当前节点的身份,master表示是一个主节点
connected_slaves表示连接的从节点的个数
slave0表示第一个从节点
offset表示主节点和从节点之间同步数据的进度。因为主节点会不断的收到新的数据以及修改数据的请求,那么从节点就需要从主节点这里同步这些请求,从节点和主节点之间的数据同步不是瞬间完成的,所以有了offset参数来标识同步的进度。如果从节点的offset值和master_repl_offset的值一样的话,则表示主节点和从节点之间同步数据的进度为100%了。
lag表示延迟时间,单位是秒
master_replid表示主节点复制ID,类似于我们的身份证号
master_replid2表示复制ID,用于主从切换(故障转移),这个在后面进行具体的介绍
master_repl_offset表示主节点自己的复制偏移量
second_repl_offset表示第二个复制ID对应的偏移量,-1表示未启用和master_replid2搭配使用
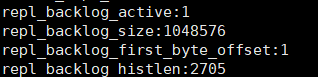
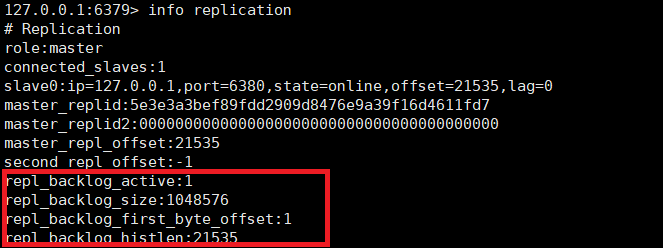
这些是关于积压缓冲区的相关属性,积压缓冲区支持部分同步机制的实现
repl_backlog_active表示复制积压缓冲区是否开启,1表示开启
repl_backlog_size表示复制积压缓冲区的大小
repl_backlog_first_byte_offset表示积压缓冲区里最早那条数据的偏移量
repl_backlog_histlen表示积压缓冲区里面有效数据长度2705字节
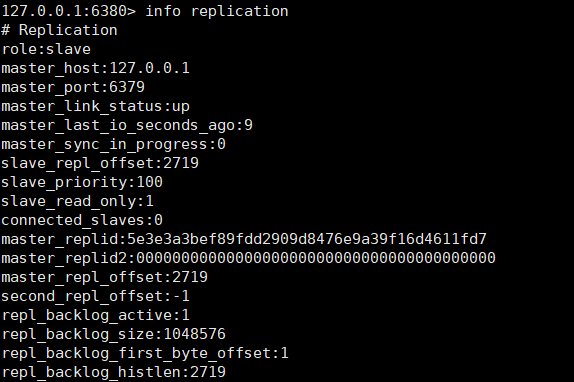
上图是从节点的配置
3.断开和修改主从结构
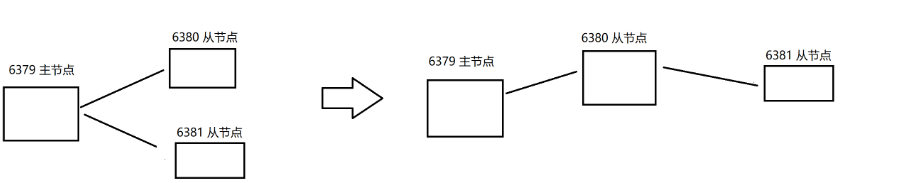
现在的状态是,6379这个节点为主节点,6380和6381这两个节点为从节点。现在,我想要断开6379和6381之间的主从关系,然后在6380和6381之间建立起主从关系,该如何进行操作?
我们依旧可以通过slaveof 命令 来进行操作。
首先,我们先登录到6381这个客户端
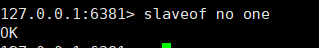
然后通过slave no one命令来断开和6379的主从关系
此时,在查看6379节点的主从配置信息
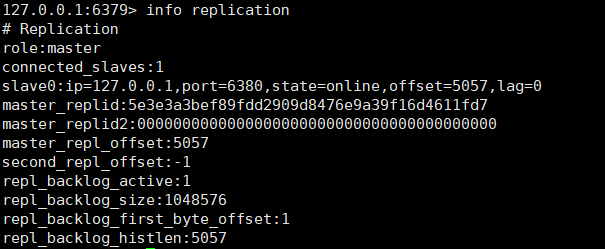
可以看到,从节点就剩下一个了
然后通过 slaveof 127.0.0.1 6380命令将6380和6381节点建立起主从关系
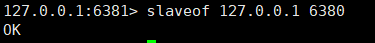
此时,我们再查看6380客户端的主从配置信息
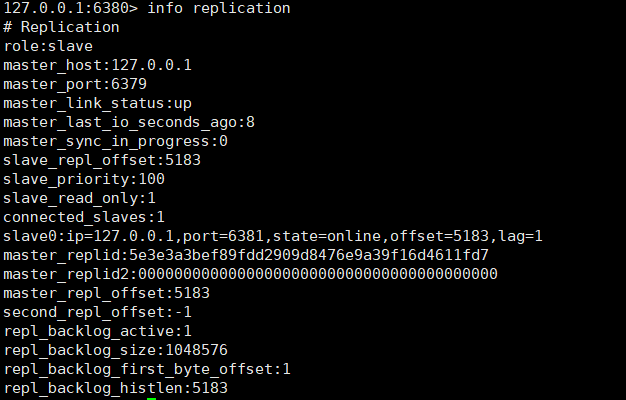
虽然6380这个节点依然为从节点,但是,可以看到,6380这个节点下面依然挂着一个从节点,这个从节点就是刚才的6381节点
4.安全,只读和传输延时等问题
(1).安全
主节点可以设置requirepass参数来进行密码验证,这时候所有的客户端访问必须使用auth命令进行校验。需要配置从节点的masterauth参数与主节点密码保持一致,这样从节点才能正确地连接到主节点并发起复制流程。
(2).只读
默认情况下,从节点使用slave-read-only=yes配置为只读模式,由于复制只能从主节点到从节点,所以主节点是感知不到从节点的修改的,如果从节点修改了数据,此时就会导致数据不一致问题,所以不建议关闭只读模式。
(3).传输延时
主节点和从节点之间是通过网络进行传输的,即TCP协议。TCP协议内部支持了nagle算法,并且默认是开启的状态。这个nagle算法,开启了就会增加tcp的传输延迟但是节省了网络带宽。我们可以通过repl-disable-tcp-nodelay参数用于控制是否关闭nagle算法, 默认是no,即开启了tcp-nodelay功能
(四).拓扑结构
拓扑结构,指的是,若干个节点之间,按照什么样的方式来进行组织连接,主要有三种:一主一从,一主多从,树状主从结构
1.一主一从
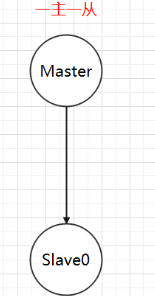
主节点即负责读数据也负责写数据。从节点只负责读数据
注意:如果写数据请求太多,导致主节点压力大,我们可以采取关闭主节点的AOF,只在从节点上开启AOF。但是这种方式有严重的缺陷,就是一旦主节点挂了,我们不能让主节点自动重启,因为主节点并没有AOF文件,然后进一步的主从同步,就会把从节点的数据也给删除了。我们只有让主节点从从节点这里获取AOF文件再启动的方式来避免这种问题的出现。
2.一主多从
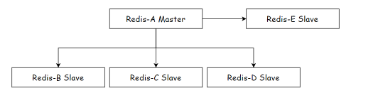
主节点上的数据发生改变,就会把修改的数据同步到所有的从节点。但是,随着节点数的增加,同步一条数据,需要被传输很多次,消耗更多的带宽。
3.树状主从结构
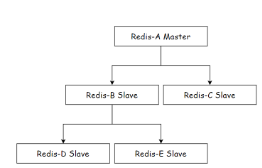
主节点不需要传输那么多次更新的数据了,也就不需要那么高的带宽了。但是,同步的演示要比刚才长了。
(五).主从复制原理
1.基本流程
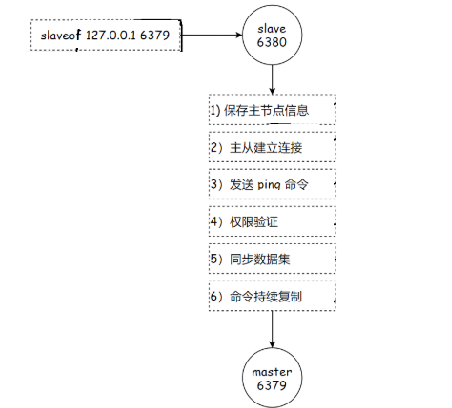
1).保存主节点的ip和端口号
2).主从建立连接,即TCP三次握手,验证主节点和从节点是否能够正确的读写数据
3).发送ping命令,验证主节点是否可以正常工作
4).如果redis主节点开启了密码,则需要进行权限验证
5).进行复制数据的操作,分为同步数据集和命令持续复制,同步数据集指的是全量同步,命令持续复制指的是增量同步。具体的在下面进行介绍
2.数据同步psync
(1).相关概念介绍
psync命令,不需要我们手动执行。当建立好主从复制关系后,从节点会执行psync命令,从主节点这边拉取数据。
语法:psync relicationid offset
如果 relicationid为?并且offset为-1,则表示全量复制。如果都设置了具体的值,则尝试部分复制
relicationid指的是主节点的复制id(replid),当主节点重新启动,或者从节点晋升为主节点的时候,都会生成一个replicationid,每次启动时都会发生变化。当从节点和主节点建立连接之后,从节点就会获取到主节点的replicationid。
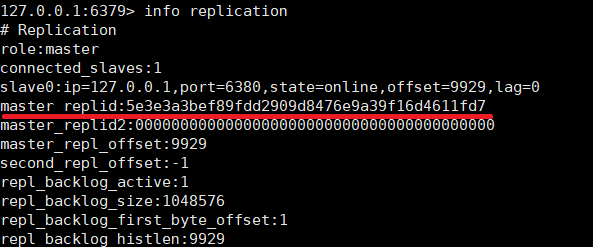
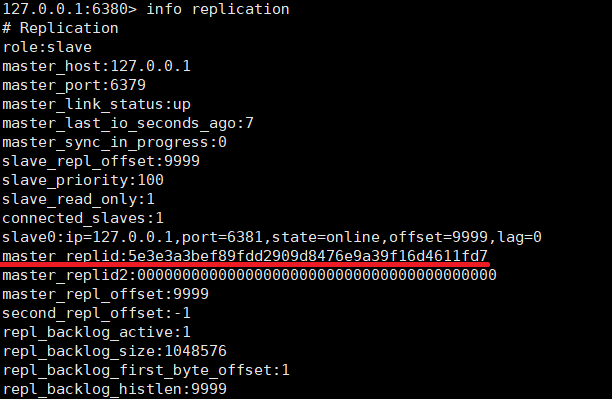
可以看到,主节点复制id和从节点获取到的主节点的复制id是一样的
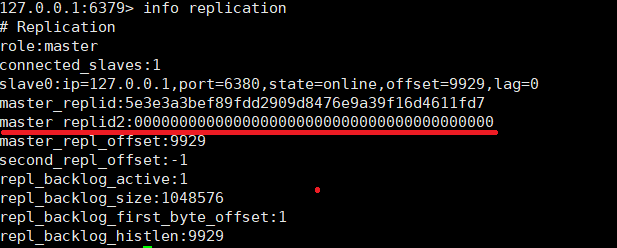
同时,也可以注意到,有一个master_replid2。一般情况下,这个master_replid2是用不到的。
例如,现在有A节点和B节点。A为主节点,B为从节点。此时B就会记录A的master_replid。如果A出现了网络抖动,导致B认为A挂了,此时B就会成为主节点,此时B就会给自己分配新的master_replid。然后B就会使用master_replid2这个属性来保存A的master_replid。等到后面网络恢复后,B就可以根据master_replid2找回之前的主节点A(哨兵机制可以自动完成这个过程,后面介绍)。如果网络没有回复,B就会按照新的master_replid自成一派,继续处理后续的数据。
offset指的是偏移量。主节点和从节点上都会维持这个偏移量。主节点的偏移量,主节点会收到很多的修改操作的命令,每个命令都会占据几个字节。主节点会把这些修改命令,每个命令的字节数进行累加。从节点的偏移量,就描述了从节点的数据同步到哪里了。
如果说,从节点的偏移量和主节点的偏移量一样,则表示从节点已经同步完成了。此时从节点存放的数据就和主节点一样了。
注意:从节点每秒钟上报自身的复制偏移量给主节点
总结:replid+offset共同标识了一个"数据集"。如果两个机器的replid一样,offset也一样,则就可以认为两个redis机器上存储的消息是一致的。
(2).执行流程
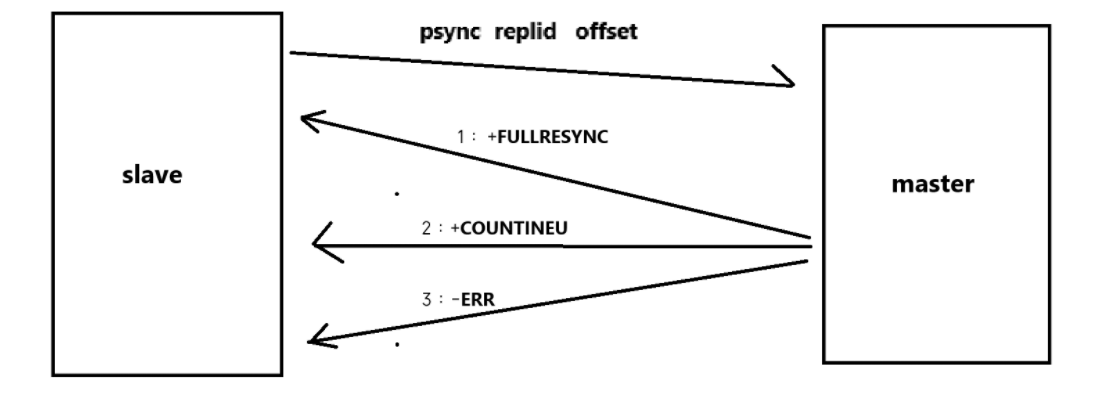
①.从节点发送psync命令给主节点,replid 和 offset的默认值为 ? 和 -1
②.主节点根据psync参数和自身数据情况决定响应结果:
如果回复+FULLRESYNC replid offset ,则从节点需要进行全量复制流程
如果回复+CONTINUE , 则从节点进行部分复制流程
如果回复 -ERR,说明Redis主节点版本过低,不支持psync命令
进行全量复制的情况:①.首次和主节点进行数据同步②.主节点不方便进行部分复制的时候
进行部分复制的情况:①.从节点之前已经从主节点复制过数据了,但是因为某些原因导致从节点重启了②.从节点需要重新从主节点这边同步数据,由于大部分数据一致,所以只同步一小部分
3.全量复制
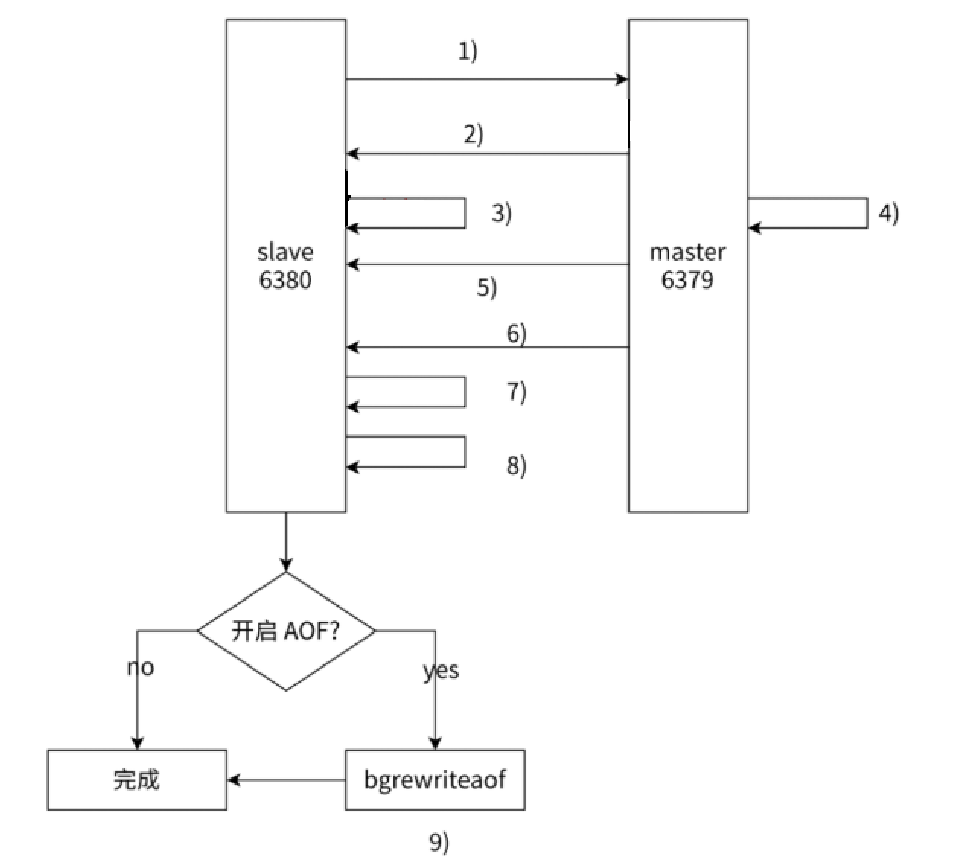
①.从节点发送psync命令给主节点进行数据同步,由于第一次复制,所以从节点没有主节点的运行ID和复制偏移量,所以发送psync ? -1
②.主节点根据命令,解析出要进行全量复制,回复 + FULLRESYNC响应
③.从节点接收主节点的运行信息并保存必要的信息
④.主节点执行bgsave命令,进行RDB文件的持久化
⑤.主节点发送RDB文件给从节点,从节点保存RDB数据到本地硬盘
⑥.主节点将从生成RDB到接收完成期间执行的写命令,写入到缓冲区,等从节点保存完RDB文件之后,主节点再将缓冲区内的数据补发给从节点,补发得分数据仍然按照RDB的二进制格式追加写入到收到的RDB文件中,保持主从一致性。
⑦.从节点清空自身原有的旧数据
⑧.从节点加载RDB文件得到与主节点一致的数据
⑨.如果从节点加在RDB完成之后,并且开启了AOF持久化功能,他会进行bgrewrite操作,得到最近的AOF文件。
缺点:主节点bgsave的时间,RDB在网络传输的时间,从节点清空旧数据的时候,从节点加载RDB的时间,都是比较耗时的
注意:主节点进行全量复制的时候,也支持"无磁盘模式",主节点生成的RDB的二进制数据,不是直接保存在文件中了。而是直接进行网络传输了,省下了读硬盘和写硬盘的操作。从节点之前也是先把收到的RDB数据写入到硬盘中,然后再加载,现在也可以省掉这个过程,直接把收到的数据进行加载了。
4.部分复制
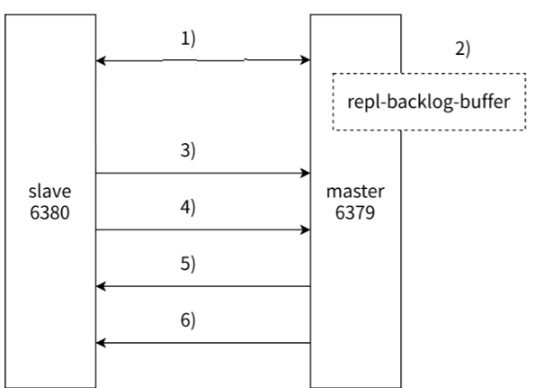
①.当主节点和从节点之间出现网络中断时,如果超过了repl-timeout时间,从节点会认为主节点故障并中断复制连接
②.主从连接中断期间,主节点依然响应命令,但是这些命令都因为网络问题无法发送给从节点,所以这些命令就会被滞留在积压缓冲区中
③.当主从节点网络恢复后,从节点再次连上主节点
④.从节点将之前保存的replicationid和offset作为psync的参数发送给主节点,请求进行部分复制
⑤.主节点接收到psync请求后,进行必要的验证,如果replicationid和当前主节点的replid一致,同时offset在复制积压缓冲区范围内,此时响应+CONTINUE给从节点,否则返回+FULLRESYNC,触发全量复制
⑥.主节点将需要从节点同步的数据发送给从节点,最终完成一致性。
复制积压缓冲区
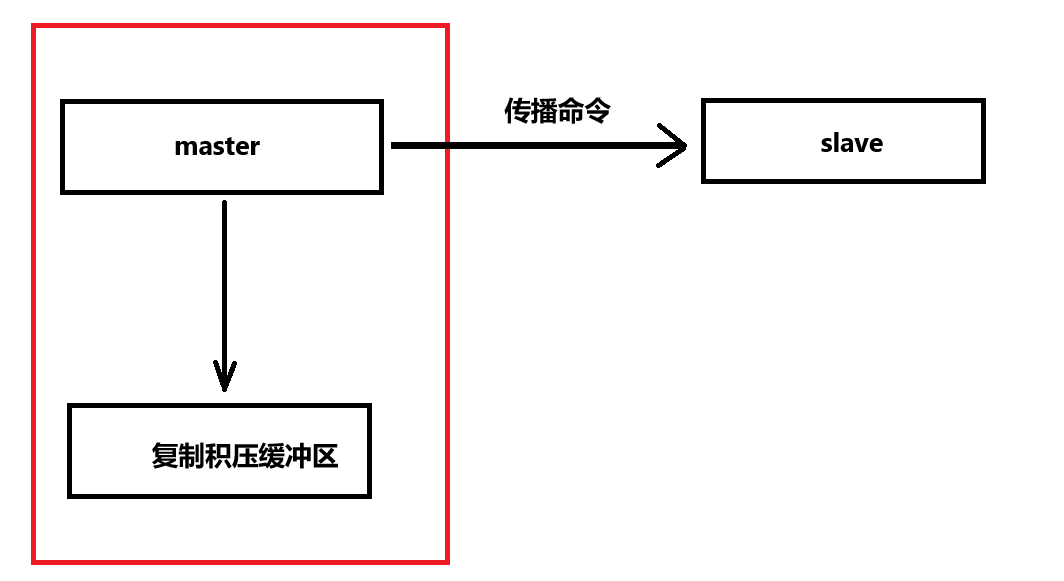
复制积压缓冲区,是保存在主节点上的一个固定长度的队列,默认大小是1MB,主节点响应写命令时,不但会把命令发送给从节点,还会写入复制积压缓冲区。复制积压缓冲区的相关统计信息可以通过主节点的info replication查看
5.实时复制
实时复制,指的是,从节点已经和主节点同步好了数据。但是之后,主节点这边会不断地收到新的修改数据的请求,此时,主节点上的数据就会发生变化,同时也需要同步给从节点。
丛节点和主节点之间会建立TCP长连接。然后主节点把自己收到的修改的数据的请求通过TCP长连接发送给从节点,从节点根据这些请求修改内存中的数据,这就是"实时复制"。
在进行实时复制的时候,也是需要保证连接处于可用状态。此时,对于TCP长连接,应用层采用的是"心跳包"机制。主节点默认10s给从节点发送一个ping命令,从节点收到就返回pong;从节点默认每隔1s就给主节点发送一个特定的请求,就会上报当前从节点复制数据的进度,即offset
6.replicationid 和 runid的区别
在一个redis服务器上,replicationid和runid是都存在的,两个不同的id长得非常类似。我们可以通过 info replication 看到applicationid , 可以通过 info server 看到 runid
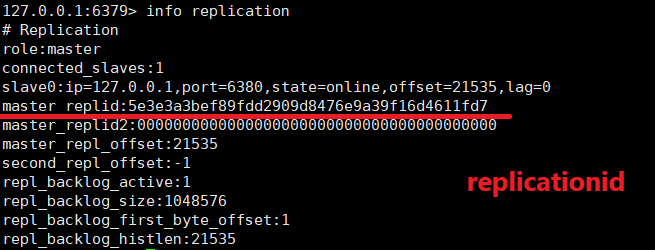
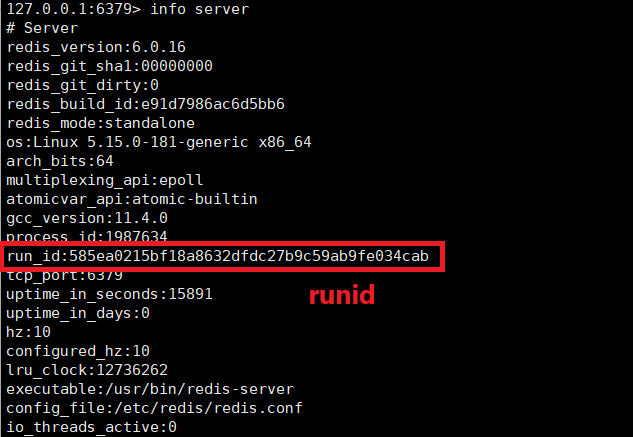
通过查看redis源码来看,runid主要是用来支撑实现redis哨兵功能的,replid主要是用来实现主从复制的
(四).总结
主从复制,最大的问题还是在"主节点"上。主节点挂了,那么从节点就无法更新新的数据了,虽然能够提供读操作,但是不能自动升级为主节点,不能替换原有主节点对应的角色。
在下一章,介绍Redis哨兵的时候,哨兵机制就会自动对挂了的主节点进行替换。
注意:如果是通过slave no one 命令,断开主从关系,那么从节点是可以晋升为主节点的。但是如果是主节点挂了,此时,从节点不会晋升为主节点,需要我们进行手动干预。