大家国庆假期快乐,文章较长,创作不易,咱们"下篇"预计在国庆末发布。
上篇的结尾,我们服务器手上已经躺着一个填好的
HttpRequest了。 它知道对方要什么方法、要哪个路径、带的什么版本、有哪些报头、有没有正文。但它还什么都没做。
中篇要回答的就是接下来这两件事:东西在哪,以及怎么答。
承接上篇
如果你是从上篇读过来的,可以直接往下走。如果你是单独打开这一篇的,这里用最短的篇幅补一下上文。
上篇讲的是"请求"这一侧:
   你在地址栏敲下字符串
        │
        ├─ URL 的七段结构(第二章)
        ├─ DNS 把域名翻译成 IP(第三章)
        ├─ TCP 三次握手搭上话(第四章)
        ├─ 报文的四段结构:请求行 / 报头 / 空行 / 正文(第五章)
        ├─ 服务器怎么从字节流里切出一条完整的报文(第六章)
        └─ 怎么把它装进 HttpRequest 结构体(第七章)
中篇接着往下走。第一步,是上篇留下的那个 _uri 字段:
class HttpRequest {
    std::string _method;                       // "GET"
    std::string _uri;                          // ★ "/index.html" ------ 中篇从这里开始
    std::string _version;                      // "HTTP/1.1"
    std::unordered_map<std::string, std::string> _header;
    std::string _blank_line;
    std::string _text;
};
_uri 只是一个字符串。而服务器需要的是一个能 open() 的磁盘路径。这两者之间的转换,就是中篇的开篇。
中篇导读:一次完整的问答
上篇回答的是"对方说了什么",中篇回答的是"我该怎么答"。
而"怎么答"这件事,比它听起来复杂得多。它至少要解决五组问题:
┌──────────────────────────────────────────────────────────────────┐
│  第一组:东西在哪?(第八章)
│
│    · /image/桃花.jpg  →  open() 的参数
│    · 中间要补 wwwroot、要处理 "/"、要防目录穿越
│    · 然后 open/read 这一路钻进内核:VFS → dentry → inode
│
│    ★ 上篇讲了"请求怎么来",这一章讲"请求怎么落到磁盘上"
├──────────────────────────────────────────────────────────────────┤
│  第二组:答的格式是什么?(第九 ~ 十章)
│
│    · 状态行 / 响应报头 / 空行 / 正文 ------ 和请求几乎对称
│    · 但 Build() 有两个真正的难点:
│      · target_file 怎么算出来
│      · 文件内容怎么读进 _text(而且不能读漏、不能读错)
├──────────────────────────────────────────────────────────────────┤
│  第三组:答得对不对?(第十一章)
│
│    · 200 / 301 / 302 / 404 / 500 ......
│    · 1xx~5xx 五大类,看一眼第一位就够
│    ★ 301 与 302 的一字之差,能让用户再也登不上账号
├──────────────────────────────────────────────────────────────────┤
│  第四组:答的是什么?(第十二章)
│
│    · 字节不会自解释 ------ 同一串字节,可以是 HTML,也可以是 PNG
│    · 靠 Content-Type 说清楚
│    ★ 顺便理解:为什么打开一个网页会发几十次请求
├──────────────────────────────────────────────────────────────────┤
│  第五组:参数怎么带、怎么保密?(第十三 ~ 十四章)
│
│    · GET 放 URI 上,POST 放正文里 ------ 差别只在位置
│    · 但这个"位置"带来了一连串现实后果
│    · 以及最根本的一个问题:明文传输
│    ★ 第十四章从网卡的混杂模式讲起,让你亲眼看到密码被读走
└──────────────────────────────────────────────────────────────────┘
走完这五组问题,一个能跑的 HTTP 服务器就完整了:它能收到请求、找到文件、拼出响应、发回去。
中篇的最后,我们还会回答一个上篇一直悬着的问题:为什么必须加密。
目录
- 第八章 从 URI 到磁盘:wwwroot 与 VFS
- 第九章 HTTP 响应:服务器怎么答
- 第十章 HttpResponse:Build() 的两大难点
- 第十一章 状态码:给机器看的数字,给人看的描述
- 第十二章 正文、Content-Type 与静态资源
- 第十三章 GET 与 POST:参数是怎么送到服务器的
- 第十四章 HTTPS:那个"加密版本"
第八章 从 URI 到磁盘:wwwroot 与 VFS
8.1 问题的起点:URI 只是一个字符串
现在服务器手里有一个字符串:
_uri = "/index.html";它似乎只是一个以 / 开头的字符串。
要把它变成一个真正的文件,中间隔着好几个问题:
问题一:这个 "/" 是什么的根?
        是 Linux 文件系统的根目录 "/" 吗?
        如果是,那 /etc/passwd 岂不是人人都能下载?!

问题二:如果 URI 只有 "/"(没有文件名),该返回什么?

问题三:把这个路径交给 open() 之后,内核是怎么找到文件的?
这三个问题,就是这一章的全部内容。
8.2 Web 根目录:为什么必须有 wwwroot
先看问题一,假设服务器直接把 _uri 拿去 open():
// ❌ 危险示范:绝对不能这么写
int fd = open(_uri.c_str(), O_RDONLY);
这句话意味着,URI 的 / 就等于 Linux 根目录的 /。
那么攻击者只要请求:
GET /etc/passwd        HTTP/1.1      ← 拿到所有用户列表
GET /etc/shadow        HTTP/1.1      ← 拿到密码哈希(如果有权限)
GET /proc/self/environ HTTP/1.1      ← 拿到进程的环境变量(可能含密钥)
整个文件系统就全部暴露了。
原文对这个问题的描述非常直接:
👈 如果这里不处理
_uri,即不做加g_wwwroot处理的话,会直接锚定到 Linux 家目录的"/"下,脱离了客户端希望的 Web 根目录下的资源!所以加上g_wwwroot是必须这么做的!
注意"脱离"这个词用得极准。 客户端心里的 / 和 Linux 心里的 /,根本就不是同一个 /:
   客户端以为的:
   /index.html   →   "服务器上那个放网页的目录里的 index.html"

   Linux 以为的:
   /index.html   →   "系统根目录下的 index.html"(这个文件根本不存在)

   ★ 两个 "/" 含义完全不同 ------ 这就是问题的根源
解决办法:给这个路径加一个前缀,把它"钉"在指定的目录里。
// 定义一个"Web 根目录"常量
const std::string g_wwwroot = "wwwroot";
原文说明了这个目录的用途:
/a/b/c/d.html是 Web 根目录 Web 根目录(wwwroot)的首页index.html前端工程师写的资源会直接放到www.root的位置
然后,在解析完 URI 之后做一次拼接:
// 把客户端的 URI,转换成服务器本地的真实路径
    _uri = g_wwwroot + _uri;
//  "/index.html"  ──►  "wwwroot/index.html"
//                           └──┬──┘ └────┬────┘
//                          Web 根目录   客户端要的文件
这一次字符串拼接,就是整个安全模型的关键一步。
拼接前:  /index.html                 ← 指向 Linux 根目录 ❌
拼接后:  wwwroot/index.html          ← 指向 Web 根目录 ✅
再看一次那个攻击,现在会发生什么:
GET /etc/passwd  →  _uri = "/etc/passwd"
                 →  拼接后 = "wwwroot/etc/passwd"
                 →  Web 根目录下不存在这个文件
                 →  返回 404 ✅
攻击被挡住了------不是靠过滤,而是靠"根本不给它走到别处的路径"。
一个安全设计的通用原则 :比起 "列出所有危险的输入然后禁止"(黑名单),更好的做法是 "只允许它走到允许的地方"(白名单 / 限定根目录)。
黑名单永远会漏,因为你想象不到所有的攻击方式;而限定根目录是结构性 的------攻击者无论输什么,都出不了这个目录。
不过要提醒一句:仅靠字符串拼接还不够。如果 URI 里含有:
../、wwwroot/../../etc/passwd仍然可能穿越出去。真正的服务器还需要做路径规范化 (把
../展开后再判断是否仍在根目录内)或者用openat+O_NOFOLLOW之类的系统调用加固。这和安全无关的..一样,是同一个"路径穿越"问题家族。
8.3 首页:为什么 / 要变成 /index.html
现在看问题二。
回到第五章 5.5 节那个真实报文:
GET / HTTP/1.1
    ↑
  URI 就是一个 "/"
/ 指的是 Web 根目录本身,它是一个目录,不是文件------文件内容没法返回一个目录啊。
所以服务器必须自己决定:当用户请求一个目录时,返回什么文件?
行业惯例是:返回这个目录下的 index.html。
原文的代码就是这么写的:
const std::string g_first_page = "index.html";   // 默认首页的名字

// 处理 URI
if (_uri == "/") {
    _uri += g_first_page;
    //  "/"  ──►  "/index.html"
}
_uri = g_wwwroot + _uri;
//  "/index.html"  ──►  "wwwroot/index.html"
两行代码,完成了两次意义不同的转换:
第一步:if (_uri == "/")  _uri += g_first_page;
        语义:把"请求目录"补全成"请求该目录下的默认文件"
        /  →  /index.html

第二步:_uri = g_wwwroot + _uri;
        语义:把"客户端视角的路径"翻译成"服务器视角的路径"
        /index.html  →  wwwroot/index.html
注意这两步的顺序不能颠倒 :
如果先加 wwwroot,_uri 就变成 wwwroot/,此时再判断 _uri == "/" 就永远不成立了。所以必须先补全文件名,再加根目录前缀。
index.html 这个名字不是随便起的,它是一套广泛遵守的约定:
Apache / Nginx / IIS ... 都默认找 index.html
(也有 index.htm、index.php、default.html 等变体,
  通常在服务器配置里可以修改这个列表)
这就是为什么你访问 www.example.com 而不写文件名,也能看到首页。
8.4 再往下钻一层:这个 read 在内核里发生了什么
好,现在服务器手里有了一个真实的路径:
wwwroot/index.html下一步就是把这个文件的内容读出来:
int fd = open("wwwroot/index.html", O_RDONLY);
read(fd, buf, size);
close(fd);
对应用层的我们来说,这一步到这就结束了。但既然这是一篇写给 Linux 学习者的文章,我们不妨再往下钻一层------看看 open 和 read 这两个调用,在内核里究竟走了一条什么路。
原文对 HTTP 的本质下过这样一个定义:
HTTP 超文本请求的本质:就是通过网络服务器把 Linux 机器上,特定目录下的文件,以 http 应答的方式返回给 client(浏览器或者 app)。 这个文件,可以是图片、音频,所以称 http 为超文本协议。
"Linux 机器上特定目录下的文件"------这半句话,就把 HTTP 和文件系统接了起来。
那么问题来了:
open("wwwroot/index.html", O_RDONLY)这一行,内核是怎么把它变成磁盘上的一块数据的?
8.4.1 第一层:VFS------为什么 open 能打开所有东西
先问一个前置问题:Linux 支持几十种文件系统(ext4、xfs、btrfs、proc、sysfs、tmpfs......),它们组织数据的方式完全不同。
但 open / read / close 只有一套接口。
这意味着内核里必须有一层"翻译官",把统一的接口翻译成各个文件系统的具体操作。这一层就是 VFS(Virtual File System,虚拟文件系统)。
      应用层        open("wwwroot/index.html")
                              │
                              ▼
┌──────────────────────────────────────────────────┐
│  VFS 抽象层                                       │
│  ↑ 统一接口:不管你是什么文件系统,都长这样         │
│  ────────────────────────────────────────────    │
│  向下分发:根据挂载点,找到是哪个文件系统           │
└──────┬───────────────────────┬───────────────────┘
       │                       │
       ▼                       ▼
   ext4 文件系统            proc 文件系统
   (磁盘上的真实文件)      (内核内存里的虚拟文件)
VFS 的核心思想,还是我们反复见到的那四个字:先描述,再组织。
内核对"打开的文件"这件事,设计了结构体去描述它。
8.4.2 struct file:一次"打开"的化身
先问需求:open() 返回一个 fd,用户拿这个 fd 去 read。内核需要记住什么?
① 我现在读到文件的哪个位置了?(读写偏移量)
   ↑ 这个必须每个"打开"单独记!
     因为同一个文件被打开两次,两个位置是各自独立的

② 我是用什么方式打开的?(只读?只写?追加?)
   ↑ 决定了这次 read/write 是否被允许、行为如何

③ 我对应的是哪个文件本身?
   ↑ 需要指向 inode
需求清楚,字段就出来了:
// include/linux/fs.h ------ 节选
struct file {
    loff_t              f_pos;      // ① 当前读写偏移量("我读到哪了")
    fmode_t             f_mode;     // ② 打开模式(O_RDONLY / O_WRONLY / O_RDWR ...)
    const struct file_operations *f_op;  // ☆ 函数表:这个文件的 read/write 该调谁
    struct dentry       *f_path.dentry;  // ③ 指向 dentry("文件名")
    struct inode        *f_inode;        // ④ 指向 inode("文件本身")
    unsigned int        f_flags;    // ⑤ 打开时的标志位(O_APPEND / O_NONBLOCK ...)
    atomic_long_t       f_count;    // ⑥ 引用计数(有几个 fd 指向我)
    // ...
};
几个字段值得多看一眼。
f_pos------为什么"打开"需要独立描述?
因为文件本身是共享的,但"读到哪了"是私有的。
进程 A 打开 log.txt,读到第 100 字节
进程 B 打开 log.txt,读到第 0 字节
        ↑ 同一个文件,两个独立的 f_pos,互不干扰
所以"打开"这件事必须有一个自己的结构体。这就是 struct file 存在的理由。
f_op------函数表,C 语言实现多态的经典手法。
这和我们讲 TCP 时见到的 proto_ops 是同一个套路:
// 一个普通磁盘文件的 read/write 会走到这里
const struct file_operations ext4_file_operations = {
    .read_iter = ext4_file_read_iter,   // read() 最终调它
    .write_iter = ext4_file_write_iter, // write() 最终调它
    // ...
};
你调用的 read() 是同一个符号,但最终执行的函数取决于这个文件是 ext4 的、还是 proc 的。 这就是 VFS 的味道。
一个细节:struct file 和"文件"不是一一对应的。
同一个文件被 open 两次  →  内核里有两个 struct file(两个 f_pos)
                       →  但它们指向【同一个 inode】
这一点非常关键,它是理解 fd、重定向、fork 共享文件偏移量的基础。
8.4.3 struct dentry:路径解析的缓存
下一个问题:open("wwwroot/index.html") 里的这串路径,内核怎么处理?
最朴素的办法是:从根目录开始,一层一层读磁盘,查找 wwwroot 目录、再查 index.html。但这样每次都要磁盘 IO,太慢了。
解法:把路径解析的结果缓存到内存里。
这个缓存就是 dcache ,它的节点就是 dentry(Directory Entry,目录项)。
需求分析:要缓存"一个路径节点",需要记住什么?
① 我叫什么名字?
② 我对应哪个文件(inode)?
③ 我的父目录是谁?(向上找)
④ 我的子节点有哪些?(向下找)
⑤ 我还在被使用吗?(引用计数)

// include/linux/dcache.h ------ 节选
struct dentry {
    struct inode    *d_inode;      // ① 指向对应的 inode("名字 → 文件"的桥梁)
    struct dentry   *d_parent;     // ② 指向父目录的 dentry(向上找爹)
    struct list_head d_child;      // ③ 挂在父目录的子节点链表上(找兄弟姐妹)
    struct list_head d_subdirs;    // ④ 自己子节点的链表头(向下找孩子)
    unsigned char    d_name[];     // ⑤ 文件名本身("index.html")
    unsigned int     d_count;      // ⑥ 引用计数(归零才能被回收)
    // ...
};
把这几个字段连起来看,你会发现一件事:
整个文件系统的目录结构,被组织成了一棵内存里的多叉树。
                    "/" (根 dentry)
                     │
        ┌────────────┼────────────┐
        ▼            ▼            ▼
     "home"       "etc"       "wwwroot"     ← 每个都是一个 dentry
                                   │
                                   ▼
"index.html" ← 叶子节点,也是一个 dentry这就是"第一次慢、第二次快"的原理:
第一次访问 wwwroot/index.html:
   逐级读磁盘 → 建 dentry → 全是磁盘 IO → 慢

第二次访问同一个路径:
   全部命中 dcache → 纯内存查找 → 快
对 HTTP 服务器来说,这意味着一个非常实际的现象:
服务器刚启动时,第一批请求会明显慢一些 (要建 dcache); 跑了一会儿之后,热门页面(比如首页)会一直很快(dcache 命中)。
8.4.4 struct inode:文件本身
最后,dentry 上的 d_inode 指向的那个东西------文件本身。
需求分析:描述一个文件,需要记住什么?
① 这个文件有多大?
② 它的内容存在哪些数据块上?
③ 它是谁创建的、权限是什么、什么时候改的?
④ 它是普通文件、目录还是设备文件?

// include/linux/fs.h ------ 节选
struct inode {
    umode_t             i_mode;     // ① 文件类型 + 权限(rwx、是不是目录)
    kuid_t              i_uid;      // ② 属主
    kgid_t              i_gid;      // ③ 属组
    loff_t              i_size;     // ④ 文件大小(字节)★
    struct timespec64   i_atime;    // ⑤ 访问时间
    struct timespec64   i_mtime;    // ⑥ 修改时间
    struct timespec64   i_ctime;    // ⑦ 状态改变时间
    const struct inode_operations *i_op;   // ⑧ 函数表
    const struct file_operations  *i_fop;  // ⑨ 默认的 file 操作
    struct super_block  *i_sb;      // ⑩ 属于哪个文件系统
    // ... 以及各文件系统自己的私有数据
};
注意这里的 i_size------它就是 HTTP 响应里 Content-Length 的数据来源!
服务器要把 wwwroot/index.html 的内容发回去,必须先告诉客户端"有多长"

    内核里:  inode->i_size  = 1024
                  │
                  ▼
    响应里:  Content-Length: 1024
这是一条从磁盘 inode 一路连到 HTTP 报头的完整链路。
再补一个反直觉的点(我们在文件系统那一章强调过):
文件名不属于 inode!
文件名存在目录的数据块 里(wwwroot 这个目录的数据块里,有一项是 "index.html" → inode 编号)。
为什么要这样设计?
因为一个 inode 可以被多个名字指向------这正是硬链接能存在的原因。
   "a.txt" ──┐
             ├──► 同一个 inode(同一份内容)
   "b.txt" ──┘
这个"名字与内容分离"的设计,就是 dentry 存在的意义:dentry 负责"名字"和"路径结构",inode 负责"文件本身"。
有关文件系统部分更详细的说明可以跳转链接🧐Linux 文件系统:磁盘结构、软硬链接、库文件与 ELF 格式-CSDN博客
8.4.5 把整条链路串起来
现在,把 open("wwwroot/index.html") 这行代码在内核里的完整旅程画出来:
   用户态:open("wwwroot/index.html", O_RDONLY)
        │
        ▼
┌──────────────────────────────────────────────────────────────┐
│  ①  VFS 层:路径解析
│      在 dcache 里找 "wwwroot" 的 dentry
│        → 命中?直接用
│        → 没命中?读目录数据块,建一个 dentry,挂进 dcache
│      再找 "index.html" 的 dentry
├──────────────────────────────────────────────────────────────┤
│  ②  拿到 dentry → 顺着 d_inode 拿到 inode
│      inode 里记着:文件多大(i_size)、内容在哪些数据块上
├──────────────────────────────────────────────────────────────┤
│  ③  分配一个 struct file
│      f_pos      = 0         (从文件开头开始读)
│      f_mode     = O_RDONLY  (只读)
│      f_op       = 该文件系统的函数表
│      f_inode    = 刚才那个 inode
├──────────────────────────────────────────────────────────────┤
│  ④  分配一个 fd(数组下标),把 fd 和 struct file 的对应关系
│      记进当前进程的 files_struct 里
│      → open() 把 fd 返回给用户态
└──────────────────────────────────────────────────────────────┘
        │
        ▼
   用户态:read(fd, buf, size)
        │
        ▼
┌──────────────────────────────────────────────────────────────┐
│  ⑤  fd → struct file → f_op->read_iter() → ext4 的实现
│  ⑥  ext4 根据 inode 里的块指针,算出这些数据在磁盘的哪些扇区
│  ⑦  向块设备层发起 IO 请求(可能命中页缓存,那就省一次磁盘 IO)
│  ⑧  数据从磁盘(或页缓存)拷回用户态缓冲区 buf
└──────────────────────────────────────────────────────────────┘
从这里再回头看 HTTP,你会发现一个很有意思的层次关系:
     HTTP  请求  ──►  一个 URI 字符串
                       │
                       ▼
     HttpRequest 里的 _uri  ──►  加上 wwwroot 前缀
                       │
                       ▼
     open()  ──►  路径解析(dentry / dcache)  ──►  inode
                       │
                       ▼
     read()  ──►  数据块  ──►  磁盘扇区(或页缓存)
                       │
                       ▼
     读到的字节  ──►  放进 HttpResponse 的 _text
                       │
                       ▼
     HTTP  响应  ──►  发回给浏览器
一条 HTTP 请求,起点是浏览器地址栏里的几个字符,终点是磁盘上的一块数据。这就是这条完整链路。
8.5 承上启下
好,现在服务器手里有文件内容了:
std::string body = "......index.html 的全部内容......";剩下的问题只有一个:怎么把它送回给客户端?
而且不只是"送回内容"这么简单。我们还欠客户端一些信息:
① 这次请求成功了吗?(还是失败了?)
② 内容多长?
③ 内容是什么类型的?(HTML?图片?)
④ 客户端该怎么理解它?
这些信息,就是下一章"HTTP 响应报文"要回答的内容。
第九章 HTTP 响应:服务器怎么答
9.1 一条铁律:不论成败,必须有应答
在讲格式之前,先记住一条铁律。原文是这么说的:
无论成功还是失败、如果网络没有问题,服务器没有挂掉,都必须有应答。
注意这句话里的两个前提条件,它们把"必须有应答"的边界划得很清楚:
条件一:网络没有问题
   → 如果网络断了,应答发不出去,那当然不算违反这条规则

条件二:服务器没有挂掉
   → 如果服务器进程直接崩了,连接被内核关闭,
     客户端会收到一个 RST 或 FIN,这也"算一种应答"
在满足这两个条件的前提下,"没有应答"是严重错误。
因为客户端会一直等:
   客户端                                 服务器
      │
      │  请求 ──────────────────────►
      │
      │  等待......                        (处理中......)
      │  等待......
      │  等到超时
      │  等到用户以为网站挂了
一个 HTTP 服务器最不应该做的事,就是"收到了请求但什么都不回"。
"必须有应答"这句话还有一个更深层的含义:
即使请求是错的、即使文件不存在、即使服务器内部出错了,也要回一个明确的响应,告诉客户端"出了什么问题"。
这就是状态码存在的意义------它是"失败也要好好说话"的机制。
9.2 响应报文的四段结构
现在看响应报文的格式。它和请求报文的格式几乎是镜像的:
┌──────────────────────────────────────────────────────────┐
│  状态行
│  ┌──────────┬──────┬────────┬──────┬───────────┬───────┐
│  │ HTTP版本   空格    状态码     空格   状态码描述    \r\n
│  └──────────┴──────┴────────┴──────┴───────────┴───────┘
├──────────────────────────────────────────────────────────┤
│  响应报头
│  ┌──────────────────────────────┬──────────────────────┐
│  │  Key: [空格] Value              \r\n
│  ├──────────────────────────────┼──────────────────────┤
│  │  Key: [空格] Value              \r\n
│  ├──────────────────────────────┼──────────────────────┤
│  │  ...(可以有任意多行)            \r\n
│  └──────────────────────────────┴──────────────────────┘
├──────────────────────────────────────────────────────────┤
│  空行
│  ┌──────────────────────────────────────────────────────┐
│  │  \r\n            ★ 同样是不可省略的分隔符
│  └──────────────────────────────────────────────────────┘
├──────────────────────────────────────────────────────────┤
│  响应正文
│  ┌──────────────────────────────────────────────────────┐
│  │  DATA  (HTML / CSS / 图片二进制 / ...)
│  └──────────────────────────────────────────────────────┘
└──────────────────────────────────────────────────────────┘
和请求报文对照着看,对应关系一目了然:
      请求报文                    响应报文
   ──────────────────      ──────────────────
    请求行                   状态行
    (方法 URI 版本)         (版本 状态码 描述)
        ↕                        ↕
    请求报头                 响应报头
        ↕                        ↕
    空行                     空行
        ↕                        ↕
    请求正文                 响应正文
第一段换了个名字(请求行 → 状态行),内容全变了,但整体骨架完全一致。
这正是同一个协议必然的设计:客户端和服务器的解析代码,结构上可以高度复用。
原文对响应正文有一句话,讲清楚了"正文里装的是什么":
正文:客户端申请的资源,html、css、图片、视频、音频等,以正文的形式返回来。
注意"客户端申请的资源"这个说法 ------正文的内容不是服务器随便给的,它必须是客户端在 URI 里点名要的那个东西。
这体现了 HTTP 的本质:
HTTP 就是"你要什么,我给你什么"------一个取文件的协议。
9.3 状态行:版本 + 状态码 + 状态码描述
状态行里也有三段,用空格分开:
HTTP/1.1 200 OK
   ↑      ↑   ↑
   │      │   └── 状态码描述(给人看的)
   │      └────── 状态码(给机器看的)
   └───────────── HTTP 版本(服务器自己的版本)
9.3.1 HTTP 版本:服务端的版本必须 ≥ 客户端
这个字段和请求行里的版本有一个关键区别,原文特意点出来了:
HTTP版本:服务端是什么版本的!服务端的版本必须≥客户端
对照第五章 5.3.3 里请求的版本:
请求行里的版本   →  是【客户端】的版本(客户端自报家门)
状态行里的版本   →  是【服务端】的版本(服务器自报家门)

约束条件         →  服务端版本 ≥ 客户端版本
为什么必须是"≥",而不是"相等"?
因为如果服务器的版本低于客户端,它就不具备客户端所期待的能力。
举一个具体的例子:
客户端说:"我是 HTTP/1.1,我要求长连接(keep-alive)"
服务器说:"我是 HTTP/1.0"
           ↑ 1.0 默认是短连接,可能根本不支持长连接
           → 客户端的期待落空了
所以服务器必须"至少和客户端一样新",才能满足客户端的期待。
而反过来是允许的:
客户端说:"我是 HTTP/1.0"
服务器说:"我是 HTTP/1.1"
           ↑ 服务器更新,它可以降级用 1.0 的方式和客户端说话
           → 完全没问题 ✅
这就是第五章讲的"向后兼容"在版本字段上的体现。
9.3.2 状态码与状态码描述:一个给机器,一个给人
原文对这两个字段的区分,说得非常清楚:
状态码:给机器看的数字 状态码概述:OK、Not Found ------ 给人看的
HTTP/1.1 200 OK
         ↑   ↑
         │   └─ 状态码描述:给人看的(人类可读的文字)
         └───── 状态码:给机器看的(程序判断用的数字)
为什么要有两份?
因为它们服务两个完全不同的读者:
    读者一:程序(浏览器、爬虫、前端 JS)
      它判断的是数字:  if (status == 200) { 正常显示 }
                        if (status == 404) { 显示"页面不存在" }

    ★ 程序不认文字,只认数字。因为文字可以被翻译、被修改、
      甚至可以写错,而数字是稳定的。

    读者二:人(开发者、运维)
      他看的是文字:"OK"、"Not Found"
      这些描述在调试时一眼就能看懂,不用去查表

      你在浏览器 F12 里看到的、在 curl 输出里看到的,
      都是这两者一起呈现的
一个实战经验:程序判断永远只看状态码,不要解析描述文字。
因为描述文字是可以被服务器自定义的:
HTTP/1.1 404 Not Found
HTTP/1.1 404 找不到这个页面          ← 某些服务器会改成中文
这两行的状态码完全一样,但描述不同。只会认数字的程序,两种都能处理。
9.3.3 状态码什么时候用
原文有一个很实在的提醒:
假设你请求的文件内容不存在呢?→ 状态码
也就是说,状态码不是装饰,它是错误处理的落点。
在 HttpResponse::Build() 里(下一章要讲),第一个要做的判断就是:
① 文件找得到吗?
    找得到  →  200 OK,正文 = 文件内容
    找不到  →  404 Not Found,正文 = 一个错误页面(或空)

② 用户有权限吗?
    有  →  继续
    没有  →  403 Forbidden

③ 服务器内部出错了吗?
    出错  →  500 Internal Server Error
每一个分支,都对应一个状态码。这就是为什么状态码必须存在------它是服务器"把话说清楚"的方式。
9.4 承上启下
到这里,响应报文的格式也讲完了。
现在我们把镜头切到服务端的代码实现上------如果把"造一个响应"这件事写成代码,它需要哪些字段?以及最难的两个地方在哪里?
这就是下一章的主题:HttpResponse 与它的 Build() 函数。
第十章 HttpResponse:Build() 的两大难点
10.1 先有需求,再有字段
还是那个方法:先说需求,再说字段。
需求分析:服务器要发回一条响应,需要记住哪些信息?
把第九章的响应报文结构拿过来看:
HTTP/1.1 200 OK                 ← 状态行:三段信息
Content-Type: text/html         ← 报头:不定数量
Content-Length: 1024
                                ← 空行
<html>...</html>                ← 正文
和请求的结构一一对应,所以字段也一一对应:
class HttpResponse
{
public:
    // ★ 核心接口:根据 Request 来完善自己
    void Build(HttpRequest &req);

    // 难点一:target_file 的获取(从 URI 来)
    // 难点二:如何分类并查看我们的目标文件的内容,放在 _text 中(ReadFile())

private:
    std::string _version;       // ① HTTP 版本:HTTP/1.1
    int         _code;          // ② 状态码:200 / 404 ...
    std::string _code_desc;     // ③ 状态码描述:OK / Not Found ...
    std::unordered_map<std::string, std::string> _header;  // ④ 响应报头
    std::string _blank_line;    // ⑤ 空行
    std::string _text;          // ⑥ 响应正文(文件内容都在这)
};
把它和 HttpRequest 并排放在一起,一眼就能看出这个协议的设计有多对称:
      HttpRequest                   HttpResponse
   ─────────────────────      ─────────────────────
    _method  (方法)            _code     (状态码)
    _uri     (URI)             _code_desc(描述)
    _version (版本)            _version  (版本)
   ─────────────────────      ─────────────────────
    _header  (请求报头)        _header   (响应报头)
    _blank_line(空行)          _blank_line(空行)
    _text    (请求正文)        _text     (响应正文)
第一行的三个字段,都是"行"里的三段信息;下面三个字段,都是"报头/空行/正文"。这就是"同一个协议的请求和响应"在数据结构上的必然对称。
注意 _code 用的是 int 而不是 std::string。
这和 _method 用 string 的选择正好相反,理由是:
_method  →  string   :因为方法名是【开放集合】,且代码里主要靠"原样传递"
_code    →  int      :因为状态码是【封闭的数字】,且代码里主要靠"数值判断"

    if (_code == 200) { ... }
    if (_code >= 400) { ... }     ← int 才能这么写
又一次"根据使用模式选类型"。
10.2 难点一:target_file 的获取
原文在这个类上标注了两个难点:
// 难点1 target_file 的获取(URI) 得到目标文件 // 难点2 如何分类并查看我们的目标文件的内容放在 _text 中。(ReadFile())
难点一,我们在第八章已经解决过了。 这里把完整的思路复述一遍:
void HttpResponse::Build(HttpRequest &req)
{
    // 第一步:拿到客户端要的资源(URI)
    std::string target_file = req.GetUri();

    // 第二步:把 URI 翻译成服务器本地路径
    if (target_file == "/") {
        target_file += g_first_page;      // "/" → "/index.html"
    }
    target_file = g_wwwroot + target_file;  // "/index.html" → "wwwroot/index.html"

    // 此时 target_file 就是"目标文件在服务器上的真实路径"
}
为什么说它是"难点"?
因为它不是一次简单的字符串拼接,而是完成了两次语义转换:
   客户端视角                   服务器视角
   ──────────                  ──────────
   "/"  ──────────────────────►  "wwwroot/index.html"
        ① 补全默认首页
        ② 加上 Web 根目录前缀

   ★ 这两步,把"一个逻辑上的请求"变成了"一个物理上的文件"
而这正是 8.4 节那条完整链路的起点:
   URI 字符串
      │  ← 难点一:翻译成真实路径
      ▼
   "wwwroot/index.html"
      │  ← 难点二:读进内存
      ▼
   _text
10.3 难点二:怎么把文件内容读进 _text
拿到路径之后,要做的事看起来很直白:
把 wwwroot/index.html 这个文件的内容,读到 _text 里去但真写起来,会发现一堆问题:
问题一:文件有多大?
        我得先知道大小,才能分配足够的空间

问题二:怎么读?
        一次 read 能读完吗?还是得循环读?

问题三:读不到怎么办?
        文件不存在?没权限?是个目录?

问题四:读进来之后呢?
        浏览器拿到的是一堆字节,它怎么知道这是 HTML 还是图片?
问题一、二、三属于"怎么正确读文件",用的是我们在文件 IO 那一章学过的标准手法:
// ReadFile 的典型实现思路(伪代码)
std::string ReadFile(const std::string &path)
{
    // ① 打开文件
    int fd = open(path.c_str(), O_RDONLY);
    if (fd < 0) {
        return "";              // ← 文件不存在/没权限,返回空
    }                           //   ★ 这个空返回,就是后面 404 的触发点!

    // ② 先拿到文件大小(用于 stat 之后分配缓冲区)
    struct stat st;
    fstat(fd, &st);
    size_t size = st.st_size;   // ← 这个值,最终会成为 Content-Length!

    // ③ 按大小读(注意:read 可能读不满,要循环)
    std::string content;
    content.resize(size);
    size_t total = 0;
    while (total < size) {
        ssize_t n = read(fd, &content[total], size - total);
        if (n <= 0) break;       // 出错或读到尾
        total += n;
    }

    // ④ 一定要关!(fd 是有限资源,不关会泄漏)
    close(fd);
    return content;
}
这里有三个细节值得单独点出来。
细节一:st.st_size 就是 Content-Length 的来源。
   内核的 inode->i_size
        │
        ▼
   stat 结构体的 st_size
        │
        ▼
   响应报头里的 Content-Length
一条从磁盘到报头的完整链路,这里终于闭上了环。
细节二:read 可能读不满。
这是 TCP 那一章留下的纪律。read 的返回值是"实际读到了多少字节 ",它可能小于你请求的字节数。所以必须用 while 循环读到够为止。
细节三:文件读不到时返回空字符串------这就是 404 的触发点。
   ReadFile 返回 ""
        │
        ▼
   _text 是空的
        │
        ▼
   ★ 服务器判断:"文件没读到,说明不存在"
        │
        ▼
   _code = 404;  _code_desc = "Not Found";
所以状态码不是在"事情发生后补一个数字",而是从代码的执行路径里自然长出来的。
问题四的答案,在下一章:Content-Type。
原文在这里有一个细节提醒:
// 应答部分不必带 Content Length,浏览器会自己做这件事
这句话的意思是:在我们自己实现的简易 HTTP 服务器里,即使响应报头里不写
Content-Length,浏览器往往也能自己处理 ------因为短连接模式下,服务器发完就close,浏览器读到 EOF 就知道"内容结束了"。但这不是规范推荐的做法。 在长连接模式下(
Connection: keep-alive),必须 带Content-Length或Transfer-Encoding: chunked,否则浏览器根本不知道"这一条响应到哪里结束",会一直等下去。所以:写代码时老老实实带上
Content-Length,是最稳妥的选择。
用一句话概括 Build() 的全过程:
   Build(req):
     ①  从 req 里取出 _uri
     ②  _uri 翻译成真实路径 target_file      ← 难点一
     ③  ReadFile(target_file) 读进 _text     ← 难点二
     ④  根据读取结果决定 _code / _code_desc
     ⑤  根据 _text 的内容决定 Content-Type
     ⑥  填充 _header
     ⑦  拼成一个完整的响应字符串,发回去
10.4 承上启下
到这里,Build() 的框架已经清楚了。但第 ④ 步"根据结果决定状态码"这件事,我们还欠一个完整的交代。
状态码到底有多少个?各自什么含义?什么时候该用哪个?
下一章,我们把状态码这张表完整地过一遍。
第十一章 状态码:给机器看的数字,给人看的描述
11.1 五大类:看一眼第一位就够
HTTP 状态码一共有几十个,但你永远不需要死记硬背------因为它们可以被"第一位数字"一刀切成五类。
┌──────┬───────────────┬──────────────────────────────────────┐
│ 类别      名称                        含义
├──────┼───────────────┼──────────────────────────────────────┤
│ 1XX  │ Informational    信息性状态码 ------ 接收的请求正在处理
│      │ 信息性状态码
├──────┼───────────────┼──────────────────────────────────────┤
│ 2XX  │ Success          成功状态码 ------ 请求正常处理完毕
│      │ 成功状态码
├──────┼───────────────┼──────────────────────────────────────┤
│ 3XX  │ Redirection      重定向状态码 ------ 需要进行附加操作
│      │ 重定向状态码      以完成请求
├──────┼───────────────┼──────────────────────────────────────┤
│ 4XX  │ Client Error     客户端错误状态码 ------ 服务器无法
│      │ 客户端错误        处理请求
├──────┼───────────────┼──────────────────────────────────────┤
│ 5XX  │ Server Error      服务器错误状态码 ------ 服务器处理
│      │ 服务器错误         请求出错
└──────┴───────────────┴──────────────────────────────────────┘
这张表有一个非常好用的记忆法:看第一位数字,就足以定位到责任方。
   1xx / 2xx / 3xx   →  一切正常,或者只是需要再走一步
   4xx               →  ★ 是【你的】问题(客户端)
   5xx               →  ★ 是【我的】问题(服务器)
这个"4 是你、5 是我"的划分,是排查问题时最重要的直觉。
用户:"网站打不开!"
你打开页面看到 404  →  4 开头 → 是客户端(用户)的错,链接写错了
你打开页面看到 500  →  5 开头 → 是服务端的错,去看服务器日志
原文还把"最常见的几个"单独拎了出来:
最常见的状态码,比如
200(OK)、404(Not Found)、403(Forbidden)、302(Redirect 重定向)、504(Bad Gateway)
这五个是日常调试里出场率最高的。
11.2 常考常查的十几个状态码
现在看完整的表。这张表不需要背,需要的时候回来查就行------但每一行的"应用样例"值得读一遍,因为它们把状态码和真实场景绑在了一起。
┌──────┬────────────────────────┬──────────────────────────────────────┐
│状态码           含义                      应用样例
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 100  │ Continue               │ 上传大文件时,服务器告诉客户端可以继续
│      │                        │ 上传
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 200  │ OK                     │ 访问网站首页,服务器返回网页内容
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 201  │ Created                │ 发布新文章,服务器返回文章创建成功的信息
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 204  │ No Content             │ 删除文章后,服务器返回"无内容"表示
│      │                        │ 操作成功
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 301  │ Moved Permanently      │ 网站换域名后,自动跳转到新域名;
│      │                        │ 搜索引擎更新网站链接时使用
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 302  │ Found 或 See Other        用户登录成功后,重定向到用户首页
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 304  │ Not Modified           │ 浏览器缓存机制,对未修改的资源返回
│      │                        │ 304 状态码
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 400  │ Bad Request            │ 填写表单时,格式不正确导致提交失败
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 401  │ Unauthorized           │ 访问需要登录的页面时,未登录或认证失败
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 403  │ Forbidden              │ 尝试访问你没有权限查看的页面
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 404  │ Not Found              │ 访问不存在的网页链接
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 500  │ Internal Server Error  │ 服务器崩溃或数据库错误导致页面无法加载
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 502  │ Bad Gateway            │ 使用代理服务器时,代理服务器无法从上游
│      │                        │ 服务器获取有效响应
├──────┼────────────────────────┼──────────────────────────────────────┤
│ 503  │ Service Unavailable    │ 服务器维护或过载,暂时无法处理请求
└──────┴────────────────────────┴──────────────────────────────────────┘
这张表里有几个点值得停下来想想。
其一:204 No Content 说明了一个重要的观念。
成功 ≠ 有内容返回。
删除一篇文章,操作成功了,但确实没有什么东西需要返回给客户端 。这时候用 204 表达"成功了,但正文是空的"。
其二:401 和 403 是两回事,很多人会混。
401 Unauthorized  →  "你没登录 / 你登录失败了" → 请先去登录
403 Forbidden     →  "你登录了,但你没权限"   → 登录也没用

★ 一个简单的判断法:
   401 → 缺的是"身份"
403 → 缺的是"权限"其三:502 和 503 也是两回事。
502 Bad Gateway       →  "我(代理)后面那个服务器出问题了" → 不是我的锅
503 Service Unavailable → "我自己出问题了(维护/过载)"      → 是我的锅

★ 用一个比喻:
   502 → 你是前台,你给后厨打电话,后厨没接
503 → 你自己病了,今天不营业其四:304 揭示了一个我们还没讲的重要机制------缓存。
浏览器缓存机制,对未修改的资源返回 304 状态码
这个机制是这样的:
   浏览器                                             服务器
      │
      │  "我之前存过 index.html,时间是 X"
      │ ──────────────────────────────────────►
      │                                          检查:这之后改过吗?
      │                                               没改过 ↓
      │  "304 Not Modified,你不用重新下载"
      │ ◄──────────────────────────────────────
      │
      │  直接用自己的本地缓存 ✅
服务器连正文都不用发,只回一个 304------这就是为什么第二次访问同一个网站会明显更快。
11.3 重定向:301 与 302 的分水岭
原文对 3xx 这一类的讲解最详细,因为它涉及一个必须分清的区别:
3xx 状态码: Moved Permanently(永久重定向)------ 更改客户端的认识 Found 或 See Other(临时重定向)------ 不会更改客户端的认识
"更改客户端的认识"这句话是理解重定向的关键。
先看重定向本身的机制。原文的描述是:
在访问时,服务端返回 302 告诉新的 Location 地址供其跳转 客户端返回 301,给 Location 通知客户端更改本地标签
机制的核心是 Location 报头------它和状态码配合使用:
HTTP/1.1 302 Found
Location: https://www.new-site.com/index.html
          ↑
      服务器在说:"你要的东西不在我这了,去这个地址拿"
浏览器收到这个响应后,会"自动"再发一次请求到 Location 指定的地址。 用户在地址栏里看到的,就是页面"自己跳过去"了。
那么 301 和 302 的区别在哪?就在"永久"和"临时"这两个词上。
┌──────────┬────────────────────┬──────────────────────────────────┐
│          │  301 永久重定向            302 临时重定向
├──────────┼────────────────────┼──────────────────────────────────┤
│ 语义       这个资源【永远】         这个资源【暂时】换了个位置
│            换到新地址了
├──────────┼────────────────────┼──────────────────────────────────┤
│ 客户端      ★ 应该记住新地址,     ★ 不应该改,还是用老地址
│ 的行为      以后直接用新的          下次访问还是发到老地址
├──────────┼────────────────────┼──────────────────────────────────┤
│ 典型场景    网站换域名了            用户登录成功后跳转到首页
├──────────┼────────────────────┼──────────────────────────────────┤
│ 对搜索      搜索引擎会把新地址      搜索引擎不会改,
│ 引擎的影响  当成正式地址,          原来的链接权重保持不变
│          │ 老的链接权重转移过去
└──────────┴────────────────────┴──────────────────────────────────┘
把这个区别讲透,最好用一个真实的场景。
场景一:301 用在哪?网站换域名。
老域名:www.old-site.com
新域名:www.new-site.com

用户访问 www.old-site.com  →  服务器回 301 + Location: www.new-site.com
                          →  浏览器把结果【记下来】
                          →  ★ 下次用户再输 www.old-site.com,
                             浏览器直接就去 www.new-site.com 了,连请求都不发

搜索引擎那边也一样 → 权重(SEO) 转移到新域名,老域名平稳退役
这就是原文说的"搜索引擎更新网站链接时使用"。
场景二:302 用在哪?登录成功后的跳转。
用户在 /login 提交账号密码
        →  验证通过
        →  服务器回 302 + Location: /home
        →  浏览器跳到 /home

★ 重点来了:这里【必须】用 302,不能用 301!

   因为"/login 成功后去 /home"这件事是【这次】的行为,
   不是"/login 这个地址永远变成了 /home"。

   如果用 301,浏览器会把 "/login → /home" 这个映射【永久缓存】下来。
   于是下次用户想【重新登录】时,浏览器直接把他送到 /home,
   根本不去 /login ------ 用户就再也登不了新账号了!
这是一个真实世界里的经典 bug,也是 301/302 必须分清的最实际的理由。
一句话总结:
301 是"我搬家了,以后都别来老地址了" 302 是"我今天不在家,你去隔壁找我,明天还来老地方"
补充一点:Location 这个报头不只用于 3xx。
原文对它的描述是:
Location:搭配 3xx 状态码使用,告诉客户端接下来要去哪里访问
"搭配 3xx 使用"是它的主要用途 ,这也是它的定义所在------Location 就是"下一个地址"。
11.3.1 动手实践:用 302 做一个"错误页跳转"
理解了 302,我们就能自己实现一个很常见的需求:
需求:用户访问了一个不存在的页面,不要只丢一个干巴巴的
404 Not Found,而是把他【跳转】到一个漂亮的错误页面。
代码长这样:
void SendNotFound(HttpResponse &resp) {
    // ★ 第一步:告诉浏览器"去 /404.html 看看"
    resp._code = 302;                          // 302,不是 301!
    resp._code_desc = "Found";
    resp._header["Location"] = "/404.html";    // ★ 去哪里

    // ★ 第二步:302 响应通常也带一个简短的正文
    resp._text = "<h1>页面不存在,正在跳转...</h1>";
}
浏览器收到之后的动作:
   ① 浏览器看到 302 + Location: /404.html
   ② ★ 立刻【自动】发起第二次请求:GET /404.html
   ③ 服务器返回 404.html 的内容
   ④ 地址栏【变成】 http://host:8080/404.html
这里有一个必须想清楚的取舍------为什么用 302 而不是在 404 响应里直接返回那段 HTML?
┌────────────────────────────────────────────────────────────────┐
│  方案 A:直接返回 404 + 错误页正文
│
│     GET /not-exist  →  404 Not Found
│                        正文 = <h1>页面不存在</h1>
│
│    ★ 优点:一次请求搞定,最快
│    ★ 缺点:错误页面的 HTML 必须【硬编码在 C++ 里】
│            想改文案就要重新编译服务器
│            而且每个 404 都重复传一遍 HTML
├────────────────────────────────────────────────────────────────┤
│  方案 B:302 跳转到 /404.html
│
│     GET /not-exist  →  302 Found, Location: /404.html
│     GET /404.html   →  200 OK, 正文 = 404.html 的内容
│
│    ★ 优点:错误页面变成一个【普通的静态文件】,
│            放在 wwwroot 里,改文案只要改文件,不用重编译
│    ★ 缺点:多一次请求往返
└────────────────────────────────────────────────────────────────┘
方案 B 的取舍,其实就是我们前面反复见到的那个思路:把一个"硬编码在代码里的东西"变成一个"可以由数据驱动的资源"。
这和第十八章的服务注册表是同一个思想------ 都是"让变化的部分待在代码外面"。
⚠️ 但是这里有一个非常容易被忽略的问题:用 302 做错误页,浏览器最终停在
/404.html,地址栏里显示的不是用户原本访问的那个地址。而且严格来说,搜索引擎会认为用户的错误页"跳转成功"了,不再报告 404 状态。
正确的做法是:返回 404 状态码,同时在正文里给出错误页面 (方案 A)------或者用服务端内部转发 (服务器自己把
/404.html的内容读出来、以 404 状态码返回),而不是让浏览器再发一次请求(方案 B)。我们这里用 302 演示,是因为它把"重定向是怎么工作的"讲得最清楚;但在真实项目里,错误页应该用 404 + 错误页正文。
11.4 为什么状态码不能自定义
原文在这里有一句话,说清了一个重要的工程纪律:
状态码和描述非自定义,是约定俗成的,直接
switch case就好。
"约定俗成"是关键词。 状态码非某个程序员拍脑袋定的,它是全世界共同遵守的一份清单。
为什么必须统一? 因为在 HTTP 的世界里,客户端和服务端是两个完全陌生的程序:
   你的服务器  ←→  别人的浏览器
   你的服务器  ←→  别人的爬虫
   你的服务器  ←→  别人的 API 调用方
如果状态码可以自定义,这套协作立刻就崩了:
服务器心想: "我要表示'文件不存在',就用 999 吧"
          → 浏览器收到 999:"这什么玩意?" → 当作未知错误处理
          → 爬虫收到 999:"404 的判断条件不成立" → 当作成功,把错误页存进了索引
所以状态码的价值,恰恰在于它是"事先约定好的共同语言"。
这句话对写代码的直接指导是:
// ✅ 正确做法:用标准状态码 + 标准描述
_code = 404;
_code_desc = "Not Found";

// ❌ 千万别这么做
_code = 404;
_code_desc = "你要的东西我这儿没有"; // 描述可以自定义吗?严格说:_code 绝对不能自定义,_code_desc 虽然允许自定义,但强烈建议用标准描述。
因为:
_code       →  ★ 程序判断全靠它,必须全世界统一
_code_desc  →  主要是给人看的,自定义的影响较小
               但用标准描述,能让开发者一眼认出、不用查表
原文说"直接 switch case 就好",就是这个意思:
// 状态码到描述的映射,就是一个简单的查表
switch (_code) {
    case 200: _code_desc = "OK";                    break;
    case 301: _code_desc = "Moved Permanently";     break;
    case 302: _code_desc = "Found";                 break;
    case 400: _code_desc = "Bad Request";           break;
    case 403: _code_desc = "Forbidden";             break;
    case 404: _code_desc = "Not Found";             break;
    case 500: _code_desc = "Internal Server Error"; break;
    // ...
}
这段代码不长,但它体现了一个原则:约定俗成的东西,就别自作主张。
11.5 承上启下
状态码讲完了,响应也就能完整地构造出来了。现在,一条响应发出去,长这样:
HTTP/1.1 200 OK
Content-Type: text/html
Content-Length: 1024

<html>...</html>
但这里还剩最后一个问题没回答:
浏览器收到这堆字节,它怎么知道这是一段 HTML,还是一张图片?如果是图片,是 PNG 还是 JPEG?
这就是 Content-Type 要解决的问题,也是下一章的主题。
第十二章 正文、Content-Type 与静态资源
12.1 什么是"静态资源"
先给一个概念下定义。原文是这么说的:
图片、视频、音频、css、js ------► 静态资源(你只需要获取即可) 音频、视频这里也视为静态资源,因为它们只是文件!
"你只需要获取即可"------这七个字点出了静态资源的本质。
静态资源的特征:
   ① 内容是【预先准备好】的,早就躺在磁盘上
   ② 服务器【不需要计算】,找出来发回去就行
   ③ 对任何人都返回【相同】的内容

典型的静态资源:
   .html  网页本体
   .css   样式表
   .js    JavaScript 脚本
   .png / .jpg / .gif / .webp    图片
   .mp4 / .avi                   视频
   .mp3 / .wav                   音频
   .json / .txt / .xml           数据与文本
   .woff / .ttf                  字体
原文特意加了一句话解释"为什么音视频也算静态资源",这其实是在纠正一种常见误解:
音频、视频这里也视为静态资源,因为它们只是文件!
很多人觉得"视频这么复杂,肯定不算静态资源吧"。不,判断标准不是"复不复杂",而是"要不要现场计算" ------一个 .mp4 文件,不也就是磁盘上的一串字节吗?服务器把它读出来发走就行了。
这个"静态"的划分标准非常重要,因为它决定了服务器的整个处理路径:
静态资源  →  找到文件 → 读出来 → 发回去           (简单,无状态)
动态内容  →  执行代码 → 查数据库 → 算出来 → 发回去  (复杂,有状态)
前者就是这一章的内容,后者在 12.5 节。
12.2 浏览器怎么知道收到的是一张图还是一段 HTML
现在问一个非常基础的问题:
一段字节,
<html><body>hello</body></html>,浏览器怎么知道要把它当网页渲染?另一段字节,
\x89PNG\r\n\x1a\n...,浏览器怎么知道要把它当图片显示?
答案是:靠 Content-Type 报头。
原文对这个问题的回答很直接:
浏览器怎么知道收到的 response 正文部分具体是什么格式的文件?
Content-Type:数据类型(text、html 等)(Content-Type 对照表)
HTTP/1.1 200 OK
Content-Type: text/html          ← ★ 这一行,告诉浏览器"当成网页处理"

HTTP/1.1 200 OK
Content-Type: image/png          ← ★ 这一行,告诉浏览器"当成 PNG 图片显示"
为什么必须要有这个字段?
因为字节本身不带自解释性:
   "12345"  是什么?  数字?字符串?还是文本文件的内容?
   ★ 字节流本身无法回答这个问题,必须由【外部信息】来标注

   这个"外部信息",就是 Content-Type
常见类型对照表:
┌────────────────────────────────────────┬──────────────────────────┐
│            Content-Type                           说明
├────────────────────────────────────────┼──────────────────────────┤
│  text/html; charset=utf-8              │  HTML 网页(最常见的)
│  text/css                              │  CSS 样式表
│  text/plain                            │  纯文本
│  application/javascript                │  JavaScript
│  application/json                      │  JSON 数据
│  application/xml                       │  XML
│  image/png                             │  PNG 图片
│  image/jpeg                            │  JPEG 图片
│  image/gif                             │  GIF 图片
│  image/svg+xml                         │  SVG 矢量图
│  video/mp4                             │  MP4 视频
│  audio/mpeg                            │  MP3 音频
│  application/octet-stream              │  ★ 未知的二进制流(兜底)
└────────────────────────────────────────┴──────────────────────────┘
注意 text/html; charset=utf-8 里的分号。
它是参数 ,用分号和主类型隔开。charset=utf-8 告诉浏览器"这段 HTML 用 UTF-8 编码"------否则中文会变成乱码。
这是实践中最容易踩的坑之一:Content-Type 写对了、但漏了 charset,中文网页就是乱码。
12.2.1 服务器怎么知道该填哪个?(靠后缀名)
现在换到服务器这一侧:服务器手里有一个文件 index.html,它怎么知道该填 text/html?
原文的答案是:
你怎么知道对应的返回资源是什么格式的(通过资源名称的后缀区分)
"通过后缀区分"------这是最简单也最通用的办法:
// 从文件后缀推断 Content-Type(思路示意,实际实现用 map 查表更清晰)
std::string GetContentType(const std::string &path)
{
    if (EndsWith(path, ".html") || EndsWith(path, ".htm"))
        return "text/html";              // 网页
    if (EndsWith(path, ".css"))
        return "text/css";               // 样式表
    if (EndsWith(path, ".js"))
        return "application/javascript"; // 脚本
    if (EndsWith(path, ".png"))
        return "image/png";              // PNG 图片
    if (EndsWith(path, ".jpg") || EndsWith(path, ".jpeg"))
        return "image/jpeg";             // JPEG 图片
    if (EndsWith(path, ".mp4"))
        return "video/mp4";              // 视频
    if (EndsWith(path, ".mp3"))
        return "audio/mpeg";             // 音频
    // ...
    return "application/octet-stream";   // ★ 兜底:不认识的,当二进制流
}
两个细节值得注意。
细节一:后缀名 → Content-Type 的映射,本质上是一张查找表。
真实的服务器(比如 Nginx)里有一份配置文件(mime.types),里面就是如下的对应关系:
types {
    text/html    html htm shtml;
    text/css     css;
    image/png    png;
    image/jpeg   jpeg jpg;
    ...
}
"通过后缀区分"就是这张表的全部逻辑。
细节二:一定要有兜底值。
不认识的类型  →  application/octet-stream
                 ↑ 意思是"我也不知道这是什么,你当二进制流处理吧"
如果没有兜底,遇到 .xyz 这种没见过的后缀,程序可能会返回空字符串或者崩溃,导致浏览器收到一个没有 Content-Type 的响应------它就只能靠猜了。
这也解释了原文那句关于"网页显示成花花绿绿的图案"的话:
假设我们的前端网页是储存在一个 html 后缀的文件中,那么请求端得到的文件在网页端显示时,就会被浏览器处理成花花绿绿的图案
"花花绿绿的图案"就是浏览器把 HTML 渲染出来的效果。 而让浏览器知道"要渲染"而不是"要显示源码"的,正是 Content-Type: text/html。
反过来的坑 :如果你把
Content-Type填成了text/plain,浏览器就不会渲染,而是把 HTML 源码原样显示出来。这是很多人第一次写 HTTP 服务器时踩过的坑------网页变成了一堆
<html><body>...的代码。
12.3 一个细节:响应为什么要带 Content-Length
在第十章我们提过一句原文的提醒,这里展开说清楚。
原文说:
// 应答部分不必带 Content Length,浏览器会自己做这件事
为什么"不必带"也能工作?
因为短连接模式下,连接关闭本身就是一种结束信号:
   服务器:发正文 → 发完 → close(fd)
   浏览器:一直读 → read 返回 0 → "哦,服务器关了,内容到此为止"

   ★ 在这种模式下,连接的关闭 = 内容的结束
但这句话有两个重要的前提,必须补上:
前提一:必须是短连接
   如果是长连接(Connection: keep-alive),连接【不会关闭】,
   浏览器就一直等,永远等不到那个 EOF ------ 页面卡死!

前提二:这种"靠关闭判断结束"的方式,无法区分【成功】和【失败】
   内容发到一半,服务器崩溃了,连接被关闭
   → 浏览器以为"内容收完了",实际上只收到一半
   → 用户看到的是一个残缺的、坏掉的页面
所以正确的做法是:
★ 老老实实带上 Content-Length。

   好处一:浏览器能精确知道"还差多少字节没收到"
   好处二:能识别"内容被截断了"
   好处三:长连接也能正常工作(这是现代 Web 的默认模式)
   好处四:可以做【下载进度条】------ 因为没有总长度就算不出百分比!
这就是为什么每个下载工具都要先看响应头------它要从 Content-Length 里拿到文件总大小。
12.4 页面的本质是一棵多叉树
现在说一个有意思的视角,原文的这句话值得单独拿出来:
页面的本质是一颗多叉树,每一次页面的切换就是一次 http 请求
<a>标签是跳转
"页面的本质是一棵多叉树"------这句话是什么意思?
看一段最简单的 HTML:
<html>
  <body>
    <div>
      <h1>标题</h1>
      <p>一段文字</p>
      <a href="/page2.html">点我跳转</a>
      <img src="/logo.png">
    </div>
  </body>
</html>
把它画成树结构:
            html
             │
           body
             │
           div
        ┌────┼────┬──────────┐
        ▼    ▼    ▼          ▼
       h1    p    a          img
                    │          │
                    ▼          ▼
              href=/page2.html  src=/logo.png
                    │          │
                    ▼          ▼
                一次 HTTP    一次 HTTP
                  请求         请求
这棵树揭示了三件事。
第一:HTML 本身就是一个树形结构。
这是 HTML 的语法本质------标签可以互相嵌套,形成一个层次结构。浏览器里的 DOM 树、CSS 选择器的匹配,全都是在这棵树上做的。
第二:树上的每一个"叶子资源",都对应一次 HTTP 请求。
   <a href="/page2.html">   →  点击时发一次 HTTP 请求
   <img src="/logo.png">    →  页面加载时发一次 HTTP 请求
   <link rel="stylesheet">  →  页面加载时发一次 HTTP 请求
   <script src="app.js">    →  页面加载时发一次 HTTP 请求
这就是为什么打开一个网页,你在 F12 的 Network 面板里会看到几十个请求,而不是一个。
每一个请求只带回一个资源。一个页面是几十次 HTTP 请求拼出来的。
原文给了一个具体的算法,叫"一个网页 = 1 + N 次请求":
   假设一个页面里嵌了 10 张图片:

   ① HTML 页面本身          →  ★ 1 次请求
   ② 10 张图片,每张一次     →  ★ N = 10 次请求
   ────────────────────────────────────────
   合计:                   →  1 + N = 11 次请求

   ★ 打开这一个页面,浏览器在网络上往返了 11 次。
把这个"1 + N"再往前推一步,就能解释一件很多人没想过的事:
┌────────────────────────────────────────────────────────────────┐
│  为什么"图片多的页面加载慢"?
│
│   不只是因为图片大(传输字节多),
│   更是因为图片多(★ 请求次数多)。
│
│   每一次请求都有【固定开销】:
│     · 排进浏览器同域并发队列里等(通常同域最多 6 个并发)
│     · 发一次 HTTP 请求报文
│     · 服务器处理、查磁盘、拼响应
│     · 传回来
│
│   ★ 哪怕每张图只有 1KB,11 次请求的"框架开销"
│     也可能比传图片本身还贵。
└────────────────────────────────────────────────────────────────┘
这也就解释了前端优化里那些看起来很怪的做法:
   · 精灵图(CSS Sprite)  → 把 10 张小图拼成 1 张大图
                             ★ 把 N 从 10 压到 1
   · 雪碧图 / 图标字体     → 同理
   · 文件合并(把多个 JS 合成一个)
                             ★ 把 N 次请求压到 1 次
   · 图片懒加载            → 没滚到的图先不请求
                             ★ 把 N 变小(只加载看得见的)
   · CDN 多域名           → 绕过"同域 6 并发"的限制
                             ★ 不是减少 N,而是让 N 个请求能并行
   · HTTP/2 多路复用       → 一条连接上并发跑完所有请求
                             ★ 从根上解决"请求次数多"的开销问题
顺带说一下,除了 <img>,还有一批标签的 src/href 同样会触发隐式请求:
   <img  src="...">            → 图片
   <video src="...">           → 视频(还有 poster 封面图)
   <audio src="...">           → 音频
   <link rel="stylesheet" ...>  → CSS
   <script src="...">           → JS
   <link rel="icon" ...>        → 标签页图标(要是不写,浏览器还是去要 /favicon.ico)
注意最后一行------这就是 6.2.1 节那个"服务器收到两次请求"现象的背后机制: favicon.ico 根本不是 HTML 里的标签触发的,而是浏览器 在你什么都没写的时候自己去要的。标签触发的请求是"显式"的,浏览器补的那个是"隐式"的。
第三:"每一次页面的切换就是一次 http 请求"。
   用户点击 <a>  →  浏览器发一次 HTTP 请求
                 →  服务器返回一个新的 HTML
                 →  浏览器丢掉旧的树,建一棵新的树
                 →  页面"切换"了
这就是传统网站(多页应用 MPA)的工作模式。
而现代的单页应用(SPA,比如用 React/Vue 写的)恰恰是要打破这一点:
   第一次请求:拿到一个大的 HTML + 一堆 JS
   之后的操作:不再请求新的 HTML
               而是用 JS 修改【已有的那棵树】(DOM 操作)
               → 页面"看起来切换了",但其实没有发生页面级跳转
               → 只发一些小的数据请求(AJAX / Fetch)
理解"页面的本质是一棵树",是理解这一切的基础。
12.5 动态站点:从"取文件"到"做计算"
前面讲的都是静态资源:服务器只需要"找文件、读出来、发回去"。
但真实的网站远不止于此。原文给出了对照的概念:
动态站点 → 站点支持和用户进行交互 → 登录、注册、支付、查找
对照着看这两类站点的区别:
┌──────────────┬──────────────────────┬────────────────────────────┐
│              │      静态站点                  动态站点
├──────────────┼──────────────────────┼────────────────────────────┤
│ 内容来源          磁盘上的现成文件        程序【现场计算】出来的
├──────────────┼──────────────────────┼────────────────────────────┤
│ 服务器做什么     找文件 → 读 → 发        执行代码 → 查数据库 →
│                                        拼出内容 → 发
├──────────────┼──────────────────────┼────────────────────────────┤
│ 同样的 URL      永远返回                 可能返回不同内容
│ 返回           【相同】的内容           (取决于用户、时间、参数)
├──────────────┼──────────────────────┼────────────────────────────┤
│ 典型代表        一个介绍页、一张图片      登录、注册、支付、搜索
├──────────────┼──────────────────────┼────────────────────────────┤
│ 对服务器的      很小                     很大(要跑代码、连数据库)
│ 要求
└──────────────┴──────────────────────┴────────────────────────────┘
看一个具体的例子就清楚了。
场景一(静态): 用户请求 /logo.png
   服务器:在 wwwroot 下找 logo.png
        →  找到了
        →  读出来
        →  原样发回去
   ★ 无论谁来请求、请求多少次,返回的都是同一张图
场景二(动态): 用户请求 /user/profile
   服务器:这不是一个文件!
        →  交给后端程序处理
        →  程序去问:"这是哪个用户?"(看 Cookie / Session)
        →  去数据库查这个用户的信息
        →  拼成一段 HTML
        →  发回去
   ★ 张三来请求,返回张三的资料;李四来请求,返回李四的资料
     同一个 URL,返回的内容【每次都不一样】
"登录、注册、支付、查找"------这四个场景全都属于这一类。
为什么?因为它们都依赖"用户是谁"这个信息:
   登录  →  要验证这个用户名密码对不对
   注册  →  要往数据库里插一条新记录
   支付  →  要扣这个用户的钱、给那个商家加钱
   查找  →  要根据关键词去数据库里搜
这些都不是"磁盘上有一个现成的文件",而是"跑一遍程序算出来的"。
理解这个区别,是理解后面框架(CGI、FastCGI、Servlet、各种 Web 框架)的起点。
而对于我们这篇文章来说,重点只在于:
静态资源走"取文件"这条路,动态内容走"执行程序"这条路。
接下来的第八章到第十三章,我们实现的都是前一条路。
而"后一条路"------服务器怎么知道 /user/profile 该交给哪段代码去执行------我们在第十八章专门回答。 到那时候你会发现,它并不需要把整个服务器重写一遍,只要往一张表里加一条记录就够了。
12.6 承上启下
到这里,一条完整的 HTTP 响应就构造完毕了:
   HTTP/1.1 200 OK
   Content-Type: text/html; charset=utf-8      ← 告诉浏览器怎么理解
   Content-Length: 1024                        ← 告诉浏览器有多长
                                               ← 空行
   <html>...</html>                            ← 正文
客户端已经把资源拿到手了。剩下的渲染工作,是浏览器的事------那属于前端领域,不在本文范围内。
现在,我们回头看一条之前一直没细讲的主线:
GET 和 POST 到底有什么不同?
用户在表单里填的数据,是怎么变成 HTTP 请求的一部分的?
这就是下一章的主题。
第十三章 GET 与 POST:参数是怎么送到服务器的
13.1 表单:浏览器替你拼请求
前面我们一直在讲"服务器怎么处理请求"。
现在换一个视角,回到客户端这一侧,问一个问题:
用户在网页上填的那些信息,是怎么变成 HTTP 请求的?
看一段最朴素的 HTML:
<!DOCTYPE html>
<html>
<body>
  <form>
    First name:<br>
    <input type="text" name="firstname">
    <br>
    Last name:<br>
    <input type="text" name="lastname">
  </form>
</body>
</html>
这段 HTML 在浏览器里渲染出来,就是两个输入框:
   First name:
   ┌──────────────────────┐
   │ ssss                 │
   └──────────────────────┘
   Last name:
   ┌──────────────────────┐
   │ aaaaaa               │
   └──────────────────────┘
原文对这张图有一句批注,很有意思:
请注意表单本身是不可见的。 同时请注意文本字段的默认宽度是 20 个字符。
"表单本身是不可见的"------这句话说的是:
<form>
   ↑ 这个标签【不会】在页面画出任何东西

  它只是一个【逻辑容器】,用来圈定"哪些输入框属于同一组"
  真正画出来的,是它内部的 <input> 标签
这是一个很多人第一次写网页时会困惑的点:为什么我写了 <form> 却什么都没看到?因为 <form> 本身就是不可见的。
那么,用户填写这些框、然后点提交,会发生什么?
原文的描述是:
前端网页中,会有表单,用户填写表单,浏览器自动提取表单里面的内容 构建带参的 http request
关键词是"自动"。
   用户做的事:
      ① 在两个框里打字
      ② 点"提交"按钮

   浏览器做的事(全是自动的!):
      ① 从表单里【提取】所有 <input> 的 name 和用户填的 value
      ② 按某种规则【拼装】成一个 HTTP 请求
      ③ 发出去
也就是说:用户只需要打字,浏览器负责把这些字变成符合 HTTP 规范的报文。
这段话里有一个关键线索:"那些 <input> 的 name 属性":
<input type="text" name="firstname">
                    ↑
              这个 name,就是参数的名字!

用户填的内容:  ssss
那么拼出来的参数就是:  firstname=ssss
name + 用户输入的值 = 一个键值对。这就是"传参"的原始形态。
而"拼装"这一步,具体拼到哪里去?
答案是:取决于表单用什么方法提交。这就是 GET 和 POST 的分水岭。
13.2 GET:参数挂在 URI 上
原文的第一个结论:
结论1:GET 方法可以常用来获取静态资源,同时也可以用来向目标服务器传递参数。 通过 URI 方式进行传递参数!
"通过 URI 方式"------也就是挂在 URL 的查询字符串那一部分:
GET /submit?firstname=ssss&lastname=aaaaaa HTTP/1.1
           └─────────────────────────────────┘
                      参数挂在这里!
                   (URL 的查询字符串部分)
拆开看这个链接:
   /submit          ← 请求的路径(URI 里不含参数的部分)
   ?                ← 分隔符:参数部分从这里开始
   firstname=ssss   ← 第一个键值对
   &                ← 键值对之间的分隔符
   lastname=aaaaaa  ← 第二个键值对
所以 GET 传参的完整形态是:
URI?key1=value1&key2=value2&key3=value3服务器拿到这个请求后,要自己从 _uri 里把参数切出来:
// 服务器端解析 GET 参数的思路
// _uri = "/submit?firstname=ssss&lastname=aaaaaa"

size_t pos = _uri.find('?');
if (pos != std::string::npos) {
    std::string path  = _uri.substr(0, pos);      // "/submit"
    std::string query = _uri.substr(pos + 1);     // "firstname=ssss&lastname=aaaaaa"

    // 再按 & 切分,按 = 取值......
    // ★ 别忘了:取到的值可能还是 URL 编码的,要 Decode!
}
//GET 请求把参数序列化到 URL 的查询字符串里;服务器解析 HTTP 请求报文时,从请求目标中把路径和查询串拆出来,再解析出参数。
注意最后那句提醒------回到第三章讲的 URL 编码。
如果用户在输入框里填的是 "张 三",那它会被编码成 %E5%BC%A0%20%E4%B8%89 挂到 URI 上。服务器取出来之后必须 Decode,才能拿到真正的内容。
这就是"浏览器自动提取"里被省略掉的细节:它不仅提取,还做了编码。
13.3 POST:参数装进正文里
原文的第二个结论:
结论2:POST 可以用来向目标服务器传参,传参的方式是通过正文部分传参的!
对照 GET,区别只在"参数放哪":
【GET】参数放这里 ↓
   GET /submit?firstname=ssss&lastname=aaaaaa HTTP/1.1
   Host: 115.190.145.241:8080
                              ← 没有正文(空行之后就是空的)

【POST】参数放这里 ↓
   POST /submit HTTP/1.1
   Host: 115.190.145.241:8080
   Content-Length: 30
   Content-Type: application/x-www-form-urlencoded
                              ← 空行
   firstname=ssss&lastname=aaaaaa    ← ★ 参数在正文里!
原文有一句话把两者的区别总结得非常精炼:
那么如果是 GET 或 POST 的方法,他们两个只有一点不一样,就是传参位置上不一样。 GET 的方法通过 URI 传参,POST 的方法通过正文传参。
"只有一点不一样,就是传参位置不一样"------这句话要好好理解,因为它打破了一个常见的误解。
一个常见的误解是:
"GET 和 POST 是两个完全不同性质的东西,一个是取数据,一个是提交数据。"
更准确的看法是:
★ 从"服务器如何处理"的角度看,两者确实不同:
     GET  → 一般是"我要取东西"
     POST → 一般是"我要交东西"

★ 但从"报文结构"的角度看,两者【结构完全一样】:
     GET   = 请求行 + 报头 + 空行 + (没有正文)
     POST  = 请求行 + 报头 + 空行 +  (正文里放着参数)

  它们的差别,只是"有没有正文、正文里放什么"
这也解释了为什么 Content-Length 在 POST 里是必须的:
   GET  通常没有正文  →  不需要 Content-Length
   POST 一定有正文    →  ★ 必须有 Content-Length
                          否则服务器不知道正文有多长(第六章讲过)
再注意 POST 里那个 Content-Type: application/x-www-form-urlencoded。
它说的是"正文里的数据格式是 URL 编码的表单数据"。注意这个词里的 urlencoded------参数在 POST 的正文里,用的还是 URL 编码的格式。
所以第三章讲的 URL 编码,在 GET 和 POST 里都会用到,只是位置不同。
13.4 两条结论
现在把这一章的内容收拢成两条结论(原文就是这么组织的):
┌─────────────────────────────────────────────────────────────────┐
│  结论一:GET
│    ① 常用来获取静态资源(图片、CSS、JS、HTML......)
│    ② 也可以向目标服务器传递参数
│    ③ ★ 传参方式:【通过 URI】
│       /submit?key1=value1&key2=value2
├─────────────────────────────────────────────────────────────────┤
│  结论二:POST
│    ① 用来向目标服务器传参
│    ② ★ 传参方式:【通过正文部分】
│       参数放在空行之后的 DATA 区域里
│       并且必须带 Content-Length 报头
└─────────────────────────────────────────────────────────────────┘
最后补两条实践层面的提醒。原文在这两点上说得很克制,我们把它们展开说清楚。
提醒一:关于"私密性"------原文有一个精确的措辞
   GET  的参数暴露在 URL 里  →  会被记录在:
                                  · 浏览器地址栏(旁边的人能看见)
                                  · 浏览器历史记录
                                  · 服务器访问日志(access.log)
                                  · 中间代理的日志
                              →  ★ 所以【绝对不能】用它传密码、验证码

   POST 的参数在正文里       →  浏览器只显示请求的服务,不显示正文数据
                              →  ★ 所以 POST 传参【更私密】
注意上面用的词是"更私密",不是"更安全"。
为什么这个措辞必须精确?因为"私密"和"安全"防的是两种完全不同的人:
┌────────────────────────────────────────────────────────────────┐
│  "私密" 防的是【旁边的人】
│
│    · 站在你身后看屏幕的同事
│    · 翻你浏览器历史的人
│    · 事后翻服务器日志的人
│
│    POST 能做到 ✅ ------ 因为密码根本没进地址栏、没进历史、没进日志
├────────────────────────────────────────────────────────────────┤
│  "安全" 要防的是【路上的设备】
│
│    · 同一个局域网里开了混杂模式的网卡(14.1.1 节)
│    · 途中的每一台路由器、运营商设备、代理
│
│    POST ❌ 完全做不到!
│    POST 的正文和 GET 的 URL 一样是【明文】,
│    抓包工具一抓就是一整个用户名密码。
└────────────────────────────────────────────────────────────────┘
一句话总结:POST 只是"不摆在台面上",不是"锁起来了"。真正的安全要靠 HTTPS(下一章)。
提醒二:URL 有长度限制
   GET 把参数塞在 URL 里  →  URL 本身是【有长度上限】的

   · HTTP 协议规范本身【没有】规定 URL 长度的上限
   · 但【浏览器】和【服务器】各自设了限制:
       - 浏览器地址栏一般能处理到几千到几万字符(各浏览器不同)
       - 很多服务器的 URL 处理缓冲是 8KB 左右(如常见的 8190 字节)
       - 常见的经验安全线:2KB 以内最稳
   · 超过之后的表现往往是:截断、返回 414(URI Too Long)或 400

   ★ 结论:传大数据(上传文件、长文本、表单批量提交)必须用 POST
      因为正文的长度由 Content-Length 说了算,没有 URL 那种限制
把这两条提醒合起来看,GET 和 POST 的取舍就变成了一张很清晰的表:
| 对比项 | GET | POST |
|---|---|---|
| 参数位置 | 通常在 URL 查询串:?k=v&k=v;也可有 body,但不推荐 |
通常在请求体 body;也可在 URL 查询串 |
| 地址栏回显 | 查询串会显示在地址栏 | 不显示 |
| 浏览器历史 | 完整 URL 会进历史 | 一般不进历史,除非前端自己记录 |
| 服务器/代理日志 | URL 默认容易进访问日志、Referer | body 默认不一定记录,但可配置记录;URL 部分仍会进日志 |
| 长度限制 | HTTP 协议无硬限制;浏览器/服务器/代理有实现限制,约 2KB 是旧经验安全线 | HTTP 协议无硬限制;实际受服务器配置、超时、内存等限制 |
| 收藏/分享 | 链接自带参数,可直接收藏/分享 | 链接不带 body,不能直接收藏/分享 |
| HTTP 明文抓包 | 请求行、头、body 都可见 | 请求行、头、body 都可见 |
| HTTPS 下 | 内容加密;但 URL 仍可能进日志/历史 | 内容加密;URL 部分仍可能进日志 |
| 安全语义 | 安全、幂等,适合查询 | 不安全、不幂等,适合创建/修改 |
| 典型用途 | 搜索、筛选、分页 | 登录、提交表单、上传、创建资源 |
13.5 重新回答一次:URI 到底是什么
现在,我们已经见过了 URI 的三种用法,可以回过头把那句定义补充完整了。
原文在最后提出了一个很好的问题:
你如何看待一个 http request 中的 URI 的?
它给了两个答案。
答案一(静态资源视角):
Linux web 根目录下存在的一个文件路径(静态资源访问),视频、音频、html......
   /index.html  →  wwwroot/index.html  →  磁盘上的一个真实文件
   /logo.png    →  wwwroot/logo.png    →  磁盘上的一个真实文件

   ★ 这种 URI,可以直接翻译成一条文件系统路径
     服务器的工作就是"把文件读出来发走"
答案二(动态服务视角):
我们可以把他当做一个字符串,用来请求 http server 中所对应的服务,"字符串"也往往以路径形式体现,只不过这个路径不能在 Web 根目录下存在!
这段话非常关键,它说出了动态站点和静态站点的本质区别:
   /user/profile   →  wwwroot/user/profile
                         ↑ 磁盘上【根本没有这个文件】!

   ★ 那服务器怎么处理?
     它不能去读文件(文件不存在)
     它必须【执行一段代码】来生成响应

     这个 URI 不是"文件名",而是"我要调用哪个服务"的标识
所以 URI 有一个漂亮的双重身份:
┌────────────────────────────────────────────────────────────────┐
│  URI 的两种身份
├────────────────────────────────────────────────────────────────┤
│  身份一:文件路径
│     /index.html  →  一个真实存在的文件
│     处理方式:读文件 → 发回去
│     这就是【静态资源访问】
├────────────────────────────────────────────────────────────────┤
│  身份二:服务标识
│     /user/login  →  磁盘上不存在的路径
│     处理方式:路由到对应的处理函数 → 执行 → 生成响应
│     这就是【动态服务请求】
└────────────────────────────────────────────────────────────────┘
服务器怎么区分这两种情况?
一个朴素但有效的判断法:
   拿到 URI → 加上 wwwroot 前缀 → 去文件系统里找
       │
       ├── 找到了  →  按静态资源处理(读文件,发回去)
       │
       └── 没找到  →  交给后面的业务逻辑
                       → 由它决定是执行某个服务,还是返回 404
"404 Not Found"这个状态码,正是从这个判断里自然产生的 ------路径找不到对应的东西。
回到我们写的那个简单 HTTP 服务器:它实现的是身份一。第十章的 Build() 里那个 ReadFile() 读不到文件就返回 404,处理的正是"这个 URI 不对应任何一个真实文件"的情况。
13.6 承上启下
到这里,GET 和 POST 的区别、参数是怎么从表单变成 HTTP 请求的一部分,都讲清楚了。
但还有一个贯穿全文的坑没有填------从第二章就埋下的那个:
http:和https:有什么区别?原文说"https 是加密的、http 是不加密的"------那具体加密的是什么?
这就是下一章的主题。
第十四章 HTTPS:那个"加密版本"
14.1 明文走网线,等于明信片走邮局
在第二章我们见过这个对比,当时只是一笔带过:
【https】是加密的协议。【http】是不加密的。
现在把这个区别讲透。
先想清楚"不加密"意味着什么。
HTTP 的报文是纯文本的(第五章讲过:它就是一个大字符串)。它从你的电脑出发,要经过:
   你的电脑
      │
      ▼
   家里的路由器
      │
      ▼
   运营商的机房
      │
      ▼
   若干个中间路由器
      │
      ▼
   目标机房的交换机
      │
      ▼
   服务器
这条路上的任何一环,都可以把经过的数据完整地看一遍。
原文对这个风险的描述是:
HTTPS:加密的是正文部分,相应的请求、应答报文是没有被加密的!
这句话有一个非常值得展开的细节。我们在下一节专门讲。
先用一个比喻说清楚"不加密"到底有多严重:
★ HTTP  好比【明信片】:
   写在上面,一路上经手的每个人都能读
   (路由器、运营商、公共 WiFi 的提供者......)

★ HTTPS 好比【密封信件】:
   内容装在信封里,中间的人只能看到"寄给谁、寄给谁"
   但看不到信里写了什么
这个比喻里有一个关键的细节:即使装了信封,信封上的收件地址还是要露在外面。 这个细节在 14.2.3 节会变得很重要。
14.1.1 它是怎么被看见的?------网卡的两种模式
"一路上经手的人都能读",这句话听起来有点抽象。我们把它落到实处:
原文给了一个非常具体、而且就在你身边的场景:
局域网抓包原理:
① 同一局域网内(如宿舍),你发给路由器的报文,同网段的其他主机也能收到;
② 正常情况下,主机在数据链路层收到报文后做 MAC 目的地址判定:不是发给自己的就丢弃(普通模式);
③ 恶意用户可以用工具绕开"丢弃非本机报文"的底层设定,把局域网里所有报文都抓上来 → 抓到你的 HTTP 请求 → 账号密码泄露。
这个机制的关键,在于网卡的两种工作模式:
┌──────────────────────────────────────────────────────────────────┐
│  模式一:普通模式(默认)
│
│    网卡收到一个报文
│        ↓
│    在【数据链路层】检查 MAC 目的地址:
│        ├── 是发给我的  →  向上交付给协议栈  ✅
│        └── 不是给我的  →  ★ 直接丢弃
└──────────────────────────────────────────────────────────────────┘

┌──────────────────────────────────────────────────────────────────┐
│  模式二:混杂模式(promiscuous)
│
│    ★ 一个标志位,由网卡驱动提供
│
│    把网卡设成"收到任何报文都向上交付"
│        ↓
│    ★ 于是能抓到局域网里【所有】报文,不只是发给自己的
└──────────────────────────────────────────────────────────────────┘
为什么局域网里"别人的报文"会跑到你的网卡上?
这是以太网的共享介质特性决定的(我们在网络基础那一章讲过):
   在同一个局域网(同一个广播域)里,
   报文是以【广播】的方式在物理介质上传播的。

   ★ 所以从物理上说,同一网段的每张网卡【都能收到】这些信号

   ★ 是"丢弃"这个动作(靠 MAC 地址判断)决定了
     "哪些报文该被上层看到"

   ★ 而混杂模式,就是把这个"丢弃"动作关掉
抓包工具的原理,就是把网卡设成混杂模式:
抓包工具原理:Wireshark、Linux 的
tcpdump,本质上就是把网卡工作模式设成混杂模式,把本机收到的所有报文抓上来再分析。
# 这就是 tcpdump 的本质:把网卡设成混杂模式,然后用过滤器筛选
sudo tcpdump -i eth0 -A port 80
#              ↑ 指定网卡   ↑ -A 以 ASCII 显示内容
#                            → ★ HTTP 明文请求会直接显示出来!
注意 -A 这个参数的含义------"以 ASCII 显示内容",因为 HTTP 是纯文本的,所以抓到的内容是直接可读的。
原文对这个场景的总结是:
核心结论:GET 和 POST 传参都不安全,因为 HTTP 请求及传递的数据本身都是明文------请求向下封装(TCP/IP、数据链路层等)时全是字符信息,没有任何保护;中途要经过无数路由器、运营商、代理。
抓包工具:fiddler 现场抓到 POST 方法的正文,用户名密码就是明文的。
注意这里有一个非常容易搞错的地方,原文特意澄清过:
区别 1(回显/私密性):
GET 通过 URI 传参,账号密码等信息会回显在浏览器地址栏、暴露出来;
POST 正文传参,浏览器只显示请求的服务,不显示正文数据 → POST 传参更私密。
这个区分极其重要:
   ★ "更私密" ≠ "更安全"

   POST 只是让你的密码【不在地址栏里显示】------
   你自己不会不小心被别人从屏幕上看到,
   也不会被记进浏览器历史。

   ★ 但在【网线上】,POST 的正文和 GET 的 URL 一样是明文,
     抓包工具一样看得一清二楚。

   一句话:POST 防的是【旁边的人】,防不了【路上的设备】。
所以真正的解决方案只有一个:加密。这就是 HTTPS 存在的全部理由。
14.2 到底加密了什么
现在看具体的技术事实。
HTTPS 的全称是 HTTP over SSL(后来 SSL 演进为 TLS,但"SSL"这个名字被沿用下来了)。
它不是一个新协议,而是"在 HTTP 下面垫了一层加密"。
原文对这个分层结构的描述是:
SSL:为保通信过程安全,应用层里还有一层 SSL = Secure Socket Layer(安全套接层),专门实现加密和解密逻辑;SSL 之上再做 HTTP。
HTTP + SSL = HTTPS,HTTPS 里的 S 就是 SSL;SSL 是一层"软件层",客户端、服务端都有。
┌─────────────────────────────────────────────┐
│   应用层    HTTP                             │  ← 还是那个 HTTP,一点没变
├─────────────────────────────────────────────┤
│   ★ SSL/TLS 加密层                           │  ← HTTPS 新加的就是这一层
├─────────────────────────────────────────────┤
│   传输层    TCP                              │
├─────────────────────────────────────────────┤
│   网络层    IP                               │
└─────────────────────────────────────────────┘
        ↑
   ★ 注意:SSL 在 HTTP【之下】,是 HTTP 的"下层"
     所以 HTTP 调用 SSL 的接口,就像它调用 read/write 一样
14.2.1 整个 HTTP 报文都被加密了
这是本节最容易搞错的一点,必须说准确。
原文对加密范围的描述是:
HTTPS:先 HTTP 构建请求 → 到 SSL 层把整个 HTTP 报文全部加密(一般包括报头属性和正文,因为参数可能在 URI 里也可能在正文里,所以必须整包加密)→ 通过网络转发给对端 → 对端先到 SSL 层解密 → 解密后上层拿到的仍是 HTTP 请求。
为什么必须"整包加密"?原文给了理由,而这个理由很关键:
因为参数可能在 URI 里,也可能在正文里
回想第十三章讲的两种传参方式:
   GET  →  参数在【请求行】的 URI 里
   POST →  参数在【正文】里

   ★ 如果只加密正文,那么 GET 请求的全部参数就是明文暴露的
     → 这显然不行

   ★ 所以必须把【整个 HTTP 报文】都加密
     包括:请求行 / 状态行、所有报头、空行、正文
于是得到两个重要的结论。原文的表述是:
结论一:只有通信双方在各自这两层能看到同一个 HTTP 明文;网络中抓包(请求、应答)看到的都是加密数据。
结论二(端口区分):HTTP 服务端默认绑定 80 端口;HTTPS 是另一种网络服务,默认绑定 443 端口。课堂用 8080 是因为绑定 80 需要超级用户权限。
结论一可以画成图:
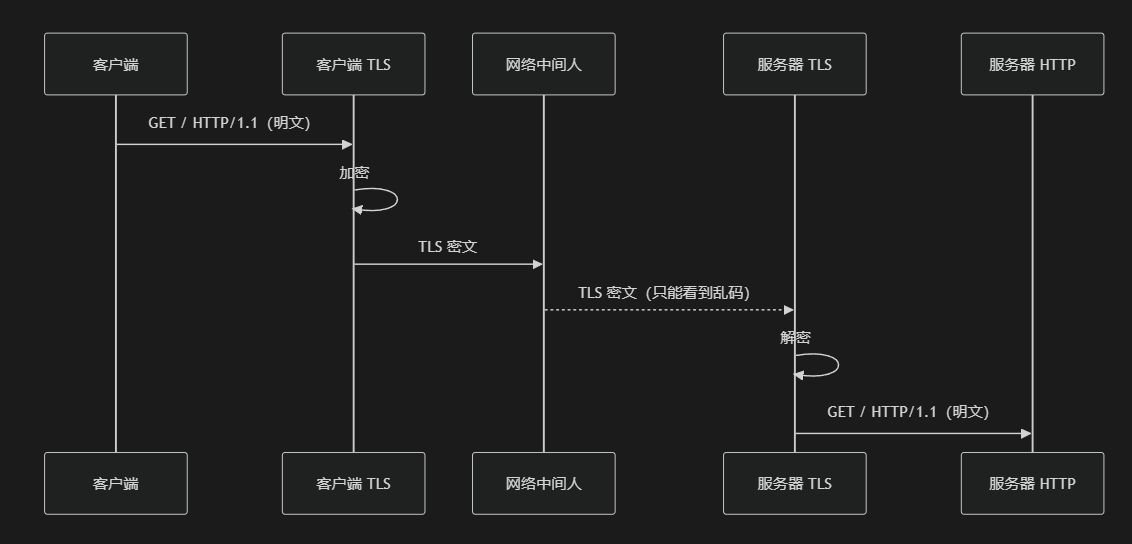
"发的是一个 HTTP request,对方收到的也是一个 HTTP request"------这句话点出了 SSL 层的透明性:
   ★ 对 HTTP 层来说,它完全不知道 SSL 的存在

     HTTP 只是"往下写一串字节",
     至于这些字节在下面被加密成了什么样子,
     HTTP 一概不管。

     ★ 这和第四章讲的"HTTP 不知道 TCP 的存在"
       是同一个道理------【分层的透明性】
14.2.2 在代码里,SSL 层长什么样
原文还描述了这个设计在代码里怎么落地:
软件架构实现:设计一个 SSL 层(加密解密底层),HTTP 属于上层、SSL 属于下层;HTTP 调用 SSL 的接口。
在 HTTP server 中:读数据时读到完整请求后,先对读到的 inbuffer 做解密,再交给上层处理;发送之前对 outbuffer(应答)做加密。
加密解密对上层 HTTP 的
HandleRequest全程透明,从而形成上下层软件关系。
画出来就是一个非常清晰的两层结构:
// 收数据的路径(从网络 → 到 HTTP)
char inbuffer[SIZE];
int n = read(sockfd, inbuffer, sizeof(inbuffer));

// ★ 解密这一步,是 SSL 层干的
std::string plain = ssl.Decrypt(inbuffer, n);

// ★ HTTP 层拿到的,已经是明文了
HandleRequest(plain);       // 它完全不知道刚才那串是密文


// 发数据的路径(从 HTTP → 到网络)
std::string response = BuildResponse();

// ★ 加密这一步,也是 SSL 层干的
std::string cipher = ssl.Encrypt(response);

write(sockfd, cipher.c_str(), cipher.size());
注意这两个注释里反复出现的词:
   ★ "HTTP 层完全不知道刚才那串是密文"

   这就是分层设计的价值:
   HTTP 的代码一行都不用改,就能切换到 HTTPS
   ------ 只要在下面垫一个 SSL 层
原文还提到了一种更灵活的组织方式:
也可直接在 TCP server 上设置两个回调(一个加密方法、一个解密方法),注册后与 HTTP server 关联。
   ★ 这就是我们第四章讲的"回调机制"的又一次应用:
     把"加密""解密"两个函数作为回调注册进去,
     TCP server 收到数据时调解密回调,
     发数据前调加密回调。
14.2.3 一个必须澄清的边界
"整包加密"这句话容易让人以为 HTTPS 是"全都看不见"的。这不准确。准确的说法是:
★ HTTPS 保护的是【你说了什么】(HTTP 报文的内容)
★ HTTPS 不保护【你在跟谁说话】(域名、IP 这些"信封上的地址")
因为有些信息必须在加密建立【之前】就暴露出来,否则根本没法开始通信:
     ① 你连的是哪个 IP、哪个端口        (TCP 层就看得见)
     ② 你连的是哪个域名(SNI)           ← ★ 这个在握手里是【明文】
     ③ 证书信息(服务器是谁、有效期)
     ④ 用了什么加密算法
     ⑤ 数据包的大小、时序
所以:
   ✅ HTTPS 能防止:别人看到你的密码、Cookie、账号、聊天内容
   ❌ HTTPS 不能防止:别人知道你访问了哪个网站
这就是为什么"访问了哪些网站"这件事,即使全站 HTTPS,仍然可能被网络管理员、运营商观察到。 想要连"访问了哪个域名"都藏起来,需要更进一步的机制(比如 TLS 1.3 的加密 SNI / ECH)。
一句话好记:HTTPS 相当于给信装了个信封------信里的内容安全了,但信封上的收件地址还是露在外面的。
再看一个实际的差别,就知道 HTTPS 有多必要:
【HTTP 下,登录一个网站】

   POST /login HTTP/1.1
   Host: www.example.com
   Content-Length: 30
                              ← 空行
   username=maisui&password=123456
                              ↑
                    ★ 这段明文,路上所有人都能看见
                      包括你在星巴克连的那个免费 WiFi

【HTTPS 下,同样的登录】

   一段完全看不懂的密文......
   ★ 中间的任何人拿到的都只是一堆乱码
"一个不经意的免费 WiFi,就能让整间咖啡馆的人的密码全部泄露"------这就是为什么今天所有正规网站都必须上 HTTPS。
另外,HTTPS 带来的不只是保密性,还有两个容易被忽略的好处:
① 完整性校验 ------ 防止内容被中途篡改
   运营商/劫持者往网页里插广告,是早年非常常见的事
   有了 HTTPS,插入的任何东西都会导致校验失败

② 身份验证 ------ 证明"你连的确实是这家网站"
   通过证书机制,防止 DNS 劫持 / 中间人冒充
   ★ 这就是为什么你在浏览器里能看见那个"锁"图标
回顾一下第二章那个 URL 的第一段:
   https://www.example.com/index.html
   └─┬──┘
     └── 【https:加密】 vs 【http:不加密】
这五个字符的差别,背后是一整层加密协议。
14.3 承上启下
到这里,HTTP 协议的全部核心内容就讲完了。
从第二章到第十四章,我们沿着"一次回车"的顺序,走完了全部十三步:
   定位 → DNS → 编码 → 连接 → 请求 → 完整性 → 解析 → 结构体
        → 文件路径 → VFS/inode → 响应 → 状态码 → 正文 → 参数 → 加密
现在到了最后一件事:把这些零散的知识点,重新接回那条完整的故事线。
这就是下一章:全景回放。
------ 中篇到此为止 ------
回头看一遍,中篇走过的路是这样的:
   HttpRequest._uri = "/image/桃花.jpg"
        │
        ├─ 第八章  字符串 → 磁盘路径
        │          "/" → "/index.html" ,再补 wwwroot 前缀
        │          ★ 顺序不能反,前缀不能少(这是安全底线)
        │          然后 open/read 钻进内核:
        │            VFS 屏蔽文件系统差异(函数表多态)
        │            dentry 组成目录树 + dentry cache 加速
        │            inode 里存着 i_size、i_op、i_fop
        │          ★ i_size 就是 Content-Length 的来源
        │
        ├─ 第九~十章  响应报文怎么拼
        │          状态行 + 响应报头 + 空行 + 正文(和请求对称)
        │          Build() 两大难点:target_file、ReadFile
        │          ★ 并在第十八章埋下伏笔:如果这个 URI 根本不是文件呢?
        │
        ├─ 第十一章  状态码
        │          1xx~5xx 五大类
        │          ★ 301 永久(会改客户端的认知)vs 302 临时(不会)
        │
        ├─ 第十二章  Content-Type
        │          字节不会自解释,后缀名 → MIME 表
        │          ★ 页面的本质是一棵多叉树,每个叶子一次请求
        │
        ├─ 第十三章  GET 与 POST
        │          参数位置:URI 上 vs 正文里
        │          ★ "更私密" ≠ "更安全"
        │
        └─ 第十四章  HTTPS
                   网卡普通模式 vs 混杂模式 → 抓包原理
                   ★ 明文传输下,GET 和 POST 一样都能被抓
                   TLS 加密的是【整个 HTTP 报文】,不只是正文
到这里,一个 HTTP 服务器"能跑"了。
   ┌──────────────────────────────────────────────────────────┐
   │  ✅ 能做:收到请求 → 找到文件 → 拼出响应 → 发回去
   │  ✅ 能做:答对状态码、答对 Content-Type、支持 GET/POST
   │  ✅ 能做:走 HTTPS 把整包加密
   └──────────────────────────────────────────────────────────┘
但"能跑"离"能用"还有一段距离。把服务器真的放到用户面前,会立刻冒出三个问题------
   问题一:服务器记不住人
        用户登录成功了,下一次请求服务器就不认识了。
        ★ 因为 HTTP 是【无状态】的。

   问题二:连接留不住
        HTTP 本身不维护连接,连接是 TCP 的事。
        ★ 因为 HTTP 是【无连接】的。

   问题三:服务器只认文件,不认代码
        /index.html 好办,磁盘上有这个文件。
        可 /login 呢?磁盘上没有这个文件,
        "登录"是一段代码,不是一个文件。
        ★ 因为前面所有章节,实现的一直是"静态资源"这条路。
这三个问题,就是下篇要回答的。
下篇预告:从一次问答到一整个系统
   第十五章  全景回放
            把上篇和中篇的所有环节,重新接回一条线
            用一张时序图,看一次访问从头到尾的完整过程

   第十六章  无状态与无连接
            HTTP 的两个"天生缺陷"到底是什么
            以及为什么它们既是缺陷、又是 HTTP 能成功的原因

   第十七章  Cookie 与 Session
            怎么让一个天生"记不住事"的协议,记住你
            两条路:数据放客户端,还是放服务器
            顺带讲清 Referer 这个报头的三大用途

   第十八章  服务注册与路由
            ★ 中篇一直绕过去的那个问题:
              /login 该怎么处理?
            答案是往一张表里插一条记录
            你会发现:file_operations、sys_call_table、
            和这张路由表,是同一个设计模式的三个实例

   第十九章  速查表
            21 节,可以随手查阅
兄弟姐妹们,😉我们下篇见。