文章目录
-
- 一、先说结论:为什么你的分类模型上了产线就废了
- 二、改造前后:一张表看清差距
- 三、架构重构:五层分层设计
- 四、数据层:把"脏"当成常态
-
- [4.1 清单驱动,而不是靠目录结构猜标签](#4.1 清单驱动,而不是靠目录结构猜标签)
- [4.2 批次分组划分:这 10 行代码能救你的验证指标](#4.2 批次分组划分:这 10 行代码能救你的验证指标)
- [4.3 数据体检与训练期兜底](#4.3 数据体检与训练期兜底)
- [4.4 增强:模拟的是产线扰动,不是花哨](#4.4 增强:模拟的是产线扰动,不是花哨)
- [4.5 类别不平衡:双管齐下](#4.5 类别不平衡:双管齐下)
- 五、模型层:小样本友好的骨干工厂
- 六、训练引擎:稳定性优先于花哨
-
- [6.1 优化配置](#6.1 优化配置)
- [6.2 学习率调度:预热是必需的](#6.2 学习率调度:预热是必需的)
- [6.3 早停:统一转成"越大越好"](#6.3 早停:统一转成"越大越好")
- [6.4 产物契约:权重与元信息分离](#6.4 产物契约:权重与元信息分离)
- 七、决策层:这才是整个系统的核心
-
- [7.1 三态判定,而不是二分类](#7.1 三态判定,而不是二分类)
- [7.2 判定规则:只有"足够像合格"才放行](#7.2 判定规则:只有"足够像合格"才放行)
- [7.3 业务指标:这三个才是老板要看的](#7.3 业务指标:这三个才是老板要看的)
- [7.4 阈值寻优:把风险权衡交给算法](#7.4 阈值寻优:把风险权衡交给算法)
- [7.5 配置方式](#7.5 配置方式)
- 八、评估与报告:给质量负责人看得懂的东西
-
- [8.1 报告字段](#8.1 报告字段)
- [8.2 报告产物的工程细节](#8.2 报告产物的工程细节)
- [九、部署:ONNX + FastAPI](#九、部署:ONNX + FastAPI)
-
- [9.1 ONNX 导出与一致性校验](#9.1 ONNX 导出与一致性校验)
- [9.2 HTTP 接口](#9.2 HTTP 接口)
- [9.3 判定结果示例](#9.3 判定结果示例)
- [9.4 双后端一致性设计](#9.4 双后端一致性设计)
- [十、实战:5 分钟跑通全流程](#十、实战:5 分钟跑通全流程)
- 十一、踩坑记录:这些坑我都踩过
-
- [坑 1:`torch.cuda.amp` 在新版本 PyTorch 上报错](#坑 1:
torch.cuda.amp在新版本 PyTorch 上报错) - [坑 2:`pretrained=True` 被移除](#坑 2:
pretrained=True被移除) - [坑 3:为了下载权重关掉 SSL 证书校验](#坑 3:为了下载权重关掉 SSL 证书校验)
- [坑 4:`torch.load` 默认参数的安全隐患](#坑 4:
torch.load默认参数的安全隐患) - [坑 5:日志重复打印](#坑 5:日志重复打印)
- [坑 6:TensorBoard 初始化失败导致训练中断](#坑 6:TensorBoard 初始化失败导致训练中断)
- [坑 1:`torch.cuda.amp` 在新版本 PyTorch 上报错](#坑 1:
- [十二、测试体系:46 个用例的分层设计](#十二、测试体系:46 个用例的分层设计)
- 十三、已知边界与后续方向
- 十四、总结
- 项目源码下载
关键词:
PyTorch工业质检缺陷检测阈值寻优ONNX 部署FastAPI类别不平衡工程化摘要:CIFAR-10 上跑通四分类,准确率 90%+,就能拿去产线检缺陷了吗?答案是否定的。本文从一个典型的"学术 Demo"项目出发,逐条拆解它上不了产线的 12 个致命问题,并给出完整的重构方案:清单驱动的数据层、批次分组划分防泄漏、业务阈值决策层、漏检/过杀/复核三指标体系、ONNX 一致性校验与在线服务。全文含可运行代码、真实运行数据与完整架构图。
一、先说结论:为什么你的分类模型上了产线就废了
先看一段非常典型的"学术 Demo"代码------它来自一个真实的缺陷分类项目:
python
# 从 CIFAR-10 里抽前 4 类,"模拟"缺陷数据
target_classes: [0, 1, 2, 3]   # CIFAR-10 前4类模拟缺陷
class_names: ['scratch', 'dent', 'stain', 'none']

# 训练 5 轮,验证集直接从训练集随机切
train_val_split: 0.9

# 32×32 的图片硬拉到 224 送进 ResNet
transforms.RandomResizedCrop(224)

# 最后:argmax 一把梭
_, pred = outputs.max(1)
这段代码在 notebook 里能跑,准确率也能到 85%+。但把它放到产线上,会连续踩下面这些坑:
| # | 问题 | 产线后果 |
|---|---|---|
| 1 | 用 CIFAR-10 假装缺陷数据 | 32×32 的马车、青蛙,和产线上 2000×2000 的划痕毫无关系 |
| 2 | 训练集随机切验证集 | 同批次泄漏:同一卷料、同一班次、同一相机参数下拍的图同时出现在训练和验证集,验证指标虚高 10~20 个点 |
| 3 | 只报 Top-1 准确率 | 质量负责人真正要的是"漏了多少缺陷件",准确率根本没法决策 |
| 4 | argmax 直接判定 | 缺陷件只要概率 0.51 > 0.49 就被判合格放行,漏检率不可控 |
| 5 | 无类别不平衡处理 | ok 占 90%、划痕占 2%,模型学会"全猜 ok",准确率 90% 但缺陷一个没抓到 |
| 6 | 无数据脏治理 | 一张坏图直接让 DataLoader 崩在半夜 |
| 7 | requirements 写了 fastapi/onnx 却没代码 | 训完不知道怎么部署,模型躺在 .pth 里吃灰 |
| 8 | torch.cuda.amp / pretrained= 旧 API |
新版 PyTorch 直接报错或警告 |
| 9 | ssl._create_unverified_context |
关掉证书校验,安全审计过不了 |
| 10 | 无任何测试 | 改一行代码不知道有没有弄坏别的 |
| 11 | 无配置快照 | 三个月后想复现实验,不知道当时用的什么参数 |
| 12 | 权重里塞满训练状态 | 部署时要拖着整个 optimizer 状态,还可能被 weights_only=True 拒绝加载 |
根本矛盾在于:学术分类追求"整体分对多少",工业质检追求"缺陷件绝不能放过"。这两件事的优化目标完全不同,甚至相互冲突。
本文的改造思路可以浓缩成一句话:
把"类别预测"升级为"业务判定",把"准确率"升级为"风险权衡"。
二、改造前后:一张表看清差距
| 维度 | v1.0 学术 Demo | v2.0 产线工程 |
|---|---|---|
| 数据源 | CIFAR-10 前 4 类 | 目录 + CSV 清单,支持批次分组划分 |
| 划分方式 | 对训练集随机切 | 按 batch_id 分组划分,杜绝同批次泄漏 |
| 输入分辨率 | 32×32 强拉 224 | 可配置(默认 224),增强围绕产线扰动 |
| 类别不平衡 | 无 | 损失加权 + 加权采样,权重归一化并截断 |
| 核心指标 | Top-1 准确率 | 每类 P/R/F1 + 漏检率 / 过杀率 / 复核率 |
| 决策方式 | argmax | 阈值保守判定 + 验证集自动寻优 + 人工复核带 |
| 部署 | 无 | ONNX 导出 + 一致性校验 + FastAPI 服务 |
| 可复现 | 仅随机种子 | 种子 + 确定性算法 + 配置快照 + 结构化指标 |
| 工程化 | 单文件 main.py | 6 个 CLI 子命令 + 分层包结构 |
| 测试 | 无 | 46 个单元测试(含端到端流水线) |
| 代码注释 | 部分 | 逐行注释,覆盖率 100% |
三、架构重构:五层分层设计
重构后的系统采用严格的五层分层,依赖方向自上而下,每层可独立替换与测试。
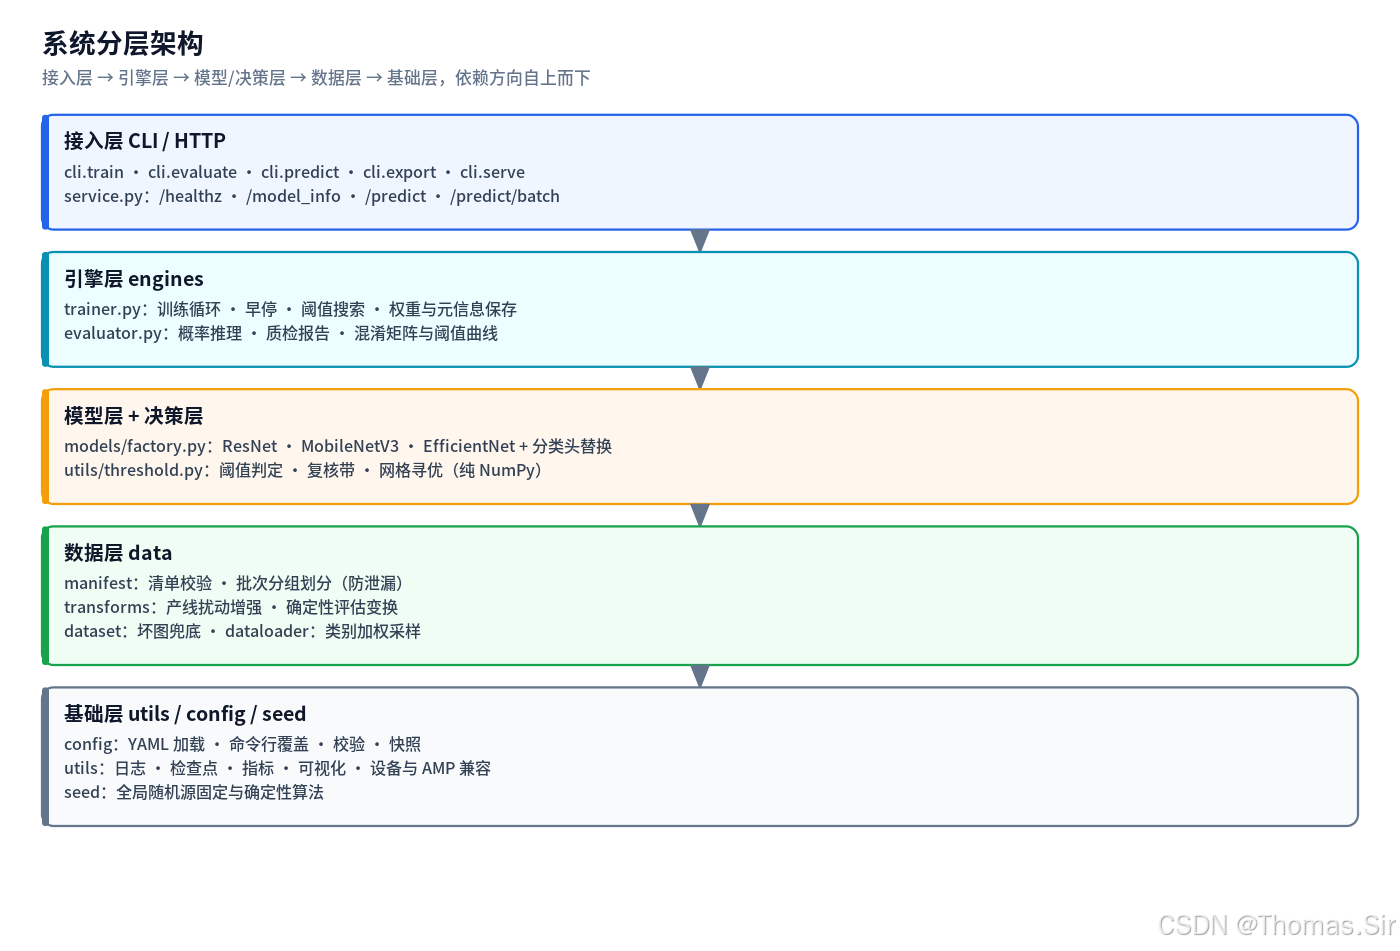
图 3-1 系统五层架构
接入层   CLI(6 个子命令)/ HTTP(4 个接口)
   ↓
引擎层   trainer(训练循环·早停·阈值搜索)/ evaluator(概率推理·质检报告)
   ↓
模型层 + 决策层   models/factory(骨干工厂)/ utils/threshold(阈值判定·寻优)
   ↓
数据层   manifest(清单·分组划分)/ transforms(增强)/ dataset(兜底)/ dataloader(采样)
   ↓
基础层 config(校验·快照)/ seed(可复现)/ utils(日志·检查点·指标·可视化·设备)这里有个刻意的设计 :决策层(utils/threshold.py)独立于模型层,且用纯 NumPy 实现。
为什么要这么设计?因为业务规则会频繁变(今天漏检率要求 1%,下个月客户要求 0.5%),而模型结构相对稳定。把决策逻辑抽离出来后:
- 调阈值不需要重新训练,跑一遍验证集就行
- 决策逻辑可以在没有 GPU、没有 PyTorch 的环境里测试
- 离线回测和在线服务共用同一份代码,不会出现"离线看着准、上线不一样"
四、数据层:把"脏"当成常态
4.1 清单驱动,而不是靠目录结构猜标签
真实产线的标注来自 MES 系统或质检记录表,导出就是一张 CSV。所以清单才是第一等公民:
csv
image_path,label,batch_id,split
scratch/IMG_20240501_0001.png,scratch,20240501,
ok/IMG_20240502_0007.png,ok,20240502,train
三个字段各有讲究:
image_path:相对data.root的路径,方便数据集整体迁移batch_id:批次号,这是防泄漏的关键split:可选。业务方指定了就用业务方的,没指定才自动划分
清单不存在时,自动扫描 root/<类别名>/*.jpg 目录结构生成,兼顾两种习惯。
4.2 批次分组划分:这 10 行代码能救你的验证指标
这是整个数据层最值钱的一段代码。产线数据的特点是:同一批次(同一卷料、同一班次、同一光照)内样本高度相似。如果随机划分,训练集和验证集里都有同一批次的图,模型只要"记住批次特征"就能拿高分------但上线遇到新批次就原形毕露。
python
def group_split(records, val_ratio=0.15, test_ratio=0.15,
                seed=42, group_key="batch_id"):
    """按批次分组划分训练/验证/测试,避免同批次泄漏"""
    groups = defaultdict(list)                            # 批次 -> 样本列表
    for record in records:                                # 遍历全部记录
        groups[str(record.get(group_key, "common"))].append(dict(record))   # 按批次聚合

    group_items = sorted(groups.items(), key=lambda kv: kv[0])   # 按批次名排序,保证确定性
    rng = random.Random(seed)                             # 独立随机源,不污染全局
    group_items = list(group_items)                       # 转列表
    rng.shuffle(group_items)                              # 打乱"批次顺序"(注意:不是打乱样本)

    splits = {"train": [], "val": [], "test": []}         # 三个集合
    n_total = sum(len(v) for _, v in group_items)         # 样本总数
    n_test = int(n_total * test_ratio)                    # 测试集目标数量
    n_val = int(n_total * val_ratio)                      # 验证集目标数量

    for _, items in group_items:                          # 按打乱后的批次依次分配
        if len(splits["test"]) < n_test:                  # 测试集还没填满
            splits["test"].extend(items)                  # 整个批次进测试集
        elif len(splits["val"]) < n_val:                  # 验证集还没填满
            splits["val"].extend(items)                   # 整个批次进验证集
        else:                                             # 其余归训练
            splits["train"].extend(items)                 # 整个批次进训练集
    return splits                                         # 返回划分结果
核心就一句话:打乱的是"批次顺序",而不是"样本"。 同一个 batch_id 的所有样本必定落在同一个集合里。
实测提醒:如果你的数据没有
batch_id,系统会从文件名推断(比如IMG_20240501_xxx.png里的日期前缀)。但最好还是显式提供,别赌推断逻辑。
4.3 数据体检与训练期兜底
产线数据脏是常态:文件被移动过、标注写错、图片传输截断。系统在两个层面处理:
构造期体检(早失败,早发现):
python
# 1. 文件不存在 → 过滤并记日志(常见于数据集迁移后)
# 2. 标签不在 class_names → 丢弃(避免训练时出现越界索引)
# 3. Pillow verify() 校验解码 → 剔除截断/损坏图片
# 4. 每类样本数 < min_samples_per_class → 直接报错提示补数训练期兜底(不中断长任务):
python
def __getitem__(self, idx):
    """带兜底重试的样本读取:坏图最多向后重试 3 次"""
    for attempt in range(self.retry + 1):                 # 最多重试 retry 次
        real_idx = (idx + attempt) % len(self.records)    # 向后顺延,取模防越界
        try:                                              # 尝试读取
            img = self._load_image(real_idx)              # 加载并解码图片
            if img is None:                               # 解码失败
                raise ValueError("图片解码失败")            # 抛错进入下一轮重试
            label = self.records[real_idx]["label_index"] # 取标签索引
            if self.transform is not None:                # 有变换
                img = self.transform(img)                 # 应用变换
            return img, label                             # 正常返回
        except Exception as exc:                          # 捕获所有异常
            self.skipped.append((real_idx, str(exc)))     # 记录被跳过的索引与原因
            continue                                      # 继续下一次尝试
    # 全部重试失败:返回全零样本,保证 DataLoader 不中断
return torch.zeros(self.fallback_shape), 0 # 兜底返回关键点:兜底返回全零样本 而不是抛异常。一个 8 小时的训练任务,不应该因为一张坏图在第 7 小时崩掉。被跳过的索引都存在 dataset.skipped 里,训练结束后统一排查。
4.4 增强:模拟的是产线扰动,不是花哨
增强不是为了"增加数据多样性",而是为了让模型对你无力改变的环境因素免疫。每一条算子都要对应一个真实物理原因:
| 增强算子 | 模拟的真实因素 | 你为什么改不了它 |
|---|---|---|
RandomResizedCrop |
相机到产品距离 / 视野微变 | 夹具公差、振动 |
| 水平/垂直翻转 + 小角度旋转 | 夹具安装方向与角度偏差 | 人工上料方向不固定 |
ColorJitter(亮度/对比度/饱和度/色相) |
车间光照漂移、灯管老化 | 车间照明不受你控制 |
GaussianBlur / RandomAdjustSharpness |
失焦、镜头脏污 | 镜头会脏、会失焦 |
RandomErasing |
局部遮挡、反光、脏点 | 现场就是有遮挡 |
强度分三档 light / medium / strong,由 augment_strength 配置。别一上来就 strong------过强的增强会让细小的划痕特征被破坏,反而学不到东西。
⚠️ 铁律 :评估、测试、推理三处必须用完全相同的确定性变换 (
Resize → CenterCrop → ToTensor → Normalize)。训练增强只作用于训练集。我见过太多"验证准确率 95%、线上 70%"的事故,最后查出来是推理时忘了归一化,或者验证时误用了随机裁剪。
4.5 类别不平衡:双管齐下
产线上 ok 类样本天然占绝大多数(良率 95% 是好事,但对训练是灾难)。系统用了两个手段,且都必须做限幅:
手段一:损失加权
python
# sqrt_inverse 比 inverse 温和,是默认选择
#   inverse       : w_c = N / (C * n_c)        ------ 极端不平衡时权重爆炸
#   sqrt_inverse  : w_c = sqrt(N / n_c)        ------ 推荐,抑制过头
# 权重归一化后按 max_weight(默认 20)截断,防止训练发散
手段二:加权采样
python
# sampler=weighted 启用 WeightedRandomSampler,少数类被多次抽中
# ⚠️ 启用采样器后必须关闭 shuffle,否则语义冲突为什么两个都要?损失加权改变的是梯度贡献 ,加权采样改变的是每个 epoch 看到的样本分布。小样本场景下,加权采样能让少数类在有限步数内被充分看到,收敛更快。
五、模型层:小样本友好的骨干工厂
统一结构是"预训练骨干 + 新分类头",分类头为 Dropout → Linear,并在 model.head 上保留引用,供分层学习率与冻结策略定位。
python
def _replace_head(model, model_name, num_classes, dropout):
    """替换分类头为 Dropout + Linear,并在 model.head 上保留引用"""
    parent, in_features, attr = _head_info(model, model_name)   # 定位原分类头
    head = nn.Sequential(                        # 构造新分类头
        nn.Dropout(p=dropout),                   # Dropout:抑制小样本过拟合
        nn.Linear(in_features, num_classes),     # 新的分类线性层
    )
    if attr == "fc":                             # ResNet 系
        model.fc = head                          # 直接替换 fc
    else:                                        # MobileNetV3 / EfficientNet
        parent[-1] = head                        # 替换 classifier 序列最后一项
    model.head = head                            # ★ 保存引用,便于分层学习率定位
    return model
支持的骨干与选型建议:
| 骨干 | 可训练参数(4 类) | 适用场景 |
|---|---|---|
resnet18 |
≈ 11.2 M | 默认,精度与速度均衡 |
resnet34 / resnet50 |
≈ 21 M / 23.5 M | 服务器端,精度优先 |
mobilenet_v3_small |
≈ 0.93 M | 产线边缘工控机 |
mobilenet_v3_large |
≈ 4.2 M | 边缘设备,精度优先 |
efficientnet_b0 |
≈ 4.0 M | 参数效率优先 |
几个容易忽略但很实用的兼容处理:
① 新旧 torchvision API 兼容
python
# 优先用新 API:weights=Enum.DEFAULT
# 失败(旧版本 / 离线无权重)→ 自动降级随机初始化并打印告警
# 好处:离线环境、内网环境也能跑起来,不会直接崩
② 灰度图输入
有些产线用黑白相机。直接把单通道图送进 ResNet 会维度不匹配。系统重建首层卷积,权重按通道维取均值继承,保留预训练特征:
python
# 原 conv1: (64, 3, 7, 7)  →  新 conv1: (64, 1, 7, 7)
# 新权重 = 原权重沿通道维取均值,形状 (64, 1, 7, 7)
③ 分阶段冻结(小样本救命)
yaml
model:
  freeze_backbone: false    # true = 只训练分类头(数据极少时先用这个)
  freeze_stages: 0          # 冻结 stem + 前 N 个 stage(ResNet 有效)
数据量 < 1000 张时,强烈建议 freeze_backbone=true 先训 5~10 轮,再解冻全网络微调。
六、训练引擎:稳定性优先于花哨
6.1 优化配置
| 配置项 | 默认值 | 为什么这么定 |
|---|---|---|
optimizer |
adamw | AdamW 解耦权重衰减,小样本更稳 |
lr |
3e-4 | 微调预训练模型的常用起点 |
head_lr_scale |
5.0 | 分类头是随机初始化的,需要更快收敛 |
weight_decay |
0.05 | 抑制过拟合 |
label_smoothing |
0.05 | 缓解人工标注噪声(质检标注本来就有争议) |
grad_clip |
1.0 | 防止异常样本导致梯度爆炸 |
amp |
auto | CPU 自动关闭,不会因为没 GPU 就报错 |
head_lr_scale 是个容易被忽略但效果明显的技巧:骨干带着 ImageNet 预训练权重,已经"差不多对了",学习率要小;分类头是随机初始化的,学习率要放大 5 倍。用同一个学习率,要么头训不动,要么骨干被破坏。
6.2 学习率调度:预热是必需的
yaml
train:
  scheduler: cosine
  scheduler_params:
    T_max: 30
    warmup_epochs: 2        # ★ 预热 2 轮
    min_lr: 1.0e-6          # 余弦退火下限
为什么必须预热? 预训练骨干的权重是"好"的,如果第一轮就用 3e-4 的学习率猛冲,会把预训练特征破坏掉。预热让学习率从 0 线性上升到目标值,给骨干一个缓冲。
实现上用 SequentialLR 把预热和主调度拼起来,旧版本 PyTorch 自动降级为主调度。
6.3 早停:统一转成"越大越好"
yaml
train:
  early_stopping:
    enable: true
    monitor: val_macro_f1    # val_loss / val_acc / val_macro_f1 / val_miss_rate
    mode: max                # max=越大越好,min=越小越好
    patience: 8
min_delta: 0.0005实现小技巧:把监控值统一转成"越大越好"(损失和漏检率取负),这样比较逻辑只有一套,不容易写反。
6.4 产物契约:权重与元信息分离
这是个安全性 + 可用性双重考虑的设计:
outputs/checkpoints/
├── best_model.pt           # 仅 state_dict → torch.load(weights_only=True) 可安全加载
├── best_model.meta.json    # 类别名、ok 索引、阈值、复核带、分辨率、策略、指标快照
├── last_model.pt           # 末轮权重
└── epoch_N.pt              # 完整训练状态(含 optimizer,可恢复训练)
json
{
  "class_names": ["scratch", "dent", "stain", "ok"],
  "ok_index": 3,
  "threshold": 0.86,
  "review_band": 0.15,
  "image_size": 224,
  "strategy": "threshold",
  "metrics": {"val_macro_f1": 0.87, "val_miss_rate": 0.008}
}
部署侧只需要 model.onnx + model.meta.json 两个文件,不需要训练配置、不需要源码、不需要 PyTorch。这样部署同学拿到东西就能干活。
七、决策层:这才是整个系统的核心
前面所有工作都是铺垫。这一节是本文的重点。
7.1 三态判定,而不是二分类
模型输出的是概率,但产线要的是动作。系统输出三态:
| 判定 | 含义 | 下游动作 |
|---|---|---|
OK |
判定合格 | 自动放行,进入下一工位 |
NG |
判定存在缺陷 | 拦截、返修或报废 |
REVIEW |
置信度不足 | 推送人工复检工位 |
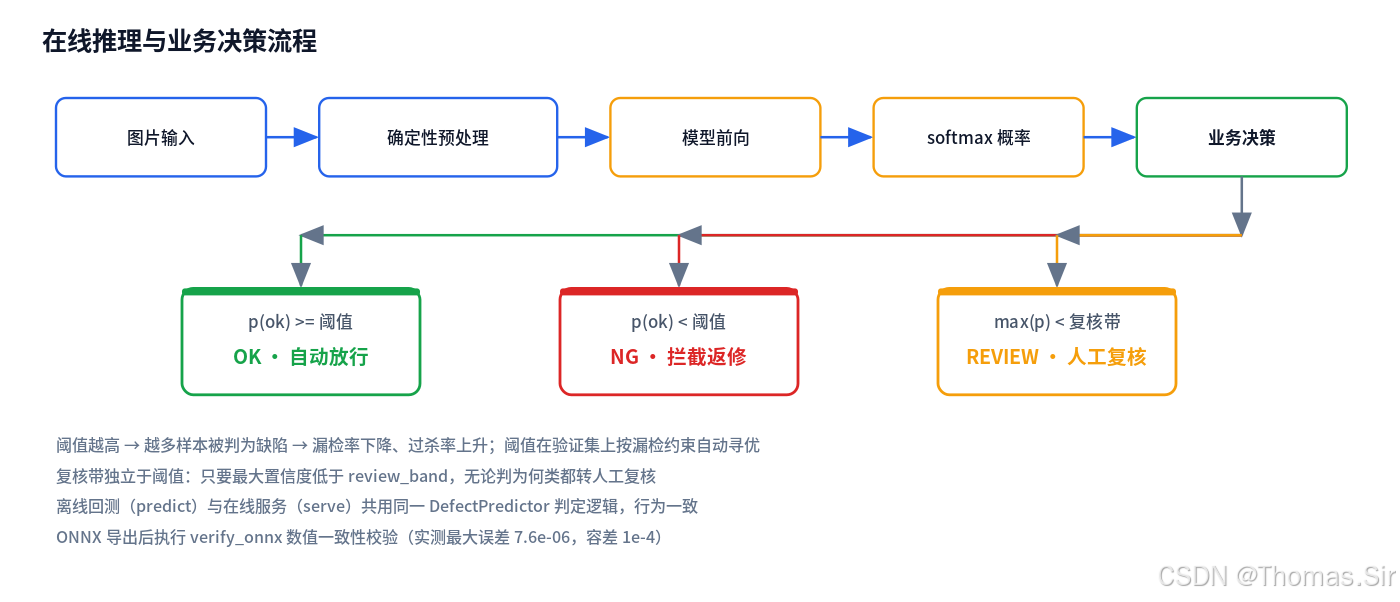
图 7-1 在线推理与业务决策流程
7.2 判定规则:只有"足够像合格"才放行
python
def decide_from_probs(probs, ok_index, threshold):
    """按阈值把概率矩阵转换为类别预测(向量化实现)"""
    probs = np.asarray(probs, dtype=np.float64)   # 转浮点数组
    if probs.ndim != 2:                           # 必须是二维
        raise ValueError("probs 必须是形状为 (N, C) 的二维数组")
    ok_probs = probs[:, ok_index]                 # 取出"合格类"的概率
    tmp = probs.copy()                            # 复制一份,避免修改入参
    tmp[:, ok_index] = -np.inf                    # ★ 屏蔽合格类,便于取"最可能的缺陷类"
    defect_pred = tmp.argmax(axis=1)              # 最可能的缺陷类别索引
    # ★ 核心:只有 p(ok) >= 阈值才放行,否则保守判为最可能的缺陷
    preds = np.where(ok_probs >= threshold, ok_index, defect_pred)
return preds.astype(np.int64) # 返回整数预测这段代码体现了保守原则:
p(ok) >= 阈值→ 放行(足够确信是合格品)p(ok) < 阈值→ 不是判 ok,而是判"最可能的那个缺陷类"
注意第二点。很多人的实现是"不 ok 就判 NG",但这样丢失了缺陷类型信息------维修工需要知道是划痕还是凹坑。这里用 tmp[:, ok_index] = -inf 屏蔽掉 ok 类再 argmax,就拿到了最可能的缺陷类型。
复核带独立生效:
python
def need_review_flags(probs, review_band):
    """标记最大置信度低于复核带的样本(需人工复核)"""
    max_probs = probs.max(axis=1) if probs.size else np.zeros(0)   # 每行最大概率
return (max_probs < float(review_band)).astype(np.int64) # 返回 0/1 标记复核带独立于阈值 。max(p) < review_band 的样本,无论被判为什么,一律转人工。这是给"模型也没把握"的情况留的出口。
7.3 业务指标:这三个才是老板要看的
| 指标 | 定义 | 业务含义 |
|---|---|---|
漏检率 miss_rate |
缺陷件被判为 ok 的比例 | 💀 最危险,直接决定客诉风险 |
过杀率 overkill_rate |
合格件被判为缺陷的比例 | 💰 影响产能、返工与报废成本 |
复核率 review_rate |
置信度低于复核带的比例 | 👷 决定人工复检人力成本 |
三者的关系:漏检和过杀此消彼长。阈值调高 → 更严格 → 漏检率下降、过杀率上升。
python
miss_rate     = 漏检数 / 缺陷总数     # 越低越好,但不能为零(那意味着全判 NG)
overkill_rate = 过杀数 / 合格总数     # 越低越好,但不能为零(那意味着全放行)
review_rate   = 复核数 / 总样本数     # 越低越好,但过低说明复核带形同虚设
7.4 阈值寻优:把风险权衡交给算法
阈值不该拍脑袋定。系统的做法是在验证集上做约束搜索:
python
def search_threshold(probs, labels, ok_index,
                     target_miss_rate=0.01, grid_start=0.5,
                     grid_end=0.99, num_points=50, review_band=0.0):
    """在验证集上搜索满足漏检率约束的最优阈值

    选择策略:优先满足 miss_rate <= target;
    在满足条件的候选中取"过杀率最小"的阈值;
    若没有任何阈值满足,则取漏检率最低者并标记 feasible=False,供人工介入。
    """
    grid = np.linspace(float(grid_start), float(grid_end), int(num_points))   # 阈值网格
    results = []                                                              # 每个阈值的结果
    for thr in grid:                                                          # 遍历候选阈值
        results.append(evaluate_threshold(probs, labels, ok_index, float(thr), review_band))

    # ① 约束筛选:只保留满足漏检率上限的候选
    feasible = [r for r in results if r["miss_rate"] <= float(target_miss_rate) + 1e-12]

    if feasible:                                                              # ② 存在可行解
        # 过杀最小优先;过杀相同时取更宽松(更小的)阈值,避免过度保守
        best = min(feasible, key=lambda r: (r["overkill_rate"], r["threshold"]))
        best = dict(best)
        best["feasible"] = True                                               # 标记可行
    else:                                                                     # ③ 无解兜底
        best = dict(min(results, key=lambda r: r["miss_rate"]))               # 取漏检最低者
        best["feasible"] = False                                              # ★ 标记不可行

    best["target_miss_rate"] = float(target_miss_rate)                        # 记录目标
    best["curve"] = results                                                   # ★ 完整曲线,便于画图/审计
return best这里有一个我认为最重要的设计决策:
python
best["feasible"] = False # 没有任何阈值满足漏检约束时当验证集上找不到任何满足 target_miss_rate 的阈值时,系统不会自动放宽业务目标 ,而是返回 feasible=False 并把漏检最低的那个阈值给你,同时明确告诉你"这个目标达不到"。
这是刻意的。工业场景里,"系统悄悄接受了一个高风险阈值"比"系统报错说做不到"要危险得多。前者会让你在不知情的情况下持续漏检,后者至少逼你去补数据、换模型或调特征。
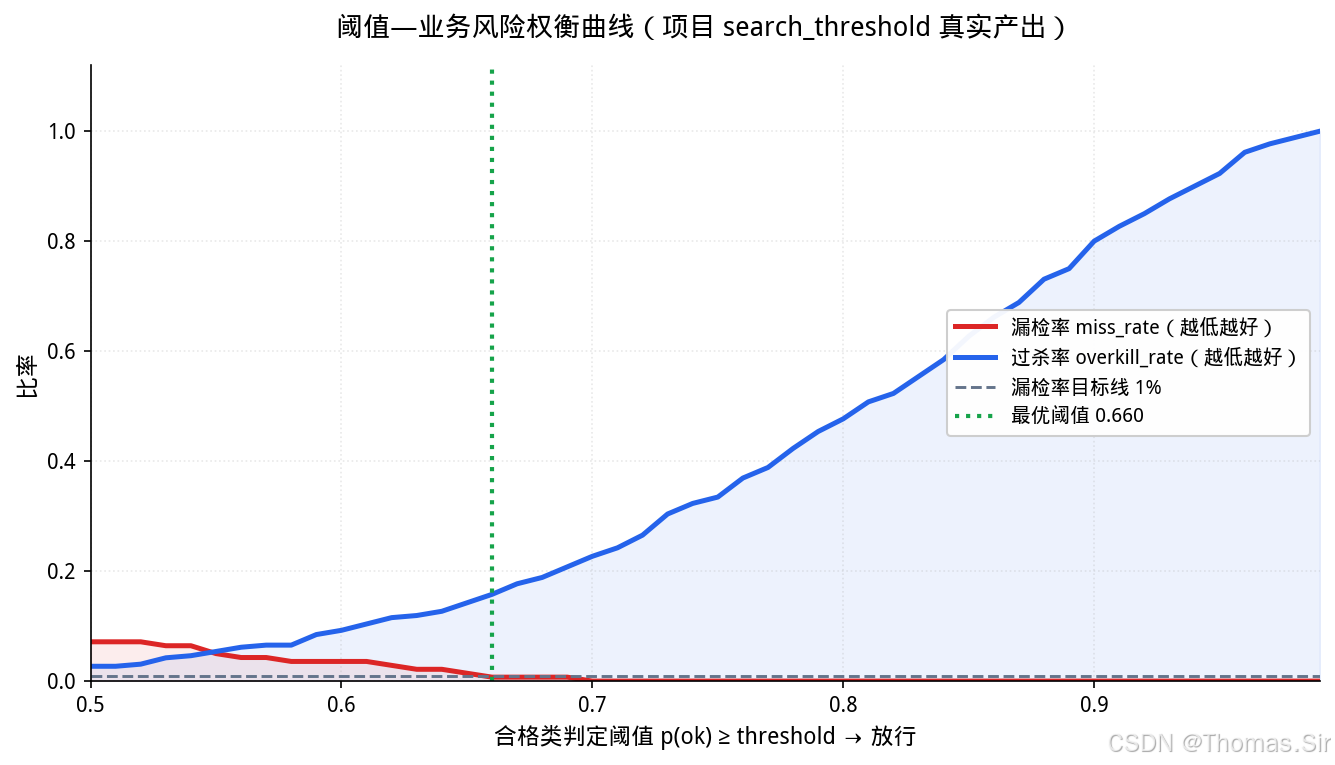
图 7-2 阈值---业务风险权衡曲线 (本项目 search_threshold 真实产出)
图中可以看到典型的权衡形态:阈值从 0.5 升到 0.99,漏检率(红)单调下降、过杀率(蓝)单调上升。绿色虚线是在"漏检 ≤ 1%"约束下搜索到的最优阈值------它选的是满足约束时过杀最小的那个点,而不是漏检最低的点(后者会让过杀率飙到不可接受)。
7.5 配置方式
yaml
decision:
  ok_class: ok
  strategy: threshold          # argmax=直接取最大概率;threshold=按阈值保守判定
  target_miss_rate: 0.01       # ★ 线上可接受的漏检率上限
  review_band: 0.15            # 置信度低于该值 → 人工复核
  threshold_grid: 0.5          # 阈值搜索起点
auto_threshold: true # 训练结束自动在验证集上搜索最优阈值调参建议:
target_miss_rate由质量协议决定,不是由模型能力决定。客户要求 0.5% 就设 0.005- 设了达不到 → 看
feasible字段,为 false 就该补数据,而不是改目标 review_band由人力预算决定:复检工位能处理多少件,反过来定这个值
八、评估与报告:给质量负责人看得懂的东西
评估不止输出一个数字,而是生成一份可直接决策的质检报告。
8.1 报告字段
json
{
  "accuracy": 0.6111,
  "macro_f1": 0.3694,
  "argmax_accuracy": 0.8333,          // ★ 不套阈值的原始模型能力
  "per_class": [
    {"class": "scratch", "precision": 0.0, "recall": 0.0, "f1": 0.0},
    {"class": "dent",    "precision": 0.0, "recall": 0.0, "f1": 0.0},
    {"class": "stain",   "precision": 1.0, "recall": 0.5, "f1": 0.667},
    {"class": "ok",      "precision": 0.68,"recall": 1.0, "f1": 0.811}
  ],
  "confusion_matrix": [[0,0,0,7],[0,0,7,0],[0,0,7,0],[0,0,0,15]],
  "business": {
    "miss_rate": 0.3333,              // 漏检率
    "overkill_rate": 0.0,             // 过杀率
    "defect_total": 21, "missed": 7,
    "ok_total": 15, "overkill": 0,
    "review_rate": 0.0, "review_count": 0
  },
  "recommended_threshold": {
    "threshold": 0.85,
    "feasible": true,
    "miss_rate": 0.0,
    "overkill_rate": 0.8667
  },
  "artifacts": {
    "confusion_matrix": "outputs/reports/test_confusion_matrix.png",
    "threshold_curve": "outputs/reports/test_threshold_curve.png"
  }
}
argmax_accuracy 这个字段非常有用 。它可能高于最终 accuracy(比如这里 0.83 vs 0.61),说明:模型本身判别能力还行,是阈值太严导致的整体准确率下降。
这能帮你快速定位问题:
argmax_accuracy低 → 模型弱,去调模型/补数据argmax_accuracy高但最终 accuracy 低 → 阈值严,这是业务选择,不是 bug
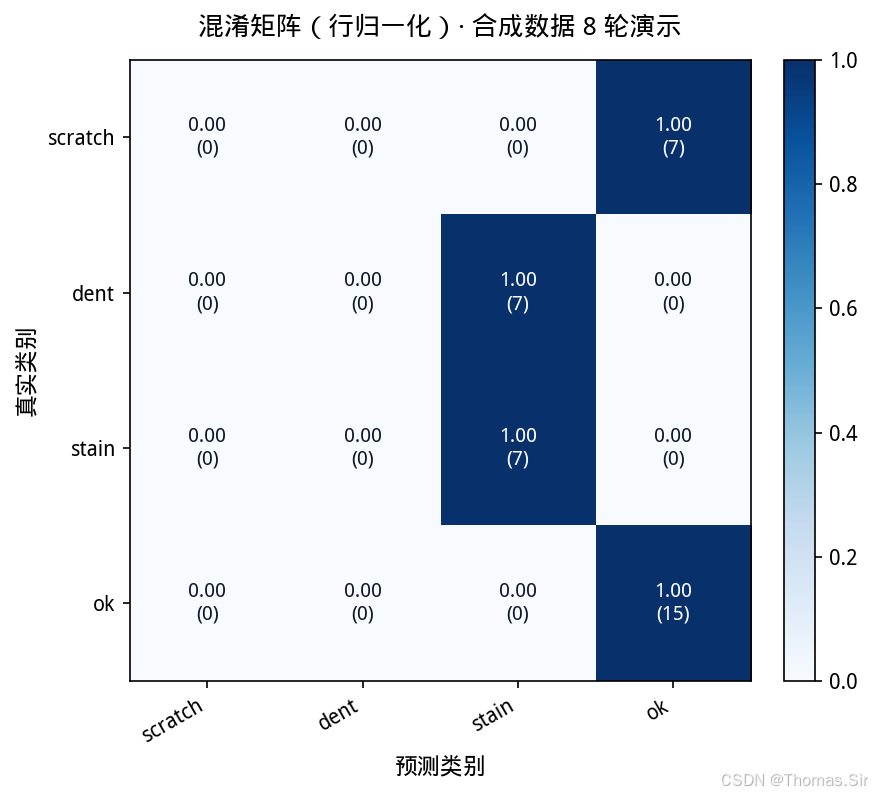
图 8-1 混淆矩阵(行归一化)
📌 说明:这张图和上面的指标来自 300 张合成数据训练 8 轮的演示结果,用于展示报告能力,不代表真实产线指标。真实产线应使用足量数据与更多轮次。
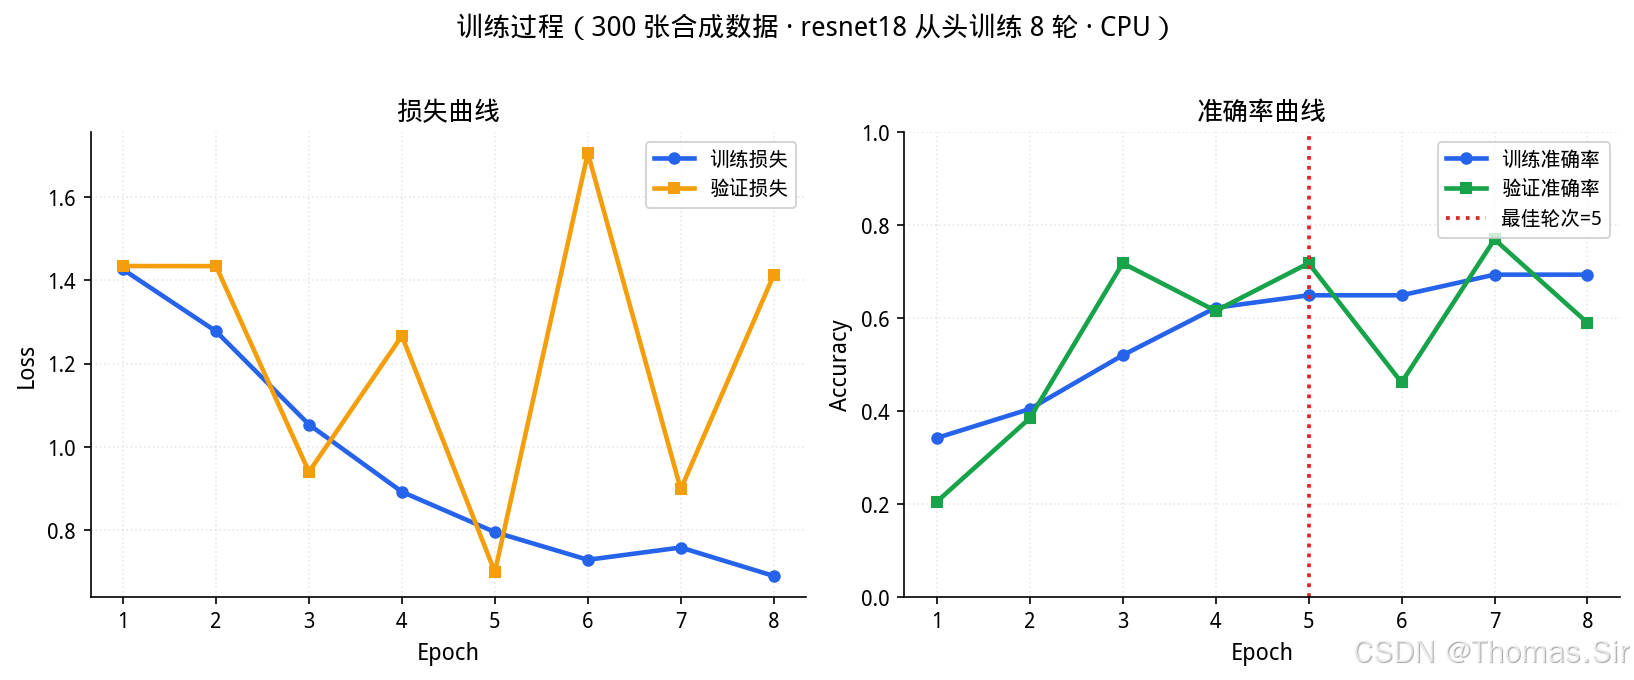
图 8-2 训练过程曲线 (读取 metrics.jsonl 绘制)
小样本下验证指标有波动是正常的,这正是早停机制存在的意义------它会挑出最佳轮次(图中红色虚线标注)的权重,而不是最后一轮。
8.2 报告产物的工程细节
python
# 用 matplotlib 的 Agg 无界面后端 → 服务器环境可直接出图
matplotlib.use("Agg")

# 中文字体缺失时静默降级 → 不会因字体问题中断报告生成
try:
    plt.rcParams["font.sans-serif"] = ["Noto Sans CJK SC"]
except Exception:
    pass    # 降级为默认字体,图照出,只是中文可能显示成方块
九、部署:ONNX + FastAPI
requirements.txt 里写了 fastapi 和 onnx 却没有任何代码,这是 Demo 项目的通病。补齐部署链路:
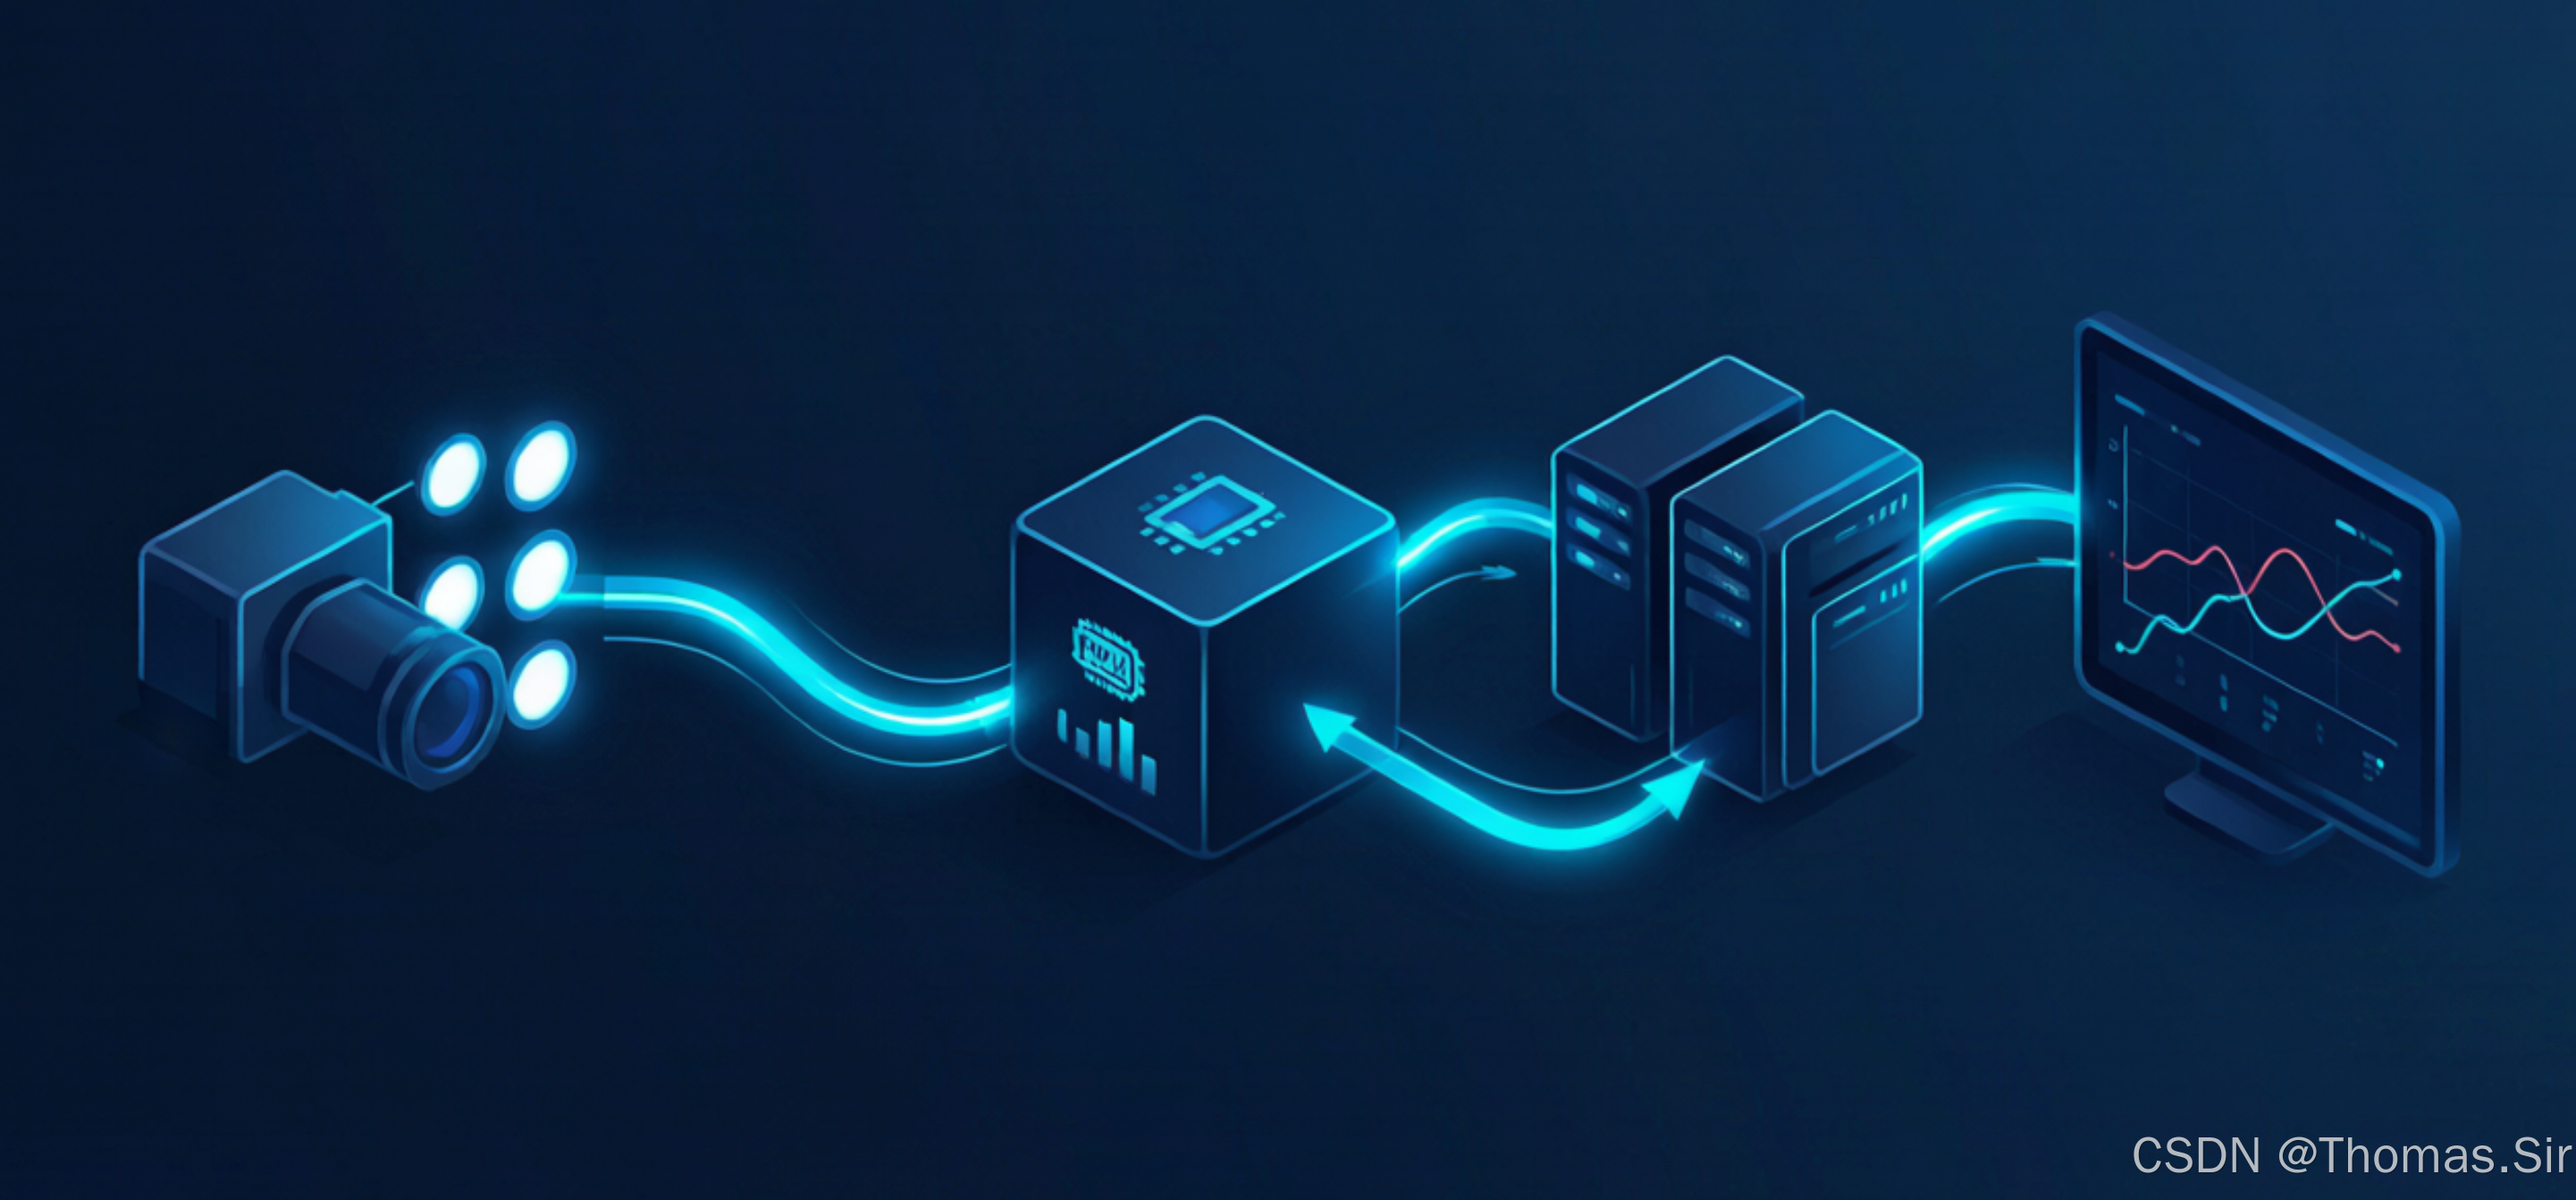
图 9-1 典型部署拓扑:相机 → 边缘工控机 → 云端训练 → 质量看板
9.1 ONNX 导出与一致性校验
这一步千万别省。 ONNX 转换过程中算子实现可能有细微差异,不校验就上线,等于埋雷。
bash
# 导出 ONNX 并做数值一致性校验(随机输入对比 torch 与 onnxruntime 输出)
python -m src.cli.export --checkpoint ./outputs/checkpoints/best_model.pt \
    --onnx ./outputs/model.onnx --verify

# 实测输出
# 一致性校验:{'ok': True, 'max_diff': 7.629e-06, 'tolerance': 0.0001}
实测最大误差 7.6e-06,远低于 1e-4 容差。导出配置:opset 17、输入名 input、输出名 logits、支持动态 batch。
9.2 HTTP 接口
| 接口 | 方法 | 说明 |
|---|---|---|
/healthz |
GET | 健康检查,返回状态与类别列表 |
/model_info |
GET | 类别、ok 索引、阈值、复核带、分辨率、后端类型 |
/predict |
POST (multipart) | 单图判定 |
/predict/batch |
POST (multipart) | 多图批量判定 |
9.3 判定结果示例
json
{
  "image": "IMG_20240501_0001.png",
  "pred_label": "scratch",
  "pred_index": 0,
  "confidence": 0.873,
  "decision": "NG",
  "need_review": false,
  "threshold": 0.86,
  "probs": {
    "scratch": 0.873, "dent": 0.060,
    "stain": 0.040,  "ok": 0.027
  }
}
注意 threshold: 0.86,但 p(ok) = 0.027 远低于它 → 判 NG。同时 confidence = 0.873 > review_band = 0.15 → 不需要复核,直接拦截。每个字段都能追溯到判定依据,出了客诉能复盘。
9.4 双后端一致性设计
python
class DefectPredictor:
    """统一预测器:PyTorch 与 ONNX Runtime 暴露完全一致的接口"""
    # predict_pil()    ------ 单张 PIL 图
    # predict_file()   ------ 单个文件
    # predict_paths()  ------ 路径列表
    # predict_dir()    ------ 整个目录
离线回测用 PyTorch,线上服务用 ONNX,但判定逻辑是同一份代码。这避免了经典的"离线看着准、上线不一样"。
十、实战:5 分钟跑通全流程
bash
# ① 安装依赖
pip install -r requirements.txt

# ② 生成合成演示数据(★ 不需要下载任何数据集,离线可跑)
python -m src.cli.make_demo_data --out-root ./data/raw --manifest ./data/manifest.csv \
    --classes scratch,dent,stain,ok --counts 40,40,40,80 --image-size 128

# ③ 训练(离线冒烟:2 轮、不加载预训练权重)
python -m src.cli.train --config configs/smoke.yaml --epochs 2 --set model.pretrained=false

# ④ 评估并生成质检报告(混淆矩阵 + 阈值曲线 + JSON 报告)
python -m src.cli.evaluate --config configs/smoke.yaml \
    --checkpoint ./outputs/checkpoints/best_model.pt --split test

# ⑤ 导出 ONNX 并做数值一致性校验
python -m src.cli.export --checkpoint ./outputs/checkpoints/best_model.pt \
    --onnx ./outputs/model.onnx --verify

# ⑥ 批量判定(torch 权重或 onnx 模型都支持)
python -m src.cli.predict --onnx ./outputs/model.onnx --input ./data/raw/ok \
    --output ./outputs/ok_predictions.csv

# ⑦ 启动在线服务:http://127.0.0.1:8000/docs
python -m src.cli.serve --onnx ./outputs/model.onnx --port 8000
常用配置覆盖
不用改 YAML,命令行直接覆盖:
bash
# 改学习率、批次与轮数
python -m src.cli.train --config configs/default.yaml \
    --set train.lr=5e-4 data.batch_size=64 train.epochs=50

# 换骨干 / 冻结骨干 / 灰度输入
python -m src.cli.train --config configs/default.yaml \
    --set model.name=efficientnet_b0 model.freeze_backbone=true data.image_mode=L

# 指定数据与输出目录(多实验对比)
python -m src.cli.train --config configs/default.yaml --manifest ./data/manifest.csv \
    --data-root ./data/raw --output-dir ./outputs/exp001
项目结构
industrial_defect_inspection/
├── configs/                  # default.yaml(生产)/ smoke.yaml(CI 冒烟)
├── src/
│   ├── config.py             # 配置加载、命令行覆盖、校验、快照
│   ├── seed.py               # 全局随机种子与确定性算法
│   ├── data/                 # manifest / transforms / dataset / dataloader
│   ├── models/               # factory:骨干工厂与分类头替换
│   ├── engines/              # trainer:训练循环;evaluator:质检报告
│   ├── inference/            # predictor / export_onnx / service
│   ├── utils/                # logger / checkpoint / metrics / threshold / visualization
│   └── cli/                  # 6 个子命令入口
├── tests/                    # 46 个单元测试(含端到端冒烟)
├── scripts/                  # run_demo.sh / run_tests.sh
├── README.md
└── ARCHITECTURE.md
十一、踩坑记录:这些坑我都踩过
坑 1:torch.cuda.amp 在新版本 PyTorch 上报错
python
# ❌ 旧写法(PyTorch 2.x 已废弃)
from torch.cuda.amp import autocast, GradScaler

# ✅ 新写法 + 兼容封装
# 优先 torch.amp.autocast(device_type=...),失败降级 torch.cuda.amp
# 并且:CPU 环境自动关闭 AMP,不会因为没 GPU 就崩
坑 2:pretrained=True 被移除
python
# ❌ 旧写法
models.resnet18(pretrained=True)

# ✅ 新写法
models.resnet18(weights=ResNet18_Weights.DEFAULT)
系统做了双重兜底:优先用新 API,失败则自动降级随机初始化并打印告警(不是静默失败)。这样内网/离线环境也能跑。
坑 3:为了下载权重关掉 SSL 证书校验
python
# ❌ 危险!原项目就是这么干的
import ssl
ssl._create_default_https_context = ssl._create_unverified_context这行代码会全局关闭证书校验 ,任何 HTTPS 请求都变得可被中间人攻击,安全审计必挂。正确做法是:权重加载失败就降级随机初始化 + 告警。不要为了可用性牺牲安全性。
坑 4:torch.load 默认参数的安全隐患
python
# ❌ 权重里塞满 optimizer 状态,部署时 weights_only=True 会拒绝加载
torch.save({"model": model.state_dict(), "optimizer": opt.state_dict()}, path)

# ✅ 分离:部署权重只存 state_dict
torch.save(model.state_dict(), "best_model.pt")        # 可 weights_only 加载
torch.save(full_state, "epoch_10.pt")                  # 显式声明不可 weights_only
# 元信息(类别/阈值/分辨率)单独存 .meta.json
坑 5:日志重复打印
python
# ❌ 每次实例化 Logger 都 addHandler,测试里实例化 5 次就打印 5 遍
self.logger.addHandler(console_handler)

# ✅ 先清理历史 handler
for h in list(self.logger.handlers):
    self.logger.removeHandler(h)
坑 6:TensorBoard 初始化失败导致训练中断
python
# ✅ 降级处理:TB 挂了也要能训练
try:
    self.tb_writer = SummaryWriter(tb_dir)
except Exception:
    self.tb_writer = None    # 降级为纯文本日志
十二、测试体系:46 个用例的分层设计
| 层级 | 覆盖范围 | 依赖 PyTorch | 用途 |
|---|---|---|---|
| 纯逻辑 | 清单解析与划分、指标、阈值搜索、配置校验 | ❌ 否 | 最快的回归网,秒级反馈 |
| 数据管线 | 变换、数据集、坏图兜底、采样与加载器 | ✅ | 验证数据层健壮性 |
| 模型 | 各骨干前向、灰度输入、冻结策略 | ✅ | 防止换骨干踩坑 |
| 引擎 | 真实训练 2 轮、验证指标、元信息可部署 | ✅ | 端到端训练闭环 |
| 评估 | 概率推理、报告字段、图表产物 | ✅ | 报告契约不被破坏 |
| 推理 | Torch/ONNX 一致性、批量预测、CSV/JSON 导出 | ✅ | 部署链路可信赖 |
| 服务 | 全部 4 个 HTTP 接口 | ✅ | 接口契约 |
| 端到端 | 造数 → 训练 → 评估 → 导出 → 预测 | ✅ | 全 CLI 串通 |
bash
python -m pytest -v
# 46 passed in ~30s
为什么把"纯逻辑"单独分层? 阈值搜索、业务指标、清单划分这些是业务规则,改动频率远高于模型代码,而且完全不依赖 GPU。把它们做成秒级可测的纯 NumPy 函数,能极大提升迭代信心。
数据全部由 make_demo_data 合成,不依赖外网下载任何数据集或预训练权重,CI 可直接运行。
十三、已知边界与后续方向
诚实说明这套系统的能力边界:
| 边界 | 说明 | 后续方向 |
|---|---|---|
| 只分类,不定位 | 输出整图类别,不给出缺陷位置与尺寸 | 引入检测/分割模型,清单扩展为带框标注 |
| 阈值依赖数据分布 | 换相机、光照改造、新产品导入后需重跑寻优 | 接入阈值漂移监控看板 |
| 小样本风险 | 每类样本过少时指标置信度低,系统仅告警不阻断 | 主动学习 + 难例挖掘 |
| ONNX 导出链路 | 默认用稳定的 TorchScript 路径(dynamo=False) |
切 dynamo 时需复核容差与动态轴 |
关于阈值漂移的提醒(这是我见过最现实的问题):
阈值是在验证集上寻优得到的,它只在"验证集分布 ≈ 线上分布"时成立。一旦:
- 更换相机或镜头
- 车间照明改造
- 导入新产品/新产线
- 供应商更换原材料
就必须重新采集数据并重跑阈值寻优。建议把漏检率/过杀率做成监控看板,一旦漂移超阈值就告警。
十四、总结
从学术 Demo 到产线工程,改动最大的不是模型,而是围绕模型的工程决策。回头看,最有价值的五个改动是:
- 按批次分组划分 ------ 一行配置的差别,可能是验证指标虚高 20 个点的差别
- 阈值保守判定替代 argmax ------ 让漏检率从"不可控"变成"可配置、可验证"
feasible=False的诚实设计 ------ 达不到业务目标就明说,绝不悄悄放宽- 权重与元信息分离 ------ 部署侧零依赖,安全性与可用性双赢
- 决策层用纯 NumPy 实现 ------ 业务规则可独立测试、独立迭代,不受模型改动影响
最后给一句我认为最重要的建议:
在工业质检场景,不要问"模型准确率多少",要问"漏检率能不能接受、过杀率要付出多少代价"。
前者是技术指标,后者才是业务决策。