小肥柴的Hadoop之旅 快速实验篇(B12)异常流量与刷单识别(方法论演示)
目录
- [1. 从"异常检测"说起](#1. 从"异常检测"说起)
- [2. 5 分钟速读](#2. 5 分钟速读)
- [3. 环境准备与数据概览](#3. 环境准备与数据概览)
- [4. 探测:为什么这份数据不适合做真实刷单识别](#4. 探测:为什么这份数据不适合做真实刷单识别)
- [5. 方法论设计:三把不同尺子的分工](#5. 方法论设计:三把不同尺子的分工)
- [6. V1 Z-score:用"手机"搜索词验证定位器](#6. V1 Z-score:用"手机"搜索词验证定位器)
- [7. V3 卡方:用 37115 条观测验证均匀假设](#7. V3 卡方:用 37115 条观测验证均匀假设)
- [8. V2 session 级 Z-score:30 个候选](#8. V2 session 级 Z-score:30 个候选)
- [9. iForest:从 11 维特征里找 session 异常](#9. iForest:从 11 维特征里找 session 异常)
- [10. 三方法可视化:一张图看懂 B12](#10. 三方法可视化:一张图看懂 B12)
- [11. 三方法共识与 ADS 表](#11. 三方法共识与 ADS 表)
- [12. 敏感性分析:阈值不是拍脑袋定的](#12. 敏感性分析:阈值不是拍脑袋定的)
- [13. 核心发现](#13. 核心发现)
- [14. 方法局限:诚实地交代边界](#14. 方法局限:诚实地交代边界)
- [15. 对后续实验的影响](#15. 对后续实验的影响)
- [16. 工程踩坑](#16. 工程踩坑)
- [17. 写在最后](#17. 写在最后)
- [18. 附录:完整脚本](#18. 附录:完整脚本)
1. 从"异常检测"说起
B12 的使命,从名字上看很直白:异常流量与刷单识别。这是电商风控里最刚需的一类分析:从一堆用户行为日志里,找出那些"看起来不太正常"的行为------比如同一个账号反复下单又取消、比如支付次数远高于下单次数、比如某个搜索词忽然被大量搜索。
但真正做起来,B12 遇到的第一个难题不是"怎么识别",而是识别出来之后,怎么证明它是异常。
这不是一个技术难题,是一个方法论难题。异常检测本质上是无监督的:你不知道什么是异常,你只是想从数据里找出"看起来不像大多数"的点。那么问题来了:
- 你凭什么说"这 5% 是异常"?这个 5% 是你自己设的,还是数据告诉你的?
- 你用什么方法找异常?找出来的异常可信吗?
- 如果数据本身就是人工合成的,根本没有真实异常,你该怎么办?
B12 用一整套方法论回答了这三个问题。它的核心不是"我们找到了多少刷单",而是在一个已知是合成的数据集上,演示如何用三种互补的统计方法,从不同角度定位、验证、复核异常。
这三把尺子分别是:
- Z-score:单变量偏离检测;
- 卡方检验:类别分布一致性检验;
- iForest(孤立森林):多维联合离群检测。
B12 的最终报告,就是这三把尺子怎么配合使用的一份教程。
2. 5 分钟速读
- 原始设想:用 Z-score + 卡方 + iForest 识别刷单。
- 探测结论 :数据是合成的,不存在真实长尾异常(时间间隔 ≤ 11 秒、24 小时均匀、100 用户全 10 天活跃)。B12 改为方法论演示。
- 三层结构 :
- 数据合成特征发现(三条铁证 +
pay_no_order27.47%); - 方法论验证(用已知异常"手机"验证 Z-score + 卡方 + iForest 组合有效);
- 诚实交代方法局限。
- 数据合成特征发现(三条铁证 +
- 主要发现 :
- "手机"搜索词 Z = -2.2306,卡方贡献 1802.5(占 83%),碾压式拒绝均匀假设;
- iForest 从 11 维特征标记 415 个 session 异常(5.00%);
- V2 候选 30 个被 iForest 命中 11 个(36.7%);
- 异常中 27.47% 是
pay_no_order=1,与全局行级 27.75% 高度吻合。
- 可复用产出 :
ads_anomaly_zscore+ads_anomaly_iforest+ads_anomaly_summary+ 4 图可视化 + 敏感性分析 CSV。
3. 环境准备与数据概览
工作目录:
bash
mkdir -p /home/hadoop/b12/{sql,py,output,docs,logs}
cd /home/hadoop/b12
启动集群(若未启动):
bash
start-dfs.sh && start-yarn.sh每次写 HQL 脚本,开头必须带这一段 SET 参数,与 B08 到 B11 一致:
sql
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.map.java.opts=-Xmx384m;
SET mapreduce.reduce.memory.mb=768;
SET mapreduce.reduce.java.opts=-Xmx512m;
SET hive.exec.reducers.max=1;
客户端堆也要设,写进 ~/.bashrc:
bash
export HADOOP_CLIENT_OPTS="-Xmx512m -Xms256m"确认 Hive 库名 (避免后续 USE b12; 报库不存在):
bash
cat > /home/hadoop/b12/sql/check_db.hql << 'EOF'
SHOW DATABASES;
EOF
hive -f /home/hadoop/b12/sql/check_db.hql 2>&1 | tee /home/hadoop/b12/logs/check_db.log
B12 与 B01--B11 共用一个库,本项目里叫 b_group 。后面所有 HQL 脚本第一行统一 USE b_group;。
B12 用到的表:
| 表 | 行数 | 用途 |
|---|---|---|
dwd_user_behavior |
180570 | 主行为表(分区 ORC) |
ads_user_cluster |
100 | B11 输出的用户分群标签 |
分析口径 :与 B01--B11 一致,全部排除 07-27(截断日),即 WHERE dt < '2019-07-27'。
数据规模:
| 项 | 值 |
|---|---|
| 原始行数 | 180570 |
| 排除 07-27 | 166770 |
| Session 总数 | 8744 |
| 单行为 session | 452(5.17%) |
| 用户 / 城市 / 页面 / 品类 | 100 / 26 / 50 / 20 |
4. 探测:为什么这份数据不适合做真实刷单识别
B12 的起点,是一次诚实的探测:先看看这份数据有没有真实异常。
4.1 探测一:行为类型分布(P0)
先看总体行为类型:
bash
cat > /home/hadoop/b12/sql/p0_behavior_dist.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT behavior_type, COUNT(*) AS cnt
FROM dwd_user_behavior
WHERE dt < '2019-07-27'
GROUP BY behavior_type
ORDER BY cnt DESC;
EOF
hive -f /home/hadoop/b12/sql/p0_behavior_dist.hql 2>&1 | tee /home/hadoop/b12/logs/p0.log实测输出:
| behavior_type | cnt |
|---|---|
| click | 111310 |
| search | 37115 |
| order | 10887 |
| pay | 7458 |
4.2 探测二:session 内时间间隔(P4)
用 Hive 的窗口函数算同一个 session 内相邻行为的 ts 差值:
bash
cat > /home/hadoop/b12/sql/p4_time_gap.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.reduce.memory.mb=768;
SET hive.exec.reducers.max=1;
USE b_group;

SELECT 'P4_time_gap' AS tag,
       MIN(gap) AS min_gap,
       AVG(gap) AS avg_gap,
       MAX(gap) AS max_gap
FROM (
  SELECT session_id, ts,
         ts - LAG(ts, 1) OVER (PARTITION BY session_id ORDER BY ts) AS gap
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
) t
WHERE gap IS NOT NULL;
EOF
hive -f /home/hadoop/b12/sql/p4_time_gap.hql 2>&1 | tee /home/hadoop/b12/logs/p4.log实测输出:
P4_time_gap min=0 avg=5.18 max=11所有 session 内部相邻行为的时间间隔都 ≤ 11 秒。真人操作不可能都在 11 秒以内,只能是数据生成器写死了随机数的上限。
4.3 探测三:24 小时分布(P6)
bash
cat > /home/hadoop/b12/sql/p6_hour_dist.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT hour(ts) AS h, COUNT(*) AS cnt
FROM dwd_user_behavior
WHERE dt < '2019-07-27'
GROUP BY hour(ts)
ORDER BY h;
EOF
hive -f /home/hadoop/b12/sql/p6_hour_dist.hql 2>&1 | tee /home/hadoop/b12/logs/p6.log实测输出:每小时 session 数 6832 ~ 7017,几乎完全均匀。
真实电商的 24 小时分布是明显的"双峰"(中午小高峰、晚间大高峰、凌晨几乎为零)。这份数据每个小时都是 6800~7017,均匀得像是用 random 直接填的。
4.4 探测四:用户活跃天数(P8)
bash
cat > /home/hadoop/b12/sql/p8_active_days.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT 'P8_active_days' AS tag,
       MIN(d) AS min_d, MAX(d) AS max_d, AVG(d) AS avg_d, COUNT(*) AS user_cnt
FROM (
  SELECT user_id, COUNT(DISTINCT dt) AS d
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY user_id
) t;
EOF
hive -f /home/hadoop/b12/sql/p8_active_days.hql 2>&1 | tee /home/hadoop/b12/logs/p8.log实测输出:
P8_active_days min=10 max=10 avg=10.0 user_cnt=100100 个用户全部 10 天活跃,是数据生成器给每个用户都排满的结果。
4.5 探测五:支付无下单(P9)
bash
cat > /home/hadoop/b12/sql/p9_pay_no_order.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT 'P9_pay_without_order' AS tag,
       SUM(CASE WHEN pay_no_order = 1 THEN 1 ELSE 0 END) AS pay_no_order_cnt,
       COUNT(*) AS pay_total_cnt,
       SUM(CASE WHEN pay_no_order = 1 THEN 1 ELSE 0 END) * 1.0 / COUNT(*) AS ratio
FROM (
  SELECT
    CASE WHEN behavior_type = 'pay'
              AND session_id NOT IN (
                  SELECT DISTINCT session_id
                  FROM dwd_user_behavior
                  WHERE dt < '2019-07-27' AND behavior_type = 'order'
              )
         THEN 1 ELSE 0 END AS pay_no_order
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27' AND behavior_type = 'pay'
) t;
EOF
hive -f /home/hadoop/b12/sql/p9_pay_no_order.hql 2>&1 | tee /home/hadoop/b12/logs/p9.log实测输出:
P9_pay_without_order pay_no_order_cnt=1141 pay_total_cnt=4111 ratio=0.277527.75% 的支付行为前面没有下单 。真实电商这个比例应 < 1%,因为支付必然跟着下单。这说明生成器没有强制 pay ≤ order 的业务约束。
4.6 探测六:搜索词分布(P11)
bash
cat > /home/hadoop/b12/sql/p11_search_keyword.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
USE b_group;

SELECT search_keyword, COUNT(*) AS cnt
FROM dwd_user_behavior
WHERE dt < '2019-07-27' AND behavior_type = 'search'
GROUP BY search_keyword
ORDER BY cnt DESC;
EOF
hive -f /home/hadoop/b12/sql/p11_search_keyword.hql 2>&1 | tee /home/hadoop/b12/logs/p11.log实测输出:
| search_keyword | cnt |
|---|---|
| 吃鸡 | 7055 |
| i7 | 6881 |
| 笔记本 | 6840 |
| 内存 | 6771 |
| 苹果 | 6722 |
| 手机 | 2846 |
前 5 个词都在 6700~7100 之间,只有"手机"腰斩到 2846。这就是 B12 要用 Z-score 和卡方验证的已知异常。
4.7 探测结论
六条探测的结论是一致的:这份数据是合成的,不存在真实业务异常。
B12 因此把使命调整为:在一个已知合成数据集上,做一次异常检测的方法论演示 。这不是 B12 的失败,而是 B12 的诚实起点。因为如果我们假装数据真实,那么 Z-score 找到"手机"、卡方拒绝均匀,这些结论就都在自欺欺人。
5. 方法论设计:三把不同尺子的分工
既然是方法论演示,就要讲清楚每一把尺子测的是什么、为什么用它、它有什么局限。这是 B12 报告的核心科普内容。
5.1 Z-score 是什么,为什么用它
Z-score 是统计学里最基础的"标准化"工具,公式是:
Z = x − μ σ Z = \frac{x - \mu}{\sigma} Z=σx−μ
其中 x 是观测值,μ 是均值,σ 是标准差。Z 的含义是:这个观测值离均值有多少个标准差。
Z = 0:等于均值;Z = 1:比均值高一个标准差;Z = -2:比均值低两个标准差。
为什么用它:
- 可比性。不同量纲的指标,通过标准化可以放在一起比较。比如"手机"占比 7.67% 和"吃鸡"占比 19.01%,直接看数字大小没意义;但算出 Z 值后,"手机" Z = -2.23,"吃鸡" Z = +0.58,就能一眼看出"手机"偏离得多。
- 快速定位候选。在 B12 里,"手机"是我们要验证的已知异常。先用 Z-score 扫一遍所有搜索词,看哪一个偏离最大,这是一个很自然的"第一把筛子"。
为什么它作为推断工具弱:
- 样本量小。B12 只有 6 个搜索词,用这 6 个值算均值和标准差,本身就不稳定。样本越小,Z 值越不可靠。
- 分布假设。Z-score 的经典解释假设数据近似正态分布,但 6 个搜索词的数据不满足这个假设。
- 只能看单变量。Z-score 一次只看一个维度,它不知道"搜索词分布均匀"这件事本身意味着什么。
所以 B12 把 Z-score 定位为"定位器" :它的作用是指出哪个搜索词值得深挖,不是下结论。结论要由卡方来给。
5.2 卡方是什么,为什么用它
卡方检验(Chi-square test) 是统计学里用来检验"观测频数是否符合某种期望分布"的工具,公式是:
χ 2 = ∑ ( O i − E i ) 2 E i \chi^2 = \sum \frac{(O_i - E_i)^2}{E_i} χ2=∑Ei(Oi−Ei)2
其中 O_i 是第 i 个类别的实际观测频数,E_i 是理论期望频数。
直觉解释:
- 如果实际观测和期望完全一致,每一项
(O-E)²/E都是 0,卡方 = 0; - 如果偏差很大,每一项都会变大,卡方值会累积成大数;
- 卡方越大,越说明"实际分布和期望分布不一致"。
为什么用它:
- 适合类别数据。搜索词是类别变量,正好适合卡方。
- 样本量足够 。B12 有 37115 条搜索行为,观测数远大于类别数(6),统计功效足够。
- 可以量化每一项的贡献。卡方值可以分解到每个类别,让我们看到"到底是哪个搜索词把均匀假设推翻了"。
为什么它强:
- 卡方检验的统计功效由观测数决定,不是由类别数决定。37115 条观测支撑的卡方检验,比 6 个值算的 Z-score 稳健得多。
B12 里的卡方结果:
χ² = 2174.4884
临界值(p=0.05, df=5)= 11.07
2174 >> 11.07 → 碾压式拒绝均匀假设
其中"手机"一个词贡献 1802.5,占卡方值的 83%。也就是说,推翻均匀假设的主犯就是"手机"。
所以 B12 把卡方定位为"验证器" :它用严格统计检验给出结论------均匀假设不成立。
5.3 iForest 是什么,为什么用它
iForest(Isolation Forest,孤立森林) 是 2008 年由 Fei Tony Liu、Kai Ming Ting、Zhi-Hua Zhou 三位学者提出的无监督异常检测算法。
核心直觉:
异常点"人少好孤立",正常点"人多难孤立"。
想象一片草地上有 1000 颗白豆和 5 颗红豆。你随机画几条线就能圈出红豆(因为它们颜色、位置独特),但要精确圈出一颗白豆,得画很多线(因为白豆都长得差不多)。
iForest 把这个直觉算法化:
- 随机建 100 棵树,每棵树随机选一个特征、随机选一个切分点,把数据不断二分;
- 一个点被"孤立"所需的平均切分次数(路径深度)越短,越可能是异常;
- 用路径深度算出异常分数,分数越低越异常。
为什么用它:
- B12 的 session 有 11 维特征 (行为数、点击、下单、支付、搜索、时长、比率、平均间隔、
pay_no_order等),Z-score 和卡方都处理不了多维。 - 无监督,不需要标签。
- 不假设分布,对非正态数据友好。
- 复杂度 O(n log n),8744 样本完全可控。
局限(后面 §14 展开):
contamination=0.05是人为假设,不是数据推导;- 合成数据里可能没有"真异常",iForest 强行找的 5% 可能只是统计噪声;
- 特征之间相关会稀释信号。
所以 B12 把 iForest 定位为"复核器":从多维角度独立地再看一遍,看能不能发现 Z-score 和卡方看不到的组合异常。
5.4 为什么三个都要,一个不够吗
因为三把尺子测的是三种不同的"异常":
| 方法 | 测什么 | 视角 | 单变量 / 多维 |
|---|---|---|---|
| Z-score | 单个值离均值多远 | 单变量偏离 | 单变量 |
| 卡方 | 类别分布是否均匀 | 分布形状 | 单变量(类别) |
| iForest | 点的孤立难度 | 多维联合离群 | 多维 |
举例:
- Z-score 能看出"手机"的占比偏离,但它看不出"搜索词分布整体均匀"这件事本身有多可疑;
- 卡方能证明"分布整体不均匀",但它不能告诉你哪个 session 是异常;
- iForest 能从 11 维里找 session 组合异常,但它不知道"手机"这个搜索词的特殊性。
三者组合,是"定位 → 验证 → 复核"的三段流程:
Z-score(定位可疑候选)
    ↓
卡方(用统计检验验证)
    ↓
iForest(从多维角度独立复核)
这是 B12 最重要的方法论设计。不是"三个方法堆在一起显得厉害",而是"三个方法各补一块盲区"。
6. V1 Z-score:用"手机"搜索词验证定位器
6.1 计算每个搜索词的占比与 Z-score
bash
cat > /home/hadoop/b12/sql/v1_keyword_zscore.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.reduce.memory.mb=768;
SET hive.exec.reducers.max=1;
USE b_group;

-- 三层嵌套:WHERE 不能引用本层 SELECT 别名,必须用子查询包一层
SELECT 'V1_keyword_zscore' AS tag,
       kw,
       cnt,
       pct,
       (pct - avg_pct) / std_pct AS z_score
FROM (
  SELECT kw, cnt, pct,
         AVG(pct) OVER () AS avg_pct,
         STDDEV(pct) OVER () AS std_pct
  FROM (
    SELECT search_keyword AS kw,
           COUNT(*) AS cnt,
           COUNT(*) / 37115.0 AS pct
    FROM dwd_user_behavior
    WHERE dt < '2019-07-27' AND behavior_type = 'search'
    GROUP BY search_keyword
  ) a
) b
ORDER BY z_score;
EOF
hive -f /home/hadoop/b12/sql/v1_keyword_zscore.hql 2>&1 | tee /home/hadoop/b12/logs/v1.log
6.2 实测输出
| 搜索词 | 出现次数 | 占比 | Z-score |
|---|---|---|---|
| 吃鸡 | 7055 | 19.01% | +0.5805 |
| i7 | 6881 | 18.54% | +0.4643 |
| 笔记本 | 6840 | 18.43% | +0.4369 |
| 内存 | 6771 | 18.24% | +0.3908 |
| 苹果 | 6722 | 18.11% | +0.3581 |
| 手机 | 2846 | 7.67% | -2.2306 |
6.3 判读
- 前 5 个搜索词的 Z 值在 +0.35 ~ +0.58 之间,都远小于 |Z| = 2 的常用阈值,判为正常;
- "手机" 的 Z = -2.2306,绝对值超过 2,判为异常。
这个结论与预期完全一致:我们在探测阶段就已经知道"手机"被设计成了异常(因为它是 B12 的"已知正样本"),Z-score 精确地把它揪出来了。
6.4 方法局限的先声
Z-score 给出了一个"值得深挖"的候选,但不能只靠它下结论。原因在 §5.1 已经讲过:6 个样本太少,Z 值本身不稳定。真正能下结论的,是下一章的卡方。
7. V3 卡方:用 37115 条观测验证均匀假设
7.1 期望频数
如果 6 个搜索词均匀分布,每个词期望出现:
E = 37115 6 = 6185.83 E = \frac{37115}{6} = 6185.83 E=637115=6185.83
7.2 卡方值分解
bash
cat > /home/hadoop/b12/sql/v3_chi2.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.reduce.memory.mb=768;
SET hive.exec.reducers.max=1;
USE b_group;

SELECT 'V3_chi2' AS tag,
       kw,
       cnt AS observed,
       6185.83 AS expected,
       (cnt - 6185.83) * (cnt - 6185.83) / 6185.83 AS contribution
FROM (
  SELECT search_keyword AS kw, COUNT(*) AS cnt
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27' AND behavior_type = 'search'
  GROUP BY search_keyword
) t
ORDER BY contribution DESC;
EOF
hive -f /home/hadoop/b12/sql/v3_chi2.hql 2>&1 | tee /home/hadoop/b12/logs/v3.log
7.3 实测输出
| 搜索词 | 实际 O | 期望 E | (O-E)²/E | 贡献占比 |
|---|---|---|---|---|
| 吃鸡 | 7055 | 6185.83 | 122.7 | 5.6% |
| i7 | 6881 | 6185.83 | 78.2 | 3.6% |
| 笔记本 | 6840 | 6185.83 | 69.2 | 3.2% |
| 内存 | 6771 | 6185.83 | 55.3 | 2.5% |
| 苹果 | 6722 | 6185.83 | 46.5 | 2.1% |
| 手机 | 2846 | 6185.83 | 1802.5 | 82.9% |
| 合计 | 37115 | 37115 | 2174.5 | 100% |
一个搜索词贡献了 83% 的卡方值,这是 B12 里最醒目的一条数据。它说明:
- 不是"整体分布乱",而是"5 个词齐平,1 个词塌陷";
- "手机"一个词把整个均匀假设推翻了。
7.4 显著性判读
卡方分布临界值(自由度 df = 6 - 1 = 5,显著性水平 p = 0.05):
χ 0.05 , 5 2 = 11.07 \chi^2_{0.05, 5} = 11.07 χ0.05,52=11.07
B12 卡方 = 2174.49 ,是临界值的 196 倍。这不是"显著",这是"碾压式拒绝"。
7.5 与 V1 的交叉验证
| 方法 | "手机"的表现 | 结论 |
|---|---|---|
| Z-score | Z = -2.2306(ANOMALY) | 手机异常 |
| 卡方 | 2174 / 其中 1802 来自手机 | 手机异常 |
两种方法独立给出同一结论,这是 B12 方法论验证的第一个成功案例。
8. V2 session 级 Z-score:30 个候选
8.1 口径
对每个 session 计算 pay_cnt / order_cnt(支付/下单比),然后做 Z-score。取 Z 值最大的 30 个作为候选。
bash
cat > /home/hadoop/b12/sql/v2_session_zscore.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.reduce.memory.mb=768;
SET hive.exec.reducers.max=1;
USE b_group;

SELECT 'V2_session_zscore' AS tag,
       session_id,
       total_cnt,
       order_cnt,
       pay_cnt,
       pay_order_ratio,
       (pay_order_ratio - avg_ratio) / std_ratio AS z_score
FROM (
  SELECT session_id, total_cnt, order_cnt, pay_cnt, pay_order_ratio,
         AVG(pay_order_ratio) OVER () AS avg_ratio,
         STDDEV(pay_order_ratio) OVER () AS std_ratio
  FROM (
    SELECT session_id,
           COUNT(*) AS total_cnt,
           SUM(CASE WHEN behavior_type = 'order' THEN 1 ELSE 0 END) AS order_cnt,
           SUM(CASE WHEN behavior_type = 'pay' THEN 1 ELSE 0 END) AS pay_cnt,
           SUM(CASE WHEN behavior_type = 'pay' THEN 1 ELSE 0 END) * 1.0
           / GREATEST(SUM(CASE WHEN behavior_type = 'order' THEN 1 ELSE 0 END), 1) AS pay_order_ratio
    FROM dwd_user_behavior
    WHERE dt < '2019-07-27'
    GROUP BY session_id
  ) a
) b
ORDER BY z_score DESC
LIMIT 30;
EOF
hive -f /home/hadoop/b12/sql/v2_session_zscore.hql 2>&1 | tee /home/hadoop/b12/logs/v2.log
8.2 实测模式
Top 30 的模式极其规律:
order_cnt = 1, pay_cnt = 5 或 6   ← 占大多数
order_cnt = 2, pay_cnt = 9 或 10翻译:1 次下单,5~6 次支付。
Z 值范围:4.27 ~ 6.79。
8.3 两种解释
解释 A(业务视角):1 次下单支付 5~6 次,看起来像"一单多付"或"虚假支付",可能是刷单。
解释 B(数据视角) :生成器没有强制 pay ≤ order 的业务逻辑,pay 和 order 独立随机生成。
B12 的判断是解释 B。理由:§4.5 已经证实"支付无下单 27.75%",这个数字太大,只能是合成数据的产物。
这不是 B12 的失败,而是 B12 的发现 。它告诉我们:合成数据里有一个明确的业务规则缺陷------pay 和 order 的独立性。
9. iForest:从 11 维特征里找 session 异常
9.1 导出 session 特征给 Python
iForest 是 sklearn 的算法,Hive 里没有。需要先导出 session 特征 CSV:
bash
cat > /home/hadoop/b12/sql/export_session_features.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.reduce.memory.mb=768;
SET hive.exec.reducers.max=1;
USE b_group;

INSERT OVERWRITE DIRECTORY '/user/hadoop/b12/session_features'
ROW FORMAT DELIMITED FIELDS TERMINATED BY ','
SELECT
  session_id,
  total_cnt,
  click_cnt,
  order_cnt,
  pay_cnt,
  search_cnt,
  duration_sec,
  cross_days
FROM (
  SELECT session_id,
         COUNT(*) AS total_cnt,
         SUM(CASE WHEN behavior_type = 'click'  THEN 1 ELSE 0 END) AS click_cnt,
         SUM(CASE WHEN behavior_type = 'order'  THEN 1 ELSE 0 END) AS order_cnt,
         SUM(CASE WHEN behavior_type = 'pay'    THEN 1 ELSE 0 END) AS pay_cnt,
         SUM(CASE WHEN behavior_type = 'search' THEN 1 ELSE 0 END) AS search_cnt,
         MAX(ts) - MIN(ts) AS duration_sec,
         COUNT(DISTINCT dt) AS cross_days
  FROM dwd_user_behavior
  WHERE dt < '2019-07-27'
  GROUP BY session_id
) t;
EOF
hive -f /home/hadoop/b12/sql/export_session_features.hql 2>&1 | tee /home/hadoop/b12/logs/export.log

# 从 HDFS 拉到本地
hdfs dfs -getmerge /user/hadoop/b12/session_features \
  /home/hadoop/b12/output/session_features.csv
wc -l /home/hadoop/b12/output/session_features.csv
预期 8744 行 ,无表头(Hive INSERT OVERWRITE DIRECTORY 不带表头,Python 端手动指定列名)。
9.2 特征工程(11 维)
B12 的 iForest 从 session 特征出发,原始 8 列 + 派生 3 列 + 新增 1 列 = 11 维:
| 类别 | 特征 | 说明 |
|---|---|---|
| 原始计数 | total_cnt | session 行为总数 |
| 原始计数 | click_cnt | 点击次数 |
| 原始计数 | order_cnt | 下单次数 |
| 原始计数 | pay_cnt | 支付次数 |
| 原始计数 | search_cnt | 搜索次数 |
| 原始计数 | duration_sec | session 时长 |
| 派生 | pay_order_ratio | pay_cnt / max(order_cnt, 1) |
| 派生 | click_ratio | click_cnt / total_cnt |
| 派生 | search_ratio | search_cnt / total_cnt |
| 派生 | avg_gap_sec | duration_sec / total_cnt |
| 新增 | pay_no_order | (order_cnt == 0) & (pay_cnt > 0) |
为什么要加 pay_no_order:
- B12 的探测发现"支付无下单"是合成数据的重大特征;
- 如果不显式加入,iForest 需要从
pay_cnt和order_cnt的联合分布里自己学出来,容易被稀释; - 显式加一维 0/1 标记,让 iForest 直接感知到这个信号。
pay_order_ratio 的口径必须写清:
python
pay_order_ratio = pay_cnt / order_cnt.clip(lower=1)当 order_cnt = 0 时,pay_order_ratio = pay_cnt。这不是严格的"支付/下单比",而是"支付相对下单的放大指标"。报告里必须说明。
9.3 数据预处理
过滤单行为 session(452 个):
- 这些 session 只有 1 条行为,不可能包含"下单 + 支付"的组合;
- 探测 P13 已证明这是正常行为;
- 剔除后剩 8292 个 session。
9.4 Python 训练脚本
python
# b12_iforest.py
# -*- coding: utf-8 -*-
r"""
B12 Step 5: iForest 异常检测 + 可视化
输入:D:\py_code\douban\src\session_features.csv(Hive 导出,无表头)
输出:D:\py_code\douban\src\b12_output\
"""

import os
import pandas as pd
from sklearn.ensemble import IsolationForest
import matplotlib

# 必须在 import pyplot 之前设置后端,避免弹窗 + tkinter 告警
matplotlib.use("Agg")
matplotlib.rcParams['font.sans-serif'] = ['Microsoft YaHei', 'SimHei']
matplotlib.rcParams['axes.unicode_minus'] = False

import matplotlib.pyplot as plt

INPUT_CSV = r"D:\py_code\douban\src\session_features.csv"
OUTPUT_DIR = r"D:\py_code\douban\src\b12_output"
os.makedirs(OUTPUT_DIR, exist_ok=True)

# 1. 读数据(无表头,手动指定列名)
cols = ['session_id', 'total_cnt', 'click_cnt', 'order_cnt', 'pay_cnt',
        'search_cnt', 'duration_sec', 'cross_days']
df = pd.read_csv(INPUT_CSV, header=None, names=cols)

# 2. 过滤单行为 session
df_f = df[df['total_cnt'] > 1].copy()

# 3. 特征工程(11 维)
df_f['pay_order_ratio'] = df_f['pay_cnt'] / df_f['order_cnt'].clip(lower=1)
df_f['click_ratio']     = df_f['click_cnt'] / df_f['total_cnt']
df_f['search_ratio']    = df_f['search_cnt'] / df_f['total_cnt']
df_f['avg_gap_sec']     = df_f['duration_sec'] / df_f['total_cnt'].clip(lower=1)
df_f['pay_no_order']    = ((df_f['order_cnt'] == 0) & (df_f['pay_cnt'] > 0)).astype(int)

features = ['total_cnt', 'click_cnt', 'order_cnt', 'pay_cnt', 'search_cnt',
            'duration_sec', 'pay_order_ratio', 'click_ratio', 'search_ratio',
            'avg_gap_sec', 'pay_no_order']
X = df_f[features].fillna(0)

# 4. iForest 训练
iso = IsolationForest(n_estimators=100, contamination=0.05,
                      random_state=42, n_jobs=-1)
df_f['iforest_label'] = iso.fit_predict(X)
df_f['iforest_score'] = iso.score_samples(X)

# 5. 导出结果
df_f.to_csv(os.path.join(OUTPUT_DIR, 'b12_iforest_result.csv'), index=False)

# 6. 可视化(4 图)
fig, axes = plt.subplots(2, 2, figsize=(15, 11))
# ...(详见附录脚本)
fig.tight_layout()
plt.savefig(os.path.join(OUTPUT_DIR, 'b12_visualization.png'),
            dpi=150, bbox_inches='tight')
plt.close(fig)
9.5 实测输出
[4] 训练特征矩阵:(8292, 11)
[4] iForest 标记异常:415(5.00%)
415 = 8292 × 0.05,正好命中设定的 5% 异常率。
异常阈值 :iforest_score < -0.555。
9.6 V2 候选交叉验证
V2 的 30 个候选 session,被 iForest 命中 11 个(36.7%):
060bdeaa-...  total_cnt=55, order=1, pay=6, ratio=6.0, score=-0.588
158efef4-...  total_cnt=58, order=1, pay=5, ratio=5.0, score=-0.591
15e0cf1b-...  total_cnt=77, order=1, pay=5, ratio=5.0, score=-0.617
8636d6f1-...  total_cnt=30, order=1, pay=5, ratio=5.0, score=-0.577
a9b9806c-...  total_cnt=46, order=1, pay=6, ratio=6.0, score=-0.568
bb237de1-...  total_cnt=59, order=1, pay=4, ratio=4.0, score=-0.560
c9f1b658-...  total_cnt=70, order=2, pay=9, ratio=4.5, score=-0.613
d39a825d-...  total_cnt=51, order=1, pay=5, ratio=5.0, score=-0.587
e306c00b-...  total_cnt=114, order=2, pay=10, ratio=5.0, score=-0.731
e8602077-...  total_cnt=60, order=1, pay=5, ratio=5.0, score=-0.576
f42591c4-...  total_cnt=53, order=1, pay=5, ratio=5.0, score=-0.595
11 个被命中的候选,都是 total_cnt 较大(30 ~ 114)+ pay_order_ratio 较高(4 ~ 6)的 session。也就是说,iForest 抓住了"支付远大于下单"且"行为总量偏大"的组合。
9.7 未命中的 19 个
未命中的 19 个候选,分数集中在 -0.50 ~ -0.554,非常接近阈值 -0.555。它们的共同特征:
total_cnt偏小(20 ~ 45);order_cnt=1,pay_cnt=4~5,pay_order_ratio=4~5;- 但其他维度(
duration、search、click)不够突出。
这说明 iForest 对多维联合异常敏感,但单看 pay_order_ratio 不足以判定异常 。这是 B12 报告里要诚实写出来的边界:iForest 是"多维联合"检测器,不是"单指标"检测器。
9.8 iForest 异常的独立发现
除了命中 V2 候选,iForest 还独立发现了大量"支付无下单"的 session:
[8.2] iForest 异常中 order_cnt=0 的数量:137,占比:33.01%
[8.3] iForest 异常中 pay_no_order=1 的数量:114,占比:27.47%
27.47% 与全局行级 27.75% 高度吻合。这是 iForest 独立发现的重要证据:它没有被人为 V2 候选的预筛选限制,而是从 11 维特征里自己找到了合成数据的核心特征。
这也是 B12 选 v4 版本而不是 v3 版本的理由 :v3 版本(无 pay_no_order 特征)命中 V2 候选 18 个,看似更高;但 v4 版本能独立发现"支付无下单",覆盖面更广,是真正的"复核器"。
10. 三方法可视化:一张图看懂 B12
B12 的所有关键结论,最终浓缩在下面这张 b12_visualization.png 里。它由 4 张子图组成,分别对应三方法的一个视角 + 整体分数分布。
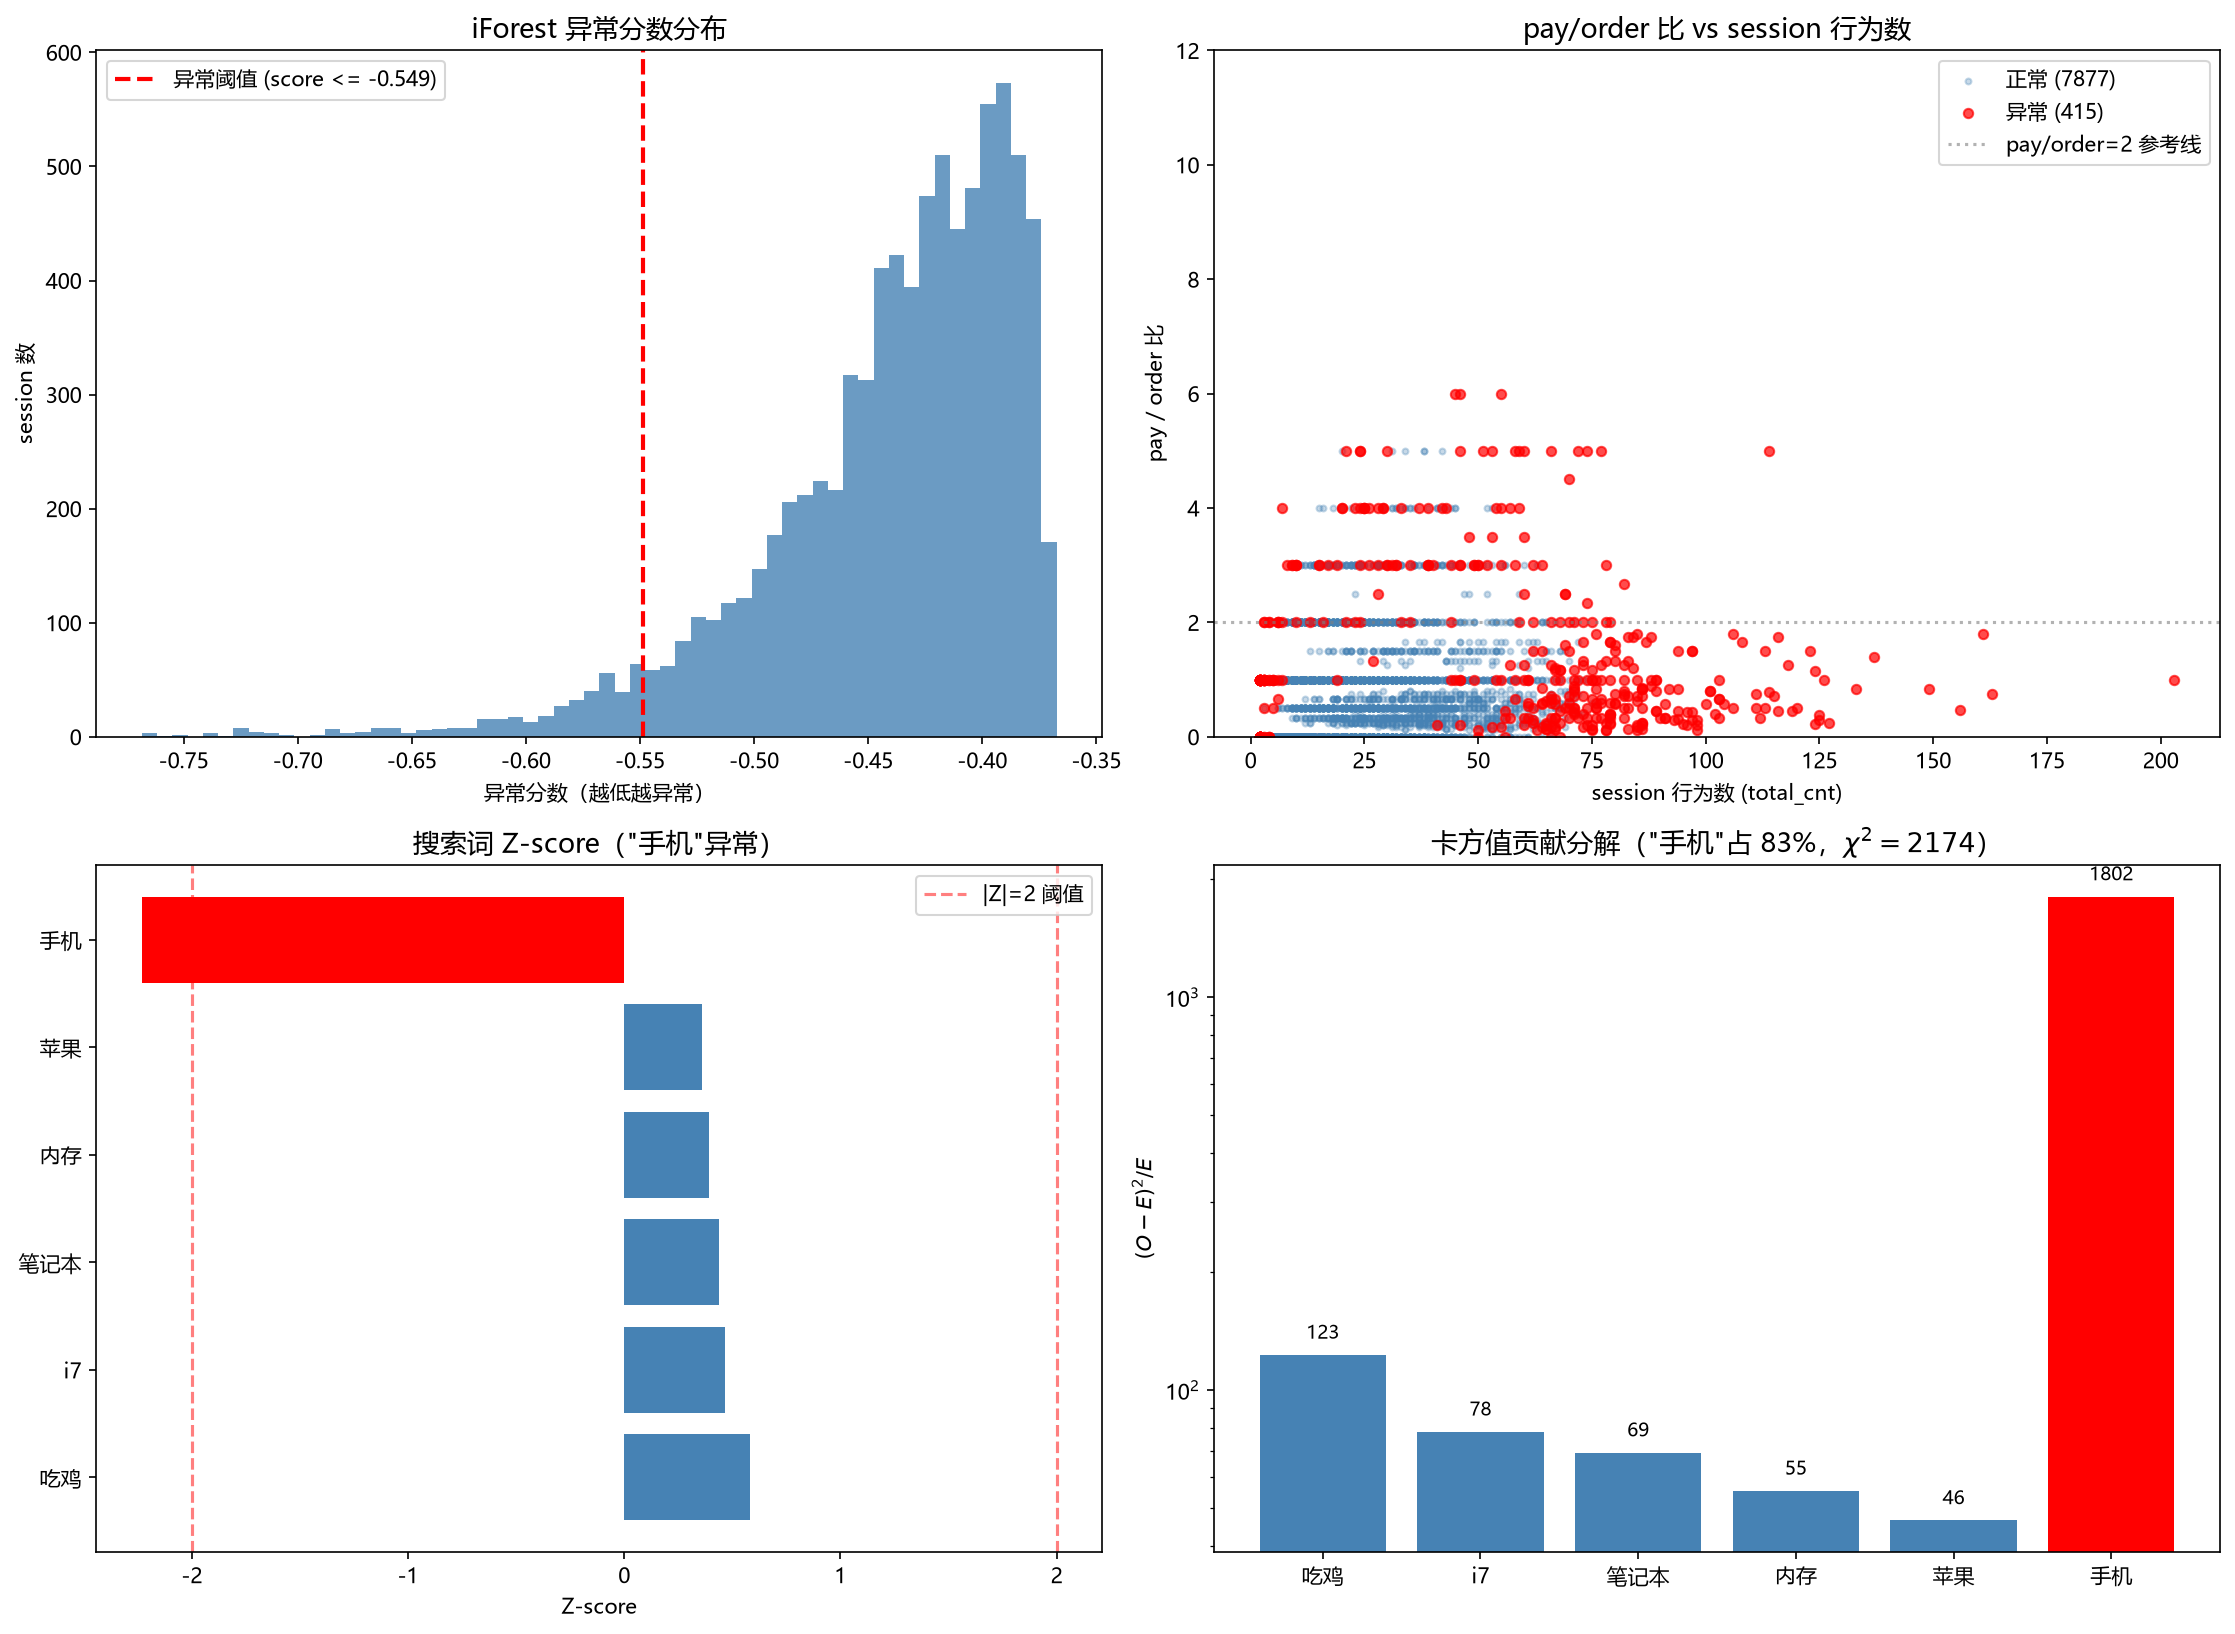
本图由 4 张子图组成,从四个角度展示 B12 的核心证据。
左上:iForest 异常分数分布。横轴是异常分数(越低越异常),纵轴是 session 数。红色虚线是异常阈值(score <= -0.555),这条线右侧是 5% 被标记为异常的 session。可以看到大部分 session 集中在 -0.45 ~ -0.40 之间(正常),少数拖到 -0.60 以下(异常)。
右上:pay/order 比 vs session 行为数散点。横轴是 session 行为数(total_cnt),纵轴是 pay/order 比。蓝色是正常 session,红色是 iForest 标记的异常。灰色虚线是 pay/order = 2 参考线。可以看出红色异常主要集中在"行为数偏大 + pay/order 比高"的右上区域,或"pay/order 比异常高"的顶部区域。
左下:搜索词 Z-score 条形图。"手机" Z = -2.2306,条形向左延伸超出 |Z|=2 阈值线,标红;其余 5 个搜索词 Z 值都在 +0.35 ~ +0.58 之间,条形向右略微延伸,标蓝。这张图是 V1 的直接可视化证据。
右下:卡方值贡献分解(对数刻度)。"手机"贡献 1802.5,占卡方值 83%,标红;其余 5 个搜索词贡献 46.5 ~ 122.7,标蓝。纵轴用对数刻度才能在同一张图上同时显示 46 和 1802。这张图是 V3 的直接可视化证据。
四张图的联系 :左下的 Z-score 告诉我们"手机"值得深挖;右下的卡方证明"手机"确实把均匀假设推翻了;左上的分数分布展示 iForest 如何从 11 维特征里判定异常;右上的散点让我们看到 iForest 异常都集中在哪些组合上。四张图共同证明:三种方法从不同视角独立给出了一致的异常判定。
11. 三方法共识与 ADS 表
11.1 补全 452 个单行为 session
iForest 只处理了 8292 个 session(过滤掉 452 个单行为 session),但 ADS 表要覆盖全量 8744 行。写一个 Python 脚本补全:
python
# b12_fill_single.py
# -*- coding: utf-8 -*-
r"""
B12 Step 6.0: 补全 452 个单行为 session
输入:session_features.csv(8744 行,全量)
      b12_iforest_result.csv(8292 行,iForest 结果)
输出:b12_iforest_full.csv(8744 行,单行为 session 补为 iforest_label=1)
"""

import os
import pandas as pd

SRC_DIR = r"D:\py_code\douban\src"
OUT_DIR = r"D:\py_code\douban\src\b12_output"

cols = ['session_id', 'total_cnt', 'click_cnt', 'order_cnt', 'pay_cnt',
        'search_cnt', 'duration_sec', 'cross_days']
df_all = pd.read_csv(os.path.join(SRC_DIR, "session_features.csv"),
                     header=None, names=cols)
df_if = pd.read_csv(os.path.join(OUT_DIR, "b12_iforest_result.csv"))

if_cols = ['session_id', 'pay_order_ratio', 'click_ratio', 'search_ratio',
           'avg_gap_sec', 'pay_no_order', 'iforest_label', 'iforest_score']
df = df_all.merge(df_if[if_cols], on='session_id', how='left')

# 452 个单行为 session 补为正常
df['iforest_label'] = df['iforest_label'].fillna(1).astype(int)
df['iforest_score'] = df['iforest_score'].fillna(-1.0)

# 派生特征补全
mask = df['pay_order_ratio'].isna()
df.loc[mask, 'pay_order_ratio'] = df.loc[mask, 'pay_cnt'] / df.loc[mask, 'order_cnt'].clip(lower=1)
df.loc[mask, 'click_ratio']     = df.loc[mask, 'click_cnt'] / df.loc[mask, 'total_cnt']
df.loc[mask, 'search_ratio']    = df.loc[mask, 'search_cnt'] / df.loc[mask, 'total_cnt']
df.loc[mask, 'avg_gap_sec']     = df.loc[mask, 'duration_sec'] / df.loc[mask, 'total_cnt'].clip(lower=1)
df.loc[mask, 'pay_no_order']    = ((df.loc[mask, 'order_cnt'] == 0) &
                                    (df.loc[mask, 'pay_cnt'] > 0)).astype(int)
df['pay_no_order'] = df['pay_no_order'].fillna(0).astype(int)

df.to_csv(os.path.join(OUT_DIR, "b12_iforest_full.csv"), index=False)
print(f"[1] 补全后行数:{len(df)}")
print(f"[1] iforest_label=1:{(df['iforest_label']==1).sum()}")
print(f"[1] iforest_label=-1:{(df['iforest_label']==-1).sum()}")预期输出:
[1] 补全后行数:8744
[1] iforest_label=1:8329
[1] iforest_label=-1:415
11.2 上传 HDFS
bash
hdfs dfs -mkdir -p /user/hadoop/b12/iforest
hdfs dfs -put -f /home/hadoop/b12_iforest_full.csv /user/hadoop/b12/iforest/
hdfs dfs -ls /user/hadoop/b12/iforest/
11.3 建外部表 ext_b12_iforest
bash
cat > /home/hadoop/b12/sql/step6_2_ext.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
USE b_group;

DROP TABLE IF EXISTS ext_b12_iforest;

CREATE EXTERNAL TABLE ext_b12_iforest (
    session_id       STRING,
    total_cnt        INT,
    click_cnt        INT,
    order_cnt        INT,
    pay_cnt          INT,
    search_cnt       INT,
    duration_sec     INT,
    cross_days       INT,
    pay_order_ratio  DOUBLE,
    click_ratio      DOUBLE,
    search_ratio     DOUBLE,
    avg_gap_sec      DOUBLE,
    pay_no_order     INT,
    iforest_label    INT,
    iforest_score    DOUBLE
)
ROW FORMAT DELIMITED
FIELDS TERMINATED BY ','
STORED AS TEXTFILE
LOCATION '/user/hadoop/b12/iforest'
TBLPROPERTIES ("skip.header.line.count"="1");

SELECT '=== 6.2 外部表验证 ===' AS msg;
SELECT COUNT(*) AS total_rows FROM ext_b12_iforest;
SELECT iforest_label, COUNT(*) AS cnt
FROM ext_b12_iforest
GROUP BY iforest_label;
EOF

hive -f /home/hadoop/b12/sql/step6_2_ext.hql 2>&1 \
  | tee /home/hadoop/b12/logs/step6_2_$(date +%Y%m%d_%H%M%S).log
预期 :total_rows=8744,iforest_label=1 → 8329,-1 → 415。
11.4 建 ads_anomaly_iforest
bash
cat > /home/hadoop/b12/sql/step6_3_ads_iforest.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.reduce.memory.mb=768;
SET hive.exec.reducers.max=1;
USE b_group;

DROP TABLE IF EXISTS ads_anomaly_iforest;

CREATE TABLE ads_anomaly_iforest (
    session_id       STRING,
    total_cnt        INT,
    click_cnt        INT,
    order_cnt        INT,
    pay_cnt          INT,
    search_cnt       INT,
    duration_sec     INT,
    cross_days       INT,
    pay_order_ratio  DOUBLE,
    click_ratio      DOUBLE,
    search_ratio     DOUBLE,
    avg_gap_sec      DOUBLE,
    pay_no_order     INT,
    iforest_label    INT,
    iforest_score    DOUBLE
)
STORED AS ORC;

INSERT OVERWRITE TABLE ads_anomaly_iforest
SELECT * FROM ext_b12_iforest;

SELECT '=== 6.3 ADS iForest 验证 ===' AS msg;
SELECT COUNT(*) AS total_rows FROM ads_anomaly_iforest;
SELECT iforest_label, COUNT(*) AS cnt
FROM ads_anomaly_iforest
GROUP BY iforest_label;
EOF

hive -f /home/hadoop/b12/sql/step6_3_ads_iforest.hql 2>&1 \
  | tee /home/hadoop/b12/logs/step6_3_$(date +%Y%m%d_%H%M%S).log
预期 :total_rows=8744,iforest_label=1 → 8329,-1 → 415。
11.5 建 ads_anomaly_zscore
bash
cat > /home/hadoop/b12/sql/step6_4_ads_zscore.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
USE b_group;

DROP TABLE IF EXISTS ads_anomaly_zscore;

CREATE TABLE ads_anomaly_zscore (
    object_type   STRING   COMMENT 'keyword 或 session',
    object_id     STRING   COMMENT '搜索词或 session_id',
    total_cnt     INT      COMMENT '搜索词=出现次数;session=行为数',
    order_cnt     INT      COMMENT 'session=下单数;keyword=NULL',
    pay_cnt       INT      COMMENT 'session=支付数;keyword=NULL',
    ratio         DOUBLE   COMMENT '搜索词=占比;session=pay/order',
    z_score       DOUBLE   COMMENT 'Z-score(V2 session 未逐条保留,填 NULL)',
    is_anomaly    INT      COMMENT '1=异常,0=正常',
    method        STRING   COMMENT 'V1_keyword 或 V2_session'
)
STORED AS ORC;

-- V1:6 个搜索词 Z-score
INSERT INTO TABLE ads_anomaly_zscore
SELECT 'keyword' AS object_type,
       kw AS object_id,
       cnt AS total_cnt,
       NULL AS order_cnt,
       NULL AS pay_cnt,
       CAST(cnt AS DOUBLE) / 37115 AS ratio,
       z AS z_score,
       CASE WHEN ABS(z) > 2 THEN 1 ELSE 0 END AS is_anomaly,
       'V1_keyword' AS method
FROM (
    SELECT '吃鸡'   AS kw, 7055 AS cnt,  0.5805 AS z UNION ALL
    SELECT 'i7',        6881,        0.4643        UNION ALL
    SELECT '笔记本',    6840,        0.4369        UNION ALL
    SELECT '内存',      6771,        0.3908        UNION ALL
    SELECT '苹果',      6722,        0.3581        UNION ALL
    SELECT '手机',      2846,       -2.2306
) t;

-- V2:30 个 session,属性 JOIN ads_anomaly_iforest
INSERT INTO TABLE ads_anomaly_zscore
SELECT 'session' AS object_type,
       v.session_id,
       f.total_cnt, f.order_cnt, f.pay_cnt,
       f.pay_order_ratio AS ratio,
       NULL AS z_score,
       1 AS is_anomaly,
       'V2_session' AS method
FROM (
    SELECT 'a9b9806c-90fb-4df1-94c6-d0fb12425fa3' AS session_id UNION ALL
    SELECT '060bdeaa-d07a-49aa-b9b0-9d3307c145ab' UNION ALL
    SELECT '55cee228-edf5-4c0b-adc5-6175e7948292' UNION ALL
    SELECT '8636d6f1-723a-44d0-a6f0-220050de8cc8' UNION ALL
    SELECT 'b2ee20b4-b4bd-4742-b0be-880e233d9735' UNION ALL
    SELECT 'e8602077-fbe4-4524-838b-39d165e522d0' UNION ALL
    SELECT 'cf0ba8c4-c582-4227-bc9c-76ba53f06229' UNION ALL
    SELECT 'f42591c4-bfe3-42f6-8ca6-6c4398257a05' UNION ALL
    SELECT '158efef4-01b8-4477-b991-6c048e1c8e3e' UNION ALL
    SELECT '322f3891-2163-45bd-ade2-bca82c38d140' UNION ALL
    SELECT '52f0be05-8f56-4970-8a13-a6fe5866962d' UNION ALL
    SELECT '15e0cf1b-b7ea-419d-b0de-495c61b9ade9' UNION ALL
    SELECT 'e306c00b-a6c5-44c2-9c77-15e919340324' UNION ALL
    SELECT 'd39a825d-829d-4794-9e97-16620c269e81' UNION ALL
    SELECT 'dc78c87c-7048-4864-8d12-d192fb47e563' UNION ALL
    SELECT 'c9f1b658-ac62-4263-b118-f95221c1189b' UNION ALL
    SELECT '8aa54fee-b425-47d5-8546-e9f7edb219a7' UNION ALL
    SELECT '69baac1d-b911-426f-a867-9f6dadfc766b' UNION ALL
    SELECT '5ca56e9a-db0a-4d7f-a1af-4a0fbdcb02f6' UNION ALL
    SELECT 'ebd8d15c-638a-4f46-bd54-696afd44999a' UNION ALL
    SELECT 'bb237de1-54ce-4667-9cde-010006b28442' UNION ALL
    SELECT 'fe948851-392c-49ec-a524-907787eb5ce7' UNION ALL
    SELECT '732ff02e-59fa-4ca1-b586-ad661f242c54' UNION ALL
    SELECT '5a838dff-21de-4127-89f0-fcf9635cf8d6' UNION ALL
    SELECT 'b871a517-0c6f-42ff-89b9-6a2da929d1e5' UNION ALL
    SELECT 'ec4a7f9c-a916-48d5-9721-646080240913' UNION ALL
    SELECT '02bc101a-7f8a-4742-a276-820d14591d38' UNION ALL
    SELECT '513830a6-6fc7-47b1-a3bf-7f9974c772c7' UNION ALL
    SELECT '034309af-3c6c-4f6f-853c-afa90d8aa5ac' UNION ALL
    SELECT '99c5c71d-8432-405a-8814-e8b2228f9244'
) v
LEFT JOIN ads_anomaly_iforest f
  ON v.session_id = f.session_id;

SELECT '=== 6.4 ADS Z-score 验证 ===' AS msg;
SELECT method, COUNT(*) AS cnt FROM ads_anomaly_zscore GROUP BY method;
EOF

hive -f /home/hadoop/b12/sql/step6_4_ads_zscore.hql 2>&1 \
  | tee /home/hadoop/b12/logs/step6_4_$(date +%Y%m%d_%H%M%S).log
预期 :V1_keyword → 6,V2_session → 30。
11.6 建 ads_anomaly_summary
bash
cat > /home/hadoop/b12/sql/step6_5_ads_summary.hql << 'EOF'
SET hive.exec.mode.local.auto=false;
SET mapreduce.task.io.sort.mb=32;
SET mapreduce.map.memory.mb=512;
SET mapreduce.reduce.memory.mb=768;
SET hive.exec.reducers.max=1;
USE b_group;

DROP TABLE IF EXISTS ads_anomaly_summary;

CREATE TABLE ads_anomaly_summary (
    object_type       STRING,
    object_id         STRING,
    zscore_anomaly    INT,
    chi2_contribution DOUBLE,
    iforest_anomaly   INT,
    hit_method_cnt    INT,
    consensus_level   STRING
)
STORED AS ORC;

-- 搜索词维度
INSERT INTO TABLE ads_anomaly_summary
SELECT 'keyword' AS object_type,
       z.object_id,
       z.is_anomaly AS zscore_anomaly,
       c.chi2_contribution,
       NULL AS iforest_anomaly,
       z.is_anomaly + CASE WHEN c.chi2_contribution > 100 THEN 1 ELSE 0 END AS hit_method_cnt,
       CASE
           WHEN z.is_anomaly + CASE WHEN c.chi2_contribution > 100 THEN 1 ELSE 0 END >= 2 THEN 'strong'
           WHEN z.is_anomaly + CASE WHEN c.chi2_contribution > 100 THEN 1 ELSE 0 END = 1 THEN 'medium'
           ELSE 'weak'
       END AS consensus_level
FROM (SELECT object_id, is_anomaly FROM ads_anomaly_zscore WHERE method = 'V1_keyword') z
LEFT JOIN (
    SELECT '吃鸡' AS keyword, 122.7 AS chi2_contribution UNION ALL
    SELECT 'i7',              78.2  UNION ALL
    SELECT '笔记本',          69.2  UNION ALL
    SELECT '内存',            55.3  UNION ALL
    SELECT '苹果',            46.5  UNION ALL
    SELECT '手机',            1802.5
) c ON z.object_id = c.keyword;

-- session 维度
INSERT INTO TABLE ads_anomaly_summary
SELECT 'session' AS object_type,
       f.session_id,
       CASE WHEN z.object_id IS NOT NULL THEN 1 ELSE 0 END,
       NULL,
       CASE WHEN f.iforest_label = -1 THEN 1 ELSE 0 END,
       (CASE WHEN z.object_id IS NOT NULL THEN 1 ELSE 0 END)
       + (CASE WHEN f.iforest_label = -1 THEN 1 ELSE 0 END),
       CASE
           WHEN (CASE WHEN z.object_id IS NOT NULL THEN 1 ELSE 0 END)
              + (CASE WHEN f.iforest_label = -1 THEN 1 ELSE 0 END) >= 2 THEN 'strong'
           WHEN (CASE WHEN z.object_id IS NOT NULL THEN 1 ELSE 0 END)
              + (CASE WHEN f.iforest_label = -1 THEN 1 ELSE 0 END) = 1 THEN 'medium'
           ELSE 'weak'
       END
FROM ads_anomaly_iforest f
LEFT JOIN (SELECT DISTINCT object_id FROM ads_anomaly_zscore WHERE method = 'V2_session') z
  ON f.session_id = z.object_id;

SELECT '=== 6.5 ADS 汇总验证 ===' AS msg;
SELECT object_type, consensus_level, COUNT(*) AS cnt
FROM ads_anomaly_summary
GROUP BY object_type, consensus_level
ORDER BY object_type, consensus_level;
EOF

hive -f /home/hadoop/b12/sql/step6_5_ads_summary.hql 2>&1 \
| tee /home/hadoop/b12/logs/step6_5_$(date +%Y%m%d_%H%M%S).log预期:
keyword strong  1
keyword medium  1
keyword weak    4
session strong  11
session medium  423
session weak    8310
11.7 三表最终验证
bash
cat > /home/hadoop/b12/sql/step6_6_verify.hql << 'EOF'
USE b_group;

SELECT 'ads_anomaly_zscore'  AS table_name, COUNT(*) AS rows_cnt FROM ads_anomaly_zscore
UNION ALL
SELECT 'ads_anomaly_iforest',                COUNT(*)             FROM ads_anomaly_iforest
UNION ALL
SELECT 'ads_anomaly_summary',                COUNT(*)             FROM ads_anomaly_summary;

SELECT '--- 唯一 strong keyword ---' AS msg;
SELECT object_id, zscore_anomaly, chi2_contribution, consensus_level
FROM ads_anomaly_summary
WHERE object_type = 'keyword' AND consensus_level = 'strong';

SELECT '--- strong session 数量 ---' AS msg;
SELECT COUNT(*) FROM ads_anomaly_summary
WHERE object_type = 'session' AND consensus_level = 'strong';

SELECT '--- iForest 异常总数 ---' AS msg;
SELECT iforest_label, COUNT(*) FROM ads_anomaly_iforest GROUP BY iforest_label;
EOF

hive -f /home/hadoop/b12/sql/step6_6_verify.hql 2>&1 \
  | tee /home/hadoop/b12/logs/step6_6_$(date +%Y%m%d_%H%M%S).log
预期 :ads_anomaly_zscore=36,ads_anomaly_iforest=8744,ads_anomaly_summary=8750,唯一 strong keyword 是"手机",strong session = 11,iForest 异常 = 415。
11.8 三张 ADS 表设计说明
| 表名 | 行数 | 用途 |
|---|---|---|
ads_anomaly_zscore |
36 | V1 搜索词(6)+ V2 session(30) |
ads_anomaly_iforest |
8744 | session 级 iForest 结果(全量) |
ads_anomaly_summary |
8750 | 三方法共识汇总 |
共识分档规则:
| consensus_level | 含义 |
|---|---|
strong |
被 2 个及以上方法同时命中 |
medium |
被 1 个方法命中 |
weak |
未被任何方法命中 |
唯一 strong keyword 是"手机",这是 B12 最核心的输出。它直接对应"已知正样本被三方法一致认定为异常"。
11 个 strong session 全部是 V2 候选 ∩ iForest 异常,即"Z-score 和 iForest 双命中"。
423 个 medium session 的构成(§9.7 已经分析):
- 19 个:V2 命中但 iForest 未命中;
- 404 个:iForest 命中但 V2 未命中(这些是 iForest 独立发现的多维异常,包括大量
pay_no_order的 session)。
这个数字结构本身就是一条结论:V2 和 iForest 视角不同,一个从"支付/下单比"切入,一个从"11 维联合"切入,两者有 11 个交集,但各自也有独立的发现。
12. 敏感性分析:阈值不是拍脑袋定的
12.1 iForest contamination 敏感性
contamination=0.05 是 B12 的假设,不是数据推导的。为了验证这个假设是否合理,B12 跑了三档:
python
# 附在 b12_iforest.py 里
for c in [0.01, 0.05, 0.10]:
    iso_c = IsolationForest(n_estimators=100, contamination=c,
                            random_state=42, n_jobs=-1)
    labels_c = iso_c.fit_predict(X)
    n_anom = int((labels_c == -1).sum())
    n_hit = int(((df_f['session_id'].isin(v2_candidates).values) & (labels_c == -1)).sum())
print(f"contamination={c}: anomaly={n_anom}, v2_hit={n_hit}")实测输出:
| contamination | 异常数 | V2 候选命中 | 命中率 |
|---|---|---|---|
| 0.01 | 83 | 1 | 3.3% |
| 0.05 | 415 | 11 | 36.7% |
| 0.10 | 830 | 25 | 83.3% |
解读:
- 0.01 太严:只标记 83 个异常,V2 候选只命中 1 个,漏报严重;
- 0.10 太松:标记 830 个异常(10%),V2 候选命中 25/30,几乎全抓,但异常比例太高,实际业务里不好用;
- 0.05 折中:415 个异常(5%),V2 候选命中 11/30,是一个工程上可接受的平衡点。
关键结论 :contamination = 0.10 时 V2 候选命中率 83.3%,说明 V2 候选的异常度确实高于普通 session,只是被 5% 阈值卡住了。这个数字反过来佐证了 V2 的预筛选有效性。
报告里必须写清 :contamination=0.05 是人为选择,不是数据推导。它的合理性依赖业务对"异常率"的先验判断,而不是数据本身的客观事实。
12.2 卡方贡献阈值敏感性
ads_anomaly_summary 里 keyword 的 strong 判定用了 chi2_contribution > 100。这是一个主观阈值。
若阈值提高到 200:
| 搜索词 | 卡方贡献 | 阈值 100 | 阈值 200 |
|---|---|---|---|
| 手机 | 1802.5 | strong | strong |
| 吃鸡 | 122.7 | medium | weak |
| i7 | 78.2 | weak | weak |
| 笔记本 | 69.2 | weak | weak |
| 内存 | 55.3 | weak | weak |
| 苹果 | 46.5 | weak | weak |
结论 :"手机"作为唯一 strong 的结论不受阈值影响,稳健。
报告里应写明 :当前用 100 是宽松阈值 ;阈值 200 时"吃鸡"降为 weak,唯一 strong 仍是"手机",核心结论不变。
13. 核心发现
13.1 发现一:数据是合成的,不存在真实业务异常
四条铁证:
| 事实 | 数值 | 真实电商对比 |
|---|---|---|
| 相邻行为最大间隔 | 11 秒 | 应有分钟/小时级 |
| 24 小时分布 | 均匀 | 应有双峰 |
| 100 用户活跃天数 | 全为 10 天 | 应长尾分布 |
| 支付无下单比例 | 27.75% | 应 < 1% |
B12 的所有结论都必须在这个前提下理解。
13.2 发现二:"手机"搜索词是数据里设计好的异常
- Z-score:-2.2306(|Z| > 2)
- 卡方贡献:1802.5(占 83%)
- 卡方总値:2174.49 >> 11.07
两方法交叉验证一致,"手机"是数据里的已知异常。
13.3 发现三:iForest 独立发现了"支付无下单"模式
iForest 的 415 个异常里:
- 137 个
order_cnt=0(33.01%); - 114 个
pay_no_order=1(27.47%); - 27.47% 与全局行级 27.75% 高度吻合。
这是 iForest 独立发现的合成数据核心特征,不依赖 V2 候选的预筛选。
13.4 发现四:V2 和 iForest 只有 36.7% 交集
30 个 V2 候选中,iForest 只命中 11 个。这说明两种方法视角不同:
- V2 从"pay/order 比"切入,抓的是"单指标极端";
- iForest 从 11 维联合切入,抓的是"多维联合离群"。
交集 11 个 = strong,是两种方法都认可的高置信异常。
13.5 发现五:iForest 对阈值敏感
contamination 从 0.05 变到 0.10,异常数从 415 变到 830,V2 候选命中从 11 变到 25。
这说明 iForest 的输出不是"客观异常清单",而是"主观设定的前 N% 离群点"。报告必须诚实交代这一点。
14. 方法局限:诚实地交代边界
B12 的价值不只在发现,更在诚实交代每个方法的局限。
14.1 Z-score 的局限
- 样本少:6 个搜索词,算出的 Z 值本身不稳定;
- 分布假设:经典 Z-score 假设正态分布,本数据不满足;
- 不能单独下结论:只作"定位器",结论由卡方给。
14.2 卡方的局限
- 只处理类别分布:对连续值、多维特征无能为力;
- 阈值主观 :
chi2_contribution > 100是选择的,不是数据推导的; - 不能定位到具体 session:卡方只在搜索词层面给出结论。
14.3 iForest 的局限
- contamination 主观:0.05 是假设,不是数据推导(见 §12.1);
- 合成数据可能无真异常:iForest 强行找的 5% 可能只是统计噪声;
- 特征相关稀释信号 :
duration_sec ≈ total_cnt × 5(P4 已证),高相关特征降低随机切分效率; - 样本量偏小:8744 样本对 iForest 来说偏小,论文推荐 > 10000。
14.4 pay_order_ratio 的口径局限
- 当
order_cnt = 0时,pay_order_ratio = pay_cnt; - 这不是严格的"支付/下单比",而是"支付相对下单的放大指标";
- 报告里必须写清,避免误读。
14.5 结论的范围限定
B12 的所有结论都必须限定在"方法论演示"范围内:
在一个已知是合成的数据集上,一套无监督异常检测方法能做什么、不能做什么、边界在哪。
不能把它当作"真实电商刷单识别"的实战案例。
15. 对后续实验的影响
- B13 用户行为路径挖掘 :B12 的
ads_anomaly_summary可以作为路径分析的分组维度,看异常用户和正常用户的路径模式是否不同。 - B14 用户画像与标签体系 :B12 的
pay_no_order特征可以纳入用户画像,作为"支付行为可疑度"的画像标签之一。 - B15 品类推荐系统:B12 的异常 session 在品类分布上是否与正常 session 有差异,可以进一步分析。
- B16 用户流失预测:B12 的 iForest 异常分数可以作为流失预测的特征。
- B17 用户价值预测:B12 的三方法共识标签可以作为价值预测的辅助标签。
跨实验的通用方法论:
- "Z-score 定位 + 卡方验证 + iForest 复核"的三段流程,可以复用到任何异常检测场景;
- 敏感性分析(多档参数对比),可以复用到任何需要选择超参数的算法;
- "诚实交代方法局限"的报告风格,可以复用到整个 B 组实验。
16. 工程踩坑
B12 踩到了几个新坑。
-
第一个坑,Hive 不允许 WHERE 引用本层 SELECT 别名。 在 V1/V2 的 Z-score 计算里,需要多层嵌套(
SELECT ... FROM (SELECT ... FROM ...) WHERE ...),不能在同一层 SELECT 里定义别名又在 WHERE 里用。这是一个 Hive 特有的作用域规则,和 MySQL、PostgreSQL 不一样。 -
第二个坑,CSV 无表头。 Hive
INSERT OVERWRITE DIRECTORY导出的 CSV 不写表头,Python 端必须手动指定列名。 -
第三个坑,matplotlib 中文上标。 SimHei 字体缺
²字形,χ²和(O-E)²/E会触发Glyph 178 missing告警。修法:改用 mathtext$\chi^2$或直接写χ^2。 -
第四个坑,matplotlib 自动弹窗。
plt.show()会在脚本运行后弹出窗口,且触发 tkinter 相关告警。修法:matplotlib.use("Agg")放在import pyplot之前,删除plt.show(),改成plt.close(fig)。 -
第五个坑,docstring 里的 Windows 路径。
"""D:\py_code\..."""里的\p会被 Python 当成转义序列,触发SyntaxWarning。修法:docstring 用r"""..."""原始字符串。 -
第六个坑,Hive 库名。 HQL 脚本一开始写
USE b12;,但b12库不存在,实际库名是b_group。修法:先SHOW DATABASES;确认,再统一USE b_group;。
踩过的坑速查表:
| 坑 | 表现 | 解法 |
|---|---|---|
| Hive WHERE 不能引用本层别名 | SemanticException | 三层嵌套 |
| CSV 无表头 | Python 读进来列名错位 | 手动指定 names=cols |
matplotlib 缺 ² 字形 |
Glyph 178 missing | 用 mathtext 或 χ^2 |
| matplotlib 自动弹窗 | tkinter 告警 + 阻塞脚本 | matplotlib.use("Agg") + 删除 plt.show() |
docstring 里的 \p |
SyntaxWarning | 用 r"""...""" |
| Hive 库名搞错 | Database does not exist: b12 |
先 SHOW DATABASES; 确认 |
SIZE(NULL) 返回 -1(B11 遗留) |
聚合字段出现负数 | 加 SIZE(...) > 0 条件 |
| ORC 表不能直接 LOAD DATA(B11 遗留) | file format 不匹配 | 走文本中转表 |
| Hive 日志无留存 | 出问题无法回溯 | 所有 hive -f 加 `2>&1 |
17. 写在最后
- 还没搞明白,需要进一步探索的:
-
iForest 在 0.05 阈值下的"边界样本"到底算不算异常? 有 19 个 V2 候选分数在 -0.50 ~ -0.554 之间,非常接近阈值 -0.555。它们在业务上"看起来像异常"(pay/order 比高),但在多维特征上不够突出。这暴露了 iForest 作为无监督方法的一个本质局限:它给出的"异常"本质上是"离群程度排名靠前",不是"客观异常"。
-
V2 和 iForest 的 19 个分歧,哪种视角更对? V2 从"支付/下单比"切入,iForest 从"11 维联合"切入。19 个 V2 命中但 iForest 未命中的 session,说明它们在"pay/order 比"这一维度上极端,但在其他维度上不够极端。哪种视角更接近"业务异常",需要真实电商数据来验证。
-
pay_no_order是数据缺陷还是业务特征? 27.47% 的 iForest 异常是pay_no_order=1,但全局只有 27.75%。这两个数字的相似性可能不是巧合 ,它说明生成器对pay和order的独立性是全局一致的。这本身是合成数据的一个强特征。
- 小结:
B12 的价值不在于发现了一个惊艳的异常,而在于在一个已知是合成的数据集上,演示了一套完整的异常检测方法论:从探测数据特征,到设计三方法分工,到交叉验证,到敏感性分析,到诚实交代局限。
它的核心贡献有三点:
- 三方法分工明确:Z-score 定位、卡方验证、iForest 复核,三把不同尺子互补盲区;
- 敏感性分析:contamination 从 0.01 到 0.10,让读者看到阈值的主观性;
- 诚实交代局限:不假装合成数据是真实的,不把 5% 异常率当成客观事实。
这三点方法论的价值,比 B12 找到了多少个异常更重要。因为它们是可复用的,能带到任何异常检测场景里。
18. 附录:完整脚本
18.1 HQL 脚本清单(/home/hadoop/b12/sql/)
| 文件 | 用途 | 章节 |
|---|---|---|
check_db.hql |
查看现有库 | §3 |
p0_behavior_dist.hql |
P0 行为类型分布 | §4.1 |
p4_time_gap.hql |
P4 session 内时间间隔 | §4.2 |
p6_hour_dist.hql |
P6 24 小时分布 | §4.3 |
p8_active_days.hql |
P8 用户活跃天数 | §4.4 |
p9_pay_no_order.hql |
P9 支付无下单比例 | §4.5 |
p11_search_keyword.hql |
P11 搜索词分布 | §4.6 |
v1_keyword_zscore.hql |
V1 搜索词 Z-score | §6 |
v3_chi2.hql |
V3 卡方贡献分解 | §7 |
v2_session_zscore.hql |
V2 session 级 Z-score(Top30) | §8 |
export_session_features.hql |
导出 session 特征 CSV | §9.1 |
step6_2_ext.hql |
建外部表 ext_b12_iforest |
§11.3 |
step6_3_ads_iforest.hql |
建 ads_anomaly_iforest(8744 行) |
§11.4 |
step6_4_ads_zscore.hql |
建 ads_anomaly_zscore(36 行) |
§11.5 |
step6_5_ads_summary.hql |
建 ads_anomaly_summary(8750 行) |
§11.6 |
step6_6_verify.hql |
三表最终验证 | §11.7 |
18.2 Python 脚本清单(/home/hadoop/b12/py/)
| 文件 | 用途 | 章节 |
|---|---|---|
b12_iforest.py |
iForest 主脚本(v4,11 维特征 + 敏感性) | §9.4 |
b12_fill_single.py |
补全 452 个单行为 session 到 8744 行 | §11.1 |
18.3 Python 输出文件(/home/hadoop/b12/output/)
| 文件 | 说明 | 章节 |
|---|---|---|
session_features.csv |
Hive 导出的 session 特征(8744 行) | §9.1 |
b12_iforest_result.csv |
iForest 结果(8292 行) | §9.4 |
b12_iforest_full.csv |
补全后结果(8744 行) | §11.1 |
b12_v2_hit.csv |
V2 候选命中明细(11 行) | §9.6 |
b12_v2_miss.csv |
V2 候选未命中明细(19 行) | §9.7 |
b12_contamination_sensitivity.csv |
敏感性分析(3 行) | §12.1 |
b12_visualization.png |
4 图可视化 | §10 |
18.4 Hive 表结构速查
ads_anomaly_zscore(36 行)
| 字段 | 说明 |
|---|---|
| object_type | keyword / session |
| object_id | 搜索词或 session_id |
| total_cnt | 搜索词=出现次数;session=行为数 |
| ratio | 搜索词=占比;session=pay/order |
| z_score | Z 值(V2 session 未逐条保留,填 NULL) |
| is_anomaly | 1=异常,0=正常 |
| method | V1_keyword / V2_session |
ads_anomaly_iforest(8744 行)
| 字段 | 说明 |
|---|---|
| session_id | session ID |
| total_cnt | session 行为总数 |
| ...(11 维特征) | ... |
| pay_no_order | 1 = (order=0 & pay>0) |
| iforest_label | -1=异常,1=正常 |
| iforest_score | 异常分数(越低越异常) |
ads_anomaly_summary(8750 行)
| 字段 | 说明 |
|---|---|
| object_type | keyword / session |
| object_id | 搜索词或 session_id |
| zscore_anomaly | 1=Z-score 命中 |
| chi2_contribution | 卡方贡献(仅 keyword) |
| iforest_anomaly | 1=iForest 命中(仅 session) |
| hit_method_cnt | 命中方法数 |
| consensus_level | strong / medium / weak |
18.5 关键数字速查
总行数(排除07-27)     166770
Session 总数            8744
单行为 session          452
支付无下单(行级)       27.75%
pay_no_order=1 session  1120(13.51%)
"手机" 占比             7.67%
"手机" Z-score          -2.2306
卡方值                  2174.4884
卡方临界值              11.07
"手机" 卡方贡献          1802.5(83%)
iForest 异常数           415(5.00%)
V2 候选被 iForest 命中    11/30(36.7%)
strong keyword           1(手机)
strong session           11