大家读到下篇,辛苦的同时,也相信大家收获颇丰。
中篇的结尾,我们写出了一个"能跑"的 HTTP 服务器: 它能收请求、找文件、拼响应、发回去,还会答状态码和 Content-Type。
但把它真的放到用户面前,会立刻冒出三个问题: 它记不住人、它留不住连接、它只认文件不认代码。
下篇要回答的,就是这三个问题------以及一个能跑的程序,是怎么变成一个系统的。
承接中篇
如果你是从中篇读过来的,可以直接往下走。如果你是单独打开这一篇的,这里用最短的篇幅补一下上文。
中篇讲的是"服务器怎么答":
   HttpRequest._uri
        │
        ├─ 第八章   拼 wwwroot 前缀 → open/read → VFS/dentry/inode(第八章)
        │           i_size 变成 Content-Length
        ├─ 第九~十章 拼响应报文,Build() 的两个难点
        ├─ 第十一章 状态码:2xx/3xx/4xx/5xx,301 与 302 的分水岭
        ├─ 第十二章 Content-Type:让浏览器知道收到的是什么
        ├─ 第十三章 GET 与 POST:参数放 URI 还是放正文
        └─ 第十四章 HTTPS:为什么明文传输必须死
下篇接着往下走。开篇第一件事,是把上篇和中篇的所有环节重新接回一条线(第十五章),然后看清楚这条线上还剩哪几个洞没补。
下篇导读:三个洞
中篇写完的那个服务器,逻辑上是自洽的。它的模型是:
URI → 磁盘上的一个文件 → 读出来 → 发回去在这个模型里,服务器是一台"文件取货机" ------ 你报一个路径,它把文件递给你。这个模型能解释很多事,但它解释不了下面三个场景:
┌──────────────────────────────────────────────────────────────────┐
│  场景一:登录
│
│    用户 POST 了正确的账号密码,服务器说"登录成功"。
│    然后用户点了一下"个人中心"。
│
│    ★ 服务器问:你是谁?
│    ★ 用户:我刚登录过啊。
│    ★ 服务器:我不记得。
│
│    因为 HTTP 是【无状态】的 ------
│    每个请求都是独立的,服务器不记得上一个请求发生过什么。
│    → 第十六章会把这个特性讲透,第十七章给出解法。
├──────────────────────────────────────────────────────────────────┤
│  场景二:连接
│
│    一个网页里有 10 张图。
│    HTTP/1.0 的默认行为是:11 次请求 = 11 次 TCP 连接。
│    每次都要重新三次握手。
│
│    ★ "HTTP 是无连接的" ------ 那连接到底是谁的?
│    ★ 为什么长连接需要【双方都带】Connection 报头才算数?
│
│    → 第十六章讲清"无连接"这个说法的准确含义。
├──────────────────────────────────────────────────────────────────┤
│  场景三:动态服务
│
│    用户访问 /login。
│
│    ★ 服务器去 wwwroot/login 找文件 ------ 没有。
│    ★ 然后呢?它该怎么知道"这个 URI 要交给一段代码去处理"?
│
│    这是中篇一直绕过去的问题:前面所有章节实现的都是静态资源,
│    而真实的网站靠的是动态服务。
│    → 第十八章给出答案,并且你会发现它只需要一张表。
└──────────────────────────────────────────────────────────────────┘
补上这三个洞之后,这篇文章就讲完了。最后用第十九章的速查表收尾------那是给以后回来查资料用的。
目录
- 第十五章 全景回放:一次访问的完整时序
- 第十六章 HTTP 的两大特性:无状态与无连接
- 第十七章 为什么登录一次能记住你:Cookie 与 Session
- 第十八章 服务端怎么知道该调用哪个函数:服务注册与路由
- 第十九章 速查表
第十五章 全景回放:一次访问的完整时序
15.1 把十五章重新连成一条线
我们在第一章说过,一次网页访问要回答五个问题。现在回头看,这五个问题已经被扩展成了完整的十几个环节:
【第一章的视角】
   ①  定位  →  ②  搭话  →  ③  提问  →  ④  处理  →  ⑤  回答

【现在的视角】(每一环都展开了)
   ①  定位
       ├─ URL 的七段结构               (第二章)
       ├─ URI 与 URL 的区别            (第二章)
       ├─ 域名 → DNS → IP              (第三章)
       └─ URL 编码                     (第三章)
   ②  搭话
       ├─ HTTP 站在 TCP 之上            (第四章)
       ├─ 服务器骨架:listen/accept/fork(第四章)
       ├─ 短连接                       (第四章)
       └─ 长连接                       (第四章)
   ③  提问
       ├─ 报文是"以行为单位的字符串"     (第五章)
       ├─ 四段结构                     (第五章)
       ├─ 请求行:方法 + URI + 版本     (第五章)
       └─ 请求报头                     (第五章)
   ④  处理
       ├─ 报文完整性(找空行)          (第六章)
       ├─ 反序列化 + 读行函数           (第六章)
       ├─ HttpRequest 结构体           (第七章)
       ├─ URI → wwwroot → index.html   (第八章)
       └─ open/read → VFS → inode      (第八章)
   ⑤  回答
       ├─ 四段结构 + 状态行             (第九章)
       ├─ HttpResponse + Build()       (第十章)
       ├─ 状态码(1xx~5xx、301/302)    (第十一章)
       ├─ Content-Type + 静态资源       (第十二章)
       ├─ GET/POST 传参                (第十三章)
       ├─ HTTPS                        (第十四章)
       └─ 是文件还是函数?查路由表       (第十八章)
   ⑥  它记得住吗?
       ├─ 无状态(记不住请求之间的关系) (第十六章)
       ├─ 无连接(连接是 TCP 的事)      (第十六章)
       ├─ Cookie:客户端自己带身份       (第十七章)
       ├─ Session:数据留服务器,只发编号 (第十七章)
       └─ Referer 的三大用途            (第十七章)
15.2 一次完整访问的时序图
现在把这条线画成一张时序图。这是整篇文章的浓缩。 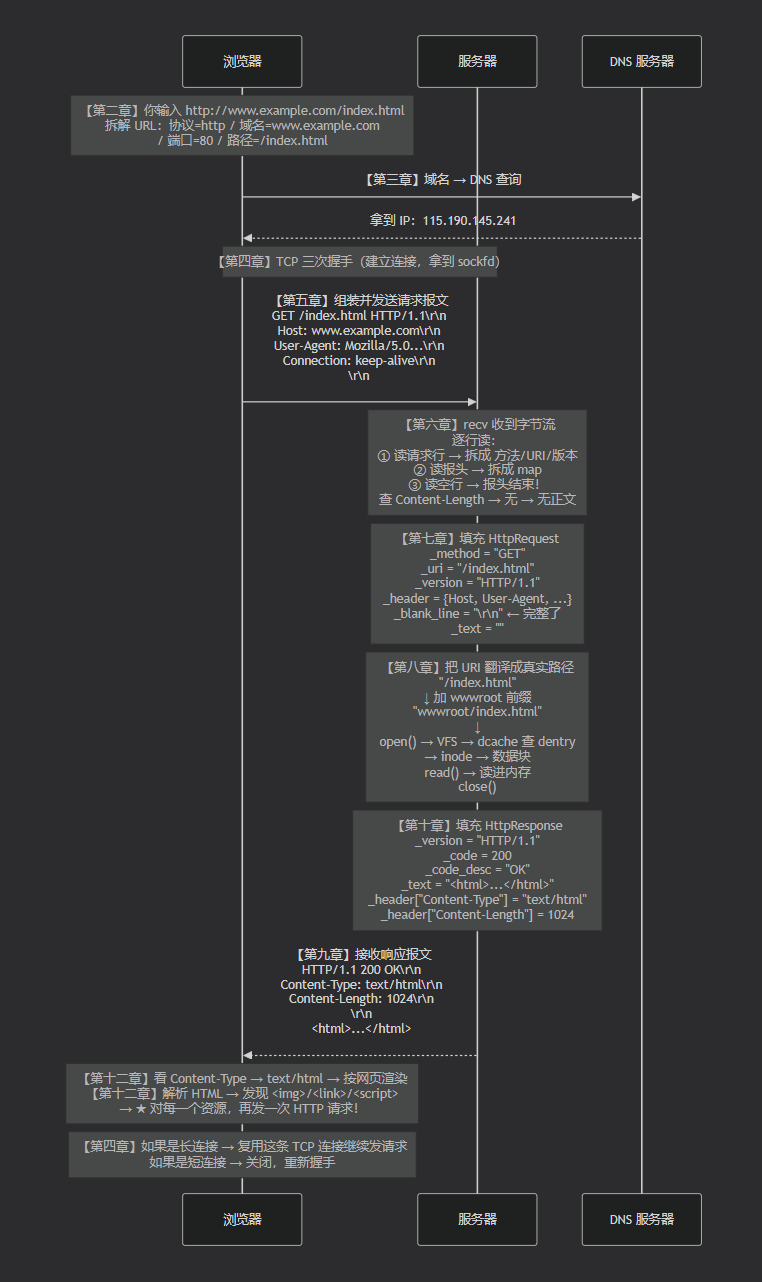
这张图里有几个节点值得再强调一次:
① 【第六章】"读空行"是整个服务端逻辑的转折点:
   在它之前,按"行"解析;在它之后,按"长度"解析。

② 【第八章】是唯一一处"跨界"的地方:
   HTTP 协议在这里把活儿交给了文件系统(VFS)。
   HTTP 只负责"要哪个文件","文件怎么在磁盘上找到"是 VFS 的事。

③ 【第十二章】那句"对每一个资源再发一次请求",
   解释了为什么一个网页会触发几十个 HTTP 请求。
15.3 三条贯穿全文的主线
最后,把散落各章的知识,收拢成三条主线。如果你只记得三件事,请记得这三件。
主线一:HTTP 本质上就是"用文本约定的一套规矩"
   整个 HTTP/1.1 的解析规则,可以压缩成两句话:

   ①  以【行】为单位      →  行之间用 \r\n 分隔
   ②  用【空行】分段      →  空行之前是报头,之后是正文

   ★ 没有二进制的魔数,没有复杂的长度字段,
     甚至不需要任何第三方库 ------ 字符串查找就够了。

   代价是:解析起来慢(要扫描全文),体积也大。
   这就是 HTTP/2 要改成二进制格式的原因。
主线二:应用层协议是"分层"思想的产物
   HTTP  只关心   "这些字节是什么意思"
   TCP   只关心   "字节怎么可靠地送到"
   IP    只关心   "送到哪台机器"
   以太网 只关心   "怎么送到下一个邻居"

   ★ 每一层只解决一个问题,解决完就交给下一层。

   这解释了为什么:
     - HTTP 服务器长得和 TCP 服务器一模一样(第四章)
     - 报文完整性可以由上一层(定界层)提前解决(第六章)
     - HTTP 完全不需要知道 TCP 在干什么
主线三:一个字段的存在,一定有它的理由
   空行          →  唯一能标记"报头结束"的方式        (第六章)
   Content-Length →  唯一能标记"正文有多长"的方式      (第六章)
   Host          →  一个服务器托管多个网站时,
                    区分"你要的是哪个站"               (第五章)
   Content-Type  →  字节本身不自解释,
                    必须外部标注"这是什么"             (第十二章)
   _blank_line   →  把"报文是否完整"这个状态存下来      (第七章)
   _uri 而非 _url →  请求行里确实只有路径,没有主机名   (第二章)

   ★ 遇到任何一个看不懂的字段,先问:"没有它会出什么问题?"
     答案往往就出来了。
第十六章 HTTP 的两大特性:无状态与无连接
16.1 一个必须提前说清的矛盾
在讲会话管理之前,必须先讲 HTTP 的两个"性格特征"。因为不理解这两个特征,就完全无法理解 Cookie 和 Session 为什么必须存在。
这两个特征听起来还互相矛盾:
特征一:无状态(Stateless)    →  HTTP 记不住你是谁
特征二:无连接(Connectionless)→ HTTP 没有"连接"这个概念第二个特征尤其让人困惑------我们第四章刚花了一整节讲"短连接"和"长连接",怎么现在又说"无连接"?
别急,这两个说法都对,只是站在不同的角度看同一件事。我们把它们一个一个拆开。
16.2 无状态:HTTP 记不住你刚才做了什么
16.2.1 现象
先看几个你一定遇到过的现象:
现象一:
   你刚访问过某个网页,隔了 1 秒再点刷新
   →  浏览器【又发了一次 HTTP 请求】
   →  ★ HTTP 本身完全不知道"你刚才来过"

现象二:
   你打开一个小网站,第一次特别慢
   过一会儿再刷新,突然变快了
   →  不是因为网速变快了
   →  是因为资源被【浏览器】缓存了
   →  ★ 注意:这是浏览器的功劳,不是 HTTP 的功劳
无状态的描述是:
HTTP 只是负责网络通信的模块,记不住你刚刚请求过哪些网页。
"记不住"这三个字,就是无状态的全部含义。
16.2.2 "无状态"到底意味着什么
把"记不住"翻译成技术语言:
★ 无状态的含义:

   服务器处理第 N 个请求时,【不会】参考它处理第 N-1 个请求时的情况。

   每一个请求,对服务器来说都是【第一次见】。

   ┌──────────────┐
   │ 请求 1       │  →  服务器:"你是谁?我不知道,我只管处理这个请求"
   ├──────────────┤
   │ 请求 2       │  →  服务器:"你是谁?我不知道,我只管处理这个请求"
   ├──────────────┤
   │ 请求 3       │  →  服务器:"你是谁?我不知道,我只管处理这个请求"
   └──────────────┘
        ↑
   三个请求之间【没有任何关联】
这听起来像个严重的缺陷。但它其实是一个极其重要的设计决策。
无状态带来的好处:
好处一:服务器不需要为每个客户端维护状态
   →  内存开销小
   →  天然适合水平扩展(加一台机器就能扛更多请求,
      因为任何一台机器都能处理任何请求,不需要"粘住"某个用户)

好处二:请求之间互相独立
   →  一个请求挂了不影响其他请求
   →  更容易做容错和重试

好处三:协议简单
   →  服务器逻辑就是"输入一个请求,输出一个响应"
   →  这是一个纯粹的函数
而它的代价,就是我们下一章要讲的那个大问题:
如果 HTTP 记不住我,那我登录过一次之后,服务器怎么知道是我?
16.2.3 一个容易混淆的点:浏览器缓存 ≠ HTTP 有状态
这是个容易混淆的地方:
题外话(浏览器缓存):浏览器有时会把访问过的图片、视频等资源缓存起来(静态资源一般不会频繁改动);缓存后不再发 HTTP 请求,直接从缓存取,加速资源获取。
现象:访问小网站第一次特别慢,过一会刷新变快------不是因为网快了,而是数据被缓存了。HTTP 虽无状态,但浏览器是"聪明的"。
这段话揭示了一个重要的分工:
   ┌───────────────────────────────────────────────┐
   │  浏览器(客户端)
   │    ★ 它是"聪明的":有缓存、有历史、有书签
   │    它记得你访问过什么
   ├───────────────────────────────────────────────┤
   │  HTTP 协议
   │    ★ 它是"健忘的":每个请求都是独立的
   ├───────────────────────────────────────────────┤
   │  服务器
   │    ★ 默认情况下,它也是"健忘的"
   │      (除非我们额外加机制,见下一章)
   └───────────────────────────────────────────────┘
所以"网站变快了"这件事,可能是三个不同的原因造成的,别搞混:
原因一:DNS 缓存          →  省掉了域名解析那一趟(第三章)
原因二:浏览器缓存         →  根本没发 HTTP 请求,直接用本地副本
原因三:TCP 长连接        →  省掉了反复三次握手的开销(第四章)
这三者都是"绕过慢"的手段,但绕过的东西完全不同。
16.3 无连接:为什么说 HTTP "没有连接"
16.3.1 矛盾的表述
现在处理那个看起来自相矛盾的说法。
无连接:初听矛盾------HTTP 用 TCP,长短连接课说过每次请求都有连接,长连接也有连接,凭什么说 HTTP 无连接?
这个疑问是合理的。我们在第四章明明讲了:
短连接:一个请求-响应后关闭 fd
长连接:一个 sockfd 上跑多次请求
                     ↑ 这里明明有"连接"啊!
所以"HTTP 无连接"这句话,到底在说什么?
16.3.2 答案:连接是 TCP 提供的,不是 HTTP 提供的
答案是:连接是 TCP 提供的,HTTP 只是使用 TCP;从软件分层角度 HTTP 并不知道有连接,它只认识文件描述符和系统调用 read/write,不关心数据怎么发。之前说的"连接"指的是 TCP 的连接。
这段话可以拆成三层。
第一层:连接的所有权属于 TCP。
   三次握手、四次挥手、确认重传、滑动窗口、拥塞控制......
   ★ 这些"维护连接"的工作,【全部是 TCP 做的】

   HTTP 一样都没做。
第二层:HTTP 眼里只有 fd 和 read/write。
从 HTTP 服务器的代码视角看,它手里有什么?
// HTTP 服务器看到的世界
int sockfd;                      // 一个整数(文件描述符)
read(sockfd, buf, size);         // 从它读
write(sockfd, buf, size);        // 往它写

// ★ 没有"连接"这个概念,只有一个可以读写的 fd
这就是所说的:"它只认识文件描述符和系统调用 read/write,不关心数据怎么发。"
对 HTTP 来说,sockfd 和打开一个文件的 fd 没有本质区别------都是"一个可以读写的东西"。至于这背后是 TCP 连接、还是 Unix 域套接字、还是一个真实的文件,HTTP 完全不知道,也不需要知道。
这正是第四章讲的"分层"在代码层面的体现。
第三层:Connection 报头只是一个"标记",不是"连接"。
这是最容易混淆的一点。看报头里那个字段:
Connection: keep-alive它的名字里有 "Connection",但它并没有建立任何连接。 它只是 HTTP 在告诉对方:
   ★ "这个 fd,请你处理完之后【先别关】,我还要接着用。"

   它是一个关于"连接生命周期"的【请求/标记】,
   而不是"我在建立连接"的动作。

   ★ 真正的连接建立,早就由 TCP 在底下悄悄做完了。
分工:
源码视角:整个连接管理由 TCP server 完成;HTTP server 只处理 Request/Response 和 HTTP 协议行,做上层数据交付;TCP 把数据回调上来,HTTP 处理后再回调回去。
16.3.3 一个绝妙的类比
一个非常好记的类比:
类比:"富二代说'我爸有钱和我有什么关系'"------TCP 维护连接,HTTP 说"我用 TCP,但连接维护不是我做的,我不关心"。
这个类比很传神。把它展开:
   TCP  =  有钱的爸爸(负责所有辛苦的"连接维护"工作)
   HTTP =  富二代(用着爸爸的资源,但说"那和我没关系")

   ★ HTTP 的"无连接"不是说"没有连接存在",
     而是说"【连接不是我的事】"。
16.4 把两个特性放在一起看
现在把这两个特性并列,它们会立刻产生一个尖锐的组合问题。
┌──────────────────────────────────────────────────────────────┐
│  无状态:  服务器不记得上一个请求是谁发的
│  无连接:  服务完成后,这条通道就可能被关掉了
│
│  ★ 组合起来的后果:
│
│     你登录了(请求 1)  →  服务器认证通过,返回"登录成功"
│
│     你想看视频(请求 2)→  服务器:"你是谁?"
│                        →  让你重新登录
│
│     你想点赞(请求 3)  →  服务器:"你是谁?"
│                        →  让你重新登录
└──────────────────────────────────────────────────────────────┘
提出问题:
由此引出问题:HTTP 既无状态又无连接,为什么登录一次、三天后再访问网站它还记得我?→ 会话管理。
如果 HTTP 只有这两个特性、没有别的机制,那上网会变成一场灾难:
   看一个视频要登录一次
   点一个赞要登录一次
   翻一页要登录一次
   ★ 这显然不是我们使用互联网的体验
所以必须有一种机制,能在"无状态"的协议之上,人造出"有状态"的体验。
这个机制,就是下一章的主题:会话管理。
第十七章 为什么登录一次能记住你:Cookie 与 Session
17.1 问题的起点:一个真实的使用场景
先看一个你每天都在经历的场景。
场景一:你访问 B 站。
   ①  打开 www.bilibili.com(未登录)
       →  它不认识你,首页推荐是"热门"

   ②  你扫码登录
       →  它认识你了,首页推荐变成了"你可能感兴趣的"

   ③  关闭浏览器

   ④  过了一两天,再打开 www.bilibili.com
       →  ★ 它还是认识你!不用重新登录
场景二:APP 的"7 天内免登录"。
   几乎所有 APP 都有这个功能:
       "7 天内免登录"
       "保持登录状态"
       "记住我"
这个能力叫会话管理(Session Management)。
而它带来的问题,正是我们上一章结尾提出的:
HTTP 是无状态的、无连接的,服务器凭什么能"记住"你?
这个问题必须解决。而它的解决历史,恰好是"方案一 → 发现问题 → 方案二"这样一次经典的技术演进。
17.2 方案一:Cookie ------ 让客户端自己带着身份
17.2.1 思路
先想清楚问题的本质:
   服务器要"认识"你,就必须知道"你是谁"。
   而 HTTP 无状态,服务器自己记不住。

   ★ 那么,能不能让【客户端】每次请求时,自己告诉服务器"我是谁"?
这个思路就是 Cookie 方案。原文的流程描述是:
Cookie 方案流程:
① 用户登录成功、服务端认证通过后,在 HTTP 应答的报头属性里新增一个
Set-Cookie(应答报头),里面可包含设置的用户名、密码等。② 客户端收到包含
Set-Cookie报头的 HTTP 应答后,必须把 Cookie 中的内容保存到客户端本地。③ 保存的小数据叫 Cookie。
④ 客户端再次发起 HTTP 请求时,必须把自己本地的 Cookie 数据自动带上------在请求中写报头
Cookie: 名字=密码。⑤ 服务端解析 HTTP 请求时必然得到请求中的 Cookie 信息,自动做权限认证。
17.2.2 完整的交互流程
把它画成时序图:
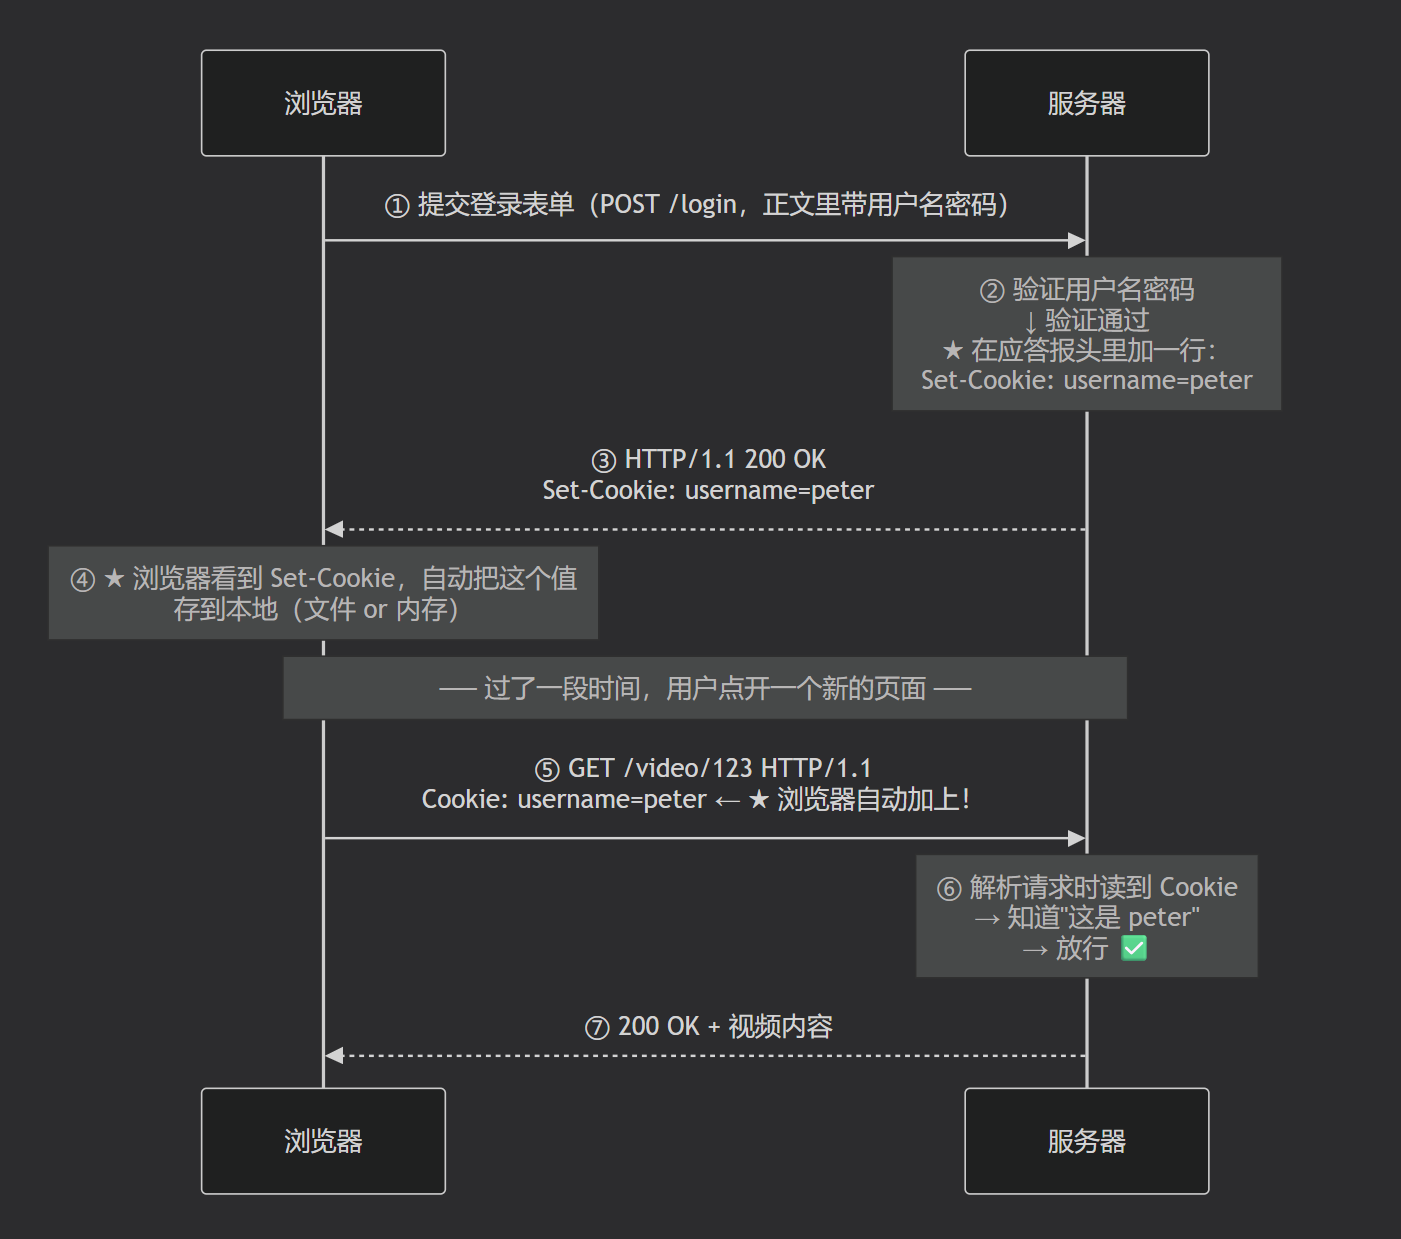
这个流程的关键,在于两条"约定"(原文明确用了"约定"这个词):
┌────────────────────────────────────────────────────────────────┐
│  约定一(写):客户端收到 Set-Cookie 后,必须保存到本地
│  约定二(读):客户端再次请求时,必须自动带上 Cookie 报头
│
│  ★ 注意:这两条都是【客户端】的责任,是浏览器帮我们做的。
│     所以这就是"约定"------HTTP 规范规定客户端应该这么做。
└────────────────────────────────────────────────────────────────┘
一句话点出 Set-Cookie 的本质:
Set-Cookie本质是服务端向客户端写入数据的过程------浏览器看到Set-Cookie自动把内容写到浏览器特定地方。
"服务端向客户端写入数据"------这个描述非常精准。
平时我们说的都是"客户端请求、服务器响应",数据是从客户端流向服务器 的。而 Set-Cookie 是一个反方向的操作:服务器在往客户端"塞"数据。
   普通响应:服务器把数据【给你看】        (一次性)
   Set-Cookie:服务器把数据【存你那儿】    (持久化,以后每次都要你带回来)
17.2.3 为什么叫 Cookie?
名字的来源说明:
保存的小数据叫 Cookie(英文原意"小饼干/小糕点",指一小段被保存的数据)。
这个词的来源是计算机历史上的一个典故------它借用了"幸运饼干"(fortune cookie)的意象:里面藏着一个小纸条(一小段信息)。
叫这个名字,是因为它确实是"一小段数据":
   名字小、内容小、格式也简单:
   Cookie: username=peter

   ★ 它不是什么复杂的数据结构,就是若干个"名字=值"而已
17.2.4 一个绝妙的类比:酒店房卡
一个非常好记的类比:
类比(酒店房卡):住酒店交身份证和钱(登录)→ 酒店认证后给一张房卡 →"保安不认人,必须出示房卡"→ 把房卡打孔挂脖子上走到哪都带 → 服务端可对用户访问任意资源做认证。
这个类比把 Cookie 方案的每个环节都对上了:
   酒店场景                          Cookie 场景
   ─────────────────────           ─────────────────────
   交身份证和钱(证明你是谁)   ←→   提交用户名密码(登录)
   前台认证,给你一张房卡        ←→   服务器回 Set-Cookie
   房卡挂脖子上随身带            ←→   浏览器自动保存 Cookie
   每次进房间/健身房都出示房卡    ←→   每次请求自动带 Cookie 报头
   "保安不认人,只认房卡"        ←→   服务器不"记"你,只认 Cookie
"把房卡挂脖子上走到哪都带"------这句话对应的是原文强调的一个行为:
只要访问的是保存过 Cookie 的那个网站,就自动把它的 Cookie 写上(浏览器自动完成)。
   ★ 注意"那个网站"这个限定条件

   你访问 www.bilibili.com 拿到的 Cookie
   →  只会带给 www.bilibili.com
   ★ 不会带给 www.taobao.com

   这是浏览器的"同源策略"在保护你------
   否则随便一个网站都能拿到你在银行的 Cookie
17.2.5 一次登录,处处生效
这个方案解决了一个关键问题:服务器能对 每一个资源做认证。
每次请求都带"我是谁",服务端对每个资源都能认证,所以认识用户,往后不需要重复登录。
细节:VIP 资源通过路径表示(如路径写
/vip/...);访问 VIP 资源时服务端对每个资源都做权限认证。网站 1000 部电影 800 部 VIP,随便点一个 5 分钟后让你重新登录或交费。
这段话揭示了一个重要的事实:
   ★ 网页上的每一个资源,都是一次独立的 HTTP 请求
   ★ 所以每一次请求,都要重新做一次权限认证

   ┌────────────────────────────────────────────────┐
   │  第 1 次请求:视频列表页   →  带 Cookie → 认证通过
   │  第 2 次请求:封面图 1     →  带 Cookie → 认证通过
   │  第 3 次请求:封面图 2     →  带 Cookie → 认证通过
   │  第 4 次请求:视频流       →  带 Cookie → 认证通过
   │  ...
   │  第 N 次请求:VIP 视频     →  带 Cookie → ★ 拒绝!
   │                           (因为这个路径需要 VIP)
   └────────────────────────────────────────────────┘
"看 5 分钟视频后 301/302 重定向跳转到登录页面"这个场景,就是从这里来的------服务器发现你的 Cookie 表明你不是 VIP,于是回一个重定向,把你送到付费页面。
17.2.6 Cookie 存在哪?------ 一个可以验证的问题
两种保存方案:
方案一:写入【文件】          ← ★ 最常见,能持久化
方案二:保存在客户端进程【内存】里  ← 用得特别少,进程退出就没了
怎么知道到底是哪种?原文给了一个简单的实验:
证明是文件级:登录 B 站后把浏览器进程关掉再打开,B 站仍认识我 → Cookie 一定在文件里,因为只有文件能持久化存储(文件系统知识:进程退出文件还在,再启动时读取 Cookie 文件自动带上)。
内存级 Cookie 在进程退出后消失,用得特别少;最常见的是持久化到文件(重启电脑后再访问仍认识)。
这个推理用到的是我们在文件系统那一章学过的知识:
   ★ 进程会死,文件不会死。

   如果 Cookie 只存在内存里:
      浏览器进程一关 → 内存释放 → Cookie 没了 → 重新打开就要重新登录

   但真实情况是:
      关闭浏览器再打开 → 它还记得你
      ⇒ 所以 Cookie 一定被写进了【文件】

   而且:
      重启电脑后还记得你
      ⇒ 说明文件写在【磁盘】上,不是内存盘
"进程退出文件还在"------这就是文件存在的全部意义。
一个实操细节:
Chrome 注意点:Chrome 两三年前更新后为保护用户隐私,Cookie 文件被隐藏且做了类似加密处理,看不到/找到也看不清------所以演示用微软自带浏览器(Edge)。
这也解释了为什么你可能在 Chrome 里找不到 Cookie 文件------那是隐私保护的设计。
17.2.7 过期时间:为什么能"7 天免登录"
对过期时间的说明:
过期时间:
Set-Cookie选项里除用户名外还可设置expires(过期时间),过期时间也是 Cookie 的一部分。浏览器客户端收到后记录 Cookie 文件的过期时间,时间一到浏览器自动把该 Cookie 文件删掉------这就是为什么有些应用能保持"7 天在线"。
浏览器每次启动时对 Cookie 做审核:过期 → 从文件移除;有效 → 加载进内存,每次请求都带上。
把这段拆开,是两个机制:
机制一:过期时间由服务器设定,但由客户端执行。
   服务器:  Set-Cookie: username=peter; expires=<某个时间>

   ★ 服务器只是"提了个建议"
   ★ 真正执行删除的是【浏览器】
机制二:浏览器启动时做一次"审核"。
   浏览器启动
      │
      ▼
   遍历所有 Cookie 文件
      │
      ├── 已过期  →  ★ 从文件里删掉
      │
      └── 未过期  →  加载进内存,以后每次请求都带上
这正好解释了"7 天免登录"的原理:
   登录时:服务器设置 expires = 当前时间 + 7 天

   7 天内:每次打开浏览器,Cookie 被加载进内存
          → 请求自动带上 → 服务器认识你 ✅

   7 天后:浏览器启动时审核发现过期 → 删掉
          → 请求没有 Cookie → 服务器不认识你
          → 请重新登录
再补两个细节(原文提到,属于 RFC 规范):
① 时间格式遵守 RFC 1123 格式(和 ls -l 显示的时间格式一样)
   ★ 这解释了一个常见的开发困惑:
     "为什么 HTTP 里的时间格式看起来和 Unix 时间戳完全不一样?"
     因为它用的是另一种标准

② Cookie 还有一些其他选项:
   - 在哪个目录下有效
   - 在哪个域名下有效
   - 是否只能通过 HTTP 访问(HttpOnly,防 JS 窃取)
   ★ HttpOnly 这个选项非常重要------它是防 XSS 盗 Cookie 的主要手段
17.2.8 Cookie 方案的问题:盗号
方案一有一个致命缺陷:
攻击场景:黑客通过假网站、全家桶、套壳软件让用户中木马/病毒;木马把浏览器中的 Cookie 文件盗走。
盗号流程:黑客把受害者的 Cookie 写到自己的浏览器 Cookie 目录下,模仿受害者向目标网站发起请求,浏览器自动携带 Cookie,服务端误以为用户本人来了 → 这就是常说的"盗号"。
把攻击过程画出来:
   ①  用户电脑中了木马

   ②  ★ 木马偷走浏览器的 Cookie 文件
       (里面是 username=peter 这样的信息)

   ③  黑客把这份 Cookie 复制到自己电脑的浏览器 Cookie 目录

   ④  黑客打开目标网站
       →  浏览器【自动】带上偷来的 Cookie
       →  服务器一看:"哦,是 peter"
       →  ★ 放行!黑客就成了你

   ⑤  黑客可以:看你的好友列表、发消息、甚至向好友借钱
注意这个攻击最可怕的地方在哪:
   ★ 黑客【不需要知道你的密码】

   密码认证被完全绕过了------
   因为服务器的判断依据是"你有没有正确的 Cookie",
   而不是"你有没有正确的密码"。

   而 Cookie 是明文存在文件里的。
QQ 案例说明:
QQ 案例:QQ 是客户端、也有会话保持;QQ 底层也是 HTTP(要登录、要提交表单);桌面应用和手机 APP 里面都套了 HTTP。信息被盗后,别人拿 Cookie 免密登录,可获取好友列表、向好友借钱。
这段话还顺带揭示了一个事实:
桌面应用和手机 APP 里面都套了 HTTP。
   ★ 你手机上几乎每一个 APP,底层都在跑 HTTP
      它们的"登录""记住我""刷新内容",用的都是同一套机制

   ★ 所以这一章讲的所有问题,
     不只属于"浏览器",而是属于【所有联网应用】
特意强调一点:加密不能根治。
加密不能根治:大公司用成熟加密方案,但黑客可用破解密钥的方式对 Cookie 做碰撞/破解。
结论:可以通过盗 Cookie 来盗账号,所以 Cookie 方案不安全。
以及一句很有哲学的收尾:
哲学观点:世界上没有绝对的黑和白;盗号问题现在还有,证明它不可能被彻底解决------ 一旦彻底解决,腾讯等公司就不会持续在安全技术上投入更新。
所以,方案一必须在原理上被修正。这就是方案二的由来。
17.2.1 插叙:Cookie 是从哪来的?
Cookie 这个东西不是凭空出现的。它有一段挺有意思的来历,顺便也能解释一件你天天在用、但可能没想过的事。
   1994 年,网景(Netscape)公司
       │
       ├── 他们做了当时最流行的浏览器:Netscape Navigator
       │
       └── 他们遇到了一个问题:
              HTTP 是无状态的,那"购物车"怎么办?
              用户加了一件商品,下一次请求服务器就不认识他了
              ★ 于是他们发明了 Cookie
再往后,就是那场所有人都知道的浏览器战争:
   1994  网景 Navigator 诞生,一度占据 90% 市场
       ↓
   1995  微软推出 IE,并把它【免费捆绑】进 Windows
       ★ 这一招直接改变了战局------
         用户不用去下载浏览器了,装完系统就有
       ↓
   1998  网景败下阵来,公司被 AOL 收购
       ★ 但它做了一件影响极其深远的事:
         把浏览器的源代码【开源】了
       ↓
       ★ 这份开源代码,就是后来 Mozilla Firefox 的起点
       ↓
   2008  Google 推出 Chrome
       ★ 同样是【开源】的(Chromium 项目)
       ★ 靠"更快" + "更安全" + "更标准的实现"重新洗牌
       ↓
   今天  Chromium 内核几乎统治了浏览器市场
         (Chrome、Edge、国产浏览器大多基于它)
这段历史和我们这一章有什么关系?关系在于那个"开源"的决定。
   ★ 浏览器开源
       → 它怎么处理 URL、怎么存 Cookie、
         怎么排序报头、怎么实现 keep-alive......
       → ★ 全都变成了【公开可查的实现】

   → 于是 Web 开发者第一次能精确地知道
     "我的请求发出去之前,浏览器到底做了什么"

   → 也正因为实现公开、标准公开,
     才有今天"任何浏览器访问任何服务器都能通"这件事
更重要的是,这也解释了我们前面反复追问的一个问题:为什么必须"按约定来"?
因为我们写的服务器,对面坐着的不是"某一个人写的浏览器",而是所有浏览器。原文在讲状态码时那句话在这里又成立了一次:
约定俗成的东西,就别自作主张。
你的服务器回一个 301,Chrome、Firefox、Safari、Edge、手机上的 WebView,甚至爬虫,都必须能理解同一个意思。 这种"不依赖任何一方实现细节"的互操作性,才是 Web 能从 1994 年活到今天的原因。
17.3 方案二:Session ------ 只给客户端一个"学号"
17.3.1 问题重新表述
方案一的根本问题在哪?原文点得很准:
原 Cookie 做法的问题:把用户私密信息(用户名密码、浏览痕迹、访问过的页面路径、登录时间等)保存在客户端本地 ------ 用户没有防范意识,易装恶意软件,数据易被盗,不能指望用户解决安全问题,所以不是成熟方案。
看这几个关键词:
   ★ "不能指望用户解决安全问题"

   这是整个安全设计的核心原则。

   把安全责任推给用户 = 系统设计失败。
   因为用户一定会:装来路不明的软件、点钓鱼链接、
                  用弱密码、在公共 WiFi 上登录......
所以要换一个思路:
   方案一:把用户的私密信息【发给客户端保管】  → 会被偷 ❌
   方案二:私密信息【留在服务器】,只给客户端一个【编号】  → ✅
17.3.2 核心改变:数据留在服务器
核心改变:企业端把用户私密信息(比账号密码大得多:账号密码、登录时间、浏览痕迹、个人信息等)不再写回客户端,而是维护在服务器端。
用户信息是结构化信息(用户名、密码、登录时间、昵称、最近登录时间、浏览痕迹、历史访问页面等)→ 保存到服务端,最好理解的方式:服务器端以文件形式保存,每个用户一个文件。
文件命名:给文件命名成全服务器内唯一的数字------用随机值 + 时间戳 + MD5 之类的算法生成唯一长序列;以唯一数字作为文件名,即作为键值(key),把用户数据保存到服务端磁盘。
两个术语在这里登场:
   Session     (会话)    = 服务器端保存的那份用户基本信息
   Session ID  (会话 ID) = 那个"全服务器内唯一的数字",也就是文件名
注意 Session ID 的生成方式:
   随机值 + 时间戳 + MD5 之类的算法  →  一个长序列

   ★ 为什么要"随机 + 时间戳"?
     随机 → 防止被猜出来(如果只是递增的 1,2,3,4,
            黑客直接猜别人的 ID 就行了)
     时间戳 → 保证不同时刻生成的不会重复

   ★ 为什么叫"长序列"?
     越长越难猜。如果 ID 只是 6 位数字,
     暴力枚举 100 万次就能撞出别人的会话。
17.3.3 完整的交互流程
改造之后的流程: 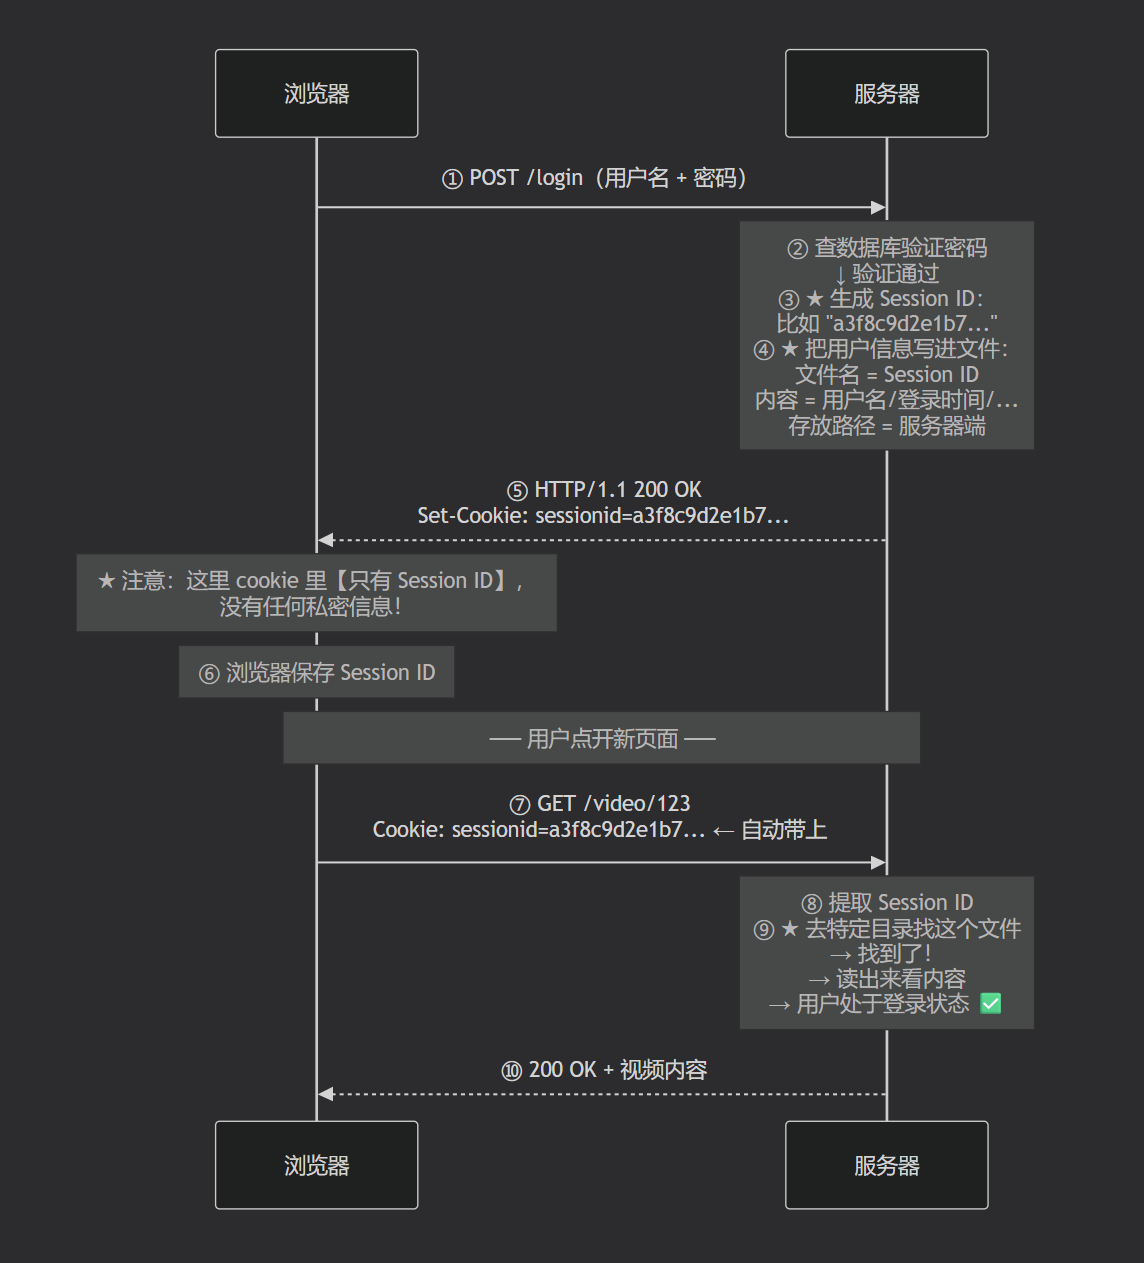
对比方案一,最关键的差别只在一处:
   方案一:Set-Cookie: username=peter&password=123456
                       └────── 私密信息在客户端 ──────┘
   ★ 偷走 Cookie = 偷走账号

   方案二:Set-Cookie: sessionid=a3f8c9d2e1b7...
                       └── 只有一个编号 ──┘
   ★ 偷走 Cookie = 偷走一个编号
     (编号还得去服务器换数据,服务器还有机会做检测)
客户端 Cookie 里只存 Session ID(只用来标识是否登录),不再存私密信息。
17.3.4 一个绝妙的类比:学生档案与学号
原文用了这个类比:
类比(学生档案/学号):
以前档案(户籍、高考成绩、在校表现)发给学生自己拿着,丢了事大;
现在档案统一交学校管理、数据化进数据库,每个学生有学号,通过学号动态查询。
这个类比精确地对应了两种方案:
   ┌─────────────────────────────────────────────────────────┐
   │  过去(方案一)
   │    档案袋发给你自己拿着
   │    ★ 丢了、被偷了、被拆开看了 ------ 全是你的责任
   ├─────────────────────────────────────────────────────────┤
   │  现在(方案二)
   │    档案留在学校(服务器),你只有一个学号(Session ID)
   │    ★ 你需要的时候,凭学号去查
   │    ★ 就算学号被别人知道了,学校还能做身份核验
   └─────────────────────────────────────────────────────────┘
注意这个类比里最重要的一点:
档案(真实数据)从来没有离开过学校的控制范围。
这对应到技术上就是:
   ★ 用户的私密数据从来没有离开服务器的控制范围。
     它没有经过网络传输,没有存在用户的电脑上,
     没有被木马偷走的可能(就这一点而言)。
17.3.5 规模问题与 Redis 的登场
一个规模上的事实:
规模:10 个用户 10 个 Session 文件,100 个用户 100 个,1 万个用户 1 万个。
以及它带来的性能问题:
生产环境考虑:把 Session ID 和用户信息存磁盘,每次 HTTP 通信除了网络还要访问磁盘(磁盘是设备,必然变慢)。
现代后端组件之一:Redis------内存级 KV 数据库,把用户 Session 信息写入 Redis,用 Session ID 直接去取。最朴素的保存文件方式也能用。
这一段点出了一个我们在文件系统那一章学过的核心权衡:
   磁盘  →  能持久化,但慢(要经过文件系统 → 块设备 → 磁盘)
   内存  →  快,但进程/机器重启就没了

   ★ Session 的使用模式是:
     每次 HTTP 请求都要查一次 Session
     → 这是【极高频】操作
     → 放磁盘上太慢

   ★ 所以用 Redis(内存级 KV 数据库)来存

     为什么是 KV 数据库?
     ★ 因为 Session 的使用模式天然就是 KV:
         键 = Session ID
         值 = 用户信息
       这正是上一章讲 Content-Length 时那个"根据使用模式选数据结构"的思路
这个"用内存缓存高频访问的数据"的思路,和我们在文件系统那一章讲的 dcache 是同一个哲学:
   dcache   →  把磁盘上的目录结构缓存在内存里,避免每次路径解析都读盘
   Redis    →  把磁盘上的 Session 缓存在内存里,避免每次请求都读盘

   ★ 同一个思路,用在不同的层次上
17.3.6 一个漂亮的反转:被盗后主动权在服务端
方案二解决了一个方案一无解的问题:
Session 解决了:用户信息泄露问题(用户端不再存私密信息/浏览痕迹,因为根本没写进 Cookie)。
但它没有彻底解决盗号:
未彻底解决:冒充用户身份(盗号)问题------Session ID 也可能被盗。
不过,这里有一个关键的区别:
核心思想:被盗后主动权在服务端------发现问题(检测账号活跃度、异常性)
→ 解决问题(让 Session ID 失效,被盗的 Session ID 就没用了)。
看这个"主动权"的差别:
   方案一:Cookie 里是密码
       被偷了 → 密码就泄露了
       ★ 服务器无能为力(密码又不能随便改,改了用户自己也不知道新密码)

   方案二:Cookie 里是 Session ID
       被偷了 → 服务器可以【主动作废这一个编号】
       ★ 作废掉,小偷手里的编号就是废纸
         而真正的用户重新登录一次,拿一个新的编号就行
"让 Session ID 失效"这个动作,是整个方案二的精髓。
两个真实的检测机制:
机制一:异地登录检测
   用户山东人在云南上学,飞回山东打开电脑登录
   → 腾讯提醒"当前客户端存在异地登录",要求验证码身份认证
   → 原理:后端记录 Session ID,发现登录 IP 变化(给 IP 做校验),
     直接让 Session ID 失效,重新走登录验证

机制二:异常行为检测
   微信账号 200 个好友 198 个多年没聊过,
   突然一天联系 60% 以上好友
   → 腾讯把账号设为异常账号,让 Session ID 失效,必须重新登录
这两个机制的思想是一致的:
   ① 服务器持续【观察】行为(IP 变了?行为模式变了?)
   ② 一旦发现异常 → 【作废】当前的 Session ID
   ③ 让用户重新走一次登录流程(登录流程可以做更强的验证)
这就是"组合式方案":
由更靠近上层的软件/业务策略解决......这是组合式方案。
17.3.7 为什么 HTTP 层解决不了这个问题
为什么 HTTP 层解决不了:HTTP 至少要有一种标识来标识用户身份,所以总要使用 Cookie;Cookie 必用,只要必用就一定可能被盗,所以 HTTP 层解决不了;现实中也很难彻底解决。
这段话的逻辑链非常严密:
   ①  HTTP 是无状态的
       → 服务器没法自己认出你

   ②  所以必须由【客户端】每次告诉你"我是谁"
       → 这就必然需要一种"客户端凭证"
       → 这个凭证就是 Cookie(不管里面装的是密码还是 Session ID)

   ③  而这个凭证必须存在客户端
       → 凡是存在客户端的凭证,原理上就可能被偷

   ★ 结论:只要 HTTP 还是无状态的,
     就必然存在一个"可以被偷的凭证"。
     这个问题在 HTTP 层【原理上】无解。
所以这一章讲的两个方案,本质上是在做权衡,而不是在消灭问题:
   ★ 方案一 → 方案二 的提升是真实的(私密数据不再外流),
     但"凭证可能被盗"这个根本问题,
     只能在 HTTP 之上的业务层用组合策略去缓解。
最后补一个同样重要的话题------服务端自己也可能被攻击。原文提到了 SQL 注入:
服务端被攻击(SQL 注入):黑客也可能攻击服务端盗取数据。
举例:提交表单的用户名密码;后端认证要查数据库;黑客在用户名里内置 SQL 注入语句,后端拿用户名查库时执行了注入语句,可能把用户表数据拿走。
防护:表单用户名密码在前端就限制格式(用户名格式、字符数、密码格式),后端再做检查(正则、信息加密等),注册时处理好。
注意这里的防御思路是"两层":
   前端限制  →  拦住大部分普通用户的手误
   后端检查  →  ★ 真正的一道防线(前端的东西,攻击者可以完全绕过)

   ★ 一条铁律:前端校验是【用户体验】,后端校验才是【安全】。
     攻击者可以直接构造 HTTP 请求,根本不用你的前端页面。
17.4 两种方案的对比与一句话总结
把两个方案放在一起:
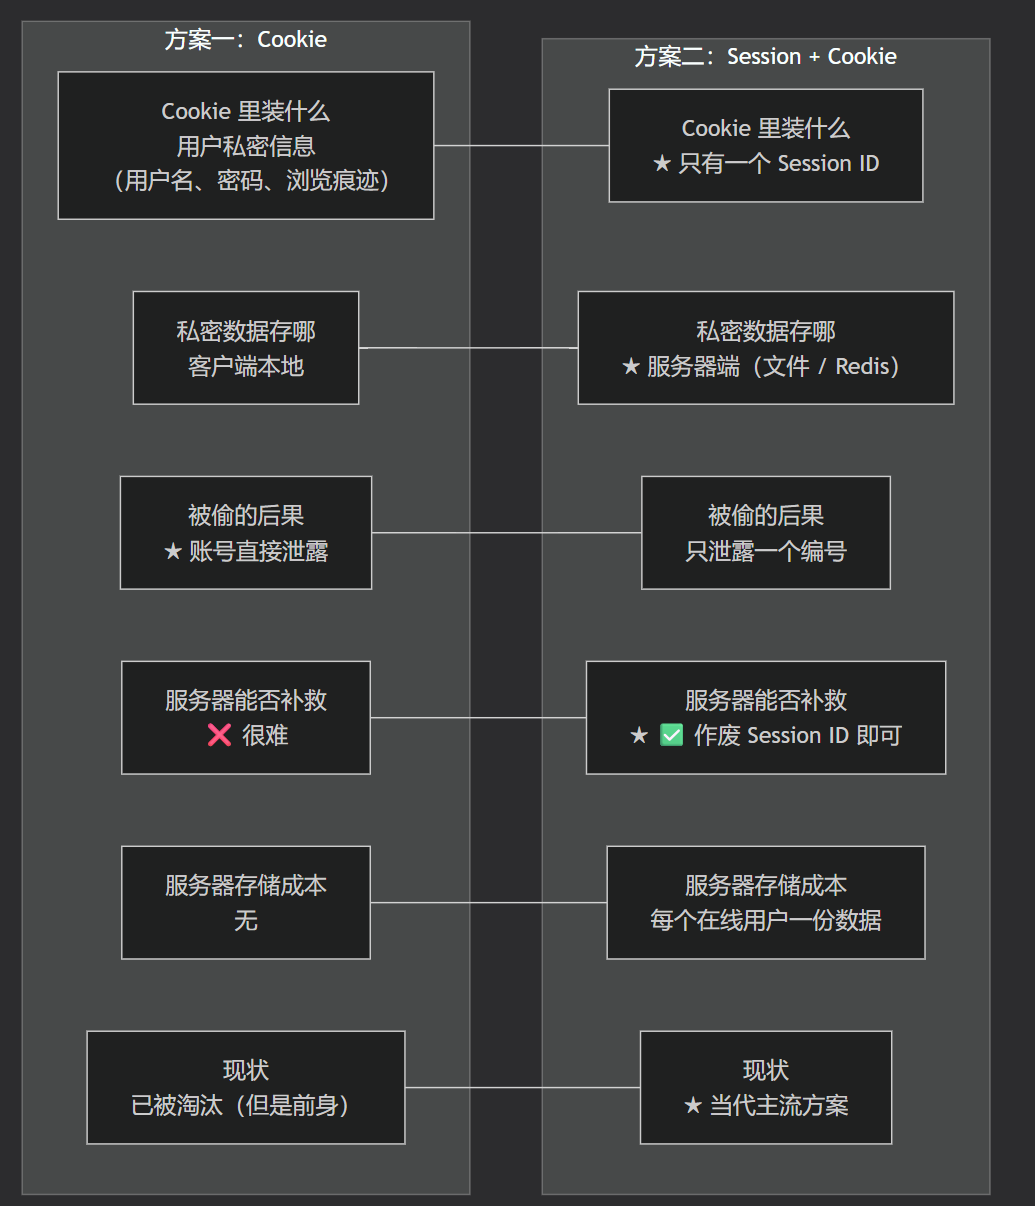
原文对方案一的定位说得很公道:
地位:Cookie 方案已被淘汰,但它是当前技术的前身,必须了解。
以及正确的术语:
术语总结:当代 HTTP 用户在线管理采用的做法准确说叫 Session + Cookie 组合技术(会话管理/会话化管理);
每次用户登录、获得 Session ID 的过程就叫做登录;此后拿着 Session ID 就能登录服务器。
注意"Session + Cookie 组合技术"这个叫法------它精确地指出了两者是配合使用的,不是二选一:
   Session  →  负责【在服务器端存数据】
   Cookie   →  负责【在客户端存 Session ID】
   ★ 缺一不可
17.5 顺带解决一个报头的用处:Referer
讲会话管理时提到的这些报头,还有一个我们之前见过但没细讲的。它在真实业务里有非常实际的用途,值得补上。
回顾一下第五章那张报头表里的一行:
Referer:当前页面是从哪个页面跳转过来的。
原文给了一个具体的演示场景:
演示:
127.0.0.1:8080请求首页 → 首页加 A 标签超链接 → 点击进入登录页面时,登录页请求的报头里Referer= 首页地址;从登录页点回首页时Referer= login 页面地址。
   ① 你在 A 页面,点了一个链接跳到 B 页面
   ② 浏览器发往 B 的请求里,会带上一行:
        Referer: <A 页面的地址>
   ③ B 服务器因此知道:"这个人是【从 A 页面来的】"
这个看似不起眼的信息,在真实业务里有三大用途。
用途一:广告计费与竞价排名。
应用场景:广告计费/竞价:点击搜索广告时按点击数计费;网站把广告投放到十几家头部网站(百度、搜狗等),用户从百度跳过来时,官网通过
Referer判断流量来源并结算(例:买新闻首页 100 万条点击,付 1 万元/两块钱,一点击跳到官网就计费)。传统搜索引擎竞价排名:把医院/公司首页链接放到搜索结果前面,对方买家通过
Referer知道有人来了,双方对照计费。
   ★ 这里解决的是一个"信任"问题:

   广告商:"我花钱买了 100 万次点击,你怎么证明真有人点了?"
   搜索引擎:"每次点击,用户都是从我这儿跳到你的官网的,
             你看请求里的 Referer 就知道是我这儿来的。"

   ★ Referer 就是那个"流量来源的凭证"
用途二:防盗链。这是最实用的一个。
防盗链:防止图片、视频资源被其他网站引用消耗自家服务器带宽。规定访问页面必须从自家网站跳转过来(站内 A→B 跳转时
Referer是自家域名),判断来源是不是自家网站,是则放行、否则拒绝。防止资源被恶意盗链。
   ★ 问题场景:
     你辛辛苦苦拍的视频/图片放在自己服务器上
     别人的网站直接引用了你的图片地址:
        <img src="https://你的服务器.com/video/xxx.mp4">
     →  视频是被【你的服务器】传出去的
     →  但带宽费用是【你】付的
     →  这就叫"盗链"

   ★ 解法:
     检查 Referer,判断"这个请求是不是从我家页面发起的"
        Referer 是自家域名  →  放行 ✅
        Referer 是别人的域名 →  拒绝 ❌
        Referer 是空的      →  (看策略,通常也拒绝)
用途三:统计与安全。
   ★ 流量分析:知道用户是从哪个渠道来的(搜索?社交?直接输入网址?)
★ 安全审计:异常的 Referer 可能是攻击行为注意一个细节:Referer 拼写是错的。
   ★ 它的正确英文拼写应该是 "Referrer",多一个 r

       但 HTTP 规范第一次写的时候就写错了(Referer),
   然后就【改不了了】------

       因为全世界已经有无数服务器和浏览器按错误的拼写实现了,
   一旦修改,全部都会不兼容。

   ★ 这是一个"锁定效应"的经典案例:
     规范一旦被广泛实现,就算有错也改不动了。

       类似的还有 HTTP 里 Content-Length 必须是字节数、
   \r\n 必须是两个字符等等------都是历史包袱,
   但都被"必须兼容"牢牢钉住了。
17.6 承上启下
到这里,HTTP 的"性格"就完整了:
   ★ 它天生【无状态】  →  所以才需要 Cookie / Session
   ★ 它天生【无连接】  →  所以才需要 Connection 报头来协商复用
而这两章讲的内容,也让我们看到了一个更宏观的图景:
   ┌────────────────────────────────────────────────────┐
   │  HTTP 协议本身,只做一件事:
   │     把一个请求的字节流,翻译成"要哪个资源"
   │     再把它变回一串响应字节流
   ├────────────────────────────────────────────────────┤
   │  至于"你是谁""你有没有权限""要不要记住你"
   │  ★ 这些都不是 HTTP 管的事
   │     而是【HTTP 之上的业务层】管的事
   └────────────────────────────────────────────────────┘
一个 HTTP 服务器写得"对",只是合格;写得"能用",还需要业务层的会话管理。
到这里,静态资源、状态码、正文类型、Cookie 与 Session 都讲完了。但还有一件事,我们从头到尾都在绕着走:前面所有章节里,服务器做的事情都是"把一个 URI 变成一个文件"。可登录、注册、搜索这些功能,服务器上根本没有对应的文件------那它们是怎么被实现的?
这就是下一章要补上的最后一块拼图。
第十八章 服务端怎么知道该调用哪个函数:服务注册与路由
18.1 一个我们一直绕过去的问题
先做一个盘点。到目前为止,我们写的 HTTP 服务器只会做一件事:
   收到 GET /index.html
        ↓
   拼出路径 "wwwroot/index.html"
        ↓
   打开这个文件,把内容读出来
        ↓
   塞进响应正文,发回去
这套流程有一个隐含的前提:URI 对应的东西,是磁盘上的一个文件。
第八章讲这个逻辑的时候,我们说得很顺------因为 wwwroot 里确实躺着 index.html。但我们当时悄悄跳过了一个问题:
┌────────────────────────────────────────────────────────────────┐
│  如果 URI 是 /login 呢?
│
│     wwwroot/login     ← ★ 这个文件不存在,也不该存在
│
│   因为"登录"不是一个文件,
│   登录是【一段代码】:
│       读你传来的用户名密码 → 查数据库 → 判断 → 写 Session → 应答
│
│   ★ 它没有对应的磁盘文件。
└────────────────────────────────────────────────────────────────┘
这就是第一章就埋下的那条分界线,现在它终于要兑现了:
   静态资源(static)                动态站点(dynamic)
   ─────────────────               ─────────────────
   HTML / CSS / JS / 图片 /        登录 / 注册 / 支付 /
   音视频                          搜索 / 提交表单 / 点赞

   ★ 本质是【文件】                 ★ 本质是【代码】
   ★ 内容早就做好了,               ★ 内容要现场算出来,
     读出来就行                       每次结果可能都不一样

   服务器的工作:                   服务器的工作:
   路径转换 → open/read            解析参数 → 调用函数 → 拼出结果
第八章讲的是左半边。这一章讲右半边。
而右半边要回答的核心问题只有一个:
服务器收到
GET /login之后,它凭什么知道要去调用"处理登录的那个函数"?------毕竟,
/login只是一个字符串,而"处理登录的函数"是代码里一个具体的地址。这两者之间是怎么连起来的?
18.2 答案是一张表
如果我们只能想到"用 if-else 判断",代码会变成这样:
// ❌ 能跑,但每加一个功能就要改这里一次
if (uri == "/login") {
    HandleLogin(req);
} else if (uri == "/register") {
    HandleRegister(req);
} else if (uri == "/search") {
    HandleSearch(req);
} else if (uri == "/submit") {
    HandleSubmit(req);
} else if (uri == "/api/log") {
    HandleLog(req);
}
// ... 还有 20 个呢?
这段代码的问题不在"慢",而在"每次加功能,都要动这个核心分发函数"。 你想加一个 /logout,就必须找到这个文件、找到 if 链、在末尾加一个分支、然后重新编译整个服务器。
我们早就学过这个问题的标准解法了------"先描述,再组织",用数据结构代替硬编码。
这一次的"描述",描述的是"一个 URI 对应一个处理函数"这件事:
// ★ 描述:什么叫"一个服务"?
//   它是一个可调用对象------吃进一个请求,吐出一个响应
using Service = std::function<void(HttpRequest &req, HttpResponse &resp)>;
//     ↑ 注意这里用的是 std::function,
//       所以"服务"可以是普通函数、静态成员函数、Lambda、仿函数......
//       只要能被这样调用就行
然后"组织"它们:
class HttpServer {
public:
    // ★ 组织:一个从 URI 到 Service 的映射表
    std::unordered_map<std::string, Service> _services;
    //                     ↑ key:URI 路径   ↑ value:处理它的函数
};
这张表,就是这一章的主角。它叫"服务注册表",也叫"路由表"。
它的意义可以用一句话说清楚:
从"服务器认识哪些 URI 是写死在代码里的",变成"服务器认识哪些 URI 是运行时注册进去的"。
加一个功能,不再是"改分发逻辑",而是"往这张表里插一条记录"。
18.3 注册:往表里插一条记录
有了表,还需要一个往表里插数据的动作。这个动作用一个函数来表达:
class HttpServer {
public:
    // ★ 注册一个服务:告诉服务器"这个 URI 归我管"
    void RegisterService(const std::string &uri, Service service) {
        _services[uri] = service;
        //      ↑ 注意这里是【赋值】,不是 insert
    }
};
注意 _services[uri] = service 这一行里的一个细节:
   ★ 用 [] = 而不是 insert,带来的语义是【覆盖】。

   【第一次】RegisterService("/login", Login);
        _services["/login"] = Login;   ✅ 新增一条记录

   【第二次】RegisterService("/login", LoginV2);
        _services["/login"] = LoginV2; ← ★ 静默覆盖掉旧的
这个"覆盖"语义是有意为之的,它带来一个很实用的能力:
可以在不改动服务器任何代码的前提下,替换掉一个已有服务的实现。
比如:先在本地注册一个假的
/login(直接返回"登录成功")来联调前端;上线时用真实的Login覆盖它。服务器的骨架一行都不用改。
一个完整的注册长这样------通常放在服务器初始化的时候:
int main() {
    HttpServer server;

    // ★ 把每个动态服务登记进路由表
    server.RegisterService("/login",    Login);       // 登录
    server.RegisterService("/register", Register);    // 注册
    server.RegisterService("/search",   Search);      // 搜索
    server.RegisterService("/api/log",  AppendLog);   // 前端上报日志
    server.RegisterService("/submit",   Submit);      // 提交表单

    server.Start();   // 启动后开始 accept 循环
    return 0;
}
这几行代码的意义,值得停下来体会一下:
┌────────────────────────────────────────────────────────────────┐
│  左边(main 里的注册)        右边(服务的实现)
│  ────────────────────         ──────────────────
│  "/login"    ─────────────►   Login()      ← 可以写在另一个 .cpp
│  "/register" ─────────────►   Register()
│  "/search"   ─────────────►   Search()
│
│  ★ 这张表把"URI 长什么样"和"处理逻辑怎么写"这两件事
│     彻底【解耦】了
│
│  ★ 前端只需要知道有 "/login" 这个路径
│     后端只需要知道有个 Login() 函数要写
│     两边唯一的交汇点,就是这张表
└────────────────────────────────────────────────────────────────┘
这也是现代 Web 框架里"路由"(routing)概念的雏形。
18.4 分发:收到请求后先查表,再决定干什么
表建好了,现在看服务器收到请求时怎么用它。
这里有一个顺序问题,而且这个顺序非常重要:
   ★ 先查路由表 ------ 命中 → 交给对应的 Service 处理
   ★ 没命中     ------ 才走第八章那套"当静态文件读出来"
为什么是这个顺序,而不是反过来?
┌────────────────────────────────────────────────────────────────┐
│  假设反过来:先当文件读,读不到再查表
│
│    收到 GET /login
│       ↓
│    去 wwwroot/login 找一个文件 → ★ 不存在
│       ↓
│    此时你已经准备好返回 404 了......
│       ↓
│    才想起来"哦,也许这是个动态服务"?
│
│  ★ 问题:404 该不该返回,已经变成"读文件失败"的副作用了
│     而真正该决定它的,是"路由表里有没有 /login"
└────────────────────────────────────────────────────────────────┘
所以正确的顺序是:
void HandleHttpRequest(HttpRequest &req, HttpResponse &resp) {
    // ── 第一步:看这个 URI 是不是一个【动态服务】────────────
    auto it = _services.find(req._uri);
    if (it != _services.end()) {
        // ★ 命中!这是一个注册过的服务
        Service service = it->second;    // 取出那个函数
        service(req, resp);              // ★ 调用它,由它填满 resp
        return;                          // ★ 处理完了,直接返回
    }

    // ── 第二步:不是服务,那按【静态资源】处理 ───────────────
    // 这里就是第八章那套逻辑: "/" → "/index.html",再拼 wwwroot
    std::string path = req._uri;
    if (path == "/") path += g_first_page;
    path = g_wwwroot + path;

    // 读文件、填 resp._text、填 Content-Length......
    // 读不到文件 → 404
}
这个函数是整个服务器的"总调度",它的结构可以用一张图概括:
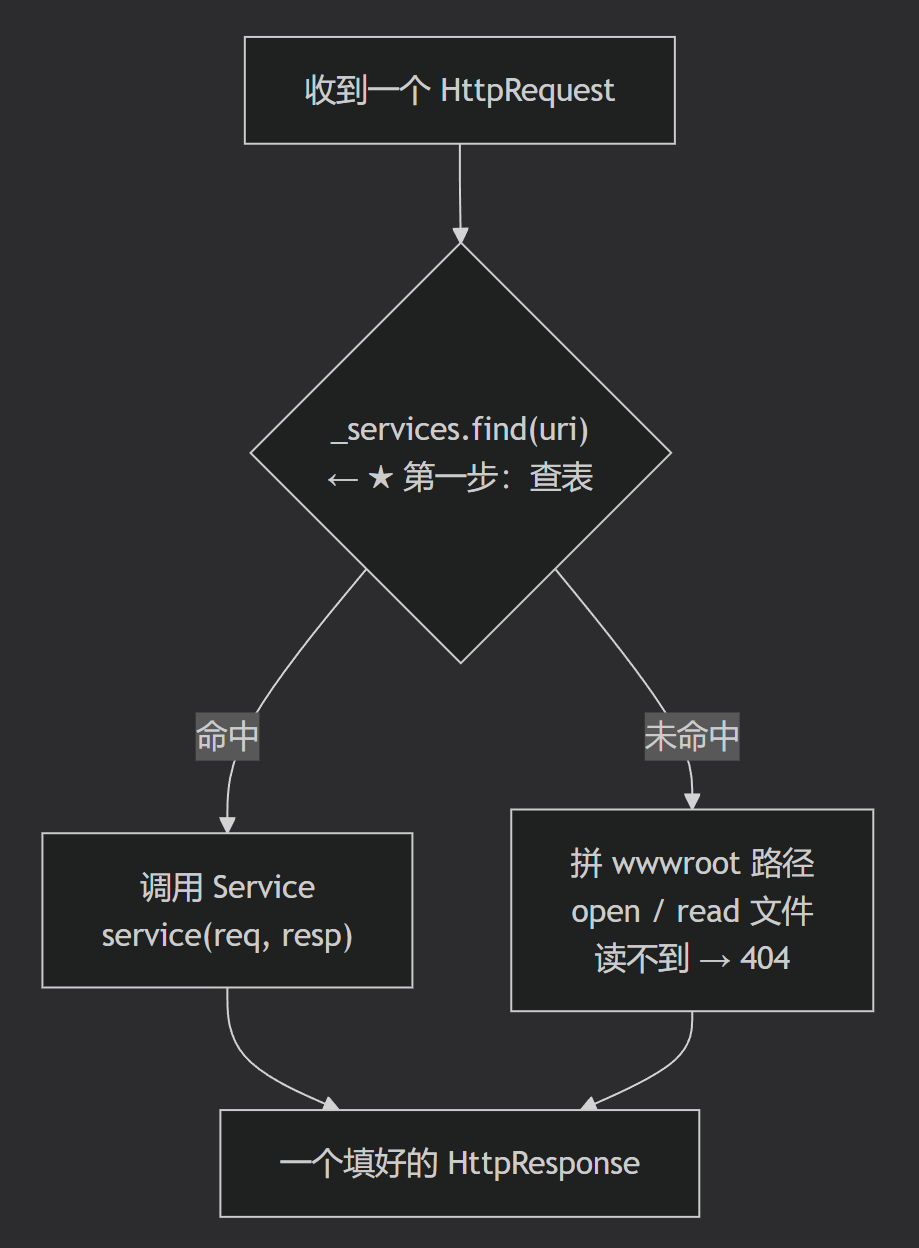
注意图中两条路径最后汇合到同一个出口------HttpResponse。
这一点很关键:对一个 Service 来说,它和"读文件"那条路完全没有区别,都是"想办法把 resp 填好"。
它不需要知道 socket 的存在,不需要知道 TCP 怎么发包,甚至不需要知道自己在处理 HTTP------它只需要:
从 req 里读信息 → 往 resp 里写结果这就是分层的力量又一次兑现:第八章的"读文件"和这一章的"调服务",在总调度的眼里是同一种东西------两个都能填满 resp 的黑盒。
18.5 举例子:四个真实的服务长什么样
光看框架还是抽象。我们直接把几个典型的服务实现出来看看。
18.5.1 例一:/login ------ 从请求里取参数
void Login(HttpRequest &req, HttpResponse &resp) {
    // ★ 第一步:从请求正文里取出参数
    //    第六章讲过:正文在哪、多长,都由 Content-Length 说了算
    std::string body = req._text;          // 形如 "username=maisui&password=123456"

    std::string user = GetValue(body, "username");   // 从 kv 串里取值
    std::string pass = GetValue(body, "password");

    // ★ 第二步:业务逻辑(这是"应用层"真正要做的事)
    if (CheckUserInDB(user, pass)) {
        resp._code      = 200;
        resp._code_desc = "OK";
        resp._header["Content-Type"] = "text/html";
        resp._text      = "<h1>登录成功</h1>";
    } else {
        // ★ 第三步:失败也要有应答 ------ 第九章那条铁律
        resp._code      = 200;          // 注意:业务失败 ≠ HTTP 失败
        resp._code_desc = "OK";
        resp._text      = "<h1>用户名或密码错误</h1>";
    }
}
这里有一个特别容易搞混的地方,值得单独说:
┌────────────────────────────────────────────────────────────────┐
│  "登录失败" 应该返回 401 还是 200?
│
│  ★ 答案是:200。
│
│  因为 HTTP 状态码描述的是【这一次 HTTP 交互本身】的结果:
│      · 200 → "服务器成功处理了这个请求,并给了你一个响应" ✅
│      · 401 → "你连访问这个资源的资格都没有"(认证失败,
│                通常配 WWW-Authenticate 报头)
│
│  "密码错了"是一个【业务层面】的判断,
│  服务器确实成功处理了请求 ------ 它只是告诉了你一个坏消息。
│
│  ★ 换句话说:状态码是给【HTTP 协议】看的,
│     不是给【你的业务逻辑】看的。
└────────────────────────────────────────────────────────────────┘
这个区分在真实项目里天天吵架,记住它。
18.5.2 例二:/api/log ------ 前端上报日志
这是一个特别能说明"动态服务"价值的例子。
需求是:网页上用 JS 捕获到用户操作或者报错,需要把这些信息送到服务器存起来,方便排查问题。
// 服务端:把前端送上来的日志追加到文件里
void AppendLog(HttpRequest &req, HttpResponse &resp) {
    // 前端发来的是 POST /api/log,正文就是一行日志
    std::string log_line = req._text;

    // ★ 注意:这里是【写文件】,不是读文件!
    int fd = open("server.log", O_WRONLY | O_APPEND | O_CREAT, 0644);
    //                        ↑ 追加写,不覆盖已有的
    if (fd >= 0) {
        write(fd, log_line.c_str(), log_line.size());
        write(fd, "\n", 1);
        close(fd);
    }

    // ★ 对前端来说,它不关心存到哪了,只要一个"收到了"的答复
    resp._code      = 200;
    resp._code_desc = "OK";
    resp._header["Content-Type"] = "application/json";
    resp._text      = R"({"ok":true})";
}
前端那边只要一句话:
// 浏览器里:任何位置都能调这一行,日志就进服务器了
fetch("/api/log", { method: "POST", body: "用户点击了购买按钮" });
这个例子说明了一件事:动态服务的返回值不一定是 HTML。
   /index.html   →  返回 HTML      (给人看的)
   /style.css    →  返回 CSS       (给浏览器看的)
   /api/log      →  返回 JSON      (给前端代码看的)
   /api/user     →  返回 JSON      (给前端代码看的)
这就是 12.4 节讲 Content-Type 的延伸------同一个服务器,可以同时对外提供"给人看的页面"和"给程序用的接口"。 后者就是今天说的 API。
18.5.3 例三:/exec ------ 一个危险但极有启发性的服务
一个很大胆的例子:让服务器执行一条命令,把输出返回给浏览器。
void Exec(HttpRequest &req, HttpResponse &resp) {
    // ★ 从 URI 里取出要执行的命令,比如 /exec?cmd=ls
    std::string cmd = GetQueryValue(req._uri, "cmd");

    // 用 popen 执行命令,读它的标准输出
    FILE *fp = popen(cmd.c_str(), "r");
    //          ↑ 注意这个 r:读模式,读的是子进程的 stdout

    if (fp == nullptr) {
        resp._code = 500;
        resp._code_desc = "Internal Server Error";
        return;
    }

    char buf[1024];
    std::string result;
    while (fgets(buf, sizeof(buf), fp) != nullptr) {
        result += buf;          // 把命令的输出一行行攒起来
    }
    pclose(fp);

    resp._code      = 200;
    resp._code_desc = "OK";
    resp._header["Content-Type"] = "text/plain";
    resp._text      = result;   // ★ 命令的输出,变成了响应正文
}
这个服务在功能上等价于一个"网页版 shell"------你在浏览器地址栏里敲 http://host:8080/exec?cmd=ls,就能看到服务器上这个目录下的文件列表。
它极具启发性,因为它把"动态服务"的能力边界彻底暴露了:
┌────────────────────────────────────────────────────────────────┐
│  动态服务能做的事,就是【服务器进程能做的事】。
│
│  服务器进程能 open 文件 → 服务就能读写文件
│  服务器进程能连数据库 → 服务就能查数据库
│  服务器进程能 fork/exec → ★ 服务就能执行任意程序
│  服务器进程能访问网络 → 服务就能去别的服务器拉数据
└────────────────────────────────────────────────────────────────┘
但正因为它把边界暴露得这么彻底,它也是最危险的一类服务。
⚠️ 这个例子只能用在本机学习和内网实验里,绝不能放到公网上。
原因很直接:
/exec?cmd=后面接什么,就执行什么。攻击者只要试出?cmd=cat /etc/passwd、?cmd=rm -rf /,服务器就变成了他的一台机器。这正是"命令注入"(Command Injection)漏洞最教科书的样子。 它和我们前面提过的目录穿越(少了
wwwroot前缀)、SQL 注入是同一类错误------把"用户可控的输入"直接当成了"要执行的指令"。正确的做法是永远不要让用户决定执行什么命令 ;如果确实需要执行外部程序,就必须用白名单限定可执行文件,并把参数单独传递(用
execve的数组形式,而不是拼一个字符串交给 shell)。
我们把它写在这里,不是教你怎么做,而是因为它把"服务器能做什么"这件事讲得最清楚。
18.5.4 例四:在线评测(OJ)------ 把前面的知识全串起来
如果要说一个"最能把前面所有知识串起来"的动态服务,那就是在线评测(Online Judge)。
用过刷题网站的人都熟悉这个流程:在网页上写一段代码,点提交,几秒后告诉你"通过"或者"答案错误"。
这几秒里发生了什么?我们把它的服务端拆开:
   你在网页上提交 C++ 代码
        │
        ▼
   ① 浏览器 POST /submit
      正文 = 你写的代码(可能几 KB,全在 req._text 里)
        │
        ▼
   ② 服务端:把代码【写到磁盘】一个临时文件里,比如 /tmp/user_9527.cpp
        │
        ▼
   ③ 服务端:★ fork + exec 调用编译器(gcc/g++)
        g++ /tmp/user_9527.cpp -o /tmp/user_9527
        → 编译失败 → 返回"编译错误",结束
        │
        ▼
   ④ 服务端:★ 把编译好的程序跑起来,并用【管道】把测试数据喂进去
        ./tmp/user_9527  <  testcase_1.txt   >  output_1.txt
        (这是 shell 的写法,代码里用 pipe() + dup2() 实现)
        │
        ▼
   ⑤ 服务端:★ 把 output_1.txt 和标准答案 answer_1.txt 逐字节对比
        相同 → 换下一组测试数据,回去执行④
        不同 → 返回"答案错误"
        │
        ▼
   ⑥ 全部通过 → 返回"通过",并把结果写进数据库
这里面每一环,都是我们前面讲过的东西:
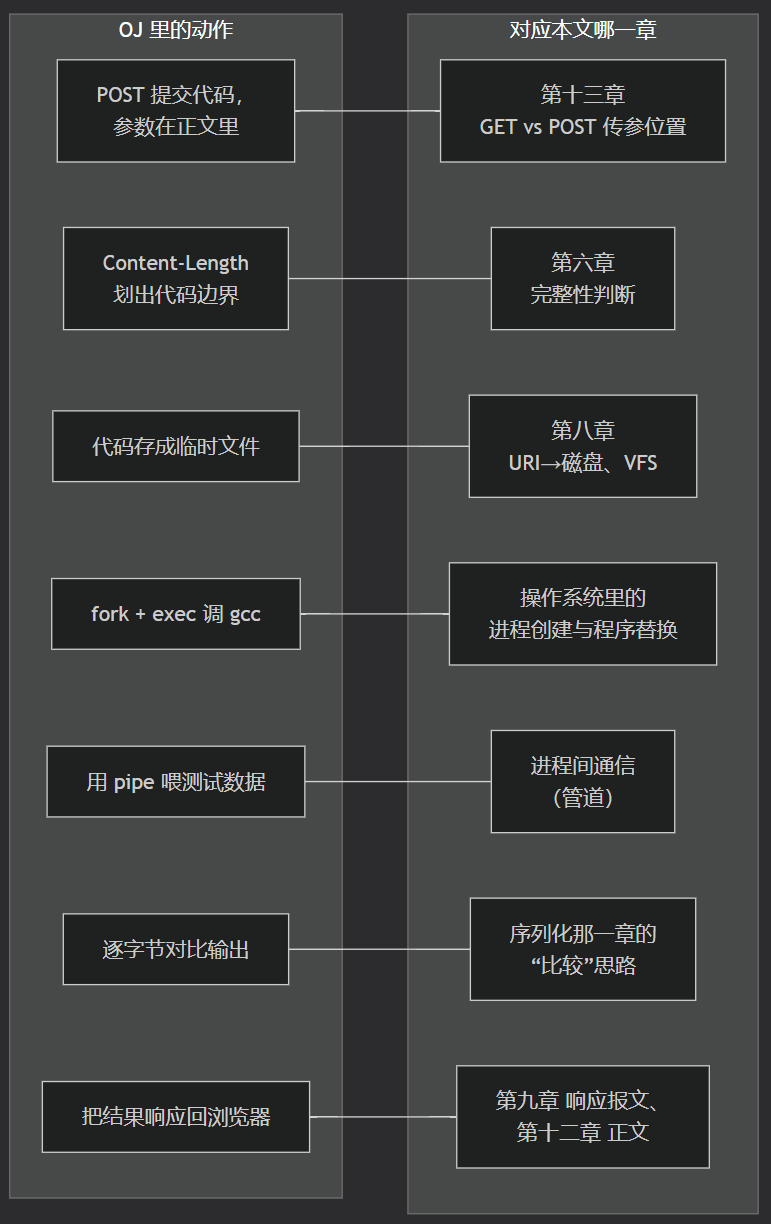 它还解答了一个很多人好奇的问题:评测系统怎么跑我的代码的?
答案朴素得让人失望:就是
fork一个子进程,exec一个编译器把它编译出来,再fork一个子进程执行它,把测试数据用管道喂进它的标准输入。所谓"沙箱""评测机""分布式判题",是在这个朴素模型上叠加资源限制(时间、内存、系统调用白名单)、隔离(容器/虚拟机)和调度(任务队列)之后的结果。核心一步就是
fork+exec。
为什么 OJ 值得放在这一章的结尾讲?因为它证明了"动态服务"的天花板有多高。
   一个 HTTP 服务器 + 一张路由表
        ↓
   注册一个 /submit 服务
        ↓
   这个服务里能 fork/exec 任意程序、能读写文件、能连接数据库
        ↓
   ★ 于是它就变成了:一个在线评测系统 / 一个云 IDE /
                      一个爬虫平台 / 一个 CI 系统 / 一个运维面板

   而它们的骨架,都还是这一章那三十行代码。
另外,OJ 里还藏着一个真实的实现细节,值得记一笔:
题目要求"用 Python 提交代码"时,服务端不能直接
exec用户的那段文本------因为它是代码片段,不是一个完整的可执行文件。做法是:把用户的函数和服务器预先写好的一段 main 框架【拼接】成一个完整的
.py文件,然后再用/usr/bin/python去执行这个完整文件。用户只写
def solve(): ...,服务器负责补上读输入、调solve()、打印输出的外壳。 这也是很多刷题平台上"你只需要实现这个函数"的由来。
18.6 路由表 vs 内核表:同一种设计,出现了三次
到这里,服务注册表已经讲清楚了。但如果你还记得我们前面几次为了讲清楚一个概念而"钻进内核"的经历,你可能会觉得这张表有点眼熟。
它确实眼熟------因为"用名字查函数"这个设计,我们在内核里已经见过两次了。
┌────────────────────────────────────────────────────────────────┐
│  第一次见:file_operations ------ 用"操作名"查函数
│
│    我们在第八章讲过 struct file 里有这么一行:
│
│        const struct file_operations *f_op;
│
│    它指向的是一张函数指针表:
│        .read    = ext4_file_read
│        .write   = ext4_file_write
│        .open    = ext4_file_open
│        .release = ext4_release_file
│
│    ★ 内核在"要对一个文件做读操作"时,不看这个文件是 ext4 还是
│       proc,它只管调 f_op->read(...)------具体调哪个函数,
│       由这张表决定。
└────────────────────────────────────────────────────────────────┘

┌────────────────────────────────────────────────────────────────┐
│  第二次见:sys_call_table ------ 用"编号"查函数
│
│    Linux 里有一张系统调用表(x86-64 的 arch/x86/entry/
│    syscalls/syscall_64.tbl 定义,编译后成为一张指针数组):
│
│        0  →  sys_read
│        1  →  sys_write
│        2  →  sys_open
│        3  →  sys_close
│        ...
│
│    ★ 你在用户态调 read(fd, buf, n),编译器生成一条 syscall
│      指令,eax 里放 0------内核拿 0 去查这张表,找到 sys_read,
│      然后调用它。
│
│    ★ "编号"和"函数地址"之间的对应关系,存在一张表里。
└────────────────────────────────────────────────────────────────┘

┌────────────────────────────────────────────────────────────────┐
│  第三次见:服务注册表 ------ 用"URI"查函数
│
│    std::unordered_map<std::string, Service> _services;
│
│        "/login"    →  Login
│        "/register" →  Register
│        "/submit"   →  Submit
│
│    ★ 服务器拿到 URI 字符串,去这张表里查,找到对应的函数调它。
└────────────────────────────────────────────────────────────────┘
把三者并排放在一起看,会发现它们是同一个模式的三个实例:
| 查表用的 key | 表里存的东西 | 谁写这张表 |
|----------------|---------|-----------------|------------|
| file_ops | 操作名 | 函数指针 | 具体文件系统 |
| sys_call_tbl | 系统调用号 | 函数指针 | 内核编译时 |
| serviceMap | URI 字符串 | std::function | main() 里 |
这个模式的通用名字叫"分派"(dispatch)。它解决的问题永远是同一个:
调用方只知道"我要做一件什么事"(读一个文件、执行一次系统调用、访问一个 URL),但不知道"这件事具体该由哪段代码完成"。
于是引入一张表,把"叫什么"和"谁来做"隔开。
调用方只依赖表,实现方只负责往表里注册。两边互不认识。
这就是为什么我们能在不修改内核的情况下加载一个新的文件系统,也解释了为什么我们能在不修改服务器的情况下加一个新的网页功能------
它们用的是同一个设计。
18.7 承上启下
这一章补上了第八章留下的另一半:
   URI  →  【静态】磁盘上的一个文件        (第八章)
   URI  →  【动态】一个注册过的函数        (第十八章)
                ↑
          靠 serviceMap 这张表连起来
至此,一个 HTTP 服务器该有的能力,我们已经全部走了一遍:
   接连接(第四章)→ 收字节流(第六章)→ 解析成 HttpRequest(第七章)
        → 判断是静态文件还是动态服务(第八章 / 第十八章)
        → 生成 HttpResponse(第九、十、十一、十二章)
        → 发回去(第四章)
剩下的,就是把这一路的知识压缩成可以随手查阅的形式。
下一章是速查表。
第十九章 速查表
19.1 URL 结构速查
https://user:pass@www.example.jp:80/dir/index.htm?uid=1#ch1
└─┬──┘  └───┬───┘ └──────┬──────┘└┬┘└──────┬──────┘└──┬──┘└─┬─┘
协议方案名  登录信息    服务器地址  端口  文件路径    查询串  片段
                                    ↑                 ↑       ↑
                              可省略(80/443)     GET 传参处  不会发给服务器

URI = 统一资源标识符  →  标识"这是什么"
URL = 统一资源定位符  →  定位"去哪里拿"
URL ⊂ URI
请求行里的字段叫 _uri(只有路径,没有主机名)
19.2 端口与默认值速查
http://   →  默认 80
https://  →  默认 443
DNS       →  53(通常 UDP)
19.3 HTTP 请求报文速查
┌──────────────────────────────────────────────────────┐
│ 请求行    方法 [空格] URI [空格] 版本  \r\n
├──────────────────────────────────────────────────────┤
│ 请求报头   Key: [空格] Value  \r\n
│           Key: [空格] Value  \r\n
│           ...
├──────────────────────────────────────────────────────┤
│ 空行      \r\n          ★ 不可省略!(报头结束标志)
├──────────────────────────────────────────────────────┤
│ 请求正文  DATA          (可选,GET 通常没有)
└──────────────────────────────────────────────────────┘
19.4 HTTP 响应报文速查
┌──────────────────────────────────────────────────────┐
│ 状态行    版本 [空格] 状态码 [空格] 状态码描述  \r\n
├──────────────────────────────────────────────────────┤
│ 响应报头  Key: [空格] Value  \r\n
│           ...
├──────────────────────────────────────────────────────┤
│ 空行      \r\n
├──────────────────────────────────────────────────────┤
│ 响应正文  DATA(HTML / CSS / 图片二进制 / ...)
└──────────────────────────────────────────────────────┘
19.5 请求方法速查
| 方法 | 描述 | HTTP 版本 |
|---|---|---|
| GET | 获取资源 | 1.0、1.1 |
| POST | 传输实体主体 | 1.0、1.1 |
| PUT | 传输文件 | 1.0、1.1 |
| HEAD | 获得报文首部 | 1.0、1.1 |
| DELETE | 删除文件 | 1.0、1.1 |
| OPTIONS | 询问支持的方法 | 1.1 |
| TRACE | 追踪路径 | 1.1 |
| CONNECT | 要求用隧道协议连接代理 | 1.1 |
| LINK | 建立和资源之间的联系 | 1.0(已废弃) |
| UNLINE | 断开连接关系 | 1.0(已废弃) |
19.6 状态码速查
【按第一位数字分类 ------ 只用记这一行】
   1xx  Informational  信息性  →  请求正在处理
   2xx  Success        成功    →  请求正常处理完毕
   3xx  Redirection    重定向  →  需要附加操作才能完成
   4xx  Client Error   客户端错 →  ★ 是【你】的问题
   5xx  Server Error   服务端错 →  ★ 是【我】的问题

【常见状态码】
   100  Continue               上传大文件,告诉客户端可以继续上传
   200  OK                     ★ 访问首页成功,返回网页内容
   201  Created                发布新文章成功
   204  No Content             删除成功(无内容返回)
   301  Moved Permanently      ★ 永久重定向(换域名,会改客户端认知)
   302  Found / See Other      ★ 临时重定向(登录后跳首页,不改认知)
   304  Not Modified           缓存未失效,直接用本地缓存
   400  Bad Request            表单格式不对
   401  Unauthorized           未登录 / 认证失败(缺身份)
   403  Forbidden              ★ 没权限(缺权限,登录也没用)
   404  Not Found              ★ 访问不存在的链接
   500  Internal Server Error  服务器崩溃 / 数据库错误
   502  Bad Gateway            代理后面的服务器没响应(不是我的锅)
   503  Service Unavailable    服务器维护 / 过载(是我的锅)

【301 vs 302 ------ 最容易搞错的一对】
   301 永久  →  客户端【记住】新地址,下次直接去新地址
              用于:换域名、SEO 权重转移
   302 临时  →  客户端【不记】,下次还去老地址
              用于:登录成功后跳转

   ★ 血的教训:登录跳转用 301,用户会再也回不到登录页
19.7 常用报头速查
┌──────────────────┬────────────────────────────────────────────┐
│ Host             │ 请求的资源在哪个主机的哪个端口上(1.1 必带)
│ Connection       │ keep-alive(长连接)/ close(短连接)
│ Content-Length   │ ★ 正文长度(字节)------ 正文边界的唯一答案
│ Content-Type     │ ★ 数据类型(text/html、image/png ...)
│ User-Agent       │ 客户端操作系统和浏览器版本
│ Referer          │ 当前页面是从哪个页面跳过来的
│ Location         │ ★ 搭配 3xx,告诉客户端下一步去哪
│ Cookie           │ 存在客户端的少量信息,用于实现 session
│ Accept           │ 我能接受哪些类型(q= 表示优先级)
│ Accept-Encoding  │ 我能接受哪些压缩格式(gzip、deflate)
│ Accept-Language  │ 我偏好哪些语言(q= 表示优先级)
└──────────────────┴────────────────────────────────────────────┘
19.8 Content-Type 速查
   text/html; charset=utf-8     HTML 网页(charset 别漏,否则中文乱码)
   text/css                     CSS 样式表
   text/plain                   纯文本
   application/javascript       JavaScript
   application/json             JSON 数据
   application/xml              XML
   image/png                    PNG 图片
   image/jpeg                   JPEG 图片
   image/gif                    GIF 图片
   image/svg+xml                SVG 矢量图
   video/mp4                    MP4 视频
   audio/mpeg                   MP3 音频
   application/x-www-form-urlencoded   POST 表单(默认格式)
   application/octet-stream     ★ 兜底:不认识的都归它

   服务器怎么决定填哪个?------ 通过文件后缀名查表
19.9 长连接 vs 短连接速查
| 短连接 | 长连接 |
|------|------------------------------|--------------------------|
| 定义 | 一次请求-响应后立即 close | 一个 sockfd 上跑多次请求 |
| 报头 | Connection: close (或什么都不写) | Connection: keep-alive |
| 成本 | 每次都要三次握手 | 只握手一次 |
| 好处 | 实现简单 | 省去反复握手的开销 |
| 报文边界 | 可靠连接关闭判断 | ★ 必须靠 Content-Length |
| 适用 | 早期 HTTP/1.0 | HTTP/1.1 默认 |
补充:HTTP/1.1 默认使用长连接;HTTP/1.0 默认短连接,但可通过
Connection: keep-alive请求长连接。长连接的报文边界除了Content-Length,也常用Transfer-Encoding: chunked。
19.10 静态资源 vs 动态站点速查
| 静态资源 | 动态站点 |
|---------|--------------------|-------------------|
| 内容来源 | 磁盘上预先准备好的文件 | 程序现场计算出来的 |
| 典型类型 | html/css/js/图片/音视频 | 登录/注册/支付/查找 |
| 服务器做什么 | 找文件 → 读 → 发 | 执行代码 → 查库 → 拼 → 发 |
| 同一 URL | 永远返回相同内容 | 可能返回不同内容 |
| URI 的含义 | 一条真实的文件路径 | 一个"服务"的标识 |
★ 音视频也算静态资源 ------ 因为它们"只是文件"
19.11 GET vs POST 速查
| 对比项 | GET | POST |
|---|---|---|
| 主要用途 | 获取资源 | 提交数据 |
| ★传参位置 | URI 的查询字符串 /submit?a=1&b=2 |
正文部分(空行之后) a=1&b=2 放在 DATA 里 |
| 正文 | 通常没有 | 一定有 |
| Content-Length | 通常不需要 | ★ 必须有 |
| 安全性 | ★ 明文暴露在 URL 里 会被日志/历史记录 | 相对隐蔽,但★不等于加密 真保密要靠 HTTPS |
| 长度限制 | 受 URL 长度限制 | 基本不限 |
共同点:报文结构完全一样,差别【只是参数放哪】
19.12 报文解析速查
【读行函数的三种返回值】
   ① 读到了空    →  没有完整行    →  数据不够,退出等更多数据
   ② 读到 \r\n   →  读到空行      →  ★ 报头结束!转折点
   ③ 其它        →  成功读一行    →  第1行=请求行,中间=报头

【解析的两个阶段】
   空行之前: 按【行】解析(找 \r\n)
   空行之后: 按【长度】解析(数 Content-Length 个字节)
              ★ 千万不要在正文里找 \r\n,
                因为正文里真的可能含有 \r\n!

【判断有没有正文】
   _header.find("Content-Length") == _header.end()
        ├─ 等于 end()  →  没有正文(GET)
        └─ 不等于      →  有正文(POST)

【正文三问,一个答案】
   有没有? →  看有没有 Content-Length
   有多大? →  就是 Content-Length 的值
   从哪开始?→  空行之后的第一个字节
19.13 服务端处理流程速查
①  收到 string(假设已由定界层保证完整)
        ↓
②  逐行解析
        ├─ 读请求行  →  _method / _uri / _version
        ├─ 读报头    →  _header[key] = value
        └─ 读空行    →  _blank_line(标记"完整了")
        ↓
③  查 Content-Length
        ├─ 有  →  按长度读正文 → _text
        └─ 无  →  _text 保持空
        ↓
④  ★ 先查路由表:这个 URI 是动态服务吗?
        auto it = _services.find(_uri);
        if (it != _services.end()) {
            it->second(req, resp);        // 调服务,由它填满 resp
            return;                       // ★ 到此为止,不走静态那套
        }
        ★ 顺序很重要:先查表,没命中才当文件读
        ★ 反过来会让 404 变成"读文件失败"的副作用
        ↓
⑤  【难点一】URI → 真实路径(静态资源这条路)
        if (_uri == "/") _uri += g_first_page;   // "/" → "/index.html"
        _uri = g_wwwroot + _uri;                 // → "wwwroot/index.html"
        ★ 顺序不能颠倒!
        ★ 不加 wwwroot 会锚定到 Linux 根目录 "/"(安全问题)
        ↓
⑥  【难点二】ReadFile() 读进 _text
        open() → fstat() 拿大小 → 循环 read() → close()
        ★ read 可能读不满,要 while 循环
        ★ st_size 就是 Content-Length 的来源
        ★ 读不到就返回空 → 触发 404
        ↓
⑦  填响应
        _code / _code_desc  →  按结果决定(200 / 404 / 403 / 500)
        ★ 注意:业务失败(如密码错)仍是 200,不是 401
        _header["Content-Type"]  →  按文件后缀查表
                                   (JSON 接口用 application/json)
        _header["Content-Length"] →  正文长度
        ↓
⑧  拼成完整响应字符串,send() 回去
19.14 HTTP 与内核的衔接点速查
【HTTP 在哪里"跨界"到内核?------ 只有两处】

1. 发/收数据(第四章)
   send() / recv()  →  struct socket → struct sock → sk_buff
                    →  TCP 层 → IP 层 → 网卡驱动

2. 读文件(第八章)
   open()  →  VFS 路径解析 → dcache 查 dentry
           →  d_inode 拿到 inode(i_size = 文件大小 → Content-Length)
   read()  →  f_op->read_iter() → ext4
           →  inode 的块指针 → 数据块 → 磁盘扇区(或页缓存)

【关键结构体一览】
   struct file      一次"打开"的化身(f_pos 是每个打开私有的读写位置)
   struct dentry    文件名 + 路径结构(组成内存里的 dcache 多叉树)
   struct inode     文件本身(属性 + 数据块位置,i_size 就是文件大小)
   struct socket    套接字的外壳(用户能看见的那张脸)
   struct sock      协议栈里的实体(TCP 连接的全部状态)

【一句话】
   HTTP 只负责"要哪个文件",
   "文件怎么在磁盘上找到"是 VFS 的事。
19.15 服务注册与路由速查
【核心问题】
   URI 是一个字符串,处理函数是一段代码,
   这两者是怎么对应起来的?

【答案:一张表】
   using Service = std::function<void(HttpRequest&, HttpResponse&)>;
   std::unordered_map<std::string, Service> _services;
   //                 ↑ key: URI 路径      ↑ value: 处理函数

【注册】
   void RegisterService(const std::string &uri, Service service) {
       _services[uri] = service;      // ★ 用 [] = 是【覆盖】语义
   }

   // main() 里:
   server.RegisterService("/login",    Login);
   server.RegisterService("/register", Register);
   server.RegisterService("/api/log",  AppendLog);

【分发的顺序 ------ 顺序很重要!】
   ① 先查 _services.find(uri)
        命中  → service(req, resp);  return;
   ② 未命中 → 才走静态资源那套(拼 wwwroot,open/read,读不到 404)

   ★ 不能反过来:先当文件读会污染 404 的语义

【静态 vs 动态】
   ┌──────────────┬────────────────────┬──────────────────────┐
   │              │  静态资源                   动态服务
   ├──────────────┼────────────────────┼──────────────────────┤
   │  本质         │  磁盘上的一个文件        内存里的一段代码
   │  例子         │  html/css/js/图片      登录/注册/搜索/支付
   │  内容         │  早就做好了             每次现场算出来
   │  实现         │  路径转换 + read        查路由表 + 调函数
   └──────────────┴────────────────────┴──────────────────────┘

【Service 里能干什么】
   凡是服务器进程能做的事,服务都能做:
   open/read/write 文件   →  读写文件、写日志
   连接数据库              →  查用户、存数据
   fork + exec            →  执行外部程序(OJ、编译、脚本)
   访问网络                →  去别的服务器拉数据(反向代理、爬虫)

【状态码与业务失败】
   ★ "密码错了" 返回 200,不是 401!
     200 = 服务器成功处理了这个请求(它只是告诉了你一个坏消息)
     401 = 你连访问这个资源的资格都没有
     → 状态码描述的是【HTTP 交互本身】,不是【业务逻辑】的结果

【"名字 → 函数" 这个模式的三个实例】
   ┌──────────────┬────────────────┬──────────────────┬───────────────┐
   │              │  查表用的 key       表里存的东西         谁写这张表
   ├──────────────┼────────────────┼──────────────────┼───────────────┤
   │ file_ops     │  操作名            函数指针             具体文件系统
   │ sys_call_tbl │  系统调用号         函数指针             内核编译时
   │ serviceMap   │  URI 字符串        std::function        main() 里
   └──────────────┴────────────────┴──────────────────┴───────────────┘
   通用名字:分派(dispatch)------ 把"叫什么"和"谁来做"隔开
19.16 Cookie 与 Session 速查
【问题来源】
   HTTP 是【无状态】的 ------ 这一次请求完全不知道上一次请求发生过什么。
   但"登录一次、之后都认识我"必须跨请求记住状态。

【两条路】
   ┌──────────────────────┬──────────────────────────────────────┐
   │  Cookie(客户端保存)        Session(服务端保存)
   ├──────────────────────┼──────────────────────────────────────┤
   │ 数据存在【浏览器】里        数据存在【服务器】里
   │ 每次都随请求带上            客户端只拿一个 Session ID
   │ 容量小、可被查看篡改            (一把"钥匙")
   │ 服务端无存储压力             服务端有存储压力(内存/Redis)
   └──────────────────────┴──────────────────────────────────────┘

【一次登录的完整往返】
   ① 浏览器  POST /login  正文带上 用户名、密码
   ② 服务器  校验通过
   ③ 服务器  响应里写:  Set-Cookie: sessionid=abc123; HttpOnly
                        ↑ ★ Set-Cookie 是【服务器写、浏览器存】
   ④ 浏览器  把这个 Cookie 存进本地(按域名分目录存)
   ⑤ 之后每次请求,浏览器自动带上:
             Cookie: sessionid=abc123
             ↑ ★ Cookie 是【浏览器写、服务器读】
   ⑥ 服务器  拿 sessionid 去查自己这边的表 → 知道你是谁 ✅

【关键区分:是哪个报头】
   ┌──────────────┬──────────────────────────────────────┐
   │ Set-Cookie   │  响应报头。服务器 → 浏览器,把票据发下去
   │ Cookie       │  请求报头。浏览器 → 服务器,把票据带回来
   └──────────────┴──────────────────────────────────────┘
   ★ 记住方向就不会搞混:Set 是"设置",是发;Cookie 是"携带",是收

【Session 存哪】
   小规模:unordered_map<string, Session> 放在服务器内存里
   大规模:Redis 等外部存储 ------ 因为服务器可能有多台,
           Session 必须放在所有机器都能访问的地方

【安全性】
   ★ Cookie 存在客户端,用户能看到、能改 → 不能存敏感信息
   ★ 只存一个随机、无意义的 Session ID(学号/钥匙),
     真正的数据留在服务器
   ★ 常见防护:HttpOnly(JS 读不到)、Secure(只走 HTTPS)、
               SameSite(防 CSRF)
   ★ Cookie 被偷 ≈ 身份被冒用(盗号)
19.17 无状态与无连接速查
【无状态(stateless)】
   ★ 每个请求都是独立的,服务器不记得上一个请求
   ★ 协议本身不保存任何客户端状态
   ★ 后果:登录状态、购物车、验证码......全靠 Cookie/Session 自己补
   ★ 好处:服务器容易横向扩展(每个请求发给哪台机器都一样)

【无连接(connectionless)】
   ★ HTTP 本身不维护"连接"这个概念
   ★ 连接是【TCP】提供的,HTTP 只是【借用】它
   ★ 后果:短连接下每次请求都要重新三次握手
   ★ 解法:Connection: keep-alive(★ 需要双方都带才算数)

【两个特性放在一起看】
   ┌────────────┬──────────────────────┬──────────────────────┐
   │            │  无状态                   无连接
   ├────────────┼──────────────────────┼──────────────────────┤
   │  说的是       记不住"人"                留不住"线"
   │  缺的是       跨请求的上下文            跨请求的通道
   │  谁来补       Cookie / Session         keep-alive 报头
   │  补在哪层     HTTP 之上(业务层)       HTTP 报头 + TCP
   └────────────┴──────────────────────┴──────────────────────┘

【一句话】
   HTTP 协议本身非常"薄"------
   它只负责"一次问答",
   所有需要"跨次"的东西,都得在外面自己搭。
19.18 抓包与网卡模式速查
【为什么 HTTP 明文就危险】
   请求向下封装(TCP/IP、数据链路层)全是字符信息,没有任何保护,
   中途要经过无数路由器、运营商、代理 → 每个经手者都能读。

【网卡的两种工作模式】
   ┌────────────────────┬────────────────────────────────────────┐
   │  普通模式(默认)        数据链路层判 MAC 目的地址:
   │                         是我的 → 向上交付 ✅
   │                         不是我的 → ★ 直接丢弃
   ├────────────────────┼────────────────────────────────────────┤
   │  混杂模式               ★ 一个标志位,收到任何报文都向上交付
   │  (promiscuous)         由网卡驱动提供
   └────────────────────┴────────────────────────────────────────┘

【局域网里为什么能抓到别人的报文】
   ① 同一局域网(同一广播域)里,报文以广播方式在物理介质上传播
   ② 所以同网段每张网卡【都能收到】这些信号
   ③ 是"丢弃"这个动作(靠 MAC 地址判断)决定了谁该看到
   ④ 混杂模式 = 把这个"丢弃"动作关掉


【关键结论】
   ★ GET 和 POST 传参【都不安全】------ 网线上都是明文
   ★ GET 通过 URI 传参 → 会回显在地址栏、进浏览器历史、被日志记录
   ★ POST 正文传参 → 浏览器不显示,更"私密"
   ★ 但"更私密" ≠ "更安全"!POST 只是防【旁边的人】,
     防不了【路上的设备】
   ★ 真正的解法只有一个:加密 → HTTPS
19.19 常见坑速查
【坑一】忘了加 wwwroot 前缀
   →  URI 的 "/" 直接锚定到 Linux 根目录
   →  攻击者可以 GET /etc/passwd
   →  ★ 必须用 g_wwwroot 前缀把路径钉在 Web 根目录内

【坑二】先加 wwwroot 再判断 "/"
   →  _uri 变成 "wwwroot/",_uri == "/" 永远不成立
   →  首页永远 404
   →  ★ 顺序必须是:先补全文件名,再加前缀

【坑三】在正文里找空行来判断结束
   →  正文里真的可能含 \r\n
   →  解析会彻底跑偏
   →  ★ 正文必须按 Content-Length 数长度

【坑四】漏了 Content-Type 里的 charset
   →  Content-Type: text/html(没有 charset=utf-8)
   →  中文变乱码
   →  ★ 写成 text/html; charset=utf-8

【坑五】Content-Type 填错
   →  填成 text/plain,浏览器不渲染,显示 HTML 源码
   →  ★ 按后缀名查表,并留一个 octet-stream 兜底

【坑六】长连接下不带 Content-Length
   →  浏览器不知道响应到哪结束,一直等
   →  页面卡死
   →  ★ 长连接下 Content-Length 或 chunked 必带其一

【坑七】read 只调一次就以为读完了
   →  read 的返回值是"实际读到的字节数",可能小于请求值
   →  ★ 必须用 while 循环读到够

【坑八】用完 fd 忘了 close
   →  fd 是有限资源,泄漏完进程就废了
   →  ★ open 之后一定要 close(RAII / 异常安全也要考虑)

【坑九】登录成功后用 301 跳转
   →  浏览器永久缓存了 "/login → /home"
   →  用户再也回不到登录页
   →  ★ 临时跳转必须用 302

【坑十】URL 编码解码了两次
   →  攻击者提交 %252e%252e%252f
   →  两次解码后变成 ../ → 目录穿越
   →  ★ 只解码一次

【坑十一】GET 传密码
   →  URL 会进浏览器历史、服务器日志、代理日志
   →  ★ 敏感数据永远用 POST + HTTPS

【坑十二】以为一次 read 就能拿到一整条报文
   →  缓冲区只开了 1024 字节,报文有 1500 字节
   →  空行被截断在后面没拿到 → 判定"不完整"→ 什么都不做就返回了
   →  ★ 剩下的字节还在内核缓冲区,没人再去读 → 双方僵死
   →  ★ 必须【循环读】到一个累积缓冲区,直到找到 \r\n\r\n
   →  ★ 记住:tmp[1024] 是"桶",累积的 buffer 才是"仓库"


【坑十三】路由表和静态资源的分发顺序搞反了
   →  先当文件读,读不到才想起查路由表
   →  ★ 404 该不该返回,变成了"读文件失败"的副作用
   →  ★ 正确顺序:先 _services.find(uri),命中就调服务并 return
                  未命中才走 wwwroot 那套

【坑十四】业务失败却返回 HTTP 错误码
   →  "密码错了"返回 401/500
   →  ★ 状态码描述的是【HTTP 交互本身】的结果
   →  ★ 密码错了 = 服务器成功处理了请求 = 200
      401 的含义是"你没资格访问这个资源",是另一回事

【坑十五】把用户输入直接拼成要执行的命令
   →  /exec?cmd=rm -rf /  就能把服务器删了
   →  ★ 这就是命令注入,和目录穿越、SQL 注入是同一类错误
   →  ★ 本质:把"用户可控的输入"当成了"要执行的指令"
   →  ★ 永远别让用户决定执行什么;要用 execve 的数组形式传参,
      不要拼字符串交给 shell
19.20 调试命令速查
# ① 用 curl 看完整的请求和响应(-v 显示报头)
curl -v http://www.example.com/index.html
#   > 开头是发出的请求,< 开头是收到的响应

# ② 只看响应报头(-I 发 HEAD 请求)
curl -I http://www.example.com/index.html
#   能看到状态行和所有响应报头

# ③ 跟随重定向,并显示跳转过程
curl -L -v http://www.example.com/
#   -L 自动跟随 Location,能清楚看到 301/302 的作用

# ④ 手动发一个请求(最直观的方式)
telnet www.example.com 80
#   连上后手敲(注意:回车要按两次,第二次代表那个空行):
#     GET /index.html HTTP/1.1
#     Host: www.example.com
#     (空行,再按一次回车)
#   ★ 这是理解"HTTP 就是一个字符串"最好的方式

# ⑤ 发一个带正文的 POST
curl -v -X POST http://www.example.com/submit \
     -d "firstname=maisui&lastname=abc"
#   -d 会自动设置 Content-Type 和 Content-Length

# ⑥ 只看响应正文
curl -s http://www.example.com/index.html

# ⑦ 查看域名解析结果
nslookup www.example.com
dig www.example.com
#   验证第三章的 DNS 过程

# ⑧ 查看自己机器的 DNS 配置
cat /etc/resolv.conf
#   这就是"浏览器内置的域名解析服务器地址"的来源

# ⑨ 查看本机监听的 HTTP 端口
netstat -nltp | grep -E ':(80|8080|443)'
ss -nltp | grep -E ':(80|8080|443)'
#   -n 数字显示  -l 只显示监听  -t 只看 TCP  -p 显示进程
19.21 一句话回顾
第二章  URL  = 协议 + 服务器地址 + 端口 + 路径 + 参数 + 片段
第三章  域名是给人记的,DNS 把域名翻译成 IP
第四章  HTTP 站在 TCP 上,一个 sockfd 可以跑一次或很多次问答
第五章  HTTP 报文就是"以行为单位的大字符串",四段结构
第六章  没有空行 = 报文不完整 = 什么都不做
第七章  HttpRequest = 把字节流变成结构化数据的容器
第八章  URI 要加 wwwroot 前缀,否则会锚定到 Linux 根目录
第九章  不论成败必须有应答,状态行 = 版本 + 状态码 + 描述
第十章  Build() 两大难点:URI 转真实路径、读文件进 _text
第十一章 4xx 是你的错,5xx 是我的错;301 永久,302 临时
第十二章 字节不会自解释,靠 Content-Type 告诉浏览器这是什么
第十三章 GET 参数挂 URI,POST 参数装正文,差别只在位置
第十四章 HTTPS = HTTP + TLS,保护的是"你说了什么"
第十五章 三条主线:文本约定、分层解耦、字段必有理由
第十六章 无状态记不住"人",无连接留不住"线",都要在外面补
第十七章 Cookie 存客户端、Session 存服务端,只给客户一把钥匙
第十八章 静态 URI 查磁盘,动态 URI 查路由表 ------ 同一套分派思想
附:三篇总览
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
上篇 从地址栏到一条报文(序章 + 第一 ~ 七章)
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━

  你在地址栏敲下 http://115.190.145.241:8080/index.html

  第二章  拆开 URL:协议 + 服务器地址 + 端口 + 路径 + 参数 + 片段
  第三章  域名是给人记的,DNS 把它翻译成 IP;路径里的空格要编码
  第四章  HTTP 站在 TCP 上,一个 sockfd 可以跑一次或很多次问答
  第五章  报文 = "以行为单位的大字符串",四段结构,\r\n 分隔
  第六章  没有空行 = 报文不完整 = 什么都不做
  第七章  HttpRequest = 把字节流变成结构化数据的容器

  ★ 上篇产出:一个填好的 HttpRequest

━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
中篇 从 URI 到一条响应(第八 ~ 十四章)
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━

  HttpRequest._uri

  第八章  URI 补 wwwroot 前缀 → open/read → VFS → dentry → inode
          ★ i_size 就是 Content-Length
  第九章  不管成败必须有应答,状态行 = 版本 + 状态码 + 描述
  第十章  Build() 两大难点:target_file 的获取、把文件读进 _text
  第十一  4xx 是你的错,5xx 是我的错;301 永久,302 临时
  第十二  字节不会自解释,靠 Content-Type 告诉浏览器这是什么
  第十三  GET 参数挂 URI,POST 参数装正文,差别只在位置
  第十四  HTTPS = HTTP + TLS,加密的是【整个报文】

  ★ 中篇产出:一个"能跑"的 HTTP 服务器

━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
下篇 从一次问答到一整个系统(第十五 ~ 十九章)
━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━

  第十五  全景回放:把所有环节接回一条线
  第十六  无状态记不住"人",无连接留不住"线",都要在外面补
  第十七  Cookie 存客户端、Session 存服务端,只给客户一把钥匙
  第十八  静态 URI 查磁盘,动态 URI 查路由表 ------ 同一套分派思想
          ★ file_operations / sys_call_table / serviceMap 是同一个模式
  第十九  速查表:21 节,随手查阅

  ★ 下篇产出:一个"能用"的 HTTP 服务器

━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━━
三条贯穿全文的主线
   ① 文本约定
      HTTP 从头到尾都是纯文本、以行为单位。
      这是它 1990 年代能成功的原因(人能用 telnet 手敲),
      也是它今天必须演进的包袱(每一行都要扫描 \r\n)。

   ② 分层解耦
      每一层只解决一个问题,解决完就交给下一层。
      HTTP 不管连接,TCP 不管内容;
      路由表管"谁来处理",Service 管"怎么处理"。
      下面这句在全文里出现了很多次,它是同一个道理:
      ★ 让变化的部分待在代码外面。

   ③ 字段必有理由
      Host 是因为一台服务器可能托管多个站;
      Content-Length 是因为正文里可能有 \r\n;
      Content-Type 是因为字节不会自解释;
      Connection 是因为连接是双方共用的资源。
      ★ 没有一个字段是"设计者觉得这样好看"。
最后,如果你只记住一句话
发送数据到目标网络,从来都不是目的,而是一种手段。 真正的目的是:两个应用进程在通信。
文章到这里就结束了:相信大家看到这里一定是收获颇丰,我们下一个专题见~