一句话怎样变成一串数字
计算机很容易比较数字,却不能直接理解"如何启动服务"和"服务的启动步骤"表达了相近含义。Embedding 模型解决的正是这个问题:它把文本、图片或音频映射成一组稠密向量,让语义关系能够通过数学距离来比较。
text
"如何启动服务"
        ↓ Embedding 模型
[0.12, -0.31, 0.08, 0.44, ...]
语义相近的内容在向量空间中通常更靠近,语义无关的内容则更远。RAG 因此可以把用户问题与所有知识片段放到同一个空间中,寻找最近的若干片段。
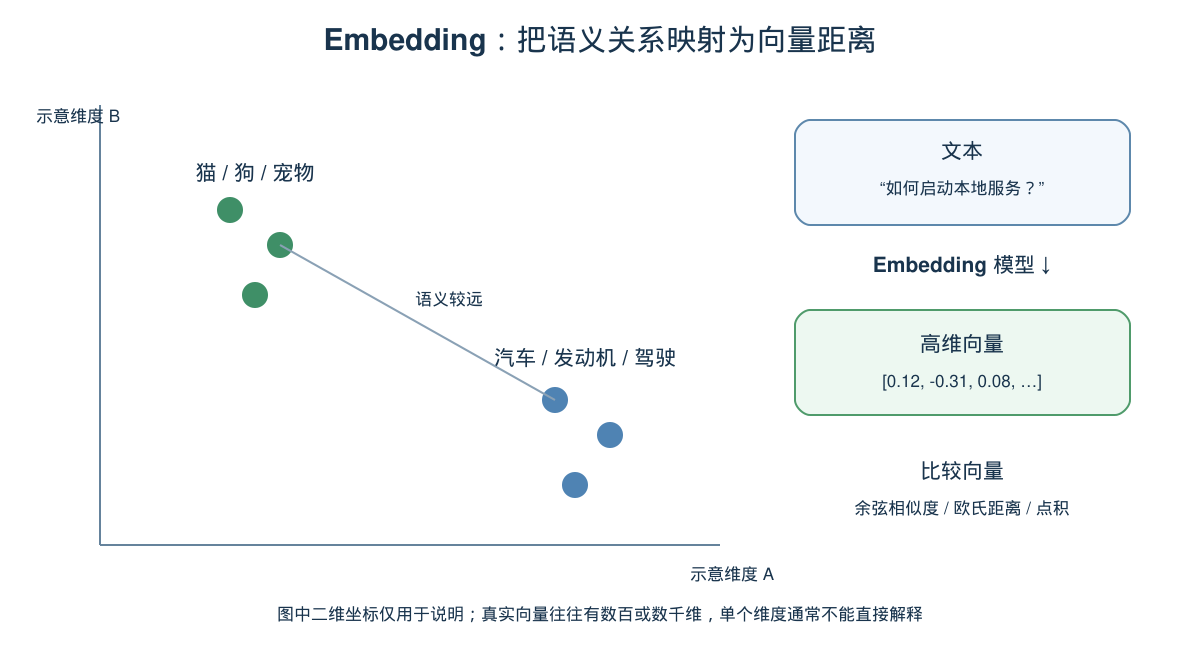
图中的两个维度只用于直观说明。真实 Embedding 往往有数百或数千维,单个维度通常不能被直接解释成"动物程度"或"技术程度"。模型学习的是大量维度共同构成的关系。
稠密向量与独热编码有什么不同
传统独热编码会为词表中的每个词分配一个位置:
text
猫 = [1, 0, 0, 0]
狗 = [0, 1, 0, 0]
车 = [0, 0, 1, 0]
在这种表示下,猫与狗和猫与车的距离没有体现语义差别。Embedding 则把信息分散在多个连续数值中,使猫和狗更可能接近,汽车落在另一个区域。这种表示称为稠密向量。
早期的 Word2Vec 主要学习词级关系,现代 Embedding 模型可以直接编码句子、段落甚至文档。有些多模态模型还会把文字与图片对齐到同一个空间,但这必须是模型训练时明确具备的能力,不能假设任意文本模型都能处理图片。
三种常见的相似度计算
余弦相似度
余弦相似度比较两个向量方向是否接近:
text
cos(a, b) = (a · b) / (||a|| × ||b||)它对向量长度不敏感,在文本语义检索中非常常见。值越大,通常表示方向越接近。
欧氏距离
欧氏距离计算空间中的直线距离。值越小,两个向量越接近。它同时受到方向和向量长度影响。
点积
点积同时反映方向和模长。若向量已做 L2 归一化,点积与余弦相似度会得到相同的排序;未归一化时,两者不能混为一谈。
下面用 NumPy 直观看三种结果:
python
import numpy as np

a = np.array([0.2, 0.8, 0.1])
b = np.array([0.3, 0.7, 0.2])

cosine = np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))
euclidean = np.linalg.norm(a - b)
dot_product = np.dot(a, b)

print("cosine:", cosine)       # 越大越相似
print("euclidean:", euclidean) # 越小越相似
print("dot:", dot_product)     # 解释取决于模型与归一化方式
选择哪种距离不能只凭习惯。Embedding 模型通常会在文档中说明推荐的相似度与是否需要归一化,向量数据库的索引配置必须与之保持一致。
查询与文档必须使用同一套表示
建立知识库时,文档片段由一个 Embedding 模型生成向量;查询时也必须使用兼容的模型和相同预处理方式。
python
# 建库
doc_vectors = embed_model.encode(chunks, normalize=True)
vector_db.upsert(chunks, doc_vectors)

# 查询
query_vector = embed_model.encode([question], normalize=True)[0]
hits = vector_db.search(query_vector, top_k=5)
如果建库后更换模型,新旧向量并不处在同一个语义空间,必须重新生成全部文档向量。即使模型名称相同,若升级版本改变了维度或表示方式,也要先验证兼容性。
有些模型区分"查询"和"文档"的输入前缀,例如要求加上 query:、passage:,或使用不同的编码方法。这不是多余格式,而是训练方式的一部分,遗漏后可能明显降低召回效果。
如何选择 Embedding 模型
排行榜可以作为参考,却不能代替业务测试。选型时至少要看以下方面。
语言和领域
中文、跨语言、代码和专业术语对模型的要求不同。一个通用英文模型即使在综合榜单上成绩很好,也未必适合中文企业文档。
输入长度
模型能接收多长文本,会限制 Chunk 上限。超过限制时,有的 SDK 报错,有的会截断;静默截断最危险,因为向量可能根本没有编码后半段答案。
向量维度与成本
更高维度会增加存储、网络传输和索引内存,但不自动意味着检索更准。云端模型还要评估调用价格与数据合规,本地模型则要考虑显存、吞吐和部署维护。
真实检索表现
准备一组"问题---正确片段"对,然后计算 Recall@K、MRR 或 nDCG。至少要与关键词检索基线比较,因为产品编号、错误码和人名等精确词,往往是关键词方法更擅长。
本地调用示例
许多本地模型服务会提供 OpenAI 兼容的 Embedding 接口。假设服务运行在 localhost:1234,可以这样请求:
bash
curl http://localhost:1234/v1/embeddings \
  -H "Content-Type: application/json" \
  -d '{
    "model": "your-embedding-model",
    "input": ["技术课程", "怎样构建本地知识库"]
  }'
返回结果通常包含每条输入对应的向量:
json
{
  "data": [
    {"index": 0, "embedding": [0.012, -0.083, 0.041]},
    {"index": 1, "embedding": [-0.022, 0.017, 0.096]}
  ]
}
示例省略了大部分维度。生产环境还要设置批量大小、超时、重试与缓存,并记录模型名称和版本,保证索引可以重建。
可视化能告诉我们什么
TensorFlow Embedding Projector 可以用 PCA、t-SNE 或 UMAP 等方法把高维向量投影到二维或三维,用于观察聚类和异常点。
但投影会损失信息。二维图上看似靠近的点,在原始高维空间中不一定同样接近。因此,可视化适合发现线索,不适合代替检索指标。
常见误区
第一个误区是把相似度当成事实正确性。向量只能告诉我们两段文字"像不像",不能证明内容真实或最新。
第二个误区是只使用向量检索。对错误码、订单号、专有名词等查询,关键词检索往往更可靠。把稠密向量与 BM25 等关键词方法结合,再做重排,通常更稳健。
第三个误区是只看模型,不检查数据。若原文解析顺序错误或 Chunk 缺少标题,再强的 Embedding 也无法恢复已经丢失的语义。
小结
Embedding 是 RAG 中连接自然语言与数学检索的桥梁。它把查询和知识片段映射到同一向量空间,再通过余弦、欧氏距离或点积寻找相近内容。