摘要
后端接口的很多问题,最终都会落到数据库上:查询为什么变慢,更新为什么互相等待,订单为什么被重复扣减,事务为什么没有回滚,明明建立了索引却仍然全表扫描。
事务、索引和锁是 MySQL 开发中最基础、也最容易被误解的三个主题。事务决定一组操作能否保持一致,索引决定数据库如何快速找到数据,锁决定多个并发请求如何安全地访问同一份数据。它们并不是互相独立的功能,而是共同影响接口的正确性、性能和稳定性。
本文以 InnoDB 为主要背景,从事务的 ACID 特性和隔离级别开始,介绍 MVCC、B+Tree 索引、聚簇索引、二级索引、行锁、间隙锁和死锁,并结合订单扣减库存的场景给出 SQL 和 Spring Boot 示例。读完本文后,你应该能够:
- 理解事务、索引和锁分别解决什么问题;
- 区分不同事务隔离级别下的并发现象;
- 看懂常见索引结构和 EXPLAIN 结果;
- 编写更安全的扣库存、状态更新和分页查询;
- 定位慢查询、锁等待和死锁的基本方向。
一、背景与问题
1. 数据库不是一个简单的 Map
在内存代码中,根据 ID 读取数据很容易:
java
User user = users.get(userId);但数据库需要同时面对:
- 数据量很大;
- 多个请求并发读写;
- 数据需要长期保存;
- 进程可能突然崩溃;
- 多个表之间需要保持一致;
- 查询条件并不总是主键;
- 一个操作可能包含多条 SQL。
因此,数据库必须解决两个核心问题:
text
如何快速找到目标数据?
  -> 索引

多个请求同时访问数据时如何保持正确?
  -> 事务、MVCC 和锁
2. 一个扣库存操作包含多个步骤
以创建订单并扣减库存为例:
text
检查商品是否存在
  -> 检查库存是否充足
  -> 扣减库存
  -> 创建订单
  -> 创建订单明细
  -> 提交事务
如果这些操作不在同一个事务中,可能出现:
- 库存扣减成功,但订单创建失败;
- 两个请求同时读到相同库存,导致超卖;
- 订单创建成功,但库存没有扣减;
- 服务中途崩溃,数据库处于半完成状态。
如果查询没有索引,又可能导致大量记录被扫描和锁定,让其他请求长时间等待。
3. 事务、索引和锁是相互影响的
这三个概念可以这样理解:
| 概念 | 主要解决的问题 |
|---|---|
| 事务 | 一组操作要么全部成功,要么全部失败 |
| 索引 | 更快地定位符合条件的数据 |
| 锁 | 控制并发读写,避免数据竞争 |
| MVCC | 在保证一致性的同时减少读写阻塞 |
索引不仅影响查询速度,还会影响更新时需要检查和锁定的记录范围。事务不仅影响数据提交,还会影响锁的持有时间。锁等待变长,又会反过来让接口变慢。
二、核心概念
1. 事务与 ACID
事务通常具有 ACID 四个特性:
| 特性 | 含义 |
|---|---|
| Atomicity 原子性 | 事务中的操作要么全部成功,要么全部回滚 |
| Consistency 一致性 | 事务前后数据满足业务和数据库约束 |
| Isolation 隔离性 | 并发事务之间按照规则隔离 |
| Durability 持久性 | 提交后的数据在故障恢复后仍然存在 |
需要注意,一致性不只是数据库自动提供的约束。唯一索引、外键和数据类型可以帮助维护一致性,但库存不能为负、订单状态不能逆向变化等业务规则,还需要应用代码和事务共同保证。
2. 事务的基本生命周期
事务的生命周期可以表示为:
text
开始事务
  -> 执行 SQL
  -> 读取或修改数据
  -> 检查业务条件
  -> COMMIT 或 ROLLBACK
如果没有显式事务,很多数据库连接默认使用自动提交。自动提交模式下,每条 SQL 可能都是一个独立事务,无法保证多条 SQL 的整体原子性。
3. 隔离级别
SQL 标准定义了多个隔离级别,MySQL InnoDB 常见配置如下:
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 并发能力 |
|---|---|---|---|---|
| READ UNCOMMITTED | 可能 | 可能 | 可能 | 较高 |
| READ COMMITTED | 避免 | 可能 | 可能 | 较高 |
| REPEATABLE READ | 避免 | 避免 | 通过 MVCC 和锁机制处理 | 中等 |
| SERIALIZABLE | 避免 | 避免 | 避免 | 较低 |
三种常见并发问题:
- 脏读:读到了其他事务尚未提交的数据;
- 不可重复读:同一个事务内,两次读取同一行得到不同结果;
- 幻读:同一个事务内,两次按范围查询,第二次出现了新增或消失的记录。
隔离级别不是越高越好。隔离越强,通常意味着更多等待和更低并发。应用应根据业务一致性要求选择,而不是机械地设置最高级别。
4. MVCC:多版本并发控制
MVCC 的目标是让普通读取尽量不阻塞写入,也让读取能够看到符合当前事务规则的数据版本。
可以简单理解为:
text
一行数据被修改
  -> 数据库保留旧版本信息
  -> 事务根据自己的读取视图选择可见版本
  -> 普通快照读不必直接等待写锁
MVCC 依赖事务 ID、隐藏字段和 undo log 等内部机制。应用开发者不需要手动管理这些细节,但要理解:
- 普通 SELECT 通常是快照读;
- SELECT ... FOR UPDATE 属于当前读;
- 当前读会读取最新版本,并可能加锁;
- 长事务会让旧版本无法及时清理,增加存储和维护压力。
5. 快照读和当前读
两类读取的行为不同:
sql
-- 通常属于快照读
SELECT stock FROM product WHERE id = 10;

-- 当前读,通常用于读取并锁定最新记录
SELECT stock FROM product WHERE id = 10 FOR UPDATE;
库存扣减、状态检查后更新等场景,常常需要当前读,避免基于过期快照做出修改。
6. 索引是什么
索引是数据库为了快速定位数据而维护的额外数据结构。没有索引时,数据库可能需要逐行检查:
text
第 1 行是否满足条件?
第 2 行是否满足条件?
第 3 行是否满足条件?
...
有合适索引时,可以先在索引结构中缩小范围,再访问目标数据。
索引会带来额外成本:
- 占用磁盘空间;
- 插入、更新和删除时需要维护;
- 索引过多会增加写入开销;
- 不合适的索引可能无法被使用。
所以索引不是越多越好,而是要围绕真实查询建立。
7. 为什么常见索引使用 B+Tree
B+Tree 适合数据库索引,主要因为:
- 树的高度较低;
- 节点可以存放较多键值;
- 适合磁盘和页式存储;
- 叶子节点按顺序连接;
- 适合等值查询和范围查询。
典型结构可以表示为:
text
根节点
  -> 中间节点
      -> 叶子节点 1 <-> 叶子节点 2 <-> 叶子节点 3
                                |
                                -> 指向数据记录或主键
等值查询可以快速定位,范围查询可以沿着叶子节点顺序扫描。
8. 聚簇索引和二级索引
在 InnoDB 中,主键索引通常是聚簇索引,叶子节点保存整行数据。普通索引通常是二级索引,叶子节点保存索引列和主键值。
text
主键索引
  key -> 完整行数据

二级索引
  secondary key -> 主键值 -> 完整行数据
通过二级索引找到主键后,再回到聚簇索引查完整行,通常称为回表。
如果查询需要的列都在二级索引中,就可能直接从索引中返回结果,这种情况称为覆盖索引,可以减少回表。
9. 联合索引和最左匹配
假设建立联合索引:
sql
CREATE INDEX idx_user_status_created
ON orders (user_id, status, created_at);
索引排序近似于:
text
先按 user_id 排序
  -> user_id 相同,再按 status 排序
      -> user_id 和 status 都相同,再按 created_at 排序
因此以下查询通常更容易利用索引:
sql
WHERE user_id = 100
WHERE user_id = 100 AND status = 'PAID'
WHERE user_id = 100 AND status = 'PAID'
  AND created_at >= '2026-01-01'
而只根据 status 查询,通常无法充分利用这个索引:
sql
WHERE status = 'PAID'这就是联合索引常说的最左匹配原则。实际是否使用索引,还要结合数据分布、选择性、统计信息和优化器成本判断。
10. 锁的基本类型
从应用视角,可以先理解以下几类锁:
| 锁 | 含义 |
|---|---|
| 共享锁 | 多个事务可以读,但会限制某些写操作 |
| 排他锁 | 持有事务可以修改,其他事务可能需要等待 |
| 行锁 | 锁定满足条件的记录或索引记录 |
| 间隙锁 | 锁定索引记录之间的范围 |
| 临键锁 | 记录锁和间隙锁的组合 |
| 意向锁 | 表达事务将要在表中加行锁的意图 |
实际锁的表现与索引、隔离级别、语句类型和执行计划有关。不能只根据 SQL 的表面写法判断锁住了几行。
11. 记录锁、间隙锁和临键锁
假设索引中存在值 10、20、30:
text
(-∞, 10)
[10]
(10, 20)
[20]
(20, 30)
[30]
(30, +∞)
范围查询或当前读可能锁定记录,也可能锁定记录之间的间隙:
- 记录锁:锁住已有的某条索引记录;
- 间隙锁:锁住两个索引值之间的范围,阻止插入;
- 临键锁:记录锁加上记录前的间隙锁。
在 REPEATABLE READ 下,范围条件的加锁行为尤其需要注意。没有合适索引时,锁的范围可能远大于开发者预期。
三、工作原理
1. 事务执行流程
一次事务大致经历:
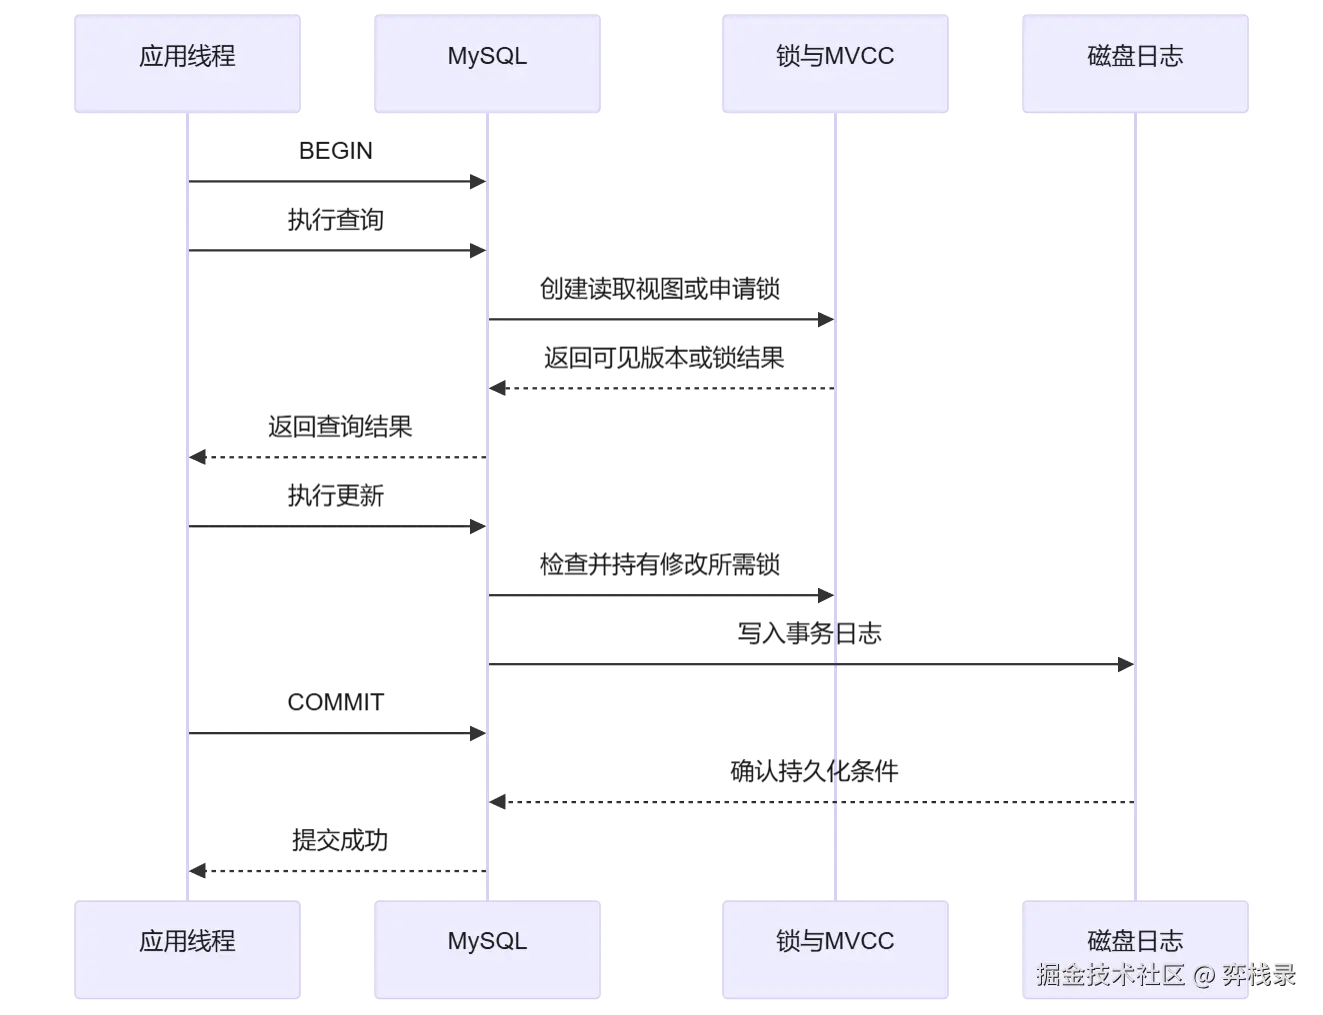
事务提交不仅是"把内存中的值写入磁盘"。数据库还要协调 undo、redo、锁和日志等机制,保证崩溃恢复后数据状态可解释。
2. 事务隔离下的可见性
一个事务执行普通 SELECT 时,数据库需要判断每条记录版本对它是否可见:
text
当前记录版本
  -> 版本是否由当前事务产生?
  -> 产生该版本的事务是否已经提交?
  -> 读取视图是否允许看到该版本?
  -> 如果不可见,沿 undo 信息查找旧版本
这也是为什么长事务会带来额外问题:只要仍有事务可能需要旧版本,相关 undo 信息就不能及时清理。
3. 当前读为什么需要锁
库存扣减不能简单写成:
text
先 SELECT 读取库存
再在应用内判断
再 UPDATE 扣减
两个事务可能同时读到库存为 1:
text
事务 A:读到 1
事务 B:读到 1
事务 A:扣减为 0
事务 B:也扣减为 0
更安全的方式之一是使用带条件的原子更新:
sql
UPDATE product
SET stock = stock - 1
WHERE id = 10
  AND stock > 0;
然后检查 affected rows:
- affected rows = 1:扣减成功;
- affected rows = 0:商品不存在或库存不足。
这种方式把条件判断和扣减放在同一条 SQL 中,减少应用层竞态。
另一种方式是先使用当前读锁定行:
sql
START TRANSACTION;

SELECT stock
FROM product
WHERE id = 10
FOR UPDATE;

UPDATE product
SET stock = stock - 1
WHERE id = 10;

COMMIT;
4. 索引如何影响扫描范围
假设有以下查询:
sql
UPDATE orders
SET status = 'CANCELLED'
WHERE user_id = 100
  AND status = 'PENDING';
如果有联合索引:
sql
CREATE INDEX idx_orders_user_status
ON orders (user_id, status);
数据库可以更快地定位目标范围。没有合适索引时,可能需要扫描大量记录,更新过程中也可能产生更广的锁影响。
因此,"加锁的是一行还是很多行"不能只看 WHERE 条件,还要看:
- 使用了哪个索引;
- 扫描了多少索引记录;
- 是否发生回表;
- 是否是唯一等值查询;
- 是否是范围查询;
- 隔离级别是什么;
- 执行计划是否发生变化。
5. EXPLAIN 如何帮助判断索引
可以使用 EXPLAIN 查看查询计划:
sql
EXPLAIN
SELECT id, status, created_at
FROM orders
WHERE user_id = 100
  AND status = 'PAID'
ORDER BY created_at DESC
LIMIT 20;
常见字段:
| 字段 | 关注点 |
|---|---|
| type | 访问类型,通常比全表扫描更好的有 ref、range 等 |
| possible_keys | 优化器认为可能使用的索引 |
| key | 实际使用的索引 |
| key_len | 使用了联合索引的多长前缀 |
| rows | 估算扫描行数 |
| filtered | 过滤比例估算 |
| Extra | 是否需要排序、临时表或回表等 |
不要只看到 key 不为空就认为查询一定高效。还要结合 rows、Extra、返回数据量和真实执行耗时判断。
6. 锁等待的形成过程
锁等待通常是:
text
事务 A 修改记录并未提交
  -> 事务 B 修改同一记录
  -> B 申请锁失败,进入等待
  -> A 提交或回滚
  -> B 获得锁并继续
如果 A 在持锁期间调用远程服务、等待用户输入或执行复杂计算,B 就可能等待很久。因此事务中应尽量只包含必要的数据库操作,不要把不可控的外部调用放在事务内部。
7. 死锁是如何产生的
两个事务以不同顺序获取锁时,可能形成循环等待:
text
事务 A:先锁住订单 1,再等待订单 2
事务 B:先锁住订单 2,再等待订单 1
数据库发现循环等待后,通常会主动回滚其中一个事务,让另一个事务继续。应用必须捕获死锁异常,并根据业务设计进行有限次数重试。
四、实战示例
下面以商品、订单和订单明细为例,展示索引设计、事务扣库存和 Spring 事务使用方式。
1. 创建表结构
商品表:
sql
CREATE TABLE product (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    name VARCHAR(100) NOT NULL,
    stock INT NOT NULL,
    version INT NOT NULL DEFAULT 0,
    updated_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP
        ON UPDATE CURRENT_TIMESTAMP,
    CONSTRAINT ck_product_stock CHECK (stock >= 0)
) ENGINE = InnoDB;
订单表:
sql
CREATE TABLE orders (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    user_id BIGINT NOT NULL,
    status VARCHAR(20) NOT NULL,
    total_amount DECIMAL(12, 2) NOT NULL,
    created_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
    updated_at DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP
        ON UPDATE CURRENT_TIMESTAMP,
    KEY idx_orders_user_created (user_id, created_at),
    KEY idx_orders_user_status_created (
        user_id,
        status,
        created_at
    )
) ENGINE = InnoDB;
订单明细表:
sql
CREATE TABLE order_item (
    id BIGINT PRIMARY KEY AUTO_INCREMENT,
    order_id BIGINT NOT NULL,
    product_id BIGINT NOT NULL,
    quantity INT NOT NULL,
    unit_price DECIMAL(12, 2) NOT NULL,
    KEY idx_order_item_order (order_id),
    KEY idx_order_item_product (product_id)
) ENGINE = InnoDB;
索引设计应该围绕查询和更新模式,而不是给每个字段都建一个单列索引。user_id、status 和 created_at 是否组成联合索引,要根据真实 SQL 和数据分布验证。
2. 使用原子更新扣库存
最简单的扣库存 SQL:
sql
UPDATE product
SET stock = stock - 1
WHERE id = 10
  AND stock > 0;
在 Java 中使用 JDBC 或 MyBatis 时,应检查更新行数:
java
int affectedRows = productMapper.decreaseStock(productId);

if (affectedRows != 1) {
    throw new InsufficientStockException(productId);
}
如果业务要求一次购买多个数量:
sql
UPDATE product
SET stock = stock - #{quantity}
WHERE id = #{productId}
  AND stock >= #{quantity};
这种写法把"库存足够"和"扣减库存"合并为一个原子操作。即使并发请求同时执行,也不会因为先读后写而重复扣减。
3. 使用事务创建订单
Service 层可以组织订单和库存操作:
java
@Service
public class OrderService {

    private final ProductMapper productMapper;
    private final OrderMapper orderMapper;
    private final OrderItemMapper orderItemMapper;

    public OrderService(
            ProductMapper productMapper,
            OrderMapper orderMapper,
            OrderItemMapper orderItemMapper) {
        this.productMapper = productMapper;
        this.orderMapper = orderMapper;
        this.orderItemMapper = orderItemMapper;
    }

    @Transactional
    public Long createOrder(CreateOrderCommand command) {
        int affectedRows = productMapper.decreaseStock(
                command.productId(),
                command.quantity()
        );

        if (affectedRows != 1) {
            throw new InsufficientStockException(
                    command.productId()
            );
        }

        Order order = orderMapper.insert(
                command.userId(),
                command.totalAmount()
        );

        orderItemMapper.insert(
                order.id(),
                command.productId(),
                command.quantity(),
                command.unitPrice()
        );

        return order.id();
    }
}
关键点:
- 事务边界放在业务服务层;
- 扣库存失败时抛出异常;
- 异常必须能够触发事务回滚;
- 不要在事务中调用耗时且不可控的远程服务;
- 订单、库存和明细的数据库操作应根据一致性要求决定是否放在同一事务中。
4. Spring 事务常见配置
使用 Spring Boot 时,通常引入事务相关依赖并在 Service 方法上使用 @Transactional。事务是否生效,还取决于调用方式。
下面这种外部调用通常可以经过 Spring 代理:
java
orderService.createOrder(command);下面这种同类内部调用可能绕过代理:
java
this.createOrder(command);如果事务注解放在 createOrder 方法上,但调用者在同一个 Bean 内直接调用它,可能无法触发预期的代理事务。可以将事务方法拆到独立 Service,或者调整调用结构。
5. 事务回滚条件
默认情况下,Spring 通常会对未检查异常触发回滚,但团队不应完全依赖默认规则。要明确:
- 哪些异常代表业务失败;
- 哪些异常需要回滚;
- 哪些异常可以被转换后继续;
- 是否存在捕获异常后没有重新抛出的情况;
- 数据库异常是否被包装成其他异常。
例如:
java
@Transactional(rollbackFor = Exception.class)
public void process() throws Exception {
    // 数据库操作
}
具体是否使用 rollbackFor,以及异常层次如何设计,应遵循项目统一规范。
6. 乐观锁更新
对于库存、余额或状态等高并发数据,也可以使用版本号实现乐观锁:
sql
UPDATE product
SET stock = stock - 1,
    version = version + 1
WHERE id = 10
  AND version = 3
  AND stock > 0;
如果 affected rows = 1,说明版本匹配并更新成功;如果为 0,说明数据已经被其他事务修改,应用可以重新读取并重试,或者直接提示失败。
乐观锁适合冲突相对较少、希望减少长时间持锁的场景。冲突频繁时,重试本身也会带来额外压力。
7. 查询用户订单列表
假设接口是:
sql
SELECT id, status, total_amount, created_at
FROM orders
WHERE user_id = 100
ORDER BY created_at DESC, id DESC
LIMIT 20;
可以建立:
sql
CREATE INDEX idx_orders_user_created_id
ON orders (user_id, created_at, id);
使用 created_at 和 id 作为稳定排序条件,可以避免同一时间创建的订单排序不稳定。
数据量较大时,优先考虑基于游标的分页:
sql
SELECT id, status, total_amount, created_at
FROM orders
WHERE user_id = 100
  AND (
        created_at < '2026-09-01 10:00:00'
        OR (
            created_at = '2026-09-01 10:00:00'
            AND id < 5000
        )
      )
ORDER BY created_at DESC, id DESC
LIMIT 20;
相比跳过大量记录的深分页,游标分页通常更稳定。
8. 使用 EXPLAIN 验证查询
不要在加索引后直接认为问题已经解决。应实际执行:
sql
EXPLAIN
SELECT id, status, total_amount, created_at
FROM orders
WHERE user_id = 100
ORDER BY created_at DESC, id DESC
LIMIT 20;
然后结合慢查询日志、实际耗时和数据规模验证。优化器可能因为选择性、统计信息或成本估算,选择与你预期不同的索引。
五、常见问题与实践建议
1. 明明建立了索引,为什么还是慢
常见原因:
- 查询条件没有使用索引的最左部分;
- 对索引列进行了函数或表达式计算;
- 隐式类型转换导致索引使用受影响;
- 条件选择性太低;
- 返回列很多且需要大量回表;
- 模糊查询以通配符开头;
- 优化器判断全表扫描成本更低;
- 数据量增长后原有索引不再适合。
排查时要看 EXPLAIN 的实际 key、rows 和 Extra,而不是只看表结构中是否存在索引。
2. 联合索引顺序应该怎么设计
通常考虑:
- 等值条件列;
- 过滤性高的列;
- 范围条件列;
- 排序和分组需求;
- 是否可以覆盖查询;
- 真实 SQL 的使用频率。
不存在适用于所有场景的固定口诀。最可靠的方法是收集真实查询,设计候选索引,用执行计划和压测验证。
3. 使用函数会导致索引失效吗
例如:
sql
WHERE DATE(created_at) = '2026-09-01'可能无法充分利用 created_at 的普通索引。可以改写为范围条件:
sql
WHERE created_at >= '2026-09-01 00:00:00'
  AND created_at < '2026-09-02 00:00:00'
对字符串、数字和日期字段,都应尽量避免在过滤列上做无法利用索引的计算。
4. 为什么不建议长事务
事务持续时间过长可能导致:
- 锁长时间不释放;
- 其他请求排队;
- undo 版本积累;
- 数据库连接长期被占用;
- 死锁概率增加;
- 接口超时后事务仍未结束。
不要在事务中:
- 调用第三方支付或物流接口;
- 等待消息或用户操作;
- 执行大批量无分页处理;
- 进行复杂的文件读写;
- 进行不必要的远程查询。
如果业务需要跨系统一致性,应考虑本地消息表、可靠事件、补偿任务或最终一致性方案,而不是把所有事情强行放进一个数据库事务。
5. 捕获异常后为什么没有回滚
下面的代码可能导致事务提交:
java
@Transactional
public void process() {
    try {
        mapper.updateSomething();
        callRiskyOperation();
    } catch (Exception exception) {
        log.error("处理失败", exception);
    }
}
异常被捕获后没有继续抛出,事务代理可能认为方法正常结束。更合理的做法是:
- 记录日志后重新抛出业务异常;
- 明确使用回滚规则;
- 将失败状态作为业务结果保存;
- 不要用返回 false 替代所有异常。
6. 为什么会出现死锁
常见原因:
- 多个事务以不同顺序更新多行记录;
- 索引不合适导致锁范围扩大;
- 事务操作时间过长;
- 批量更新顺序不稳定;
- 外键检查涉及相关记录;
- 高并发下多个业务流程交叉加锁。
减少死锁的方法:
- 统一访问多个资源的顺序;
- 尽快完成事务;
- 给更新条件建立合适索引;
- 拆分过大的批量事务;
- 对死锁异常做有限重试;
- 记录死锁日志并分析具体 SQL。
重试只能缓解结果,不能替代死锁原因治理。
7. SELECT 会不会加锁
普通快照读通常不会像 SELECT ... FOR UPDATE 一样直接加排他锁,但具体行为需要结合语句类型、隔离级别、索引和执行计划判断。
以下语句明确表达了锁定意图:
sql
SELECT ...
FROM product
WHERE id = 10
FOR UPDATE;
sql
SELECT ...
FROM product
WHERE id = 10
LOCK IN SHARE MODE;
锁的语义应服务于业务目标。不要为了"安全"给所有查询都加 FOR UPDATE,否则会明显降低并发能力。
8. 为什么事务里查到的数据和外面不一样
可能原因包括:
- 事务隔离级别不同;
- 事务内使用了快照读,外部使用了当前读;
- 查询发生在不同事务中;
- Spring 事务没有实际生效;
- 数据库连接被连接池复用但事务状态管理异常;
- 读写分离导致读取了延迟副本。
遇到这类问题,应同时打印事务边界、连接信息、隔离级别和 SQL,而不是只比较业务日志。
9. 软删除字段需要加索引吗
如果所有查询都带:
sql
WHERE deleted = 0是否单独给 deleted 建索引,要看 deleted 的选择性。软删除字段通常只有 0 和 1,单独索引选择性可能很低。更合理的方式可能是把它和业务查询字段组成联合索引,例如:
sql
CREATE INDEX idx_user_deleted_created
ON user_account (user_id, deleted, created_at);
仍然需要通过真实数据和执行计划验证。
10. 分页为什么越翻越慢
传统分页:
sql
SELECT ...
FROM orders
ORDER BY id
LIMIT 100000, 20;
数据库需要跳过大量记录。更适合大数据量的方式是记录上一页最后一条数据:
sql
SELECT ...
FROM orders
WHERE id < 100000
ORDER BY id DESC
LIMIT 20;
游标分页需要稳定排序和明确的下一页游标,适合无限滚动和高数据量列表。
六、进阶思考
1. redo、undo 和 binlog 的职责
可以先从职责角度理解几类日志:
| 机制 | 主要作用 |
|---|---|
| undo log | 支持回滚和旧版本读取 |
| redo log | 支持崩溃恢复和持久化 |
| binlog | 记录逻辑变更,支持复制和恢复 |
| slow log | 记录超过阈值的慢查询 |
事务提交涉及多个日志和存储层之间的协调。实际部署中还要考虑刷盘策略、复制延迟、备份方式和故障恢复目标。
2. 为什么"先查再改"容易出问题
下面的业务流程存在竞态:
text
SELECT stock
  -> 应用判断 stock > 0
  -> UPDATE stock = stock - 1
两个请求之间可能交错执行。改进方案包括:
- 使用带条件的原子 UPDATE;
- 使用 SELECT FOR UPDATE;
- 使用版本号乐观锁;
- 使用队列串行化特定资源;
- 使用数据库约束兜底。
选择方案时要看冲突概率、响应要求、失败重试成本和业务可接受的一致性。
3. 读写分离会带来什么问题
读写分离可以提升读取能力,但副本复制存在延迟,可能出现:
text
主库刚写入
  -> 应用立即从副本读取
  -> 副本还没有同步
  -> 读到旧数据
对于写后立即读、支付结果、库存和权限等场景,应根据一致性要求选择主库读取、会话粘滞、延迟感知或其他方案。不能把读写分离当作对业务完全透明的基础设施。
4. 数据库连接池和事务边界
一个事务通常会占用一个数据库连接。事务越长,连接池中的可用连接越少。
如果连接池大小为有限值,而每个事务都在等待下游服务,可能形成:
text
连接池耗尽
  -> 新请求等待连接
  -> 请求超时
  -> 事务和连接释放变慢
  -> 系统进一步拥塞
数据库连接池大小不能脱离数据库最大连接数、应用实例数、接口并发和下游调用时间单独设置。
5. 如何观察锁等待
生产排查需要结合:
- 当前活动事务;
- 锁等待关系;
- 阻塞事务的 SQL;
- 被阻塞事务的 SQL;
- 事务开始时间;
- 连接来源和应用实例;
- 相关索引和执行计划。
应用日志中应记录 traceId、事务操作名称和关键 SQL 的耗时摘要,但不建议无条件记录完整敏感参数。
6. 索引优化的完整流程
可以建立一套固定流程:
text
收集慢查询
  -> 还原真实参数和数据规模
  -> EXPLAIN 查看执行计划
  -> 判断过滤、排序和回表问题
  -> 设计候选索引
  -> 评估写入成本和空间成本
  -> 在测试或灰度环境验证
  -> 对比延迟分位数和资源消耗
  -> 上线后持续观察
索引优化不是单条 SQL 的局部修改,还要考虑其他查询是否会因为新增索引而变慢或写入成本增加。
7. 数据库一致性需要多层保障
可靠的业务数据通常依赖多层约束:
text
数据库约束:唯一、非空、检查
事务:一组操作的原子性
锁或版本号:并发修改控制
应用校验:业务规则
幂等设计:重复请求处理
补偿机制:跨系统失败修复
审计记录:问题追踪
不要把所有一致性都交给某一层。数据库约束不能代替业务幂等,应用判断也不能代替事务和并发控制。
结论
事务、索引和锁共同构成了后端数据库开发的基础。事务保证一组操作的原子性和一致性,索引帮助数据库快速定位数据,锁和 MVCC 则在并发访问时平衡正确性与性能。
本文的重点可以归纳为:
- 事务解决多步操作的原子性和隔离问题;
- 隔离级别决定并发读取能够看到什么;
- MVCC 通过多版本减少普通读写之间的阻塞;
- B+Tree 索引适合等值和范围查询;
- 聚簇索引、二级索引和覆盖索引影响访问成本;
- 联合索引设计必须结合真实查询和最左匹配;
- 锁的范围与索引、条件、隔离级别和执行计划有关;
- 库存扣减应使用原子更新、当前读或乐观锁;
- 长事务、无索引更新和不一致加锁顺序容易导致阻塞和死锁;
- EXPLAIN、慢查询和锁等待信息是数据库排查的重要依据。
下一篇可以继续学习 Redis 在 Java 项目中的常见应用与踩坑实践,进一步理解缓存、数据库和事务之间如何协同工作。