年初的时候我分享了我的AI资讯热点捕捉器,用 n8n 搭了个工作流,每天自动抓 AI 资讯存进飞书多维表格。这期间每天都在正常运行,截止到10月2日,已经汇总了14194条数据了。
其实这中间我就发现了一些问题,比如分类不准确,即使我的提示词里面已经说明了分类的选项,但是模型因为幻觉或是降智的原因,总是会出现一些我未曾给到的分类,结果凌乱不堪。当然这也有我前期分类不细致的一些原因。
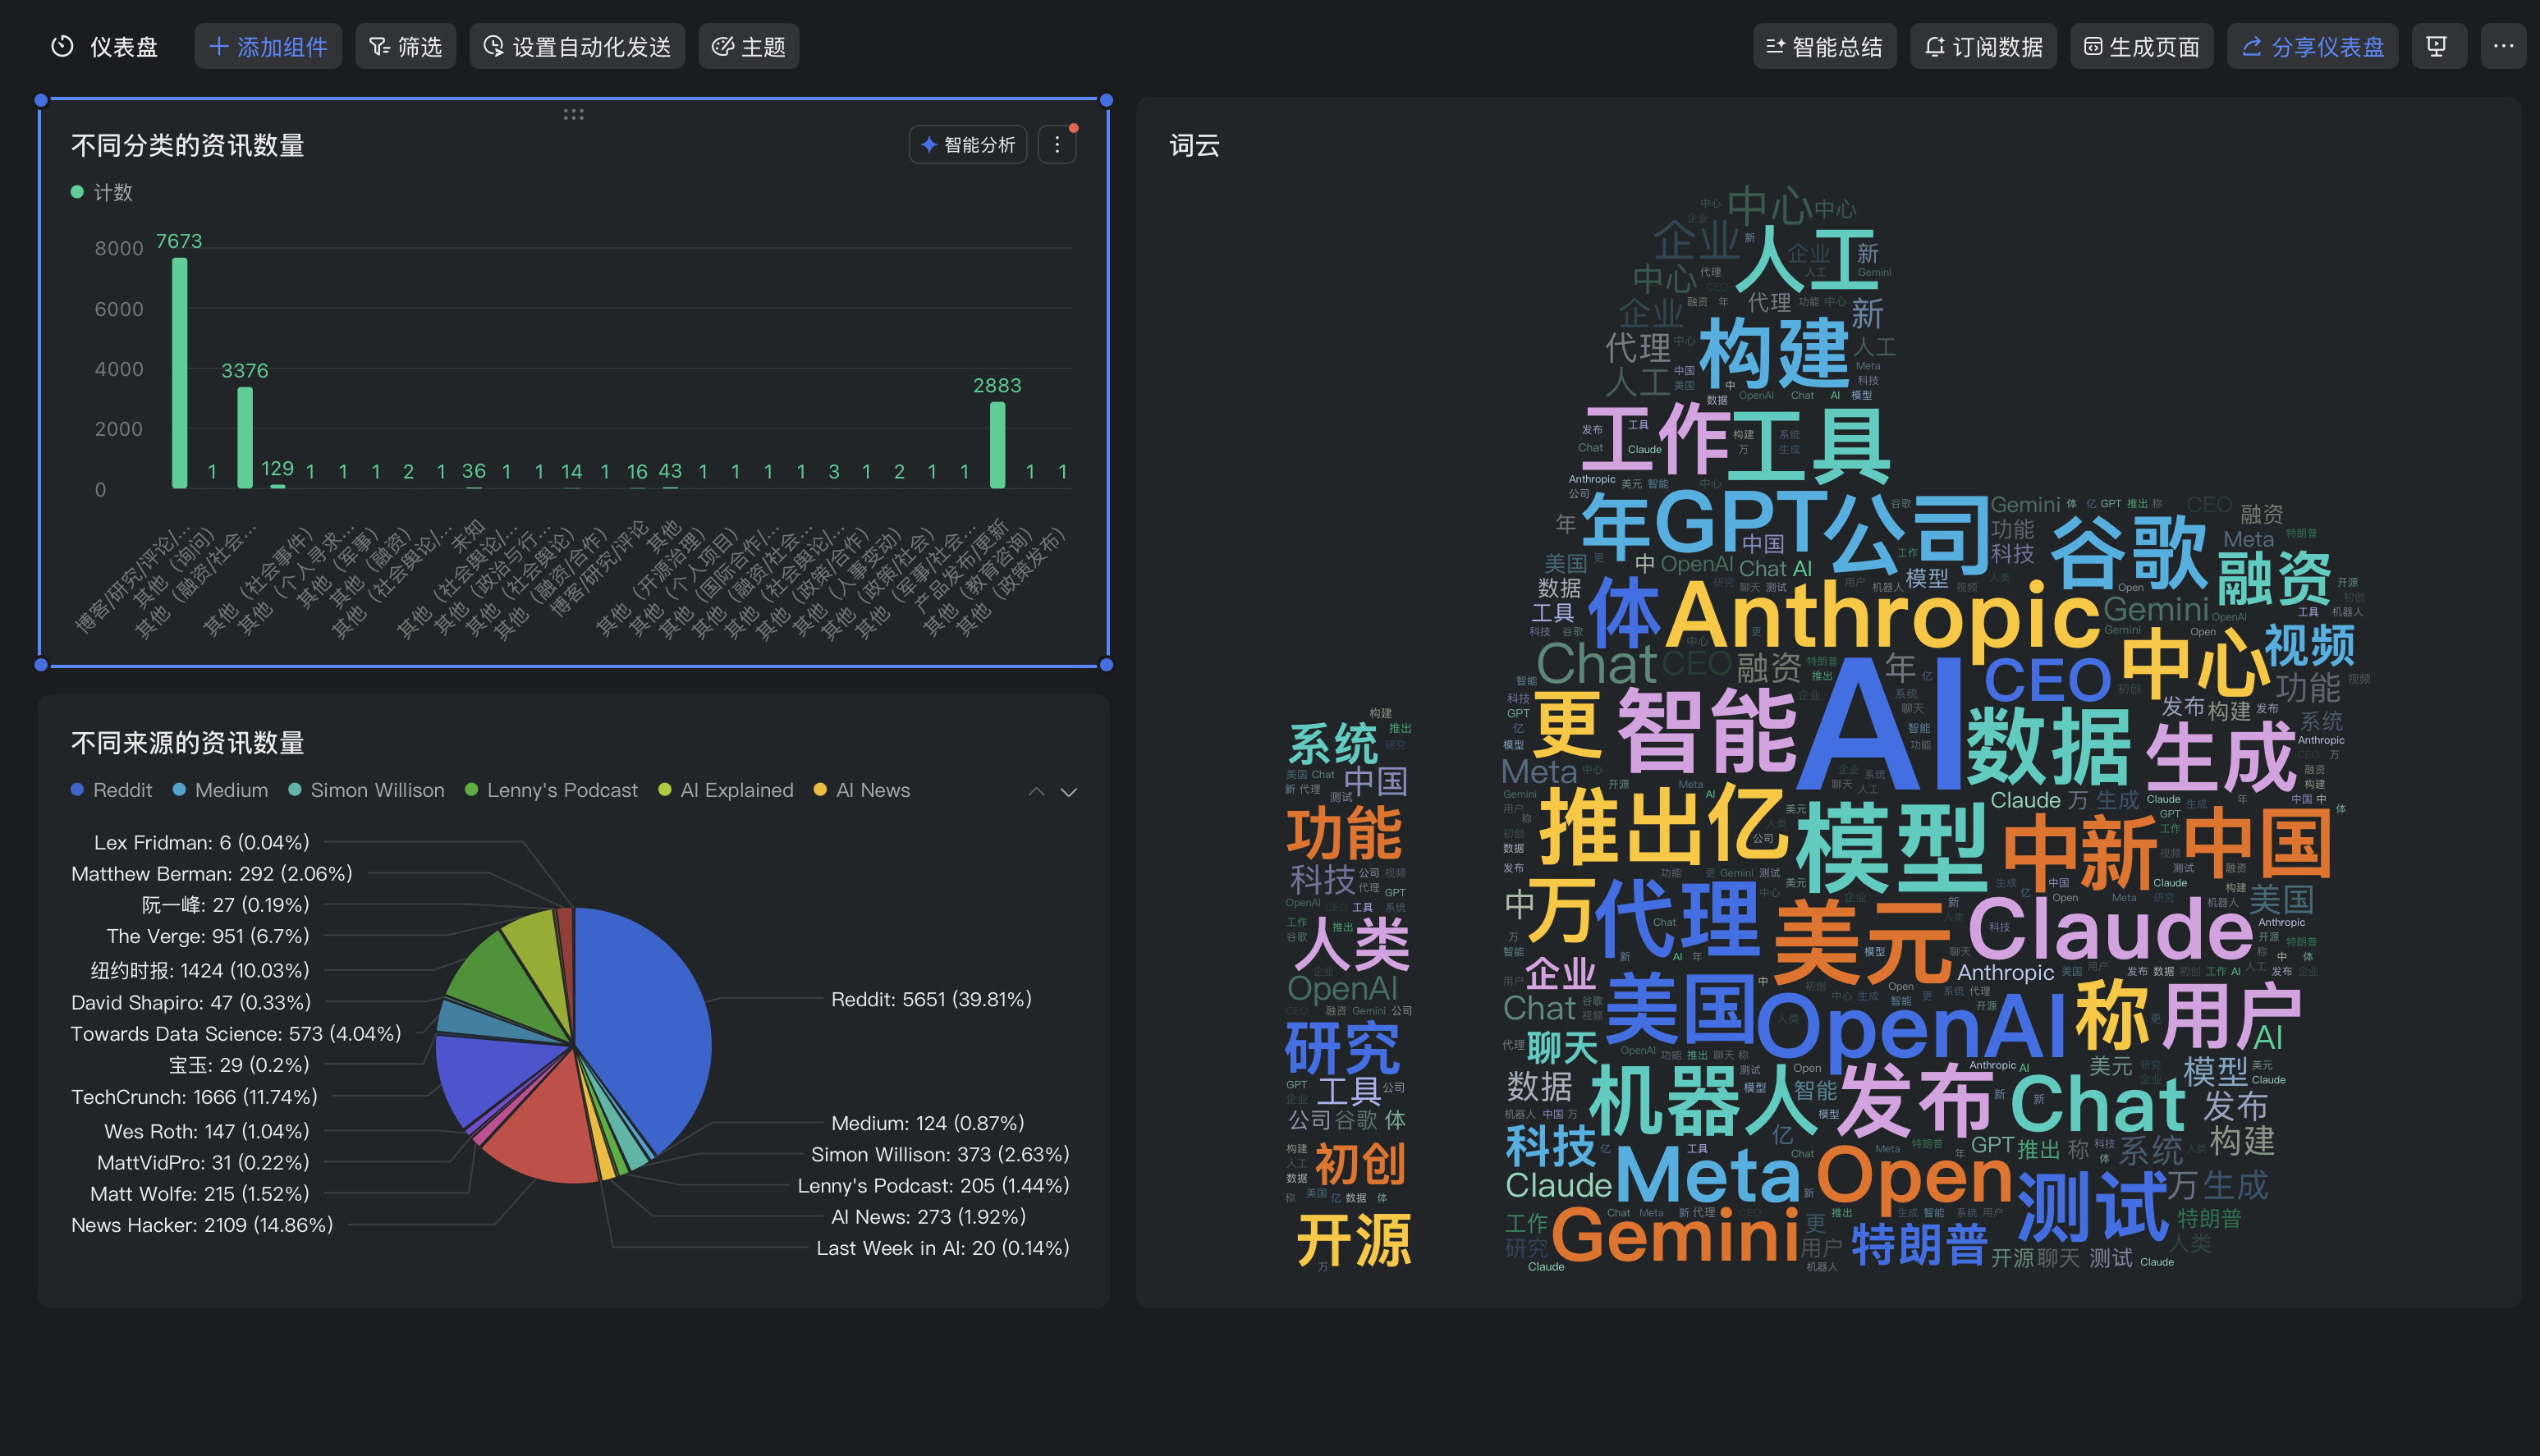
- 7,673 条在「博客/研究/评论/深度报道」
- 3,376 条叫「其他(融资/社会舆论/人事变动等)」
- 2,883 条「产品发布/更新」
- 剩下的散落在 20 多种「其他(...)」变体里。图中可以看到各种的其他分类。
所以我很早就想要全部重新分类了,但是感觉太浪费token了。就一直没有实施。
Jev 是什么
这次用的不是 ChatGPT 也不是 Claude这些大模型,而是 TypeSafe 家的 Jev,官方叫它「System One 模型」------名字来自卡尼曼《思考,快与慢》里的系统一/系统二。
你把材料(state)和问题(question)发过去,它直接返回结构化判断------选了哪个选项、各选项概率多少、置信度多少。没有废话,直接返回 JSON 结果。
它有三种方式:
Choice:给固定选项让它选,我做分类用的就是这个Score:按有序档位打分Noul:是/非判断,带概率
还有一个对我最重要的特性:一次请求里可以塞很多个问题,并行评估。这就可以批量处理数据了。
怎么用
先设计类目
模型只负责判,类目是人划的,边界划不好结果就跟着歪。我让AI按内容主题重新设计了 10 个类目:模型与基准、研究与技术、产品与应用、智能体与自动化、安全与事故、政策与监管、商业与市场、社会与文化、观点与评论、其他。每类都有一句判定标准,另外把模糊情况的优先级规则也写进了指令,比如:
- 涉及政府/立法/监管调查/诉讼的,归「政策与监管」,不归「安全与事故」
- Agent 产品的发布归「智能体与自动化」,普通产品归「产品与应用」
请求长什么样
一次调用的核心就这三块:state(材料)、questions(问题)、criteria(选项)。
python
{
  "state": [
    {"n": 1, "title": "英伟达确认将斥资129亿美元收购Hugging Face", "summary": "..."},
    {"n": 2, "title": "FTC调查OpenAI和Anthropic的潜在消费者损害", "summary": "..."},
    # ...一次塞 20 条
  ],
  "model": "jev-latest",
  "questions": {
    "q1": {"type": "choice", "instructions": "根据标题和摘要判断类目...这是第1条记录。", "criteria": {...10个类目...}},
    "q2": {"type": "choice", "instructions": "...这是第2条记录。", "criteria": {...}},
    # ...q20
  }
}
返回也很干净:
json
"answers": {
  "q1": {"choice": "business_market", "confidence": 1.0, ...}
}
一次请求并行判 20 条,实测每次响应只要 1 秒左右。14,194 条 ÷ 20 = 710 次请求。
结果
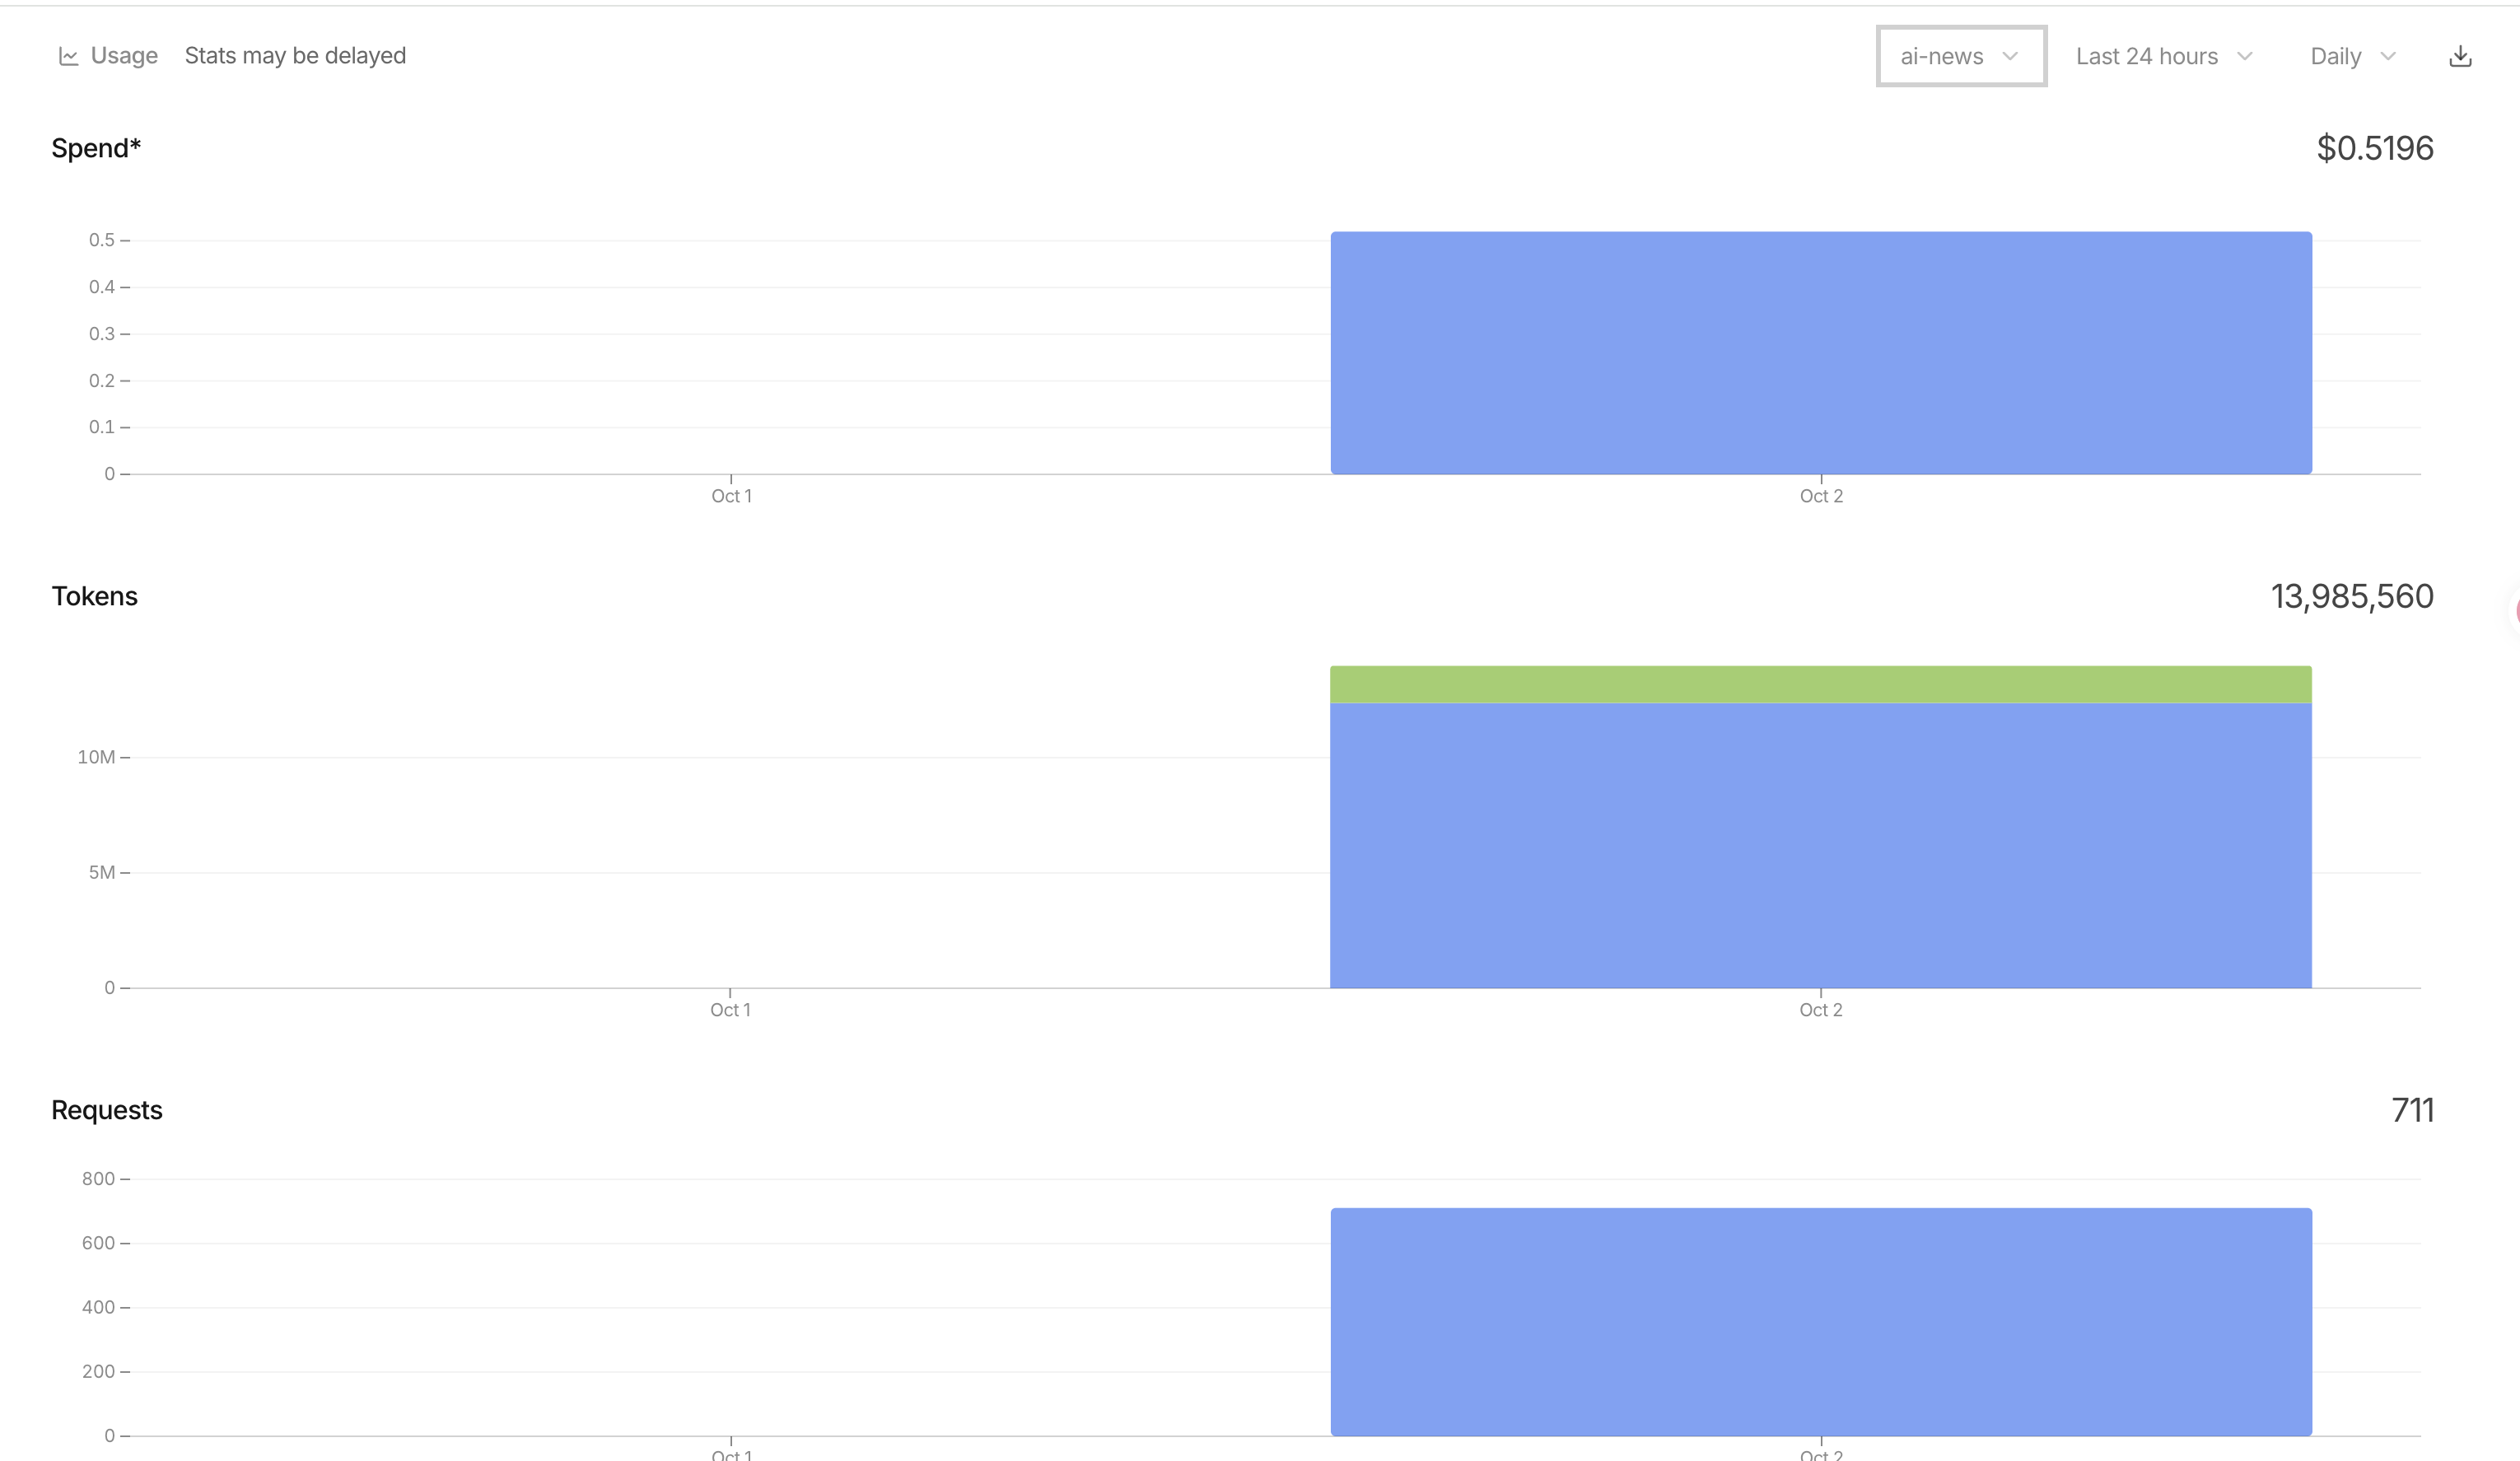
- 分类 14,194 条:710 次请求,652 秒,输入 1,235 万 tokens,输出 161 万,总费用0.52美元。
- 平均置信度 0.776
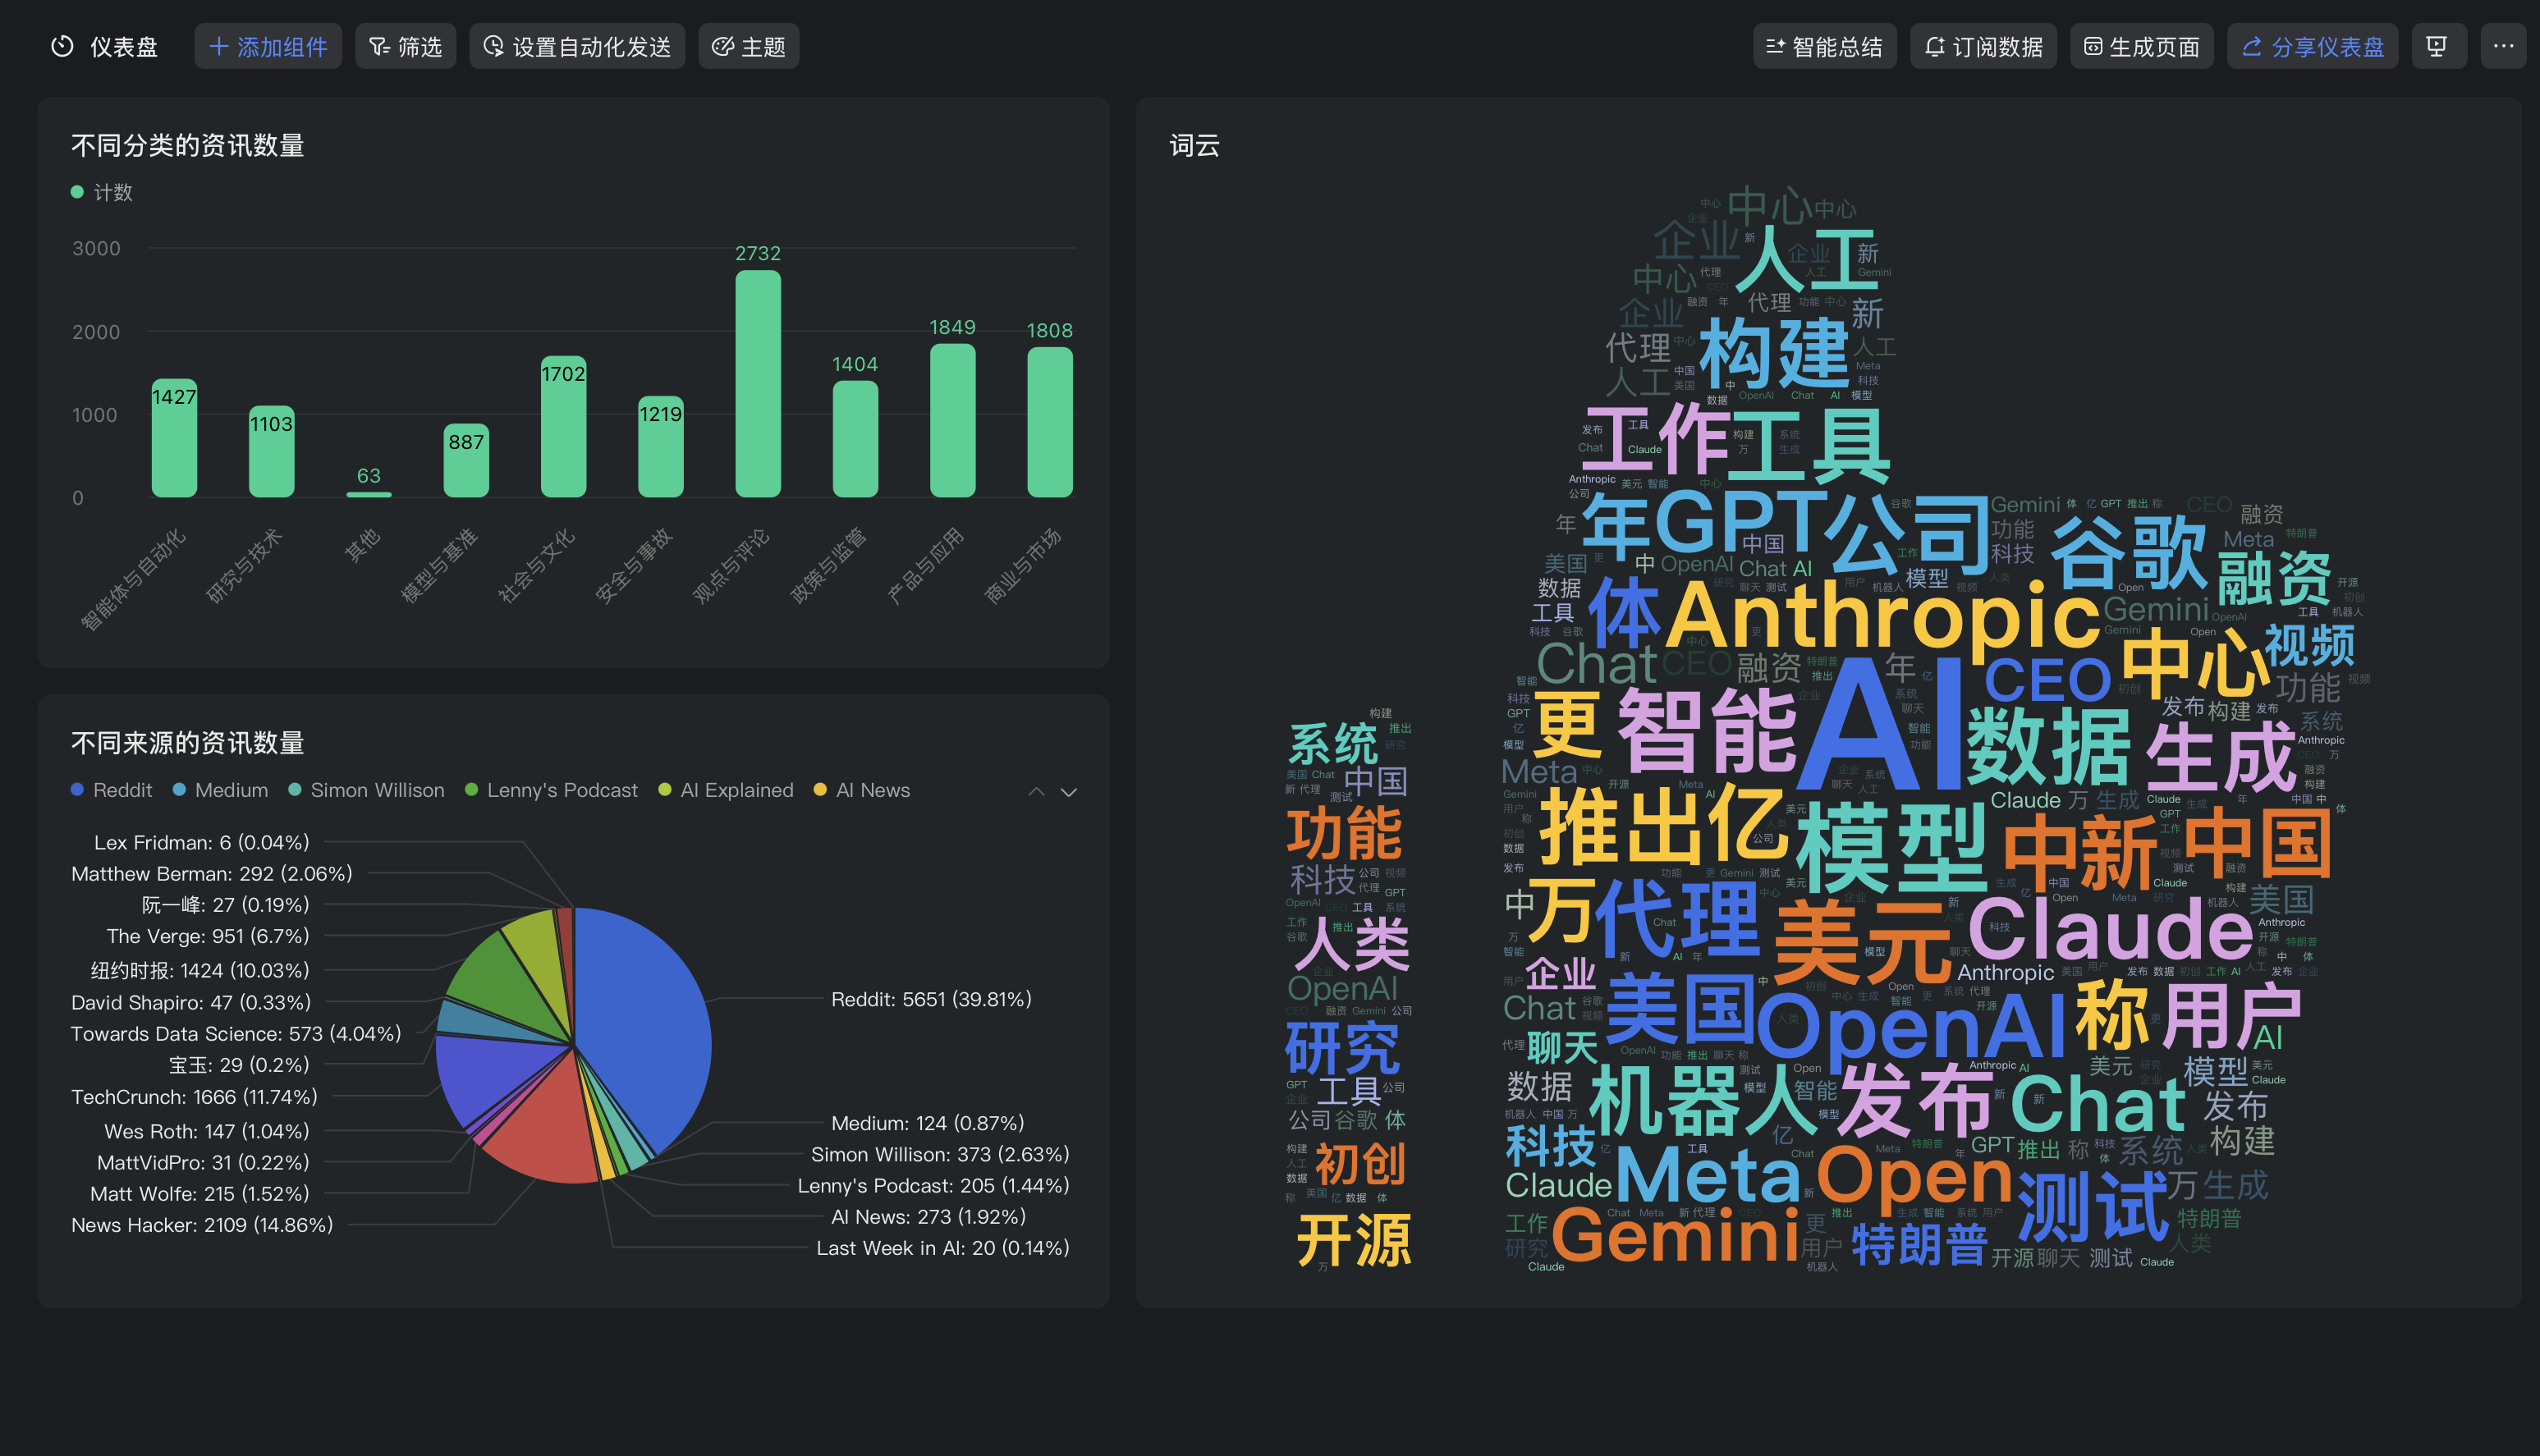
新旧对比一眼就能看出差别:原来 54% 的数据(7,673 条)挤在「博客/研究/评论/深度报道」一个大筐里,现在按主题拆成了这样------观点与评论 2,732 条,产品与应用 1,849 条,商业与市场 1,808 条,社会与文化 1,702 条,智能体与自动化 1,427 条,政策与监管 1,404 条,安全与事故 1,219 条,研究与技术 1,103 条,模型与基准 887 条,兜底的「其他」只剩 63 条(0.4%)。
当然也有翻车的:「科技爱好者周刊」是个每期主题都不同的聚合帖,有的期判成「观点与评论」没问题,但有一期被按当期主题判到了别的类目,置信度只有 0.28。全量有 809 条置信度低于 0.4 的记录,这部分可以来人工复核,而不是混在里面假装正确。
优缺点
优点:
- 快。1 万多条 11 分钟跑完,单请求 1 秒判 20 条,这个吞吐对脏活累活来说非常够用
- 返回即结构化。选项、概率、置信度都是现成字段,不用写任何解析代码
- 置信度是真有用。低置信度记录天然就是人工复核清单,809 条比 14,194 条好查多了
- 判定规则写进指令它真的遵守。我写的边界规则在实际结果里都能对上号
缺点:
- 类目设计还是人的活,而且占了大头。模型判得再稳,边界划歪了整体就歪
- 不做长篇推理,特别模糊的题目(比如「900年前的古老答案应对现代难题」这种标题党)置信度会很低,得有人工兜底
- 「其他」这个兜底类目偶尔会吞掉一些其实能归类的(某期周刊被判了 0.28 的「其他」,其实归「观点与评论」更合适)
另外新用户Jev送5美元体验额度(有效期一个月),所以等于没要钱,哈哈。
整体感受是,以前我做这类批量判断任务,默认拿起聊天模型,写 prompt、输出 JSON、写解析、处理解析失败重试。Jev 这类「判断型」模型等于把这套流程做成了标准件------尤其适合分类、打分、合规检查、意图识别这种「一万四千条里哪个是哪个」的任务。它不会帮你写文章干活,但脏活累活又快又省心。