专栏导语 :本专栏不搬运赛题题解,而是从大数据与人工智能的视角,重新拆解经典数学建模问题。每一篇遵循"问题 → 假设 → 建模 → 求解 → 反思"的闭环,并在结尾点出它与人工智能方法的隐秘联系。上一篇配齐了编程工具与排版工具,结尾留下一句"实战开始"------这一篇就兑现它:用最朴素的人口增长问题,把前四篇的流程、趋势、地图与工具链真正串起来跑一遍。上一篇里的曲线拟合和绘图还只是"演示",从这一篇起,它们是干活的工具。
文章目录
- 个人主页 :蒲公英eric
- 专栏传送门 :《数学建模 × AI:从经典模型到智能方法》
- 学习方向:大数据 / 数学建模 / AI交叉领域
- 人生格言:建模没有终点,只有不断迭代的更优解
📌本文是专栏「数学建模 × AI:从经典模型到智能方法」的第 5 篇文章。
一、问题引入
人口预测是数学建模最古老的课题之一。1798 年,马尔萨斯在《人口原理论》中提出一个简单判断:人口按几何级数增长,食物按算术级数增长,因此人口终将触及资源边界。这套说法粗糙,但它把"增长"这件事第一次变成了可以被公式描述的对象。
问题来了:如果人口真的无限指数增长,地球早该被挤爆,但现实没有。那么------
- 究竟什么样的数学结构能描述"先快后慢、最终趋于稳定"的增长?
- 用历史数据能不能反推出增长率、环境容量这些参数?
- 这套思路和今天机器学习里的"模型训练"是什么关系?
本文就沿着这条线,从最朴素的 Malthus 模型出发,一步步走到 Logistic 模型,最后落回到 AI。
二、问题分析
我们关注的对象是人口数量随时间的变化规律。先抽取要素:
- 研究对象:人口数 P P P,看作时间 t t t 的连续函数 P ( t ) P(t) P(t)
- 核心关系:单位时间人口增量 d P d t \frac{dP}{dt} dtdP 由什么决定?
- 已知信息:若干年的人口普查数据
- 要回答:未来人口走势;增长率与环境上限
关键抽象:把"出生"和"死亡"合并成一个净增长率 r r r,把"资源约束"压缩成一个环境容量上限 K K K。建模就是把杂乱的现实压成几个可量化的参数------这一点贯穿所有建模问题。
三、模型假设
Malthus 模型的假设:
- 人口净增长率 r r r 是常数(出生率与死亡率差值稳定)
- 不考虑资源、环境、迁移的限制
- 人口可视为连续变量,规模足够大
Logistic 模型在此基础上放松假设:
- 增长率不再是常数,随人口逼近环境容量 K K K 而下降
- 引入"自限项" ( 1 − P / K ) (1 - P/K) (1−P/K),描述资源拥挤效应
从 Malthus 到 Logistic,不是推翻,而是放松假设------这是建模迭代的典型手法,也是后面机器学习里"模型容量由小到大"的同一思路。
四、符号说明
| 符号 | 含义 | 单位 |
|---|---|---|
| P ( t ) P(t) P(t) | t t t 时刻人口数 | 人 |
| P 0 P_0 P0 | 初始时刻人口数 P ( 0 ) P(0) P(0) | 人 |
| r r r | 自然增长率 | 1/年 |
| K K K | 环境容量(承载上限) | 人 |
| t t t | 时间 | 年 |
五、模型建立
5.1 Malthus 模型
由假设,单位时间人口增量与当前人口成正比:
d P d t = r P , P ( 0 ) = P 0 \frac{dP}{dt} = rP, \quad P(0) = P_0 dtdP=rP,P(0)=P0
分离变量积分:
∫ d P P = ∫ r d t ⟹ ln P = r t + C \int \frac{dP}{P} = \int r\,dt \;\Longrightarrow\; \ln P = rt + C ∫PdP=∫rdt⟹lnP=rt+C
代入 P ( 0 ) = P 0 P(0)=P_0 P(0)=P0 得 C = ln P 0 C = \ln P_0 C=lnP0,于是:
P ( t ) = P 0 e r t P(t) = P_0 e^{rt} P(t)=P0ert
其中, P 0 P_0 P0 为初始人口, r r r 为自然增长率。这是一个纯指数增长曲线。
问题暴露 :当 t → ∞ t\to\infty t→∞ 时 P ( t ) → ∞ P(t)\to\infty P(t)→∞,与现实严重背离------任何种群都不可能无限增长。模型在短期内(人口远低于资源上限时)拟合良好,长期失效。这正是需要改进的信号。
5.2 Logistic 模型
修正思路:让增长率随 P P P 的增大而衰减,最简单的衰减方式是线性衰减:
d P d t = r P ( 1 − P K ) , P ( 0 ) = P 0 \frac{dP}{dt} = rP\left(1 - \frac{P}{K}\right), \quad P(0)=P_0 dtdP=rP(1−KP),P(0)=P0
其中, r r r 为内禀增长率( P → 0 P\to 0 P→0 时的增长率), K K K 为环境容量。当 P ≪ K P\ll K P≪K 时退化为 Malthus;当 P → K P\to K P→K 时 d P d t → 0 \frac{dP}{dt}\to 0 dtdP→0,增长自然停滞。
求解(伯努利方程,可分离变量):
d P P ( 1 − P / K ) = r d t \frac{dP}{P(1 - P/K)} = r\,dt P(1−P/K)dP=rdt
对左边做分式分解。设:
1 P ( 1 − P / K ) = A P + B 1 − P / K \frac{1}{P(1-P/K)} = \frac{A}{P} + \frac{B}{1-P/K} P(1−P/K)1=PA+1−P/KB
令 P = 0 P=0 P=0 得 A = 1 A=1 A=1;令 P = K P=K P=K 得 B = 1 / K B=1/K B=1/K。于是:
∫ ( 1 P + 1 K − P ) d P = ∫ r d t \int\left(\frac{1}{P} + \frac{1}{K-P}\right)dP = \int r\,dt ∫(P1+K−P1)dP=∫rdt
积分得 ln P − ln ( K − P ) = r t + C \ln P - \ln(K-P) = rt + C lnP−ln(K−P)=rt+C,即:
P K − P = C ′ e r t \frac{P}{K-P} = C' e^{rt} K−PP=C′ert
代入 P ( 0 ) = P 0 P(0)=P_0 P(0)=P0 得 C ′ = P 0 K − P 0 C' = \frac{P_0}{K-P_0} C′=K−P0P0,整理:
P ( t ) = K 1 + K − P 0 P 0 e − r t \boxed{P(t) = \frac{K}{1 + \dfrac{K-P_0}{P_0}\,e^{-rt}}} P(t)=1+P0K−P0e−rtK
其中, K K K 为环境容量, r r r 为内禀增长率, P 0 P_0 P0 为初始人口。这是一条 S 形曲线------先指数上升,过拐点后趋于平稳。
伏笔 :把 P ( t ) P(t) P(t) 除以 K K K 做归一化,记 x = P / K x = P/K x=P/K,则 x ( t ) = 1 1 + a e − r t x(t) = \frac{1}{1+ae^{-rt}} x(t)=1+ae−rt1。这正是神经网络里 sigmoid 激活函数的来源。我们后面会回到这一点。
六、模型求解
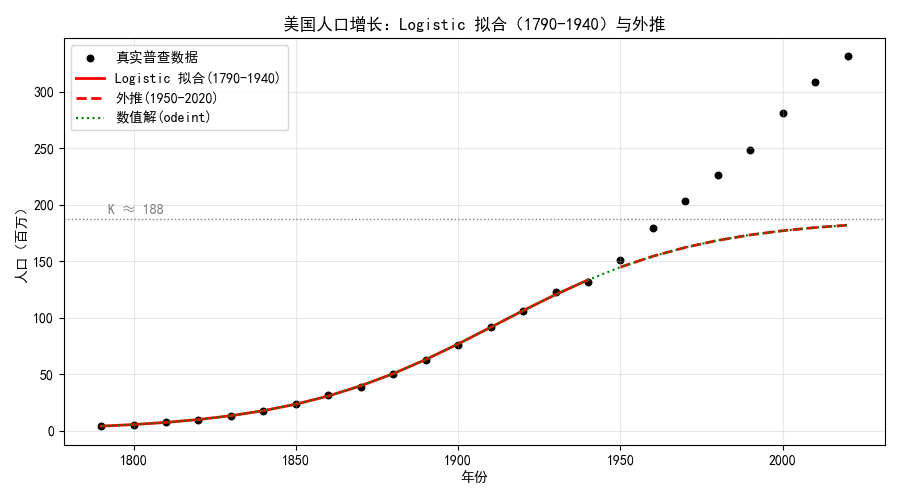
数据用美国 1790--2020 年人口普查(单位:百万人)。思路分三步:固定已知初值 P 0 = 3.9 P_0=3.9 P0=3.9,用 1790--1940 年的数据拟合 K K K 和 r r r ;用 odeint 数值求解同一条微分方程,验证解析解;再把拟合曲线外推到 1950--2020,与真实数据对比------这一步才是真正的模型检验。为什么只用早期数据拟合?这正是 1920 年代 Pearl 与 Reed 的经典做法:用过去的数据建模,用"没见过的年份"检验,才能看出模型能否预测未来------这也是机器学习里"训练集/测试集分离"思想的雏形。
python
import numpy as np
import matplotlib.pyplot as plt
from scipy.optimize import curve_fit
from scipy.integrate import odeint

# 美国人口普查数据(年份, 人口/百万)
years = np.arange(1790, 2021, 10)
pop = np.array([3.9, 5.3, 7.2, 9.6, 12.9, 17.1, 23.2, 31.4, 38.6,
                50.2, 62.9, 76.0, 92.0, 105.7, 122.8, 131.7, 150.7,
                179.3, 203.2, 226.5, 248.7, 281.4, 308.7, 331.4])
t = years - years[0]                      # 以 1790 年为原点

P0 = 3.9                                  # 1790 年普查值:已知初值,固定不拟合
mask = t <= 150                           # 训练窗口 1790-1940,1950-2020 留作外推检验

# 1) 拟合 K 和 r(P0 已固定):P(t) = K / (1 + a*exp(-r*t))
def logistic(t, K, r):
    a = (K - P0) / P0
    return K / (1 + a * np.exp(-r * t))

popt, _ = curve_fit(logistic, t[mask], pop[mask], p0=[200, 0.03],
                    bounds=([50, 0.005], [1000, 0.1]), maxfev=10000)
K, r = popt
print(f"拟合参数(1790-1940): K={K:.1f}, r={r:.4f}")

# 拟合优度(只看训练段)
pred = logistic(t, K, r)
ss_res = np.sum((pop[mask] - pred[mask]) ** 2)
ss_tot = np.sum((pop[mask] - pop[mask].mean()) ** 2)
print(f"训练段 R²={1 - ss_res/ss_tot:.4f}, RMSE={np.sqrt(ss_res/mask.sum()):.2f} 百万")

# 2) 数值求解同一条微分方程 dP/dt = r*P*(1 - P/K),验证解析解
def dP(P, t, r, K):
    return r * P * (1 - P / K)

P_num = odeint(dP, P0, t, args=(r, K)).ravel()

# 3) 绘图:训练段实线,外推段虚线
plt.rcParams['font.sans-serif'] = ['SimHei', 'Microsoft YaHei']  # 中文字体备选
plt.rcParams['axes.unicode_minus'] = False
plt.figure(figsize=(9, 5))
plt.scatter(years, pop, c='k', s=22, label='真实普查数据')
plt.plot(years[mask], pred[mask], 'r-', lw=2, label='Logistic 拟合(1790-1940)')
plt.plot(years[~mask], pred[~mask], 'r--', lw=2, label='外推(1950-2020)')
plt.plot(years, P_num, 'g:', lw=1.5, label='数值解(odeint)')
plt.axhline(K, color='gray', ls=':', lw=1)
plt.text(1792, K + 4, f'K ≈ {K:.0f}', color='gray')
plt.xlabel('年份')
plt.ylabel('人口(百万)')
plt.title('美国人口增长:Logistic 拟合(1790-1940)与外推')
plt.legend()
plt.grid(alpha=0.3)
plt.tight_layout()
plt.savefig('logistic_fit.png', dpi=130)

# 4) 残差图:真实值 - 预测值(正 = 真实高于预测)
residuals = pop - pred
plt.figure(figsize=(9, 3.5))
plt.bar(years, residuals, width=6,
        color=['steelblue' if m else 'indianred' for m in mask],
        edgecolor='k', linewidth=0.5)
plt.axhline(0, color='k', lw=0.8)
plt.xlabel('年份')
plt.ylabel('残差(百万)')
plt.title('Logistic 模型残差:真实值 - 预测值(蓝=训练段,红=外推段)')
plt.grid(alpha=0.3, axis='y')
plt.tight_layout()
plt.savefig('residuals.png', dpi=130)
plt.show()
运行后:训练段拟合相当好------ K K K 取在 188 附近、 r r r 取在 0.032 附近, R 2 R^2 R2 达到 0.9996,RMSE 只有约 0.9 百万;训练段里解析解(红实线)与数值解(绿点线)几乎叠在一起。但看外推段(红虚线):曲线逐渐躺平在 K ≈ 188 K\approx 188 K≈188 附近,黑色散点却继续爬升------真实人口在 1960 年代末就"突破"了模型认定的上限,到 2020 年已比预测高出约 150 百万。要强调:这个 K K K 是模型在 1940 年数据下的外推参数,不能当成真实的"人口上限"来解读 。
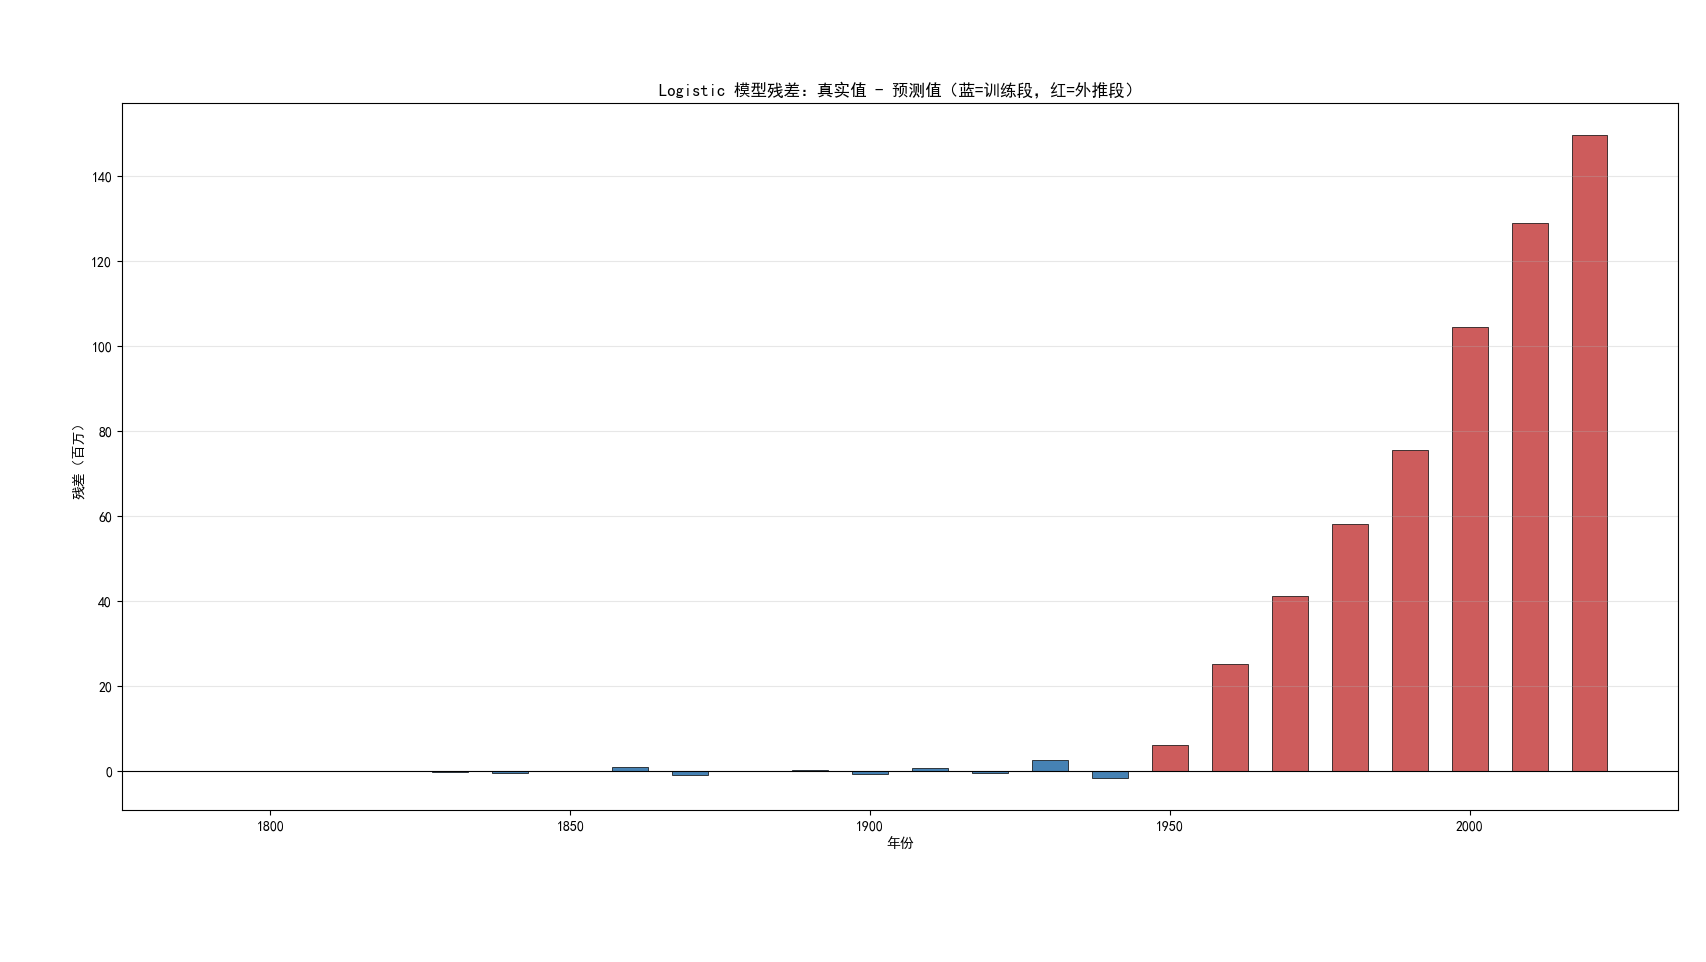
注意 :解析解与数值解的重合,验证的是求解方法本身的正确性 ------两者解的是同一个微分方程,差异只来自数值积分误差。但"求解方法对"不等于"模型对":模型对不对,要看它和真实数据(黑点)的残差,这正是第 4 步残差图的任务。另外提醒一句统计严谨性:人口序列前后相关(自相关),并不满足普通最小二乘"误差独立同分布"的假设,所以
curve_fit给出的参数标准误和置信区间只宜参考,不宜过度解读。
建模注意 : P 0 P_0 P0 是 1790 年的已知普查数据(3.9 百万),属于"已知信息"而非"待估参数"------所以代码把它固定为 3.9,只让 K K K 和 r r r 浮动。如果把 P 0 P_0 P0 也放开去拟合,可能出现"拟合出的 P 0 P_0 P0 偏离真实值、但曲线整体仍然贴合"的伪拟合,还会多消耗一个自由度。
残差图把问题暴露得很直白:训练段(蓝柱)在零线附近小幅摆动,说明模型与 1790--1940 的数据贴合;从 1950 年起残差转正并单调拉大,2020 年达到约 +150 百万------正残差意味着真实人口高于预测,固定的 K K K 被真实世界突破了。这就是"容量漂移"的定量证据。
七、结果与反思
结果分析: 模型在训练窗口 1790--1940 内近乎完美( R 2 ≈ 0.9996 R^2\approx 0.9996 R2≈0.9996),但一外推就露馅:真实人口在 1960 年代末越过模型给出的 K ≈ 188 K\approx 188 K≈188,此后一路高于预测,到 2020 年高出约 150 百万。原因是移民、医疗与技术进步抬高了 K K K------环境容量本身在变化,单一 Logistic 捕捉不了这种"容量漂移"。这是模型的边界。
还有一个更隐蔽的陷阱值得单独说:如果把 1790--2020 全部数据 丢回去重新拟合,最小二乘会给出 K ≈ 391 K\approx 391 K≈391、 r ≈ 0.026 r\approx 0.026 r≈0.026,样本内 R 2 R^2 R2 达 0.992------模型看起来"又好了"。但这是把漂移吸收进参数 ,不是把漂移建模出来:放大后的 K K K 只是模型的外推参数,不能解读为真实的人口上限。教训是:样本内拟合得好,不能证明模型对;只有样本外数据才有资格检验它。 这也正是机器学习里"分布漂移"(distribution shift)的经典形态------训练时世界是稳的,部署后世界变了。
模型检验 :当模型假设与现实发生系统性偏离时,有两条路------要么修正假设(例如让 K K K 随时间变化,建立时变 Logistic),要么换用更灵活的模型。数模比赛里,评委对"模型检验与改进"这一步格外看重,因为它体现了你对模型局限性的清醒认识,而不是拟合完就万事大吉。
模型优缺点。
- 优点:参数有明确物理含义( K K K、 r r r),可解释性强;形式简洁,解析解可推导
- 缺点:假设增长率线性衰减,过于理想化; K K K 被当作常数,忽略了技术进步
与 AI 的联系。 注意 curve_fit 在做什么:它自动调整 ( K , r ) (K, r) (K,r),让模型预测值与真实数据的平方误差之和最小。这个目标函数:
L ( K , r ) = ∑ i ( P model ( t i ) − P true , i ) 2 L(K, r) = \sum_{i}\big(P_{\text{model}}(t_i) - P_{\text{true},i}\big)^2 L(K,r)=∑i(Pmodel(ti)−Ptrue,i)2
就是最小二乘损失。而机器学习训练的本质,正是定义一个衡量预测误差的损失函数,然后调参数使它最小 ------线性回归、神经网络,无一例外。区别只在于:Logistic 模型只有 2 个自由参数( K K K 和 r r r)、函数形式受人脑限定;神经网络有上百万参数、函数形式由数据学出来。从数学建模到深度学习,骨架没有变,变的是"模型有多自由"和"参数怎么搜"。
再看那个 S 形曲线本身。归一化后的 x ( t ) = 1 / ( 1 + a e − r t ) x(t)=1/(1+ae^{-rt}) x(t)=1/(1+ae−rt) 就是 sigmoid 函数------神经网络里把线性输出压到 ( 0 , 1 ) (0,1) (0,1) 的激活函数。它的函数形式早在 1838 年就出现在 Verhulst 的人口学研究中,后来在统计力学、心理学和神经科学等多个领域被独立重新发现。你今天在 PyTorch 里写的 torch.sigmoid,血脉可以追溯到 1838 年的 Verhulst。
这就是本专栏想做的事:把"传统建模"和"AI 方法"还原成同一条河的上下游。前面四篇是"地图",这一篇开始是"走路"------带着地图下场解题。
📌 本文是专栏「数学建模 × AI:从经典模型到智能方法」的第 5 篇文章。
- 上一篇回顾 :Python工具链与LaTeX排版:把兵器配齐
- 下一篇预告 :下一篇我们正式进入评价类模型,从 AHP 讲到熵权法与 TOPSIS,并对照机器学习里的信息增益与特征重要性------看看"评估重要性"这件事,两套体系各自怎么解。
👉 点击订阅专栏,第一时间收到更新通知!
如果你在阅读过程中有任何疑问,欢迎在评论区留言交流。😊